

HPE ha introdotto una generazione ampliata di soluzioni di supercomputing HPE Cray, progettate per soddisfare le esigenze di densità prestazionale, efficienza e operatività dell'intelligenza artificiale su larga scala. Il portfolio si basa su un'architettura blade multi-vendor e multi-workload, un software di gestione dei sistemi unificato e un fabric di interconnessione ad alte prestazioni, formando una piattaforma coesa rivolta a istituti di ricerca, agenzie governative e grandi aziende che accelera la scoperta, la simulazione e la produzione di intelligenza artificiale.
Combinazione di architetture AI e HPC
L'ultima piattaforma Cray di HPE allinea HPC e IA in un'architettura unificata che offre prestazioni deterministiche su larga scala, con i controlli operativi richiesti dall'IT aziendale. Nell'annunciare la piattaforma, Trish Damkroger, Senior Vice President e General Manager delle soluzioni infrastrutturali HPC e IA di HPE, ha sottolineato che l'integrazione di architetture IA e HPC è essenziale per aumentare la densità delle prestazioni e sbloccare nuovi livelli di progresso scientifico e tecnologico. In sintesi, la posizione di HPE è chiara: IA e supercomputing stanno convergendo e HPE intende essere all'avanguardia con sistemi integrati che promuovano sia la ricerca che i risultati concreti.
Questa espansione si basa sul lancio del mese scorso di HPE Cray Supercomputing GX5000, progettato appositamente per l'era dell'integrazione AI+HPC, e ora completato da HPE Cray Supercomputing Storage Systems K3000. Il K3000 si distingue per essere il primo sistema di storage preassemblato dotato di software open source DAOS (Distributed Asynchronous Object Storage) integrato, progettato per supportare le prestazioni dei carichi di lavoro di simulazione e intelligenza artificiale ad alto consumo di I/O.
Rapida adozione nei principali centri di ricerca
Le prime fasi di implementazione della piattaforma includono la selezione da parte dell'High-Performance Computing Center dell'Università di Stoccarda (HLRS) e del Leibniz Supercomputing Center (LRZ) dell'Accademia Bavarese delle Scienze e delle Lettere. I loro sistemi di nuova generazione, Herder di HLRS e Blue Lion di LRZ, sfrutteranno l'HPE Cray Supercomputing GX5000. Nel complesso, queste implementazioni sottolineano lo slancio dei siti HPC europei di primo livello che mirano a espandere la scoperta basata sull'intelligenza artificiale con il rigore HPC di livello produttivo.
Nuove lame di calcolo multi-vendor raffreddate direttamente a liquido
HPE introduce tre nuove blade di elaborazione che possono essere combinate all'interno di un rack HPE Cray GX5000 per adattarsi ai profili dei carichi di lavoro, ai budget e ai vincoli della struttura. Tutte le blade utilizzano il raffreddamento a liquido diretto, offrono due SSD NVMe integrate per l'accelerazione locale dei nodi e integrano quattro o otto endpoint HPE Slingshot da 400 Gbps per una connettività fabric ad alta velocità e bassa latenza. I processori supportati spaziano dalle GPU leader di settore, NVIDIA Rubin e AMD Instinct MI430X, alle CPU AMD EPYC "Venice", consentendo un abbinamento preciso tra elaborazione e caratteristiche del carico di lavoro.
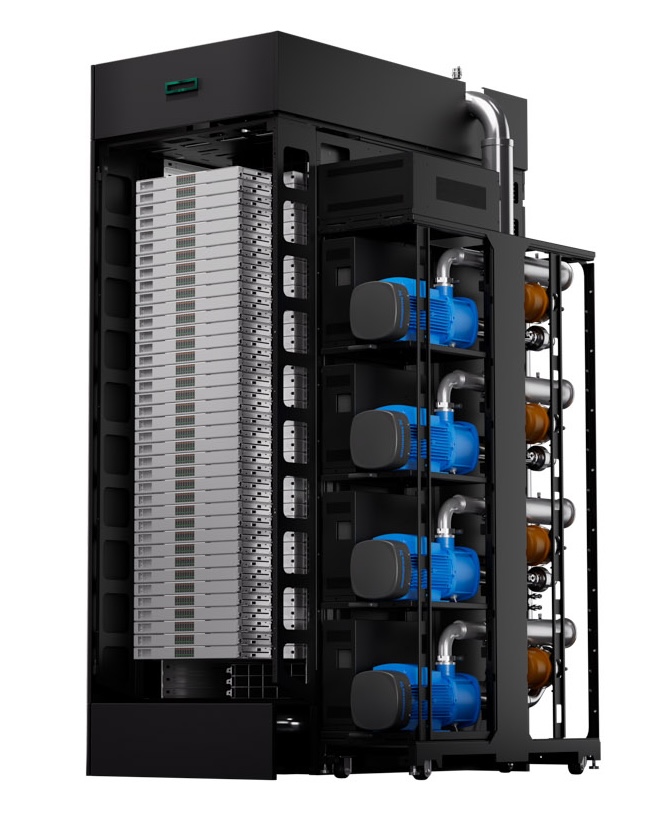
- Blade accelerata HPE Cray Supercomputing GX440n: Progettato come motore AI-HPC universale, questo blade combina quattro CPU NVIDIA Vera con otto GPU NVIDIA Rubin. Con un massimo di 24 blade per rack, le configurazioni possono raggiungere fino a 192 GPU per rack, per l'addestramento AI su larga scala, l'inferenza multi-nodo e i flussi di lavoro di simulazione accelerati.
- Blade accelerata HPE Cray Supercomputing GX350a: Ottimizzato per il calcolo a precisione mista, il GX350a abbina una singola CPU AMD EPYC SP7 da 600 W "Venice" (fino a 256 core) a quattro GPU AMD Instinct MI430X della serie MI400. Questa combinazione è pensata per il training AI e l'accelerazione HPC, con elevate prestazioni FP16/BF16, pur mantenendo la capacità di doppia precisione per le fasi di simulazione: fino a 28 blade per rack generano 112 GPU AMD MI430X.
- HPE Cray Supercomputing GX250 Compute Blade: Progettato per carichi di lavoro pesanti a doppia precisione che richiedono solo CPU (ad esempio, CFD, meteorologia e simulazione tradizionale), il GX250 integra otto CPU AMD EPYC "Venice" per blade, ciascuna con un massimo di 256 core. Con un massimo di 40 blade per rack, è ideale per le strutture che consolidano grandi processi MPI con un comportamento di scalabilità prevedibile.
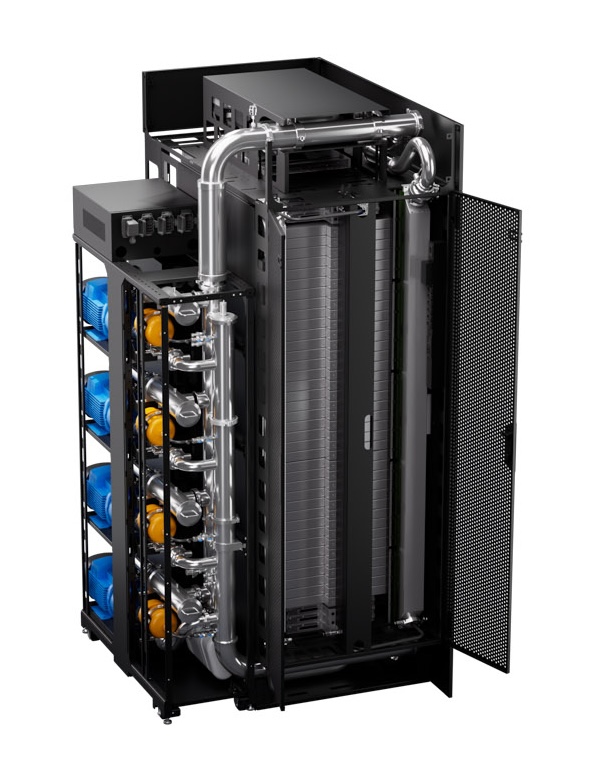
La combinazione flessibile di queste blade a livello di rack consente una progettazione di sistemi su misura, che spazia da isole di addestramento AI ad alta densità di GPU a pool di simulazione basati su CPU, senza sprecare risorse di alimentazione, raffreddamento o interconnessione.
Gestione unificata dei sistemi multi-tenant
Il software di gestione del supercomputing HPE offre multi-tenancy e sicurezza di livello enterprise in ambienti bare-metal, virtualizzati e containerizzati. L'obiettivo è massimizzare l'utilizzo, offrendo al contempo agli operatori solidi controlli di isolamento per utenti, progetti e carichi di lavoro. La gestione dell'alimentazione e dell'energia sono funzionalità di prima classe. Il software fornisce telemetria in tempo reale e storica, stima dei costi e funzionalità per la pianificazione basata sui consumi energetici, consentendo alle organizzazioni di ottimizzare l'efficienza energetica e prevedere le spese.
L'ambito operativo abbraccia l'intero ciclo di vita del sistema, inclusi provisioning, monitoraggio, supervisione di alimentazione/raffreddamento e scalabilità elastica, con controlli di sicurezza avanzati e reporting ottimizzato. Per i team operativi tecnici, l'effetto netto è un unico piano di controllo progettato per ambienti misti di intelligenza artificiale e HPC ad alto utilizzo.
HPE Slingshot 400 per sistemi basati su GX5000
Ora disponibile per i cluster HPE Cray Supercomputing GX5000, HPE Slingshot 400 migliora l'interconnessione con un'architettura blade switch raffreddata a liquido diretta, pensata per implementazioni ad alta densità e throughput sostenuto con carichi compositi AI+HPC. Ogni blade switch offre 64 porte a 400 Gbps e le configurazioni a livello di chassis supportano:
- 8 switch con 512 porte
- 16 switch con 1,024 porte
- 32 switch con 2,048 porte
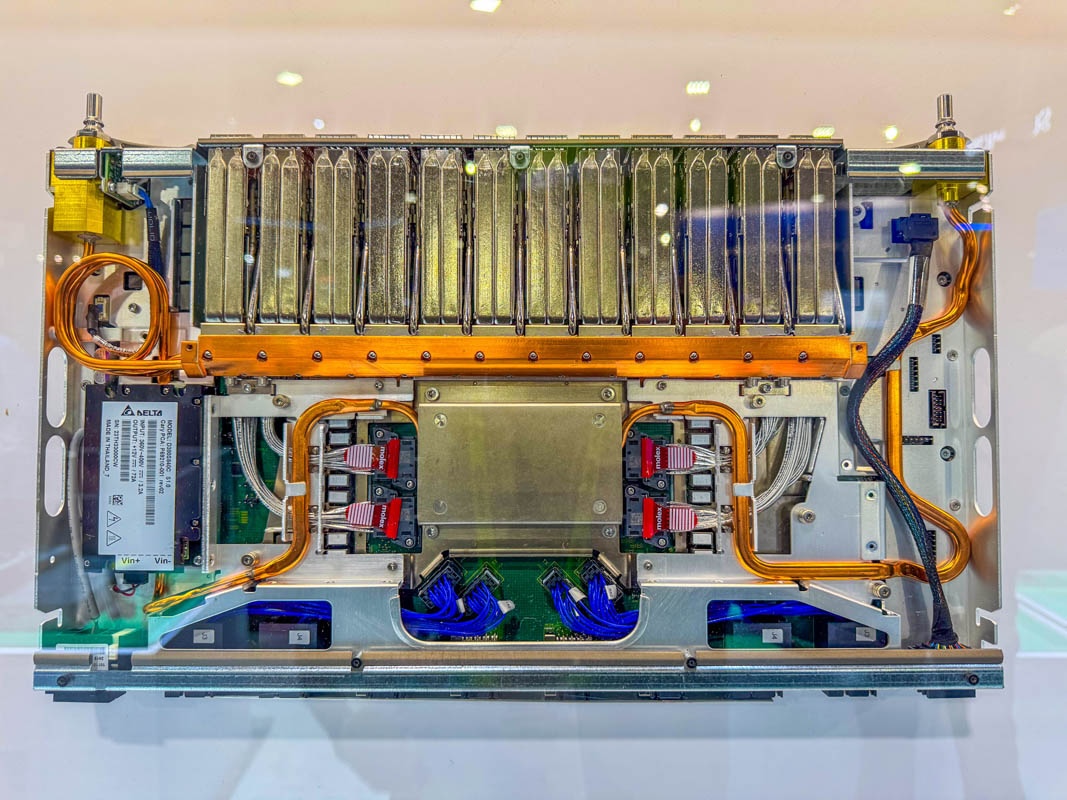
Annunciato per la prima volta lo scorso anno, Slingshot 400 è progettato per sfruttare la topologia ad alte prestazioni del GX5000, riducendo la latenza, migliorando la larghezza di banda costante e l'affidabilità, mantenendo al contempo il controllo dei costi. Per ambienti multi-tenant e flussi di lavoro misti, la combinazione mira a prestazioni prevedibili su larga scala.
Storage basato su DAOS per accelerare l'intelligenza artificiale legata all'I/O
HPE Cray Supercomputing Storage Systems K3000 sfrutta i server HPE ProLiant Compute DL360 Gen12 con DAOS integrato per dare priorità all'accesso agli oggetti a bassa latenza, all'elevato parallelismo e alla scalabilità lineare, attributi cruciali per le pipeline di intelligenza artificiale I/O-bound e i checkpoint di simulazione. La piattaforma bilancia l'elaborazione per nodo di storage con la memoria e la densità NVMe per mantenere GPU e CPU alimentate secondo modelli di accesso simultaneo.
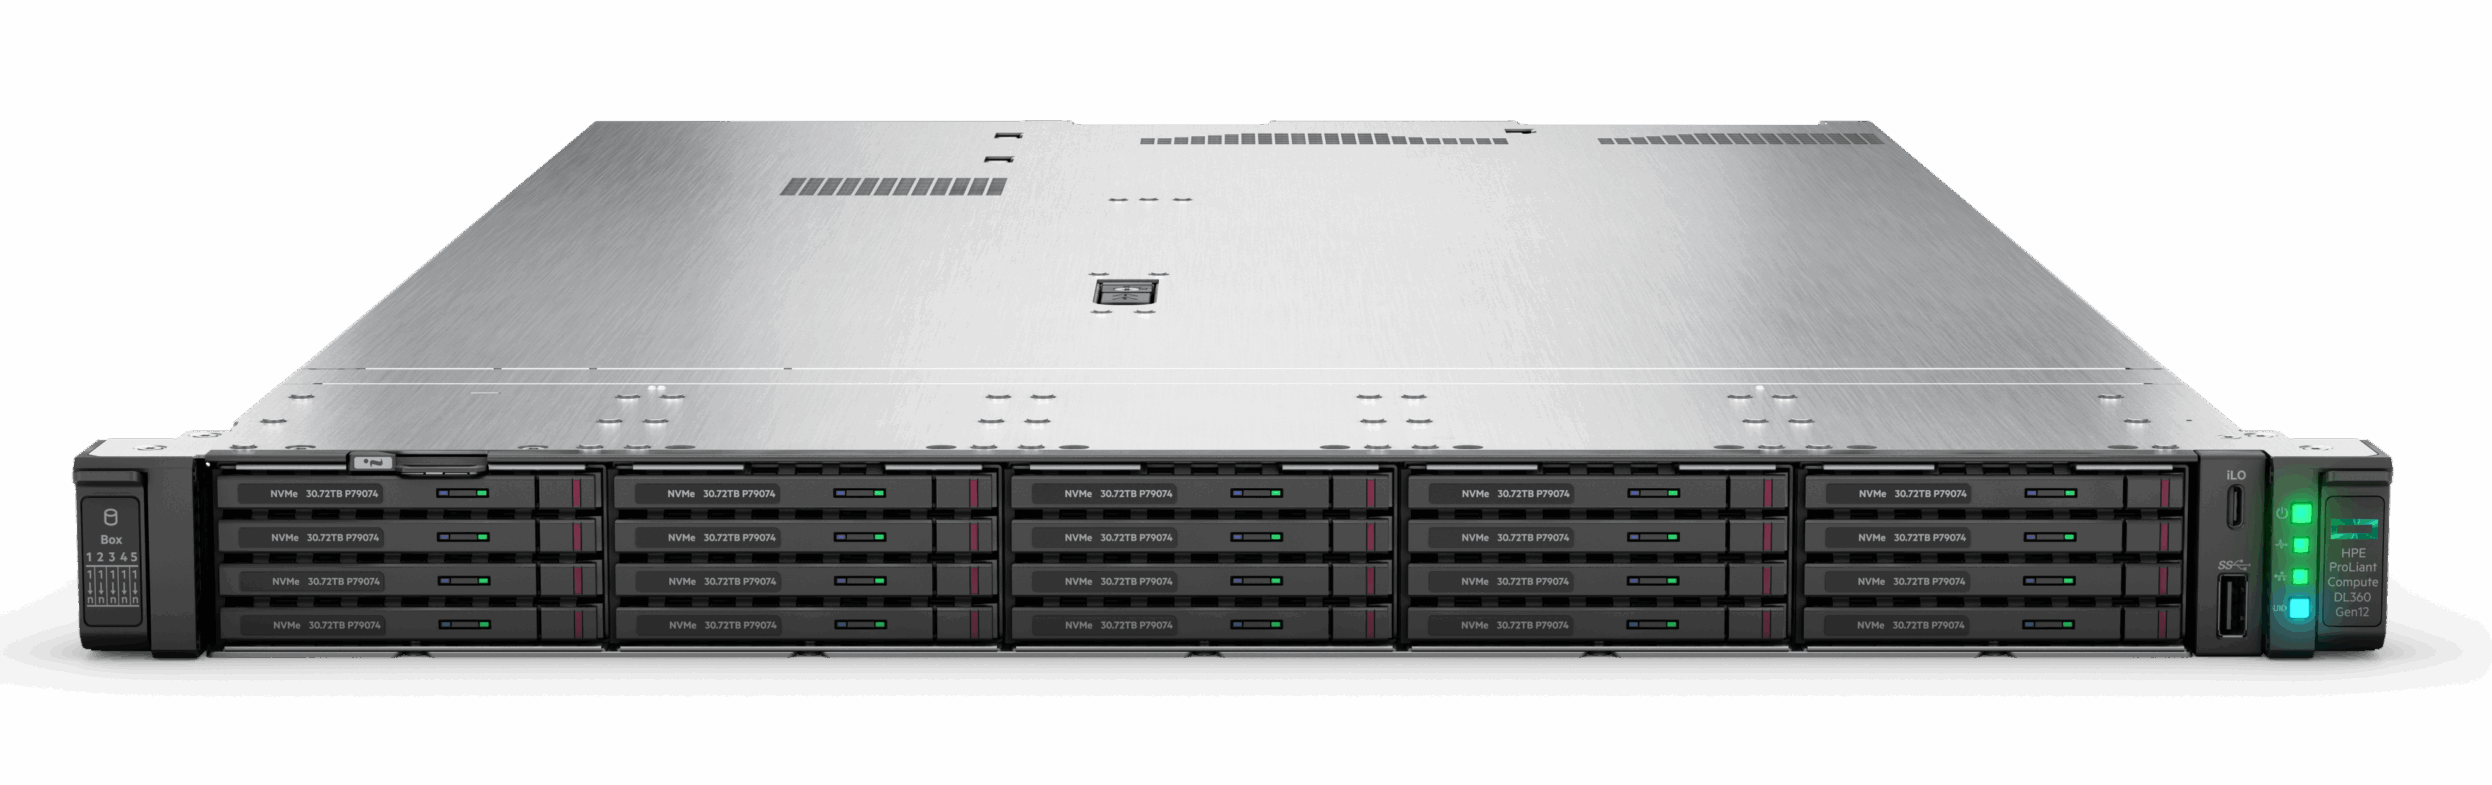
Le opzioni configurabili consentono di ottimizzare le prestazioni o la capacità:
- Server di archiviazione DAOS ottimizzati per le prestazioni con 8, 12 o 16 unità NVMe
- Server di archiviazione DAOS con capacità ottimizzata con 20 unità NVMe
- Dimensioni delle unità NVMe: 3.84 TB, 7.68 TB o 15.36 TB
- Opzioni DRAM: 512 GB, 1,024 GB o 2,048 GB, allineate al numero di unità e ai profili di carico di lavoro
Le scelte di interconnessione riflettono le reti eterogenee dei data center e le esigenze del flusso di lavoro:
- HPE Slingshot 200
- HPE Slingshot 400
- Rapporto di mancato recapito InfiniBand
- 400 Gigabit Ethernet
Inserendo DAOS in un sistema integrato in fabbrica e supportato dal fornitore, HPE punta ad accorciare i tempi di distribuzione, ridurre la complessità dell'integrazione e aumentare le prestazioni sostenibili per l'intelligenza artificiale e l'HPC ad alta intensità di dati.
Disponibilità
- Sistemi di archiviazione di supercomputing HPE Cray K3000 con server HPE ProLiant Compute: inizio 2026
- HPE Cray Supercomputing GX440n Accelerated Blade, GX250 Compute Blade e GX350a Accelerated Blade: inizio 2027
- Software di gestione del supercalcolo HPE: inizio 2027
- HPE Slingshot 400 per sistemi basati su GX5000: inizio 2027
Il portafoglio Cray di nuova generazione di HPE è in grado di eliminare i tradizionali silos AI/HPC, offrendo una maggiore densità di prestazioni per rack e semplificando le operazioni per le istituzioni che scalano sia la simulazione che la formazione/inferenza AI su una piattaforma comune ad alta efficienza.


 Amazon