

Intel ha presentato i suoi piani per il calcolo ad alte prestazioni (HPC) in occasione dell'SC26, con Diamond Rapids, la sua architettura server Xeon di nuova generazione, al centro. Intel afferma che la piattaforma sarà scalabile fino a 256 core ad alte prestazioni con una larghezza di banda di memoria fino a 1.6 TB/s e fino a 1.28 GB di cache di ultimo livello. La presentazione è stata fatta da Jeff McVeigh, vicepresidente e direttore generale dei programmi strategici per i data center, e comprende anche le GPU Intel serie D, il software HPC, la fotonica al silicio e lo sviluppo quantistico. Intel non ha fornito una data di lancio per Diamond Rapids.
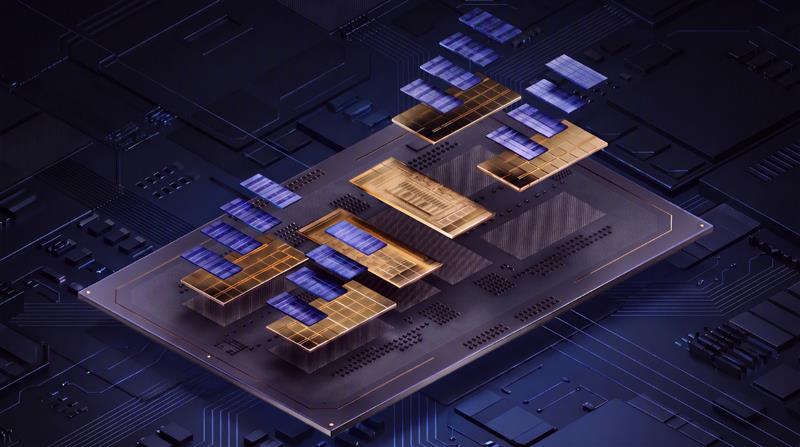
Architettura della CPU Diamond Rapids
Intel descrive Diamond Rapids , presentato a Hot Chips come un design 18A-P, come una tecnologia che combina una maggiore densità di calcolo con una maggiore larghezza di banda della memoria, cache più grandi e un'accelerazione della CPU potenziata. Le Intel Advanced Performance Extensions (APX) sono pensate per migliorare le prestazioni per thread, e quella che Intel definisce una struttura di memoria unificata permette di raggiungere la velocità di 1.6 TB/s. Intel non ha specificato il numero di canali di memoria, la velocità della memoria alla base di questo valore, né se si applichi a tutti i socket.
L'architettura supporta anche Intel AVX 10.2 e le estensioni avanzate Intel Advanced Matrix Extensions (Intel AMX). Intel definisce i processori Xeon di nuova generazione come le uniche CPU server x86 con calcolo a matrice integrato per carichi di lavoro HPC e AI. Per riferimento, i processori AMD EPYC Venice di fascia alta che abbiamo recensito dispongono di 256 core Zen 6c per socket.
McVeigh ha delineato la roadmap attorno a sistemi misti in cui le CPU orchestrano i flussi di lavoro ed eseguono librerie di comunicazione parallele, mentre gli acceleratori si occupano del lavoro di intelligenza artificiale, scrivendo che il futuro dell'HPC è "aperto, eterogeneo ed equilibrato".
GPU Intel serie D e software HPC
La serie D di GPU Intel combina l'accelerazione AI con il calcolo a doppia precisione (FP64) in una scheda PCIe raffreddata ad aria, con supporto per tipi di dati che vanno da FP4 e MXFP4 a FP64. La GPU D270 a marchio Intel offre 160 GB di LPDDR5X con una larghezza di banda di memoria di 1.5 TB/s, e le configurazioni progettate dai partner arrivano fino a 480 GB. L'argomentazione di Intel per i centri di ricerca si concentra sulla capacità di memoria, poiché mantenere set di dati di lavoro più grandi sulla scheda riduce il partizionamento e i trasferimenti dall'host all'acceleratore che rallentano i flussi di lavoro scientifici. Intel propone inoltre la scheda per agenti AI sempre attivi che generano codice e avviano processi di calcolo.
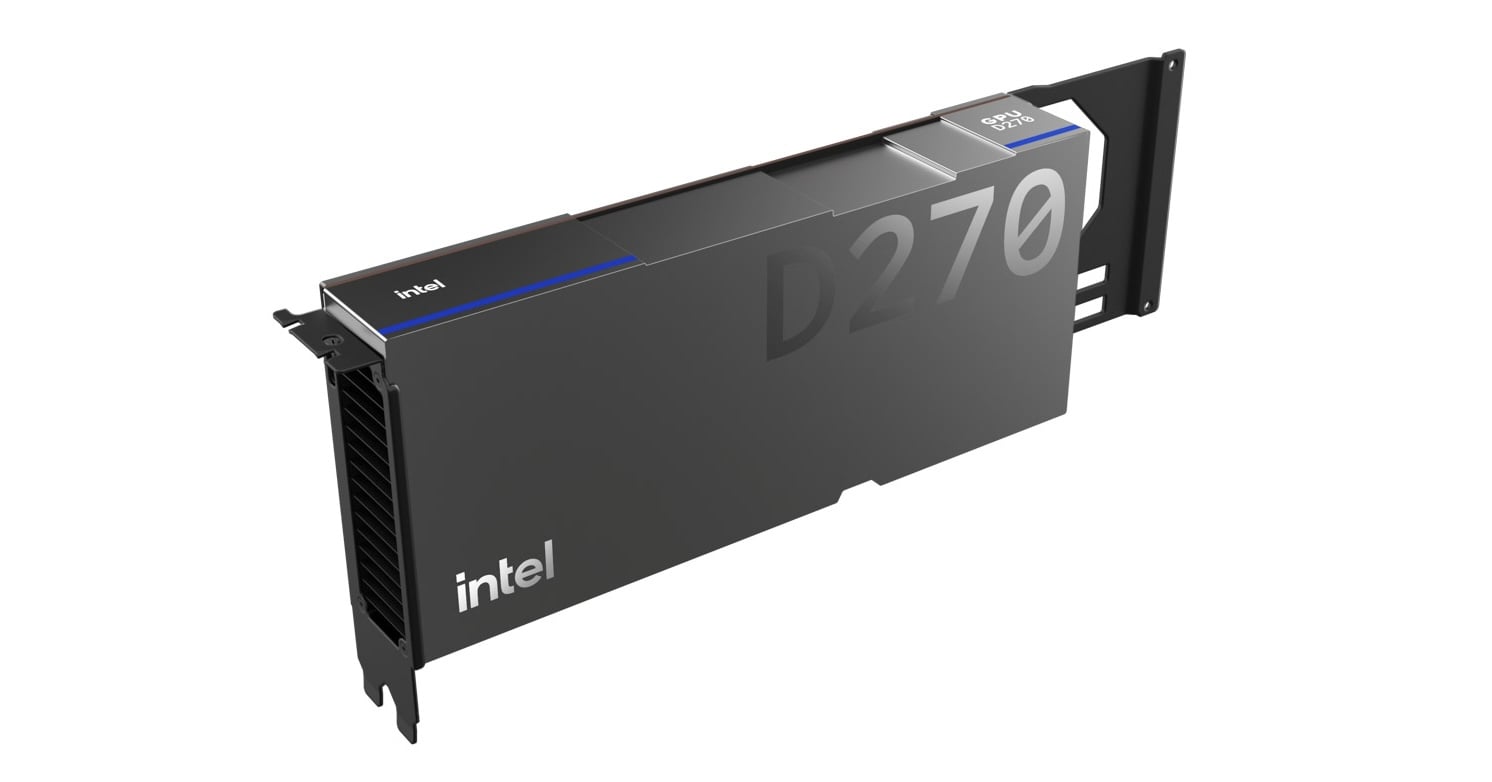
Intel sta eseguendo due demo live della GPU D270, la scheda della serie D precedentemente nota con il nome in codice Crescent Island, presso il suo stand all'SC26. La prima è una mini-applicazione di imaging sismico di Veridien, convertita da HIP e CUDA a SYCL in meno di un mese, e Intel afferma che il 90% dei suoi kernel ha funzionato correttamente senza alcuna ottimizzazione specifica Intel. La seconda suddivide una pipeline di inferenza tra schede D270 che gestiscono il pre-fill e unità SambaNova SN50 che gestiscono la decodifica, con processori Xeon 6 e Xeon 6+ a coordinare il tutto.
Intel ha anche pubblicato dei confronti con la RTX PRO 6000 Blackwell Server Edition di NVIDIA. Su carichi di lavoro finanziari FP64, dichiara un throughput fino a 5.9 volte superiore su European Monte Carlo, 5.6 volte superiore su European Black-Scholes, 4.6 volte superiore su binomial pricing e 1.92 volte superiore su American Black-Scholes, con la D270 a 350 W e la scheda NVIDIA a 600 W. Per l'inferenza, Intel dichiara una latenza inferiore fino al 29% su Drex v2.0 e un throughput di output dei token 1.12 volte superiore su Qwen3-30B-A3B a FP8.
Questi sono i risultati del fornitore su silicio di pre-produzione e non sono stati eseguiti o verificati da noi. La configurazione di test finanziario di Intel elenca otto schede NVIDIA a confronto con una singola D270 e non specifica se i risultati siano normalizzati per scheda; inoltre, le inferenze NVIDIA sono state eseguite su una macchina virtuale AWS.
Per quanto riguarda il software, Intel afferma che continuerà a investire in Intel MPI, Fortran, ottimizzazioni del compilatore e oneAPI, in modo che i codebase paralleli esistenti continuino a funzionare correttamente su sistemi misti CPU e GPU. Sta inoltre lavorando all'integrazione a monte con framework di intelligenza artificiale, runtime di inferenza e ambienti di distribuzione. L'obiettivo dichiarato è che modelli e strumenti standard funzionino su nuovo hardware, come la serie D, fin dal primo giorno di implementazione.
Connettività ottica e sviluppo quantistico
Intel ha inoltre fatto riferimento al suo lavoro nel campo della fotonica al silicio, che utilizza la luce per trasferire dati su distanze maggiori con un consumo energetico che, secondo l'azienda, è solo una frazione di quello richiesto dai collegamenti in rame. Intel non ha fornito dati né una tempistica di lancio del prodotto a supporto di tale affermazione.
In ambito quantistico, Intel ha ribadito le motivazioni a sostegno della sua proposta di acquisizione di Classiq , che combinerebbe la piattaforma automatizzata di sintesi di algoritmi quantistici di Classiq con la tecnologia di spin-qubit al silicio e la produzione di chip di Intel. Intel ha dichiarato di prevedere la conclusione dell'accordo nella prima metà del 2027, previa approvazione delle autorità di regolamentazione.


 Amazon