

Secondo un comunicato stampa dell'azienda, l'acceleratore di deep learning Intel Habana Gaudi2 e i processori scalabili Intel Xeon di quarta generazione hanno dimostrato risultati impressionanti nel benchmark MLPerf Training 4. Il benchmark, pubblicato da MLCommons, è uno standard di settore ampiamente riconosciuto per le prestazioni dell’intelligenza artificiale.
I risultati mettono in discussione la narrativa prevalente nel settore secondo cui l’intelligenza artificiale generativa e i modelli LLM (large Language Model) possono essere eseguiti solo su GPU NVIDIA. Il portafoglio di soluzioni AI di Intel offre alternative competitive per i clienti che cercano di abbandonare gli ecosistemi chiusi che limitano l’efficienza e la scalabilità.
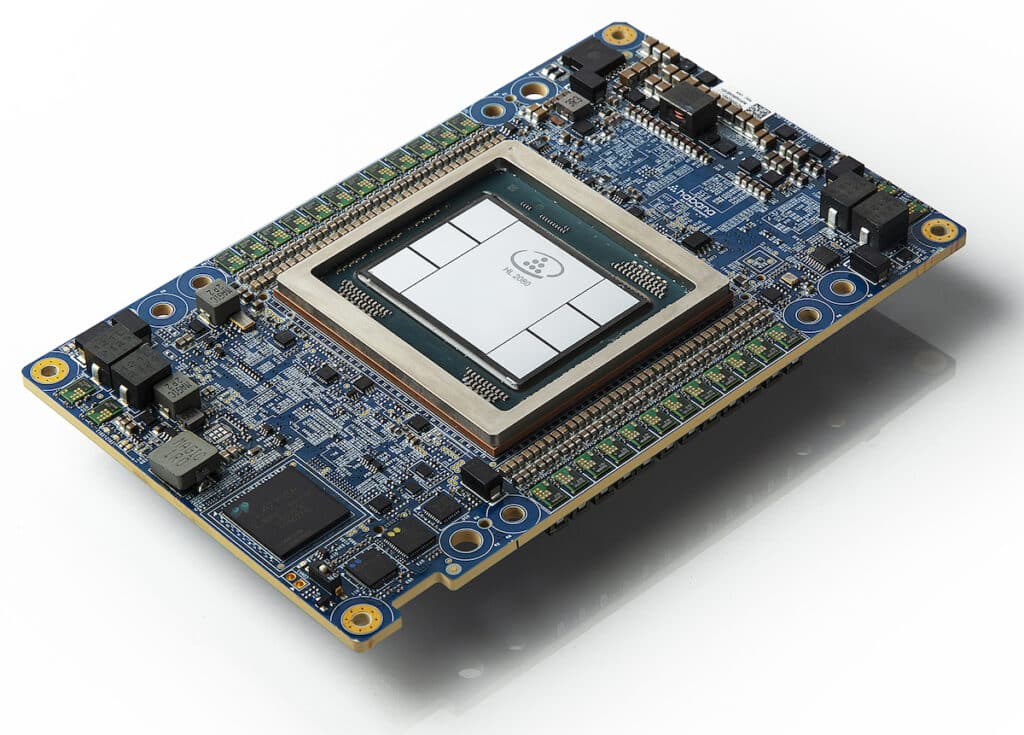
Una foto mostra la Habana Gaudi2 Mezzanine Card. Il 10 maggio 2022, Habana Labs, il team di data center di Intel focalizzato sulle tecnologie dei processori di deep learning AI, ha lanciato i suoi processori di deep learning di seconda generazione per training e inferenza: Habana Gaudi2 e Habana Greco. (Credito: Intel Corporation)
Cos'è MLPerf?
La suite di benchmark MLPerf Training 3.0 misura la velocità con cui diversi sistemi possono addestrare modelli per soddisfare una specifica metrica di qualità. I benchmark coprono vari settori, tra cui visione artificiale, elaborazione del linguaggio naturale e commercio elettronico, e utilizzano diversi set di dati e obiettivi di qualità.
Dettagli del benchmark
| Zona | Segno di riferimento | dataset | Obiettivo di qualità | Modello di implementazione di riferimento |
|---|---|---|---|---|
| Visione | Classificazione delle immagini | IMAGEnet | Classificazione 75.90%. | ResNet-50 v1.5 |
| Visione | Segmentazione delle immagini (medica) | KiTS19 | 0.908 Punteggio DICE medio | Rete U 3D |
| Visione | Rilevamento oggetti (leggero) | Apri immagini | 34.0% mappa | Rete Retina |
| Visione | Rilevamento oggetti (peso pesante) | COCO | 0.377 AP minimo scatola e 0.339 AP minimo maschera | Maschera R-CNN |
| Lingue disponibili | Il riconoscimento vocale | LibriDiscorso | Tasso di errore di parola 0.058 | RNN-T |
| Lingue disponibili | NLP | Wikipedia 2020/01/01 | Precisione maschera-LM 0.72 | BERT-grande |
| Lingue disponibili | LLM | C4 | 2.69 log perplessità | GPT3 |
| Commercio | Consigli | Criteo 4TB multi-caldo | 0.8032 AUC | DLRM-dcnv2 |
Nel campo visivo, i parametri di riferimento includono la classificazione delle immagini utilizzando il set di dati ImageNet con un obiettivo di qualità pari a una precisione di classificazione del 75.90%. Il modello di riferimento per questa attività è ResNet-50 v1.5. Altri benchmark sulla visione includono la segmentazione delle immagini utilizzando il set di dati medici KiTS19 e il rilevamento di oggetti utilizzando i set di dati Open Images e COCO.
Per le attività linguistiche, i parametri di riferimento includono il riconoscimento vocale utilizzando il set di dati LibriSpeech con un obiettivo di qualità di un tasso di errore di parola di 0.058. Il modello di riferimento per questo compito è RNN-T. Altri parametri di riferimento linguistici includono l'elaborazione del linguaggio naturale (NLP) utilizzando il set di dati Wikipedia 2020/01/01 e la formazione sul modello linguistico di grandi dimensioni (LLM) utilizzando il set di dati C4.
Nell'area commerciale, il benchmark è un'attività di raccomandazione che utilizza il set di dati multi-hot Criteo da 4TB con un obiettivo di qualità di 0.8032 AUC. Il modello di riferimento per questa attività è DLRM-dcnv2.
Metrica di misurazione
La suite di benchmark misura il tempo necessario per addestrare un modello su un set di dati specifico per raggiungere un obiettivo di qualità specificato. A causa della variabilità intrinseca nei tempi di addestramento al machine learning, i risultati finali si ottengono eseguendo il benchmark più volte, scartando i risultati più alti e quelli più bassi e quindi calcolando la media dei risultati rimanenti. Nonostante ciò, c'è ancora qualche variazione nei risultati, con i risultati dei benchmark di imaging che hanno una varianza di circa +/- 2.5% e altri benchmark che hanno una varianza di circa +/- 5%.
Divisioni di riferimento
MLPerf incoraggia l'innovazione nel software e nell'hardware consentendo ai partecipanti di reimplementare le implementazioni di riferimento. Esistono due divisioni in MLPerf: le divisioni Chiusa e Aperta. La divisione Closed è progettata per confrontare direttamente piattaforme hardware o framework software e richiede l'utilizzo dello stesso modello e ottimizzatore dell'implementazione di riferimento. D’altro canto, la divisione Open incoraggia lo sviluppo di modelli e ottimizzatori più veloci e consente a qualsiasi approccio di machine learning di raggiungere la qualità target.
Disponibilità del sistema
MLPerf classifica i risultati dei benchmark in base alla disponibilità del sistema. I sistemi classificati come "Disponibili" sono costituiti solo da componenti che possono essere acquistati o noleggiati nel cloud. Si prevede che i sistemi di “anteprima” saranno disponibili nella prossima fase di presentazione. Infine, i sistemi classificati come "Ricerca, sviluppo o interni (RDI)" contengono hardware o software sperimentale, in fase di sviluppo o per uso interno.
Intel Habana Guadi2 si presenta
In particolare, l'acceleratore di deep learning Gaudi2 ha dimostrato prestazioni elevate sul modello linguistico di grandi dimensioni GPT-3, risultando una delle sole due soluzioni a semiconduttore ad aver presentato risultati prestazionali per l'addestramento LLM di GPT-3. Il Gaudi2 offre inoltre significativi vantaggi in termini di costi per server e sistema, rappresentando un'alternativa interessante in termini di rapporto prezzo/prestazioni rispetto all'H100 di NVIDIA.
I processori Xeon di quarta generazione con motori Intel AI hanno dimostrato che i clienti possono creare un sistema AI universale per la pre-elaborazione dei dati, l'addestramento dei modelli e l'implementazione, offrendo prestazioni, efficienza, precisione e scalabilità dell'IA.
Gaudi2 ha ottenuto tempi di addestramento impressionanti su GPT-3, raggiungendo 311 minuti su 384 acceleratori e una scalabilità quasi lineare del 95% da 256 a 384 acceleratori sul modello GPT-3. Ha inoltre mostrato eccellenti risultati di addestramento nei modelli di visione artificiale e di elaborazione del linguaggio naturale. I risultati di Gaudi2 sono stati presentati "out of the box", il che significa che i clienti possono aspettarsi prestazioni comparabili implementando Gaudi2 on-premise o nel cloud.
I processori Xeon di quarta generazione, unica CPU presentata tra numerose soluzioni alternative, hanno dimostrato che i processori Intel Xeon forniscono alle aziende funzionalità pronte all'uso per implementare l'intelligenza artificiale su sistemi generici, evitando i costi e la complessità dell'introduzione di un'intelligenza artificiale dedicata. sistemi.
Cluster Habana Gaudi2 da 8 nodi
Nell'attività di elaborazione del linguaggio naturale (NLP) utilizzando il set di dati di Wikipedia e il modello BERT-large, Gaudi2 ha raggiunto un tempo di addestramento di 2.103 minuti con 64 acceleratori.
Nell'attività di segmentazione delle immagini (medica) utilizzando il set di dati KiTS19 e il modello 3D U-Net, Gaudi2 ha ottenuto un tempo di addestramento di 16.460 minuti con TensorFlow e 20.516 minuti con PyTorch, entrambi con otto acceleratori.
Nell'attività Recommendation utilizzando il set di dati Criteo da 4TB e il modello DLRM-dcnv2, Gaudi2 ha ottenuto un tempo di addestramento di 14.794 minuti con PyTorch e 14.116 minuti con TensorFlow, entrambi con otto acceleratori.
Nella divisione chiusa, gli Xeon di quarta generazione potrebbero addestrare i modelli BERT e ResNet-4 rispettivamente in meno di 50 e meno di 50 minuti. Con BERT nella divisione aperta, Xeon ha addestrato il modello in circa 90 minuti con lo scaling out fino a 30 nodi.
Questi risultati evidenziano l'eccellente efficienza di scalabilità possibile utilizzando adattatori di rete Intel Ethernet serie 800 convenienti e facilmente disponibili che utilizzano il software open source Intel Ethernet Fabric Suite basato su Intel oneAPI.
Impatto sul mercato
I risultati di Intel Habana Gaudi2 nel benchmark MLPerf Training 3.0 sottolineano l’impegno dell’azienda nel fornire soluzioni IA competitive ed efficienti per un’ampia gamma di applicazioni, dal data center all’intelligent edge. NVIDIA è chiaramente il leader del clubhouse in questo senso, e ogni fornitore di server si sta dando da fare per mostrare al settore una vasta gamma di box ricchi di GPU pronti per i carichi di lavoro AI. Ma questi dati ribadiscono che l’intelligenza artificiale non è una categoria valida per tutti e Intel sta facendo la sua parte per offrire scelte al settore. Il risultato netto è una vittoria per le organizzazioni che implementano l’intelligenza artificiale, poiché una maggiore concorrenza e scelta sono solitamente un’ottima cosa.


 Amazon