

Meta ha illustrato il rapido sviluppo del suo programma Meta Training and Inference Accelerator (MTIA). Ha descritto quattro generazioni di chip create in circa due anni. Questi chip risolvono un problema infrastrutturale chiave che Meta considera essenziale per l'IA a livello globale: adattarsi rapidamente alle architetture dei modelli in evoluzione a basso costo, senza dipendere da lunghi cicli di sviluppo del silicio. MTIA fa parte di una più ampia strategia per il silicio e Meta ha ribadito la sua collaborazione con Broadcom per lo sviluppo di questi chip.
Secondo Meta, l'azienda ha già implementato centinaia di migliaia di dispositivi MTIA in produzione e ha integrato diversi modelli interni. Il lavoro di validazione include il test di modelli linguistici di grandi dimensioni come Llama. L'azienda aveva precedentemente pubblicato i dettagli tecnici sulle prime due generazioni di MTIA, MTIA 100 e MTIA 200, in articoli di ricerca ISCA. Ora sta espandendo la piattaforma con MTIA 300, 400, 450 e 500. Questi nuovi componenti estendono la copertura dall'inferenza di ranking e raccomandazione (R&R) all'addestramento di R&R e, in misura crescente, ai carichi di lavoro GenAI generali, in particolare all'inferenza, con implementazioni in corso o pianificate per il 2026 e il 2027.
L'iterazione come principio di progettazione
Un tema chiave è la cadenza. Meta sostiene che l'evoluzione del modello sia più rapida rispetto allo sviluppo tradizionale dei chip, che può richiedere 2 anni dalla progettazione alla produzione. Meta realizza i chip MTIA sull'architettura open-source RISC-V, con la Taiwan Semiconductor Manufacturing Corporation (TSMC) che si occupa della fabbricazione. La risposta è un approccio di progettazione iterativo e modulare. Ogni generazione si basa su chiplet riutilizzabili e viene ottimizzata utilizzando le più recenti conoscenze su operatori e servizi. L'azienda ha anche sottolineato l'importanza del riutilizzo oltre il chip stesso. MTIA 400, 450 e 500 condividono lo stesso chassis, rack e infrastruttura di rete. Ciò consente aggiornamenti rapidi, riducendo i tempi che intercorrono tra la disponibilità del silicio e l'implementazione nel data center.
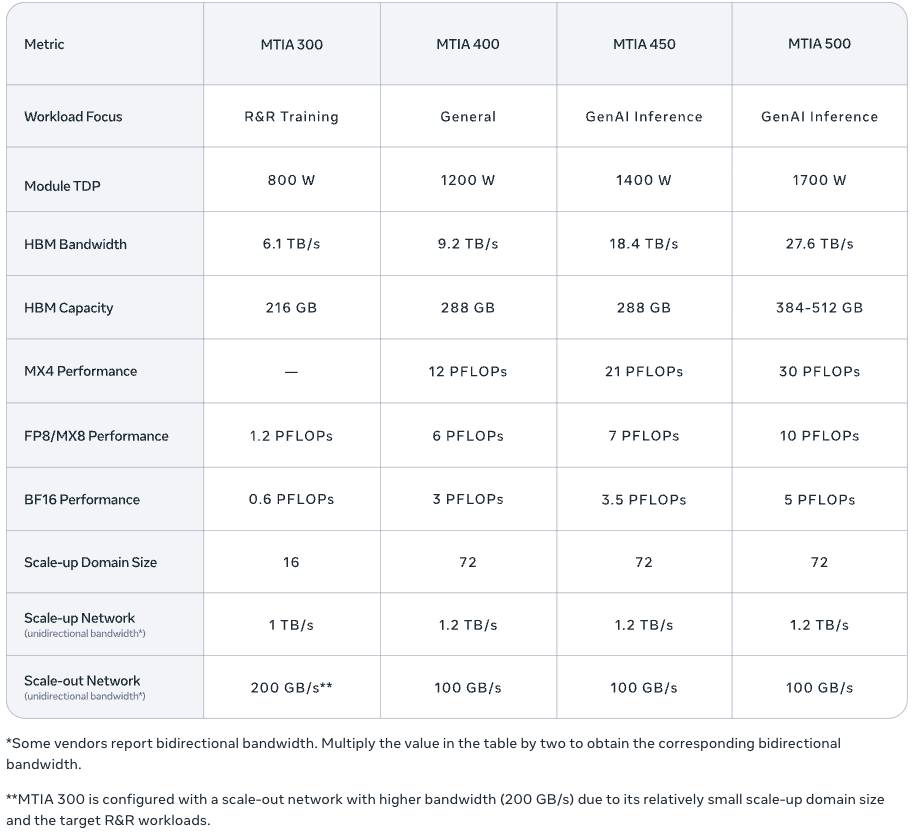
MTIA 300: Reti e collettività integrate nella Silicon Valley
MTIA 300 costituisce la base della nuova roadmap. Inizialmente è stato ottimizzato per l'addestramento R&R, il carico di lavoro principale di Meta prima dell'avvento di GenAI. L'architettura include chiplet di rete integrati, motori di messaggistica dedicati per una comunicazione collettiva efficiente e calcolo near-memory per ridurre il carico sulle operazioni collettive. Sebbene focalizzati su R&R, questi componenti di comunicazione supporteranno anche l'addestramento GenAI e l'efficienza dell'inferenza nelle versioni successive.
A livello di blocco, Meta ha descritto MTIA 300 come un design multi-chiplet caratterizzato da un chiplet di calcolo, due chiplet di rete e più stack HBM. Il blocco di calcolo è organizzato come una griglia di elementi di elaborazione (PE), con PE aggiuntivi per migliorare la resa. Ogni PE include due core vettoriali RISC-V, un motore di prodotto scalare per le operazioni matriciali, un'unità funzionale specializzata per le attivazioni e le operazioni elemento per elemento, un motore di riduzione per l'accumulazione e la comunicazione PE-to-PE e un motore DMA per il trasferimento dati locale.
MTIA 400: Una svolta verso l'IA di generazione di nuova generazione con ambiziosi obiettivi di throughput.
MTIA 400 aggiorna MTIA 300 per supportare meglio GenAI, mantenendo al contempo le capacità di R&R. Meta descrive MTIA 400 come un importante aggiornamento, riportando prestazioni FP8 FLOPS superiori del 400% e una larghezza di banda HBM superiore del 51% rispetto a MTIA 300. Dal punto di vista architetturale, MTIA 400 combina due chiplet di calcolo per aumentare la densità di calcolo e aggiunge il supporto per i formati a bassa precisione MX8 e MX4 migliorati, che Meta considera essenziali per un'inferenza GenAI efficiente.

La progettazione del sistema rimane un punto focale. Meta ha descritto un'implementazione su scala rack in cui 72 dispositivi MTIA 400 si connettono tramite un backplane commutato, formando un singolo dominio scalabile. Per implementazioni flessibili, Meta ha menzionato i rack con raffreddamento a liquido assistito ad aria (AALC) per accelerare la configurazione nei data center esistenti. Ha inoltre sottolineato che la piattaforma può supportare soluzioni di raffreddamento a liquido.
MTIA 450: L'ottimizzazione dell'inferenza GenAI inizia con la larghezza di banda della memoria
MTIA 450 è una versione migliorata di MTIA 400, focalizzata sull'inferenza e guidata dalla crescente domanda di inferenza GenAI. Meta ha identificato la larghezza di banda HBM come il principale fattore limitante le prestazioni di inferenza e l'ha raddoppiata da MTIA 400 a MTIA 450. L'azienda ha anche riportato un aumento del 75% dei FLOPS di MX4 per migliorare i calcoli con algoritmi di miscela di esperti, insieme all'accelerazione hardware per ridurre i colli di bottiglia comuni nelle operazioni di attenzione e feed-forward, in particolare nel comportamento di Softmax e FlashAttention.
Meta ha sottolineato l'importanza del suo lavoro sui tipi di dati. MTIA 450 va oltre FP8 e MX8, raggiungendo la velocità di elaborazione di MX4 a sei volte la velocità di FP16/BF16. Il chip supporta calcoli misti a bassa precisione senza richiedere conversioni software. Presenta innovazioni personalizzate per i tipi di dati, progettate per preservare la qualità del modello e al contempo aumentare i FLOPS con un impatto minimo sull'area. La distribuzione di massa di MTIA 450 è prevista per l'inizio del 2027.
MTIA 500: maggiore larghezza di banda, maggiore capacità, ulteriore scomposizione dei chiplet
MTIA 500 continua a concentrarsi sull'inferenza con ulteriori miglioramenti in termini di memoria e capacità di calcolo. Meta ha affermato che MTIA 500 aumenta la larghezza di banda HBM del 50% rispetto a MTIA 450, incrementa la capacità HBM fino all'80% e aumenta le prestazioni in FLOPS di MX4 del 43%. Il design del chiplet si evolve con una configurazione 2×2 di chiplet di calcolo più piccoli, circondati da più stack HBM e due chiplet di rete. Include anche un chiplet System-on-Chip (SoC) per la connettività PCIe alla CPU host e schede di rete scalabili. Meta ha menzionato un'ulteriore accelerazione hardware e modifiche ai tipi di dati per risolvere i colli di bottiglia nell'inferenza.
La diffusione su larga scala del sistema MTIA 500 è prevista per il 2027.
Adozione facile
Meta sta allineando MTIA con l'obiettivo di una facile adozione, privilegiando strumenti standard del settore piuttosto che un framework specializzato. L'azienda ha descritto MTIA come nativo di PyTorch, in grado di funzionare senza problemi con i processi di compilazione di PyTorch 2.x e di supportare sia l'esecuzione eager che quella a grafo. In modalità grafo, gli sviluppatori possono utilizzare torch.compile e torch.export per ottimizzare i grafi senza dover riscrivere modelli specifici di MTIA, consentendo la distribuzione parallela su GPU e MTIA.
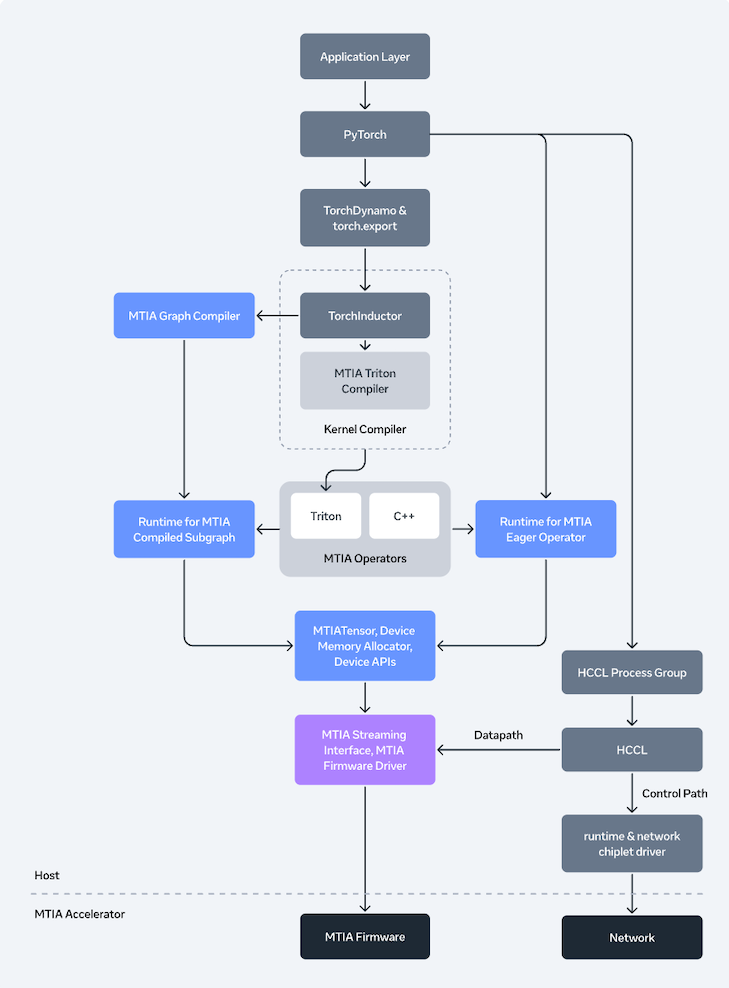
Dietro le quinte, Meta ha descritto in dettaglio uno stack di compilatori MTIA basato su Torch FX IR e TorchInductor. Gli strati inferiori utilizzano Triton, MLIR e LLVM, insieme a ottimizzazioni specifiche per MTIA, tra cui miglioramenti alla fusione del kernel ed estensioni per le parti critiche per le prestazioni. L'ottimizzazione automatica è una caratteristica chiave per la selezione tra diverse strategie di compilazione.
Per l'esecuzione distribuita, Meta ha introdotto la sua Hoot Collective Communications Library (HCCL). Questa libreria è simile agli stack collettivi GPU, ma è ottimizzata per i chiplet di rete e i motori di messaggistica integrati di MTIA. Utilizza il calcolo in prossimità della memoria per accelerare le operazioni di riduzione. Meta supporta anche la fusione tra calcolo e calcolo collettivo per ridurre la latenza e dispone di uno stack di trasporto progettato per gestire il percorso dei dati e ridurre l'overhead dell'host.
In fase di esecuzione, Meta ha dimostrato un runtime di dispositivo che gestisce la memoria, la pianificazione e il coordinamento tra le modalità eager e graph. Ha inoltre introdotto un driver in spazio utente basato su Rust, abbandonando il tradizionale driver Linux integrato nel kernel. Il firmware è scritto in Rust bare-metal, con particolare attenzione alla bassa latenza e alla sicurezza.
Per quanto riguarda il servizio GenAI, Meta ha descritto la sua integrazione vLLM tramite un sistema di plugin. Questo sostituisce operatori chiave come FlashAttention e LayerNorm fuso con kernel specifici per MTIA. Abilita inoltre la modalità a grafo tramite un backend torch.compile personalizzato. Meta ha anche menzionato strumenti per la gestione di implementazioni MTIA su larga scala, tra cui monitoraggio, profilazione, debug e osservabilità su host e dispositivi.
Qual'è il prossimo
La roadmap aggiornata di Meta per MTIA pone l'accento sugli aspetti economici dell'inferenza GenAI, evidenziando la larghezza di banda HBM e i formati a bassa precisione come fattori chiave. Se Meta rispetterà le tempistiche di implementazione, MTIA 450 e 500 serviranno come primi test su larga scala per determinare se una strategia di accelerazione incentrata sull'inferenza, basata su rapide iterazioni di chiplet e software standardizzato, possa mantenere un vantaggio rispetto alle piattaforme GPU tradizionali per l'erogazione di servizi GenAI.


 Amazon