

L'LPU, o Language Processing Unit, è un acceleratore di inferenza AI personalizzato, progettato e realizzato da Groq, Inc. Fondata nel 2016 da Jonathan Ross, ex ingegnere di Google e considerato uno degli inventori originali della TPU, Groq ha dedicato anni allo sviluppo di un'architettura di processore deterministica e definita via software, partendo da zero. A differenza delle GPU, che si basano sulla pianificazione dinamica dell'hardware e su gerarchie di cache multilivello, l'LPU adotta un approccio radicalmente diverso: elimina tutti i componenti hardware reattivi e colloca l'intero piano di controllo nel compilatore, consentendo un'esecuzione completamente prevedibile fino al ciclo di clock.
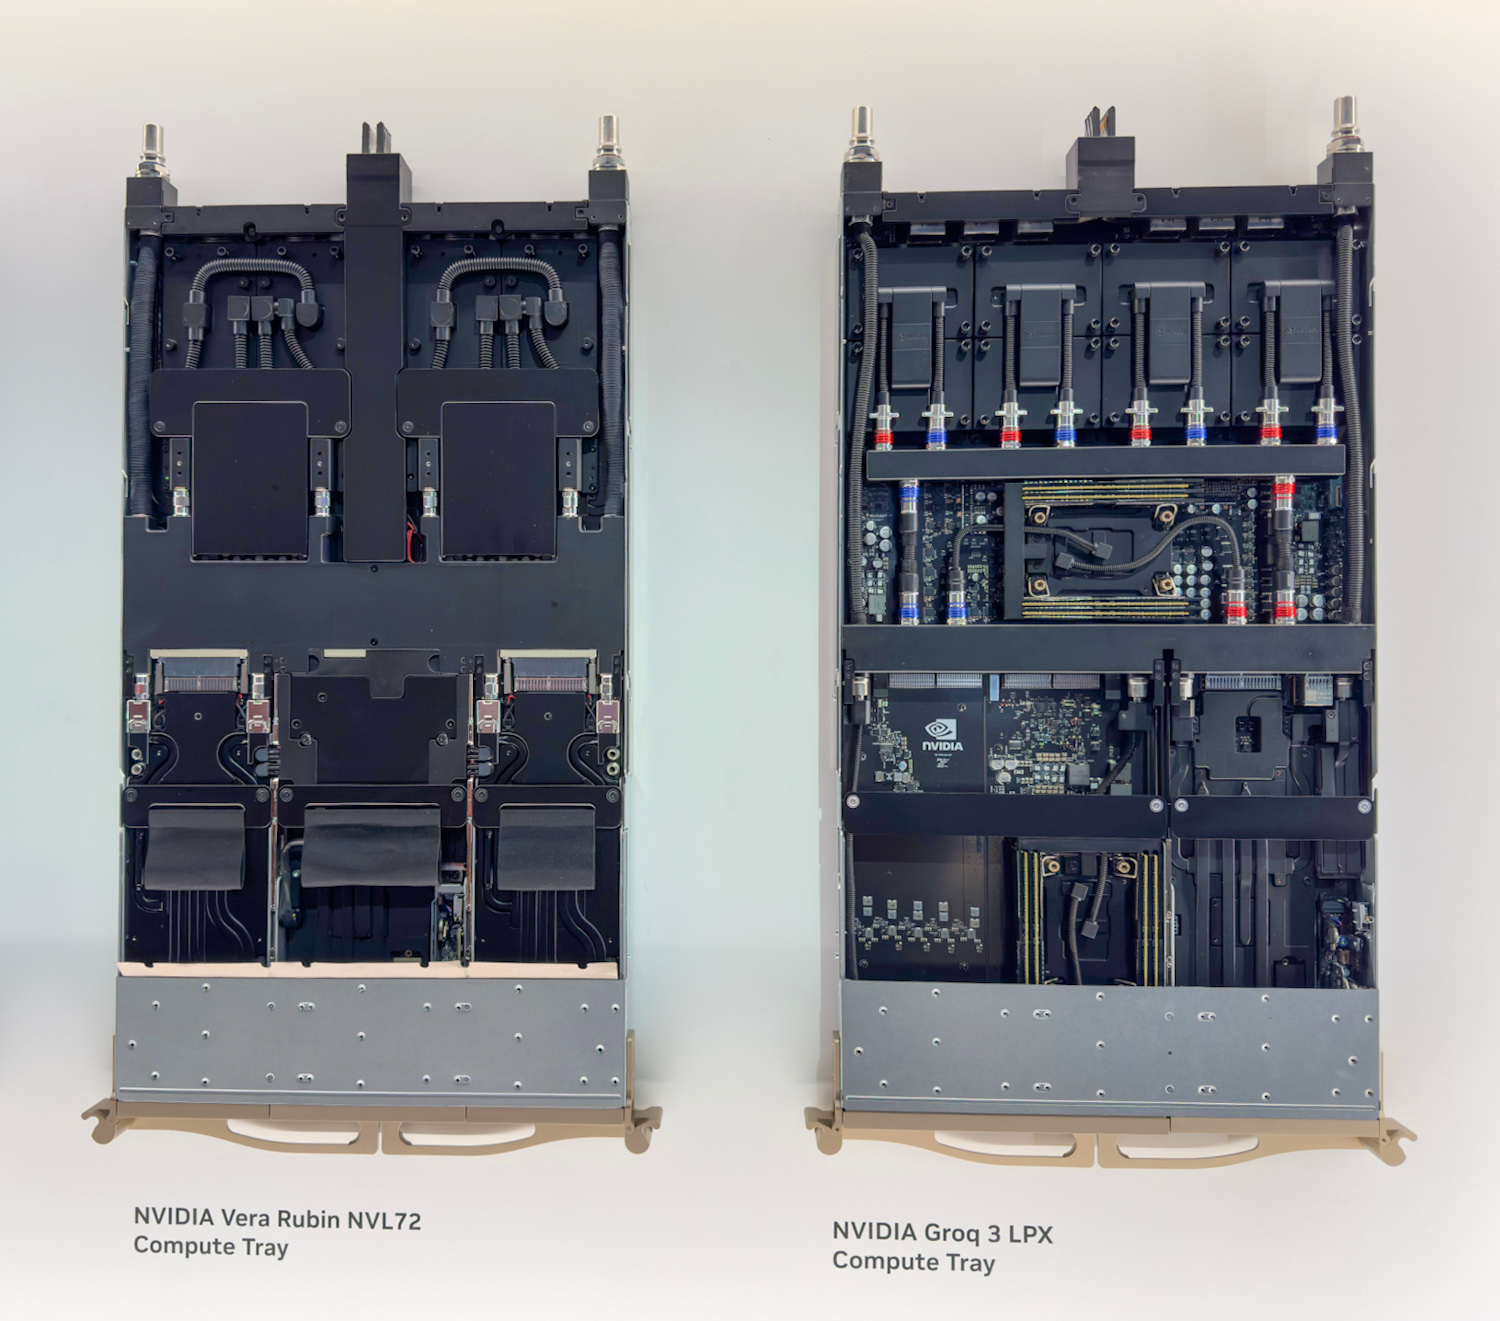
Nel dicembre dello scorso anno, NVIDIA ha acquisito Groq, portando l'architettura LPU sotto l'egida di NVIDIA. L'acquisizione è stata accolta con grande entusiasmo nel settore e ha immediatamente scatenato speculazioni su come NVIDIA avrebbe integrato la tecnologia di Groq nel suo ecosistema per data center. A queste domande è stata finalmente data risposta al GTC 2026, dove NVIDIA ha presentato il Groq 3 LPX, il settimo chip della piattaforma Vera Rubin, che combina 256 acceleratori LPU in un sistema rack-scale insieme al Vera Rubin NVL72.
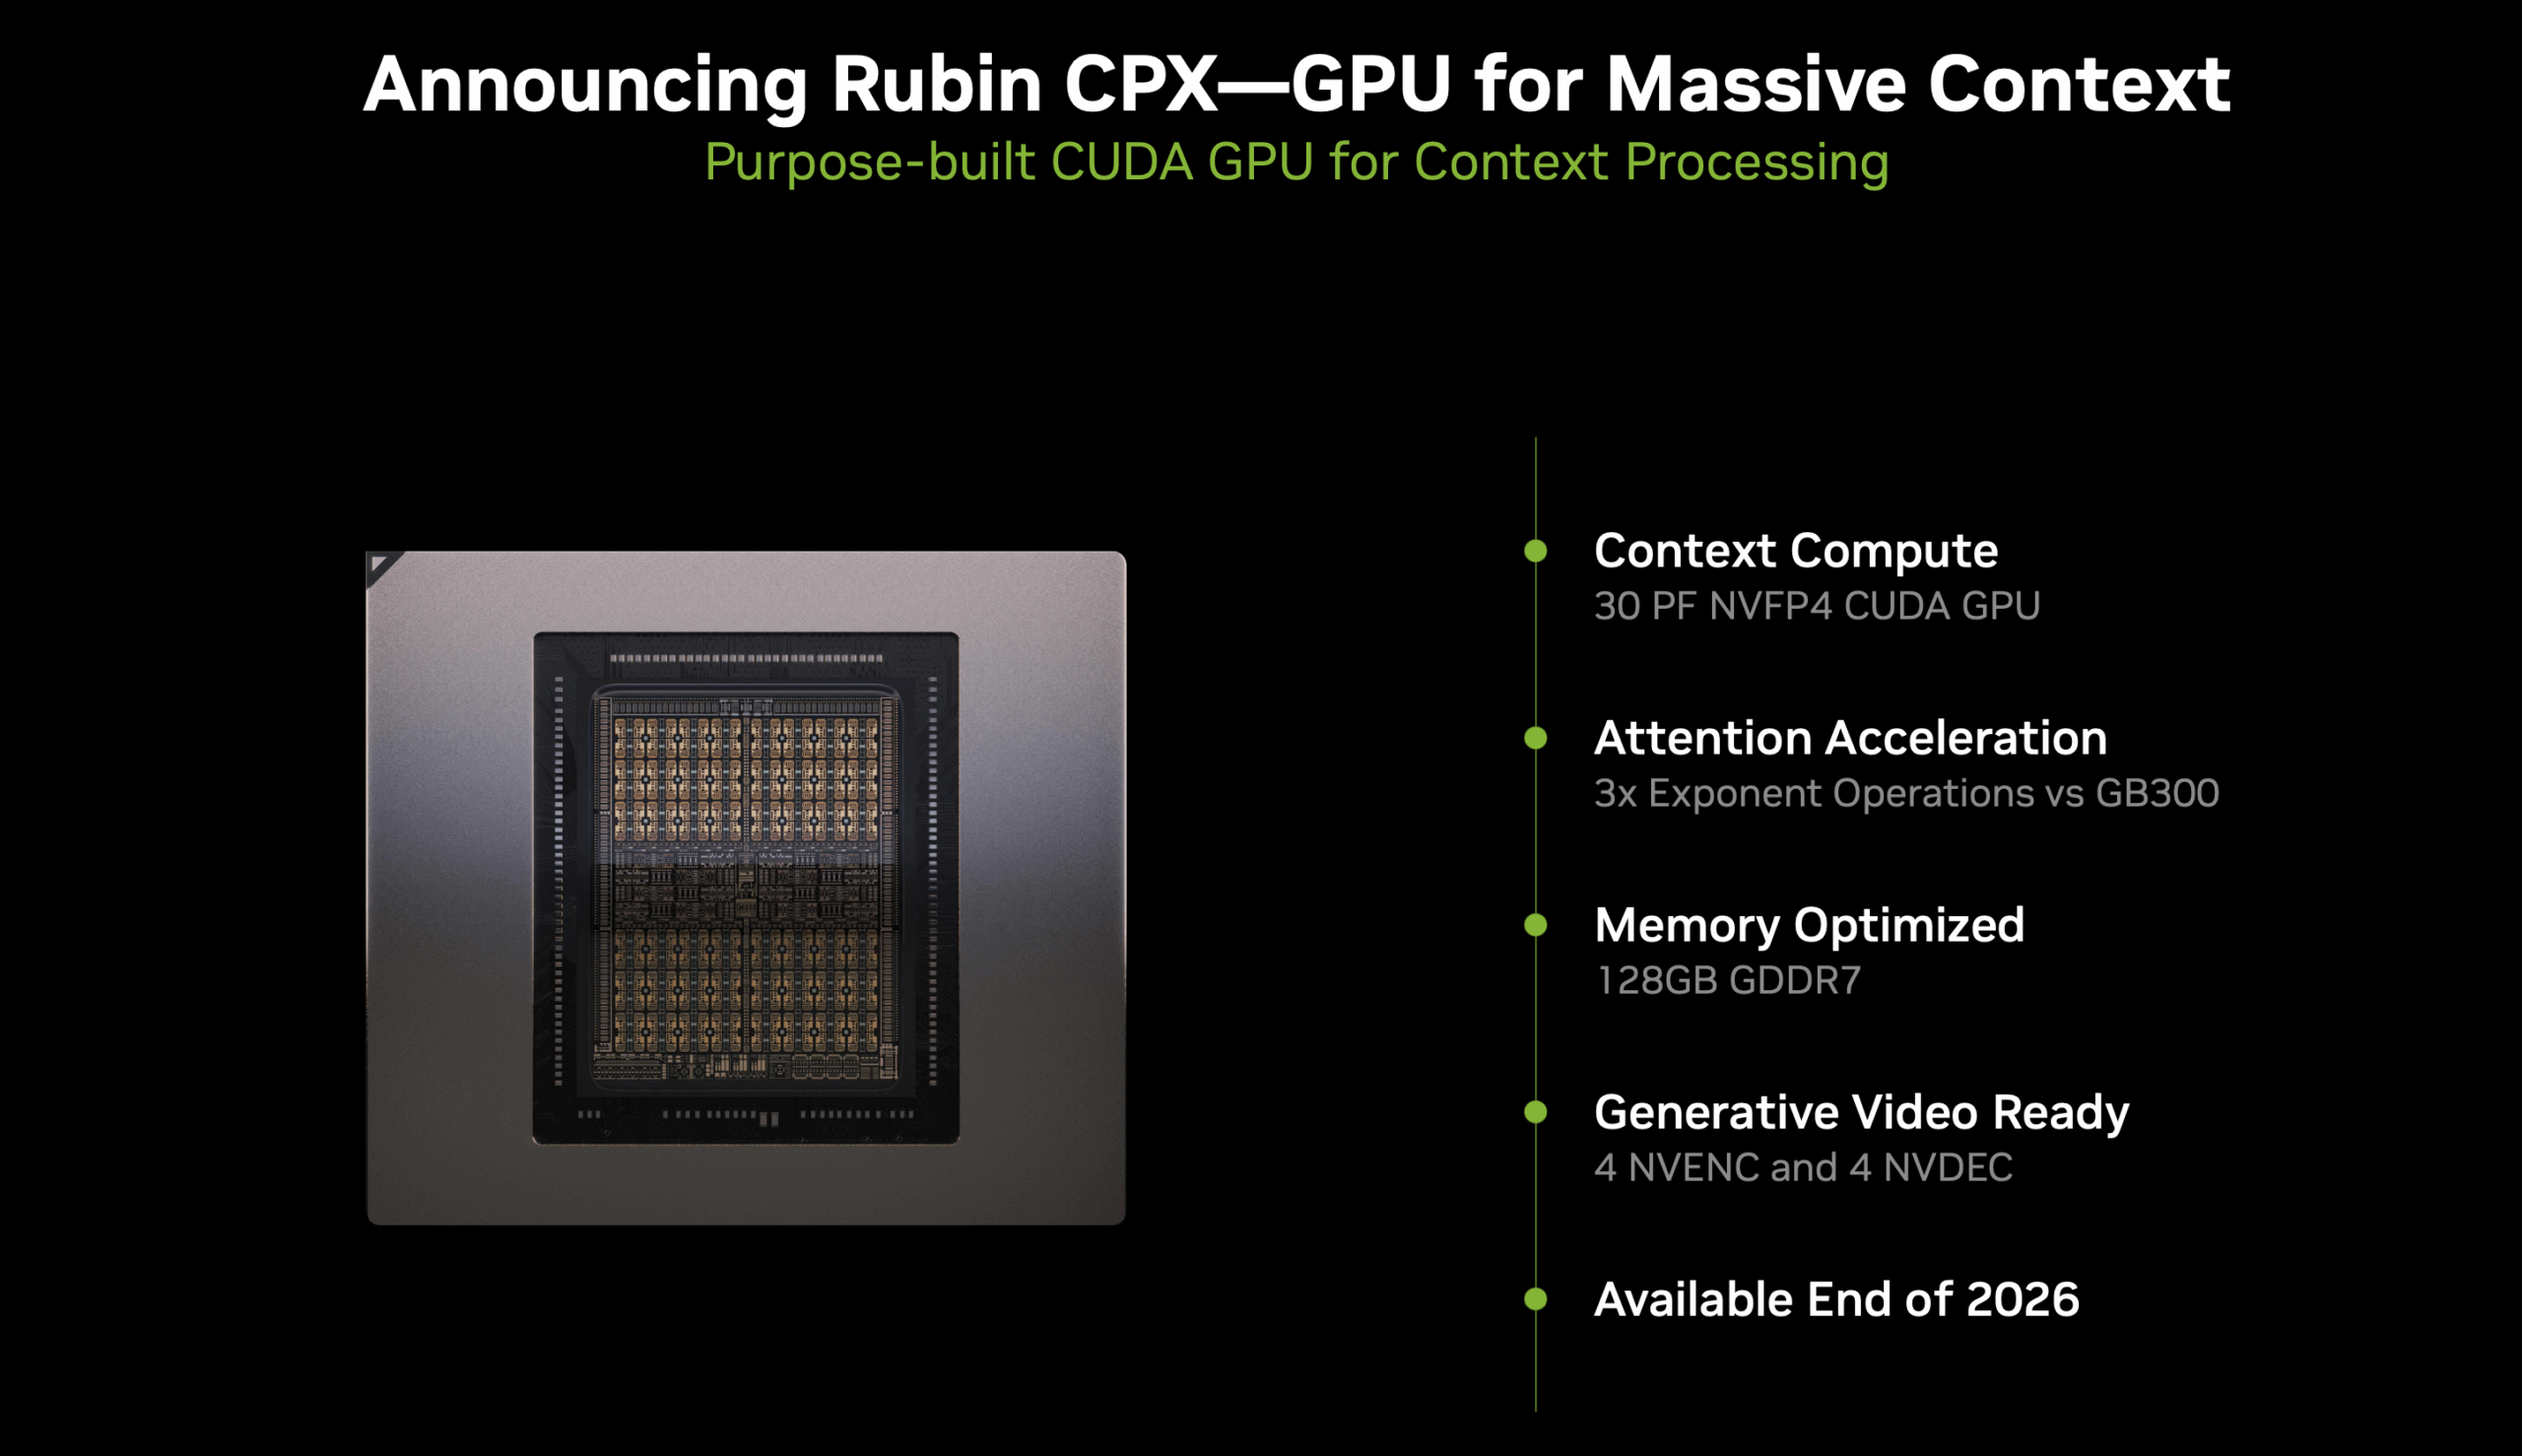
Che fine ha fatto CPX?
Lo scorso anno, all'AI Infra Summit, NVIDIA ha anche annunciato il rack CPX in un paio di configurazioni progettate per accelerare le query di inferenza a contesto lungo. Dopo la nostra prima copertura di quell'annuncio, ci siamo posti diverse domande sulla funzione effettiva del CPX. A prima vista, sebbene fosse un concetto architetturale interessante, il CPX non sembrava offrire nulla di sostanziale in più rispetto alla GPU Rubin stessa, a parte forse un'accelerazione aggiuntiva per le operazioni di attenzione. Poi è arrivata l'acquisizione di Groq, che ha scatenato speculazioni su come NVIDIA avrebbe integrato la tecnologia LPU di Groq nella più ampia piattaforma Vera Rubin.
Ebbene, NVIDIA ha fatto chiarezza al GTC 2026 con l'annuncio di LPX. Da quanto presentato, sembra che il concetto di rack CPX si sia evoluto nel Groq 3 LPX Rack, con l'attenzione all'elaborazione del contesto del CPX originale che ha lasciato il posto a un'architettura di decodifica e accelerazione fondamentalmente diversa, basata sul silicio di Groq. L'LPX Rack è completamente raffreddato a liquido, costruito sull'infrastruttura MGX e sarà disponibile nella seconda metà del 2026, in concomitanza con il lancio più ampio di Vera Rubin. NVIDIA afferma che con questa nuova aggiunta si otterrà un throughput di inferenza fino a 35 volte superiore per megawatt e fino a 10 volte maggiori opportunità di guadagno per modelli con trilioni di parametri.
Ma, cosa ancora più importante, NVIDIA ha confermato che l'LPU funziona come un acceleratore all'interno dello stack CUDA esistente in esecuzione sulle piattaforme Vera e NVL72, con il calcolo scaricato in modo trasparente per ogni singolo token. Durante la sessione di domande e risposte del GTC, NVIDIA ha descritto l'LPU come un "potenziatore di decodifica dei modelli" e ha spiegato che collaborerà a stretto contatto con laboratori di intelligenza artificiale e sviluppatori di modelli all'avanguardia che implementano modelli con trilioni di parametri per abilitare la prossima generazione di servizi di modelli premium.
Risolta la questione relativa al CPX, la domanda successiva è: cos'è esattamente questa LPU attorno alla quale NVIDIA sta costruendo un intero sistema rack?
Cos'è una LPU?
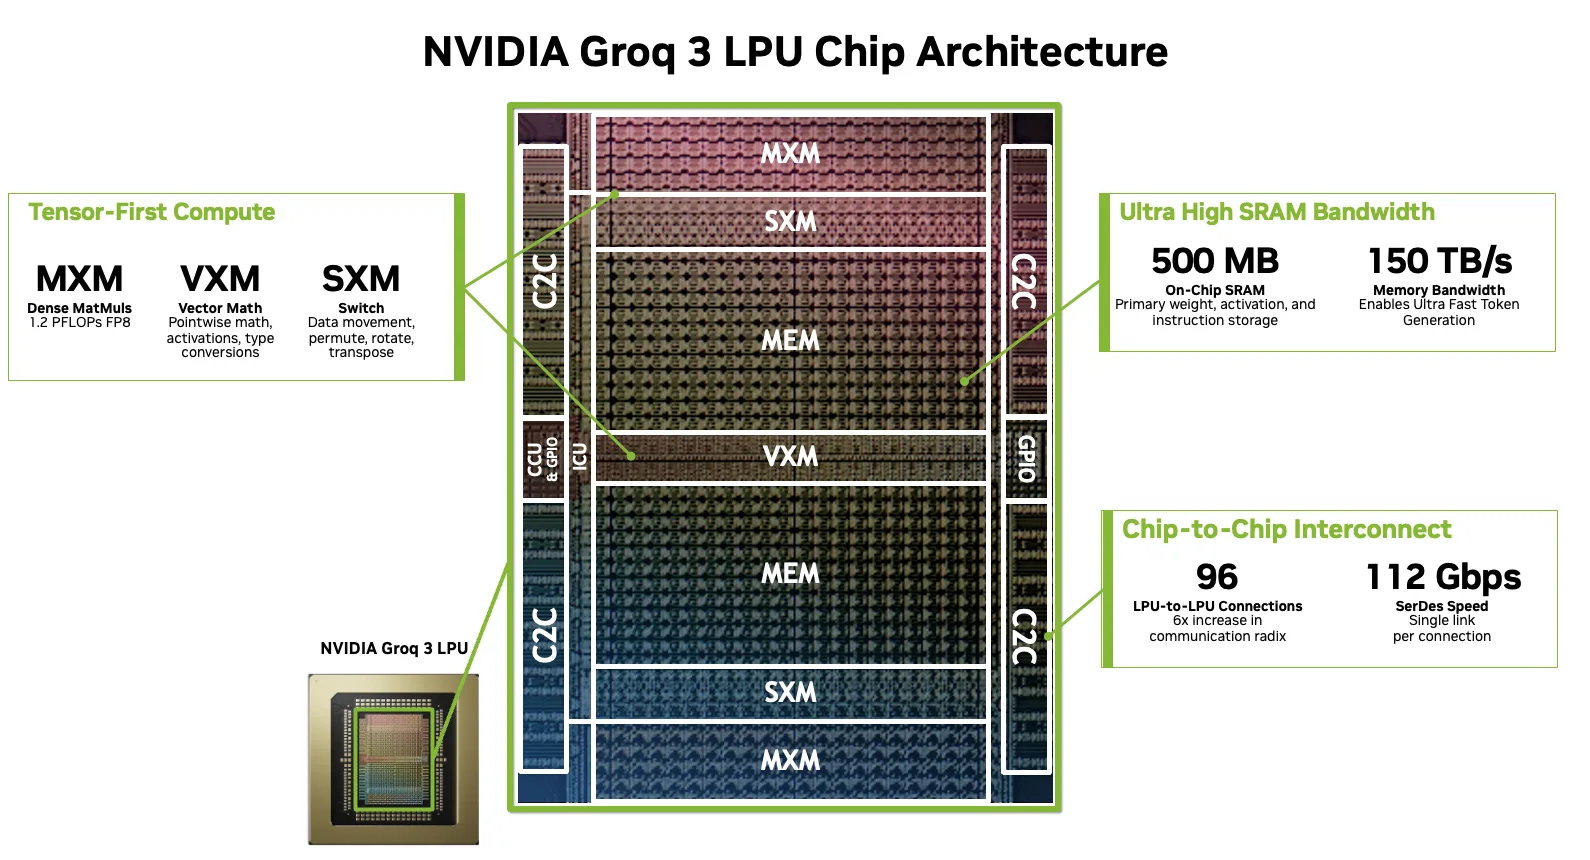
In sostanza, l'LPU è un processore vettoriale di grandi dimensioni. L'unità fondamentale sia per il calcolo che per la comunicazione è un vettore di 320 elementi, costituito da 320 byte a INT8 e 640 byte a FP16. Ogni operazione sul chip, che si tratti di aritmetica, accesso alla memoria, riorganizzazione dei dati o trasferimento tra chip, opera su questi vettori a dimensione fissa.
Fonte: Nvidia
L'architettura è costruita a partire da un singolo elemento fondamentale: un'unità funzionale SIMD abbinata a un'unità di gestione delle istruzioni leggera. Groq la considera come una classe base che viene specializzata in quattro tipi distinti, ciascuno ottimizzato per una specifica categoria di operazioni:
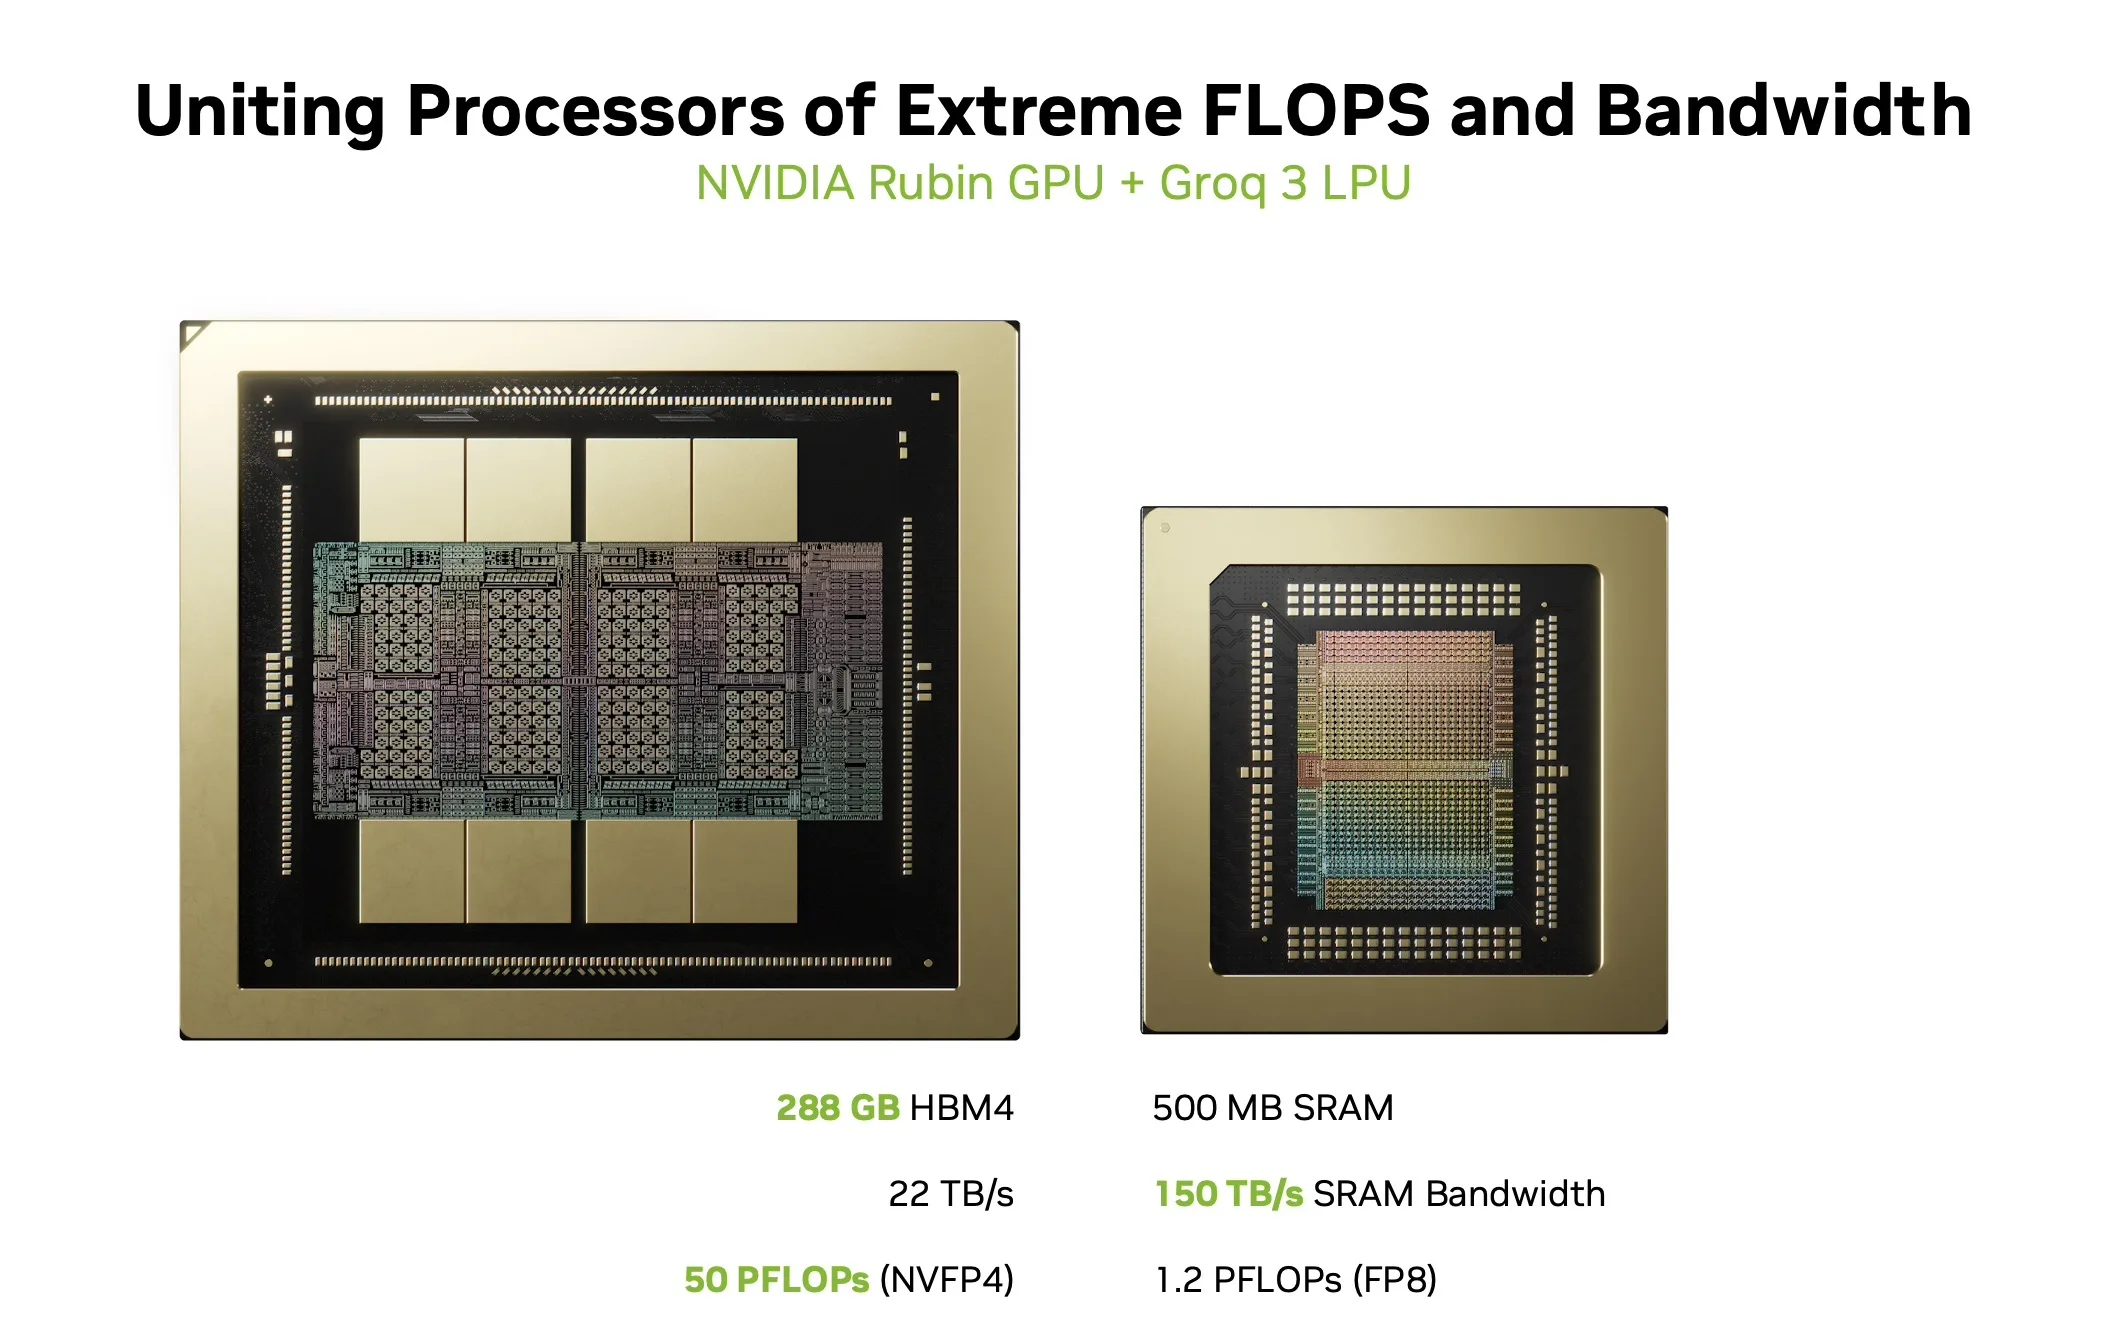
Moduli di esecuzione matriciale (MXM): il principale motore di calcolo, che fornisce capacità di moltiplicazione-accumulazione dense per operazioni matrice-vettore e matrice-matrice. Ciascuno degli 8 chip Groq 3 LP30 nel rack LPX di NVIDIA offre 1.2 PFLOPS di calcolo FP8 per chip, per un totale di 9.6 PLOPS di calcolo FP8 per vassoio LPX.
Moduli di esecuzione vettoriale (VXM): gestiscono operazioni aritmetiche puntuali, operazioni logiche, conversioni di tipo e funzioni di attivazione. Il VXM contiene un array di ALU che il compilatore concatena automaticamente per formare operazioni composte (ad esempio, riduzione seguita da somma di bias, seguita da attivazione, seguita da cast di tipo) in un singolo passaggio.
Moduli di esecuzione dello switch (SXM): Eseguono lo spostamento strutturato dei dati, inclusi permutazione, rotazione, distribuzione e trasposizione di vettori.
Unità di memoria (MEM): un'architettura di memoria piatta, incentrata sulla SRAM, senza cache, senza gerarchia e senza il concetto di cache miss. Il Groq 3 LP30 offre 500 MB di SRAM on-chip con una larghezza di banda di 150 TB/s. Il compilatore indirizza direttamente le posizioni fisiche dei banchi di memoria, conoscendo la posizione esatta di tutti i dati durante l'esecuzione del programma.
Sul chip sono stampate più copie di ciascun tipo di unità funzionale lungo la dimensione orizzontale. Le istruzioni fluiscono dall'alto e dal basso verso il centro, mentre i flussi di dati scorrono da est a ovest, intersecando le unità funzionali per eseguire le operazioni.
L'interconnessione 1D, i registri di flusso e il determinismo
Registri di flusso e interconnessione 1D
La comunicazione tra le unità funzionali sulla LPU avviene tramite registri di flusso, un'interconnessione unidimensionale volutamente semplice. Esistono due percorsi di comunicazione, uno che scorre verso est e uno verso ovest, con ciascun registro di flusso che rappresenta un singolo salto. I dati si spostano esattamente a un salto per ciclo di clock, il che significa che il compilatore può calcolare il tempo di percorrenza tra due unità funzionali qualsiasi eseguendo una semplice addizione o sottrazione in base alla loro posizione fisica sul layout del chip.
Nell'interconnessione non ci sono code né meccanismi di contesa. Questo semplifica il problema di pianificazione, trasformandolo da un complesso problema di bin-packing bidimensionale a un problema unidimensionale molto più gestibile. Igor Arsovski, Chief Architect di Groq, lo descrive al meglio: il compilatore sa esattamente dove si troverà un dato tra 10 cicli, perché sarà esattamente a 10 hop di distanza. Non c'è ambiguità, non c'è speculazione e nessun hardware prende decisioni di routing indipendenti.
Determinismo
La caratteristica distintiva delle LPU è il determinismo. A differenza dei processori convenzionali, in cui la pianificazione dinamica, il comportamento della cache e la contesa per l'accesso alla memoria introducono variazioni a tempo di esecuzione, le LPU operano con varianza zero e ogni unità funzionale funziona in modo sincronizzato.
Questo determinismo si ottiene eliminando funzionalità come i blocchi hardware e spostando tutto il processo decisionale nel compilatore; l'hardware si limita a eseguire la pianificazione risultante. Altri vantaggi di questo approccio sono che tutto opera con la stessa identica latenza e persino il consumo energetico è prevedibile in ogni istante.
Il determinismo si estende anche al dominio numerico attraverso quella che Groq chiama tecnologia TruePoint, dove l'ordine garantito delle operazioni dell'architettura consente una precisione di livello FP32 a partire da input FP16 tramite un prodotto scalare fuso a 320 elementi con un singolo passaggio di arrotondamento. I dettagli sul perché il determinismo numerico sia importante per l'inferenza LLM e sul perché l'hardware non deterministico produca output leggermente diversi tra le varie esecuzioni sono esplorati in profondità nel white paper di Thinking Lab "Defeating Nondeterminism in LLM Inference" . Questo non è l'oggetto principale di questo articolo, ma i lettori interessati alle implicazioni per la precisione numerica possono trovare l'analisi pertinente nella documentazione tecnica TruePoint di Groq, il cui link si trova in fondo al testo.
Come si connettono le LPU: RealScale, la catena di montaggio e la topologia del rack
La catena di montaggio: come si muovono i dati
Al livello più semplice, il trasferimento dei dati tra le LPU funziona come una catena di montaggio. Quando un modello viene compilato per il sistema, il compilatore lo suddivide in fasi e mappa spazialmente ciascuna fase su un gruppo di chip LPU. Ogni gruppo memorizza i parametri di peso necessari nella SRAM locale on-chip. Durante l'inferenza, gli unici dati che viaggiano tra i gruppi di chip sono i risultati intermedi dell'attivazione provenienti dalla fase precedente. I dati fluiscono da un chip all'altro come un prodotto che si muove lungo un nastro trasportatore, con ogni stazione che esegue il calcolo assegnato e passa il risultato alla successiva. Questo è fondamentalmente diverso dalle GPU, dove ogni fase di calcolo richiede il recupero dell'intero set di pesi dalla memoria HBM off-chip e la scrittura dei risultati. Sulle LPU, i pesi sono già residenti nella SRAM di ciascuna stazione; solo i tensori di attivazione vengono trasferiti.
Nota sui link C2C: RealScale, non NVIDIA C2C.
Prima di addentrarci nei dettagli della topologia, è importante chiarire una potenziale fonte di confusione. I collegamenti chip-to-chip (C2C) utilizzati in tutto il sistema LPX sono le interconnessioni RealScale C2C di Groq. Queste non sono le stesse della tecnologia C2C di NVIDIA, utilizzata in altre parti dell'ecosistema NVIDIA. Le due tecnologie sono architettonicamente distinte:
- NVIDIA C2C è un'interconnessione a coerenza di cache progettata per collegare due diversi tipi di chip all'interno di un modulo strettamente integrato, come ad esempio un collegamento CPU-GPU. Utilizza un protocollo coerente con SerDes ad alta velocità ed è progettato per la comunicazione eterogenea tra chip all'interno di un singolo package o modulo.
- Groq RealScale C2C è un'interconnessione punto-punto deterministica e pianificata via software. I collegamenti di rete sono esplicitamente controllati dal compilatore e pianificati come unità funzionali di prima classe, proprio come le unità di calcolo MXM o VXM. Non vi è arbitraggio hardware né routing adattivo e i pacchetti non contengono intestazioni di origine o destinazione. I collegamenti sono allineati in fase e si comportano come cavi ad alta larghezza di banda e latenza fissa tra i chip. Un protocollo plesiocrono tiene conto in modo deterministico della deriva naturale dell'orologio tra i chip, esponendo un singolo dominio temporale comune al compilatore sull'intera rete.
Ogni connessione C2C nel rack LPX, sia all'interno di un singolo vassoio, sia tra vassoi tramite la dorsale, sia tra rack tramite le porte del pannello frontale, utilizza RealScale. Si tratta della stessa tecnologia di interconnessione fondamentale che Groq utilizza fin dal primo GroqNode, con una velocità di collegamento aumentata (da 30 Gbps a 112 Gbps per corsia) ma con un'architettura invariata.
Nota: la sezione successiva, che illustra la connettività, si basa sulla nostra comprensione dell'architettura, ricavata dalla documentazione di Groq (collegata in fondo), dal post del blog di NVIDIA e dalla spiegazione del rack fornitaci presso lo stand del GTC.
- I collegamenti C2C utilizzati dalle unità rack LPX sono basati sulla tecnologia di Groq e non sono gli stessi collegamenti C2C utilizzati in altri sistemi rack di NVIDIA
- I 4 collegamenti C2C presenti nella parte anteriore di ciascuna unità rack LPX vengono utilizzati per connettersi alle unità rack adiacenti allo stesso livello.
- All'interno di un rack, la comunicazione tra le LPU è completa e continua.
- Il processore nel rack LPX è x86
Connettività interna al vassoio
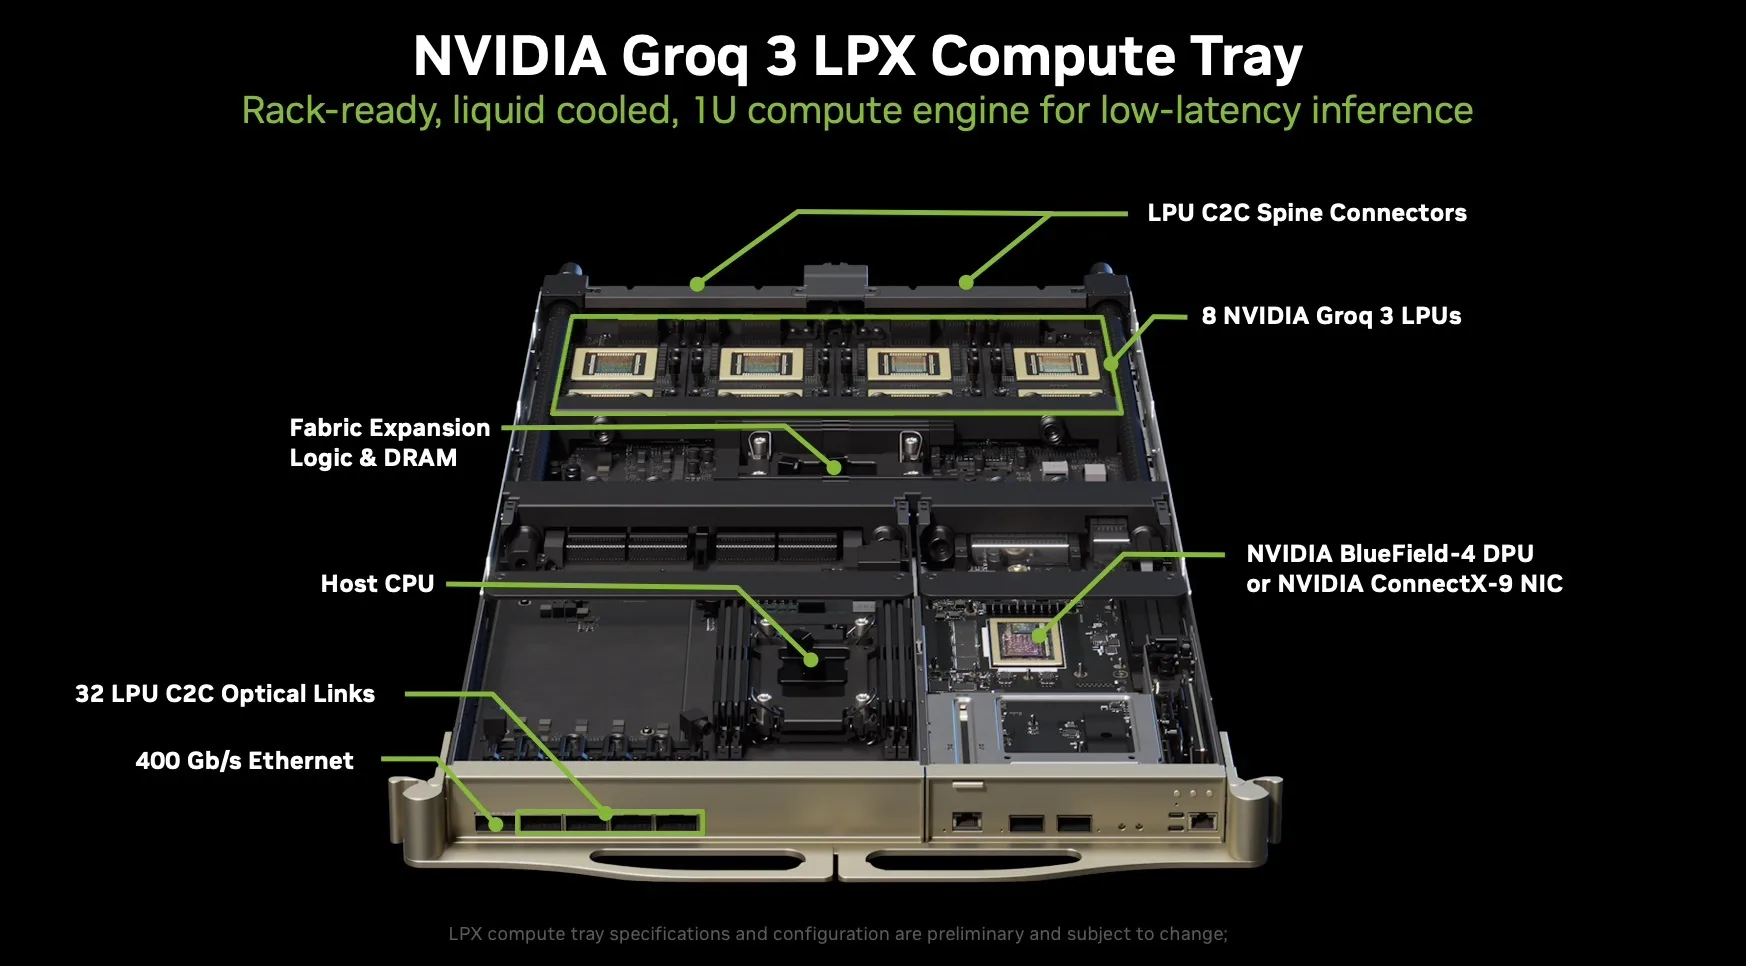
L'elemento costitutivo fondamentale della topologia di rete di Groq non è cambiato dal GroqNode originale all'NVIDIA Groq 3 LPX. Ogni vassoio di calcolo 1U contiene esattamente otto chip LP30, densamente interconnessi in un grafo completo (da tutti a tutti), in cui ogni chip può comunicare direttamente con ogni altro chip alla stessa velocità.
Fonte: Nvidia
Ogni chip LP30 ha 96 collegamenti C2C, ognuno con una velocità di 112 Gbps, che forniscono una larghezza di banda bidirezionale di 2.5 TB/s per chip. In un grafo completo di 8 chip, ogni chip ha 7 vicini. Il numero di collegamenti unici chip-to-chip all'interno di un vassoio è C(8,2) = 28. Una parte dei 96 collegamenti di ciascun chip è dedicata a queste connessioni intra-vassoio "all-to-all", mentre i collegamenti rimanenti sono instradati al backplane (per la dorsale del rack) e al pannello frontale (per le connessioni inter-rack). Le specifiche pubblicate da NVIDIA indicano una larghezza di banda totale di scalabilità di 20 TB/s per vassoio, che rappresenta la larghezza di banda combinata intra-vassoio e dorsale. Possiamo verificarlo: ogni vassoio ha 8 chip × 96 collegamenti = 768 collegamenti in totale. Sottraendo le 32 linee inter-rack del pannello frontale, rimangono 736 collegamenti per la scalabilità. A 112 Gbps per collegamento, si ottengono 736 × 112 Gbps = 82,432 Gbps, ovvero circa 10.3 TB/s per direzione, che corrispondono a circa 20.6 TB/s bidirezionali. Questo dato è in linea con i 20 TB/s per vassoio dichiarati da NVIDIA.
Questo gruppo all-to-all a 8 chip forma il "gruppo locale" di una topologia di rete Dragonfly. Il GroqChip 1 originale aveva 11 collegamenti C2C per scheda, ciascuno a 30 Gbps per corsia (quattro corsie per collegamento), per un totale di 330 GB/s per scheda. I 96 collegamenti a 112 Gbps del Groq 3 LP30 rappresentano un enorme salto generazionale nella larghezza di banda I/O per chip, pur mantenendo la stessa struttura topologica.
Connettività intra-rack
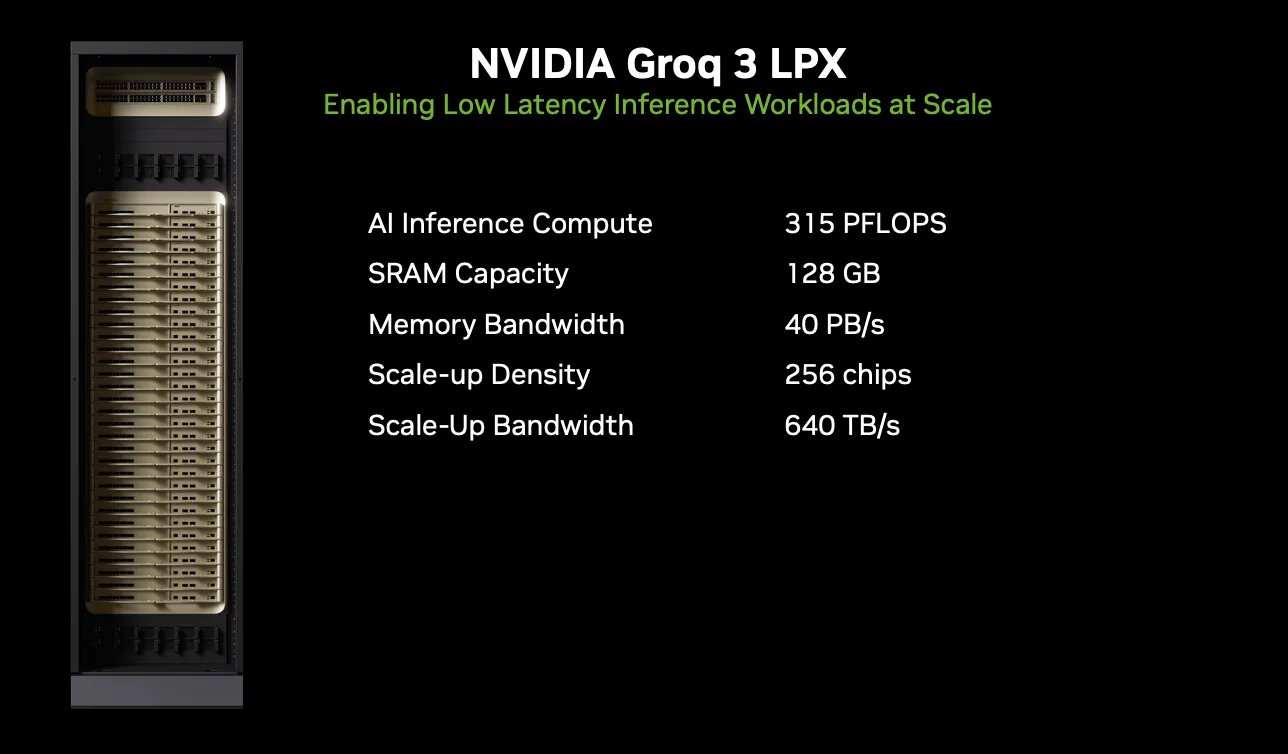
All'interno di un singolo rack LPX, 32 unità di calcolo (per un totale di 256 chip) si interconnettono tramite quattro spine ETL nel backplane. Queste spine trasportano il traffico RealScale C2C tra le unità, creando il dominio di scalabilità a livello di rack. La larghezza di banda di scalabilità aggregata sull'intero rack è di 640 TB/s (32 unità × 20 TB/s per unità). Suddivisa tra le quattro spine, ciascuna spina trasporta circa 160 TB/s di larghezza di banda bidirezionale.
Connettività tra rack
Ogni vassoio di calcolo 1U espone quattro porte QSFP C2C sul pannello frontale, fornendo un totale di 32 corsie (8 corsie per porta) per la comunicazione tra rack. Queste porte si collegano ai rack adiacenti secondo uno schema simmetrico: due porte (16 corsie) si collegano al rack adiacente a sinistra e due porte (16 corsie) si collegano al rack adiacente a destra. Ogni posizione U si collega alla corrispondente posizione U nel rack adiacente (la prima U nel rack A si collega alla prima U nel rack B, la seconda alla seconda e così via).
Fonte: Nvidia
A 112 Gbps per corsia, le 32 corsie inter-rack di ciascun vassoio forniscono 32 × 112 Gbps = 3,584 Gbps, ovvero circa 448 GB/s per direzione per vassoio di larghezza di banda inter-rack. Sull'intero rack, i 32 vassoi forniscono 32 × 32 = 1,024 corsie inter-rack. Ciò equivale a 1,024 × 112 Gbps = 114,688 Gbps, ovvero circa 14.3 TB/s per direzione verso ciascun rack adiacente (suddiviso equamente: ~7.2 TB/s per direzione verso il rack adiacente a sinistra e ~7.2 TB/s per direzione verso il rack adiacente a destra).
Questa larghezza di banda inter-rack è, per impostazione predefinita, più rada rispetto alla larghezza di banda intra-rack. All'interno del rack, il dominio di scalabilità a 640 TB/s fornisce una connettività densa e completa attraverso la dorsale. Tra i rack, i collegamenti del pannello frontale forniscono le connessioni globali più sparse della topologia dragonfly. Questo è lo stesso schema architetturale del GroqRack originale, in cui quattro collegamenti C2C esterni per chip connettevano gruppi locali (nodi) per formare sistemi multi-rack con un diametro di rete ridotto (massimo tre hop in una configurazione a 264 chip).
Assemblaggio: stessa architettura, densità quadrupla
La configurazione originale GroqRack a quattro rack conteneva 264 processori GroqChip. Un singolo rack LPX integra 256 chip LP30 in un rack MGX ETL, circa 4 volte la densità di chip, il tutto in un unico rack con raffreddamento a liquido e backplane senza cavi. Il gruppo locale all-to-all a 8 chip, la topologia dragonfly e il paradigma di routing pianificato via software rimangono invariati. La tecnologia di rete fondamentale di Groq non è cambiata; è stata semplicemente scalata.
Per i modelli che superano la capacità SRAM di un singolo rack (128 GB totali su 256 chip), è possibile interconnettere più rack LPX o file di rack tramite le porte C2C sul pannello frontale per estendere ulteriormente la linea di assemblaggio. Maggiori dettagli su cosa ciò significhi per le dimensioni reali dei modelli saranno forniti nella sezione successiva.
Perché i layer FFN? Capire cosa sta scaricando NVIDIA
Perché Decode sta diventando sempre più difficile da servire
Prima di addentrarci nei dettagli di cosa NVIDIA stia delegando a LPX e perché, è utile comprendere le tendenze più ampie, come sottolinea la stessa NVIDIA, che rendono necessaria questa decisione architetturale. L'inferenza AI non è un carico di lavoro singolo e uniforme. All'interno di una singola richiesta, la fase di precompilazione (acquisizione del prompt e creazione della cache KV) e la fase di decodifica (generazione dei token uno alla volta) impongono esigenze hardware molto diverse, e tali esigenze variano in base alla dimensione del batch, alla lunghezza del contesto e alla struttura del modello.
Man mano che i modelli producono output di ragionamento più lunghi e catene di pensiero a più fasi, una quota maggiore di ogni richiesta si sposta nella fase di decodifica sequenziale. Allo stesso tempo, tecniche come la memorizzazione nella cache dei prefissi riducono il costo del pre-riempimento riutilizzando lo stato del prompt condiviso tra le richieste, il che rende il costo relativo della decodifica ancora più rilevante. Anche le finestre di contesto stanno crescendo fino a centinaia di migliaia di token, esercitando una pressione crescente sulla larghezza di banda della memoria durante il calcolo dell'attenzione. Inoltre, nei flussi di lavoro agentici, la latenza si accumula su numerose chiamate di modello, interazioni con gli strumenti e cicli di verifica. L'effetto cumulativo è che la latenza di decodifica diventa sempre più il collo di bottiglia percepito dagli utenti, e l'hardware ottimizzato esclusivamente per la massima velocità di trasmissione aggregata non è sempre la soluzione migliore per carichi di lavoro che richiedono una generazione di token rapida e prevedibile per ogni singola richiesta.
Inoltre, come dimostrato dal rilascio della modalità Fast Mode di Anthropic , una latenza inferiore e una maggiore velocità di elaborazione dei token si traducono in maggiori ricavi, con l'offerta di inferenza rapida di Anthropic che costa 6 volte di più rispetto alle richieste normali.
Con l'annuncio di LPX, sappiamo che NVIDIA vuole spostare il principale collo di bottiglia della decodifica alle LPU: i livelli della rete feed-forward (FFN). Per capire perché l'obiettivo sia proprio l'FFN e per apprezzare la portata di questo cambiamento, abbiamo analizzato il numero di parametri FFN per i modelli open-source più diffusi attualmente.
Cosa sono i layer FFN e perché sono così diffusi?
Ogni layer Transformer ha due blocchi principali: un blocco di attenzione e un blocco feed-forward (FFN). Il blocco di attenzione permette ai token di osservare e combinare le informazioni provenienti da altri token nella sequenza. Il blocco FFN opera su ciascun token in modo indipendente: proietta la rappresentazione del token in uno spazio a dimensioni superiori, applica una non linearità e la proietta nuovamente verso il basso. Si può pensare a questo blocco come al knowledge store del modello, dove risiedono le associazioni fattuali e le trasformazioni apprese.
L'architettura MoE, o Mixture of Experts (miscela di esperti), si è affermata come l'architettura dominante tra i principali modelli linguistici open-source di grandi dimensioni attualmente disponibili: DeepSeek R1, Kimi K2, Qwen3-235B, GLM-5, MiniMax M2.5 e GPT-OSS 120B di OpenAI.
All'interno di questi modelli MoE, è nello specifico il blocco FFN che viene replicato in centinaia di copie indipendenti più piccole chiamate esperti, mentre l'attenzione rimane condivisa. Una funzione di routing leggera e appresa seleziona dinamicamente un piccolo sottoinsieme di esperti da attivare per ogni singolo token. Il risultato è un modello che memorizza un numero totale enorme di parametri, ma ne attiva solo una frazione per token, ottenendo i vantaggi qualitativi della scalabilità senza il relativo costo computazionale.
Tuttavia, come avrete sicuramente intuito, questo pone un'ulteriore sfida: i layer FFN costituiscono la maggior parte dei pesi del modello. Nello specifico, per i modelli MoE, questi possono arrivare fino al 90% dei pesi del modello.
All'interno di DeepSeek R1: un esempio pratico
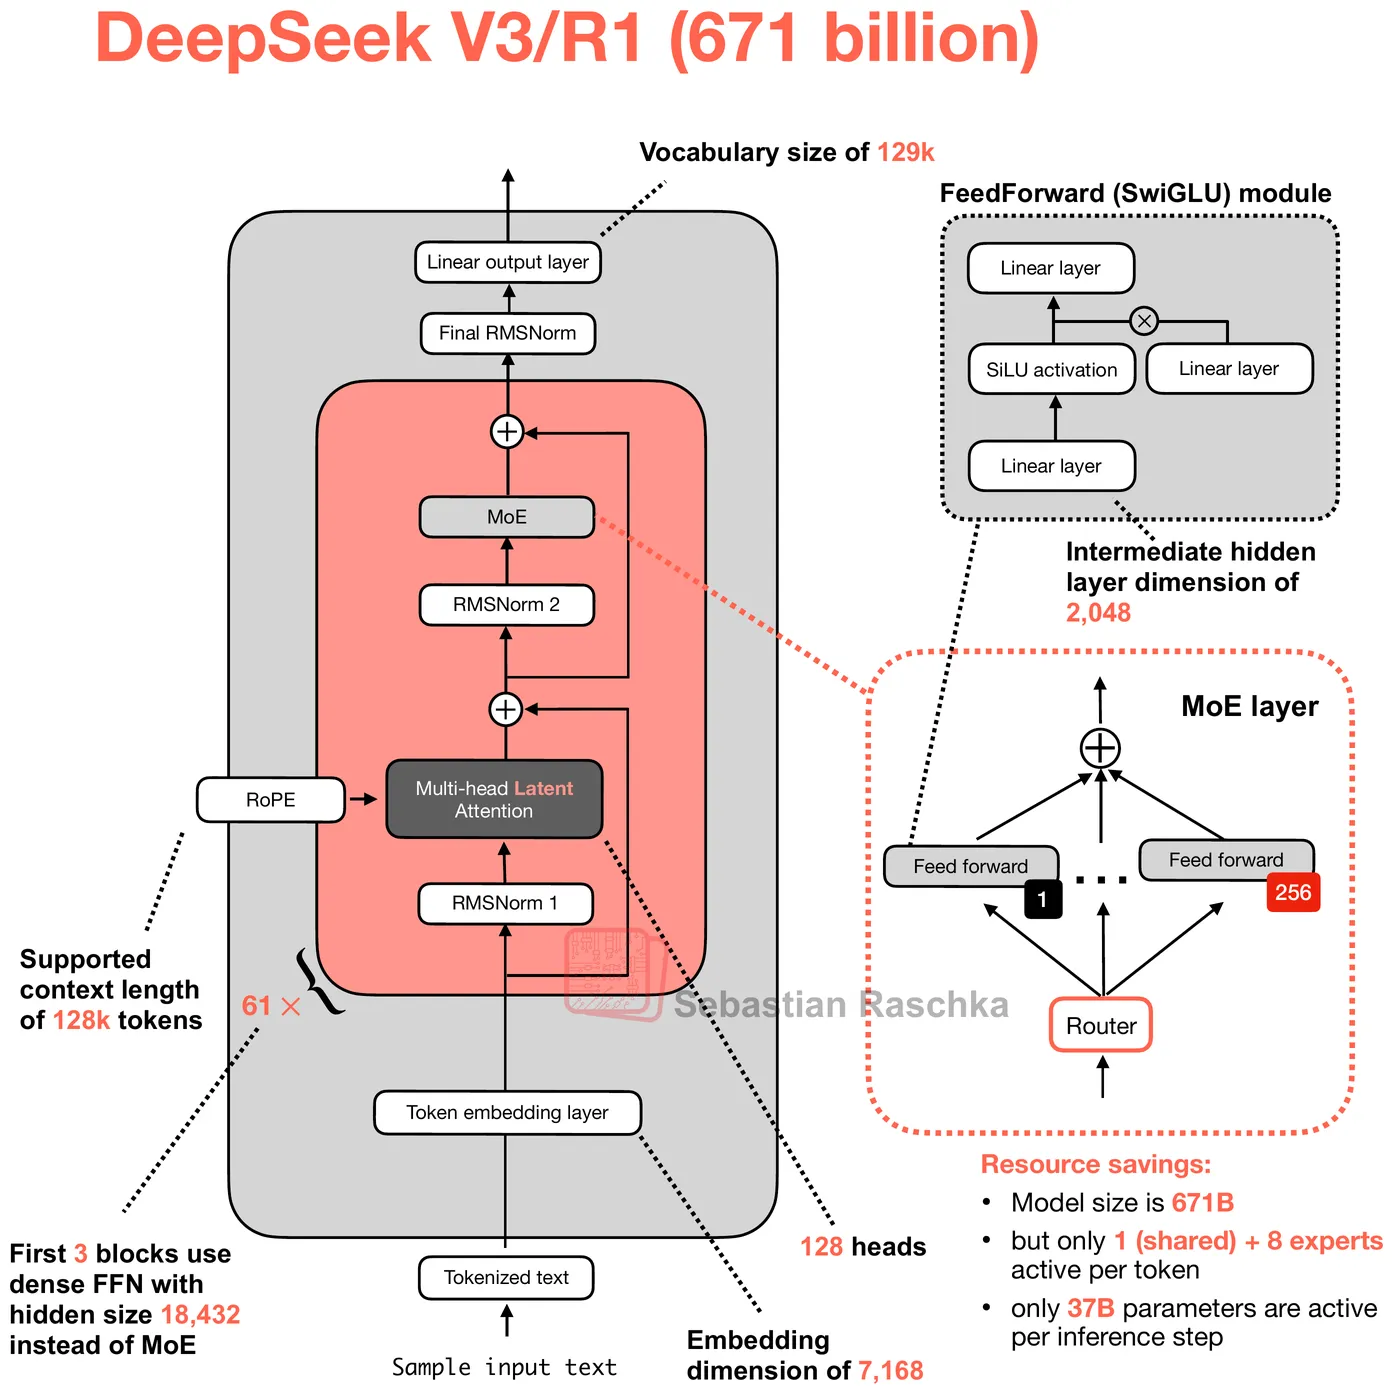
Per illustrare, ingrandiamo DeepSeek R1. Il modello ha 61 layer Transformer con una dimensione nascosta (H) di 7,168. I primi 3 layer utilizzano una FFN densa standard, mentre i restanti 58 utilizzano MoE (più 1 layer MTP aggiuntivo con i propri esperti, per un totale di 59 layer MoE). I moderni LLM utilizzano una variante chiamata SwiGLU, che ha tre matrici di peso invece di due. Il passaggio in avanti calcola w2(SiLU(w1(x)) ⊙ w3(x)), dove w1 (la proiezione del gate) e w3 (la proiezione verso l'alto) espandono entrambe la dimensione nascosta da H a una dimensione intermedia I, e w2 (la proiezione verso il basso) la comprime. Il ⊙ rappresenta la moltiplicazione elemento per elemento tra i percorsi con gate e senza gate. Nessuna di queste matrici ha termini di bias, quindi ogni blocco FFN SwiGLU contiene esattamente 3 × H × I parametri.
Fonte: Sebastian Raschka
Per i layer densi di DeepSeek R1 (i primi 3), la dimensione intermedia è 18,432, il che corrisponde a 3 × 7,168 × 18,432 = 396.4 milioni di parametri per layer. Per i layer MoE, ciascuno dei 256 esperti instradati è un blocco SwiGLU completo con una dimensione intermedia più piccola di 2,048, quindi ogni esperto ha 3 × 7,168 × 2,048 = 44.0 milioni di parametri. Moltiplicando per 256 esperti, si ottengono 11.27 miliardi di parametri solo negli esperti instradati, per layer. Oltre a ciò, ogni layer MoE ha un esperto condiviso (lo stesso blocco SwiGLU da 44 milioni di parametri, sempre attivato per ogni token), un gate di routing (una proiezione lineare di forma [256, 7168] = 1.8 milioni di parametri) e un piccolo vettore di bias di 256 valori FP32 utilizzato per il bilanciamento del carico durante il routing.
La rete FFN completa ha circa 669.1 miliardi di parametri. Nel formato FP8 E4M3 (1 byte per peso), ciò si traduce in circa 623.1 GB di dati FFN. Questo rappresenta il 97.7% della dimensione totale stimata del modello su disco. Il restante ~2.3% è costituito da pesi di attenzione, embedding, l'intestazione di output, norme di livello e metadati di scala FP8.
Decodifica Disaggregazione
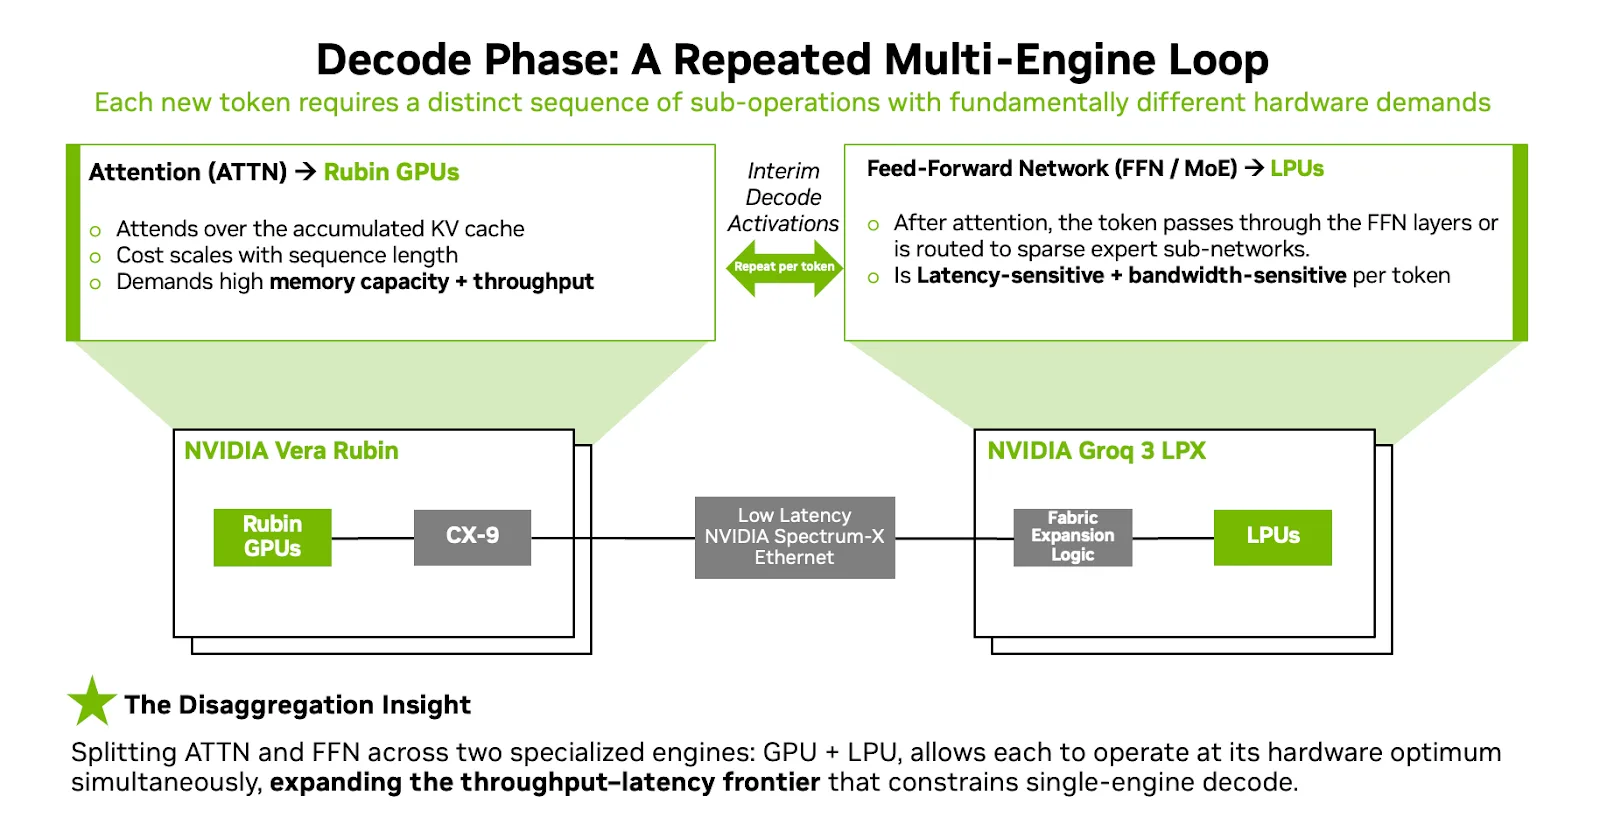
NVIDIA ora inquadra la fase di decodifica non come un'operazione monolitica, ma come un ciclo ripetuto per ogni token, in cui diverse parti sollecitano diversi colli di bottiglia hardware. La fase di pre-riempimento è dominata dall'acquisizione di input di grandi dimensioni e dalla creazione della cache KV, un carico di lavoro che beneficia di un'elevata capacità di calcolo parallelo e di una grande capacità di memoria. La Vera Rubin NVL72 gestisce questo processo in modo efficiente, soprattutto per i carichi di lavoro a contesto lungo in cui il prompt può essere massiccio e altamente variabile.
Fonte: Nvidia
La decodifica è diversa. Per ogni nuovo token, il sistema deve eseguire l'attenzione sull'intera cache KV accumulata e quindi eseguire il calcolo FFN/MoE sull'output dell'attenzione. Nell'architettura Attention-FFN Disaggregation (AFD) di NVIDIA, questi due passaggi sono suddivisi tra due motori. Le GPU Rubin gestiscono l'attenzione in fase di decodifica: leggono la cache KV dall'HBM, calcolano i punteggi di attenzione e producono l'attivazione intermedia. Tale tensore di attivazione (che NVIDIA definisce "stato del tensore intermedio") viene quindi passato all'LPX, che esegue il calcolo esperto FFN o MoE con larghezza di banda estrema e latenza deterministica prima di restituire il risultato alla GPU per continuare la generazione dei token.
Questo passaggio di consegne avviene per ogni singolo token. I tensori di attivazione scambiati tra GPU e LPU sono piccoli rispetto ai dati dei pesi, ed è proprio in questo ambito che la rete a overhead quasi nullo dell'LPU eccelle. La suddivisione sfrutta i punti di forza fondamentali di ciascun processore: le GPU forniscono la capacità HBM e l'esecuzione flessibile necessarie per l'attenzione a lunghezza variabile su grandi cache KV, mentre le LPU forniscono la larghezza di banda SRAM e la pianificazione deterministica necessarie per i pesi FFN, limitati dalla larghezza di banda e pianificabili staticamente.
Fonte: Nvidia
C'è una proprietà di scalabilità sottile ma importante che merita di essere sottolineata. Man mano che la lunghezza del contesto aumenta, aumentano anche i requisiti di calcolo e di memoria dell'operazione di attenzione: la cache KV si espande linearmente con ogni token di contesto aggiuntivo e ogni nuovo passaggio di decodifica deve occuparsi dell'intera cache accumulata. FFN, tuttavia, non cresce affatto con il contesto. Le matrici dei pesi FFN (w1, w2, w3 in SwiGLU) sono costanti fisse dell'architettura del modello. Hanno le stesse dimensioni sia che il contesto sia di 1,000 token o di 1,000,000 di token e ogni token le attraversa indipendentemente. Ciò significa che nell'architettura AFD, man mano che le finestre di contesto continuano a crescere, il lato GPU assorbe il costo crescente (più HBM per la cache KV, più calcolo per l'attenzione), mentre il lato LPX rimane completamente statico. Il numero di rack LPX necessari per servire l'FFN di un modello è determinato interamente dall'architettura del modello, non dalla lunghezza del contesto della configurazione di servizio. Questo risolve in modo elegante quello che storicamente è stato uno dei maggiori problemi per gli acceleratori basati esclusivamente su SRAM: ovvero che le crescenti esigenze di contesto finiscano per superare la capacità di memoria fissa on-chip. Nella suddivisione AFD, il lavoro dipendente dal contesto rimane sull'hardware con HBM espandibile, mentre l'LPU gestisce solo il lavoro indipendente dal contesto che si adatta naturalmente alla SRAM fissa.
NVIDIA Dynamo rende operativa la decodifica eterogenea
Per far funzionare questo ciclo a due motori in produzione, non basta solo l'hardware. Il livello di orchestrazione Dynamo di NVIDIA è ciò che rende praticabile la decodifica eterogenea. Dynamo coordina l'erogazione disaggregata tra i backend GPU e LPU, gestendo la classificazione, l'instradamento e il trasferimento di attivazione per singolo token richiesti da AFD.
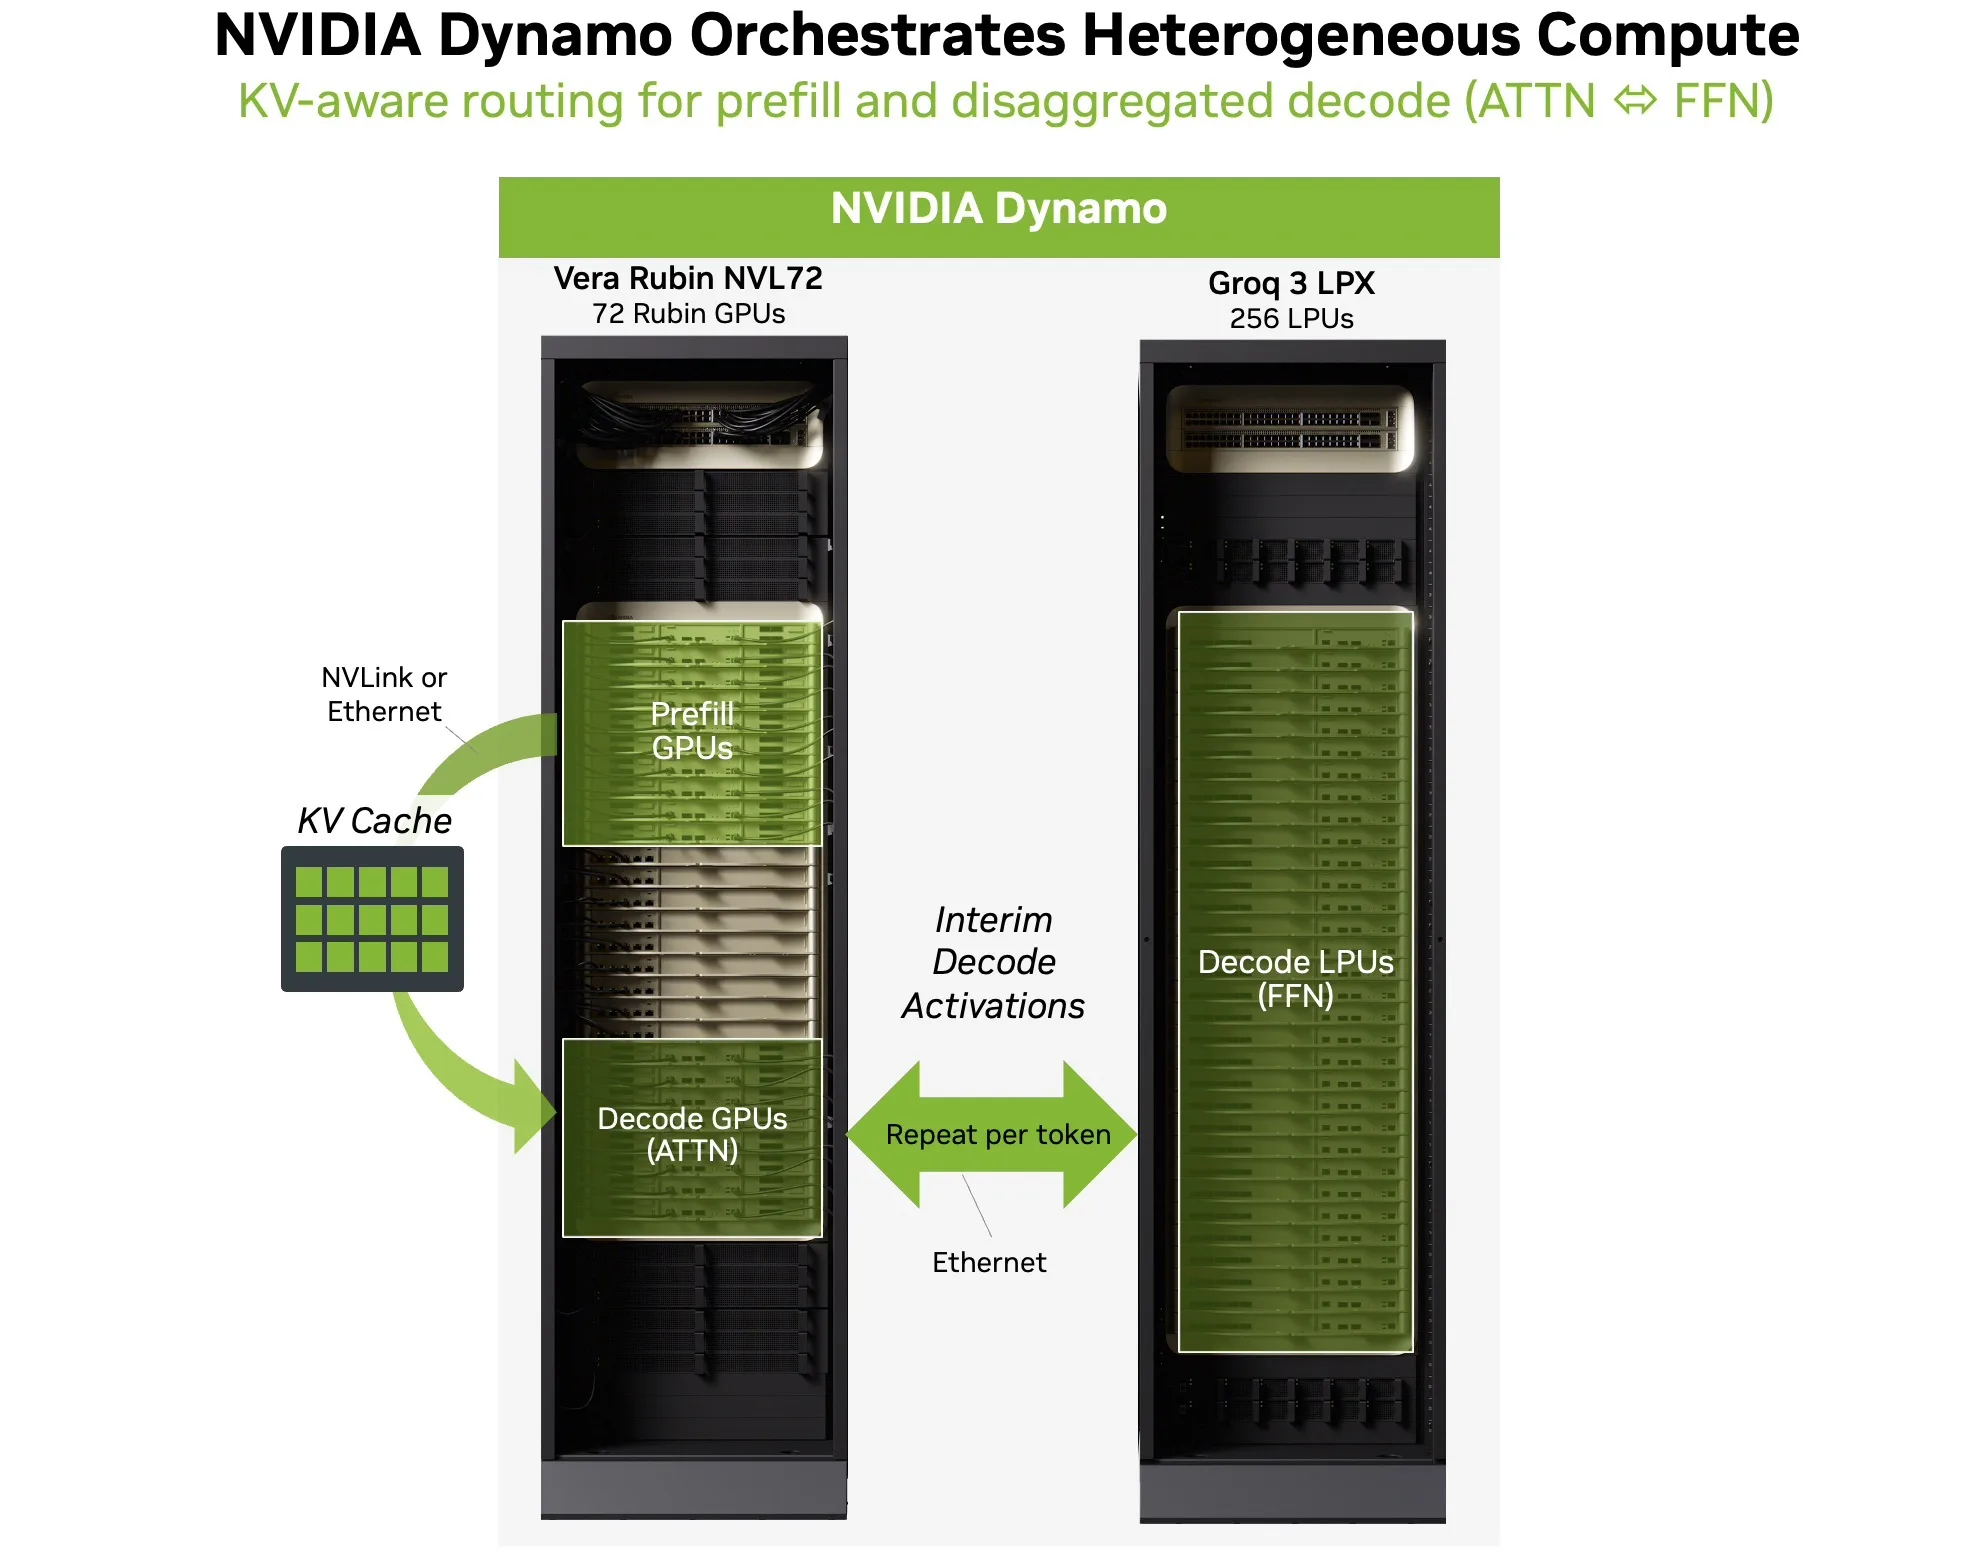
Fonte: Nvidia
In pratica, Dynamo instrada il precaricamento ai worker GPU per elaborare l'input e costruire la cache KV. Durante la decodifica, Dynamo orchestra il ciclo AFD: le GPU applicano l'attenzione alla cache KV accumulata, le attivazioni intermedie vengono trasferite alle LPU per l'esecuzione di FFN/MoE e gli output ritornano alle GPU per continuare la generazione dei token. Il risultato è un unico percorso di servizio coerente anziché due sistemi disconnessi.
Dynamo offre anche il routing consapevole della chiave primaria (in modo che le richieste vengano indirizzate ai worker che hanno già la chiave primaria corrispondente nella cache), la pianificazione basata su obiettivi di latenza (in modo che le sessioni interattive non vengano inserite in code lunghe) e una gestione dei trasferimenti a basso overhead. Queste funzionalità sono importanti perché, in presenza di traffico di produzione reale con lunghezze di contesto variabili, tipi di richieste misti e concorrenza a raffiche, il livello di orchestrazione mantiene stabile la latenza di coda e impedisce che il jitter tra tenant comprometta l'esperienza utente.
Taglie FFN per tutti i principali modelli open-source e taglie LPX
Ora che abbiamo capito come funziona LPX e cosa si propone di risolvere, analizziamo i requisiti hardware.
Abbiamo calcolato il numero di parametri e la dimensione FFN su disco per i modelli più diffusi utilizzando i file config.json e model.safetensors.index.json disponibili su Huggingface.
| Modello | Parametri FFN | Dimensioni FFN (su disco) | FFN % | tipo D | Esperti |
|---|---|---|---|---|---|
| DeepSeek R1 e DeepSeek V3.2 | 669.1B | 623.1 GB | 97.7% | FP8 | 256 |
| Kimi K2 | 1.02T | 948.0 GB | 98.9% | FP8 | 384 |
| Kimi K2.5 | 1.02T | 474.0 GB | 98.5% | INT4 | 384 |
| MiniMax M2.5 | 224.7B | 209.3 GB | 97.7% | FP8 | 256 |
| OpenAI GPT-OSS 120B | 114.7B | 53.4 GB | 95.4% | MXFP4 | 128 |
| GLM5 | 738.1B | 1,374.8 GB | 98.0% | BF16 | 256 |
| Qwen3 235B-A22B | 227.2B | 423.1 GB | 96.6% | BF16 | 128 |
Il modello conferma quanto analizzato in precedenza: in ogni modello di questa analisi, i parametri FFN rappresentano dal 95% al 99% della dimensione totale del modello su disco. Kimi K2 è il caso più estremo, con 384 esperti instradati per livello che portano i parametri FFN a oltre 1 trilione e quasi il 99% del totale. Anche il modello più piccolo del set, GPT-OSS 120B di OpenAI con 128 esperti memorizzati in MXFP4, ha comunque parametri FFN che rappresentano il 95.4% del totale. Le dimensioni su disco variano da un modesto 53 GB per GPT-OSS 120B (grazie alla quantizzazione a 4 bit) fino a quasi 1.4 TB per GLM 5 (memorizzato in BF16 senza quantizzazione).
Questi numeri ci aiutano a comprendere le dimensioni di LPX. Un singolo rack LPX offre 128 GB di SRAM totale distribuiti su 256 chip. Per un modello come OpenAI GPT-OSS 120B da 53 GB FFN, i pesi FFN si adattano comodamente a un singolo rack, con spazio a sufficienza. DeepSeek R1 da 623 GB richiederebbe circa cinque rack LPX, mentre GLM 5 da 1.4 TB in BF16 ne richiederebbe oltre dieci (anche se la quantizzazione in FP8 ridurrebbe questo numero circa della metà). Questo è precisamente il motivo per cui sono necessarie le porte C2C inter-rack sul pannello frontale: consentono di collegare in serie più rack LPX, estendendo la linea di assemblaggio per ospitare modelli più grandi.
Accelerazione della decodifica speculativa con LPX
Oltre al ciclo di decodifica AFD, NVIDIA individua un secondo importante caso d'uso per l'LPX: fungere da motore di generazione di bozze nella decodifica speculativa.
La decodifica speculativa è una tecnica sempre più importante per ridurre la latenza nell'inferenza LLM. L'idea è semplice: un modello di bozza più piccolo e veloce genera in anticipo più token candidati, mentre un modello di destinazione più grande li verifica e li accetta in parallelo. Quando le previsioni del modello di bozza sono corrette (come spesso accade per i testi di routine), è possibile confermare più token contemporaneamente in un'unica fase di verifica. Il risultato è un numero significativamente maggiore di token effettivi al secondo e una latenza percepita inferiore per l'utente finale.
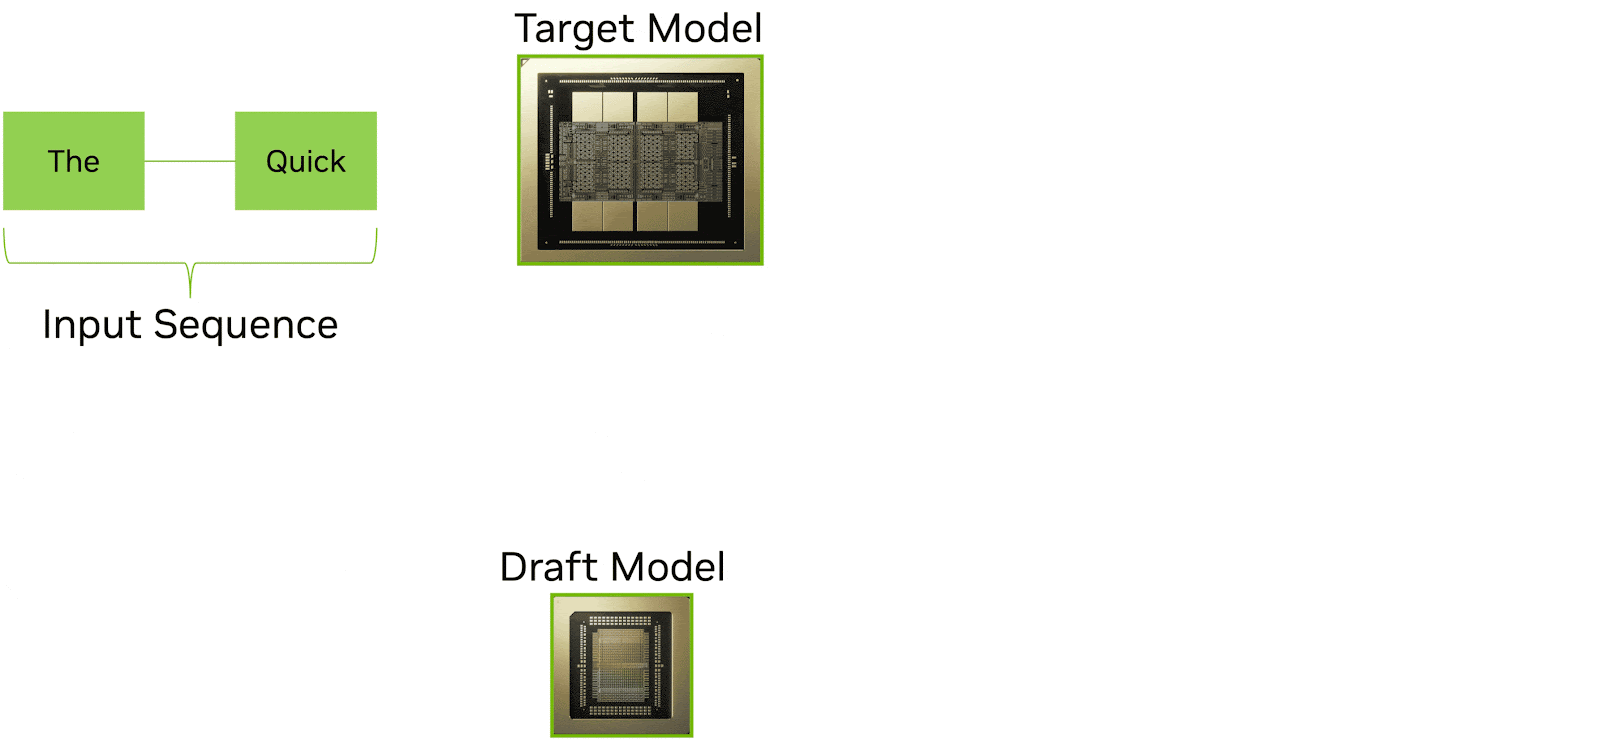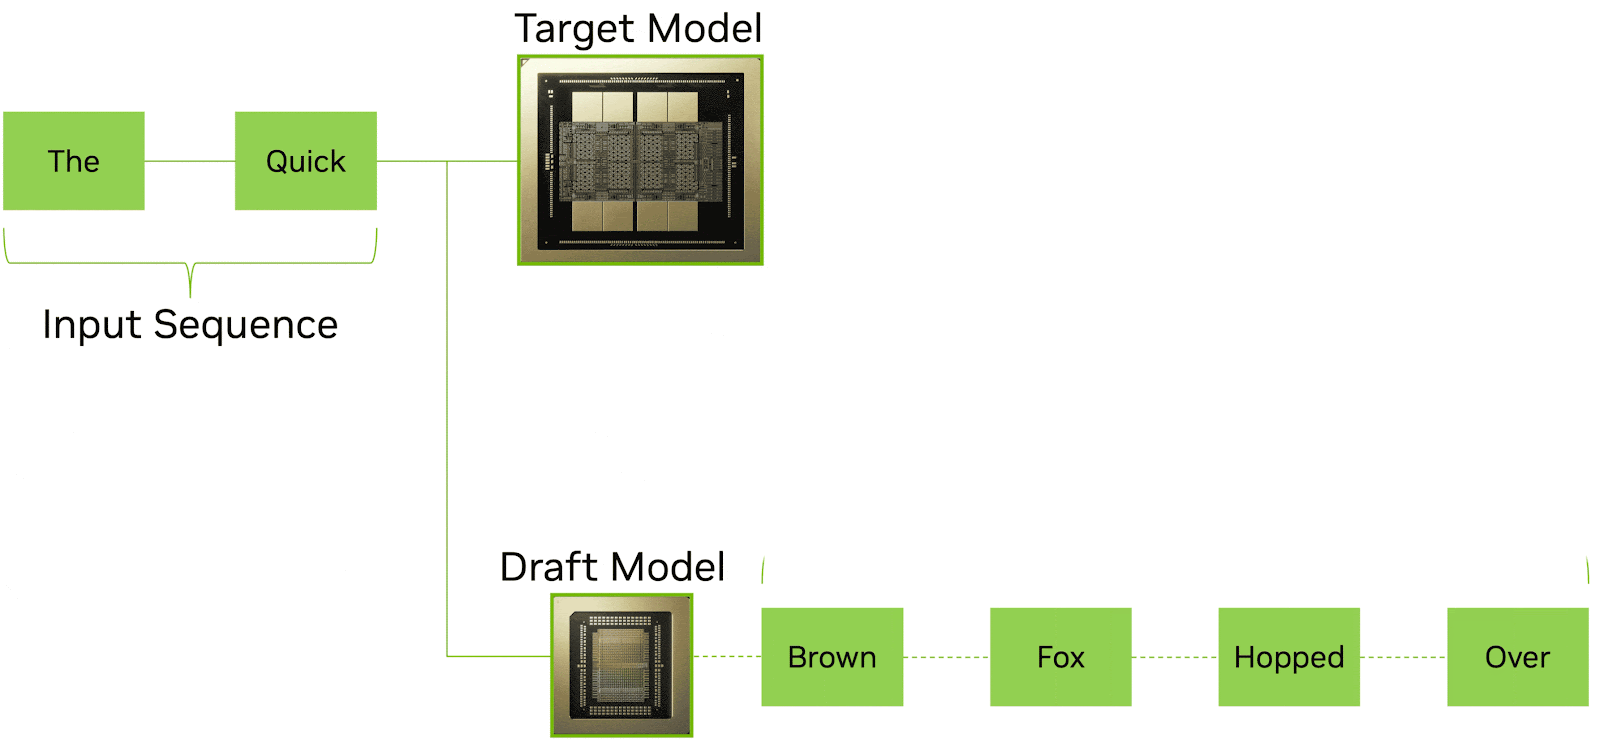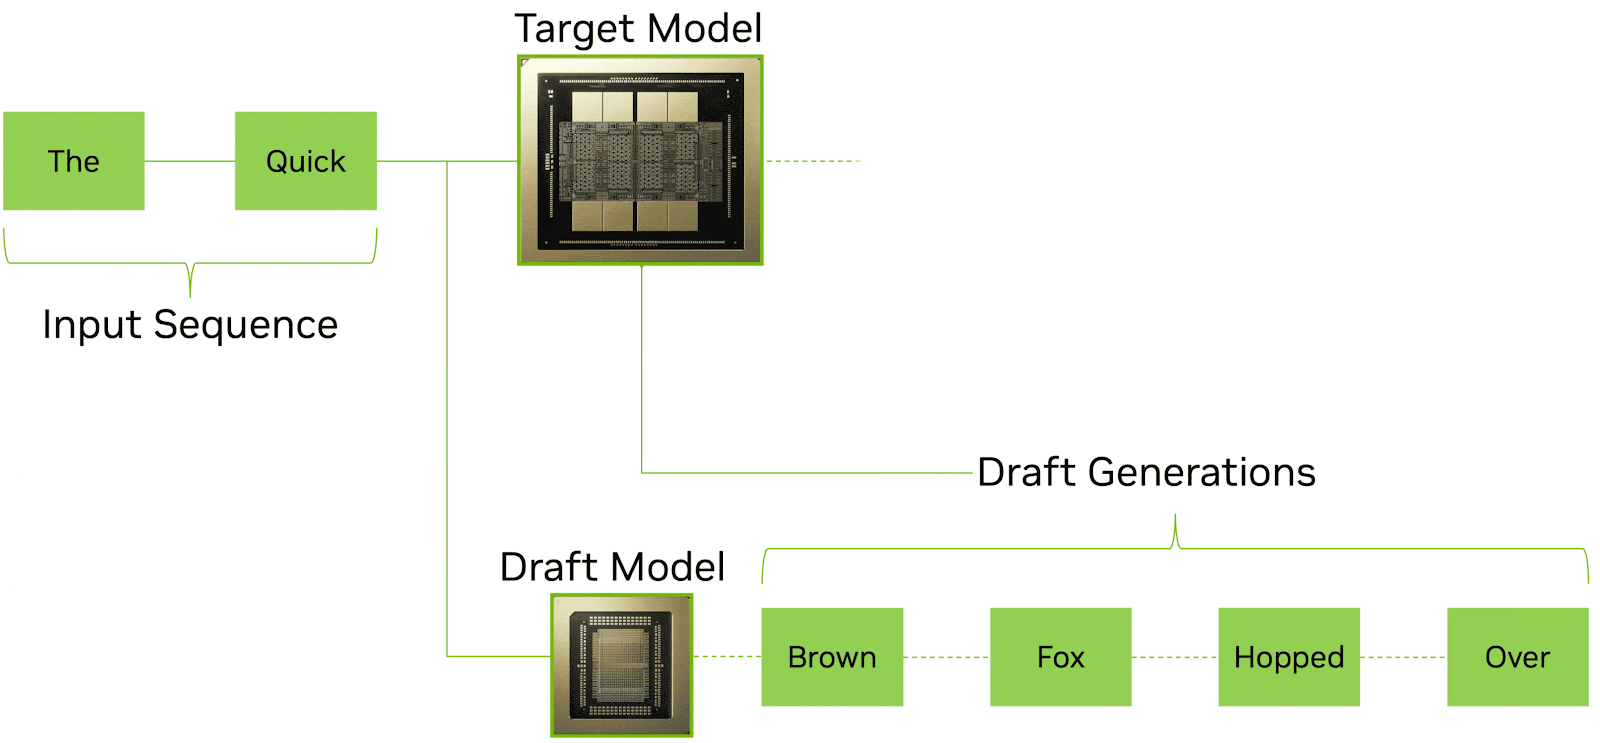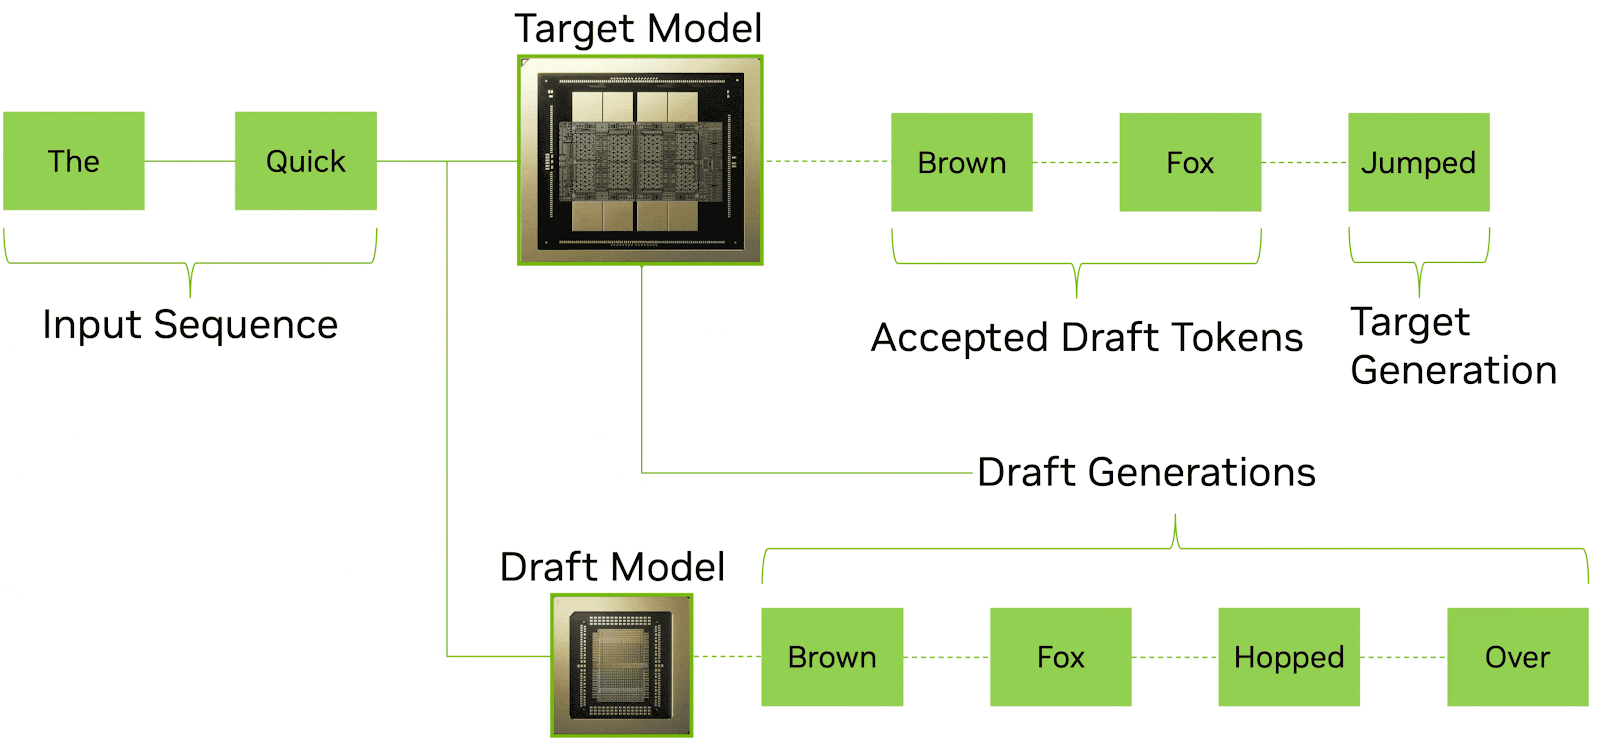
Fonte: Nvidia
La difficoltà sta nel fatto che la decodifica speculativa richiede che il modello di bozza venga eseguito a una velocità estremamente elevata. Ogni millisecondo che il modello di bozza impiega per generare candidati è un millisecondo di attesa per il verificatore. In una configurazione convenzionale basata esclusivamente su GPU, sia il modello di bozza che il modello di destinazione competono per le stesse risorse hardware e la velocità del modello di bozza è limitata dagli stessi vincoli di larghezza di banda HBM che influenzano tutto il resto.
LPX è perfettamente adatto a questo ruolo. Il modello di esecuzione deterministico e l'estrema larghezza di banda SRAM on-chip dell'LP30 consentono una generazione di token di bozza molto rapida e prevedibile. Un modello di bozza più compatto si adatta comodamente alla SRAM di un singolo vassoio LPX o di un numero limitato di vassoi, e la pianificazione deterministica garantisce che la generazione della bozza avvenga a una velocità costante e prevedibile, senza la variabilità che renderebbe difficile la pipeline con il verificatore.
In questa configurazione, il sistema accoppia i due processori per ruoli complementari: LPX genera rapidamente i token di bozza grazie alla sua architettura a bassa latenza, mentre le GPU Rubin verificano e finalizzano i token in modo efficiente grazie alla loro elevata capacità di calcolo e all'ampia capacità HBM. Questa separazione consente alla decodifica speculativa di essere eseguita su processori eterogenei anziché richiedere che entrambi i modelli condividano una singola GPU, migliorando potenzialmente la velocità di generazione della bozza e la velocità di verifica rispetto a una configurazione omogenea.
NVIDIA ha evidenziato la decodifica speculativa, insieme all'AFD, come un carico di lavoro chiave per LPX, suggerendo che la considera una parte significativa della proposta di valore del sistema. Con la continua crescita dei modelli di frontiera e l'allungamento delle catene di ragionamento, la capacità di generare e verificare i token in parallelo su hardware specializzato potrebbe diventare una leva importante per mantenere la reattività interattiva.
Considerazioni finali: co-progettazione hardware/software estrema
Uno degli aspetti che più colpisce dell'approccio di NVIDIA con la piattaforma Vera Rubin e LPX è la precisione con cui ogni componente è stato progettato. Nel mercato consumer, ci imbattiamo spesso in prodotti che cercano di risolvere problemi inesistenti, realizzati da aziende che non comprendono a fondo le esigenze dei propri clienti. La strategia di NVIDIA in questo caso rappresenta un netto contrasto. È evidente che l'azienda comprende i problemi della pipeline di inferenza a un livello estremamente dettagliato e sta ottimizzando ogni segmento di tale pipeline per aiutare i clienti a massimizzare il ritorno sull'investimento hardware.
La disaggregazione di Attention/FFN non è un concetto di marketing. È una risposta diretta al profilo di collo di bottiglia misurato nella gestione del modello MoE con trilioni di parametri. La decisione di spostare specificamente FFN (e non Attention) e di far evolvere il rack CPX nel rack LPX riflette una precisa comprensione di quali operazioni siano limitate dalla larghezza di banda e quali dalla capacità, quali siano pianificabili staticamente e quali dinamicamente variabili, e quale architettura di processore sia più adatta a ciascuna. Il livello di orchestrazione Dynamo, l'integrazione trasparente di CUDA e il design senza cavi del rack MGX indicano tutti un'organizzazione di ingegneri che ha pensato all'intero ciclo di vita dell'implementazione.
Ci sono ancora molte incognite riguardo a LPX e ai nuovi prodotti di frontiera di NVIDIA. Uno dei grandi interrogativi che ci assillano è quale sia lo scopo della "Fabric Expansion Logic and DRAM", che tipo di silicio venga utilizzato e, come molti hanno già notato, il socket x86, l'investimento in Intel dello scorso anno e il design del dissipatore di calore fanno pensare che si tratti di un processore Intel, ma quale sia esattamente è ancora un mistero.
L'implementazione di LPX si concentrerà inizialmente sui creatori di modelli e sui fornitori di servizi, piuttosto che su una disponibilità generale. Le prestazioni reali in condizioni di traffico di produzione, con lunghezze di contesto variabili, tipologie di richieste miste e picchi di concorrenza, nonché l'efficienza energetica, devono ancora essere validate in modo indipendente. Non vediamo l'ora di poter accedere a questi sistemi per effettuare test indipendenti.
Fonti di riferimento:
Groq: Cos'è un'unità di elaborazione del linguaggio?
Groq: La tecnologia Groq LPU, basata sull'inferenza AI, offre una maggiore efficienza energetica…
Groq: Tecnologia di interconnessione chip-to-chip su scala reale
Groq: Bassa latenza per IA in tempo reale e HPC
Groq: Determinismo e processore di streaming tensoriale
Nvidia: All'interno di Nvidia Groq 3 LPX…


 Amazon