

Al GTC 2026 di San Jose, il CEO di NVIDIA, Jensen Huang, ha tenuto un discorso di apertura in cui ha illustrato la piattaforma infrastrutturale AI di nuova generazione dell'azienda e ha annunciato una serie di importanti novità che spaziano dai semiconduttori ai sistemi, dal software alle partnership con l'ecosistema. Con oltre 30,000 partecipanti provenienti da più di 190 paesi, il GTC 2026 è stato il palcoscenico per il più completo rinnovamento della piattaforma NVIDIA dall'introduzione di Blackwell, incentrato sul lancio in produzione dell'architettura Vera Rubin e sull'integrazione della tecnologia Groq 3 LPU nell'ecosistema dei data center di NVIDIA. Come ha affermato Huang sul palco, il punto di svolta per l'IA agentiva è arrivato e Vera Rubin sta dando il via a quella che NVIDIA definisce la più grande espansione infrastrutturale della storia.
Il tema centrale del keynote è stato l'emergere di una quarta legge di scalabilità dell'IA: la scalabilità agentica, in cui i sistemi di IA comunicano non solo con gli esseri umani, ma anche con altri agenti di IA, generando una domanda esponenziale di inferenza a bassa latenza e ad ampio contesto su una scala senza precedenti. NVIDIA ha posizionato la piattaforma Vera Rubin come infrastruttura di base per servire questa nuova frontiera. Essa combina sette chip co-progettati in cinque nuovi sistemi rack-scale, realizzati appositamente per la "fabbrica di IA". La piattaforma ha anche ricevuto il sostegno dei laboratori di IA all'avanguardia: il CEO e co-fondatore di Anthropic, Dario Amodei, ha osservato: "Aziende e sviluppatori utilizzano Claude per ragionamenti sempre più complessi, flussi di lavoro agentici e decisioni mission-critical. Ciò richiede un'infrastruttura in grado di tenere il passo. La piattaforma Vera Rubin di NVIDIA ci fornisce la potenza di calcolo, la rete e la progettazione di sistema per continuare a fornire risultati, migliorando al contempo la sicurezza e l'affidabilità su cui i nostri clienti fanno affidamento". Il CEO di OpenAI, Sam Altman, ha dichiarato: "L'infrastruttura NVIDIA è il fondamento che ci permette di continuare a spingere i confini dell'IA. Con NVIDIA Vera Rubin, saremo in grado di eseguire modelli e agenti più potenti su vasta scala e di fornire sistemi più veloci e affidabili a centinaia di milioni di persone."
Piattaforma Vera Rubin: Aprire la frontiera dell'IA agente
Basandosi sull'architettura Vera Rubin NVL72, presentata per la prima volta al CES 2026, GTC 2026 ha ampliato la piattaforma in un ecosistema completo di data center per l'intelligenza artificiale su scala POD. NVIDIA presenta questo cambiamento come una transizione da chip discreti e server standalone a sistemi completamente integrati su scala rack, implementazioni su scala pod e data center per l'intelligenza artificiale indipendenti. La piattaforma Vera Rubin riunisce CPU NVIDIA Vera, GPU Rubin, switch NVLink 6, SuperNIC ConnectX-9, DPU BlueField-4, switch Ethernet Spectrum-6 e una nuova LPU NVIDIA Groq 3 integrata, il tutto progettato per funzionare come un singolo supercomputer per l'IA unificato, con una profonda co-progettazione tra calcolo, rete e storage, supportato da un ecosistema di oltre 80 partner MGX con una catena di fornitura globale.

NVIDIA afferma che la piattaforma offre una velocità di inferenza per watt fino a 10 volte superiore e un costo per token dieci volte inferiore rispetto alla generazione Blackwell, su tutta la gamma di carichi di lavoro AI. Per l'addestramento di modelli Mixture-of-Experts di grandi dimensioni, Vera Rubin richiede solo un quarto delle GPU per ottenere prestazioni equivalenti. NVL72 si integra perfettamente con NVIDIA Quantum-X800 InfiniBand e Spectrum-X Ethernet per sostenere un elevato utilizzo su cluster GPU di grandi dimensioni, riducendo al contempo i tempi di addestramento e il costo totale di proprietà.
Confronto generazionale: Blackwell Ultra vs. Vera Rubin NVL72
| Specificazione | GB300 NVL72 (Blackwell Ultra) | VR NVL72 (Vera Rubin) |
|---|---|---|
| Architettura di calcolo | ||
| Conteggio GPU | 72 GPU Blackwell Ultra | 72 GPU Rubin |
| Conteggio CPU | 36 CPU Grace | 36 CPU Vera |
| CPU Cores | 72 core ARM per CPU | 88 core Olympus ARM per CPU |
| Prestazioni dell'IA | ||
| Prestazioni di inferenza FP4 | 1.44 ExaFLOPS | 3.6 ExaFLOPS |
| NVFP4 per GPU (inferenza) | 20 PFLOP | 50 PFLOP |
| NVFP4 per GPU (addestramento) | 10 PFLOP | 35 PFLOP |
| Memorie | ||
| Tipo di memoria GPU | HBM3e | HBM4 |
| Larghezza di banda della memoria della GPU | ~8 TB/s | ~22 TB/s |
| Collegamenti | ||
| Generazione NVLink | NVLink 5 | NVLink 6 |
| Larghezza di banda NVLink (per GPU) | 1.8 TB / s | 3.6 TB / s |
| Larghezza di banda NVLink su scala rack | 130 TB / s | 260 TB / s |
| Networking | ||
| NIC scalabile | ConnectX-8 (800 Gb/s) | ConnectX-9 (1.6 TB/s) |
| Interconnessione CPU-GPU | NVLink-C2C (900 GB/s) | NVLink-C2C (1.8 TB/s) |
A partire dalla seconda metà del 2026, i prodotti basati su Vera Rubin saranno disponibili presso i partner, tra cui i principali fornitori di servizi cloud come Amazon Web Services, Google Cloud, Microsoft Azure e Oracle Cloud Infrastructure, nonché i partner cloud di NVIDIA CoreWeave, Crusoe, Lambda, Nebius, Nscale e Together AI. Si prevede che i produttori di sistemi globali Dell Technologies, HPE, Lenovo e Supermicro, così come ASUS, Foxconn, GIGABYTE, Inventec, Pegatron, QCT, Wistron e Wiwynn, forniranno server basati su prodotti Vera Rubin.
Da CPX a LPX: come l'acquisizione di Groq da parte di NVIDIA ha ridefinito l'accelerazione della decodifica.
Lo scorso anno, all'AI Infra Summit, NVIDIA ha annunciato il rack CPX in un paio di configurazioni progettate per accelerare le query di inferenza a contesto lungo. Quando abbiamo parlato di quell'annuncio, ci sono sorti diversi interrogativi sulla funzione effettiva del CPX. A prima vista, sebbene fosse un concetto architetturale interessante, il CPX non sembrava offrire nulla di sostanzialmente diverso dalla GPU Rubin stessa, a parte forse un'accelerazione aggiuntiva per le operazioni di attenzione.
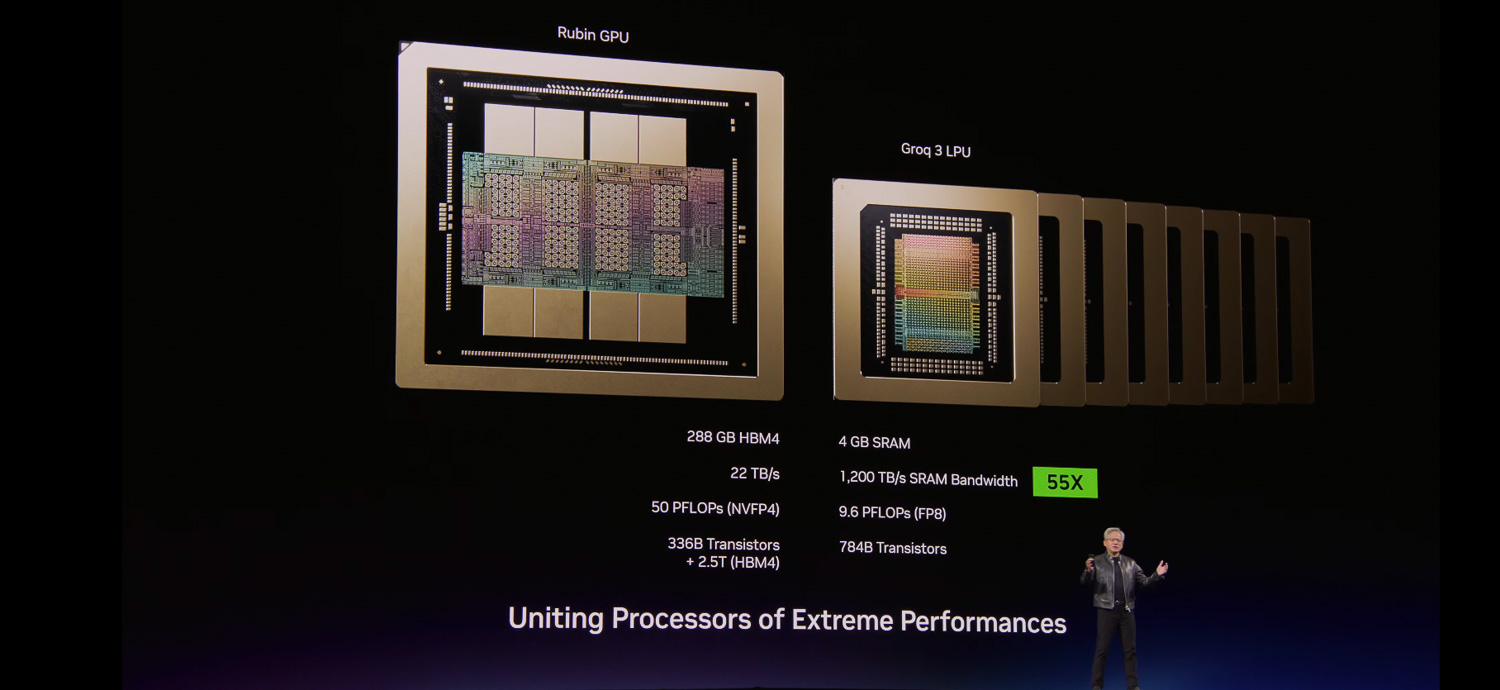
Poi è arrivata l'acquisizione di Groq, che ha riscosso un enorme successo nel settore e ha alimentato le speculazioni su come NVIDIA avrebbe integrato la tecnologia LPU di Groq nella più ampia piattaforma Vera Rubin. Ebbene, NVIDIA ha chiarito la situazione al GTC 2026 con l'annuncio di LPX. Da quanto presentato, sembra che il concetto di rack CPX si sia evoluto nel Groq 3 LPX Rack, con l'attenzione all'elaborazione del contesto del CPX originale che ha lasciato il posto a un'architettura di decodifica e accelerazione fondamentalmente diversa, basata sui chip di Groq.
GPU Rubin vs. LPU Groq 3: Architetture complementari
| Specificazione | GPU Rubin | Groq 3 LPU (LP30) |
|---|---|---|
| Tipo di memoria | HBM4 | SRAM impilata |
| Capacità di memoria (per chip) | 288 GB | 500 MB |
| Banda di memoria | 22 TB / s | 150 TB / s |
| Forza | Formazione e precompilazione ad alta produttività | Decodifica del token a bassissima latenza |
| Distribuzione | VR NVL72 (72 per rack) | Rack LPX (256 per rack) |
| Memoria rack aggregata | ~20.7 TB HBM4 | 128 GB di SRAM |
| Larghezza di banda scalabile (Rack) | 260 TB/s NVLink 6 | 640 TB / s |
Un singolo rack LPX ospita 256 LPU Groq 3. Ogni LPU contiene circa 500 MB di SRAM impilata, offrendo così circa 128 GB di SRAM on-chip aggregata e una larghezza di banda di scalabilità di 640 TB/s, progettata specificamente per l'accelerazione della decodifica a latenza ultra-bassa. Il contrasto tra i due tipi di processore è netto: una GPU Rubin offre 288 GB di HBM4 con una larghezza di banda di 22 TB/s, mentre l'LPU sacrifica la capacità a favore della larghezza di banda pura, erogando 150 TB/s dal suo pool di SRAM per chip. Quando implementati insieme al VR NVL72 tramite un'interconnessione personalizzata basata su Spectrum X, i due rack dovrebbero elaborare ogni token di decodifica in modo cooperativo, con la decodifica di attenzione gestita dai layer Rubin e Feed Forward scaricata sulle LPU. Ottimizzata per modelli con trilioni di parametri e contesti con milioni di token, l'architettura LPX, progettata in collaborazione con Vera Rubin, massimizza l'efficienza in termini di potenza, memoria e capacità di calcolo. Il rack LPX è completamente raffreddato a liquido, basato sull'infrastruttura MGX e sarà disponibile nella seconda metà del 2026, in concomitanza con il lancio più ampio di Vera Rubin.

È importante sottolineare che NVIDIA ha confermato che non sono necessarie modifiche a CUDA. L'LPU funziona come un acceleratore per lo stack CUDA esistente in esecuzione sulle piattaforme Vera e NVL72, con il calcolo scaricato in modo trasparente per ogni singolo token. Durante la sessione di domande e risposte del GTC, NVIDIA ha descritto l'LPU come un "potenziatore di decodifica dei modelli" e ha spiegato che "lavorerà a stretto contatto con i laboratori di IA e i creatori di modelli all'avanguardia che stanno implementando questi modelli da trilioni di parametri" per abilitare la prossima generazione di servizi di modellazione premium e ultra-premium. Molti dei fondatori e degli ingegneri di Groq sono entrati a far parte di NVIDIA e la collaborazione tra i due team è stata a quanto pare eccellente, mentre portano avanti la roadmap di Groq per integrarla nell'infrastruttura MGX. L'implementazione di LPX si concentrerà inizialmente sui creatori di modelli e sui fornitori di servizi, piuttosto che su una disponibilità generale per gli OEM. Non vediamo l'ora di constatare i miglioramenti prestazionali concreti derivanti dall'integrazione tra NVIDIA e Groq.
Vera CPU Rack: un sistema di calcolo progettato specificamente per l'apprendimento per rinforzo e i carichi di lavoro basati su agenti.
Perché l'IA agentiva richiede una nuova classe di CPU
Per capire perché NVIDIA abbia costruito un rack di CPU dedicato, è utile comprendere come funziona l'apprendimento per rinforzo (RL) nella fase di post-addestramento dello sviluppo dell'IA moderna. Il post-addestramento è la fase successiva al pre-addestramento di un modello su un set di dati di grandi dimensioni, in cui il modello viene perfezionato e specializzato per i casi d'uso specifici.
In un algoritmo di apprendimento per rinforzo, il ciclo di addestramento prevede tre componenti principali: un modello di policy (il modello in fase di addestramento), un ambiente in cui il modello esegue azioni e riceve feedback, e un segnale di ricompensa che valuta la qualità di tali azioni. Il modello di policy genera output candidati, che vengono poi eseguiti nell'ambiente, valutati dal modello di ricompensa e i gradienti risultanti vengono utilizzati per aggiornare la policy.
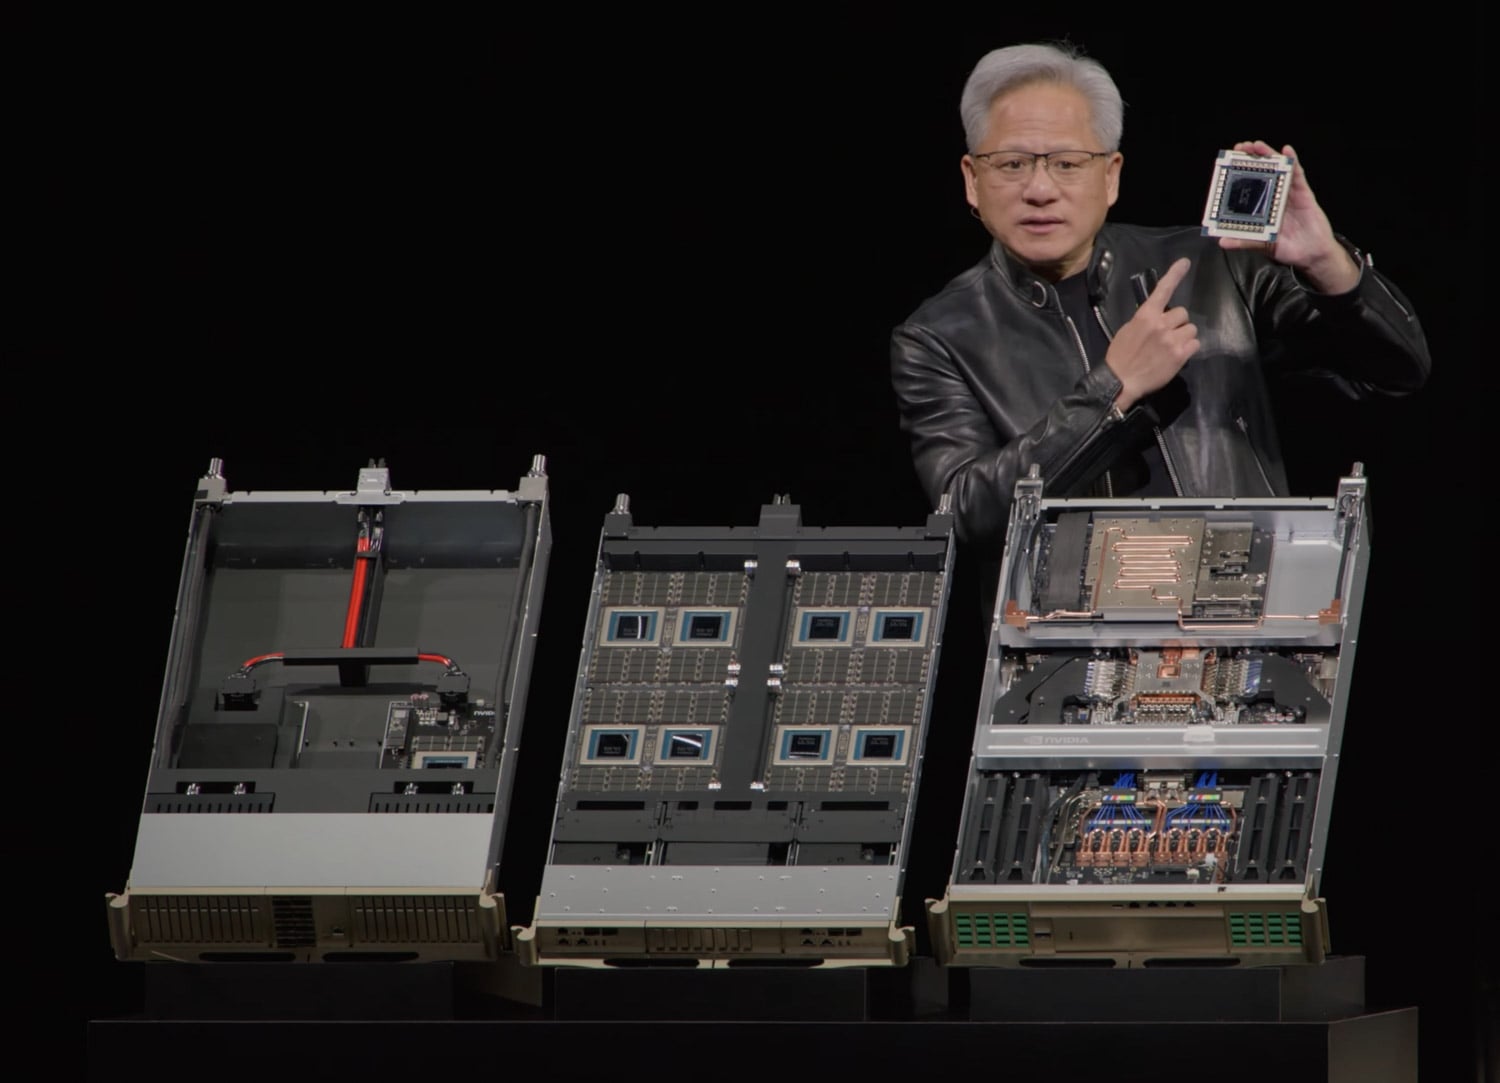
Per i carichi di lavoro di IA agentiva, questo ambiente di apprendimento per rinforzo non è una simulazione astratta, bensì un vero e proprio ambiente di test computazionale. Si consideri, ad esempio, il post-addestramento di un modello di codifica agentiva con strumenti come Claude Code o agenti di codifica autonomi simili. In questo contesto, sono necessari tre distinti pool di calcolo che operano simultaneamente. In primo luogo, un pool di addestramento composto da acceleratori GPU che aggiornano i pesi del modello di policy. In secondo luogo, gli acceleratori di inferenza eseguono il checkpoint corrente del modello di policy per generare azioni candidate (modifiche al codice, chiamate a strumenti, operazioni sui file) su larga scala. In terzo luogo, e aspetto fondamentale, un ampio pool di calcolo CPU convenzionale in cui vengono eseguiti gli ambienti di apprendimento per rinforzo veri e propri. In questi ambienti, gli agenti eseguono il codice generato, effettuano suite di test, chiamano strumenti, inviano query SQL, compilano file binari, interagiscono con i file system ed eseguono tutte le operazioni di test che producono i segnali di ricompensa che alimentano il ciclo di addestramento.
La portata di questo requisito di calcolo convenzionale è considerevole. Ogni esecuzione del modello di policy può innescare decine di chiamate sequenziali agli strumenti, ognuna delle quali deve essere eseguita, valutata e restituita prima che il passaggio successivo possa procedere. Quando si generano migliaia di punti dati in parallelo durante l'esecuzione dell'addestramento, è necessaria un'enorme flotta di CPU veloci per evitare che il cluster di addestramento GPU si blocchi a causa dell'esecuzione dell'ambiente. Qualsiasi latenza nel pool sandbox della CPU si traduce direttamente in cicli GPU inattivi e spreco di risorse di calcolo per l'addestramento. La stessa dinamica si applica in fase di inferenza per i sistemi agentici distribuiti. Ogni chiamata di strumento, compilazione di codice ed esecuzione sandbox effettuata da un agente è un lavoro della CPU che deve essere completato abbastanza rapidamente da mantenere reattiva l'intera pipeline agentica. Come affermato nei comunicati stampa di NVIDIA, la CPU non si limita più a supportare il modello; lo sta guidando.
Il rack per CPU Vera: la risposta di NVIDIA
Per soddisfare questo requisito, NVIDIA ha lanciato la CPU Vera, che l'azienda definisce il primo processore al mondo progettato specificamente per l'era dell'IA agentiva e dell'apprendimento per rinforzo. Il Vera CPU Rack è un sistema dedicato su scala rack contenente 256 processori Vera raffreddati a liquido, in grado di supportare oltre 22,500 ambienti CPU simultanei, ciascuno dei quali funziona in modo indipendente a pieno regime. Le "fabbriche" di IA possono implementare e scalare rapidamente fino a decine di migliaia di istanze simultanee e strumenti agentivi in un singolo rack. Il rack offre 400 TB di memoria totale, 300 TB/s di larghezza di banda di memoria aggregata e 64 DPU BlueField-4, tutte compatibili con gli ecosistemi Vera Rubin e DGX e basate sull'architettura di riferimento modulare NVIDIA MGX.
La CPU Vera è basata su 88 core Olympus progettati su misura da NVIDIA, con piena compatibilità con Armv9.2. Ogni core supporta due attività simultanee grazie alla tecnologia NVIDIA Spatial Multithreading. Il sottosistema di memoria a basso consumo di seconda generazione è basato su LPDDR5X e offre una larghezza di banda fino a 1.2 TB/s, il doppio rispetto alle CPU generiche, con un consumo energetico dimezzato.
Oltre alle caratteristiche prestazionali, Vera Rack affronta anche un problema pratico della catena di fornitura: le organizzazioni che gestiscono ambienti di intelligenza artificiale con decine di migliaia di GPU necessitano di flotte altrettanto ingenti di CPU per l'esecuzione degli ambienti, e reperire tale volume di processori x86 ad alte prestazioni da AMD o Intel, nelle dimensioni e nei tempi richiesti, può comportare notevoli difficoltà di approvvigionamento e disponibilità. Un rack di CPU NVIDIA integrato verticalmente semplifica questa dipendenza.
Tra i clienti che collaborano con NVIDIA per implementare la CPU Vera figurano Alibaba, ByteDance, Meta e Oracle Cloud Infrastructure, nonché CoreWeave, Crusoe, Lambda, Nebius, Nscale, Cloudflare, Together AI e Vultr. I partner di produzione includono Dell Technologies, HPE, Lenovo, Supermicro, ASUS, Cisco, Foxconn, GIGABYTE e QCT, tra gli altri.
BlueField-4 STX e NVIDIA CMX: l'architettura di riferimento alla base dell'archiviazione della memoria del contesto di inferenza.
Al CES 2026, NVIDIA ha annunciato la piattaforma Inference Context Memory Storage (ICMS), una nuova classe di infrastrutture di storage native per l'IA, progettate specificamente per la gestione della cache KV nell'inferenza LLM su larga scala. Al GTC 2026, NVIDIA ha presentato l'architettura di riferimento che la alimenta: BlueField-4 STX, un design modulare che estende senza soluzione di continuità la memoria GPU all'interno del pod per il contesto agentivo e i dati della cache KV. La prima implementazione su scala rack di STX è la nuova piattaforma di storage di memoria di contesto NVIDIA CMX, che espande la memoria GPU con un livello di contesto ad alte prestazioni per sistemi di inferenza e agentivi scalabili.
La necessità di un livello di archiviazione dedicato diventa evidente quando si esamina la scalabilità dell'inferenza basata su transformer. Ogni token generato deve prestare attenzione a tutti i token precedenti tramite il meccanismo di attenzione, e la cache chiave-valore (KV) memorizza matrici di attenzione precalcolate per il riutilizzo, evitando il ricalcolo. Il problema è che la dimensione della cache KV cresce con la lunghezza della sequenza e la dimensione del batch. In ambienti multi-tenant che gestiscono migliaia di richieste simultanee su finestre di contesto da milioni di token, la memoria HBM delle GPU si esaurisce. Gli operatori devono ridurre le dimensioni dei batch, accorciare le finestre di contesto o aggiungere più GPU, tutte soluzioni che compromettono l'efficienza o le prestazioni.
Il BlueField-4 STX risolve questo problema fornendo un livello di storage condiviso ad alta larghezza di banda, progettato specificamente per i modelli di accesso alla cache KV, che si interpone tra la memoria HBM della GPU e lo storage convenzionale. È accelerato dalla piattaforma Vera Rubin e sfrutta un processore BlueField-4 ottimizzato per lo storage che combina la CPU Vera con ConnectX-9 SuperNIC, insieme alla rete Ethernet Spectrum-X, NVIDIA DOCA e al software NVIDIA AI Enterprise. NVIDIA afferma che la piattaforma CMX offre fino a 5 volte più token al secondo rispetto allo storage tradizionale, 4 volte più efficienza energetica rispetto alle architetture CPU tradizionali per lo storage ad alte prestazioni e 2 volte più veloce l'acquisizione dei dati per i dati AI aziendali.
NVIDIA introduce anche DOCA Memos, un nuovo framework DOCA che potenzia lo storage BlueField-4 con l'elaborazione dedicata della cache KV per aumentare la velocità di inferenza e migliorare significativamente l'efficienza energetica. Il risultato è un contesto a livello di POD che offre interazioni multi-turno più rapide con gli agenti AI, servizi AI più scalabili e un utilizzo complessivo dell'infrastruttura più elevato. Questo si collega al progetto open source NVIDIA Dynamo, che fornisce il framework software per fasi di pre-riempimento/decodifica disaggregate, routing intelligente e offload dello storage a livelli.
STX è un'architettura di riferimento che NVIDIA non vende direttamente, ma fornisce ai partner dell'ecosistema di storage. Tra i fornitori di storage che collaborano alla progettazione di infrastrutture di nuova generazione su STX figurano Cloudian, DDN, Dell Technologies, Everpure, Hitachi Vantara, HPE, IBM, MinIO, NetApp, Nutanix, VAST Data e WEKA. I partner produttori che realizzano sistemi basati su STX includono AIC, Supermicro e QCT. Tra i principali laboratori di intelligenza artificiale e fornitori di servizi cloud che prevedono di adottare STX per lo storage della memoria di contesto si annoverano CoreWeave, Crusoe, IREN, Lambda, Mistral AI, Nebius, Oracle Cloud Infrastructure e Vultr. Le piattaforme basate su STX saranno disponibili presso i partner nella seconda metà del 2026.
Vera Rubin DSX AI Factory Reference Design e Omniverse DSX Blueprint
Oltre ai singoli rack e pod, NVIDIA ha annunciato il design di riferimento Vera Rubin DSX AI Factory e la disponibilità generale di NVIDIA Omniverse DSX Blueprint, che insieme forniscono un framework completo per la progettazione, la costruzione e la gestione di infrastrutture AI co-progettate che massimizzano i token per watt e accelerano il time to first production. Grazie alla stretta integrazione di elaborazione, rete, storage, alimentazione e raffreddamento, l'architettura aumenta l'efficienza energetica e garantisce che le fabbriche AI possano scalare in modo affidabile sotto carichi di lavoro continui e ad alta intensità, mantenendo al contempo la massima disponibilità.
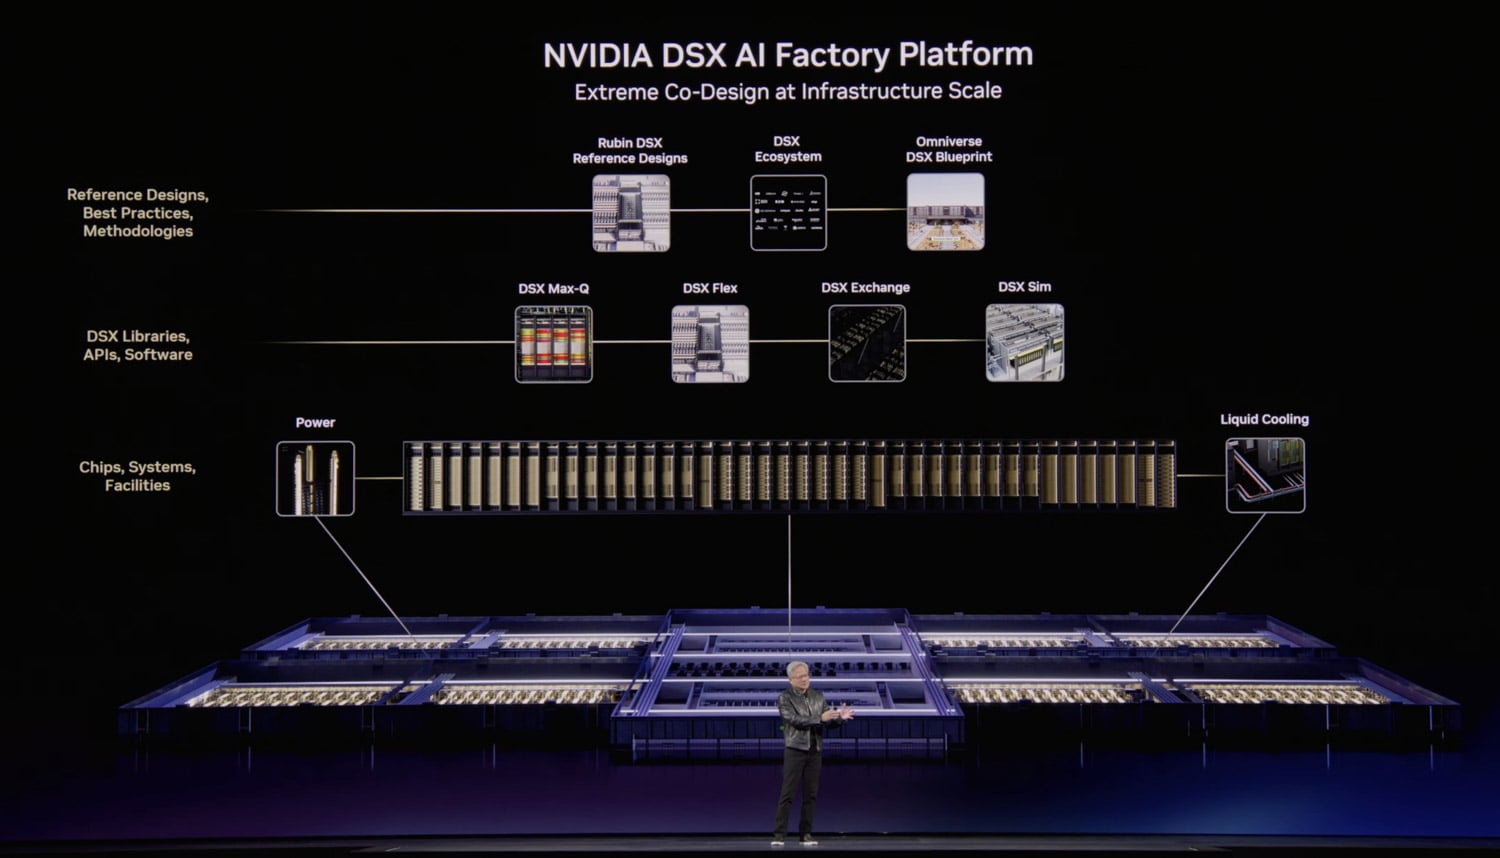
Lo stack software Rubin DSX è aperto, modulare e componibile, e collega l'hardware del cluster con i sistemi di alimentazione e raffreddamento. Include diverse librerie di componenti: DSX Max-Q consente il provisioning dinamico dell'alimentazione per l'intera AI factory, permettendo l'implementazione del 30% in più di infrastrutture AI all'interno di un data center a potenza fissa. DSX Flex consente alle AI factory di diventare risorse flessibili rispetto alla rete elettrica, sbloccando, secondo le stime di NVIDIA, 100 gigawatt di energia elettrica inutilizzata, una capacità fondamentale dato che l'energia rappresenta attualmente il principale collo di bottiglia per la realizzazione di infrastrutture AI, con oltre 300 miliardi di dollari di arretrati di apparecchiature e più di 200 GW di progetti in attesa di interconnessione negli Stati Uniti. DSX Exchange consente l'integrazione scalabile e sicura di segnali di calcolo, rete, energia, alimentazione e raffreddamento tra IT, tecnologia operativa e operatori. I modelli DSX Sim convalidano le AI factory come gemelli digitali ad alta fedeltà utilizzando la piattaforma NVIDIA DSX Air.
Il progetto Omniverse DSX Blueprint, ora disponibile su build.nvidia.com e pienamente compatibile con il design di riferimento Vera Rubin DSX, consente agli sviluppatori di creare gemelli digitali fisicamente accurati delle proprie fabbriche di intelligenza artificiale, simulare le operazioni in tempo reale e ottimizzare le prestazioni prima dell'inizio della costruzione o dell'implementazione. Questo unifica alimentazione, raffreddamento, rete e gestione in un unico ambiente per accelerare il time-to-revenue e l'efficienza dell'IA.
Tra i leader del settore che contribuiscono all'architettura e al progetto DSX figurano Cadence, Dassault Systèmes, Eaton, Jacobs, Nscale, Phaidra, Procore Technologies, PTC, Schneider Electric, Siemens, Switch, Trane Technologies e Vertiv. In particolare, Nscale e Caterpillar stanno implementando i progetti di riferimento DSX Vera Rubin in West Virginia, in un sito multigigawatt descritto come una delle più grandi fabbriche di intelligenza artificiale al mondo. Sul fronte energetico, Emerald AI, GE Vernova, Hitachi e Siemens Energy stanno utilizzando l'architettura di riferimento DSX per sbloccare la capacità della rete e fornire l'energia necessaria per la realizzazione di nuove fabbriche di intelligenza artificiale. Phaidra ha integrato DSX Max-Q in un agente di intelligenza artificiale autoapprendente che offre circa il 10% di potenza di calcolo in più, riducendo i picchi di raffreddamento e mantenendo la sicurezza.
NVIDIA Agent Toolkit e OpenCLAW: lo stack software per agenti autonomi
Il TC 2026 ha inoltre messo in luce la rapida ascesa dei carichi di lavoro di IA agentica, con NVIDIA che ha descritto gli agenti autonomi come il carico di lavoro in più rapida crescita che l'azienda abbia mai visto. Al centro degli annunci software c'era OpenCLAW, descritto come probabilmente la singola release software più importante della storia e un framework di orchestrazione per agenti autoevolutivi a lunga esecuzione chiamati CLAW, sistemi autonomi in grado di pianificare, agire ed eseguire intere missioni anziché singoli compiti. NVIDIA ha definito i CLAW come il nuovo livello applicativo per l'IA, osservando che siamo passati dal chiedere "cosa, come o perché" al chiedere "costruisci, crea o realizza".
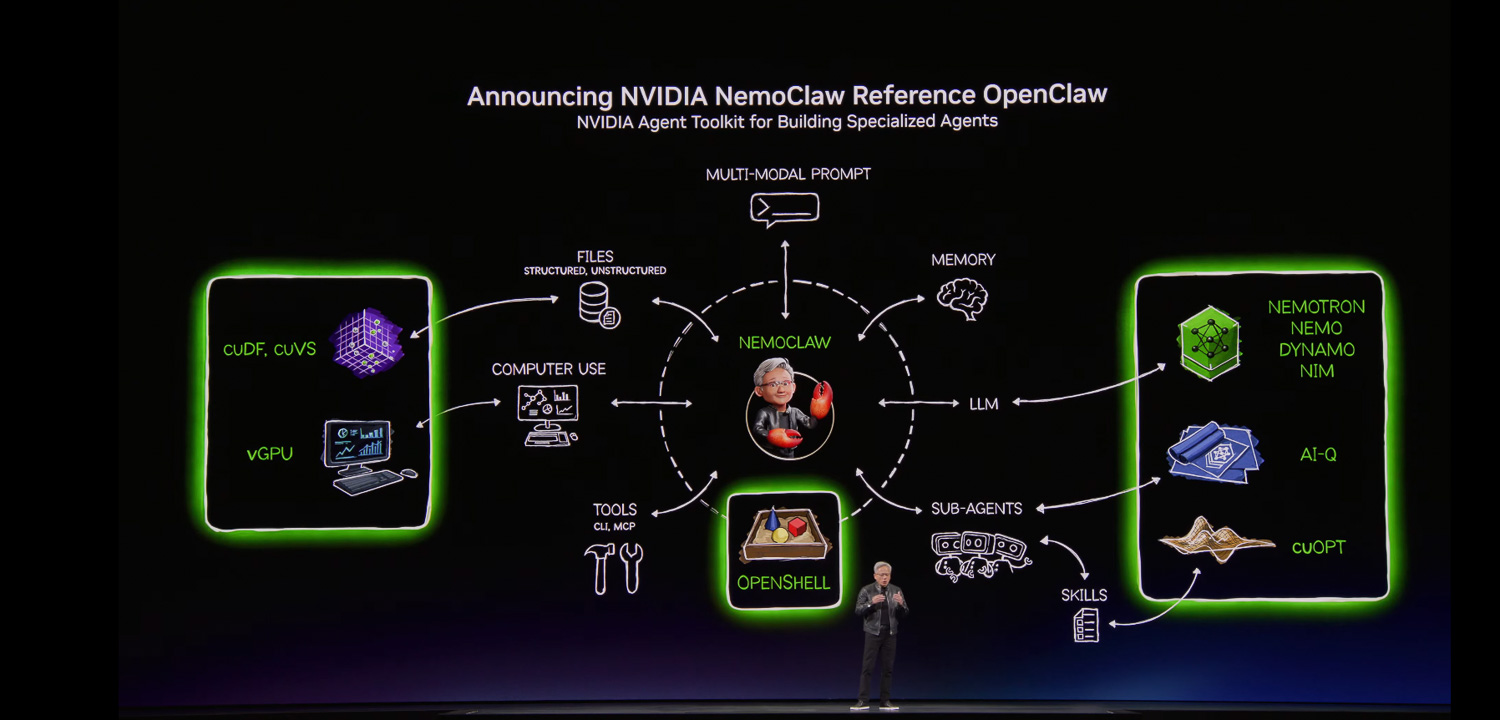
NVIDIA ha annunciato NVIDIA Agent Toolkit, una raccolta completamente open-source di modelli, runtime e blueprint per la creazione, la valutazione e l'ottimizzazione di agenti autonomi a lunga esecuzione. I componenti chiave includono i modelli aperti Nemotron per il ragionamento, la codifica e il parlato; Nemo per la profilazione e la personalizzazione degli agenti; NIM per l'inferenza dei modelli; e Dynamo 1.0 per la distribuzione su larga scala. Tra le nuove aggiunte figurano NVIDIA OpenShell, un runtime open-source per la sicurezza che fornisce protezioni di rete, privacy e sicurezza basate su policy per l'esecuzione degli agenti, e IQ, un blueprint open-source che combina l'intelligenza di frontiera e l'intelligenza basata su modelli aperti per agenti di deep learning, il primo sistema di ricerca a raggiungere la vetta sia del benchmark Deep Research Bench 1 che del benchmark Complex Deep Research Bench 2. Una nuova skill cuOPT offre competenze nella risoluzione di problemi di ottimizzazione descritti in linguaggio naturale.
NVIDIA ha inoltre annunciato Nemo CLAW, il suo contributo alla comunità OpenCLAW, sviluppato in collaborazione con Peter Steinberger, uno dei creatori di OpenCLAW. Nemo CLAW installa OpenCLAW, insieme ai modelli Nemotron e al runtime OpenShell, con un singolo comando, fornendo una base per lo sviluppo e l'apprendimento di nuove competenze da parte degli agenti, operando nel rispetto di rigidi parametri di privacy e sicurezza. Può essere eseguito su qualsiasi piattaforma, dalle infrastrutture cloud ai PC RTX on-premise, DGX Station e DGX Spark.
DGX Spark e DGX Station: piattaforme di sviluppo CLAW locali
Consapevole che molti sviluppatori preferiscono ambienti di sviluppo locali con il pieno controllo delle proprie risorse di calcolo, NVIDIA ha introdotto due nuove piattaforme, progettate specificamente per lo sviluppo di agenti CLAW. DGX Spark è una piattaforma ad alte prestazioni ed efficiente dal punto di vista energetico per l'esecuzione di agenti autonomi sicuri e sempre attivi, e i sistemi DGX Spark e quelli dei partner OEM basati su GB10 sono ora disponibili a livello globale. DGX Station, posizionata come la piattaforma di sviluppo CLAW locale definitiva, consente agli sviluppatori di eseguire modelli con intelligenza di livello avanzato interamente in locale, senza connettività cloud, aspetto fondamentale per lo sviluppo, dove tutto rimane locale per garantire il controllo e la sicurezza completi. I sistemi DGX Station sono disponibili per l'ordine presso i partner OEM a partire dal 16 marzo 2026.
Vera Rubin Space Modules: Infrastruttura di intelligenza artificiale oltre la Terra
NVIDIA ha annunciato che le sue più recenti piattaforme di calcolo accelerato stanno inaugurando una nuova era di innovazione spaziale, portando la potenza di calcolo per l'intelligenza artificiale nei centri dati orbitali (ODC), nell'intelligence geospaziale e nelle operazioni spaziali autonome. Il modulo spaziale NVIDIA Vera Rubin offre una potenza di calcolo per l'IA fino a 25 volte superiore rispetto alla GPU NVIDIA H100, consentendo a modelli linguistici di grandi dimensioni e modelli di base avanzati di operare direttamente in orbita. La sua architettura CPU-GPU strettamente integrata fornisce le prestazioni e la memoria necessarie per elaborare enormi flussi di dati provenienti da strumenti spaziali in tempo reale.
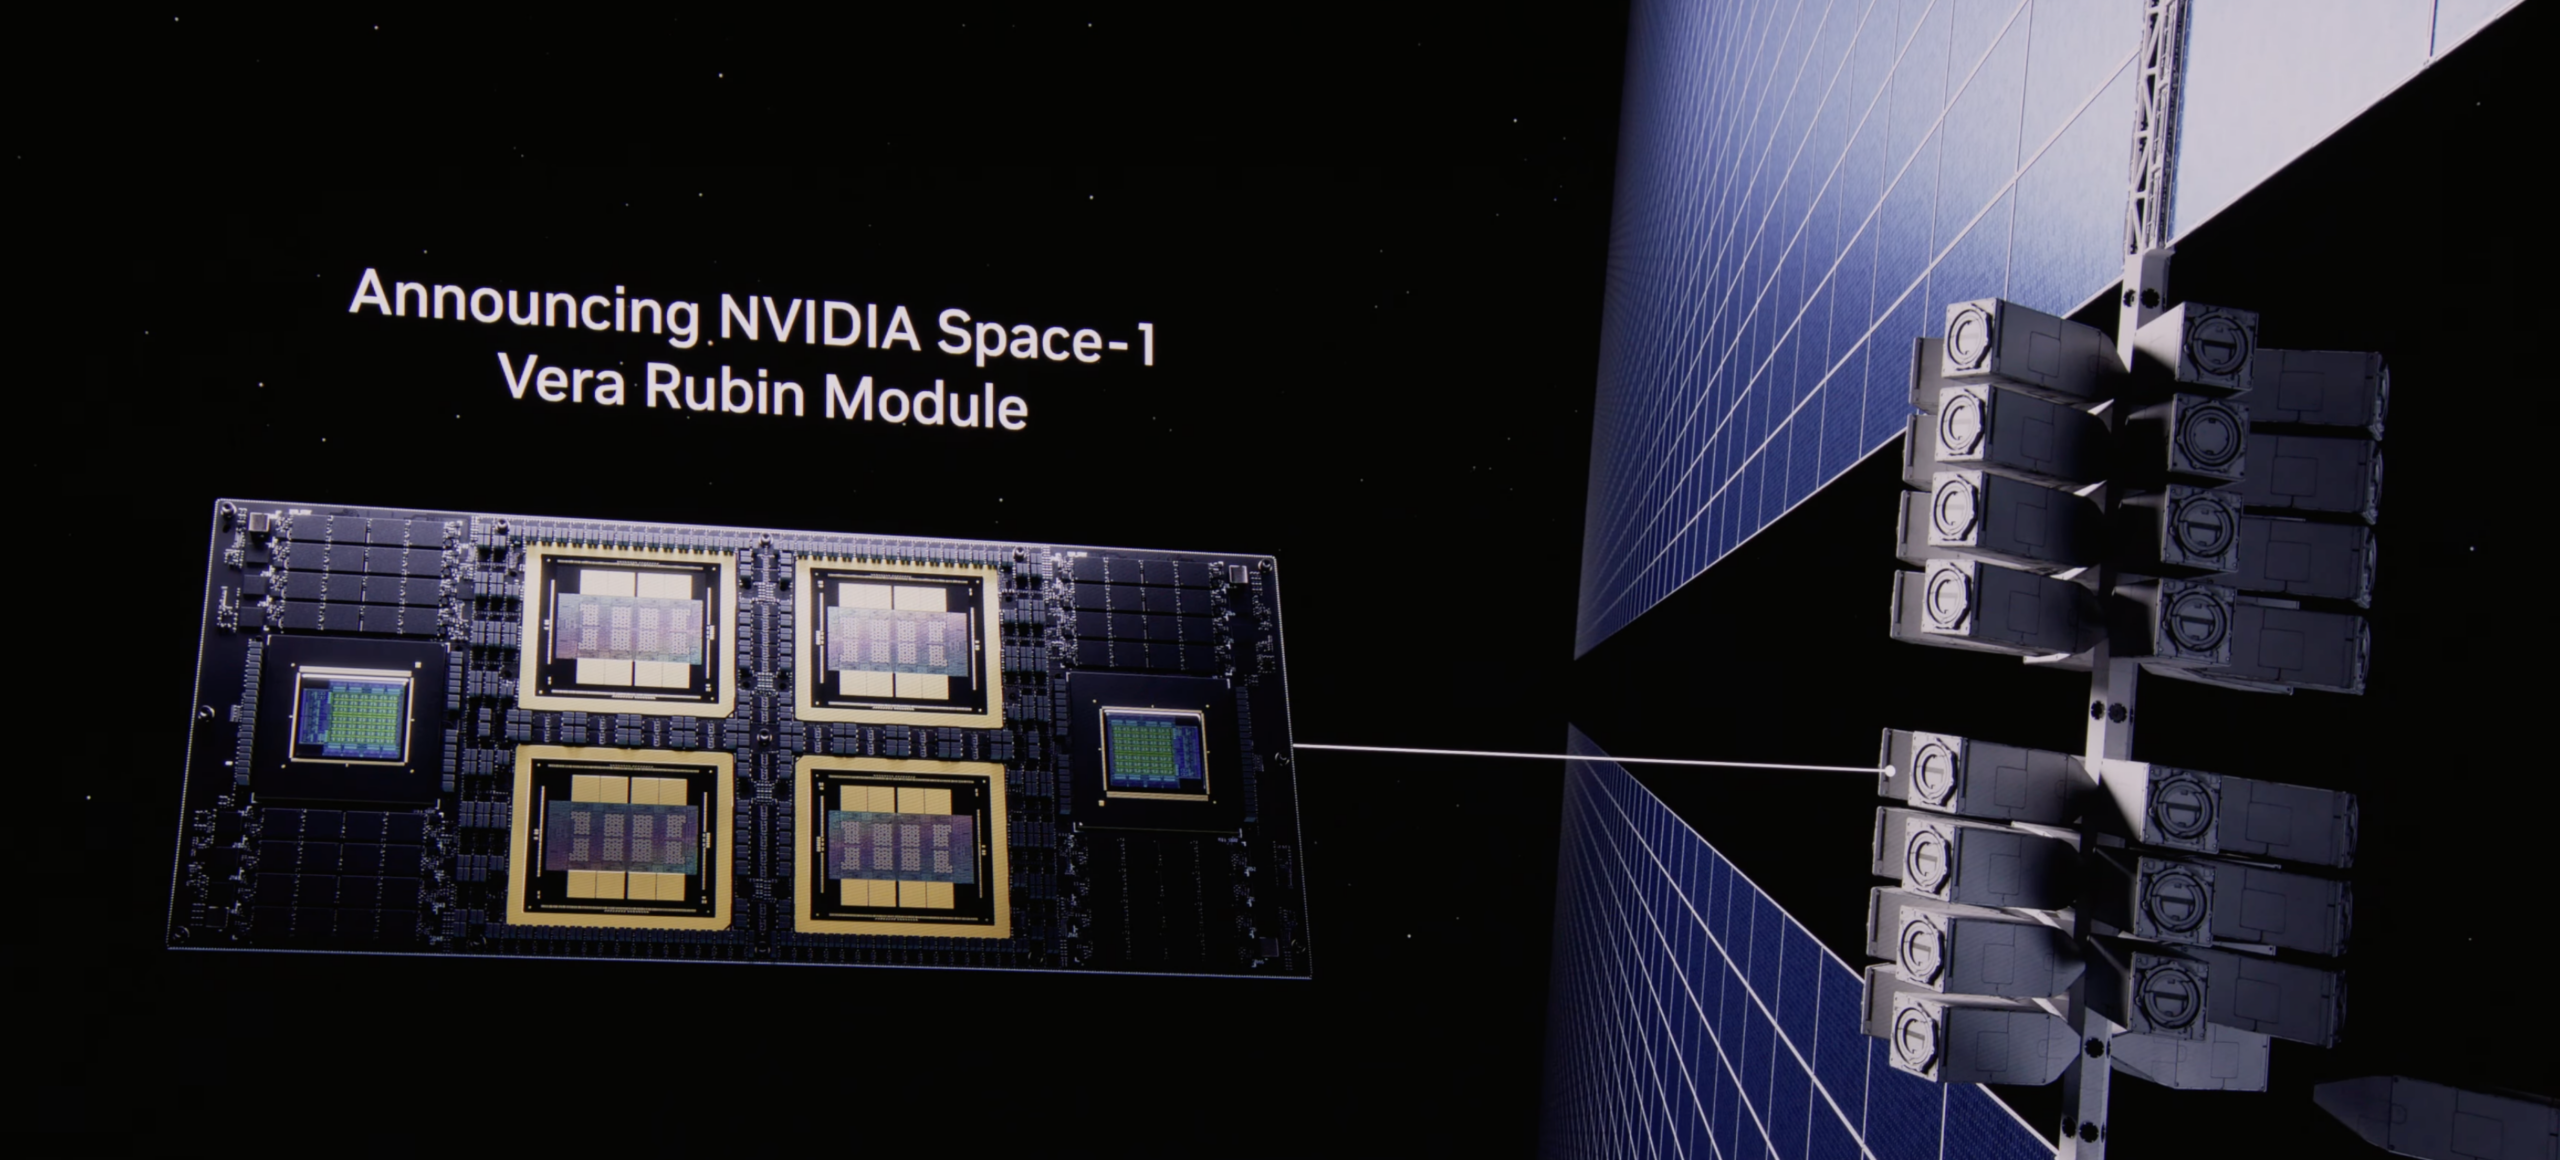
Insieme al modulo spaziale Vera Rubin, NVIDIA IGX Thor offre una robustezza di livello industriale per ambienti edge mission-critical in orbita, mentre Jetson Orin fornisce inferenze AI ad alte prestazioni in un modulo ultracompatto ottimizzato per veicoli spaziali con vincoli di dimensioni, peso e consumo energetico (SWaP). A terra, la GPU RTX PRO 6000 Blackwell Server Edition offre prestazioni fino a 100 volte superiori rispetto ai sistemi batch basati su CPU tradizionali per l'elaborazione di informazioni geospaziali. Partner come Aetherflux, Axiom Space, Kepler Communications, Planet Labs, Sophia Space e Starcloud stanno sviluppando su queste piattaforme le missioni spaziali di prossima generazione, che spaziano dai data center orbitali alle operazioni spaziali autonome e all'osservazione della Terra in tempo reale.
NVIDIA Dynamo 1.0: Il sistema operativo di inferenza per le fabbriche di intelligenza artificiale
A conclusione degli annunci del GTC 2026, NVIDIA ha avviato la produzione del software open-source Dynamo 1.0, che l'azienda presenta come il primo sistema operativo distribuito per l'inferenza AI factory. Proprio come il sistema operativo di un computer coordina hardware e applicazioni, Dynamo 1.0 funge da livello di orchestrazione distribuito per le AI factory, gestendo in modo trasparente le risorse GPU e di memoria nell'intero cluster per supportare carichi di lavoro AI complessi ed eterogenei su larga scala.
Dynamo 1.0 suddivide il lavoro di inferenza tra le GPU con un routing intelligente e la capacità di spostare i dati tra le GPU e i livelli di storage a basso costo, riducendo i calcoli superflui e alleviando i vincoli di memoria. Per l'IA agentiva e i carichi di lavoro a lungo termine, Dynamo può instradare le richieste alle GPU che già contengono i dati della cache KV più rilevanti provenienti dalle fasi precedenti, quindi liberare tale memoria quando non è necessaria, una funzionalità che si integra direttamente con l'architettura di storage BlueField-4 STX/ICMS. In recenti benchmark di settore, Dynamo ha aumentato le prestazioni di inferenza delle GPU NVIDIA Blackwell fino a 7 volte, riducendo il costo del token e aumentando le opportunità di guadagno per milioni di GPU implementate, il tutto con software gratuito e open source.
NVIDIA sta accelerando l'ecosistema open-source integrando le ottimizzazioni di Dynamo e TensorRT-LLM nei framework di inferenza più diffusi, tra cui LangChain, llm-d, LMCache, SGLang e vLLM. I componenti principali di Dynamo, KVBM per la gestione della memoria, NIXL per il trasferimento rapido dei dati da GPU a GPU e Grove per la scalabilità semplificata, sono disponibili anche come moduli autonomi. NVIDIA contribuisce inoltre al progetto FlashInfer con i kernel CUDA di TensorRT-LLM per l'integrazione nativa nei framework open-source.
L'ampiezza dell'adozione è notevole. La piattaforma di inferenza NVIDIA è ora integrata con i provider di cloud, tra cui AWS, Microsoft Azure, Google Cloud e Oracle Cloud Infrastructure, nonché con i partner cloud di NVIDIA come Alibaba Cloud, CoreWeave, Crusoe, DigitalOcean, Nebius, Nscale e Together AI. Aziende native dell'IA come Cursor, Hebbia e Perplexity hanno adottato la piattaforma, così come i provider di endpoint di inferenza Baseten, Deep Infra e Fireworks. Aziende globali come Amazon, AstraZeneca, BlackRock, ByteDance, Coupang, Instacart, Meituan, PayPal, Pinterest, Shopee e SoftBank Corp. hanno adottato lo stack di inferenza NVIDIA. Dynamo 1.0 è disponibile da oggi per gli sviluppatori di tutto il mondo.


 Amazon