

Alla GTC di Berlino, NVIDIA ha annunciato Minerva, una piattaforma AIOps che raccoglie dati di telemetria da GPU, reti, storage, scheduler e carichi di lavoro di intelligenza artificiale in esecuzione su di essi, applicando poi l'apprendimento automatico per individuare un componente che si sta deteriorando prima che rallenti un processo di addestramento. Dell Technologies, Lenovo e Supermicro la offriranno nei loro portfolio di soluzioni per le operazioni di fabbrica basate sull'IA, IREN la sta già utilizzando e IBM, Jio, Lambda, Quake AI, Tesla, Aolani e Bitdeer AI prevedono di implementarla. NVIDIA non ha ancora pubblicato informazioni su prezzi o una data di disponibilità generale.
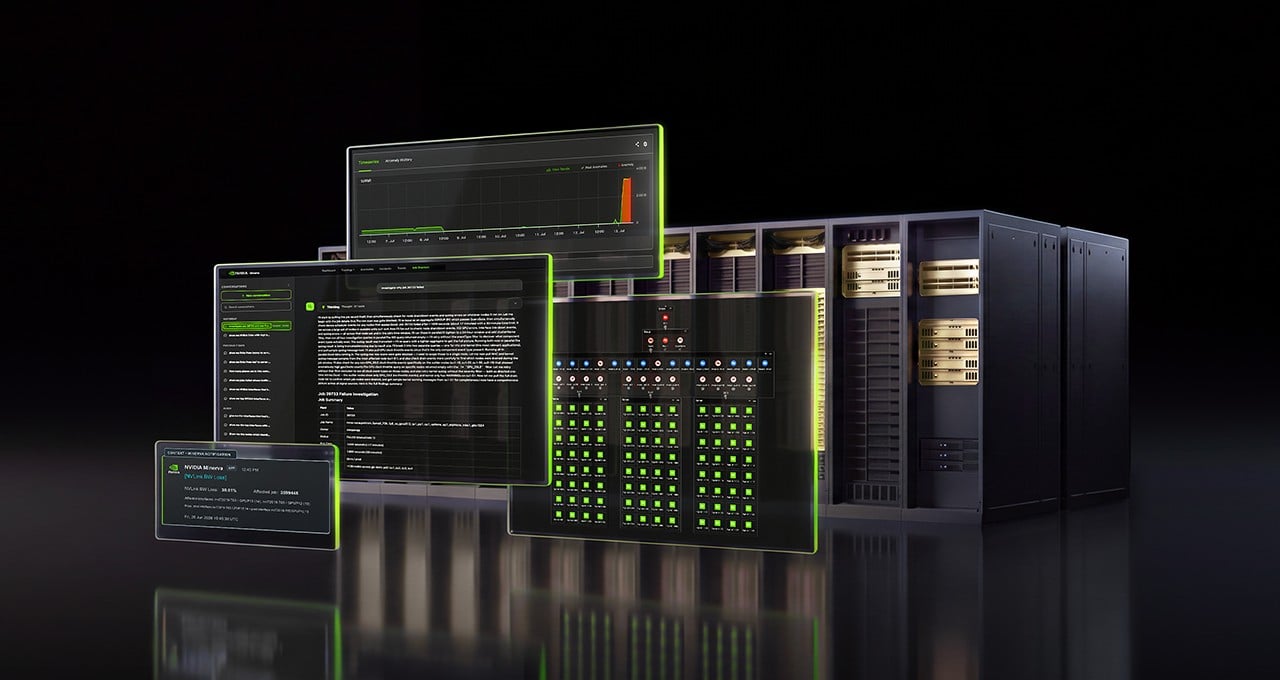
Il problema che Minerva intende risolvere è ben noto a tutti gli operatori di grandi cluster: migliaia di GPU su una rete ad alta velocità si comportano come un'unica macchina, quindi un singolo componente che non soddisfa le specifiche trascina con sé l'intero carico di lavoro. Gli esempi forniti da NVIDIA includono una GPU che si surriscalda più delle altre e un'unità NVMe che perde prestazioni sotto carico: si tratta di dati che oggi si trovano in strumenti di rete, strumenti di calcolo e dashboard di team di machine learning, ognuno con una visualizzazione separata dello stesso cluster.
Cosa guarda Minerva
Minerva crea un grafo di conoscenza dinamico che mappa GPU, SuperNIC, switch, cavi e i processi programmati su di essi, quindi analizza quelli che NVIDIA definisce miliardi di punti dati all'ora con l'apprendimento automatico supervisionato e non supervisionato. I modelli apprendono il comportamento normale dello stabilimento, segnalano anomalie mai viste prima, prevedono guasti in fase di sviluppo e correlano eventi correlati utilizzando la topologia, in modo che un processo di addestramento lento possa essere ricondotto al componente responsabile in stabilimenti NVIDIA che arrivano a centinaia di migliaia di GPU.
L'output è organizzato in incidenti, con gli eventi correlati raggruppati in un unico elemento e corredato da una probabile causa principale. Secondo NVIDIA, questo sistema sostituisce una valanga di avvisi con un unico elemento su cui intervenire. Un assistente integrato risponde a domande in linguaggio naturale basandosi sui dati di telemetria in tempo reale e suggerisce una soluzione. La piattaforma si connette inoltre a strumenti esterni. Gli operatori possono scegliere se la correzione debba essere applicata manualmente o se Minerva debba automatizzarla tramite API infrastrutturali e sistemi esterni.
NVIDIA inquadra i vantaggi come rendimento della "fabbrica di IA", misurato in ore GPU, produttività effettiva, tempo di attività del cluster e produzione di token. I risultati dichiarati includono intervalli più lunghi tra le interruzioni, riparazioni più rapide e un minor numero di avvisi da gestire, con il team operativo che passa da una manutenzione reattiva a una proattiva. Si tratta di affermazioni del fornitore senza dati concreti; NVIDIA non ha pubblicato i dati relativi al tempo medio di riparazione o al tempo di attività per Minerva.
Dove si trova nella pila
NVIDIA vende già software operativo per i suoi progetti di riferimento. Mission Control , introdotto a marzo 2025, gestisce il provisioning dei cluster tramite Base Command Manager, la gestione dei carichi di lavoro tramite Run:ai, la telemetria e il ripristino autonomo dei job per i sistemi DGX SuperPOD. Nella stessa settimana di Minerva, NVIDIA ha rilasciato in anteprima per sviluppatori tre componenti open source di DSX OS per la gestione del ciclo di vita delle fabbriche di intelligenza artificiale: Config Manager per la configurazione di rete, Rack Management Service per la gestione di alimentazione, inventario, firmware e switch a livello di rack e Cluster Readiness Engine per la convalida dei cluster GPU con carichi di lavoro distribuiti.
La portata del problema che Minerva intende risolvere è stata ben illustrata nella relazione di Meta su Prometheus pubblicata la scorsa settimana. Meta esegue ogni dominio NVL72 come una slice da 64 GPU, con le altre otto GPU tenute come riserva nei rack, mantiene circa il 2% dei rack in riserva e mette in quarantena ogni sistema riparato fino al superamento della validazione. Un anno di lavoro sulle cause principali con gli ingegneri NVIDIA in loco ha ridotto le interruzioni del 99% e ha portato il tempo medio tra le interruzioni a oltre 54,000 ore GPU, con un obiettivo di 100,000.
Si tratta di un hyperscaler che utilizza una pipeline di telemetria appositamente progettata e un team di triage congiunto con NVIDIA. Minerva sembra essere una versione preconfezionata di questa disciplina, qualcosa di più simile a una soluzione pronta all'uso per un'azienda o un neocloud che desidera una visibilità di livello hyperscaler sullo stato di salute di GPU, fabric e storage, nonché il flusso di lavoro di ripristino e sostituzione che ne consegue, fornito dagli stessi OEM che vendono i rack.
NVIDIA non ha specificato in che modo Minerva si integri con Mission Control o DSX OS, se venga distribuito come software, appliance o servizio in hosting, né quale sarà l'aspetto del packaging OEM per Dell, Lenovo e Supermicro. La pagina della documentazione del prodotto indirizza i clienti al proprio team di account NVIDIA per ottenere la guida utente. Il cliente di riferimento è IREN, che secondo NVIDIA utilizza Minerva per ottimizzare le proprie "fabbriche" di intelligenza artificiale.
"NVIDIA Minerva offre al nostro team operativo una visione unificata dell'intera rete, delle GPU e dei processi in esecuzione su di esse", ha affermato Denis Skrinnikoff, direttore tecnologico di IREN, che ha attribuito a questa soluzione il merito di aver permesso al team di dedicare più tempo alla manutenzione proattiva.
Per quanto riguarda lo storage, l'aspetto interessante è che il comportamento delle unità sotto carico viene utilizzato come input, insieme alla telemetria della GPU e della rete, poiché un dispositivo NVMe che rallenta raramente si riflette nell'utilizzo della GPU fino a quando non si blocca un checkpoint o una fase di caricamento dati. Sarà interessante approfondire, con l'arrivo sul mercato di questa soluzione, quanto sia approfondita la telemetria dello storage e quali piattaforme OEM e di array la alimentino.



 Amazon