

Oggi Pivotal Software Inc. ha annunciato importanti aggiornamenti alla sua Pivotal Big Data Suite. I nuovi aggiornamenti includono aggiornamenti alla distribuzione Pivotal HD Apache Hadoop e Pivotal dichiara un miglioramento delle prestazioni fino a 100 volte per le sue soluzioni di analisi, incluso Pivotal Greenplum Database. I nuovi aggiornamenti hanno lo scopo di aiutare i clienti a gestire set di dati in espansione guidati da dispositivi mobili, cloud, social e Internet of Things e ad affrontare le query più complesse su questi set di dati con velocità, scala e flessibilità senza precedenti.
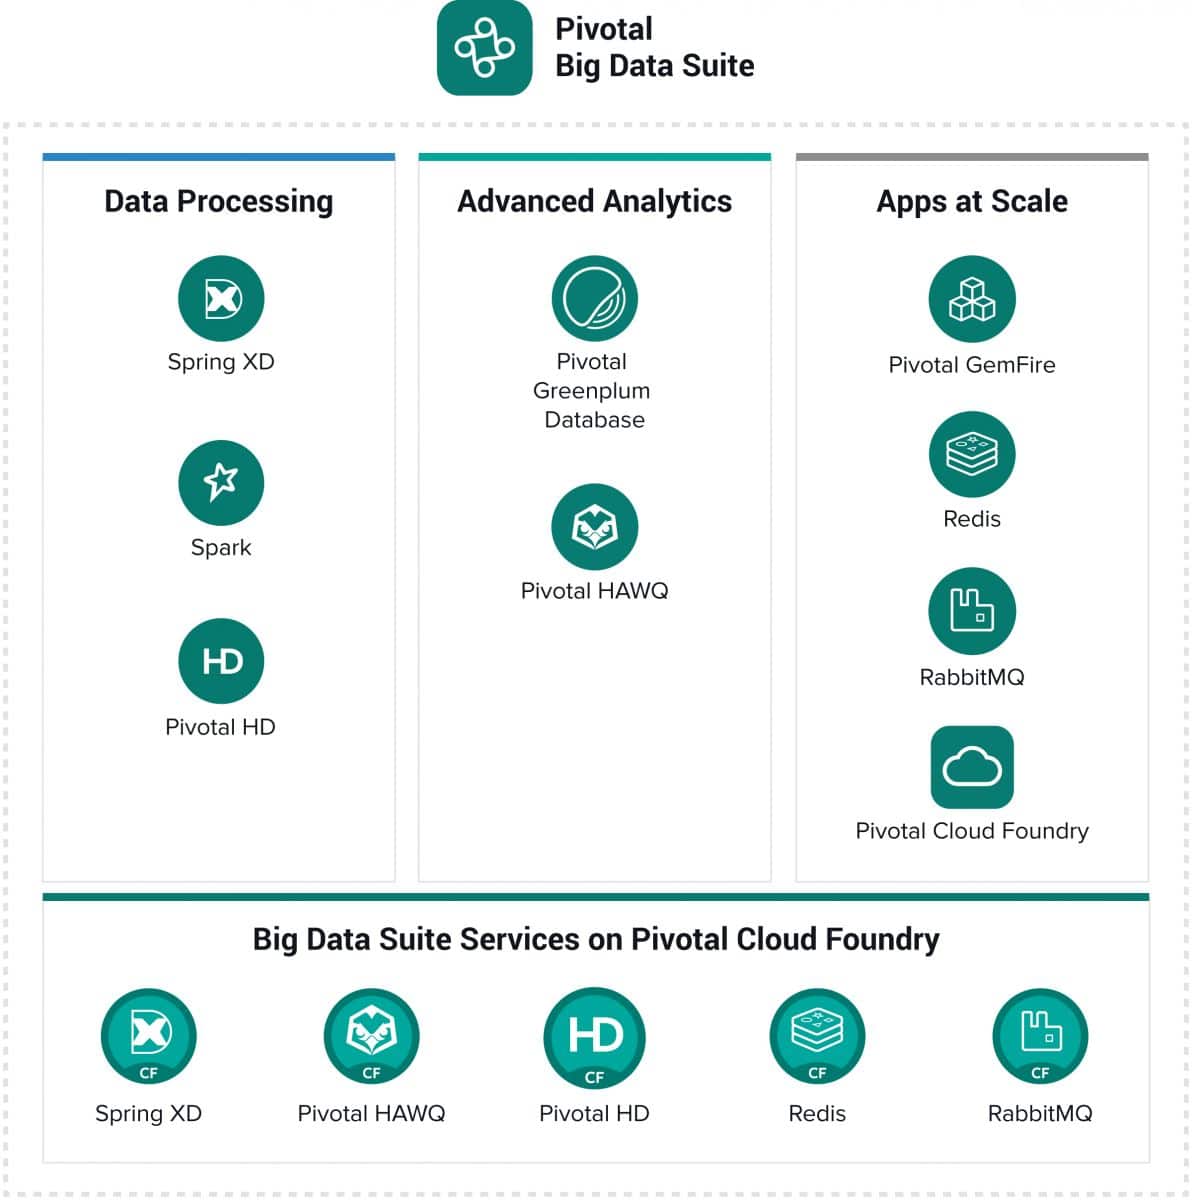
Le aziende moderne devono essere in grado di padroneggiare i Big Data, le metodologie agili e le applicazioni cloud native. È qui che entra in gioco Pivotal Big Data Suite. Basata su un modello di abbonamento e ancorata al software open source, Big Data Suite è progettata per ampliare e supportare approcci nuovi ed esistenti alle architetture dei dati. I clienti ottengono tutte le funzionalità di elaborazione dati, analisi e applicazioni di cui hanno bisogno per ottenere informazioni migliori in un'unica suite. Pivotal Big Data Suite è aperta, agile e leggibile nel cloud e i suoi componenti possono essere distribuiti su hardware di base, dispositivi precertificati, istanze di cloud virtualizzate e private e su cloud pubblici
Uno dei nuovi aggiornamenti è il nuovo Pivotal Query Optimizer, un ottimizzatore di query avanzato basato sui costi per i big data. Il nuovo ottimizzatore sta determinando miglioramenti delle prestazioni sia nel Pivotal Greenplum Database che nel Pivotal HAWQ. Un altro aggiornamento è la prima versione di Pivotal HD, basata sul core Open Data Platform e include importanti aggiornamenti ai componenti Apache Hadoop, incluso Apache Spark. Ciò offre ai clienti migliori funzionalità di stabilità, gestione, sicurezza, monitoraggio ed elaborazione dei dati nello stack Hadoop e consente loro di scaricare più carichi di lavoro business-critical su Hadoop, riducendo i costi e rimanendo conformi alle policy e alle normative.
I nuovi vantaggi includono:
- Database fondamentale di Greenplum e HAWQ fondamentale
- Importante balzo in avanti nelle prestazioni con Pivotal Query Optimizer notevolmente migliorato, il più avanzato ottimizzatore di query basato sui costi per big data.
- La capacità di gestire un gran numero di carichi di lavoro diversi ad alte prestazioni consente a team di grandi dimensioni di lavorare contemporaneamente su più casi d'uso di analisi.
- Capacità di gestire volumi di Big Data su larga scala senza degrado delle prestazioni.
- Struttura dei dati e funzionalità di gestione dei dati migliorate
- HD fondamentale
- Ora basato su un core standardizzato della piattaforma Open Data composto da Apache Hadoop 2.6 e Apache Ambari.
- Aggiorna i componenti Hadoop esistenti per scripting e query (Apache Pig e Apache Hive), database non relazionali (Apache HBase), insieme al coordinamento di base e all'orchestrazione del flusso di lavoro (Apache Zookeeper™ e Apache Oozie).
- Aggiunge il core Apache Spark e la libreria di machine learning.
- Aggiunge ulteriori componenti Hadoop per migliorare la sicurezza (Apache Ranger (incubating), Apache Knox), il monitoraggio (Nagios, Ganglia oltre ad Apache Ambari) e l'elaborazione dei dati (Apache Tez).
Disponibilità
Le nuove funzionalità sono ora disponibili.


 Amazon