

Portworx di Everpure ha reso Kube Datastore disponibile a livello generale su array SAN supportati, fornendo alle macchine virtuali su Kubernetes volumi a replica singola supportati da un array condiviso. Annunciata al KubeCon 2026, la release è inclusa in Portworx Enterprise 3.7.2 e arriva insieme a un centro operativo ampliato, al supporto per Red Hat OpenShift 5 e a volumi preconfigurati per l'inferenza AI che Everpure prevede di rilasciare nel primo trimestre del 2027.
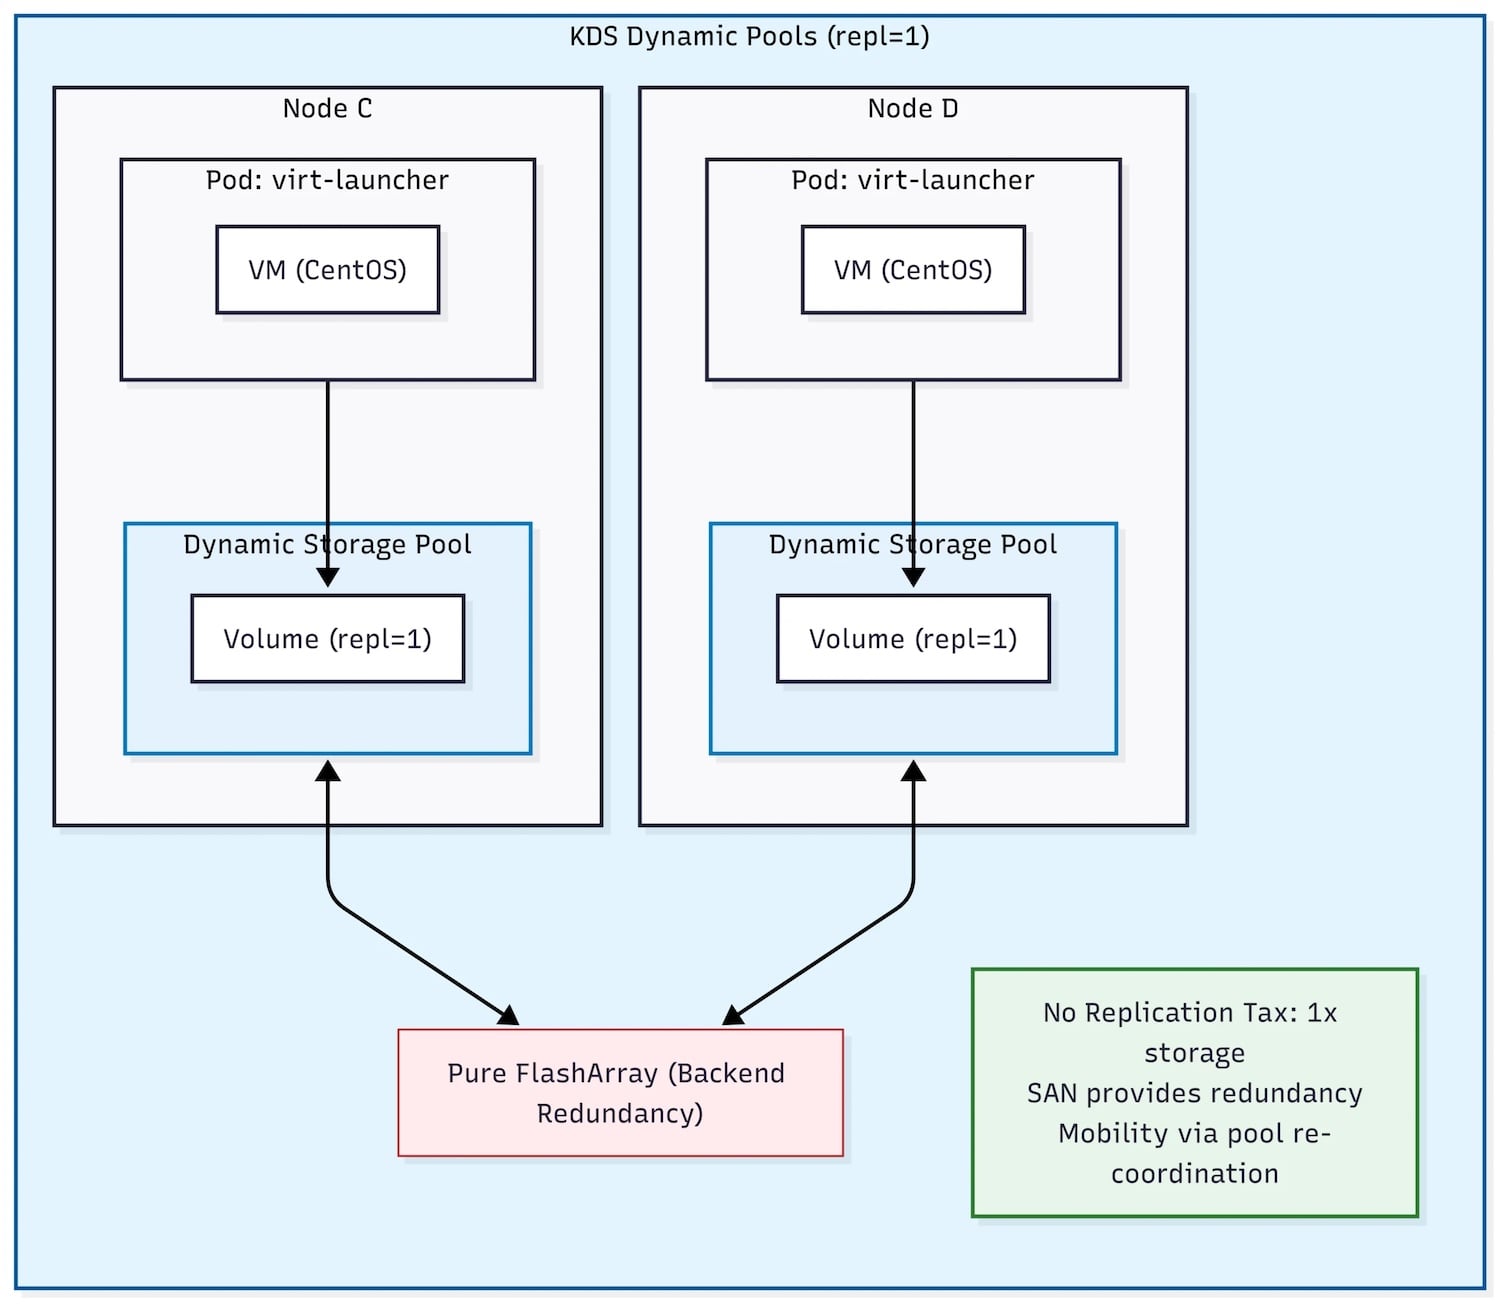
Portworx gestisce i dati per macchine virtuali, container e carichi di lavoro di intelligenza artificiale su Kubernetes, sia in locale che nel cloud e su sistemi di storage edge. Kube Datastore (KDS) raggruppa i pool di storage di Portworx che condividono un backend in un datastore, offrendo agli amministratori di macchine virtuali concetti di datastore familiari e mobilità dello storage su Kubernetes, e consentendo agli ingegneri della piattaforma di controllare dove vengono allocati i volumi e quanta capacità utilizzano.
Kube Datastore per macchine virtuali Kubernetes
La versione GA (General Availability) si concentra sui pool dinamici: un pool dinamico è un pool di storage Portworx creato su un backend condiviso e contiene volumi con un fattore di replica pari a uno, lasciando la protezione dei dati all'array. Portworx indica Everpure FlashArray come backend supportato e non ha elencato altri array. I pool statici rimangono per i carichi di lavoro che necessitano di disponibilità basata sulla replica e per i tipi di volume non idonei, come SharedV4.
L'efficienza si basa sul numero di repliche: Portworx stima che il modello tradizionale senza condivisione di risorse comporti un overhead di storage da 2 a 3 volte superiore e un'amplificazione dell'I/O di rete da 3 a 5 volte maggiore, a seconda del fattore di replica, mentre un volume a singola replica su un array evita entrambi i problemi. Quando un nodo si guasta o entra in manutenzione, il pool viene spostato su un altro nodo come un'unica unità e le attività del secondo giorno, come il ribilanciamento, vengono eseguite tramite flussi di lavoro nativi di Kubernetes. Portworx non ha pubblicato i tempi di failover.
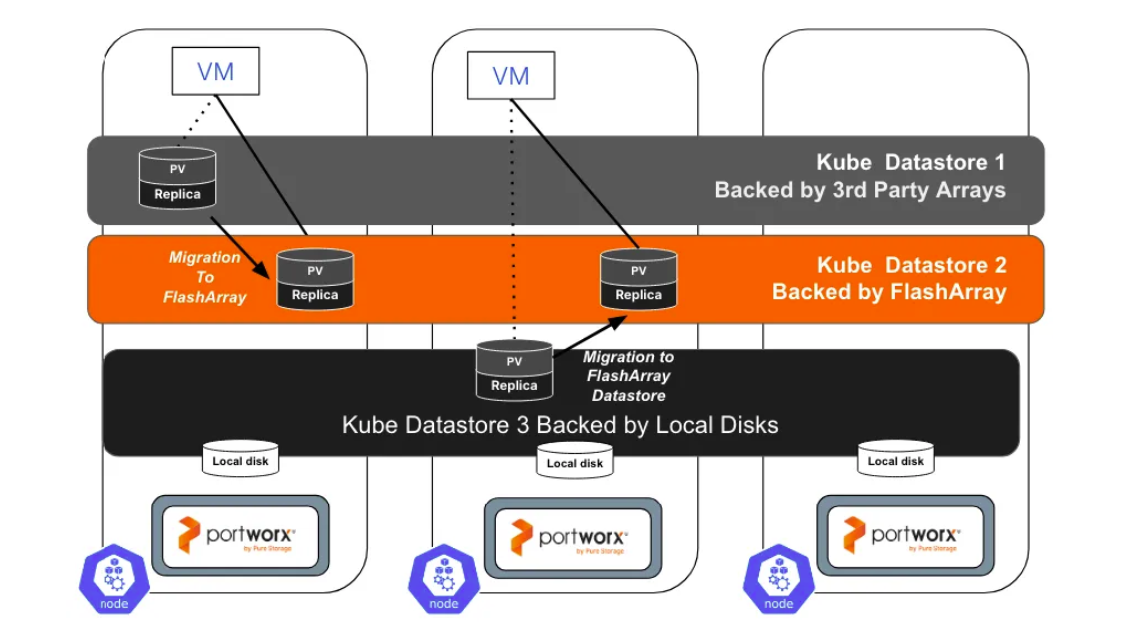
Portworx pubblica un profilo di scalabilità per Enterprise 3.7.2: fino a 12 pool di storage per nodo consigliati con un limite massimo di 16, fino a 150 volumi e 300 snapshot per pool, fino a 700 volumi collegati per nodo e fino a 5,000 volumi collegati per cluster. KDS funziona con KubeVirt e OpenShift Virtualization.
Portworx lo abbina alla migrazione nativa dell'array da VMware che utilizza FlashArray XCOPY, che secondo l'azienda è fino a 12 volte più veloce del metodo predefinito, spostando una VM da 2 TB in circa due ore contro oltre un giorno. Si tratta di dati forniti dal produttore e non sono stati da noi verificati o controllati.
"Le nostre ultime innovazioni, tra cui Kube Datastore, aiutano i clienti a semplificare la gestione dello storage, a ripristinare più rapidamente i sistemi in caso di guasti all'infrastruttura e a utilizzare lo storage in modo più efficiente", ha dichiarato Greg Muscarella, General Manager di Portworx presso Everpure.
Volumi preconfigurati per carichi di lavoro di intelligenza artificiale
I volumi preconfigurati sono pensati per il periodo di attesa prima dell'avvio di un servizio di inferenza, quando i pesi dei modelli, che possono raggiungere decine o centinaia di gigabyte, vengono spesso scaricati nuovamente dopo che un pod viene eseguito su un nuovo nodo. Un team della piattaforma carica un volume sorgente con un pacchetto di modelli versionato proveniente da un repository approvato e Portworx distribuisce copie locali ai nodi worker idonei, verificando che ciascuna sia pronta.
Un pod di inferenza viene quindi pianificato solo su un nodo che ne possiede già una copia e le policy di archiviazione selezionano la copia all'avvio o allo spostamento di un carico di lavoro. Everpure afferma che questo approccio riduce i ritardi di avvio legati all'archiviazione e velocizza il ripristino laddove i carichi di lavoro di IA vengono frequentemente pianificati, spostati o riavviati. Portworx prevede volumi preconfigurati nel primo trimestre del 2027, afferma che l'ambito e le tempistiche potrebbero subire variazioni e non ha pubblicato dati sui tempi di avvio.
Centro operativo e supporto di backup
Il centro operativo di Portworx, un'unica interfaccia all'interno del cluster, ora dispone di una vista di osservabilità che copre l'inventario dei pool, l'avanzamento della migrazione in tempo reale e lo stato dell'iperconvergenza. Si affianca a una vista topologica che mappa nodi di storage, pool, volumi, carichi di lavoro e macchine virtuali con lo stato di salute di ciascun oggetto, e a una vista di avviso che combina gli avvisi di Portworx e Prometheus con filtri per gravità, raggio d'azione e tipo di risorsa.
Portworx sta inoltre aprendo la piattaforma a strumenti di backup di terze parti secondo un modello "bring-your-own-backup" (BYOB) basato sul tracciamento dei blocchi modificati di Kubernetes (KEP-3314), che consente a un prodotto di backup di copiare solo i blocchi che sono stati modificati. Questo supporto arriverà con Portworx Enterprise 3.8.0, previsto per l'inizio del 2027, e Portworx non ha ancora specificato i prodotti di backup con cui sarà compatibile. Portworx Backup 3.2.0, la cui disponibilità generale è prevista per novembre, aggiunge il ripristino selettivo dei file per le macchine virtuali Windows e per le reti solo IPv6 e dual-stack.
Supporto per Red Hat OpenShift 5
Red Hat ha lanciato OpenShift 5 ed Everpure afferma che Portworx è un partner di lancio, con supporto disponibile al momento del rilascio generale sia per Portworx Enterprise che per Portworx CSI. Portworx è già integrato in OpenShift in prodotti come gli appliance AI edge di Supermicro . Everpure ha anche affermato che IDC l'ha nominata Leader nel report IDC MarketScape 2026 per il software di gestione dei dati e dell'infrastruttura dei container.


 Amazon