

NVIDIA si presenta alla conferenza Hot Chips di Stanford con un messaggio chiaro: il data center è il computer e il suo limite prestazionale è determinato più dalla struttura di interconnessione che dai FLOPS (Flop). Nel corso di cinque sessioni, NVIDIA mostrerà come Spectrum-XGS Ethernet, NVLink di quinta generazione con NVLink Fusion, switch fotonici basati su CPO e il nuovo supercomputer desktop DGX Spark interagiscono tra loro. Questa integrazione mira a trasformare decine di migliaia di GPU in un'unica fabbrica di intelligenza artificiale generatrice di fatturato.
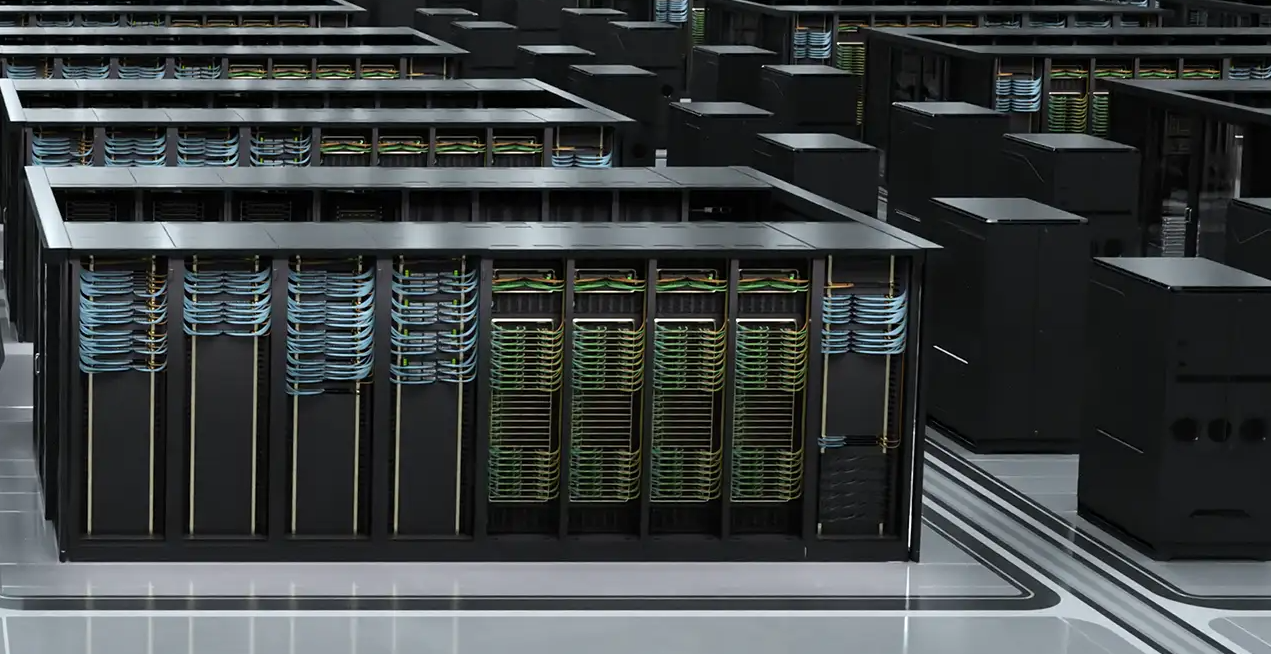
Un tessuto a tre strati per le fabbriche di intelligenza artificiale
I moderni LLM sono applicazioni distribuite implicitamente. Trasmettono in streaming migliaia di miliardi di parametri tra le GPU, sincronizzano gli aggiornamenti del gradiente con cadenza microseconda e devono restituire un primo token a un utente in meno di un battito di ciglia. Questo carico di lavoro determina una gerarchia di interconnessioni:
- Scalabilità all'interno di un rack in modo che le GPU funzionino come core su un singolo processore di grandi dimensioni.
- Scalabilità orizzontale su più rack in modo che il cluster funzioni come un sistema unificato.
- Scalabilità su interi data center per garantire ridondanza geografica, condivisione della capacità e conformità alle normative.
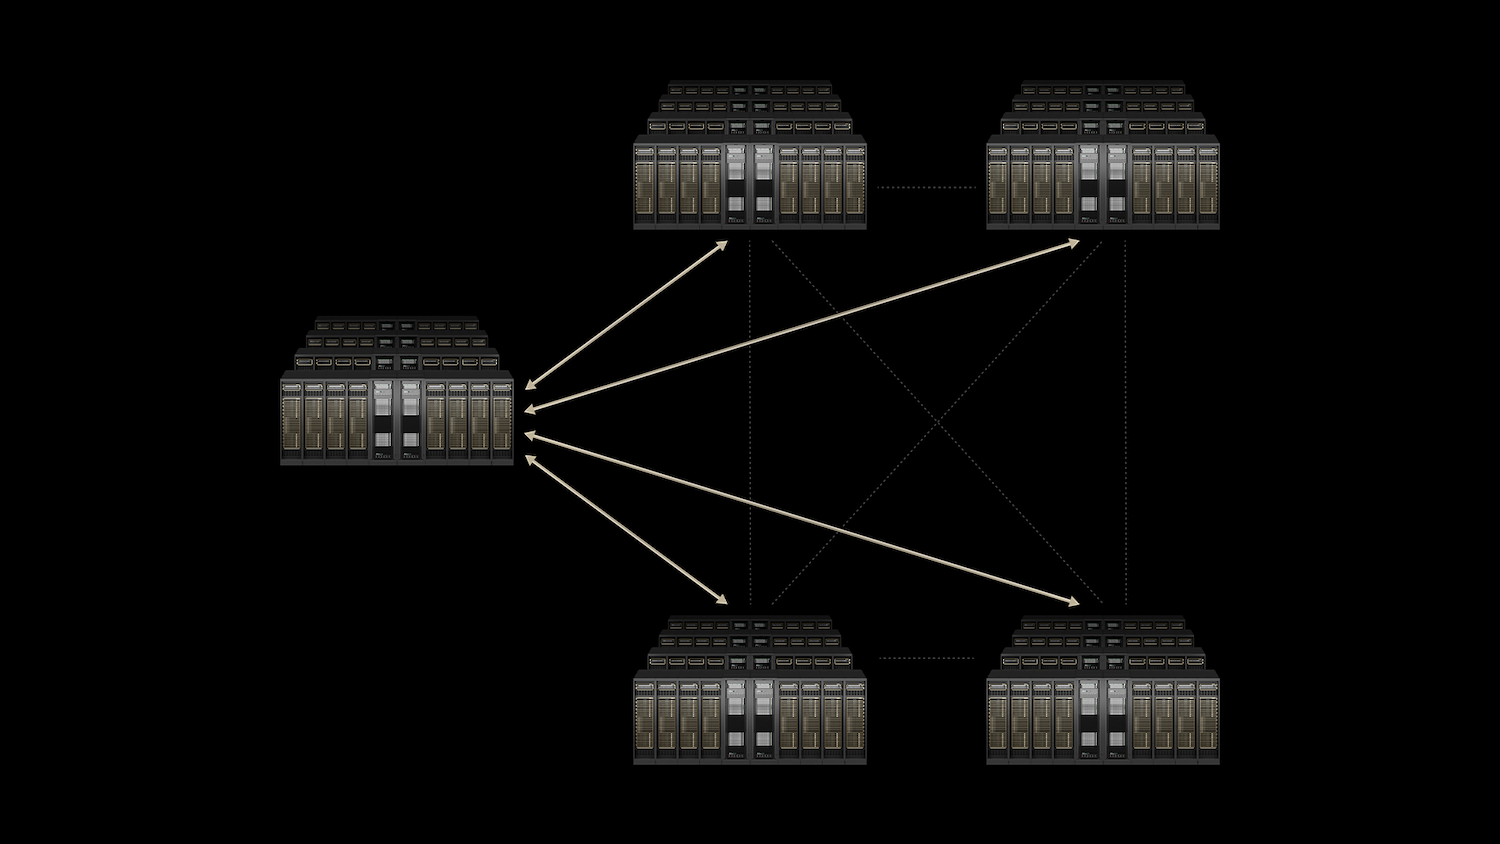
La risposta di NVIDIA è uno stack verticalmente integrato. NVLink e NVLink Switch gestiscono il dominio scale-up; Quantum InfiniBand e Spectrum-X gestiscono quello scale-out; il nuovo Spectrum-XGS Ethernet estende la rete lossless e ottimizzata per l'intelligenza artificiale tra i data center. La tecnologia Co-Packaged Optics (CPO) riduce i limiti di potenza e densità che altrimenti incontrerebbero cluster da milioni di GPU.
Ethernet Spectrum-XGS
La tecnologia Ethernet tradizionale è stata progettata principalmente per gestire il traffico best-effort, il che significa che funzionava bene per comunicazioni semplici e basate su un singolo server. Tuttavia, con l'avanzare dell'intelligenza artificiale in un mondo sempre più dipendente, ci troviamo ad affrontare nuove sfide.
Con l'avvento dei collettivi di intelligenza artificiale e dei sistemi di inferenza multi-tenant, i requisiti di prestazioni di rete si sono evoluti in modo significativo. Queste applicazioni moderne richiedono un livello di affidabilità e velocità che la tradizionale rete Ethernet semplicemente non può fornire.
In particolare, richiedono zero jitter, ovvero nessuna variabilità nella latenza, un aspetto fondamentale per l'elaborazione in tempo reale. Inoltre, la latenza deterministica garantisce risposte prevedibili e coerenti, il che è fondamentale per le applicazioni che si basano su un feedback immediato. Infine, un throughput near-line-rate è essenziale per gestire l'elevato volume di dati elaborato durante i carichi di microbursty, in cui il traffico dati può subire picchi inaspettati.
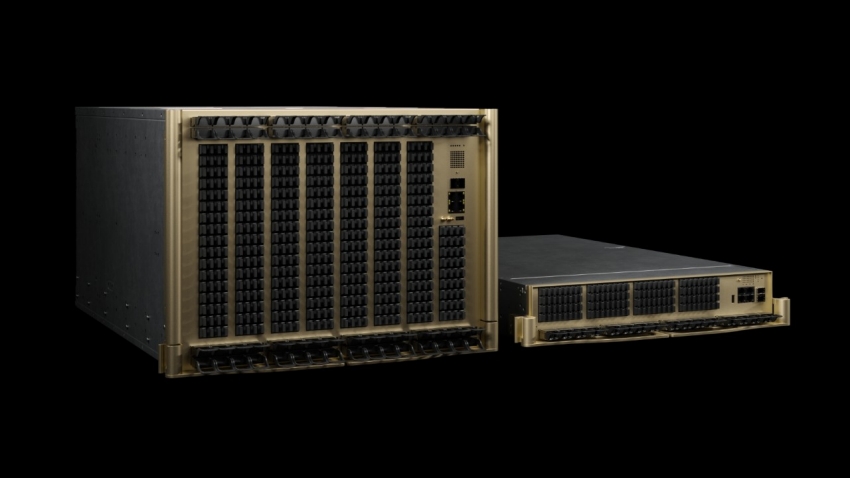
Spectrum-X è una soluzione che opera in modo trasparente all'interno di un data center, mentre Spectrum-XGS porta questa innovazione a un livello superiore estendendone le capacità a più data center. Integra switch avanzati basati su ASIC Spectrum-6 o -4 con SuperNIC ultraveloci da 800 Gb/s, in particolare le varianti BlueField-3 o ConnectX-8. Queste tecnologie lavorano insieme per gestire in modo efficiente la congestione e riordinare i pacchetti, garantendo un flusso di dati fluido.
Ciò che distingue questo sistema è la sua telemetria intelligente che raccoglie i dati da ogni porta e li inserisce nella logica di controllo della congestione interna allo switch, consentendo la riorganizzazione del traffico in tempo reale. Nei cluster di produzione, questo si traduce in prestazioni notevoli, mantenendo un throughput superiore al 95% della capacità teorica con una sorprendente scala di GPU pari a 32. Al contrario, la tradizionale rete Ethernet a 800 GHz presenta difficoltà, raggiungendo solo circa il 60% di throughput in caso di collisioni collettive.
Inoltre, Spectrum-XGS garantisce la conformità agli standard, rendendo SONiC e Cumulus Linux componenti integranti del suo ecosistema. Ciò significa che gli operatori cloud e aziendali possono mantenere i loro stack di automazione esistenti, beneficiando al contempo del determinismo superiore tipicamente associato a InfiniBand. I miglioramenti portano a un maggiore utilizzo della GPU e a una latenza ridotta, che si traducono in più token per watt e obiettivi di livello di servizio più rigorosi. Inoltre, consente agli operatori di integrare nuovi tenant nella stessa flotta senza subire cali di prestazioni, rendendolo una novità rivoluzionaria nel settore.
NVLink e NVLink Fusion: il rack come un'unica GPU gigante
La tecnologia NVLink di quinta generazione offre un'impressionante larghezza di banda punto-punto di 1.8 TB/s e un'impressionante larghezza di banda aggregata di 130 TB/s all'interno di un rack NVL72. Questa connettività avanzata consente a ogni GPU di comunicare direttamente con ogni altra GPU in un singolo salto, trasformando di fatto l'intero rack in un dominio di memoria coerente. Grazie alla NVIDIA Collective Communications Library (NCCL), perfezionata nel corso di oltre dieci anni, gli sviluppatori di applicazioni possono raggiungere senza sforzo velocità near-wire senza dover scrivere codice di comunicazione personalizzato per diverse topologie.
Inoltre, il recente annuncio di NVLink Fusion apre interessanti possibilità per gli hyperscaler. Questa innovazione consente a CPU o XPU personalizzate di integrare perfettamente SERDES o chiplet NVLink tramite UCIe per gli acceleratori, o NVLink-C2C per le CPU, consentendo il posizionamento diretto di questi componenti sulla struttura NVLink. Un vantaggio significativo di Fusion è la sua specifica rack MGX modulare, che include una supply chain completamente qualificata. Ciò significa che gli stessi fornitori che attualmente forniscono rack NVL72 possono anche fornire rack Fusion, riducendo significativamente il time-to-market per le aziende che desiderano implementare questa tecnologia.
Per quanto riguarda l'economia dell'inferenza, l'influenza di NVLink è evidente sulla tradizionale frontiera di Pareto tra throughput per watt e latenza. Passando da una mesh PCIe a un nodo switch NVLink, sia il throughput che la latenza migliorano, e ulteriori miglioramenti possono essere ottenuti aggiornando il rack NVLink. Ciò si traduce nell'elaborazione di un maggior numero di query utente per kilowattora, riducendo al contempo la spesa in conto capitale ammortizzata per token generato, rendendo NVLink un potente strumento per migliorare l'efficienza operativa.
La tecnologia NVLink di quinta generazione offre 1.8 TB/s di larghezza di banda punto-punto e 130 TB/s di larghezza di banda aggregata all'interno di un rack NVL72. Con lo switch NVLink, ogni GPU vede tutte le altre in un singolo salto, trasformando l'intero rack in un dominio di memoria coerente. Le operazioni collettive vengono eseguite tramite NCCL, una libreria giunta ormai al decimo anno di produzione, ottimizzata per ogni topologia immaginabile e automaticamente sensibile alla topologia. Pertanto, gli sviluppatori di applicazioni non necessitano di codice di comunicazione personalizzato per raggiungere velocità near-wire.
Ottica co-confezionata (CPO): abbattere il muro di potenza a 800 Gb/s e oltre
Gli switch tradizionali con moduli collegabili sono ormai da tempo lo standard di rete. Tuttavia, le inefficienze intrinseche di questi sistemi stanno diventando sempre più evidenti. Quando i dati escono dall'ASIC, percorrono lunghe piste PCB e attraversano diversi connettori prima di raggiungere un modulo ottico con un elevato numero di DSP. Questo percorso comporta perdite significative, spesso fino a 22 dB nel dominio elettrico, e consuma ben 30 W per porta solo per recuperare il segnale. Con l'avanzare verso velocità di trasmissione dati più elevate, come l'attuale PAM200 da 4 GHz e l'ambizioso 1.6 T nel prossimo futuro, i limiti di questa architettura diventano evidenti, portando a budget di potenza esplosivi e a vincoli sulla densità del frontalino.
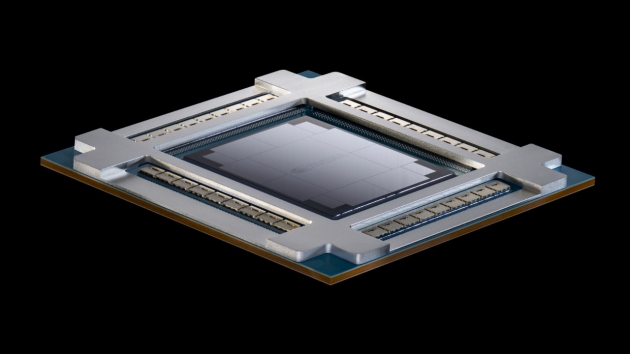
Ecco le soluzioni innovative di NVIDIA: Quantum-X Photonics per InfiniBand e Spectrum-X Photonics per Ethernet. Integrando i motori ottici direttamente nel package dello switch, riducono drasticamente la lunghezza del percorso elettrico. Questo non solo riduce al minimo le perdite a circa 4 dB, ma riduce anche il consumo energetico della porta a circa 9 W: un miglioramento impressionante.
La prossima settimana assisteremo al lancio di due chassis all'avanguardia raffreddati a liquido: il modello a 128 porte, che vanta un throughput di ben 102.4 Tb/s, e il modello a 512 porte, che spinge ulteriormente questo limite a 409.6 Tb/s. Quest'ultimo modello è dotato di un fiber shuffle integrato, che garantisce che ogni porta si colleghi perfettamente al fascio di fibre corretto, senza la necessità di complesse operazioni di patching manuale. I dati iniziali sul campo sono promettenti, indicando un'efficienza energetica notevolmente superiore di 3.5 volte e un tempo medio tra guasti di circa 10 volte superiore rispetto ai tradizionali sistemi collegabili. Inoltre, la finestra di avvio per cluster è 1.3 volte più veloce, semplificando l'implementazione.
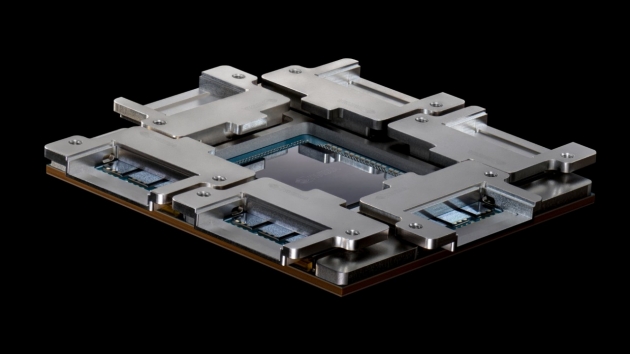
Sebbene queste soluzioni avanzate non saranno disponibili prima del 2026, i design-in sono già in corso. Questo è fondamentale per gli operatori che pianificano impianti da gigawatt o per le amministrazioni che stanno valutando laboratori nazionali da milioni di GPU. La tecnologia CPO (Coherent Photonics Optics) di NVIDIA definisce chiaramente un percorso per rimanere entro i limiti di potenza ed evitare il temuto incubo della manutenzione delle ottiche, aprendo la strada a un futuro più efficiente e potente nel networking ad alte prestazioni.
DGX Spark e il sistema: dal prototipo desktop alla produzione su scala rack
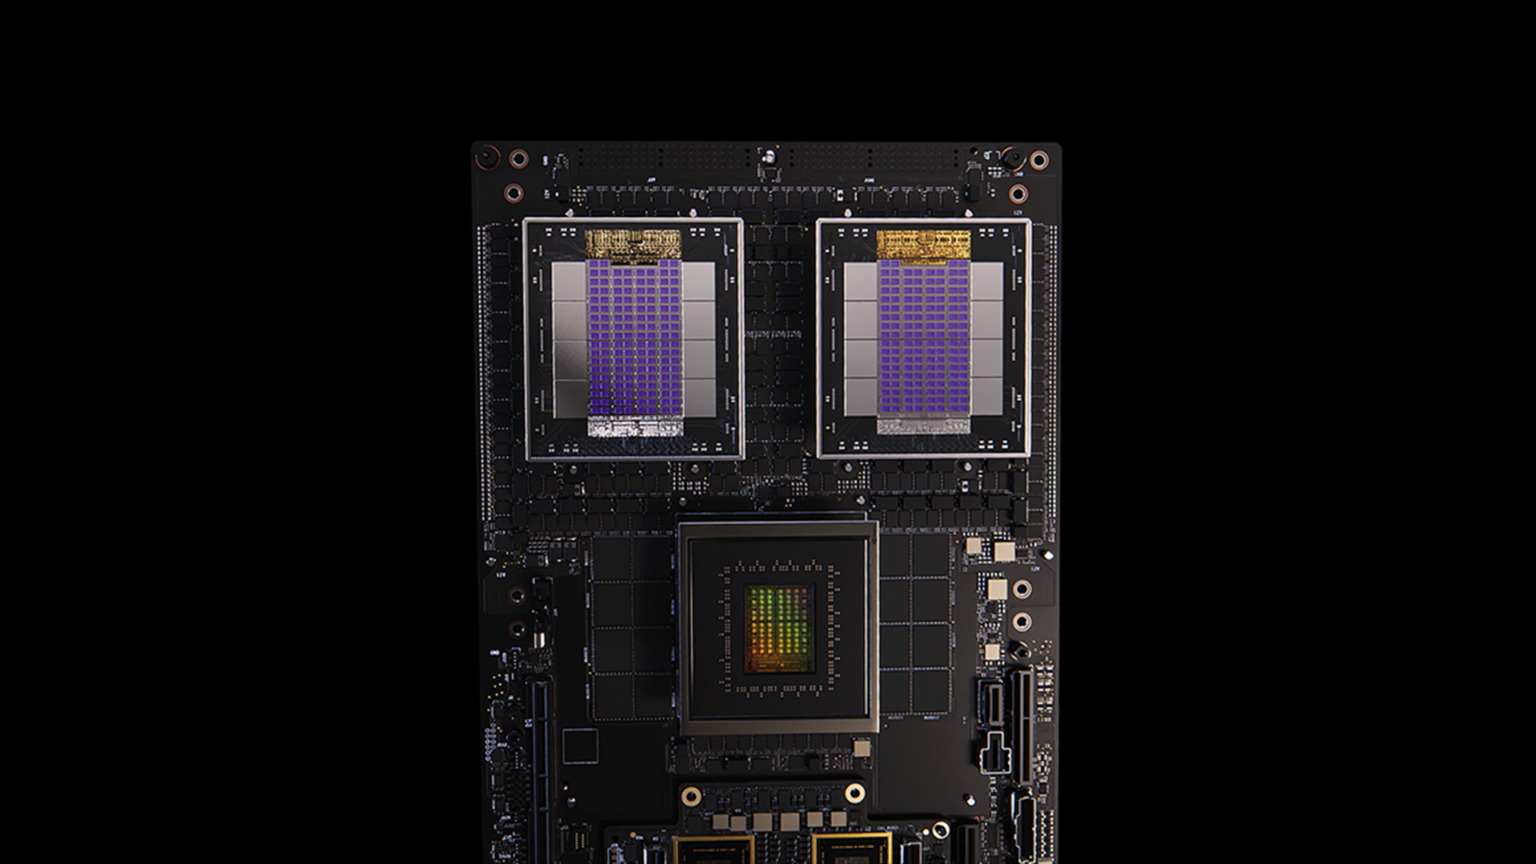
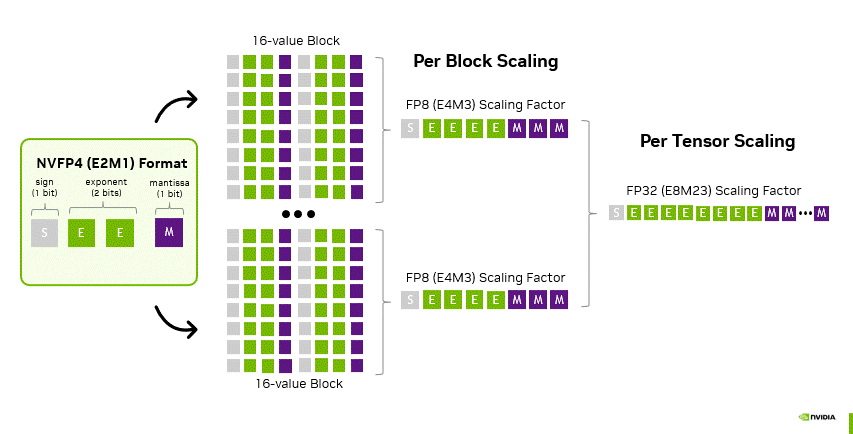
Non tutti i carichi di lavoro iniziano su scala hyperscale. DGX Spark , basato sul nuovo Superchip GB10, comprime i Tensor Core di Blackwell, l'inferenza NVFP4 (virgola mobile a 4 bit) e tutte le librerie CUDA-X in uno chassis desktop. Gli sviluppatori addestrano, ottimizzano e compongono i RAG localmente, quindi trasferiscono container identici su rack GB200 o GB300 NVL72 quando i carichi di lavoro sono maturi.
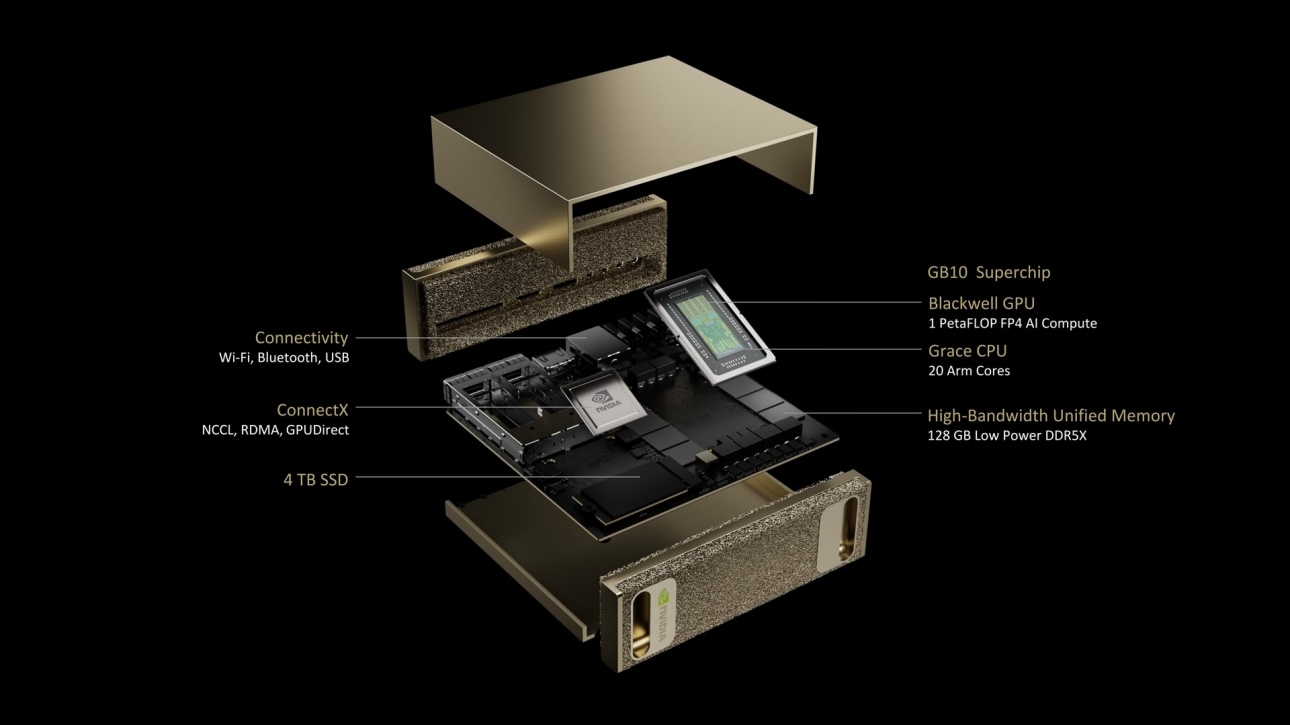
Questo continuum consente alle aziende di pilotare l'intelligenza artificiale agentica, la percezione robotica o attività generative multimodali senza bloccarsi sugli slot del cluster. Per il settore, Spark è un cavallo di Troia: basta posizionarne uno nel laboratorio di un cliente, lasciare che i suoi ricercatori vedano in prima persona l'accelerazione dell'inferenza a 4 bit e le espansioni seguono.
Il moltiplicatore software: microservizi TensorRT-LLM, Dynamo e NIM
Le interconnessioni hardware stabiliscono i limiti; il software determina quanto si avvicinano i carichi di lavoro reali. NVIDIA mostrerà TensorRT-LLM eseguendo il modello GPT-OSS a 120 miliardi di parametri in NVFP4, raggiungendo un'interattività quattro volte superiore a quella di TorchServe standard su contesti lunghi. Su rack GB200, DeepSeek-R1 a 671 B registra un throughput per GPU 2.5 volte superiore con lo scheduler di pipeline disaggregato di Dynamo, senza aumentare il costo per query. Tutto questo arriva come microservizi NIM: endpoint containerizzati che si inseriscono in cluster Kubernetes o in stack bare-metal on-premise.
L'open source è alla base dello stack. RAPIDS accelera l'ETL end-to-end sulle GPU; i template CUTLASS consentono kernel personalizzati ad alte prestazioni; NeMo e BioNeMo estendono PyTorch per l'addestramento LLM di frontiera e per il ripiegamento proteico, pur rimanendo al 100% OSS. Il messaggio per gli acquirenti diffidenti nei confronti dei lock-in: NVIDIA è "aperta dove serve, ottimizzata dove serve".
Implicazioni competitive e commerciali
NVIDIA si è ritagliata una posizione unica nel panorama tecnologico grazie al suo approccio verticalmente integrato, in particolare rispetto ai fornitori di switch basati su silicio e alle startup di acceleratori disaggregati. Questa strategia consente a NVIDIA di offrire non solo singoli componenti, ma soluzioni complete che comprendono un'architettura di riferimento. Questa architettura è supportata da una supply chain collaudata, una roadmap biennale chiaramente definita e una superficie API di alto livello nota come NIM, che semplifica la complessità del cablaggio per gli sviluppatori.
Per gli hyperscaler, l'offerta NVIDIA è interessante grazie all'enfasi posta su Service Level Agreement (SLA) deterministici e al rischio operativo minimo. Implementando rack NVLink, queste organizzazioni possono ottenere funzionalità di inferenza di livello superiore, essenziali per le applicazioni che richiedono un'elaborazione rapida dei dati. Inoltre, la tecnologia Spectrum-X facilita lo scale-out della capacità, consentendo agli hyperscaler di espandere la propria infrastruttura senza soluzione di continuità. L'introduzione di Spectrum-XGS consente la federazione di regioni, migliorando così l'efficienza dell'allocazione delle risorse tra data center distribuiti geograficamente. Questa integrazione supporta il funzionamento di piani di controllo Ethernet standard, garantendo compatibilità e facilità di gestione all'interno dell'infrastruttura esistente.
Per le aziende, l'attrattiva della tecnologia NVIDIA risiede nella sua capacità di massimizzare i ricavi per rack. Il sistema Spectrum-X, ad esempio, migliora significativamente l'efficacia dei cicli GPU, fino al 35%. Ciò significa che le aziende possono ottenere una maggiore produttività, sia sotto forma di token, immagini o azioni automatizzate, senza aumentare le spese in conto capitale. Di conseguenza, le aziende possono ricavare maggiore valore dai propri investimenti esistenti, allineandosi alle attuali esigenze di efficienza e convenienza in un mercato competitivo.
Conclusione
La narrazione che circonda Hot Chips segna un notevole cambiamento nel panorama della tecnologia informatica, in particolare in relazione all'intelligenza artificiale (IA). Sottolinea che il networking è ora considerato un acceleratore fondamentale per l'informatica, paragonabile per importanza a progressi come i tensor core.
Tecnologie come NVLink sono fondamentali in quanto trasformano un rack di server in un chip logico coeso, migliorando prestazioni ed efficienza. Spectrum-X svolge un ruolo cruciale nel facilitare la creazione di reti di dimensioni inferiori al millisecondo, mentre Spectrum-XGS estende questa struttura ad alte prestazioni su scala globale. Inoltre, CPO è progettato per garantire che i requisiti di potenza e densità siano a prova di futuro, rispondendo alle esigenze in continua evoluzione delle applicazioni di intelligenza artificiale. DGX Spark, d'altra parte, è fondamentale nel promuovere l'adozione di queste tecnologie, incoraggiando le aziende ad adottare soluzioni innovative.
Nel complesso, questi progressi hanno il potenziale per modificare le dinamiche economiche dei processi di inferenza e formazione. Ciò è particolarmente rilevante in quanto le aziende si trovano attualmente a un bivio, valutando le opzioni tra la costruzione di nuove infrastrutture, l'affitto di soluzioni esistenti o il rinvio degli investimenti in capacità di intelligenza artificiale su larga scala. La posizione di NVIDIA è inequivocabile: le organizzazioni dovrebbero investire nella costruzione di una propria infrastruttura, ma con particolare attenzione a un framework di rete meticolosamente progettato, dalla dorsale in rame allo switch fotonico, per supportare la futura era dominata dalle fabbriche basate sull'intelligenza artificiale.


 Amazon