

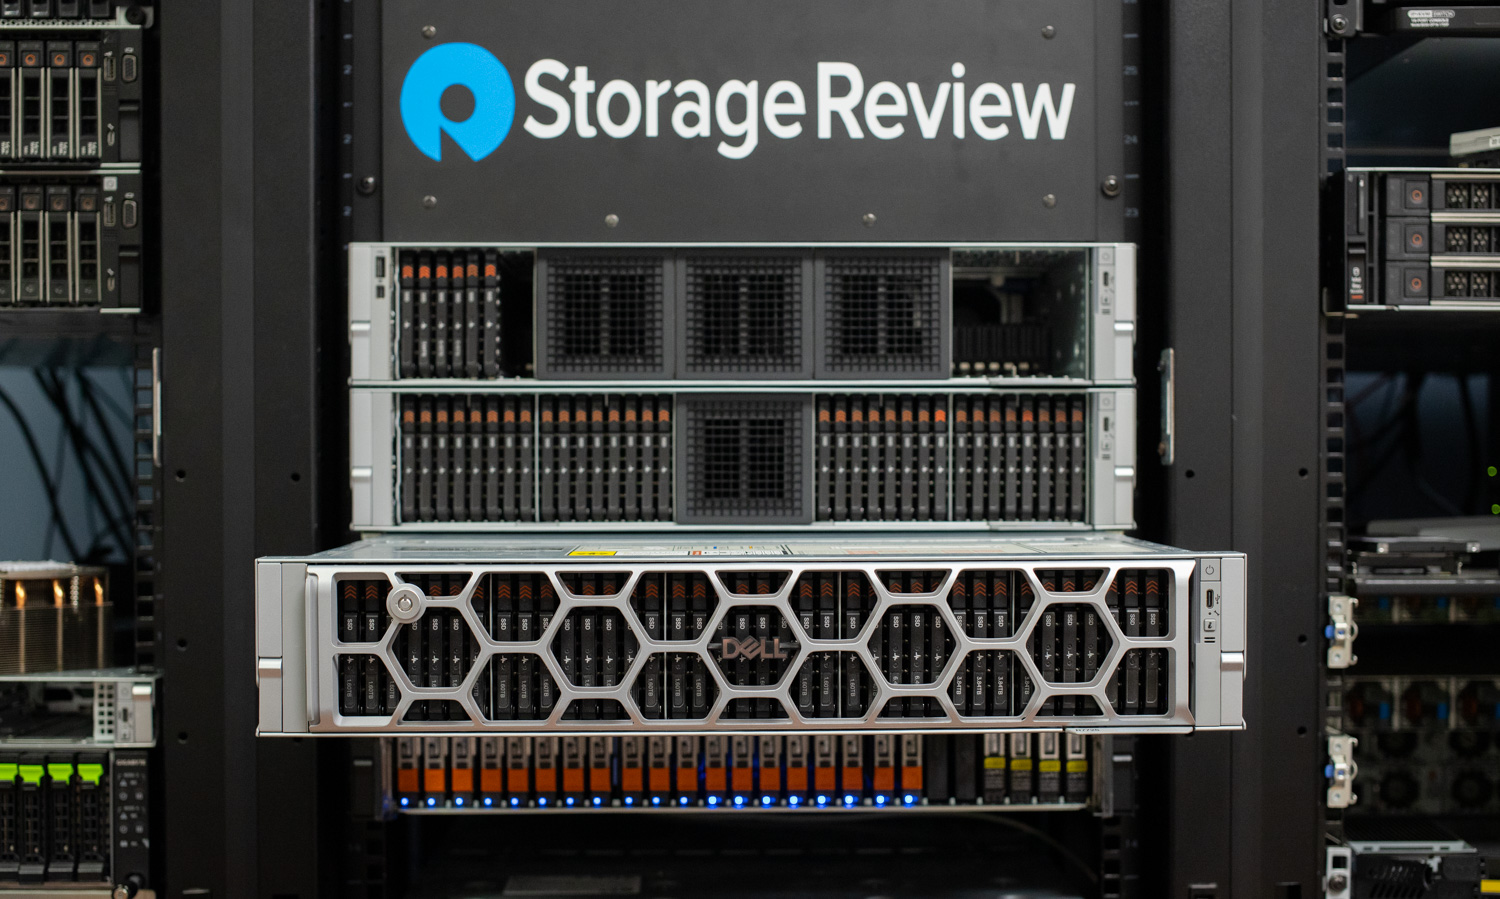
All'inizio di quest'anno, abbiamo stabilito un nuovo record calcolando 314 trilioni di cifre di Pi greco . Il calcolo è durato mesi su un singolo Dell PowerEdge R7725, spingendo al limite le moderne infrastrutture di CPU e storage e dimostrando quanto si sia evoluto l'hardware aziendale. Al termine dell'esecuzione, tuttavia, il record si è rivelato solo una parte della storia. Il calcolo ha prodotto un enorme dataset composto da 628 file, ciascuno di circa 206 GB, per un totale di oltre 130 TB. Questi file rappresentano l'intero artefatto del calcolo e sono spesso la parte più interessante di un progetto come questo. Matematici, sviluppatori e data scientist desiderano spesso esplorare ulteriormente dataset di questo tipo, sia per convalidare parti del calcolo, sia per sperimentare nuovi metodi analitici o per lavorare con dataset numerici insolitamente grandi.
Questo crea un problema pratico che va ben oltre il calcolo di Pi. I moderni carichi di lavoro computazionali generano sempre più spesso enormi set di dati di output che devono rimanere accessibili a lungo dopo il completamento del lavoro di calcolo. Simulazioni scientifiche, analisi genomiche e addestramenti di intelligenza artificiale su larga scala producono risultati che possono estendersi per decine o centinaia di terabyte. Sebbene un ambiente di laboratorio possa essere perfettamente adatto a generare tali dati, raramente è il luogo migliore per ospitarli indefinitamente per un pubblico globale.
Per il nostro progetto Pi, mantenere più di 130 TB di risultati permanentemente archiviati nel laboratorio di StorageReview non era la soluzione ideale. I ricercatori avevano già iniziato a richiedere l'accesso e rendere il dataset ampiamente disponibile richiedeva un'infrastruttura in grado di archiviarlo in modo affidabile e distribuirlo in modo efficiente.
È qui che è intervenuta Backblaze. L'azienda ospita l'intero dataset di Pi su Backblaze B2 Cloud Storage, rendendo i risultati accessibili a ricercatori e appassionati che desiderano lavorarci. Fornire uno storage duraturo e un accesso globale a un dataset di queste dimensioni è un impegno significativo e apprezziamo il contributo di Backblaze nel garantire che i risultati di questo calcolo da record rimangano disponibili alla comunità scientifica.
Questa collaborazione illustra anche una tendenza che osserviamo sempre più spesso nelle infrastrutture moderne: i vantaggi pratici dei flussi di lavoro ibridi che combinano l'elaborazione locale con l'archiviazione e la distribuzione basate sul cloud. Il calcolo con Pi è stato eseguito interamente nel nostro laboratorio su un singolo sistema, ma una volta completato il lavoro, il cloud è diventato il luogo logico in cui ospitare e condividere i risultati.
Prima che ciò potesse accadere, però, i dati dovevano viaggiare dal nostro laboratorio a Backblaze. Spostare oltre 130 TB di risultati non è un'impresa da poco, ma grazie a una connessione di rete efficiente, il trasferimento è stato completato in meno di due settimane, mantenendo una velocità di trasmissione costante di 2 Gbps per gran parte del processo. I grandi set di dati hanno comunque un peso, e quando si spostano centinaia di gigabyte alla volta, la larghezza di banda diventa rapidamente il fattore limitante.
Ora che il dataset è archiviato in modo sicuro su Backblaze B2, i risultati del calcolo di 314 trilioni di cifre possono essere consultati anche al di fuori del nostro laboratorio. I ricercatori possono scaricare i file, sperimentare con essi, verificare sezioni del calcolo o esplorare le cifre per i propri progetti. Con il Pi Day 2026 alle porte, questo è il momento perfetto per rendere disponibile il dataset.
Backblaze B2: Archiviazione cloud aziendale per grandi quantità di dati
Per rendere ampiamente disponibile il dataset Pi, era necessaria un'infrastruttura in grado di archiviare e distribuire in modo affidabile volumi di dati molto elevati. Backblaze B2 Cloud Storage è una piattaforma di object storage aziendale progettata proprio per questo tipo di carico di lavoro. L'object storage consente di archiviare enormi raccolte di file in bucket di oggetti scalabili, anziché costringerli in gerarchie di file tradizionali, risultando quindi ideale per dataset di grandi dimensioni, backup e pipeline di dati moderne. B2 supporta inoltre API compatibili con S3, consentendo alle organizzazioni di interagire con il servizio utilizzando strumenti e flussi di lavoro familiari senza dover riprogettare applicazioni o processi dati esistenti.
Backblaze ha incentrato la sua piattaforma sull'offerta di storage durevole con un'economia semplice e una gestione intuitiva. L'architettura è progettata per garantire un'affidabilità dei dati del 99,9
Hosting del dataset in Backblaze B2
Una volta completato il calcolo PI da 314 trilioni di cifre e scaricati i dati dal server R7725 al sistema di archiviazione NAS, si è posto il problema di come rendere il dataset pubblicamente disponibile. Distribuire 130 TB direttamente dal laboratorio non era un'opzione praticabile. La nostra connessione WAN opera a una velocità massima di 2 Gbps in upload e 2 Gbps in download ed è condivisa tra tutte le attività di laboratorio. Download pubblici continui di una certa portata avrebbero creato conflitti con le normali attività lavorative e il limite di banda avrebbe reso i download simultanei di grandi dimensioni lenti e inaffidabili per chiunque tentasse di accedere ai dati.
L'idea iniziale era di distribuire il dataset tramite BitTorrent. Sebbene tecnicamente avrebbe funzionato, non si tratta dell'esperienza più accessibile per la maggior parte degli utenti. Scaricare un dataset di 130 TB tramite torrent richiede un client, una certa familiarità con il funzionamento dei torrent e pazienza con un processo che non è semplice come un download diretto. Per un dataset destinato a essere ampiamente accessibile ai ricercatori e alla comunità in generale, era preferibile evitare tale complessità.
Backblaze B2 ha risolto entrambi i problemi in modo impeccabile. Il dataset è ospitato interamente su un'infrastruttura cloud, quindi i download pubblici non dipendono dalla rete WAN del laboratorio e non gravano sulle sue attività operative. Le connessioni a B2 vengono gestite tramite HTTPS direttamente dall'infrastruttura Backblaze, garantendo download sicuri, affidabili e indipendenti dalla disponibilità di seeders di terze parti. L'intero dataset è ora disponibile nel bucket pi-314-trillion, suddiviso in 628 oggetti per un totale di circa 132 TB, organizzati su un unico percorso dati e accessibili a chiunque, senza alcun impatto sul laboratorio.
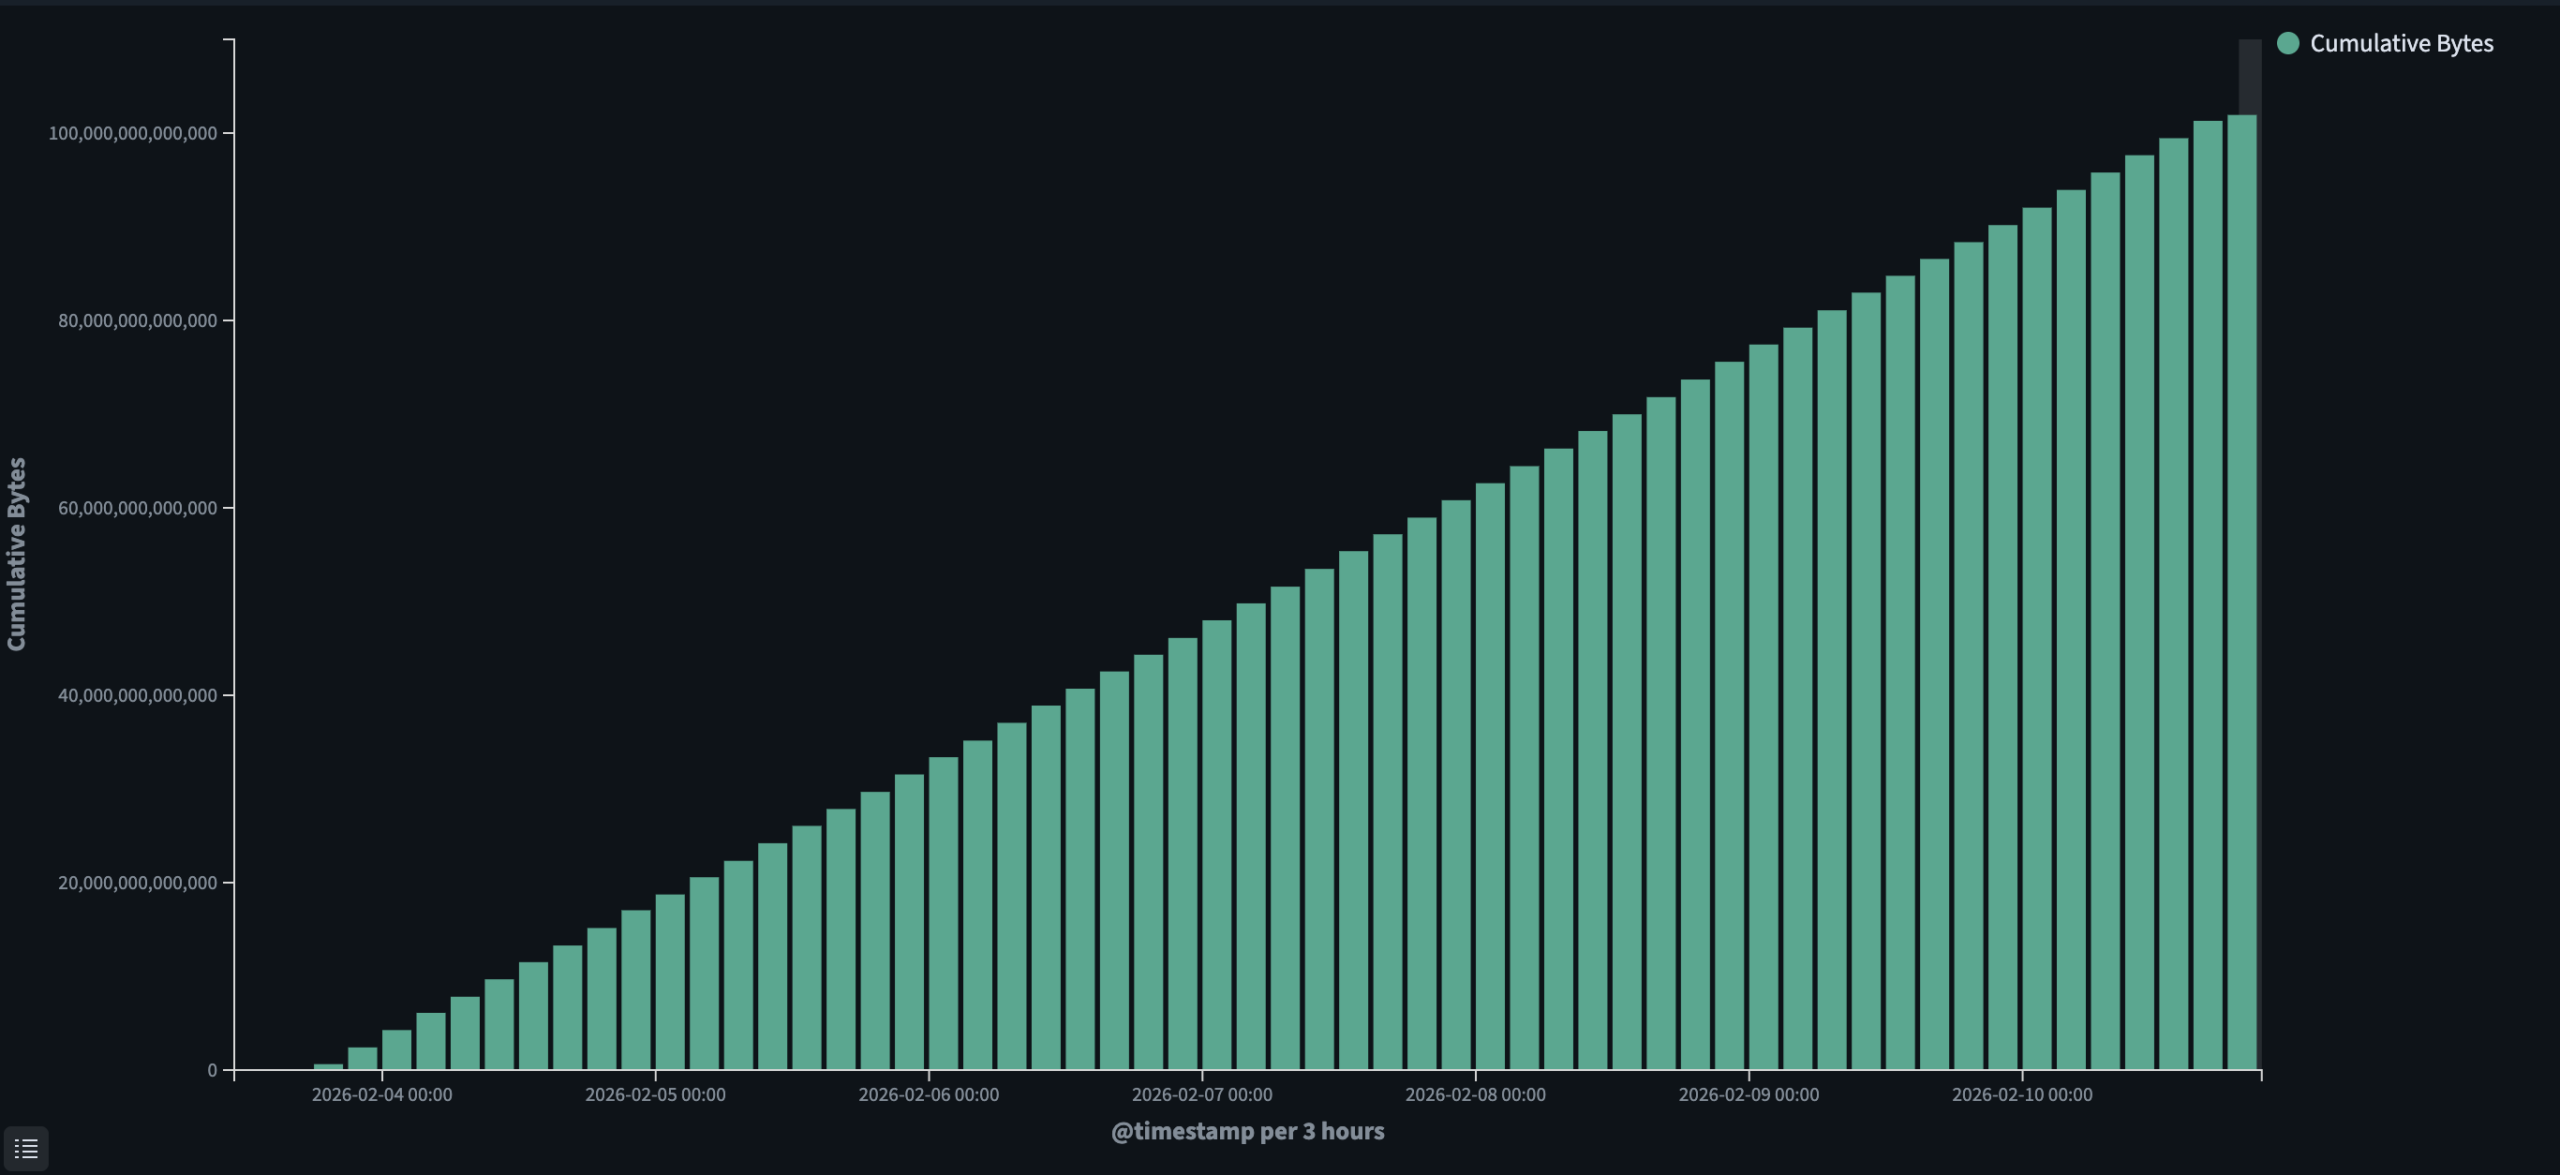
Il trasferimento dal NAS del laboratorio è stato gestito con una semplice configurazione Rclone, instradata attraverso il nostro UDM Pro Max, che funge da gateway del laboratorio, a una velocità costante di poco superiore a 2 Gbps durante l'intero caricamento. A tale velocità, il trasferimento di 130 TB ha richiesto circa 10 giorni di trasferimento continuo. I grafici seguenti mostrano l'andamento del trasferimento sia al minuto che cumulativo.
Utilizzo della WAN durante il trasferimento
La dashboard di rete UniFi del laboratorio conferma le caratteristiche di upload durante la finestra di trasferimento. L'interfaccia WAN mostra Backblaze come l'applicazione dominante in termini di volume di traffico, con una velocità di upload di 2.27 Gbps e un utilizzo mensile dei dati WAN registrato pari a 90.9 TB per il periodo. La connessione è rimasta stabile per tutta la durata del trasferimento, senza eventi significativi di perdita di pacchetti.
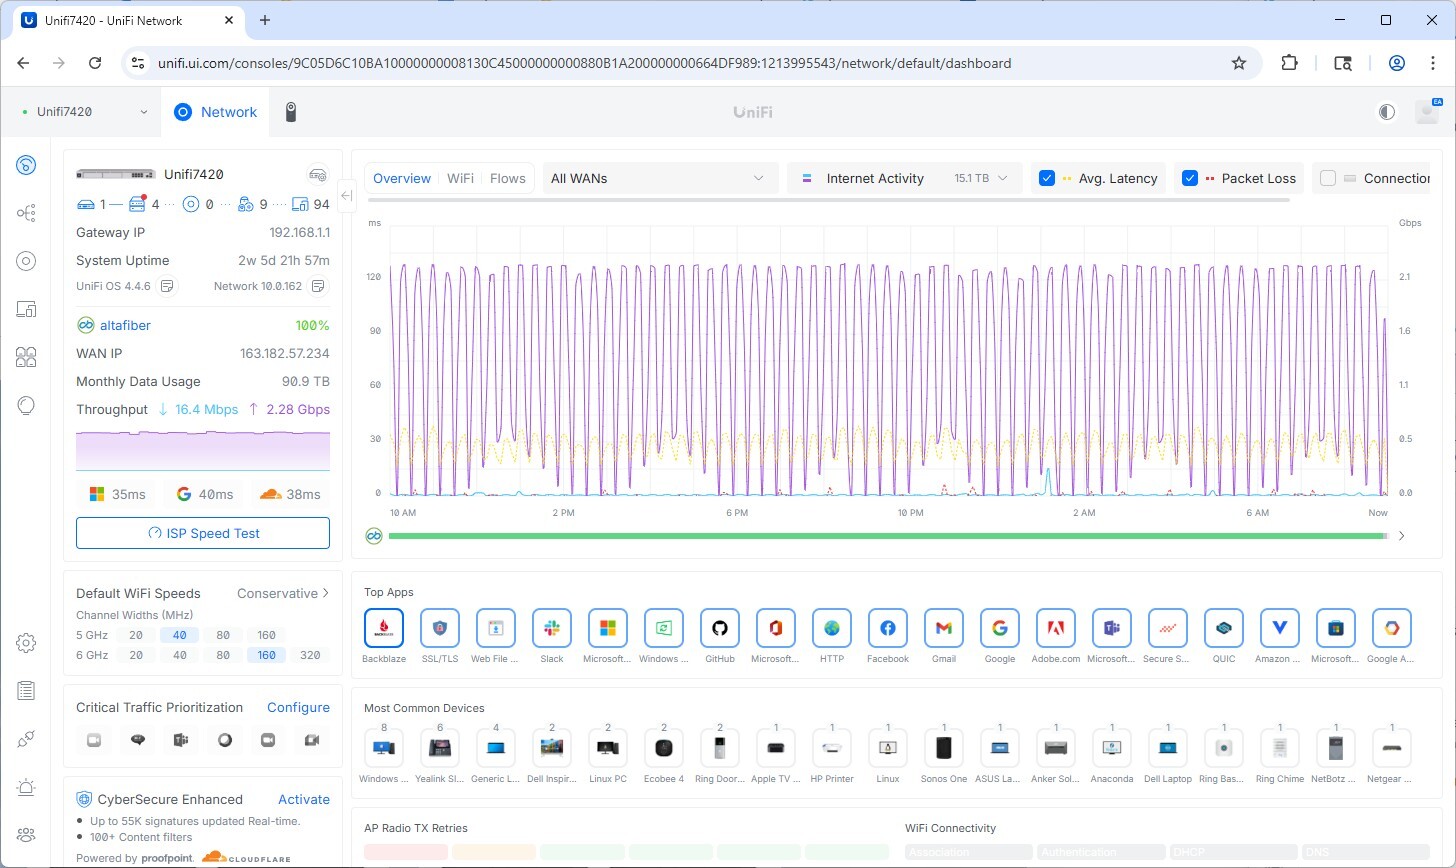
La dashboard di UniFi mostra una velocità di upload costante superiore a 2 Gbps con Backblaze come applicazione WAN principale durante il periodo di trasferimento.
Velocità di trasferimento al minuto
Il grafico sottostante mostra la velocità di trasferimento campionata al minuto in un intervallo rappresentativo del caricamento. Le barre raggiungono costantemente valori compresi tra 15 e 16 gigabyte al minuto, il che corrisponde a una velocità di linea sostenuta di circa 2 Gbps. Le brevi interruzioni visibili nel grafico corrispondono alle pause di convalida del checksum, eseguite periodicamente durante il trasferimento per confermare l'integrità dei dati prima di proseguire.
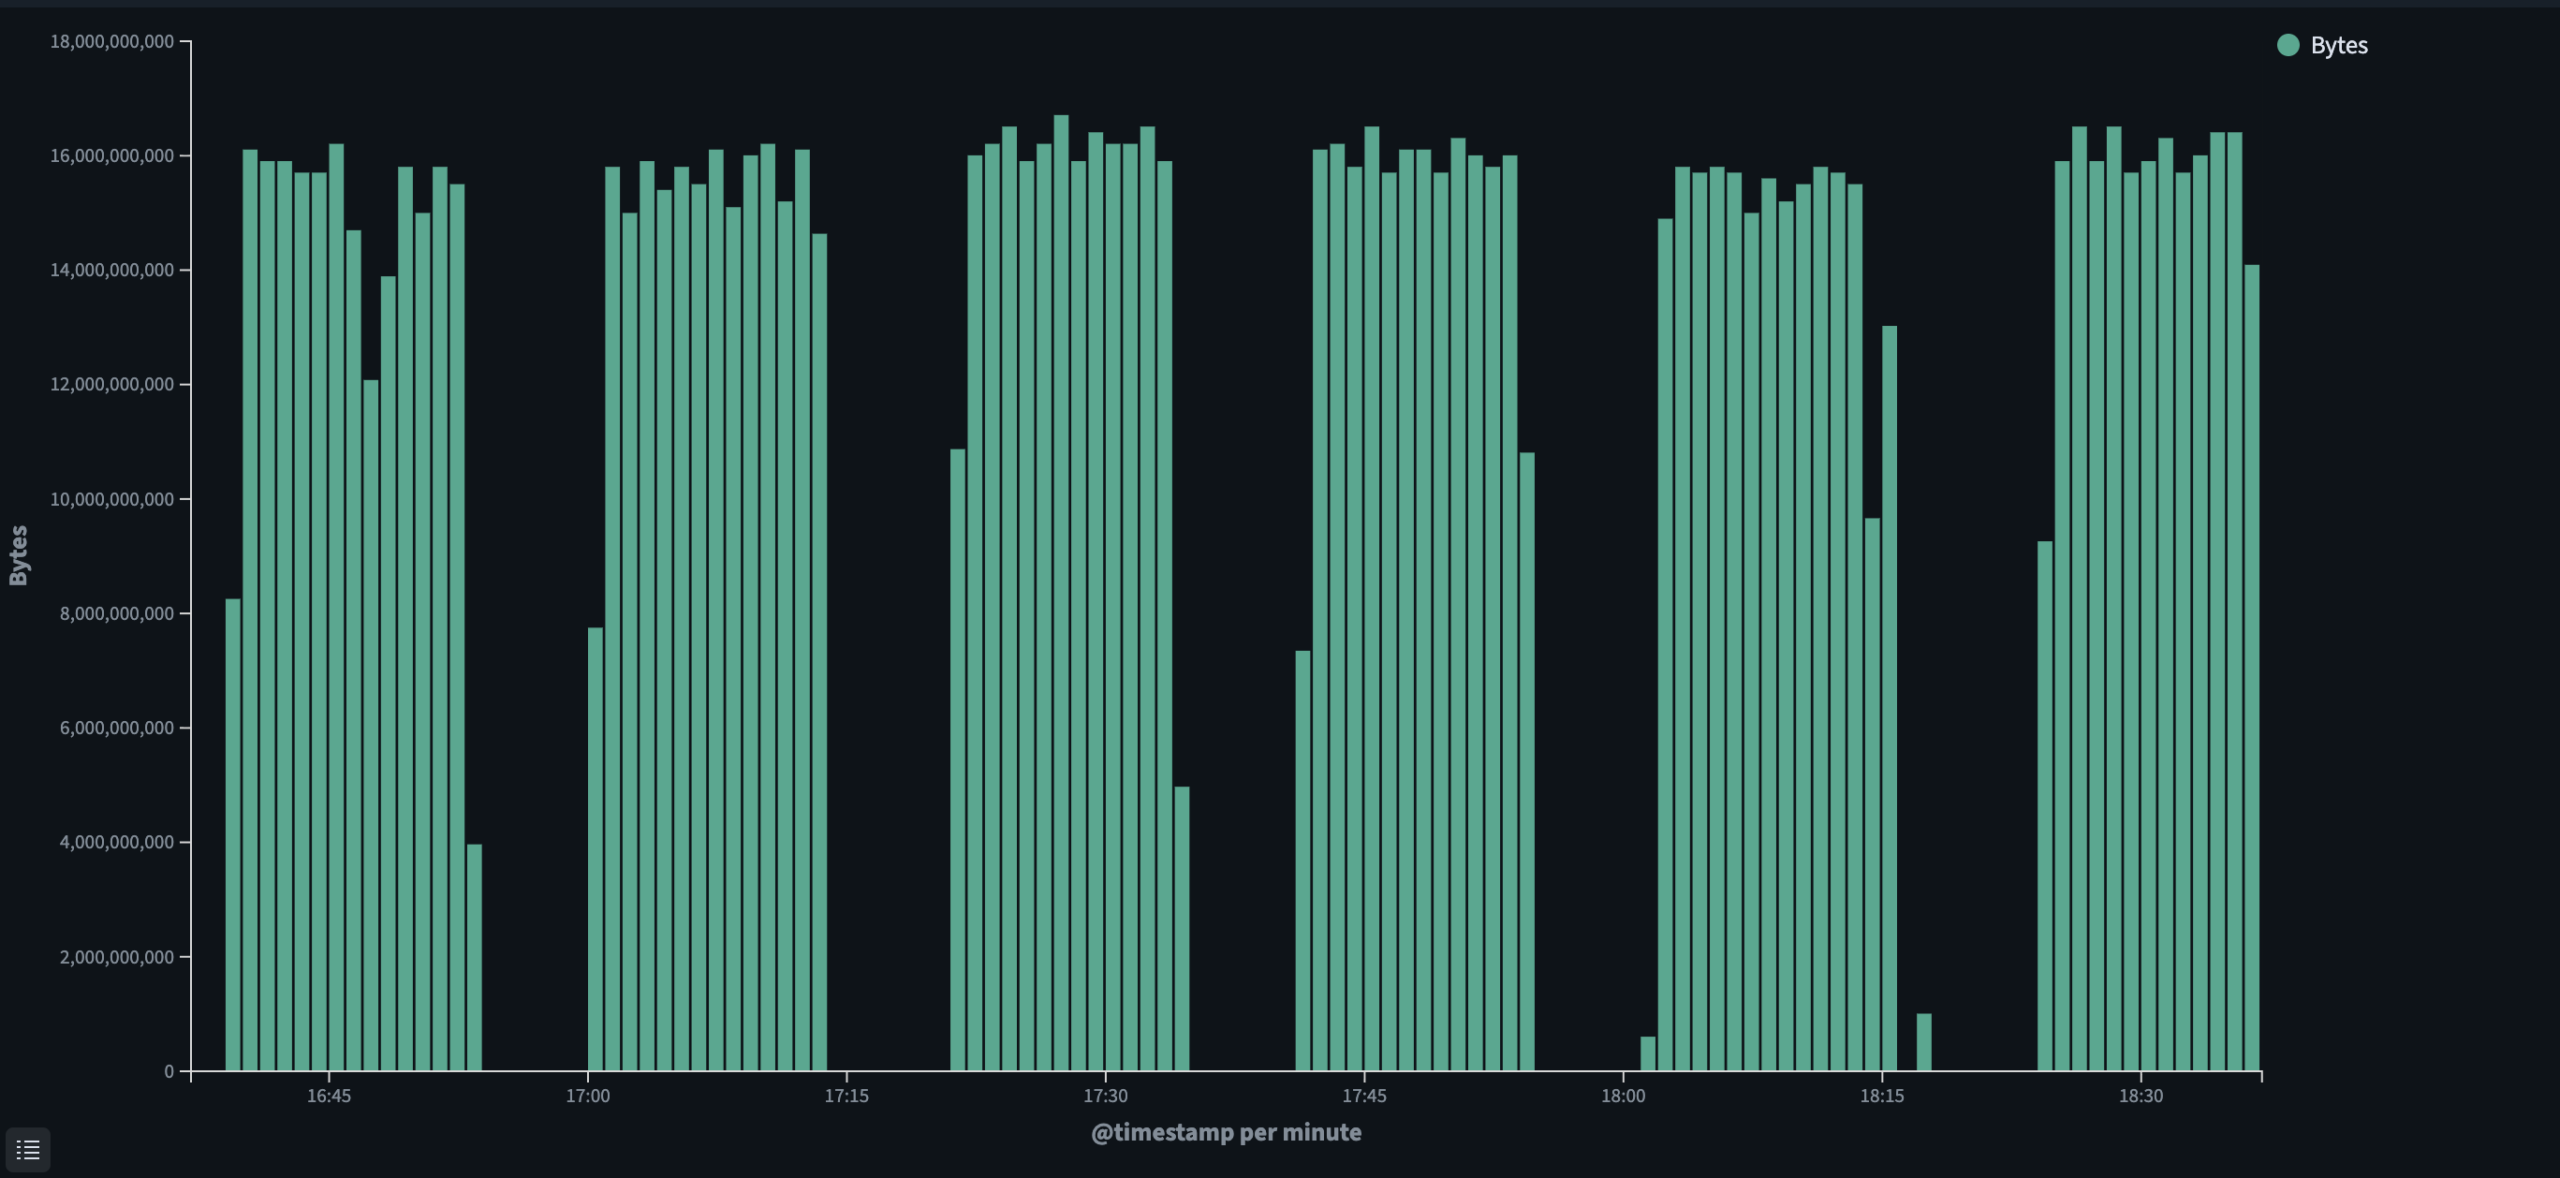
Velocità di trasferimento in byte al minuto durante il caricamento, che mostra una velocità di trasmissione costante tra 15 e 16 GB al minuto nell'arco della finestra di trasferimento attiva.
Progresso cumulativo dei trasferimenti
Il grafico cumulativo dei byte traccia la quantità totale di dati trasferiti dal 4 al 10 febbraio, mostrando una crescita lineare costante da 0 a circa 100 TB in tale periodo. La pendenza costante per tutto il periodo riflette la stabilità del trasferimento, senza interruzioni significative o cali di velocità.
Disposizione finale dei secchi
Backblaze ha creato il bucket pi-314-trillion, che contiene tutti i 628 file e ha una dimensione confermata di 132,210.5 GB. Il bucket è configurato come privato, con tutte le versioni dei file conservate, ed è accessibile tramite l'endpoint compatibile con S3 all'indirizzo s3.us-west-004.backblazeb2.com. L'archiviazione a oggetti semplifica la gestione di un dataset di queste dimensioni. Ogni file è indirizzabile individualmente, l'elenco completo può essere recuperato a livello programmatico e non ci sono gerarchie di file system o limiti di volume da aggirare.
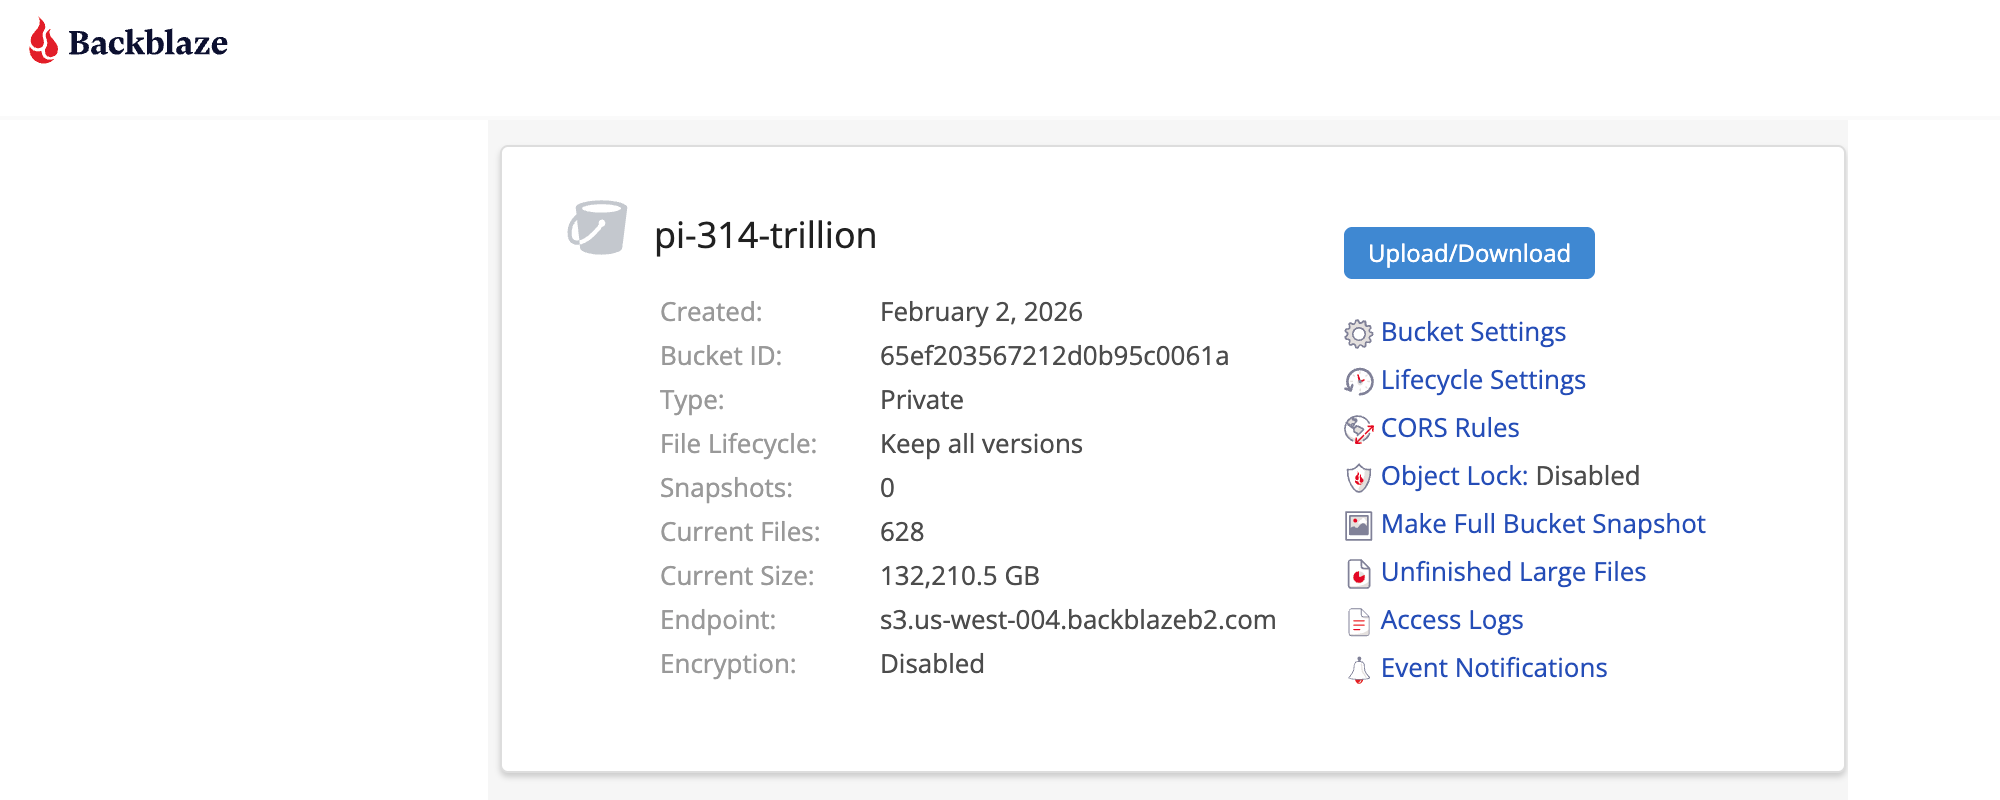
La console di Backblaze B2 mostra il bucket pi-314-trillion che conferma 628 file, una dimensione totale di 132,210.5 GB e l'endpoint compatibile con S3.
Accesso al dataset
I ricercatori ci hanno chiesto di poter accedere a questi dati; infatti, abbiamo già un progetto in corso. Michael Kleber è un ingegnere software principale presso Google, ma si diletta con le cifre di pi greco da quando ha conseguito il dottorato in matematica nel 1999. I matematici si aspettano che pi greco sia un numero normale , quindi è ragionevole chiedersi: "Tra le 10^d sequenze di d cifre, quale impiega più tempo ad apparire per la prima volta in pi greco e di quante cifre ha bisogno?". Kleber ha condotto la ricerca fino a d=7 e, quando Fabrice Bellard ha calcolato 2.7 trilioni di cifre di pi greco nel 2009, Kleber lo ha incoraggiato ad estendere la ricerca fino a d=11, il limite di ciò che era possibile all'epoca. "Con 314 trilioni di cifre casuali, c'è circa il 79% di probabilità di vedere tutte le stringhe di lunghezza 13", afferma Kleber, "quindi spero che saremo fortunati!". Ora che Backblaze ha reso i dati disponibili a tutti, ci aspettiamo che questo accada molto più spesso.
Il dataset PI è ospitato su Backblaze B2 ed è disponibile per il download da chiunque sia interessato a lavorarci. L'accesso è fornito tramite un link di richiesta, attraverso il quale gli utenti possono ottenere le credenziali o le istruzioni per scaricare i file dal bucket. Backblaze manterrà il dataset disponibile per la ricerca e la verifica per tutta la durata del periodo di validità.
Opzioni di download
Gli utenti possono recuperare singoli file dal dataset o l'intera collezione di 130 TB, a seconda delle proprie esigenze. Il bucket è strutturato in modo tale che i singoli oggetti possano essere individuati e scaricati direttamente senza dover scaricare l'intero dataset. Per coloro che desiderano recuperare tutto, è possibile eseguire una sincronizzazione completa del bucket utilizzando gli strumenti descritti di seguito. Per questa opzione, si consiglia di disporre di 135 TB di spazio libero.
Strumenti consigliati
- Rclone è lo strumento consigliato per accedere al dataset. Si integra perfettamente con Backblaze B2 e consente agli utenti di personalizzare il processo di download in base alle proprie esigenze di larghezza di banda.
- API compatibile con S3Pertanto, qualsiasi strumento di download con funzionalità S3 può essere utilizzato per recuperare i dati. L'unico requisito è che lo strumento consenta di sovrascrivere l'URL predefinito dell'endpoint S3 in modo che punti all'endpoint B2 anziché ad AWS.
Un esempio concreto di infrastruttura ibrida
Il nostro calcolo del Pi greco da 314 trilioni di cifre è un chiaro esempio di come si presenta un'infrastruttura ibrida nella pratica. Il calcolo è stato eseguito interamente su un singolo server Dell PowerEdge R7725 nel laboratorio di StorageReview, ma poiché il sistema doveva essere riallocato ad altri progetti e attività una volta completata l'esecuzione, mantenere 130 TB di risultati ospitati permanentemente nel laboratorio non è mai stata un'opzione sostenibile.
Il desiderio di rendere i dati disponibili a chiunque voglia utilizzarli, sia per un serio lavoro scientifico che per soddisfare la curiosità sui numeri, è reale. Tuttavia, ospitare un set di dati di tali dimensioni all'interno del laboratorio diventa rapidamente un onere per le attività operative. La larghezza di banda si esaurisce, l'infrastruttura rimane sovraccarica e il lavoro quotidiano del laboratorio entra in competizione con ogni richiesta di download in arrivo.
Una soluzione come Backblaze B2 elimina tutti questi ostacoli. I dati risiedono in un'infrastruttura cloud progettata appositamente per set di dati di queste dimensioni, con una velocità di trasmissione che si adatta alla domanda, molteplici punti di ridondanza per garantire che nulla vada perso e la sicurezza e l'esperienza operativa tipiche di una piattaforma di storage enterprise. L'elaborazione era on-premise perché il progetto lo richiedeva. Lo storage è nel cloud perché è semplicemente lo strumento migliore per tutto ciò che verrà dopo.



 Amazon