

Il Dell Pro Max 16 Plus racchiude due storie, che però si sviluppano in direzioni opposte. La prima è quella di una workstation mobile di altissimo livello: processore Intel Core Ultra 9 285HX a 24 core, fino a 256 GB di memoria CAMM2, tre slot M.2, scheda grafica NVIDIA RTX PRO Blackwell fino alla serie 5000 con 24 GB di GDDR7, certificazione MIL-STD-810H e uno chassis in cui Dell ha chiaramente investito notevoli risorse ingegneristiche.
L'altro modello è quello in esame, che sostituisce la GPU con una scheda di inferenza Qualcomm AIC100 PC, un modulo dual-SoC basato su un chip Cloud AI 100 del 2019 e uno stack software che trasforma la maggior parte dei moderni carichi di lavoro di inferenza in un'esperienza frustrante. Questo è un monito su cosa succede quando uno chassis di punta viene abbinato all'acceleratore sbagliato e sul perché i clienti debbano comprendere lo stack software alla base di una soluzione di intelligenza artificiale prima di firmare l'ordine di acquisto. Prima di arrivare al perché, diamo un'occhiata al laptop nel suo complesso.
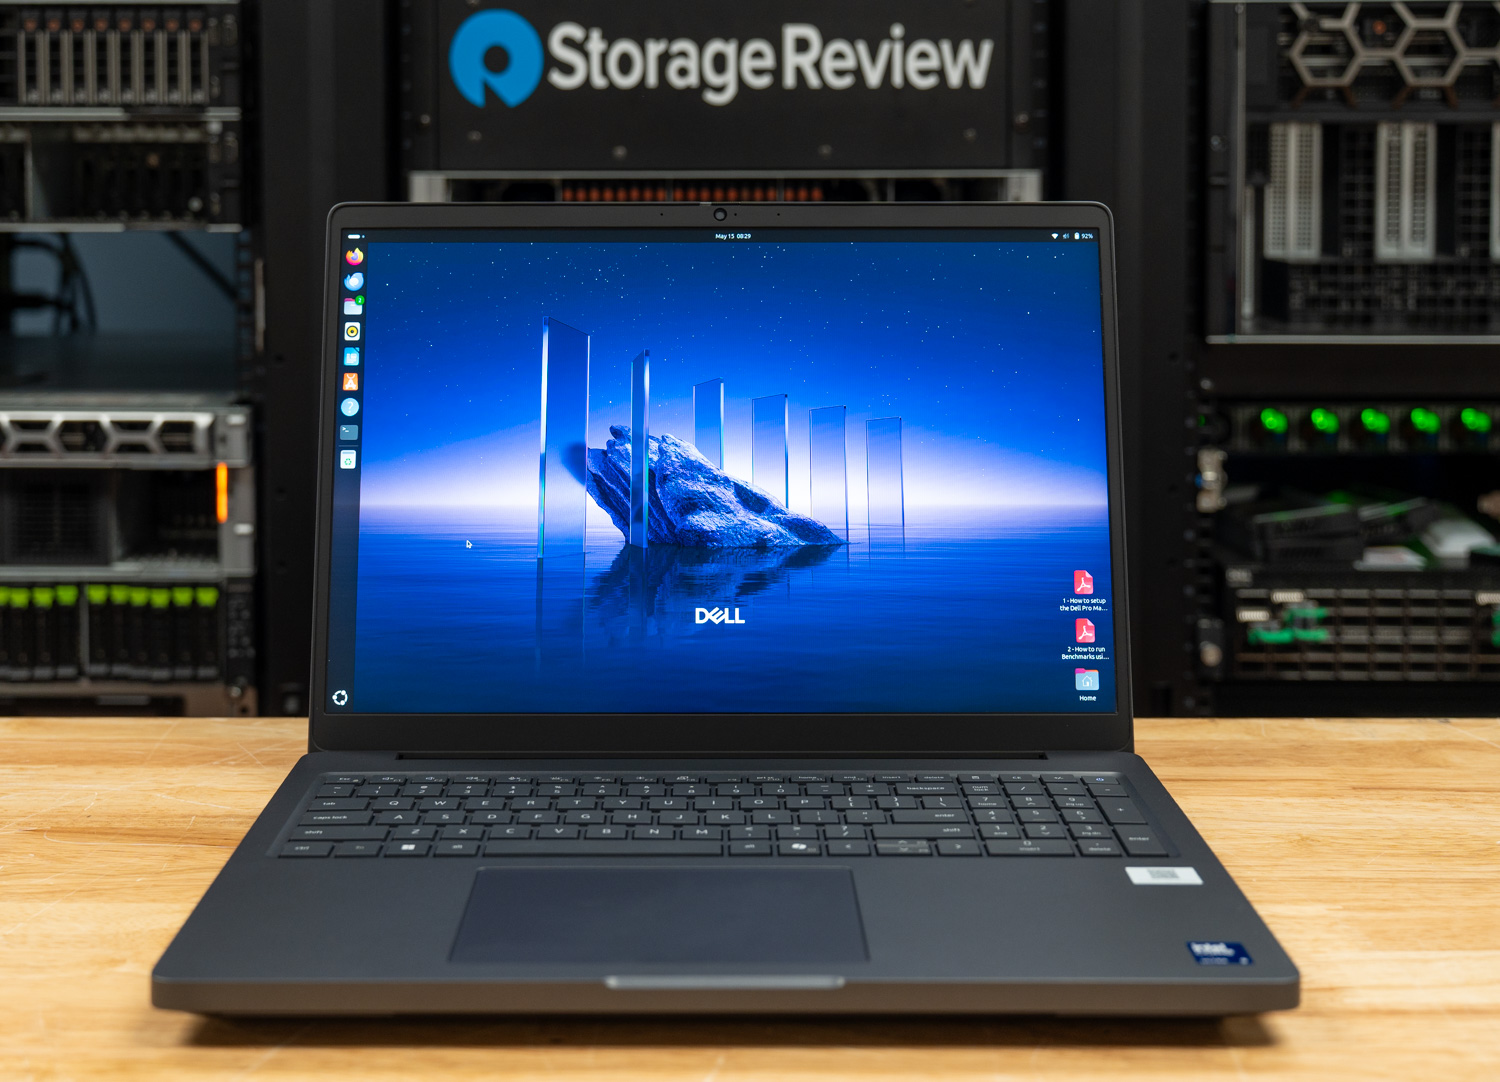
Il Pro Max 16 Plus si posiziona al vertice della gamma di workstation Pro Max di Dell, offrendo una potenza di calcolo superiore sia al modello base Pro Max 16 che al più sottile Pro Max 16 Premium. Il suo cuore pulsante è il processore Intel Core Ultra 9 285HX, un chip scalabile da 55 watt con 24 core e una frequenza Turbo Boost di 5.5 GHz. Tutte le configurazioni della CPU supportano Intel vPro Enterprise, rafforzando le credenziali di livello enterprise del laptop. Il prezzo parte da 2,779 dollari.
Le opzioni grafiche spaziano dalla grafica integrata Intel alla RTX PRO 1000 basata su architettura Blackwell di NVIDIA, fino ad arrivare alla RTX PRO 5000 che abbiamo recensito in precedenza , dotata di ben 24 GB di memoria GDDR7. Anche le configurazioni di storage e memoria sono altrettanto generose: fino a 12 TB distribuiti su tre slot M.2 Gen5 e fino a 128 GB di memoria DDR5-6400 tramite il modulo CAMM2 di Dell.
Le opzioni di visualizzazione spaziano da un pannello IPS di base da 1920 x 1200 al vivido touchscreen OLED da 3840 x 2400. Tra i due si colloca un'opzione intermedia da 1920 x 1200, che aggiunge 500 nit di luminosità, una frequenza di aggiornamento variabile a 120 Hz e la copertura completa dello spazio colore DCI-P3. Con oltre 100 certificazioni ISV, i professionisti creativi possono contare su un funzionamento fluido delle proprie applicazioni.
Le funzionalità di sicurezza sono di livello aziendale e includono un lettore di impronte digitali, il supporto per smart card, NFC, una fotocamera a infrarossi da 8 MP per il riconoscimento facciale e Dell Control Vault 3. La garanzia standard di tre anni completa il pacchetto, sottolineando il ruolo del laptop come strumento professionale per il lavoro.
Specifiche del Dell Pro Max 16 Plus
| Specificazione | Dell Pro Max 16 Plus |
|---|---|
| Piattaforma | |
| Processore | Intel Core Ultra 5 245HX Intel Core Ultra 7 265HX Intel Core Ultra 9 285HX |
| Sistema operativo | Finestre 11 Pro Ubuntu Linux 24.04 LTS |
| Memorie | 16-128 GB CSoDIMM o CAMM2, 1 slot |
| Accelerazione grafica e IA | |
| Scheda grafica | Grafica integrata Intel NVIDIA RTX PRO 1000 8GB NVIDIA RTX PRO 2000 8GB NVIDIA RTX PRO 3000 12GB NVIDIA RTX PRO 4000 16GB NVIDIA RTX PRO 5000 24GB Qualcomm AI Cloud 100 64GB (2x 32GB) |
| Archiviazione e visualizzazione | |
| Archiviazione | Fino a 3 SSD M.2, 4 TB ciascuno RAID 0/1/5 disponibili |
| Display | 16 pollici 16:10 1920×1200, 300 nit, 45% NTSC, 60Hz, non touch 1920×1200, 500 nit, 100% DCI-P3, 120Hz VRR, non touch 3840×2400, 500 nit, OLED, touch |
| Connettività e potenza | |
| Telecamere | 8MP IR |
| Networking Wireless | Intel Wi-Fi 7 BE200, con o senza Bluetooth 5.4 Banda larga mobile disponibile |
| batteria | 6 celle da 96 Wh |
| Adattatore di alimentazione | 165W o 280W |
| Sicurezza e fisica | |
| Caratteristiche di sicurezza | Webcam a infrarossi lettore di impronte digitali Lettore di smart card NFC Controlla il caveau 3 |
| Dimensioni e peso | 1.22 di 10.18 di 14.17 pollici Peso iniziale: 5.63 libbre |
| Garanzia | Garanzia standard di tre anni, riparazione in loco il giorno lavorativo successivo |
Costruire e disegnare
Come il modello precedente che abbiamo recensito, il Pro Max 16 Plus è indiscutibilmente robusto, vantando la certificazione MIL-STD-810H per la resistenza in ambienti difficili. La scelta dei materiali da parte di Dell è fortemente orientata alla sostenibilità, con l'utilizzo di plastica riciclata post-consumo, magnesio e cobalto riciclati e plastiche di origine biologica. Al tatto, lo chassis risulta eccezionalmente rigido, senza alcuna flessione percepibile. In breve, è costruito come un carro armato.
Si tratta di un dispositivo piuttosto ingombrante. Con uno spessore di 1.22 cm (piedini inclusi) e un peso a partire da 5.63 kg, non è pensato per essere trasportato frequentemente, sebbene le sue dimensioni di 10.18 x 14.17 cm siano ragionevolmente compatte per un display da 16 pollici in formato 16:10. La webcam è posizionata nella parte superiore del coperchio, completa di otturatore scorrevole per la privacy; l'unità che abbiamo ricevuto per la recensione è dotata della versione a infrarossi per il riconoscimento facciale.
Dal punto di vista estetico, il linguaggio di design di Dell è fin troppo sobrio. L'esterno grigio-nero e il marchio discreto sottolineano che si tratta di un prodotto in cui la funzionalità ha la precedenza sull'estetica. La linea Pro Max Premium offre un aspetto più accattivante a scapito delle prestazioni e delle possibilità di espansione.
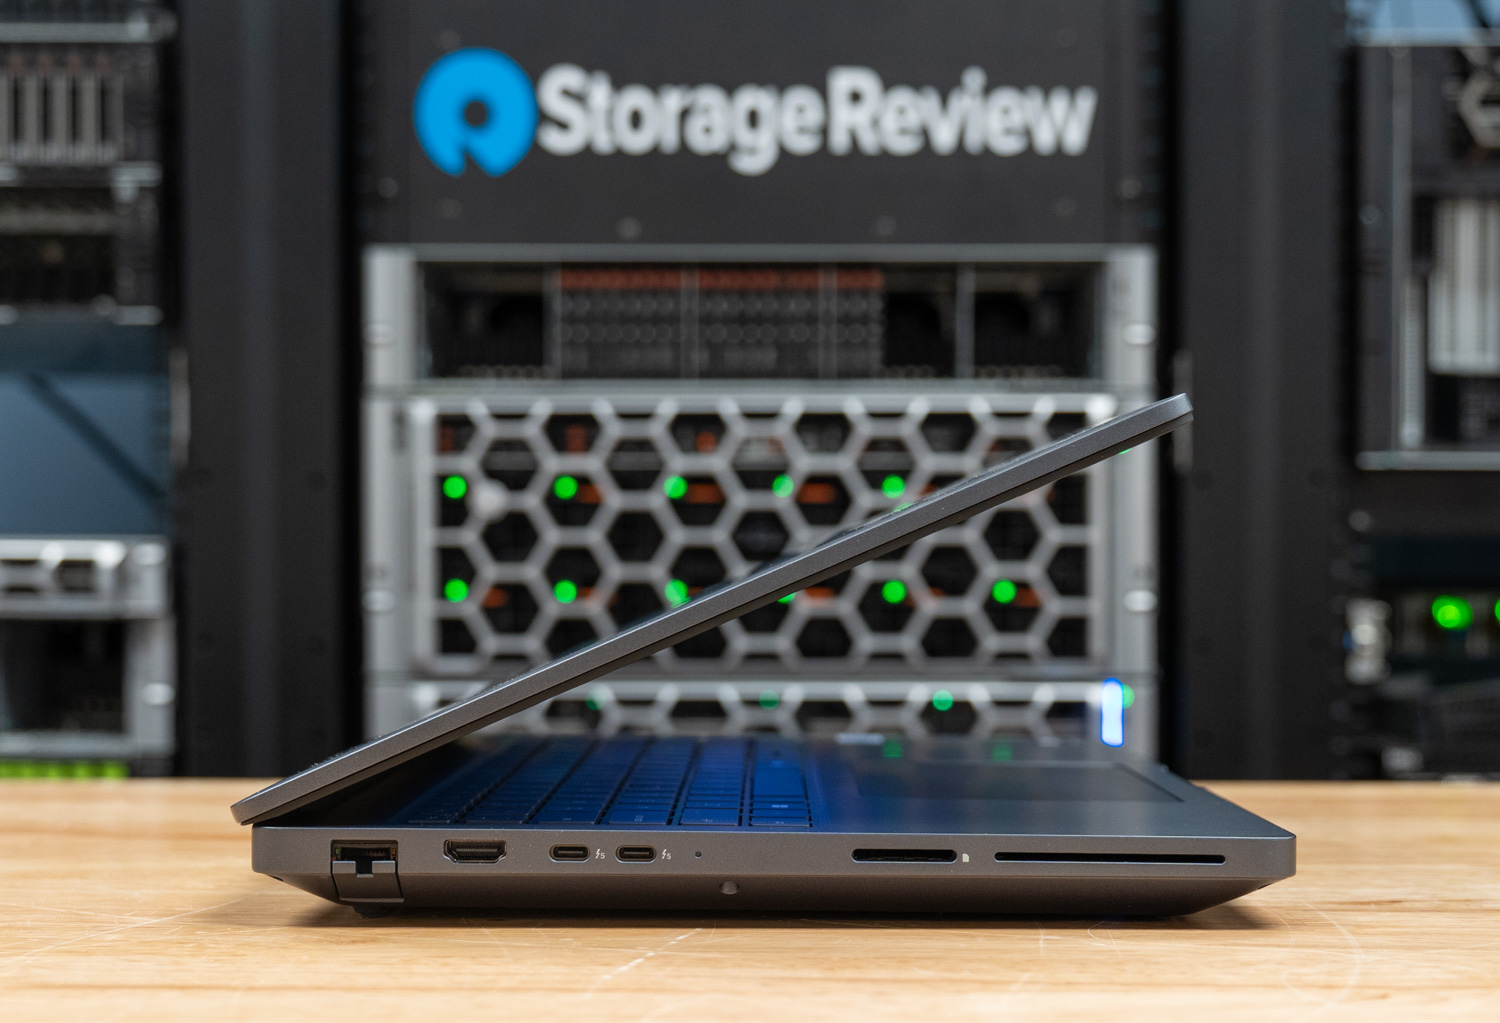
La selezione completa delle porte inizia sul bordo sinistro:
- Ethernet RJ45 da 2.5 Gbps
- Uscita HDMI 2.1
- Due porte 5 (USB-C) Thunderbolt
- lettore di schede SD
- Slot SmartCard opzionale
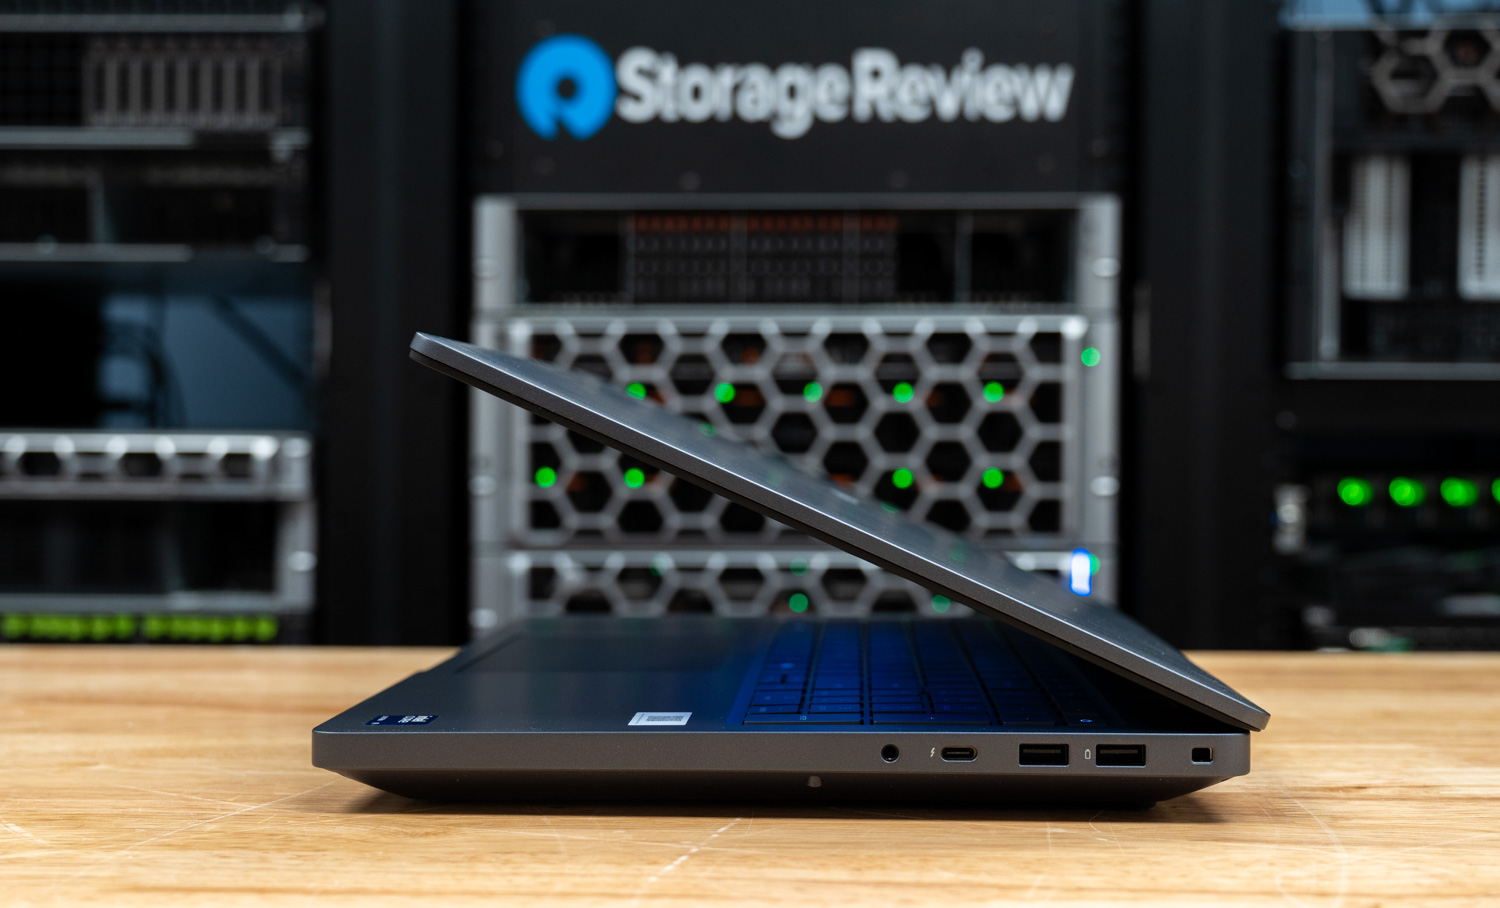
Sulla destra:
- Jack audio 3.5mm
- Thunderbolt 4 (USB-C)
- Due porte USB 3.2 Gen1 Type-A
- Foro per blocco
Sul bordo posteriore non sono presenti porte. La connettività wireless è gestita dal modulo Intel BE200, che supporta Wi-Fi 7 e Bluetooth 5.4. Il Bluetooth può essere omesso nelle configurazioni personalizzate ed è disponibile anche la banda larga mobile 5G.
Schermo e dispositivi di input
Il modello che abbiamo testato è dotato di un display Dell da 16 pollici con risoluzione 1920×1200 e pannello VRR a 120Hz, che offre prestazioni eccellenti nell'uso quotidiano. I colori sono vivaci e, grazie alla copertura del 100% dello spazio colore DCI-P3, è ideale per flussi di lavoro in cui la precisione del colore è fondamentale, una volta calibrato. La luminosità di 500 nit contribuisce inoltre a mantenere un'esperienza visiva confortevole anche in ambienti di lavoro o studio luminosi.
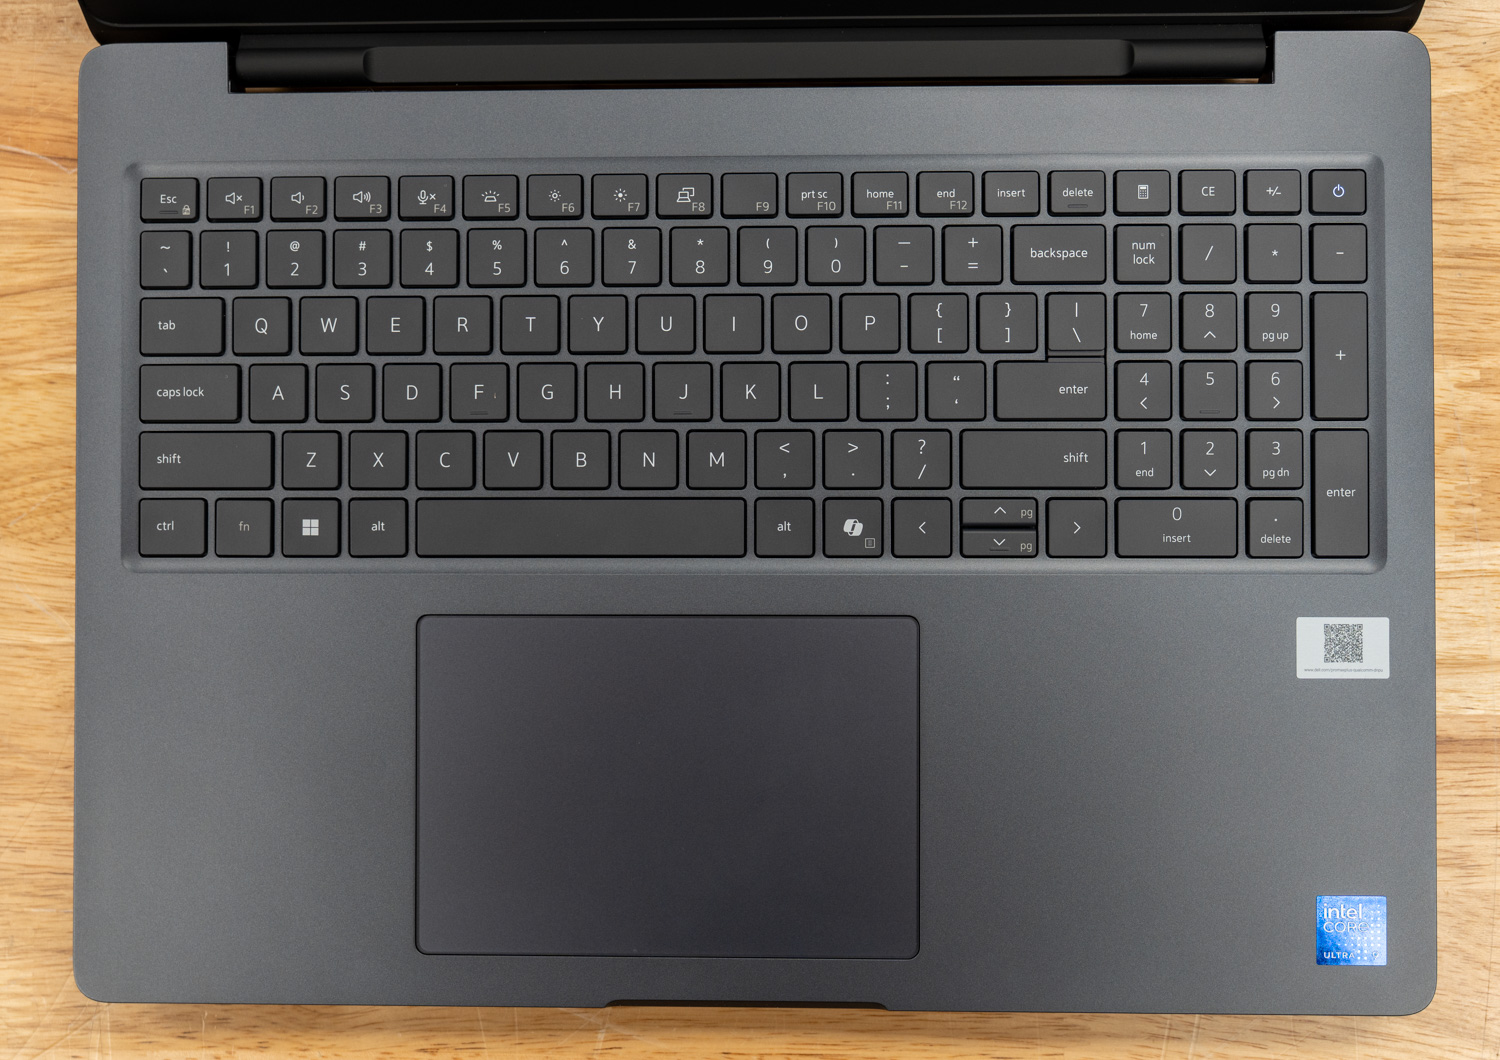
La tastiera Dell è ideale per lunghe sessioni di digitazione, con tasti di dimensioni standard che offrono una sensazione leggera e reattiva e un feedback tattile preciso. La retroilluminazione bianca la rende visibile anche in ambienti poco illuminati. Il layout è in gran parte convenzionale, ma le dimensioni non uniformi dei tasti freccia possono causare occasionali pressioni errate, e la posizione dei tasti Home e Fine rappresenta un particolare svantaggio: condividono lo spazio con F11 e F12, quindi l'attivazione del blocco Fn (Fn + Esc) per dare priorità alla riga dei tasti funzione obbliga a premere Fn + F11 o F12 per accedervi. Sarebbero stati graditi tasti Pagina Su e Pagina Giù dedicati; invece, sono funzioni secondarie delle frecce su e giù, che sono già i tasti più scomodi del gruppo. Il pulsante di accensione, situato in alto a destra, funge anche da sensore di impronte digitali.
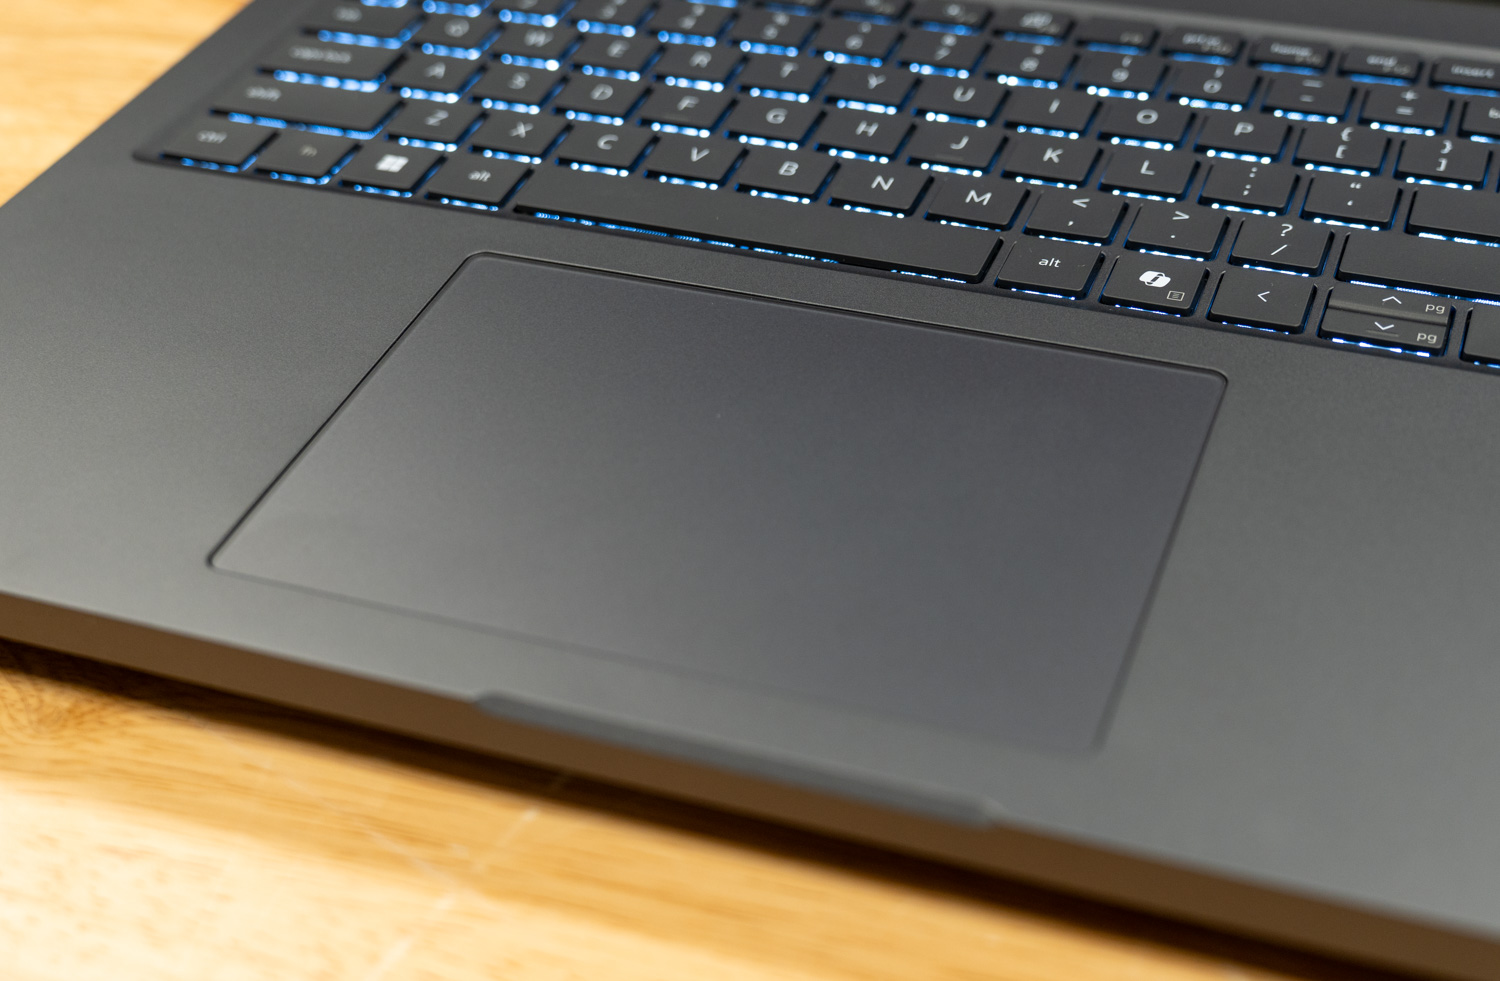
Il touchpad di dimensioni generose si integra perfettamente con il formato da 16 pollici. La sua superficie liscia e antiriflesso garantisce un tracciamento preciso e la funzione di riconoscimento del palmo ha funzionato in modo impeccabile durante tutti i test.
Aggiornabilità
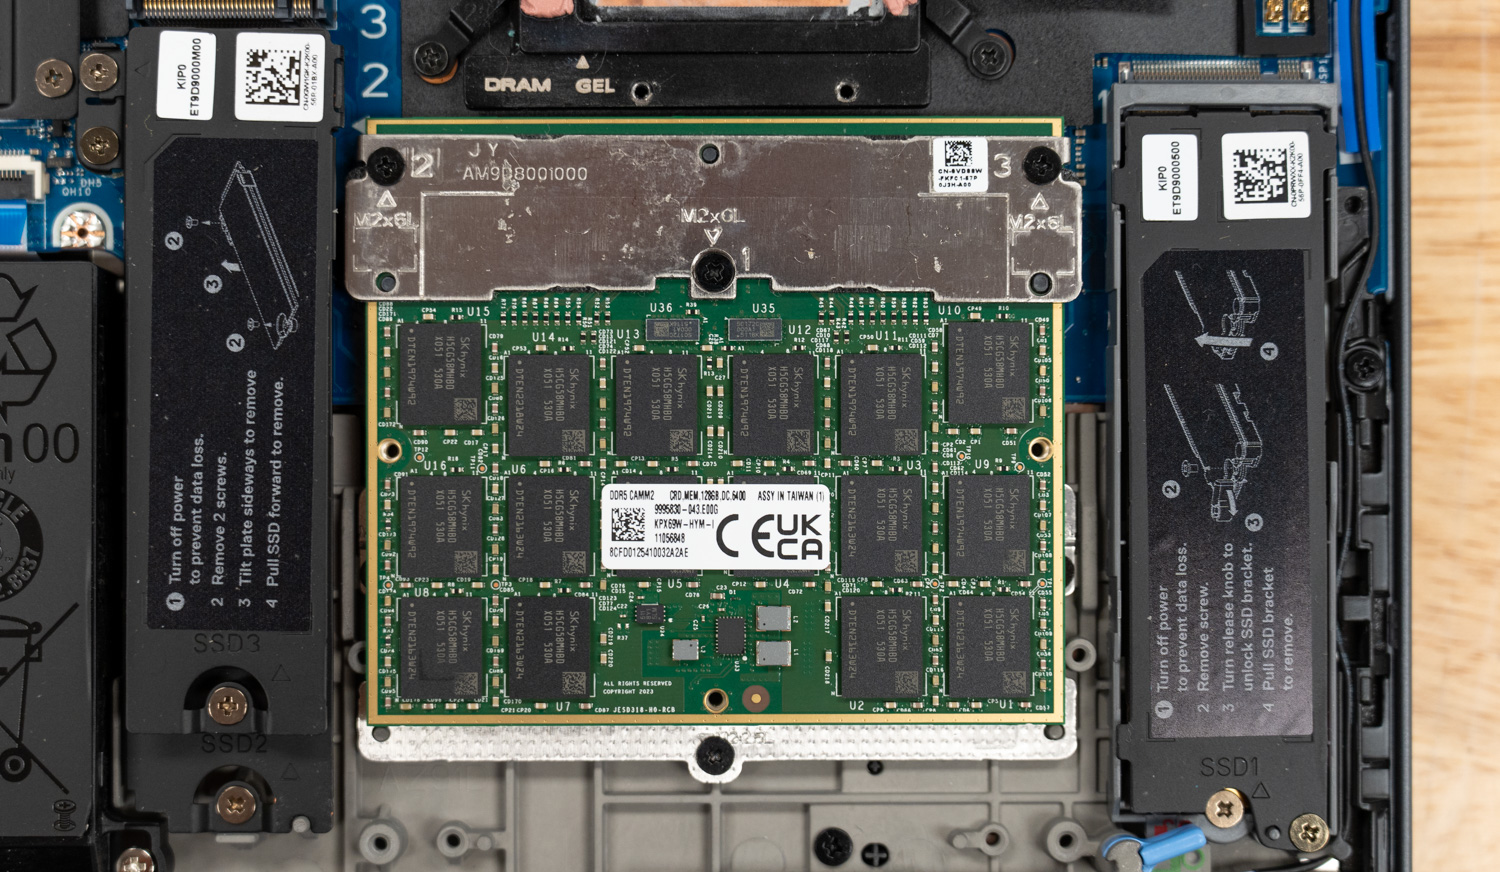
Il Pro Max 16 Plus è progettato per essere espandibile, offrendo un notevole potenziale di aggiornamento. È dotato di tre slot M.2 Gen5 per l'archiviazione, uno slot CAMM2 per l'espansione della memoria e diversi componenti modulari, tra cui porte USB-C sostituibili.
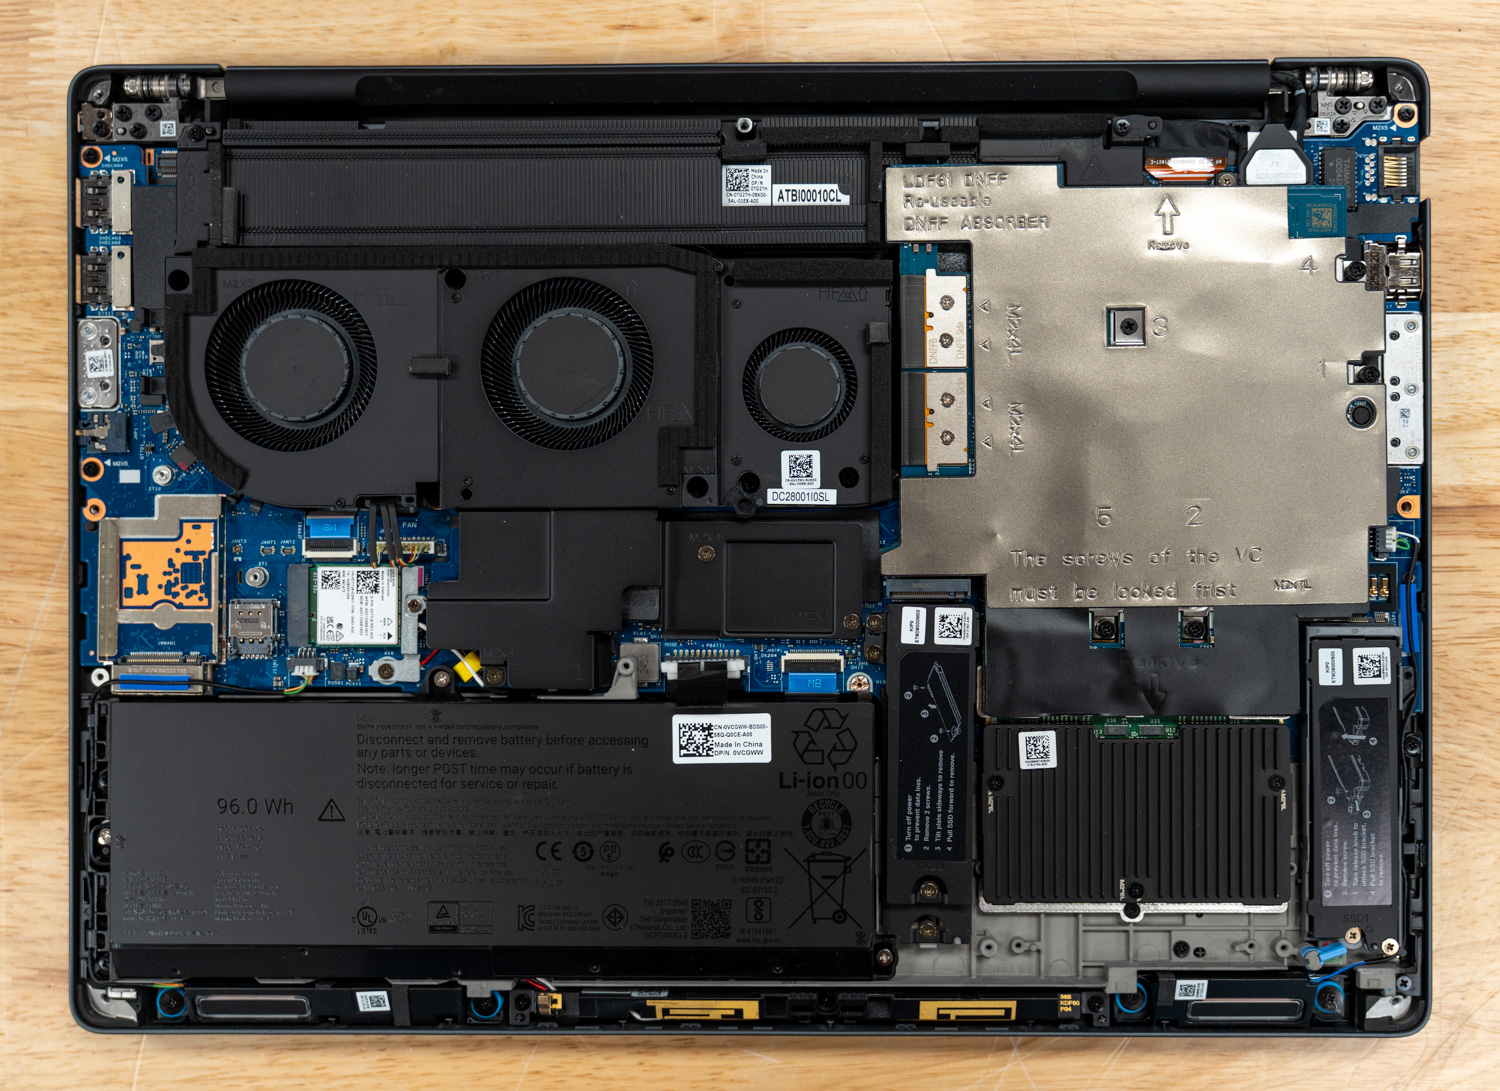
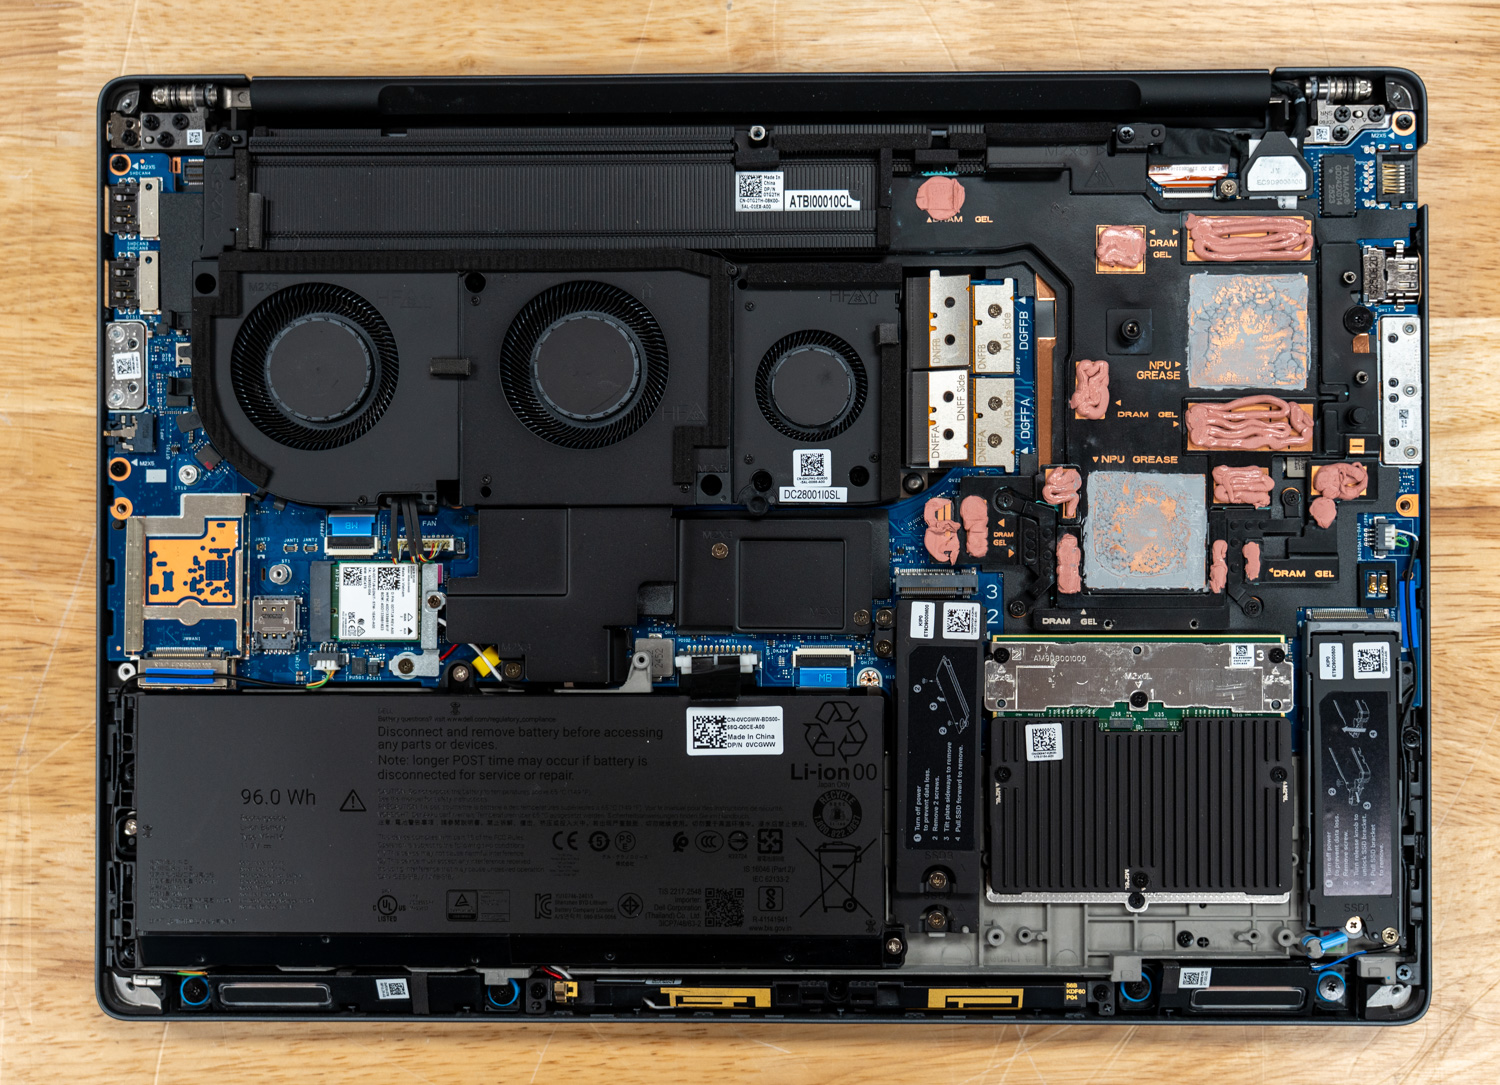
Accedere ai componenti interni è semplice: basta rimuovere le viti perimetrali e sollevare il pannello inferiore da dietro in avanti. All'interno, si trova un robusto sistema di raffreddamento a tre ventole e una capiente batteria da 96 Wh. Il modulo di memoria CAMM2 si trova in basso a destra, posizionato sotto un dissipatore dedicato e affiancato dagli slot M.2. Dalla foto non si nota bene, ma lo slot M.2 a sinistra è in realtà uno slot sovrapposto che ospita due unità nello stesso ingombro. La scheda wireless M.2, anch'essa sostituibile dall'utente, si trova appena sopra la batteria.
La star dello show: Qualcomm AIC100
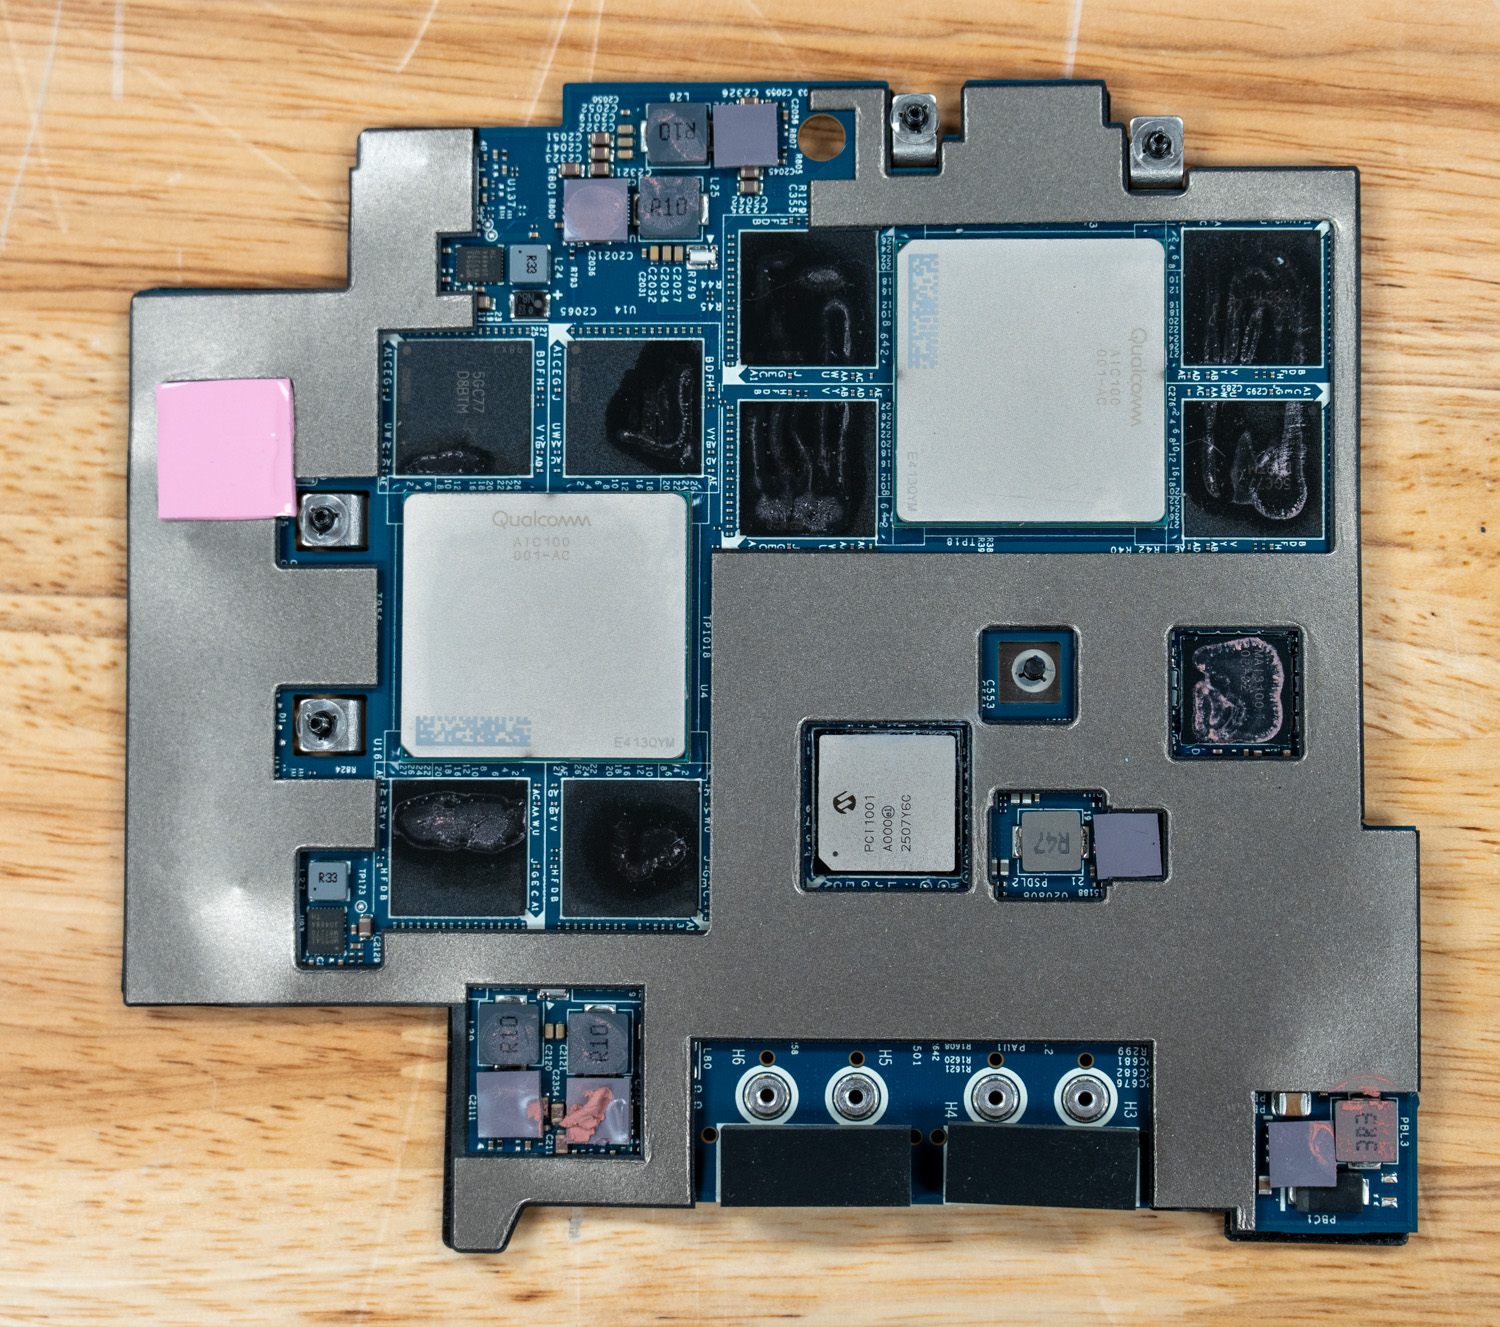
Il modello Dell in esame è dotato di NPU Qualcomm AI 100, un singolo modulo che ospita due SoC Qualcomm Cloud AI 100 affiancati. Ciascun SoC contribuisce con 16 core AI, per un totale di 32 core nell'intero modulo, e ognuno dispone di 32 GB di memoria LPDDR4x, presentati all'host come due NPU individuali.
Dell e Qualcomm pubblicizzano circa 450 TOPS di throughput INT8 e la capacità di eseguire modelli con un numero di parametri nell'ordine dei 100 miliardi, con Dell che ha dimostrato pubblicamente l'esecuzione locale di Llama 4 Scout (109 miliardi di parametri, MoE) sul laptop. I due SoC comunicano con l'host tramite il driver acceleratore QAIC di Linux, con i firmware integrati nel progetto linux-firmware.
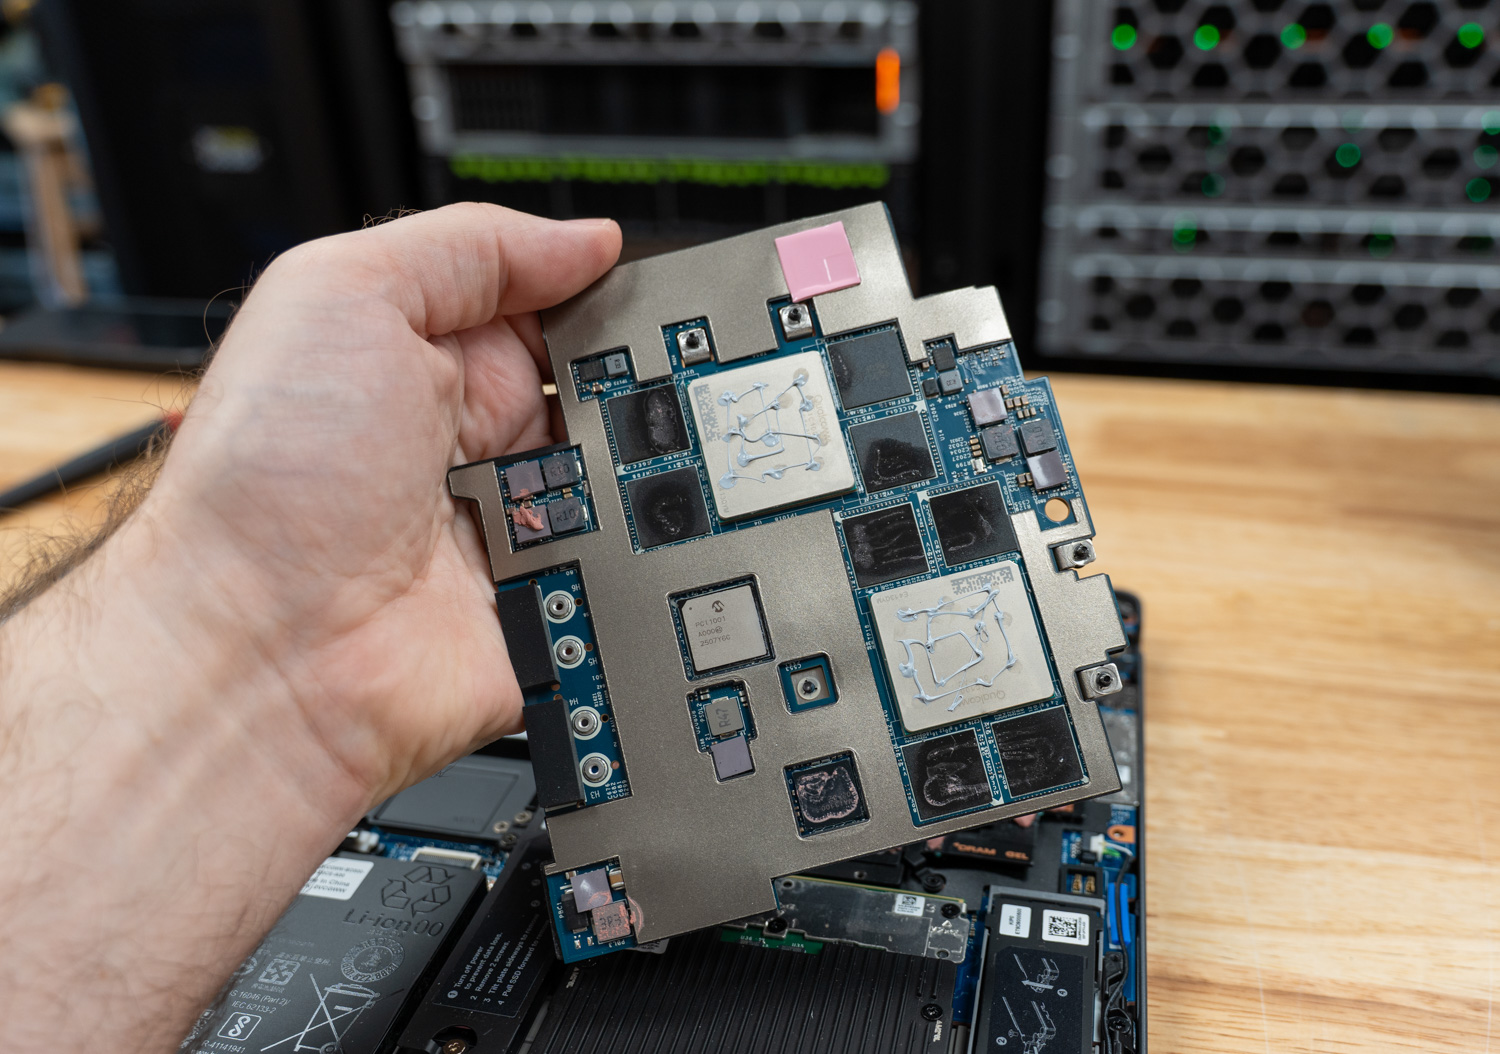
Fin qui tutto bene. I numeri, presi singolarmente, sono elevati. Il problema è il silicio che si cela dietro a quei numeri.
Qualcomm ha annunciato il Cloud AI 100 nell'aprile del 2019, ne ha distribuito dei campioni alla fine del 2020 e ha iniziato la commercializzazione nella prima metà del 2021. Il chip è realizzato con un processo produttivo a 7 nm e utilizza quattro controller LPDDR4X a 64 bit con una frequenza di 2100 MHz (LPDDR4X-4200), offrendo una larghezza di banda di memoria di 136 GB/s per SoC, secondo la documentazione sull'architettura Cloud AI di Qualcomm.
Originariamente era stato progettato pensando al fattore di forma PCIe. Inserire due di questi chip in un modulo personalizzato e installarlo in un laptop del 2025 non cambia i compromessi di fondo. Si tratta di silicio del 2019 con tecnologia di memoria del 2019, aggiornato e rinominato, ma architettonicamente appartenente alla stessa famiglia. Quando è approdato nel Dell Pro Max 16 Plus, il resto del settore era già passato a HBM2e, HBM3, HBM3e e LPDDR5X, e ora si sta dirigendo verso GDDR7 e HBM4 per gli acceleratori AI di fascia alta.
Ma il problema più profondo va oltre la larghezza di banda della memoria. Nel settore esistono molti progetti di chip brillanti e team di ingegneri che comprendono a fondo il problema dell'inferenza AI, e l'architettura stessa di Cloud AI 100 potrebbe essere competente. Il problema è che gli ingegneri software che effettivamente determinano il successo o il fallimento di un prodotto hanno già investito molto in un altro ecosistema: CUDA. A meno che non ci sia un forte incentivo a cambiare, gli sviluppatori rimangono fedeli alla toolchain che gode già di un ottimo supporto, documentazione e aiuto da parte della community. NVIDIA ha conquistato la base di sviluppatori fin da subito e ha costruito un'enorme community attorno ad essa. AMD è rimasta indietro per anni su questo fronte, ma le recenti versioni di ROCm sono davvero eccellenti e il divario si sta riducendo. Soluzioni come Mojo e MAX di Modular consentono persino di utilizzare lo stesso codice sia su NVIDIA che su AMD, e a volte superano le prestazioni dei runtime nativi. Tutti gli altri acceleratori, tuttavia, faticano ad affermarsi sul mercato a causa della mancanza di supporto software.
L'adozione pubblica è la parola chiave. Grandi organizzazioni come Google possono investire miliardi in XLA e JAX per far funzionare al meglio le TPU . Startup private ben finanziate e laboratori di intelligenza artificiale possono scrivere kernel personalizzati per il loro ristretto set di modelli e non preoccuparsi del fatto che nessun altro possa replicare lo stack che stanno costruendo, non per infiniti casi d'uso pubblici; lo stanno costruendo per i problemi che devono affrontare. Per un utente pubblico, o anche per la maggior parte delle aziende, un acceleratore senza un fiorente ecosistema di sviluppatori pubblici è praticamente inutile. Si perderanno settimane cercando di caricare il proprio modello e, nel momento in cui Hugging Face rilascerà una nuova architettura, ci si troverà di fronte a una ricompilazione (o a un errore di modello non supportato) mentre tutti coloro che utilizzano CUDA e ROCm avranno il supporto fin dal primo giorno.
Quindi, diciamolo chiaramente: l'AIC100 di questo portatile è completamente inutilizzabile. Nessun privato dovrebbe acquistarlo. Nessuna organizzazione dovrebbe acquistarlo a meno che non disponga delle risorse ingegneristiche e dell'esplicita intenzione di implementare l'inferenza da zero per il proprio specifico carico di lavoro, e abbia accettato di assumersi la responsabilità della manutenzione di tale infrastruttura.
La realtà del software e degli strumenti
Per capire perché questa raccomandazione sia così severa, bisogna esaminare cosa implica effettivamente l'inferenza di spedizione su questa carta.
Le componenti rivolte all'utente sono suddivise in due SDK e una libreria wrapper. Il Qualcomm Cloud AI Platform SDK include il driver del kernel (il driver accel/qaic upstream in Linux mainline), il firmware del dispositivo, il runtime on-card e le API di basso livello. L'Apps SDK si basa su questi e fornisce il compilatore qaic-exec, la CLI di inferenza qaic-runner, l'integrazione con ONNX Runtime tramite un provider di esecuzione QAIC, binding Python e una versione modificata di vLLM. La libreria Qualcomm efficient-transformers, chiamata anche QEfficient, è un wrapper per Hugging Face Transformers che reimplementa le architetture LLM più diffuse con le forme statiche, i layout della cache KV e le trasformazioni del grafo richiesti dall'AIC100. Qualcomm AI Hub è un catalogo di modelli separato e un servizio di compilazione (compile-as-a-service) pensato più per dispositivi di classe Snapdragon che per l'AIC100, pur condividendone il marchio.
Il percorso di compilazione è rigido. Si prende un modello PyTorch, lo si esporta usando torch.export o ONNX e lo si passa a qaic-exec con flag come -convert-to-fp16, -mxfp6-matmul, una dimensione del batch, una lunghezza del contesto e un numero di SoC di destinazione. Il compilatore esegue la pianificazione e l'allocazione della memoria in anticipo, quindi genera un QPC, un Qualcomm Program Container, un binario sigillato che fissa il layout della memoria, la forma della cache KV, la dimensione del batch, la lunghezza della sequenza di pre-riempimento e la lunghezza del contesto. Non è presente il JIT. Secondo la documentazione LLM di Qualcomm, il compilatore AI 100 in anticipo pre-alloca le risorse del dispositivo in base alla lunghezza del prompt, alla lunghezza della generazione, alla cache KV e alla dimensione del batch, e il Cloud AI 100 supporta solo forme di input statiche. Qualsiasi modifica a questi parametri in fase di compilazione attiva una nuova compilazione completa, che può richiedere molti minuti per i modelli piccoli e ore per quelli grandi.
L'elenco delle architetture supportate è molto breve. La libreria QEfficient e il catalogo di QPC preconfigurati ospitati su Zentree, a cui Dell indirizza i clienti, coprono principalmente modelli più vecchi, e solo una manciata di essi risultano ancora utilizzabili nel 2026.
I checkpoint nativi FP8 più recenti richiedono una riquantizzazione. Se un modello viene distribuito nativamente in MXFP4, come nel caso dei popolari modelli GPT-OSS, si dovrà ricorrere a una pipeline di conversione e ricompilazione anziché semplicemente inserire i pesi. Nessuno di questi problemi è impossibile da aggirare con il giusto impegno, ma rappresenta comunque un costo costante.
Poi c'è il problema della concorrenza, che è il punto debole del portatile, persino per gli sviluppatori che puntano alle prestazioni immediate. Le immagini container fornite da Dell, che Dell consiglia agli utenti di scaricare ed eseguire con vLLM, si basano su QPC precompilati da Zentree con forme specifiche, e i container distribuiti funzionano solo con una concorrenza pari a 1. Indipendentemente dalla forma della sequenza di input o output, si ottiene un singolo throughput fisso per un dato modello. Più richieste parallele non vengono eseguite contemporaneamente; vengono accodate ed elaborate in sequenza da vLLM. Non è possibile eseguire il batching dinamico. Non è possibile utilizzare il batching continuo come quello offerto gratuitamente da vLLM o SGLang sulle GPU Team Red o Green. Per ottenere una concorrenza superiore a 1, è necessario ricompilare il QPC con una dimensione del batch maggiore.
Gli esempi di Dell promuovono questo laptop agli sviluppatori, e il caso d'uso dell'IA più diffuso tra gli sviluppatori oggi è la programmazione intuitiva con strumenti come Claude Code, OpenCode e simili. Una singola richiesta a questi strumenti può generare più chiamate LLM in parallelo; di default, queste NPU mettono in coda tali richieste e le elaborano in sequenza anziché in parallelo, quindi un'operazione che potrebbe richiedere secondi su una NVIDIA Spark richiederà minuti su questa configurazione.
Cookie di prestazione
Il sistema fornito da Dell per i test ha la seguente configurazione:
- CPU Intel Core Ultra 9 285HX
- Scheda di interferenza Qualcomm AIC100 per PC
- 128 GB 6400 MTs CAMM2 DDR5
- 4TB SSD
Prima di passare ai dati numerici, una nota metodologica. Come descritto in precedenza, l'AIC100 esegue QPC precompilati con dimensioni del batch, lunghezza della sequenza e layout della cache KV fissi. Dell fornisce questo laptop con un set selezionato di QPC precompilati ospitati su Zentree e un'immagine container vLLM che li scarica al primo avvio. Questo set di QPC preconfigurati, serviti tramite il container di riferimento di Dell con concorrenza pari a 1, è ciò che un utente finale riceve effettivamente quando disimballa il computer e segue la documentazione Dell, ed è questa la configurazione che abbiamo utilizzato per i benchmark.
Abbiamo gli strumenti per fare altrimenti. Potremmo scaricare qaic-exec, creare un checkpoint, eseguirlo con torch.export, riquantizzare, ricompilare un QPC con una dimensione del batch maggiore e reinserirlo in vLLM. Potremmo anche scrivere kernel personalizzati per il driver dell'acceleratore QAIC, se volessimo. Abbiamo scelto di non farlo, poiché la stragrande maggioranza degli acquirenti nel mercato di riferimento di questo laptop, ovvero sviluppatori, ingegneri interessati all'IA e team di progetto aziendali, non si occuperà di questo tipo di lavoro. Scaricheranno il container, lo eseguiranno e giudicheranno il prodotto in base al risultato ottenuto. Ed è questo che abbiamo misurato.
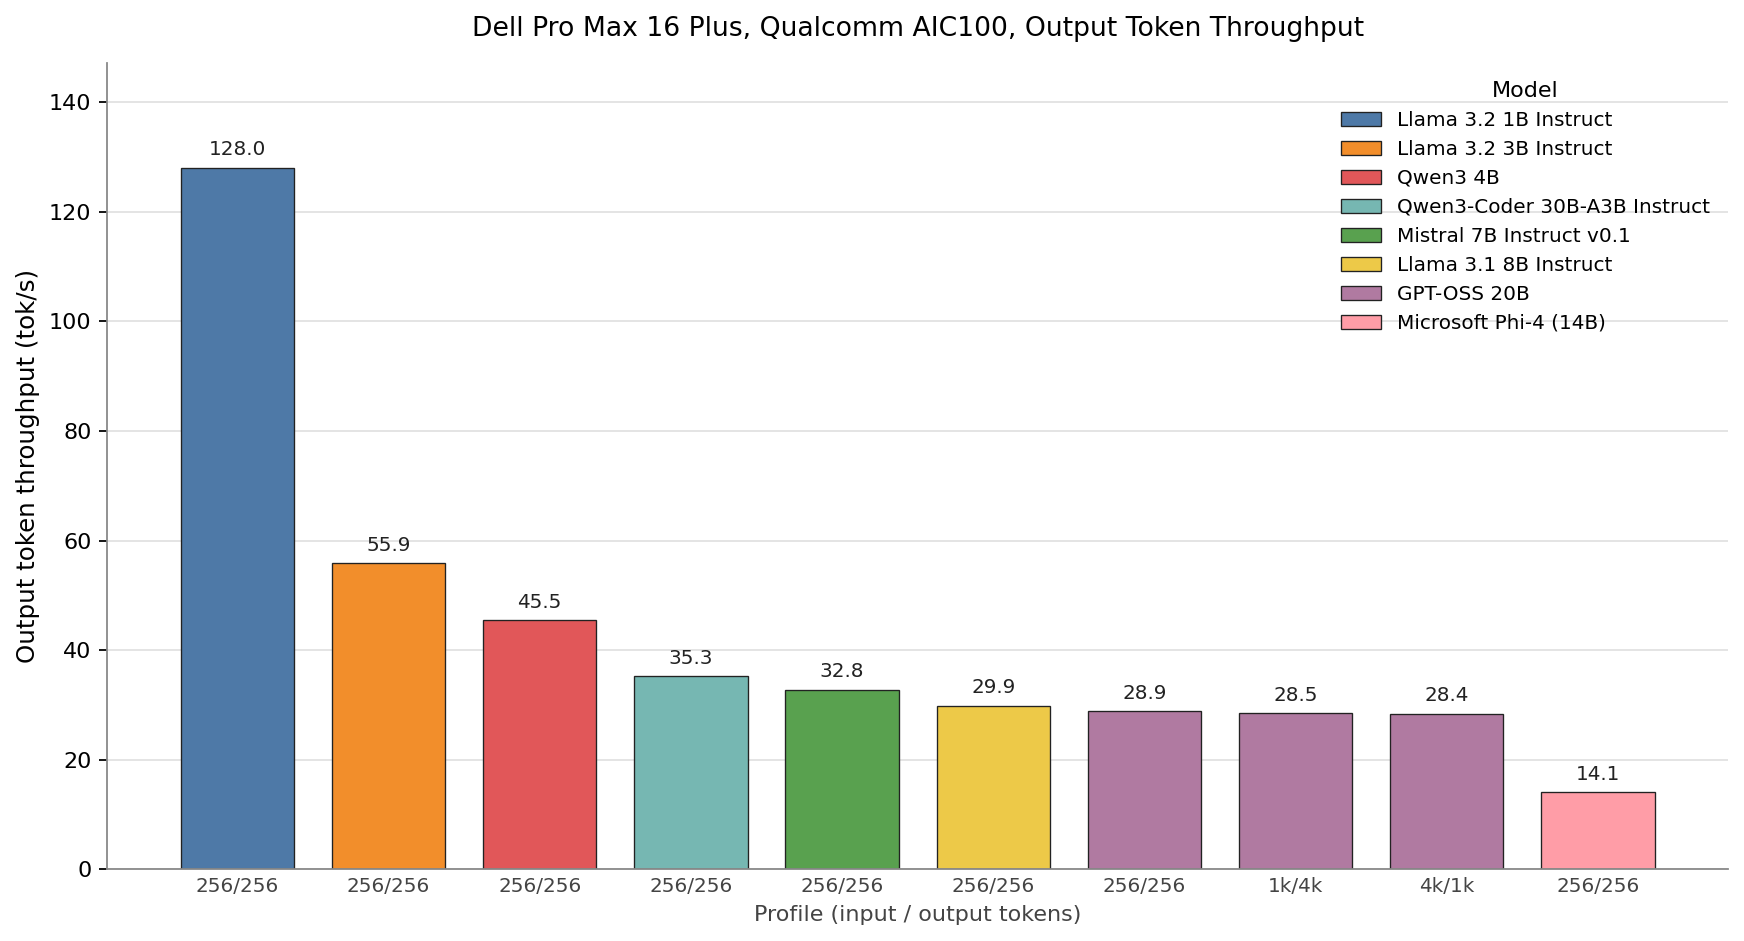
Ogni barra rappresenta un QPC compilato da Qualcomm che utilizza pesi MXFP6 e una cache KV MXINT8, la stessa precisione impiegata da Dell in tutti i suoi prodotti. Llama 3.2 1B è l'unico modello nel grafico a superare i 100 TPS, raggiungendo quota 128. Seguono Llama 3.2 3B con 56 TPS, Qwen3 4B con 45 TPS, Qwen3-Coder 30B-A3B con 35 TPS, Mistral 7B con 33 TPS e Llama 3.1 8B con 30 TPS. GPT-OSS 20B si attesta a 28.9, 28.5 e 28.4 TPS rispettivamente sui profili 256/256, 1k/4k e 4k/1k, confermando quanto promesso dalla documentazione di Qualcomm riguardo al compilatore AOT: una volta creato un QPC per una determinata forma, la velocità di decodifica è fissa e la lunghezza del prompt non influisce sul costo per token. Phi-4 chiude la classifica con 14 TPS.
Sebbene modelli più grandi di quelli sopra menzionati possano essere caricati su questa scheda, non li abbiamo sottoposti a benchmark. Farlo, ad esempio, con il modello Llama 4 Scout, che Dell presenta pubblicamente, richiederebbe un'ulteriore riduzione della precisione a INT4 e, in pratica, un modello più piccolo e meno quantizzato supererà in prestazioni un modello più grande e fortemente quantizzato in molti carichi di lavoro.
Il container vLLM distribuito esegue ogni QPC con batch_size=1 e abbiamo confermato in pratica che l'invio di due richieste simultanee non raddoppia il throughput. La seconda richiesta si limita ad attendere nella coda software fino al termine della prima. Non sono disponibili funzionalità di batching continuo, batching in corso d'opera o decodifica speculativa nello stack distribuito. Per gli agenti di codifica come Claude Code o OpenCode, che distribuiscono più chiamate LLM in parallelo da un singolo turno utente, questo limite a flusso singolo trasforma quello che dovrebbe essere un tempo di risposta di pochi secondi in un'attesa di diversi minuti. Aumentare la dimensione del batch richiede la ricompilazione del QPC sull'host, il che ci riporta al punto di partenza che avevamo già evitato.
Confrontiamolo con la NVIDIA Spark. Con una lunghezza di sequenza di input/output di 256/256, la Spark può eseguire il modello a 120 bit più velocemente di quanto la Qualcomm AIC 100 di Dell esegua il modello a 20 bit. E questi non sono nemmeno i migliori risultati che la Spark può offrire, dato che questi dati sono stati raccolti utilizzando il kernel Marlin nelle revisioni software di lancio.
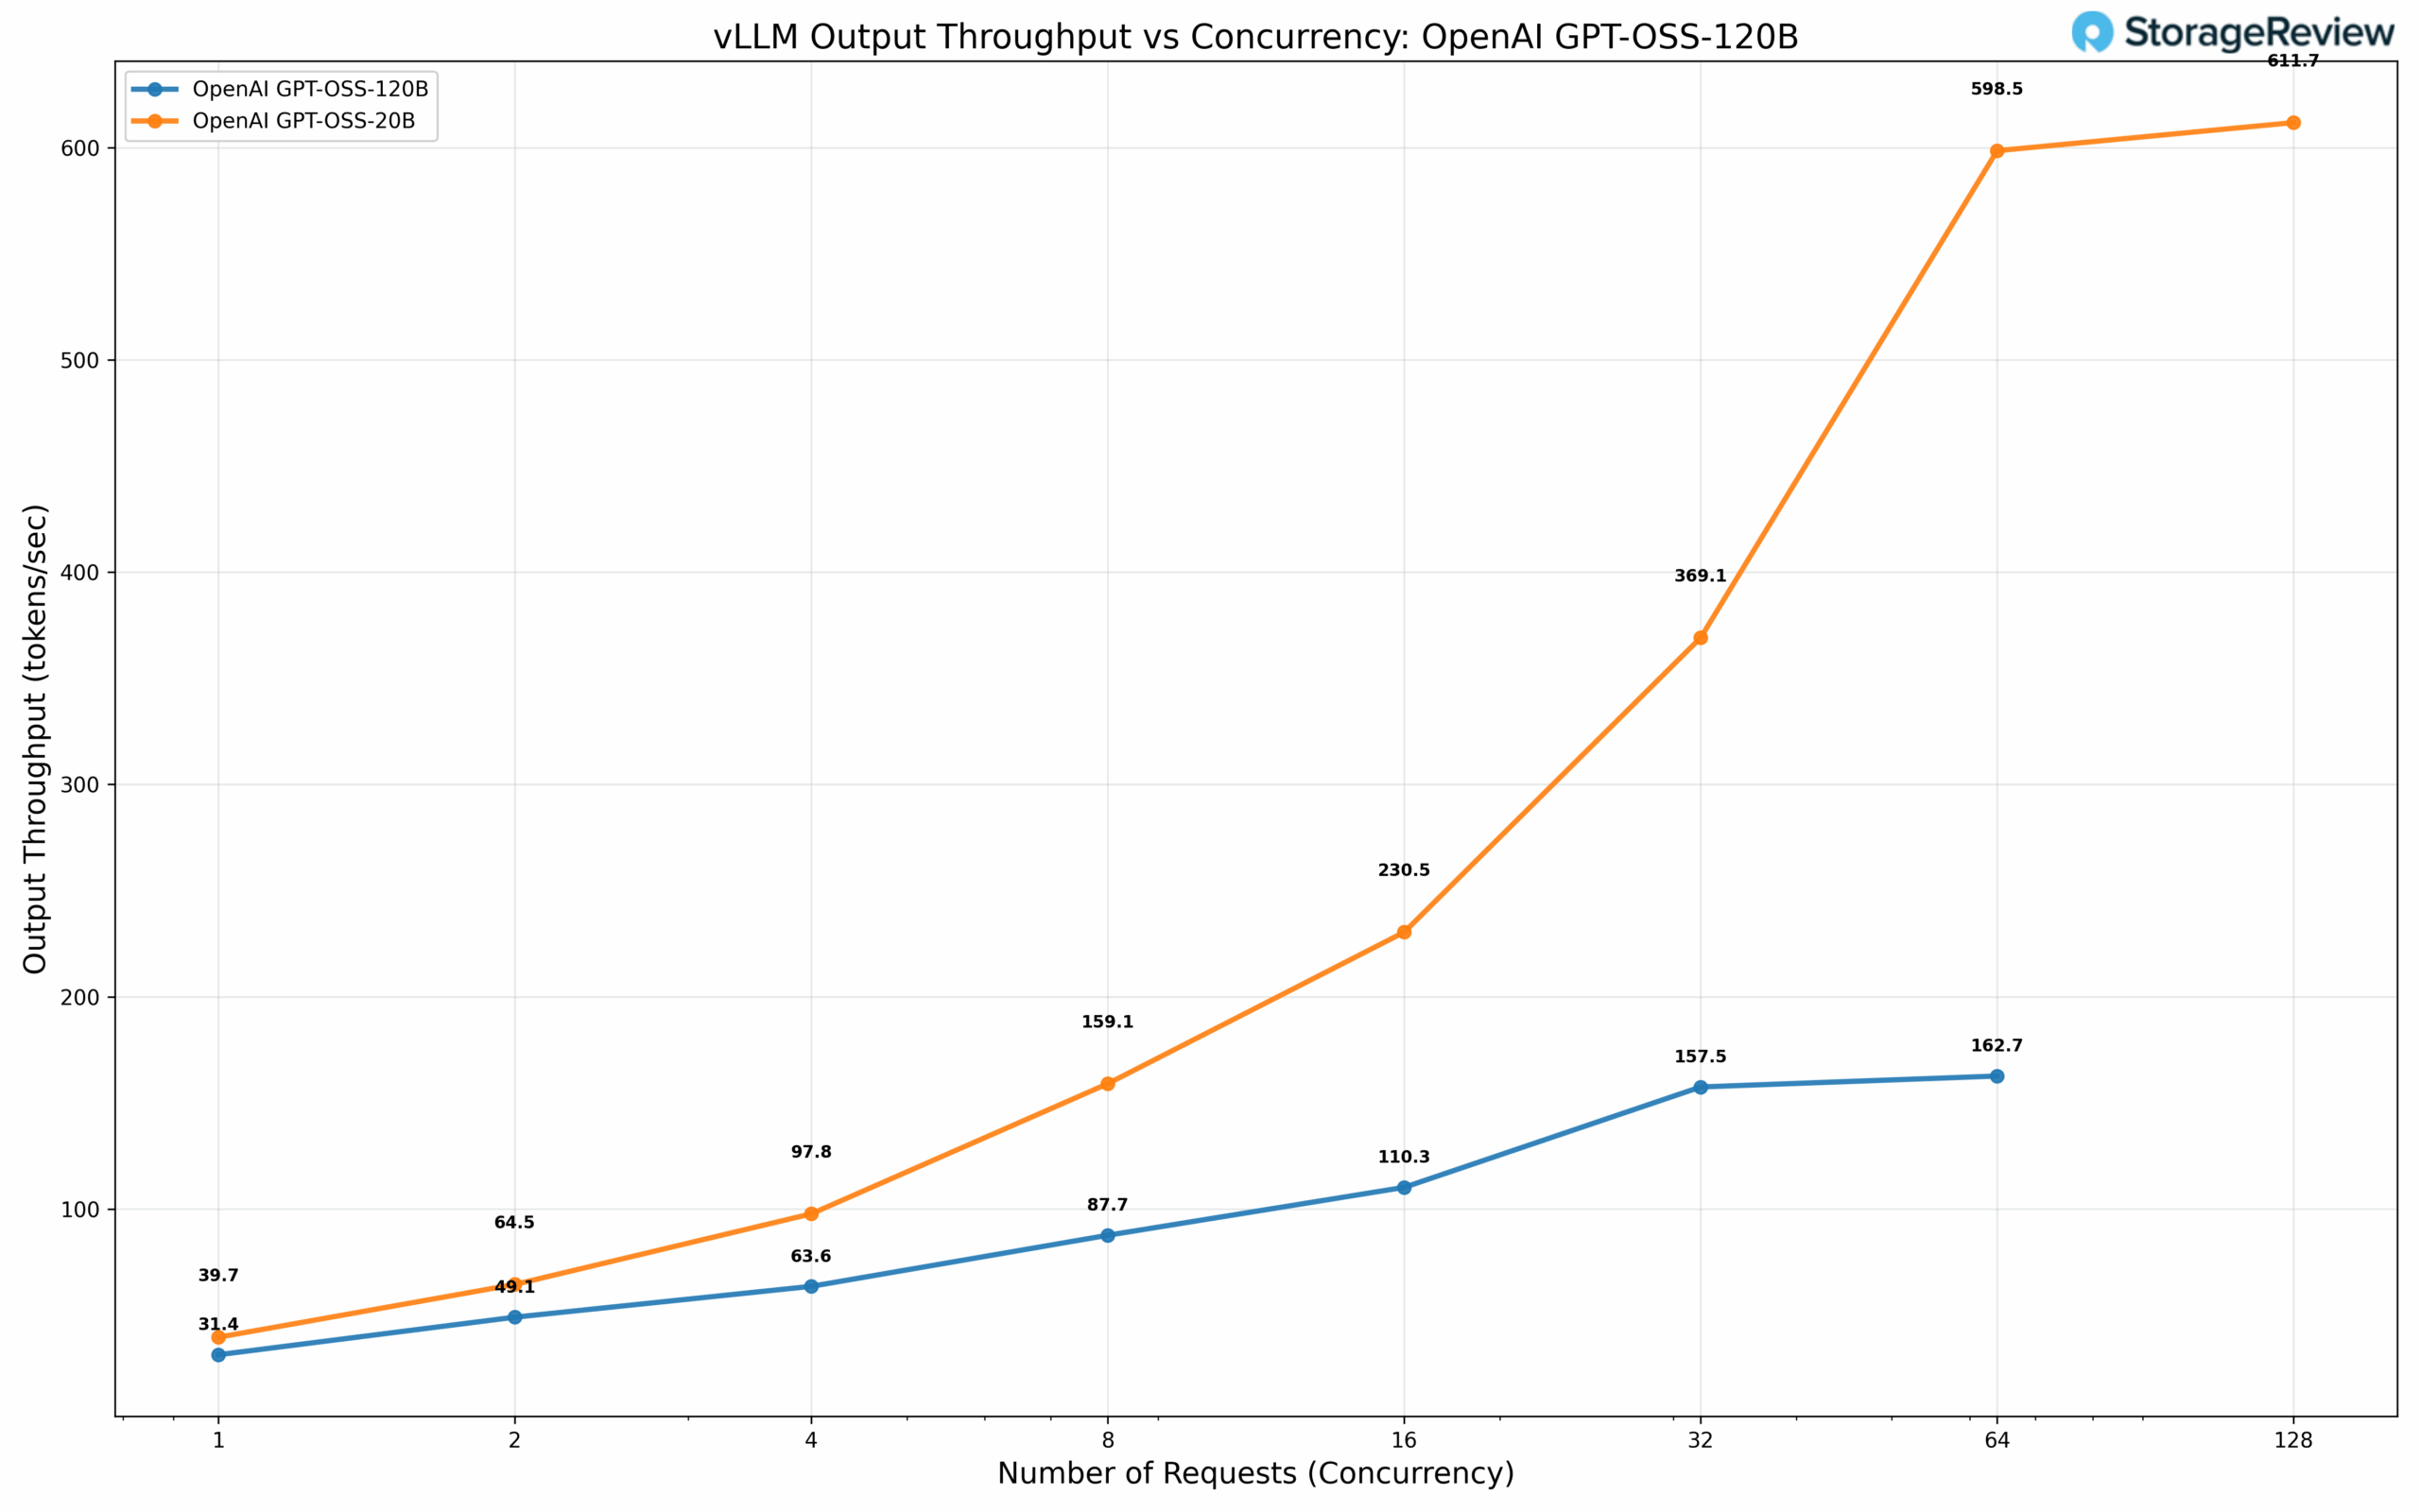
La conclusione è limitata. Per un singolo utente, una singola conversazione e un modello sufficientemente piccolo da non avere come limite i 136 GB/s di LPDDR4X per SoC (Llama 3.2 1B e, probabilmente, Llama 3.2 3B), l'AIC100 di questo portatile è utilizzabile. Per qualsiasi dispositivo più grande, nella configurazione effettivamente ricevuta dal cliente, la combinazione di decodifica a singolo flusso e una pipeline di compilazione a forma statica che penalizza qualsiasi forma non pre-calcolata da Qualcomm, rende questo acceleratore inferiore alla NPU e alla GPU integrate dello stesso Intel Core Ultra HX con cui si trova, per non parlare delle schede grafiche dedicate NVIDIA con cui lo stesso chassis può essere ordinato.
Se confrontiamo per un attimo le specifiche di base, la NVIDIA Spark offre 273 GB/s e abbiamo testato il massimo numero di operazioni in virgola mobile (MAMF) raggiungibili in FP8 (E4M3) a 200 TFLOPs su un singolo chip. La QAIC dichiara di offrire 272 GB/s su 2 chip e 435 TFLOPs di INT8. Quindi, in teoria, le prestazioni dovrebbero essere simili, ma la Qualcomm è in svantaggio a causa del software.
A chi è destinato questo prodotto e conviene acquistarlo?
Per chiunque voglia svolgere un lavoro serio nel campo dell'intelligenza artificiale oggi, la risposta è no. Non acquistate questa configurazione.
Il negozio online statunitense di Dell elenca le SKU AIC100 del Pro Max 16 Plus a $14,871.56 per la configurazione top di gamma (Core Ultra 9 285HX, 128 GB di RAM, SSD da 4 TB), $9,661.56 per la configurazione intermedia (Core Ultra 7 265HX, 64 GB, 1 TB) e $8,831.56 per la SKU AIC100 base. Tutte le configurazioni includono solo Ubuntu Linux, il supporto per Windows sarà disponibile a breve. Il prezzo del dispositivo testato si colloca nella fascia tra i $14,000 e i $15,000.
Per riferimento, la DGX Spark di NVIDIA è attualmente venduta a 4,699 dollari. Per quella cifra, si ottiene un Superchip Grace Blackwell GB10 , 128 GB di memoria LPDDR5X unificata, un SSD NVMe da 4 TB, una GPU Blackwell e circa 1 petaflop di potenza di calcolo AI in FP4, il tutto supportato dallo stack software CUDA completo, TensorRT-LLM, NIM e l'intero ecosistema NVIDIA. Una singola DGX Spark supererà le prestazioni dell'AIC100 presente in questo portatile in quasi tutti i carichi di lavoro AI realistici, e lo farà con software che qualsiasi ingegnere AI assunto quest'anno sa già usare. Con il prezzo dell'unità che abbiamo recensito, si potrebbero acquistare tre DGX Spark, equipaggiare ciascuna con un monitor, periferiche e una scrivania, e avanzare ancora dei soldi. Se l'intelligenza artificiale su piccola scala non fa per voi, una workstation Dell Pro Max Tower T2 con processore Intel 285K, 128 GB di RAM DDR5 e una GPU NVIDIA RTX Pro 6000 si aggira anch'essa intorno ai 15,000 dollari, a seconda della capacità dell'SSD scelto.
È difficile non avere la sensazione che Dell abbia inserito dei componenti che in realtà sono rifiuti elettronici in uno chassis altrimenti eccellente. Il Pro Max 16 Plus con una RTX PRO 5000 è una workstation mobile fantastica. La stessa macchina, con una AIC100, è un esperimento scientifico mal riuscito ancora coperto da garanzia Dell.
Conclusione
Se tra qualche anno vi capiterà di leggere questo articolo da appassionati di elettronica e di imbattervi in uno di questi portatili in saldo a due o trecento dollari, non esitate ad acquistarlo. Il sistema è riparabile e aggiornabile, la tastiera è di buona qualità e riuscire a far funzionare i moduli AIC100 in qualcosa di interessante come progetto per il fine settimana è esattamente il tipo di divertimento senza troppe pretese che questo hardware merita.
Se oggi intendete svolgere seriamente lavori di intelligenza artificiale, configurate il vostro Pro Max 16 Plus con qualsiasi altro acceleratore. Una GPU mobile NVIDIA RTX PRO, anche la RTX PRO 1000 di fascia bassa, vi offrirà prestazioni migliori rispetto ai moduli AIC100. La NPU integrata dell'Intel Core Ultra HX sarà più adatta in molti scenari pratici, poiché si integra con Windows ML, OpenVINO e l'attuale stack di intelligenza artificiale per PC.
Un suggerimento che vale la pena offrire a Dell: il Pro Max 16 Plus è un case eccellente e la linea Pro Max è una delle piattaforme workstation mobili più potenti sul mercato. La SKU AIC100, così come viene commercializzata, non raggiunge minimamente questi standard. Una linea di prodotti sperimentali o di anteprima per sviluppatori, chiaramente etichettata come tale, darebbe a Dell un modo per offrire acceleratori innovativi ai clienti che desiderano provarli, senza associare il marchio Pro Max a una gamma di prodotti non ancora pronta. Il marchio Pro Max merita di essere tutelato e c'è un modo efficace per farlo, trovando al contempo una collocazione per l'hardware sperimentale.


 Amazon