

NVIDIA DGX Spark rappresenta una svolta nell'infrastruttura di intelligenza artificiale accessibile. Nel 2017, il documento fondamentale "Attention is All You Need" che ha introdotto l'architettura Transformer si basava su una configurazione server P100 a otto GPU, con un consumo di decine di kilowattora e un'occupazione significativa di spazio nei data center. Oggi, DGX Spark offre prestazioni di calcolo superiori in un formato desktop compatto da 240 watt. Questa radicale evoluzione nell'efficienza energetica e nella compressione del formato rende le funzionalità di intelligenza artificiale, in precedenza riservate ai data center, accessibili a singoli ricercatori, piccoli team e organizzazioni di sviluppo distribuite.
Ciò che distingue Spark dalle precedenti soluzioni di intelligenza artificiale desktop è il suo approccio completo all'intero ciclo di vita dello sviluppo. Anziché imporre compromessi tra sperimentazione, messa a punto e distribuzione, Spark offre capacità reali in tutte le fasi. L'architettura di memoria unificata da 128 GB consente la messa a punto completa dei parametri dei modelli, che richiederebbe risorse cloud su workstation convenzionali, offrendo al contempo centinaia di token al secondo di throughput, adatti a carichi di lavoro di inferenza batch, inclusa la generazione di dati sintetici. L'inclusione della rete ConnectX-7 con capacità fabric da 200 Gb consente alle organizzazioni di raggruppare più sistemi Spark per un'esplorazione di modelli ancora più ampia, sebbene, come dimostreremo, anche una singola unità si dimostri straordinariamente capace.
Punti chiave
Potenza da data center in un computer desktop : GB10 Grace Blackwell in un contenitore da 1.13 litri e 240 W, al prezzo di 3,999 dollari, offre prestazioni sparse fino a 1 petaFLOP FP4.
Memoria che rivoluziona i flussi di lavoro : 128 GB di memoria unificata consentono la messa a punto completa dei parametri dei modelli 8B in locale e l'inferenza ad alta velocità. Nei test abbiamo visto Llama 3.1 8B FP4 raggiungere circa 924 token/s con 128 concorrenti, e Qwen3 Coder 30B-A3B FP8 arrivare a circa 483 token/s con batch da 64.
Pronto per la scalabilità e il collegamento di storage veloce : ConnectX-7 integrato offre una rete a 200G per il clustering o NVMe-oF. L'NVMe interno 2242 Gen5 è pratico ma limitato per operazioni di I/O intensive, pertanto l'NVMe-oF esterno su RDMA rappresenta la soluzione migliore per un throughput costante.
Maturità del software fin dal primo giorno : include DGX OS, CUDA, cuDNN, TensorRT, AI Workbench, container e playbook per i flussi di lavoro, consentendo ai team di eseguire immediatamente carichi di lavoro reali.
Prestazioni reali comprovate : MAMF ha misurato circa 99.8 TFLOPs BF16 e circa 207.7 TFLOPs FP8. Le letture GDSIO hanno raggiunto un picco di circa 11.4 GiB/s internamente, con un potenziale massimo previsto sulla rete a 200G.
Che cos'è DGX Spark e chi dovrebbe prenderlo in considerazione?
NVIDIA DGX Spark è fondamentalmente una piattaforma di sviluppo AI completa, piuttosto che un semplice componente GPU. Al suo interno si trova il superchip GB10 Grace Blackwell, che integra una GPU con architettura Blackwell dotata di Tensor Core di quinta generazione con una CPU Arm a 20 core (10× Cortex-X925 + 10× Cortex-A725) connessa tramite NVLink-C2C. Questa architettura di interconnessione coerente, secondo NVIDIA, consente una larghezza di banda fino a 5 volte superiore rispetto a PCIe Gen 5, creando un'infrastruttura computazionale unificata anziché domini di elaborazione discreti.
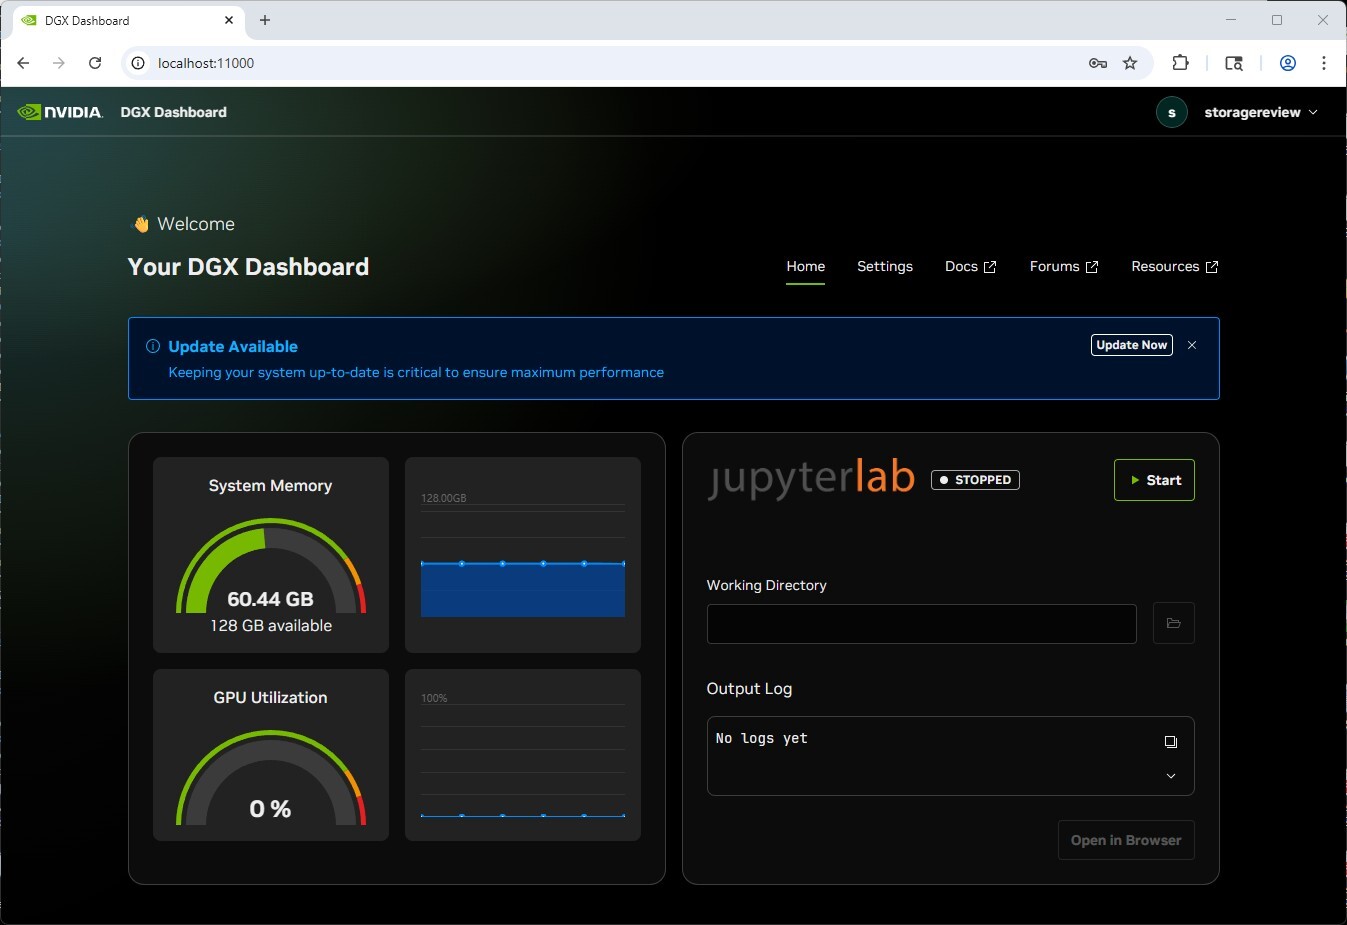
Per agevolare gli utenti, NVIDIA fornisce DGX OS basato su Ubuntu Desktop con l'intero stack software di intelligenza artificiale preconfigurato, inclusi CUDA, cuDNN, TensorRT, NVIDIA Container Runtime e AI Workbench, eliminando le tipiche sfide legate ai driver e il sovraccarico di configurazione dell'ambiente che affliggono le build di workstation personalizzate. Il sistema offre paradigmi di distribuzione flessibili: collegando le periferiche, può essere utilizzato come una workstation compatta con l'esperienza desktop Ubuntu completa, oppure può essere distribuito come un'appliance di rete headless accessibile tramite NVIDIA Sync, che garantisce un'integrazione perfetta con JupyterLab, VS Code, Cursor IDE e terminali SSH.
Si tratta di un'infrastruttura progettata appositamente per professionisti dell'intelligenza artificiale, ricercatori che perfezionano modelli linguistici, data scientist che accelerano i flussi di lavoro RAPIDS, sviluppatori che implementano sistemi agentici o team che sperimentano architetture con modelli ablativi su piccola scala. Spark si rivolge ai professionisti che necessitano di elevate capacità di calcolo dell'intelligenza artificiale senza la complessità dei data center.
Specifiche tecniche di NVIDIA DGX Spark
| Specificazione | Dettagli |
|---|---|
| Architettura | |
| GPU | Architettura NVIDIA Blackwell |
| CPU | Arm a 20 core (10x Cortex-X925 + 10x Cortex-A725) |
| Tensor Core | 5th Generation |
| RT | 4th Generation |
| NVENC/NVDEC | 1 × / 1 × |
| Memorie | |
| Memoria di sistema | 128 GB LPDDR5X (memoria di sistema unificata) |
| Interfaccia di memoria | 256-bit |
| Banda di memoria | 273 GB / s |
| Cookie di prestazione | |
| FP4 | fino a 1 petaFLOP (con Sparsity) |
| Archiviazione | |
| Archiviazione | NVMe M.2 da 1 TB o 4 TB (auto-crittografato) |
| Connettività | |
| USB | 4× USB 3.2 Gen 2×2 di tipo C (20 Gbps) |
| Ethernet | 1× 10GbE RJ-45 |
| NIC | ConnectX-7 Smart NIC – 2x 200G QSFP (consente una larghezza di banda massima di 200G) |
| Wireless | WiFi 7, Bluetooth 5.3 |
| Uscita audio | Uscita audio multicanale HDMI |
| Connettori display | 1× HDMI 2.1a |
| Meccanico | |
| Dimensioni | 150 × 150 × 50.5 mm (5.9 × 5.9 × 1.98 pollici) |
| Peso | 1.2 kg |
| Consumo di energia | 240 W |
Progettazione e realizzazione di NVIDIA DGX Spark
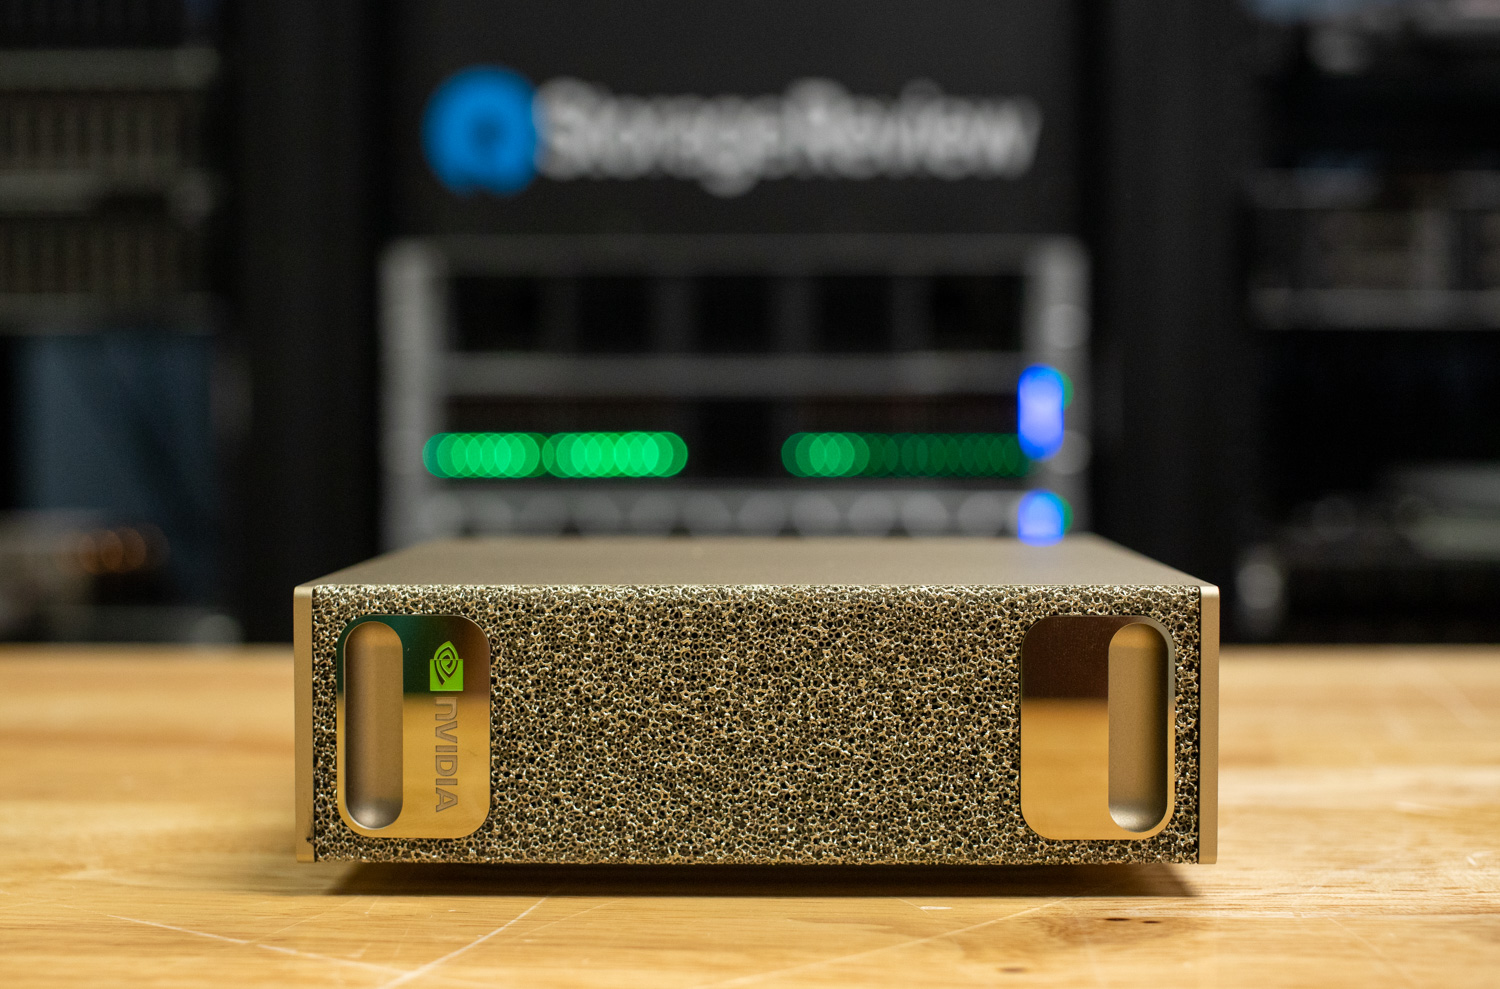
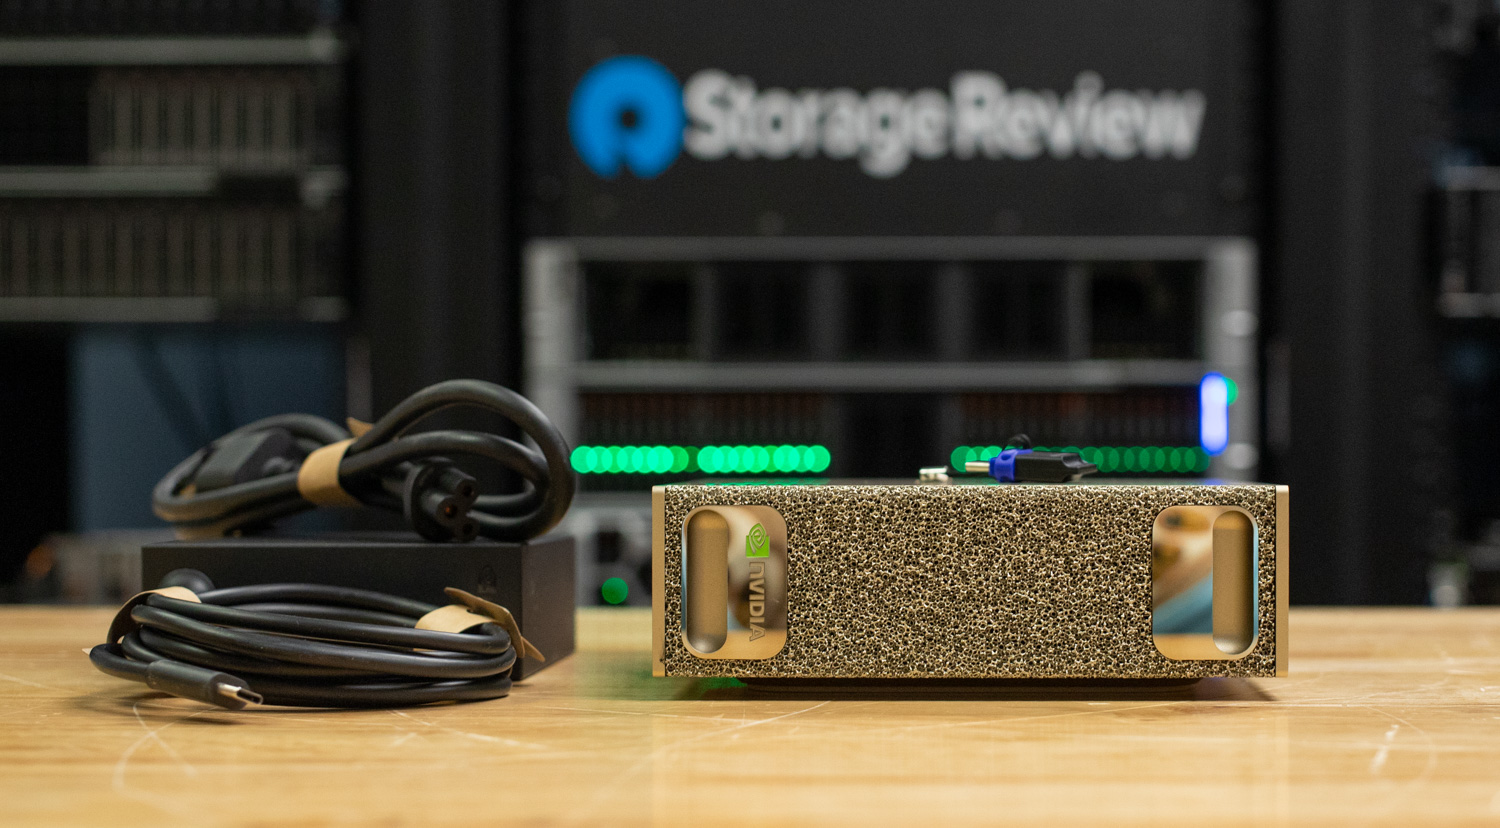
NVIDIA DGX Spark mantiene l'inconfondibile linguaggio di design industriale di NVIDIA, con uno chassis compatto che rispecchia l'aspetto e le funzionalità dei suoi sistemi DGX più grandi. Il pannello frontale presenta intagli in miniatura per la presa, un omaggio alle maniglie delle unità DGX originali di dimensioni standard, e una finitura metallica con macchie dorate che offre una texture raffinata e di alta qualità, impreziosita dall'iconico logo verde di NVIDIA.
Fisicamente, il DGX Spark misura 150 × 150 × 50.5 mm (5.9 × 5.9 × 1.98 pollici) e pesa 1.2 kg (2.6 libbre), per un volume interno totale di 1.13 litri. Questo lo colloca saldamente nella classe dei PC con fattore di forma ridotto da 1 litro. Nonostante l'ingombro minimo, il sistema appare compatto e robusto grazie a un guscio interamente in lega metallica che funge anche da dissipatore di calore passivo, mantenendo l'attenzione sia sull'aspetto che sulla funzionalità.
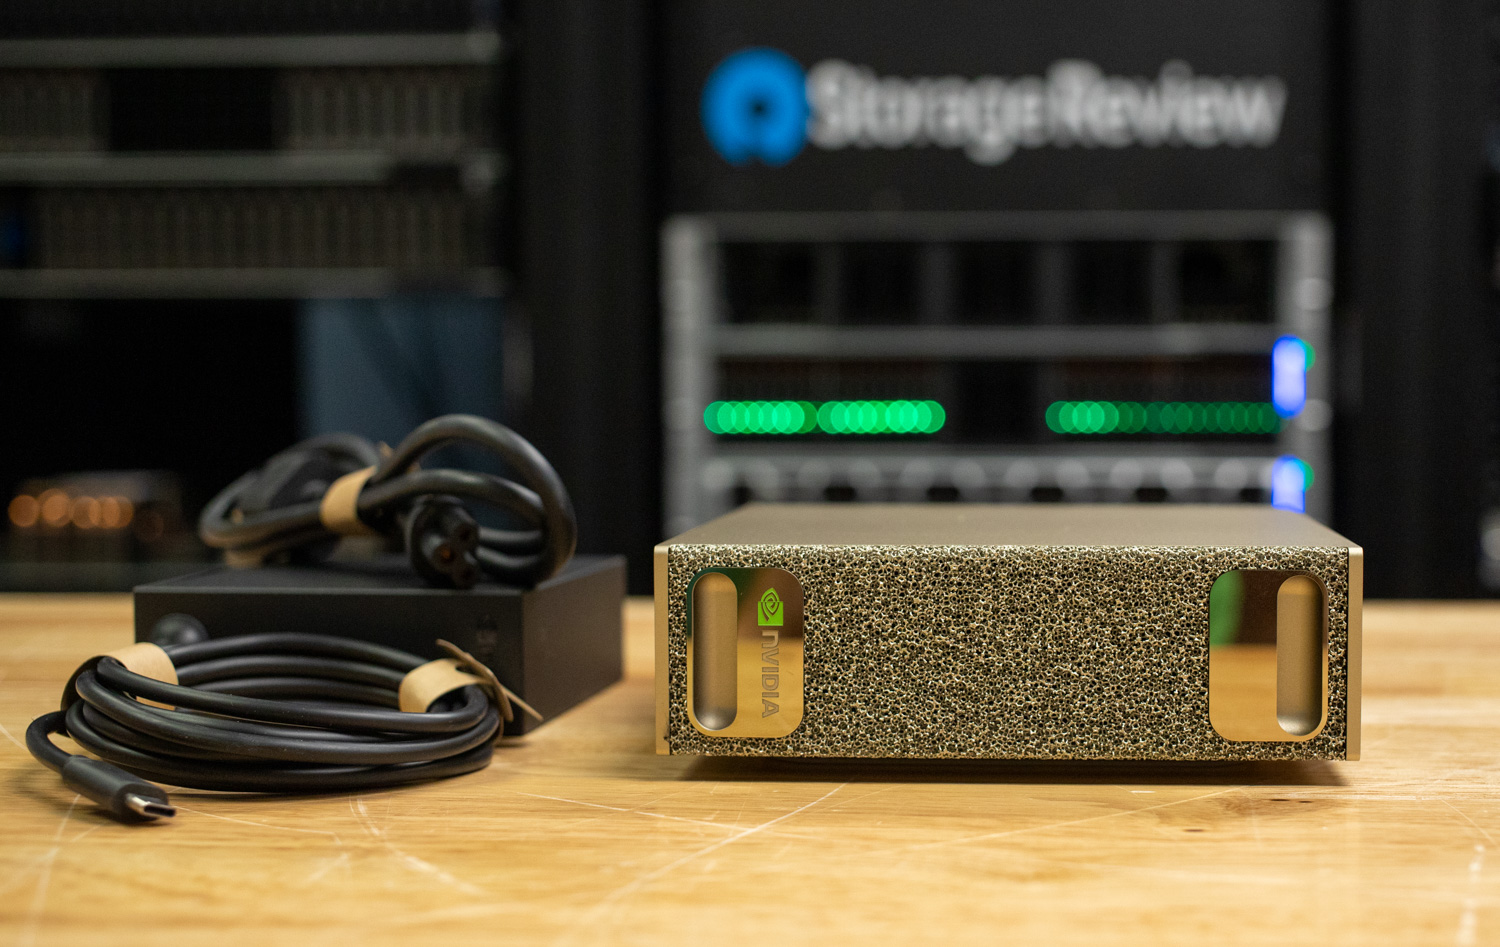
L'alimentazione è fornita da un alimentatore esterno USB-C da 240 W, visibile accanto all'unità principale nell'immagine. L'alimentatore è compatto e ben costruito, utilizza un connettore C5 standard (a quadrifoglio) per l'ingresso CA e si adatta al design pulito ed efficiente del DGX Spark.
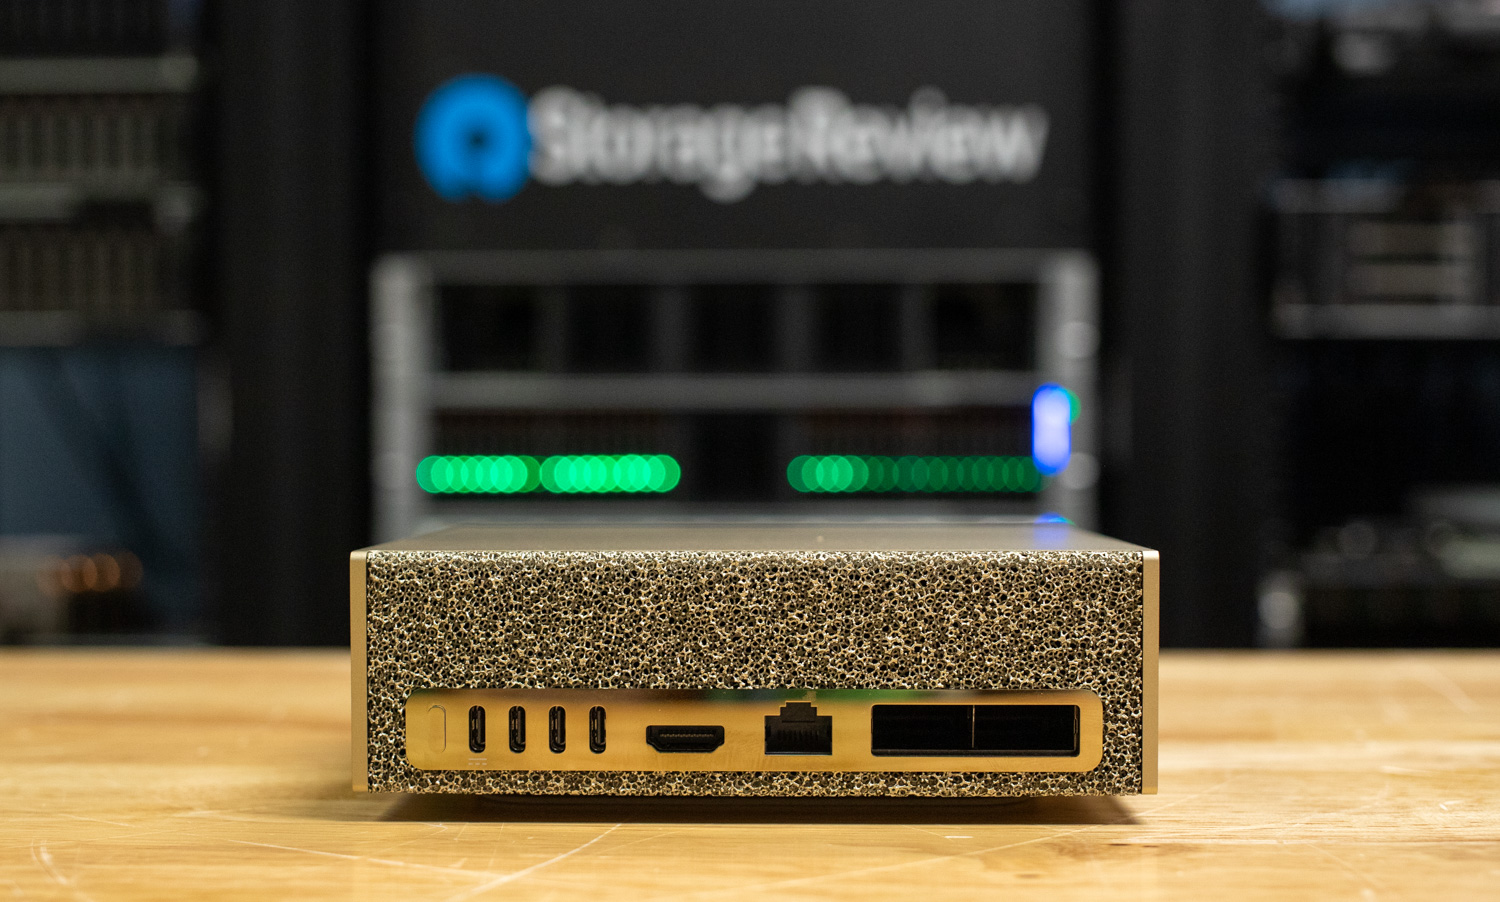
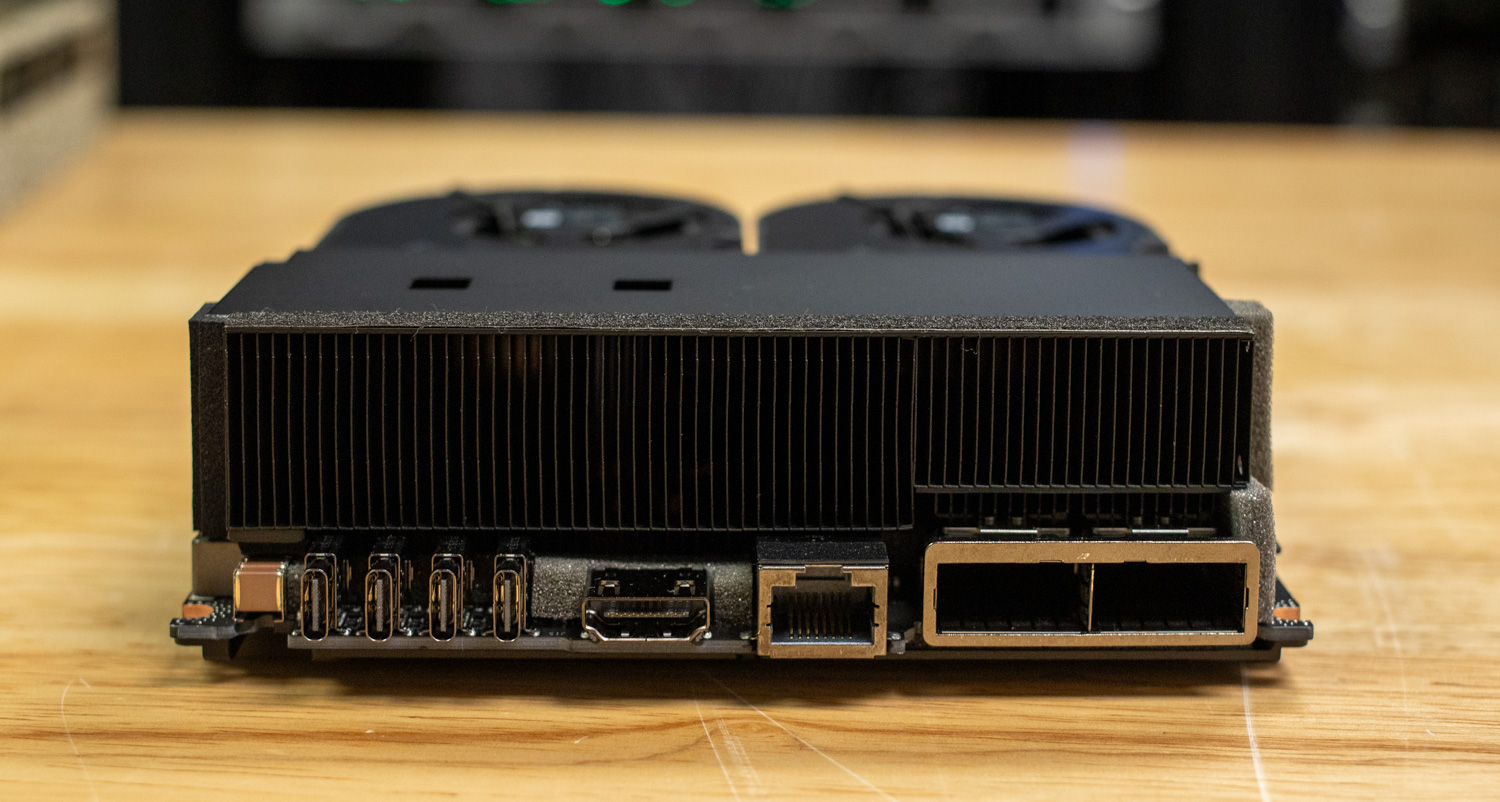
Passando al retro, il DGX Spark ripropone la stessa finitura testurizzata con puntini dorati presente sulla parte anteriore, mantenendo un design coerente in tutto il telaio. Partendo da sinistra, il pulsante di accensione si trova accanto a quattro porte USB-C, una delle quali fornisce l'alimentazione all'unità. Seguono una singola uscita HDMI 2.1a, una porta RJ-45 10 GbE e, a rendere questa unità interessante, le due interfacce QSFP56 200 GbE gestite da una scheda NVIDIA ConnectX-7 SmartNIC integrata.
A prima vista, si potrebbe dedurre che Spark consenta una connettività di 400 GB; purtroppo, a causa delle limitazioni PCIe, Spark è in grado di fornire solo 200 GB di connettività. Volendo saperne di più, abbiamo approfondito la topologia di Spark:
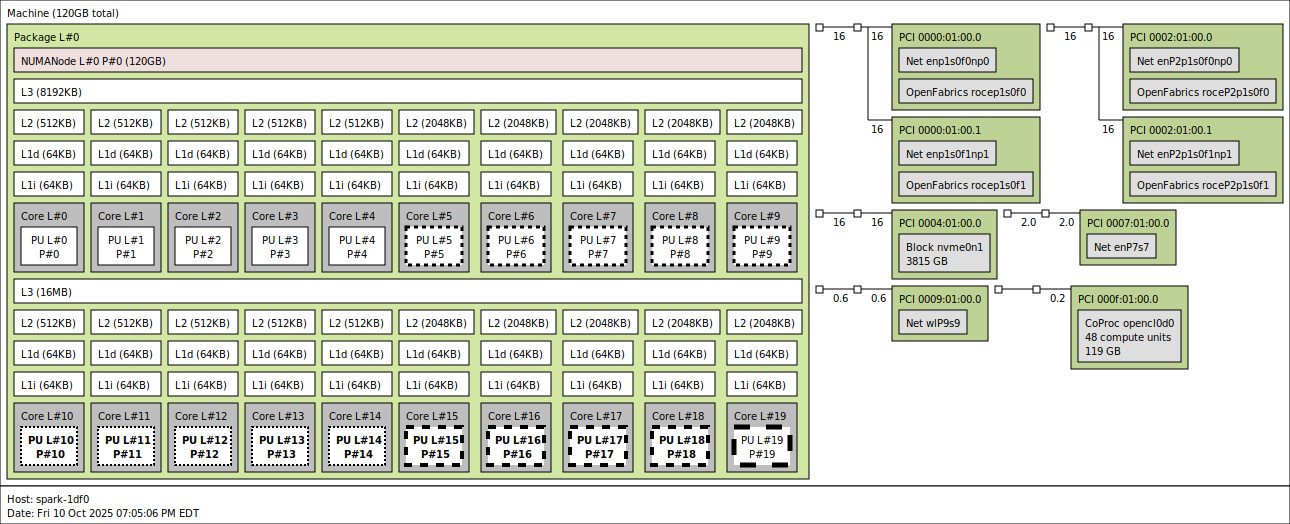
Utilizzando lstopo, osserviamo le due interconnessioni dalla scheda di rete CX7. Elettricamente, il CX7 è collegato tramite due collegamenti Gen5 x4. All'interno del sistema operativo, queste connessioni appaiono come quattro interfacce, ciascuna con una larghezza di banda massima di 200G. A causa del tempo limitato per i test, non siamo stati in grado di scoprire tutte le peculiarità di rete di questa piattaforma al di fuori dei nostri test NVMe-oF, che sono descritti in dettaglio più avanti nell'articolo. Tuttavia, prevediamo di esplorare ulteriormente questa piattaforma e pubblicheremo articoli futuri che approfondiranno le sue capacità, come il clustering di più Spark per un mini cluster.
Esaminando gli altri dispositivi connessi, il prossimo è il piccolo SSD M.2 con fattore di forma 2242 connesso con Gen5 x4, seguito dal controller Realtek RJ45 10GbE connesso con collegamento PCIe Gen4 x1 e dal controller Wi-Fi MediaTek connesso con collegamento PCIe Gen3 x1.
Analizzando la CPU, Spark monta un processore Arm a 20 core con un'architettura eterogenea, simile a quella dei più recenti processori Intel, composta da 10 core Cortex-A725 ad alta efficienza e 10 core Cortex-X925 ad alte prestazioni, suddivisi in due cluster di cache L3. Il primo cluster (8 MB L3) contiene le CPU 0-4 (Cortex-A725, max 2808 MHz) e le CPU 5-9 (Cortex-X925, max 3900 MHz), mentre il secondo cluster (16 MB L3) contiene le CPU 10-14 (Cortex-A725, max 2860 MHz) e le CPU 15-19 (Cortex-X925, max 3978-4004 MHz). Ogni core ha una cache dati L1 privata da 64 KB e una cache istruzioni L1 da 64 KB, ma la cache L2 differisce significativamente in base al tipo di core: i core Cortex-A725 ad alta efficienza hanno una cache L2 da 512 KB, mentre i core Cortex-X925 ad alte prestazioni hanno una cache L2 sostanzialmente più grande da 2 MB (4 volte più grande). I core più veloci sono le CPU 15-19, che beneficiano sia della cache L3 più grande da 16 MB che di frequenze più elevate, con la CPU 19 che rappresenta il core con le massime prestazioni a 4004 MHz. Questi diversi livelli di potenza/frequenza sono indicati dalle linee tratteggiate sul core nella topologia mostrata sopra.
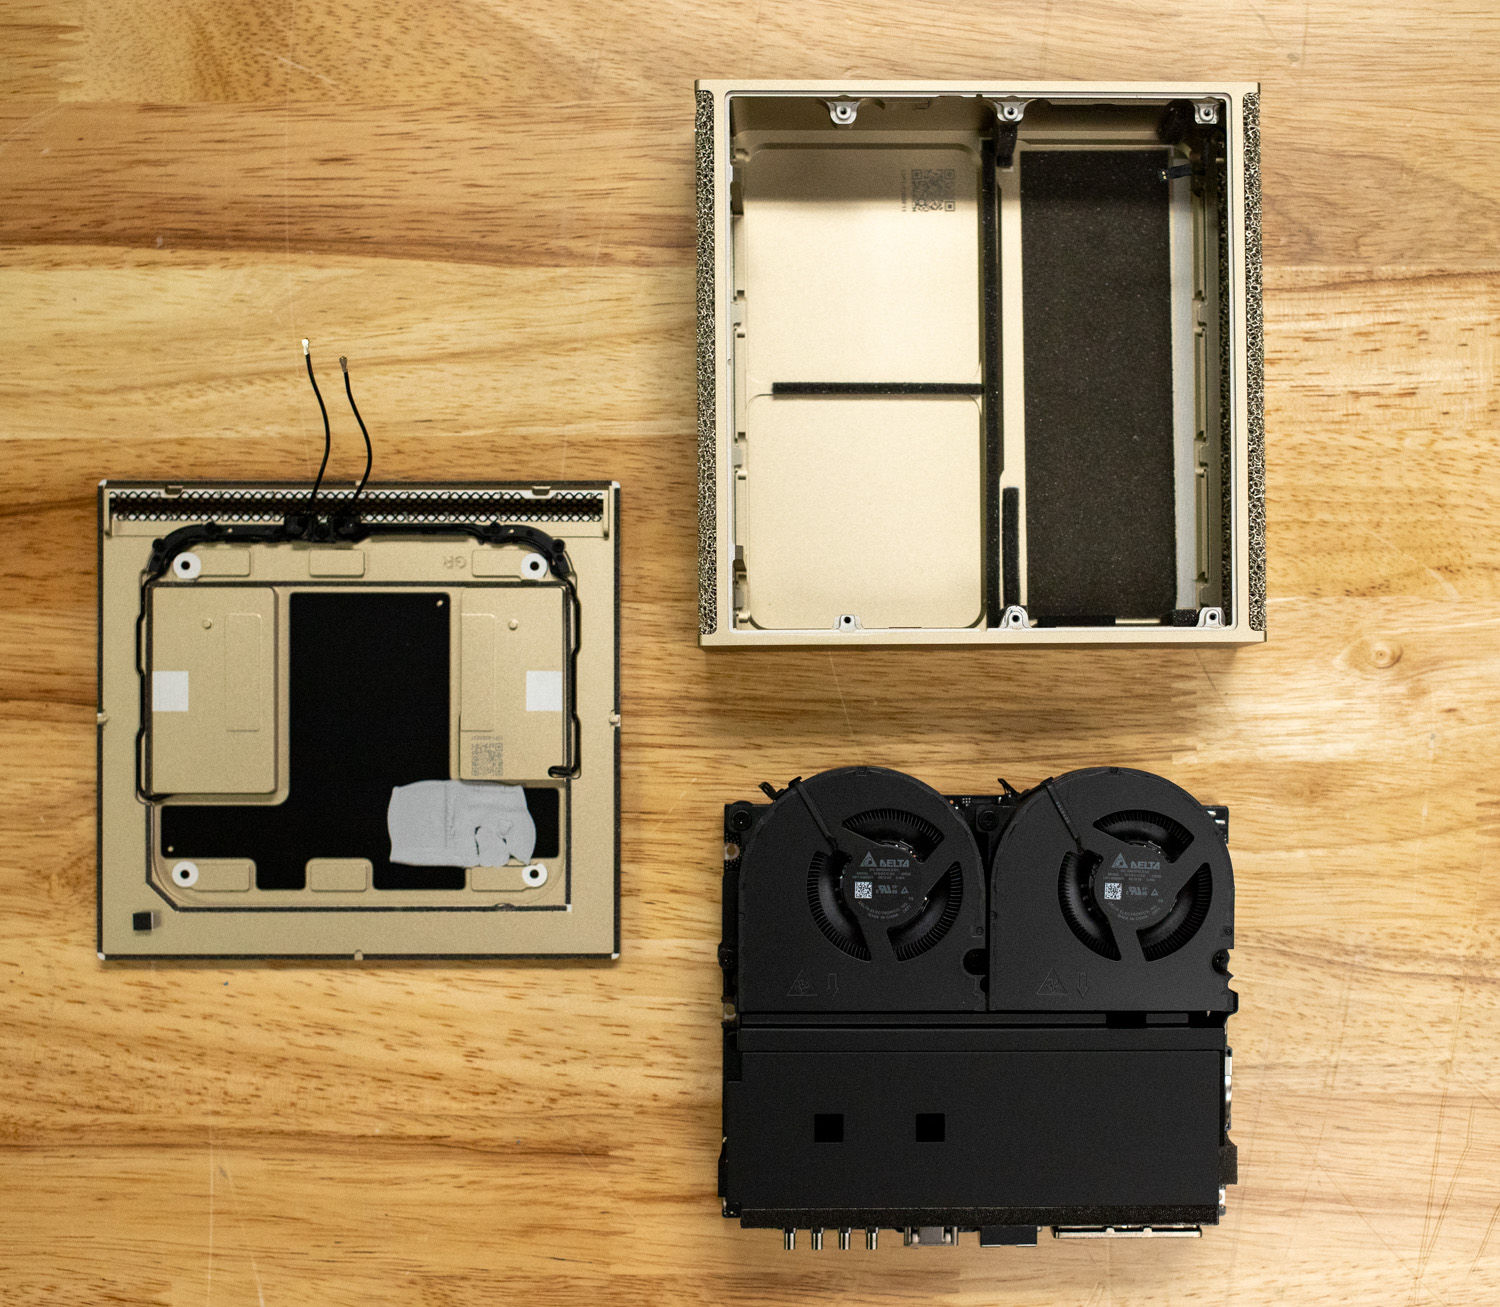
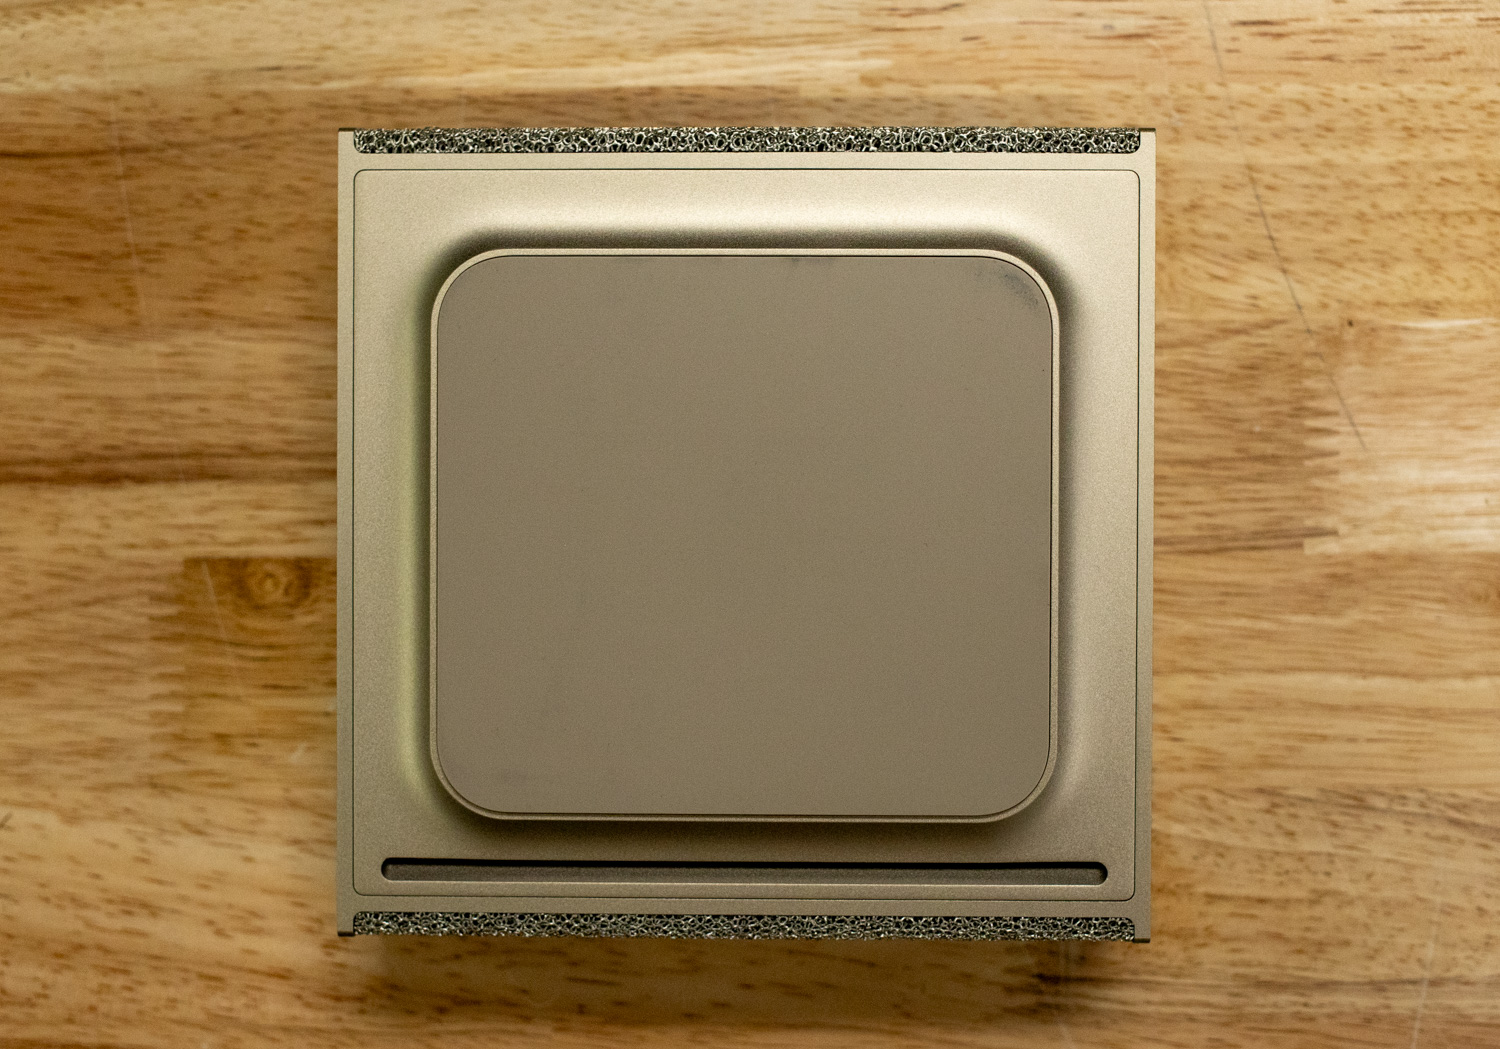
Allontanandoci di nuovo, capovolgiamo il DGX Spark; l'unico componente in plastica visibile è la cover della base, che si aggancia magneticamente alla parte inferiore del telaio. Questo design mantiene l'esterno pulito, consentendo al contempo un rapido accesso ai componenti interni. Una volta rimossa la base magnetica, quattro viti rimangono esposte, consentendo l'accesso al vano interno principale.
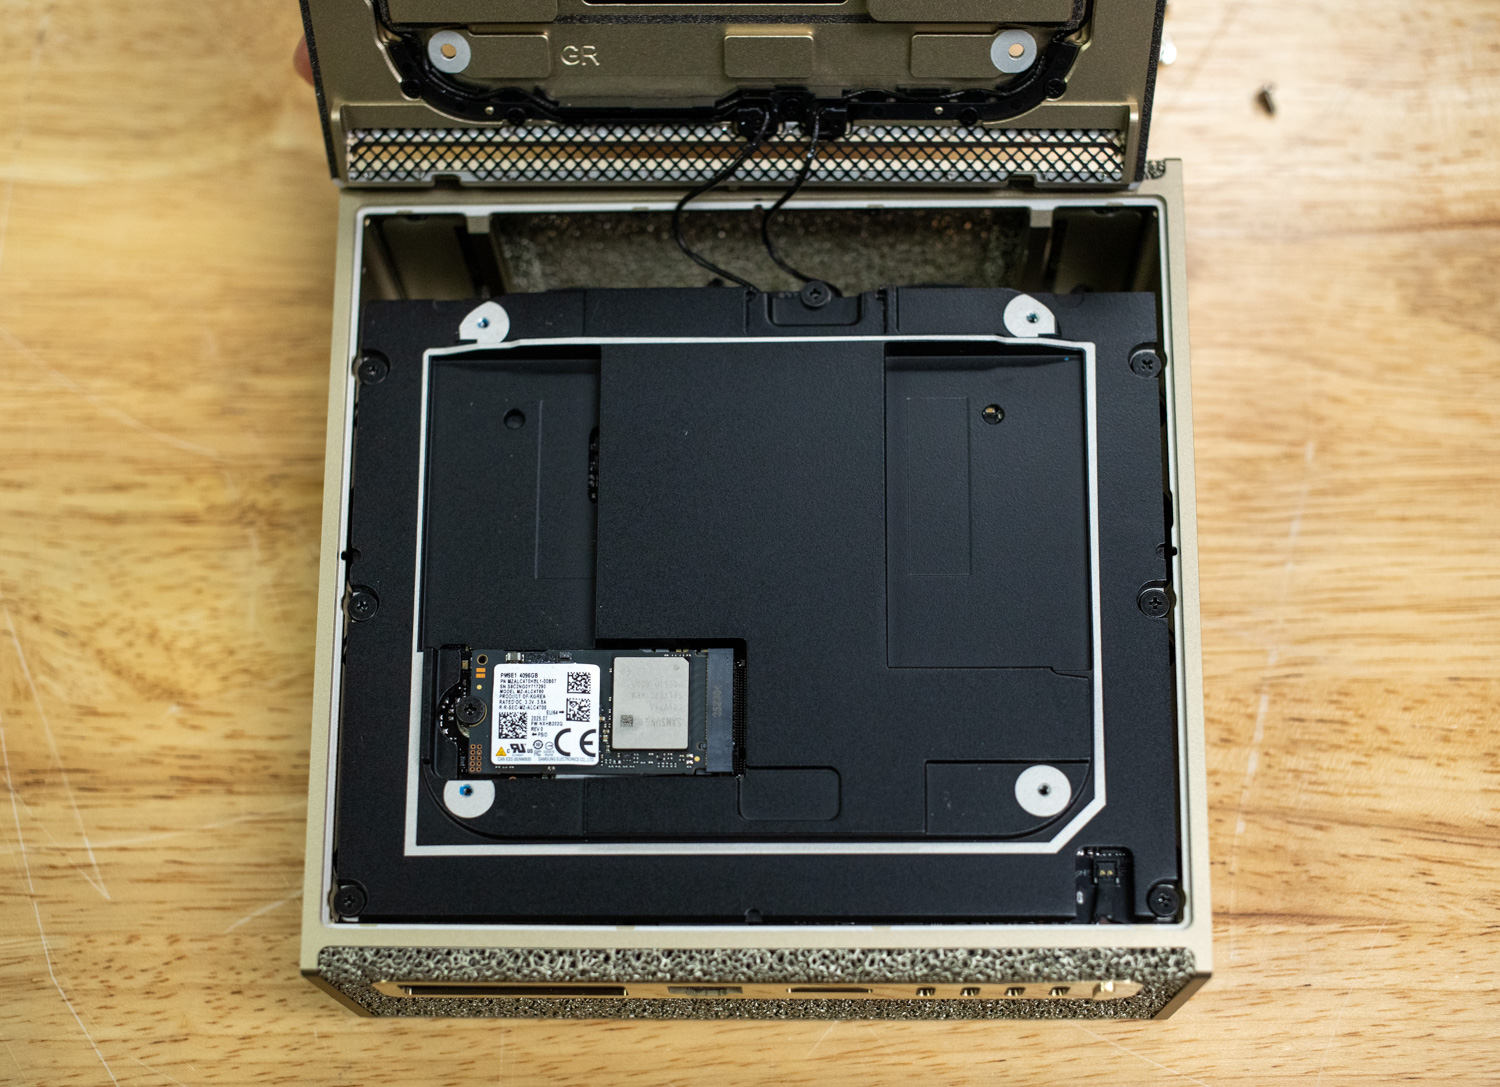
All'interno, possiamo vedere il cablaggio dell'antenna instradato verso la sezione superiore dell'unità, a conferma dell'inclusione delle connettività Wi-Fi 7 e Bluetooth 5.3. Ciò offre opzioni di rete flessibili, particolarmente utili per installazioni mobili o in laboratorio in cui l'accesso cablato potrebbe non essere disponibile.
È visibile anche la soluzione di storage dell'unità, un SSD PCIe Gen5 2242 M.2, un fattore di forma meno comune per hardware così performante. La configurazione mostrata qui include un'unità Samsung NVMe da 4 TB.
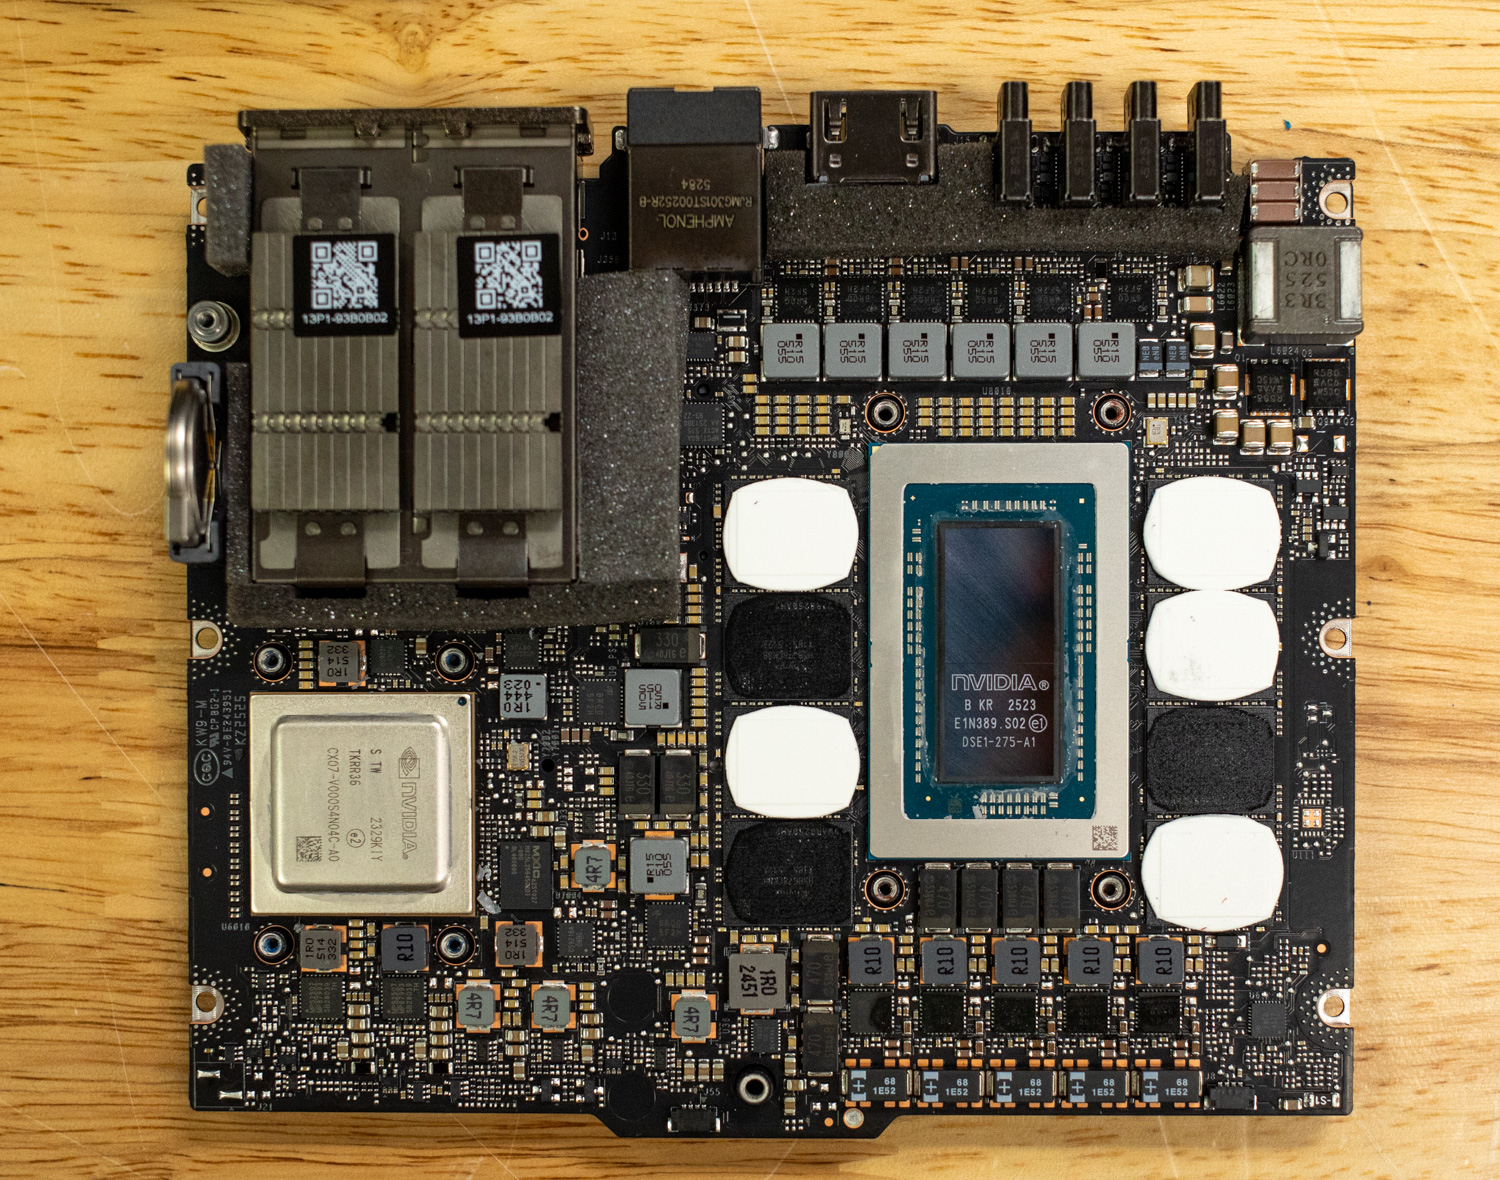
Analizzando più a fondo il DGX Spark, scopriamo il cuore del sistema: il GB10 Superchip di NVIDIA Grace Blackwell. Accanto al GB10 Superchip si trovano 8 memorie di sistema unificate LPDDR5X saldate che offrono 273 GB/s di larghezza di banda, garantendo un rapido accesso ai dati sia durante le operazioni della CPU che della GPU.
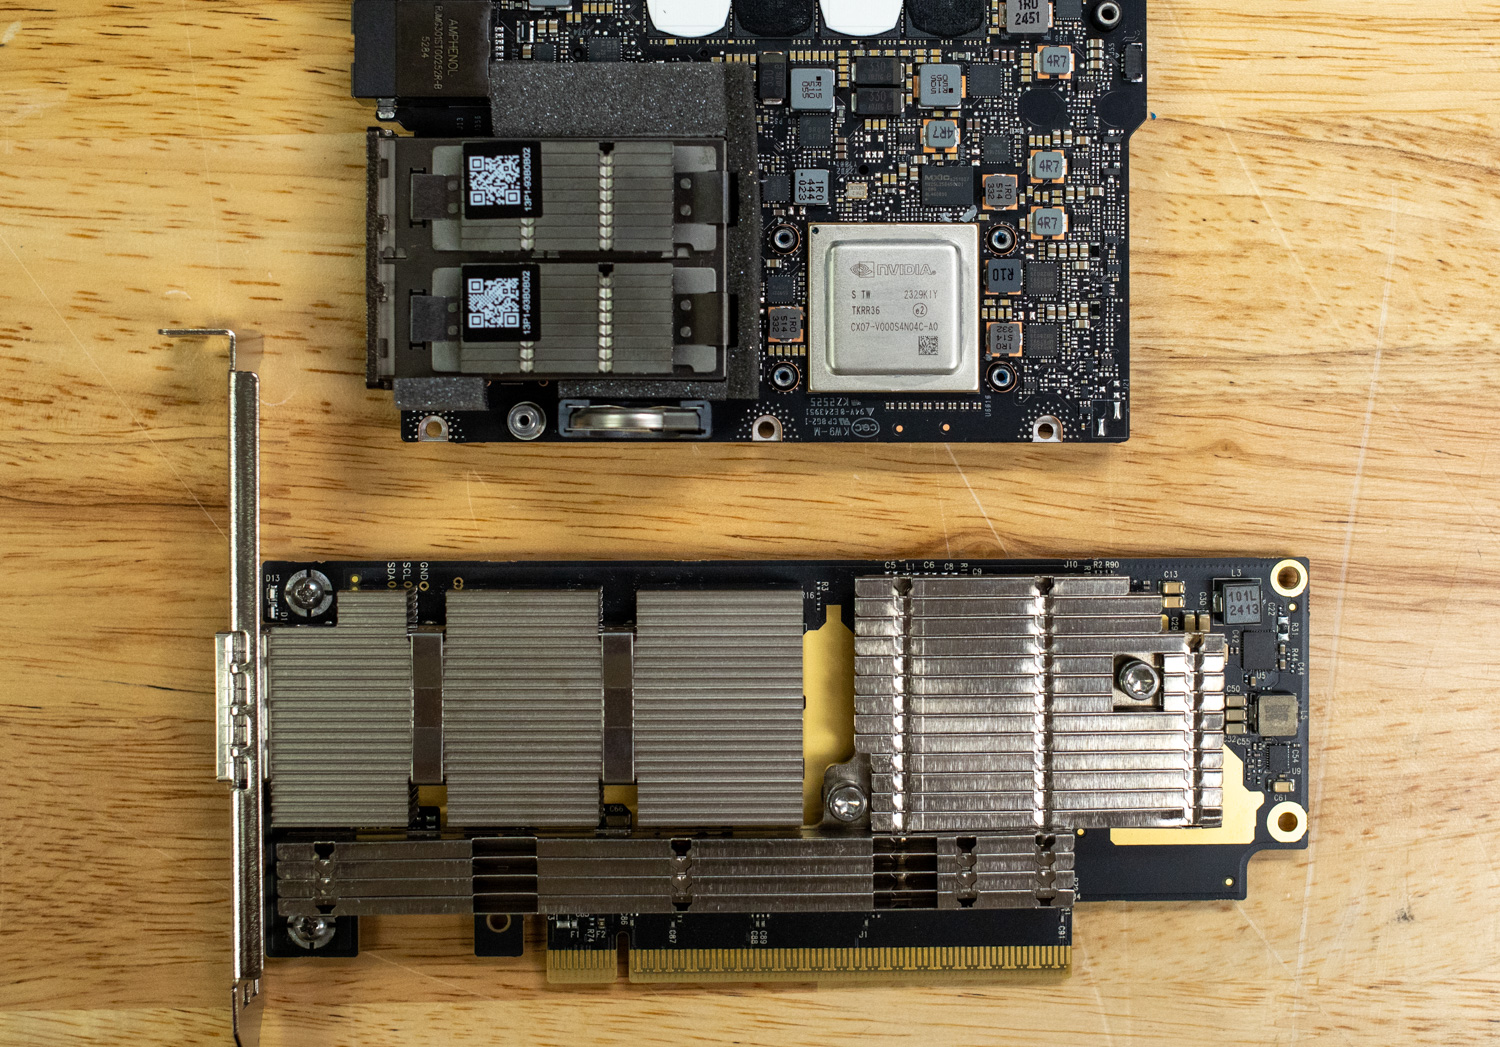
Proprio accanto al chip si trova la scheda di rete CX7 che, come accennato in precedenza, offre 200 GB di connettività. Ciò consente agli utenti di collegare Spark a storage ad alta velocità o persino di raggruppare più istanze di Spark insieme. NVIDIA ha convalidato e commercializza un cluster di 2 Spark che possono essere collegati direttamente per supportare modelli di intelligenza artificiale ancora più grandi.
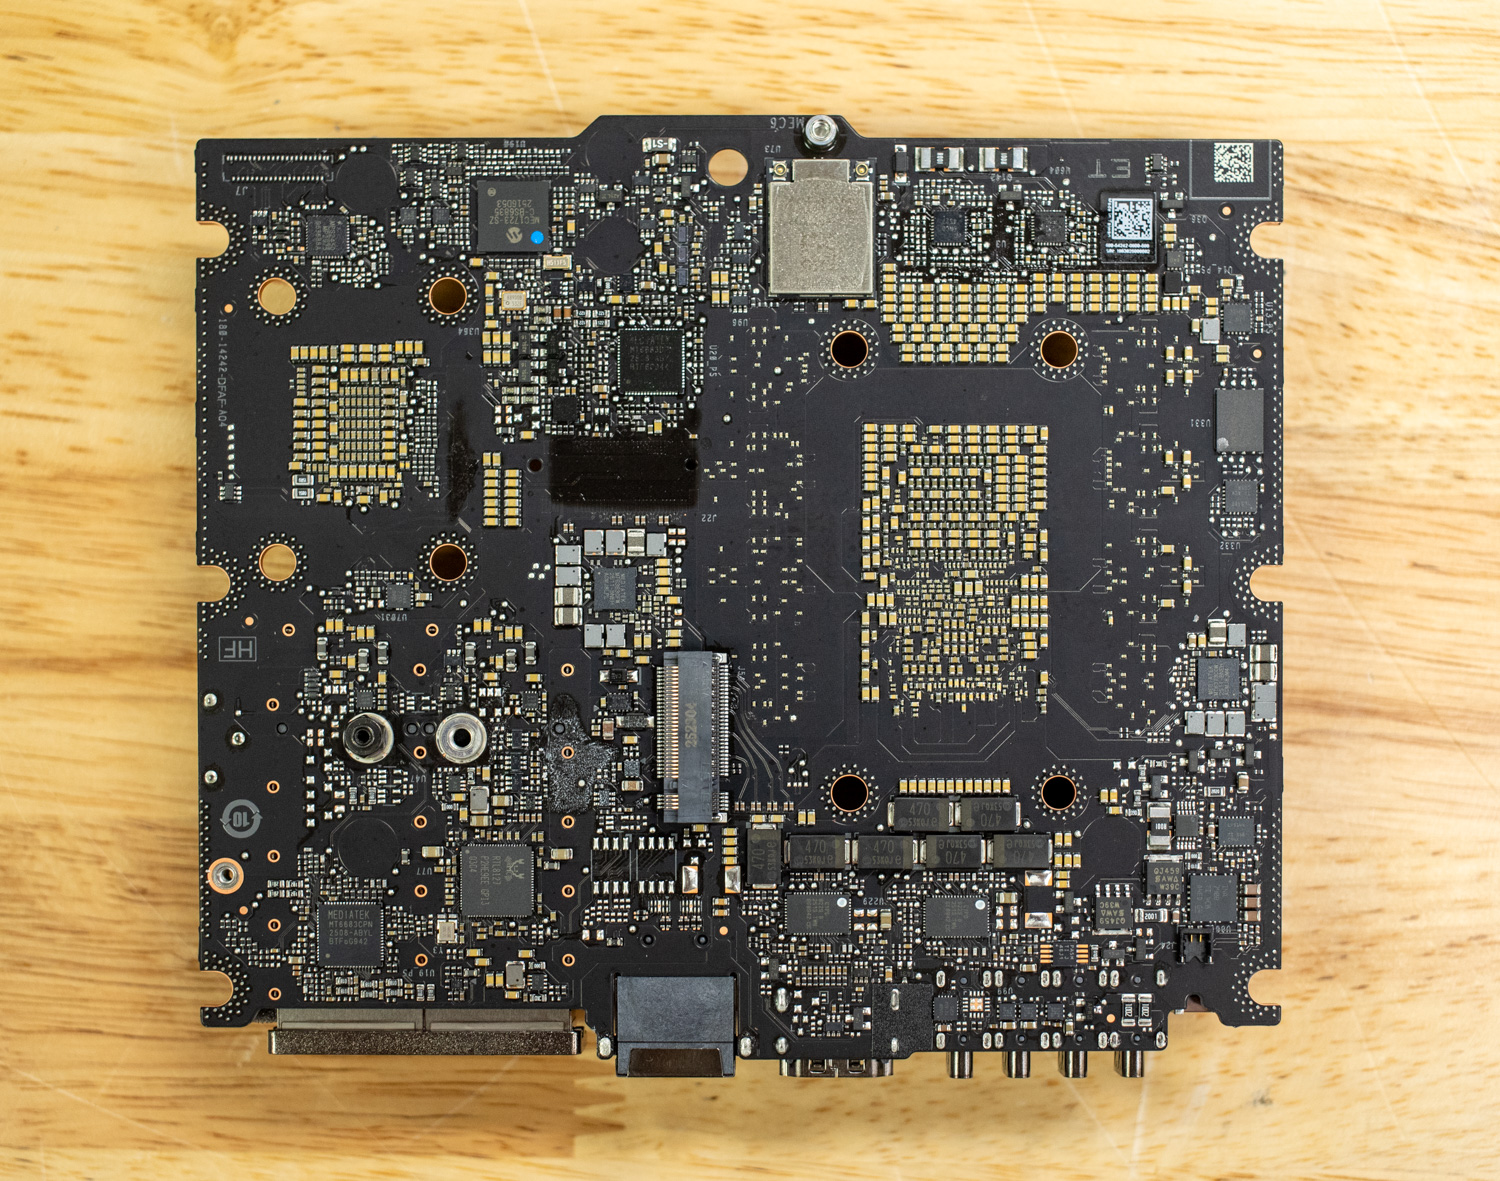
Infine, capovolgendo la scheda, si scoprono tutte le connettività PCIe, tra cui l'SSD PCIe Gen5 x4 2242 M.2 e l'adattatore Wi-Fi PCIe Gen3x1 MediaTek.
Dove Spark diventa indispensabile: il moderno dispositivo di sviluppo dell'intelligenza artificiale
DGX Spark si dimostra particolarmente interessante in diversi contesti professionali distinti, ognuno dei quali trae vantaggio dalla sua combinazione unica di memoria unificata, fattore di forma compatto e integrazione software completa.
Accelerazione della scienza dei dati: da Pandas alla produzione
Per i data scientist, NVIDIA DGX Spark rappresenta un notevole miglioramento in termini di velocità e esperienza del flusso di lavoro. La rete ConnectX-7, che offre una larghezza di banda di 200 Gbps, combinata con le librerie accelerate CUDA X, trasforma la pre-elaborazione dei dati. L'intelligenza artificiale e la scienza dei dati si basano sul principio "buoni dati in ingresso e buoni dati in uscita". Tradizionalmente, la fase più dispendiosa in termini di tempo di qualsiasi progetto di ML convenzionale è la pulizia dei dati e l'estrazione delle feature. I flussi di lavoro convenzionali in genere comportano il caricamento di set di dati in strumenti come Pandas e l'esecuzione di trasformazioni sui core della CPU, un processo generalmente lento. Anche l'esplorazione manuale e l'ingegneria delle feature possono rappresentare un ostacolo significativo. Spark consente l'accelerazione GPU end-to-end tramite RAPIDS.
Un tipico scenario di data science aziendale prevede l'ingegneria delle feature su set di dati di dimensioni comprese tra 40 e 80 GB: unione di più tabelle, elaborazione di aggregazioni su finestre temporali, gestione della codifica categoriale e normalizzazione delle distribuzioni. Su un'infrastruttura CPU, questa pre-elaborazione potrebbe richiedere ore. Con RAPIDS cuDF che carica l'intero set di dati nella memoria unificata da 128 GB di Spark, queste operazioni vengono completate in pochi minuti con un'accelerazione 10 volte superiore. Il successivo training del modello è vantaggioso sia per il machine learning classico con cuML che per il deep learning con PyTorch, eliminando il tradizionale collo di bottiglia in cui i data scientist attendono l'infrastruttura anziché iterare sulle ipotesi.
Generazione di dati sintetici: robotica e simulazione
L'inclusione dei core RT di quarta generazione posiziona Spark in modo unico per un flusso di lavoro emergente: la generazione di dati sintetici per l'addestramento di modelli del mondo reale. L'addestramento di politiche di manipolazione robuste richiede tradizionalmente decine di migliaia di dimostrazioni nel mondo reale, con costi e tempi proibitivi. La simulazione fotorealistica in piattaforme come Isaac Sim o Omniverse offre un'alternativa, ma il rendering di immagini ray-tracing con illuminazione, riflessi e materiali fisicamente accurati ha storicamente richiesto costose GPU per workstation come le NVIDIA L40S e RTX 6000 Ada.
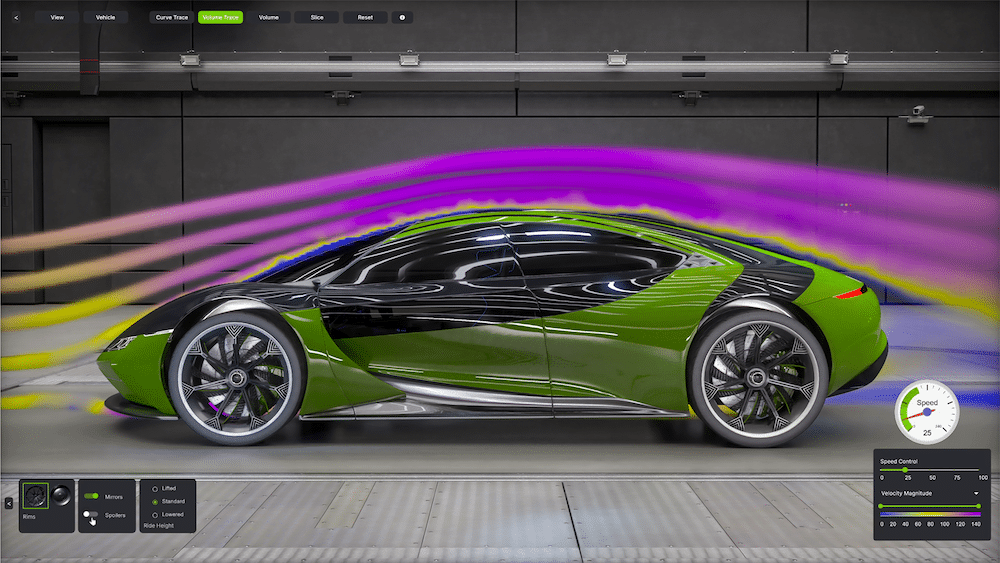
Fonte: NVIDIA
Spark consolida questo flusso di lavoro. Gli RT Core consentono ai carichi di lavoro OpenUSD di gestire la generazione di dati sintetici, mentre i Tensor Core vengono utilizzati per l'inferenza AI in un progetto/flusso di lavoro. In precedenza, le organizzazioni potevano implementare più macchine per il rendering e un server separato ottimizzato per l'inferenza. Ora, questo è possibile con un'unica appliance da 240 W. Per le startup di robotica, i laboratori universitari o i produttori di automobili che esplorano la manipolazione autonoma, questa integrazione riduce significativamente i tempi di sviluppo e le spese in conto capitale.
In precedenza, nella nostra analisi di NVIDIA L40S, abbiamo esplorato pipeline di generazione di dati sintetici simili utilizzando sistemi di rendering L40S dedicati, abbinati a H100 per l'inferenza . Il consolidamento architetturale di queste funzionalità in un'unica appliance di sviluppo, operato da GB10, rappresenta un'evoluzione significativa di questo flusso di lavoro. Prevediamo di condurre ulteriori test sulle prestazioni di Spark RT Core rispetto a queste configurazioni distinte in un'analisi futura, esaminando il rendering e altri carichi di lavoro per scenari rappresentativi di manipolazione robotica.
La rivoluzione del Vibe Coding
Andrej Karpathy, ex direttore dell'intelligenza artificiale di Tesla e membro fondatore di OpenAI, ha coniato il termine "vibe coding" per descrivere un approccio emergente allo sviluppo rapido di software con l'assistenza dell'intelligenza artificiale. Anziché scrivere meticolosamente il codice riga per riga, il vibe coding sfrutta gli LLM come programmatori interattivi in coppia: descrivono le funzionalità in linguaggio naturale, generano impalcature di implementazione, iterano attraverso il raffinamento conversazionale e prototipano rapidamente le funzionalità. Questo flusso di lavoro trasforma la codifica da costruzione deliberata a conversazione guidata con un'intelligenza artificiale che comprende il contesto, le API e i pattern architetturali, consentendo ai singoli sviluppatori di costruire sistemi straordinariamente sofisticati a una velocità senza precedenti.
La portata dell'adozione della codifica assistita dall'IA è dimostrata dalle classifiche di utilizzo di OpenRouter , dove i modelli focalizzati sulla codifica dominano costantemente il volume di inferenza. I professionisti tecnici, il principale gruppo demografico di utilizzatori della codifica vibe, operano in genere come utenti avanzati, eseguendo più agenti di codifica in parallelo in contesti diversi. E poiché i modelli open-weight eguagliano sempre più le alternative proprietarie nei benchmark chiave , gli sviluppatori stanno esplorando implementazioni di inferenza locali per eliminare le limitazioni di velocità, garantire la disponibilità durante le finestre di sviluppo critiche e mantenere la riservatezza del codice per i progetti proprietari.
La community r/LocalLLaMA presenta configurazioni personalizzate davvero impressionanti, che spaziano da workstation multi-GPU a server assemblati con nastro adesivo che eseguono modelli locali, inferenza distribuita su hardware consumer e soluzioni di raffreddamento elaborate che consentono una generazione ad alto rendimento e costante. Tuttavia, queste configurazioni presentano ostacoli significativi: spese in conto capitale che spesso superano decine di migliaia di dollari, consumi energetici considerevoli, problemi di gestione termica che richiedono spazi dedicati anziché ambienti d'ufficio standard e notevoli competenze tecniche per la configurazione, l'ottimizzazione e la risoluzione dei problemi.
Spark modifica radicalmente questa proposta di valore. A 3,999 dollari con 128 GB di memoria unificata, offre prestazioni di inferenza di modelli impressionanti in un dispositivo silenzioso, compatto ed efficiente dal punto di vista energetico, con un consumo di soli 240 W. Gli utenti che desiderano creare un'infrastruttura locale per l'assistente di codifica non hanno più bisogno di elaborati laboratori domestici che consumano kilowattora e generano una notevole emissione di calore. L'approccio basato su un dispositivo convalidato con sistema operativo DGX preconfigurato elimina la complessità di configurazione che in precedenza limitava l'implementazione di LLM locali agli utenti con una profonda esperienza in Linux e CUDA.
Oltre a eliminare gli attriti infrastrutturali, Spark affronta problematiche critiche relative alla privacy del codice e alla personalizzazione dei modelli. Gli assistenti di programmazione basati su cloud trasmettono necessariamente il codice sorgente a server remoti, il che è un'opzione non consigliabile per le organizzazioni che gestiscono algoritmi proprietari, infrastrutture critiche per la sicurezza o dati regolamentati. L'inferenza locale su Spark garantisce che il codice non lasci mai l'ambiente di sviluppo. Inoltre, la capacità di memoria di 128 GB consente la completa messa a punto dei parametri dei modelli di programmazione, consentendo agli sviluppatori esperti di specializzare i modelli su basi di codice interne. Questa funzionalità è particolarmente preziosa per le organizzazioni con linguaggi specifici per dominio, framework personalizzati o modelli architetturali non sufficientemente rappresentati nei dati di training pubblici.
Ottimizzazione con NVIDIA NeMo su DGX Spark
La memoria unificata da 128 GB di DGX Spark consente la messa a punto completa dei parametri dei modelli 8B che tradizionalmente richiedevano costose configurazioni cloud multi-GPU. La messa a punto completa di Qwen3 8B con ottimizzazione Adam standard richiede circa 132 GB (16 GB di pesi del modello, 96 GB di stati dell'ottimizzatore, 16 GB di gradienti, più attivazioni), superando le configurazioni dual H100 da 80 GB. L'utilizzo di Adam a 8 bit a basso consumo di memoria riduce i requisiti a circa 70 GB, a seconda delle dimensioni del batch, rientrando comodamente nel pool di memoria di Spark. Questo è importante perché la messa a punto completa offre una precisione del 4-6% migliore rispetto a LoRA su attività di ragionamento complesse. Mentre le configurazioni cloud basate su 2× H100 da 80 GB costano circa 5 dollari all'ora con complessità di training distribuita, Spark offre training su un singolo sistema con un investimento una tantum di 3,999 dollari.
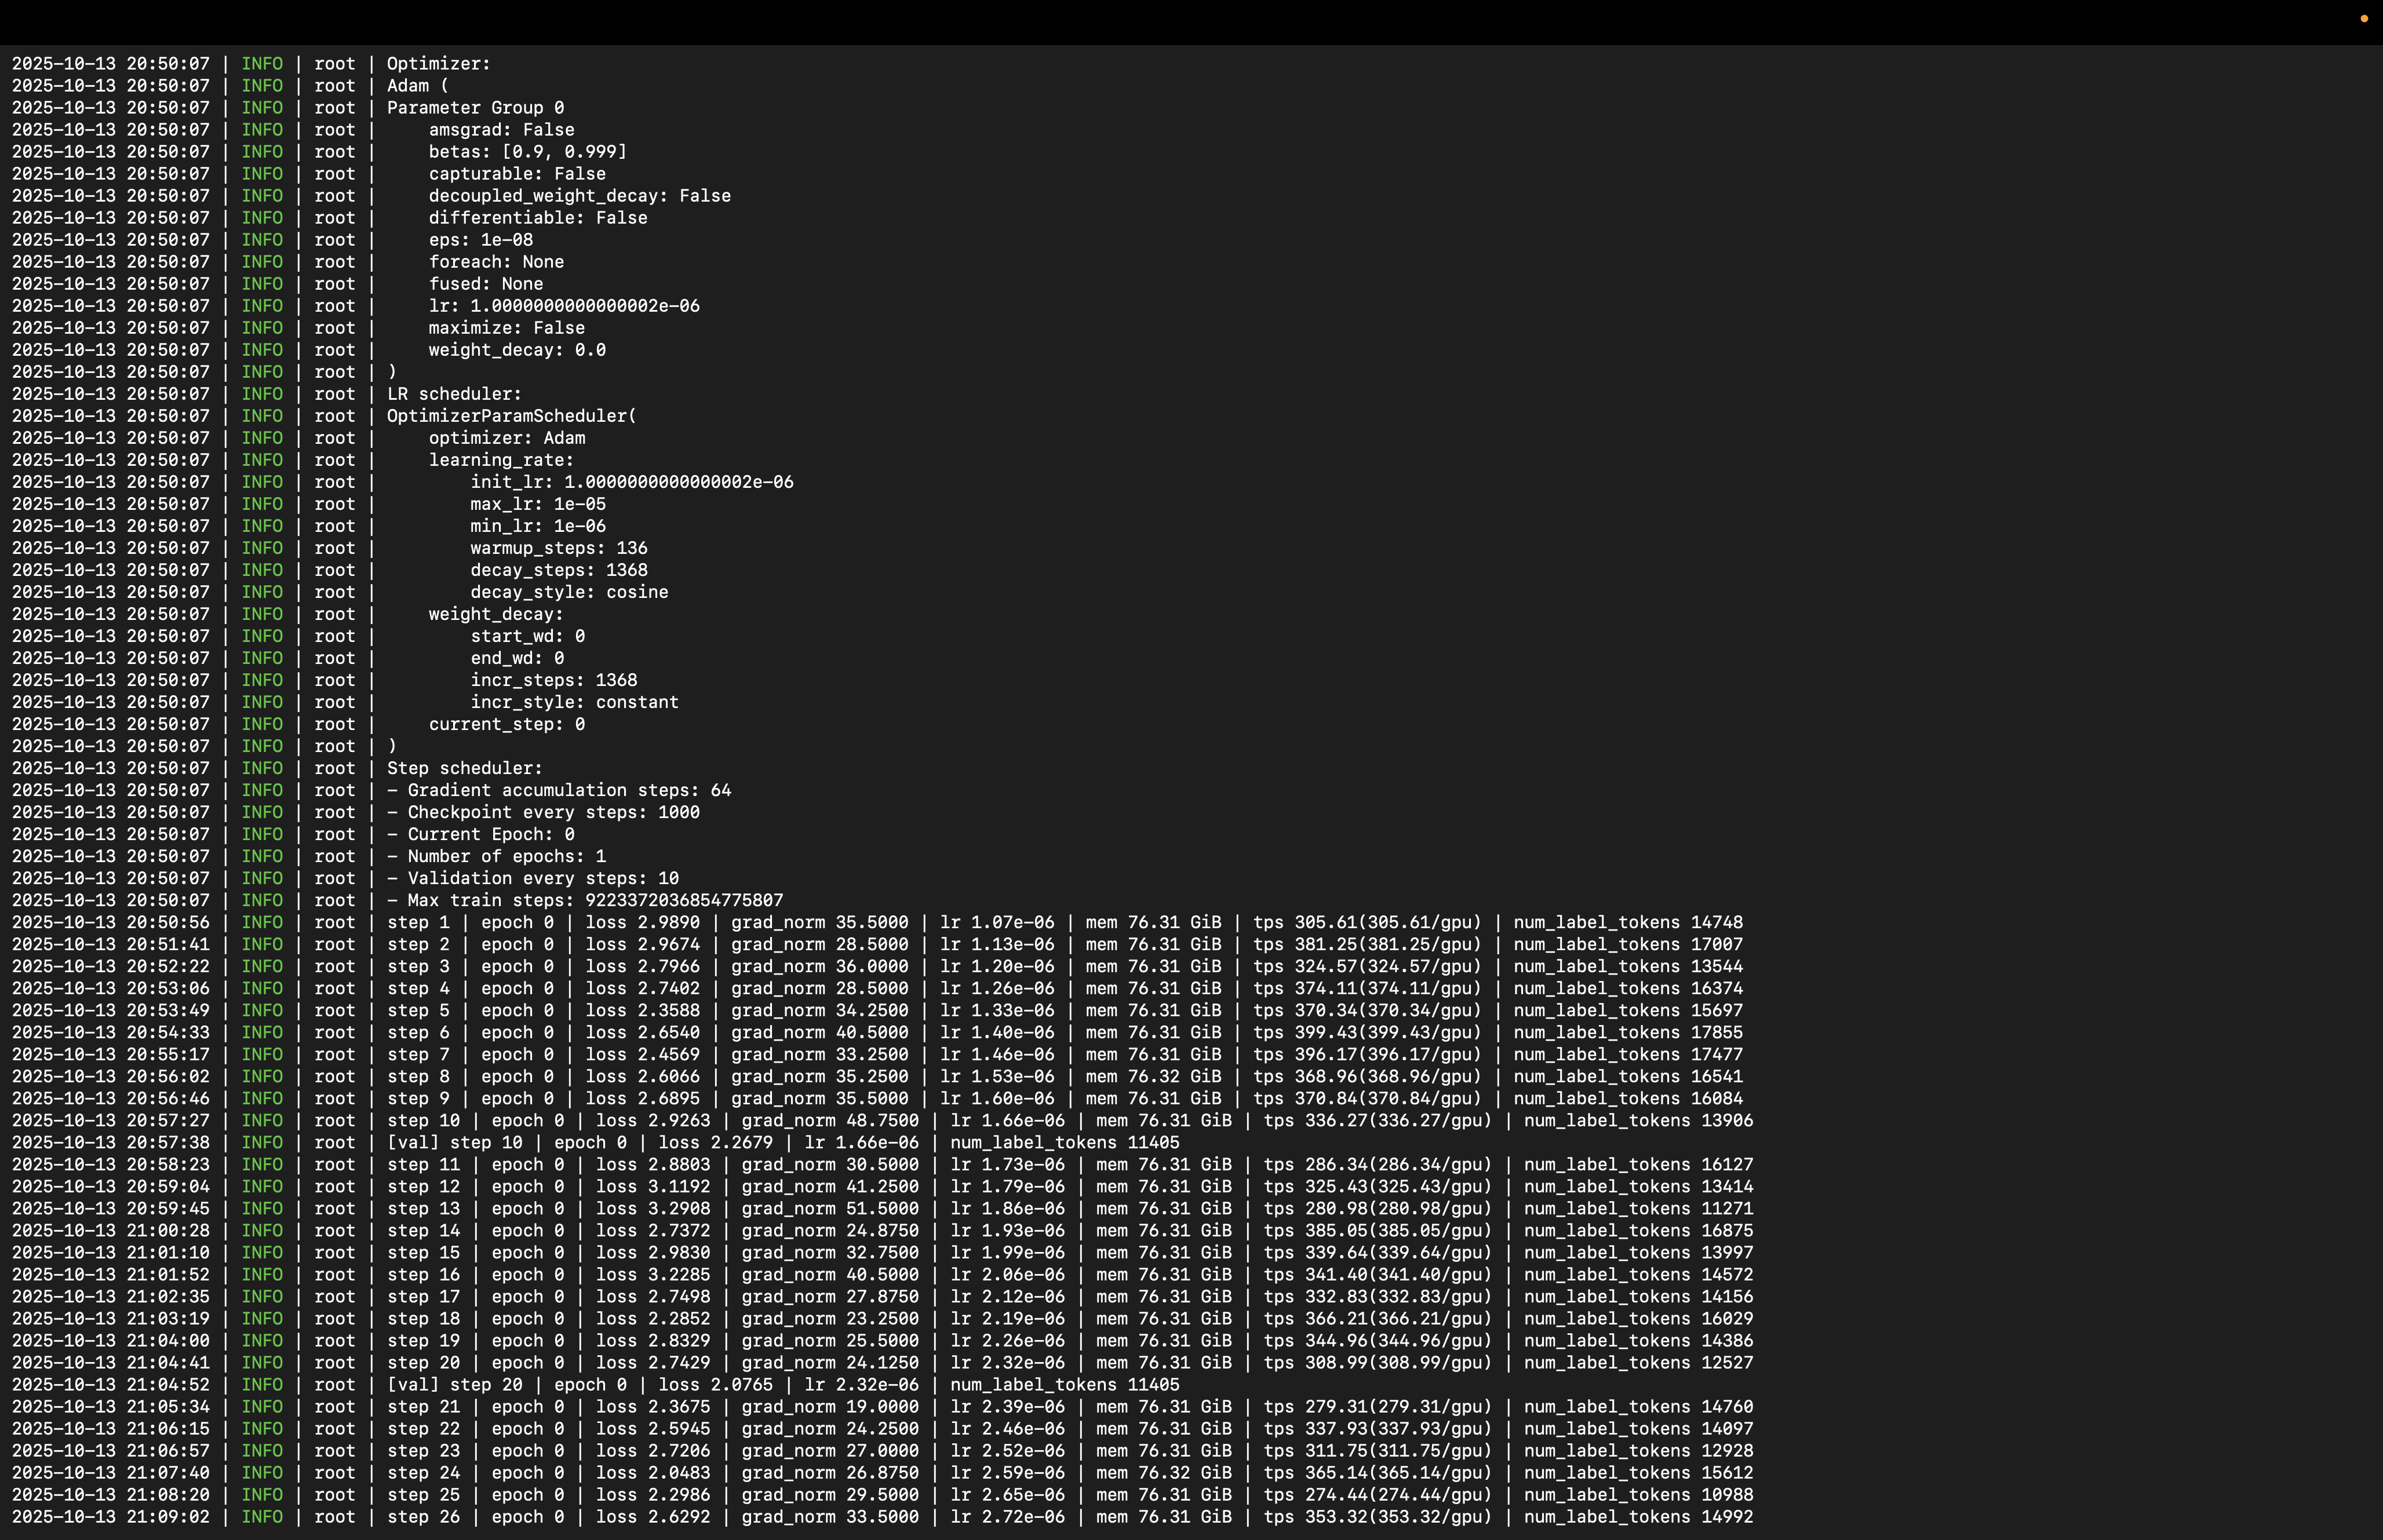
NVIDIA NeMo Automodel elimina le difficoltà del framework di training aziendale fornendo supporto immediato per qualsiasi modello Hugging Face senza conversione dei checkpoint. È possibile caricare Qwen3 8B direttamente da HuggingFace Hub e configurare la messa a punto tramite file YAML specificando le sorgenti dei dataset, le impostazioni dell'ottimizzatore e i target LoRA. NeMo automatizza il checkpointing distribuito con compatibilità con i safetensor, implementa kernel CUDA fusi per accelerazioni da 2 a 5 volte superiori e gestisce l'accumulo di gradienti.
Generazione di immagini con interfaccia utente comoda
ComfyUI offre un'interfaccia grafica basata su nodi che trasforma la diffusione stabile e i modelli di diffusione correlati in pipeline creative altamente personalizzabili. A differenza delle tradizionali interfacce web che astraggono la complessità dietro cursori di parametri semplificati, ComfyUI impiega un'architettura grafica visiva in cui gli utenti costruiscono flussi di lavoro collegando nodi funzionali discreti, ognuno dei quali rappresenta operazioni specifiche come il caricamento del modello, la codifica dei prompt, il campionamento della diffusione latente, la decodifica VAE o le trasformazioni di upscaling. Questo design modulare consente un controllo granulare sull'intera pipeline di generazione, rendendo ogni fase computazionale trasparente e regolabile. Consente inoltre agli utenti di concatenare più modelli, implementare pianificazioni di campionamento personalizzate o integrare tecniche avanzate come la guida ControlNet, cosa che sarebbe impossibile in interfacce semplificate.
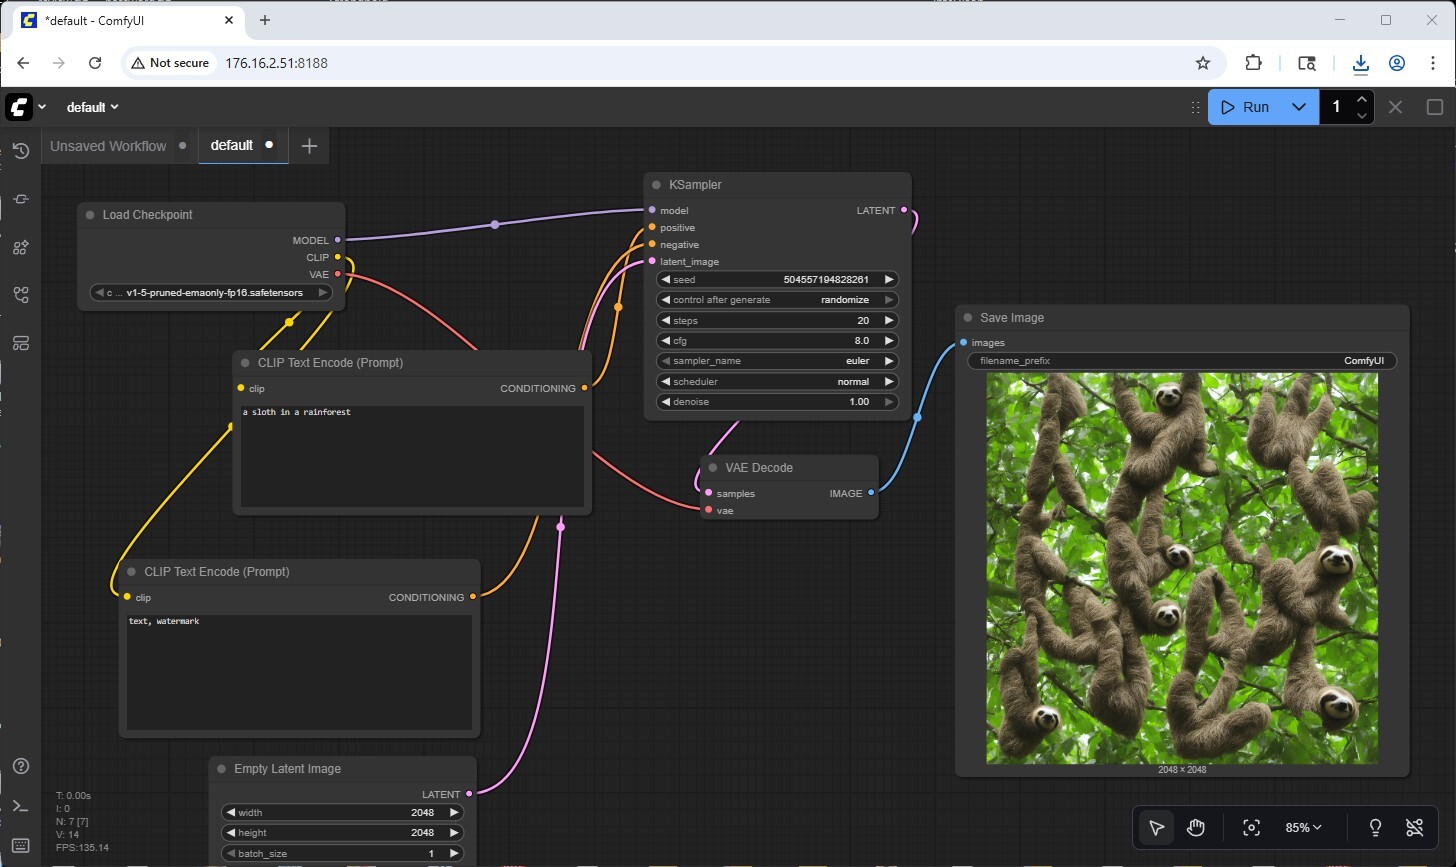
Su DGX Spark, ComfyUI sfrutta i Tensor Core della GPU Blackwell per il campionamento a diffusione accelerato, completando in genere le generazioni in 15-30 secondi a seconda della complessità del campionamento. L'architettura di memoria unificata da 128 GB si rivela particolarmente vantaggiosa, mantenendo contemporaneamente in memoria più modelli di checkpoint, adattatori LoRA e decoder VAE, eliminando il sovraccarico di ricarica che affligge i sistemi con limitazioni di VRAM. Gli utenti possono generare localmente un numero praticamente illimitato di opere d'arte basate sull'intelligenza artificiale, senza i limiti di velocità delle API, i costi del cloud per generazione e i problemi di privacy associati ai flussi di lavoro creativi proprietari. Il modello di persistenza del flusso di lavoro aggiunge valore operativo: pipeline complete vengono serializzate in file JSON che possono essere controllati in base alla versione, condivisi tra i team o incorporati direttamente nelle immagini generate come metadati, consentendo una riproducibilità fondamentale per le organizzazioni che creano pipeline di dataset sintetici o mantengono stili artistici coerenti tra le risorse generate.
Test delle prestazioni di NVIDIA DGX Spark
Servizio online vLLM – Test di inferenza LLM
vLLM è il motore di inferenza e di servizio ad alta velocità più diffuso per gli LLM. Il benchmark di servizio online vLLM è uno strumento di valutazione delle prestazioni progettato per misurare le capacità di servizio reali di questo motore di inferenza durante la gestione di richieste simultanee. Simula carichi di lavoro di produzione inviando richieste a un server vLLM in esecuzione con parametri configurabili, come frequenza di richiesta, lunghezza di input/output e numero di client simultanei. Il benchmark misura metriche chiave, tra cui la velocità di trasmissione (throughput), ovvero token al secondo, tempo per il primo token e tempo per token di output, aiutando gli utenti a comprendere le prestazioni di vLLM in diverse condizioni di carico.
Abbiamo testato le prestazioni di inferenza su una suite completa di modelli che rappresentano le architetture e i tipi di modelli più diffusi nelle attuali distribuzioni di produzione.
Modelli di miscela di esperti
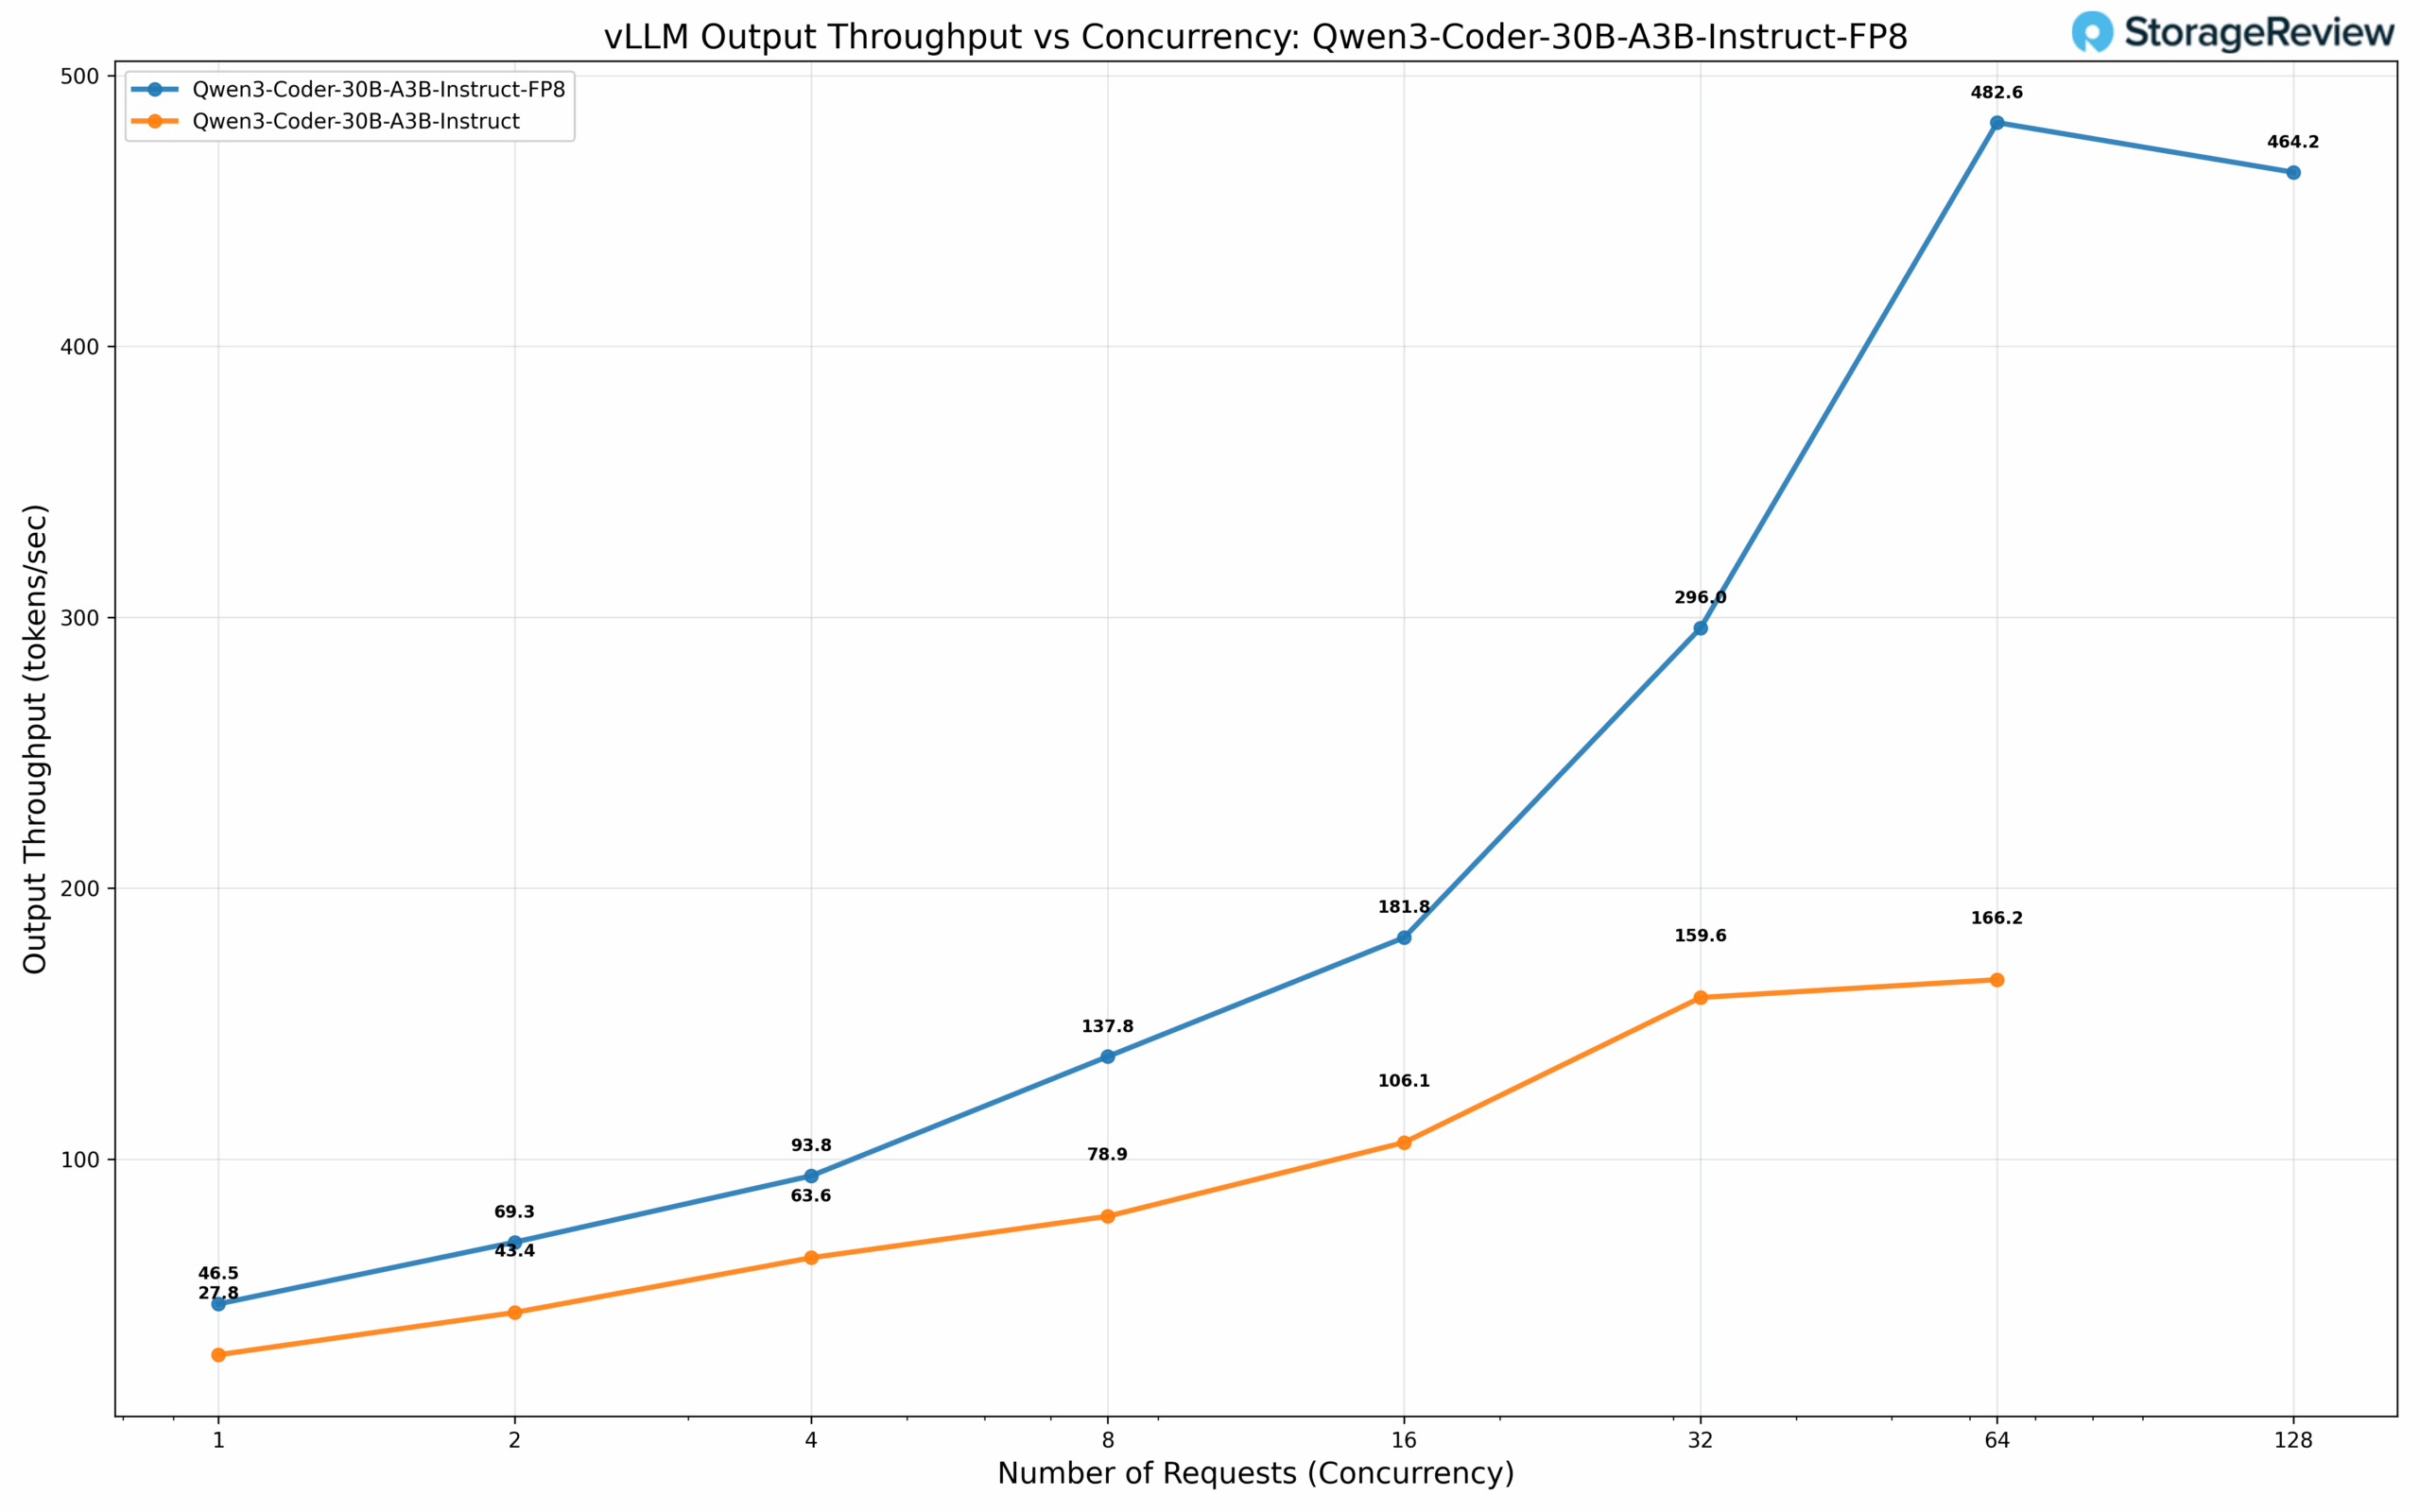
Abbiamo valutato il Qwen3 Coder 30B-A3B, uno dei modelli di codifica più diffusi per l'implementazione di inferenze locali. Questa architettura sparsa mantiene una dimensione del modello completo di 30 miliardi di parametri con precisione BF16, attivando solo 3 miliardi di parametri per token generato. Abbiamo eseguito benchmark sia del modello standard che di una variante quantizzata FP8 di Qwen. Il modello quantizzato FP8 dimostra notevoli miglioramenti in termini di prestazioni: raggiunge 46.5 tok/s con concorrenza 1, raggiungendo un impressionante valore di 482.6 tok/s con batch size 64. Il modello standard BF16 fornisce 27.8 tok/s con concorrenza 1, raggiungendo 166.2 tok/s con batch size 64, con un differenziale di prestazioni quasi 3 volte superiore.
Modelli densi
I modelli densi rappresentano l'architettura LLM convenzionale, in cui tutti i parametri e le attivazioni vengono coinvolti durante l'inferenza, con conseguente elaborazione più intensiva dal punto di vista computazionale rispetto alle controparti sparse. Per valutare in modo completo le caratteristiche prestazionali su diverse scale di modelli e strategie di quantizzazione, abbiamo confrontato cinque configurazioni di modelli densi.
La nostra suite di test includeva Mistral Small 3.1 24B di Mistral AI con precisione BF16, insieme a una variante quantizzata dinamicamente di Mistral Small 3.1 24B FP8 di RedHat AI. La quantizzazione dinamica impiega tecniche di quantizzazione selettiva dei pesi per ottimizzare il compromesso tra prestazioni e accuratezza, riducendo strategicamente la precisione e minimizzando al contempo il degrado del modello. Abbiamo integrato questi modelli densi più grandi con valutazioni di Meta Llama 3.1 8B su tre formati di precisione: la configurazione BF16 standard, più le versioni quantizzate FP8 e FP4 di NVIDIA. Questa strategia di selezione del modello consente il confronto diretto delle prestazioni su diverse scale di modelli, isolando al contempo l'impatto della quantizzazione progressiva sulla produttività dell'inferenza.
Analisi delle prestazioni: modelli grandi e densi
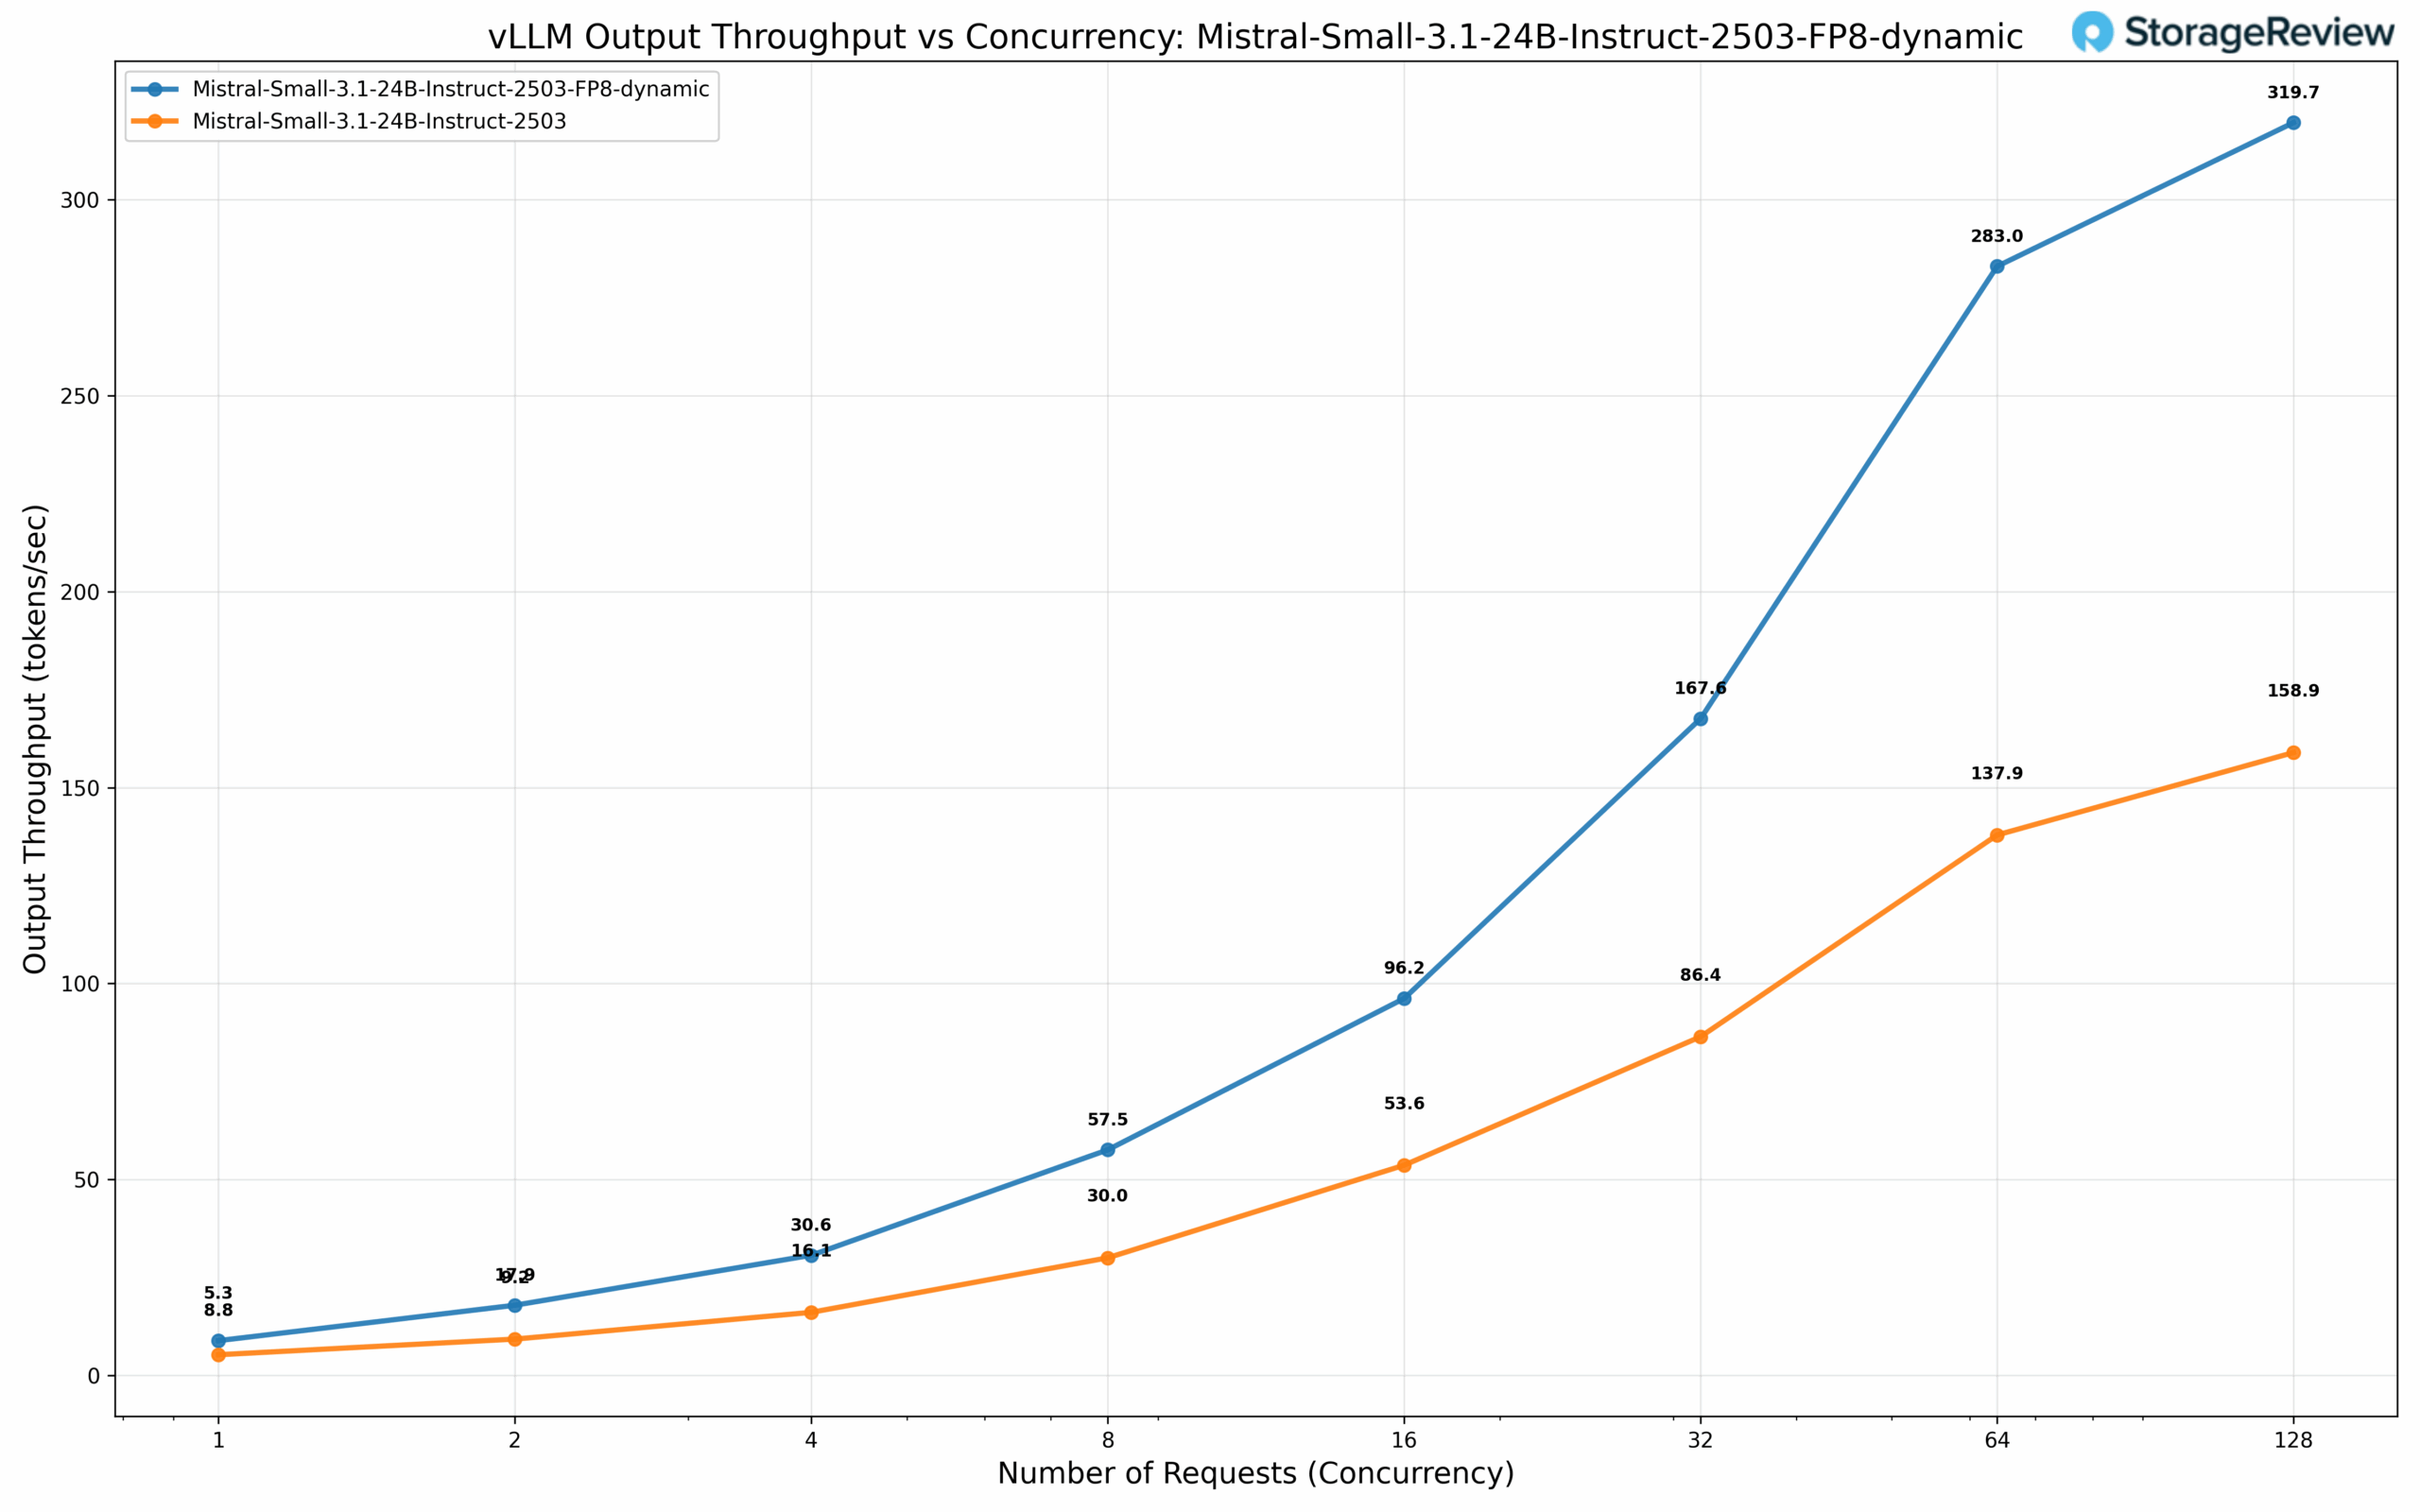
Il Mistral Small 3.1 24B con precisione BF16 mostra un throughput di base di 5.3 tok/s con concorrenza 1, che raggiunge un sostanziale 158.9 tok/s con 128 richieste simultanee. La variante FP8 quantizzata dinamicamente dimostra modesti guadagni con una concorrenza inferiore, con 8.8 tok/s, ma offre un interessante moltiplicatore di prestazioni 2x su larga scala, raggiungendo 319.7 tok/s con 128 richieste simultanee, sottolineando l'efficacia della quantizzazione dinamica per scenari di servizio ad alto throughput.
Analisi delle prestazioni: modelli compatti e densi
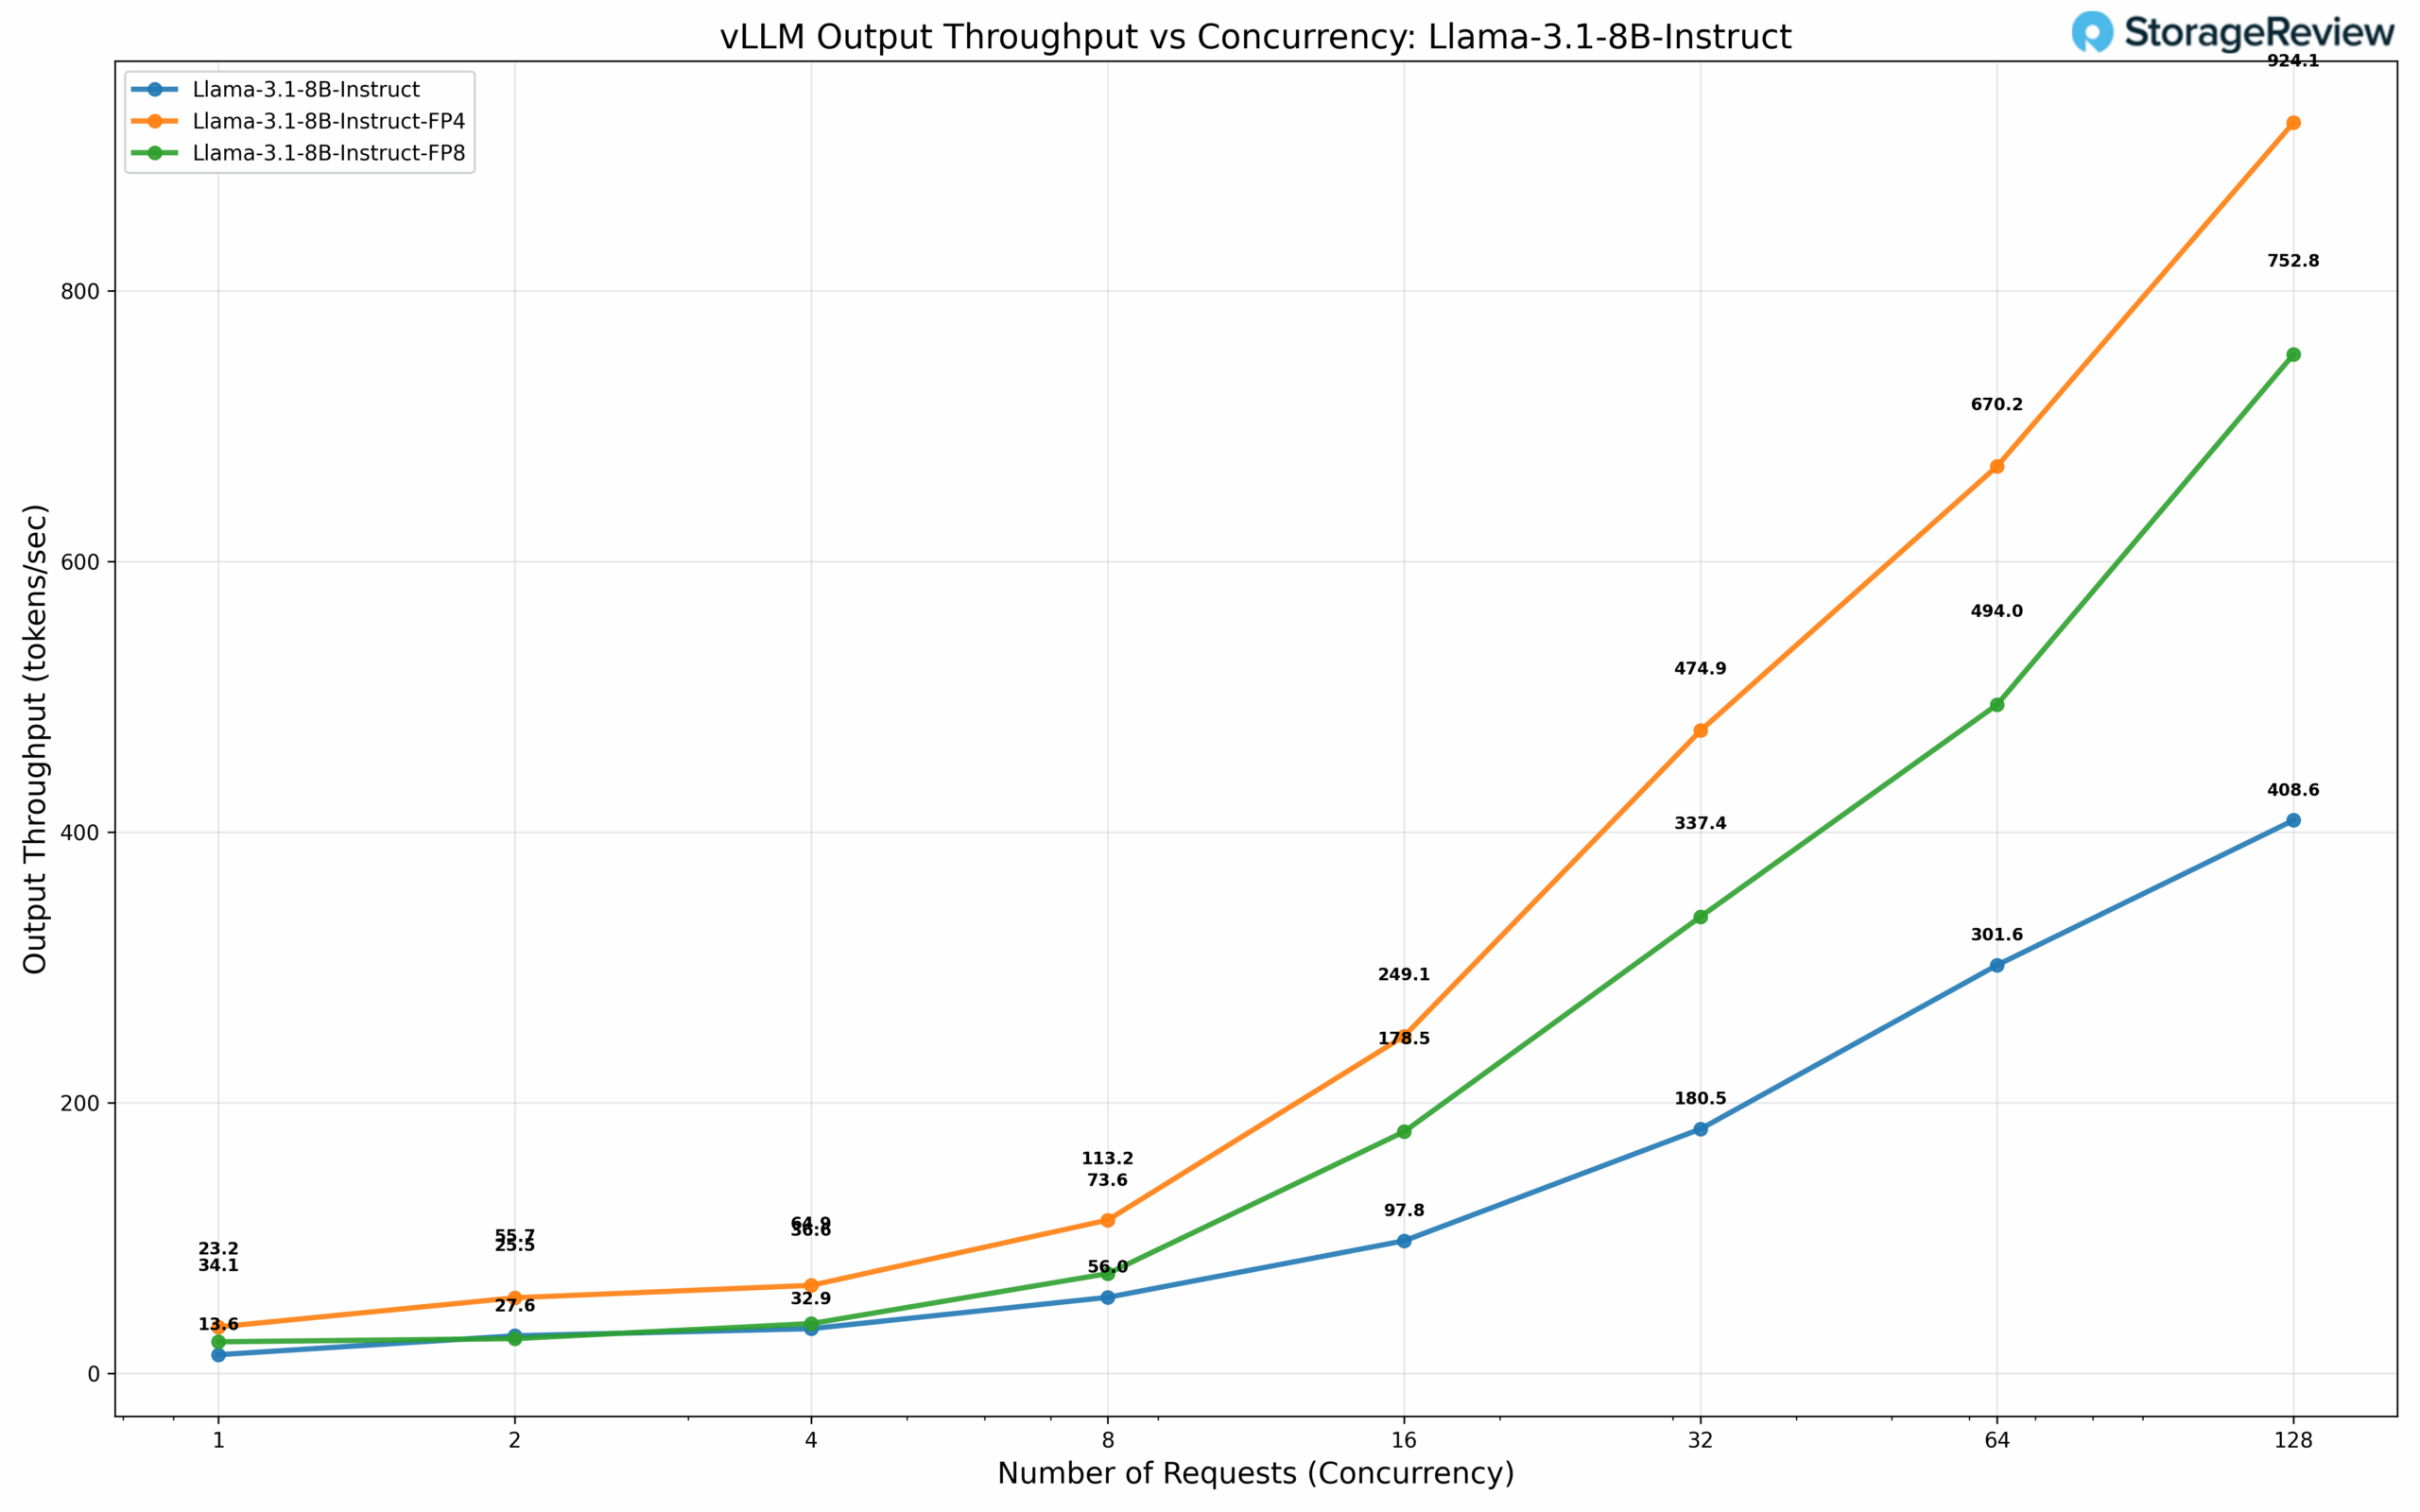
L'architettura Llama 3.1 8B rivela caratteristiche prestazionali notevolmente diverse tra le diverse strategie di quantizzazione. Con una precisione BF16, il modello fornisce 13.6 tok/s con un livello di concorrenza pari a 1, che si espandono a 408.6 tok/s con 128 richieste simultanee. La transizione alla quantizzazione FP8 produce 23.2 tok/s e 752.8 tok/s rispettivamente con livelli di concorrenza pari a 1 e 128, rappresentando un miglioramento del throughput su larga scala dell'84%. La configurazione FP4 spinge ulteriormente le prestazioni, raggiungendo 34.1 tok/s e 924.1 tok/s con gli stessi livelli di concorrenza, dimostrando che strategie di quantizzazione aggressive possono offrire un incremento prestazionale di 2.3 volte rispetto alla precisione di base, mantenendo al contempo una qualità del modello accettabile per molti carichi di lavoro di produzione.
Tipo di dati di microscaling
Il microscaling rappresenta un approccio di quantizzazione avanzato che applica fattori di scala a grana fine a piccoli blocchi di pesi anziché una quantizzazione uniforme su grandi gruppi di parametri. Il formato NVFP4 di NVIDIA implementa questa tecnica attraverso una rappresentazione in virgola mobile bloccata in cui ogni blocco di microscala di 8-32 valori condivide un esponente comune come fattore di scala. Questo approccio granulare preserva la precisione numerica ottenendo al contempo una rappresentazione a 4 bit, mantenendo la gamma dinamica critica per le architetture a trasformatore. Il formato si integra con l'architettura Tensor Core di NVIDIA, consentendo un calcolo efficiente a precisione mista con decompressione al volo durante le operazioni sulla matrice.
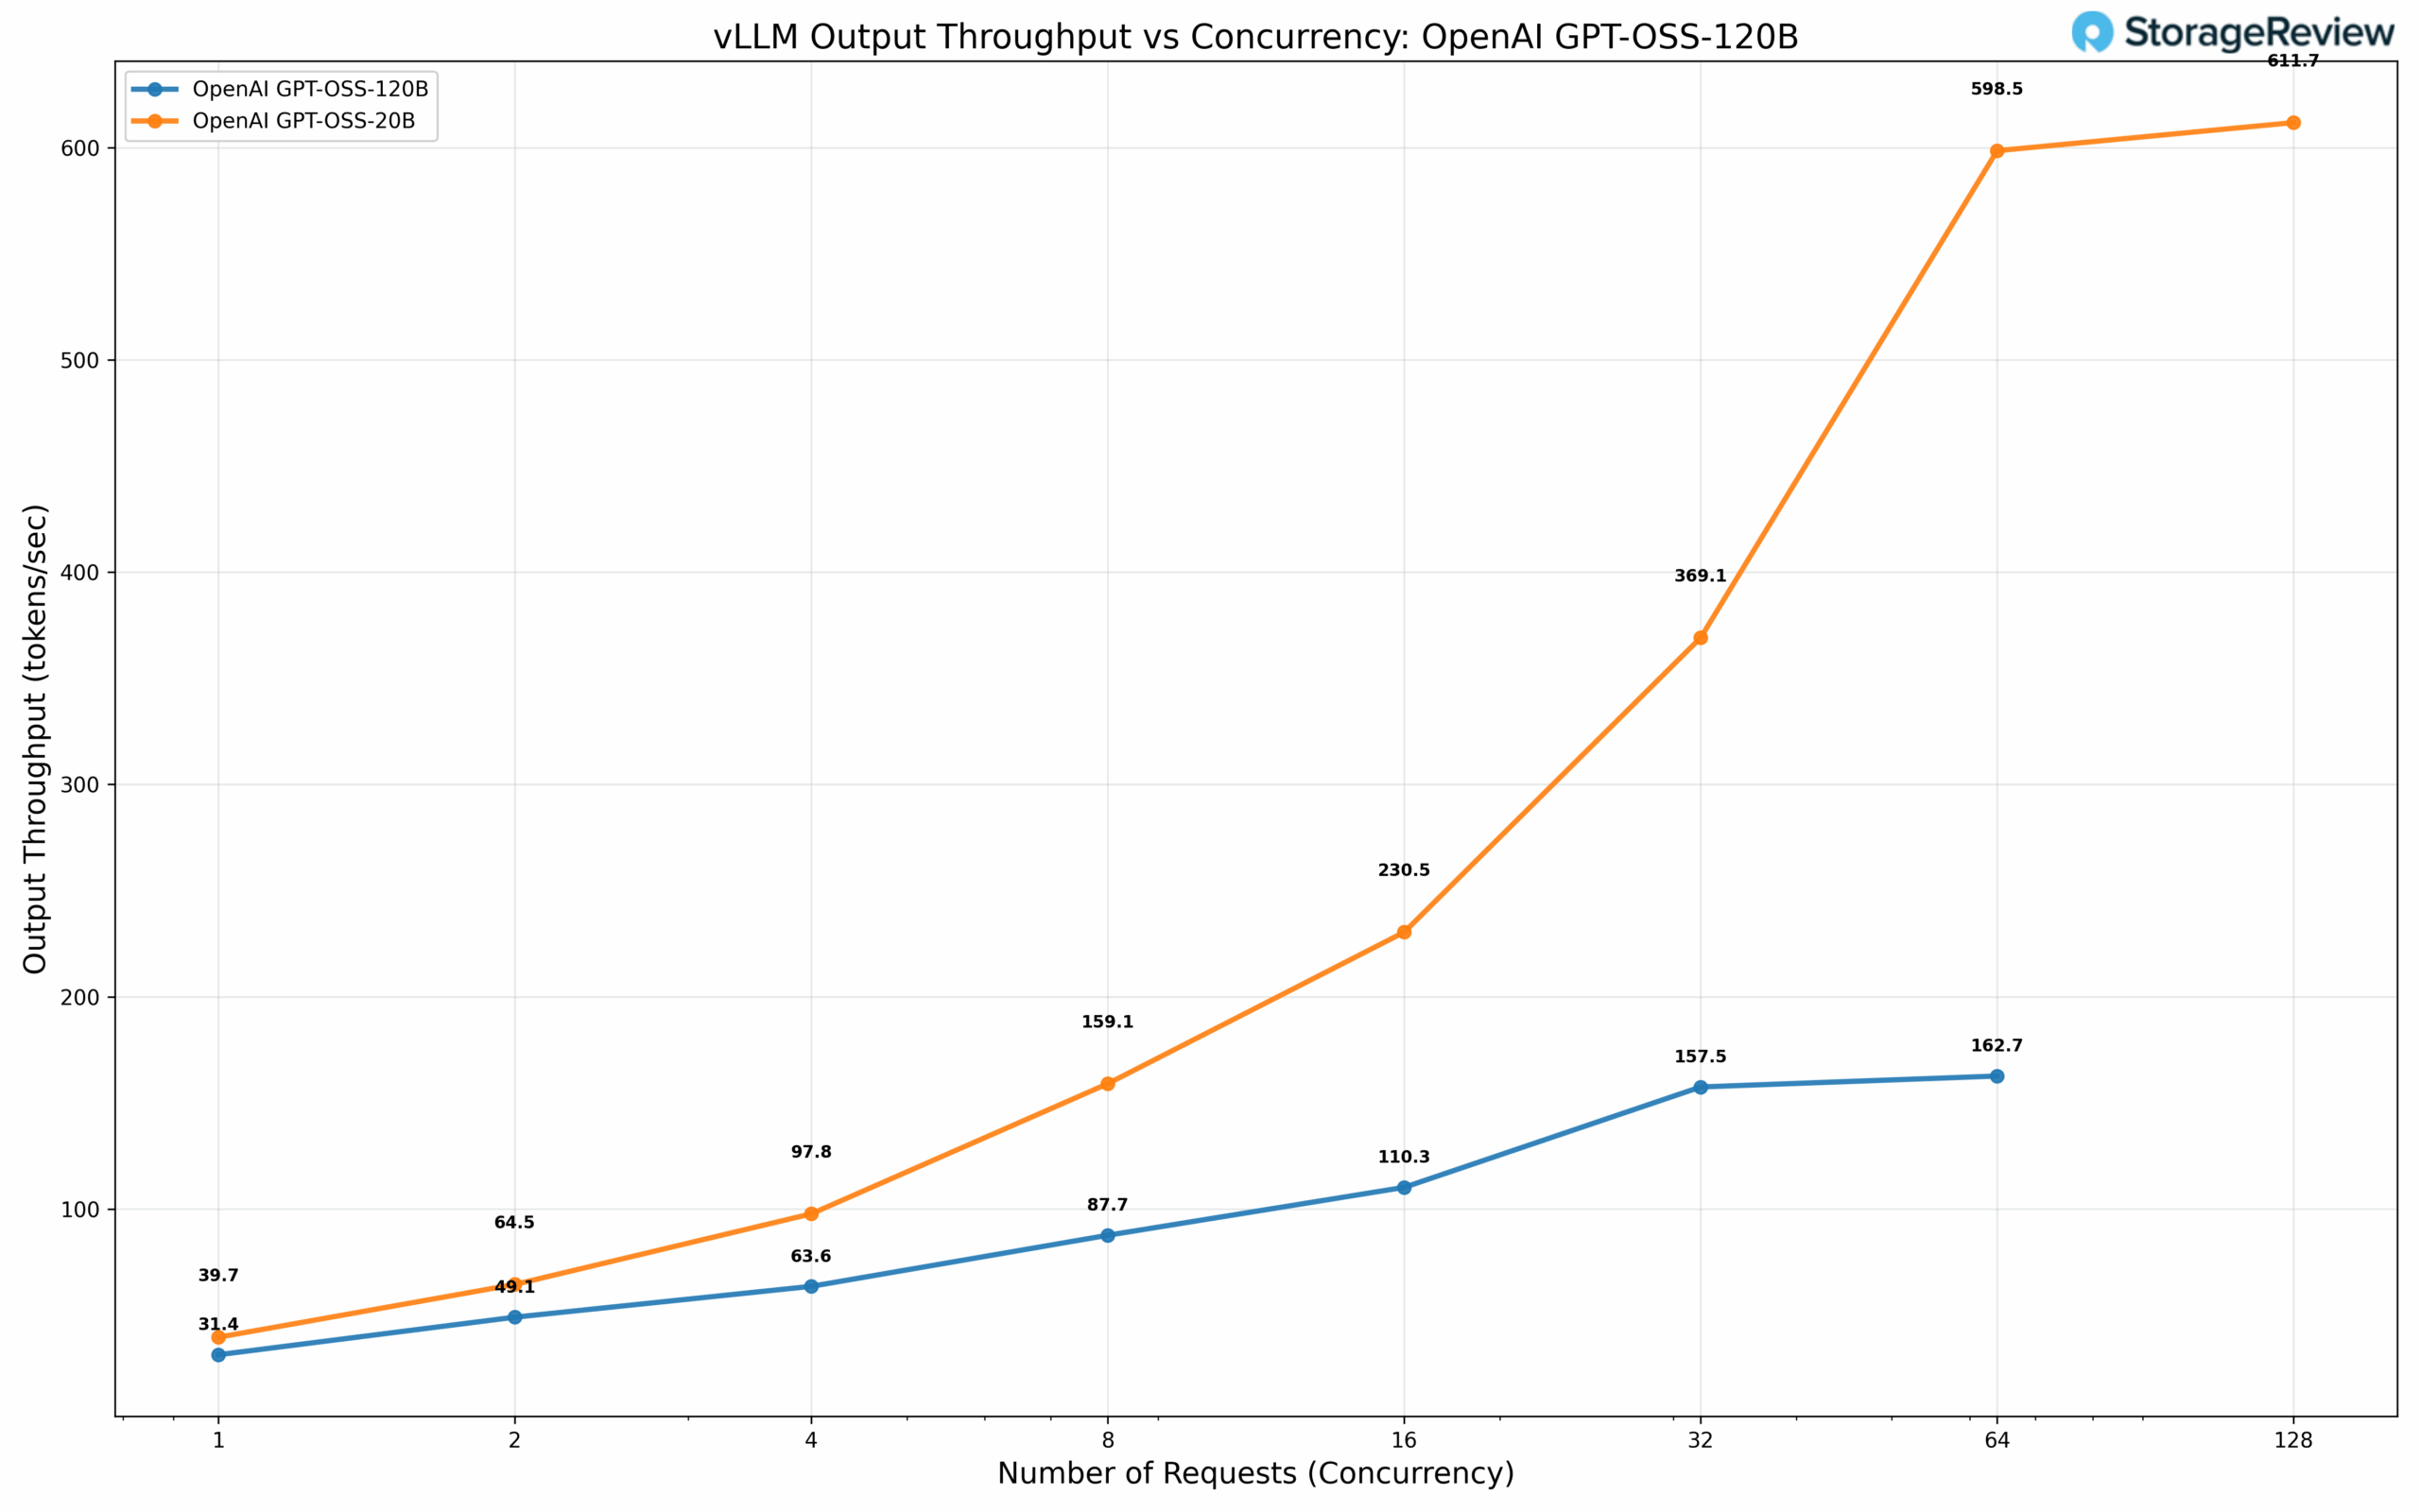
Abbiamo valutato i modelli OSS GPT di OpenAI su scale di parametri di 20B e 120B utilizzando la quantizzazione NVFP4. Il modello a 20B di parametri raggiunge 39.7 tok/s con concorrenza 1, scalando a 611.7 tok/s con 128 richieste simultanee. La variante a 120B di parametri fornisce 31.4 tok/s con concorrenza 1 e 162.7 tok/s con 64 richieste simultanee.
Nota: la velocità di trasmissione in uscita si riferisce alla velocità di trasmissione complessiva delle richieste e non alla velocità di trasmissione per singola richiesta.
A causa del tempo limitato non siamo riusciti a terminare i nostri test TensorRT. Continuate a seguirci per i prossimi articoli su Spark, in cui esploreremo le prestazioni su altri framework di inferenza.
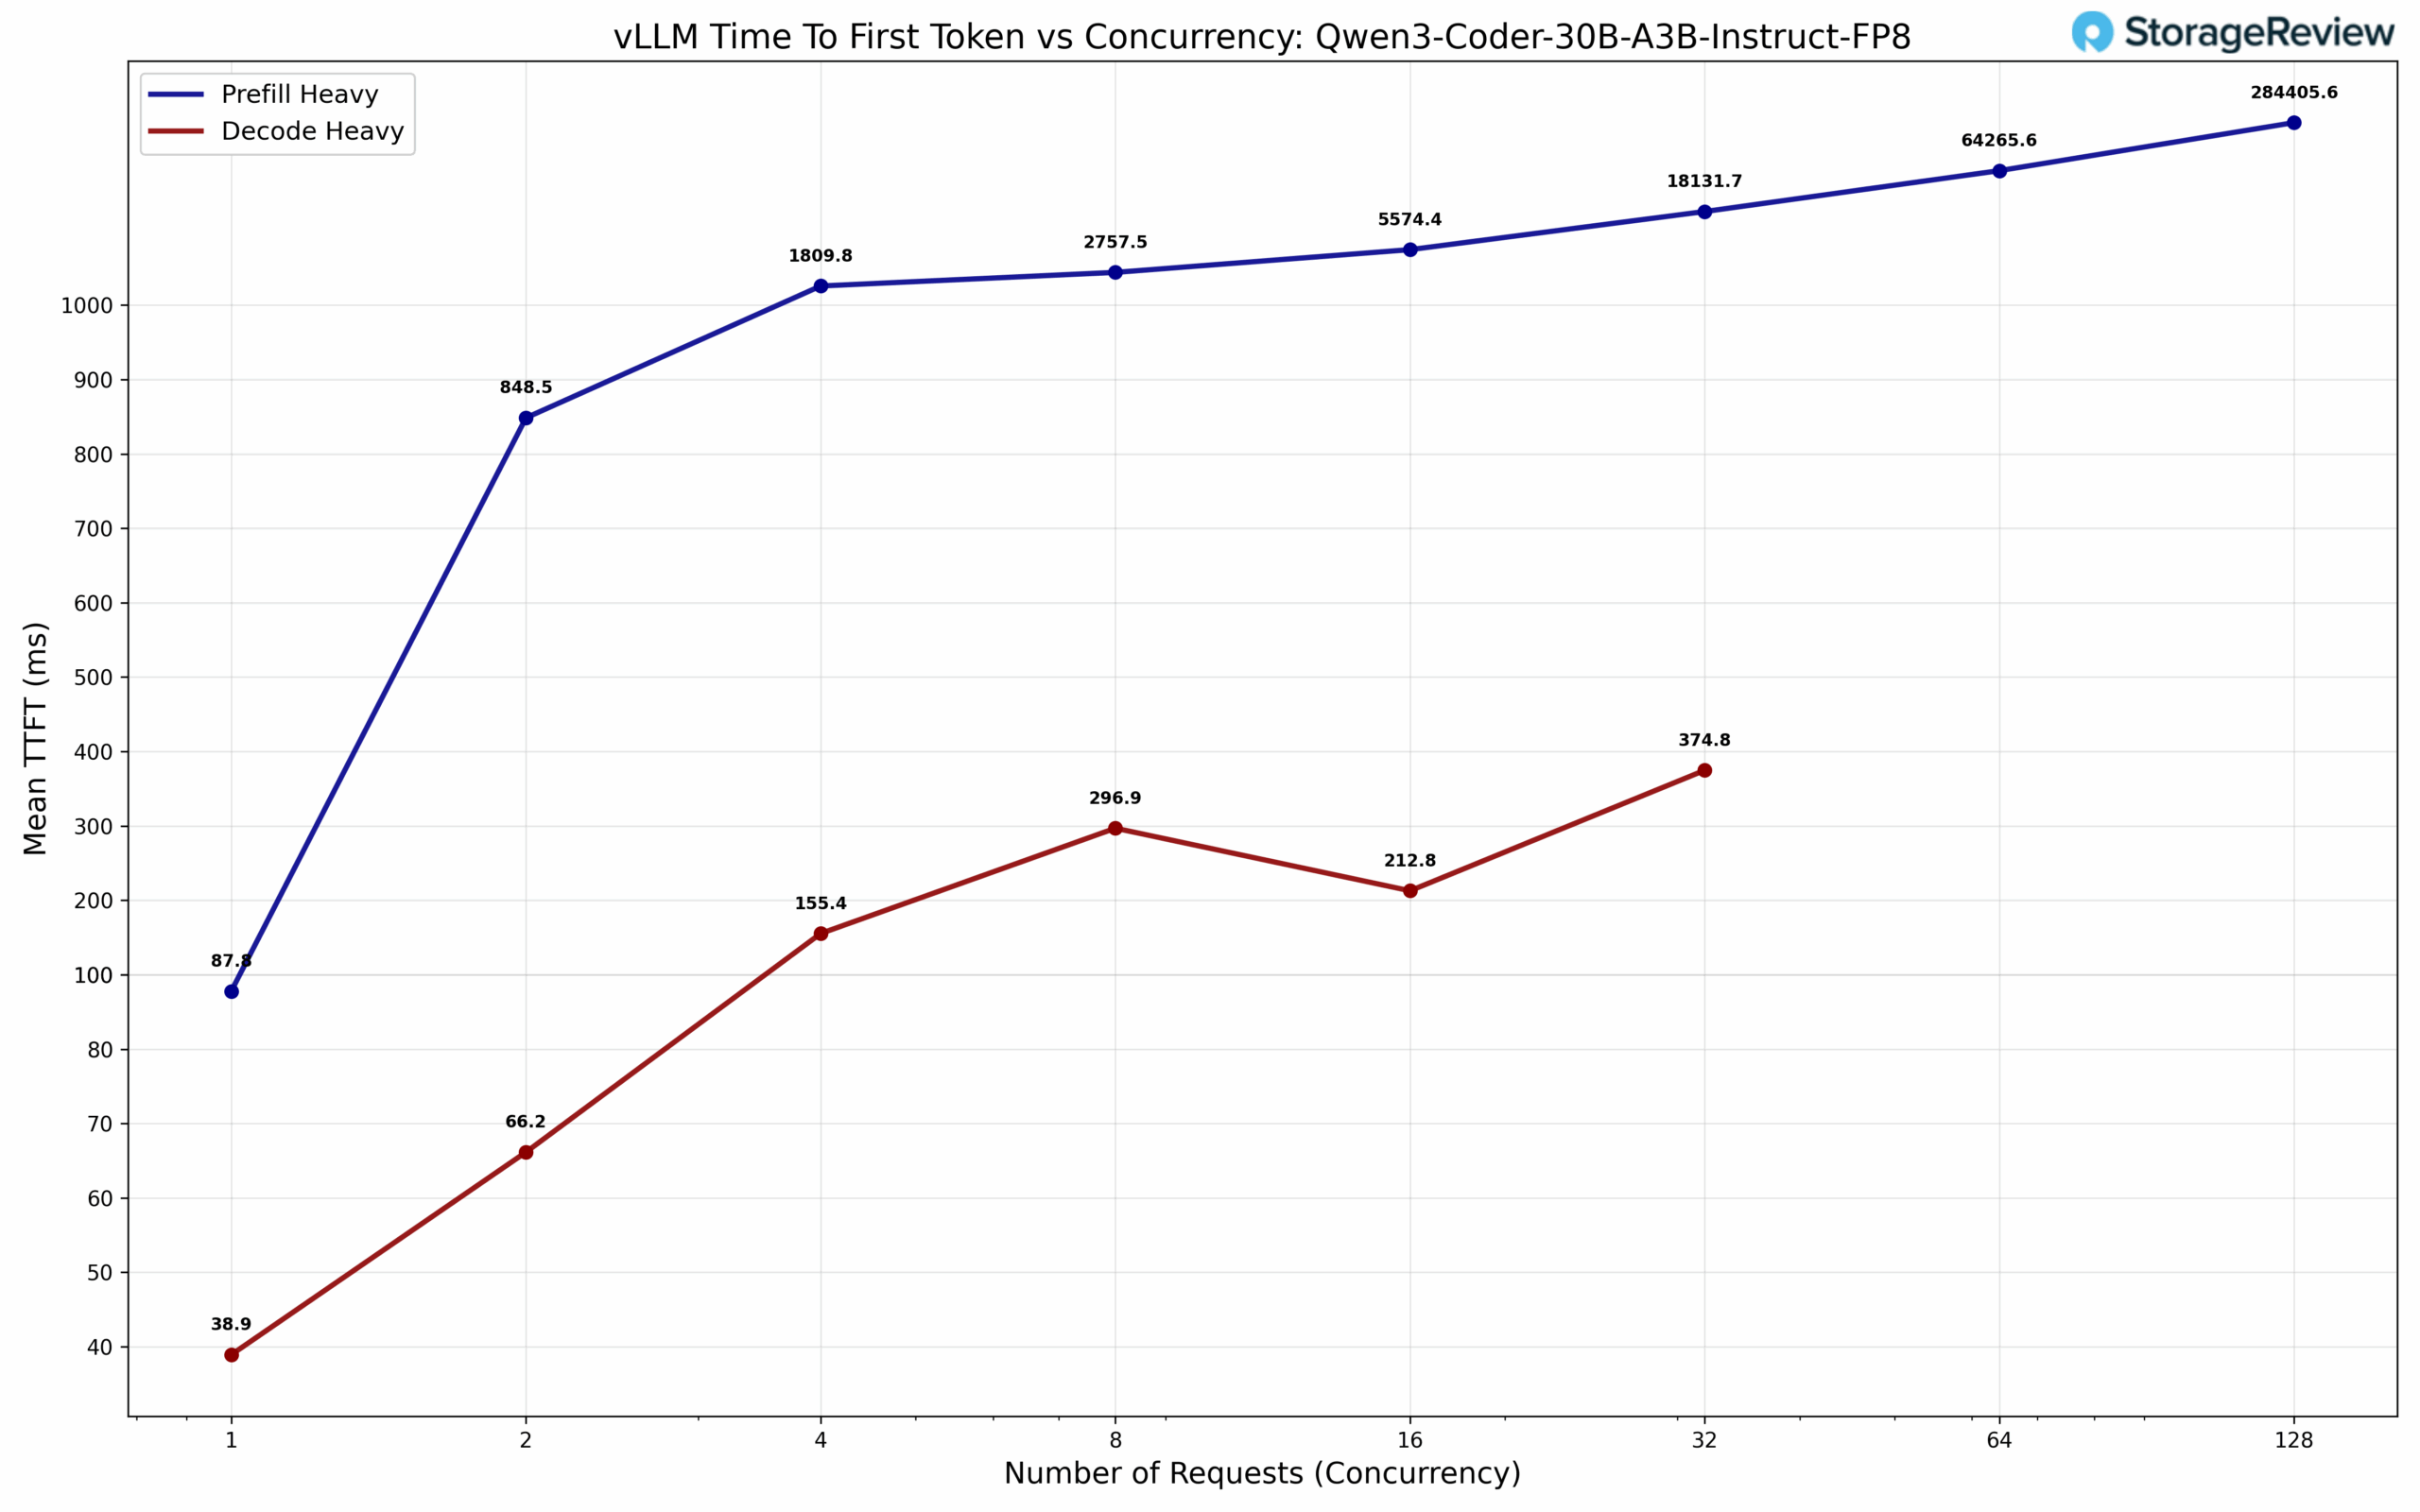
Precompila e decodifica l'inferenza pesante
L'inferenza LLM può essere fondamentalmente scomposta in due fasi computazionali distinte, ciascuna con caratteristiche prestazionali e modelli di utilizzo delle risorse notevolmente diversi. La fase di pre-riempimento elabora l'intero prompt di input in un'unica operazione parallela, elaborando simultaneamente i meccanismi di attenzione su tutti i token di input, un'operazione ad alta intensità di calcolo che satura completamente i core tensoriali e le unità computazionali. Al contrario, la fase di decodifica genera token di output in modo autoregressivo, producendo un token alla volta attraverso operazioni sequenziali che presentano un'intensità computazionale inferiore ma richiedono una notevole larghezza di banda di memoria, poiché il modello deve accedere ripetutamente ai pesi e alla crescente cache chiave-valore. Ciò crea profili di collo di bottiglia fondamentalmente diversi: le operazioni di pre-riempimento sono tipicamente vincolate al calcolo, mentre le operazioni di decodifica richiedono molta larghezza di banda di memoria, il che le rende particolarmente sensibili ai vincoli del sottosistema di memoria.
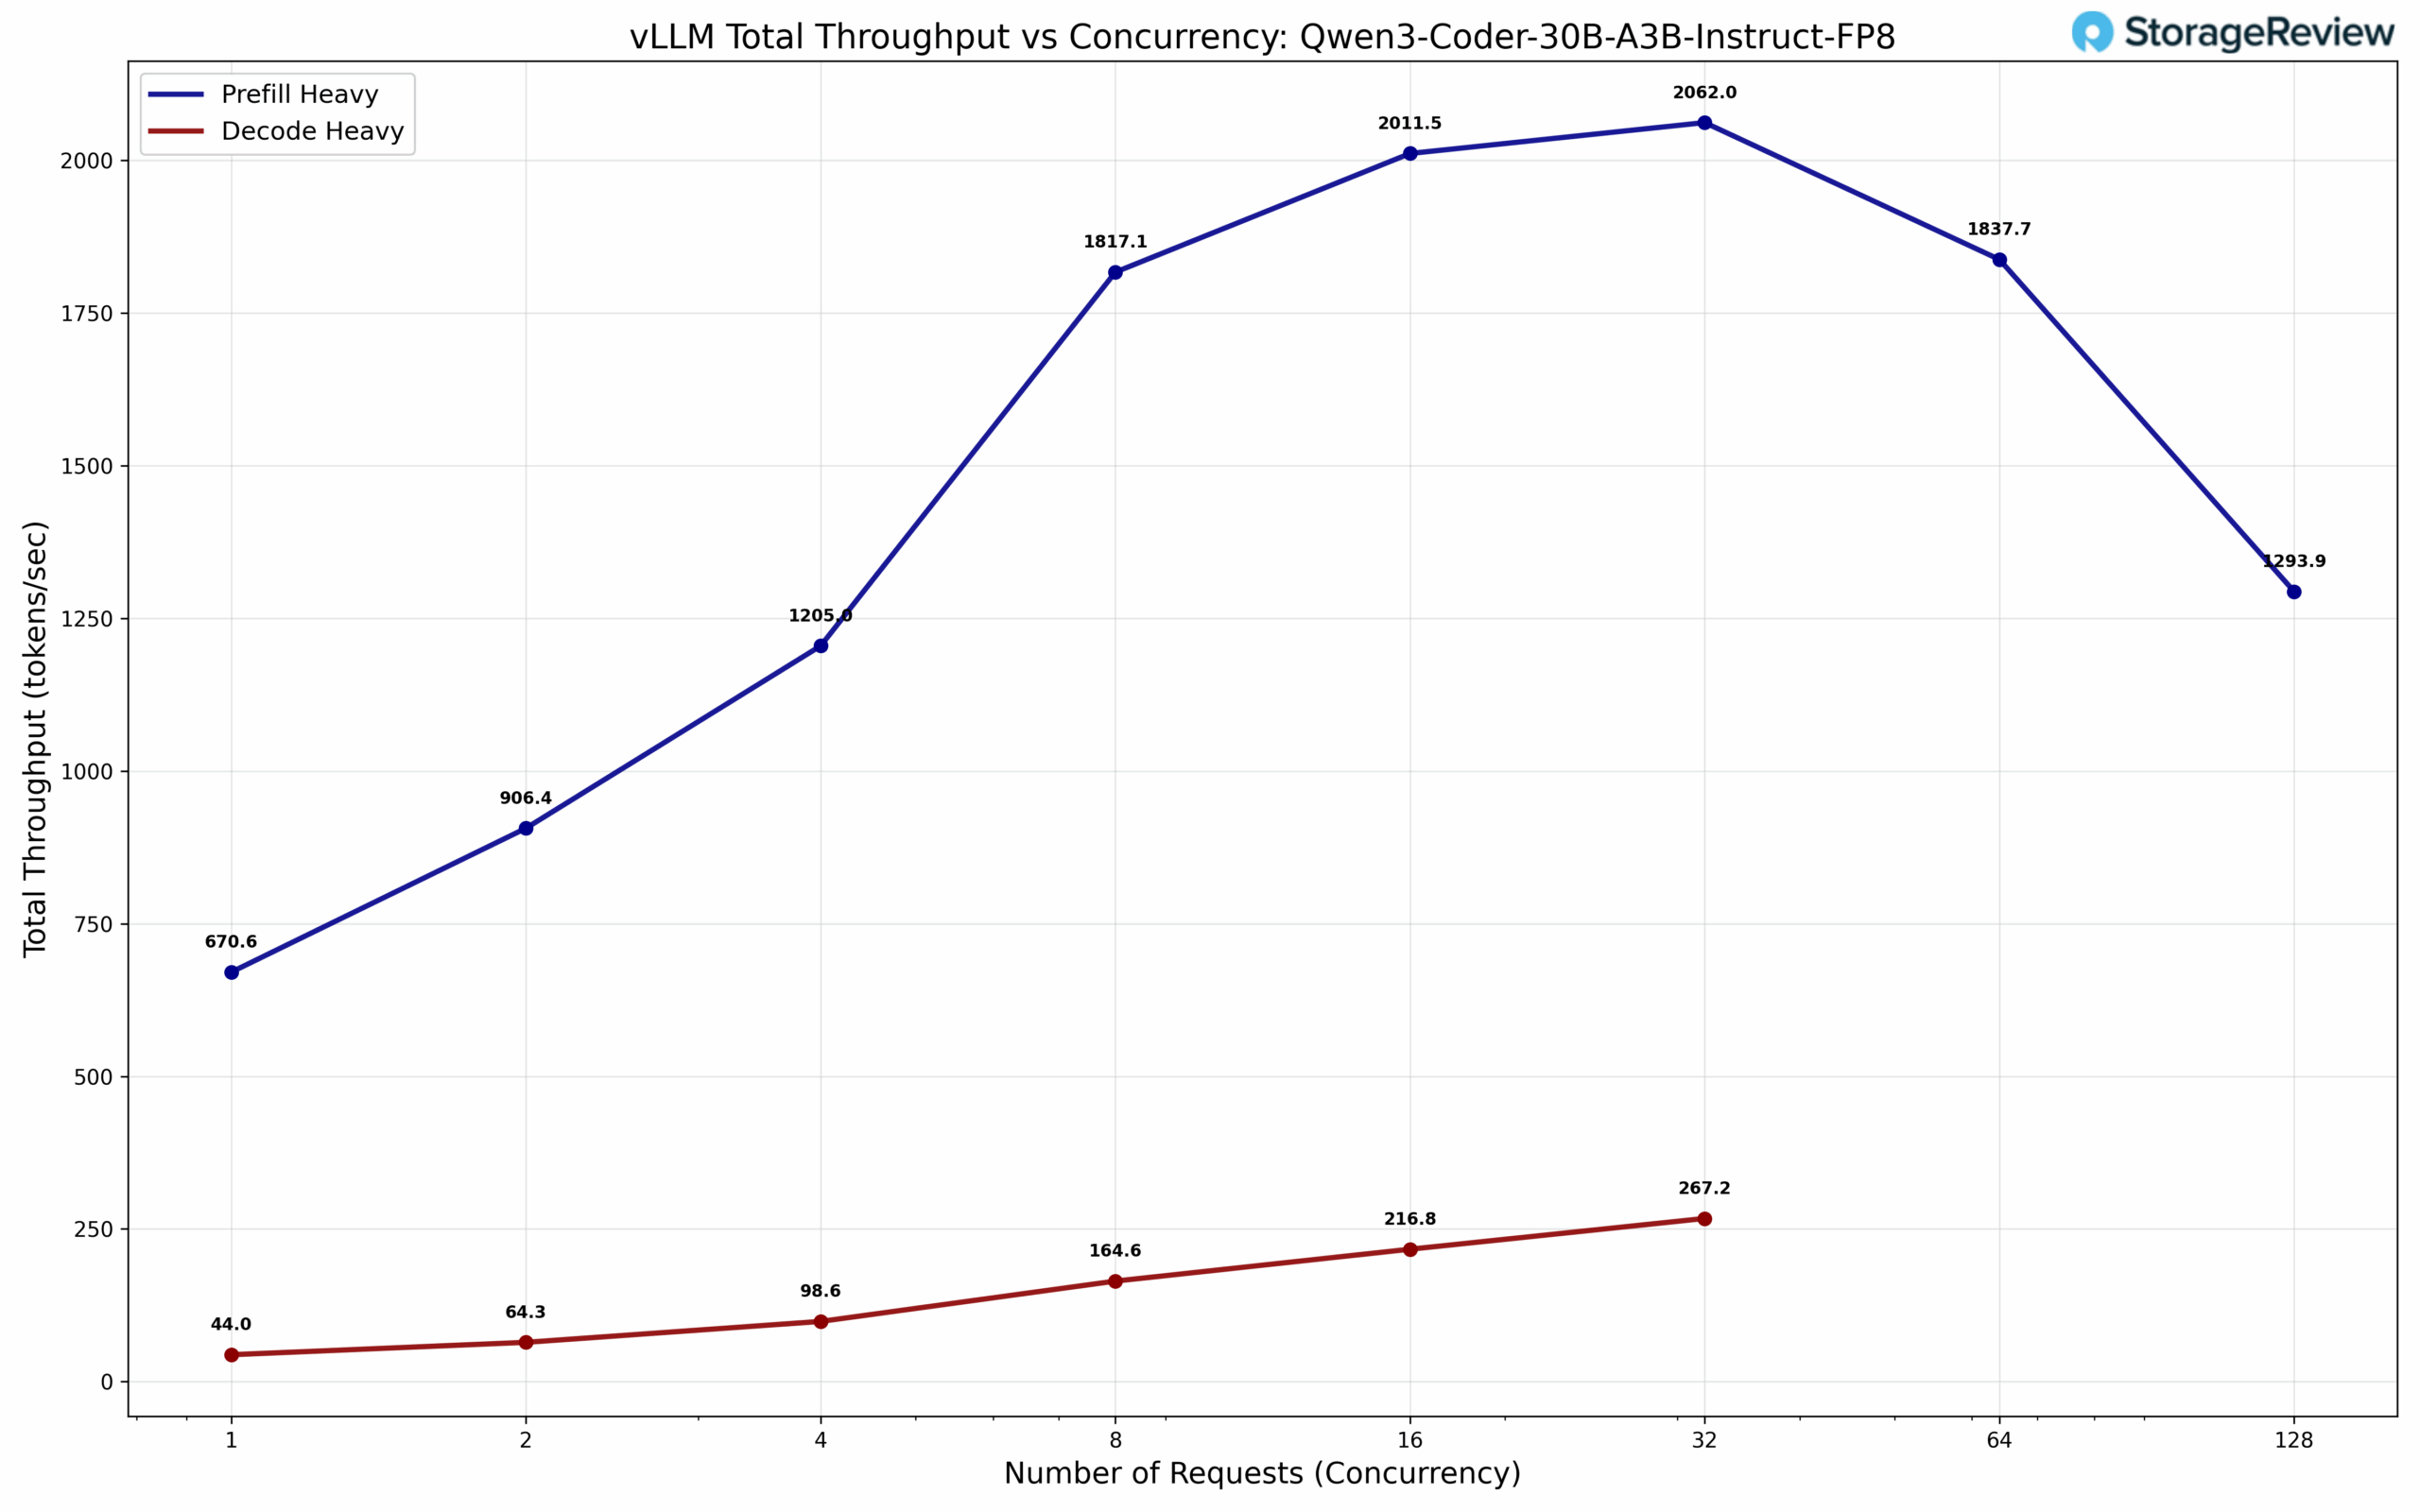
Abbiamo condotto test completi su due distinti profili di carico di lavoro: inferenza con elevata capacità di decodifica con 512 token di input e 8,192 token di output, e inferenza con elevata capacità di precompilazione con 8,192 token di input e 512 token di output. La caratterizzazione delle prestazioni rivela i compromessi architetturali previsti: Spark dimostra un throughput competitivo su carichi di lavoro con elevata capacità di precompilazione, in cui le risorse di elaborazione rimangono il principale collo di bottiglia, ma mostra prestazioni ridotte su scenari con elevata capacità di decodifica. Questa differenza di prestazioni è perfettamente in linea con i vincoli di larghezza di banda della memoria. La natura sequenziale delle operazioni di decodifica e i modelli di accesso intensivo alla memoria espongono direttamente i limiti di larghezza di banda insiti nell'architettura di Spark. Questi risultati forniscono un contesto fondamentale per l'interpretazione delle misurazioni MAMF nella prossima sezione, poiché entrambe le suite di benchmark identificano costantemente la larghezza di banda della memoria come il fattore fondamentale che limita le prestazioni nelle implementazioni di inferenza nel mondo reale.
Numero massimo di FLOPS Matmul raggiungibili (MAMF)
MAMF (Maximum Achievable Matmul FLOPS) è una metrica di prestazione pratica progettata per misurare il picco realistico di operazioni in virgola mobile al secondo che possono essere raggiunte sugli acceleratori di machine learning durante le operazioni di moltiplicazione di matrici, offrendo un benchmark più accurato rispetto al picco teorico di FLOPS spesso pubblicizzato nelle specifiche hardware. Stiamo utilizzando il benchmark mamf-finder di Stas Beckman.
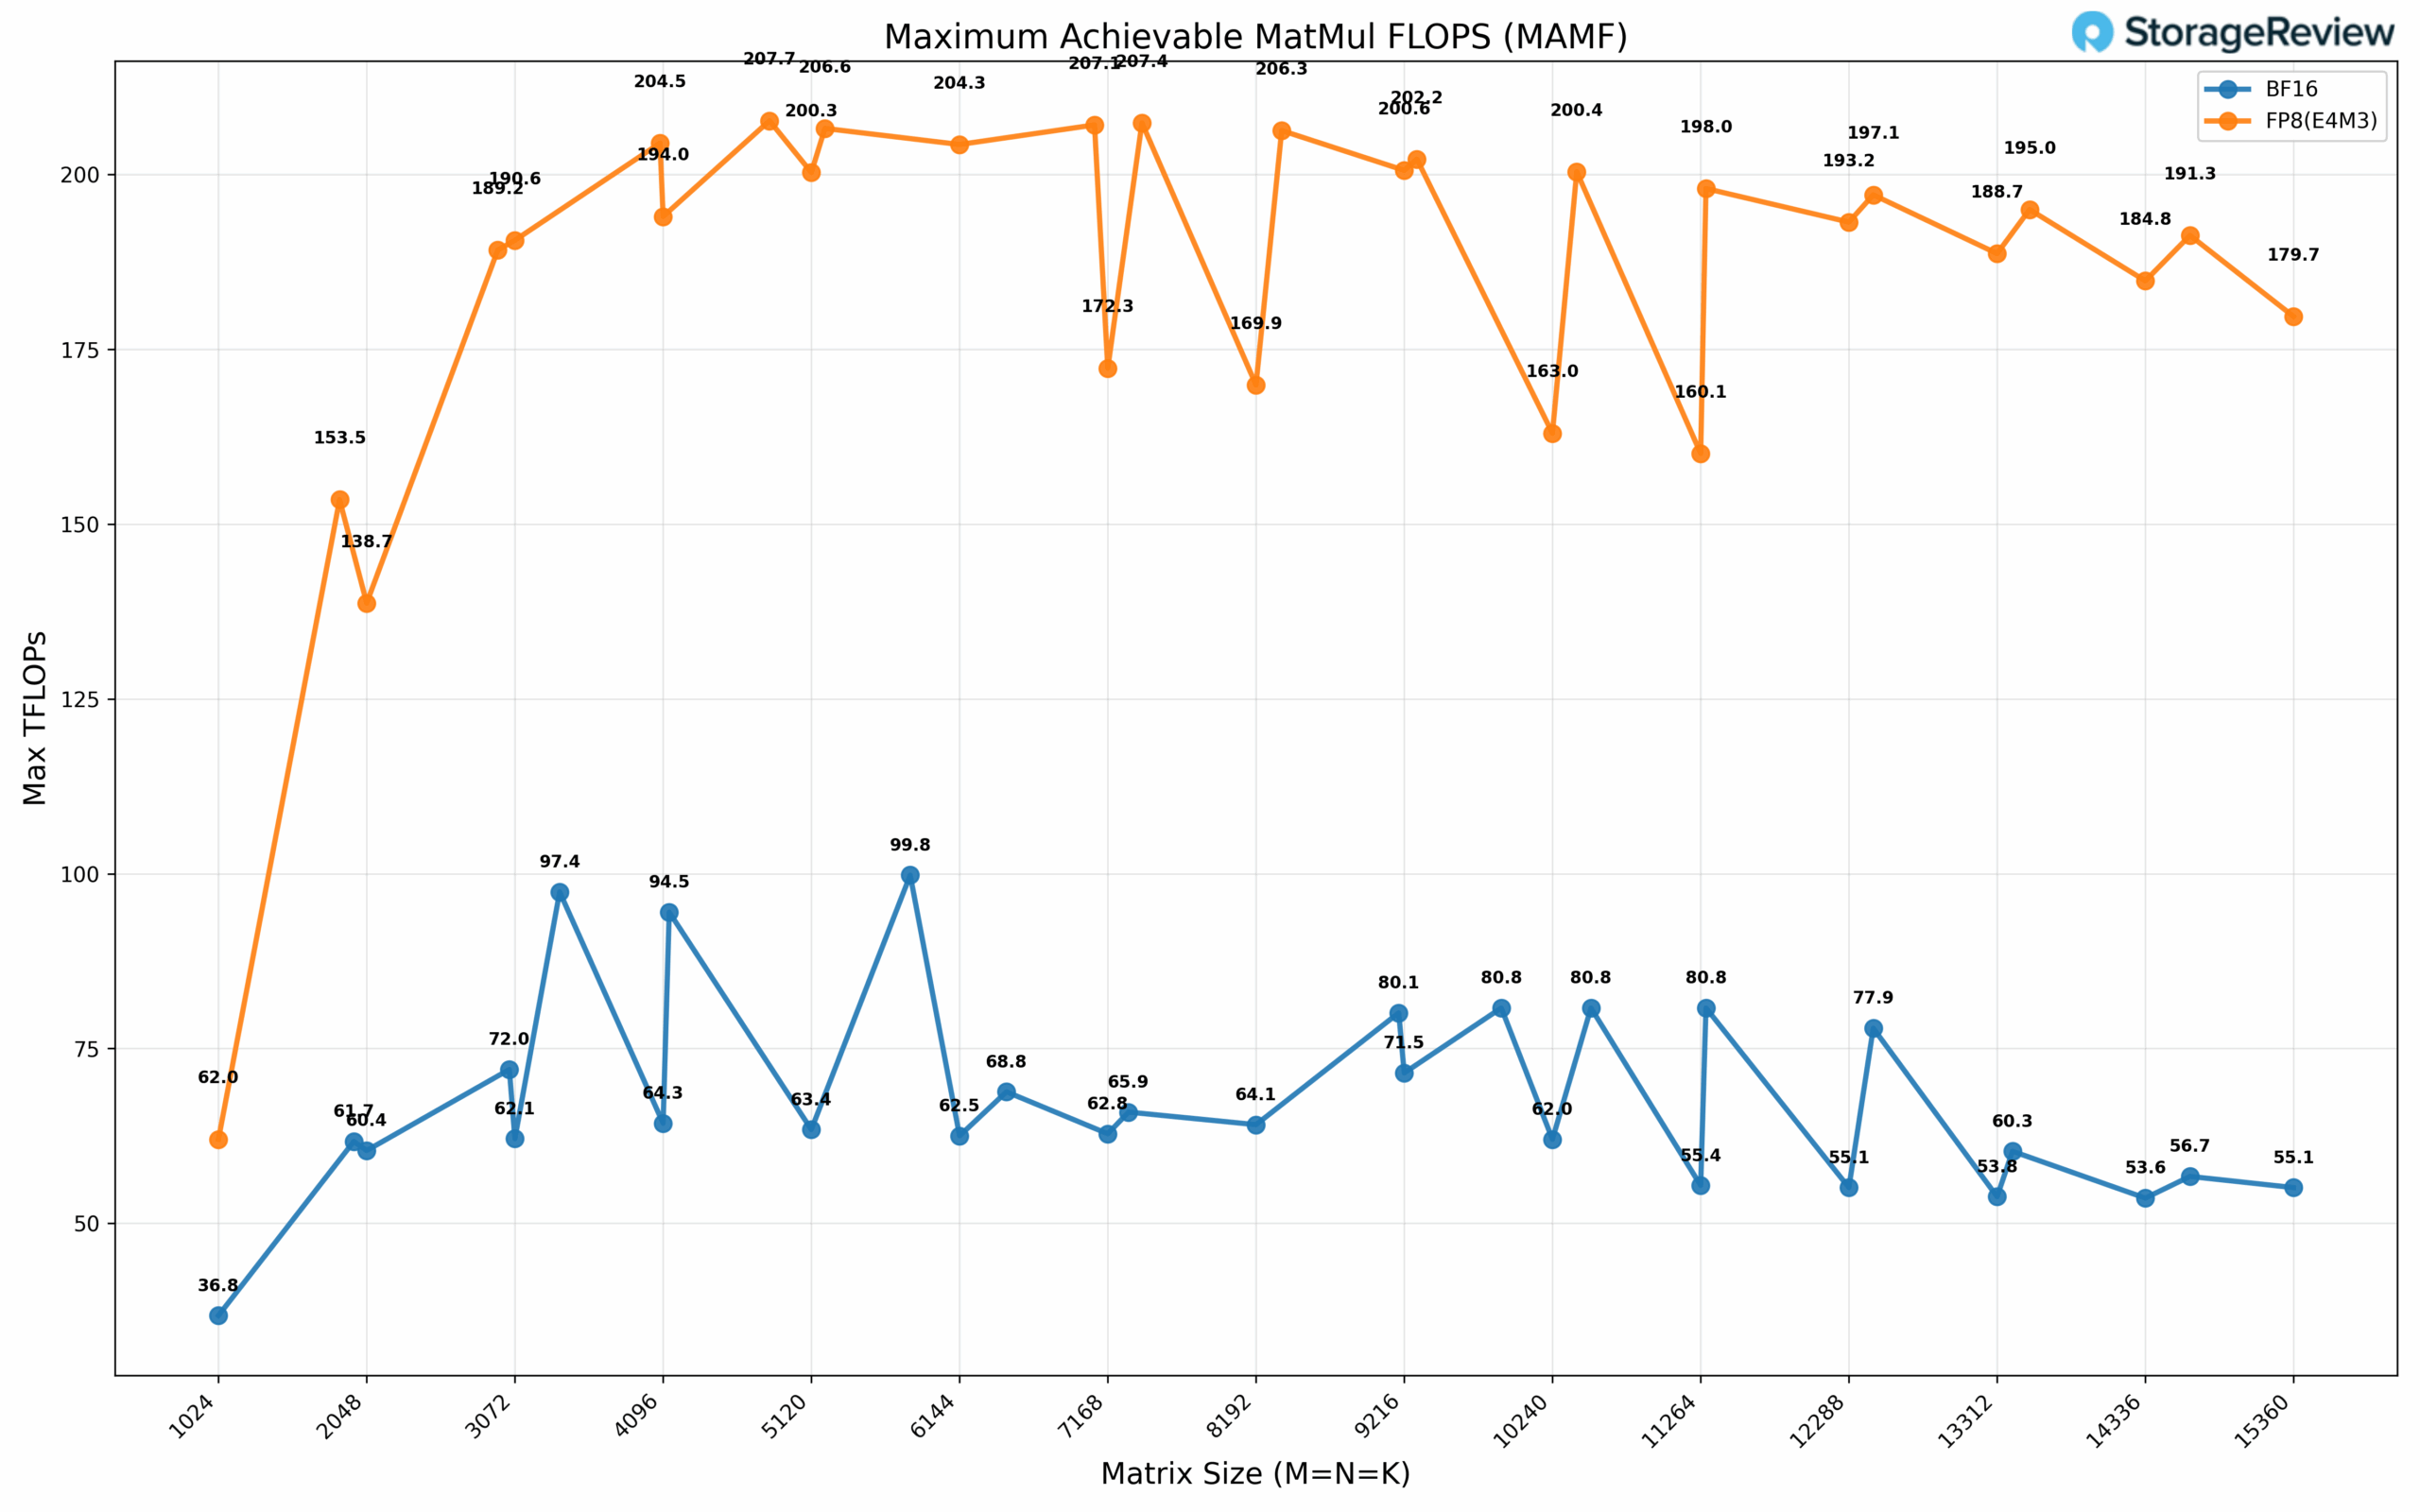
Con una precisione BF16, osserviamo una MAMF di 99.8 TFLOP, mentre FP8 (E4M3) dimostra una MAMF di 207.7 TFLOP. A causa di vincoli di tempo, non siamo stati in grado di condurre una caratterizzazione completa della MAMF di FP4; tuttavia, estrapolando dai modelli di scala basati sulla precisione osservati, prevediamo un ulteriore guadagno di prestazioni pari a 2x rispetto a FP8, con un rendimento di circa 400 TFLOP per operazioni FP4 dense. Considerando l'ottimizzazione della sparsità strutturata 2:1, questo si traduce in circa l'80% delle capacità prestazionali teoriche di FP4, raggiungendo circa 800 TFLOP con carichi di lavoro computazionali sparsi. È importante notare che queste misurazioni della MAMF potrebbero essere inferiori alle specifiche teoricamente pubblicizzate per molte ragioni che non approfondiremo in questa revisione.
Archiviazione diretta GPU
Uno dei test che abbiamo condotto sullo Spark è stato il test MagnumIO GPU Direct Storage (GDS). GDS è una funzionalità sviluppata da NVIDIA che consente alle GPU di bypassare la CPU quando accedono ai dati archiviati su unità NVMe o altri dispositivi di archiviazione ad alta velocità. Invece di instradare i dati attraverso la CPU e la memoria di sistema, GDS consente la comunicazione diretta tra la GPU e il dispositivo di archiviazione, riducendo significativamente la latenza e migliorando la velocità di trasmissione dei dati.
Come funziona l'archiviazione diretta GPU
Tradizionalmente, quando una GPU elabora dati archiviati su un'unità NVMe, i dati devono prima passare attraverso la CPU e la memoria di sistema prima di raggiungere la GPU. Questo processo introduce colli di bottiglia, poiché la CPU diventa un intermediario, aggiungendo latenza e consumando preziose risorse di sistema. GPU Direct Storage elimina questa inefficienza consentendo alla GPU di accedere ai dati direttamente dal dispositivo di archiviazione tramite il bus PCIe. Questo percorso diretto riduce il sovraccarico associato allo spostamento dei dati, consentendo trasferimenti di dati più rapidi ed efficienti.
I carichi di lavoro AI, in particolare quelli che coinvolgono il deep learning, sono altamente intensivi in termini di dati. L'addestramento di grandi reti neurali richiede l'elaborazione di terabyte di dati e qualsiasi ritardo nel trasferimento dei dati può portare a GPU sottoutilizzate e tempi di addestramento più lunghi. GPU Direct Storage affronta questa sfida assicurando che i dati vengano consegnati alla GPU il più rapidamente possibile, riducendo al minimo i tempi di inattività e massimizzando l'efficienza computazionale.
Inoltre, GDS è particolarmente utile per carichi di lavoro che comportano lo streaming di grandi set di dati, come l'elaborazione video, l'elaborazione del linguaggio naturale o l'inferenza in tempo reale. Riducendo la dipendenza dalla CPU, GDS accelera lo spostamento dei dati e libera risorse della CPU per altre attività, migliorando ulteriormente le prestazioni complessive del sistema.
GDSIO – M.2 interno da 4 TB
NVIDIA DGX Spark offre un'interessante scelta per l'archiviazione. Per questioni di dimensioni all'interno del case compatto, NVIDIA ha optato per il meno comune SSD Gen5 2242 M.2. Per i lettori che non hanno familiarità con questo tipo di SSD, si tratta di una versione più corta da 42 mm rispetto agli 80 mm, più comuni nel settore desktop. La scelta di unità è minore, con 4 TB come capacità massima per questo formato. Il problema principale, tuttavia, sono le prestazioni. Gli SSD di piccole dimensioni, come i modelli 2242 e 2230, privilegiano le dimensioni, lasciando la velocità dell'unità in secondo piano. Sono comuni nelle console di gioco portatili, nei tablet e in alcuni notebook.
Lo spazio disponibile sul PCB degli SSD 2230 e 2242 è ridotto, con conseguente riduzione dello spazio per controller, DRAM e package NAND. Abbiamo osservato alcuni di questi compromessi durante i nostri test. Applicando il nostro carico di lavoro GDSIO in un footprint da 1 TB o 128 GB, l'SSD si bloccava e richiedeva una nuova immagine dello Spark. Riducendo il footprint di test a 64 GB e riducendo il numero di thread più elevato, abbiamo aggirato questo problema. Questi problemi generalmente non si presentano con i più comuni SSD da 80 mm ad alte prestazioni.
Esaminando le prestazioni di lettura sequenziale dell'unità interna, notiamo la massima produttività con blocchi da 1 M con 16 thread, raggiungendo 11.4 GiB/s.
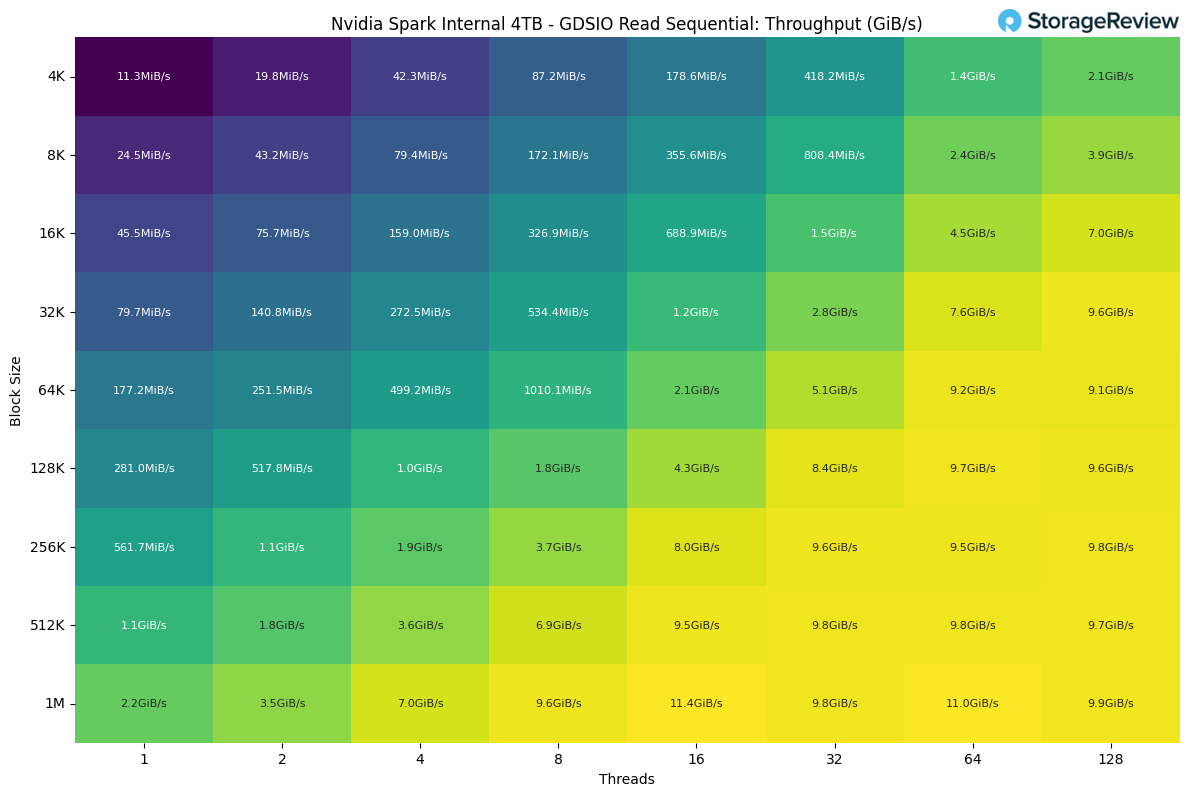
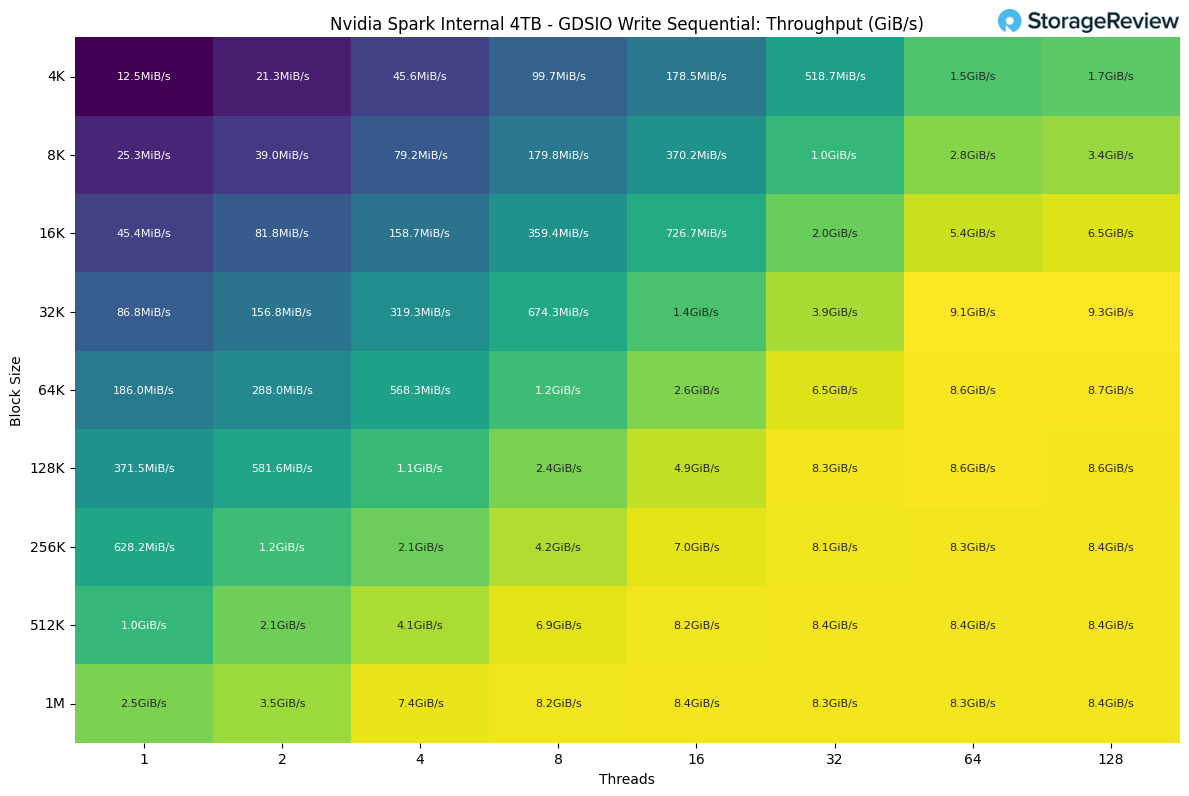
Per quanto riguarda le prestazioni in scrittura sequenziale, l'unità raggiunge il throughput più elevato con blocchi da 32k e 128 thread. Con blocchi di dimensioni maggiori, le prestazioni sembrano stabilizzarsi, attestandosi in media intorno a 8.3 GiB/s.
Per gli acquirenti che desiderano acquistare NVIDIA DGX Spark per lavori di sviluppo più impegnativi, in particolare per le aziende che potrebbero crearne piccoli cluster, consigliamo vivamente di sfruttare la scheda di rete NVIDIA ConnectX-7 da 200 Gb integrata.
GDSIO – NVMe-oF su RDMA
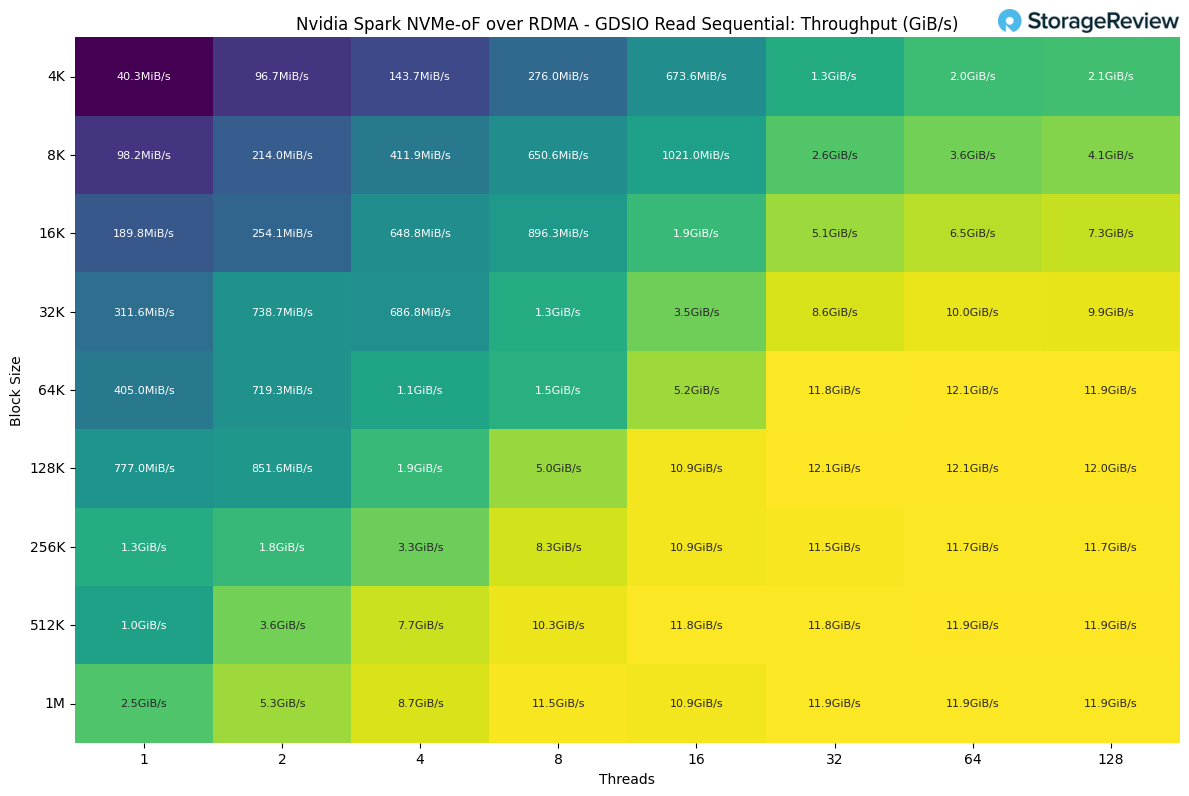
Per i test NVMe-oF RDMA con NVIDIA DGX Spark, abbiamo utilizzato il software PEAK:AIO per creare un target NVMe-oF su un Dell PowerEdge R770 con sei SSD Micron 9550 da 3.84 TB e connessione RDMA. Come accennato in precedenza, la scheda di rete CX7 dello Spark presenta delle peculiarità e, a causa di vincoli di tempo, siamo riusciti a testare lo Spark solo con connettività 100G. Sia lo Spark che PEAK:AIO possono raggiungere valori significativamente più elevati. Condurremo ulteriori test di storage e rete con lo Spark in articoli successivi.
Esaminando le prestazioni di lettura sequenziale dell'unità interna, notiamo la massima produttività con blocchi da 128 kB con 32 thread, raggiungendo 12.1 GiB/s.
Per quanto riguarda le prestazioni in scrittura sequenziale, l'unità raggiunge il throughput più elevato con blocchi da 128k e 16 thread. Con blocchi di dimensioni maggiori, le prestazioni sembrano stabilizzarsi, attestandosi in media intorno a 11.3 GiB/s.
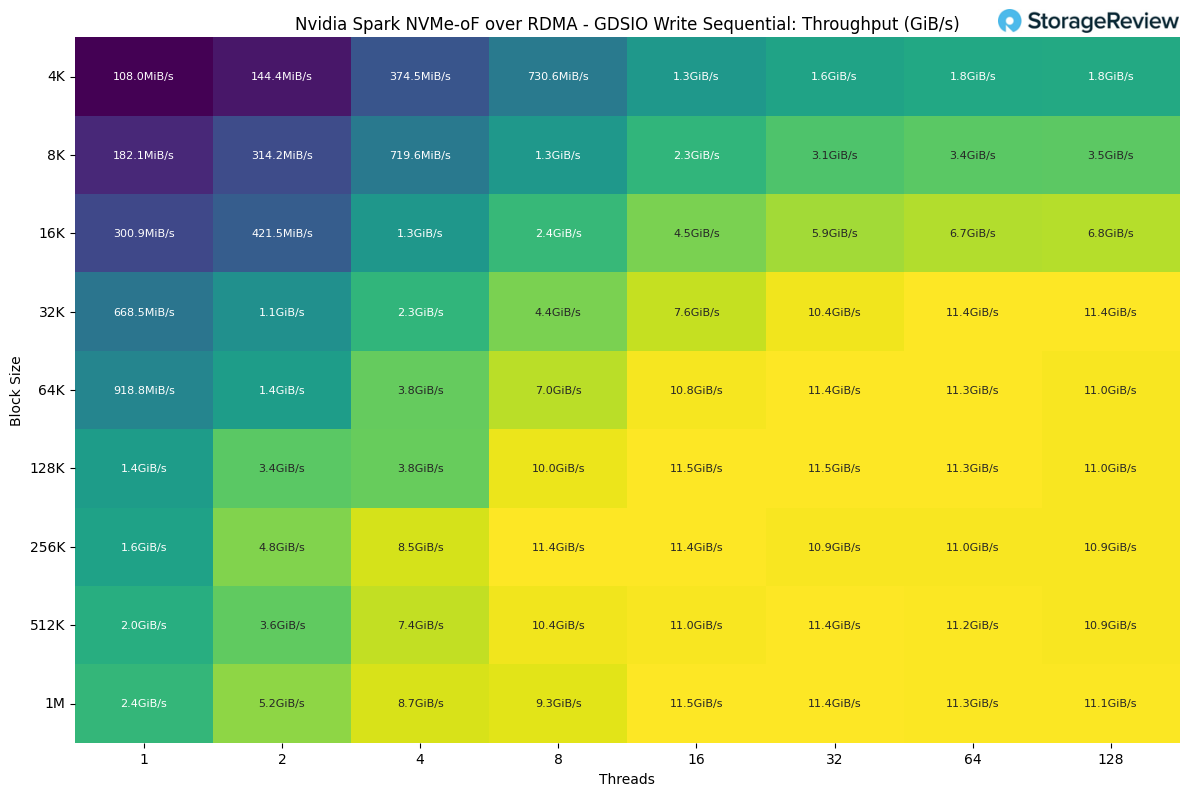
Questi risultati presentano molte sfumature: stiamo osservando solo la metà del massimo teorico a causa delle suddette ragioni legate al tempo e alla rete. Inoltre, la massima produttività con blocchi da 128k è influenzata da molteplici fattori, come le unità aziendali utilizzate o il modo in cui PEAK:AIO gestisce questo IO. Il risultato potrebbe variare e intendiamo approfondire i test con Spark in futuro.
Ecosistema software Day-One
NVIDIA e altri fornitori hanno investito in modo sostanziale nella preparazione del software, un netto cambiamento rispetto ai tipici lanci hardware in cui i primi utilizzatori si trovano a dover gestire documentazione incompleta e strumenti mancanti. Spark viene lanciato con playbook completi che coprono i flussi di lavoro più comuni: ComfyUI per i modelli di diffusione, TRT-LLM per l'inferenza ottimizzata, Ollama con Open WebUI per il servizio di modelli locali, Unsloth per il fine-tuning e architetture multi-agente con LangGraph.
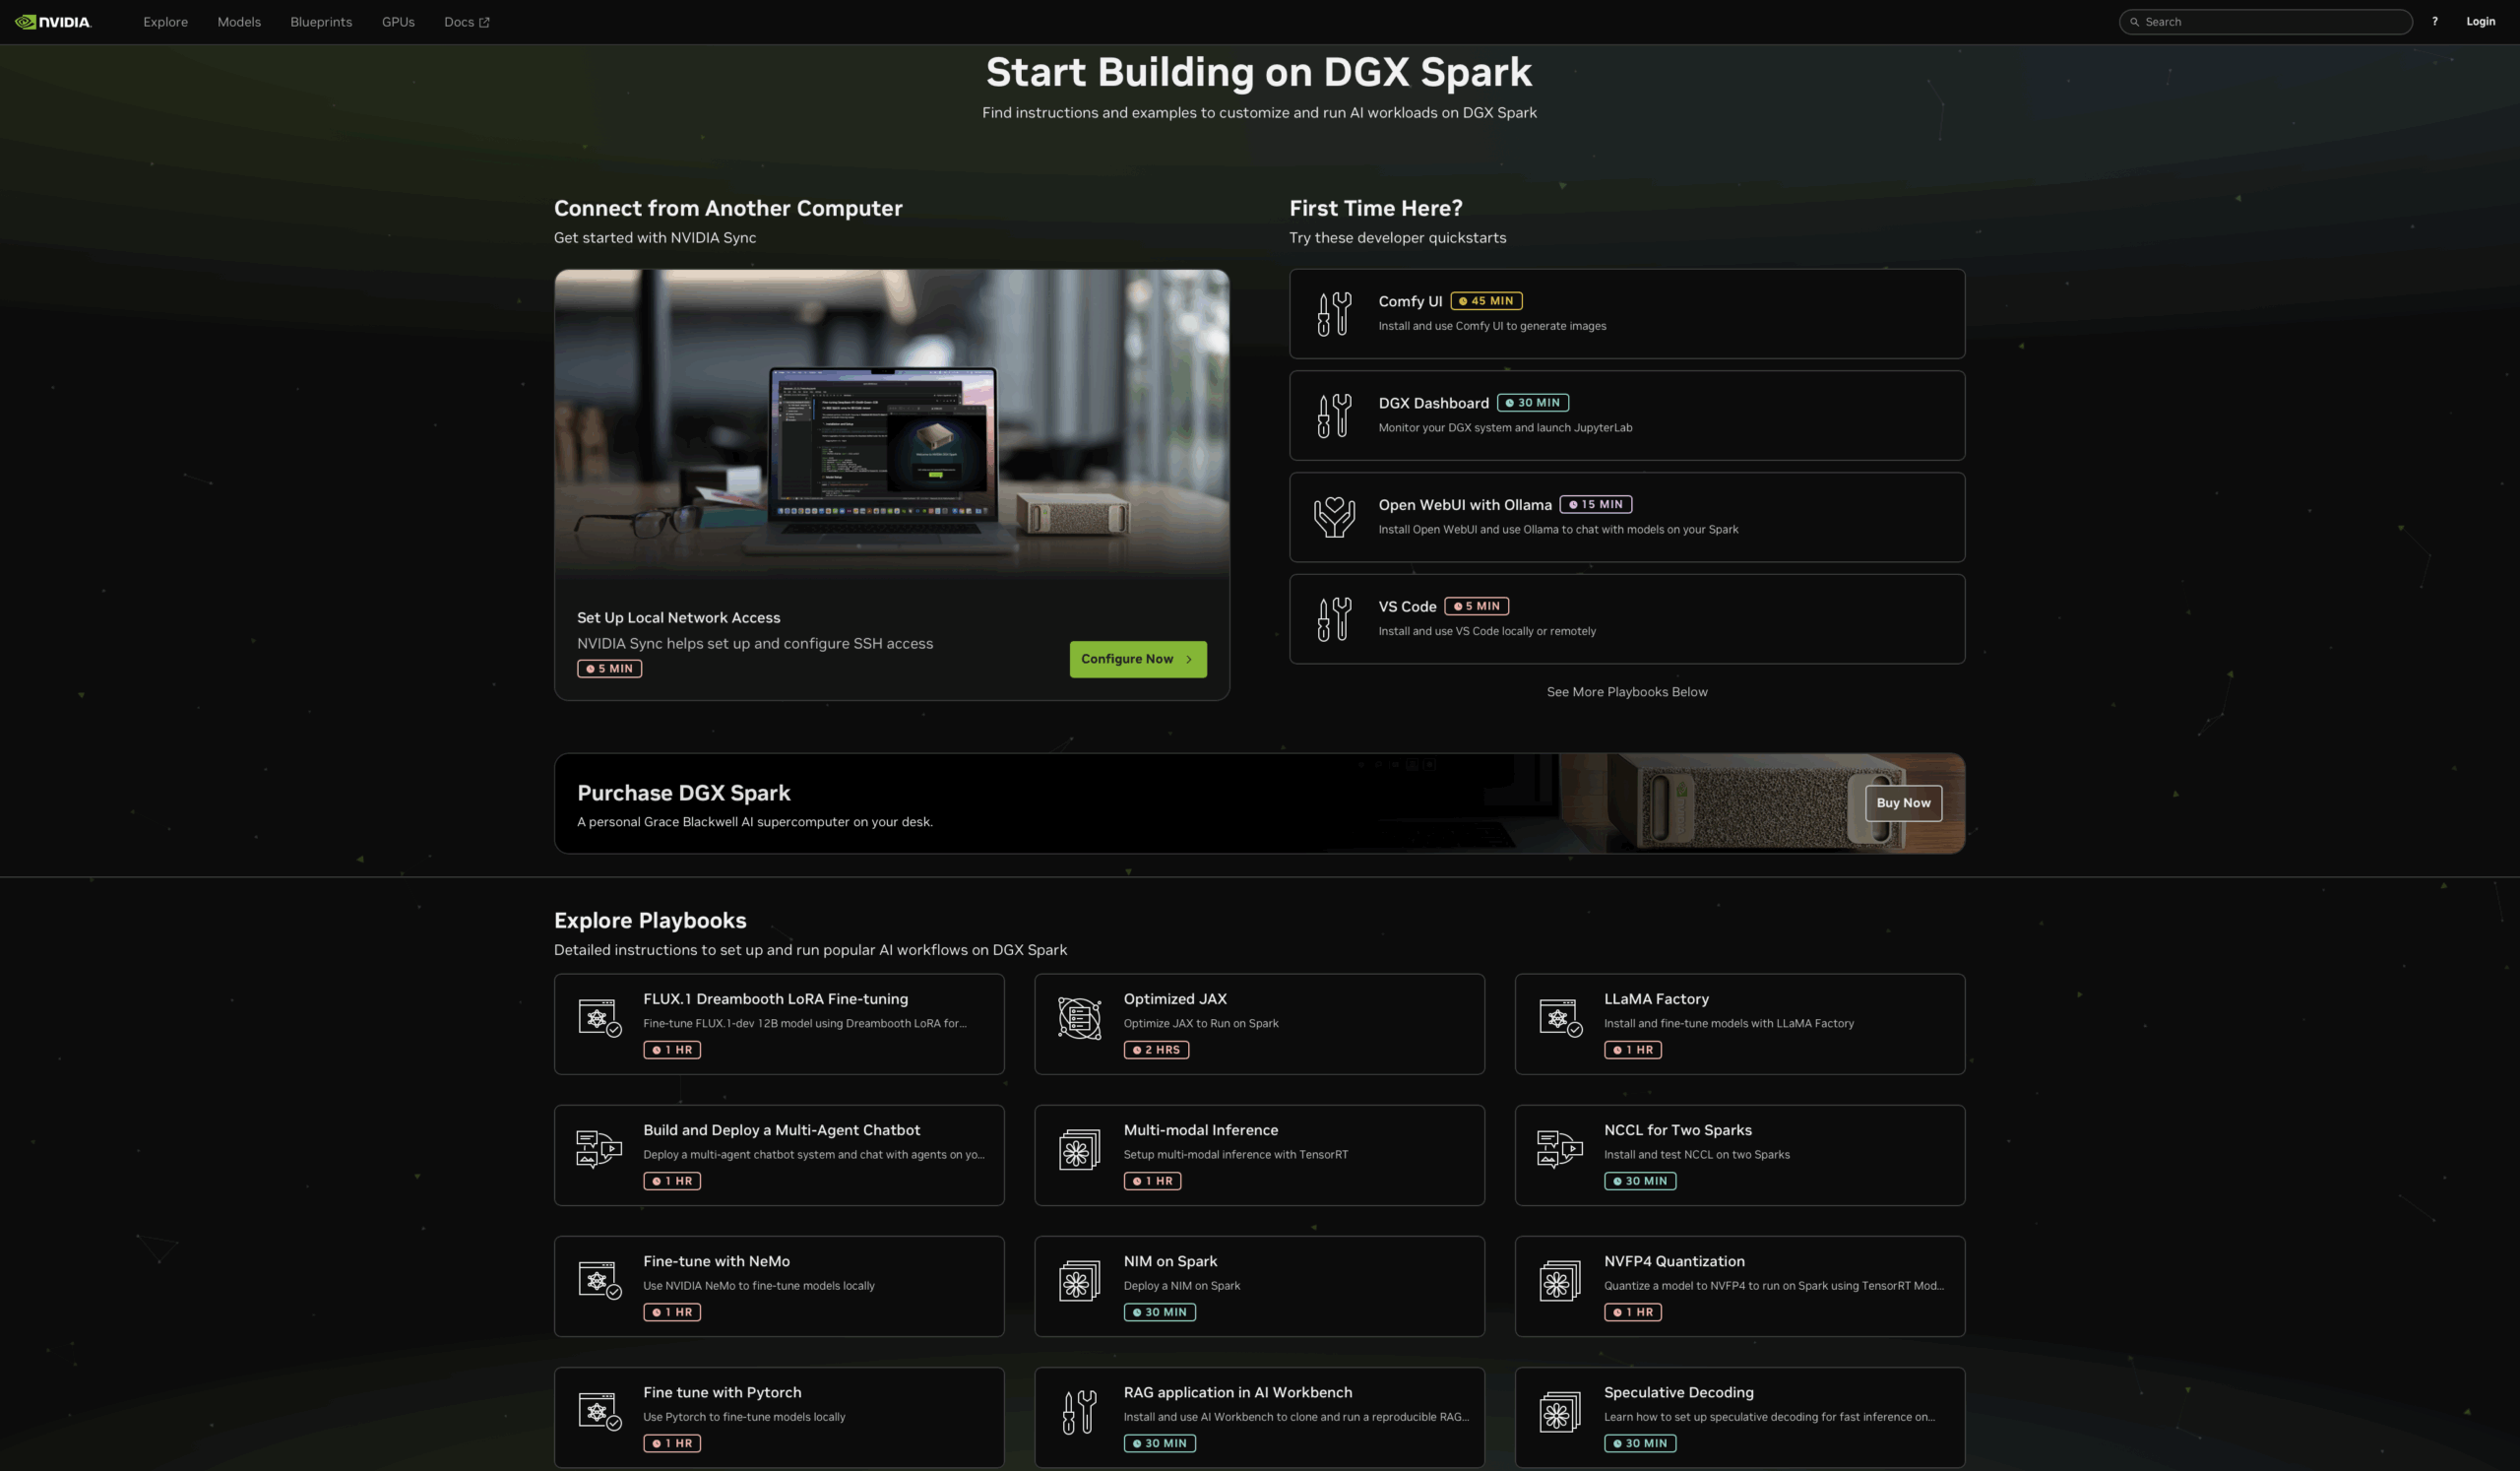
Questa maturità del software trasforma l'esperienza di valutazione. Invece di impiegare giorni a configurare gli ambienti, gli sviluppatori possono valutare immediatamente se Spark soddisfa i loro requisiti eseguendo carichi di lavoro rappresentativi. I playbook forniscono non solo istruzioni, ma anche ambienti containerizzati, set di dati di esempio e metriche di prestazioni previste.
Disponibilità e sistemi OEM
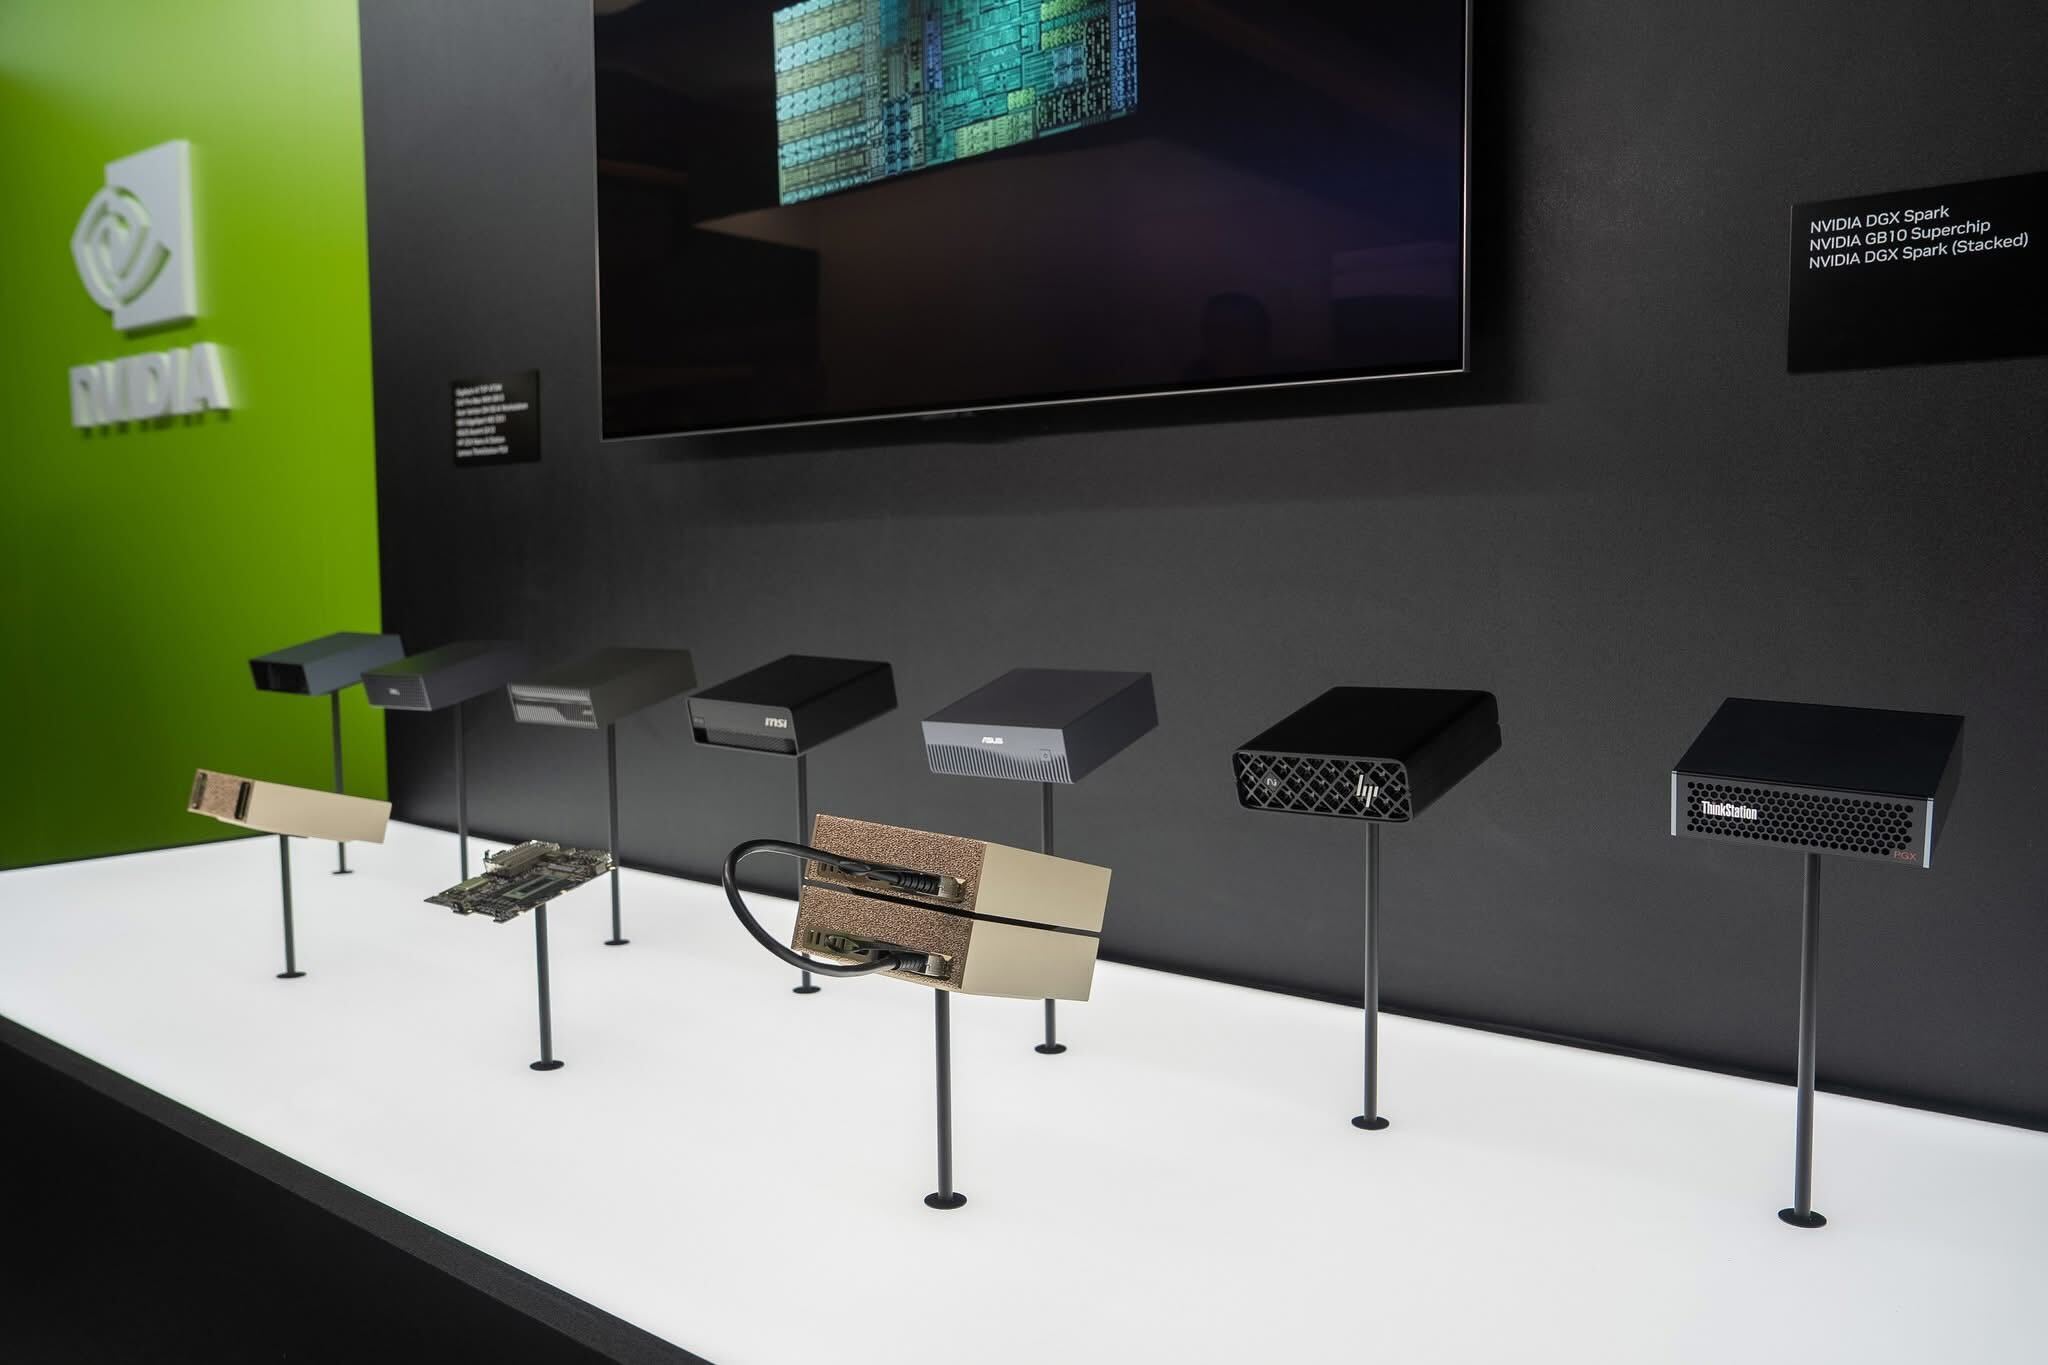
La Founders Edition di NVIDIA è disponibile per l'ordine a 3,999 dollari per la configurazione da 4 TB e la disponibilità generale inizierà il 15 ottobre. Oltre all'unità di NVIDIA, diversi desktop GB10 arriveranno dai principali OEM. L'hardware di base sarà piuttosto simile per tutti gli OEM, ma potrebbe esserci un piccolo margine di manovra per differenziarsi, anche se la maggior parte della variazione di prezzo deriverà probabilmente dalla scelta dello storage. Abbiamo già visto molti annunci, tra cui Dell Pro Max con GB10, Lenovo ThinkStation PGX, Acer Veriton GN100 e ASUS Ascent GX10.
Fonte: Nvidia
Conclusione
NVIDIA DGX Spark rappresenta un punto di svolta fondamentale nel paradigma di accessibilità delle infrastrutture di elaborazione AI avanzate. Consolidando le capacità del GB10 Grace Blackwell Superchip: 128 GB di memoria unificata, prestazioni sparse FP4 da 1 petaFLOP, RT Core di quarta generazione e rete ConnectX-7 in un'appliance da 240 W e 1.13 litri al prezzo di 3,999 dollari, NVIDIA ha di fatto abbattuto le barriere che storicamente separavano le capacità di AI di classe data center da quelle di singoli ricercatori e piccoli team di sviluppo.
L'approccio basato su appliance convalidate affronta un punto di attrito persistente nell'implementazione dell'infrastruttura di intelligenza artificiale: il sovraccarico operativo dovuto al mantenimento di configurazioni personalizzate. Le organizzazioni che implementano unità Spark beneficiano dei test e della convalida completi di NVIDIA dell'intero stack, inclusi DGX OS, toolkit CUDA, framework container e firmware hardware, eliminando così il debito di configurazione che affligge le build di workstation personalizzate. La gestione integrata degli aggiornamenti, il monitoraggio del sistema e il provisioning di JupyterLab della DGX Dashboard riducono ulteriormente l'onere operativo, mentre la distribuzione automatica delle chiavi SSH e la gestione dei tunnel di NVIDIA Sync rendono l'accesso remoto davvero fluido. Per le organizzazioni in crescita, questo si traduce in un onboarding sensibilmente più rapido: i nuovi ricercatori ricevono hardware standardizzato, si collegano all'infrastruttura esistente tramite la configurazione di clustering a due nodi convalidata e iniziano a lavorare in modo produttivo entro poche ore, anziché giorni, dalla risoluzione dei conflitti di driver o dalla configurazione del fabric di rete.
DGX Spark offre già una reale potenza di intelligenza artificiale in un'appliance compatta e silenziosa, e i nostri primi risultati dimostrano perché è importante per i team che desiderano funzionalità di alto livello senza sovraccarichi per il data center. La storia è solo all'inizio. Prevediamo di espandere i nostri test con il fabric da 200G, i target NVMe-oF e il clustering multi-nodo per esplorare l'efficienza di scalabilità, modelli di dimensioni maggiori e architetture di storage condivise. Con la maturazione del software e dell'ecosistema dei partner, prevediamo che le distribuzioni Spark si evolveranno da potenti configurazioni a nodo singolo a mini cluster altamente integrati e ad alta produttività, che miglioreranno ulteriormente questa piattaforma.
Classifica: NVIDIA DGX Spark si aggiudica il primo posto nella nostra classifica dei migliori desktop per l'intelligenza artificiale locale.
Classifica: Le indicazioni per il dimensionamento di questo tipo di sistema sono disponibili nella nostra guida su RAM, GPU e archiviazione per Agentic AI.


 Amazon