

La workstation HP Z2 Mini G1a segna un importante passo avanti nell'elaborazione compatta e altamente personalizzabile. Progettata per i professionisti in settori come la modellazione 3D, lo sviluppo di intelligenza artificiale e la creazione di contenuti digitali, questa potente workstation combina portabilità e precisione. Il cuore di questa workstation è il processore AMD Ryzen AI Max PRO Series, che offre prestazioni accelerate per multitasking, rendering e LLM locali.
Il cuore del sistema è il Ryzen AI MAX+ Pro 395 di AMD, un processore all'avanguardia presentato all'inizio del 2025. La velocità di clock della CPU aumenta fino a 5.1 GHz e dispone di 16 core, offrendo prestazioni di elaborazione elevate. È inoltre abbinato alla grafica integrata AMD Radeon 8060S. Inoltre, come molti prodotti di intelligenza artificiale, l'unità di elaborazione neurale inclusa fornisce ulteriori 50 TOPS per carichi di lavoro di intelligenza artificiale impegnativi. La sua grafica integrata Radeon 8060S lo rende un concorrente ideale per i carichi di lavoro ad alta intensità di GPU, poiché gli utenti possono allocarvi fino a 96 GB di VRAM. Questo gli conferisce un vantaggio unico per i carichi di lavoro di inferenza LLM locale, nonché per il rendering e la creazione di contenuti.
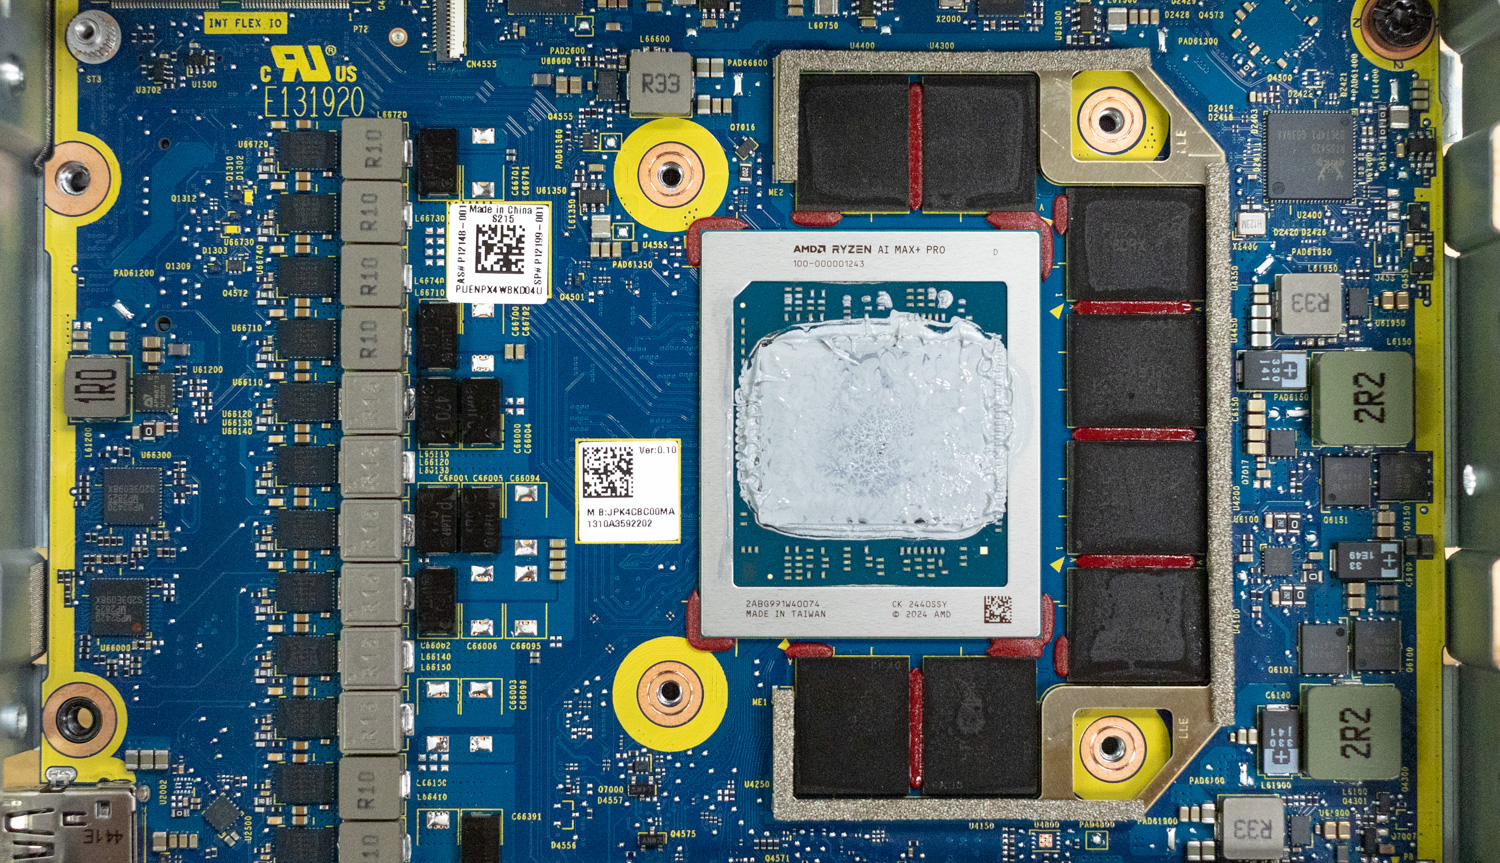
Quando gli utenti configurano l'HP Z2 Mini G1a, questo sistema scala in modo diverso rispetto ad altri sistemi. CPU e GPU scalano insieme. Ad esempio, la configurazione base include un AMD Ryzen AI Max Pro 380 con grafica Radeon 8040S e 32 GB di memoria condivisa. Quando si aumenta la memoria, ad esempio passando a 128 GB, anche la CPU e la GPU cambiano. Questa modifica passa al Ryzen AI Max+ Pro 395 con grafica Radeon 8060S, con 128 GB di memoria condivisa.
Il sistema oggetto di questa recensione è lo Z2 Mini G1a con chipset Ryzen AI Max+ Pro 395, che offre una CPU a 16 core abbinata alla scheda grafica Radeon 8060S, entrambe con 128 GB di RAM DDR5. Sebbene il nostro sistema sia dotato di due SSD da 1 TB e abbia un prezzo di listino di 4,781 dollari, il suo prezzo effettivo sul mercato è molto inferiore. Il prezzo era stato un punto critico per l' HP ZBook Ultra G1a che abbiamo recensito all'inizio di quest'anno, ma fortunatamente, prezzo e prestazioni sono notevolmente migliorati. Attualmente, B&H vende lo Z2 Mini G1a top di gamma con SSD da 2 TB a soli 3,342.65 dollari.
HP ZCentral Remote Boost
Una delle funzionalità più interessanti offerte da HP nelle sue linee di workstation professionali è HP ZCentral Remote Boost. HP ZCentral Remote Boost è il software di connessione remota dell'azienda (precedentemente noto come HP Remote Graphics Software o RGS). È stato progettato per l'utilizzo con workstation fisiche anziché con macchine virtuali (VM). In sostanza, Remote Boost connette un dispositivo endpoint a una workstation Z in ufficio o a casa, consentendo agli utenti di accedere al sistema per lavori che richiedono un utilizzo intensivo della grafica tramite il dispositivo endpoint.
Più utenti possono quindi sfruttare un'unica postazione di lavoro, indipendentemente da dove si trovi: in un data center, in un data closet o persino sulla scrivania. Se il destinatario può contattare il sistema mittente tramite la rete, le risorse di elaborazione possono essere completamente remote, anche in un ambiente WAN in presenza di VPN.
Nel complesso, l'esperienza utente con HP Remote Boost è stata eccellente. Consigliamo la lettura del white paper "Come funziona: HP ZCentral Remote Boost " per un'analisi dettagliata di questa utile tecnologia, oggi più rilevante che mai.
Specifiche HP Z2 Mini G1a
| Categoria | Specifiche |
|---|---|
| Sistemi operativi disponibili |
|
| Famiglia di processori | Processore AMD Ryzen AI Max PRO |
| Processori disponibili |
|
| Unità di elaborazione neurale | AMD Ryzen AI (50 TOP) |
| Colore del prodotto | Jet nero |
| Fattore di forma | Mini |
| Memoria massima | 128 GB LPDDR5X-8533 MT/s ECC, velocità di trasferimento fino a 8000 MT/s |
| Storage interno |
|
| Grafica disponibile |
|
| audio | Altoparlante mono integrato, Realtek ALC3205-VA2-CG, altoparlante mono interno da 2.0 W |
| Slot di espansione | 2 M.2 2280 PCIe 4×4; 1 M.2 2230 per WLAN |
| Porte e connettori |
|
| Opzioni della tastiera | Tastiera HP USB Business Slim SmartCard CCID; tastiera cablata nera HP 125; tastiera cablata HP 320K |
| Opzioni del mouse | Mouse laser HP Wired Desktop 128; Mouse HP Wired 320M; Mouse HP Wired 125 |
| Comunicazioni | LAN: Realtek RTL8125BPH-CG 2.5 GbE; WLAN: MediaTek Wi-Fi 7 MT7925 (2×2) e Bluetooth 5.4 |
| Software | Certificazione HP UEFI BIOS 2.7B; HP PC Hardware Diagnostics Windows; HP Image Assistant; HP Manageability Integration Kit 10; Performance Advisor 3.0 |
| Gestione della sicurezza | HP Secure Erase; HP Sure Click; HP BIOSphere Gen6; Sure Recover Gen4; HP Sure Admin; Kit opzionale sensore cappuccio; HP Client Security Manager Gen6; HP Sure Start Gen7; HP Sure Sense Gen2; HP Sure Run Gen5; Microsoft Pluton; HP Wolf Pro Security Edition |
| Funzionalità di gestione | Modalità ad alte prestazioni, modalità silenziosa, modalità rack, modalità prestazioni |
| Potenza | Adattatore di alimentazione interno da 300 W, efficienza fino al 92%, PFC attivo |
| Dimensioni | 3.4 x 6.6 x 7.9 pollici; 8.55 x 16.8 x 20 cm (orientamento desktop standard) |
| Peso | A partire da 5.07 libbre (2.3 kg); Confezione a partire da 9 libbre (4.1 kg) |
| Ecolabel | Dichiarazione ECO IT; SEPA; Marchio verde di Taiwan; Etichetta verde PC Giappone; FEMP; EPEAT Gold con Climate+; MEPS Corea |
| Certificazione Energetica | Certificato ENERGY STAR |
| Impatto sostenibile | Imballaggio sfuso disponibile; 10% di plastica a circuito chiuso derivata da ITE; Impronta di carbonio del prodotto; Contiene almeno il 65% di plastica riciclata post-consumo; Contiene almeno il 20% di acciaio riciclato post-industriale; Portale del prodotto abilitato per codice QR (dicembre 2025); Nuovo dashboard sul consumo energetico |
| Visualizza supporto | Supporta quattro display contemporaneamente. Ogni Mini DisplayPort può gestire un display; ogni porta Thunderbolt può gestire due display. |
Progetta e costruisci
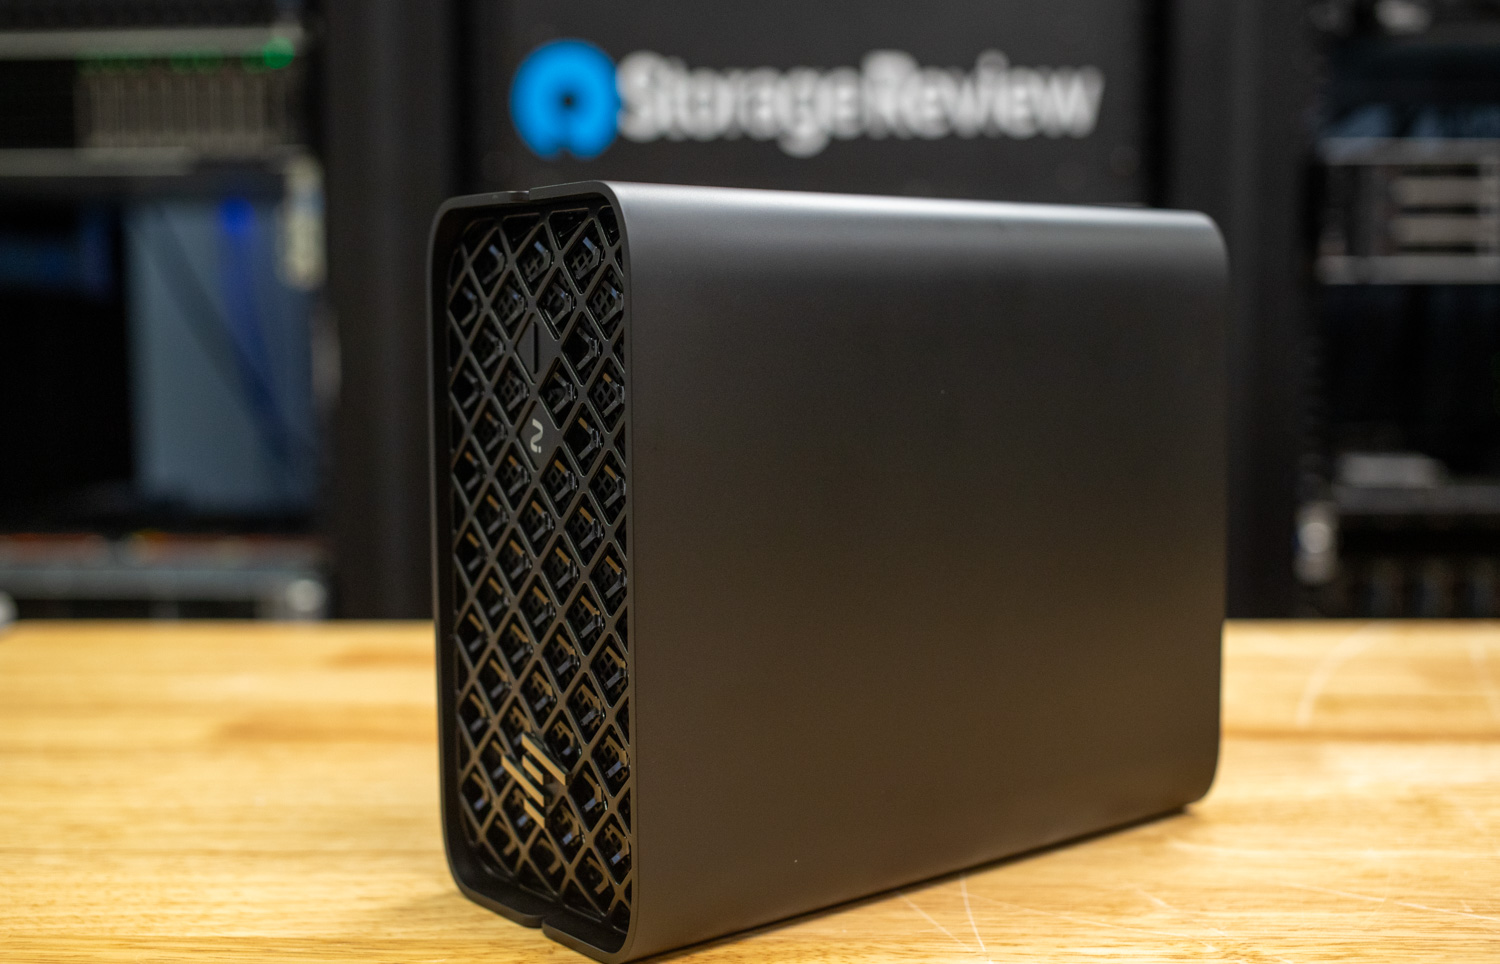
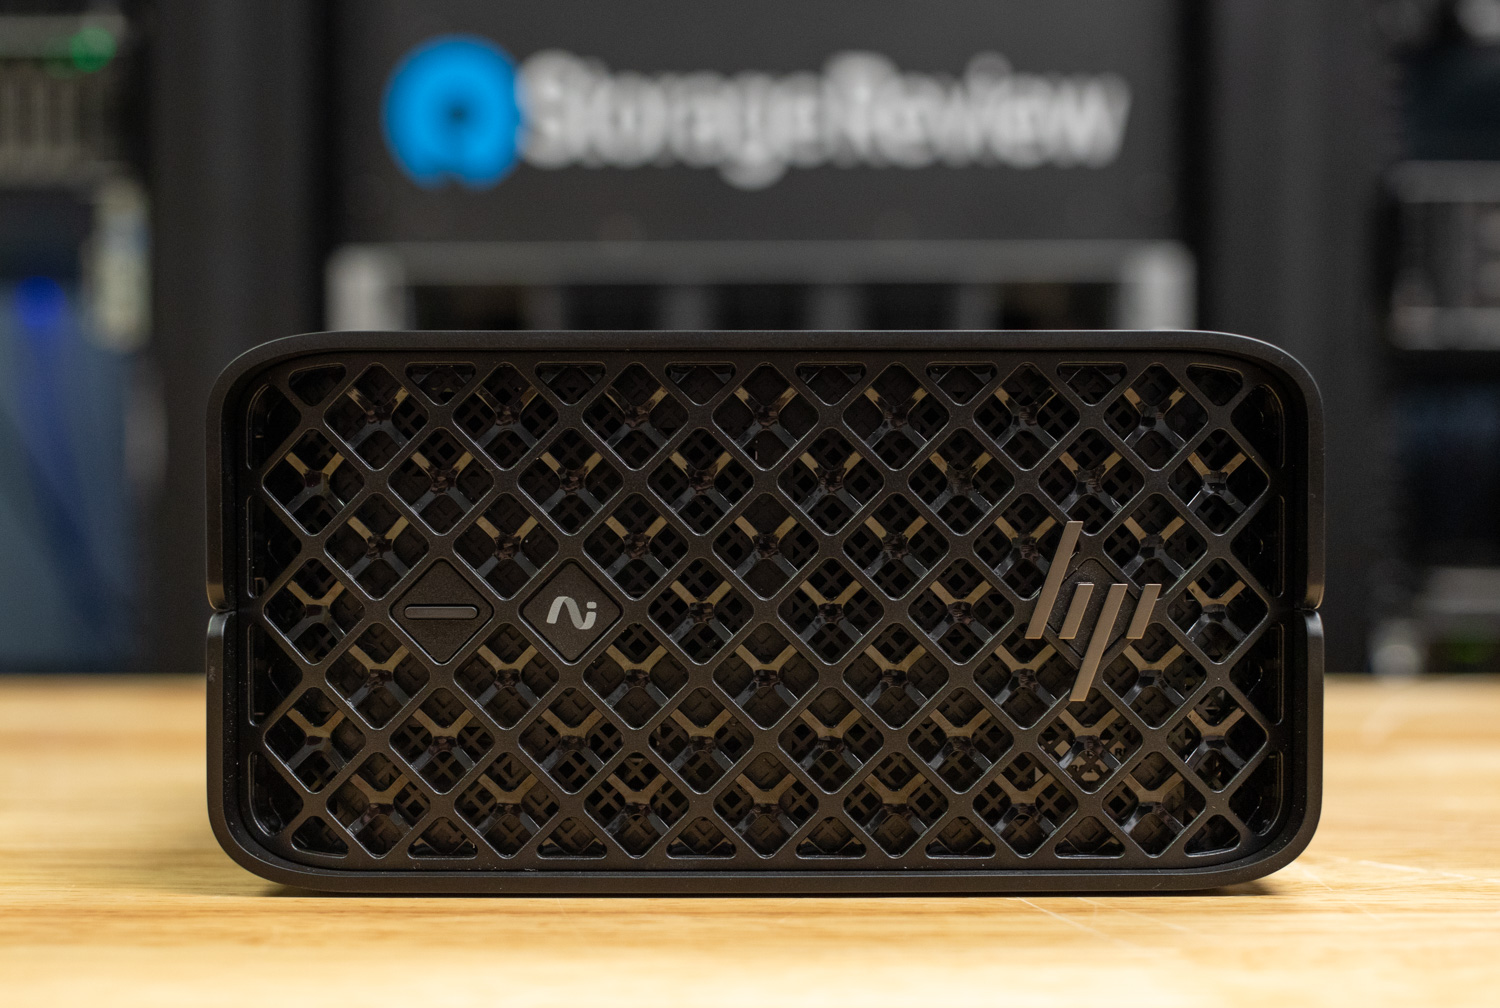
La parte anteriore dell'HP Z2 Mini G1a offre un design elegante e un layout semplice. La cornice anteriore presenta una raffinata struttura a reticolo, con il logo HP su un lato e un pulsante di accensione sull'altro. La struttura a reticolo è funzionale e consente all'aria di circolare liberamente all'interno del case senza ostacoli.
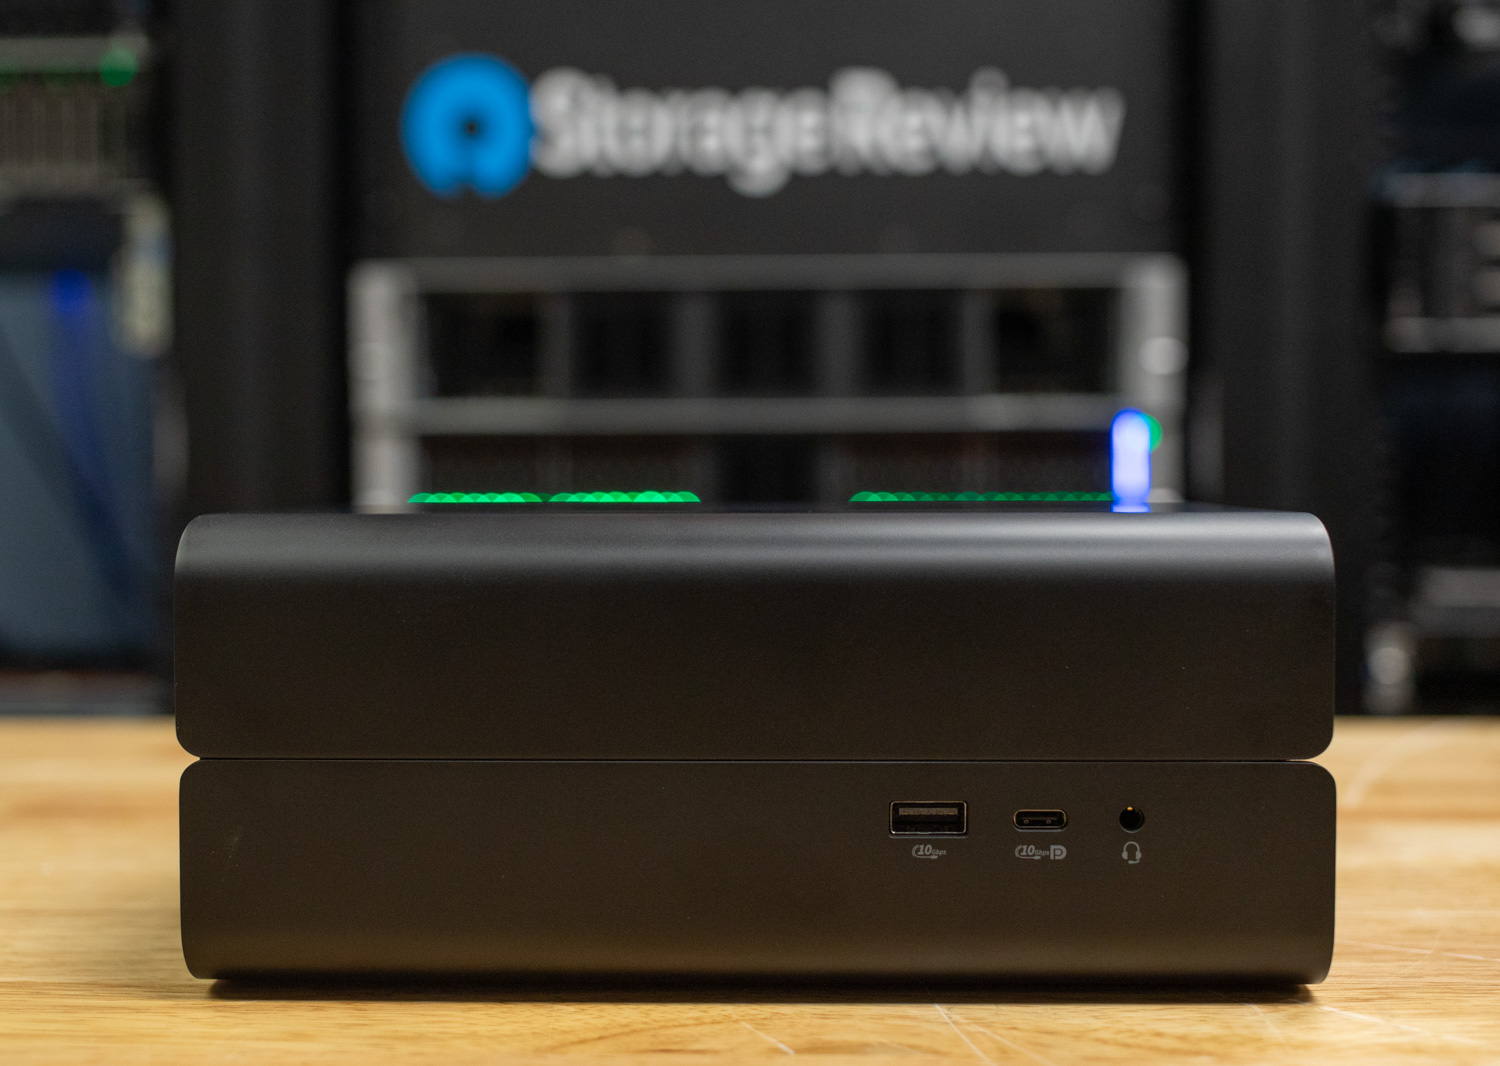
Un lato dello Z2 Mini G1a offre anche alcune porte, tra cui una porta USB-C da 10 Gbps con uscita da 15 W, una porta USB-A con connettività da 10 Gbps e un jack per cuffie/microfono.
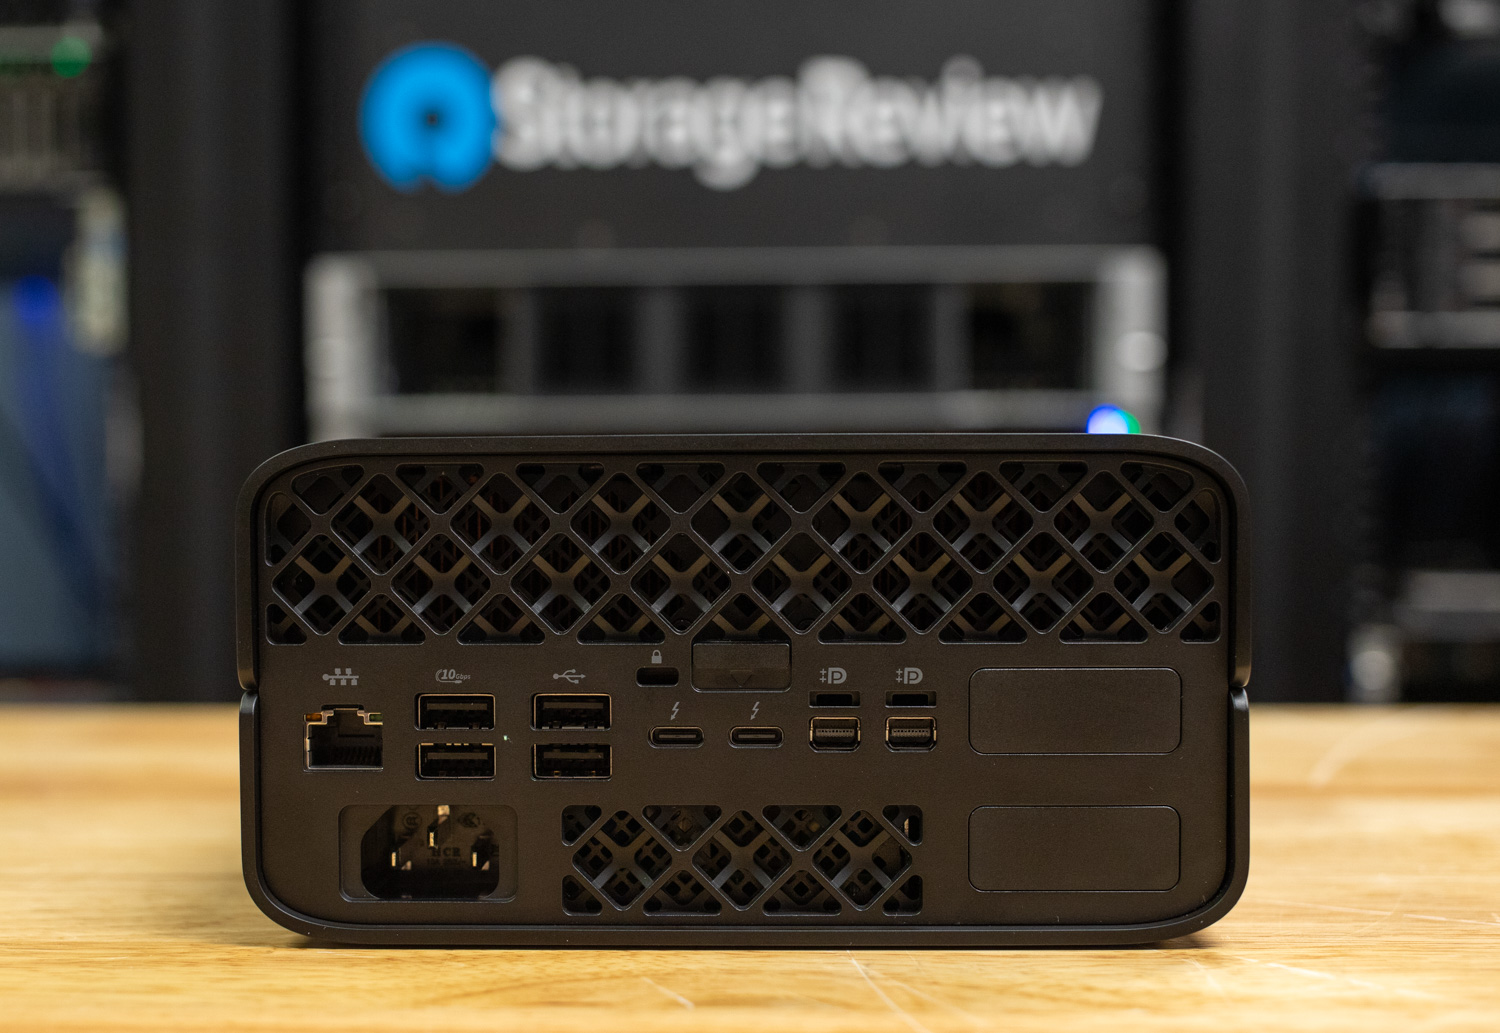
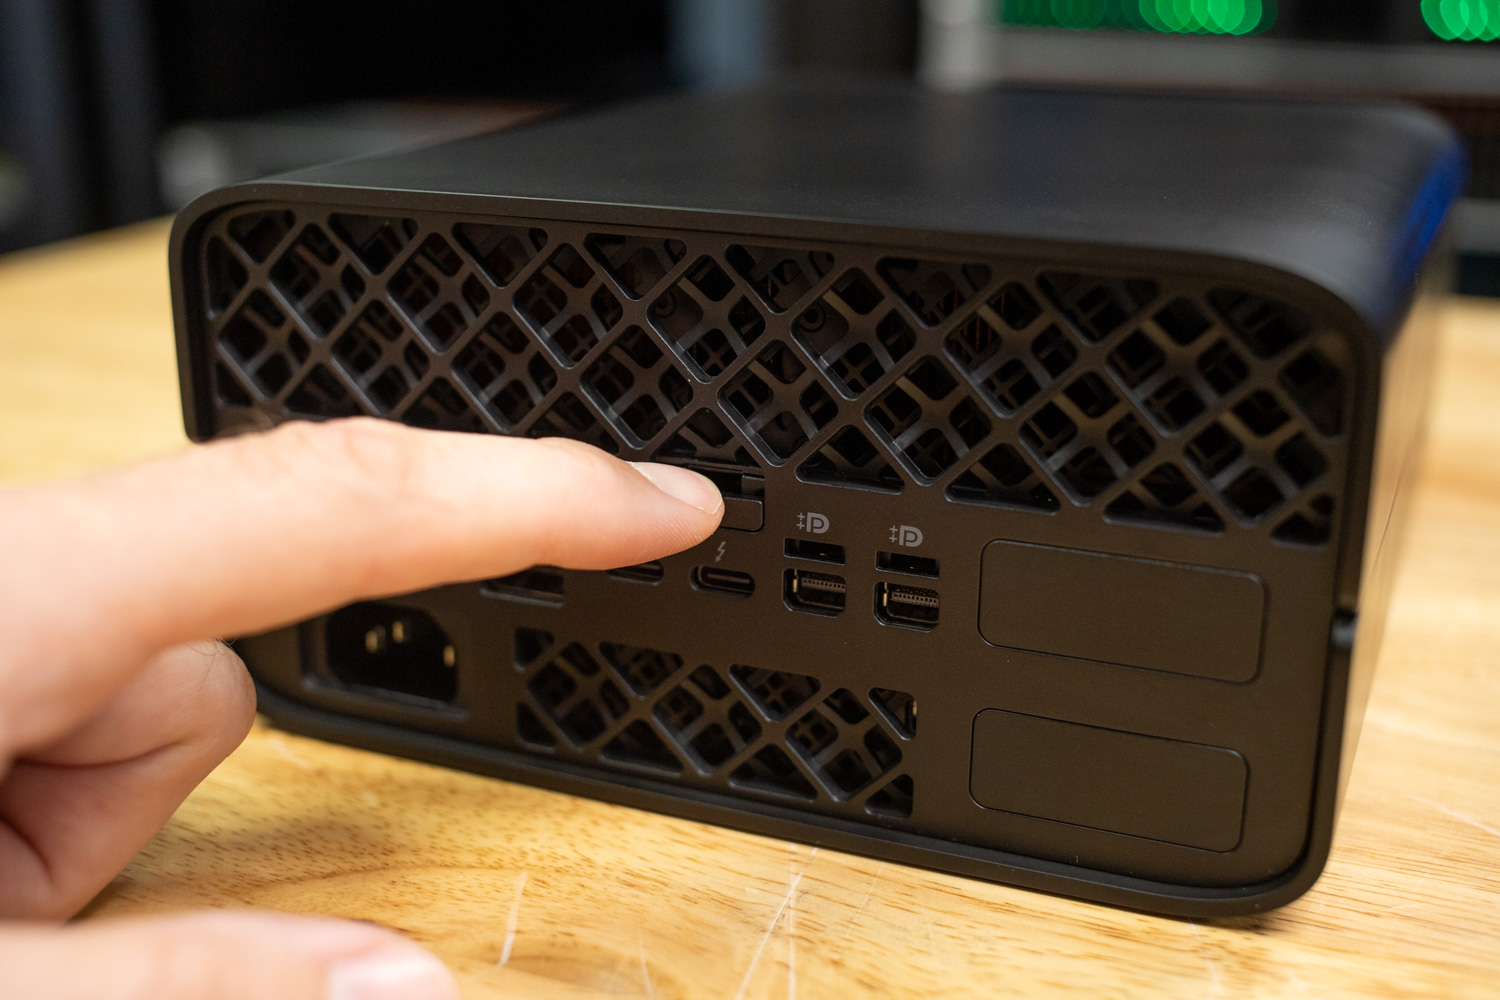
Il retro di questo sistema è dotato di un'ampia gamma di porte. Include due Mini DP 2.1, due USB 2.0, due USB 3.0 10 Gb/s, due Thunderbolt 4 USB-C 40 Gb/s, una porta 2.5 GbE e, naturalmente, la connessione per l'alimentatore e un cavo di sicurezza. L'alimentatore è completamente integrato, il che è un vantaggio, eliminando la necessità di un alimentatore CA di grandi dimensioni. HP supporta anche una funzionalità che consente una maggiore personalizzazione: due slot Flex IO che gli utenti possono modificare a proprio piacimento. Lo slot superiore offre la possibilità di scegliere tra una combinazione a due porte USB-A 5 Gb/s o una scheda di rete 1 GbE con porta seriale. Lo slot inferiore può essere configurato con un'altra scheda di rete 1 GbE tramite una porta seriale, un pulsante di alimentazione esterno aggiuntivo e un HP Remote System Controller per la gestione fuori banda (OOB).
Per estrarre il dispositivo dall'HP Z2 Mini G1a, è sufficiente far scorrere il coperchio superiore verso l'esterno tramite un pratico meccanismo a scatto sul retro.
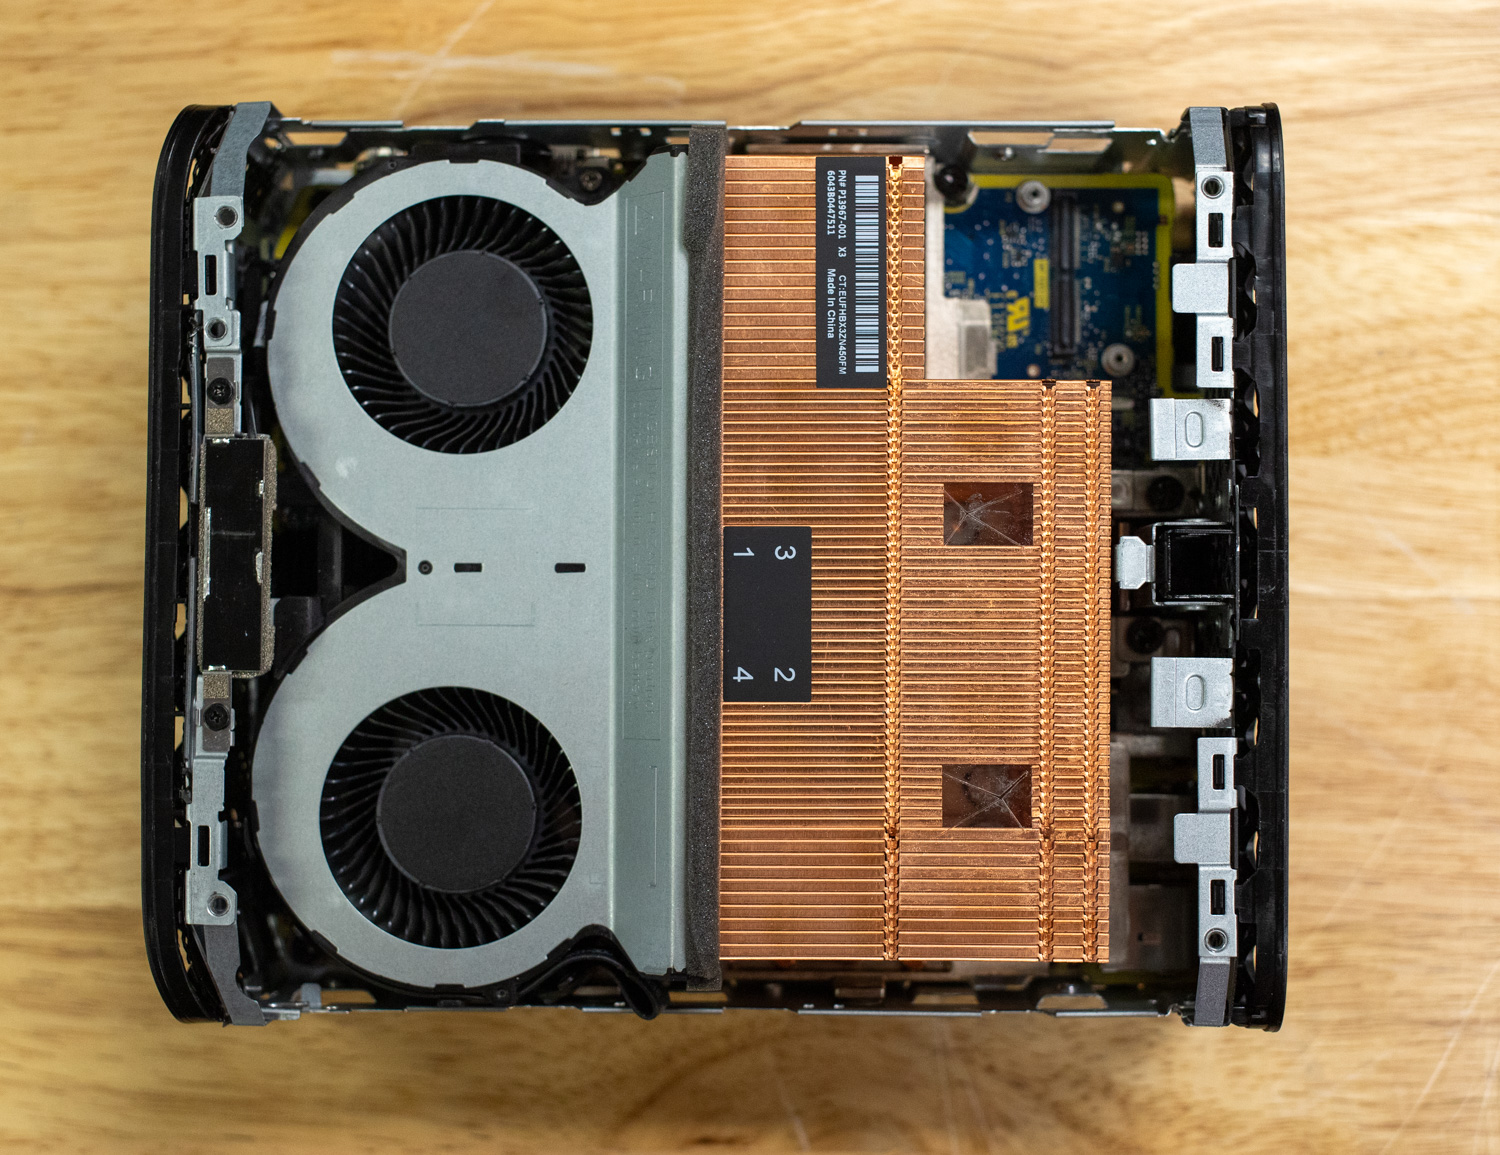
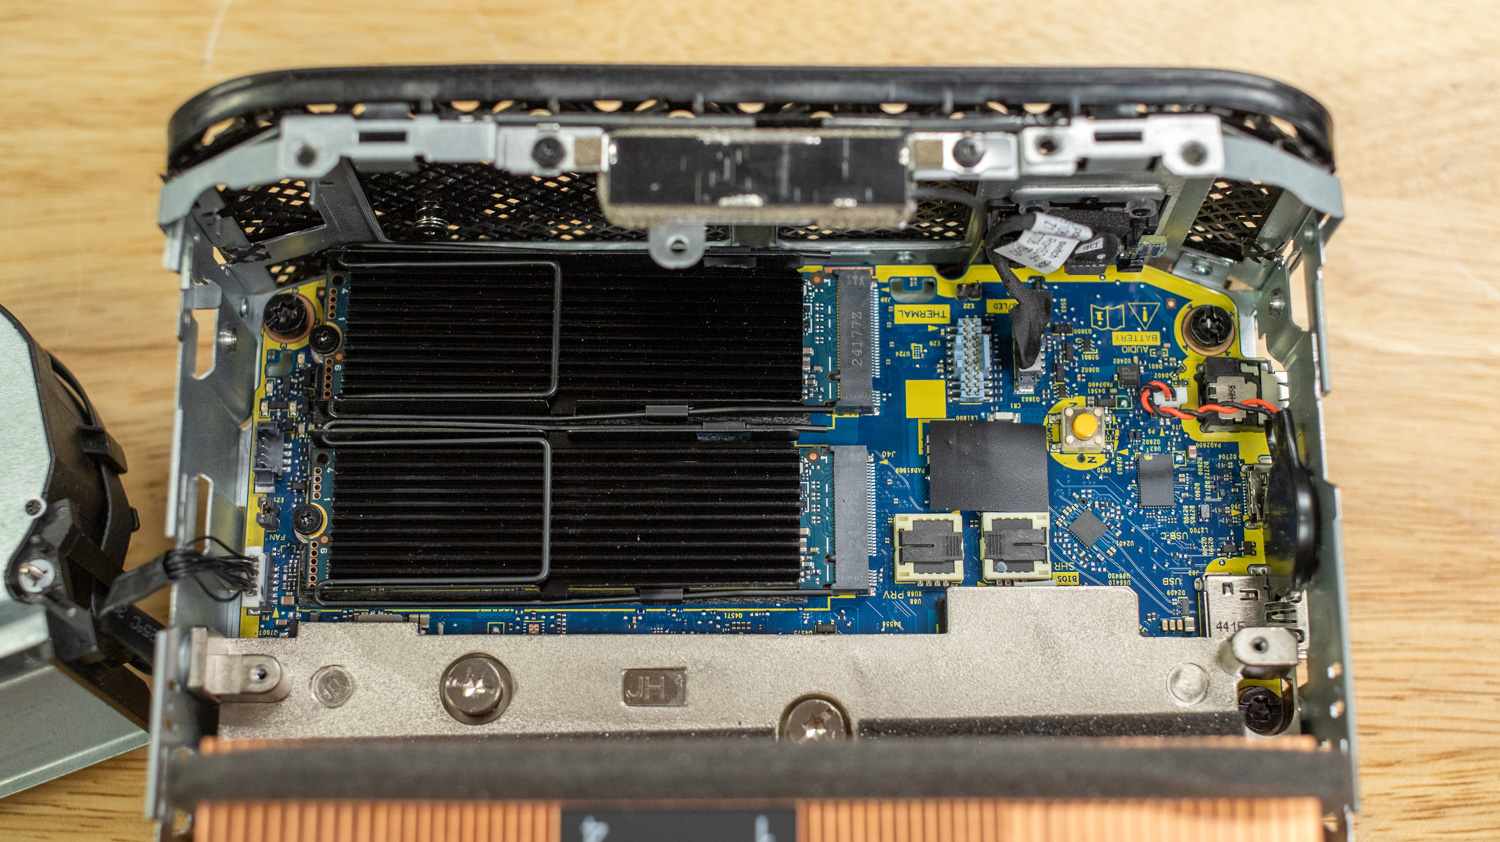
Un'ampia combinazione di ventola e dissipatore di calore copre gran parte della scheda madre, raffreddando la combinazione CPU/GPU AMD Ryzen. Sebbene la RAM di sistema sia saldata e non possa essere riparata, lo Z2 Mini G1a offre due slot PCIe Gen4 M.2. Per accedervi, è necessario rimuovere due piccole viti che collegano il gruppo ventola al dissipatore di calore e sollevare il gruppo ventola.
Durante un utilizzo intenso, si è iniziato a percepire un certo rumore della ventola, anche se non così forte o aggressivo come quello che si potrebbe riscontrare in una workstation più grande.
Test delle prestazioni dell'HP Z2 Mini G1a
In questa recensione, confrontiamo l'HP Z2 Mini G1a con il laptop HP ZBook Ultra G1a da 14 pollici di cui abbiamo già parlato. Sia la workstation che il laptop contengono componenti identici, il che ci permette di valutare le prestazioni del formato desktop rispetto a un sistema di alimentazione più potente e a un sistema di raffreddamento migliorato.
UL Procyon: visione artificiale
Il benchmark Procyon AI Computer Vision fornisce approfondimenti dettagliati sulle prestazioni dei motori di inferenza AI a livello professionale. Incorporando motori di diversi fornitori, fornisce punteggi prestazionali che riflettono accuratamente le capacità di un dispositivo. Il benchmark valuta modelli di reti neurali all'avanguardia confrontando le loro prestazioni di accelerazione AI su diversi tipi di hardware, tra cui CPU, GPU e NPU, consentendo agli utenti di valutare l'efficienza relativa in una gamma di dimensioni e condizioni di carico di lavoro.
Per riflettere i carichi di lavoro di intelligenza artificiale del mondo reale, il benchmark utilizza sei diversi modelli di reti neurali, ciascuno scelto per la sua rilevanza per le moderne attività di visione artificiale. MobileNet V3 è un modello compatto, incentrato sui dispositivi mobili, progettato per l'identificazione dei soggetti nelle immagini, mentre Inception V4 esegue lo stesso compito utilizzando un'architettura più profonda e complessa.
YOLO V3 (You Only Look Once) è specializzato nel rilevamento di oggetti stimandone le probabilità in tempo reale. DeepLab V3, basato su MobileNet V2, si concentra sulla segmentazione semantica delle immagini e sul clustering dei pixel. Real-ESRGAN, il test più impegnativo dal punto di vista computazionale, aumenta la risoluzione delle immagini da 250×250 a 1,000×1,000. Infine, ResNet 50 è un modello di classificazione robusto che consente un addestramento più efficace delle reti neurali profonde.
L'HP Z2 Mini G1a supera leggermente l'HP ZBook Ultra G1a da 14" nel test CPU. La workstation ha ottenuto un punteggio complessivo di 227, mentre il laptop ha ottenuto un punteggio complessivo di 186. La workstation ha registrato un tempo notevolmente più veloce, proporzionale in ogni categoria. Il miglior risultato è stato ottenuto nel test REAL-ESRGAN, con 1,892.10 ms per la workstation e 2,138.97 ms per la piattaforma mobile. Sebbene la differenza di velocità sia evidente in tutti i test, con punteggi a favore della workstation, entrambi i dispositivi ottengono punteggi eccellenti.
Nel test GPU, il laptop si è classificato al primo posto con un punteggio complessivo di 583, contro i 528 della workstation. La grafica integrata Radeon 8060S mostra prestazioni elevate su entrambi i sistemi. Tuttavia, sul notebook, i risultati sono stati leggermente più rapidi nella maggior parte delle categorie. L'unica eccezione è MobileNet V3, dove la workstation ha ottenuto un punteggio di 0.42 ms rispetto agli 0.46 ms del laptop. Tuttavia, il contrario si è verificato per il resto dei risultati. Considerando il carico di lavoro più elevato, REAL-ESRGAN, ad esempio, la workstation ha ottenuto un tempo di 211.76 ms, circa 11 ms in meno rispetto ai 200.40 ms del notebook.
Sia l'HP Z2 Mini G1a che l'HP ZBook Ultra G1a da 14" hanno ottenuto buoni risultati nel test NPU. Considerando i punteggi complessivi di 1,761 per la workstation e 1,773 per il notebook, sembra che la piattaforma mobile ZBook sia migliore in questo caso. Tuttavia, la differenza in quasi tutte le categorie, ad eccezione di DeepLab V3 e REAL-ESRGAN, è di soli centesimi di millisecondo. Entrambi i sistemi mostrano solide prestazioni nell'inferenza AI, il che indica che sono comparabili in termini di prestazioni.
| UL Procyon: Inferenza della visione artificiale tramite intelligenza artificiale (più basso è meglio) | HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a 14″ (Ryzen AI Max+ PRO 395 | Radeon 8060S) |
| Tempi di CPU | ||
| Punteggio complessivo della visione artificiale (più alto è meglio è) | 227 | 186 |
| Rete Mobile V3 | ms 0.75 | ms 1.09 |
| Res Net 50 | ms 5.99 | ms 6.84 |
| Inizio V4 | ms 17.12 | ms 19.80 |
| Deep Lab V3 | ms 21.20 | ms 28.27 |
| YOLO V3 | ms 36.58 | ms 41.64 |
| REAL-ESRGAN | ms 1,892.10 | ms 2,138.97 |
| Tempi GPU | ||
| Punteggio complessivo della visione artificiale (più alto è meglio è) | 528 | 583 |
| Rete Mobile V3 | ms 0.42 | ms 0.46 |
| Res Net 50 | ms 3.85 | ms 3.27 |
| Inizio V4 | ms 15.15 | ms 11.62 |
| Deep Lab V3 | ms 10.98 | ms 10.72 |
| YOLO V3 | ms 12.64 | ms 10.57 |
| REAL-ESRGAN | ms 211.76 | ms 200.40 |
| Orari NPU | ||
| Punteggio complessivo della visione artificiale (più alto è meglio è) | 1,761 | 1,773 |
| Rete Mobile V3 | ms 0.27 | ms 0.27 |
| Res Net 50 | ms 0.83 | ms 0.82 |
| Inizio V4 | ms 1.72 | ms 1.71 |
| Deep Lab V3 | ms 4.31 | ms 4.22 |
| YOLO V3 | ms 3.17 | ms 3.15 |
| REAL-ESRGAN | ms 100.05 | ms 100.83 |
UL Procyon: generazione di testo AI
Il benchmark Procyon AI Text Generation semplifica i test delle prestazioni dei modelli LLM basati sull'IA, fornendo un metodo di valutazione conciso e coerente. Consente di eseguire test ripetuti su più modelli LLM, riducendo al minimo la complessità derivante da modelli di grandi dimensioni e fattori variabili. Sviluppato in collaborazione con i leader nel settore dell'hardware per l'IA, ottimizza l'utilizzo degli acceleratori AI locali per valutazioni delle prestazioni più affidabili ed efficienti. I risultati riportati di seguito sono stati ottenuti utilizzando TensorRT.
Dopo aver completato i test di generazione di testo tramite intelligenza artificiale, i risultati mostrano un andamento coerente in cui l'HP Z2 Mini G1a si posiziona leggermente al di sopra dell'HP ZBook Ultra G1a, sebbene le differenze rimangano modeste. Nel benchmark Phi, ad esempio, lo Z2 Mini ha ottenuto un punteggio complessivo di 965 rispetto ai 922 dello ZBook. Il tempo per il primo token è stato pressoché identico, misurato in 1.898 secondi per lo Z2 Mini e 1.956 secondi per lo ZBook. I token in uscita al secondo erano altrettanto simili, rispettivamente a 68.967 e 64.986. Questi dati suggeriscono che, sebbene lo Z2 Mini elabori le attività leggermente più velocemente, entrambi i sistemi offrono una reattività comparabile durante l'inferenza.
Questa tendenza continua nei test Mistral e Llama3. Lo Z2 Mini ha ottenuto rispettivamente 850 e 766 punti, mentre lo ZBook ha ottenuto rispettivamente 829 e 756 punti. Anche la velocità di output e la latenza dei token hanno seguito l'esempio, con margini altrettanto ravvicinati. Questi risultati coerenti indicano che entrambi i sistemi offrono livelli di prestazioni simili, in particolare quando si utilizzano modelli di medie dimensioni in condizioni reali.
Il test Llama2 ha prodotto il set di risultati più simile in assoluto. Lo Z2 Mini ha registrato un punteggio di 936 con un tempo di 3.813 secondi per il primo token, mentre lo ZBook ha ottenuto 929 con un tempo di 3.860 secondi. Il piccolo divario tra questi risultati rafforza la stretta corrispondenza tra i sistemi nella gestione dei moderni carichi di lavoro di intelligenza artificiale.
Nel complesso, lo Z2 Mini si posiziona costantemente leggermente in vantaggio in ogni test, ma i dati mostrano che entrambi i sistemi offrono prestazioni quasi alla pari quando si eseguono LLM con TensorRT. Queste differenze possono essere evidenti nei benchmark sintetici, ma è improbabile che si traducano in divari prestazionali significativi nella maggior parte degli scenari di utilizzo.
| UL Procyon: generazione di testo AI | HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a 14″ (Ryzen AI Max+ PRO 395 | Radeon 8060S) |
| Punteggio complessivo Phi | 965 | 922 |
| Tempo di output Phi per il primo token | 1.898 secondi | 1.956 secondi |
| Token di output Phi al secondo | 68.967 token/s | 64.986 token/s |
| Durata complessiva Phi | 52.666 secondi | 55.501 secondi |
| Punteggio complessivo Mistral | 850 | 829 |
| Tempo di output di Mistral per il primo token | 2.734 secondi | 2.783 secondi |
| Gettoni di output Mistral al secondo | 43.358 token/s | 41.992 token/s |
| Durata complessiva del Mistral | 81.716 secondi | 84.065 secondi |
| Punteggio complessivo di Llama3 | 766 | 756 |
| Tempo di output di Llama3 per il primo token | 2.545 secondi | 2.578 secondi |
| Token di output Llama3 al secondo | 36.752 token/s | 36.243 token/s |
| Llama3 Durata complessiva | 91.987 secondi | 93.200 secondi |
| Punteggio complessivo di Llama2 | 936 | 929 |
| Tempo di output di Llama2 per il primo token | 3.813 secondi | 3.860 secondi |
| Token di output Llama2 al secondo | 24.685 token/s | 24.619 token/s |
| Llama2 Durata complessiva | 136.077 secondi | 136.720 secondi |
Procione UL: Generazione di immagini AI
Il benchmark Procyon AI Image Generation offre un metodo coerente e preciso per misurare le prestazioni dell'inferenza AI su diverse configurazioni hardware, dalle NPU a basso consumo alle GPU di fascia alta. Include tre test: Stable Diffusion XL (FP16) per GPU di fascia alta, Stable Diffusion 1.5 (FP16) per GPU di potenza media e Stable Diffusion 1.5 (INT8) per dispositivi a basso consumo. Il benchmark utilizza il motore di inferenza ottimale per ciascun sistema, garantendo risultati equi e comparabili.
Per simulare l'utilizzo nel mondo reale, il benchmark genera immagini da un set standardizzato di prompt di testo, creando un carico di lavoro di intelligenza artificiale da testo a immagine coerente su tutti i dispositivi. Ogni test fornisce metriche chiave sulle prestazioni, tra cui un punteggio complessivo, il tempo totale di generazione e la velocità di generazione delle immagini, consentendo un confronto semplice ed efficace tra modelli e configurazioni hardware.
Sia l'HP Z2 Mini G1a che l'HP ZBook Ultra G1a sono stati in grado di eseguire due dei tre test di generazione di immagini inclusi nel benchmark di generazione di immagini AI di Procyon. Nello specifico, entrambi i sistemi hanno completato Stable Diffusion 1.5 con precisione FP16 e il più impegnativo test Stable Diffusion XL FP16. La versione INT8 di Stable Diffusion 1.5 non era supportata su nessuna delle due configurazioni.
Nel test Stable Diffusion 1.5 FP16, lo Z2 Mini ha completato il carico di lavoro con un punteggio complessivo di 725, un tempo di generazione totale di 137.815 secondi e una velocità di generazione delle immagini di 8.613 secondi per immagine. Lo ZBook ha prodotto risultati comparabili, con un punteggio complessivo di 648, un tempo totale di 154.203 secondi e 9.638 secondi per immagine. Questi dati suggeriscono che lo Z2 Mini mantiene un modesto vantaggio in termini di efficienza di elaborazione, sebbene entrambi i sistemi condividano lo stesso processore Ryzen AI Max+ PRO 395 e la stessa GPU Radeon 8060S.
Un andamento simile si riscontra nel test Stable Diffusion XL FP16. Lo Z2 Mini ha ottenuto un punteggio complessivo di 570 e ha completato il benchmark in 1,052.468 secondi, generando immagini a 65.779 secondi per immagine. Lo ZBook, al contrario, ha ottenuto un punteggio di 451 e un tempo totale di 1,329.592 secondi, con una velocità di elaborazione delle immagini di 83.100 secondi per immagine. Sebbene entrambi i sistemi siano in grado di gestire questi modelli più grandi, lo Z2 Mini completa costantemente le attività più rapidamente, riflettendo prestazioni leggermente più ottimizzate con vincoli hardware identici.
| UL Procyon: generazione di immagini AI | HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a 14″ (Ryzen AI Max+ PRO 395 | Radeon 8060S) |
| Diffusione stabile 1.5 (FP16) – Punteggio complessivo | 725 | 648 |
| Diffusione stabile 1.5 (FP16) – Tempo complessivo | 137.815 secondi | 154.203 secondi |
| Diffusione stabile 1.5 (FP16) – Velocità di generazione delle immagini | 8.613 s/immagine | 9.638 s/immagine |
| Diffusione stabile 1.5 (INT8) – Punteggio complessivo | N/A | N/A |
| Diffusione stabile 1.5 (INT8) – Tempo complessivo | N/A | N/A |
| Diffusione stabile 1.5 (INT8) – Velocità di generazione delle immagini | N/A | N/A |
| Stable Diffusion XL (FP16) – Punteggio complessivo | 570 | 451 |
| Diffusione stabile XL (FP16) – Tempo complessivo | 1,052.468 secondi | 1,329.592 secondi |
| Stable Diffusion XL (FP16) – Velocità di generazione delle immagini | 65.779 s/immagine | 83.100 s/immagine |
SPECworkstation 4
Il benchmark SPECworkstation 4.0 è uno strumento completo per valutare tutti gli aspetti chiave delle prestazioni delle workstation. Offre una misurazione concreta delle prestazioni di CPU, grafica, acceleratore e disco, garantendo ai professionisti i dati necessari per prendere decisioni informate sui propri investimenti hardware. Il benchmark include una serie di test specifici incentrati sui carichi di lavoro di IA e ML, tra cui attività di data science e test di inferenza basati sul runtime ONNX, a testimonianza della crescente importanza dell'IA/ML negli ambienti workstation. Copre sette settori verticali e quattro sottosistemi hardware, fornendo una misurazione dettagliata e pertinente delle prestazioni delle workstation odierne.
I risultati mostrano che lo Z2 Mini ottiene generalmente punteggi più elevati nella maggior parte delle categorie, riflettendo un leggero vantaggio prestazionale nei carichi di lavoro sostenuti. Nel test Energia, lo Z2 Mini ha ottenuto un punteggio di 2.50, rispetto al 2.20 dello ZBook. I Servizi Finanziari hanno mostrato un divario più ampio, con punteggi di 2.35 per la workstation e 1.60 per il laptop. Le Scienze della Vita hanno seguito un andamento simile, con lo Z2 Mini a 2.60 e lo ZBook a 2.20. Media e Intrattenimento hanno ottenuto rispettivamente 2.22 e 1.90, mentre il Design di Prodotto ha ottenuto punteggi di 2.00 per la workstation e 1.74 per il laptop.
L'unico caso in cui lo ZBook ha ottenuto un vantaggio è stato in Produttività e Sviluppo, dove ha registrato un punteggio di 1.03 rispetto all'2 dello Z1.00 Mini. Sebbene queste differenze non siano significative, suggeriscono che lo Z2 Mini potrebbe offrire un throughput leggermente più costante nelle applicazioni di classe workstation, nonostante entrambi i sistemi condividano lo stesso processore e la stessa GPU.
| SPECworkstation 4.0.0 (più alto è meglio) |
HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S) |
HP ZBook Ultra G1a 14″ (Ryzen AI Max+ PRO 395 | Radeon 8060S) |
| Energy | 2.50 | 2.20 |
| Servizi finanziari | 2.35 | 1.60 |
| Life Sciences | 2.60 | 2.20 |
| Media e intrattenimento | 2.22 | 1.90 |
| Product Design | 2.00 | 1.74 |
| Produttività e sviluppo | 1.00 | 1.03 |
Luxmark
Luxmark è un benchmark GPU che utilizza LuxRender, un motore di rendering open source per il ray-tracing, per valutare le prestazioni di un sistema nella gestione di scene 3D altamente dettagliate. Questo benchmark è utile per valutare le capacità di rendering grafico di server e workstation, in particolare per applicazioni di effetti visivi e visualizzazione architettonica, dove un'accurata simulazione della luce è fondamentale.
Sia l'HP Z2 Mini G1a che l'HP ZBook Ultra G1a hanno ottenuto buoni risultati in questo test, a dimostrazione della potenza del Ryzen AI Max+ PRO 395 abbinato alla Radeon 8060S. Nella scena Hallbench, lo Z2 Mini ha ottenuto un punteggio di 8,477, leggermente superiore ai 7,833 dello ZBook. Analogamente, nella scena Food, i punteggi sono stati di 3,943 per la workstation e 3,915 per il laptop. Questi risultati mostrano solo una minima varianza, suggerendo che entrambi i sistemi sono adatti a carichi di lavoro di rendering 3D da leggeri a moderati.
In particolare, entrambi i dispositivi beneficiano di un'allocazione flessibile della memoria, che consente la condivisione dinamica della RAM tra le attività della CPU e della GPU. Questa capacità contribuisce alla loro capacità di gestire le attività di rendering in modo efficiente, anche in fattori di forma compatti, solitamente non associati a prestazioni grafiche intensive.
| Luxmark (più alto è meglio) | HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a 14″ (Ryzen AI Max+ PRO 395 | Radeon 8060S) |
| Panchina | 8,477 | 7,833 |
| Alimentare - Food | 3,943 | 3,915 |
Compressione a 7 zip
Il benchmark di compressione 7-Zip valuta le prestazioni della CPU durante le attività di compressione e decompressione, misurando le valutazioni in GIPS (Giga Instructions Per Second) e l'utilizzo della CPU. GIPS più elevati e un utilizzo efficiente della CPU indicano prestazioni superiori.
Concentrandosi sui punteggi risultanti, sia l'HP Z2 Mini G1a che l'HP ZBook Ultra G1a offrono prestazioni elevate e molto simili. Durante la compressione, lo Z2 Mini ha ottenuto un punteggio finale di 139.298 GIPS, leggermente inferiore ai 139.617 GIPS dello ZBook. In decompressione, tuttavia, lo Z2 Mini ha ottenuto un punteggio finale più alto, pari a 163.969 GIPS, rispetto ai 174.046 GIPS dello ZBook.
Considerando entrambi i carichi di lavoro, il punteggio totale risultante è stato di 151.634 GIPS per Z2 Mini e 156.832 GIPS per ZBook. Questi risultati indicano che, sebbene entrambi i sistemi siano altamente capaci di gestire flussi di lavoro ad alta compressione, ZBook presenta un leggero vantaggio in termini di throughput complessivo, in particolare durante le fasi di decompressione.
| Benchmark di compressione 7-Zip (più alto è, meglio è) | HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a 14″ (Ryzen AI Max+ PRO 395 | Radeon 8060S) | |||
| Compressione | |||||
| Utilizzo attuale della CPU | 2,734% | 2,868% | |||
| Valutazione/utilizzo corrente | 5.136 GIPS | 4.883 GIPS | |||
| Corrente nominale | 140.405 GIPS | 140.061 GIPS | |||
| Utilizzo della CPU risultante | 2,718% | 2,855% | |||
| Valutazione/Utilizzo risultante | 5.126 GIPS | 4.890 GIPS | |||
| Valutazione risultante | 139.298 GIPS | 139.617 GIPS | |||
| decompressione | |||||
| Utilizzo attuale della CPU | 2,343% | 2,904% | |||
| Valutazione/utilizzo corrente | 6.805 GIPS | 6.029 GIPS | |||
| Corrente nominale | 159.451 GIPS | 175.104 GIPS | |||
| Utilizzo della CPU risultante | 2,414% | 2,887% | |||
| Valutazione/Utilizzo risultante | 6.793 GIPS | 6.028 GIPS | |||
| Valutazione risultante | 163.969 GIPS | 174.046 GIPS | |||
| Valutazione totale | |||||
| Utilizzo totale della CPU | 2,566% | 2,871% | |||
| Valutazione/utilizzo totale | 5.959 GIPS | 5.459 GIPS | |||
| Valutazione totale | 151.634 GIPS | 156.832 GIPS | |||
Test di velocità RAW di Blackmagic
Blackmagic RAW Speed Test è uno strumento di benchmarking delle prestazioni che misura la capacità di un sistema di gestire la riproduzione e l'editing video utilizzando il codec Blackmagic RAW. Valuta la capacità di un sistema di decodificare e riprodurre file video ad alta risoluzione, fornendo frame rate per l'elaborazione basata sia sulla CPU che sulla GPU.
Nel test CPU 8K, l'HP Z2 Mini G1a ha raggiunto 124 frame al secondo, superando l'HP ZBook Ultra G1a, che ha ottenuto 102 frame al secondo. Ciò suggerisce un leggero vantaggio per la workstation nelle attività di decodifica raw basate sulla CPU. Tuttavia, i risultati accelerati dalla GPU utilizzando OpenCL mostrano la tendenza opposta. Lo ZBook ha prodotto un frame rate leggermente superiore di 78 frame al secondo, rispetto ai 74 frame al secondo dello Z2 Mini.
| Test di velocità RAW di Blackmagic | HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a 14″ (Ryzen AI Max+ PRO 395 | Radeon 8060S) |
|---|---|---|
| CPU 8K | 124 FPS | 102 FPS |
| 8K APERTOCL | 74 FPS | 78 FPS |
Test della velocità del disco Blackmagic
Il Blackmagic Disk Speed Test valuta le prestazioni di archiviazione misurando le velocità di lettura e scrittura, fornendo informazioni sulla capacità di un sistema di gestire attività che richiedono un uso intensivo di dati, come l'editing video e i trasferimenti di file di grandi dimensioni.
HP Z2 Mini G1a offre due slot PCIe Gen4, entrambi molto facili da accedere e aggiornare. Le prestazioni dell'SSD potrebbero variare leggermente a seconda del componente utilizzato per la configurazione specifica.
| Test di velocità del disco (più alto è, meglio è) | HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S) |
HP ZBook Ultra G1a 14″ (Ryzen AI Max+ PRO 395 | Radeon 8060S) |
| Leggi | 4,549.3 MB / s | 4,547.3 MB / s |
| Scrivi | 5,344 MB / s | 4,264.8 MB / s |
Benchmark del frullatore
Blender è un'applicazione open source per la modellazione 3D. Questo benchmark è stato eseguito utilizzando l'utility Blender Benchmark. Il punteggio è misurato in campioni al minuto, con valori più alti che indicano prestazioni migliori.
L'HP Z2 Mini G1a ha costantemente superato l'HP ZBook Ultra G1a in tutte e tre le scene testate. Nel progetto Monster, lo Z2 Mini ha raggiunto 224.3 campioni al minuto, rispetto ai 189.29 dello ZBook. La scena Junkshop ha seguito con rispettivamente 149.5 e 129.42 campioni al minuto. Infine, nella scena Classroom, lo Z2 Mini ha elaborato 116.3 campioni al minuto, mentre lo ZBook ne ha completati 94.14.
| Blender Benchmark CPU (campioni al minuto, più alto è meglio è) | HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a 14″ (Ryzen AI Max+ PRO 395 | Radeon 8060S) |
| Mostro - Monster | 224.3 campioni/m | 189.29 campioni/m |
| Rigattiere | 149.5 campioni/m | 129.42 campioni/m |
| Aula | 116.3 campioni/m | 94.14 campioni/m |
Passando al rendering basato su GPU utilizzando il motore OptiX di Blender, i risultati mostrano una ripartizione delle prestazioni più equilibrata tra i due sistemi. Nella scena Monster, l'HP ZBook Ultra G1a ha renderizzato 661.50 campioni al minuto, leggermente in più rispetto ai 2 campioni al minuto dello Z616.1 Mini. Ciò suggerisce un leggero vantaggio dal punto di vista della GPU per lo ZBook in questa specifica scena, nonostante la grafica Radeon 8060S identica su entrambi i dispositivi.
Nei test Junkshop e Classroom, tuttavia, lo Z2 Mini riacquista un leggero vantaggio. Ha ottenuto rispettivamente 350.6 e 342.7 campioni al minuto, mentre lo ZBook ha ottenuto 341.92 e 333.26 nelle stesse scene. Queste differenze sono relativamente minori e rientrano nella varianza prevista, indicando che entrambi i sistemi offrono prestazioni di rendering GPU molto simili con OptiX.
| Blender Benchmark GPU (campioni al minuto, più alto è meglio è) | HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a 14″ (Ryzen AI Max+ PRO 395 | Radeon 8060S) |
| Mostro - Monster | 745.55 campioni/m | 661.50 campioni/m |
| Rigattiere | 366.54 campioni/m | 341.92 campioni/m |
| Aula | 359.01 campioni/m | 333.26 campioni/m |
y-cruncher
y-cruncher è un programma multithread e scalabile in grado di calcolare Pi greco e altre costanti matematiche con una risoluzione di migliaia di miliardi di cifre. Dal suo lancio nel 2009, è diventato un'applicazione di benchmarking e stress test molto apprezzata da overclocker e appassionati di hardware.
I parametri dell'HP Z2 Mini G1a sono coerenti con quelli dell'HP ZBook Ultra G1a da 14". La workstation ha offerto un leggero vantaggio in tutti gli incrementi di calcolo, a partire dal test da 1 miliardo di cifre che ha misurato 12.965 secondi. Sia nei test da 2.5 miliardi che in quelli da 5 miliardi, il divario si è ampliato di un paio di secondi. I risultati di 34.533 secondi per 2.5 miliardi e 75.021 secondi per 5 miliardi sono solidi. Quando la workstation ha completato la porzione da 10 miliardi di cifre, ha ottenuto un tempo di completamento di 160.252 secondi, risultando 11 secondi più veloce dello ZBook, principalmente a causa di lievi limitazioni energetiche del laptop.
| Y-Cruncher (tempo di calcolo totale) | HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a 14″ (Ryzen AI Max+ PRO 395 | Radeon 8060S) |
|---|---|---|
| 1 Billion | 12.965 secondi | 12.93 secondi |
| 2.5 Billion | 34.533 secondi | 34.91 secondi |
| 5 Billion | 75.021 secondi | 78.19 secondi |
| 10 Billion | 160.252 secondi | 171.72 secondi |
Geekbench 6
Geekbench 6 è un benchmark multipiattaforma che misura le prestazioni complessive del sistema.
I risultati dell'HP Z2 Mini G1a non sorprendono. I punteggi della CPU sono quasi identici a quelli del laptop, con 2,862 Single-Core e 12,210 Multi-Core. Per ragioni simili a quelle già menzionate, il punteggio OpenCL della GPU ha registrato un andamento più alto, attestandosi a 91,591. I punteggi forniti suggeriscono che le attività che richiedono un uso intensivo della CPU non rappresenteranno un problema per questo sistema. Per quanto riguarda la GPU, la scheda grafica integrata Radeon 8060S è paragonabile alle nuove schede grafiche del 2019 circa, ideale per le mini workstation.
| Geekbench 6 (più alto è meglio) | HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a 14″ (Ryzen AI Max+ PRO 395 | Radeon 8060S) |
|---|---|---|
| CPU single-core | 2,862 | 2,825 |
| CPU multicore | 17,210 | 17,562 |
| OpenCL GPU | 91,591 | 85,337 |
Cinebench R23
Cinebench R23 è un benchmark ampiamente riconosciuto per la valutazione delle prestazioni della CPU nei carichi di lavoro di rendering 3D. Utilizzando il motore di Cinema 4D, misura la capacità di un processore di gestire attività sia single-thread che multi-thread, offrendo informazioni sulla reattività complessiva e sulle capacità di elaborazione parallela.
Nel test multi-core, l'HP Z2 Mini G1a ha ottenuto un punteggio di 37,156, nettamente superiore a quello dell'HP ZBook Ultra G1a, che ha ottenuto 29,112. Ciò suggerisce che lo Z2 Mini è meglio equipaggiato per sostenere carichi di lavoro di rendering multithread più pesanti, probabilmente grazie alle condizioni termiche più favorevoli del suo chassis.
Per quanto riguarda le prestazioni single-core, i due sistemi hanno ottenuto risultati pressoché identici. Lo Z2 Mini ha ottenuto un punteggio di 2,020, mentre lo ZBook lo segue a breve distanza con 1,984. Questi dati indicano che entrambi i dispositivi offrono prestazioni simili in attività leggermente multi-thread, come l'interazione con la viewport o le operazioni di modellazione di base.
| Cinebench R23 (Più alto è meglio è) | HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a 14″ (Ryzen AI Max+ PRO 395 | Radeon 8060S) |
|---|---|---|
| Multi-Core | 37,156 | 29,112 |
| Single core | 2,020 | 1,984 |
Cinebench 2024
Cinebench 2024 si basa sulle fondamenta di R23 introducendo test di rendering basati su GPU e continuando a concentrarsi sulle prestazioni della CPU. Per questa sezione, esaminiamo solo i punteggi della CPU, che forniscono informazioni aggiornate su come ciascun sistema gestisce le moderne attività di rendering 3D.
Nel test multi-core, l'HP Z2 Mini G1a ha ottenuto un punteggio di 1,906, superando il punteggio di 1 dell'HP ZBook Ultra G1,579a. Questo segue lo stesso schema osservato in R23, dove lo Z2 Mini ha dimostrato un throughput multithread più efficiente, probabilmente beneficiando di migliori prestazioni sostenute sotto carico.
I risultati single-core sono stati pressoché identici. Lo Z2 Mini ha registrato 112 punti, mentre lo ZBook si è classificato solo un punto dietro, con 111. Questo suggerisce prestazioni simili per le attività che si basano su thread individuali, come l'editing leggero o le interazioni in tempo reale con le applicazioni.
| Cinebench 2024 (Più alto è, meglio è) | HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a 14″ (Ryzen AI Max+ PRO 395 | Radeon 8060S) |
|---|---|---|
| Multi-Core | 1,906 | 1,579 |
| Single core | 112 | 111 |
Ollama Gemma3 LLM Performance
Per valutare come HP Z2 Mini G1a gestisce l'inferenza di modelli linguistici di grandi dimensioni (LLM) in carichi di lavoro reali, abbiamo utilizzato Ollama con un prompt progettato per analizzare le sezioni relative alle prestazioni di questa recensione. I modelli testati spaziano da 1.5 a 70 miliardi di parametri, con varianti Gemma3 utilizzate ove applicabile. Questo carico di lavoro sollecita sia le risorse della GPU che della CPU, soprattutto con lunghe sequenze di prompt che mettono a dura prova la capacità di memoria, il throughput di inferenza e la stabilità di elaborazione.
Modelli più piccoli come Ollama 1.5B e 7B sono stati eseguiti rapidamente, completandosi rispettivamente in 4.76 e 36.65 secondi. La valutazione rapida per entrambi è stata efficiente, con velocità di elaborazione dei token di 716.99 token al secondo per il modello 1.5B e 799.29 token al secondo per il 7B. Tuttavia, la velocità di valutazione dell'output diminuisce all'aumentare delle dimensioni del modello. A 1.5B, i token di output sono stati generati a 112.18 token al secondo, mentre il modello 7B è stato completato a 36.86 token al secondo.
Come previsto, le prestazioni diminuiscono con l'aumentare delle dimensioni del modello. Il modello da 14B ha impiegato quasi 65 secondi per essere completato, con una velocità di generazione che è scesa a 18.90 token al secondo. Il modello da 32B ha registrato un rallentamento più significativo, impiegando 94.29 secondi totali e producendo un output di 9.38 token al secondo. Il test più impegnativo dal punto di vista computazionale, il modello da 70B, ha richiesto 164.73 secondi e ha generato token a soli 4.24 token al secondo.
Sebbene la valutazione iniziale dei prompt rimanga efficiente su tutte le dimensioni grazie alle ottimizzazioni della cache KV, il tempo di generazione totale e le velocità di output dei token diminuiscono in modo prevedibile con l'aumentare delle dimensioni del modello e delle richieste di memoria. HP Z2 Mini G1a dimostra di poter scalare fino al livello 70B, ma gli utenti devono aspettarsi notevoli rallentamenti nella reattività oltre i 14B per prompt lunghi o complessi.
| Ollama 1.5B | Durata totale (s) | Durata del carico (ms) | Conteggio valutazione prompt (token) | Durata della valutazione del prompt (ms) | Tasso di valutazione rapida | Conteggio di valutazione (token) | Durata della valutazione (s) | Tasso di valutazione |
|---|---|---|---|---|---|---|---|---|
| HP Z2 Mini g1a | 4.76 s | ms 17.21 | 22 | ms 30.68 | 716.99 tk/s | 528 | 4.71 s | 112.18 tk/s |
| Ollama 7B | ||||||||
| HP Z2 Mini g1a | 36.65 s | ms 18.21 | 22 | ms 27.52 | 799.29 tk/s | 1349 | 36.06 s | 36.86 tk/s |
| Ollama 14B | ||||||||
| HP Z2 Mini g1a | 64.97 s | ms 18.66 | 22 | ms 28.41 | 774.37 tk/s | 1227 | 64.92 s | 18.90 tk/s |
| Ollama 32B | ||||||||
| HP Z2 Mini g1a | 94.29 s | ms 73.83 | 22 | ms 69.27 | 317.61 tk/s | 883 | 94.14 s | 9.38 tk/s |
| Ollama 70B | ||||||||
| HP Z2 Mini g1a | 164.73 s | ms 21.97 | 22 | ms 38.90 | 565.52 tk/s | 699 | 164.67 s | 4.24 tk/s |
Supporto per il nuovo modello GPT-OSS 120B di OpenAI
Pochi giorni fa, OpenAI ha rilasciato le sue prime release LLM open source da molto tempo: i modelli GPT-OSS 120B e 20B. Il GPT-OSS 120B rappresenta una svolta in quanto è uno dei primi modelli addestrati nativamente con quantizzazione MXFP4. Secondo OpenAI, i modelli vengono sottoposti a post-addestramento con quantizzazione dei pesi MoE nel formato MXFP4, riducendo i pesi a soli 4.25 bit per parametro. Poiché i pesi MoE costituiscono oltre il 90% del conteggio totale dei parametri, questa quantizzazione aggressiva consente al modello 120B di adattarsi a una singola GPU H80 da 100 GB o, nel nostro caso, al Ryzen AI Max+ PRO 395 con i suoi 96 GB di memoria condivisa. Questo allineamento con le tendenze del settore è particolarmente significativo, poiché i modelli Mixture of Experts a bassa precisione stanno diventando sempre più diffusi, consentendo ai dispositivi con capacità di calcolo inferiori di offrire comunque prestazioni eccezionali in inferenza.
Questo training nativo MXFP4 offre anche un vantaggio cruciale. Quando si quantizza ulteriormente a Int4 per l'implementazione su AI Max+ PRO 395, il degrado della qualità è minimo rispetto alle perdite sostanziali tipicamente osservate quando si quantizza da BF16 a Int4. Il risultato è che GPT-OSS 120B si pone come uno dei modelli più performanti eseguibili su AI Max+ PRO 395, offrendo una qualità quasi completa.
Sfruttando questa tendenza architettonica a bassa precisione, Z2 Mini G1a trasforma ciò che tradizionalmente richiederebbe hardware di livello aziendale dal costo tre volte superiore (come la NVIDIA RTX 6000 Pro con 96 GB di VRAM) in una soluzione workstation accessibile per la sperimentazione LLM su larga scala.
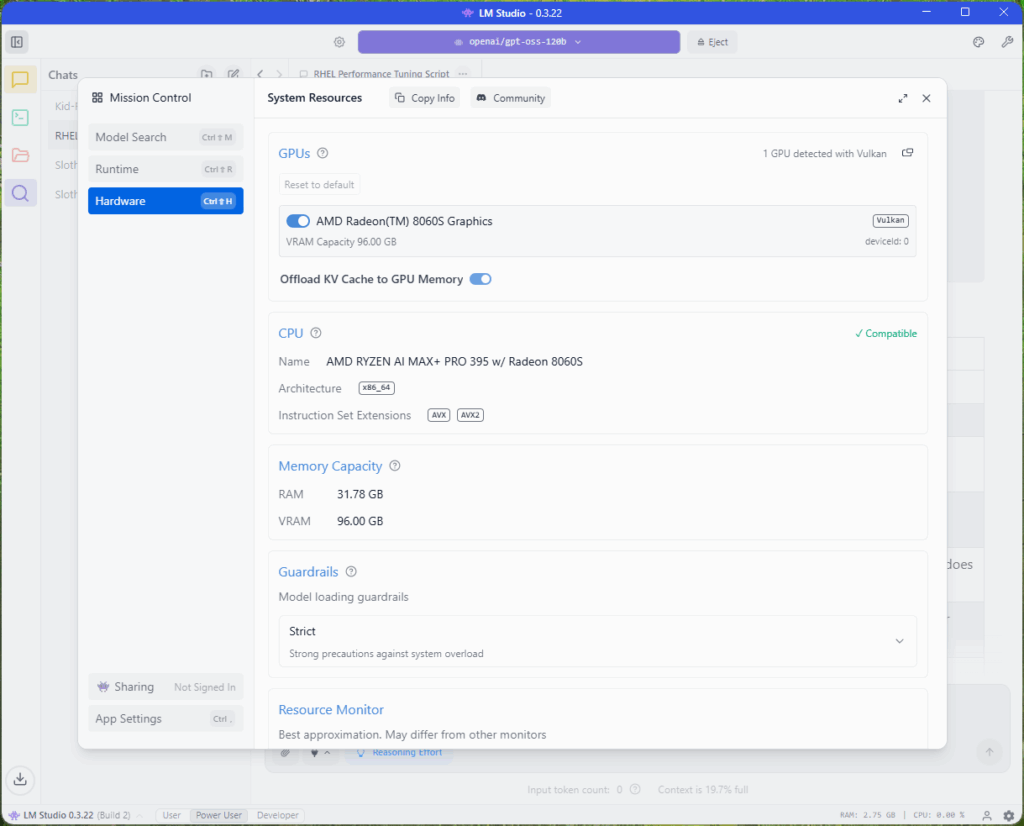
Come mostrato in LM Studio, il sistema rileva la GPU Radeon 8060S con 96 GB di VRAM e ne conferma la compatibilità per l'esecuzione del modello. La configurazione supporta anche l'offload della cache KV sulla memoria GPU, migliorando ulteriormente l'efficienza dell'inferenza per prompt lunghi o conversazioni estese. Con i rigidi controlli di sicurezza del modello di OpenAI abilitati, il sistema rimane protetto dal sovraccarico, anche durante carichi di lavoro LLM pesanti.
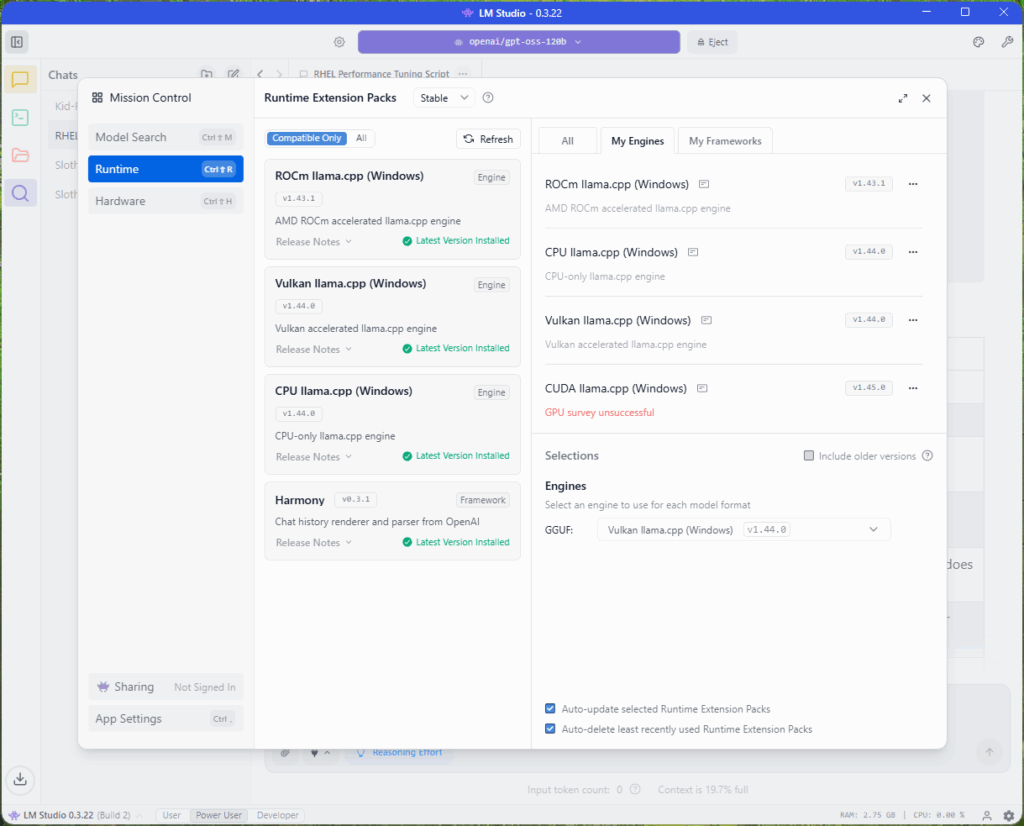
I pacchetti di estensione runtime installati includono ROCm llama.cpp (Windows), Vulkan llama.cpp (Windows), CPU llama.cpp (Windows) e il framework Harmony. Anche CUDA è elencato, ma non utilizzabile, poiché richiede una GPU NVIDIA e il sistema è dotato di una AMD Radeon 8060S.
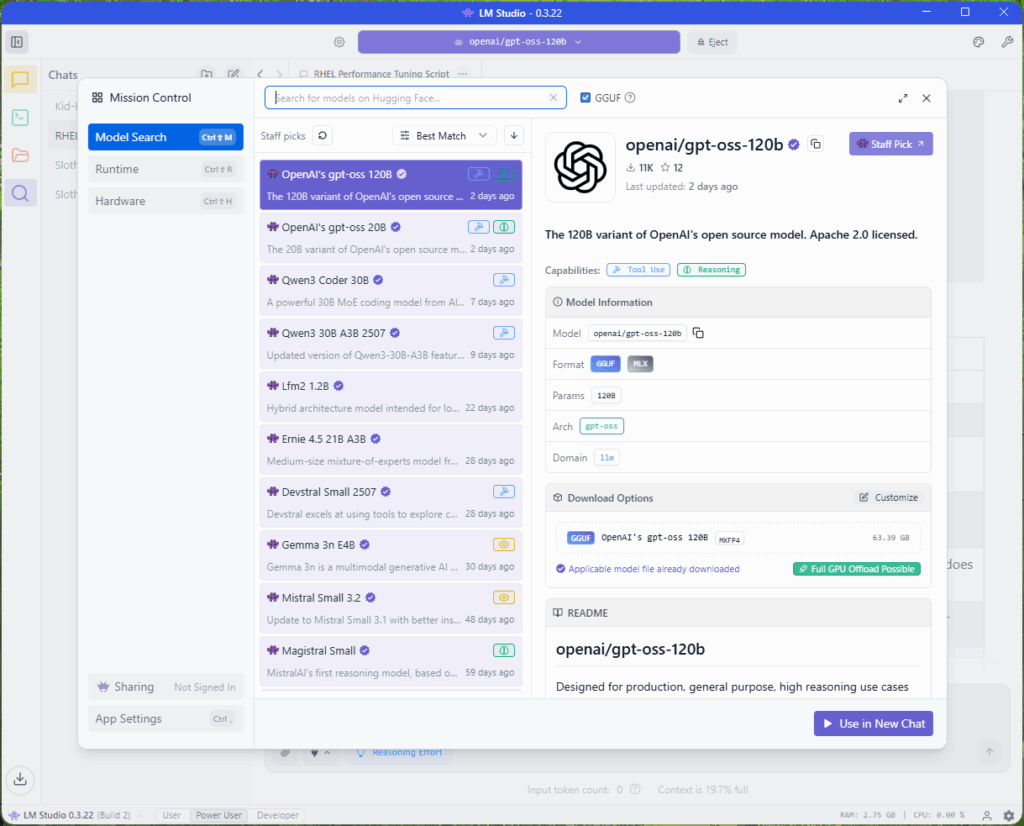
Per questa esecuzione, l'immagine sottostante mostra il modello OpenAI GPT OSS 120B menzionato in precedenza, insieme al suo formato, architettura e dimensioni. Utilizza il formato GGUF, ha una dimensione totale di 63.39 GB ed è configurato per l'offload completo della GPU.
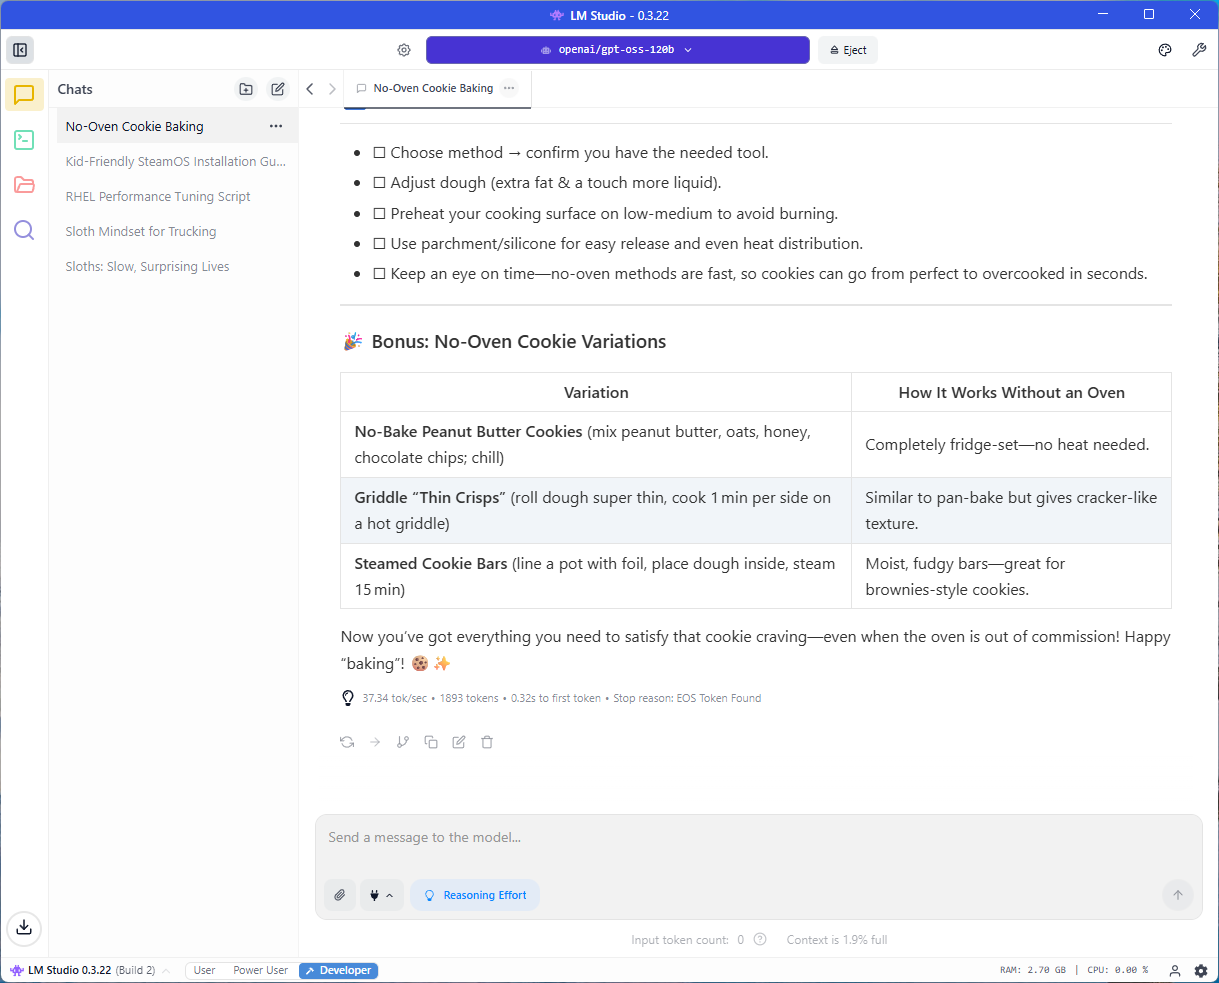
In termini di utilizzo, l'HP Z2 Mini G1a ha mostrato prestazioni sorprendentemente elevate utilizzando il modello di parametri a 120B, mantenendo una velocità prossima a 40 token/sec. Abbiamo svolto diverse conversazioni dettagliate con l'LLM. La qualità delle risposte è stata notevolmente migliore rispetto all'utilizzo di modelli più piccoli, a cui molti sistemi sono limitati a causa dei vincoli di VRAM.
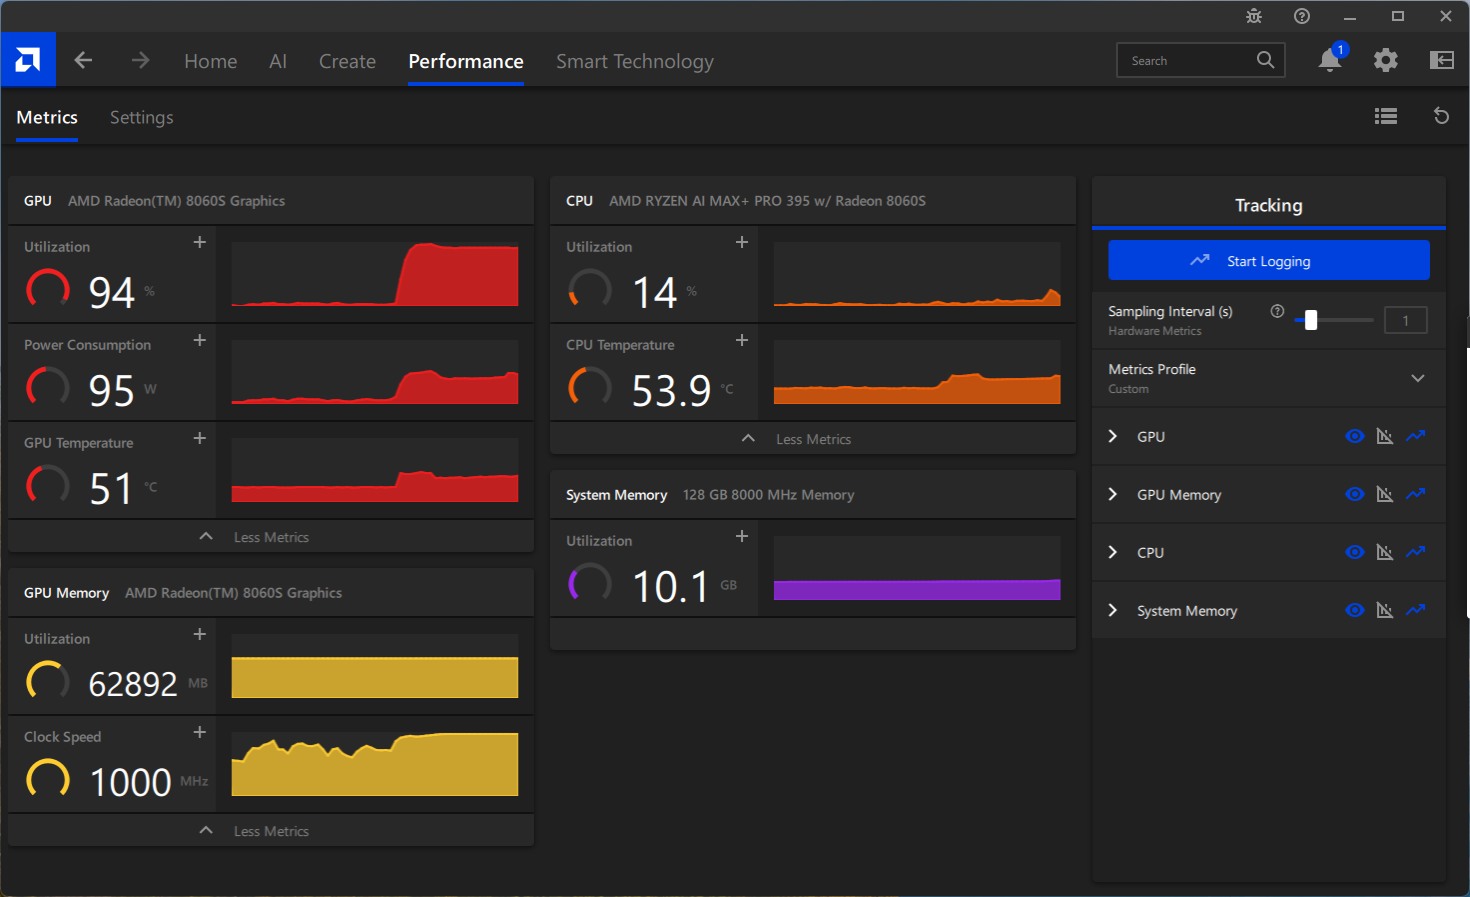
Osservando le statistiche del sistema con LLM in funzione, abbiamo visto che la GPU consumava poco meno di 100 W di potenza e le temperature rimanevano sotto controllo a 51-54 °C su GPU e CPU.
Conclusione
L'HP Z2 Mini G1a è uno dei sistemi più sorprendenti che abbiamo testato quest'anno. Sulla carta, sembra un desktop compatto con scheda grafica integrata. In pratica, questa piccola workstation offre costantemente prestazioni ben oltre le aspettative, soprattutto quando si tratta di carichi di lavoro AI. Con un prezzo di listino di circa 3,300 dollari, compete con sistemi molto più grandi e costosi, compresi quelli dotati di GPU dedicate di fascia alta.
Questo sistema ci offre anche l'opportunità di rivedere il laptop HP ZBook Ultra G1a da 14 pollici che abbiamo recensito all'inizio di quest'anno. All'epoca, eravamo rimasti delusi dal prezzo elevato e dalle prestazioni deludenti, soprattutto nelle attività incentrate sull'intelligenza artificiale. Nonostante utilizzasse hardware AMD simile, il laptop faticava con l'inferenza e avevamo sottolineato che le prestazioni dell'IA non erano all'altezza delle promesse di marketing. Non ci aveva impressionato.
Che differenza possono fare pochi mesi e un aggiornamento software significativo. Grazie al continuo lavoro di AMD sui driver e sul supporto runtime, il Ryzen AI Max+ Pro 395 ora offre le prestazioni che speravamo. Con 128 GB di memoria condivisa e fino a 96 GB disponibili come VRAM, lo Z2 Mini G1a può gestire modelli locali di grandi dimensioni come GPT-OSS 120B di OpenAI con sorprendente facilità. Un tempo, questo tipo di capacità richiedeva una workstation da 10,000 dollari con una RTX 6000 o una GPU simile. Ora, si adatta a uno chassis compatto a una frazione del costo.
HP merita elogi non solo per la scelta dei componenti. Lo Z2 Mini G1a è progettato con cura, con elevate prestazioni termiche, un'eccellente flessibilità delle porte e funzionalità opzionali come Flex IO e HP ZCentral Remote Boost che aggiungono un valore significativo negli ambienti professionali.
Questo sistema ridefinisce le aspettative su ciò che una workstation di piccole dimensioni può offrire. Combina prestazioni di intelligenza artificiale locali impressionanti, design intelligente e un prezzo che sembra quasi troppo bello per essere vero. Per questo motivo, l'HP Z2 Mini G1a si è aggiudicato il premio "Editor's Choice". È davvero eccezionale.
Classifica: L'HP Z2 Mini G1a si aggiudica il primo posto nella nostra classifica dei migliori desktop per l'intelligenza artificiale locale senza scheda grafica dedicata.
Classifica: HP Z2 Mini G1a si aggiudica il primo posto nella classifica delle migliori workstation desktop.
Classifica: Le indicazioni per il dimensionamento di questo tipo di sistema sono disponibili nella nostra guida su RAM, GPU e archiviazione per Agentic AI.


 Amazon