

Con l'evoluzione dell'infrastruttura di intelligenza artificiale, le pipeline di dati diventano più veloci, più estese e sempre più complesse. Dall'addestramento di modelli di grandi dimensioni all'inferenza in tempo reale su larga scala, il sottosistema di storage è essenziale per garantire che le GPU ricevano i dati necessari in modo continuo. Con l'importanza sempre maggiore dello storage nei cluster di intelligenza artificiale, le organizzazioni stanno ripensando a come offrire throughput elevato, prestazioni prevedibili e resilienza, soprattutto in ambienti in cui la perdita di dati o i tempi di inattività sono semplicemente inaccettabili.
La sfida diventa ancora più impegnativa con la continua crescita esponenziale delle dimensioni dei modelli di intelligenza artificiale. I moderni modelli linguistici di grandi dimensioni e i modelli di base richiedono frequenti checkpoint per preservare i progressi di addestramento. Con l'aumento delle dimensioni dei modelli da miliardi a migliaia di miliardi di parametri, i requisiti di archiviazione per questi checkpoint aumentano proporzionalmente. Ciò crea un'urgente necessità di namespace di archiviazione unificati e di grandi dimensioni in grado di gestire file di checkpoint di grandi dimensioni, mantenendo al contempo prestazioni di scrittura e lettura estremamente elevate. Le architetture di archiviazione tradizionali faticano a fornire sia la capacità che la velocità richieste per questi carichi di lavoro impegnativi.
Gli attuali approcci alla gestione dei checkpoint, come il checkpoint asincrono che scarica i pesi dei modelli nella memoria della CPU per consentire alle GPU di continuare l'addestramento, incontrano notevoli limitazioni con la crescita dei modelli. L'archiviazione temporanea di questi checkpoint nella memoria di sistema diventa sempre più dispendiosa e costosa, richiedendo enormi quantità di RAM che fanno lievitare i costi di sistema e il consumo energetico. Ancora più critico, con la continua espansione delle dimensioni dei modelli, questo approccio potrebbe diventare del tutto impraticabile a causa dell'enorme volume di dati che dovrebbero essere temporaneamente conservati in memoria.
Graid Technology ha introdotto un nuovo approccio specificamente studiato per affrontare queste sfide. Basandosi sul modello software-defined consolidato in soluzioni precedenti come SupremeRAID SR1010 , il nuovo SupremeRAID AE (AI Edition) di Graid offre funzionalità RAID di livello enterprise per i carichi di lavoro di intelligenza artificiale con modifiche minime all'infrastruttura. Invece di una scheda RAID hardware dedicata o di un'appliance personalizzata, AE viene fornito come licenza software e utilizza solo una piccola parte di una GPU NVIDIA esistente. Ciò significa che le organizzazioni possono ottenere prestazioni e affidabilità di storage di livello enterprise senza 1) consumare slot PCIe aggiuntivi, 2) apportare modifiche all'infrastruttura o 3) subire un impatto significativo sulle prestazioni della GPU per i carichi di lavoro di training e inferenza.
Punti chiave
- Alte prestazioni su larga scala: SupremeRAID AE raggiunge una velocità di lettura fino a 183.60 GB/s e una velocità di scrittura fino a 54.23 GB/s, soddisfacendo i severi requisiti dell'intelligenza artificiale.
- Sovraccarico minimo della GPU: Introduce un overhead minimo (~4%) durante l'inferenza ad alta intensità di GPU, mantenendo elevate le prestazioni complessive del sistema.
- Spazio dei nomi di archiviazione unificato di grandi dimensioni: Supporta fino a 32 SSD NVMe per array, offrendo quasi 1 PB di storage in un singolo namespace unificato.
- Capacità di integrazione avanzate: Si integra completamente con NVIDIA GPUDirect Storage e con i principali file system incentrati sull'intelligenza artificiale (BeeGFS, Lustre, Ceph).
- Infrastruttura semplificata: Elimina l'hardware RAID dedicato, riducendo significativamente la complessità, i costi e le spese generali operative.
Archiviazione e resilienza ottimizzate per carichi di lavoro di intelligenza artificiale avanzati
SupremeRAID AE supporta fino a 32 SSD NVMe in un singolo array, aggregandoli in un namespace unificato. Questa struttura consente ai carichi di lavoro di intelligenza artificiale di accedere in modo efficiente a grandi set di dati mantenendo al contempo la resilienza, aspetto particolarmente importante per gli ambienti che eseguono processi di training di lunga durata. In caso di guasto di un'unità, l'array rimane disponibile e i progressi controllati vengono preservati. Questa protezione riduce al minimo il rischio di perdita di dati o di lunghi riavvii, il che rappresenta un vantaggio significativo per i team che gestiscono modelli di grandi dimensioni o pipeline di inferenza ad alto volume.
Le funzionalità di gestione intelligente delle risorse di SupremeRAID AE offrono ulteriori opportunità di ottimizzazione per i carichi di lavoro di intelligenza artificiale. Sebbene i nostri test dimostrino un overhead minimo durante le operazioni simultanee, l'impatto può essere ulteriormente ridotto tramite una pianificazione intelligente. Le operazioni di checkpoint in genere non vengono eseguite contemporaneamente all'addestramento attivo sullo stesso nodo; di solito si verifica una pausa momentanea nell'addestramento durante le fasi di checkpoint. Durante questi intervalli, SupremeRAID AE può sfruttare ulteriori risorse GPU inutilizzate per accelerare il completamento del checkpoint.
SupremeRAID AE supporta anche NVIDIA GPUDirect Storage. Ciò consente percorsi diretti tra storage e memoria GPU, con conseguente riduzione della latenza e miglioramento dell'efficienza I/O. Si integra con file system basati sull'intelligenza artificiale, come BeeGFS, Lustre e Ceph, e include l'offload intelligente dei dati, insieme ad API pronte per l'orchestrazione per l'automazione. Nel complesso, SupremeRAID AE offre un modo semplificato, ma potente, per integrare i vantaggi del RAID nei moderni flussi di lavoro basati sull'intelligenza artificiale.
Oltre ai carichi di lavoro di training, SupremeRAID AE soddisfa i requisiti critici dei moderni scenari di inferenza AI. Man mano che le organizzazioni scalano le operazioni di inferenza, si affidano sempre più a strategie avanzate come la gestione della cache KV persistente, l'ottimizzazione pre-riempimento-decodifica e le architetture di memoria a livelli. Queste tecniche spesso richiedono l'offload delle cache KV sullo storage quando superano la capacità della VRAM. Soluzioni come NVIDIA Dynamo, LLM-D di Red Hat e lo stack di produzione vLLM incorporano tutte integrazioni di caching KV a livelli che dipendono da storage veloce e ad alta capacità. In questi scenari, disporre di pool di storage ampi e performanti diventa essenziale per mantenere un'inferenza a bassa latenza e la capacità di SupremeRAID AE di fornire sia un'enorme capacità che una velocità eccezionale lo rende una base ideale per queste architetture di inferenza avanzate.
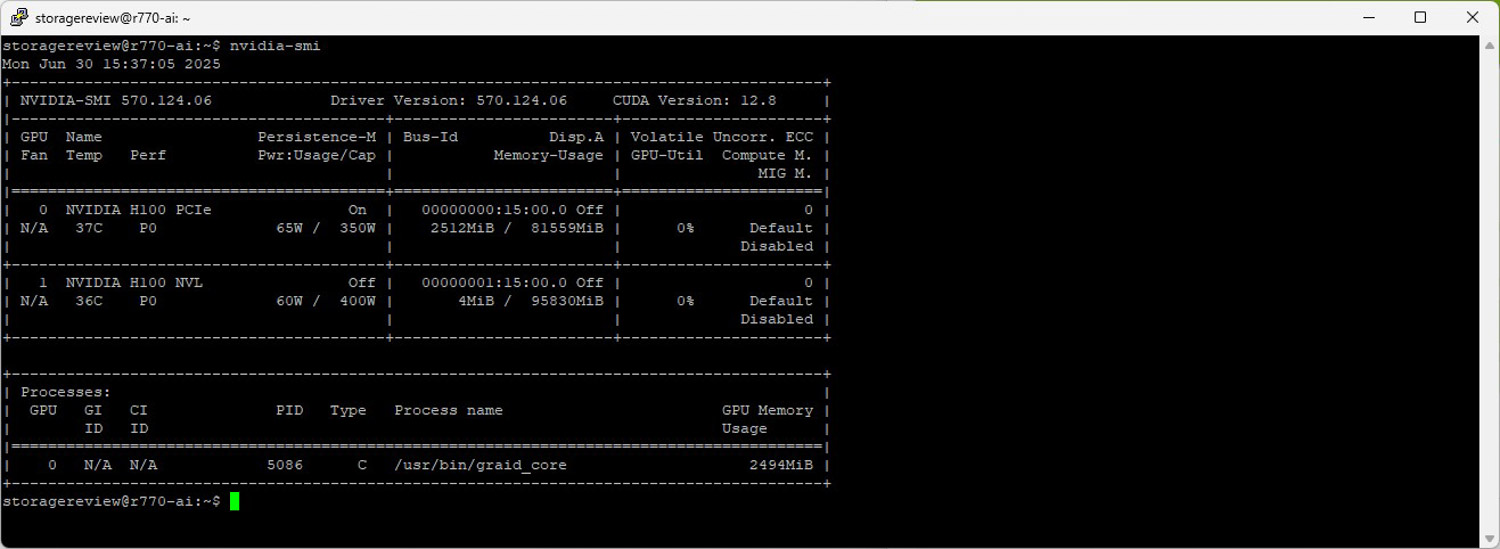
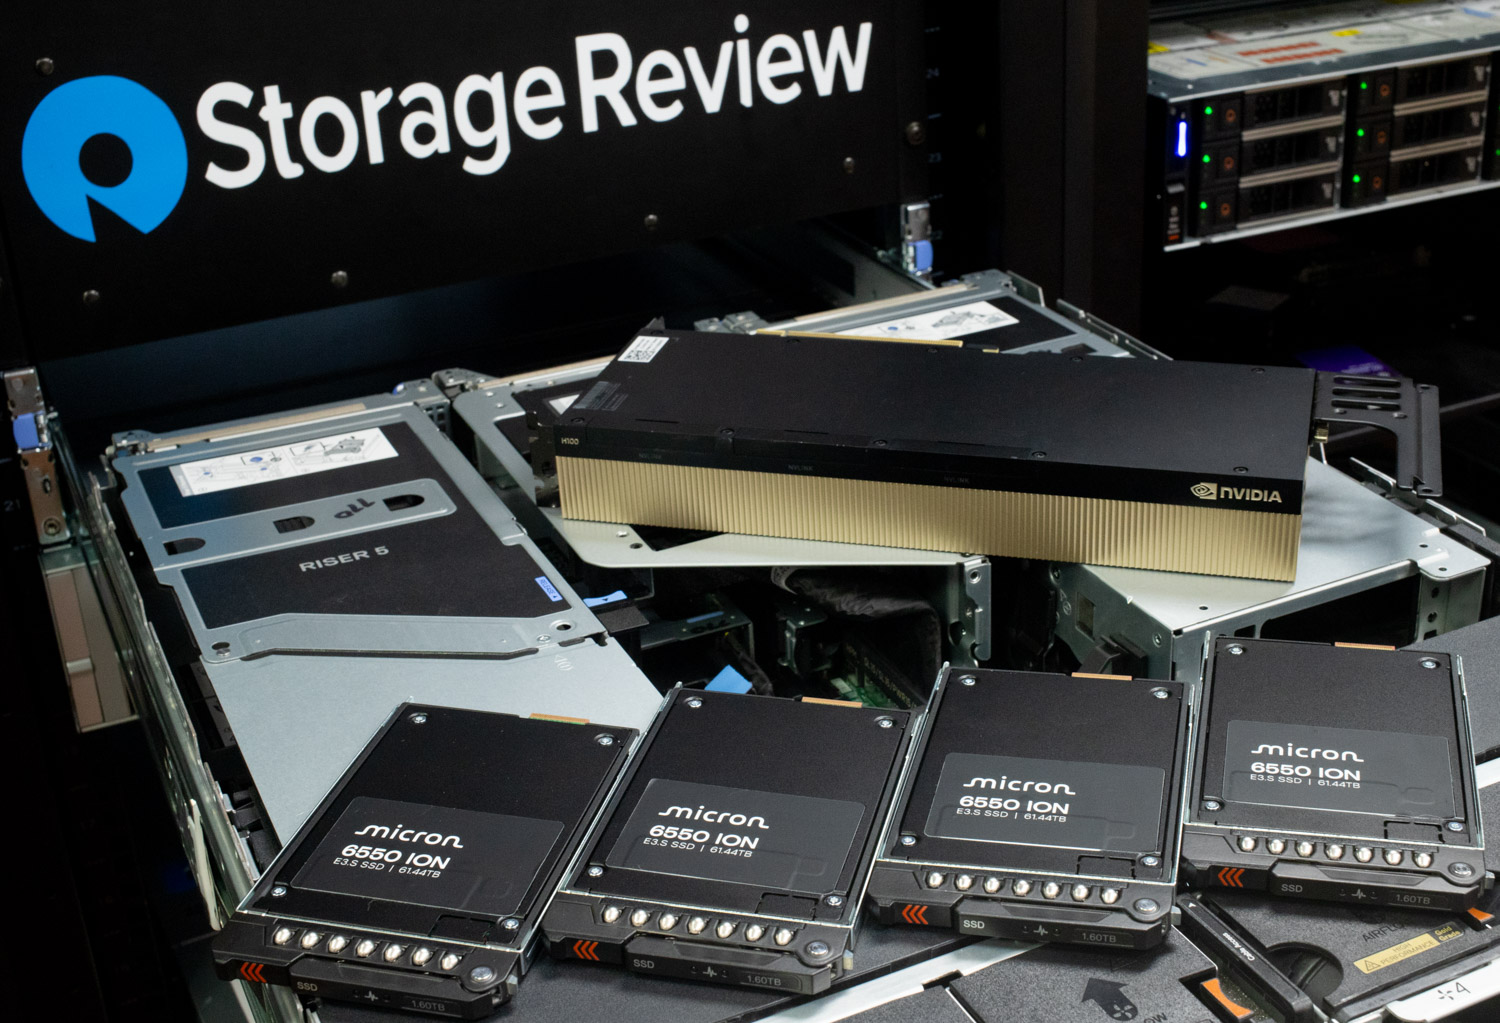
In questa analisi, valutiamo SupremeRAID AE in esecuzione sulla nostra piattaforma Dell PowerEdge R770, dotata di due GPU NVIDIA H100 e 16 SSD Micron 6550 Gen61.44 NVMe da 5 TB. Esploriamo le prestazioni in RAID 5 utilizzando strumenti GDSIO e FIO ed esaminiamo come SupremeRAID AE influisce sul comportamento della GPU durante un carico di lavoro di inferenza LLM in tempo reale. L'obiettivo è comprendere come questa soluzione si integri in ambienti di intelligenza artificiale di livello enterprise, in cui prestazioni, capacità, resilienza e semplicità devono essere scalabili insieme.
Dentro i numeri: analisi approfondita delle prestazioni di SupremeRAID AE
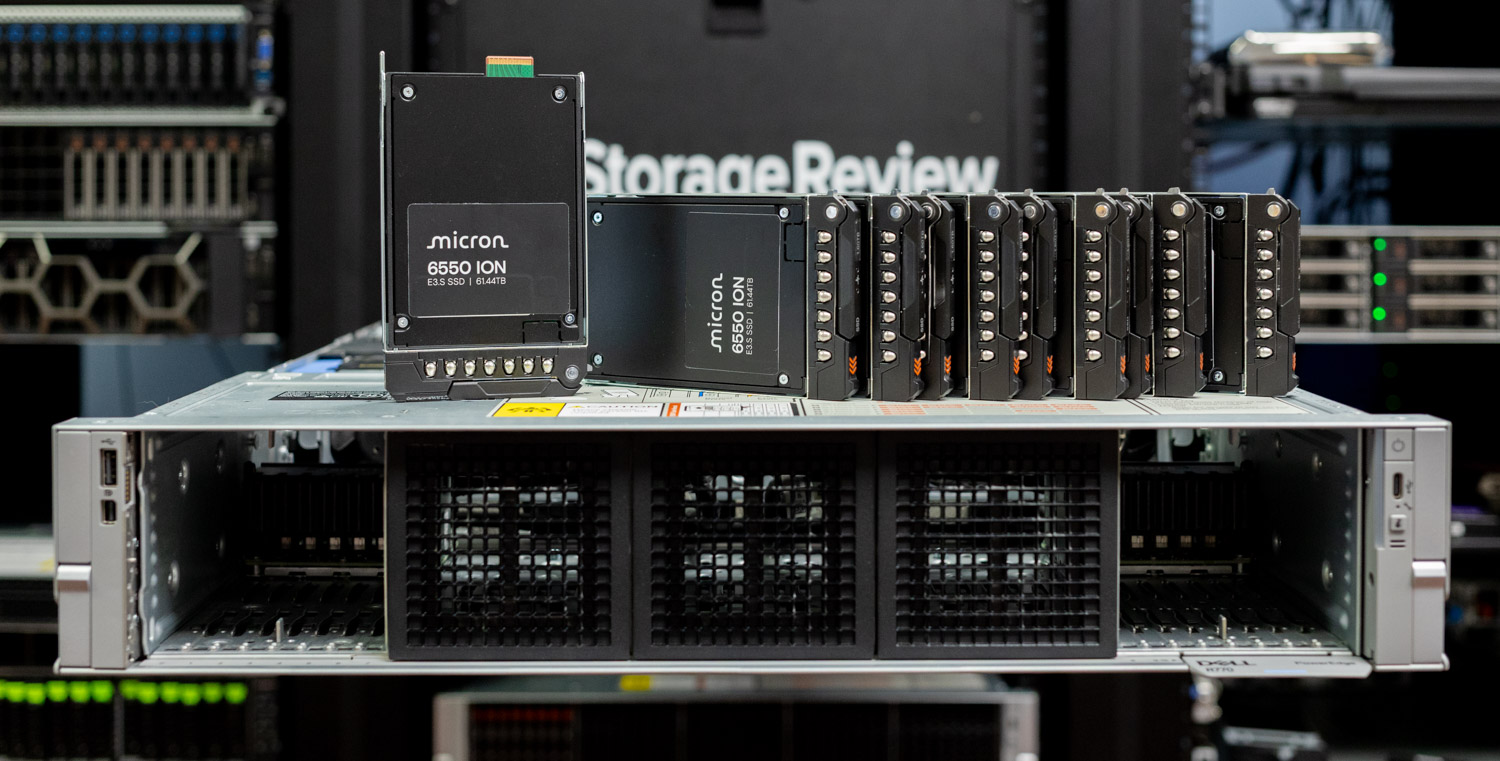
Per testare le prestazioni di Graid SupremeRAID AE, abbiamo configurato un Dell PowerEdge R770 con due GPU NVIDIA H100 e 16 bay E3.S nella parte anteriore. Basato sulla più recente piattaforma Intel Xeon 6, questo sistema è stato configurato con due processori Intel Xeon 6787P, ciascuno con 86 core, per gestire carichi di lavoro altamente paralleli in ambienti di intelligenza artificiale, HPC e data-heavy.
Il modello R770 è stato configurato con 16 bay E3.S e lo storage è stato interamente popolato con SSD Micron 6550 ION Gen61.44 NVMe TLC da 5 TB, progettati per offrire prestazioni costanti su un'ampia gamma di carichi di lavoro. Gli SSD Micron offrono un equilibrio ideale tra prestazioni eccezionali e capacità elevata, consentendo ai carichi di lavoro di intelligenza artificiale di mantenere un throughput elevato e semplificando drasticamente l'infrastruttura di intelligenza artificiale. Con un petabyte di storage in sole 16 unità, le organizzazioni possono gestire in modo efficiente set di dati estesi e checkpoint di modelli su larga scala all'interno di un singolo server, riducendo significativamente la complessità e il sovraccarico infrastrutturale.
Test delle specifiche del sistema
- Piattaforma: Dell PowerEdge R770
- CPU: 2x Intel Xeon 6787P (86 core ciascuno)
- Memoria: 32x Micron 64 GB Dual-Rank DDR5 6400 MT/s Memoria totale: 2 TB
- Networking: Scheda di rete OCP Dell BRCM 4P 25G SFP 57504S
- GPU 1: NVIDIA H100 (VRAM 80 GB)
- GPU 2: NVIDIA H100NVL (VRAM 96 GB)
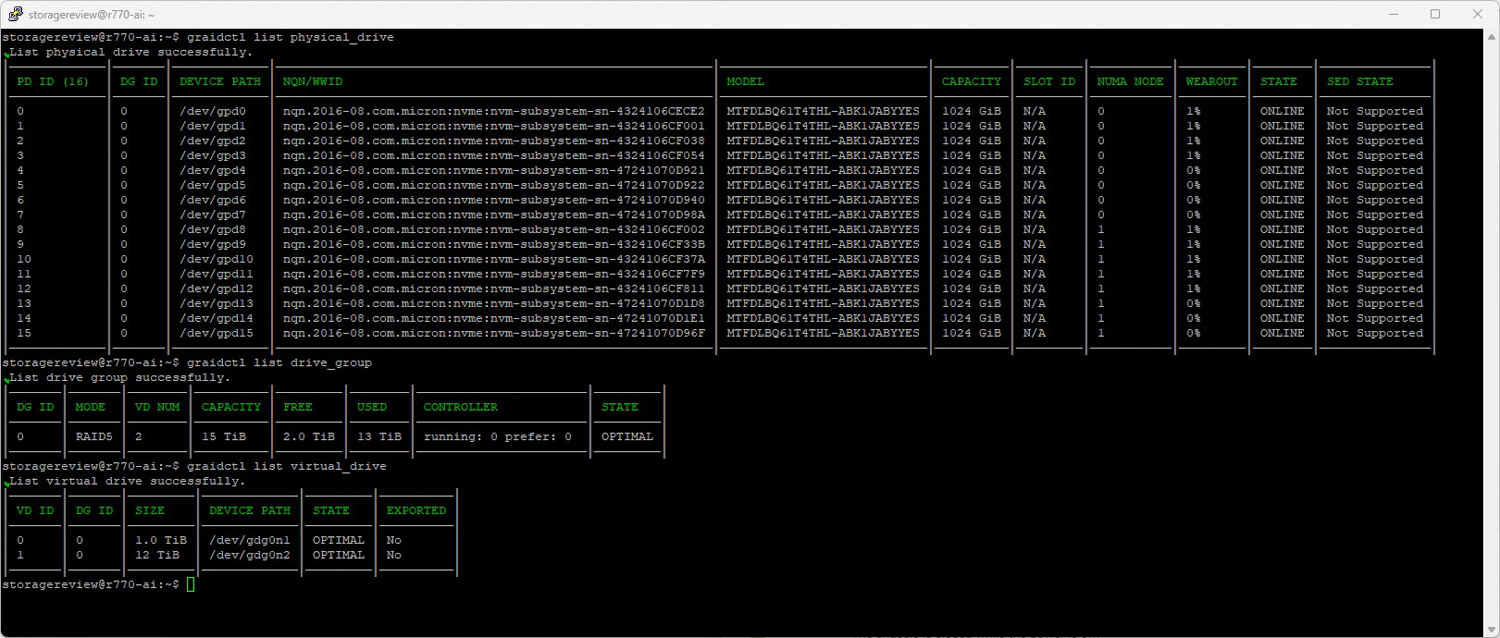
- Memoria su disco: 16 x Micron ION 61 da 6550 TB SSD (pool RAID 915 da 5 TB)
Nell'ambito di questo test prestazionale, gli SSD Micron sono stati configurati in un singolo pool RAID 5 utilizzando SupremeRAID AE. Questo layout è stato scelto per valutare l'efficacia di SupremeRAID AE nel bilanciare prestazioni e tolleranza ai guasti in un ambiente basato sull'intelligenza artificiale che richiede storage ad alta capacità. RAID 5 distribuisce la parità su tutte le unità, proteggendo dai guasti di singole unità e mantenendo al contempo una capacità di storage utilizzabile.
Prima di addentrarci nei test delle prestazioni, è importante notare le differenze tra GDSIO e FIO quando si misurano le prestazioni di storage utilizzando Graid. Nelle nostre precedenti valutazioni delle prestazioni di Graid, un'osservazione cruciale è che non ci sono colli di bottiglia (come una scheda RAID hardware) che limitano la larghezza di banda di picco. Le schede RAID hardware gestiscono i dispositivi di storage a loro collegati e lo slot PCIe può diventare un collo di bottiglia in questo processo. Graid utilizza una GPU per le operazioni RAID, ma non tutti i dati devono attraversarla. Di conseguenza, la GPU non limita la larghezza di banda.
Il benchmark di storage FIO misura le prestazioni di storage utilizzando la CPU per accedere allo storage ed è limitato solo dalla soluzione di storage. GDSIO, invece, misura le prestazioni di GPU Direct Storage, dove la GPU può rappresentare il fattore limitante. La NVIDIA H100, ad esempio, ha un'interfaccia PCIe Gen5 x16 ed è in grado di gestire circa 63 GB/s di larghezza di banda in ingresso e in uscita. Quando si parla di colli di bottiglia delle prestazioni della GPU in questo contesto, il problema è legato alla larghezza di banda che la GPU può supportare con GPU Direct Storage, non a un collo di bottiglia Graid.
Archiviazione diretta GPU NVIDIA
Uno dei test che abbiamo condotto su questo banco di prova è stato il test Magnum IO GPU Direct Storage (GDS). GDS è una funzionalità sviluppata da NVIDIA che consente alle GPU di bypassare la CPU quando accedono ai dati archiviati su unità NVMe o altri dispositivi di archiviazione ad alta velocità. Invece di instradare i dati attraverso la CPU e la memoria di sistema, GDS consente la comunicazione diretta tra la GPU e il dispositivo di archiviazione, riducendo significativamente la latenza e migliorando la velocità di elaborazione dei dati.
Come funziona l'archiviazione diretta GPU
Tradizionalmente, quando una GPU elabora dati archiviati su un'unità NVMe, i dati devono prima passare attraverso la CPU e la memoria di sistema prima di raggiungere la GPU. Questo processo introduce colli di bottiglia, poiché la CPU diventa un intermediario, aggiungendo latenza e consumando preziose risorse di sistema. GPU Direct Storage elimina questa inefficienza consentendo alla GPU di accedere ai dati direttamente dal dispositivo di archiviazione tramite il bus PCIe. Questo percorso diretto riduce il sovraccarico associato allo spostamento dei dati, consentendo trasferimenti di dati più rapidi ed efficienti.
I carichi di lavoro AI, in particolare quelli che coinvolgono il deep learning, sono altamente intensivi in termini di dati. L'addestramento di grandi reti neurali richiede l'elaborazione di terabyte di dati e qualsiasi ritardo nel trasferimento dei dati può portare a GPU sottoutilizzate e tempi di addestramento più lunghi. GPU Direct Storage affronta questa sfida assicurando che i dati vengano consegnati alla GPU il più rapidamente possibile, riducendo al minimo i tempi di inattività e massimizzando l'efficienza computazionale.
Inoltre, GDS è particolarmente utile per carichi di lavoro che comportano lo streaming di grandi set di dati, come l'elaborazione video, l'elaborazione del linguaggio naturale o l'inferenza in tempo reale. Riducendo la dipendenza dalla CPU, GDS accelera lo spostamento dei dati e libera risorse della CPU per altre attività, migliorando ulteriormente le prestazioni complessive del sistema.
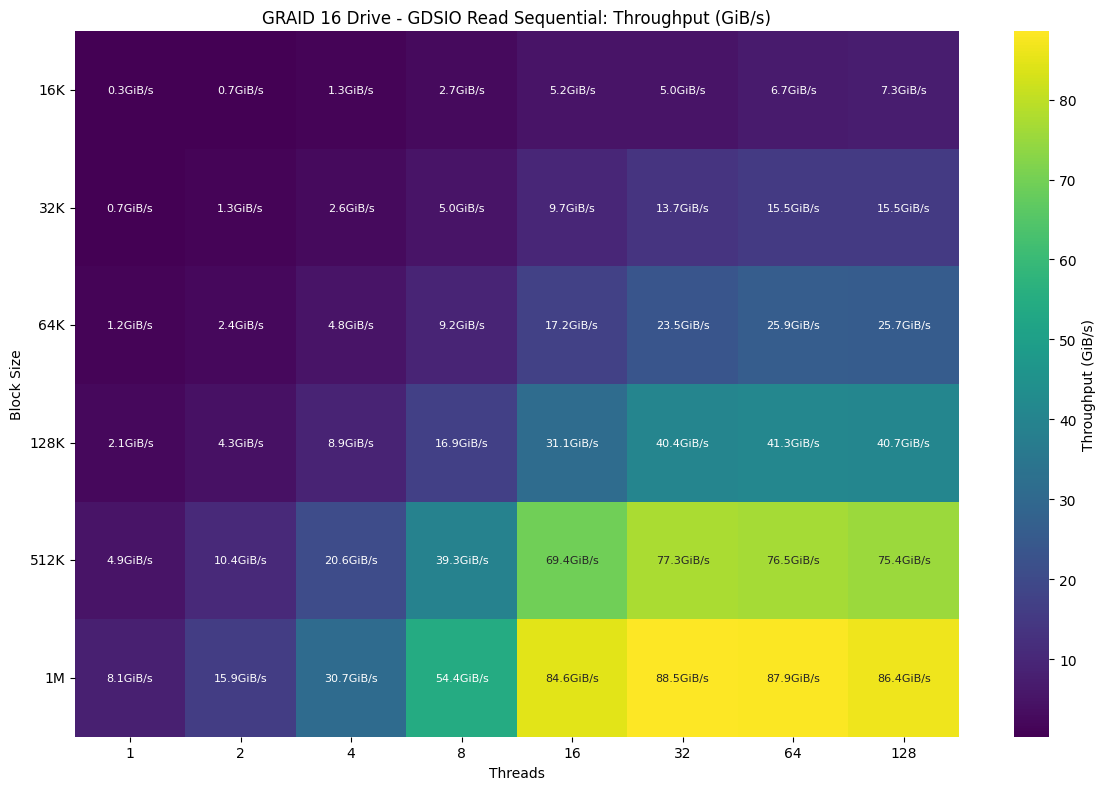
Velocità di lettura casuale dell'unità GDSIO 16
Prima di addentrarci nei numeri delle prestazioni, è essenziale notare che il fattore limitante nelle prestazioni di lettura e scrittura con i valori GDSIO è la/le GPU. Il test è progettato per misurare le massime prestazioni di archiviazione che possono essere erogate o erogate dalla GPU. Alla fine si incontrerà un collo di bottiglia nello slot PCIe, che per PCIe Gen5 x16 è di circa 63 GB/s.
Per quanto riguarda il throughput di lettura casuale GDSIO, l'array ha ottenuto i risultati migliori con blocchi di dimensioni maggiori e un numero di thread più elevato, pur avendo difficoltà a scalare in modo efficiente ai livelli più bassi. A 16K/128 thread, le cose hanno iniziato a migliorare in modo più evidente, raggiungendo 7.3 GiB/s, ma la vera accelerazione del throughput non è avvenuta fino a 32K e oltre, dove l'array ha raggiunto 15.5 GiB/s con 64 thread. Sono stati osservati guadagni sostanziali a 64K, salendo a 25.9 GiB/s, e le prestazioni sono decollate da 128K, che ha raggiunto 41.3 GiB/s a 64 thread e si è mantenuto sopra i 40 GiB/s con 128 thread. Il throughput massimo è stato raggiunto a blocchi di 1M con 32 thread, dove l'array ha raggiunto 88.5 GiB/s e ha mantenuto tale livello anche con i conteggi di thread più elevati.
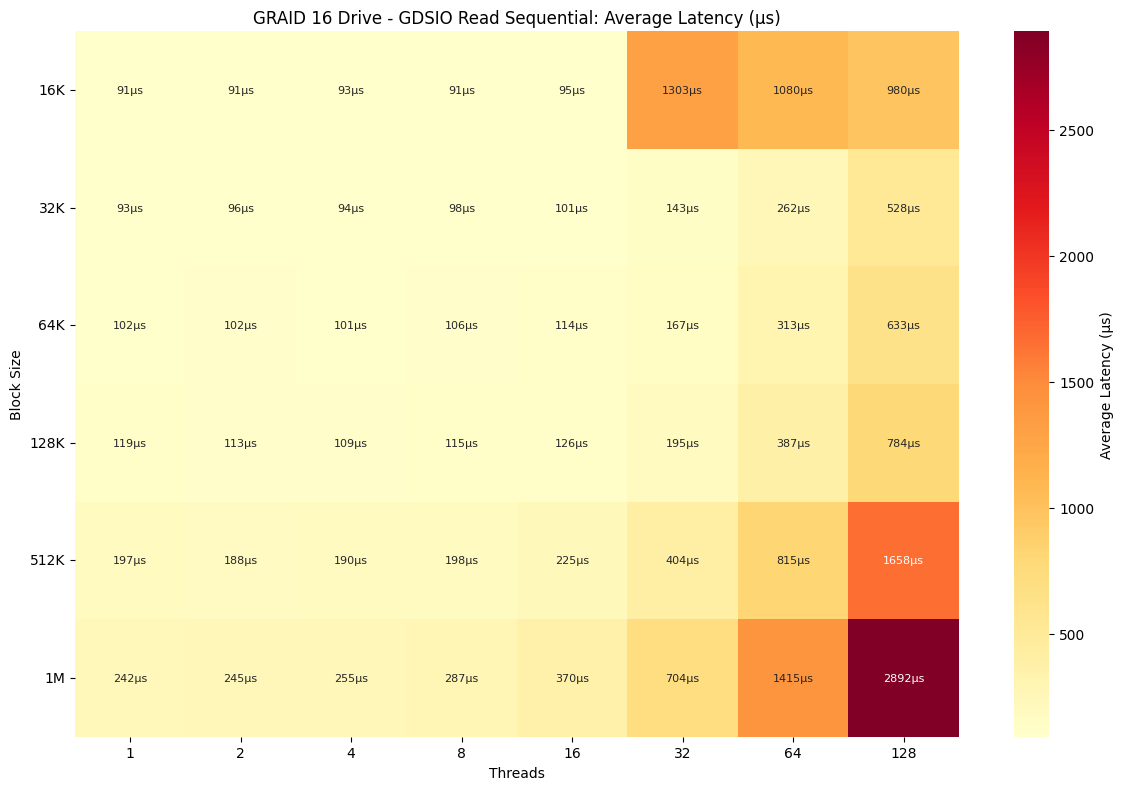
Latenza di lettura casuale dell'unità GDSIO 16
In seguito ai risultati del throughput, il profilo di latenza delle letture casuali dell'array ha rispecchiato il comportamento di scalabilità osservato in precedenza. La latenza è rimasta eccezionalmente bassa su tutte le dimensioni dei blocchi e i conteggi dei thread fino a 16 thread, con valori inferiori a 0.1 ms per tutti i blocchi fino a 128K. Anche i blocchi più grandi, come 128K, si sono mantenuti tra 0.13 ms e 0.20 ms. Oltre i 16 thread, tuttavia, la latenza è aumentata notevolmente. A 16K/32 thread, la latenza ha continuato ad aumentare, raggiungendo infine 980 ms a 128 thread. Analogamente, le letture da 1M, che hanno registrato il throughput più elevato, sono aumentate da 0.242 ms a un thread a 2.892 ms a 128 thread. La tendenza è stata costante su tutte le dimensioni, poiché la latenza è rimasta stabile in condizioni di concorrenza moderata, ma è aumentata bruscamente con l'aumentare del numero di thread oltre i 32, in particolare con blocchi di dimensioni maggiori.
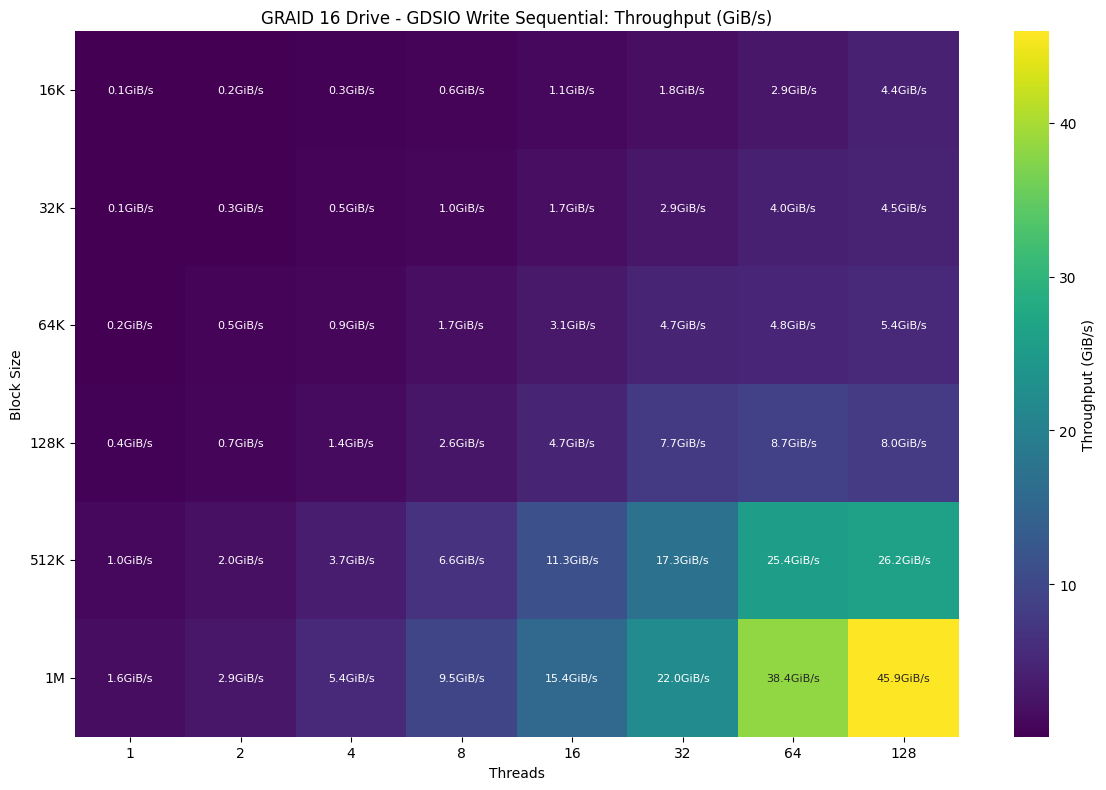
Velocità di scrittura casuale dell'unità GDSIO 16
Passando alla velocità di scrittura GDSIO, l'array ha nuovamente mostrato ottime prestazioni a blocchi di dimensioni maggiori, scalando complessivamente in modo più graduale rispetto alle letture. Le prestazioni hanno iniziato a migliorare in modo più significativo a partire da 32K, dove la velocità ha superato i 5.9 GiB/s, e soprattutto a 64 thread e oltre, dove blocchi da 512K e 1M hanno fornito guadagni sostenuti anche con conteggi di thread elevati. A 64 thread e oltre, le scritture da 512K hanno raggiunto 25.4 GiB/s e quelle da 1M hanno raggiunto un picco di 38.4 GiB/s, mentre a 128 thread, le scritture da 1M hanno continuato a scalare fino a un picco massimo di 45.9 GiB/s. Anche le dimensioni dei blocchi di 512K e 128K sono rimaste costanti ad alta concorrenza, stabilizzandosi rispettivamente intorno a 26.2 GiB/s e 8.0 GiB/s.
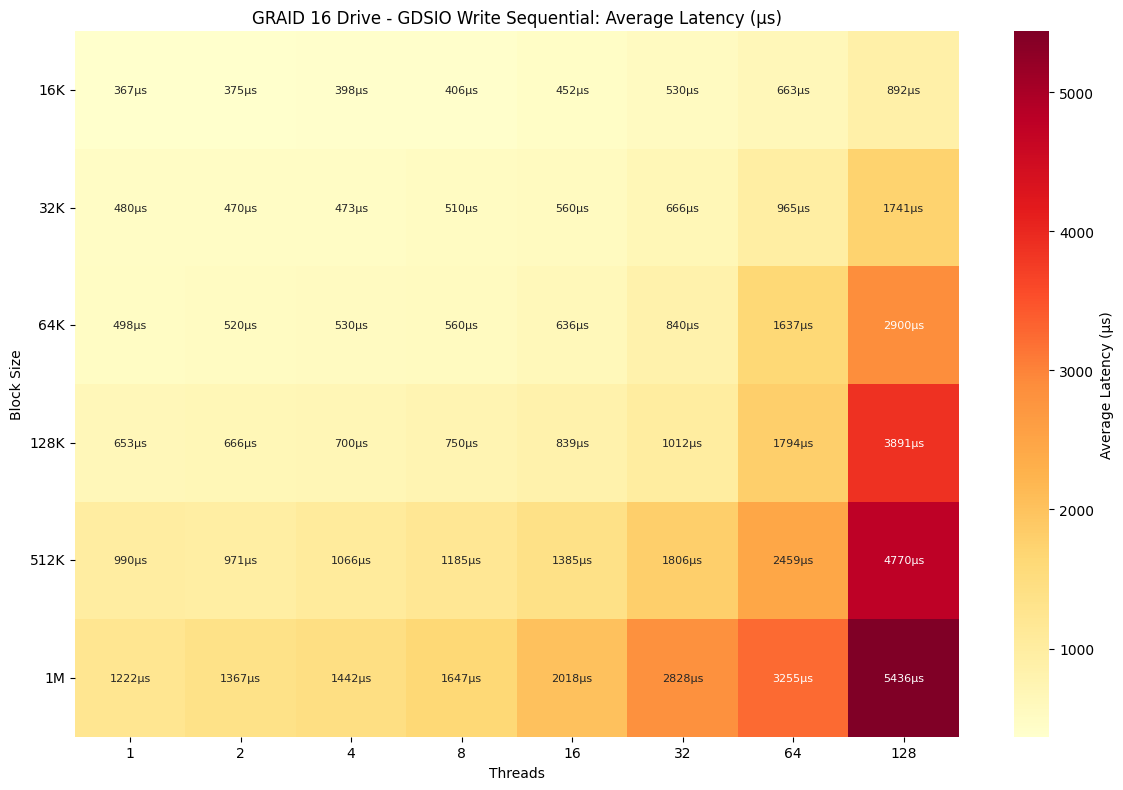
Latenza di scrittura casuale dell'unità GDSIO 16
A seguito del forte aumento della velocità di scrittura, il profilo di latenza per le scritture casuali sull'array ha mostrato un aumento costante con l'aumentare della dimensione del blocco e del numero di thread. Anche con un basso numero di thread, la latenza in scrittura è iniziata notevolmente più alta rispetto alle letture, partendo da 0.367 ms e aumentando con ogni dimensione del blocco fino a 1.222 ms a 1M. Con l'aumento della concorrenza, la latenza è aumentata gradualmente fino a 16 thread, per poi accelerare in modo più aggressivo. A 64 thread, le scritture hanno raggiunto 0.663 ms, mentre le scritture a 1M hanno raggiunto 3.255 ms. A 128 e 256 thread, la latenza è diventata significativamente elevata, in particolare con blocchi di grandi dimensioni. Ad esempio, le scritture a 512K hanno raggiunto 4.770 ms a 128 thread, mentre 512K e 1M hanno superato la soglia dei 5 ms, raggiungendo un massimo di 5.436 ms a 1M.
FIO Benchmark delle prestazioni
Passiamo ora alla misurazione delle prestazioni FIO nel singolo pool RAID5. Mentre il GDSIO dipende in ultima analisi dalle prestazioni delle GPU installate nel sistema e dalla loro larghezza di banda PCIe, il FIO può aumentare in base alle prestazioni degli SSD e della soluzione RAID stessa.
L'intero array viene sottoposto a un processo di test coerente, a partire da una fase di precondizionamento che consiste in due riempimenti a volume pieno utilizzando un carico di lavoro di scrittura sequenziale, seguito dai nostri carichi di lavoro sequenziali e casuali. Questo garantisce che le unità raggiungano una condizione di stato stazionario prima dell'inizio della misurazione delle prestazioni.
Per ogni nuovo tipo di carico di lavoro, abbiamo riavviato il precondizionamento utilizzando la dimensione di trasferimento corrispondente per mantenere l'accuratezza e la coerenza nei risultati.
Questa sezione evidenzia i seguenti benchmark FIO di scrittura/lettura casuale applicati all'array RAID 16 SSD Graid 5:
- Scrittura/lettura casuale 1M
- Scrittura/lettura casuale 64K
- Scrittura/lettura casuale 16K
- Scrittura/lettura casuale 4K
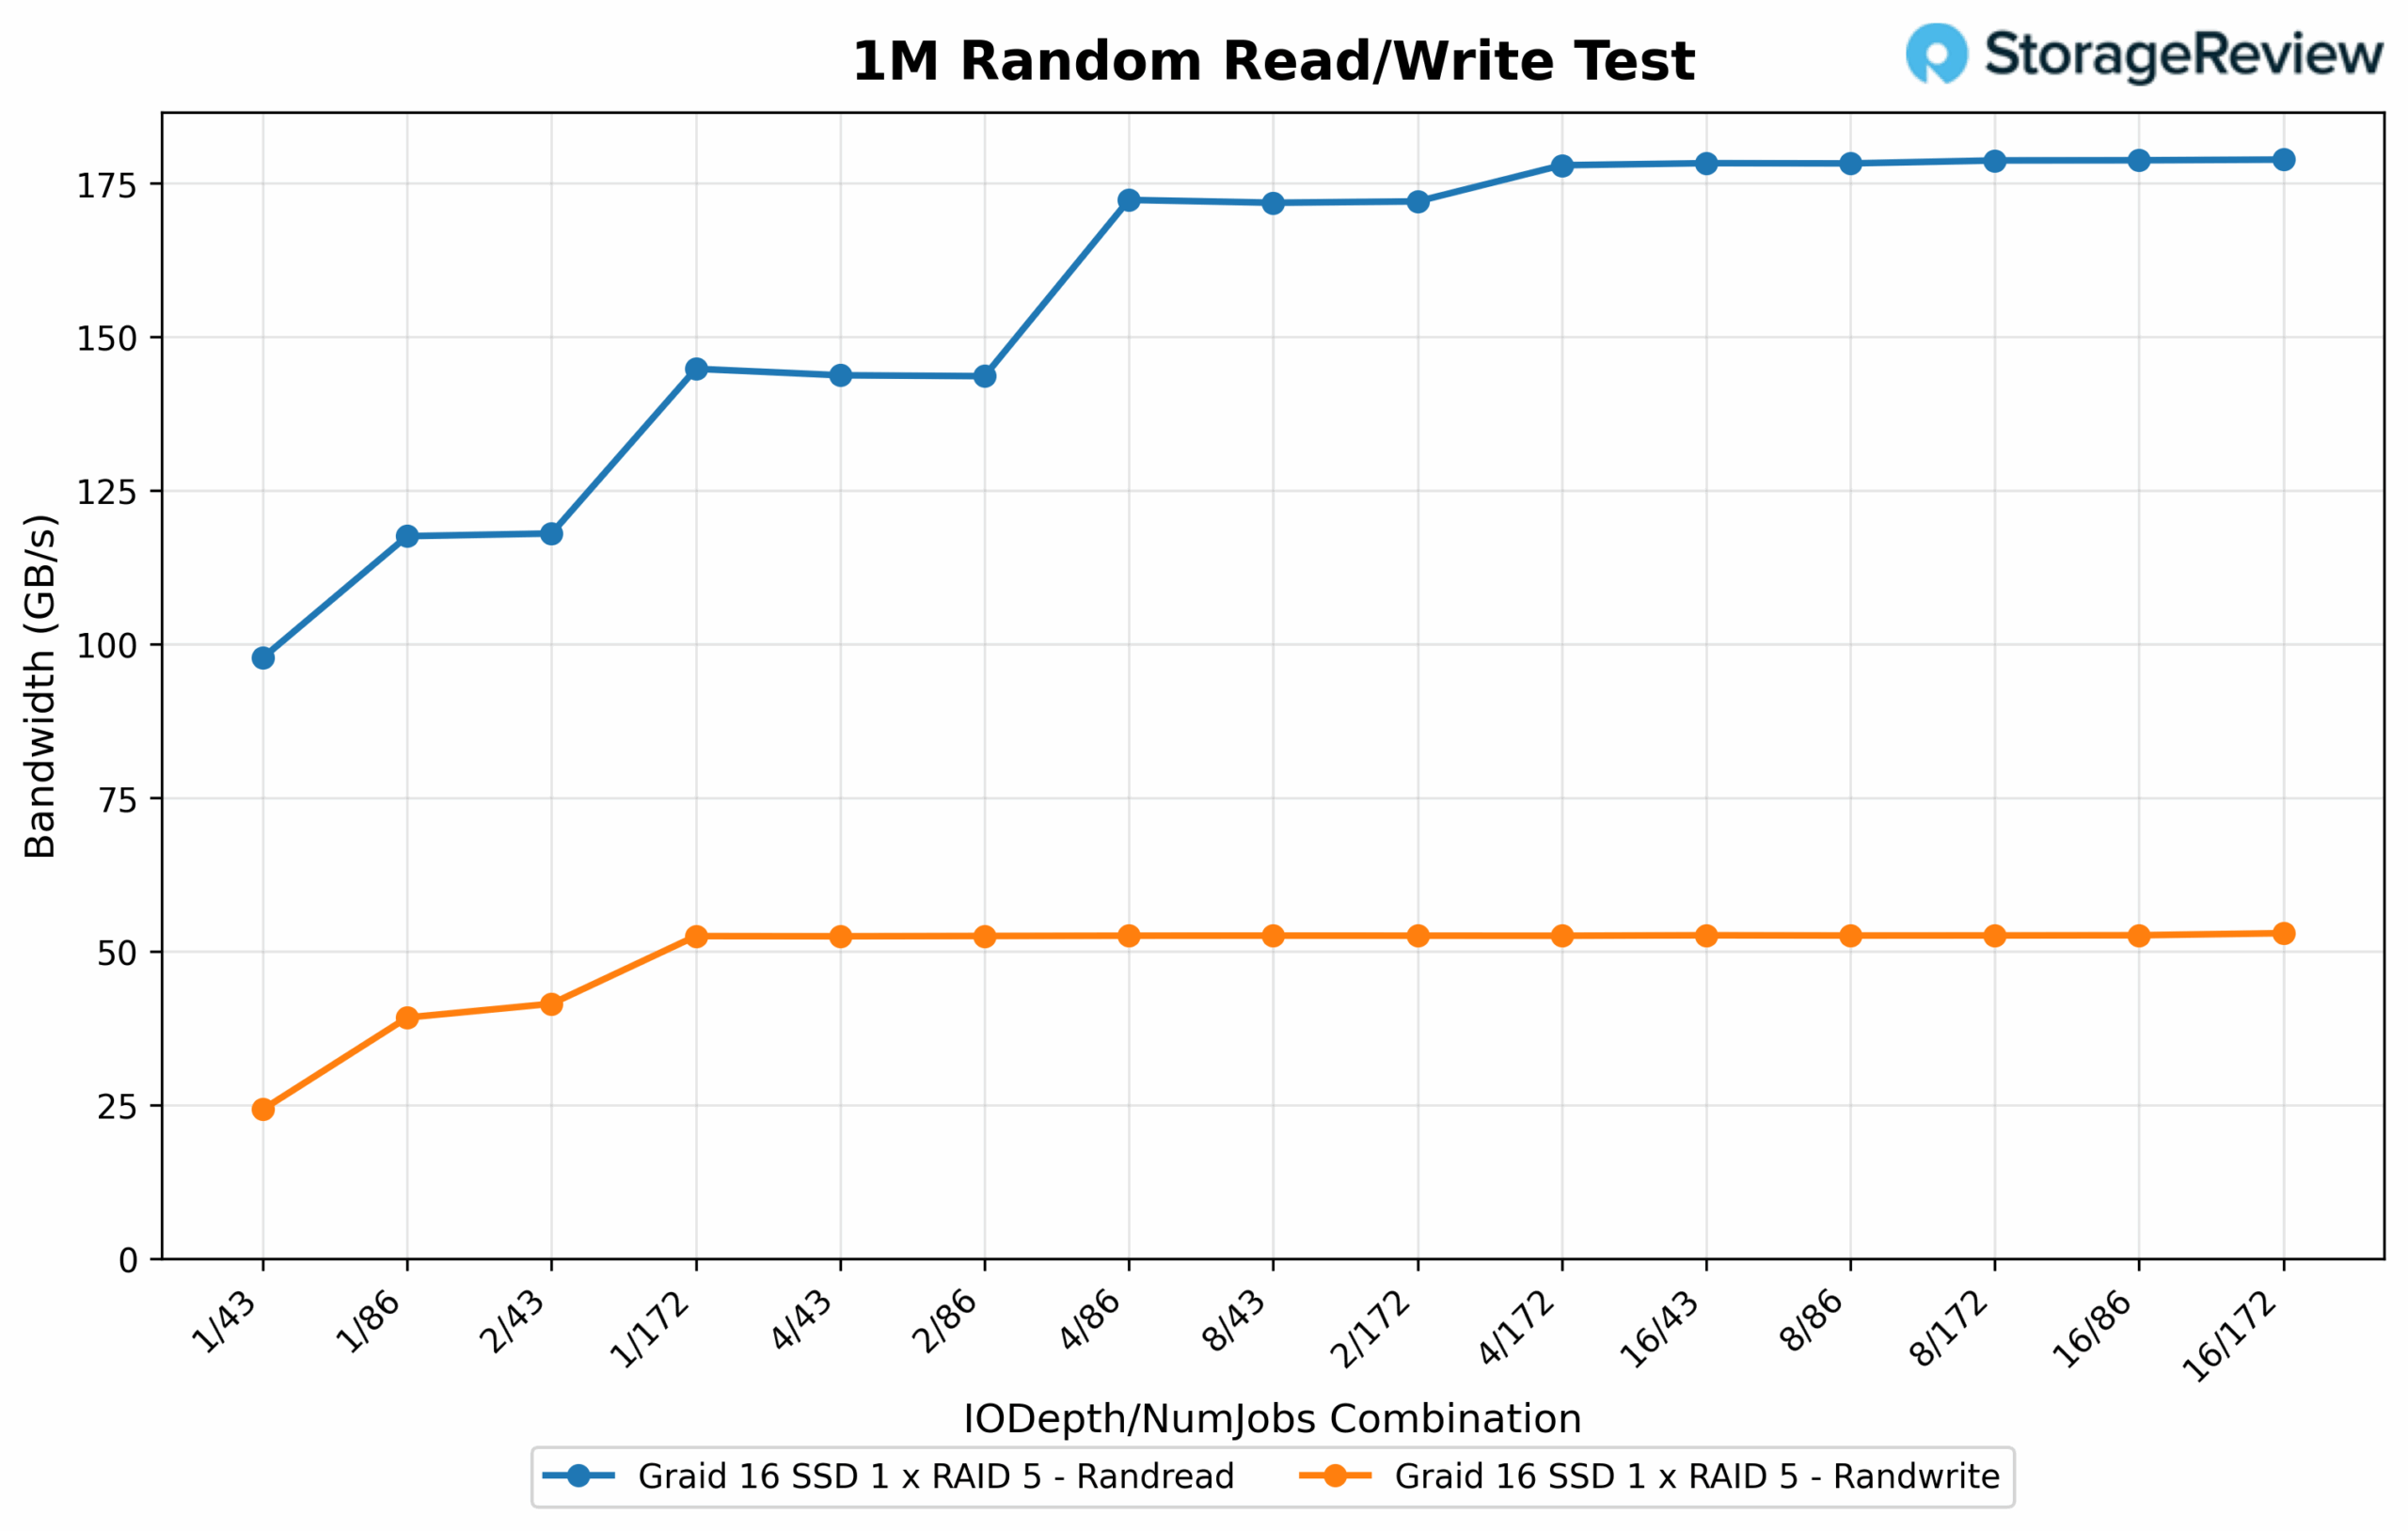
Larghezza di banda di lettura/scrittura casuale 1M
Passando alle operazioni casuali da 1M, la larghezza di banda in lettura ha guidato la curva delle prestazioni raggiungendo un picco di 183.60 GB/s utilizzando una profondità di I/O di 16 con 172 job, la configurazione più aggressiva testata. Risultati simili in termini di throughput elevato sono stati registrati con 8/172 e 4/172, entrambi superiori a 182 GB/s, il che evidenzia la capacità dell'array di scalare con l'aumento del numero e della profondità dei job. Anche le configurazioni di fascia media come 4/86 e 16/43 hanno mantenuto una buona tenuta, mantenendo oltre 147 GB/s, mostrando prestazioni di lettura costanti su diversi livelli di concorrenza. Passando alle scritture, la larghezza di banda casuale da 1M ha raggiunto un picco di 54.233 GB/s a 8/172, con un valore quasi identico di 53.77 GB/s a 2/86, convalidando l'efficiente scalabilità in scrittura con carichi di lavoro paralleli. Le prestazioni sono diminuite gradualmente nelle combinazioni con thread inferiori come 1/43 e 2/43, che hanno prodotto rispettivamente 24.88 GB/s e 42.48 GB/s, riflettendo comunque una forte curva di saturazione anche a livelli di concorrenza moderati.
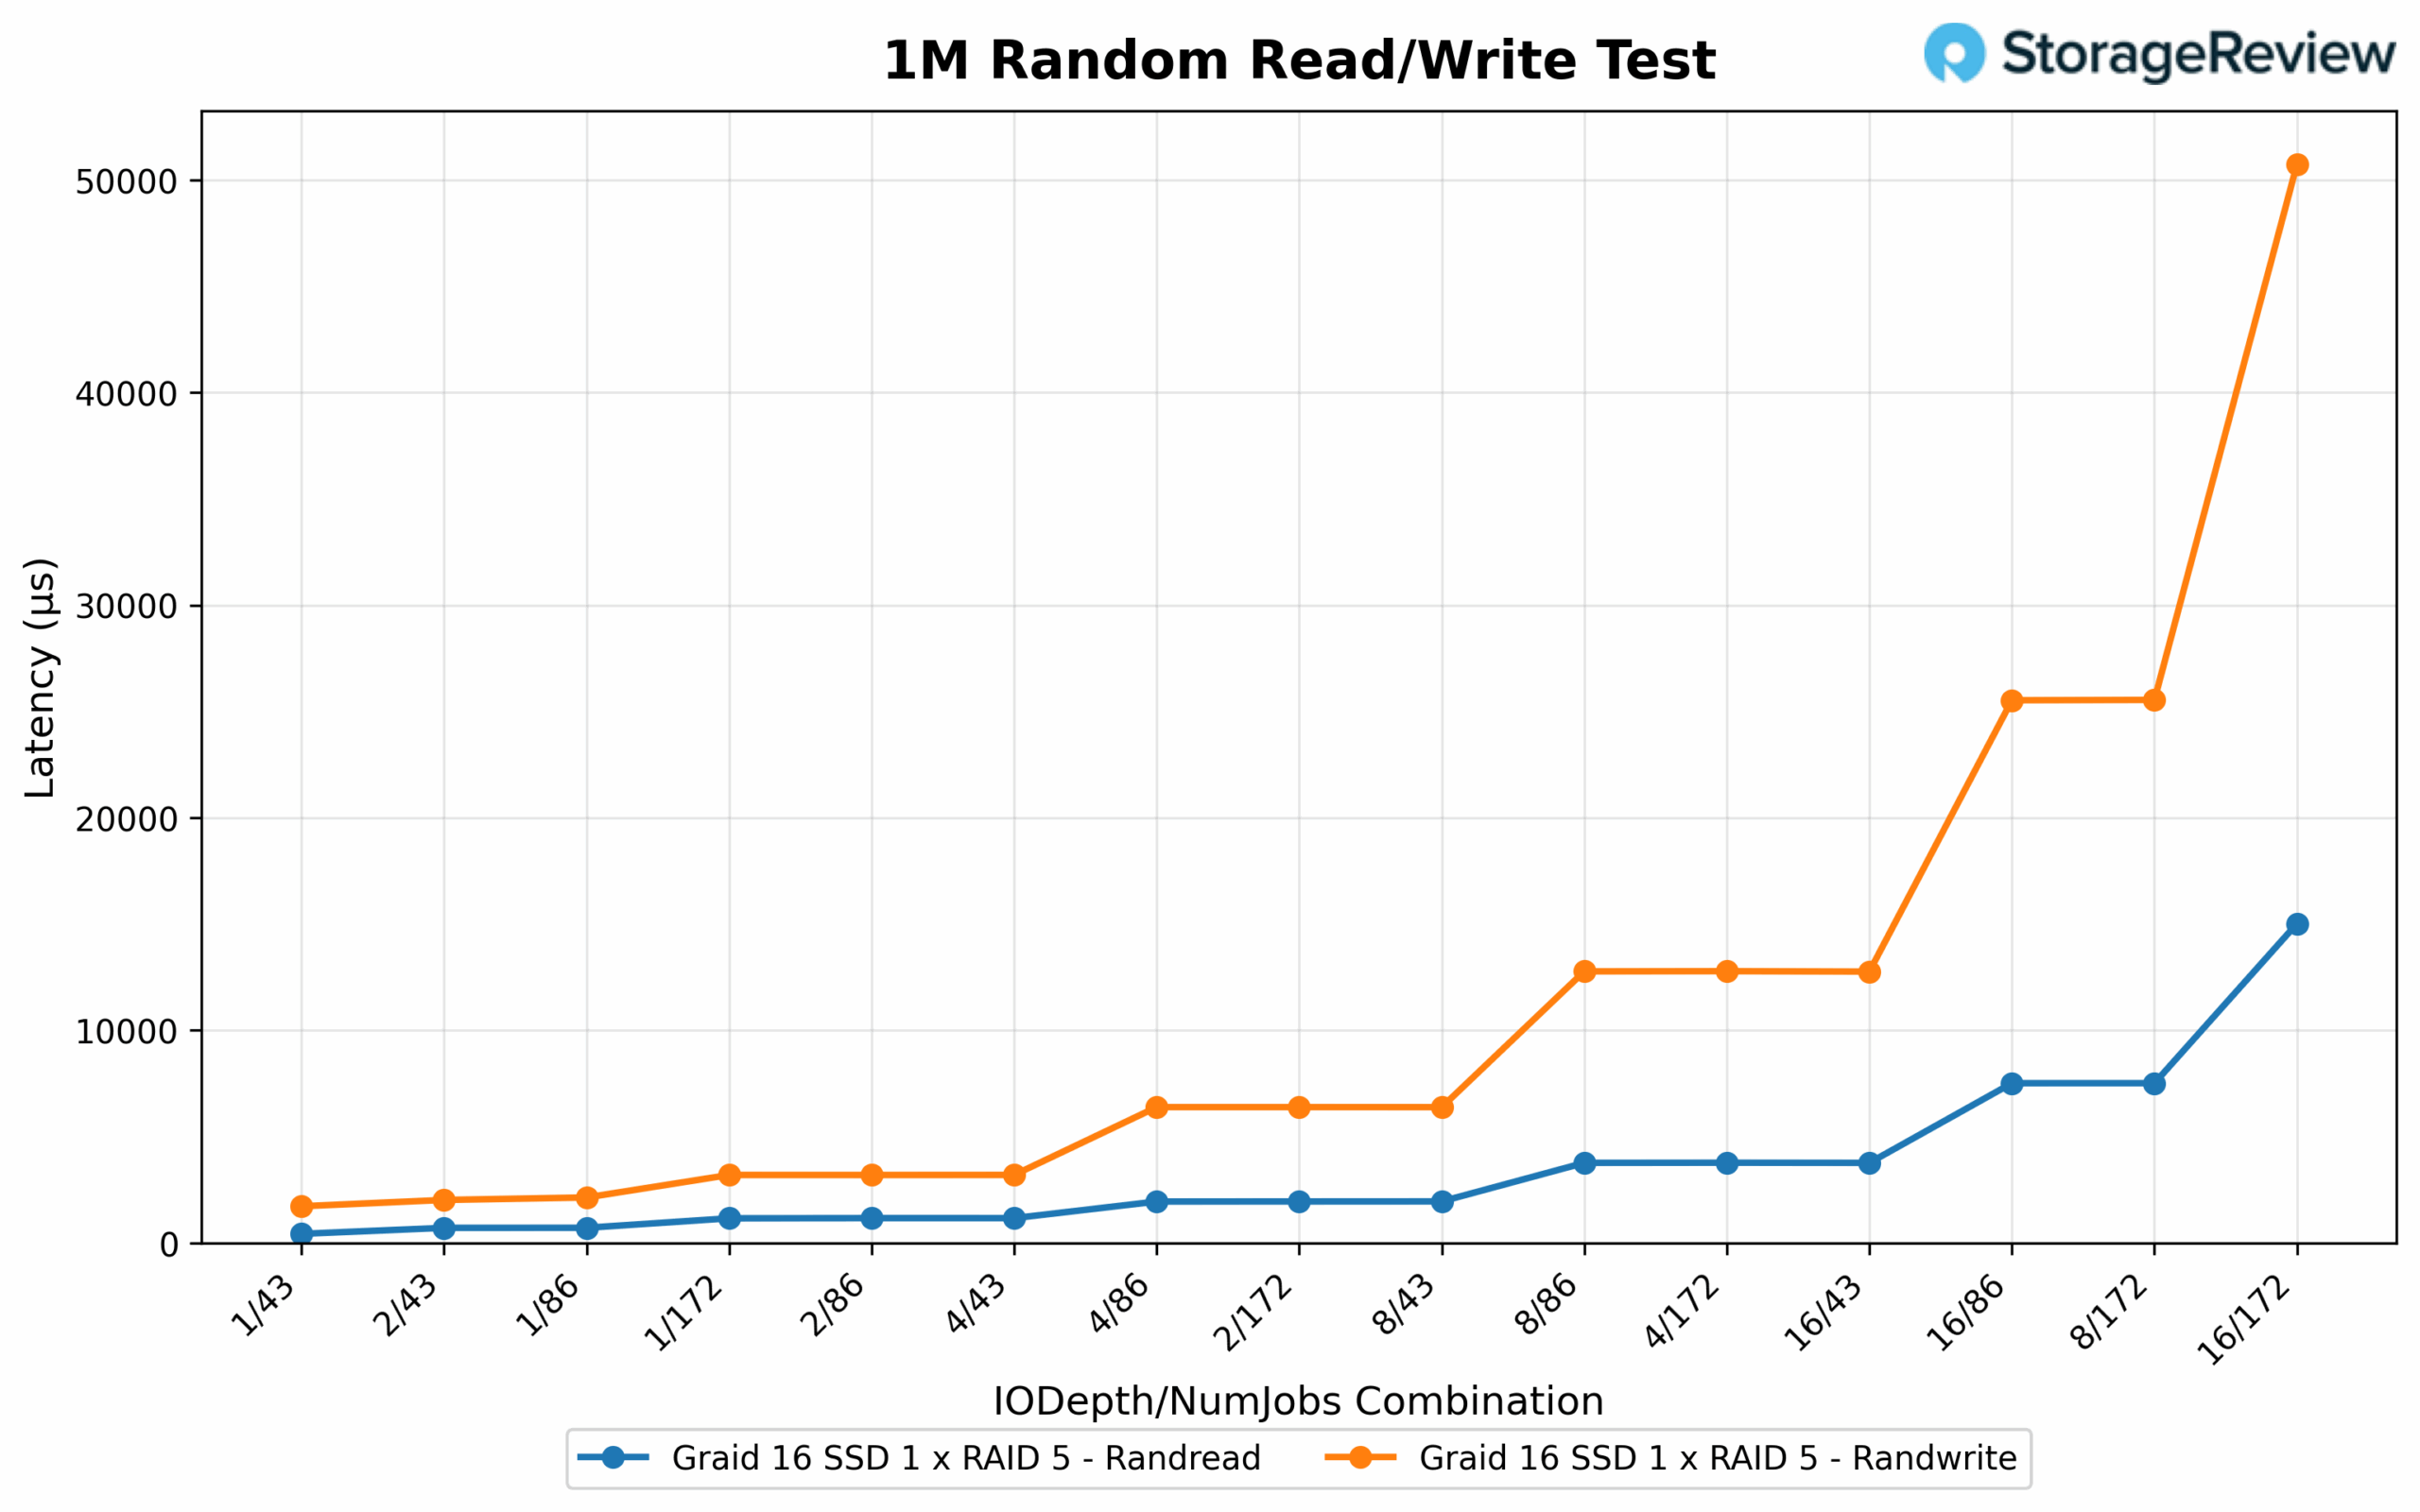
Latenza di lettura/scrittura casuale di 1M
La latenza è rimasta sotto controllo per le letture durante l'intero intervallo di test. La latenza più bassa osservata è stata di 0.714 ms sia a 2/86 che a 4/86, mentre carichi a profondità maggiore come 8/172 e 4/172 sono rimasti al di sotto dei 2 ms. La configurazione che ha prodotto la maggiore velocità di lettura, 16/172, ha registrato la latenza più elevata, pari a 7.516 ms, un chiaro compromesso, poiché code più profonde aumentavano i tempi di risposta. Sul lato scrittura, la latenza ha seguito un andamento simile. La latenza di scrittura più bassa è stata misurata a 1.727 ms con 1/43. Un solido equilibrio tra velocità di lettura e latenza è stato raggiunto a 2/86 con 3.197 ms. Le opzioni di concorrenza più elevate, come 8/43, hanno registrato 6.389 ms, mentre la configurazione 16/172, pur garantendo prestazioni di scrittura di picco, ha registrato la latenza più elevata a 50.741 ms, sottolineando la nota relazione inversa tra throughput e reattività a profondità estreme.
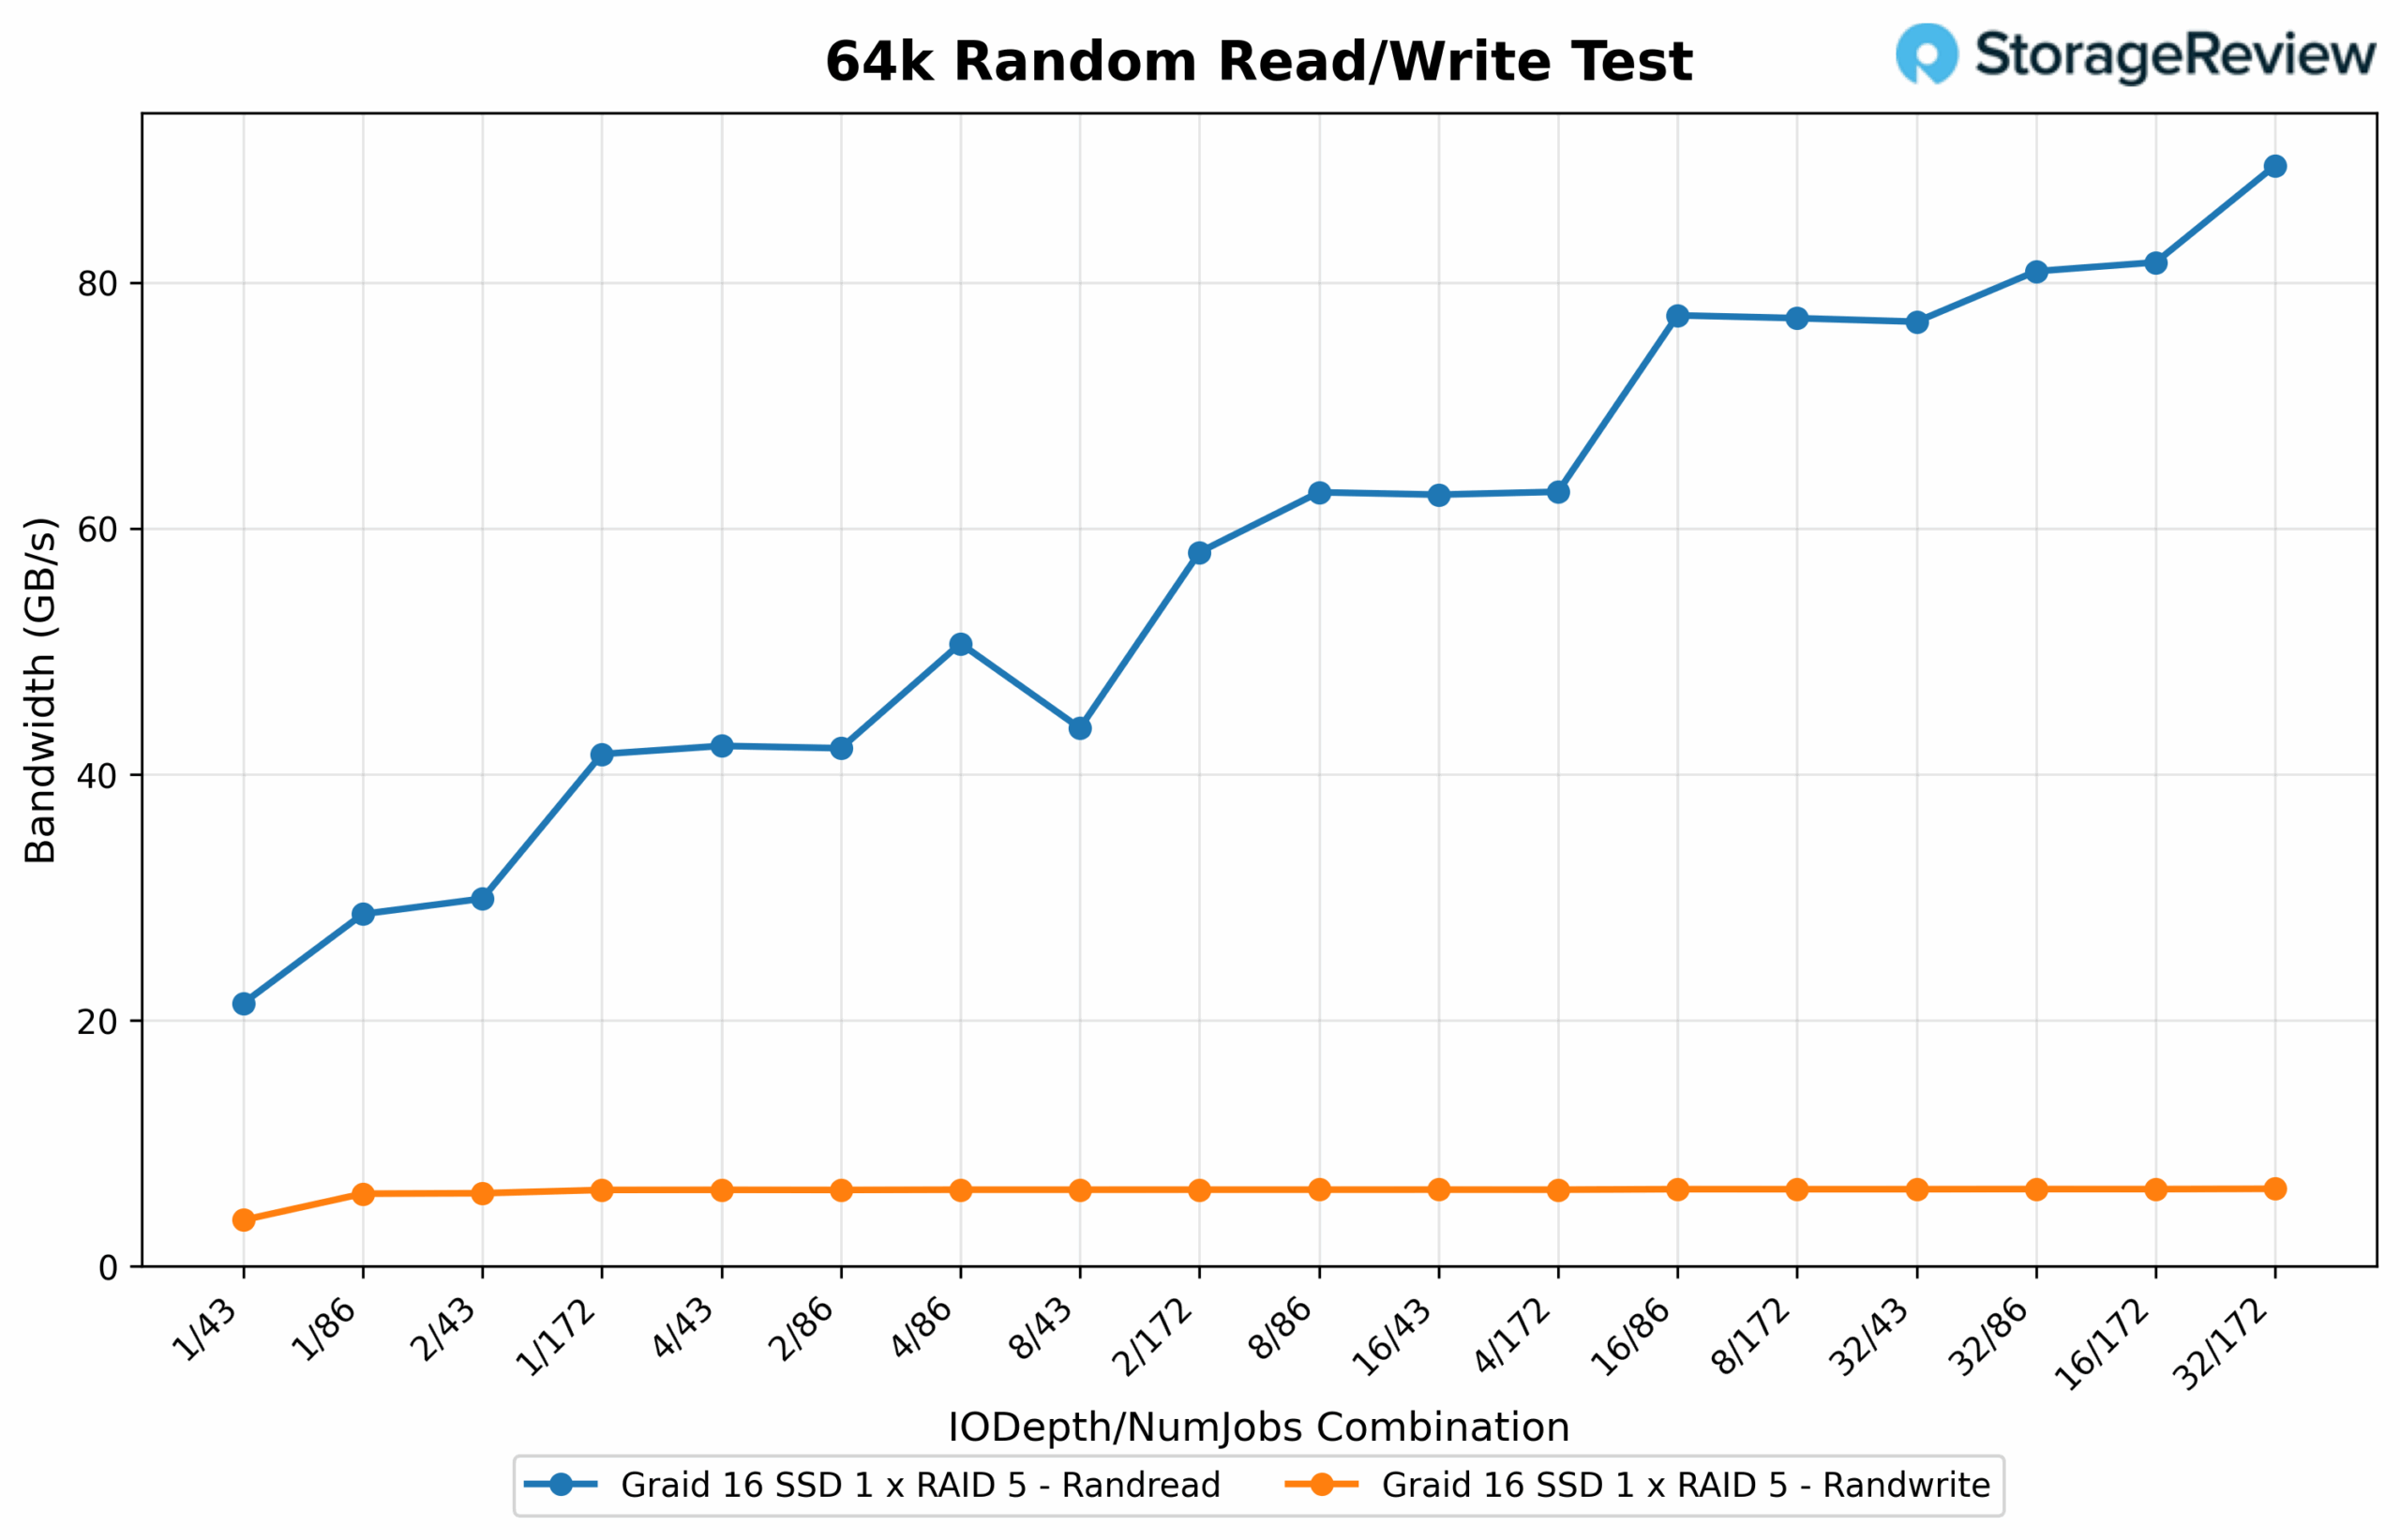
Larghezza di banda di lettura/scrittura casuale di 64K
Passando alle operazioni casuali a 64K, la larghezza di banda in lettura è migliorata significativamente con una maggiore profondità di coda e un numero maggiore di job, raggiungendo un picco di 91.65 GB/s a una profondità di IO di 32 con 172 job. Diverse altre configurazioni hanno seguito a breve distanza, tra cui 16/172 a 83.59 GB/s e 32/86 a 82.85 GB/s, evidenziando miglioramenti prestazionali costanti con l'aumentare del carico di lavoro. Le configurazioni di fascia media come 8/172 e 16/86 hanno mantenuto risultati elevati tra 78 GB/s e 79 GB/s. Al contrario, combinazioni a bassa concorrenza come 1/43 e 1/172 hanno prodotto livelli di throughput ridotti, compresi tra 21.89 GB/s e 42.63 GB/s, a dimostrazione della dipendenza dell'array dal parallelismo per le massime prestazioni. Sul lato scrittura, la larghezza di banda casuale a 64K ha raggiunto il picco di 6.44 GB/s con 32/86. Altre configurazioni ad alte prestazioni, tra cui 32/172 e 16/86, sono risultate molto simili, registrando rispettivamente 6.41 GB/s e 6.36 GB/s. La maggior parte dei punti di test si è attestata tra 6.3 GB/s e 6.4 GB/s, mostrando una coerenza stabile a diverse profondità di coda. Configurazioni leggere come 1/43 hanno mostrato le prestazioni di scrittura più basse, pari a 3.83 GB/s, rafforzando ulteriormente la tendenza ai progressivi miglioramenti con carichi di lavoro più pesanti.
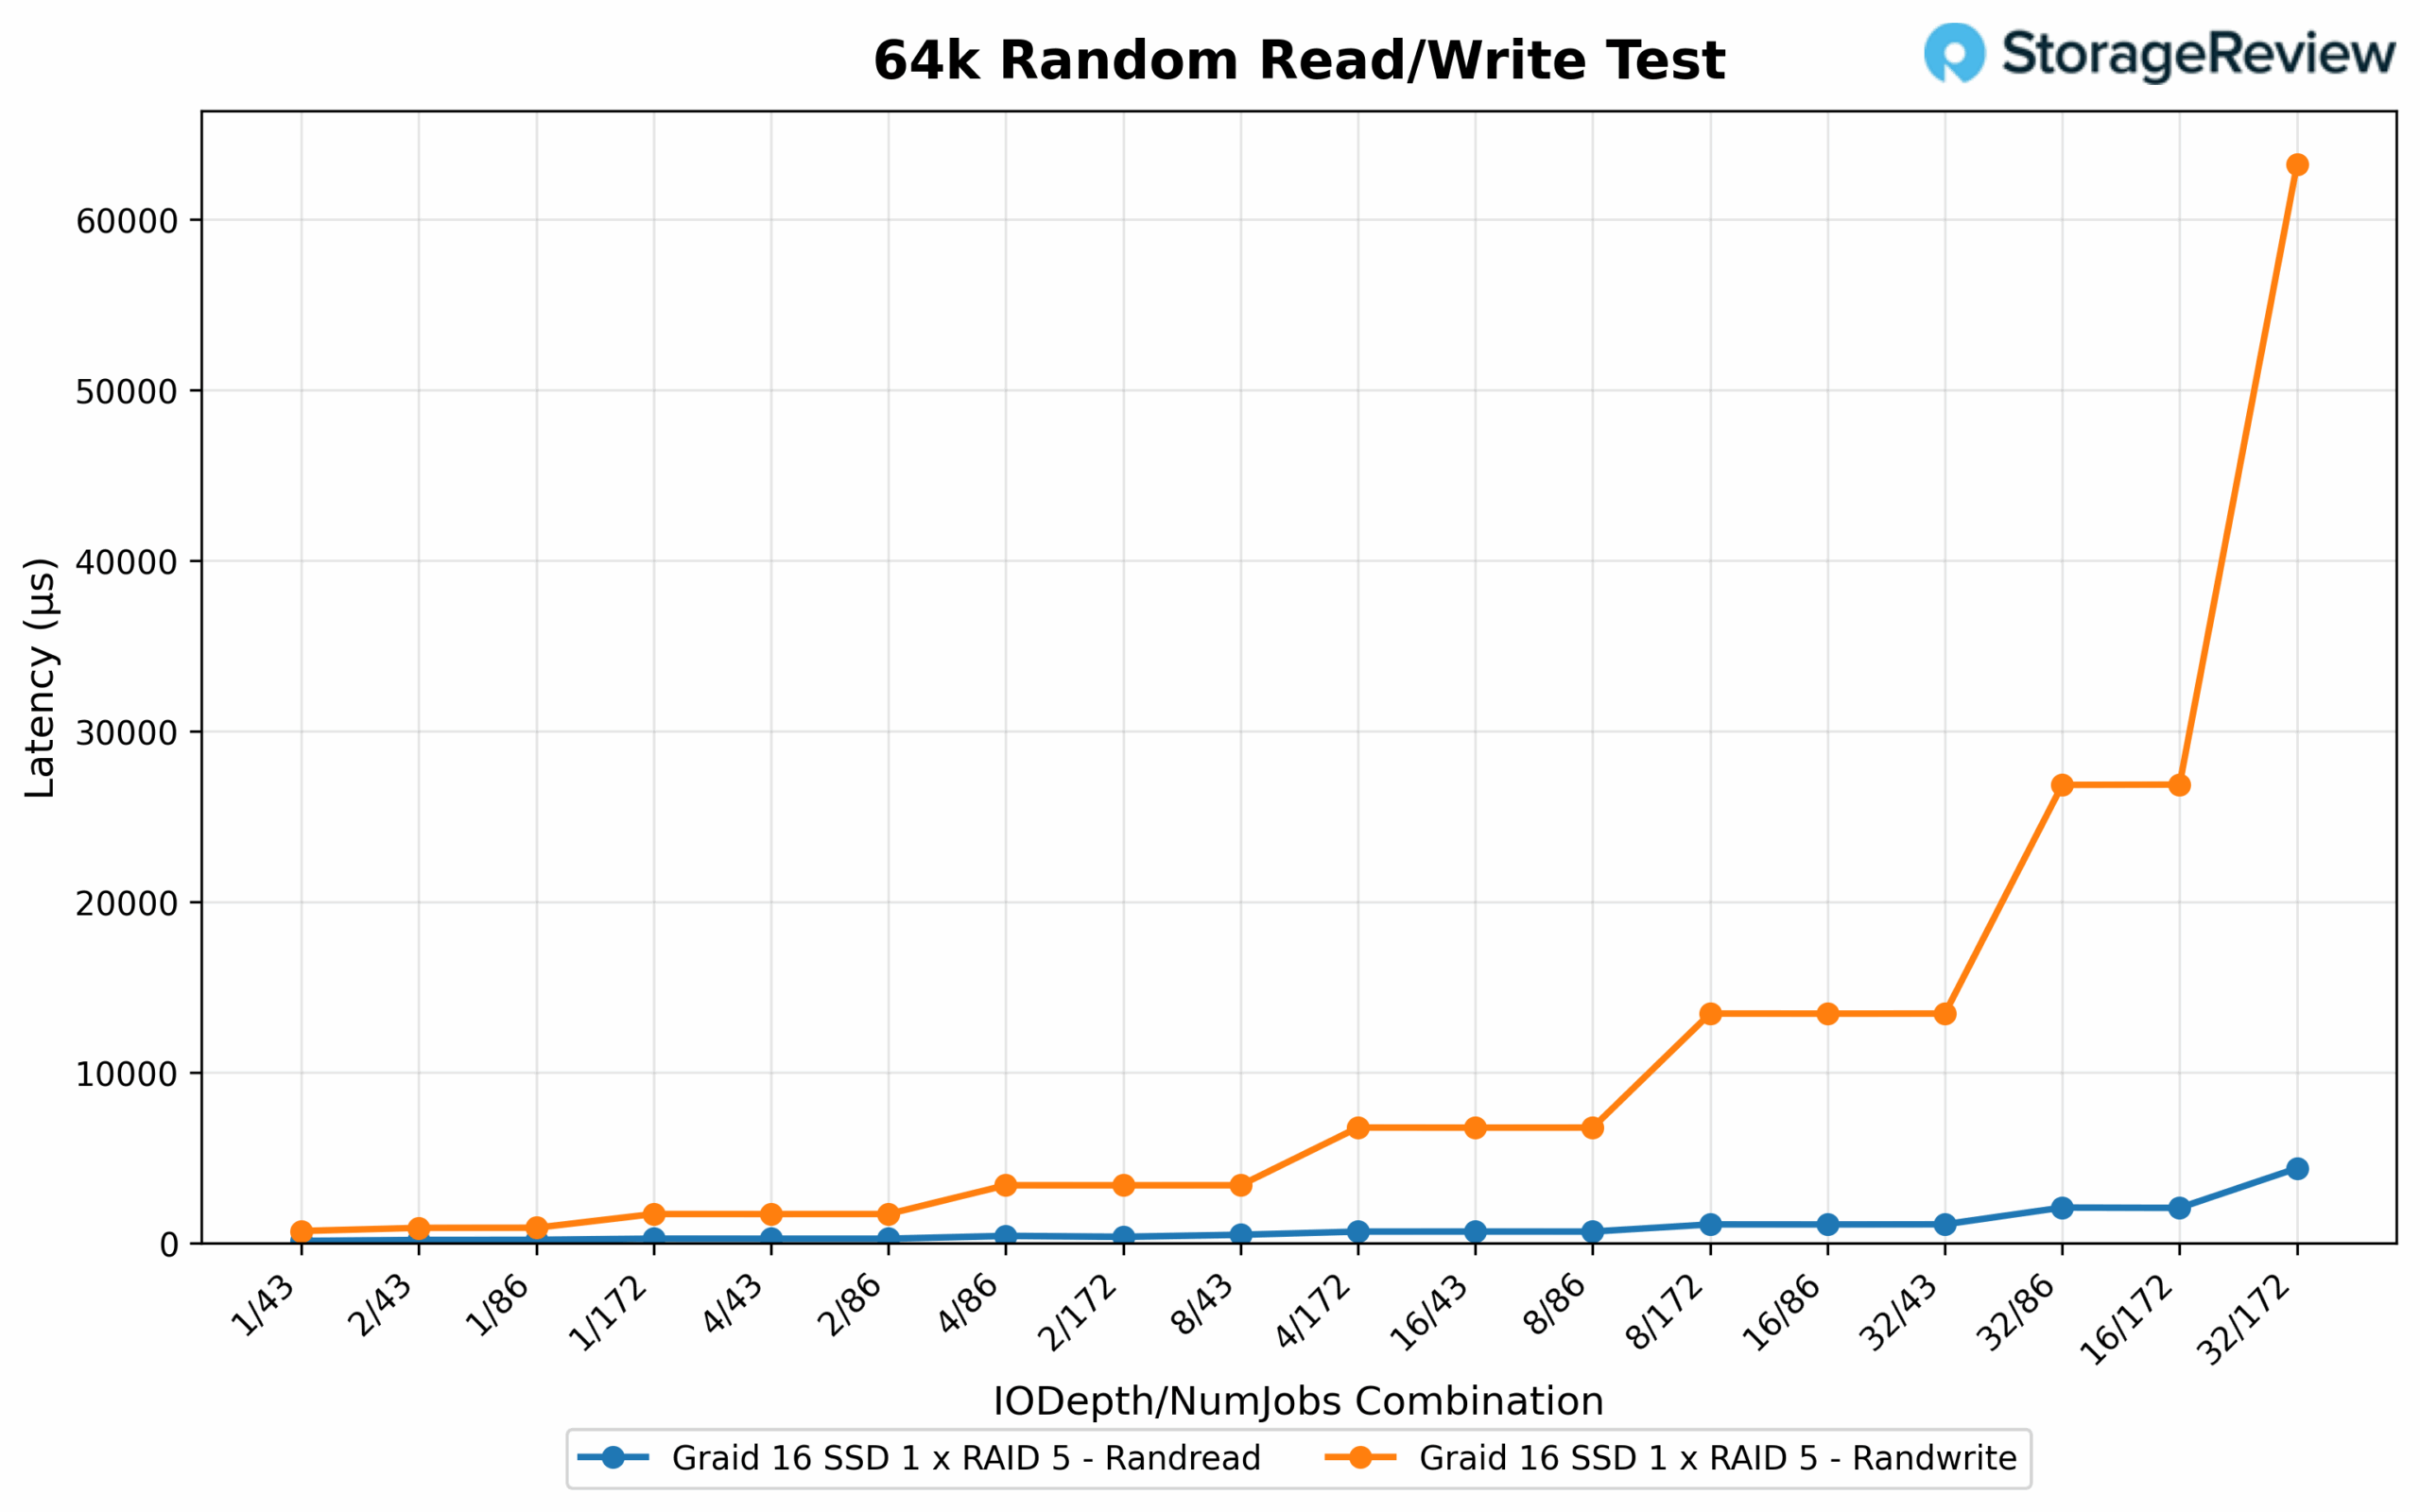
Latenza di lettura/scrittura casuale di 64K
La latenza di lettura casuale a 64K è rimasta costantemente bassa nella maggior parte dei casi di test. La latenza più bassa è stata di 0.123 ms a 1/43, seguita da 0.175 ms a 1/86. Con l'aumento della velocità, la latenza è rimasta entro un intervallo controllato: 4/172 ha registrato 0.666 ms, mentre 16/172 ha raggiunto 2.057 ms. Anche in condizioni di carico più elevato, la reattività è rimasta efficiente, con 32/86 che ha registrato 2.076 ms nonostante abbia fornito uno dei migliori risultati in termini di larghezza di banda. Sul lato scrittura, la latenza è aumentata in modo più netto con la profondità e il numero di job. La latenza più bassa è stata registrata da 2/43 a 0.887 ms, seguita da vicino da 4/43 e 2/86, rispettivamente a 1.694 ms e 1.697 ms. Le configurazioni più pesanti hanno mostrato chiari segnali di compromesso nei tempi di risposta: 8/172 ha registrato 13.445 ms, 16/172 è salito a 26.862 ms e 32/172 ha raggiunto il picco di 63.201 ms, evidenziando l'aumento del sovraccarico di coda con l'intensificarsi dei carichi di lavoro.
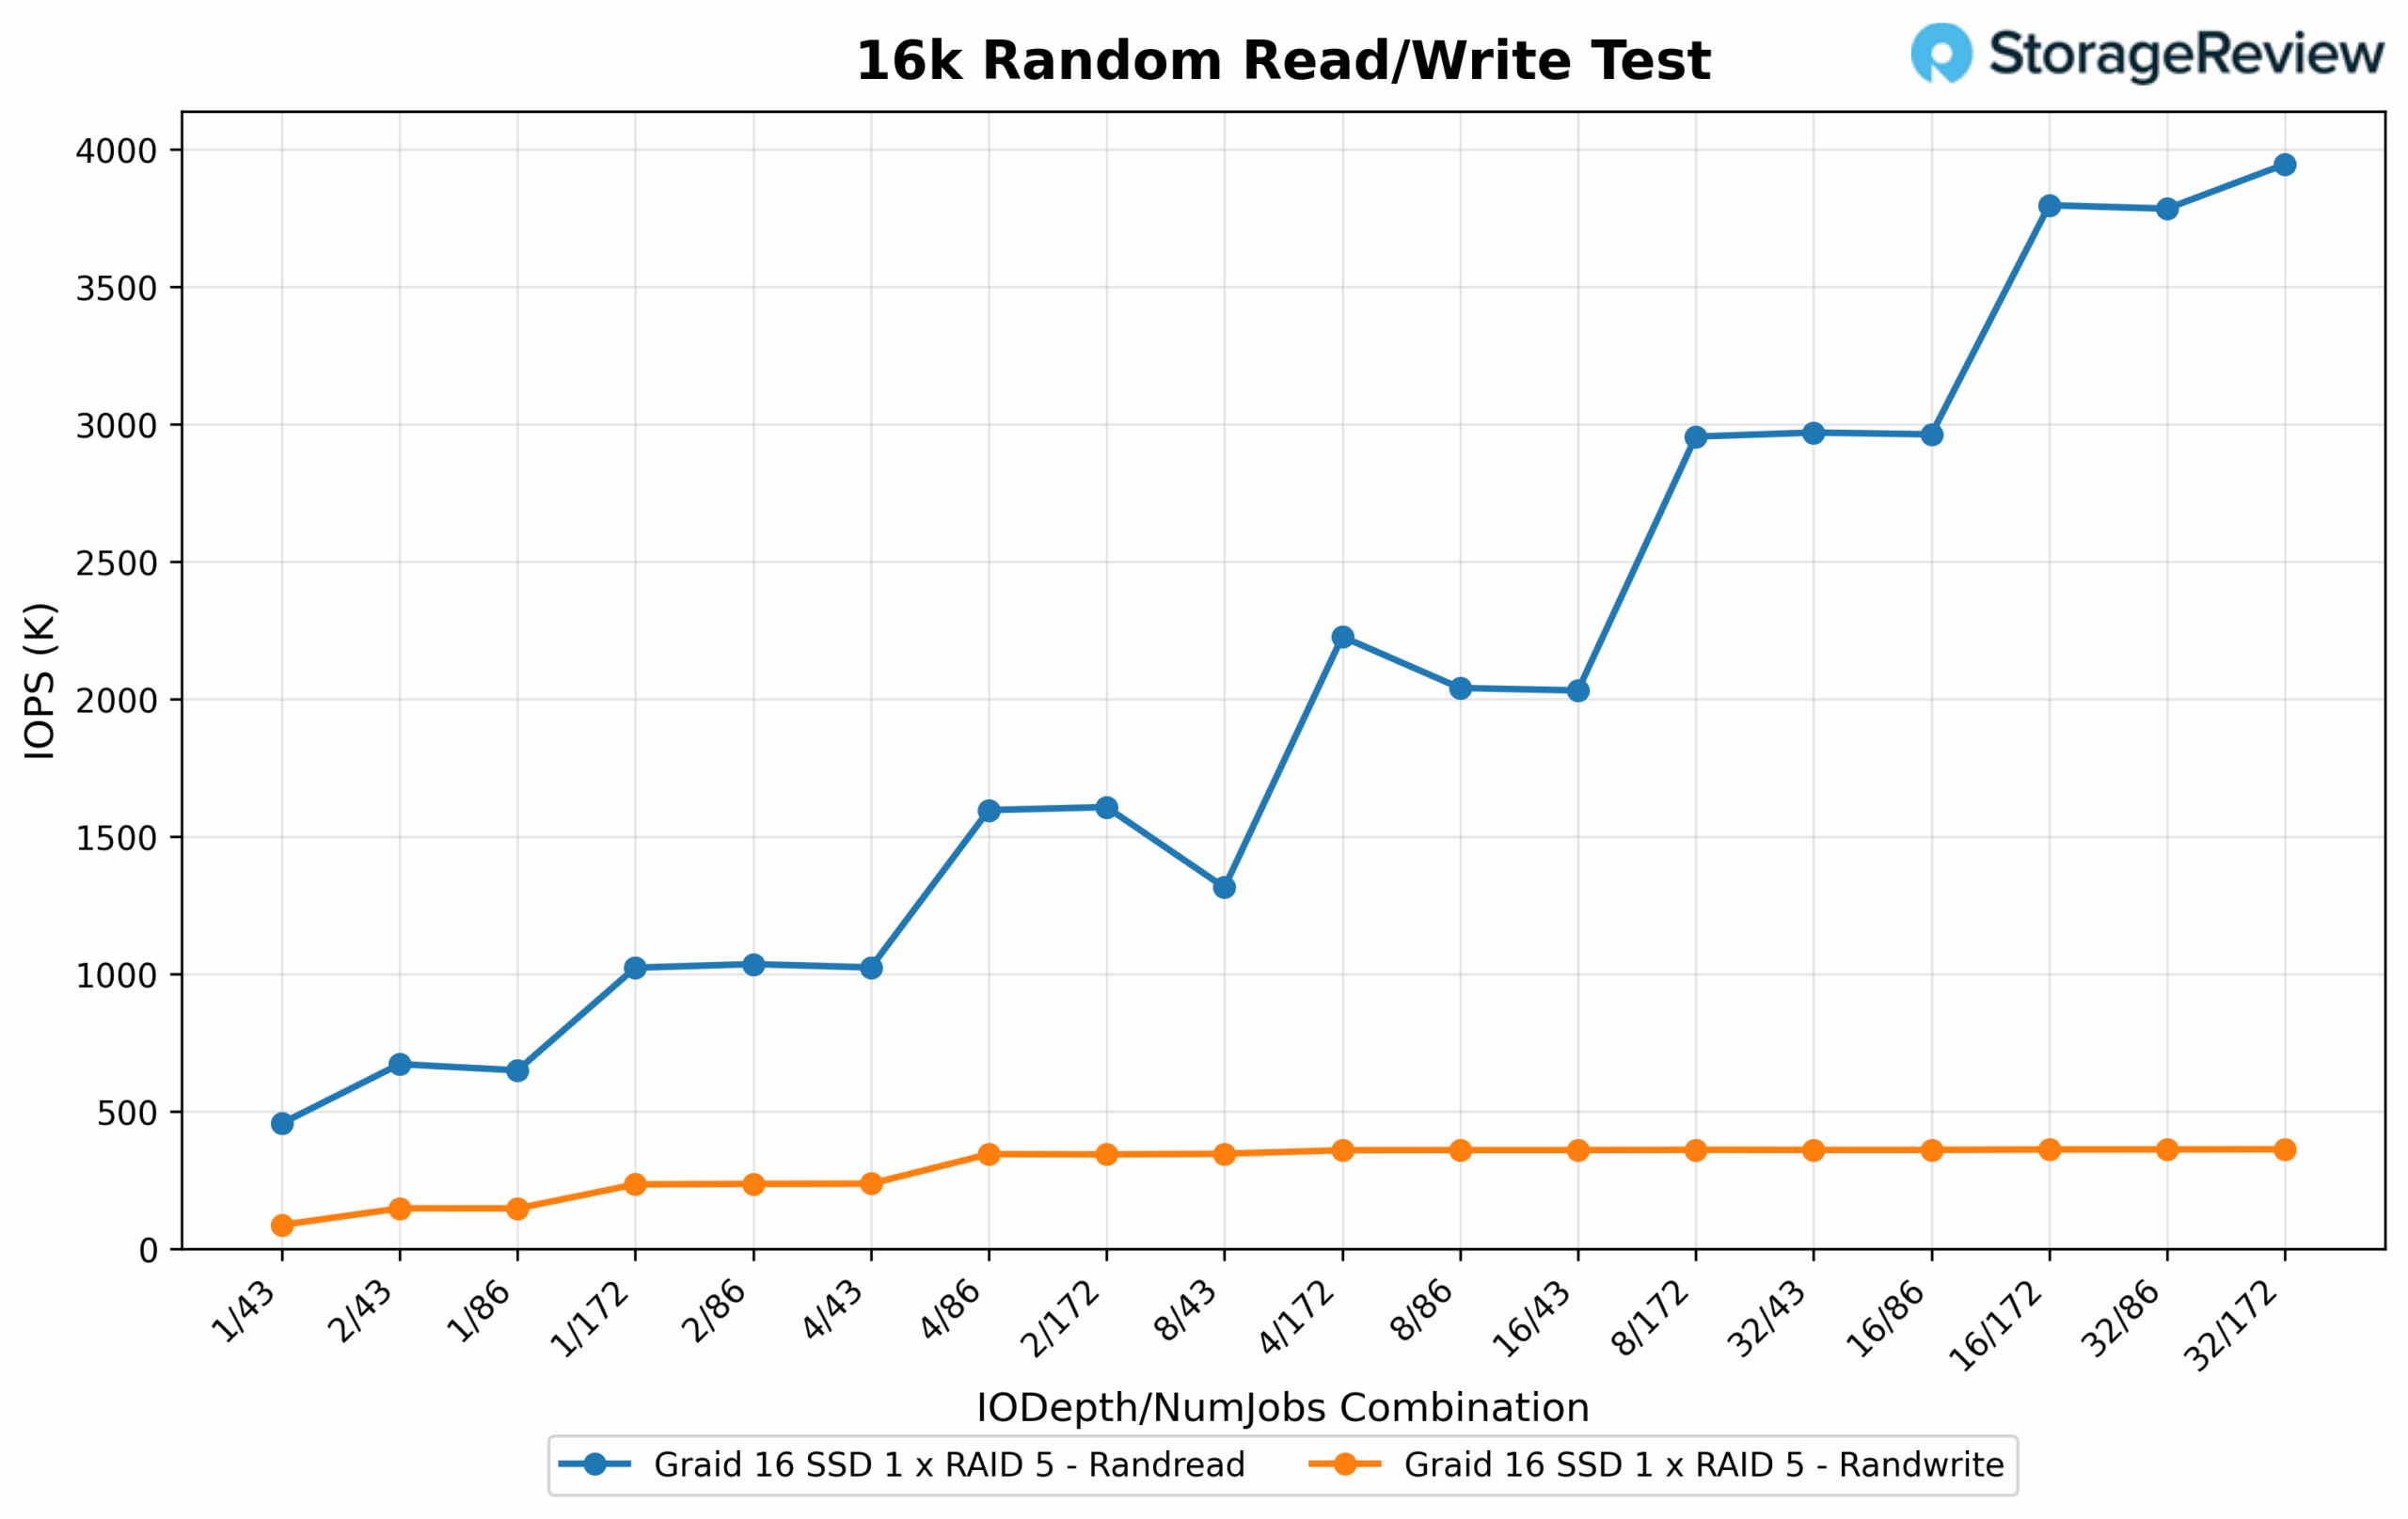
16K IOPS di lettura/scrittura casuale
La latenza di lettura casuale a 16K è rimasta bassa anche ai massimi IOPS. La migliore reattività è stata osservata nelle configurazioni più leggere, con 1/43 che ha raggiunto solo 0.087 ms e 1/86 che ha raggiunto 0.114 ms. Combinazioni di concorrenza più elevate come 4/86 e 8/86 hanno misurato rispettivamente 0.236 ms e 0.420 ms. Anche le configurazioni più performanti hanno mantenuto una latenza ragionevole, con 16/172 che ha registrato 1.143 ms e 32/172 che ha raggiunto 2.372 ms, dimostrando un ridimensionamento efficiente con un impatto gestibile sul tempo di risposta. Per le scritture casuali a 16K, la latenza più bassa è stata registrata a 2/43 con 0.848 ms, seguita da 1.253 ms a 4/43 e 1.415 ms a 1/43. Con l'aumento della profondità e del numero di processi, la latenza è gradualmente aumentata: 8/172 ha raggiunto 5.574 ms, mentre 16/172 e 32/172 sono saliti rispettivamente a 10.455 ms e 22.958 ms, evidenziando il compromesso previsto con l'aumento della saturazione della coda.
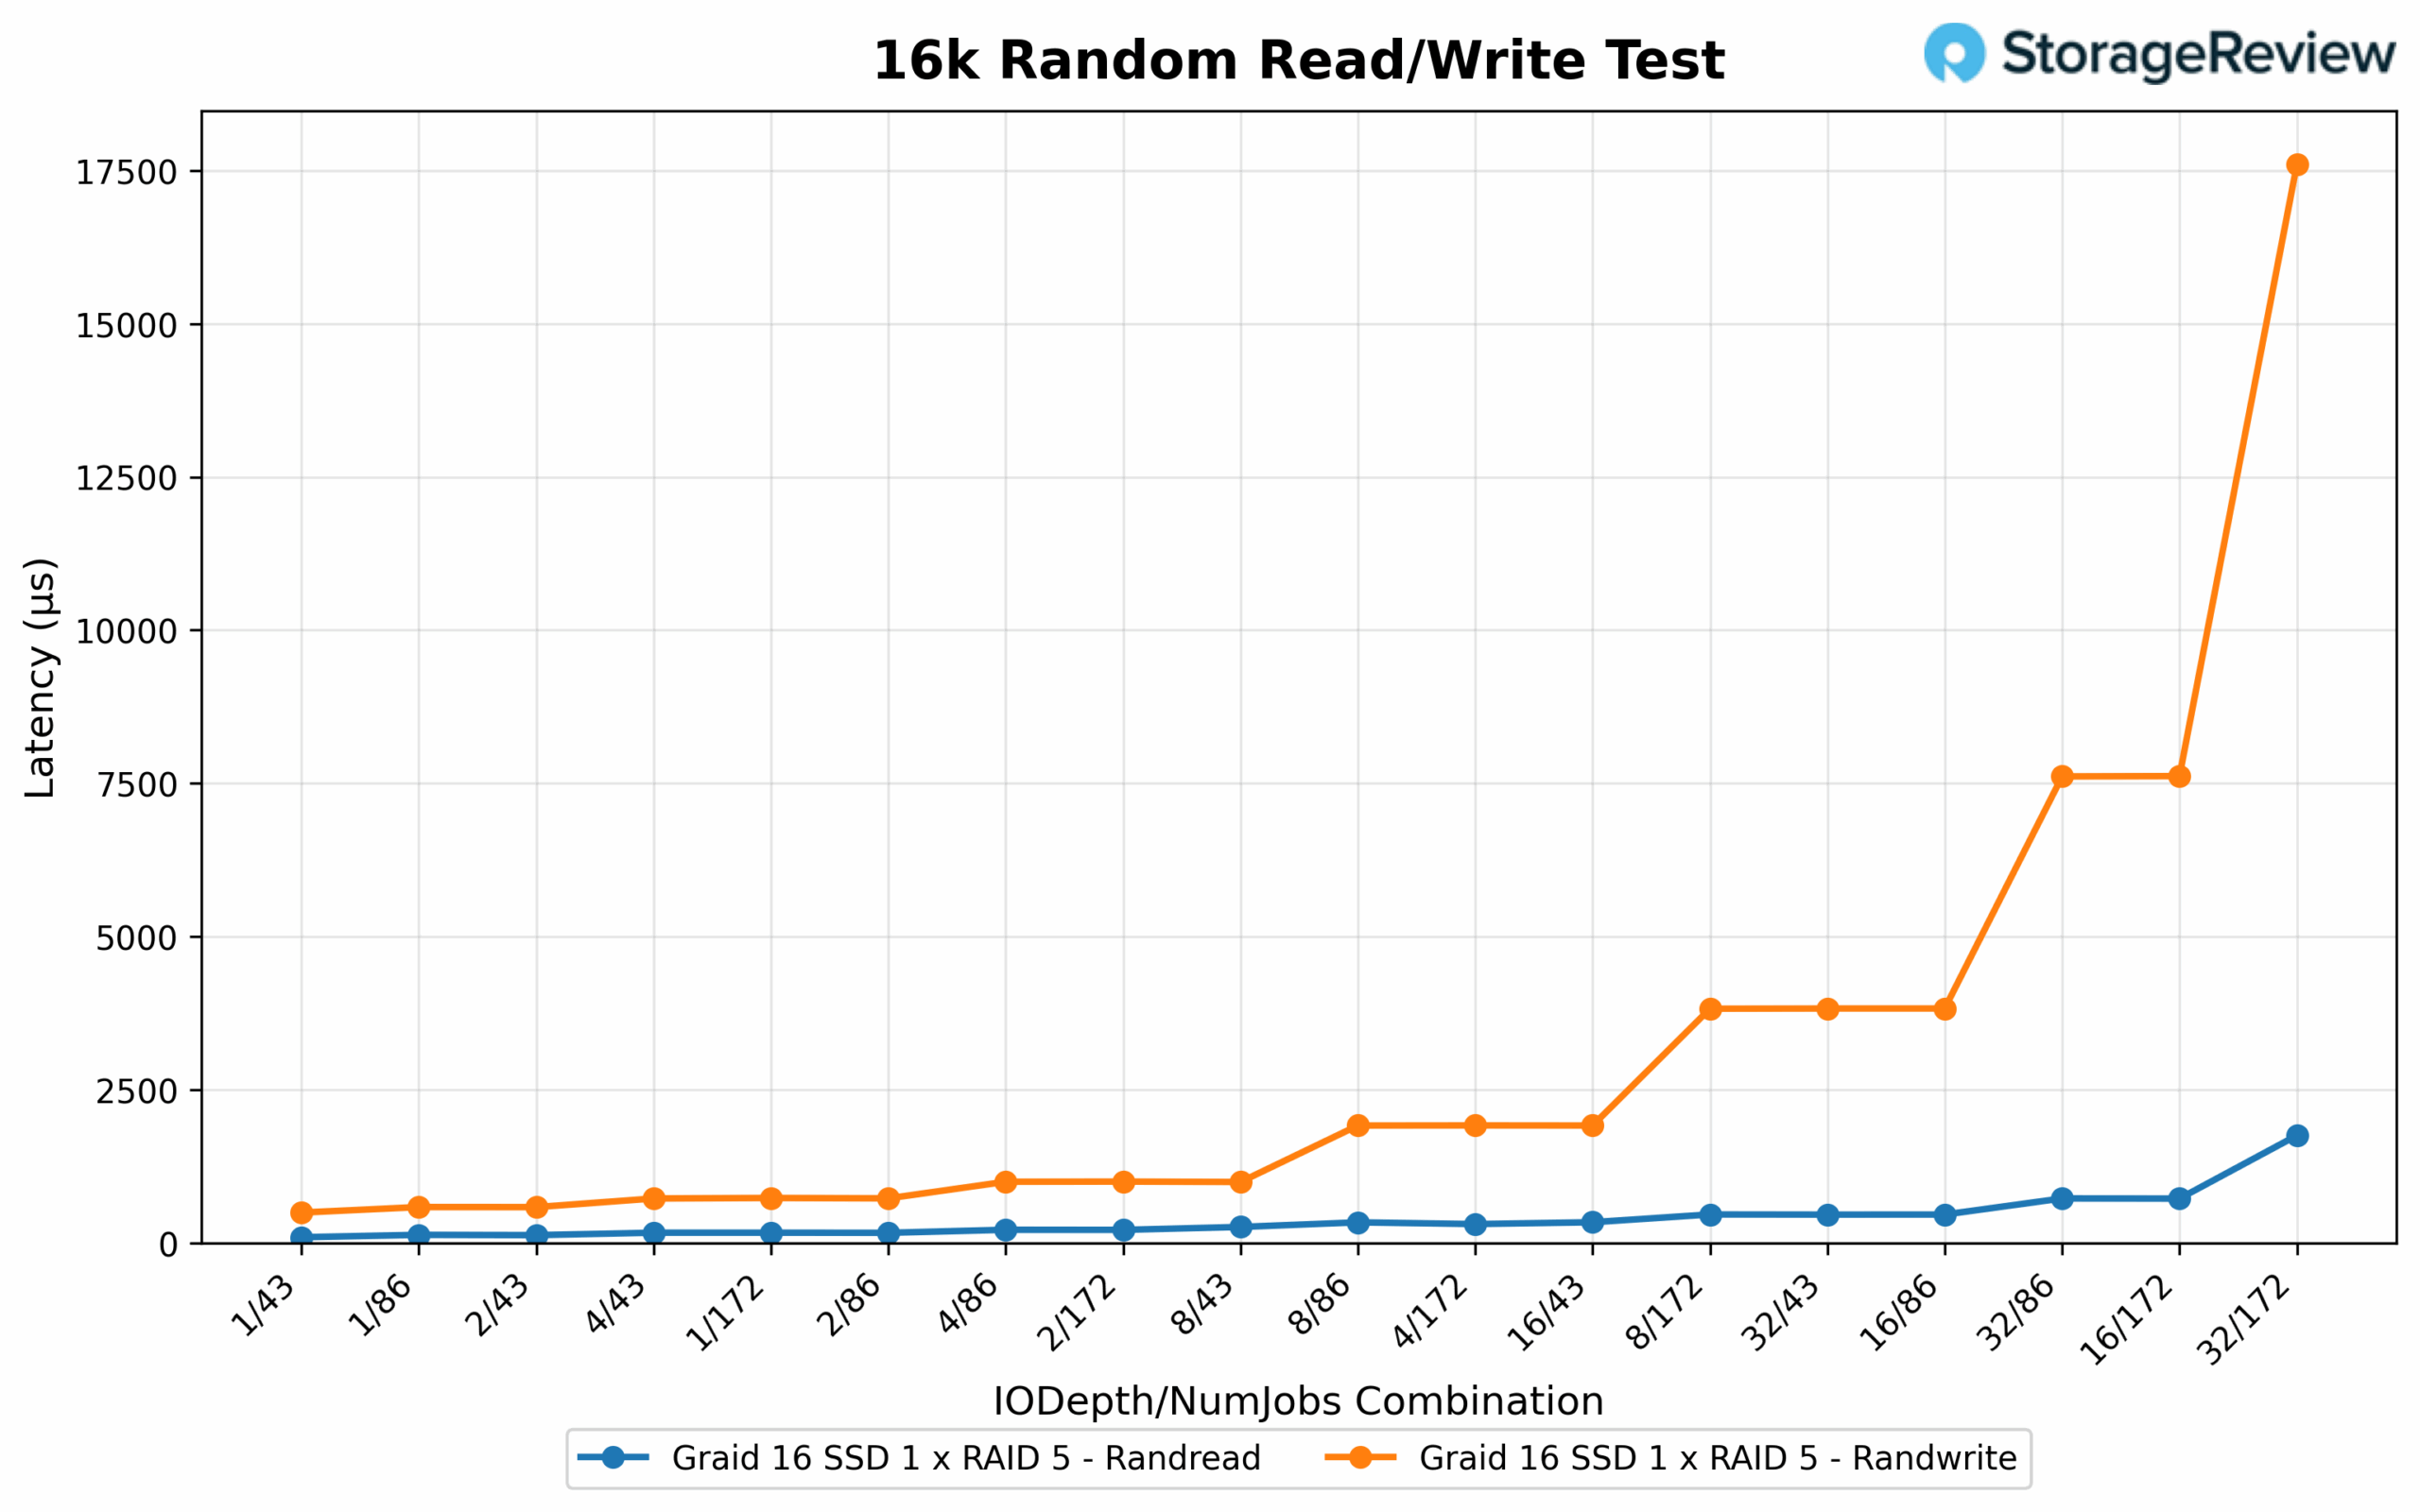
Latenza di lettura/scrittura casuale di 16K
La latenza di lettura casuale a 16K è rimasta costantemente bassa su tutta la linea. La configurazione più reattiva è stata 1/43 a 0.123 ms, seguita da vicino da 1/86 a 0.175 ms. Anche sotto la massima pressione, configurazioni come 32/172 e 16/172 hanno mantenuto la latenza al di sotto di 2.1 ms, dimostrando che l'array ha mantenuto tempi di risposta rapidi gestendo IOPS elevati. Al contrario, la latenza di scrittura casuale a 16K ha mostrato una varianza più ampia. La latenza più bassa è stata di 0.496 ms a 1/43, con ulteriori esecuzioni efficienti come 2/86 e 4/43 che si sono mantenute al di sotto di 1 ms. Con l'aumento della concorrenza e della profondità, la latenza è aumentata di conseguenza: 16/172 ha registrato 7.017 ms e 32/172 ha raggiunto 17.246 ms, rafforzando il compromesso previsto tra throughput di picco e reattività alla massima saturazione.
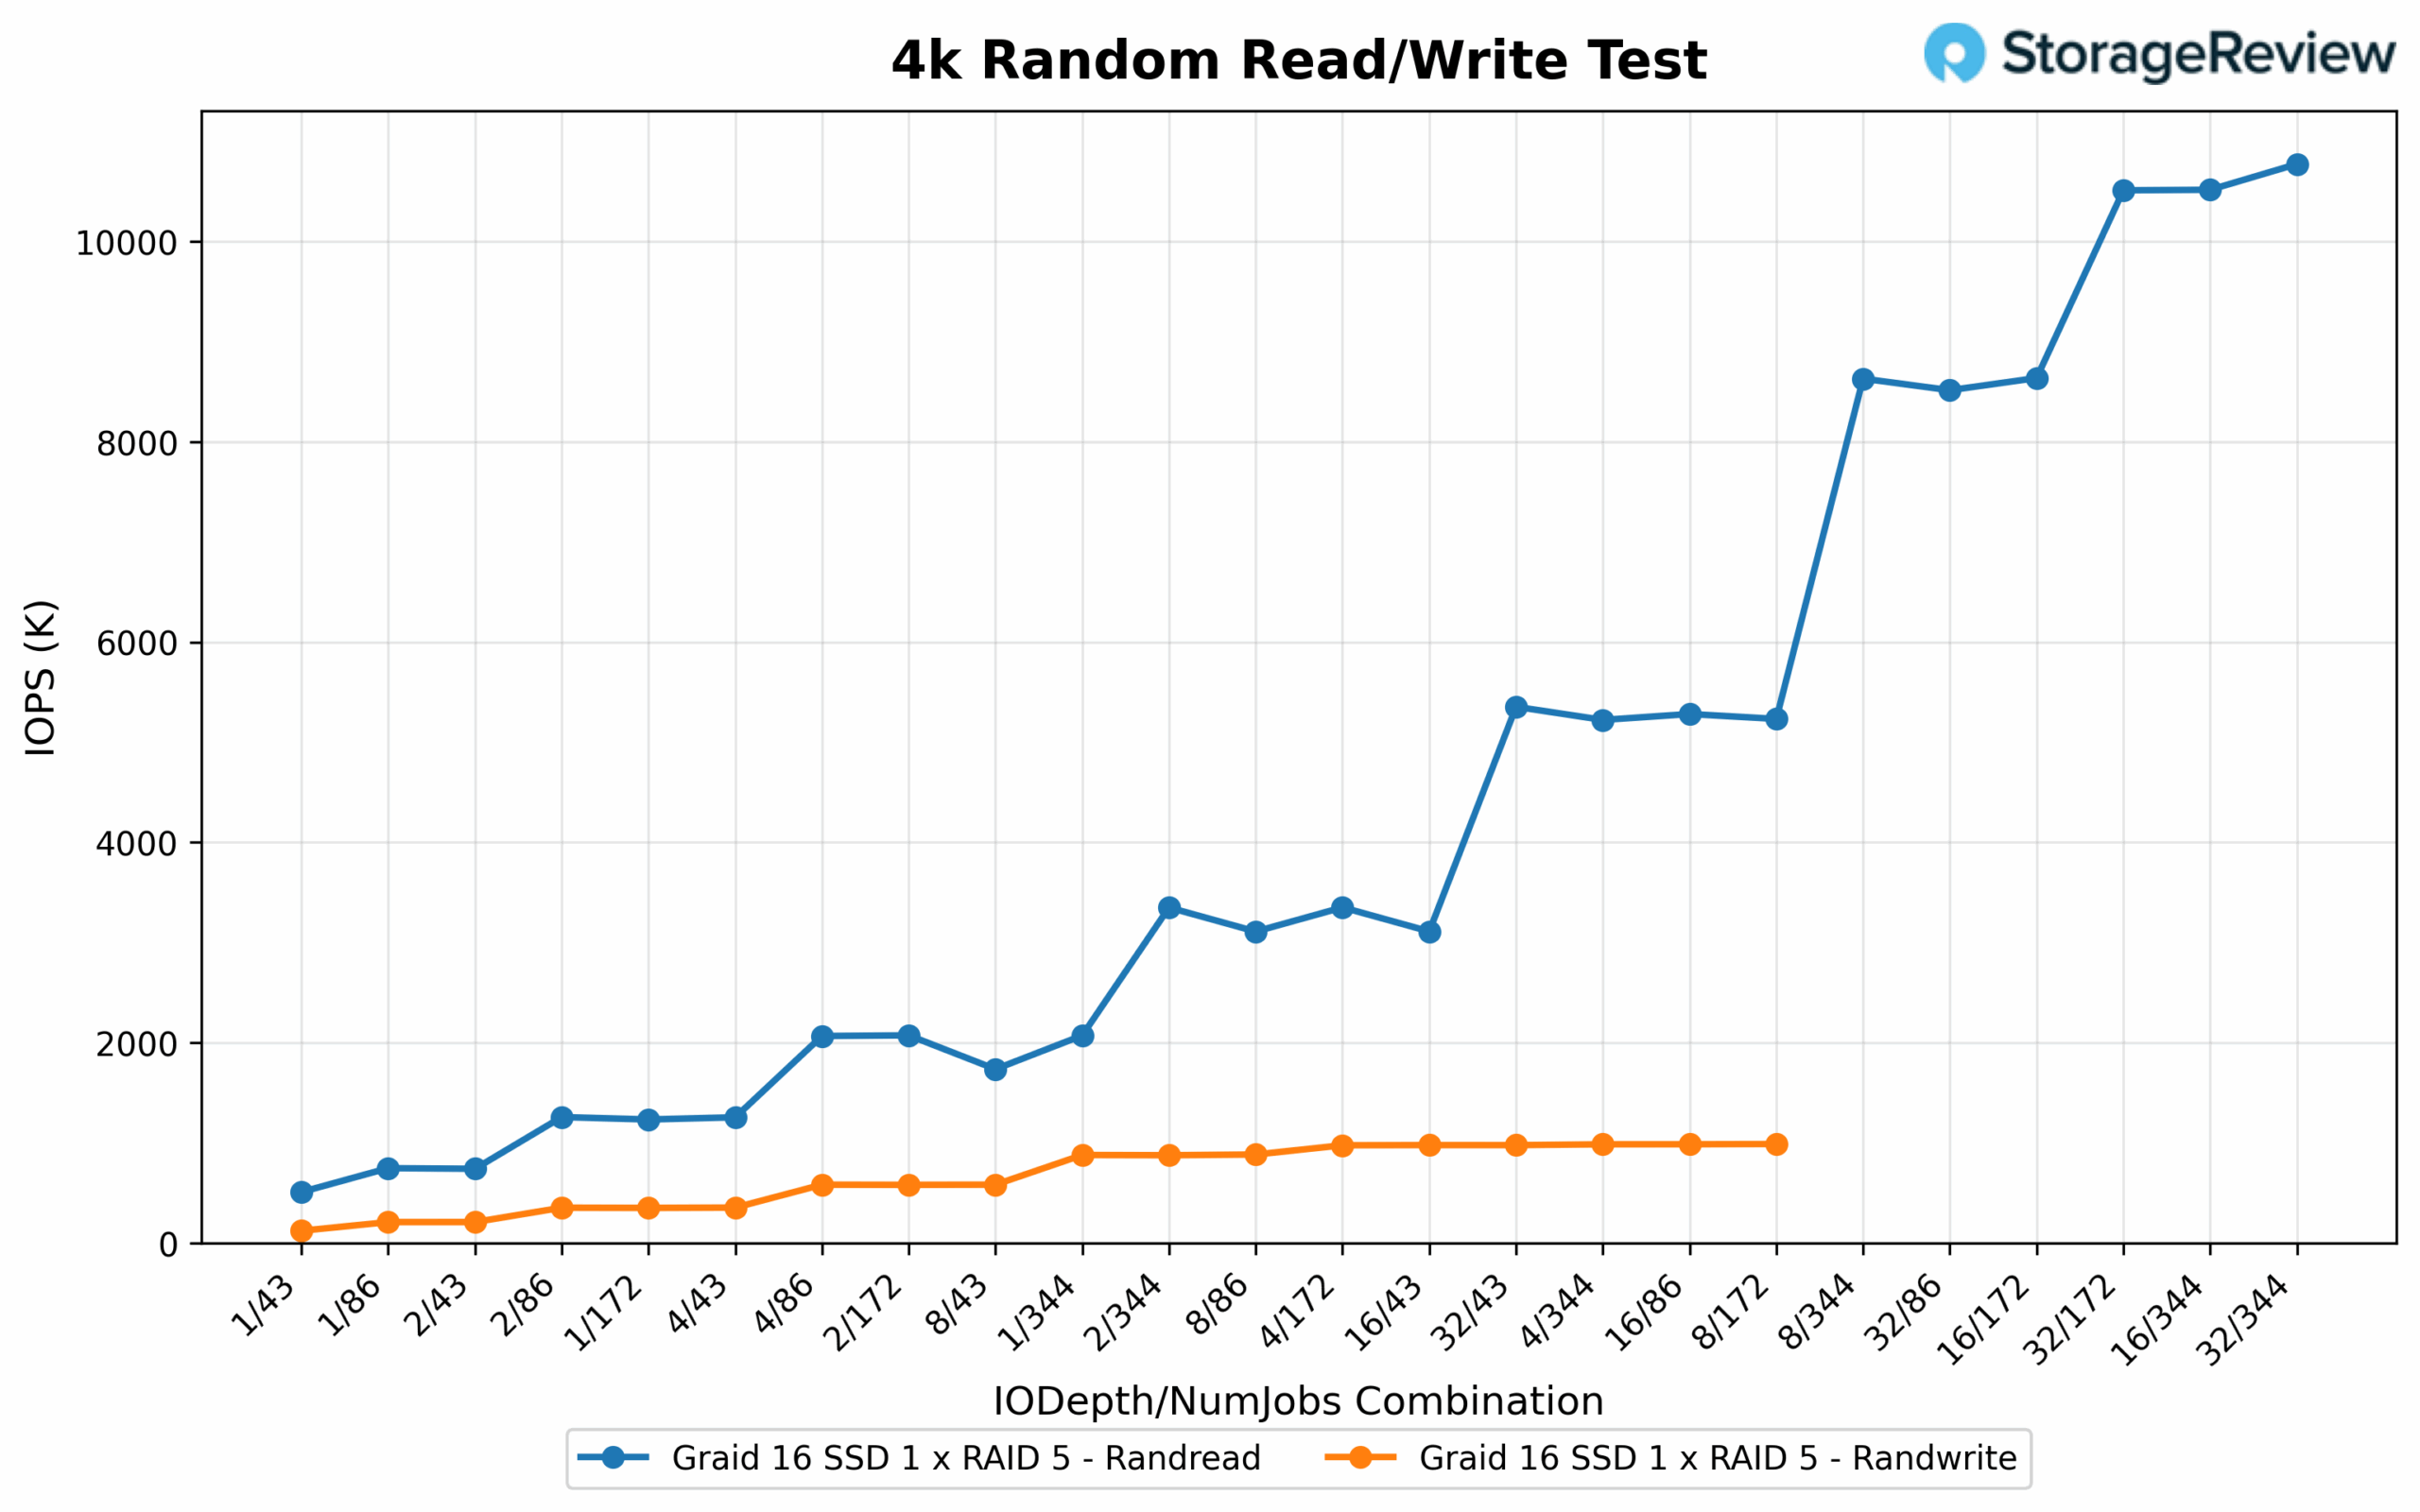
4K IOPS di lettura/scrittura casuale
In condizioni di carico di concorrenza più elevato, le IOPS di lettura casuali a 4K hanno raggiunto un picco impressionante di 10.77 milioni a una profondità di IO di 32 con 344 job. Altre configurazioni hanno seguito da vicino, tra cui 16/344 a 10.52 M, 4/344 a 10.51 M e 8/344 a 10.42 M, tutte dimostrando una scalabilità eccezionale con combinazioni aggressive di coda e profondità di job. Anche le opzioni a profondità ridotta come 8/172 e 16/172 hanno mantenuto un throughput elevato tra 5.23 M e 5.35 M IOPS, evidenziando ulteriormente la capacità dell'array di gestire carichi di lavoro paralleli impegnativi. Sul lato scrittura, le IOPS a 4K hanno raggiunto un picco di 987.9 K con 32/172. Configurazioni simili ad alta efficienza includevano 32/86 a 985.1K, 16/172 a 985.6K e 8/172 a 976.9K. Ulteriori combinazioni da 8/86 a 16/86 hanno mantenuto le prestazioni nell'intervallo da 875K a 977K, rafforzando la coerenza e l'affidabilità dell'array quando completamente saturo di operazioni di scrittura simultanee.
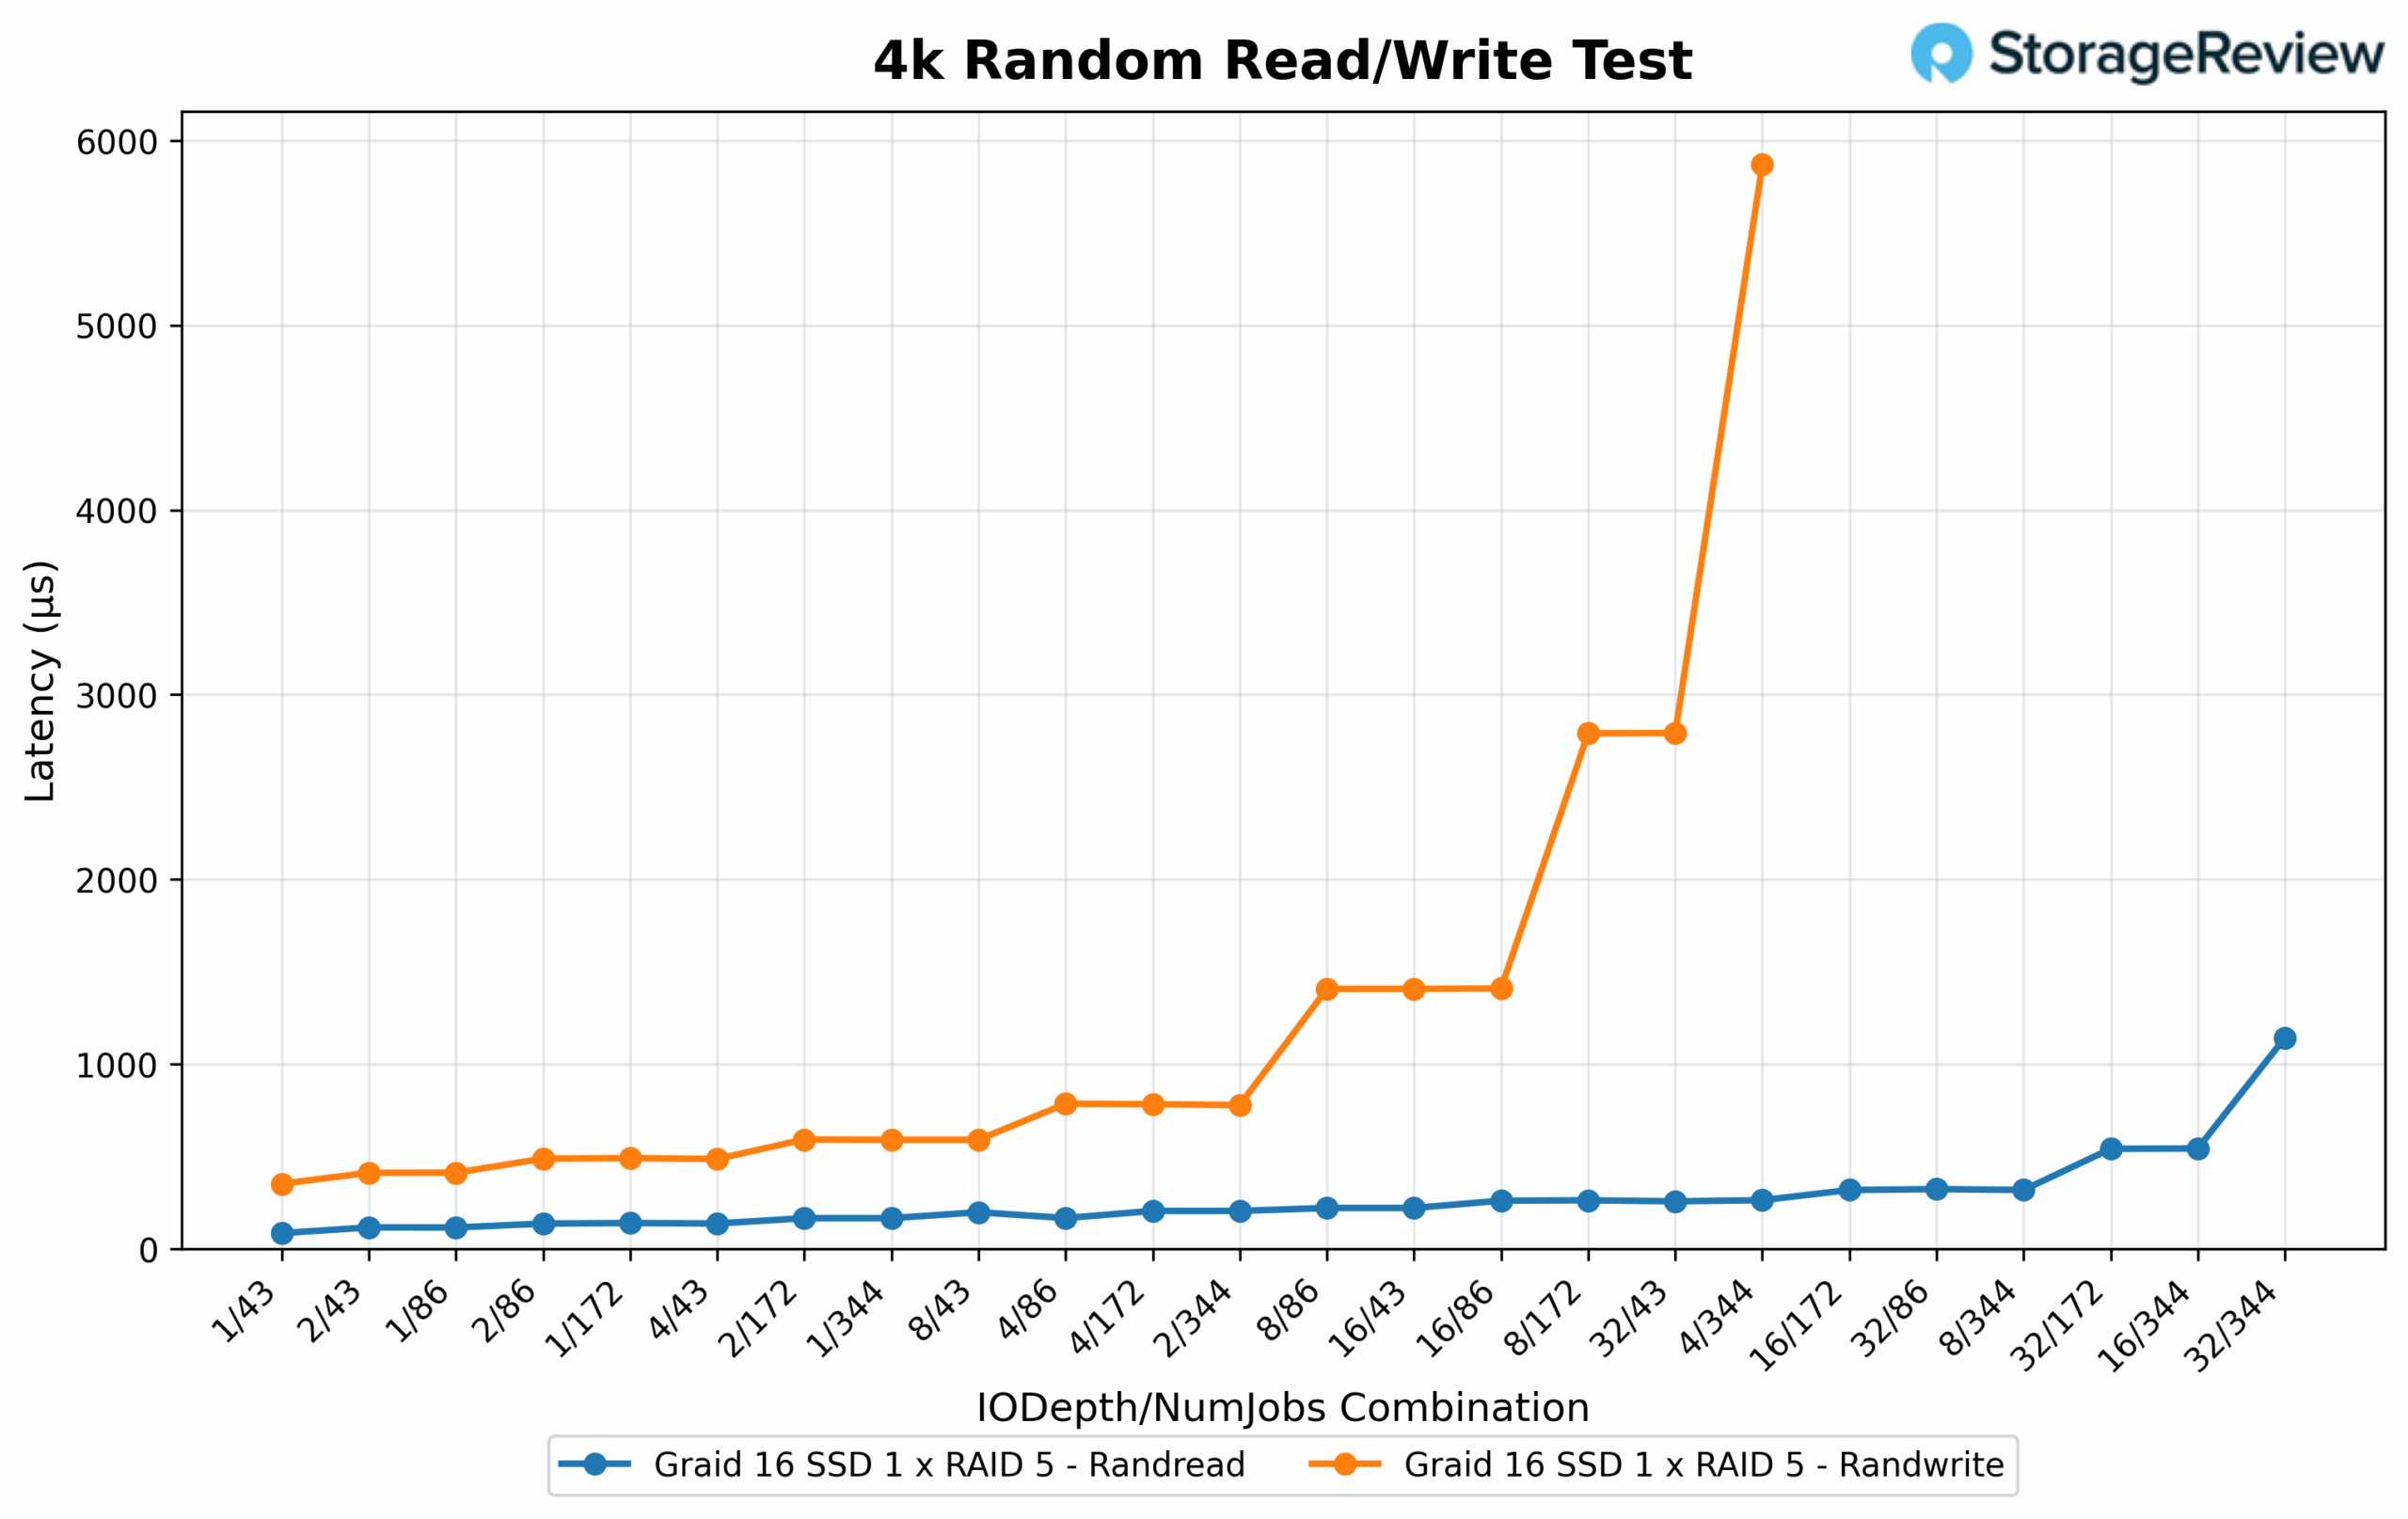
Latenza di lettura/scrittura casuale di 4K
La latenza di lettura casuale 4K è rimasta estremamente bassa su tutta la linea. Il tempo di risposta più rapido è stato di 0.084 ms a 1/86, con diverse altre configurazioni, tra cui 1/43, 2/43 e 4/43, tutte inferiori a 0.12 ms. Anche ai massimi IOPS, la latenza è rimasta ben controllata, con la configurazione 32/344 più performante che si è attestata su soli 1.142 ms. Ciò riflette un'eccellente reattività, anche quando l'array è stato spinto al massimo potenziale di throughput. Sul lato scrittura, anche la latenza casuale 4K è stata ben gestita. Il valore più basso registrato è stato di 0.352 ms a 1/43, mentre altre configurazioni altamente efficienti come 1/86, 2/43 e 4/43 sono rimaste tutte sotto gli 0.6 ms. Nelle configurazioni ad alta capacità, come 32/172 e 32/86, la latenza è aumentata leggermente, attestandosi tra 2.79 ms e 5.87 ms, rimanendo entro un intervallo accettabile considerando i livelli di saturazione della scrittura sostenuti.
Misurazione del sovraccarico della GPU Graid SupremeRAID AE
Nell'esaminare le metriche delle prestazioni di storage SupremeRAID AE di Graid, è essenziale considerare come SupremeRAID, che condivide le risorse GPU, possa influire sui carichi di lavoro che utilizzano le stesse GPU. Nelle precedenti distribuzioni di SupremeRAID, la GPU del sistema era dedicata a Graid. Con questa soluzione, la si distribuisce su una piattaforma che contiene già GPU che Graid può utilizzare e condividere risorse. Per misurare l'impatto ambientale, abbiamo creato uno scenario di inferenza LLM utilizzando vLLM. Abbiamo misurato le prestazioni di base del carico di lavoro con Graid inattivo e poi di nuovo con Graid che leggeva 172 GB sul pool RAID 5. Questo simula il carico di lavoro di inferenza, preallocando il carico di lavoro successivo mentre uno è in esecuzione. Con vLLM che spinge le GPU al 100% di utilizzo, qualsiasi operazione di Graid influirà sulla velocità dei token e sulla latenza.
Per il carico di lavoro di intelligenza artificiale, abbiamo eseguito l'inferenza con vLLM utilizzando il modello Llama 3.3 70B a piena precisione (BF16) con una cache da 16K KV. Questo ha utilizzato quasi completamente la VRAM su entrambe le schede (78G sulla scheda da 80G e 86G sulla scheda da 94G). Abbiamo quindi eseguito lo script di benchmarking di vLLM con una lunghezza massima di output di 256 token. Ogni test ha eseguito 256 query con una concorrenza massima di 32 richieste, utilizzando il batching continuo per simulare un pattern di richiesta realistico. Le metriche che abbiamo raccolto sono Tok/s, Time to First Token (TTFT), Time per Output Token (TPOT) e Inter Token Latency (ITL). Il carico di lavoro FIO che abbiamo avviato durante il test di inferenza consisteva in 172 job di lettura casuale da 16K, ciascuno con una lettura di 1 GB.
La produttività ha registrato un modesto calo generale. La produttività delle richieste è scesa da 1.86 a 1.78 richieste al secondo, con un calo del 4.3%. La produttività dei token in uscita è scesa da 225.44 a 215.94 token al secondo, con una riduzione del 4.2%. La produttività totale dei token è scesa da 2029.77 a 1944.30 token al secondo, con un calo analogo del 4.2%. Ciò suggerisce che il trasferimento ha introdotto un sovraccarico che ha leggermente influito sulle prestazioni.
Le metriche di latenza hanno rivelato risultati contrastanti. Il TTFT medio è aumentato del 3.6%, da 6,704 ms a 6,945 ms, mentre il TTFT mediano è aumentato dell'1.5%. È interessante notare che il TTFT P99 è migliorato, diminuendo del 2.8%, da 14,199 ms a 13,803 ms, indicando migliori prestazioni di coda in tale metrica. Per il TPOT, la media è aumentata del 5.3%, mentre la mediana è rimasta relativamente stabile con un aumento dello 0.65%. Tuttavia, il TPOT P99 è aumentato bruscamente del 24.6%, da 127.69 ms a 159.15 ms, dimostrando che il tempo di generazione del token nel caso peggiore è stato significativamente influenzato. La latenza inter-token (ITL) ha mostrato tendenze simili, con la media in aumento del 5.1%, la mediana rimasta sostanzialmente invariata e il P99 in aumento del 2.2%.
SupremeRAID AE di Graid, in esecuzione insieme al nostro carico di lavoro vLLM, ha introdotto un calo lieve ma costante della produttività (circa il 4%), insieme a moderati aumenti della latenza media e un notevole degrado delle prestazioni P99 per la generazione di token. Nonostante questi impatti, il sistema è rimasto completamente stabile e reattivo, dimostrando che l'inferenza ad alta concorrenza con modelli di grandi dimensioni, come Llama 3.3 70B, può ancora funzionare in modo affidabile insieme a Graid SupremeRAID AE.
| Metrica (durata inferiore / tok/s più alto è meglio) | Linea di base | Con operazione di lettura FIO da 172 GB |
| Richieste riuscite | 256 | 256 |
| Durata del benchmark (s) | 137.68 | 143.73 |
| Token di input totali | 248,414 | 248,414 |
| Totale token generati | 31,037 | 31,037 |
| Capacità di elaborazione delle richieste (req/s) | 1.86 | 1.78 |
| Capacità di elaborazione del token di output (tok/s) | 225.44 | 215.94 |
| Throughput totale dei token (tok/s) | 2029.77 | 1944.30 |
| Tempo al primo token (TTFT) (una latenza più bassa è meglio) | ||
| TTFT medio (ms) | 6,704.43 | 6,945.72 |
| TTFT mediano (ms) | 6,469.88 | 6,569.80 |
| P99 TTFT (ms) | 14,199.21 | 13,803.62 |
| Tempo per token di output (TPOT, escluso il 1° token) (una latenza inferiore è migliore) | ||
| TPOT medio (ms) | 81.44 | 85.72 |
| TPOT mediano (ms) | 80.38 | 80.90 |
| P99 TPOT (ms) | 127.69 | 159.15 |
| Latenza inter-token (ITL) (una latenza più bassa è migliore) | ||
| ITL medio (ms) | 79.94 | 83.99 |
| ITL mediana (ms) | 49.75 | 49.78 |
| P99 ITL (ms) | 539.07 | 550.73 |
Pensieri di chiusura
SupremeRAID AE di Graid offre una soluzione pratica e di grande impatto per le organizzazioni che sviluppano o ampliano infrastrutture di intelligenza artificiale. Sostituendo il tradizionale RAID hardware con un approccio basato su GPU e software-defined, SupremeRAID AE semplifica l'implementazione, eliminando al contempo i colli di bottiglia più comuni che bloccano i moderni flussi di lavoro di intelligenza artificiale.
I nostri test hanno dimostrato la sua capacità di unificare fino a 32 SSD NVMe in un unico namespace resiliente, offrendo quasi 1 PB di capacità in un unico server con prestazioni eccezionali. Risultati di picco di 183 GB/s in lettura e 54 GB/s in scrittura, combinati con un overhead GPU minimo durante l'inferenza live, convalidano la sua capacità di soddisfare la duplice esigenza di checkpointing di modelli massivi e inferenza a bassa latenza su larga scala.
Eliminando i costi e la complessità dell'hardware RAID dedicato e integrandosi perfettamente con tecnologie come NVIDIA GPUDirect Storage e file system basati sull'intelligenza artificiale, SupremeRAID AE crea una base di storage pronta per il futuro. Per le organizzazioni che puntano a semplificare l'inferenza e ridurre il rischio operativo, SupremeRAID AE offre le prestazioni, la semplicità e la resilienza necessarie per gli ambienti di produzione basati sull'intelligenza artificiale.
Classifica: Le schede H100 NVL in questo test si posizionano nella sezione "Testate anche" della nostra classifica delle migliori GPU aziendali , con i nostri numeri di servizio vLLM a scheda singola.


 Amazon