

HPE ha creato un'architettura coordinata di resilienza informatica attorno ad Alletra Storage MP B10000. Essa estende le funzionalità di sicurezza native della piattaforma attraverso uno stack integrato che include la virtualizzazione con Morpheus e VM Essentials, la protezione continua dei dati con Zerto, la conservazione dei backup a lungo termine con StoreOnce e l'osservabilità tramite l'integrazione con sistemi SIEM (Security Information and Event Management) indipendenti dal fornitore. Nel suo complesso, l'architettura è progettata per essere direttamente allineata al framework di sicurezza informatica NIST Cybersecurity Framework 2.0, con il B10000 che funge da centro operativo per ogni funzione del framework. L'intero progetto è concepito per rispondere alle due domande che un esperto di sicurezza si pone in definitiva riguardo a qualsiasi infrastruttura: è ancora sotto il nostro controllo e i dati in essa contenuti sono ancora protetti?
Storicamente, lo storage aziendale è rimasto fuori dal dibattito più ampio sulla sicurezza. Nella maggior parte delle organizzazioni, un responsabile della sicurezza informatica preoccupato per un router configurato in modo errato in una filiale o per un laptop non aggiornato sulla rete aziendale presta poca attenzione all'array di storage nel data center. L'array è protetto da diversi livelli di sicurezza perimetrale, accessibile solo a una ristretta cerchia di amministratori e sostanzialmente invisibile al resto dell'organizzazione IT. Sulla carta, è una delle risorse più sicure dell'intero edificio.
Questa ipotesi non è più valida. Le moderne operazioni di ransomware hanno imparato che l'array è l'obiettivo di maggior valore nel data center. Endpoint e server possono essere reinstallati. Lo storage primario è dove risiedono effettivamente i dati e un attaccante che ottiene il controllo amministrativo dell'array può crittografare i dati, eliminare gli snapshot destinati al loro recupero e distruggere i backup in un'unica azione coordinata. A quel punto, l'organizzazione non si trova ad affrontare un semplice inconveniente, ma a negoziare per la propria sopravvivenza. Gli strumenti a disposizione degli attaccanti, comprese le varianti assistite dall'IA che si adattano più velocemente di quanto le difese basate sulle firme riescano a stare al passo, sono sempre più in grado di raggiungere questo obiettivo.
La posta in gioco non è più solo operativa. Gli enti regolatori negli Stati Uniti, nell'Unione Europea e nel Regno Unito hanno trasformato la sicurezza delle infrastrutture da una buona prassi a un obbligo legale. Framework come il Digital Operational Resilience Act (DORA) dell'UE e la Direttiva NIS2 richiedono controlli dimostrabili per il rilevamento, il ripristino e la segnalazione degli incidenti, con responsabilità che si estendono fino al livello dirigenziale. Le organizzazioni che si assumono questi obblighi sono proprio quelle che gestiscono sistemi di storage aziendali su larga scala: banche e società di servizi finanziari, ospedali e reti sanitarie, aziende di servizi pubblici e operatori di infrastrutture critiche, agenzie governative e i fornitori di servizi cloud che ospitano tutte le entità sopra menzionate. Per loro, la mancata protezione del livello infrastrutturale non rappresenta solo un rischio per l'attività, ma anche una violazione della conformità con gravi conseguenze.
Il lavoro sulla resilienza informatica si colloca nel divario tra i team di storage e di sicurezza, che fanno capo a responsabili diversi, misurano il successo in modo differente e raramente condividono il linguaggio operativo necessario per coordinarsi durante un incidente. Gli amministratori dello storage comprendono gli obiettivi di throughput, capacità e ripristino. I team di sicurezza comprendono le kill chain, i vettori di attacco e la gestione della postura di sicurezza. La maggior parte delle organizzazioni si accorge di questo divario solo dopo essere stata costretta a operare al suo interno. L'architettura che HPE ha realizzato è progettata per colmare questo divario e le sezioni che seguono analizzano ciascuna funzione NIST per testarne l'efficacia, tornando costantemente alle due domande fondamentali di controllo e protezione.
Punti chiave
- Resilienza completa dell'intera infrastruttura: HPE abbina Alletra Storage MP B10000 a VM Essentials, Zerto, StoreOnce e all'integrazione SIEM indipendente dal fornitore, mappando lo stack coordinato a ogni funzione NIST CSF 2.0.
- Rilevamento rapido a livello di blocco: Il motore ransomware integrato del B10000, basato sull'entropia e validato contro oltre 100 varianti, ha segnalato un tentativo di crittografia simulato in 4-5 minuti e ha acquisito automaticamente un'istantanea forense al momento del rilevamento.
- Immutabilità che resiste a una compromissione amministrativa: Gli snapshot di Virtual Lock applicati tramite array rimangono di sola lettura fino al termine del periodo di conservazione; nemmeno un account amministratore compromesso può eliminarli e qualsiasi tentativo di cancellazione viene registrato come evento visibile al SIEM.
- Recupero a più livelli: Nel laboratorio sono stati testati quattro livelli (Zerto per il RPO più basso, snapshot VME, Virtual Lock promote e StoreOnce Catalyst per la conservazione a lungo termine), con ripristini puliti sia da Virtual Lock che da Catalyst.
- Telemetria conforme alle normative: I syslog di sicurezza strutturati e normalizzati secondo lo schema comune di Elastic alimentano Elastic Security, CrowdStrike Falcon o qualsiasi SIEM moderno, supportando le prove DORA/NIS2 e i playbook SOAR automatizzati.
Panoramica dell'architettura
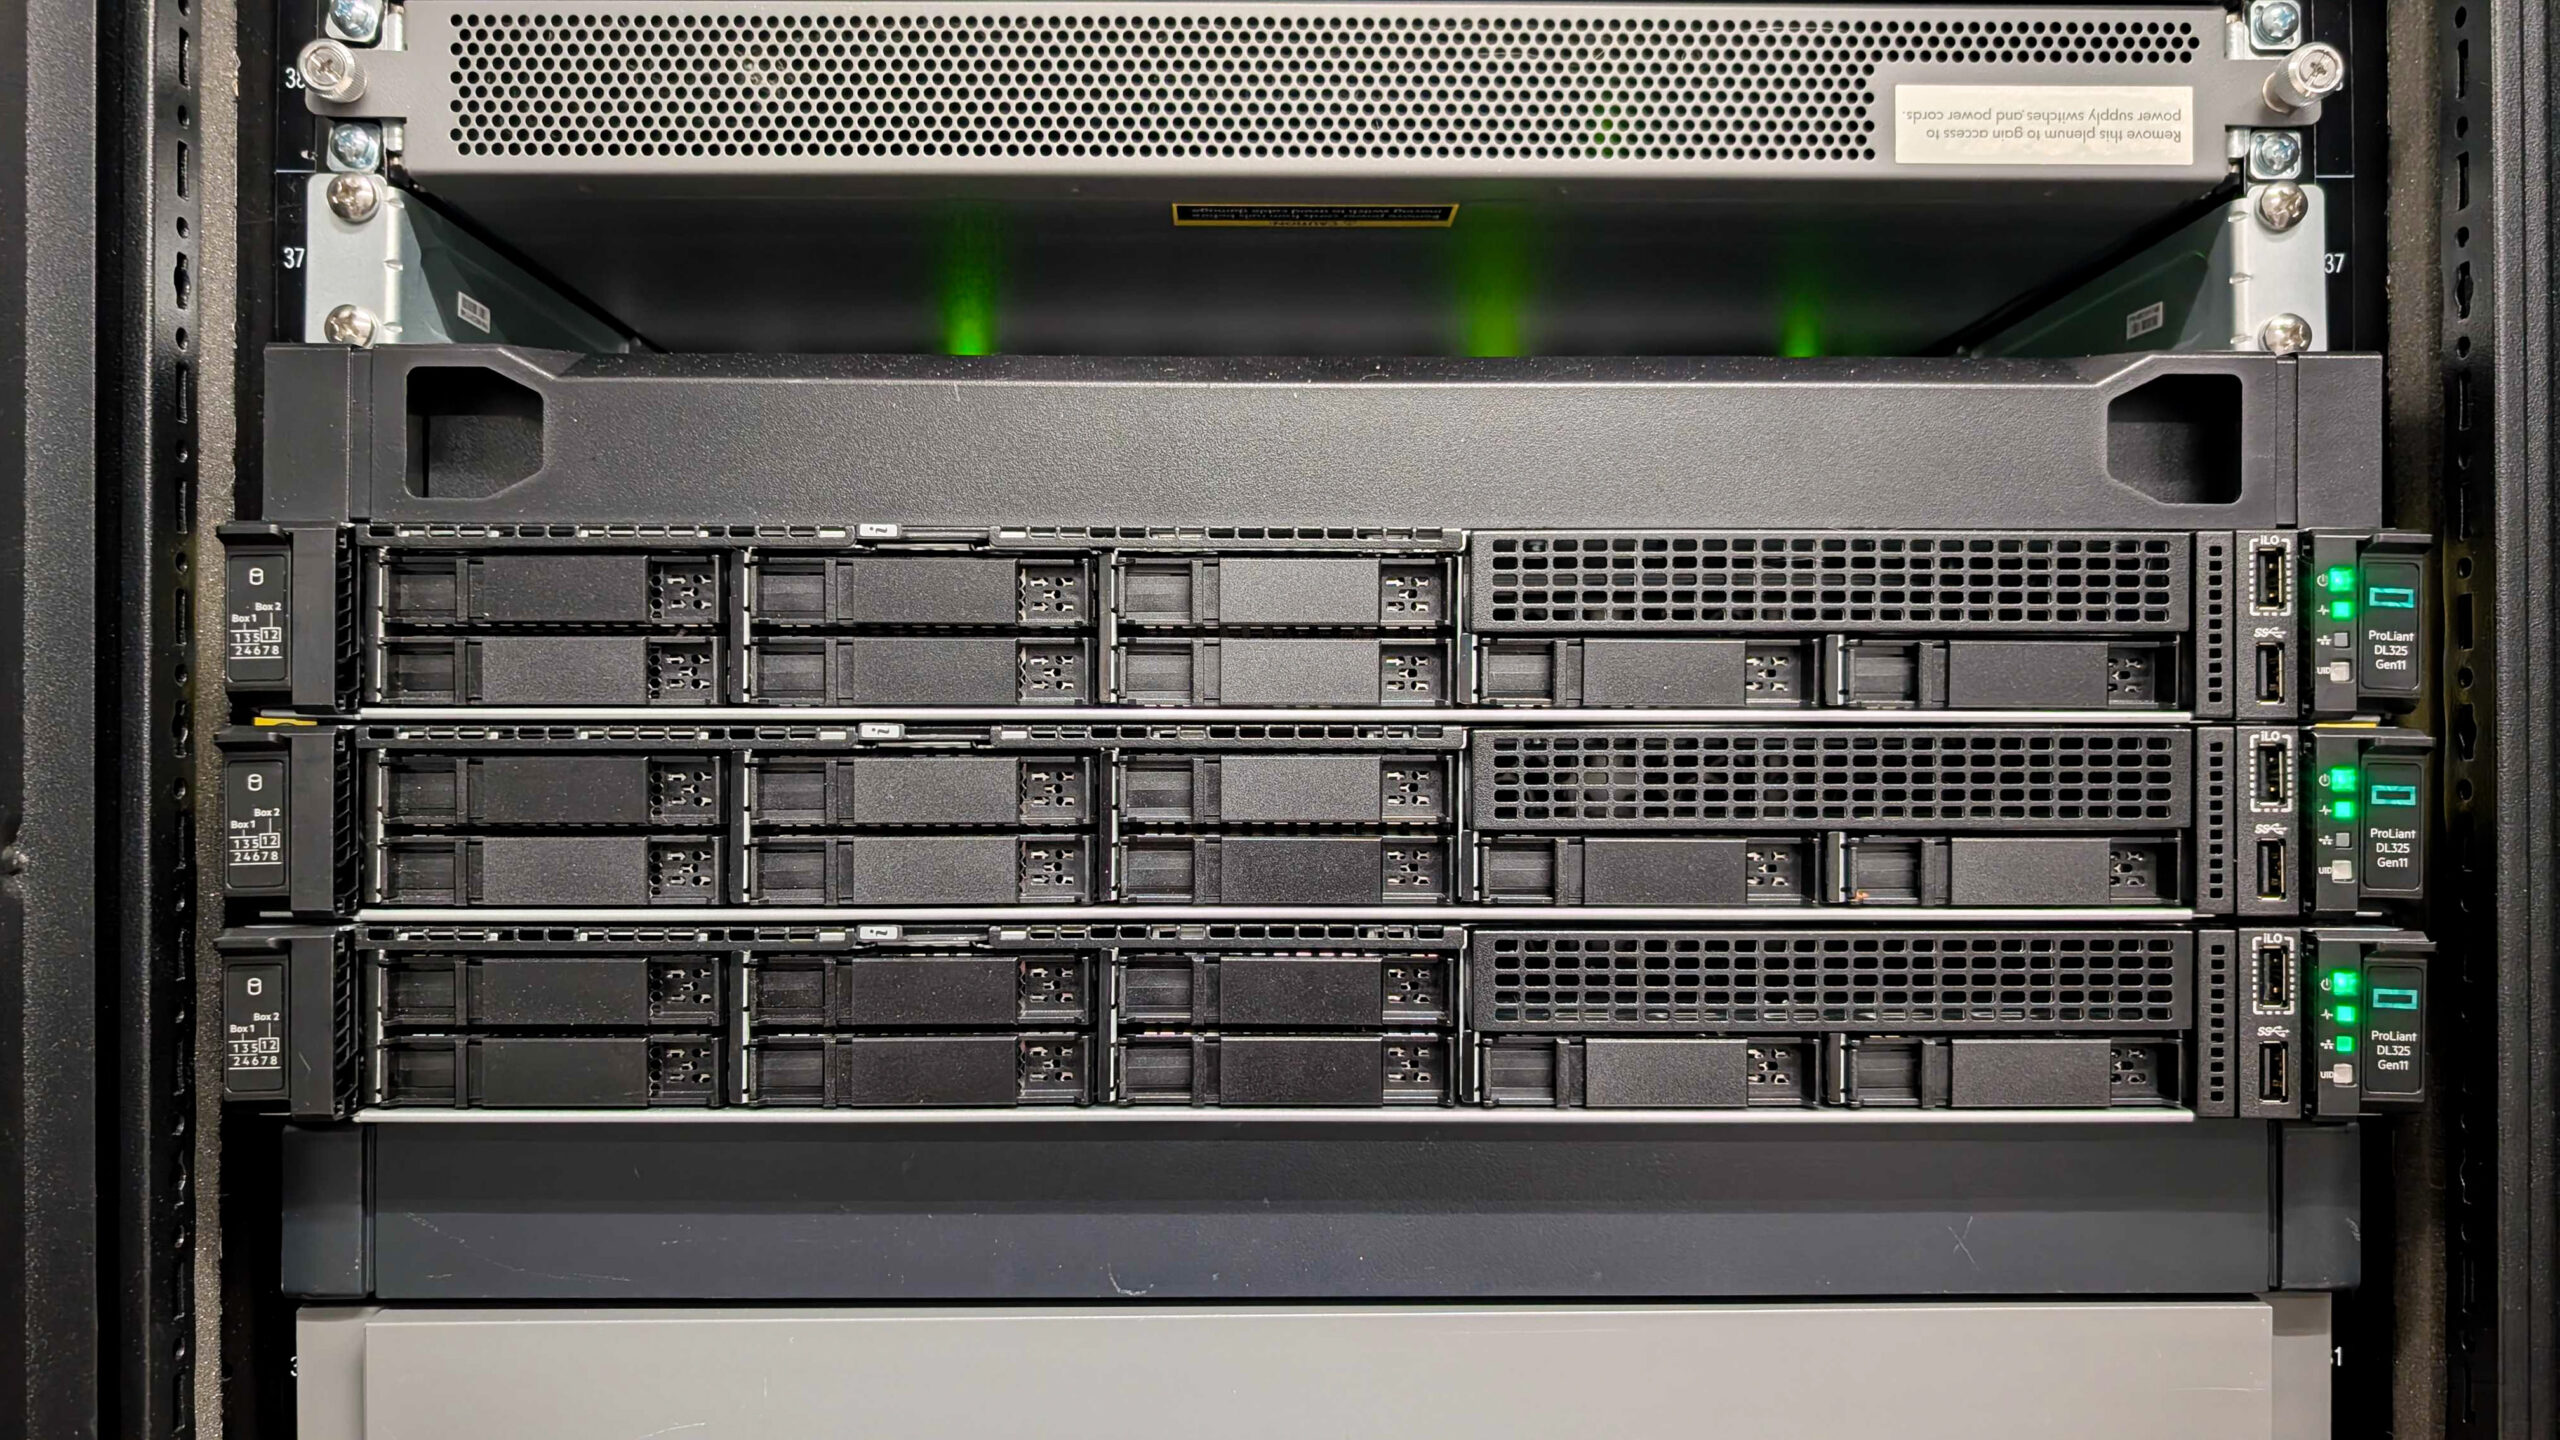
Per offrire un ambiente dimostrativo pratico anziché una distribuzione aziendale sovradimensionata, il team HPE ha creato uno stack di ripristino e backup compatto ma funzionale nel proprio laboratorio di Fort Collins. Al centro dell'ambiente si trova un cluster HPE VM Essentials (VME) a tre nodi in esecuzione su server HPE ProLiant DL325 Gen 11, che fornisce il livello di elaborazione per l'infrastruttura dimostrativa. Questi host sono interconnessi tramite la rete IP locale, che fornisce anche la connettività al livello NAS utilizzato nell'ambiente.
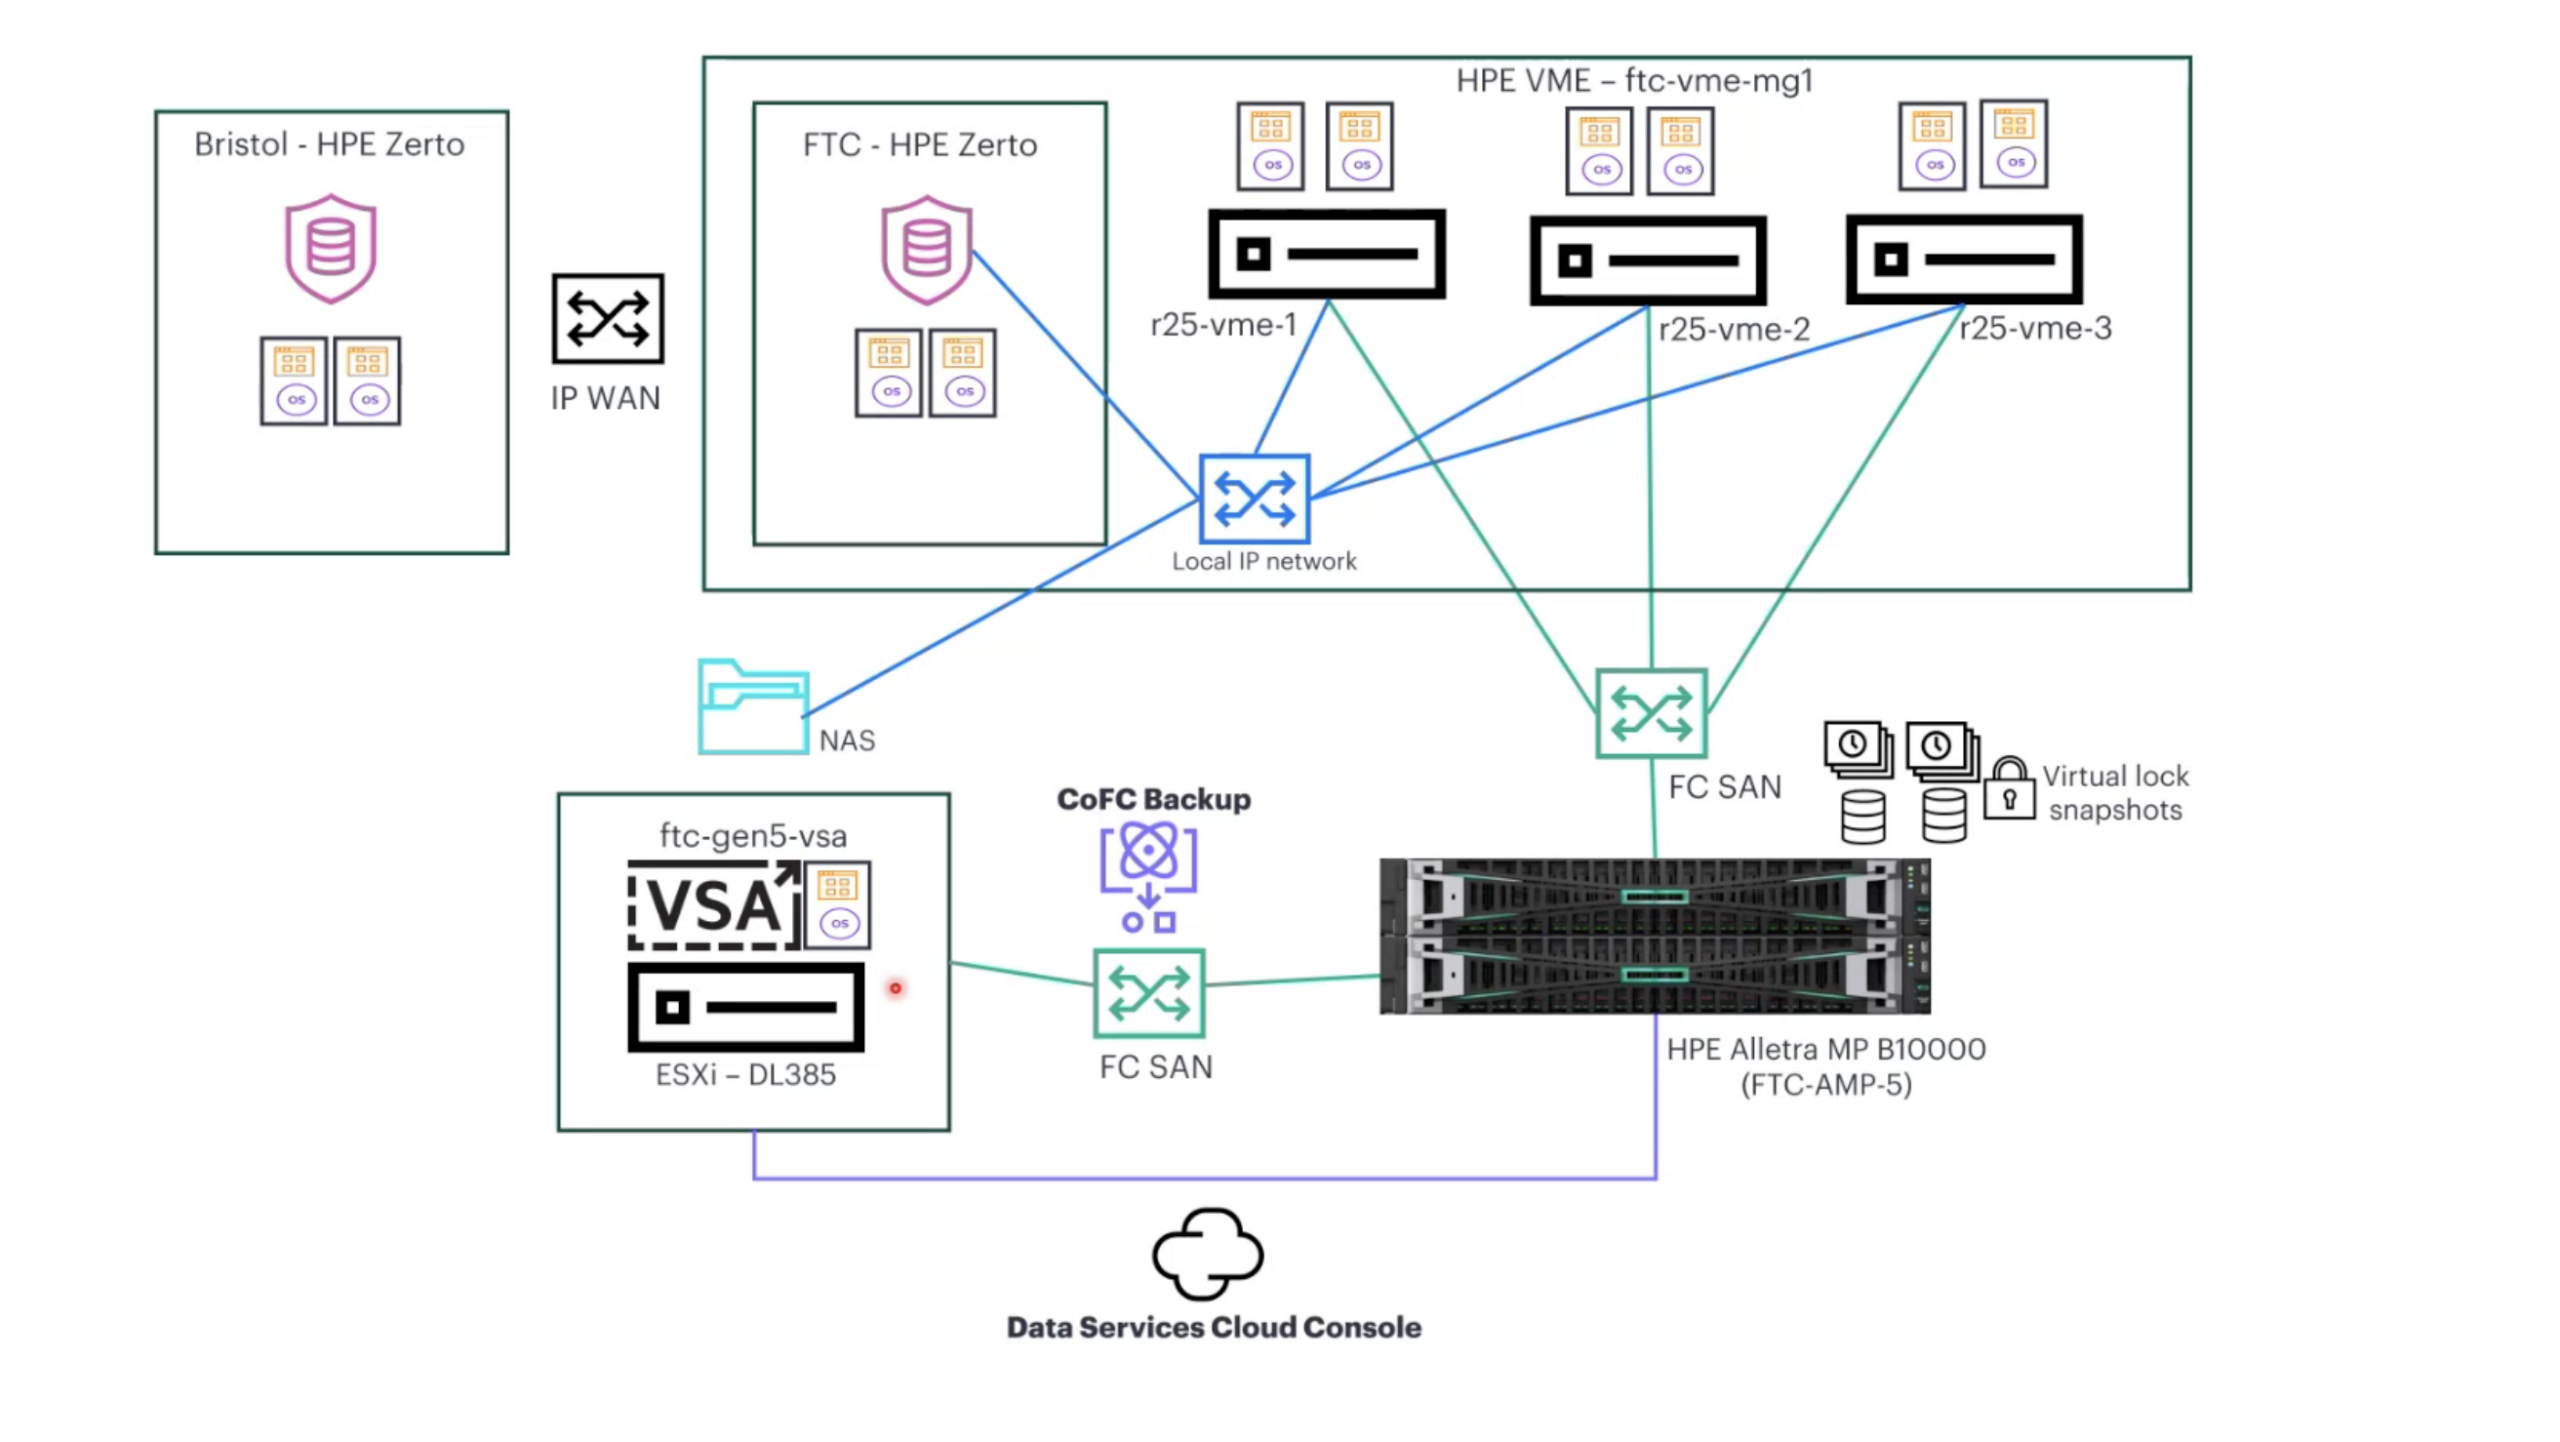
All'interno del cluster VME sono in esecuzione le macchine virtuali HPE Zerto, configurate in modo simile a come molte organizzazioni implementano attualmente Zerto in un ambiente VMware tradizionale. Sebbene l'infrastruttura sottostante utilizzi HPE VME, il flusso operativo e le funzionalità di ripristino rimangono familiari per gli amministratori che hanno esperienza con i flussi di lavoro di disaster recovery basati su VMware.
Nel laboratorio di Bristol, nel Regno Unito, è disponibile un ambiente Zerto secondario connesso tramite WAN, con regole firewall e percorsi di rete configurati per supportare la replica da Fort Collins. L'obiettivo di questa topologia è il ripristino multisito: replica continua e orchestrazione del ripristino di emergenza tra siti geograficamente separati. Ciò consentirebbe ai carichi di lavoro protetti a Fort Collins di effettuare il failover su Bristol qualora il sito primario diventasse non disponibile.
Durante questa attività, HPE ha eseguito la replica di Zerto localmente a Fort Collins a causa di limitazioni di larghezza di banda e distanza, e perché non era disponibile un secondo cluster VME parallelo per testare il flusso completo tra siti. La parte relativa a Bristol è documentata qui come infrastruttura configurata e disponibile, non come un failover tra siti eseguito in questa sessione.
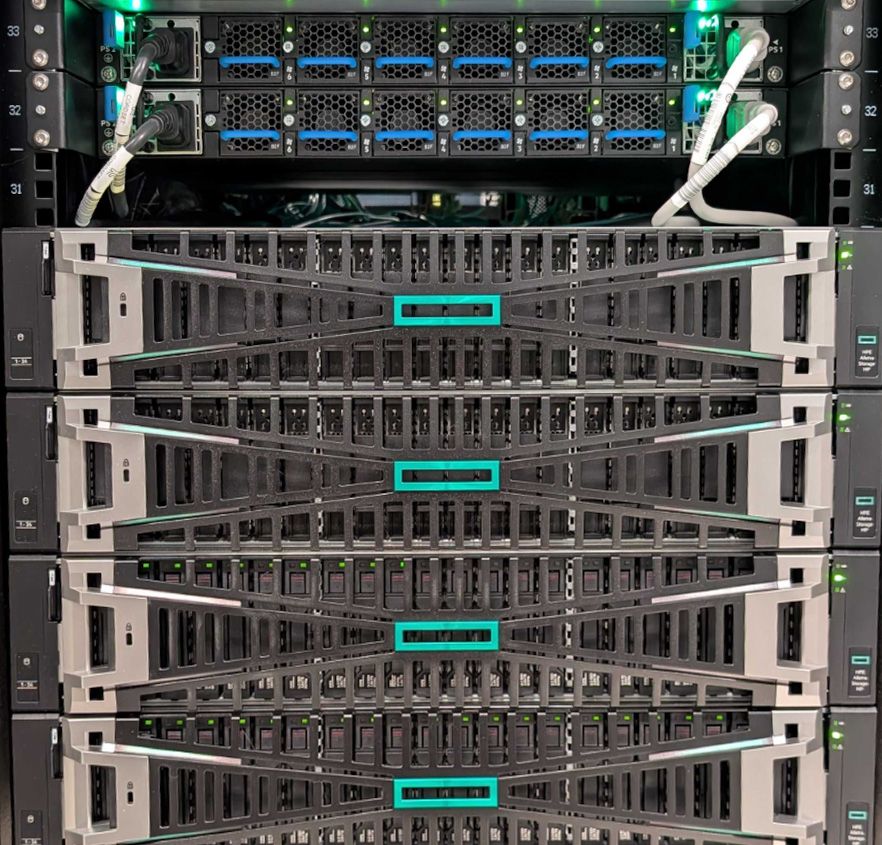
La connettività di storage nell'ambiente è suddivisa tra reti IP e Fibre Channel, a seconda del carico di lavoro. La struttura SAN FC collega gli host VME direttamente alla piattaforma HPE Alletra MP B10000, fornendo accesso condiviso allo storage aziendale in tutto il cluster. La B10000 presenta inoltre Catalyst su Fibre Channel all'appliance di storage virtuale (VSA) StoreOnce, che rappresenta il percorso utilizzato per i backup coerenti con le applicazioni tra l'array e la destinazione di backup. Gli snapshot di Virtual Lock svolgono un ruolo centrale nei flussi di lavoro di resilienza e immutabilità contro i ransomware sulla piattaforma e vengono illustrati in dettaglio nelle sezioni Protezione e Ripristino.
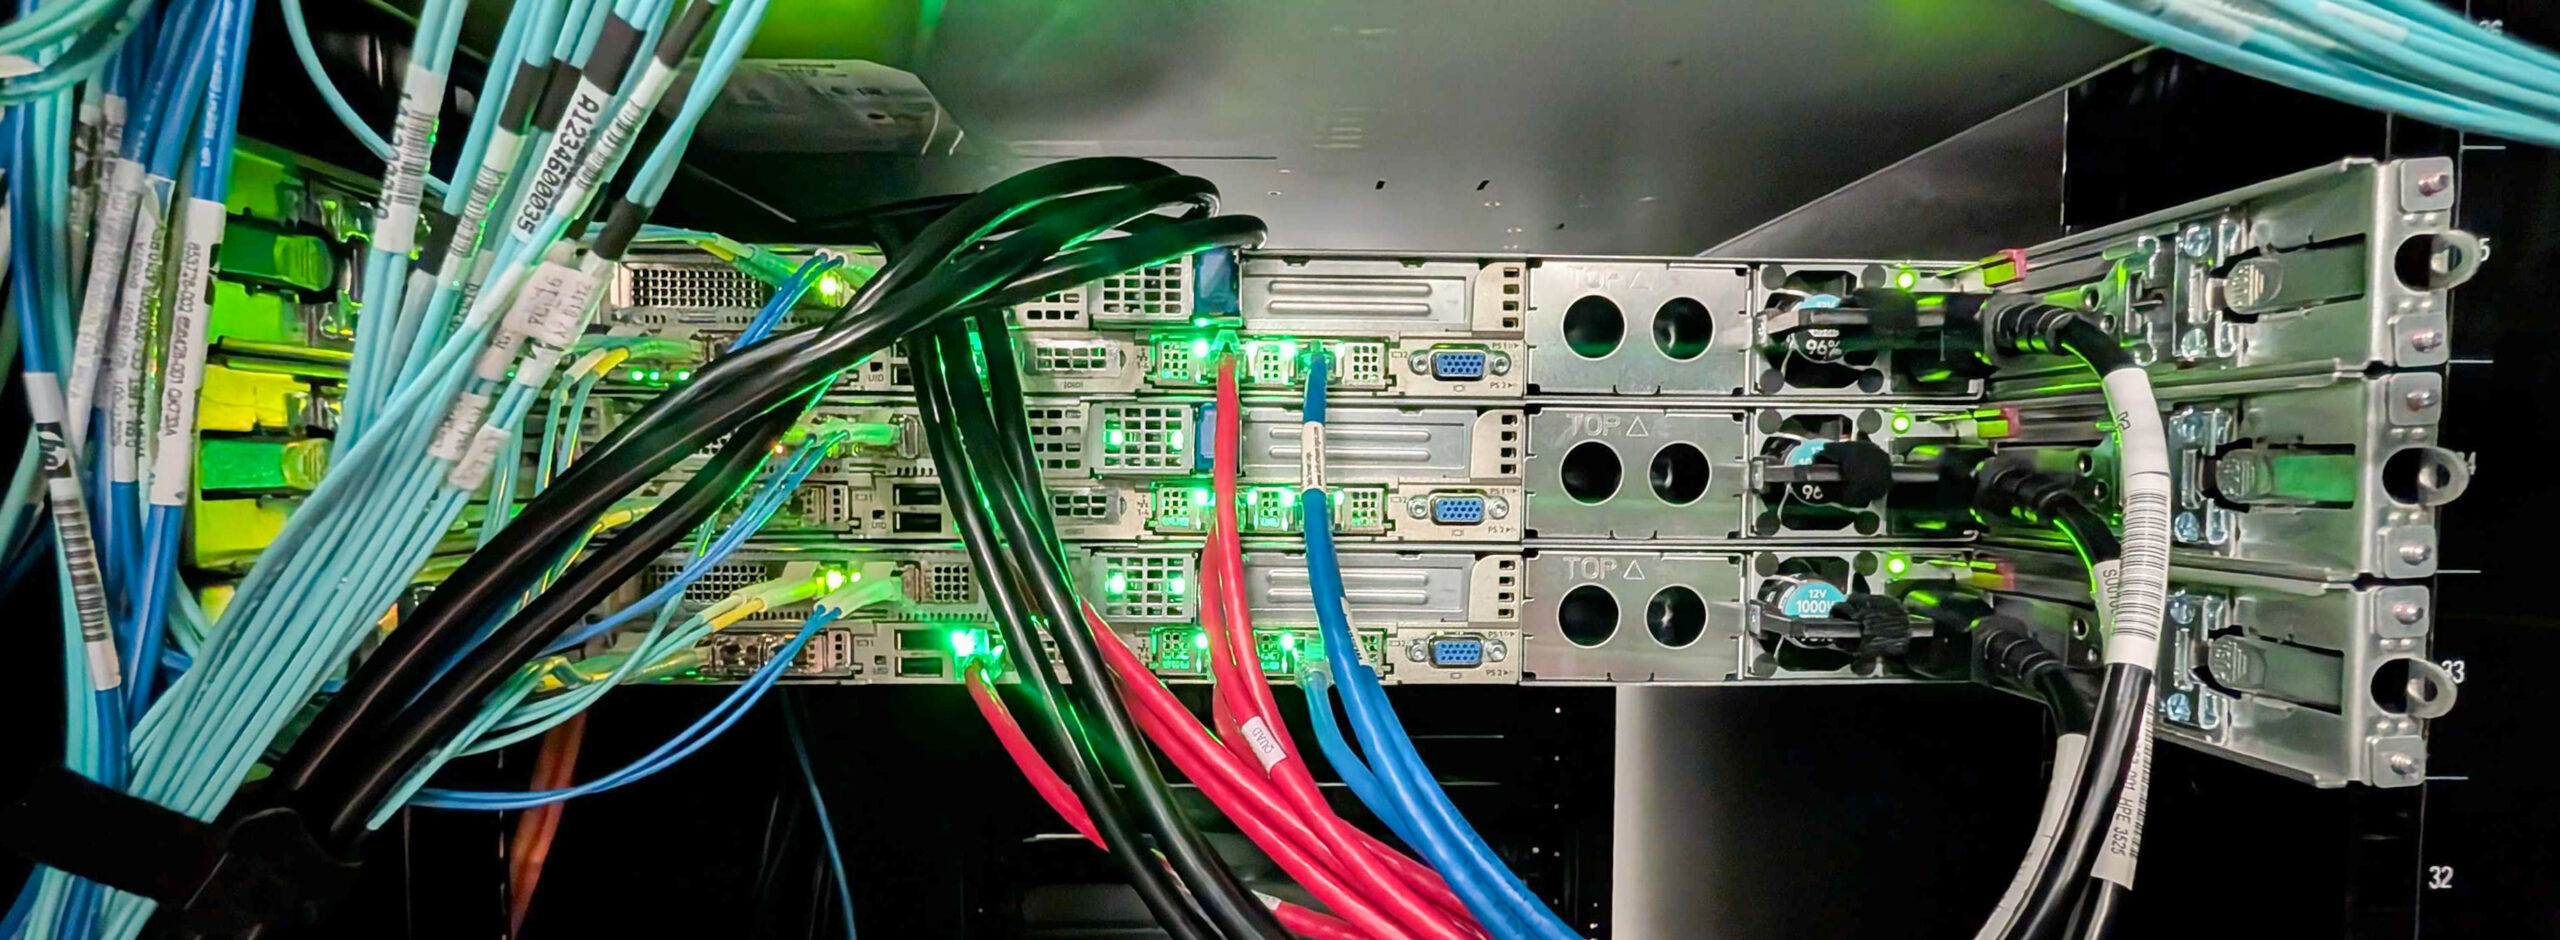
Per l'infrastruttura di backup, HPE ha implementato un'appliance StoreOnce Gen5 VSA in esecuzione su un singolo server HPE nel laboratorio. La VSA offre le stesse funzionalità principali di StoreOnce dell'appliance dedicata. La deduplicazione, la presentazione delle destinazioni di backup, il comportamento di replica e l'integrazione con l'intera suite di protezione dati HPE rimangono sostanzialmente invariati, sia che l'appliance venga implementata come VSA o su hardware dedicato. La VSA è ideale per laboratori, filiali, ambienti di test e casi d'uso di produzione di dimensioni ridotte, rendendo questa dimostrazione compatta pratica da implementare.
L'appliance fisica StoreOnce offre un vantaggio che va oltre la scalabilità e la velocità di trasmissione, e che risulta particolarmente rilevante nel contesto del ransomware analizzato in questo documento. Un VSA (Virtual Storage Agency) viene eseguito come guest su un hypervisor. Se un aggressore compromette il livello di virtualizzazione, ogni carico di lavoro su di esso, incluso un target di backup VSA, diventa accessibile. Un'appliance fisica StoreOnce non presenta tale dipendenza. Viene eseguita su hardware dedicato esterno all'hypervisor, che un aggressore dovrebbe superare, mantenendo il backup di ultima istanza su un'infrastruttura che l'aggressore non ha ancora violato. Per le implementazioni in produzione in cui StoreOnce rappresenta il livello di conservazione a lungo termine in una progettazione di resilienza informatica, l'appliance fisica è la scelta migliore proprio per questo motivo.
Sia il sistema HPE Alletra MP che StoreOnce VSA sono stati integrati nella console cloud di HPE Data Services, fornendo una gestione centralizzata basata sul cloud e visibilità sull'intero ambiente. Tramite la console cloud di Data Services, l'infrastruttura può essere monitorata, gestita e integrata nei flussi di lavoro più ampi dei servizi dati HPE da un'unica interfaccia, collegando le operazioni di storage, backup e ripristino.
Governare: Implementare la propria strategia
HPE non redige il vostro piano di governance. La policy viene definita dalla vostra organizzazione, dalla vostra compagnia assicurativa e dal vostro team legale. HPE fornisce le interfacce (API, CLI, Data Services Cloud Console e le guide di hardening pubblicate) che vi consentono di implementare tale policy, documentarne la conformità e verificarne la conformità tramite audit.
Questa distinzione è importante perché la maggior parte dei fornitori di soluzioni di storage presuppone tacitamente il contrario. Forniscono impostazioni predefinite preconfezionate spacciandole per best practice e considerano le discrepanze di configurazione come un problema di supporto anziché come un segnale di governance. Il B10000 ribalta questo approccio. Ogni azione amministrativa viene registrata. Ogni impostazione rilevante per le policy è esposta tramite API. Il flusso di syslog di sicurezza è strutturato per alimentare lo stesso SIEM in cui risiedono già tutte le altre prove di governance dell'organizzazione. Quando un revisore chiede chi ha modificato la policy delle password in una data specifica, la risposta è disponibile nello stesso pannello di controllo di tutti gli altri sistemi gestiti nell'infrastruttura.
Due discipline di governance meritano una menzione specifica. La prima è l'allineamento normativo. L'architettura di registrazione degli audit e di integrazione SIEM del B10000 supporta i controlli operativi richiesti dal Digital Operational Resilience Act (DORS) dell'UE e dalla Direttiva NIS2, che coprono le attività di rilevamento, risposta e ripristino, i flussi di lavoro di segnalazione degli incidenti e la visibilità di supervisione esecutiva che ci si aspetta dalla dirigenza. Centralizzare l'audit e la telemetria di sicurezza nel SIEM rende operativi tali obblighi. I controlli che l'auditor si aspetta di vedere non sono aggiunti in un secondo momento. Sono gli stessi controlli che il Security Operations Center (SOC) utilizza già quotidianamente per gestire la piattaforma.
Il secondo aspetto riguarda la supervisione da parte del management. I quadri normativi richiedono sempre più spesso che la dirigenza dimostri una visibilità tempestiva e consolidata sui rischi relativi alle tecnologie dell'informazione e della comunicazione (TIC). Un sistema di storage che nasconde la propria traccia di audit dietro un portale di supporto accessibile solo al fornitore non può soddisfare tale requisito. Un sistema che trasmette gli eventi di audit e di sicurezza direttamente al SIEM del cliente, invece, sì. Il B10000 è stato progettato proprio per questo secondo modello.
La piattaforma offre diverse funzionalità concrete. Le guide di hardening documentate definiscono la configurazione iniziale. I controlli di accesso basati sui ruoli e i meccanismi di doppia autorizzazione garantiscono la separazione dei compiti. L'autenticazione a più fattori è integrata. Per gli ambienti che lo richiedono, sono pubblicate le linee guida di hardening DISA STIG (Defense Information Systems Agency Security Technical Implementation Guide). Il flusso di syslog di sicurezza trasforma ogni azione rilevante per la governance in un evento interrogabile. La pianificazione è a cura del cliente. La strumentazione è responsabilità della piattaforma.
Identificare: Fiducia nella piattaforma
Nell'ambito del framework NIST CSF 2.0, l'identificazione consiste nel comprendere cosa possiede l'organizzazione, da dove proviene e quali rischi comporta. Per una piattaforma di storage, ciò si traduce in integrità della catena di fornitura, pratiche di sviluppo sicure e una posizione di partenza verificabile.
La catena di fornitura hardware e software di HPE è il fondamento. I componenti vengono reperiti attraverso canali certificati, il firmware è firmato digitalmente e le piattaforme vengono spedite con imballaggi e sigilli antimanomissione che il team di ricezione può verificare confrontandoli con le bolle di accompagnamento. La valutazione della catena di fornitura è un processo documentato che l'HPE Cybersecurity Center of Excellence utilizza per verificare che una B10000 in uscita dalla fabbrica in una settimana abbia la stessa provenienza di una B10000 in uscita in un'altra settimana.
Le pratiche di sviluppo sicuro estendono questa catena al software. Il sistema operativo B10000 viene sottoposto a test di penetrazione strutturati, che includono esercitazioni interne di red team e collaborazioni con terze parti, i cui risultati vengono poi integrati nel ciclo di rilascio. L'identificazione non è un'attività una tantum completata al momento dell'installazione. Si tratta di una verifica continua che la piattaforma ritenuta affidabile il primo giorno sia ancora la stessa presente il 400° giorno. Il B10000 fornisce gli artefatti (firmware firmato, download con hash verificato, guide di hardening, documentazione sullo sviluppo sicuro e flusso di log di audit) che consentono tale verifica. Cosa il team di sicurezza faccia con questi artefatti è, ancora una volta, una decisione del team di sicurezza.
Protezione: Mantenere la postura
La protezione del B10000 si basa su quattro meccanismi: pianificazione immutabile degli snapshot di Virtual Lock, una separazione deliberata tra snapshot dell'array e snapshot dell'hypervisor, replica su un secondo sito tramite Remote Copy nativo dell'array e Zerto, e rilevamento continuo delle discrepanze tramite il flusso di log di audit.
Pianificazione degli snapshot del blocco virtuale immutabile
Gli snapshot di Virtual Lock vengono creati secondo una pianificazione definita a livello di array e applicati direttamente dalla piattaforma di storage B10000. Gli snapshot rimangono immutabili e di sola lettura per tutta la durata del periodo di conservazione configurato, impedendone la modifica o la cancellazione fino alla scadenza. Le azioni amministrative intraprese sugli snapshot protetti vengono registrate nel registro di controllo. Tali registri possono essere inoltrati a piattaforme SIEM esterne, fornendo visibilità sui tentativi di violazione delle policy, inclusi i tentativi di cancellazione dai punti di ripristino protetti.
Snapshot B10000 rispetto agli snapshot VME
In questo contesto, le istantanee provengono da due fonti diverse, e la definizione delle politiche dipende dalla capacità di mantenerle distinte.
Gli snapshot pianificati da B10000 sono immutabili e di sola lettura e sono regolati dalla conservazione del blocco virtuale. Gli snapshot VME, acquisiti da HPE Morpheus VM Essentials a livello di hypervisor, sono modificabili e di lettura/scrittura per i flussi di lavoro operativi a livello di macchina virtuale.
Se un utente malintenzionato ottiene l'accesso all'hypervisor, gli snapshot VME diventano accessibili. Gli snapshot di Virtual Lock non lo sono. La pianificazione di Virtual Lock definisce il livello minimo di conservazione. Gli snapshot VME completano il livello operativo superiore.
Replica: a livello di array e a livello di applicazione
Un'istantanea di Virtual Lock nel sito primario non protegge dagli eventi a livello di sito e l'architettura offre due percorsi di replica distinti per ovviare a questo problema. Il primo è nativo dell'array: B10000 Remote Copy replica in modo asincrono i volumi su un secondo B10000 in un altro sito e, se combinato con le pianificazioni di istantanee di Virtual Lock nella destinazione, si traduce in un vault immutabile e fisicamente separato che non dipende dall'hypervisor o da alcun software a livello applicativo. Il secondo è Zerto, che opera a livello applicativo con replica quasi sincrona e registrazione continua del journal, fornendo il percorso di ripristino granulare a basso obiettivo di punto di ripristino (RPO) descritto nella sezione Ripristino.
Le due soluzioni sono complementari, non ridondanti. Remote Copy preserva le garanzie di immutabilità imposte dall'array tra i siti, mentre Zerto offre granularità dei checkpoint e failover orchestrato a livello di macchina virtuale. In questo progetto, la topologia è stata configurata per supportare la replica Zerto da Fort Collins alla sede HPE di Bristol, nel Regno Unito, ma durante la sessione di test la replica è stata eseguita localmente a Fort Collins a causa di limitazioni di larghezza di banda e di cluster parallelo. La parte relativa a Bristol è presente come topologia disponibile e attività di follow-up, non come ripristino tra siti dimostrato.
Rilevamento della deriva di configurazione
La guida di hardening definisce una baseline. Il flusso continuo di log di audit consente a un SIEM di verificare, quasi in tempo reale, che la baseline non si sia discostata. Modifiche alle policy delle password, modifiche alle policy di blocco, nuovi account, elevazione dei ruoli, modifiche alla pianificazione e modifiche alle destinazioni di replica vengono tutti visualizzati come eventi interrogabili. L'ambiente di laboratorio non includeva un SIEM, quindi il rilevamento delle deviazioni in questo progetto è stato osservato a livello di log di audit B10000 anziché in uno strumento di correlazione centralizzato. In un ambiente cliente con un SIEM implementato, gli stessi eventi di audit vengono inviati al SIEM tramite l'integrazione syslog descritta nella sezione Rilevamento.
Rilevamento: visibilità e allerta precoce
Il B10000 è dotato di un motore di rilevamento ransomware integrato che monitora i modelli di I/O dello storage in tempo reale e genera un avviso quando la firma statistica di una crittografia su larga scala viene rilevata nelle operazioni di scrittura sull'array. L'HPE Cybersecurity Center of Excellence ha convalidato il motore contro oltre 100 delle principali varianti di ransomware.
Il rilevamento è abilitato per singolo datastore dal lato VME. Quando un datastore viene creato o modificato in VME su un server di storage B10000, l'opzione di rilevamento ransomware è abilitata per impostazione predefinita per ogni volume di cui è stato effettuato il provisioning in quel datastore, con la possibilità di personalizzazione per singolo volume dopo la creazione. Questa funzionalità richiede la versione 10.5.0 o successiva del sistema operativo B10000. Nel laboratorio di Fort Collins, il datastore ftc-vme-mg1 è stato configurato per connettersi al server FTC-AMP-5 B10000 tramite Fibre Channel, con il rilevamento ransomware abilitato; questa è la configurazione utilizzata per la simulazione di ransomware descritta più avanti in questa sezione.
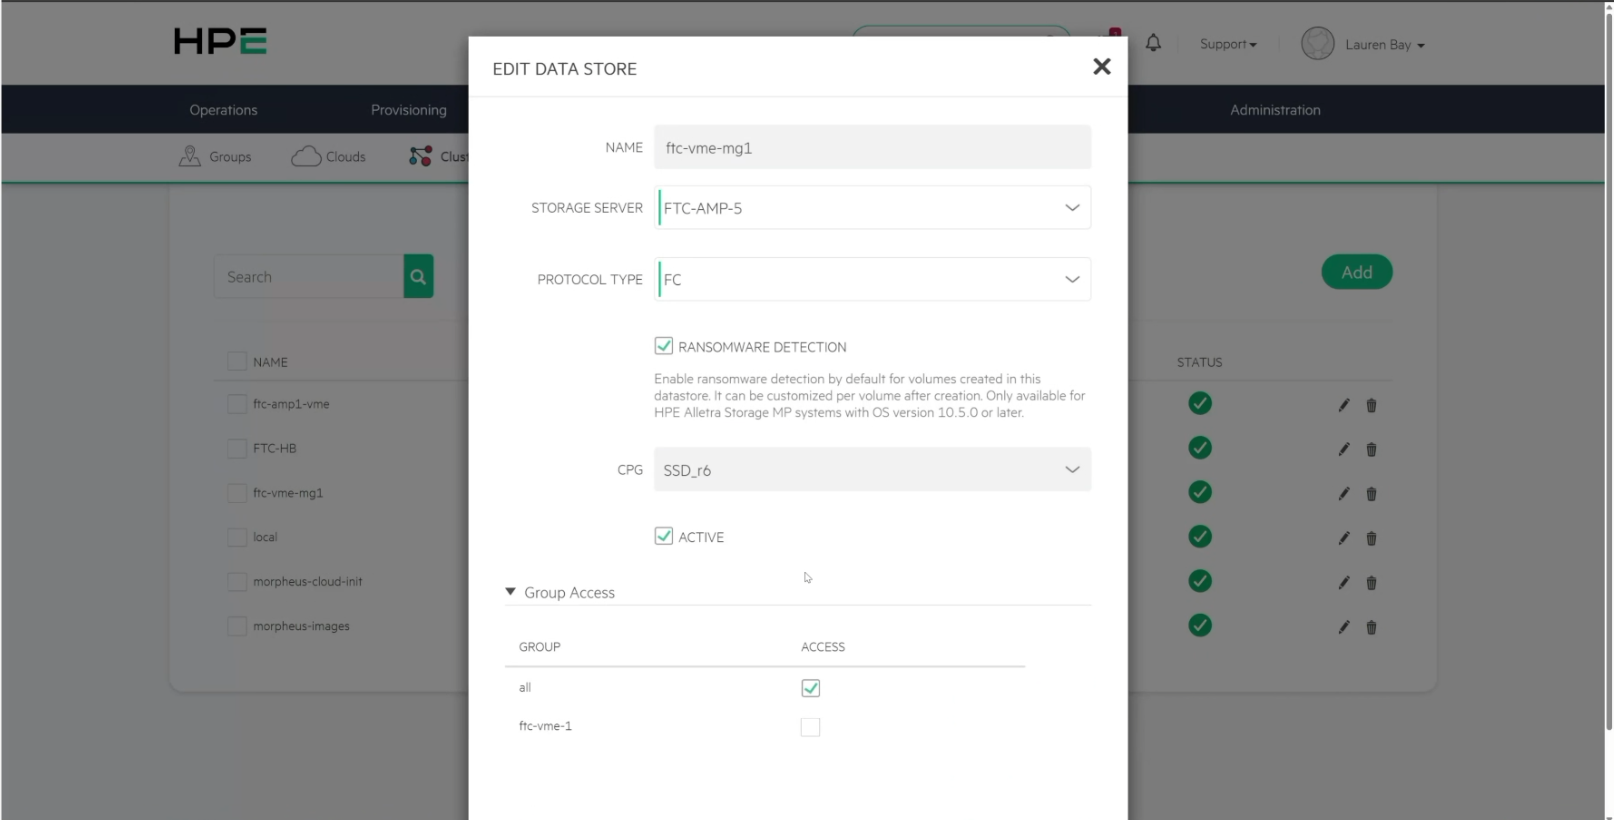
Configurazione del data store VME che mostra il data store ftc-vme-mg1 sull'FTC-AMP-5 B10000 su Fibre Channel, con il rilevamento ransomware abilitato.
Il B10000 supporta anche le policy di rilevamento ransomware a livello di sistema direttamente sull'array di storage, consentendo agli amministratori di definire la sensibilità di rilevamento globale e il comportamento di conservazione automatica degli snapshot sui volumi protetti. Come mostrato di seguito, nell'ambiente di Fort Collins era abilitata la policy di rilevamento ransomware a livello di array con un profilo di sensibilità a bassa affidabilità e la conservazione automatica degli snapshot configurata. Ciò fornisce un ulteriore livello di protezione oltre all'abilitazione per singolo datastore in VME, garantendo che il motore di rilevamento rimanga applicato in modo coerente a livello di piattaforma, indipendentemente da come vengono configurati i singoli volumi.
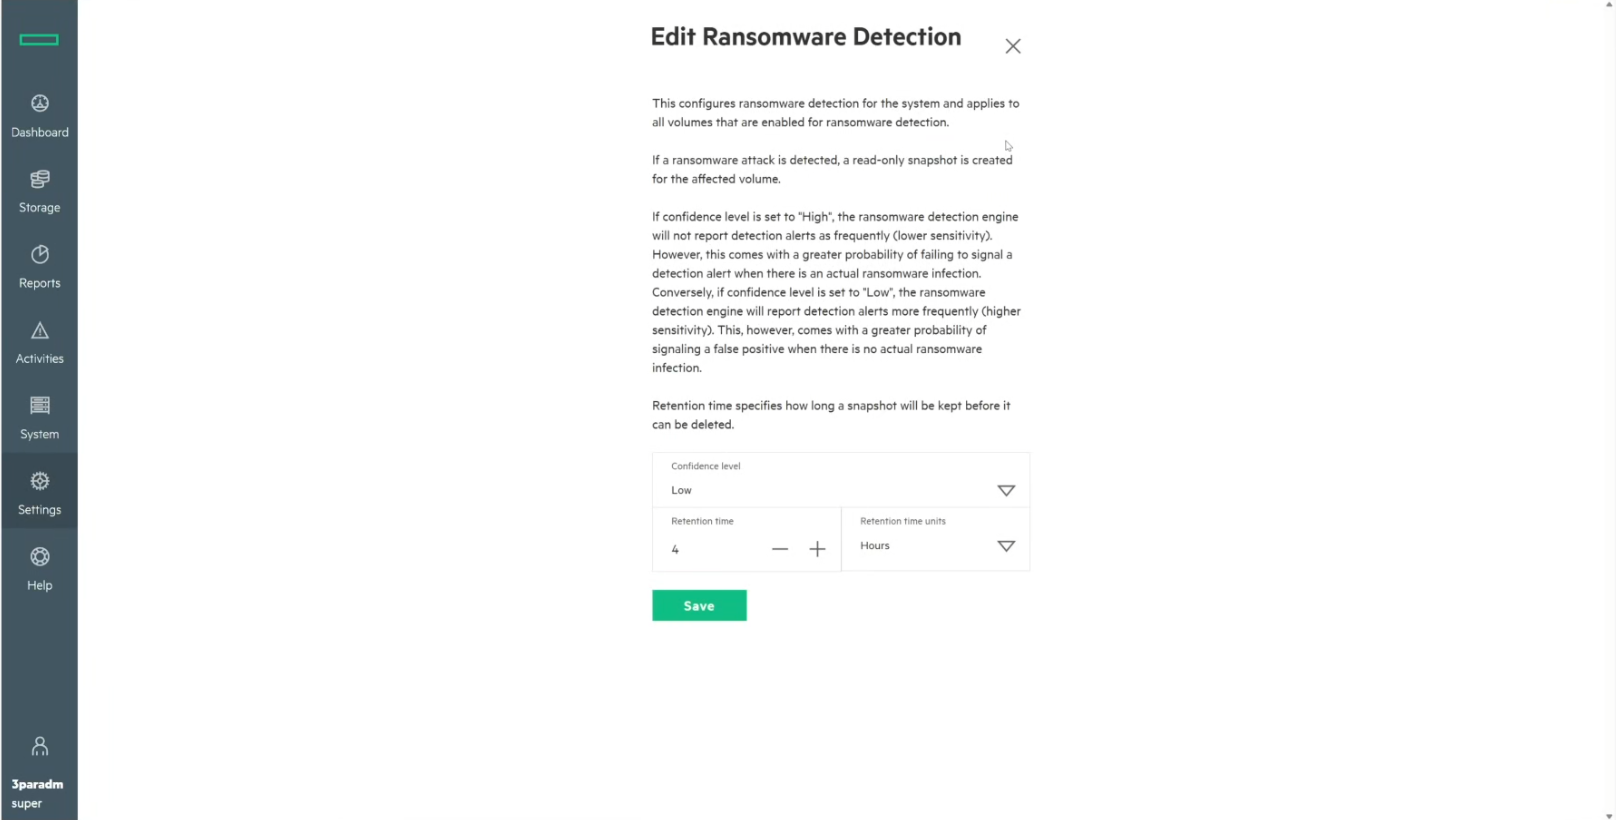
La logica di rilevamento per entrambi i metodi si basa sull'entropia. I dati casuali, ovvero i dati crittografati a livello di blocco, presentano un'elevata entropia. I dati di carico di lavoro legittimi, anche se compressi, hanno una struttura che il motore riconosce. Il motore utilizza un calcolo dell'entropia CuSum per misurare il disordine nelle scritture in ingresso rispetto a una linea di base prestabilita. La linea di base viene appresa durante una finestra di addestramento, quando un nuovo volume viene protetto per la prima volta, e viene poi mantenuta tramite un profilo I/O mobile di un'ora, in modo che le variazioni legittime del carico di lavoro non generino falsi positivi. Quando l'entropia si discosta dalla linea di base con un margine statisticamente significativo, il motore segnala il volume.
Per il SOC, il concetto chiave è che si tratta di un motore di rilevamento della crittografia che funge da ultima linea di difesa per l'ambiente, non da sostituto della protezione degli endpoint. L'endpoint è il punto in cui il ransomware dovrebbe essere rilevato per primo. Il B10000 intercetta ciò che l'endpoint non è riuscito a rilevare.
Integrazione SIEM
L'integrazione è volutamente indipendente dal fornitore. Il ruolo di HPE è quello di fornire le basi e gli strumenti affinché il B10000 possa inviare i dati di audit e di log di sicurezza a qualsiasi SIEM già in uso presso un'organizzazione, anziché indirizzare i clienti verso un singolo strumento preferito da HPE. Gli avvisi di rilevamento e gli eventi di audit vengono esportati tramite il flusso syslog di sicurezza. L'aggregatore basato su Fluentd che HPE pubblica su GitHub prende il messaggio syslog grezzo, lo normalizza in Elastic Common Schema e tagga l'evento con campi come "event.kind: alert" e "event.severity: high" in modo che il motore di regole esistente della piattaforma ricevente lo rilevi senza bisogno di analisi personalizzata. La differenza fondamentale è che questi dati non sono semplicemente compatibili con i moderni SIEM; sono attivi. Arrivano strutturati per attivare avvisi automatici e risposte a valle, anziché rimanere in un archivio di log in attesa di essere interrogati a posteriori. Elastic Security e CrowdStrike Falcon Next-Gen SIEM sono piattaforme che HPE ha esplicitamente validato, e il formato syslog aperto consente di integrare Microsoft Sentinel e altri SIEM moderni con uno sforzo comparabile.
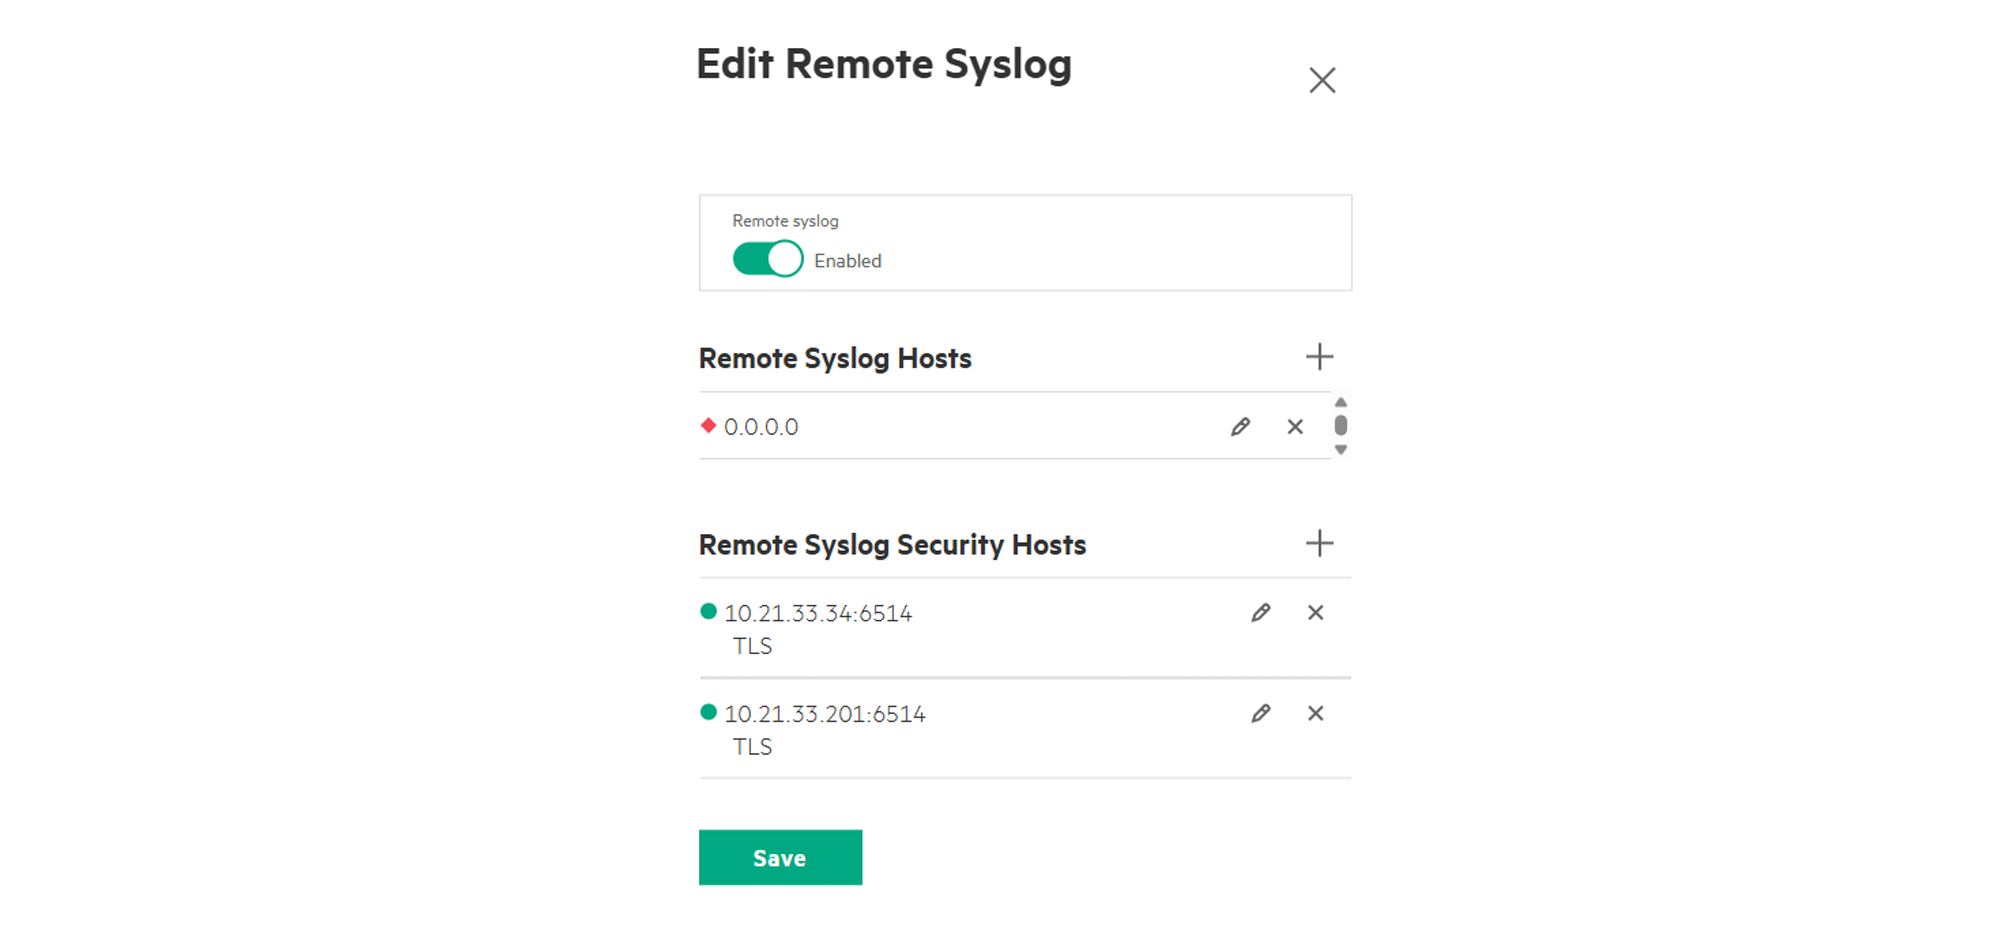
Simulazione di ransomware su un host Windows
Durante i test remoti presso il laboratorio HPE di Fort Collins, è stato eseguito un carico di lavoro simulato di ransomware su un host Windows collegato a un volume protetto da Virtual Lock sul B10000. La simulazione ha eseguito uno script di crittografia controllato che ha prodotto il modello di scrittura ad alta entropia caratteristico di un evento di crittografia ransomware, senza utilizzare malware reale.
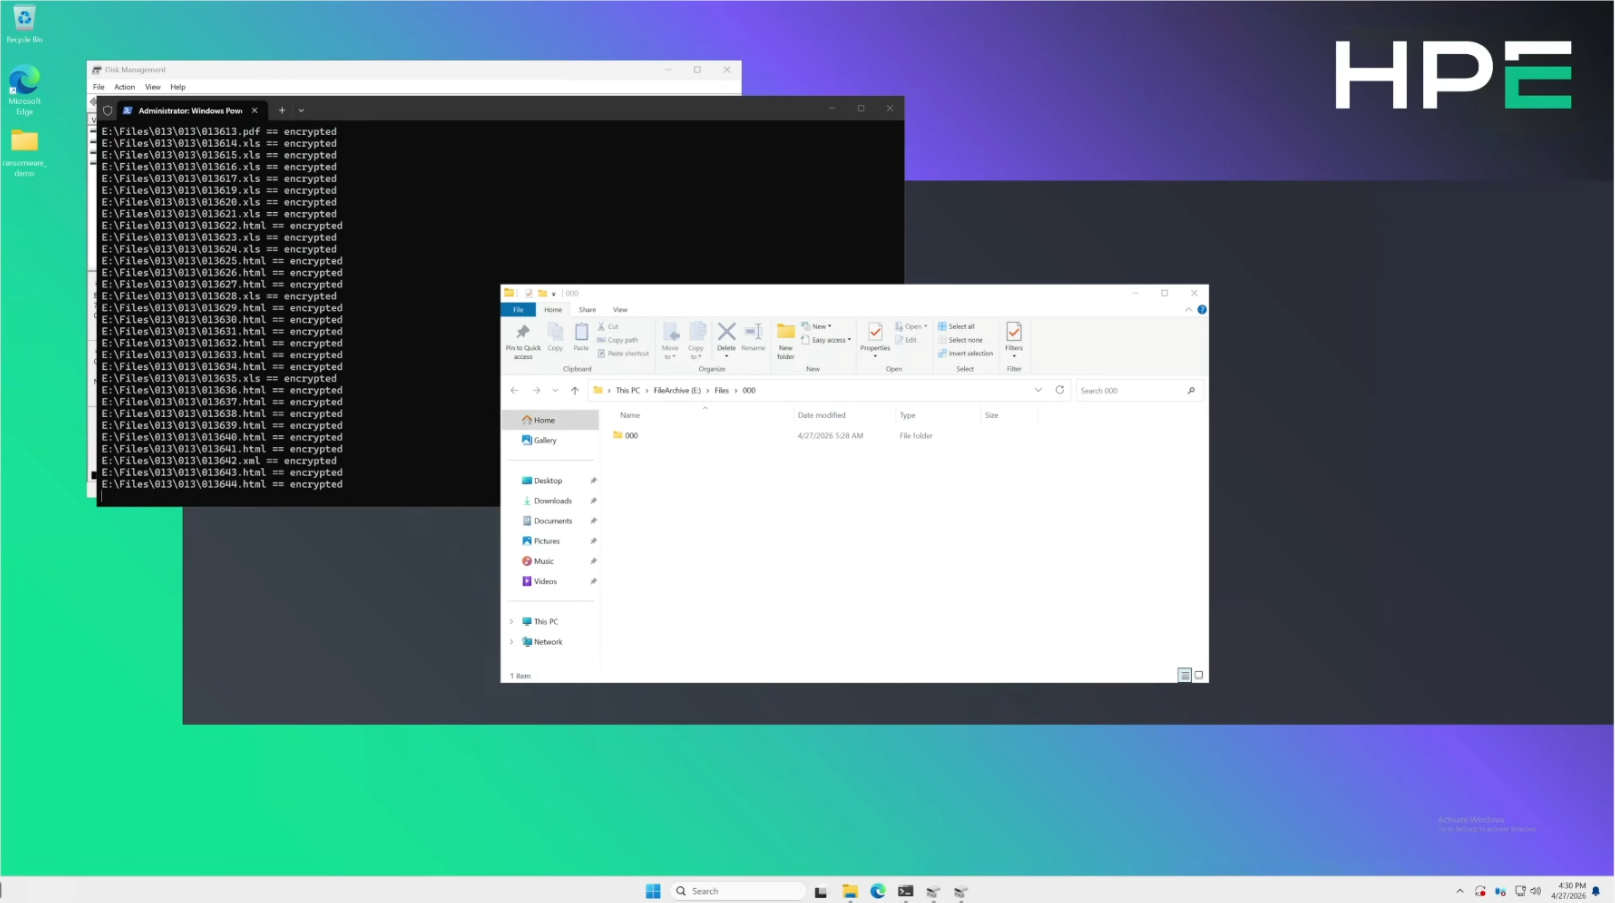
Il motore di rilevamento B10000 ha generato l'allarme entro quattro o cinque minuti dall'inizio della scrittura dello script di crittografia sul volume. L'allarme è apparso sulla console di gestione B10000 con l'identificazione del volume interessato.
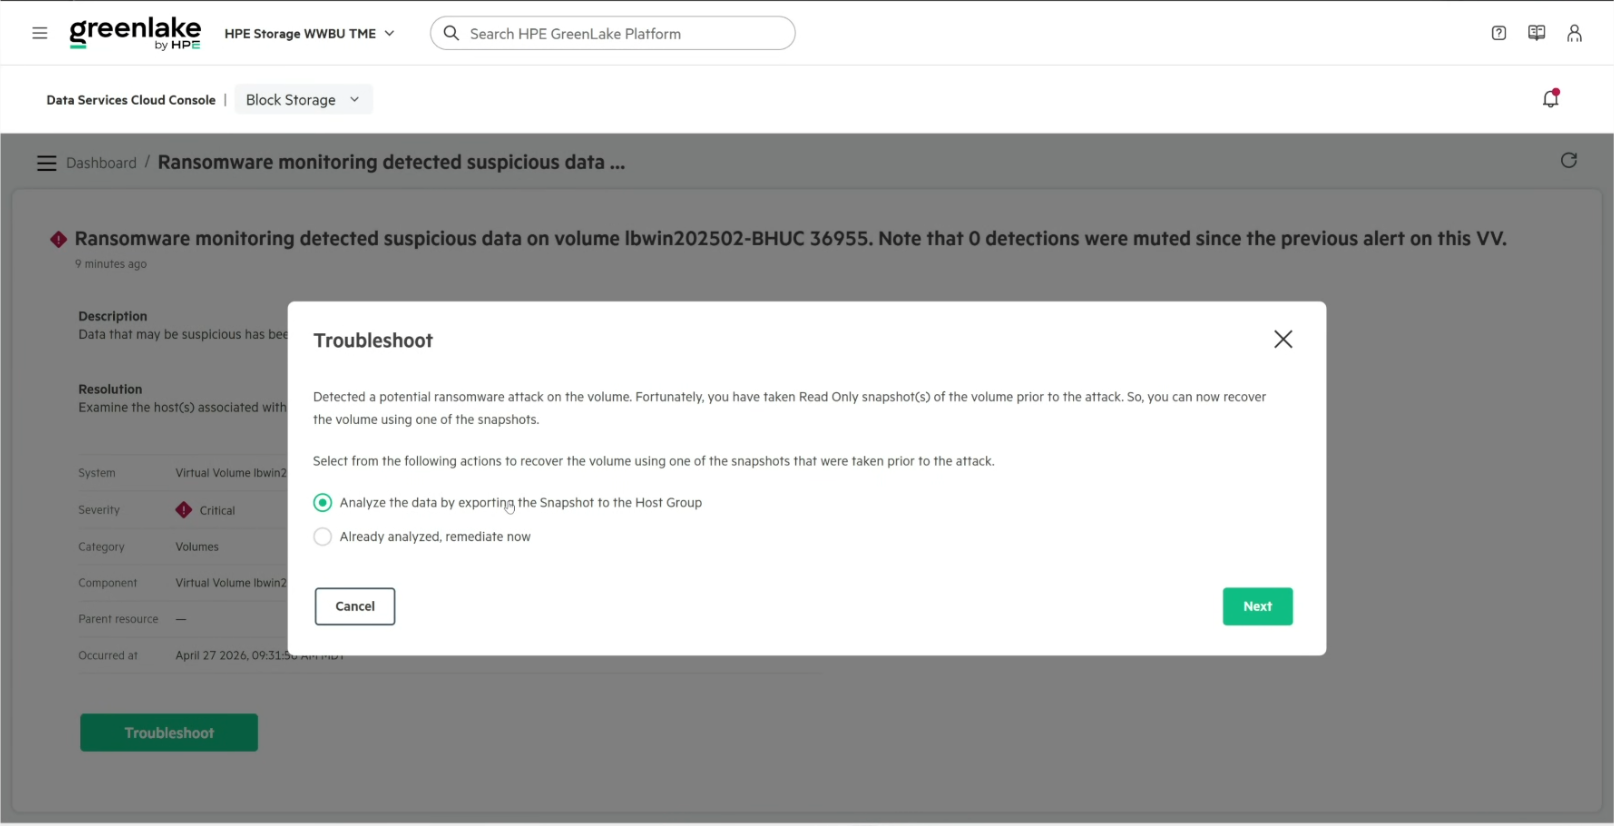
La finestra temporale di quattro o cinque minuti è sufficientemente breve da consentire agli snapshot immutabili acquisiti al momento del rilevamento o in prossimità di esso di catturare un punto preciso nel tempo, prima che l'attaccante abbia terminato di attraversare il volume. È più veloce della maggior parte delle analisi comportamentali eseguite a livello applicativo perché il B10000 rileva le scritture a livello di blocco non appena si verificano.
Rispondere: dall'allerta all'azione
Quando il motore di rilevamento del ransomware B10000 si attiva, la piattaforma intraprende autonomamente azioni protettive, prima ancora che intervenga qualsiasi sistema esterno. Al momento del rilevamento, l'array acquisisce un'istantanea immutabile del volume interessato e ne contrassegna lo stato come degradato. Questa istantanea di allerta non rappresenta un punto di ripristino pulito e non deve essere utilizzata per il ripristino, poiché potrebbe contenere dati crittografati. È destinata all'analisi forense, preservando lo stato del volume al momento del rilevamento dell'attacco. È importante sottolineare che l'array non blocca l'accesso al volume. I dati rimangono accessibili, una scelta progettuale deliberata. L'array genera l'allarme e preserva le prove. Tuttavia, lascia agli operatori la decisione su come procedere, poiché sono nella posizione migliore per valutare se l'evento sia un attacco reale o un falso positivo, come ad esempio un carico di lavoro di crittografia o compressione legittimo di grandi dimensioni.
Questo comportamento autonomo rappresenta il livello minimo, non il limite massimo, della capacità di risposta. Poiché viene eseguito direttamente sull'array, non dipende dall'attivazione di una regola SIEM, dal corretto funzionamento di un flusso syslog o dalla presenza online di uno strumento di automazione esterno. Se tutti gli altri livelli falliscono, l'istantanea del momento esiste comunque. Questa indipendenza è il punto cruciale: la risposta più importante si verifica indipendentemente dal funzionamento del resto dello stack.
Al di sopra di tale livello, l'integrazione SIEM attiva descritta nella sezione Rilevamento consente la risposta orchestrata. Poiché gli avvisi del B10000 arrivano strutturati per attivare un'azione anziché essere archiviati, un cliente può creare playbook automatizzati nel SIEM o nella piattaforma SOAR (Security Orchestration, Automation, and Response) di sicurezza che già utilizza, che si tratti di estendere la conservazione degli snapshot sui volumi interessati, isolare l'host, aprire un ticket di incidente o notificare il team di risposta. HPE fornisce il segnale attivo e strutturato. La logica di orchestrazione risiede negli strumenti scelti dal cliente, mantenendo la risposta allineata con i runbook e i flussi di lavoro di approvazione che il team di sicurezza ha già creato.
Un chiarimento è importante in questo contesto, poiché il linguaggio dell'interfaccia può essere stratificato. L'avviso B10000 offre un'opzione per analizzare i dati, ma l'array stesso non esegue la scansione né identifica malware specifici. Tale opzione presuppone che il cliente disponga di propri strumenti di scansione e analisi forense per individuare i dati interessati. Il compito del B10000 è il rilevamento e la conservazione, non la bonifica.
Recupero: Ripristino e convalida a livelli
Il ripristino è un insieme di decisioni a più livelli: quale punto di ripristino, da quale livello, in quale ambiente, convalidato da quale processo. L'architettura realizzata nel laboratorio di Fort Collins supporta un modello di ripristino a quattro livelli, in cui ogni livello esiste perché gli altri non risolvono lo stesso problema.
Livello 1: Zerto per una protezione continua. La replica quasi sincrona con registrazione continua del journal offre il RPO più basso dell'intera suite. Il ripristino granulare consente al team di risposta agli incidenti di ripristinare una singola VM o un singolo file a un checkpoint precedente all'evento di crittografia. Questo è il livello da utilizzare quando l'avviso viene generato rapidamente e la finestra di opportunità per l'attaccante è limitata.
Livello 2 : protezione nativa VME per il ripristino giornaliero a livello di macchina virtuale. Il flusso di snapshot di HPE Morpheus VM Essentials fornisce il ripristino operativo con granularità a livello di macchina virtuale. Questo livello gestisce le attività di ripristino di routine e funge da soluzione di ripiego qualora il Livello 1 non sia disponibile.
Livello 3: snapshot di blocco virtuale immutabili B10000 per il rollback a livello di volume. Questo è il livello più importante nel caso di ransomware. Gli snapshot di blocco virtuale sono protetti da cancellazione e modifica e l'operazione di promozione è nativa di B10000, senza ISV di terze parti nella catena di dipendenze.
Livello 4: Ripristino di StoreOnce Catalyst per la conservazione a lungo termine e il ripristino tra array. I livelli da 1 a 3 proteggono da eventi misurati in ore o giorni. Il livello 4 protegge da eventi misurati in settimane o mesi, nei casi in cui l'attaccante abbia stabilito la persistenza molto prima che la crittografia venisse attivata e quando l'unico punto di ripristino pulito è precedente al periodo di conservazione di qualsiasi snapshot di storage primario. Gli storage Catalyst sono deduplicati, immutabili e possono essere replicati tra i sistemi StoreOnce o scollegati nello storage a oggetti di Cloud Bank. Catalyst Copy e Cloud Bank Detach insieme forniscono il livello "1" nel modello 3-2-1-1. Questo è anche il livello in cui la distinzione tra fisico e VSA, menzionata nella panoramica dell'architettura, assume maggiore importanza. Essendo l'opzione di ripristino di ultima istanza, il livello 4 deve essere in grado di sopravvivere a una compromissione dell'hypervisor. Questo è il motivo per cui StoreOnce viene distribuito su un appliance fisico dedicato piuttosto che come VSA in produzione.
Valutazione di chiusura
Le due domande che un esperto di sicurezza si pone riguardo a una piattaforma di storage sono se l'infrastruttura rimanga sotto il controllo dell'organizzazione e se i dati rimangano protetti. Dopo aver analizzato l'architettura nel laboratorio di Fort Collins, il B10000 risponde a entrambe le domande in modo più completo di quanto possa fare un semplice array di storage, perché la risposta non si ferma all'array.
La piattaforma registra ogni azione amministrativa, espone ogni impostazione rilevante per le policy tramite la sua API e trasmette in streaming i dati di telemetria di audit e sicurezza risultanti a qualsiasi SIEM già in uso nell'organizzazione. Il piano di governance rimane di competenza del cliente, ma la strumentazione necessaria per implementarlo, documentarlo e dimostrarlo a un revisore è presente ed esposta, anziché essere nascosta dietro un portale del fornitore. Gli snapshot di Virtual Lock immutabili garantiscono che nemmeno un account amministratore compromesso possa distruggere silenziosamente i punti di ripristino, e qualsiasi tentativo in tal senso viene registrato come evento interrogabile.
In termini di protezione, il ciclo di rilevamento e ripristino al centro dell'architettura è la parte che si è dimostrata più efficace. Il B10000 ha segnalato il carico di lavoro di crittografia simulato entro quattro o cinque minuti a livello di blocco e ha acquisito un'istantanea forense al momento del rilevamento, senza attendere un sistema esterno. Il volume interessato è stato ripristinato correttamente sia tramite la promozione pianificata di un'istantanea di Virtual Lock, sia tramite un ripristino con StoreOnce Catalyst. Questa è la sequenza più importante durante un incidente, ed è stata eseguita senza la necessità di prodotti di terze parti.
Ciò che distingue l'architettura non è che il B10000 sia drasticamente più sicuro degli array concorrenti se considerato singolarmente. È piuttosto il fatto che HPE è uno dei pochi fornitori in grado di offrire storage, virtualizzazione, replica, backup e osservabilità come un sistema coordinato, e di testare tale sistema nel suo complesso contro ransomware reali nel proprio laboratorio, anziché validare ogni componente singolarmente. Per un'azienda che possiede l'infrastruttura ma risponde a un team di sicurezza separato e a un ente regolatore esterno, questo coordinamento fa la differenza tra una raccolta di prodotti validi e una strategia di resilienza operativa anche sotto pressione.
Anche l'architettura si sta evolvendo rapidamente. HPE sta adottando un ritmo di rilascio costante per l'intera infrastruttura, con una maggiore integrazione tra VM Essentials e B10000, l'estensione del rilevamento dei ransomware a tipi di dati aggiuntivi oltre ai volumi a blocchi e la pubblicazione di un'architettura di riferimento full-stack, il tutto previsto nella roadmap a breve termine. La direzione intrapresa indica una maggiore gestione nativa del coordinamento da parte della piattaforma e un modello più chiaro per la realizzazione del tipo di architettura di resilienza analizzata in questo documento.
Per anni, il sistema di storage è stato considerato uno dei beni più sicuri dell'edificio, soprattutto perché nessuno gli prestava attenzione. Questa architettura propone invece l'opposto: il sistema di storage non dovrebbe essere una scatola trascurata in un angolo, ma un partecipante attivo nel rilevamento e nella sopravvivenza a un attacco, a condizione che l'organizzazione si impegni a trasformare queste capacità in un piano d'azione.
Pagina del prodotto HPE B10000
Risorse addizionali
HPE Alletra Storage MP B10000 – Resilienza informatica con rilevamento ransomware adattivo ai dati
Framework di protezione ransomware per HPE Alletra Storage MP B10000
HPE Alletra Storage MP B10000 − Integrazione SIEM
Guida di sicurezza per gli amministratori di HPE Alletra Storage MP B10000
Guida alla sicurezza di HPE Alletra Storage MP B10000
Video
hpe.com/uk/en/resource-library.video.hpe-alletra-storage-mp-b10000-r6-ransomware-detection-with…
hpe.com/uk/en/resource-library.video.hpe-alletra-storage-mp-b10000-and…
Questo rapporto è sponsorizzato da HPE. Tutti i pareri e le opinioni espressi in questo rapporto si basano sulla nostra visione imparziale dei prodotti in esame.



 Amazon