

Quando si parla di NVIDIA DGX Spark, emergono subito due aspetti. Il primo è la specifica principale: 128 GB di memoria unificata in un dispositivo desktop da circa 4,000 dollari, una cifra che sarebbe sembrata impensabile anche solo due anni fa. Il secondo è la connettività di rete da 200 GB sul retro del dispositivo. La presenza di una vera e propria infrastruttura di livello data center su un dispositivo desktop è ciò che attira l'attenzione, perché implica qualcosa di più di una semplice workstation più veloce. Implica la possibilità di connettere più Spark e replicare fisicamente i dati, una configurazione multi-nodo che un tempo era appannaggio esclusivo dei rack.
Questa recensione esamina tale capacità. Eseguiamo un benchmark dell'inferenza distribuita su tutte e tre le implementazioni OEM di Spark a nostra disposizione, accoppiate in cluster a due nodi connessi tramite la rete a 200 Gb, e analizziamo diverse varianti del modello e tre configurazioni di carico di lavoro. Inoltre, adottiamo una scelta metodologica deliberata sulla suddivisione del modello tra i due box, che si discosta dalla raccomandazione predefinita di NVIDIA, e la giustifichiamo con dati concreti. Prima di tutto ciò, tuttavia, due elementi contestuali sono fondamentali: la rete che rende possibile il clustering e i motivi per cui una persona potrebbe volerlo utilizzare o meno.
Il tessuto da 200 GB
Nella nostra recensione originale del DGX Spark abbiamo trattato in dettaglio l'implementazione di rete, ma vale la pena riepilogare i concetti fondamentali perché tutto ciò che analizzeremo in questa recensione si basa su di essi. Sul retro di ogni Spark sono presenti due alloggiamenti QSFP56 gestiti da una SmartNIC NVIDIA ConnectX-7 integrata. Sulla carta, i due alloggiamenti suggeriscono una connettività aggregata di 400 GB, ma il vero limite è rappresentato dallo standard PCIe: la ConnectX-7 si trova dietro una coppia di collegamenti Gen5 x4 e la piattaforma raggiunge un massimo di 200 GB di larghezza di banda utilizzabile, indipendentemente da come sono cablati gli alloggiamenti. Un singolo alloggiamento QSFP56 occupato offre già tutti i 200 Gb supportati dal dispositivo, quindi la seconda porta serve per la flessibilità topologica piuttosto che per un throughput aggiuntivo.
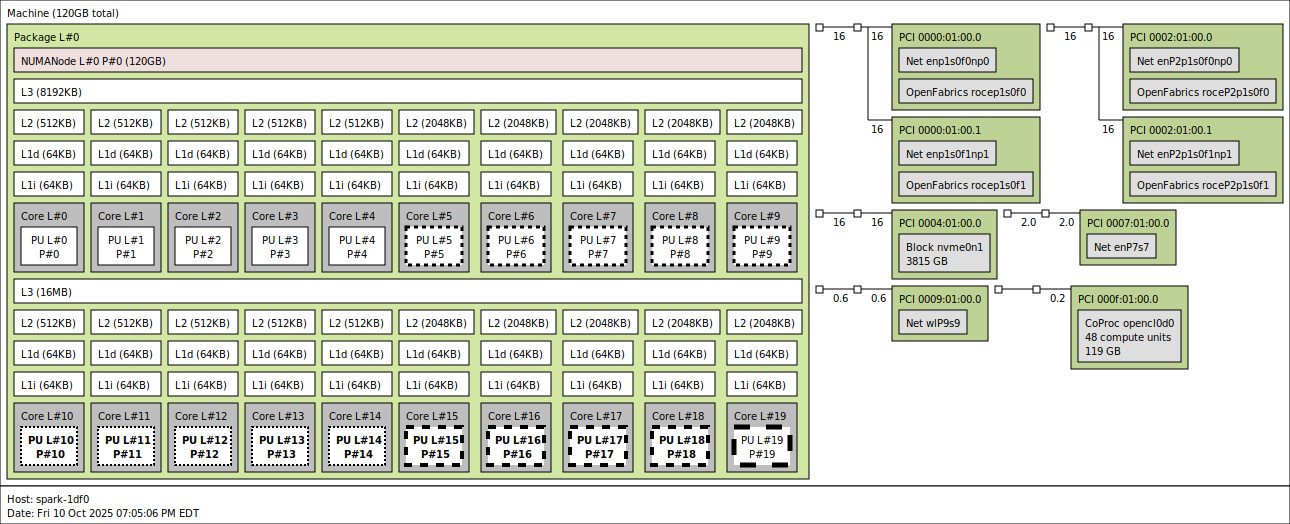
Questa flessibilità si manifesta in tre configurazioni comuni. La più semplice prevede una singola porta da 200 GB utilizzata come collegamento diretto Spark-to-Spark, che è la configurazione a due nodi convalidata da NVIDIA e che abbiamo utilizzato per questa recensione. La seconda prevede due porte da 100 Gb che configurano una topologia ad anello tra gli Spark per creare un cluster senza bisogno di uno switch. La terza è una configurazione a ruoli separati in cui un cage è collegato a uno Spark peer per il clustering e l'altro a un'unità di storage ad alta velocità tramite NVMe-oF, utile quando il dataset di lavoro non può essere contenuto nell'NVMe interno dello Spark.
NVIDIA vende Spark in tre configurazioni che corrispondono direttamente alle modalità di utilizzo della rete. Una singola Spark per il lavoro individuale su desktop, un cluster validato con due Spark, collegati direttamente tramite la rete a 200 Gb, per modelli estesi e, a partire dal GTC di quest'anno, una configurazione a quattro unità che NVIDIA ha presentato pubblicamente in risposta alla richiesta degli utenti di superare il limite di due nodi. La configurazione a due Spark è quella che NVIDIA commercializza attivamente, quella che la maggior parte dei lettori utilizzerà effettivamente e quella che riteniamo rappresenti il limite superiore ragionevole per l'inferenza di tipo produttivo su questo hardware. È anche quella che questa recensione utilizza per i benchmark end-to-end.
Perché Cluster Sparks in primo luogo
Il motivo principale per cui conviene utilizzare un cluster Spark è lo stesso di qualsiasi altro cluster: un singolo server da 128 GB non può contenere tutti i modelli importanti. Distribuire un modello con 120 miliardi di parametri su due server apre la strada a una classe di carichi di lavoro che altrimenti non sarebbero gestibili. Questo è il caso d'uso principale, ed è anche quello che viene mostrato più frequentemente nelle demo.
Il motivo meno ovvio, e probabilmente il più importante per la clientela di NVIDIA su questa piattaforma, è l'apprendimento. NVIDIA posiziona Spark come punto di ingresso. La documentazione ufficiale , i notebook di esempio e i manuali per i partner considerano il dispositivo come uno strumento didattico. Offrono guide di prim'ordine per qualsiasi attività, dalla creazione di un modello preconfigurato tramite un'interfaccia di chat locale all'esecuzione di un assistente di programmazione su un endpoint ospitato, dalla messa a punto di piccoli modelli alla creazione di applicazioni end-to-end in PyTorch e JAX. L'idea è che chiunque, anche senza aver mai scritto un kernel CUDA, possa passare da zero a un flusso di lavoro di intelligenza artificiale funzionante sulla propria scrivania in un fine settimana, e lo stesso vale per gli ingegneri di settori diversi dal machine learning che desiderano un ambiente di test autonomo e completamente controllato. Un cluster con due Spark estende questa superficie didattica al territorio multi-nodo: la stessa persona può ora anche imparare come funzionano effettivamente il parallelismo tensoriale, il parallelismo pipeline e le librerie di comunicazione collettiva, con una rete sufficientemente realistica da evidenziare i colli di bottiglia reali.
Ciò che invece manca vistosamente in qualsiasi dichiarazione di NVIDIA è l'affermazione che Spark sia pensato per l'inferenza in ambienti di produzione. Jensen ha parlato di co-progettazione hardware-software in quasi tutti i keynote degli ultimi anni, e il principio si applica anche in questo caso. Ogni piattaforma NVIDIA è ottimizzata per una specifica tipologia di carico di lavoro, e Spark è ottimizzata per l'esplorazione e l'apprendimento individuali, non per la gestione del traffico. Le nostre precedenti recensioni di Spark hanno già dimostrato che la piattaforma è fortemente limitata dalla larghezza di banda della memoria nella maggior parte delle attività di inferenza, e la rete accentua ulteriormente questo limite non appena si utilizza il clustering. Un singolo collegamento a 200 Gb, pur essendo impressionante per un desktop, è significativamente più lento di una connessione PCIe Gen5 x16 all'interno di un singolo chassis, e i modelli di comunicazione collettiva che funzionano correttamente su una coppia di GPU per data center collegate tramite bridge NVLink non si adattano a una rete a 200 Gb senza subire penalizzazioni significative in termini di latenza.
Questo è il vero motivo per cui NVIDIA ha limitato a lungo la configurazione ufficialmente supportata a due Spark, e perché la dimostrazione con quattro unità al GTC è stata una risposta alla domanda degli utenti piuttosto che un'espansione organica del prodotto. Nulla impedisce allo stack software di funzionare su quattro o otto nodi, e diversi utenti e testate giornalistiche hanno pubblicato risultati ottenuti con cluster più grandi. I dati prestazionali di questi esperimenti non sono generalmente incoraggianti: l'infrastruttura tra i nodi diventa il costo dominante e le prestazioni complessive si degradano drasticamente; inoltre, il throughput per utente nelle configurazioni più complesse può scendere a poche unità di token al secondo per qualsiasi modello sufficientemente grande da giustificare la creazione del cluster. A quel punto, la configurazione si configura più come un laboratorio di apprendimento che come una piattaforma di servizio.
Niente di tutto ciò è da intendersi come una svalutazione. Il clustering di Spark è un metodo davvero eccellente per sviluppare un'intuizione per l'inferenza e l'addestramento distribuiti, altrimenti preclusa a costo di centinaia di migliaia di dollari in hardware per data center. Il valore didattico di poter effettivamente osservare bolle di pipeline, colli di bottiglia all-reduce e compromessi di parallelismo su un sistema di proprietà è significativo. Il nostro piano successivo era di approfondire ulteriormente la questione addestrando da zero un piccolo modello con 1 miliardo di parametri o meno di 1 miliardo su un cluster dual-Spark, con una configurazione scelta per rispecchiare il più fedelmente possibile le condizioni in cui opera una reale esecuzione di pre-addestramento distribuito, in modo da poter dimostrare esattamente dove questa classe di cluster è appropriata e dove non lo è. Questo progetto è attualmente in secondo piano, mentre ci dedichiamo ad altri articoli che potreste aver già visto e attendiamo l'arrivo dei componenti ottici per il nostro nuovo switch core da 800 Gb per il laboratorio. Prevediamo di riprenderlo una volta che la configurazione del laboratorio sarà stabile.
Di seguito ci concentriamo sul caso d'uso per il quale la configurazione dual-Spark è più giustificabile: l'inferenza distribuita di modelli sufficientemente grandi da richiedere entrambi i dispositivi, con benchmark eseguiti su tutte e tre le implementazioni OEM a nostra disposizione. Prima di passare ai dati per singolo modello, la sezione successiva spiega perché riportiamo questi numeri in una configurazione parallela a pipeline piuttosto che in quella parallela a tensori, che la documentazione ufficiale di NVIDIA tende a utilizzare di default.
Test di Performance
Perché riportiamo il parallelismo della pipeline e non il parallelismo tensoriale
Le guide DGX Spark pubblicate da NVIDIA e la maggior parte del materiale di riferimento si basano sul parallelismo tensoriale (TP) per descrivere come scalare un modello su due macchine Spark. Il TP suddivide ogni moltiplicazione di matrici tra entrambe le GPU, in modo che ogni layer venga eseguito simultaneamente su entrambi i dispositivi e i risultati parziali vengano combinati tramite un'operazione all-reduce dopo ogni blocco di attenzione e MLP. Il parallelismo pipeline (PP) adotta un approccio diverso: divide il modello a metà per layer, posiziona la prima metà su una macchina e la seconda sull'altra, quindi trasmette le attivazioni tra di esse. Ogni richiesta continua a fluire attraverso il modello completo, ma in un dato istante solo una macchina sta eseguendo i calcoli per un determinato token mentre l'altra sta lavorando sul microbatch successivo.
Il compromesso si riduce a ciò che viaggia sulla rete. Uno stack dual-Spark collega i due sistemi tramite un collegamento ConnectX-7 da 200 GbE, che è veloce per un collegamento di rete ma lento rispetto alla larghezza di banda della memoria all'interno di un singolo Spark. L'operazione all-reduce di TP viene eseguita due volte per ogni strato transformer, quindi un modello a 80 strati con TP=2 genera 160 scambi cross-box per ogni singolo token di output, e ognuno di questi scambi blocca il calcolo successivo. PP=2 trasferisce le attivazioni solo una volta per token, nel punto di giunzione tra le due metà del modello. Su un collegamento da 200 GbE con latenza non trascurabile, questa differenza domina tutto il resto.
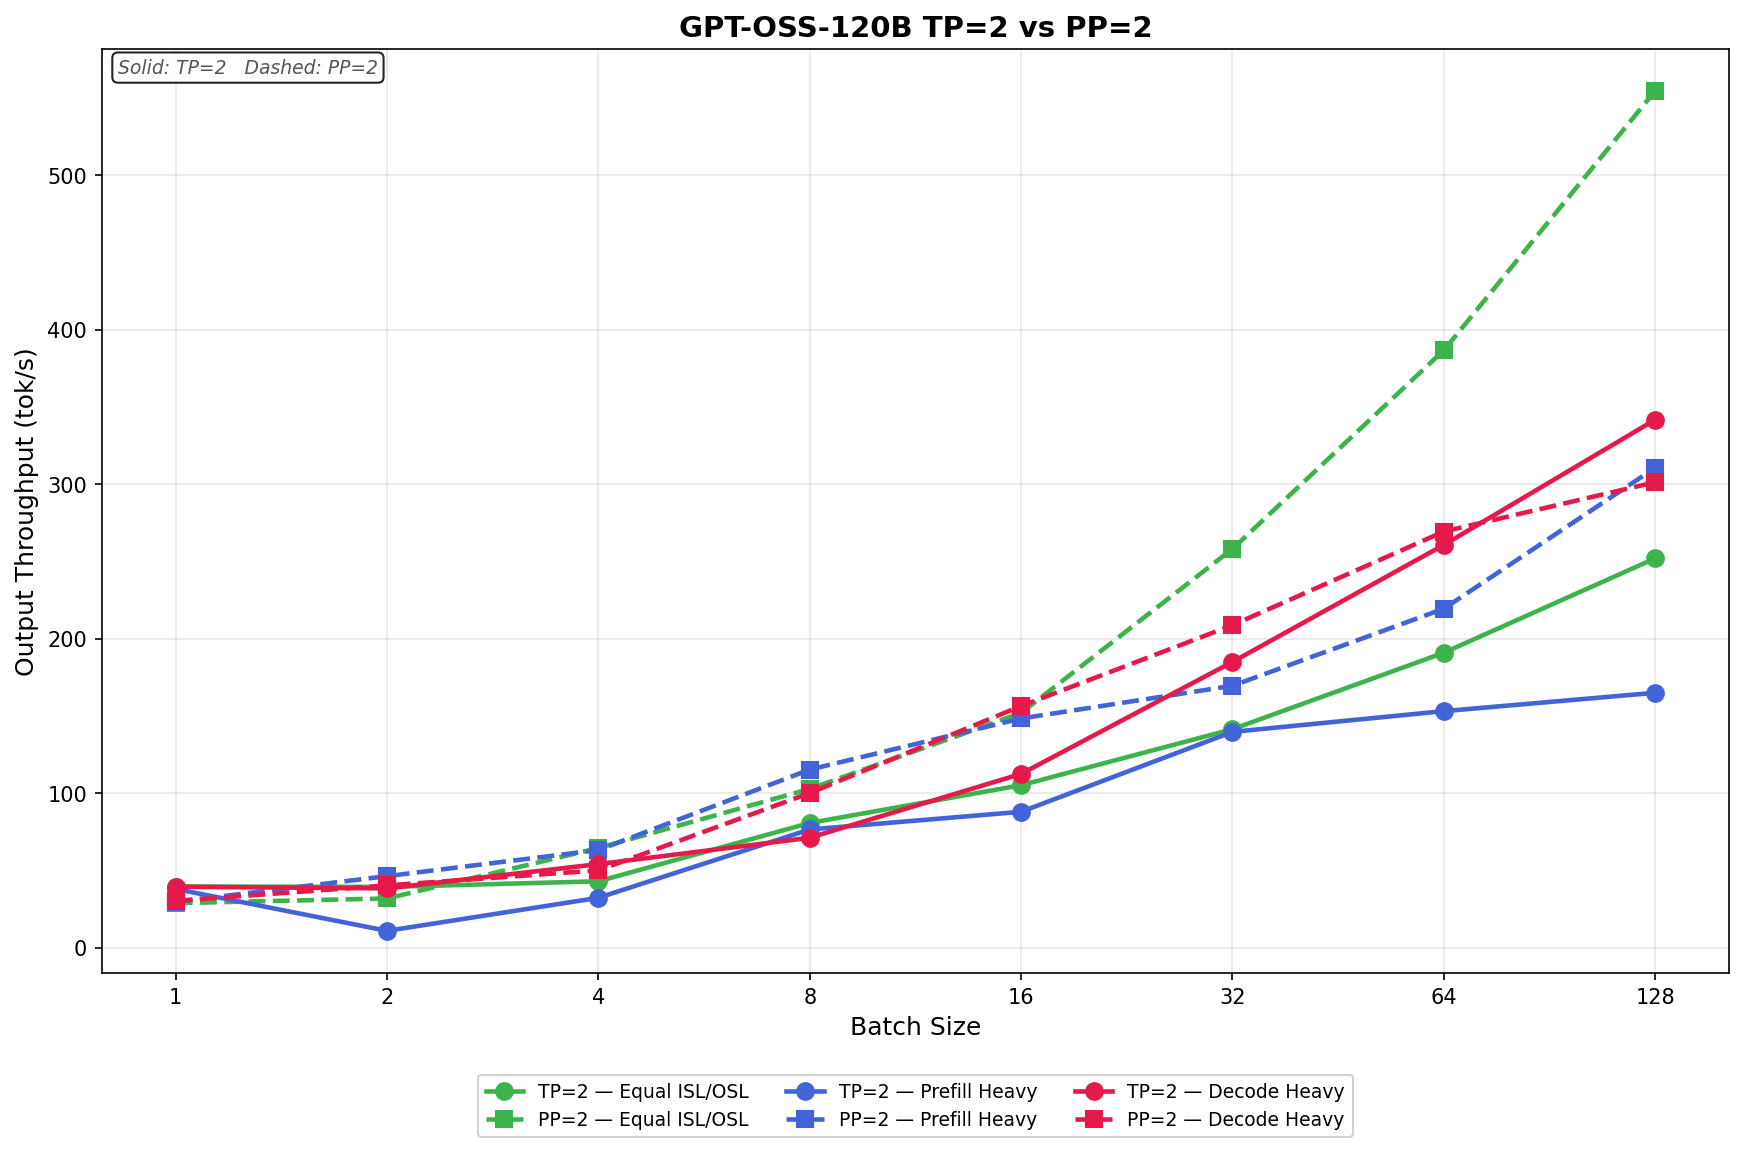
Le nostre misurazioni GPT-OSS-120B lo confermano chiaramente. Al di fuori della dimensione del batch pari a 1, dove il carico di lavoro è troppo esiguo per nascondere l'overhead di entrambe le strategie, PP=2 si impone e mantiene il vantaggio all'aumentare della concorrenza. Nel carico di lavoro Equal ISL/OSL, TP=2 raggiunge 252.01 tok/s con una dimensione del batch di 128, mentre PP=2 arriva a 554.69 tok/s sullo stesso hardware, con un vantaggio di 2.20 volte. Prefill Heavy mostra lo stesso andamento, con PP=2 che termina a 310.63 tok/s contro i 164.99 tok/s di TP=2. Lo scenario Decode Heavy è il più simile dei tre, ma PP=2 rimane in testa dalla dimensione del batch 8 alla dimensione del batch 64, cedendo solo un modesto vantaggio alla dimensione del batch 128, dove l'output 8K di grandi dimensioni amplifica il costo di bolla della pipeline.
TP=2 ha una finestra temporale ristretta in cui risulta vincente. Con una dimensione del batch pari a 1 in ogni scenario, TP offre un vantaggio piccolo ma reale: 39.55 tok/s contro 28.79 tok/s in Equal, 37.97 contro 29.60 in Prefill Heavy e 39.42 contro 30.28 in Decode Heavy. Con una sola richiesta in corso, non c'è un secondo microbatch a tenere occupata la fase di pipeline inattiva, quindi PP paga per uno slot vuoto a ogni passaggio, mentre TP può utilizzare entrambe le GPU sull'unico token disponibile. Questo è il regime per cui sono state pensate le linee guida di NVIDIA per TP: un servizio interattivo a flusso singolo in cui la latenza sulla prima e unica richiesta è più importante del throughput aggregato. Se un'implementazione è effettivamente in stile chat, con un utente per server e obiettivi TTFT stringenti, TP=2 è la scelta giusta, e questo si allinea anche con la visione di NVIDIA su Spark.
Per i carichi di lavoro che servono infrastrutture su larga scala, con inferenza batch e molte richieste simultanee, il parallelismo Pipeline è la soluzione migliore quando si scala tra più server, soprattutto quando non si utilizzano strategie come Expert Parallelism. La rete 200 GbE non è in grado di supportare il traffico all-reduce per token di TP senza lasciare risorse di calcolo inattive e, una volta che la dimensione del batch raggiunge 4 o 8, il costo di "bubble" di PP si annulla nel flusso di lavoro a regime. Ecco perché tutti i valori per modello nel resto di questo articolo sono riportati con TP=1 e PP=2. Questa è la configurazione che rappresenta effettivamente ciò che un'implementazione dual-Spark può offrire quando le viene richiesto di svolgere un lavoro reale.
Abbiamo scelto deliberatamente GPT-OSS-120B come grafico principale di confronto tra TP e PP perché mostra il divario più ampio. Tuttavia, vogliamo anche dimostrare che questo non vale per tutti i modelli e che questi parametri dipendono dai parametri del modello stesso. Llama-3.1-8B-Instruct al BF16 racconta una storia molto più prudente. Il modello è abbastanza piccolo da rendere veloce il calcolo di ogni livello e il traffico all-reduce di TP è di conseguenza modesto. Al contrario, il costo di coordinamento per ogni passaggio di PP è fisso indipendentemente dalle dimensioni del modello. Il risultato è che TP=2 mantiene il vantaggio per quasi l'intera durata del batch sweep. In Equal ISL/OSL, TP=2 è in testa dalla dimensione del batch 1 (23.2 vs 13.4 tok/s) fino alla dimensione del batch 32 (388.7 vs 349.3 tok/s), e perde il primato solo alla dimensione del batch 64 (524.8 vs 638.2 tok/s) e alla dimensione del batch 128 (679.2 vs 1,047.1 tok/s). Prefill Heavy segue lo stesso andamento, con TP=2 in vantaggio fino alla dimensione del batch 32 prima che PP=2 prenda il sopravvento a 64 e 128. Decode Heavy è il più decisivo: TP=2 vince per ogni singola dimensione del batch, terminando a 366.7 tok/s contro 330.5 tok/s per PP=2 alla dimensione del batch 128.
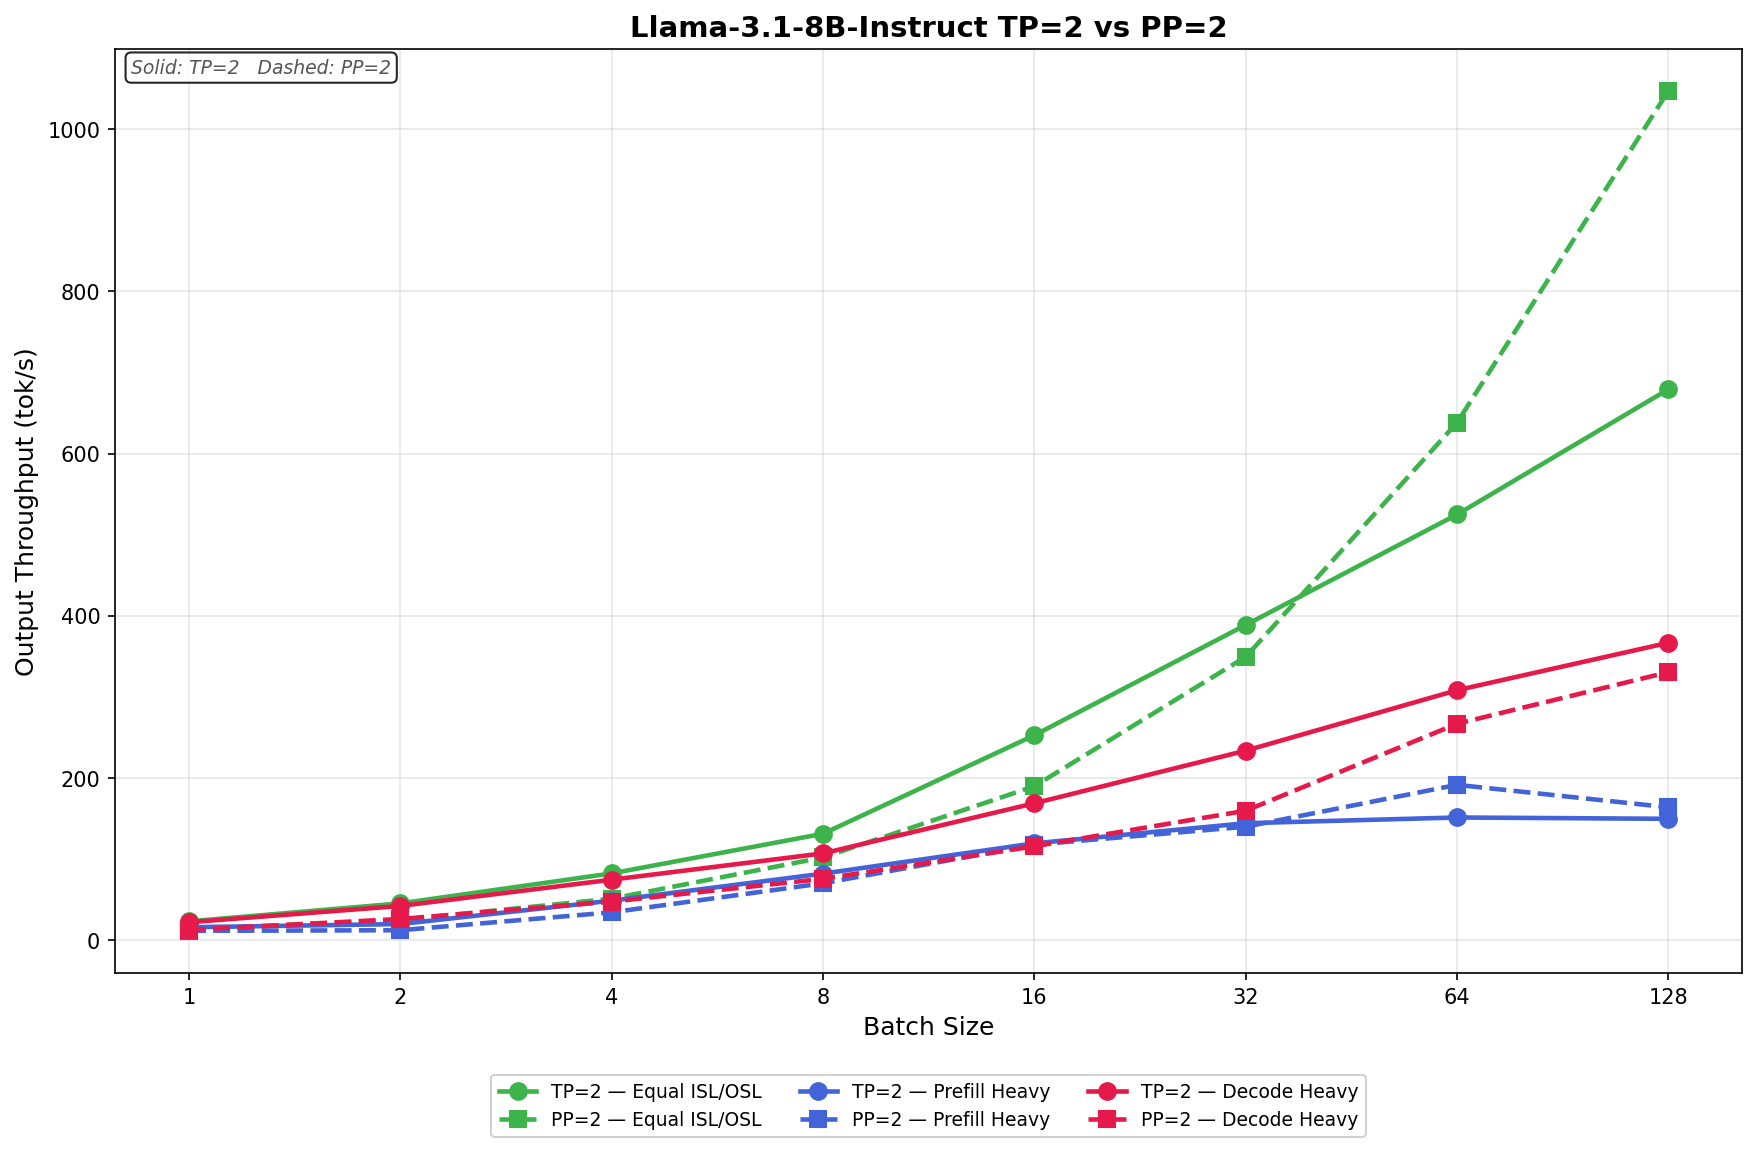
Questo controesempio rafforza, anziché contraddire, i meccanismi sottostanti. PP=2 vince solo quando le dimensioni dei batch sono sufficientemente elevate da riempire la pipeline e ammortizzare completamente il costo della bolla, e quando il modello stesso è abbastanza piccolo da rendere economica l'operazione all-reduce per strato di TP; quel punto di crossover viene spostato ulteriormente. Anche il risultato di Decode Heavy è coerente: sequenze di output più lunghe significano più passaggi di decodifica, più bolle della pipeline pagate una dopo l'altra e una finestra più piccola per PP per recuperare la differenza. In altre parole, la stessa fisica che conferisce a PP una vittoria di 2.20x su GPT-OSS-120B con una dimensione del batch di 128 spiega anche perché vince solo con le due dimensioni del batch più elevate su un modello 8B e non vince mai la sfida con Decode Heavy.
GPT-OSS-120B
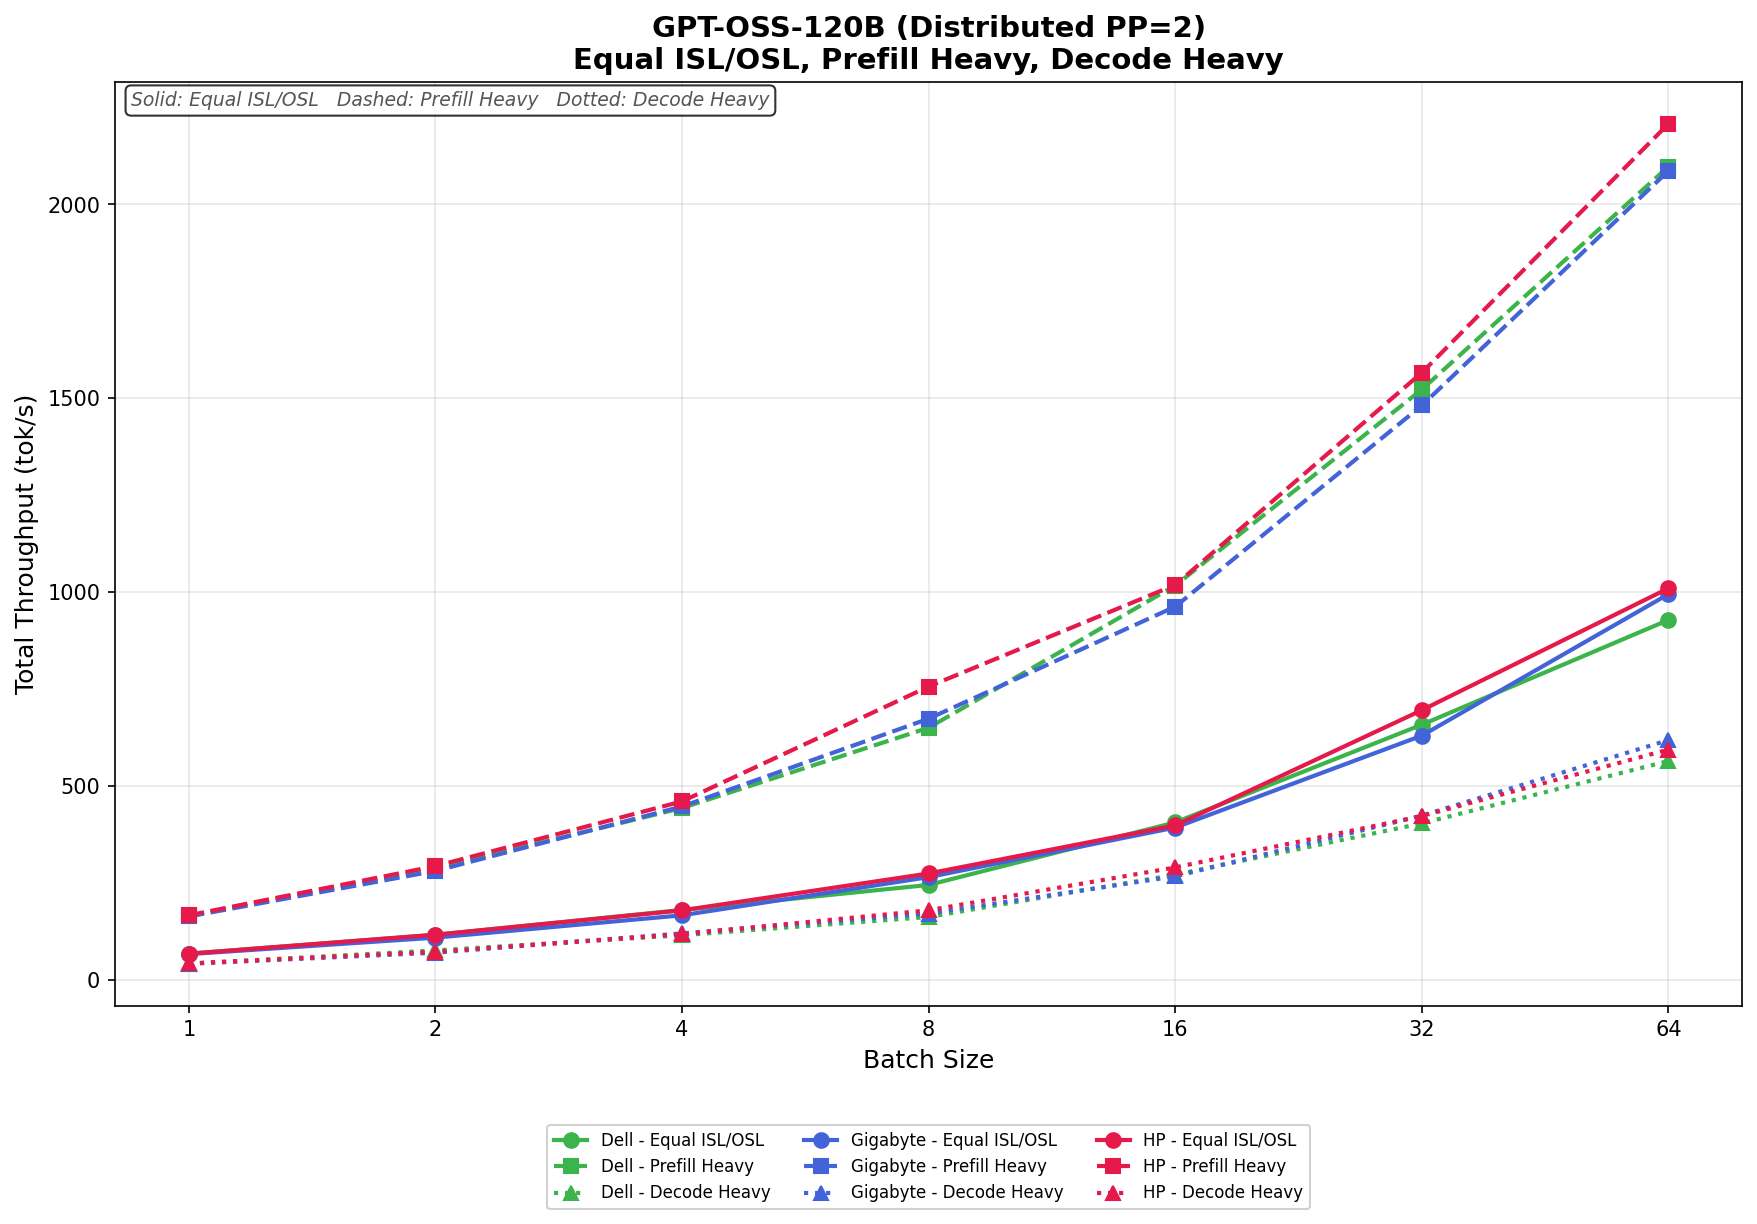
In Equal ISL/OSL, Dell parte da 67.06 tok/s e arriva fino a 927.93 tok/s con una dimensione del batch di 64. GIGABYTE parte leggermente più in basso con 65.77 tok/s ma termina più forte a 994.53 tok/s, mentre HP è in testa al gruppo nella fascia alta con 1,009.75 tok/s. Il distacco rimane ridotto per la maggior parte del test, con HP che prende il sopravvento a partire dalla dimensione del batch di 32.
Nella modalità Prefill Heavy, la velocità di elaborazione aumenta in modo molto più aggressivo su tutta la linea. Dell passa da 164.42 tok/s a 2,097.80 tok/s, GIGABYTE da 162.96 tok/s a 2,086.72 tok/s e HP registra il risultato migliore, salendo da 165.95 tok/s a 2,208.16 tok/s. HP è in testa per quasi tutte le dimensioni di batch, mentre Dell e GIGABYTE rimangono molto vicine, soprattutto per le dimensioni di batch di 32 e 64.
Nel carico di lavoro Decode Heavy, le prestazioni complessive sono inferiori, come previsto per il carico di lavoro di decodifica. Dell raggiunge valori compresi tra 41.20 tok/s e 563.98 tok/s, GIGABYTE tra 40.83 tok/s e 617.96 tok/s e HP tra 41.63 tok/s e 593.56 tok/s. GIGABYTE ottiene il risultato migliore con una dimensione del batch di 64, mentre HP è in testa nella fascia intermedia e Dell rimane vicina ma leggermente indietro con una concorrenza più elevata.
GPT-OSS-20B
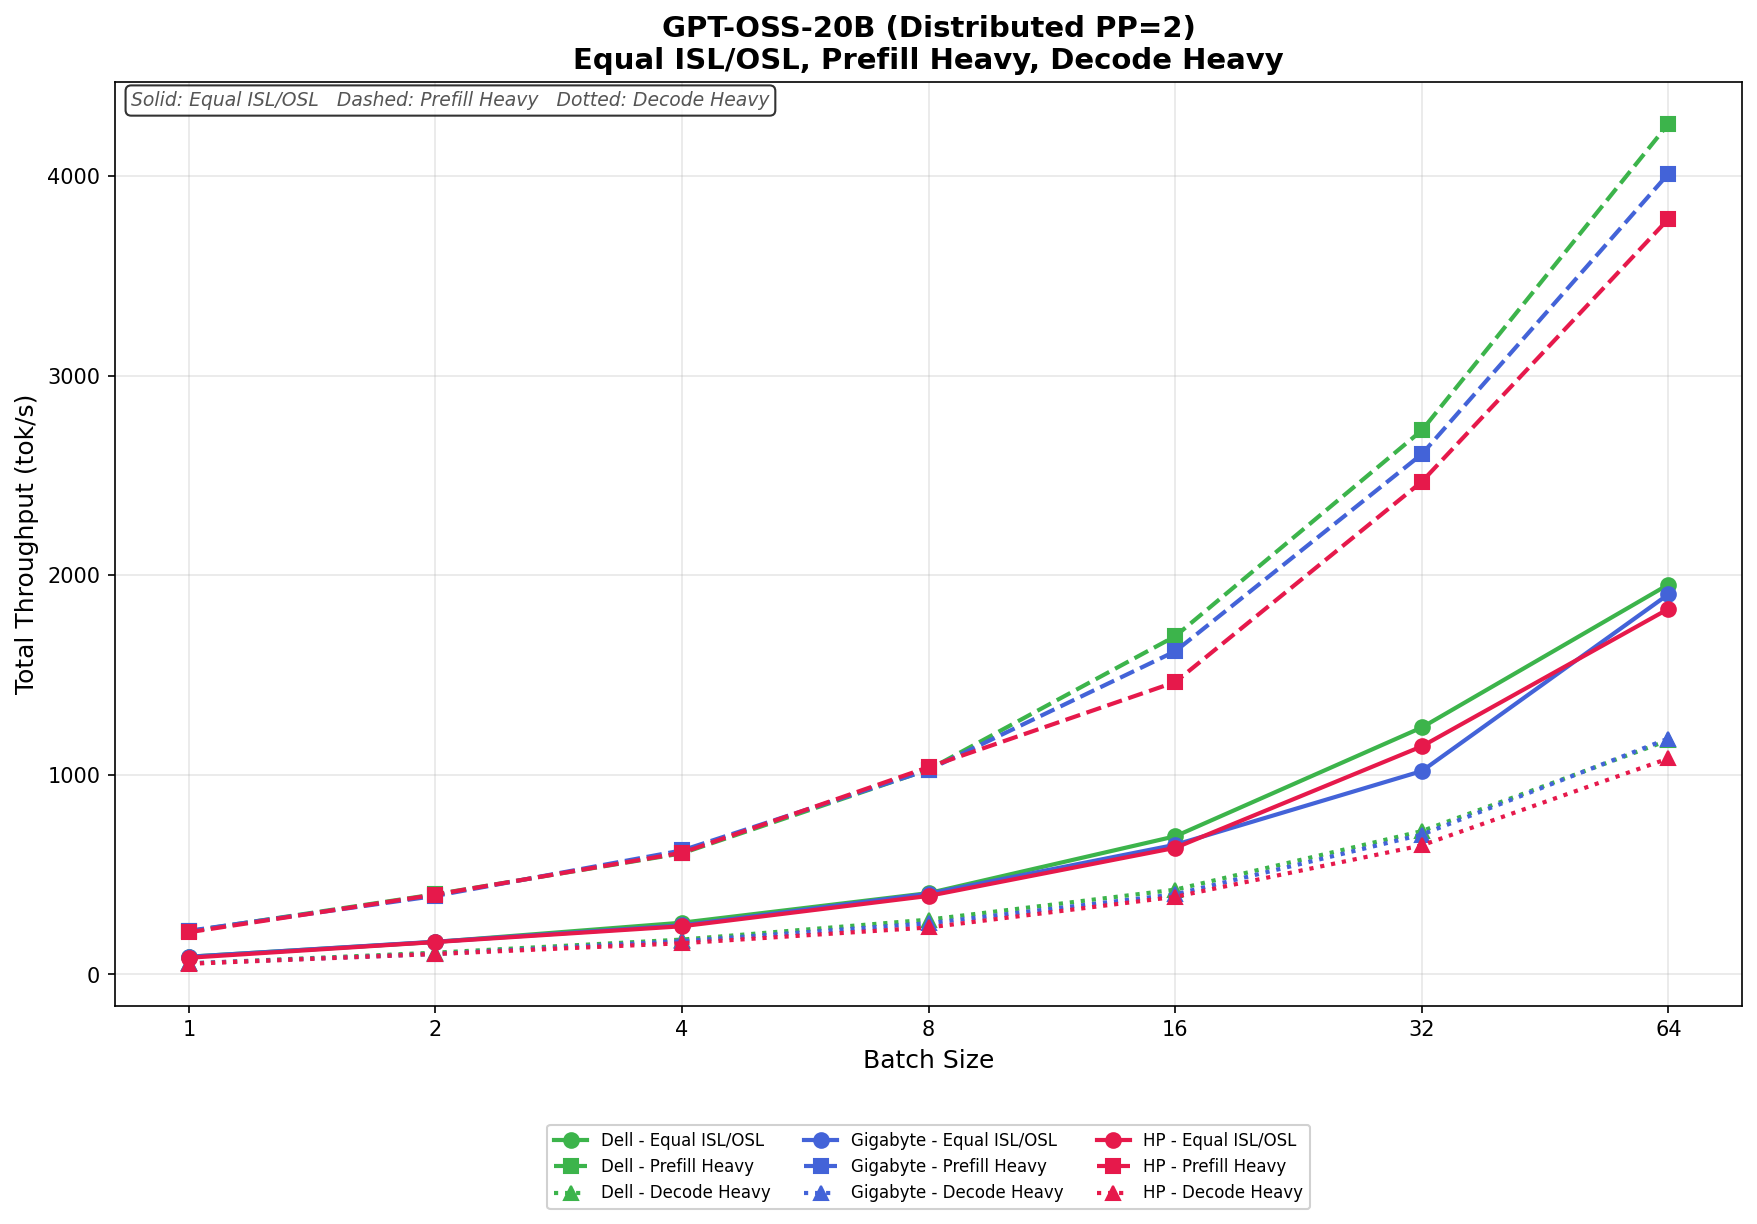
Nel test Equal ISL/OSL, Dell si posiziona al primo posto per la maggior parte del tempo, con una scalabilità che passa da 88.73 tok/s con batch size 1 a 1,953.55 tok/s con batch size 64. GIGABYTE segue da vicino, con un incremento da 88.42 tok/s a 1,904.62 tok/s, mentre HP si attesta tra 83.49 tok/s e 1,831.45 tok/s. Dell mantiene la scalabilità più elevata in assoluto, soprattutto a partire dal batch size 16.
Nel test Prefill Heavy, la velocità di elaborazione aumenta rapidamente su tutti e tre i sistemi. Dell ottiene il risultato migliore, passando da 216.05 tok/s a 4,261.96 tok/s con una dimensione del batch di 64. GIGABYTE segue con 4,011.86 tok/s, mentre HP raggiunge 3,785.25 tok/s. I tre sistemi rimangono molto vicini tra loro con dimensioni del batch inferiori, ma Dell inizia a distaccarsi a partire dalla dimensione del batch di 16 e consolida il suo vantaggio per il resto del test.
In Decode Heavy, la scalabilità è più graduale ma rimane elevata su tutte le piattaforme. Dell raggiunge valori compresi tra 54.88 tok/s e 1,173.31 tok/s, GIGABYTE tra 55.24 tok/s e 1,181.94 tok/s e HP tra 53.20 tok/s e 1,082.23 tok/s. GIGABYTE supera di poco Dell con la dimensione del batch più elevata, mentre HP è in svantaggio rispetto a entrambi i sistemi con livelli di concorrenza più alti.
Base di istruzioni Llama 3.1 8B
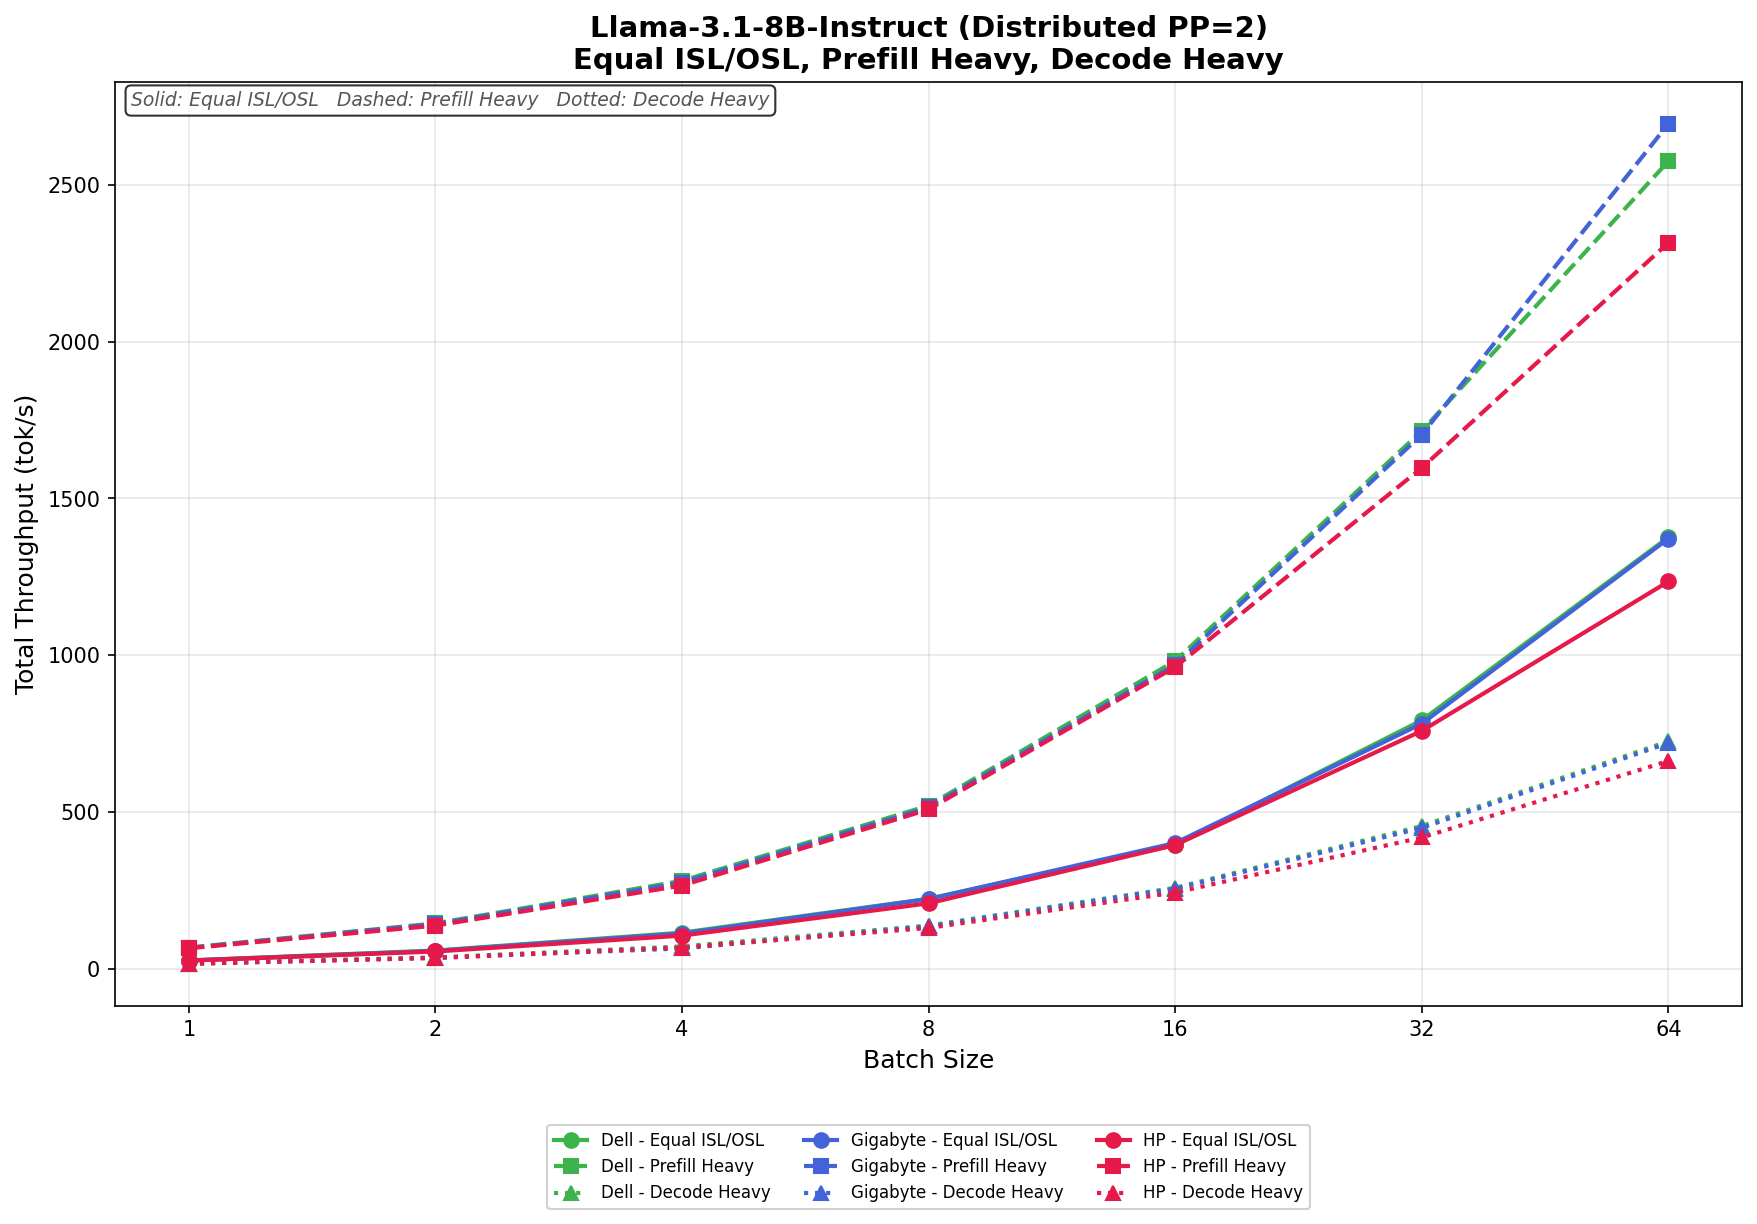
In Equal ISL/OSL, Dell scala da 27.69 tok/s a 1,376.38 tok/s con una dimensione del batch di 64, leggermente davanti a GIGABYTE, che varia da 27.23 tok/s a 1,372.27 tok/s. HP è leggermente indietro durante l'intero test, scalando da 26.89 tok/s a 1,235.32 tok/s. Tutti e tre i sistemi si avvicinano molto fino a una dimensione del batch di 16, prima che Dell inizi ad accumulare un piccolo vantaggio a livelli di concorrenza più elevati.
In Prefill Heavy, la velocità di elaborazione aumenta in modo significativo all'aumentare delle dimensioni dei lotti. Dell passa da 68.60 tok/s a 2,575.25 tok/s, mentre GIGABYTE ottiene il risultato migliore, passando da 67.49 tok/s a 2,694.25 tok/s con una dimensione del lotto pari a 64. HP raggiunge 2,315.15 tok/s, rimanendo competitiva ma costantemente indietro rispetto a Dell e GIGABYTE con dimensioni del lotto più elevate. GIGABYTE si impone nella fascia alta, in particolare per lotti di 64 o più unità.
Nel test Decode Heavy, la scalabilità rimane costante per tutta la durata del test. Dell passa da 17.19 tok/s a 726.22 tok/s, GIGABYTE da 16.96 tok/s a 720.57 tok/s e HP da 16.79 tok/s a 663.31 tok/s. Dell e GIGABYTE si mantengono pressoché identiche per la maggior parte del test, con Dell leggermente in vantaggio ai livelli di concorrenza più elevati. Allo stesso tempo, HP risulta leggermente indietro con batch di dimensioni maggiori.
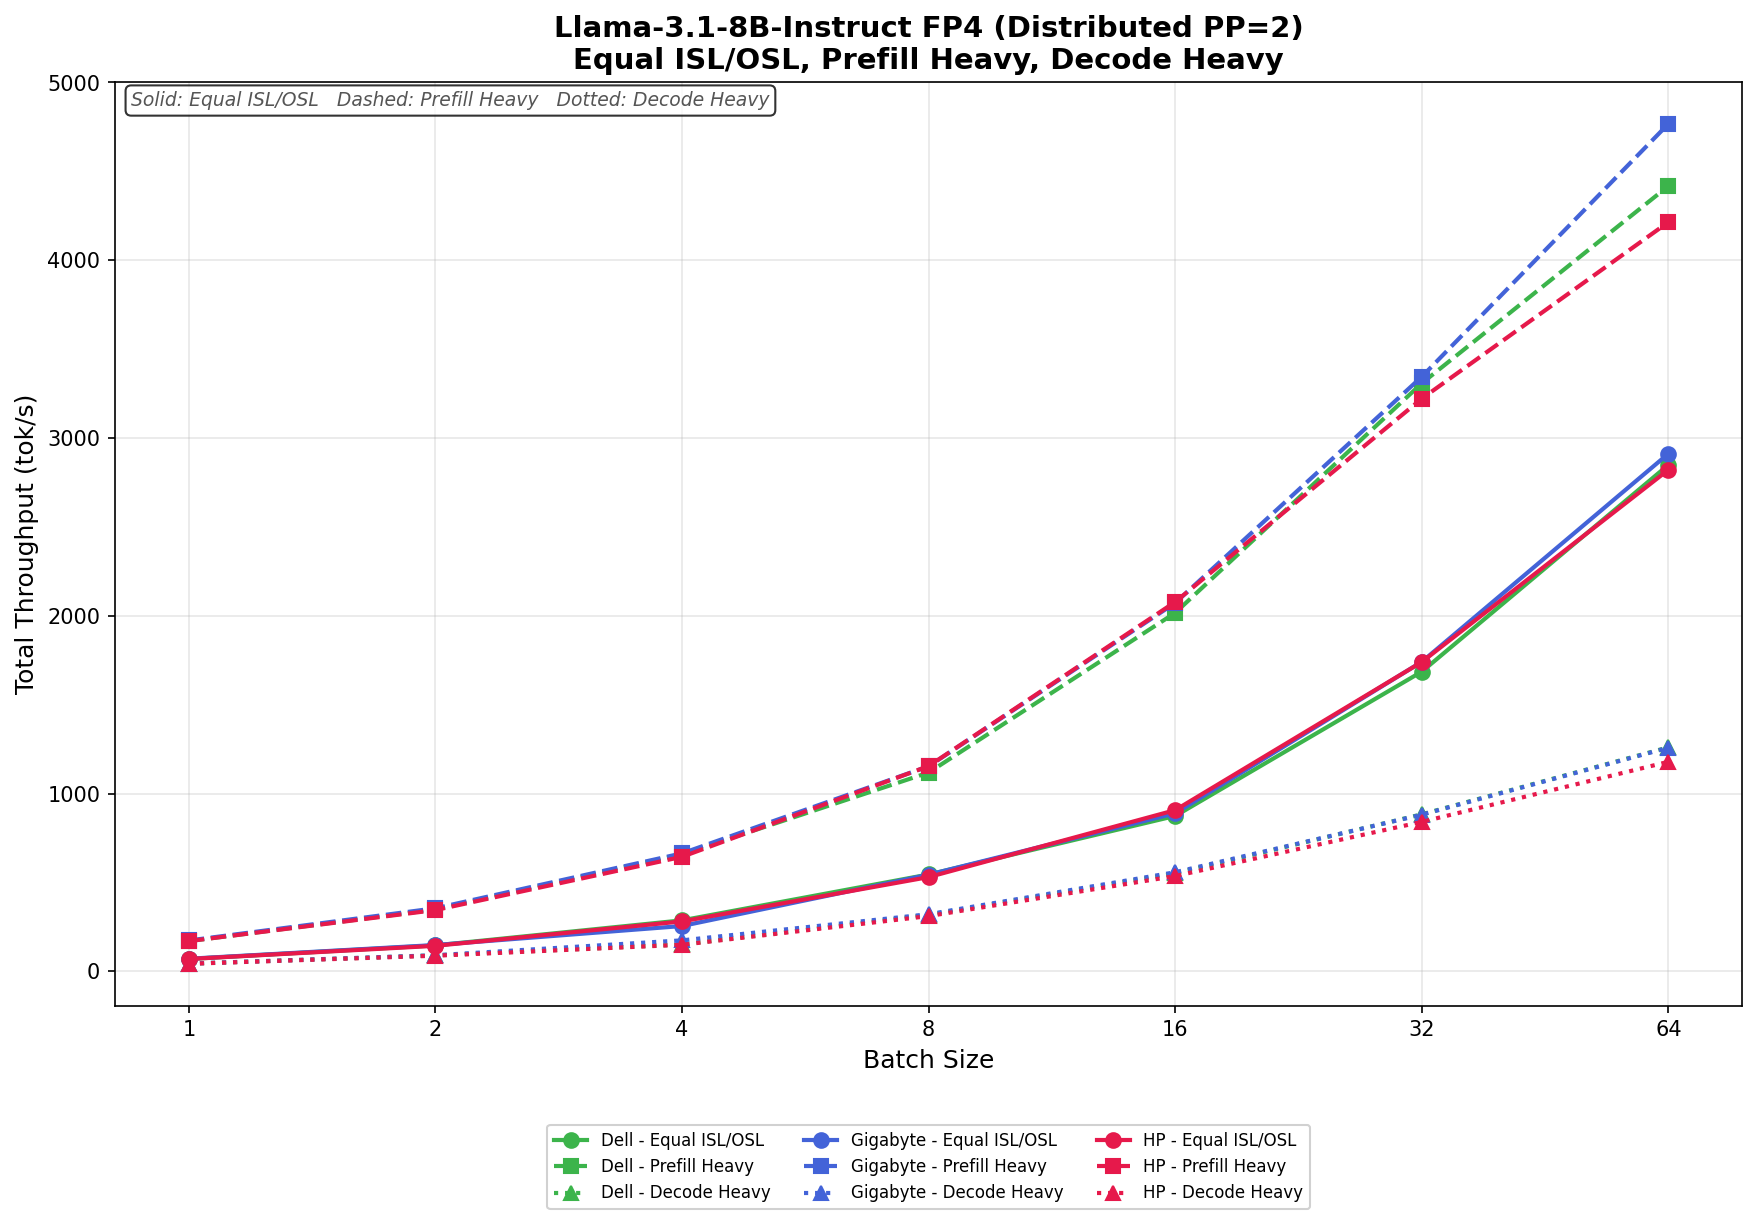
Llama 3.1 8B Istruzione FP4
In Equal ISL/OSL, Dell scala da 69.71 tok/s a 2,849.20 tok/s con una dimensione del batch di 64, mentre GIGABYTE si porta leggermente in vantaggio, crescendo da 70.92 tok/s a 2,912.03 tok/s. HP rimane competitiva, con valori compresi tra 69.52 tok/s e 2,821.50 tok/s. I tre sistemi restano molto vicini tra loro per l'intero carico di lavoro, con una piccola separazione che si manifesta solo a livelli di concorrenza più elevati.
In Prefill Heavy, la scalabilità diventa molto più aggressiva, in particolare con dimensioni di batch più grandi. Dell passa da 170.09 tok/s a 4,417.65 tok/s, mentre GIGABYTE registra il risultato migliore del gruppo, salendo da 173.55 tok/s a 4,767.43 tok/s con una dimensione di batch di 64. HP scala da 170.12 tok/s a 4,214.57 tok/s. GIGABYTE inizia a distaccarsi dagli altri dopo una dimensione di batch di 32, offrendo la massima velocità di elaborazione in questo carico di lavoro.
In Decode Heavy, tutti e tre i sistemi rimangono nuovamente molto simili per la maggior parte della durata del test. Dell varia da 43.19 tok/s a 1,260.24 tok/s, GIGABYTE da 43.53 tok/s a 1,258.05 tok/s e HP da 42.54 tok/s a 1,178.74 tok/s. Dell e GIGABYTE si alternano al comando a seconda della dimensione del batch, mentre HP si posiziona leggermente dietro a entrambi i sistemi ai livelli di concorrenza più elevati.
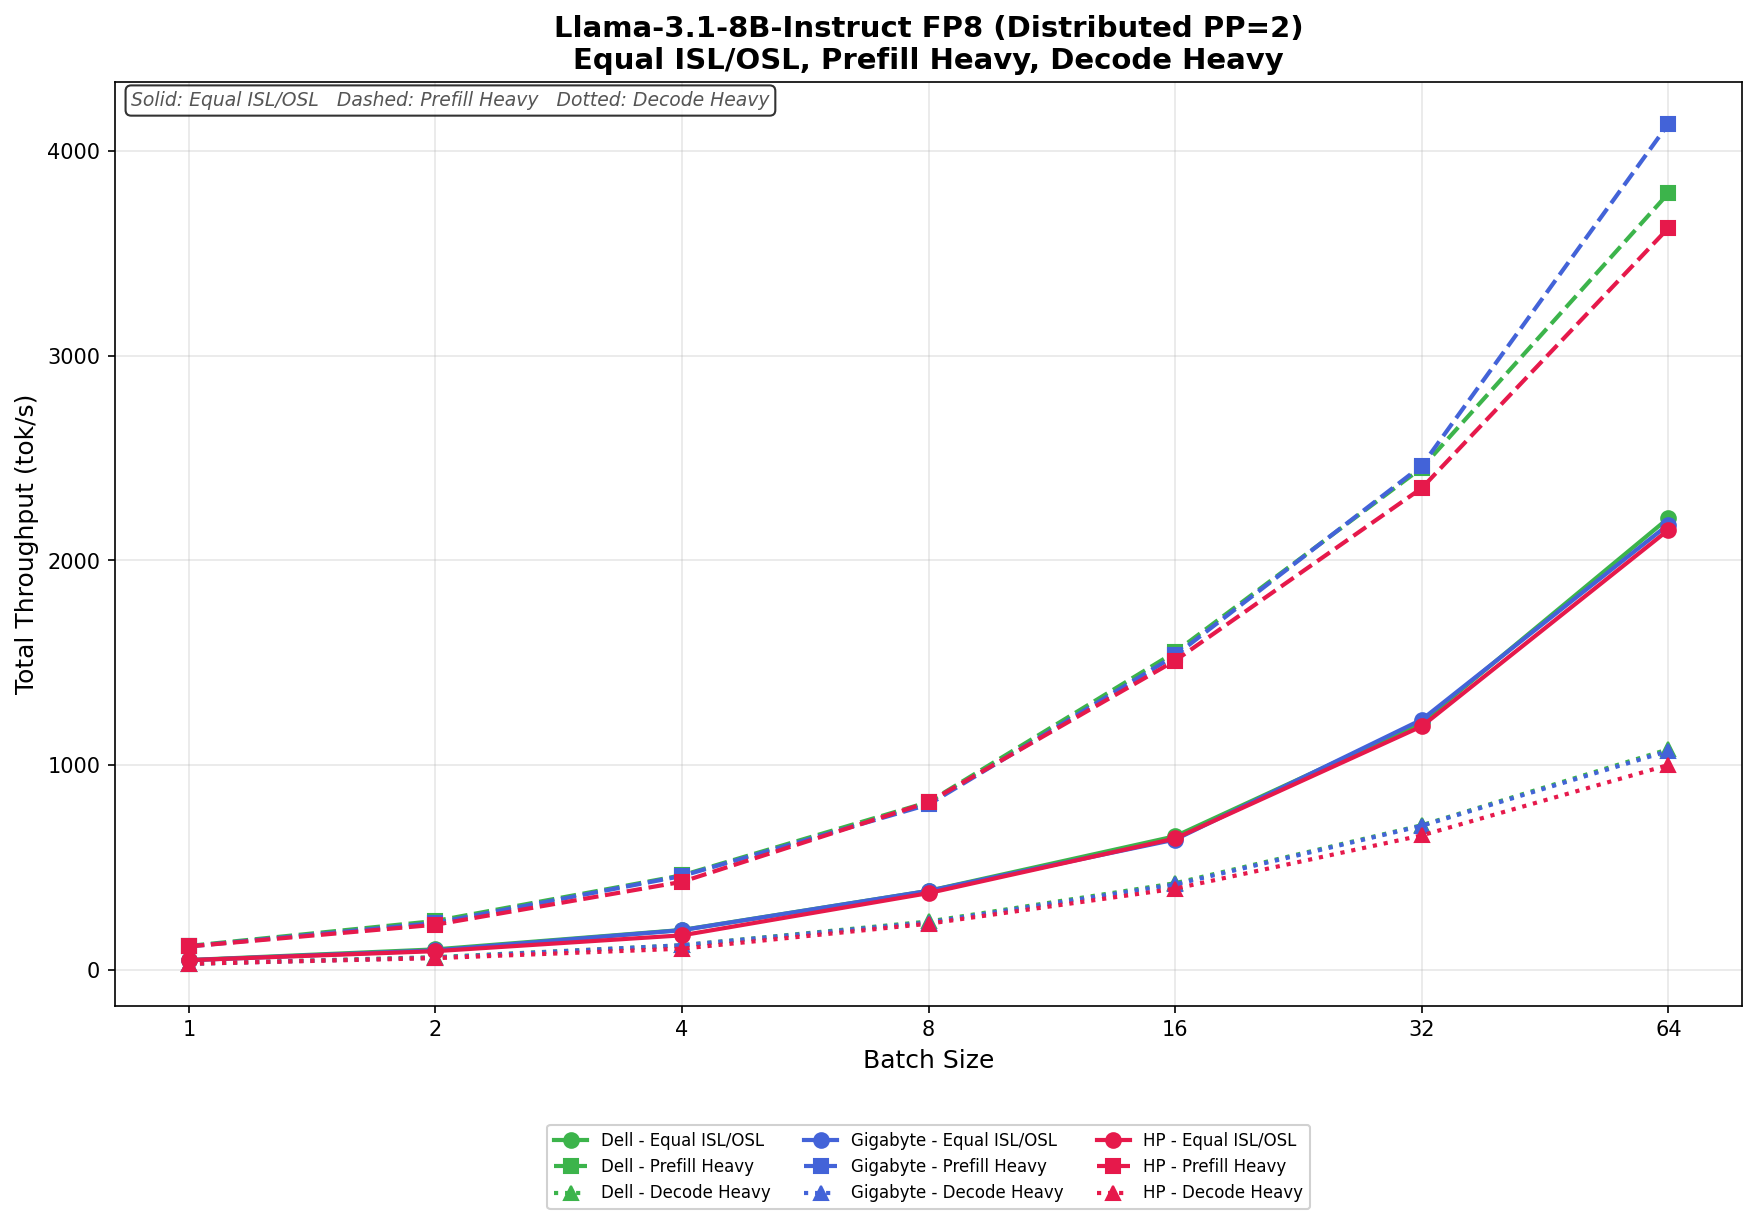
Llama 3.1 8B Istruzione FP8
In Equal ISL/OSL, Dell scala da 46.93 tok/s a 2,206.52 tok/s con una dimensione del batch di 64, mentre GIGABYTE varia da 46.16 tok/s a 2,175.44 tok/s. HP segue a ruota, aumentando da 46.40 tok/s a 2,149.15 tok/s. La dispersione complessiva rimane ristretta per tutta la durata del test, con tutti e tre i sistemi che mantengono un comportamento di scalabilità pressoché identico fino a una dimensione del batch di 32.
In Prefill Heavy, la velocità di elaborazione aumenta in modo più aggressivo con l'aumentare della concorrenza. Dell passa da 115.85 tok/s a 3,794.52 tok/s, mentre GIGABYTE registra il risultato complessivo migliore, passando da 113.34 tok/s a 4,133.76 tok/s con una dimensione del batch di 64. HP raggiunge 3,624.73 tok/s. GIGABYTE inizia a consolidare un vantaggio più marcato con dimensioni del batch più elevate, in particolare a partire dalla dimensione del batch di 32.
In Decode Heavy, i tre sistemi rimangono strettamente raggruppati a bassi livelli di concorrenza, prima che emergano piccole separazioni ad alti livelli di concorrenza. Dell varia da 29.11 tok/s a 1,077.07 tok/s, GIGABYTE da 28.64 tok/s a 1,068.92 tok/s e HP da 28.68 tok/s a 1,000.20 tok/s. Dell mantiene un leggero vantaggio per la maggior parte del carico di lavoro, con GIGABYTE che la segue a brevissima distanza, mentre HP è leggermente indietro per batch di dimensioni maggiori.
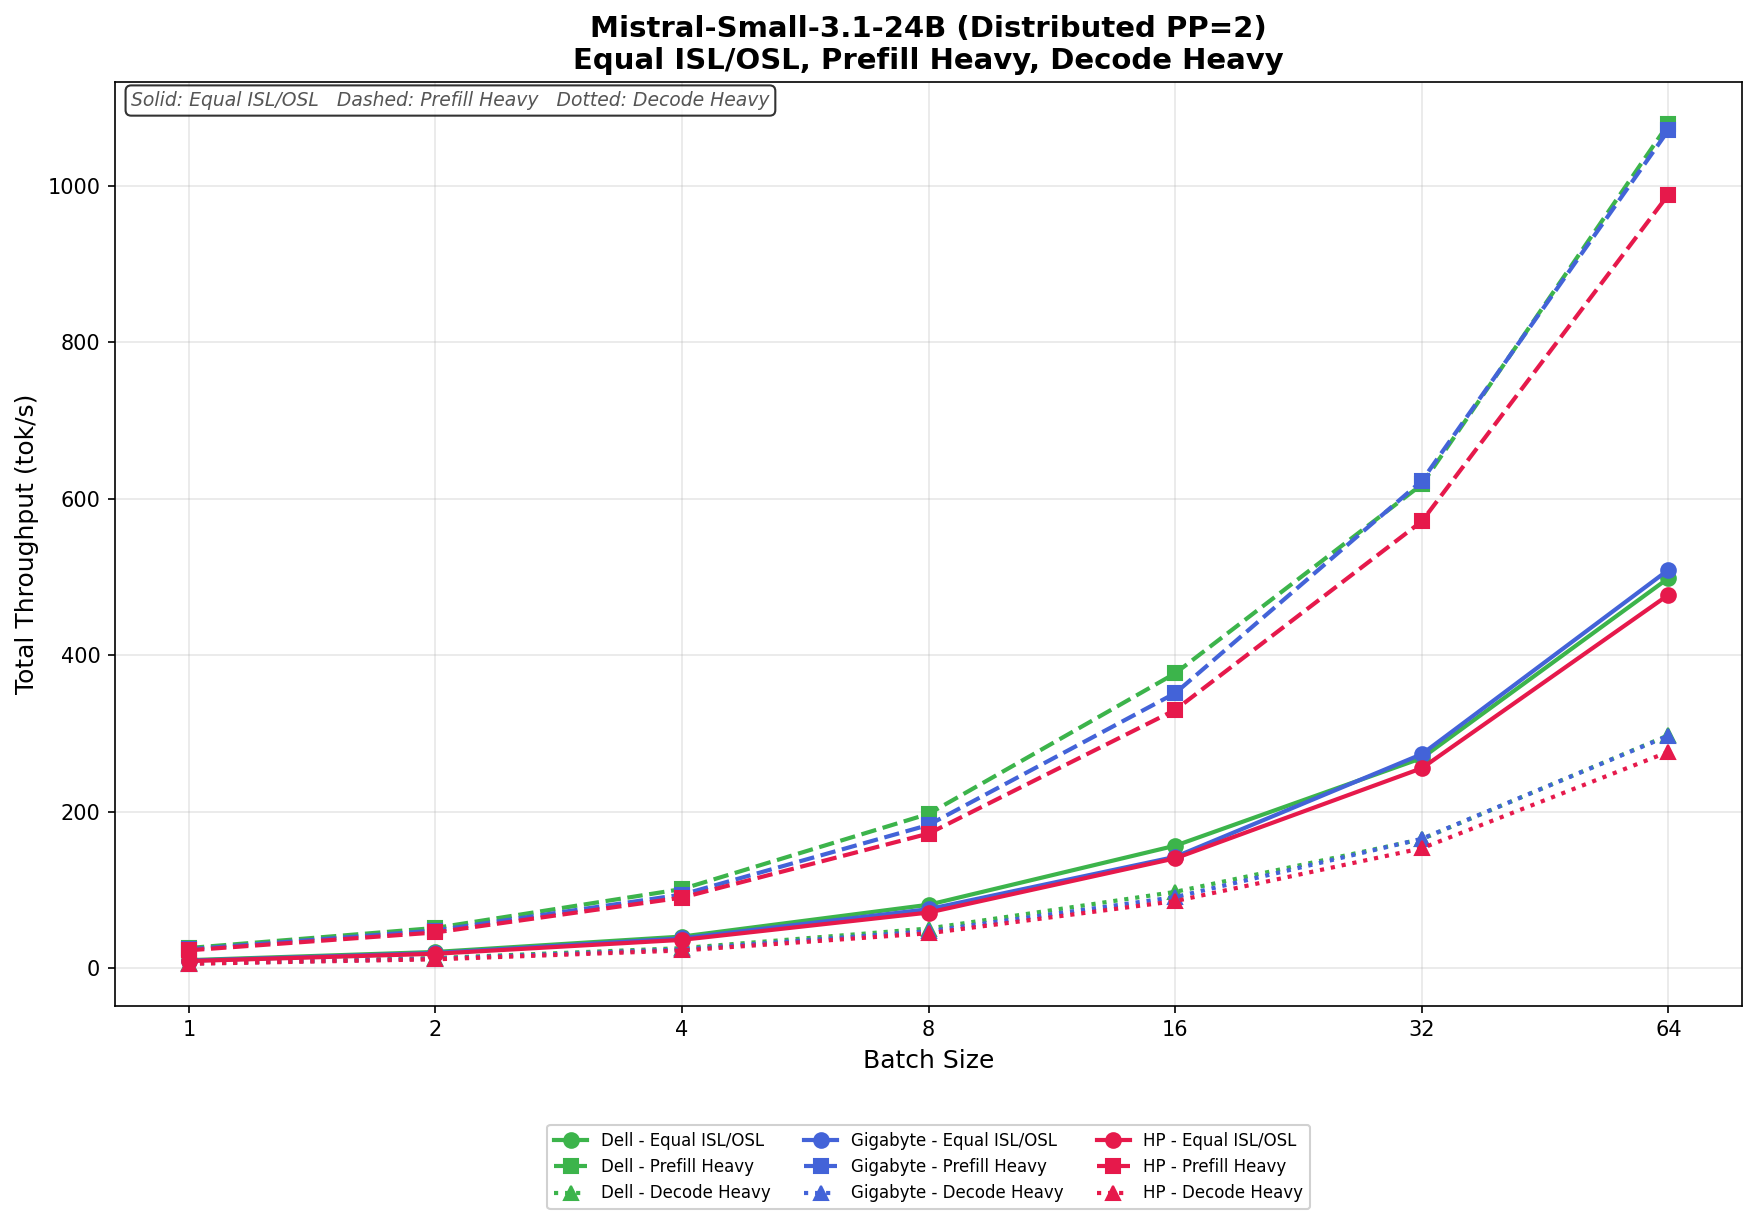
Mistral Piccolo 3.1 24B
In Equal ISL/OSL, Dell scala da 10.41 tok/s a 498.56 tok/s con una dimensione del batch di 64, mentre GIGABYTE si porta leggermente in vantaggio nella fascia alta, passando da 9.76 tok/s a 509.18 tok/s. HP è leggermente indietro rispetto a entrambi i sistemi, con valori compresi tra 9.25 tok/s e 477.25 tok/s. Il divario tra i sistemi rimane relativamente piccolo per tutto il carico di lavoro, in particolare a livelli di concorrenza bassi e medi.
In Prefill Heavy, la scalabilità migliora sostanzialmente su tutti e tre i sistemi. Dell passa da 25.91 tok/s a 1,079.19 tok/s, mentre GIGABYTE passa da 24.25 tok/s a 1,071.07 tok/s. HP raggiunge 988.82 tok/s con una dimensione del batch di 64. Dell e GIGABYTE rimangono pressoché identici per la maggior parte del test, con Dell che mantiene un leggero vantaggio al livello di concorrenza più elevato.
Nel test Decode Heavy, la velocità di elaborazione complessiva rimane significativamente inferiore, come previsto per un carico di lavoro incentrato sulla decodifica su un modello più grande. Dell registra valori compresi tra 6.49 tok/s e 297.82 tok/s, GIGABYTE tra 6.10 tok/s e 297.23 tok/s, e HP tra 5.77 tok/s e 276.55 tok/s. Dell e GIGABYTE si mantengono a pari merito per tutta la durata del test, mentre HP si posiziona costantemente leggermente indietro rispetto a entrambi i sistemi con batch di dimensioni maggiori.
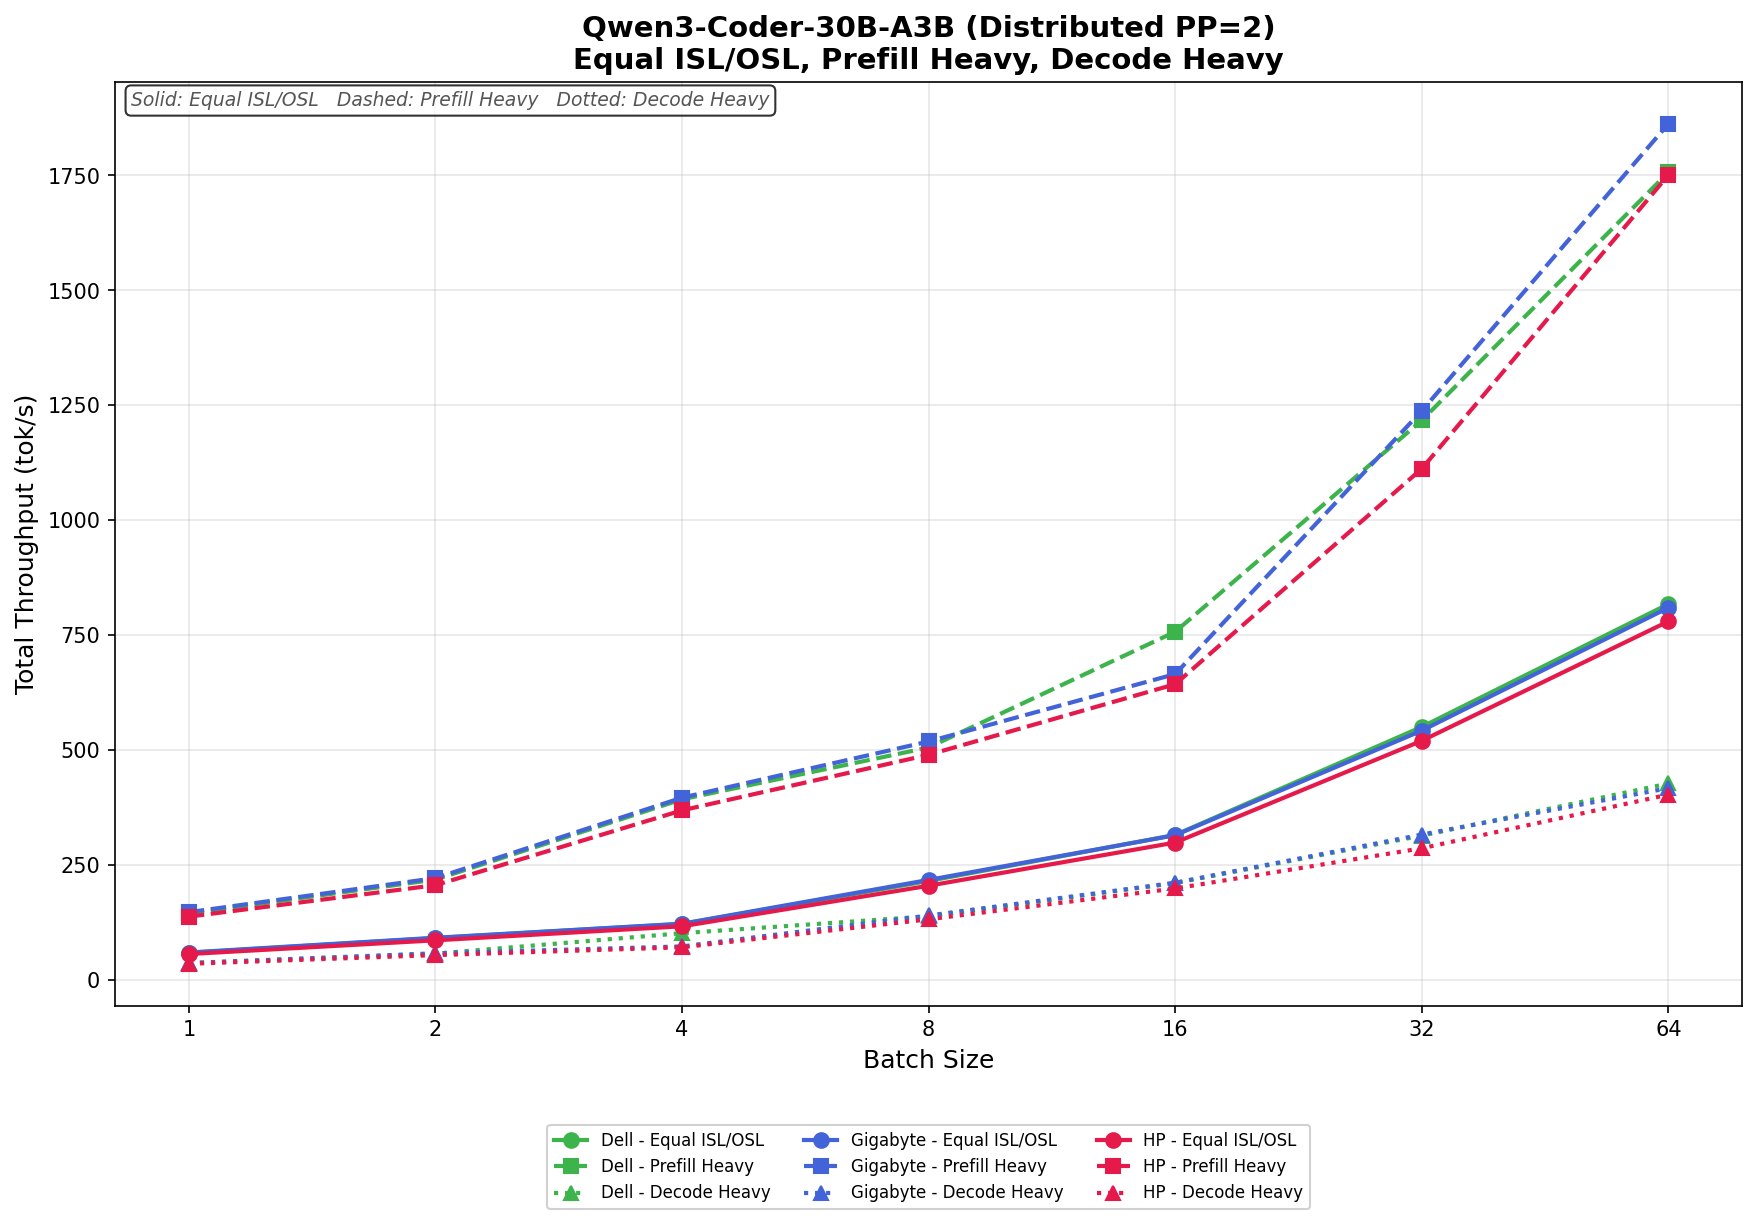
Codificatore Qwen3 30B A3B Base
In Equal ISL/OSL, Dell scala da 59.05 tok/s a 817.82 tok/s con una dimensione del batch di 64, mentre GIGABYTE varia da 59.81 tok/s a 809.88 tok/s. HP è leggermente indietro rispetto a entrambi i sistemi, aumentando da 56.51 tok/s a 780.21 tok/s. Le prestazioni tra Dell e GIGABYTE rimangono pressoché identiche per la maggior parte del periodo di prova, con solo piccole variazioni che si manifestano con dimensioni del batch più elevate.
Nel test Prefill Heavy, la velocità di elaborazione aumenta significativamente con l'aumentare della concorrenza. Dell passa da 144.81 tok/s a 1,756.99 tok/s, mentre GIGABYTE registra la scalabilità complessiva più elevata, passando da 147.55 tok/s a 1,862.40 tok/s con una dimensione del batch pari a 64. HP raggiunge 1,751.17 tok/s, rimanendo competitiva ma leggermente indietro rispetto agli altri due sistemi nella fascia alta. GIGABYTE si assicura un modesto vantaggio a partire da una dimensione del batch di circa 32 e lo mantiene fino alla fase finale del test.
Nel test Decode Heavy, i tre sistemi rimangono nuovamente molto simili per la maggior parte del carico di lavoro. Dell raggiunge valori compresi tra 36.69 tok/s e 427.48 tok/s, GIGABYTE tra 36.92 tok/s e 417.42 tok/s, e HP tra 35.30 tok/s e 403.32 tok/s. Dell mantiene un leggero vantaggio con le dimensioni di batch più elevate, mentre HP è leggermente indietro rispetto a Dell e GIGABYTE nel carico di lavoro incentrato sulla decodifica.
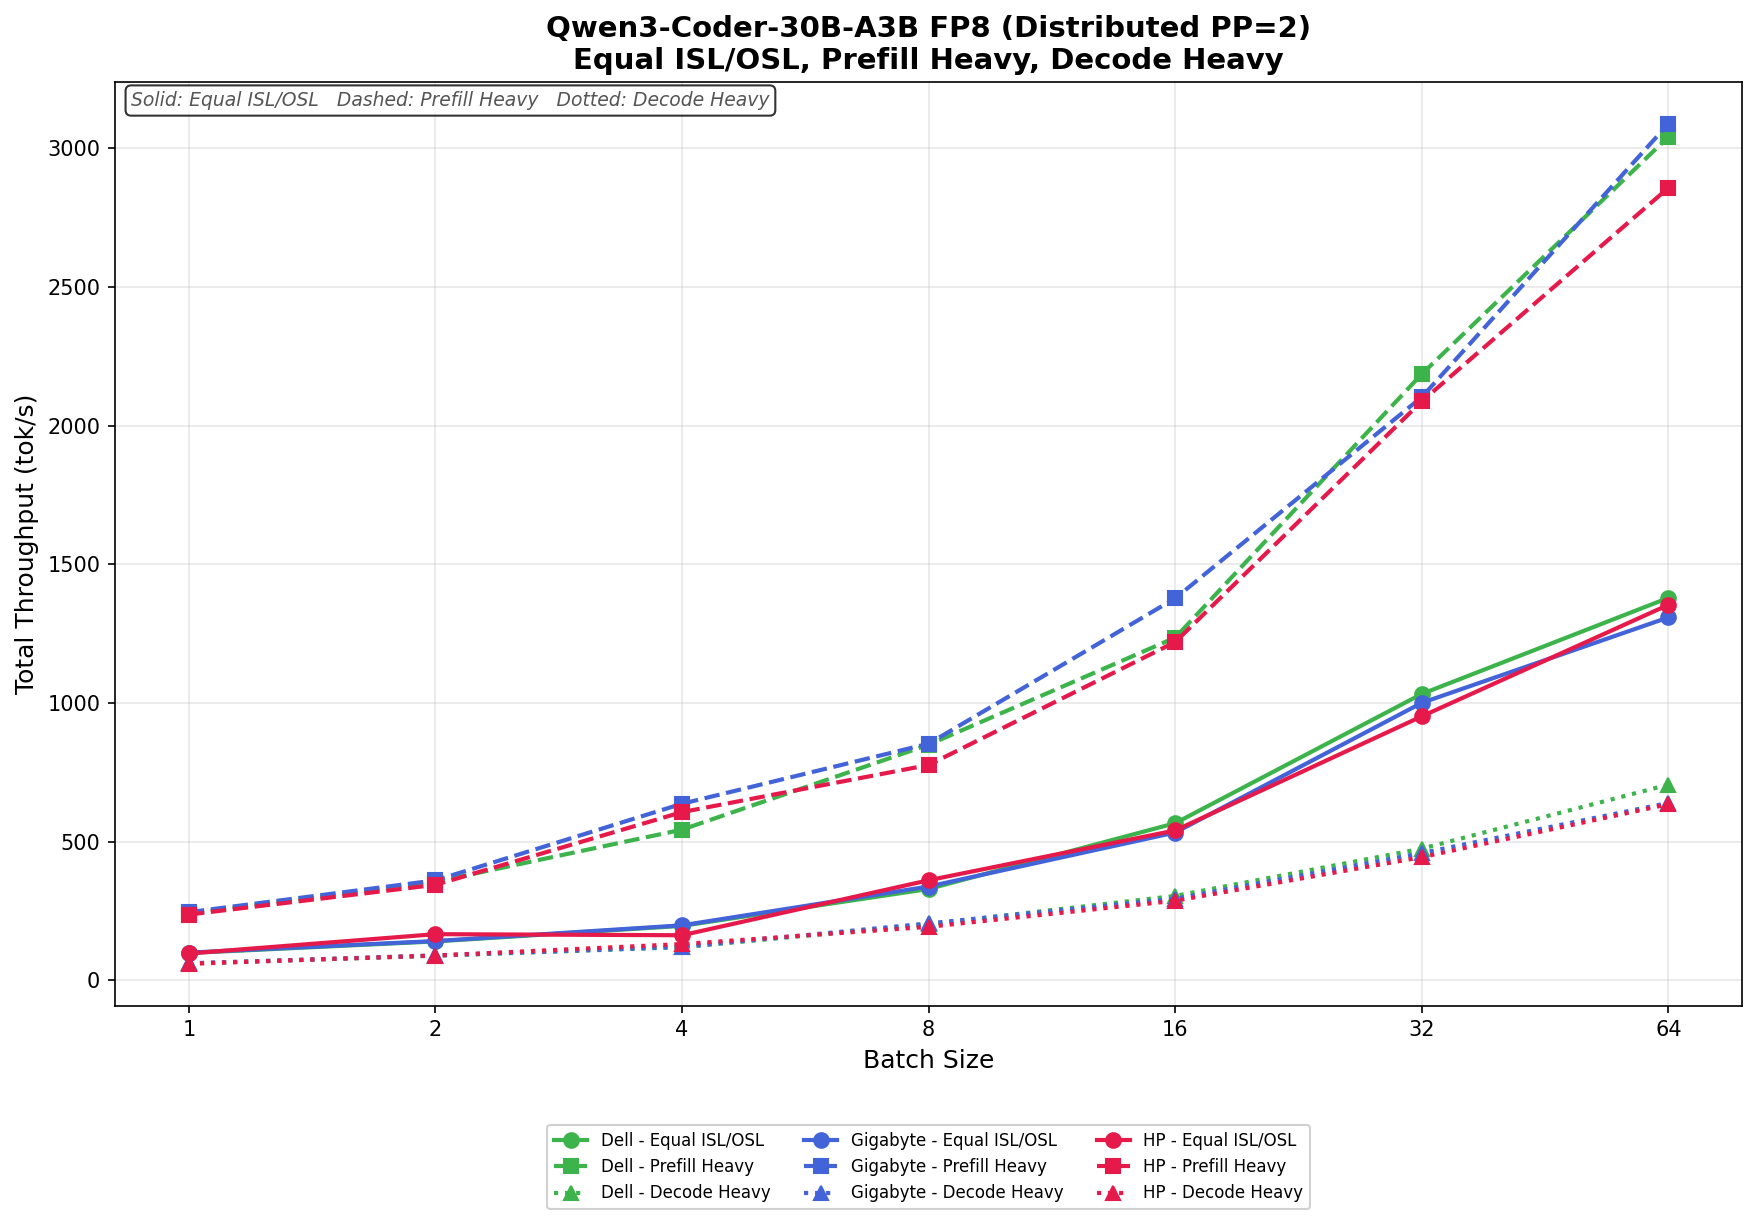
Codificatore Qwen3 30B A3B FB8
In Equal ISL/OSL, Dell scala da 98.65 tok/s a 1,379.26 tok/s con una dimensione del batch di 64, mentre GIGABYTE varia da 100.20 tok/s a 1,308.79 tok/s. HP rimane competitiva in tutto il test, aumentando da 97.06 tok/s a 1,354.23 tok/s. HP è brevemente in vantaggio in diverse fasce di batch inferiori e medie, sebbene Dell concluda con la migliore velocità di elaborazione complessiva nella fascia alta.
In Prefill Heavy, la velocità di elaborazione aumenta in modo significativo su tutti e tre i sistemi. Dell passa da 240.43 tok/s a 3,041.72 tok/s, mentre GIGABYTE registra il risultato complessivo migliore, passando da 245.92 tok/s a 3,088.62 tok/s con una dimensione del batch pari a 64. HP raggiunge 2,857.80 tok/s. GIGABYTE si impone con un vantaggio notevole a partire dalla dimensione del batch pari a 4 e lo mantiene per il resto del test.
Nel test Decode Heavy, Dell detiene la scalabilità di fascia alta più elevata in assoluto. Dell raggiunge valori compresi tra 60.91 tok/s e 705.77 tok/s, mentre GIGABYTE passa da 61.53 tok/s a 639.80 tok/s e HP da 59.85 tok/s a 635.25 tok/s. HP è brevemente in vantaggio con batch di dimensioni ridotte, ma Dell la supera con livelli di concorrenza più elevati, concludendo con la velocità di decodifica più alta del gruppo.
Riepilogo della potenza di picco dei sistemi a doppia scintilla
La tabella seguente riassume il throughput di output massimo dei token osservato durante i test con PP=2 distribuito sui sistemi dual-Spark di Dell, GIGABYTE e HP. Ogni valore rappresenta il throughput di output più elevato misurato (tok/s) raggiunto per quello scenario di carico di lavoro alla dimensione del batch testata. I valori in grassetto indicano il sistema con le prestazioni migliori in quello specifico scenario di carico di lavoro.
| Modello | Scenario (BS – 64) | Uscita di picco Dell | Uscita di picco GIGABYTE | Potenza di picco HP |
|---|---|---|---|---|
| Modelli GPT-OSS | ||||
| GPT-OSS-120B | ISL/OSL pari | 463.97 tok/s | 497.26 tok/s | 504.88 tok/s |
| GPT-OSS-120B | Preriempimento pesante | 419.56 tok/s | 417.34 tok/s | 441.63 tok/s |
| GPT-OSS-120B | Decodifica pesante | 451.18 tok/s | 494.37 tok/s | 474.85 tok/s |
| GPT-OSS-20B | ISL/OSL pari | 976.77 tok/s | 952.31 tok/s | 915.72 tok/s |
| GPT-OSS-20B | Preriempimento pesante | 852.39 tok/s | 802.37 tok/s | 757.05 tok/s |
| GPT-OSS-20B | Decodifica pesante | 938.65 tok/s | 945.55 tok/s | 865.78 tok/s |
| Modelli di lama | ||||
| Llama-3.1-8B-Istruisci | ISL/OSL pari | 689.53 tok/s | 687.48 tok/s | 618.87 tok/s |
| Llama-3.1-8B-Istruisci | Preriempimento pesante | 515.45 tok/s | 539.27 tok/s | 463.39 tok/s |
| Llama-3.1-8B-Istruisci | Decodifica pesante | 581.43 tok/s | 576.91 tok/s | 531.07 tok/s |
| Llama-3.1-8B-FP4 | ISL/OSL pari | 1427.39 tok/s | 1458.86 tok/s | 1413.51 tok/s |
| Llama-3.1-8B-FP4 | Preriempimento pesante | 884.22 tok/s | 954.23 tok/s | 843.57 tok/s |
| Llama-3.1-8B-FP4 | Decodifica pesante | 1008.98 tok/s | 1007.23 tok/s | 943.73 tok/s |
| Llama-3.1-8B-FP8 | ISL/OSL pari | 1105.42 tok/s | 1089.85 tok/s | 1076.68 tok/s |
| Llama-3.1-8B-FP8 | Preriempimento pesante | 759.50 tok/s | 827.40 tok/s | 725.51 tok/s |
| Llama-3.1-8B-FP8 | Decodifica pesante | 862.33 tok/s | 855.81 tok/s | 800.78 tok/s |
| Modelli di Mistral e Qwen | ||||
| Mistral-Piccolo-3.1-24B | ISL/OSL pari | 249.77 tok/s | 255.09 tok/s | 239.09 tok/s |
| Mistral-Piccolo-3.1-24B | Preriempimento pesante | 216.01 tok/s | 214.38 tok/s | 197.92 tok/s |
| Mistral-Piccolo-3.1-24B | Decodifica pesante | 238.44 tok/s | 237.97 tok/s | 221.41 tok/s |
Conclusione
Il risultato più utile di questa serie di test ha poco a che fare con quale OEM si sia distinto in base al carico di lavoro. Su tutti i modelli e le tipologie di carico di lavoro testati, le tre implementazioni di Spark di Dell, GIGABYTE e HP hanno mostrato prestazioni pressoché identiche. Lievi vantaggi sono emersi per specifiche dimensioni di batch, ma nessuna piattaforma ha prevalso nettamente e nessuna è risultata costantemente inferiore. Chi deve scegliere tra le tre dovrebbe basare la propria decisione sul design dello chassis, sul comportamento termico, sui termini di garanzia e sul rapporto con l'assistenza, piuttosto che sulle differenze nei benchmark, che sono simili alla variabilità tra un'esecuzione e l'altra di qualsiasi sistema desktop sotto carico prolungato.
Il risultato più interessante è di natura metodologica. Sulla rete 200 GbE che collega due Spark, la scelta tra parallelismo tensoriale e parallelismo pipeline è più rilevante di qualsiasi differenza tra i tre produttori, e per l'inferenza batch a qualsiasi livello di concorrenza ragionevole, il parallelismo pipeline risulta la soluzione migliore. Il traffico all-reduce per livello di TP=2 non sopravvive al passaggio attraverso un collegamento ConnectX-7 senza lasciare risorse di calcolo inattive, e il costo di "bolla" della pipeline di PP=2 si ammortizza nel flusso a regime non appena il batch riempie la pipeline. La documentazione di NVIDIA utilizza TP come impostazione predefinita per una ragione valida: il loro posizionamento principale per Spark è la gestione interattiva di flussi singoli con TTFT (Time To First Time) ristretto, che è l'unico regime in cui TP=2 risulta nettamente superiore. Nel momento in cui il carico di lavoro assomiglia a quello di un'infrastruttura di gestione piuttosto che a quello di un'interfaccia di chat, il calcolo si inverte.
Questa inversione rafforza la definizione di cosa Spark sia e cosa non sia. Un cluster Spark a due nodi è una piattaforma di sviluppo e apprendimento che consente a un singolo ingegnere di osservare in prima persona il comportamento dell'inferenza distribuita su una rete sufficientemente veloce da simulare una reale infrastruttura di data center, ma al contempo abbastanza limitata da evidenziare i colli di bottiglia che le implementazioni di produzione devono aggirare su larga scala.
Le configurazioni Spark di dimensioni maggiori meritano di essere esaminate singolarmente, con carichi di lavoro e strategie di parallelismo adatti a tale scala, e abbiamo già in programma di lavorare su questo aspetto. Parallelamente, il prossimo esperimento in coda a questo si sposta dall'inferenza all'addestramento: un modello con meno di un miliardo di parametri, addestrato da zero su un cluster dual-Spark, configurato per replicare le condizioni di pre-addestramento distribuito di sistemi molto più grandi. Questo lavoro è sospeso in attesa che siano disponibili i componenti ottici per il nostro nuovo switch di rete da 800 Gb nel laboratorio, e prevediamo di pubblicarlo non appena il nuovo core sarà operativo.


 Amazon