

La L40S colma una lacuna critica nell'ecosistema delle GPU per data center. Mentre le GPU per l'addestramento dell'IA incentrate sul calcolo, come la Nvidia H100, danno priorità alle prestazioni pure ma omettono completamente l'accelerazione grafica, le tradizionali schede di visualizzazione professionale in genere non dispongono delle capacità di calcolo dell'IA richieste dai moderni carichi di lavoro di inferenza e dalle emergenti applicazioni grafiche basate sull'IA. Questo posizionamento la rende particolarmente preziosa per la generazione di dati sintetici, lo sviluppo di IA multimodale e le applicazioni Omniverse, in cui sia le prestazioni di calcolo che quelle grafiche sono essenziali.
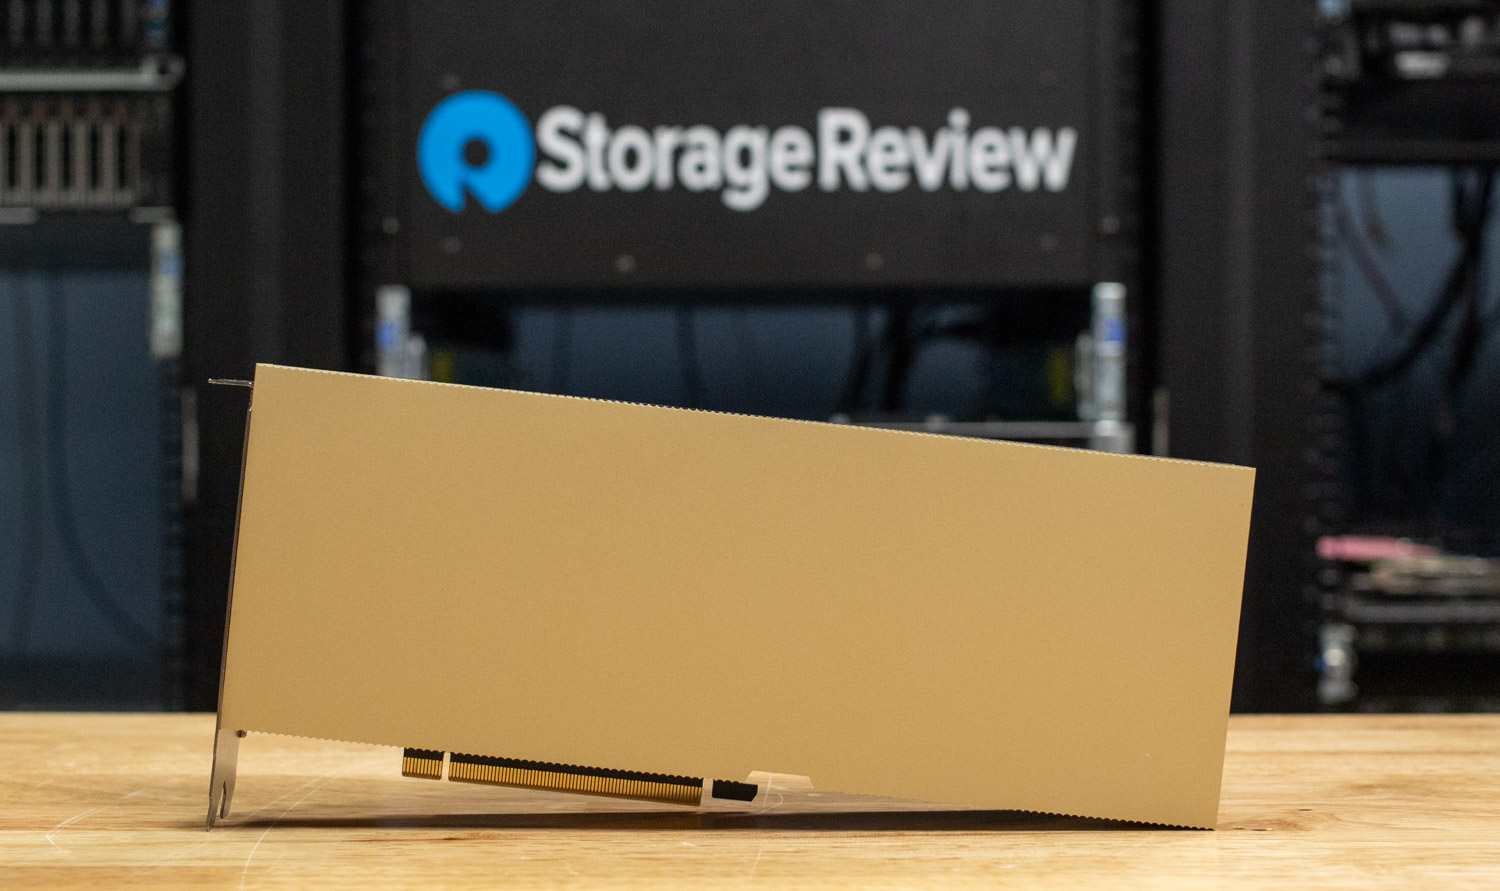
Specifiche NVIDIA L40S
| Specificazione | L40 | L40S | H100 80G PCIe |
| Architettura GPU | Ada Lovelace | Ada Lovelace | Hopper |
| La GPU muore | AD102 | AD102 | GH100 |
| Core CUDA | 18,176 | 18,176 | 14,592 |
| Tensor Core | 568 (4a generazione) | 568 (4a generazione) | 456 |
| RT | 142 (3a generazione) | 142 (3a generazione) | - |
| Memoria GPU | GDDR48 da 6 GB con ECC | GDDR48 da 6 GB con ECC | HBM80e da 2 GB |
| Banda di memoria | 864 GB / s | 864 GB / s | 2 TB / s |
| Interfaccia di memoria | 384-bit | 384-bit | 5120-bit |
| Carico stimato | 300W | 350W | 350W |
| Fattore di forma | 4.4″ H x 10.5″ L: Doppio slot | 4.4″ H x 10.5″ L: Doppio slot | 4.4″ H x 10.5″ L: Doppio slot |
| Soluzione termica | Passivo | Passivo | Passivo |
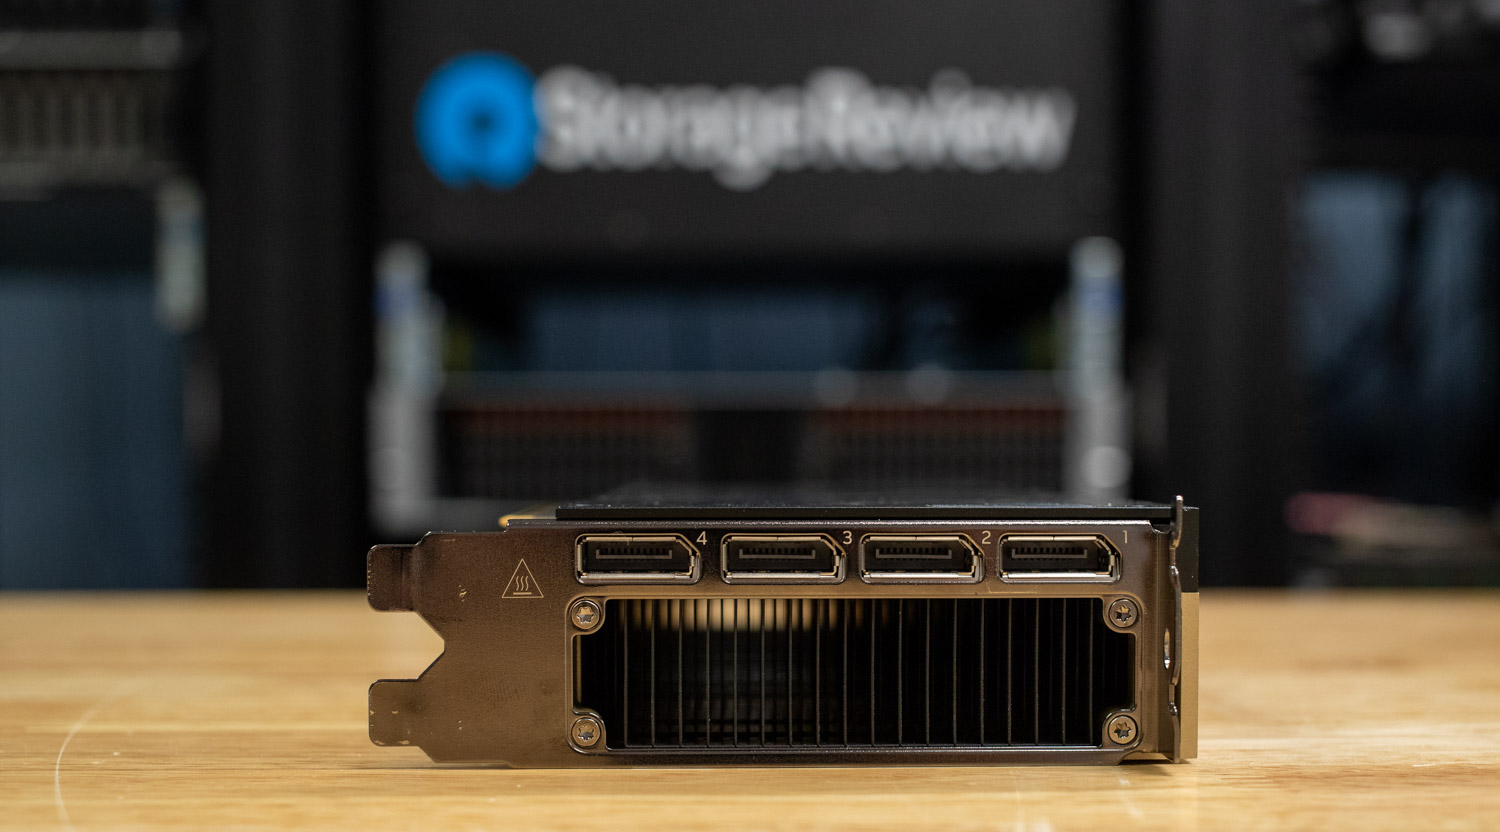
| Connettori display | 4 porte DisplayPort 1.4a | 4 porte DisplayPort 1.4a | - |
| Interfaccia PCIe | Gen4x16 | Gen4x16 | Gen5x16 |
| Connettore di alimentazione | 16-pin | 16-pin | 16-pin |
| Supporto vGPU | Si | Si | Nodo |
| GPU multi-istanza (MiG) | Nodo | Nodo | Si |
| Supporto NVLink | Nodo | Nodo | Nodo |
Specifiche di prestazione
| Metrico | Prestazioni L40 | Prestazioni L40S | Prestazioni H100 |
| Prestazioni FP32 | 90.5 TFLOPS | 91.6 TFLOPS | 51.2 TFLOPS |
| Nucleo Tensoriale TF32 | 362.1 TFLOPS | 366 TFLOPS | 756 TFLOPS |
| Nucleo tensoriale FP16 | 724 TFLOPS | 733 TFLOPS | 1513 TFLOPS |
| Nucleo tensoriale FP8 | 1,448 TFLOPS | 1,466 TFLOPS | 3026 TFLOPS |
| Picco INT8 Tensor TOPS | 1,448 TFLOPS | 1,466 TFLOPS | 3026 TOP |
| Prestazioni principali di RT | 209 TFLOPS | 212 TFLOPS | - |
(I numeri delle prestazioni sono scarsi)
NVIDIA L40S contro H100
Uno sguardo più approfondito alle specifiche rivela le distinte filosofie di progettazione alla base di NVIDIA L40S e H100. La L40S è basata sull'architettura Ada Lovelace, utilizzando lo stesso die AD102 presente nelle schede grafiche per workstation di fascia alta di NVIDIA. Questa eredità le conferisce un numero enorme di 18,176 core CUDA, garantendo prestazioni FP32 a precisione singola eccezionali, un pilastro del rendering grafico tradizionale e del calcolo scientifico. Al contrario, l'architettura Hopper e il die GH100 della H100 sono progettati specificamente per carichi di lavoro di intelligenza artificiale e HPC.
L'elemento di differenziazione più significativo è la configurazione del core. L'L40S include 142 RT Core di terza generazione e 568 Tensor Core di quarta generazione. Gli RT Core sono hardware specializzato per l'accelerazione del ray tracing, una funzionalità completamente assente nell'H100, rendendo l'L40S l'unico in grado di realizzare rendering fotorealistici. Sebbene l'H100 abbia meno Tensor Core, questi sono più veloci e avanzati, ottimizzati per i nuovi formati di dati AI come FP8, il che gli conferisce un vantaggio decisivo nelle prestazioni grezze dell'AI.
Questo compromesso è evidente anche nei sottosistemi di memoria. L'H100 utilizza 80 GB di memoria HBM2e ad alto costo, offrendo ben 2 TB/s di larghezza di banda. Questo è essenziale per alimentare i sottosistemi di memoria durante l'addestramento e l'inferenza di modelli di intelligenza artificiale su larga scala. L'L40S utilizza una memoria GDDR48 più convenzionale da 6 GB, fornendo 864 GB/s di larghezza di banda. Sebbene sia meno della metà di quella dell'H100, si tratta comunque di una quantità considerevole, perfettamente adeguata per caricare scene 3D di grandi dimensioni, texture ad alta risoluzione e modelli di intelligenza artificiale di notevoli dimensioni per l'inferenza.
Infine, il set di funzionalità ne delinea i ruoli previsti. L'L40S include quattro uscite DisplayPort 1.4a e un robusto supporto vGPU, rendendolo ideale per workstation virtualizzate, render farm e implementazioni di cloud gaming. L'H100, privo di uscite video o funzionalità vGPU, offre invece la tecnologia Multi-Instance GPU (MiG), che consente di suddividerlo in più istanze GPU più piccole e isolate per gestire contemporaneamente più carichi di lavoro ad alta intensità di calcolo. Il design termico passivo a doppio slot condiviso e l'inviluppo di potenza da 350 W dell'L40S e dell'H100 PCIe consentono flessibilità di implementazione in un'ampia gamma di server standard del settore.
Confrontando la L40S con la scheda di punta NVIDIA H100, le differenze nei ruoli previsti diventano evidenti. La H100 è leader indiscussa nelle prestazioni di training IA raw di quella generazione di GPU, ma questo confronto racconta solo una parte della storia. Vale la pena notare che anche la L40 fa parte della gamma NVIDIA, con un TDP inferiore di 300 W rispetto ai 40 W della L350S, offrendo capacità simili a consumi ridotti.
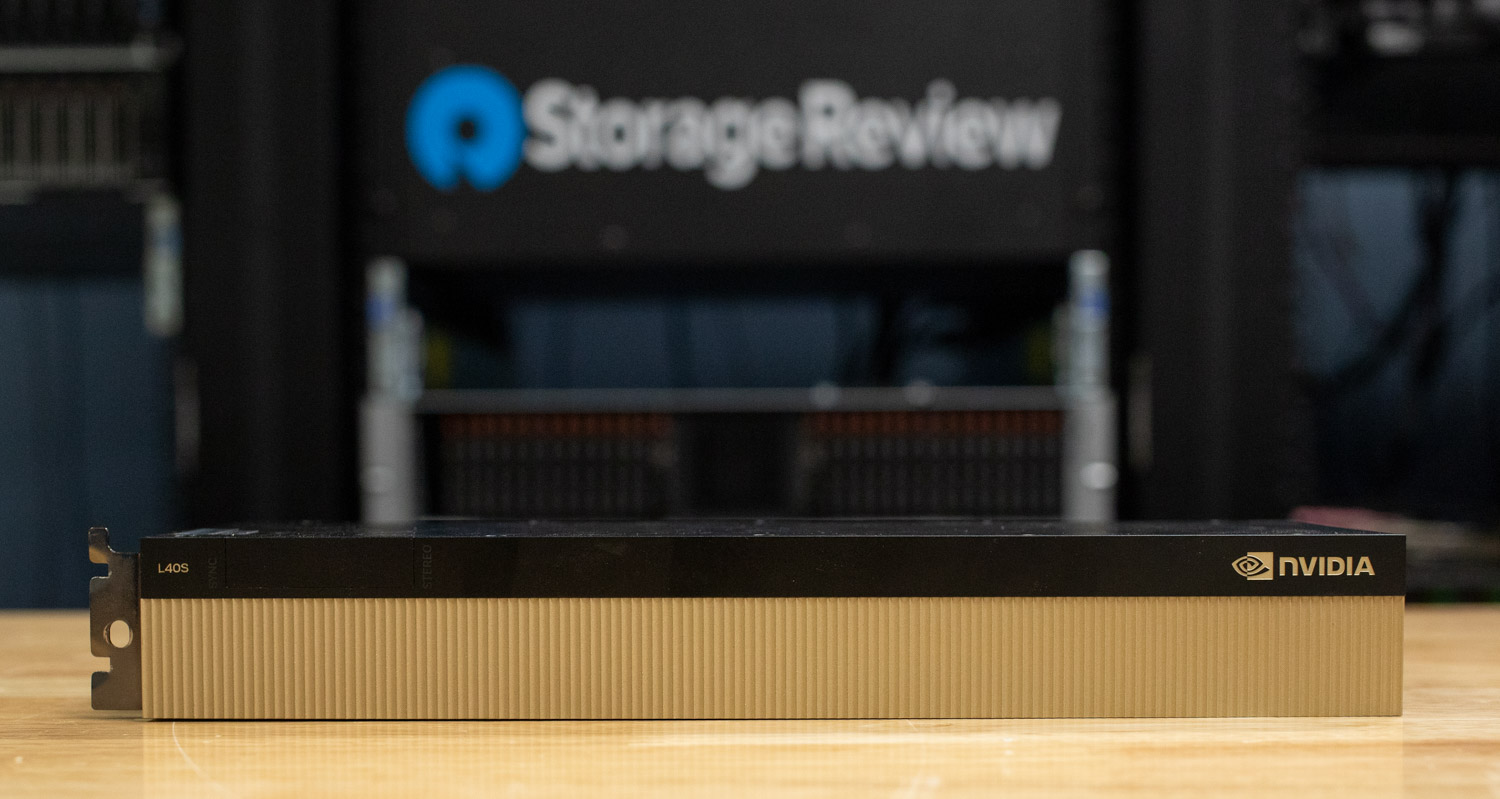
L'H100 che stiamo esaminando qui è la versione originale PCIe da 80 GB con memoria HBM2e. NVIDIA ha poi ampliato questa gamma con varianti come l'H100 NVL, che sostituisce il modello PCIe originale da 80 GB, offrendo 94 GB di memoria e un TDP più elevato di 400 W, aggiungendo il supporto NVLink per configurazioni a doppia GPU. La famiglia H100 si estende anche alle configurazioni SXM a 8 GPU e al più recente H200, che condivide lo stesso die GPU ma offre prestazioni migliorate sia nei fattori di forma PCIe che SXM.
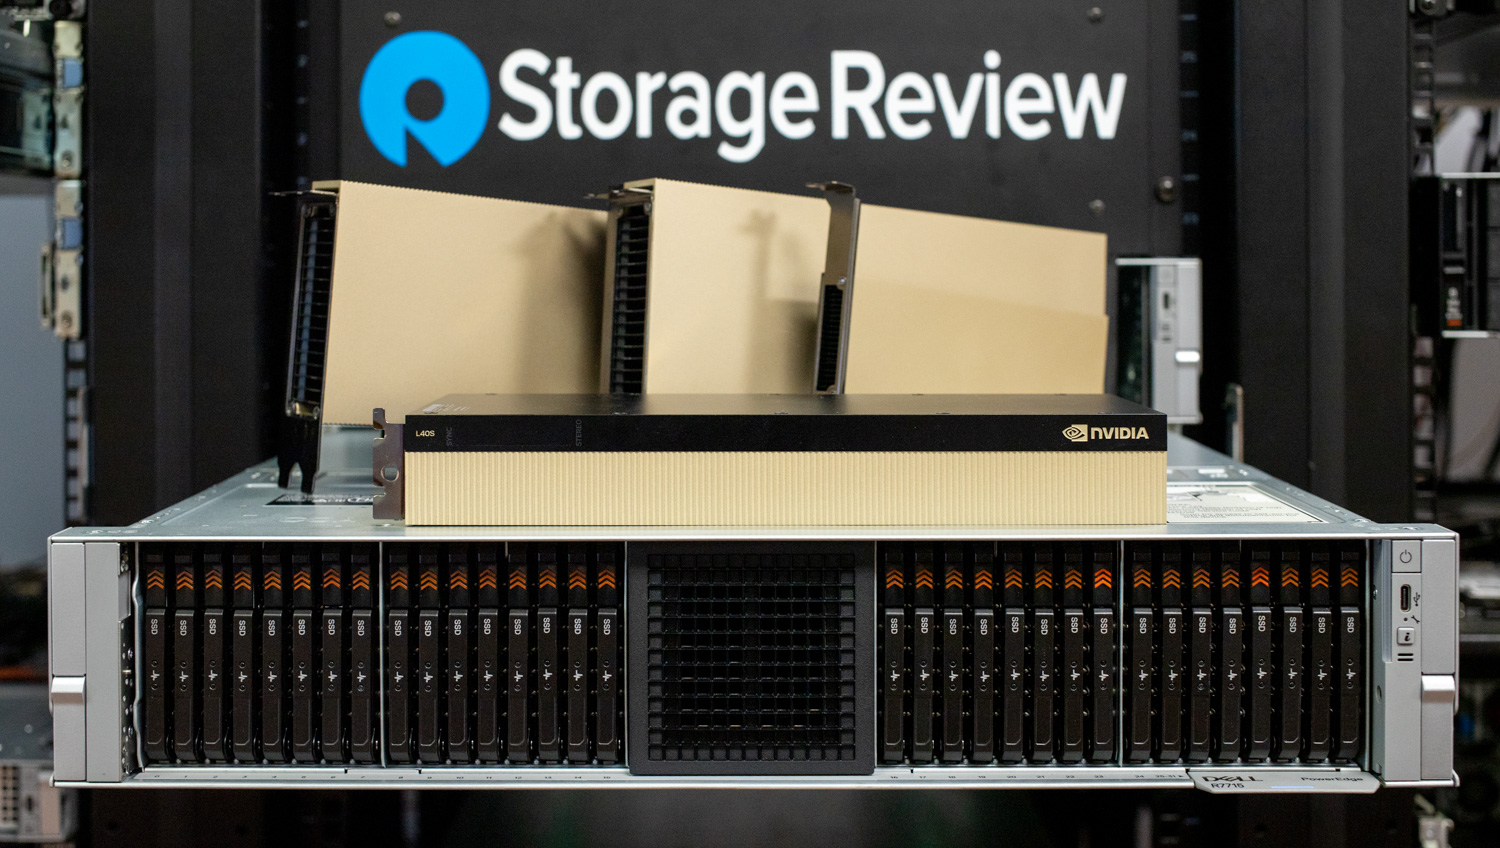
La differenza tra L40S e H100 evidenzia una divergenza strategica nella progettazione delle GPU per data center. L'H100 è una scheda puramente incentrata sul calcolo, ottimizzata esclusivamente per carichi di lavoro di intelligenza artificiale e calcolo ad alte prestazioni. L'obiettivo è l'addestramento di intelligenza artificiale su larga scala, in cui la massima produttività computazionale è l'obiettivo primario. Ogni aspetto del suo design, dall'enorme larghezza di banda di memoria HBM2e ai Tensor Core specializzati, è progettato per gli scenari di addestramento di reti neurali più impegnativi.
Al contrario, la L40S è una GPU universale progettata per la versatilità, pensata per l'inferenza AI, abbinata a carichi di lavoro ad alta intensità grafica e distribuzioni vGPU NVIDIA. Pur rappresentando una soluzione competente ed economica per l'inferenza AI, il suo vero punto di forza risiede nel supportare una vasta gamma di applicazioni ad alta intensità grafica, per le quali l'H100 non è progettata.
Carichi di lavoro ad alta intensità grafica e applicazioni professionali
La L40S eccelle in numerosi ambiti ad alta intensità grafica che richiedono sia potenza di calcolo che capacità di rendering avanzate. Nel rendering e nell'animazione 3D, gli studi si affidano alla L40S per il rendering di scene complesse, dove i suoi RT Core accelerano calcoli di ray tracing impossibili da eseguire con GPU basate solo su elaborazione. Le case di produzione cinematografica e televisiva utilizzano queste capacità per la previsualizzazione in tempo reale, consentendo a registi e direttori della fotografia di visualizzare rendering fotorealistici di scene CGI durante le riprese, riducendo drasticamente i tempi e i costi di post-produzione.
Studi di architettura e ingegneria sfruttano la L40S per la visualizzazione architettonica in tempo reale e la progettazione di prodotti, consentendo ai clienti di visualizzare rendering fotorealistici di edifici o esaminare prototipi dettagliati prima dell'inizio della costruzione fisica. Le capacità grafiche professionali della scheda la rendono ideale anche per le workstation CAD, dove gli ingegneri necessitano sia della potenza di calcolo necessaria per simulazioni complesse sia dell'accelerazione grafica necessaria per prestazioni di visualizzazione fluide e ad alta fedeltà.
Nel settore dei media e dell'intrattenimento, la L40S alimenta le render farm che elaborano frame di animazione di qualità finale. Allo stesso tempo, le sue funzionalità vGPU consentono flussi di lavoro creativi basati su cloud, dove gli artisti possono accedere a potenti workstation grafiche da remoto. I reparti di editing video e post-produzione utilizzano la L40S per l'elaborazione di effetti in tempo reale, la gradazione del colore e i flussi di lavoro di compositing che richiedono sia accelerazione grafica che notevoli risorse di calcolo.
Il mercato delle infrastrutture desktop virtuali (VDI) rappresenta un'altra area applicativa chiave, in cui la tecnologia vGPU dell'L40S consente a più utenti di condividere le risorse GPU per desktop virtuali con accelerazione grafica. Ciò rende le funzionalità grafiche professionali accessibili in ambienti aziendali senza dover dedicare GPU individuali a ciascun utente.
L'evoluzione verso la formazione dell'intelligenza artificiale basata sulla fisica
Ancora più importante, l'L40S offre funzionalità completamente assenti nell'H100. Il principale elemento di differenziazione risiede nei 40 RT Core di terza generazione dell'L142S, che consentono il ray tracing in tempo reale e il rendering fotorealistico. Mentre l'H100 non ha RT Core e non può eseguire l'accelerazione grafica, i core RT dell'L40S lo rendono la scelta ideale per applicazioni che richiedono sia elaborazione AI che grafica avanzata.
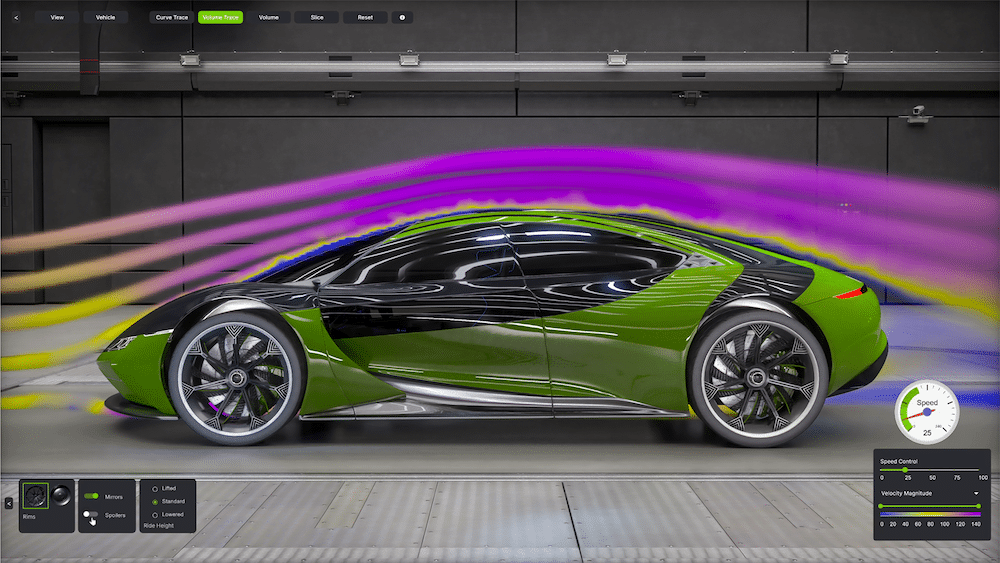
Fonte: Nvidia
Questa distinzione diventa sempre più critica man mano che assistiamo alla crescente popolarità della modellazione 3D generata dall'intelligenza artificiale, delle simulazioni di gemelli digitali e dei flussi di lavoro Universal Scene Description (OpenUSD). La prossima frontiera dell'intelligenza artificiale non riguarda solo l'addestramento di modelli linguistici più ampi; si tratta di sviluppare modelli del mondo che comprendano la fisica, le relazioni spaziali e le interazioni del mondo reale. Questa evoluzione richiede un cambiamento fondamentale nel nostro approccio alla generazione dei dati di addestramento.
Mentre l'addestramento dei modelli di intelligenza artificiale tradizionali si basa in larga misura sulle GPU di calcolo di punta di NVIDIA, l'addestramento della prossima generazione di modelli di mondo basati sulla fisica richiede un approccio diverso. Questi sistemi di intelligenza artificiale avanzati necessitano di enormi quantità di dati di addestramento che catturino non solo informazioni visive, ma anche proprietà fisiche, comportamento dell'illuminazione, interazioni tra materiali e relazioni spaziali. GPU come la L40S diventano essenziali per la generazione di dati di addestramento su larga scala, dove i loro RT Core consentono la creazione di ambienti sintetici fisicamente accurati che fungono da base per l'addestramento di modelli di intelligenza artificiale più sofisticati.
Questa capacità di rendering grafico avanzato, supportata dai core RT dedicati, è esattamente ciò che rende L40S il motore ideale per la piattaforma Omniverse di NVIDIA e per l'ecosistema più ampio di sviluppo dell'intelligenza artificiale basata sulla fisica.
Onniverso
Omniverse è una piattaforma di sviluppo composta da API, SDK e servizi che consente agli sviluppatori di creare applicazioni e flussi di lavoro basati su Universal Scene Description (OpenUSD). È progettata per creare e connettere mondi virtuali 3D fisicamente accurati e in tempo reale. Ciò è reso possibile dall'integrazione della tecnologia RTX di NVIDIA per il rendering fotorealistico con ray tracing direttamente nei flussi di lavoro di simulazione industriale e robotica. Il processore L40S, con i suoi potenti RT Core, fornisce l'accelerazione hardware essenziale per gestire questi impegnativi carichi di lavoro di rendering RTX, consentendo agli sviluppatori di simulare luce, materiali e fisica con un realismo straordinario.
Più di un semplice strumento di visualizzazione, Omniverse è una piattaforma per lo sviluppo della prossima generazione di intelligenza artificiale fisica. Creando questi mondi virtuali realistici, o "gemelli digitali", gli sviluppatori possono simulare complessi impianti industriali, testare intere flotte di robot e convalidare veicoli autonomi in un ambiente virtuale sicuro prima della loro implementazione nel mondo reale. Fondamentalmente, queste simulazioni ad alta fedeltà diventano la base per la generazione di enormi quantità di dati sintetici basati sulla fisica; una risorsa fondamentale per l'addestramento dei potenti modelli di intelligenza artificiale che girano su GPU focalizzate sul calcolo.
Generazione di movimento di manipolazione sintetica per la robotica
Il progetto NVIDIA Isaac GR00T per la generazione di movimenti di manipolazione sintetica fornisce un framework per l'addestramento robotico, dimostrando come le capacità del core RT dell'L40S consentano la creazione di grandi set di dati a partire da dimostrazioni umane minime. Questo flusso di lavoro affronta una delle principali sfide nello sviluppo della robotica: il processo, lungo e costoso, di raccolta di dati di addestramento sufficienti e di alta qualità per le attività di manipolazione robotica.
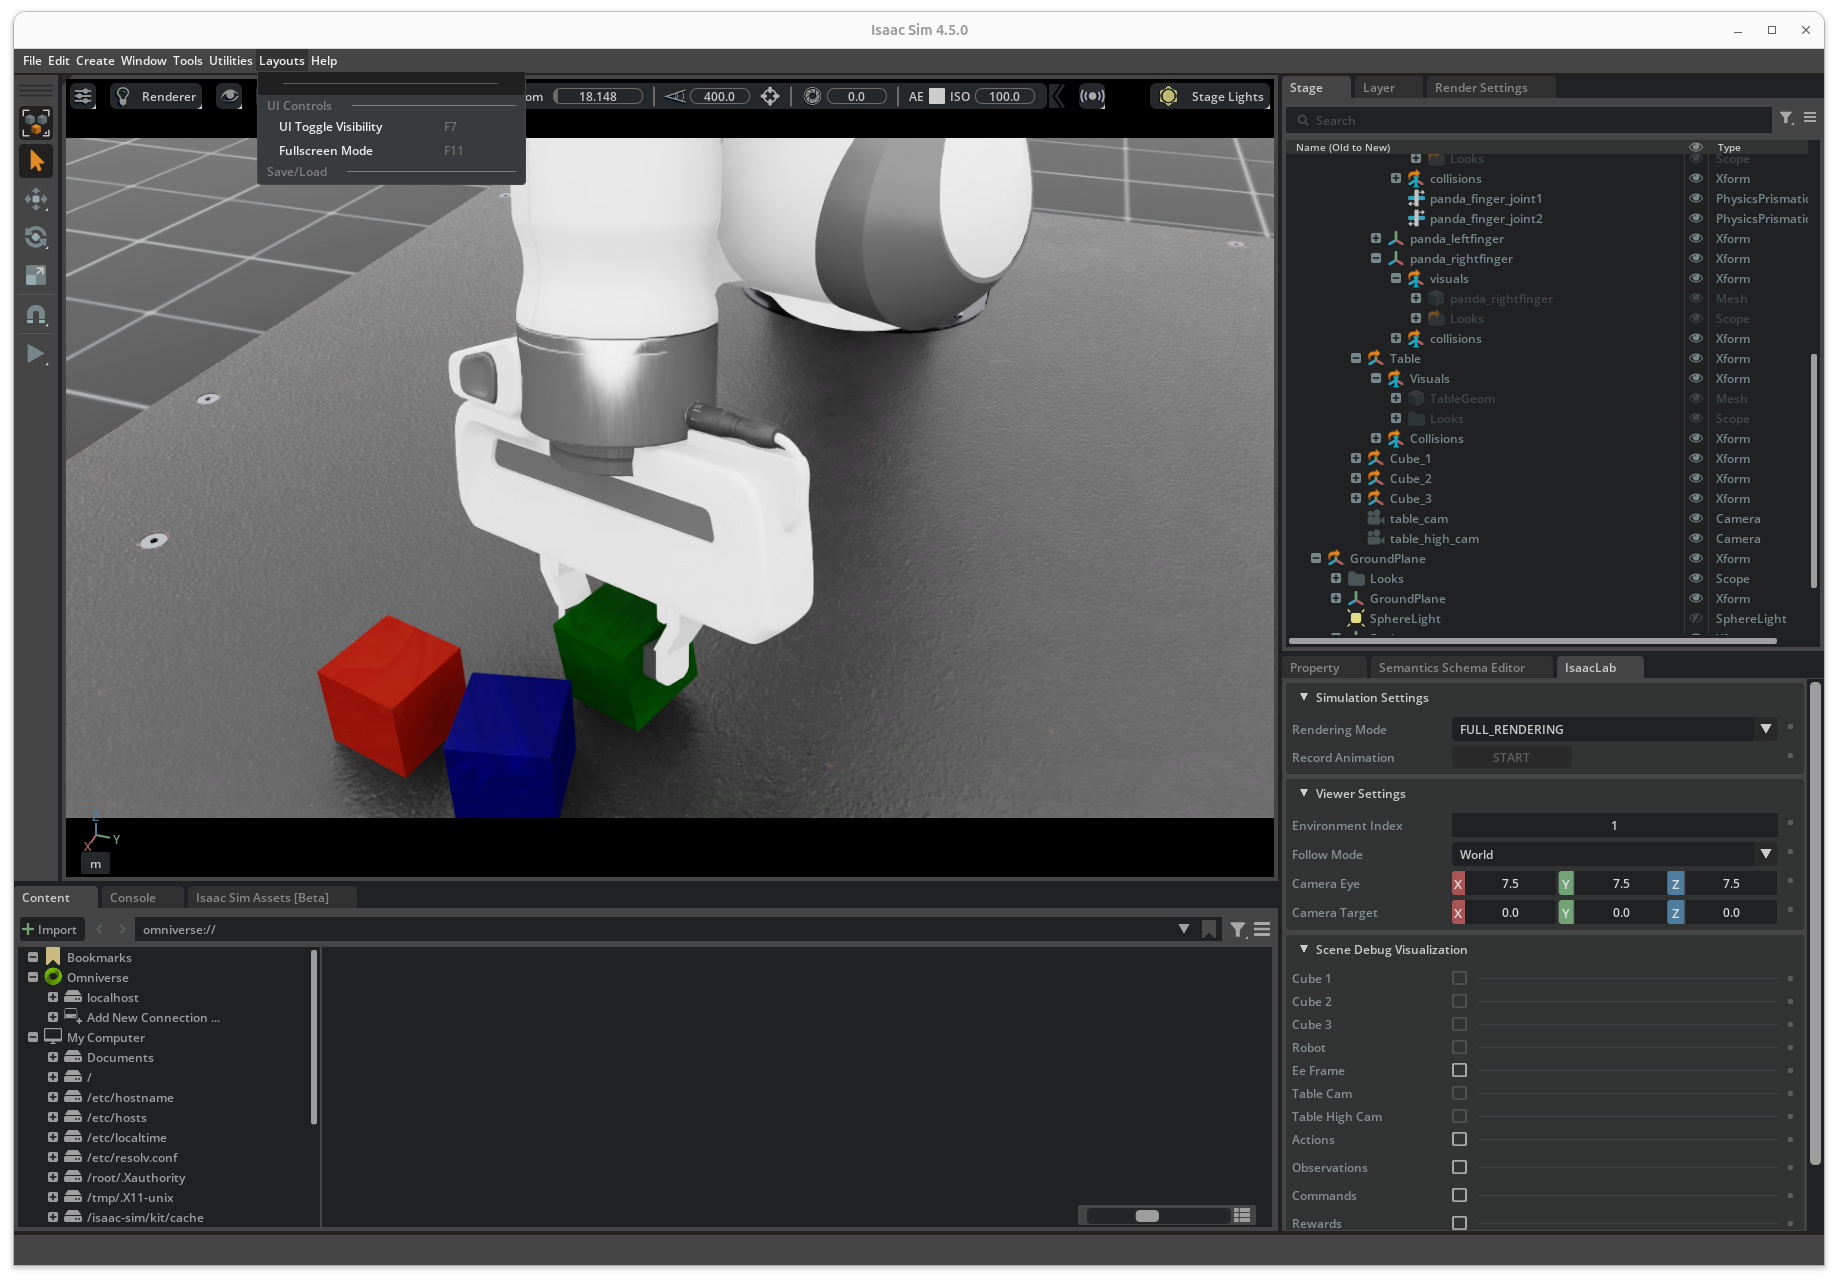
L'addestramento robotico tradizionale si basa in larga misura sull'apprendimento supervisionato o per imitazione, in cui i robot acquisiscono nuove competenze osservando e imitando dimostrazioni umane esperte. Tuttavia, creare dimostrazioni perfette è impegnativo e raccogliere ampi set di dati di alta qualità nel mondo reale è noioso, dispendioso in termini di tempo e denaro. Un operatore umano adeguatamente formato impiega in genere circa un minuto per registrare una singola dimostrazione di alta qualità, un'operazione difficile da realizzare su larga scala a causa del notevole impegno umano richiesto e del potenziale di errore.
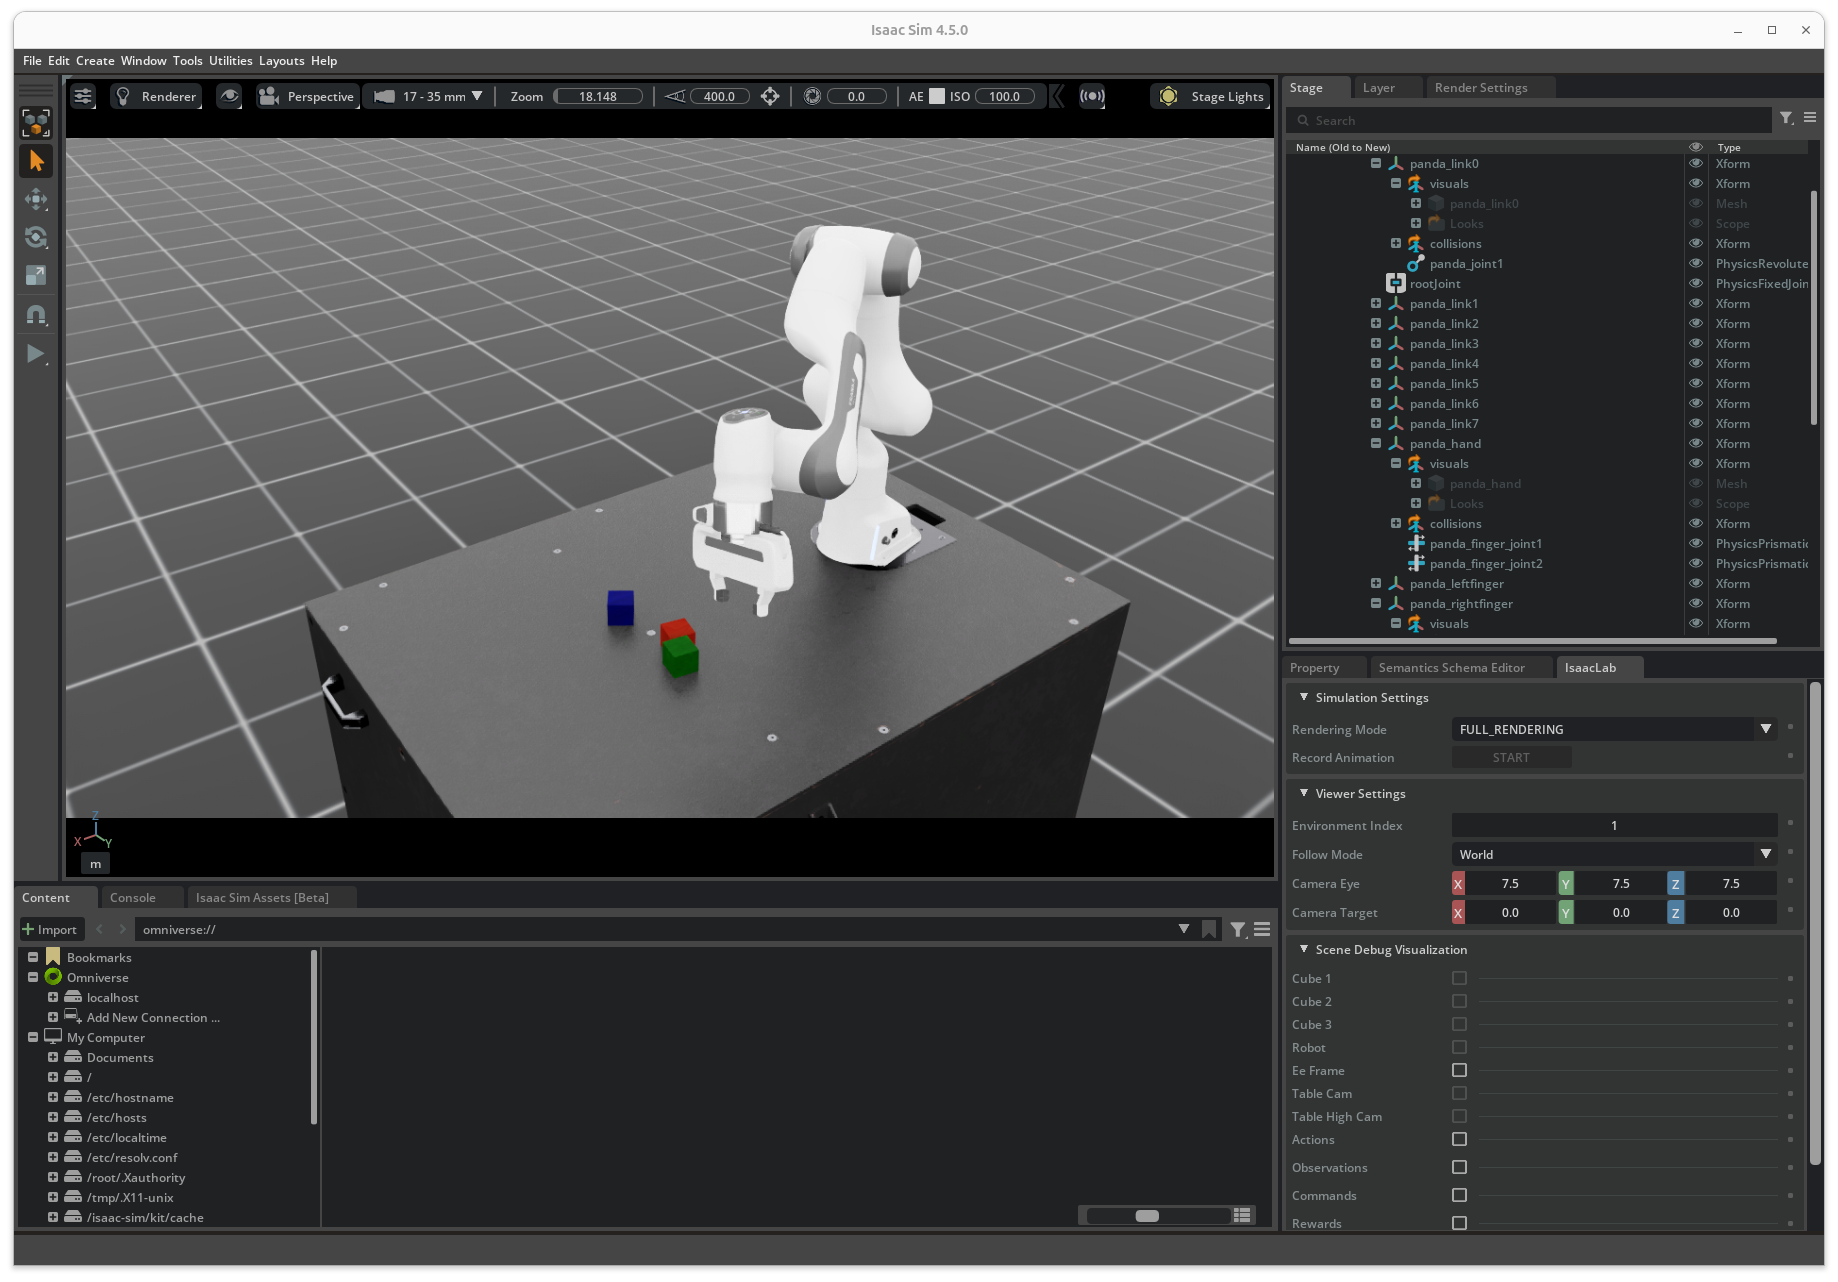
Il progetto Isaac GR00T affronta questa sfida sfruttando dati sintetici generati da simulazioni fisicamente accurate per accelerare il processo di raccolta dati. Le organizzazioni possono raccogliere una quantità di dati esponenzialmente maggiore con solo un paio d'ore di dimostrazioni umane.
Il progetto Isaac GR00T è costituito da tre componenti chiave che lavorano insieme per creare una pipeline completa di generazione di dati sintetici:
- GR00T-Teleop consente agli operatori umani qualificati di controllare robot virtuali utilizzando dispositivi di elaborazione spaziale come Apple Vision Pro. Questo sistema consente agli operatori di dimostrare complesse attività di manipolazione in ambienti virtuali fotorealistici, catturando non solo le traiettorie di movimento, ma anche il contesto ambientale e le interazioni con gli oggetti. Apple Vision Pro trasmette i dati di tracciamento delle mani a Isaac Lab, che contemporaneamente trasmette al dispositivo una vista immersiva dell'ambiente in cui si trova il robot, consentendo un controllo intuitivo e interattivo del robot.
- GR00T-Mimic Prende le dimostrazioni registrate e le moltiplica in set di dati sintetici più ampi utilizzando tecniche di simulazione avanzate. Questo componente utilizza le dimostrazioni registrate come input per generare ulteriori traiettorie di movimento sintetiche in Isaac Lab, supportando sia la manipolazione di robot umanoidi a braccio singolo che a due mani. Il processo prevede l'annotazione dei punti chiave nelle dimostrazioni e l'utilizzo dell'interpolazione per garantire che le traiettorie sintetiche siano fluide e contestualmente appropriate.
- GR00T-Gen Sfrutta le piattaforme NVIDIA Omniverse e Cosmos per espandere i set di dati sintetici tramite upscaling 3D e randomizzazione dei domini. Questo componente aggiunge ulteriore diversità randomizzando sfondo, illuminazione e altre variabili nella scena. Potenzia le immagini generate tramite NVIDIA Cosmos Transfer, ottenendo un fotorealismo che contribuisce a ridurre il divario tra simulazione e realtà.
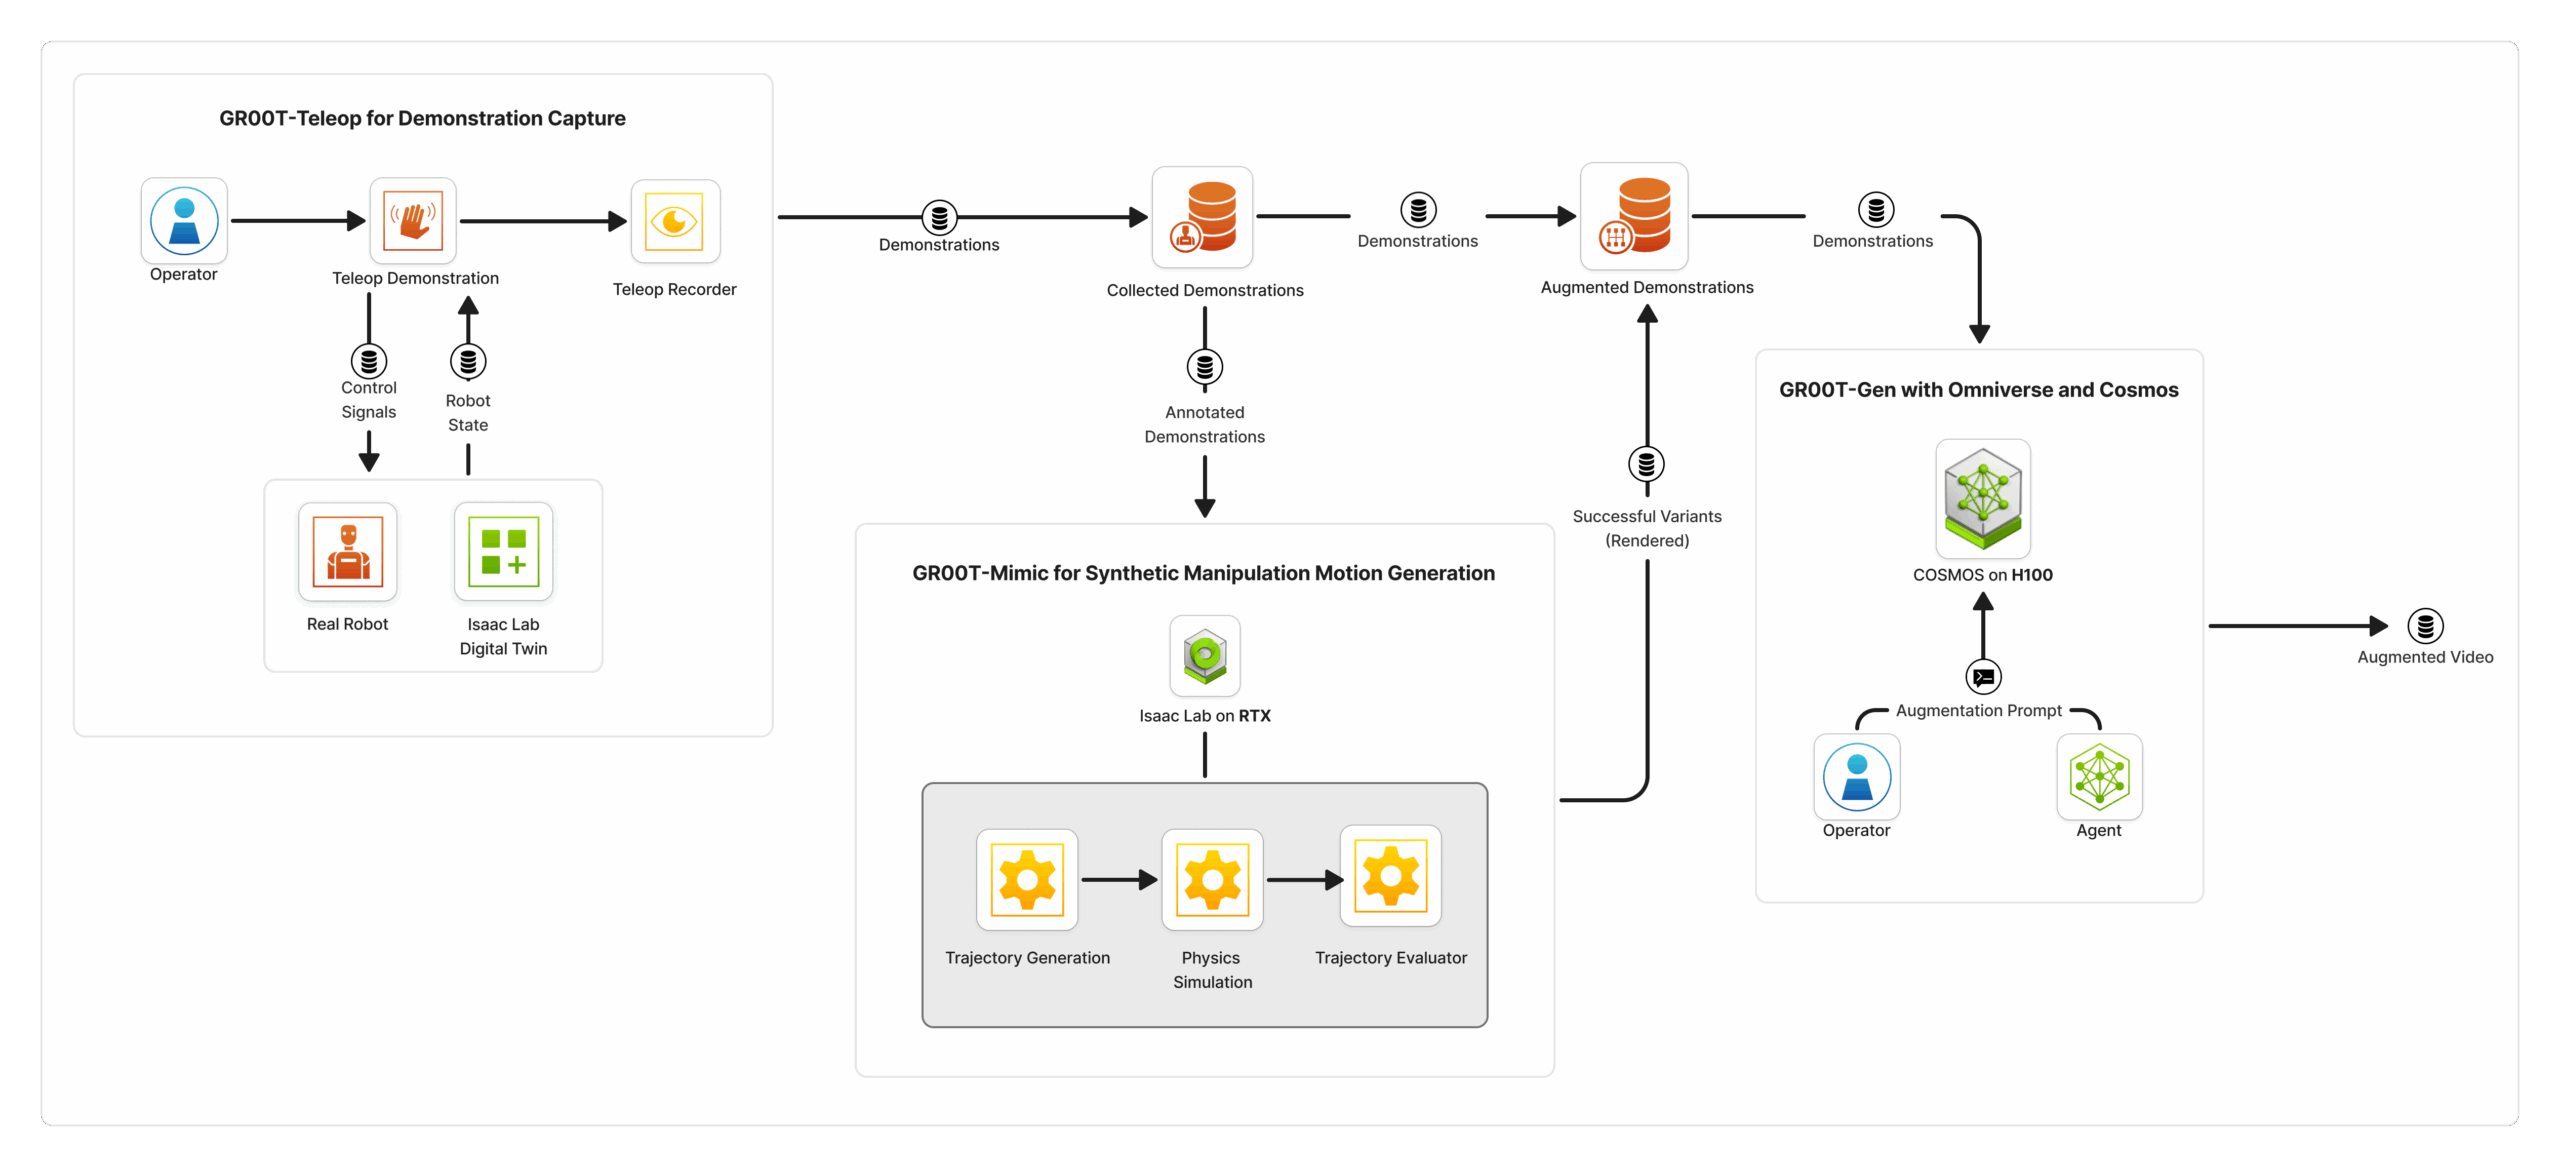
Questa pipeline illustra perfettamente i ruoli specializzati e complementari delle moderne GPU per data center. La L40S, con i suoi RT Core dedicati, funge da world-builder. È indispensabile per le fasi iniziali della generazione dei dati, dove gestisce il rendering basato sulla fisica, il ray-tracing in tempo reale e la randomizzazione dei domini necessari per creare un ambiente virtuale fotorealistico e diversificato.
Questo mondo virtuale ad alta fedeltà diventa quindi la tela per la fase successiva della generazione. I modelli di intelligenza artificiale generativa, come quelli di NVIDIA Cosmos , vengono eseguiti su GPU focalizzate sul calcolo come l'H100 per produrre i dati di addestramento finali. L'H100 sfrutta l'ambiente realistico creato dall'L40S per generare milioni di scenari dinamici e fisicamente consapevoli.
Benchmark delle prestazioni di inferenza dell'IA
Un altro caso d'uso in cui schede come la L40S sono popolari è l'inferenza a basso costo. Per valutare le capacità di inferenza AI nel mondo reale della L40S rispetto all'H100, abbiamo confrontato le prestazioni LLM utilizzando vLLM che esegue il modello parametrico Open Reasoning Nemotron 14B di Nvidia a BF16 con una lunghezza massima di token di 32K.
Risultati del benchmark vLLM
L'H100 dimostra una netta leadership in termini di prestazioni, offrendo una velocità di trasmissione dati circa 4.2 volte superiore rispetto all'L40S. Questo vantaggio deriva direttamente dalle prestazioni raddoppiate del Tensor Core e dalla larghezza di banda di memoria più che raddoppiata dell'H100 (2 TB/s contro 864 GB/s).
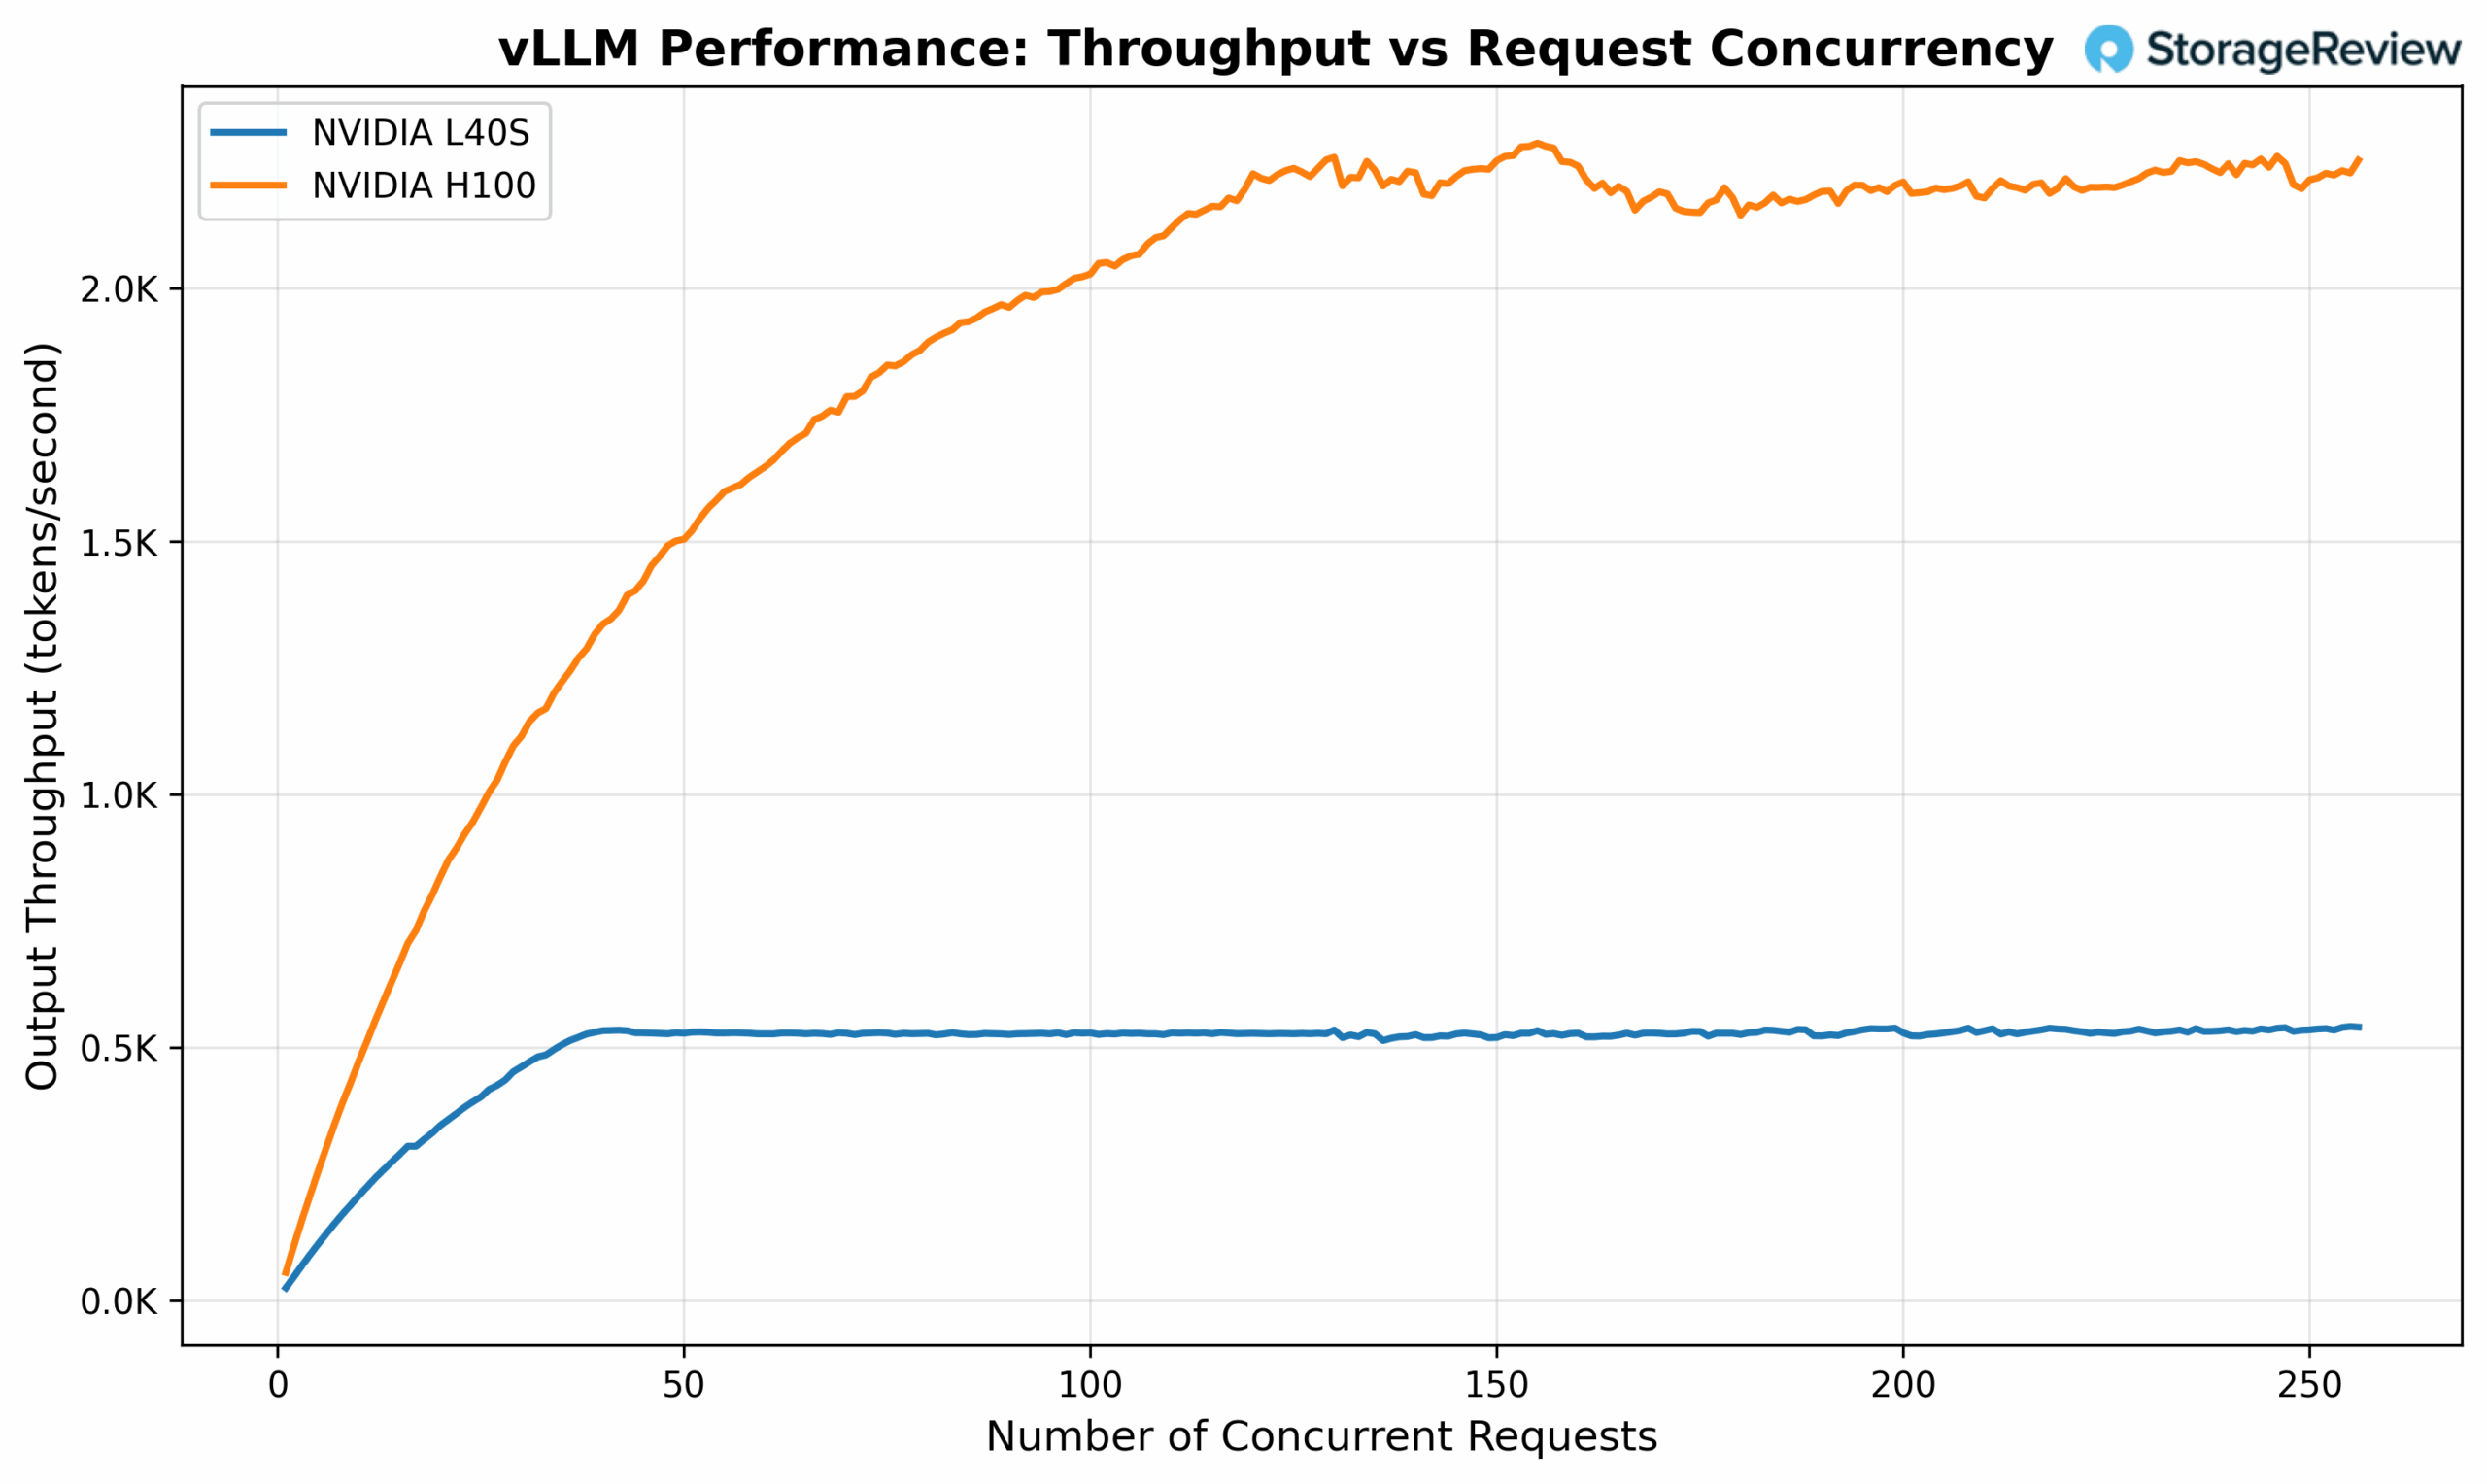
Tuttavia, il rapporto prestazioni/prezzo racconta una storia diversa. L'L40S costa in genere meno di un terzo del prezzo di un H100, il che lo rende più conveniente per molti carichi di lavoro di inferenza. Le organizzazioni che gestiscono servizi di inferenza in cui le massime prestazioni assolute non sono critiche spesso riscontrano che l'L40S offre un costo totale di proprietà inferiore.
Facendo doppio clic sulla sezione con prestazioni lineari, vediamo che L40S offre un livello di prestazioni molto accettabile, essendo in grado di gestire 16 richieste simultanee con un SLO TPOT (Time Per Output Token) di circa 52 ms.
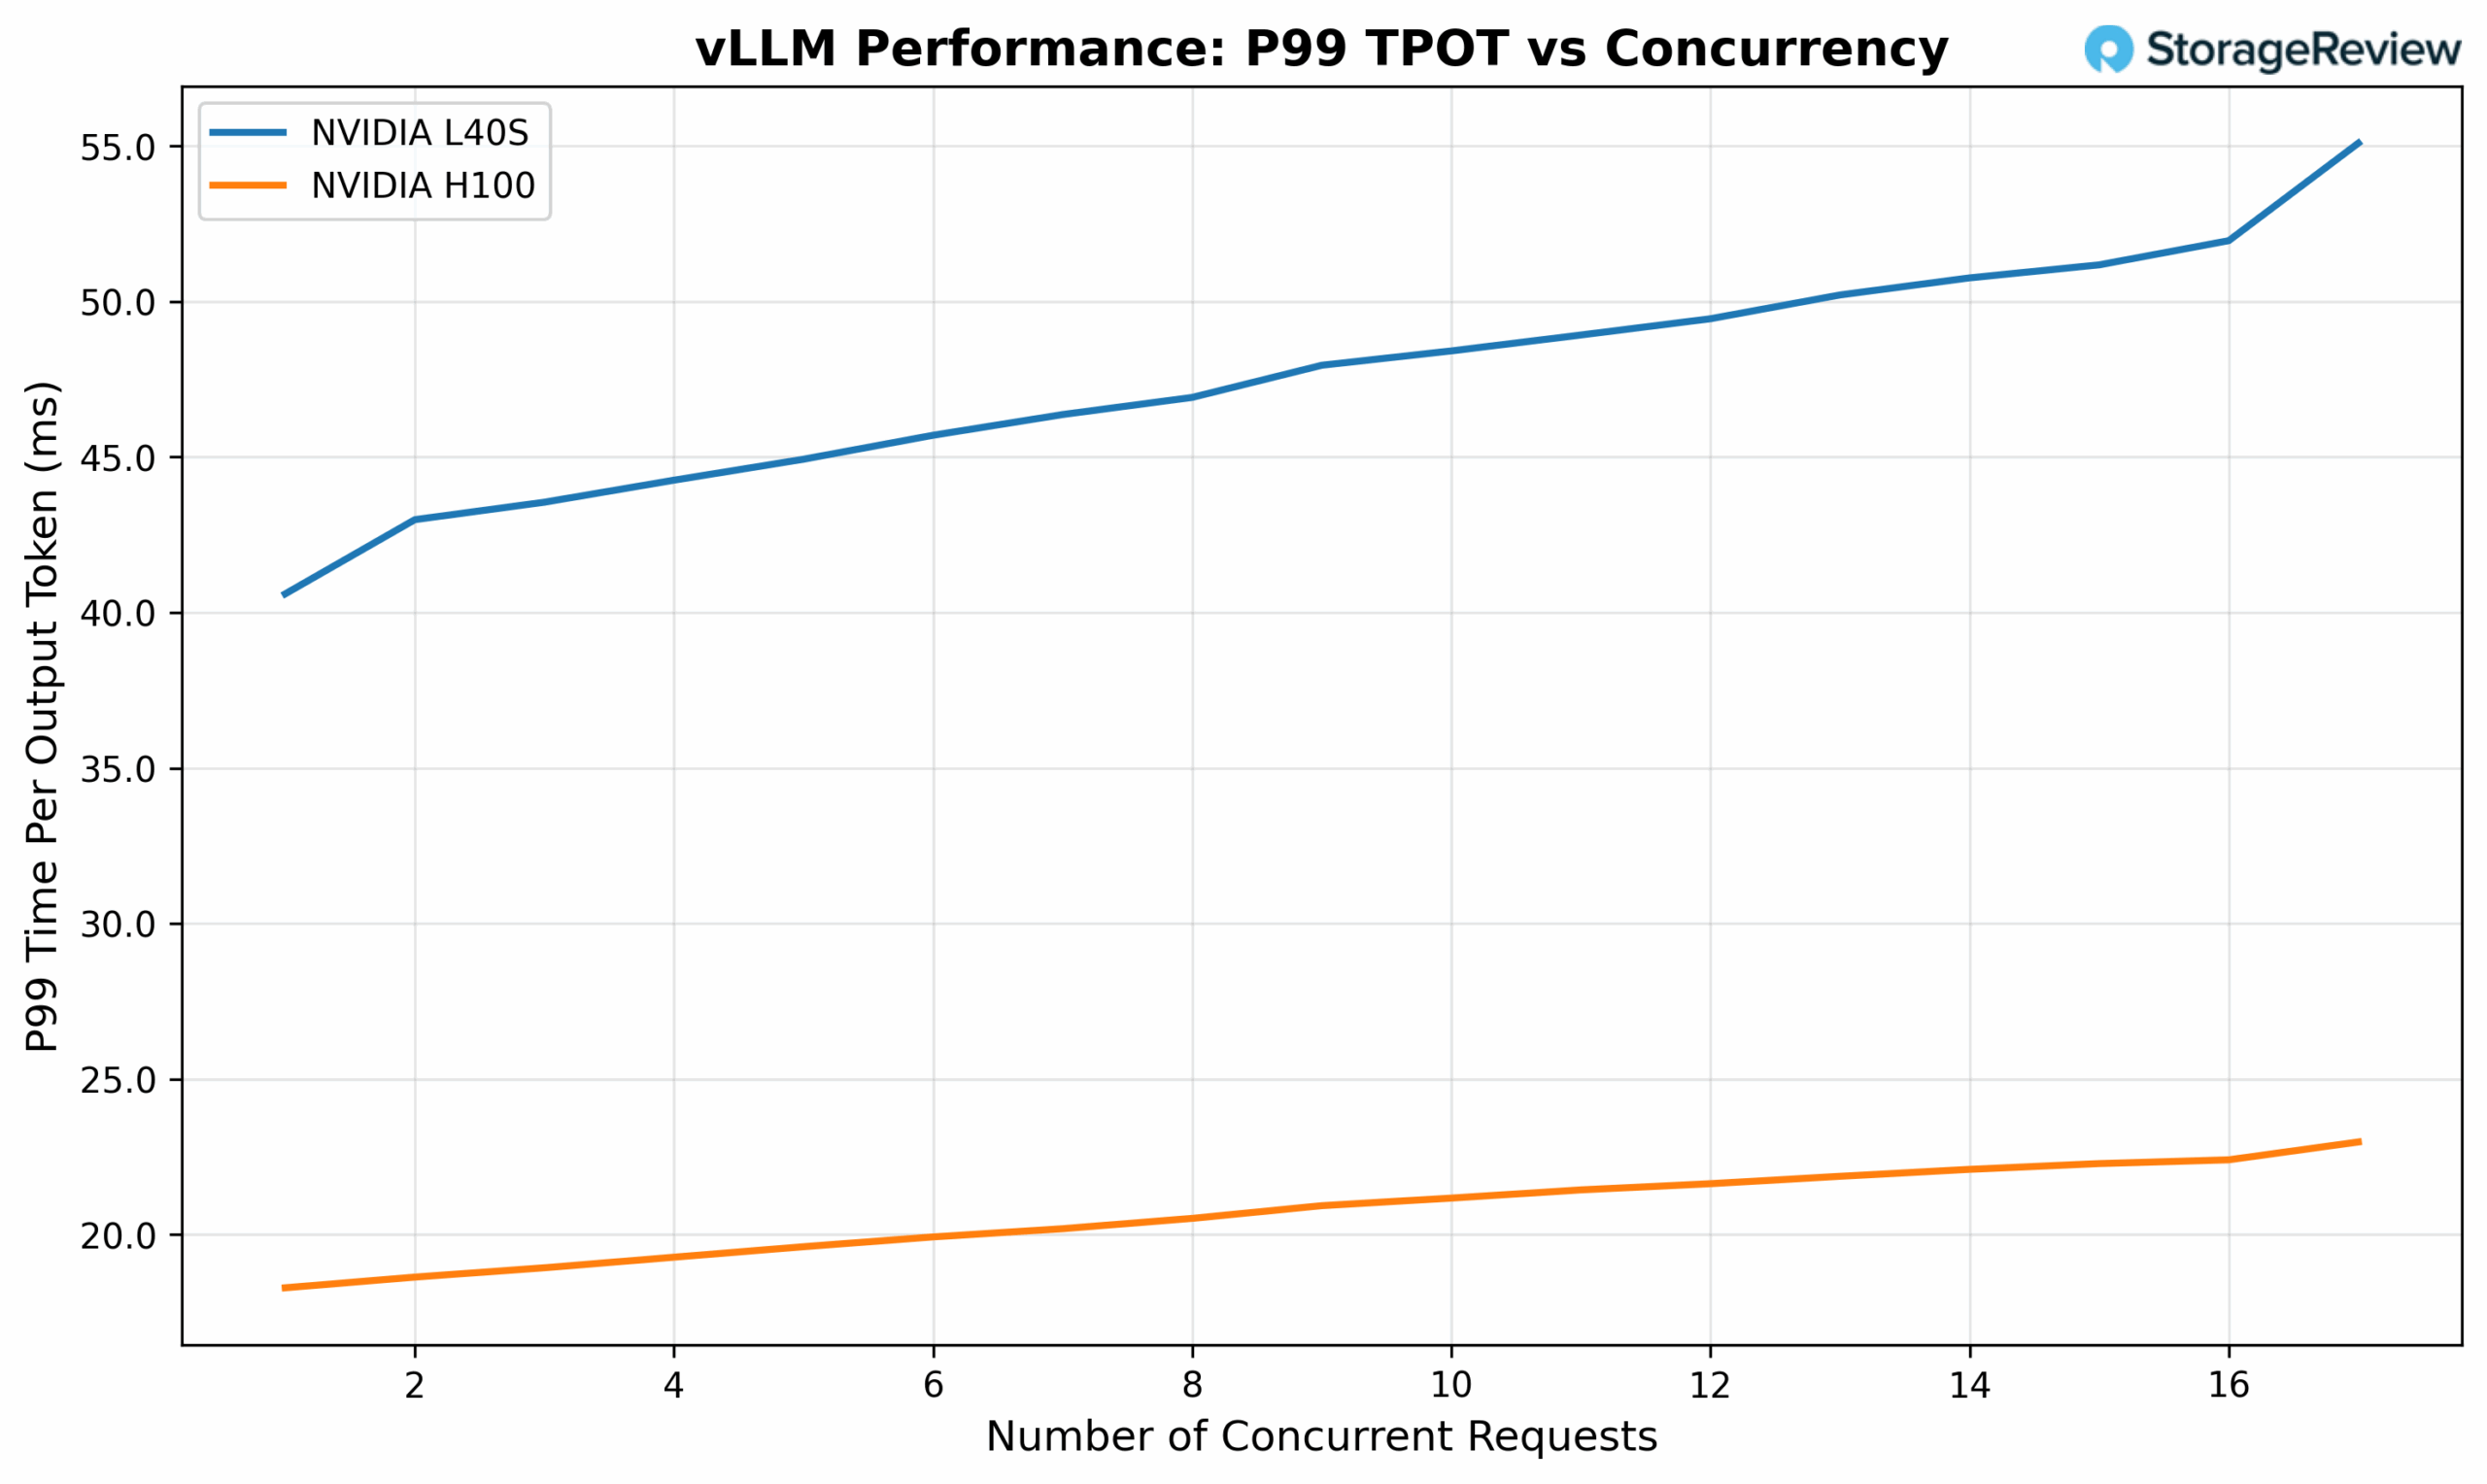
Un fattore importante da notare è che l'inferenza AI, in particolare la fase di decodifica della generazione del testo, è fondamentalmente un'operazione che richiede molta banda di memoria. Durante l'inferenza, il modello deve accedere ripetutamente ai pesi memorizzati nella memoria della GPU per generare ogni nuovo token, rendendo la velocità di trasmissione della memoria un collo di bottiglia critico per le prestazioni. Questa caratteristica spiega perché l'H100, con la sua larghezza di banda di memoria superiore e le prestazioni migliorate del Tensor Core, raggiunge naturalmente una velocità di trasmissione dell'inferenza più elevata.
Tuttavia, per gli scenari di distribuzione che richiedono sia l'inferenza AI che l'accelerazione grafica, come il rendering in tempo reale con effetti potenziati dall'AI, applicazioni interattive con funzionalità basate sull'AI, l'L40S diventa l'unica opzione praticabile.
Conclusione
NVIDIA L40S e i più recenti successori di Blackwell RTX Pro 6000 si presentano come GPU strategicamente posizionate per rispondere alle esigenze in continua evoluzione dei moderni data center, dove l'elaborazione AI e le capacità grafiche avanzate convergono sempre più. Mentre le classi di GPU H100 e B200 rimangono leader indiscusse per i carichi di lavoro di training e inferenza AI pura, la L40S si ritaglia una nicchia distinta e preziosa come GPU universale che colma il divario tra le schede AI focalizzate sul calcolo e le tradizionali soluzioni di visualizzazione professionale.
L'esclusiva proposta di valore dell'L40S diventa più evidente in scenari che richiedono sia capacità di inferenza AI che accelerazione grafica. I suoi 142 RT Core di terza generazione consentono applicazioni semplicemente impossibili su GPU di sola elaborazione come l'H100, dal ray tracing in tempo reale nei flussi di lavoro professionali alla generazione di dati sintetici fotorealistici per l'addestramento AI di nuova generazione. Questa duplice capacità lo rende indispensabile per le applicazioni emergenti nello sviluppo di gemelli digitali, nell'addestramento AI basato sulla fisica e nel crescente ecosistema Omniverse.
Da un punto di vista economico, l'L40S offre un valore interessante per le organizzazioni che non necessitano delle massime prestazioni di intelligenza artificiale dell'H100. A circa un terzo del costo di un H100, l'L40S offre prestazioni di inferenza rispettabili, offrendo al contempo funzionalità grafiche che aggiungono un'enorme versatilità alle implementazioni dei data center. Per molte organizzazioni, questa combinazione di convenienza e versatilità rende l'L40S una scelta più pratica rispetto all'investimento in soluzioni di intelligenza artificiale e grafica separate.
Classifica: L40S si conferma la migliore GPU per inferenza mainstream ancora disponibile nella nostra classifica delle migliori GPU aziendali , basata sui risultati ottenuti con vLLM.


 Amazon