

Ad agosto, NVIDIA ha suddiviso la sua offerta desktop Blackwell di punta in due categorie per i professionisti: Workstation e Server. La scheda RTX PRO 6000 Workstation è progettata per creatori, ingegneri e sviluppatori di intelligenza artificiale che richiedono la massima potenza di calcolo e VRAM in un telaio tower o desktop. La RTX PRO 6000 Blackwell Server Edition è progettata per server rack e nodi di inferenza o rendering headless nei data center. Ora che abbiamo la scheda workstation sul banco di prova, possiamo concentrarci su quella per questa recensione.
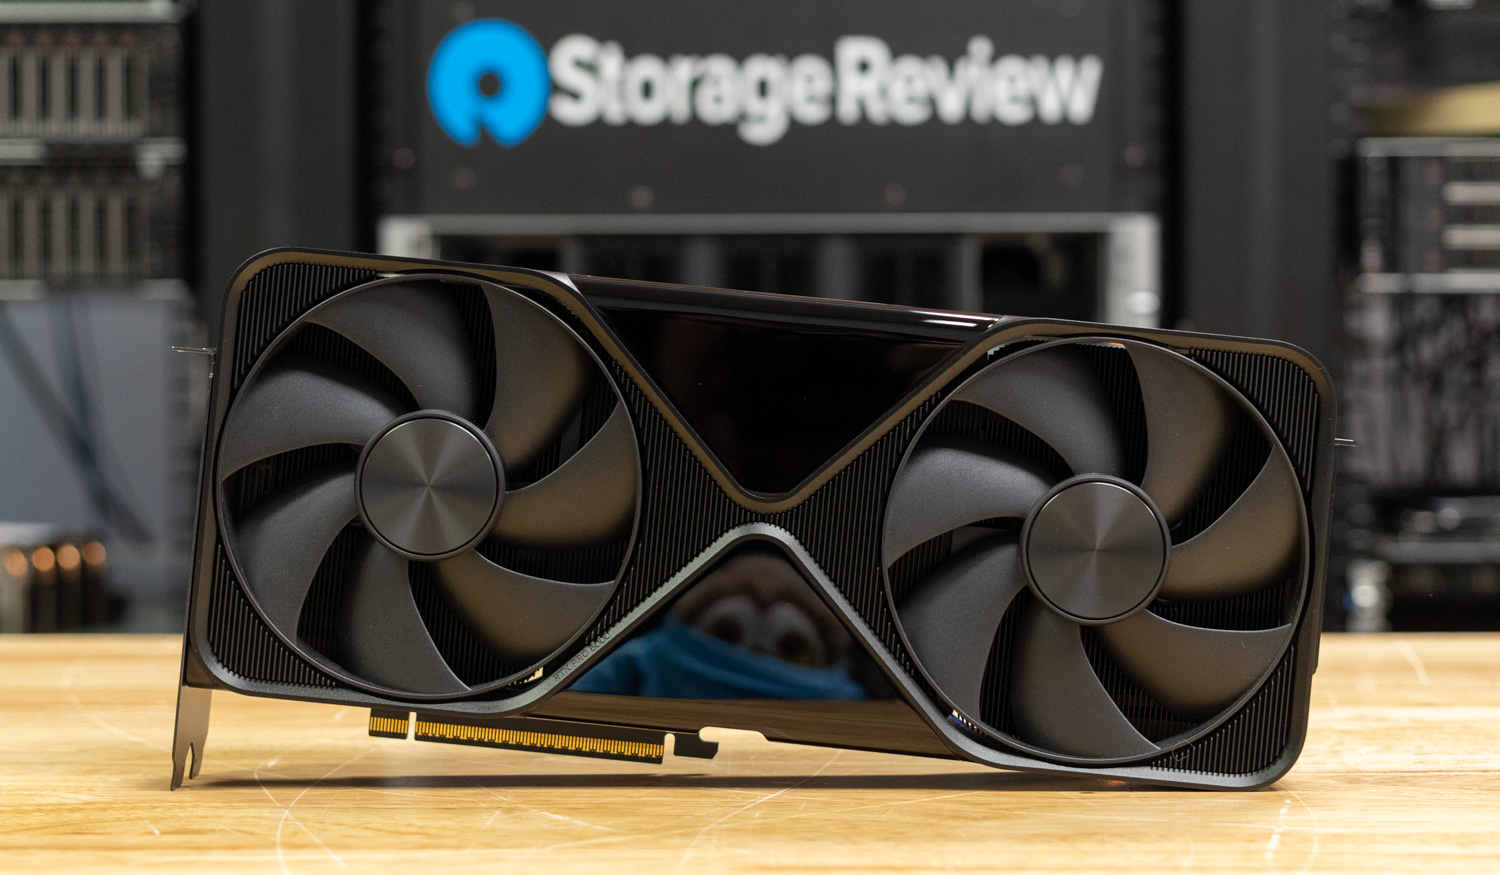
A 8,500 dollari, la RTX PRO 6000 porta sulla scrivania un GB202 completo con 24,064 core CUDA, 752 Tensor Core di quinta generazione, 188 RT Core di quarta generazione e 96 GB di GDDR7 ECC. Il fascino è immediatamente evidente. Offre una capacità di memoria che le schede consumer non possono eguagliare, driver professionali e un fattore di forma a doppio slot che si adatta alle workstation reali senza particolari requisiti di alimentazione o flusso d'aria.
NVIDIA posiziona questa GPU per flussi di lavoro misti. Ciò include inferenza LLM locale con contesto lungo, rendering di scene di grandi dimensioni, simulazione complessa e piattaforme di ricerca multi-GPU. Anche in questo caso, gli aspetti pratici sono importanti. La scheda utilizza un'interfaccia PCIe 5.0 x16 standard, offre quattro uscite DisplayPort 2.1b per una visualizzazione ad alta risoluzione e alta frequenza di aggiornamento e offre un TDP configurabile di 600 W, consentendo agli integratori di ottimizzare le prestazioni termiche, acustiche o di densità.
Il nostro obiettivo è valutare le prestazioni di questa versione workstation in laboratorio per quanto riguarda l'intelligenza artificiale, il rendering e l'elaborazione generale, e quantificare l'impatto del pool da 96 GB sulle capacità di un singolo nodo desktop.
NVIDIA RTX PRO 6000 Workstation vs. Server Edition
Le varianti RTX PRO 6000 partono dalla stessa base Blackwell GB202, quindi le capacità matematiche grezze sembrano familiari sulla carta. La differenza sta nel come e nel luogo in cui sono destinate a essere installate. La scheda workstation che stiamo testando è una scheda autonoma, a doppio slot e raffreddata attivamente, con quattro uscite DisplayPort 2.1b e driver di livello studio. Si inserisce in una workstation tower o deskside, gestisce pannelli locali ed esegue app DCC e CAD certificate ISV insieme a CUDA, TensorRT e cuDNN. Se i flussi di lavoro combinano lavoro interattivo con viewport, visualizzazione locale e intelligenza artificiale integrata, questa è la soluzione che mantiene tutto in un unico chassis con acustica e temperature prevedibili.
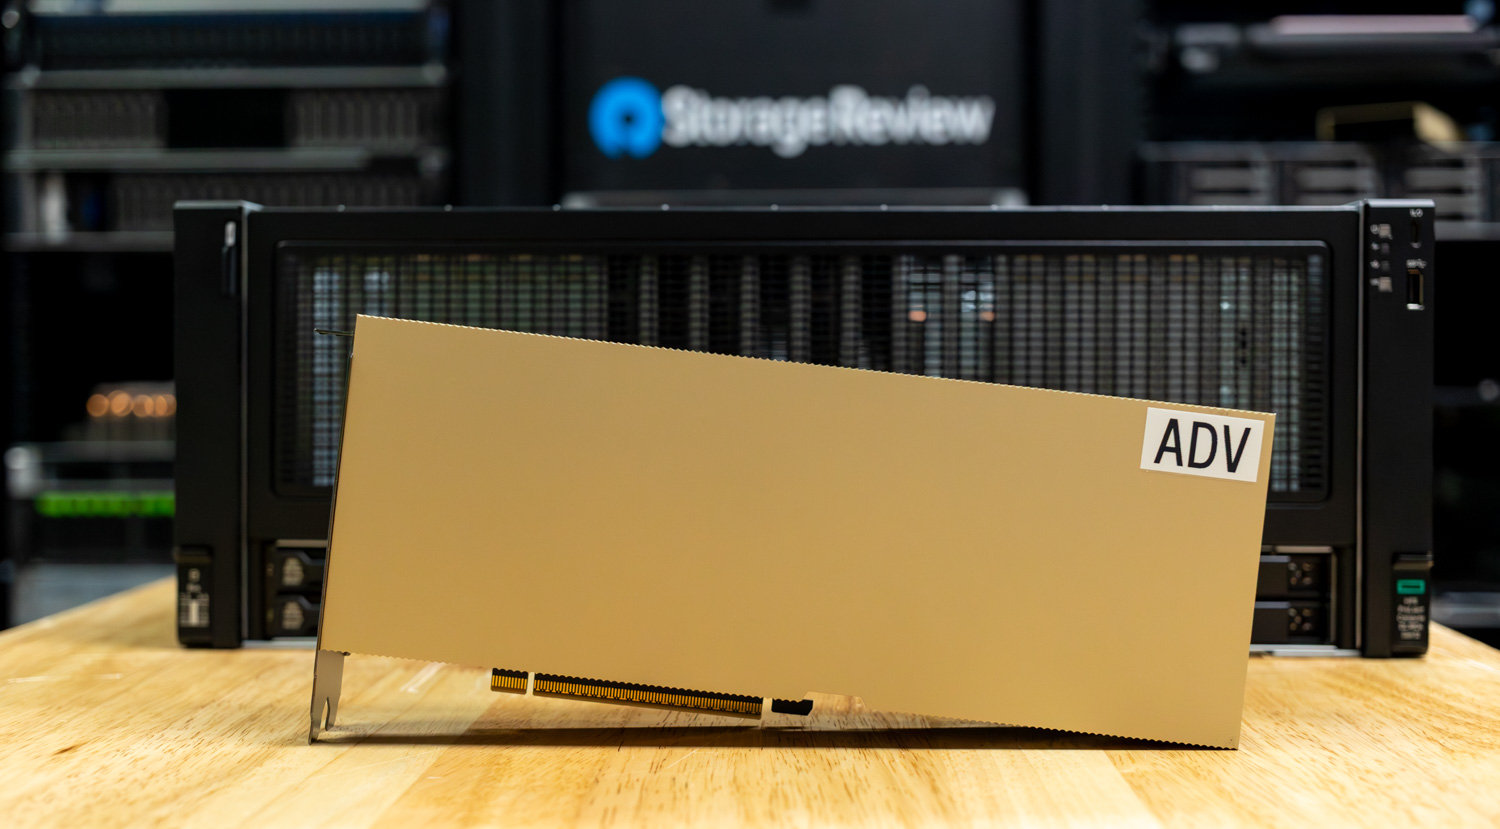
La RTX PRO 6000 Blackwell Server Edition è progettata per uno scopo nettamente diverso. Si tratta di una configurazione senza monitor, pensata per l'installazione in rack, destinata ai server, con flusso d'aria frontale-posteriore e funzionalità di gestione remota. Non sono presenti uscite video attive, poiché i processi vengono pianificati in rete e i risultati vengono elaborati da remoto. Il firmware, l'alimentazione e i profili termici sono ottimizzati per un funzionamento continuo 24 ore su 24, 7 giorni su 7, tramite uno scheduler, in genere abbinato a NVIDIA AI Enterprise, all'orchestrazione dei container e al passthrough dell'hypervisor. In breve, il modello workstation è la scelta ideale quando creatori e ingegneri hanno bisogno di visualizzare e manipolare il lavoro localmente, eseguendo al contempo grandi batch di inferenza o simulazione. La versione server è più adatta quando si scalano nodi identici in coda in un data center, dove ogni watt, cavo e percorso di flusso d'aria deve rientrare in un piano di assistenza OEM.
Specifiche NVIDIA RTX PRO 6000
La tabella seguente illustra le specifiche della NVIDIA RTX PRO 6000 rispetto alla RTX 5090 e alla precedente generazione di Ada Lovelace, la RTX 4090.
| Confronto GPU | NVIDIA RTX PRO 6000 | NVIDIA RTX 5090 | NVIDIA RTX 4090 |
| Nome GPU | GB202 | GB202 | AD102 |
| Architettura | Nerowell 2.0 | Nerowell 2.0 | Ada Lovelace |
| Dimensione del processo | 5 nm | 5 nm | 5 nm |
| Transistor | 92,200 milioni | 92,200 milioni | 76,300 milioni |
| Densità | 122.9M/mm² | 122.9M/mm² | 125.3M/mm² |
| Die Size | 750 mm² | 750 mm² | 609 mm² |
| Larghezza della scanalatura | Doppio slot | Doppio slot | Triplo slot |
| Dimensioni | 304 mm x 137 mm x mm 40 | 304 mm x 137 mm x mm 48 | 304 mm x 137 mm x mm 61 |
| TDP | 600W | 575W | 450W |
| Uscite | 4 porte DisplayPort 2.1b | 1x HDMI 2.1b, 3x DisplayPort 2.1b | 1 HDMI 2.1, 3 DisplayPort 1.4a |
| Connettori di alimentazione | 1x 16-pin | 1x 16-pin | 1x 16-pin |
| Bus Interface | PCIe 5.0 x16 | PCIe 5.0 x16 | PCIe 4.0 x16 |
| Orologio base | 1590 MHz | 2017 MHz | 2235 MHz |
| Aumenta l'orologio | 2617 MHz | 2407 MHz | 2520 MHz |
| Orologio di memoria | 1750 MHz (28 Gbps effettivi) | 2209 MHz (28 Gbps effettivi) | 1313 MHz (21 Gbps effettivi) |
| Dimensioni memoria | 96 GB | 32 GB | 24 GB |
| Tipo di memoria | GDDR7 ECC | GDDR7 | GDDR6X |
| Memory Bus | 512 bit | 512 bit | 384 bit |
| Banda di memoria | 1.79 TB / s | 1.79 TB / s | 1.01 TB / s |
| Core CUDA | 24,064 | 21,760 | 16,384 |
| Tensor Core | 752 | 680 | 512 |
| POR | 192 | 192 | 176 |
| Conte SM | 188 | 170 | 128 |
| RT | 188 | 170 | 128 |
| L1 Cache | 128 KB (per SM) | 128 KB (per SM) | 128 KB (per SM) |
| L2 Cache | 128 MB | 88 MB | 72 MB |
| Frequenza pixel | 502.5 GPixel/s | 462.1 GPixel/s | 443.5 GPixel/s |
| Tasso di consistenza | 1,968.0 GTexel/s | 1,637 GTexel/s | 1,290 GTexel/s |
| FP16 (metà) | 126.0 TFLOP (1:1) | 104.8 TFLOP (1:1) | 82.58 TFLOP (1:1) |
| FP32 (galleggiante) | 126.0 TFLOPS | 104.8 TFLOPS | 82.58 TFLOPS |
| FP64 (doppio) | 1.968 TFLOP (1:64) | 1.637 TFLOP (1:64) | 1,290 GFLOP (1:64) |
| Prezzo di lancio (USD) | $8,500 | $1,999 | $1,599 |
Costruire e disegnare
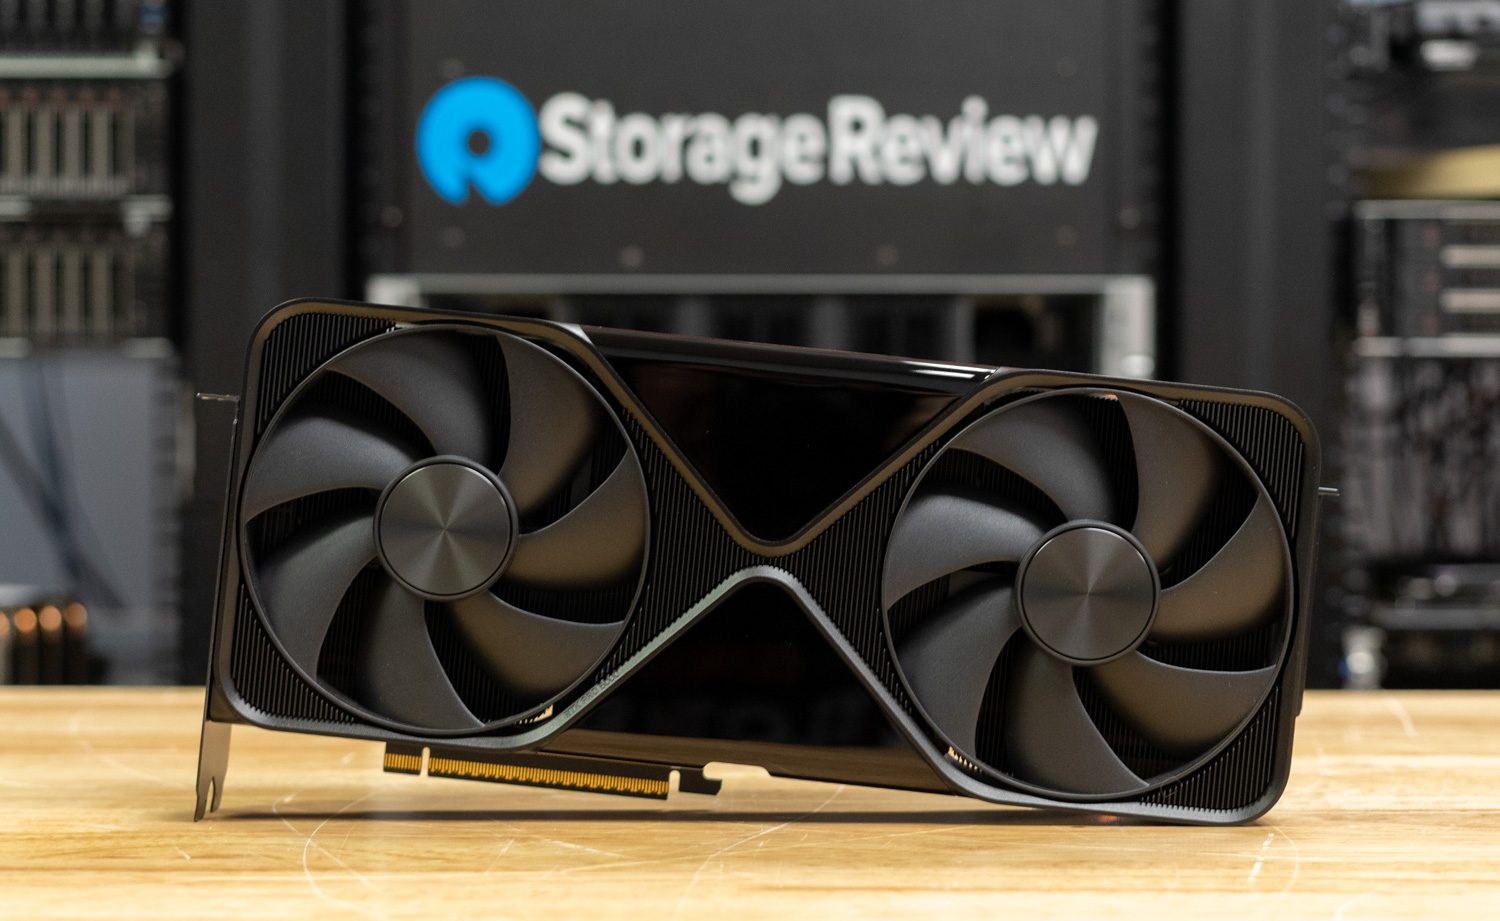
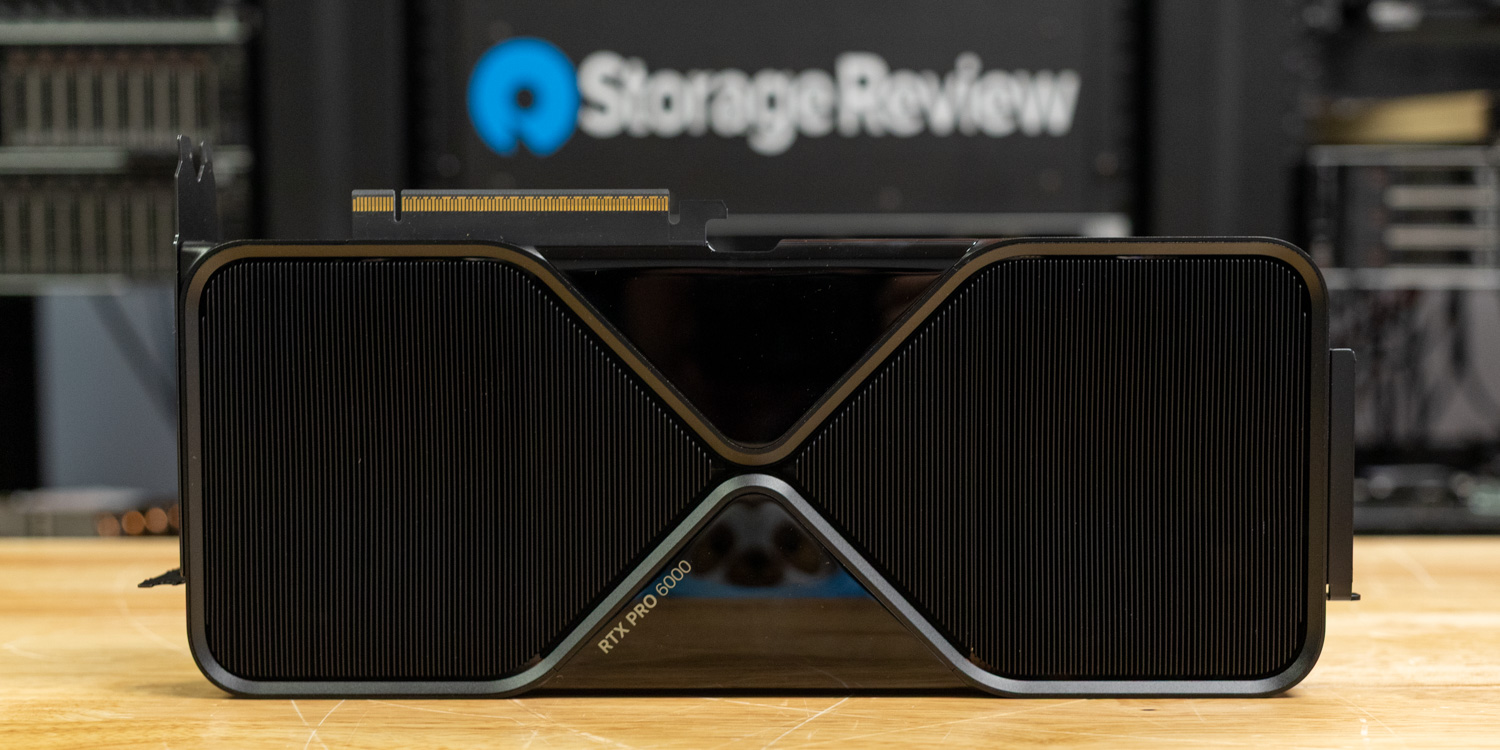
La GPU RTX PRO 6000 Workstation ripropone il design pulito e funzionale di NVIDIA, già presente sulla RTX 5090 FE, con una finitura nera opaca di tipo industriale e un layout a doppia ventola assiale ottimizzato per gli ambienti workstation. Ogni ventola è progettata per spingere il flusso d'aria attraverso la camera di vapore 3D a tutta lunghezza, contribuendo a mantenere l'equilibrio termico anche in presenza di carichi di lavoro prolungati. Con dimensioni di 304 mm × 137 mm × 40 mm, si adatta comodamente a una configurazione a doppio slot, offrendo un'eccezionale densità di prestazioni grazie al suo TDP di 600 W.
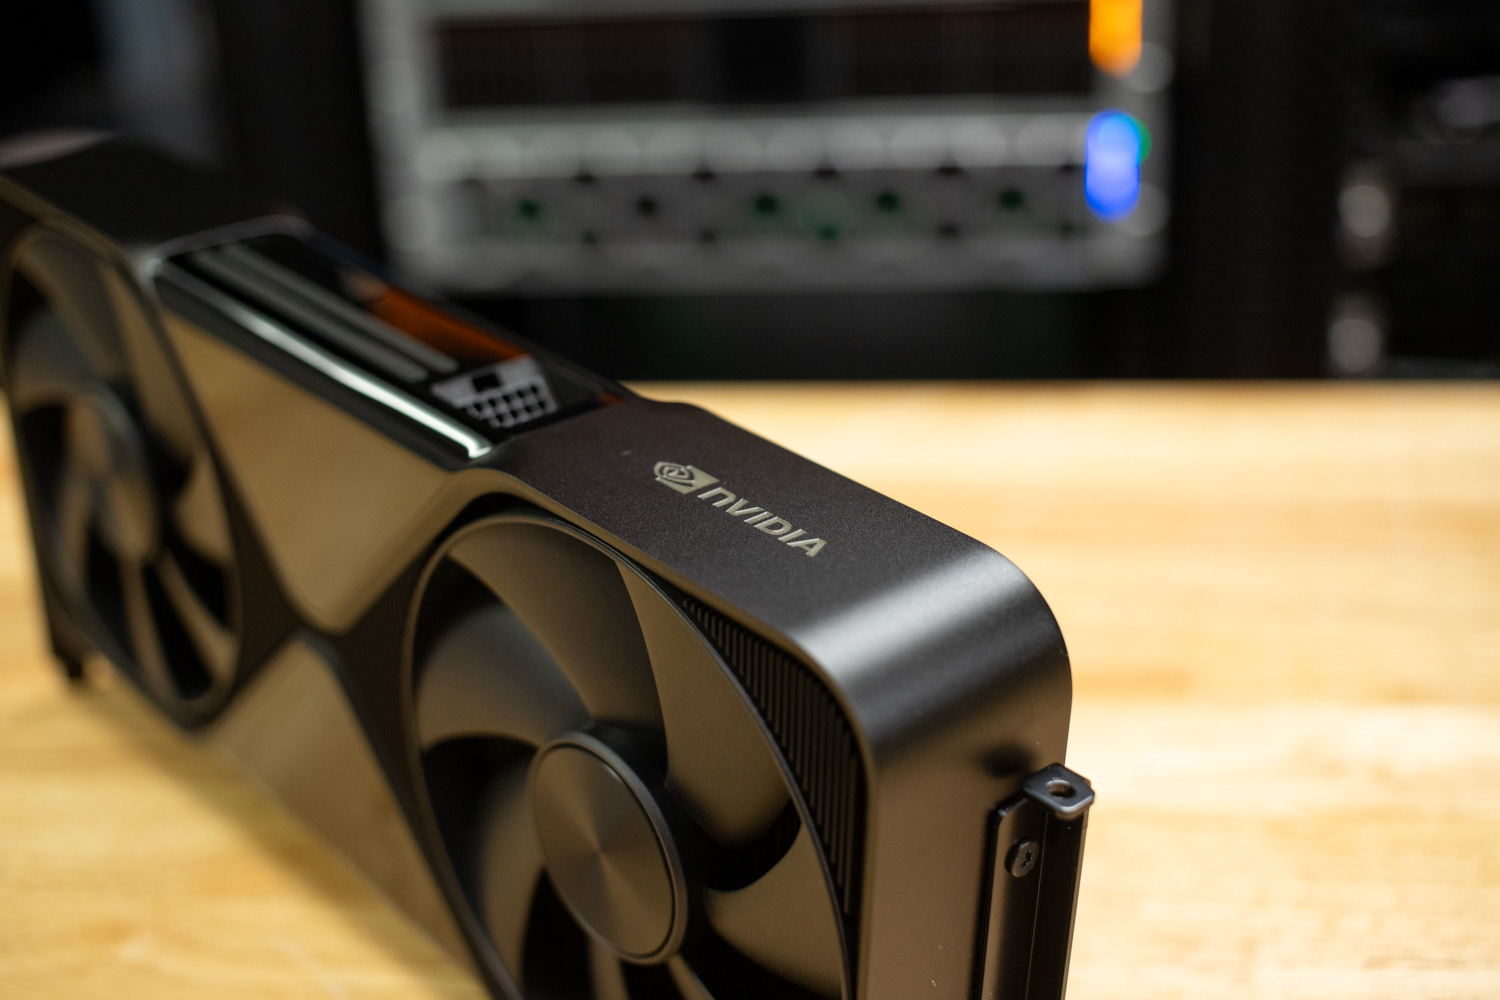
Lungo il bordo superiore, il PRO 6000 presenta un singolo connettore di alimentazione a 16 pin, che fornisce la corrente necessaria per supportare i suoi 96 GB di memoria GDDR7 e l'architettura Blackwell 2.0 completa. La qualità costruttiva è di alta qualità e rigida, con una copertura in alluminio che incanala efficacemente l'aria lungo la pila di alette. Il discreto marchio NVIDIA completa l'estetica professionale, senza RGB o fronzoli da gaming, enfatizzando l'affidabilità e le prestazioni in chassis per workstation con requisiti termici elevati.
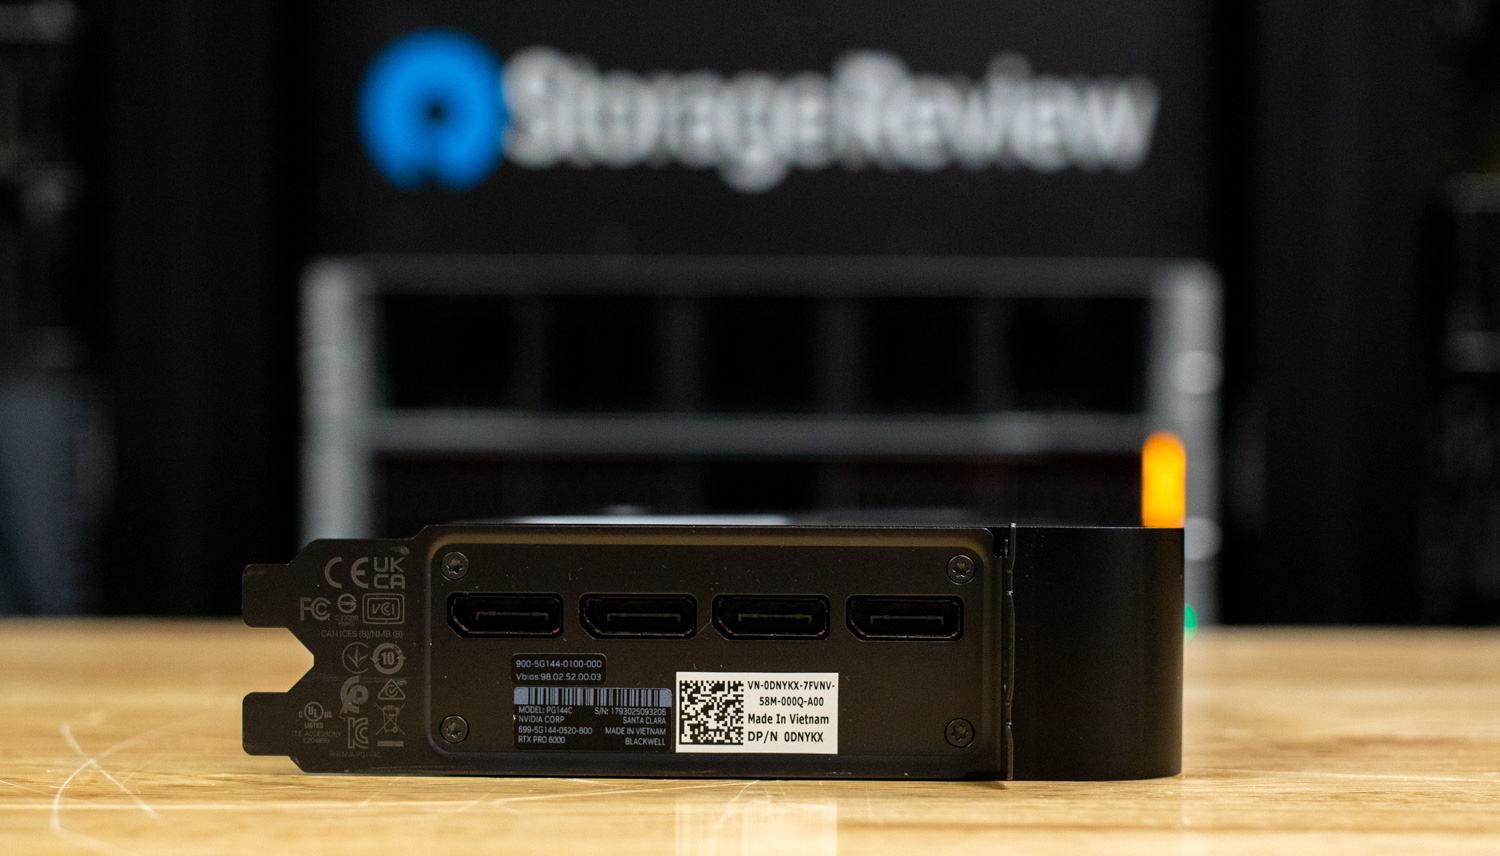
Sul lato I/O, NVIDIA offre quattro uscite DisplayPort 2.1b, garantendo la compatibilità con configurazioni 8K multi-monitor, flussi di lavoro HDR con colori accurati e ambienti di rendering avanzati. L'utilizzo di DisplayPort 2.1b su HDMI riflette il suo orientamento professionale, con una larghezza di banda migliorata per display ad alta risoluzione e ad alto refresh.
Test di Performance
Per valutare le prestazioni del nostro campione NVIDIA RTX PRO 6000, lo abbiamo confrontato direttamente con le controparti consumer di punta di NVIDIA, RTX 5090 Founders Edition e RTX 4090 Founders Edition. I test sono stati condotti su un mix di carichi di lavoro professionali e basati su intelligenza artificiale per evidenziare sia la potenza di calcolo grezza che le prestazioni delle applicazioni reali. I benchmark includevano UL Procyon AI Text Generation, UL Procyon AI Image Generation, LuxMark, Geekbench 6 e V-Ray, fornendo una panoramica equilibrata delle prestazioni di rendering, inferenza e produttività.
Oltre a questi carichi di lavoro standard, abbiamo anche eseguito test mirati progettati per mettere in mostra i 96 GB di memoria GDDR7 della RTX PRO 6000, dimostrandone i vantaggi nella gestione di modelli di grandi dimensioni, set di dati ad alta risoluzione e carichi di lavoro di visualizzazione professionale in cui la capacità e la produttività sostenuta sono fondamentali.
- RTX PRO 6000
- GeForce RTX 5090FE
- GeForce RTX 4090FE
- RTX6000ADA
Per sfruttare appieno i vantaggi della nuova NVIDIA RTX PRO 6000, abbiamo utilizzato la nostra piattaforma AMD ThreadRipper. Questo sistema, così configurato, offre una CPU a 64 core e un circuito di raffreddamento a liquido. Dispone di un'ampia potenza di calcolo per consentire alla GPU di svolgere il suo lavoro senza intoppi. La configurazione completa del sistema è elencata di seguito.
Piattaforma di test AMD ThreadRipper StorageReview
- Scheda madre: ASUS Pro WS TRX50-SAGE WIFI
- CPU: AMD Ryzen Threadripper 7980X 64-core
- RAM: 32 GB DDR5 4800 MT/s
- Memoria su disco: Samsung 2Pro da 980TB
- OS: Windows 11 Pro per workstation
UL Procyon: generazione di testo AI
Il benchmark Procyon AI Text Generation semplifica i test delle prestazioni dei modelli LLM basati sull'IA, fornendo un metodo di valutazione conciso e coerente. Consente di eseguire test ripetuti su più modelli LLM, riducendo al minimo la complessità derivante da modelli di grandi dimensioni e fattori variabili. Sviluppato in collaborazione con i leader nel settore dell'hardware per l'IA, ottimizza l'utilizzo degli acceleratori AI locali per valutazioni delle prestazioni più affidabili ed efficienti. I risultati riportati di seguito sono stati ottenuti utilizzando TensorRT.
In tutti e quattro i test sui modelli, la NVIDIA RTX PRO 6000 si è costantemente posizionata al primo posto. A partire da Phi, la PRO 6000 ha ottenuto un punteggio complessivo di 6,775, superando la RTX 5090 con 5,749, la RTX 4090 con 4,958 e la RTX 6000 Ada con 4,508. La sua maggiore velocità di generazione di token (325.9 token/s) e la minore latenza (0.182 s al primo token) sottolineano la sua reattività nella generazione di testo in tempo reale e nei carichi di lavoro AI basati su chat.
Il trend è proseguito con Mistral, dove il PRO 6000 ha totalizzato 7,346, mantenendo un margine sostanziale rispetto al 5090 (6,267), al 4090 (5,094) e al 6000 Ada (4,255). Il suo throughput di 271.8 token/s dimostra i vantaggi del suo pool di memoria più ampio da 96 GB e dell'ottimizzazione della workstation per l'inferenza ad alto contesto.
In Llama3, la PRO 6000 è rimasta in testa con un punteggio di 6,501, rispetto ai 6,104 della RTX 5090, ai 4,849 della 4090 e ai 4,026 della 6000 Ada. Questo evidenzia la coerenza dell'architettura Blackwell di NVIDIA, con la PRO 6000 che mantiene i vantaggi prestazionali man mano che i carichi di lavoro dei trasformatori aumentano in complessità e lunghezza del contesto.
Infine, in Llama2, che enfatizza l'inferenza a lungo contesto e le prestazioni sostenute, la PRO 6000 ha raggiunto 8,008, mentre le GPU 5090, 4090 e 6000 Ada sono rimaste indietro, rispettivamente con 6,591, 5,013 e 3,957. Anche con l'aumento della lunghezza delle sequenze e dei tempi di inferenza, la PRO 6000 ha mantenuto un netto predominio sia in termini di velocità che di stabilità, completando le esecuzioni più velocemente e con un throughput più fluido rispetto a qualsiasi altra GPU testata.
| UL Procyon: generazione di testo AI | NVIDIA RTX PRO 6000 | NVIDIA RTX 5090 | NVIDIA RTX 4090 | NVIDIA RTX 6000 Ada |
| Punteggio complessivo Phi | 6,775 | 5,749 | 4,958 | 4,508 |
| Tempo di output Phi per il primo token | 0.182 s | 0.244 s | 0.255 s | 0.288 s |
| Token di output Phi al secondo | 325.855 tok/s | 314.435 tok/s | 244.343 tok/s | 228.359 tok/s |
| Durata complessiva Phi | 9.498 s | 10.280 s | 12.872 s | 13.869 s |
| Punteggio complessivo Mistral | 7,346 | 6,267 | 5,094 | 4,255 |
| Tempo di output di Mistral per il primo token | 0.229 s | 0.297 s | 0.322 s | 0.419 s |
| Gettoni di output Mistral al secondo | 271.779 tok/s | 255.945 tok/s | 183.266 tok/s | 166.633 tok/s |
| Durata complessiva del Mistral | 11.493 s | 12.593 s | 17.010 s | 19.092 s |
| Punteggio complessivo di Llama3 | 6,501 | 6,104 | 4,849 | 4,026 |
| Tempo di output di Llama3 per il primo token | 0.218 s | 0.234 s | 0.259 s | 0.348 s |
| Token di output Llama3 al secondo | 226.407 tok/s | 214.285 tok/s | 150.039 tok/s | 138.620 tok/s |
| Llama3 Durata complessiva | 13.554 s | 14.304 s | 19.991 s | 22.062 s |
| Punteggio complessivo di Llama2 | 8,008 | 6,591 | 5,013 | 3,957 |
| Tempo di output di Llama2 per il primo token | 0.307 s | 0.419 s | 0.500 s | 0.679 s |
| Token di output Llama2 al secondo | 145.595 tok/s | 134.502 tok/s | 92.853 tok/s | 78.532 tok/s |
| Llama2 Durata complessiva | 20.712 s | 23.018 s | 32.448 s | 38.923 s |
Procione UL: Generazione di immagini AI
Il benchmark Procyon AI Image Generation offre un metodo coerente e preciso per misurare le prestazioni dell'inferenza AI su diverse configurazioni hardware, dalle NPU a basso consumo alle GPU di fascia alta. Include tre test: Stable Diffusion XL (FP16) per GPU di fascia alta, Stable Diffusion 1.5 (FP16) per GPU di potenza media e Stable Diffusion 1.5 (INT8) per dispositivi a basso consumo. Il benchmark utilizza il motore di inferenza ottimale per ciascun sistema, garantendo risultati equi e comparabili.
A partire da Stable Diffusion 1.5 (FP16), la NVIDIA RTX PRO 6000 ha ottenuto un punteggio complessivo di 8,869, superando la RTX 5090 (8,193), la RTX 4090 (5,260) e la RTX 6000 Ada (4,230). La PRO 6000 ha completato la generazione dell'immagine in 11.27 secondi, con una media di 0.705 secondi per immagine, risultando la più veloce in questo test. Ciò dimostra come la sua messa a punto ottimizzata per workstation e i 96 GB di memoria GDDR7 consentano un output costante e ad alta precisione senza compromettere l'efficienza.
Nel test Stable Diffusion 1.5 (INT8), che misura le prestazioni di inferenza quantizzata leggera, tutte le GPU hanno ottenuto risultati simili. La PRO 6000 ha ottenuto un punteggio di 79,064, quasi identico ai 79,272 della RTX 5090, superando la RTX 4090 (62,160) e la RTX 6000 Ada (55,901). Poiché i carichi di lavoro INT8 dipendono meno dalla larghezza di banda e dalla capacità della memoria, le differenze sono state minime, ma la PRO 6000 ha mantenuto risultati costanti con un tempo medio di generazione di 0.395 secondi per immagine.
Il test Stable Diffusion XL (FP16) sottopone le GPU a sessioni di inferenza più lunghe e impegnative, che mettono a dura prova sia la memoria che il throughput di elaborazione sostenuto. In questo caso, la PRO 6000 ha ottenuto un punteggio complessivo di 6,991, posizionandosi subito dietro ai 7,179 della RTX 5090, ma ben al di sopra dei 5,025 della RTX 4090 e dei 3,043 della RTX 6000 Ada. Ha mantenuto un tempo di rendering totale di 85.8 secondi, ovvero 5.36 secondi per immagine, dimostrando che la PRO 6000 gestisce i carichi di lavoro di generazione estesa in modo efficiente e senza rallentamenti.
| UL Procyon: generazione di immagini AI | NVIDIA RTX PRO 6000 | NVIDIA RTX 5090 | NVIDIA RTX 4090 | NVIDIA RTX 6000 Ada |
| Diffusione stabile 1.5 (FP16) – Punteggio complessivo | 8,869 | 8,193 | 5,260 | 4,230 |
| Diffusione stabile 1.5 (FP16) – Tempo complessivo | 11.274 s | 12.204 s | 19.011 s | 23.639 s |
| Diffusione stabile 1.5 (FP16) – Velocità di generazione delle immagini | 0.705 s/immagine | 0.763 s/immagine | 1.188 s/immagine | 1.477 s/immagine |
| Diffusione stabile 1.5 (INT8) – Punteggio complessivo | 79,064 | 79,272 | 62,160 | 55,901 |
| Diffusione stabile 1.5 (INT8) – Tempo complessivo | 3.162 s | 3.154 s | 4.022 s | 4.472 s |
| Diffusione stabile 1.5 (INT8) – Velocità di generazione delle immagini | 0.395 s/immagine | 0.394 s/immagine | 0.503 s/immagine | 0.559 s/immagine |
| Stable Diffusion XL (FP16) – Punteggio complessivo | 6,991 | 7,179 | 5,025 | 3,043 |
| Diffusione stabile XL (FP16) – Tempo complessivo | 85.819 s | 83.573 s | 119.379 s | 197.172 s |
| Stable Diffusion XL (FP16) – Velocità di generazione delle immagini | 5.364 s/immagine | 5.223 s/immagine | 7.461 s/immagine | 12.323 s/immagine |
Blender 4.4
Blender è un'applicazione open source per la modellazione 3D. Questo benchmark è stato eseguito utilizzando l'utility Blender Benchmark. Il punteggio è misurato in campioni al minuto, con valori più alti che indicano prestazioni migliori.
In tutte e tre le scene, la NVIDIA RTX PRO 6000 si è aggiudicata la prima posizione, mettendo in mostra i vantaggi della sua architettura Blackwell e della maggiore capacità di memoria. Nella scena Monster, la PRO 6000 ha ottenuto 7,870.17 campioni al minuto, davanti alla RTX 5090 con 7,421.50, mentre la RTX 4090 e la RTX 6000 Ada hanno seguito rispettivamente con 5,733.97 e 5,632.60.
Nella scena Junkshop, la PRO 6000 ha mantenuto la leadership con 4,158.91 campioni al minuto, rispetto ai 3,980.15 della RTX 5090, ai 2,827.83 della RTX 4090 e ai 2,663.77 della RTX 6000 Ada. Infine, nella scena Classroom, che tende a mettere in risalto sia lo shading che l'efficienza della memoria, la PRO 6000 ha raggiunto 4,041.11 campioni al minuto, ancora una volta davanti ai 3,732.63 della RTX 5090 e superando significativamente la RTX 4090 e la RTX 6000 Ada, rispettivamente a 2,909.35 e 2,818.83.
| Blender 4.4 (più alto è meglio) | NVIDIA RTX PRO 6000 | NVIDIA RTX 5090 | NVIDIA RTX 4090 | NVIDIA RTX 6000 Ada |
| Mostro - Monster | 7,870.17 | 7,421.50 | 5,733.97 | 5,632.60 |
| Rigattiere | 4,158.91 | 3,980.15 | 2,827.83 | 2,663.77 |
| Aula | 4,041.11 | 3,732.63 | 2,909.35 | 2,818.83 |
Luxmark
Luxmark è un benchmark GPU che utilizza LuxRender, un motore di rendering open source per il ray-tracing, per valutare le prestazioni di un sistema nella gestione di scene 3D altamente dettagliate. Questo benchmark è particolarmente rilevante per valutare le capacità di rendering grafico di server e workstation, soprattutto nelle applicazioni di effetti visivi e visualizzazione architettonica, dove un'accurata simulazione della luce è fondamentale.
Nel test sulla scena Food, la NVIDIA RTX PRO 6000 ha ottenuto un punteggio di 24,287, superando la RTX 5090 con 23,141, mentre la RTX 4090 e la RTX 6000 Ada hanno ottenuto rispettivamente 17,171 e 14,873. Questo dimostra come la PRO 6000 mantenga prestazioni di ray tracing fluide su carichi di lavoro con geometrie e illuminazione altamente dettagliati, senza perdite di stabilità o throttling termico.
Nella scena Hall più impegnativa, che sottolinea la geometria su larga scala e l'illuminazione globale complessa, il PRO 6000 si è nuovamente assicurato il risultato migliore con 52,588, di poco davanti ai 51,725 dell'RTX 5090 e ben al di sopra dell'RTX 4090 (38,887) e dell'RTX 6000 Ada (32,132).
| Luxmark (più alto è meglio) | NVIDIA RTX PRO 6000 | NVIDIA RTX 5090 | NVIDIA RTX 4090 | NVIDIA RTX 6000 Ada |
| Punteggio cibo | 24,287 | 23,141 | 17,171 | 14,873 |
| Punteggio Hall | 52,588 | 51,725 | 38,887 | 32,132 |
Geekbench 6
Geekbench 6 è un benchmark multipiattaforma che misura le prestazioni complessive del sistema. Il Geekbench Browser consente di confrontare qualsiasi sistema con i risultati ottenuti.
In questo test, la NVIDIA RTX PRO 6000 ha ottenuto un punteggio GPU OpenCL di 384,158, superando la RTX 5090 (374,807), la RTX 4090 (333,384) e la RTX 6000 Ada (336,882). Il punteggio più alto della PRO 6000 riflette il design ottimizzato della workstation, la maggiore larghezza di banda di memoria e lo stack di driver professionali, che insieme consentono prestazioni costanti su un'ampia gamma di carichi di lavoro ad alta intensità di calcolo.
| Geekbench (più alto è, meglio è) | NVIDIA RTX PRO 6000 | NVIDIA RTX 5090 | NVIDIA RTX 4090 | NVIDIA RTX 6000 Ada |
| Punteggio GPU OpenCL | 384,158 | 374,807 | 333,384 | 336,882 |
V-Ray
Il benchmark V-Ray misura le prestazioni di rendering di CPU, GPU NVIDIA o entrambe, utilizzando i motori avanzati V-Ray 6. Si avvale di test rapidi e di un semplice sistema di punteggio per consentire agli utenti di valutare e confrontare le capacità di rendering dei propri sistemi. È uno strumento essenziale per i professionisti che desiderano ottenere informazioni precise sulle prestazioni.
Nei nostri test, la NVIDIA RTX PRO 6000 ha totalizzato 12,128 vpath, posizionandosi tra la RTX 5090, che ha ottenuto un punteggio di 14,764, e la RTX 4090, che ha ottenuto un punteggio di 10,847. La RTX 6000 Ada è rimasta leggermente indietro, con 10,766. Mentre la RTX 5090 ha mantenuto un leggero vantaggio in questo test di rendering ad alta intensità di GPU, la PRO 6000 ha dimostrato prestazioni elevate e costanti, rafforzando la sua messa a punto orientata alle workstation e l'efficienza sostenuta sotto carichi di rendering completi.
| V-Ray (più alto è meglio) | NVIDIA RTX PRO 6000 | NVIDIA RTX 5090 | NVIDIA RTX 4090 | NVIDIA RTX 6000 Ada |
| percorsi verticali | 12,128 | 14,764 | 10,847 | 10,766 |
Test di inferenza multi-modello LM Studio
Per questa fase di test, abbiamo utilizzato LM Studio per valutare le prestazioni della NVIDIA RTX PRO 6000 su una gamma di modelli di linguaggio di grandi dimensioni più diffusi, tra cui GPT-OSS 120B, Gemma 3 (4B, 12B e 27B), Llama 3.1 (8B e 70B) e Llama 3.3 70B. A ciascun modello è stata fornita la stessa istruzione:
“Scrivi un articolo accademico di 500 parole sulla storia dei bradipi.”
L'attenzione principale di questo test è rivolta ai token al secondo (throughput) e al tempo totale (durata del completamento), che insieme evidenziano l'efficienza con cui l'RTX PRO 6000 gestisce diverse dimensioni e complessità del modello in condizioni di generazione identiche.
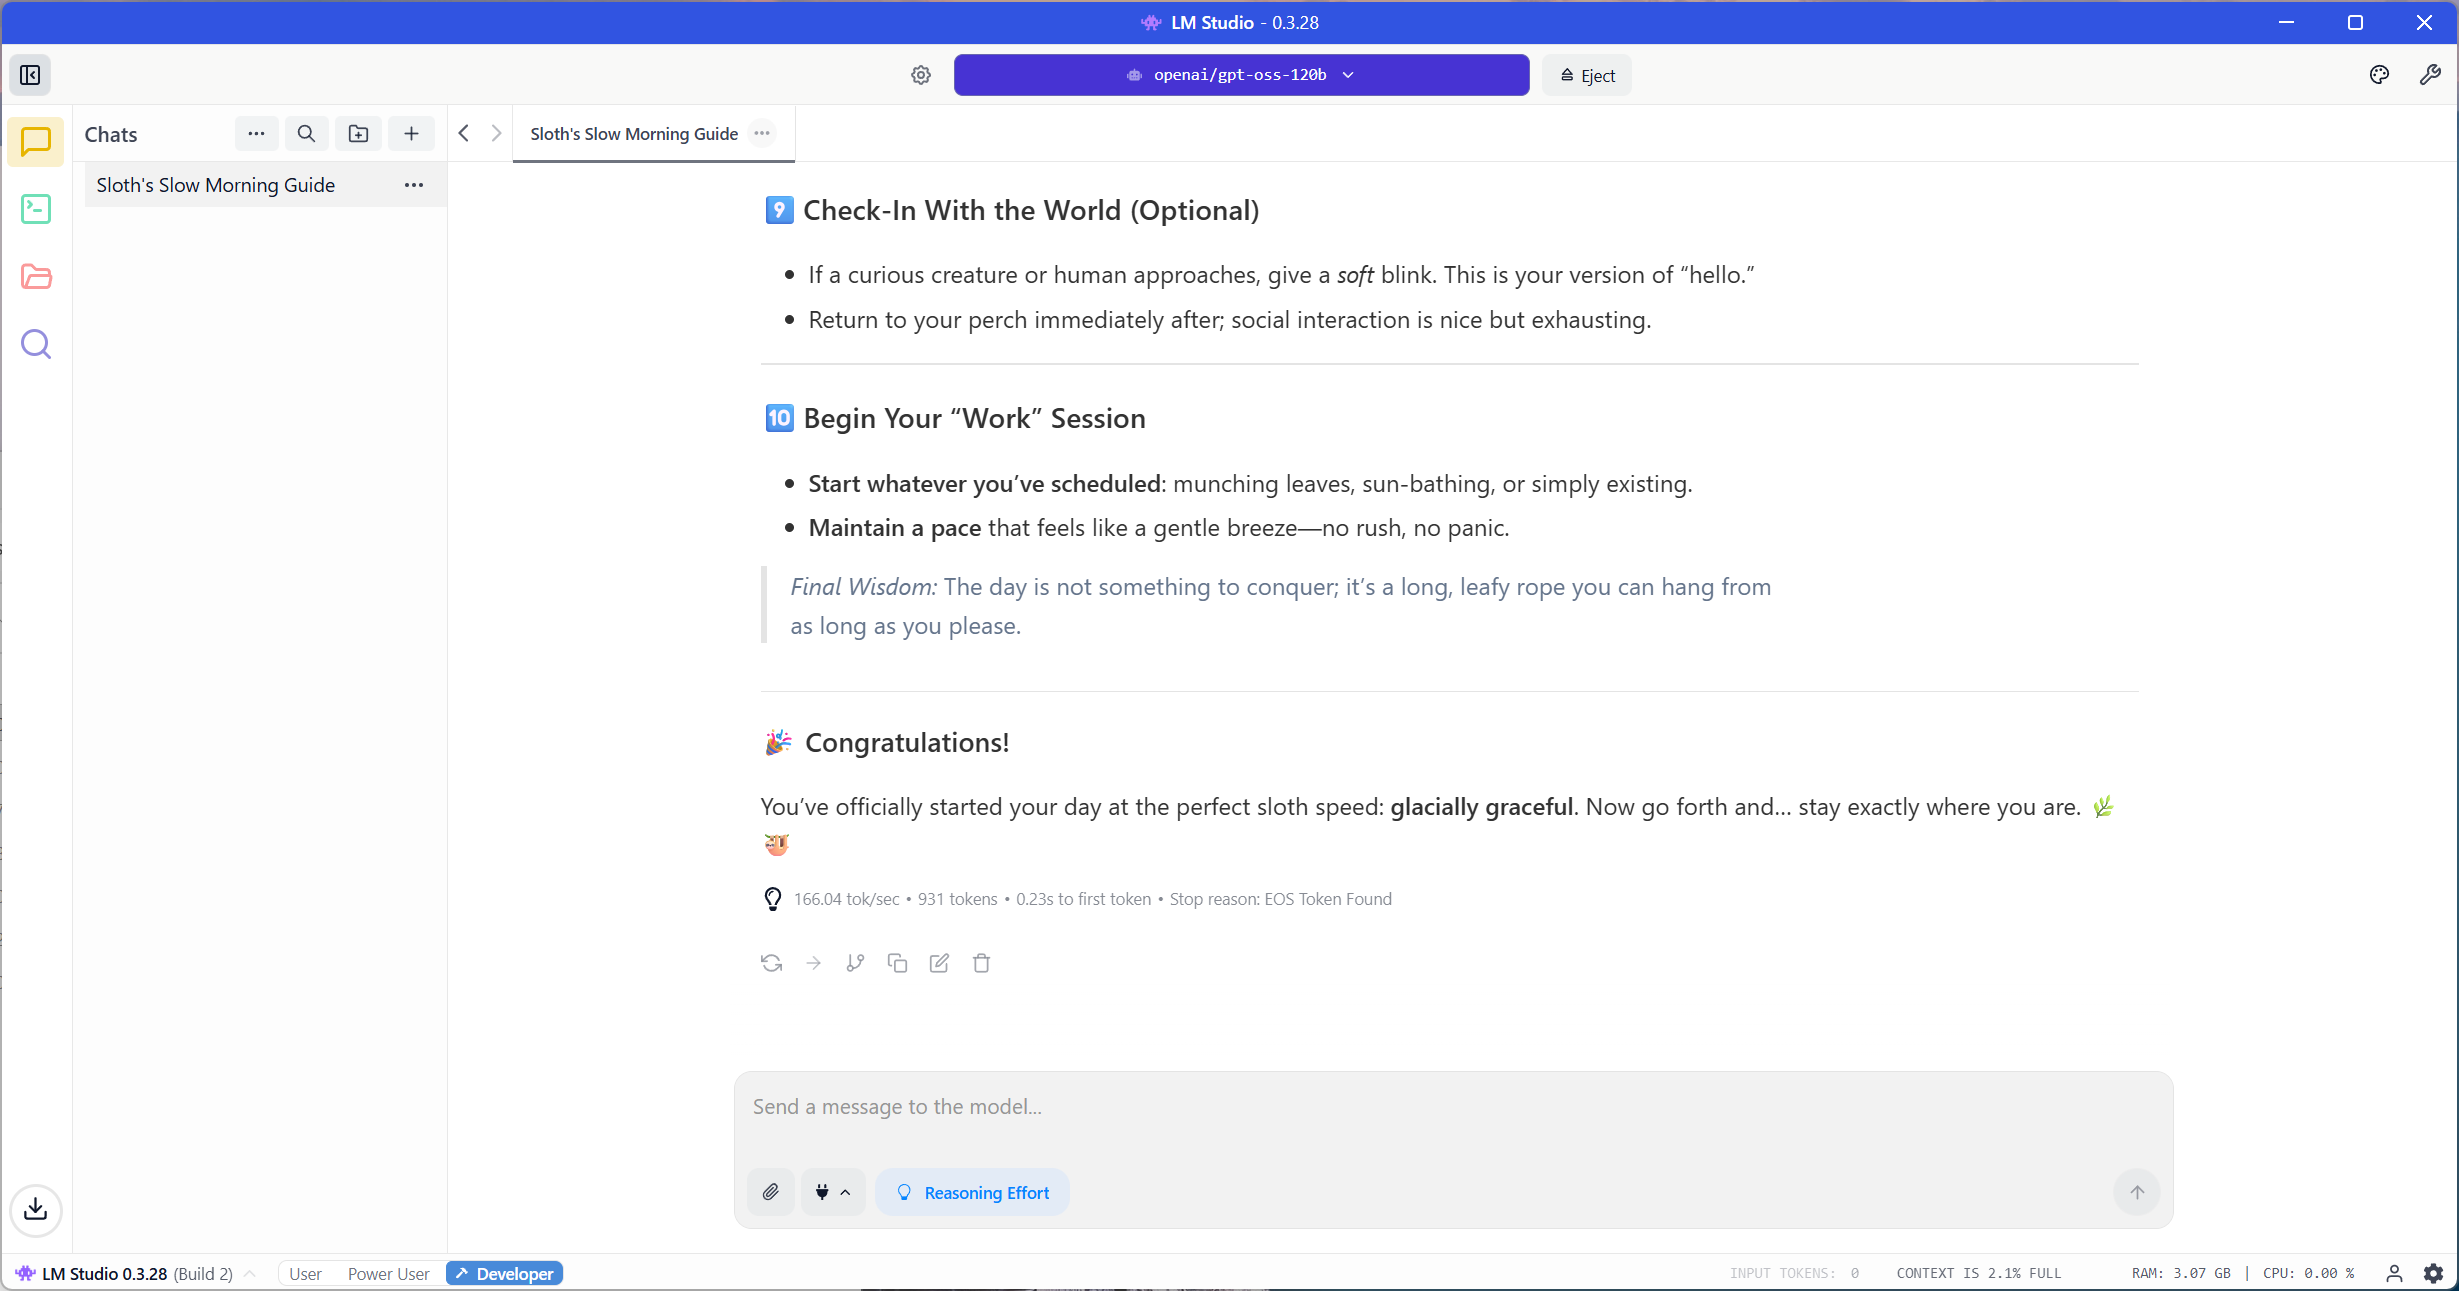
Nei test di inferenza di LM Studio, la NVIDIA RTX PRO 6000 ha dimostrato prestazioni e scalabilità eccellenti su un'ampia gamma di dimensioni di modelli, dai modelli più piccoli con parametri 4B alle configurazioni più imponenti di classe 120B.
Il momento clou di questo test è stato l'OpenAI GPT-OSS 120B, in cui la RTX PRO 6000 ha prodotto 163.1 token al secondo e ha completato la generazione di 500 parole in 9.54 secondi. Questo risultato è notevole perché schede come la RTX 5090 non possono caricare o eseguire un modello da 120B e spesso non riescono a gestire nemmeno i modelli da 70B a causa della VRAM limitata. I 96 GB di memoria GDDR7 della PRO 6000 le consentono di elaborare localmente questi enormi modelli, rendendola unica tra le GPU per workstation.
Per i modelli più piccoli, Gemma 3.4 B ha raggiunto il throughput più elevato, completando l'attività a 226.7 token al secondo in 3.51 secondi. Llama 3.1 8B Instruct ha seguito a breve distanza, con 197.1 token al secondo e un tempo totale di 4.17 secondi. Queste esecuzioni dimostrano l'elevata efficienza e la rapida risposta del PRO 6000 nei carichi di lavoro di inferenza di fascia media.
Nella fascia alta, i modelli Llama 3.1 70B Instruct e Llama 3.3 70B hanno prodotto in media circa 31.8 token al secondo, con tempi di generazione totali di 27.2 secondi e 25.3 secondi, mostrando un output costante nonostante le loro grandi dimensioni.
Nel complesso, la RTX PRO 6000 offre stabilità, throughput e capacità eccezionali nell'esecuzione di modelli su larga scala. La sua capacità di memoria di 96 GB le consente di gestire carichi di lavoro che superano i limiti delle GPU consumer, rendendola una scelta eccellente per sviluppatori, ricercatori e professionisti che necessitano di prestazioni locali affidabili per l'intelligenza artificiale avanzata e lo sviluppo di modelli generativi.
| LM Studio (risultati dell'inferenza del modello) | |||||||||
|---|---|---|---|---|---|---|---|---|---|
| Nome del modello | Token / Sec | Tempo per il primo token (s) | Tempo totale (s) | Token di richiesta | Token previsti | Token totali | |||
| OpenAI GPT-OSS 120B | 163.15 | 0.193 | 9.543 | 81 | 1,557 | 1,638 | |||
| Gemma3B | 226.73 | 0.113 | 3.51 | 25 | 796 | 821 | |||
| Gemma3B | 117.15 | 0.068 | 8.06 | 25 | 944 | 969 | |||
| Gemma3B | 68.06 | 0.221 | 12.048 | 25 | 820 | 845 | |||
| Meta Llama 3.1 8B Istruzione | 197.07 | 0.062 | 4.171 | 49 | 822 | 871 | |||
| Meta Llama 3.1 70B Istruzione | 31.84 | 0.159 | 27.227 | 49 | 867 | 916 | |||
| Meta Llama 3.3 70B | 31.74 | 0.323 | 25.329 | 49 | 804 | 853 | |||
Consumo energetico NVIDIA RTX PRO 6000
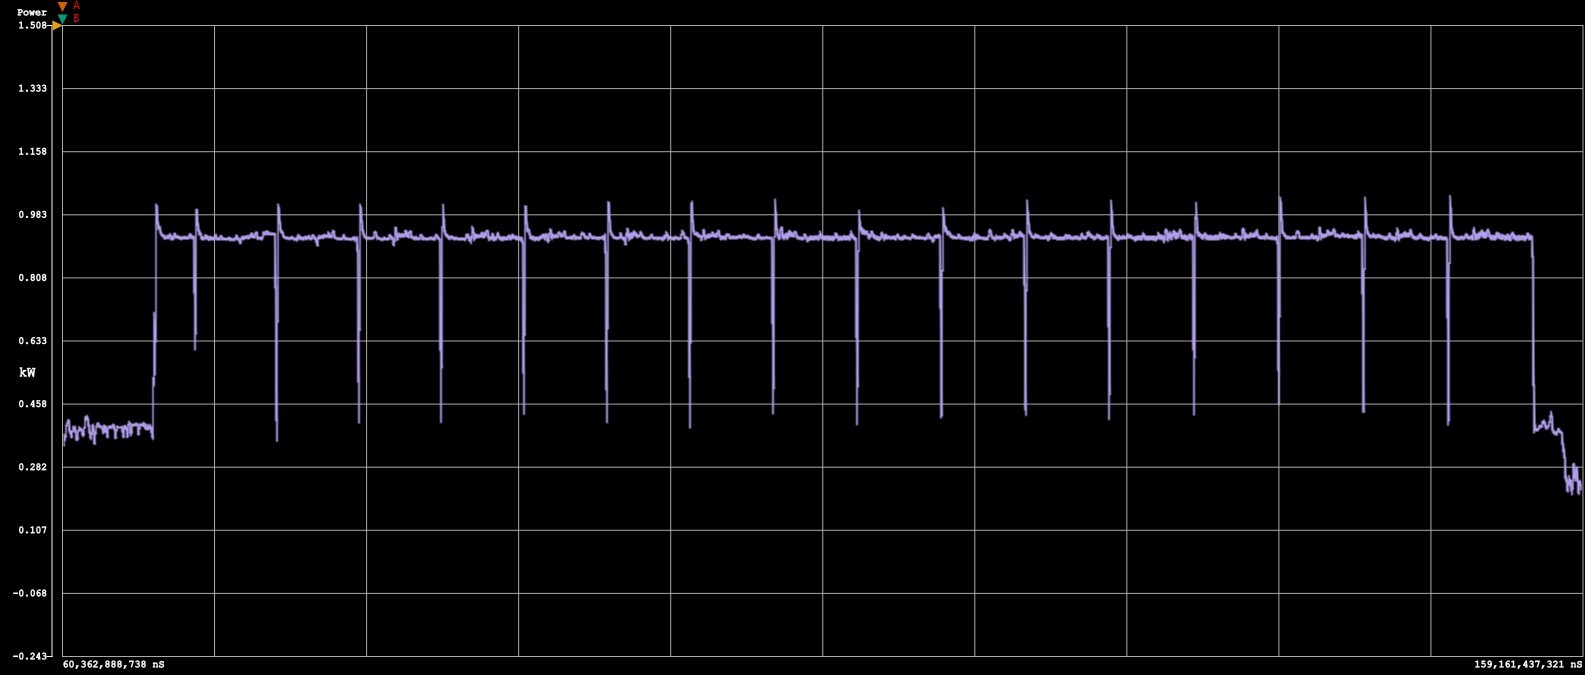
Per valutare l'efficienza reale dei carichi di lavoro di intelligenza artificiale, abbiamo utilizzato il benchmark UL Procyon AI Image Generation, in particolare il test Stable Diffusion XL FP16. Questo test si concentra sull'intervallo tra la seconda e l'ultima immagine generata, registrando il tempo necessario al completamento dell'intervallo, il consumo energetico di picco e sostenuto e il consumo energetico del sistema inattivo dopo il completamento.
Durante i nostri test, la RTX PRO 6000 ha mantenuto un consumo medio di sistema di 918.5 W sotto carico sostenuto, con un picco di 1,036.3 W, con un consumo inattivo che si è attestato a 152.3 W una volta completato il carico di lavoro. L'intervallo di test completo è durato 5.3 secondi, consumando un totale di 1.35 Wh di energia. Questi risultati mostrano un'eccellente efficienza energetica per una GPU di classe workstation, mantenendo il consumo ben controllato e mantenendo un output elevato durante carichi di lavoro di inferenza prolungati.
Rispetto ad altre GPU, la RTX PRO 6000 si allinea molto bene alla RTX 4090 in termini di consumo energetico totale, pur mantenendo tempi di completamento più rapidi, e supera significativamente la RTX 6000 Ada sia in termini di efficienza energetica che di velocità. È interessante notare che le nuove schede Blackwell, che condividono il chip GB202, presentano caratteristiche di efficienza molto simili sotto questo carico di lavoro, con solo lievi differenze nel consumo energetico totale, probabilmente dovute al TDP più elevato della PRO 6000. Ciò indica che l'ultima generazione di NVIDIA continua a perfezionare le prestazioni per watt anziché modificarle drasticamente.
| Potenza dell'immagine utilizzata Stable Diffusion XL FP16 (più bassa è, meglio è) | NVIDIA RTX PRO 6000 | NVIDIA RTX 5090 | NVIDIA RTX 4090 | NVIDIA RTX 6000 Ada |
| Consumo di energia | 1.35Wh | 1.16Wh | 1.35Wh | 1.76Wh |
| Durata del test | 5.3 secondi | 5.1 secondi | 7.3 secondi | 12.6 secondi |
Conclusione
La NVIDIA RTX PRO 6000 è, nel complesso, la GPU per workstation più performante disponibile per i flussi di lavoro professionali, offrendo prestazioni di livello data center in un formato desktop. Con un prezzo al dettaglio di circa 8,500 dollari al momento del test, si rivolge a team che richiedono affidabilità, elevata densità di elaborazione e un'ampia riserva di memoria ECC per il lavoro di produzione. Con 24,064 core CUDA, 752 Tensor Core, 96 GB di GDDR7 ECC e architettura Blackwell, gestisce carichi di lavoro che superano i limiti pratici di schede consumer come la GeForce RTX 5090 o 4090. I singoli benchmark possono mostrare una scheda consumer superiore in termini di velocità pura, ma nel complesso, considerando capacità, stabilità, driver e supporto ISV, la RTX PRO 6000 è la soluzione più adatta per l'uso professionale.
Per AI e ML, il pool da 96 GB è la soluzione migliore. Consente inferenze di contesto prolungate e checkpoint molto grandi in locale, come abbiamo dimostrato eseguendo modelli di classe da 70B a 120B mantenendo al contempo un elevato numero di token al secondo. Anche il rendering e la simulazione beneficiano della maggiore larghezza di banda della cache L2 e della memoria, offrendo prestazioni prevedibili e costanti in Blender, V-Ray e LuxMark anche sotto carichi prolungati.
La scheda è adatta a workstation reali. Presenta un design a doppio slot con interfaccia PCIe 5.0 x16, quattro uscite DisplayPort 2.1b e un singolo ingresso di alimentazione a 16 pin. È necessario prevedere un alimentatore di qualità e un flusso d'aria adeguato per supportare la potenza della scheda da 600 W. Anche la gestione multi-GPU è semplice, con supporto OEM e ISV per 2-8 GPU su stack di intelligenza artificiale, rendering e calcolo.
Se il tuo lavoro prevede LLM di contesto lunghi, scene molto grandi o simulazioni ad alta precisione su un singolo nodo, la RTX PRO 6000 giustifica il suo prezzo premium con capacità e coerenza che altre schede non possono eguagliare.


 Amazon