

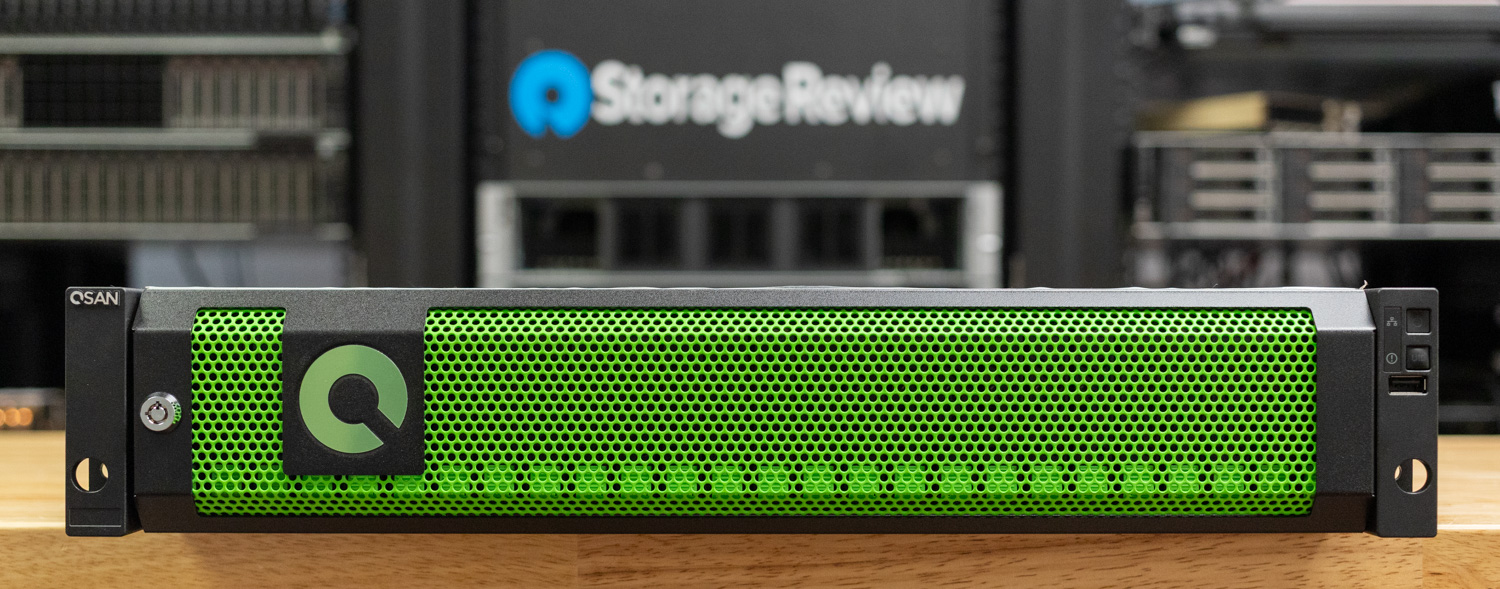
QSAN sviluppa soluzioni di storage aziendale dal 2004 e questa esperienza è evidente nella linea XN4. L'XN4226D nel nostro laboratorio è un array 2U, 26 bay, completamente NVMe con doppi controller attivi, che offre elevata disponibilità come storage unificato a blocchi e file. Il software QSM 4 aggiunge i servizi dati previsti, tra cui snapshot, opzioni di replica, riduzione dei dati e un'esperienza di gestione intuitiva. L'XN4 è progettato per i team che cercano la velocità NVMe senza compromettere la flessibilità multiprotocollo, il tutto a un prezzo molto accessibile.
Punti chiave
- Blocco e file unificati con HA reale. I controller attivi doppi e QSM 4 garantiscono elevata disponibilità con un'unica piattaforma per blocchi e file.
- NVMe-oF fatto bene. Diffusione completa del protocollo con NVMe-oF su TCP e RDMA insieme a iSCSI, Fibre Channel, NFS, SMB, FTP e WebDAV.
- Rendimento comprovato. Abbiamo misurato fino a 21.21 GB/s su grandi letture sequenziali con TCP e 11.14 GB/s su grandi scritture sequenziali con RDMA.
- Progettato per le condutture moderne. 26 alloggiamenti completamente NVMe in 2U, gestione semplice e opzioni I/O scalabili fino a 100–200 GbE per supporti, analisi di sorveglianza, VDI, database e inferenza AI.
La piattaforma supporta NVMe-oF su TCP e RDMA, oltre a iSCSI, Fibre Channel, NFS, SMB, FTP e WebDAV. Abbiamo inoltre completato uno studio mirato su NVMe-oF confrontando il comportamento e la scalabilità di TCP e RDMA. Nei nostri test, abbiamo spinto l'unità al limite con letture sequenziali di grandi dimensioni, raggiungendo un throughput impressionante di 21.21 GB/s. Il posizionamento di questo sistema è importante tanto quanto i numeri. L'XN4226D è adatto ad ambienti misti che combinano VMware o Proxmox per VM, VDI e livelli di database, nonché servizi di file creativi, nodi di inferenza AI che richiedono percorsi NVMe prevedibili, backup di supporti e acquisizione ad alta larghezza di banda per carichi di lavoro di sorveglianza e sensori. Il QSAN XN4226D è adatto a quasi tutti i carichi di lavoro.
QSAN ha registrato una crescita significativa nella produzione multimediale, tra cui trasmissioni in diretta, opzioni di replay, miglioramento video tramite intelligenza artificiale e caching OTT/edge, nonché nell'analisi video di sorveglianza, come CCTV per smart city, rilevamento di anomalie e replay in tempo reale. Questi carichi di lavoro sono idealmente supportati da una velocità di trasmissione di 100-200 GbE.
In definitiva, il valore è immediato. Si ottiene alta disponibilità unificata, NVMe su tutto lo chassis e opzioni di I/O fino a 100 GbE o Fibre Channel a 32 Gb in base alle esigenze crescenti. Le prestazioni sono in linea con quelle di molti array di livello 1, mentre le licenze rimangono più accessibili e la copertura dei protocolli rimane ampia su NVMe-oF, iSCSI, Fibre Channel, SMB e NFS. Per le aziende che puntano a InfiniBand ma hanno limiti di budget, l'approccio Ethernet di QSAN offre una reattività prossima a quella di un IB su dispositivi standard su scala da 100 a 200 GbE.
Per i team che danno priorità ai risultati delle applicazioni nel mondo reale, la longevità, il software intuitivo e il design hardware pulito di QSAN rendono l'XN4226D un affidabile cavallo di battaglia all-flash su cui costruire.
Hardware QSAN XN4
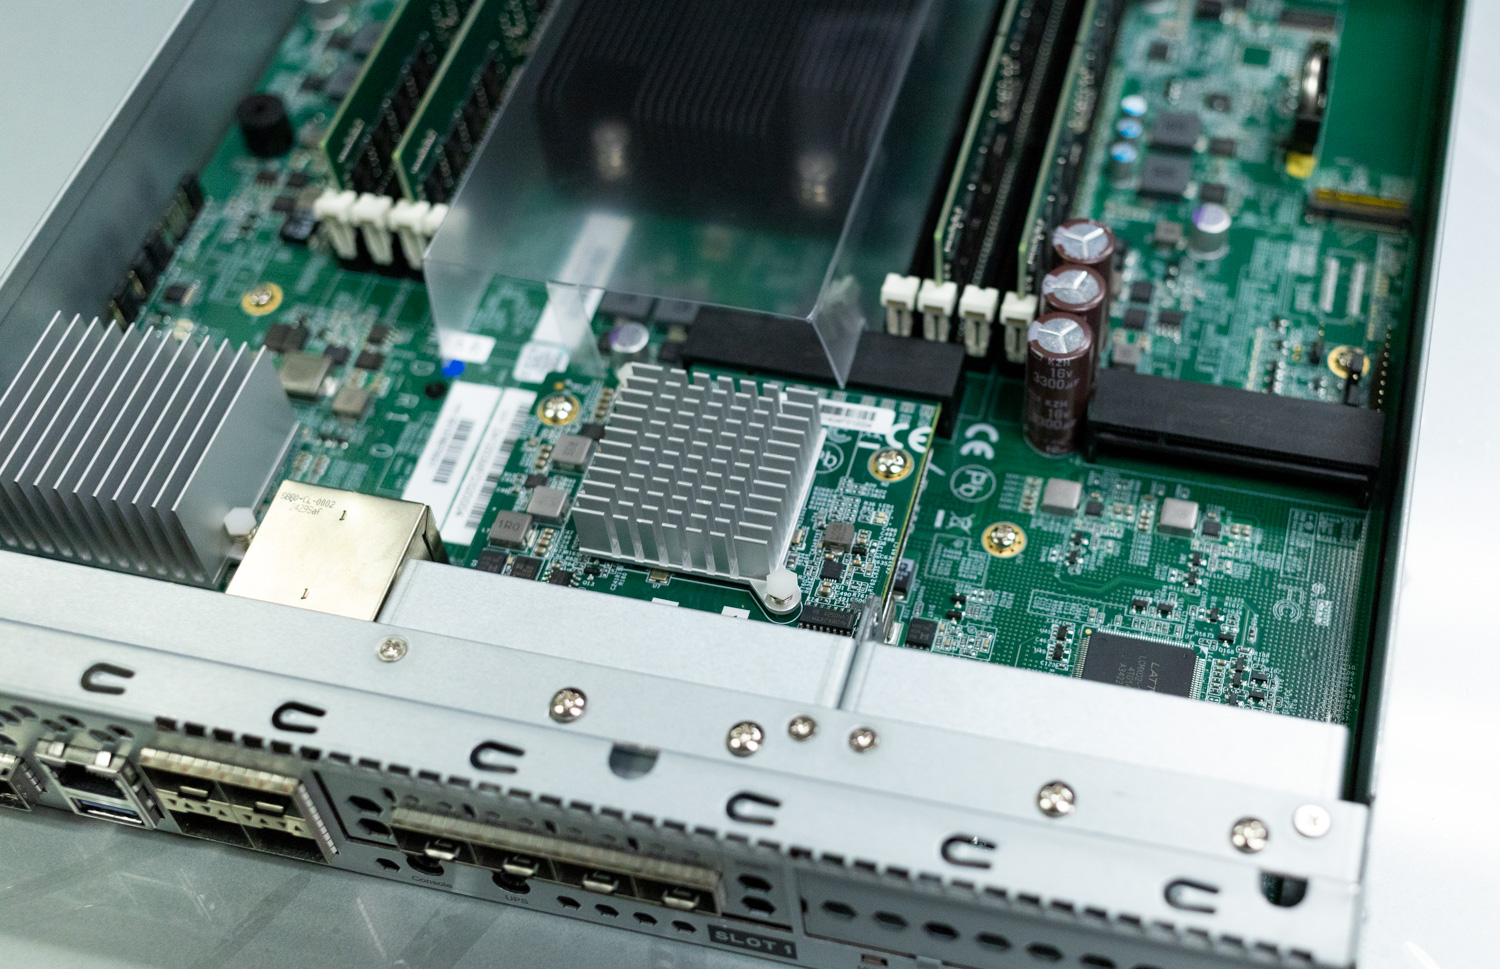
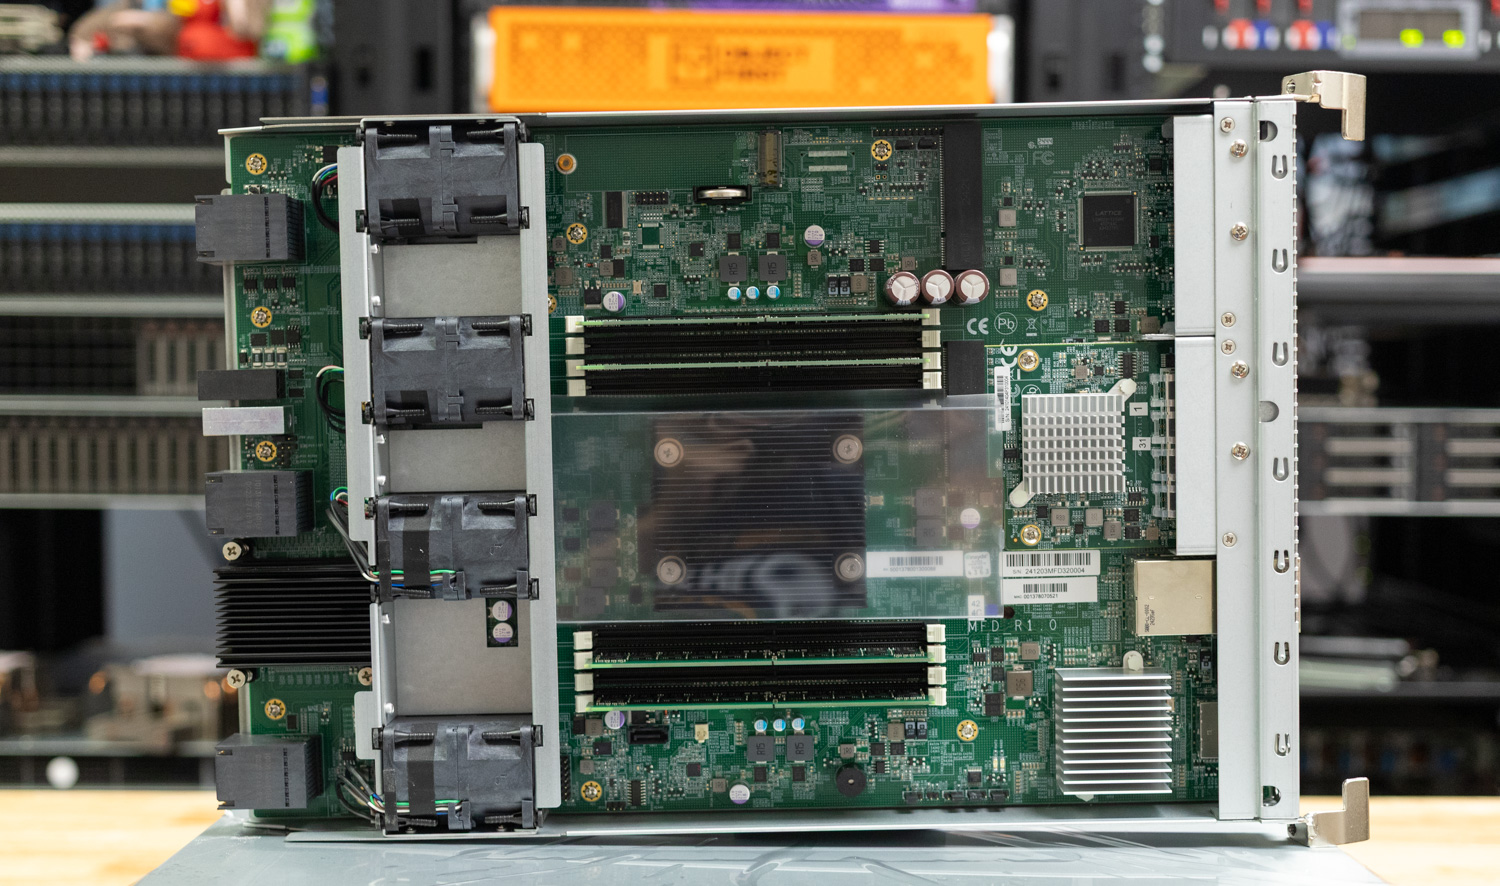
Gli array di storage della serie QSAN XN4 sono disponibili in uno chassis server da 26 alloggiamenti, 2U, compatibile con rack da 19", con opzioni a controller singolo o doppio che ospitano CPU Intel Xeon a 4 o 8 core per soddisfare le esigenze di ridondanza e prestazioni delle aziende più piccole e più grandi. Con tutti i 26 alloggiamenti occupati, un singolo chassis della serie XN4 può contenere fino a 798 terabyte di dati su unità a stato solido NVMe U.2/U.3 da 2.5". È inoltre possibile aggiungere fino a 20 unità di espansione SAS, aumentando la capacità totale di un array fino a ben 16.773 petabyte.
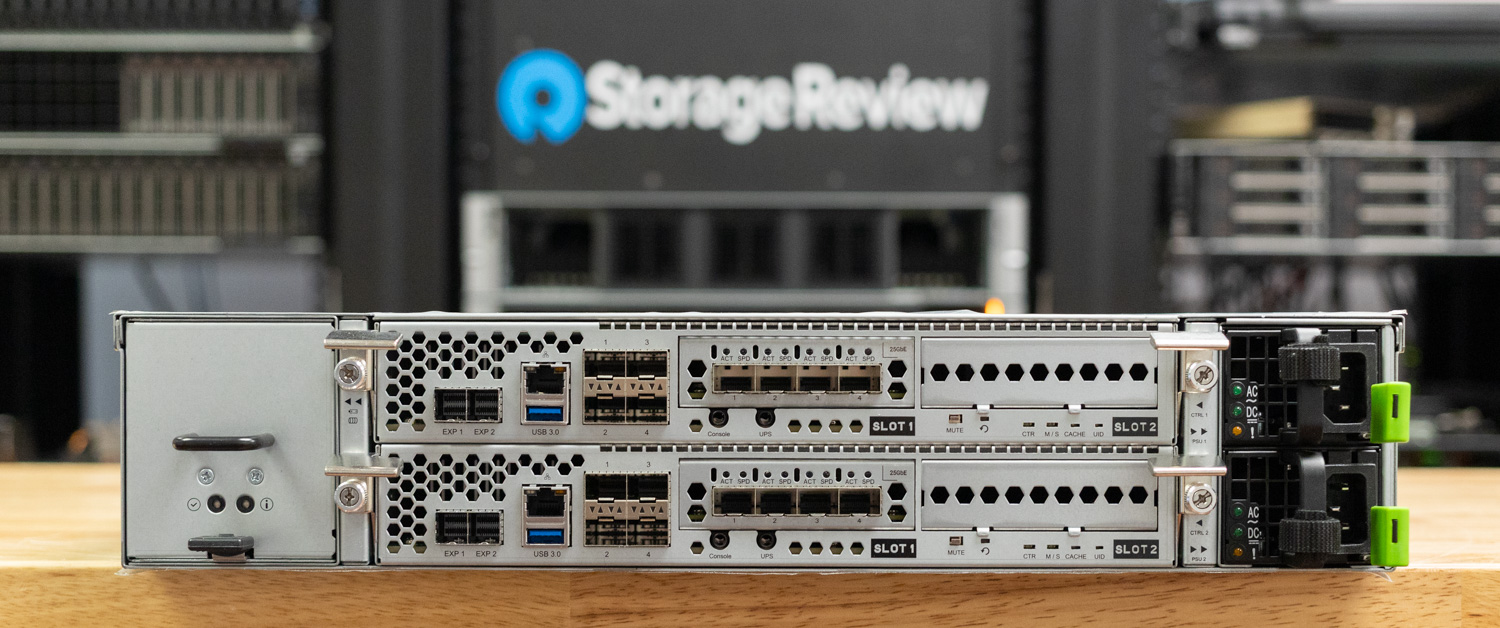
Ogni controller integrato è dotato di una singola porta Ethernet RJ45 da 2.5 Gbps, quattro porte SFP+ da 10 Gbps e due porte SAS wide da 12 Gbps. Sono inoltre disponibili opzioni di upgrade per porte RJ45 da 10 Gbps, SFP28 da 25 Gbps e QSFP da 100 Gbps. È possibile aggiungere il supporto Fibre Channel, con adattatori SFP+ da 16 Gbps e SFP28 da 32 Gbps.
La tabella seguente confronta le specifiche dei sistemi di storage XN4226D-4C e XN4226S-4C. Si tratta delle varianti 4C, progettate con controller dual-active o single-upgradable a seconda del modello. Per implementazioni che richiedono maggiore potenza di elaborazione, è disponibile anche una versione 8C di questi sistemi.
| Specificazione | XN4226D-4C | XN4226S-4C |
|---|---|---|
| Nome del modello | XN4226D-4C | XN4226S-4C |
| Architettura | Controller dual-active | Controller aggiornabile singolarmente |
| CPU | Intel® Xeon® 4-core × 2 | Intel® Xeon® a 4 core |
| Memorie | ||
| Modulo di memoria preinstallato | Scheda madre DDR32 da 4 GB | Scheda madre DDR16 da 4 GB |
| Slot di memoria totali | 16 | 8 |
| Memoria espandibile fino a | 2,048GB | 1,024GB |
| Archiviazione | ||
| Alloggiamenti per unità | Slot da 2.5″ × 26 | Slot da 2.5″ × 26 |
| Numero massimo di alloggiamenti per unità con unità di espansione | 546 | 546 |
| Tipo di unità compatibile | SSD NVMe U.2/U.3 a doppia porta da 2.5" SSD SAS da 2.5″ (per unità di espansione) HDD SAS da 3.5″ (per unità di espansione) |
SSD NVMe U.2/U.3 a porta singola da 2.5" SSD SAS da 2.5″ (per unità di espansione) HDD SAS da 3.5″ (per unità di espansione) |
| Interfaccia dell'unità | U.2 NVMe (PCIe Gen 4) SAS 12 Gb/s (per unità di espansione) |
U.2 NVMe (PCIe Gen 4) SAS 12 Gb/s (per unità di espansione) |
| Capacità grezza interna massima | 798TB | 798TB |
| Capacità massima grezza con espansione | 16,773TB | 16,773TB |
| Unità sostituibile a caldo | Si | Si |
| Porta di connettività | ||
| Espansione PCIe | (Slot Gen 4×8) × 4 | (Slot Gen 4×8) × 2 |
| Porta LAN RJ45 da 2.5 GbE | 2 (a bordo) | 1 (a bordo) |
| Porta LAN SFP+ da 10 GbE | 8 (a bordo) / 16 (opzionale) | 4 (a bordo) / 8 (opzionale) |
| Porta LAN RJ45 da 10 GbE | 16 (opzione) | 8 (opzione) |
| Porta LAN SFP28 da 25 GbE | 16 (opzione) | 8 (opzione) |
| Porta LAN QSFP da 100 GbE | 8 (opzione) | 4 (opzione) |
| Canale in fibra SFP+ da 16 Gb | 16 (opzione) | 8 (opzione) |
| Canale in fibra SFP28 da 32 Gb | 16 (opzione) | 8 (opzione) |
| Espansione e porta esterna | ||
| Porta larga SAS da 12 Gb/s | 4 (a bordo) | 2 (a bordo) |
| Porta USB | 1 (anteriore) / 2 (posteriore) | 1 (anteriore) / 1 (posteriore) |
| Altro | Porta console × 2, Porta servizio × 2 | Porta console × 1, Porta servizio × 1 |
| Specifiche del software | ||
| Sistema operativo di archiviazione | QSM 4 | QSM 4 |
| Tipo RAID | 0 / 1 / 5 / 6 / 10 / 50 / 60 / 5EE / 6EE / 50EE / 60EE | |
| Efficienza di archiviazione | Thin provisioning / Compressione e deduplicazione (opzione) | |
| Accelerazione del software | Cache SSD / Tiering automatico / RDMA | |
| Protezione dei dati | Snapshot / Asincrono / Sincrono (opzione) | |
| Servizio di backup | Backup Rsync / S3 / Backup cloud / XMirror* / Backup e-mail di Microsoft 365 | |
| Sicurezza | SSL / SSH / iSCSI CHAP / ISE e SED / WORM / RBAC / Windows ACL / Antivirus | |
| Protocolli di supporto | CIFS / NFS / FTP / WebDAV / iSCSI / FCP / NVMe-oF | |
| Management | Interfaccia utente Web / Windows AD / LDAP / API RESTful / SES / LCM | |
| Forma | ||
| Dimensioni (A × L × P) | 88 × 438 × 573mm | 88 × 438 × 573mm |
| Peso netto | 19.6 kg | 16.5 kg |
| Peso lordo | 28.6 kg | 25.5 kg |
| Altro | ||
| Protezione della memoria | Modulo Cache-to-Flash (integrato) | |
| Fan di sistema | 8 pezzi | 4 pezzi |
| Alimentatore | 850 W × 2 (80 Plus Platinum) | |
| Potenza di ingresso | 100 – 240 V CA, 50/60 Hz | |
| Consumo di energia | 812 W / 2,770 BTU | |
| Certificazione | CE / FCC / BSMI | |
| Garanzia standard | Sistema: 5 anni | Modulo Cache-to-Flash: 1 anno | |
Funzionalità QSAN XN4
Gli array XN4 sono dotati di serie dei più recenti protocolli di connessione necessari per supportare modelli di elaborazione ad alte prestazioni e intelligenza artificiale ad alto consumo di dati, tra cui NVMe over Fabrics (NVMe-oF) gestiti tramite TCP e RDMA. Sono inoltre supportate connessioni tramite iSCSI, NFS, FCP, CIFS/SMB, FTP e WebDAV, consentendo all'array di soddisfare le esigenze di storage a blocchi e file dei data center con un mix di sistemi legacy e all'avanguardia.
I vantaggi di NVMe-oF
Sebbene protocolli come iSCSI, NFS e FCP siano ancora ampiamente utilizzati nelle applicazioni di storage aziendale, NVMe-oF offre significativi miglioramenti in termini di latenza. Gli standard NVMe sono stati progettati da zero per unità a stato solido collegate direttamente al bus PCIe di un sistema. Al contrario, protocolli più vecchi come iSCSI e NFS sono stati sviluppati per far fronte alle limitazioni e ai tempi di accesso più lenti delle unità disco rigido tradizionali. In quasi tutti i casi, le tecnologie NVMe-oF superano i vecchi protocolli di connessione, con una maggiore larghezza di banda e tempi di accesso più rapidi. NVMe-oF può anche sfruttare le interfacce di rete con funzionalità RDMA (Remote Direct Memory Access), consentendo il trasferimento dei dati direttamente alla memoria di un computer di destinazione senza richiedere l'elaborazione da parte della CPU.
Funzionalità di riduzione e ottimizzazione dei dati
Lo stack hardware ad alte prestazioni dell'array di storage XN4 è ulteriormente potenziato da numerose funzionalità software ben note e apprezzate dagli amministratori di storage. Thin provisioning, compressione e deduplicazione consentono alle aziende di massimizzare la capacità della SAN, mentre la memorizzazione nella cache SSD e il tiering automatico dello storage accelerano i tempi di accesso per file e oggetti utilizzati di frequente. Il sistema operativo QSM 4 dell'appliance semplifica inoltre il test e il rollback delle modifiche grazie agli strumenti di snapshot integrati.
Funzionalità di sicurezza e gestione
QSAN ha tenuto conto delle mutevoli esigenze di sicurezza e gestione dei propri clienti con la linea XN4. XN4 è compatibile con Instant Secure Erase (ISE) e Self-Encrypting Drives (SED), nonché con protocolli di sicurezza come SSL/TLS, autenticazione tramite Role-Based Access Control (RBAC) e supporto per server Active Directory/LDAP. L'array può essere gestito tramite un'interfaccia utente web HTTPS o un'API RESTful, consentendo l'automazione tramite un'ampia gamma di strumenti, come Ansible o Terraform.
Gestione QSM 4
QSM 4, il sistema operativo della serie QSAN XN4, semplifica la configurazione e la gestione dell'array di storage per gli amministratori di storage di qualsiasi livello di esperienza. L'implementazione immediata è semplice: creazione rapida di pool, assegnazione intuitiva degli host e gestione semplificata tramite interfaccia utente web e API REST, il tutto progettato per team IT di piccole dimensioni senza competenze approfondite in ambito storage.
La schermata Dashboard mostra le informazioni sullo stato del sistema e gli eventi recenti registrati dal server.
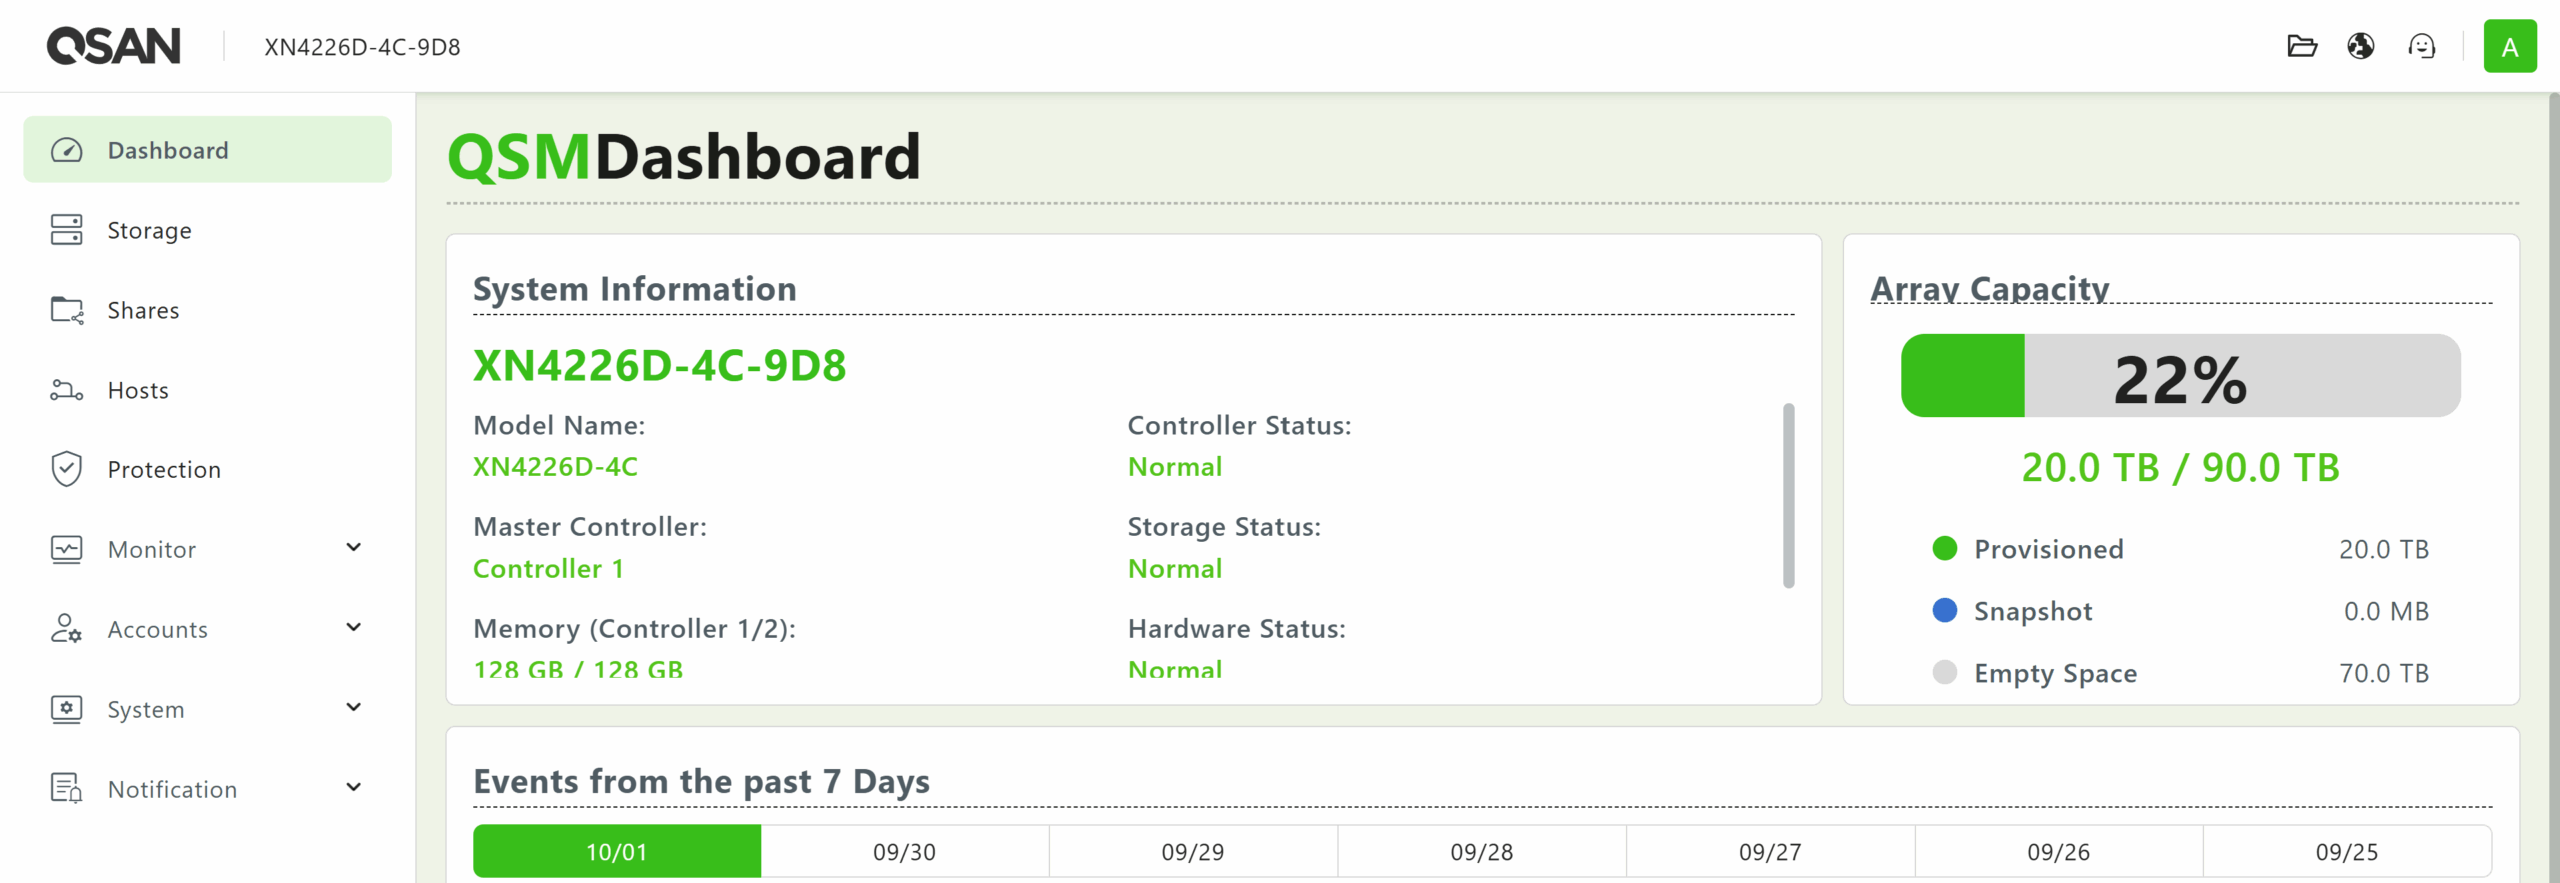
Dopo aver effettuato l'accesso, all'utente viene presentata la schermata Dashboard, che fornisce una rapida panoramica dello stato di salute della SAN. Da qui, è possibile accedere a qualsiasi sottomenu dall'elenco nel pannello a sinistra.
Dal menu Archiviazione, gli amministratori possono creare e gestire pool di unità e i volumi associati.
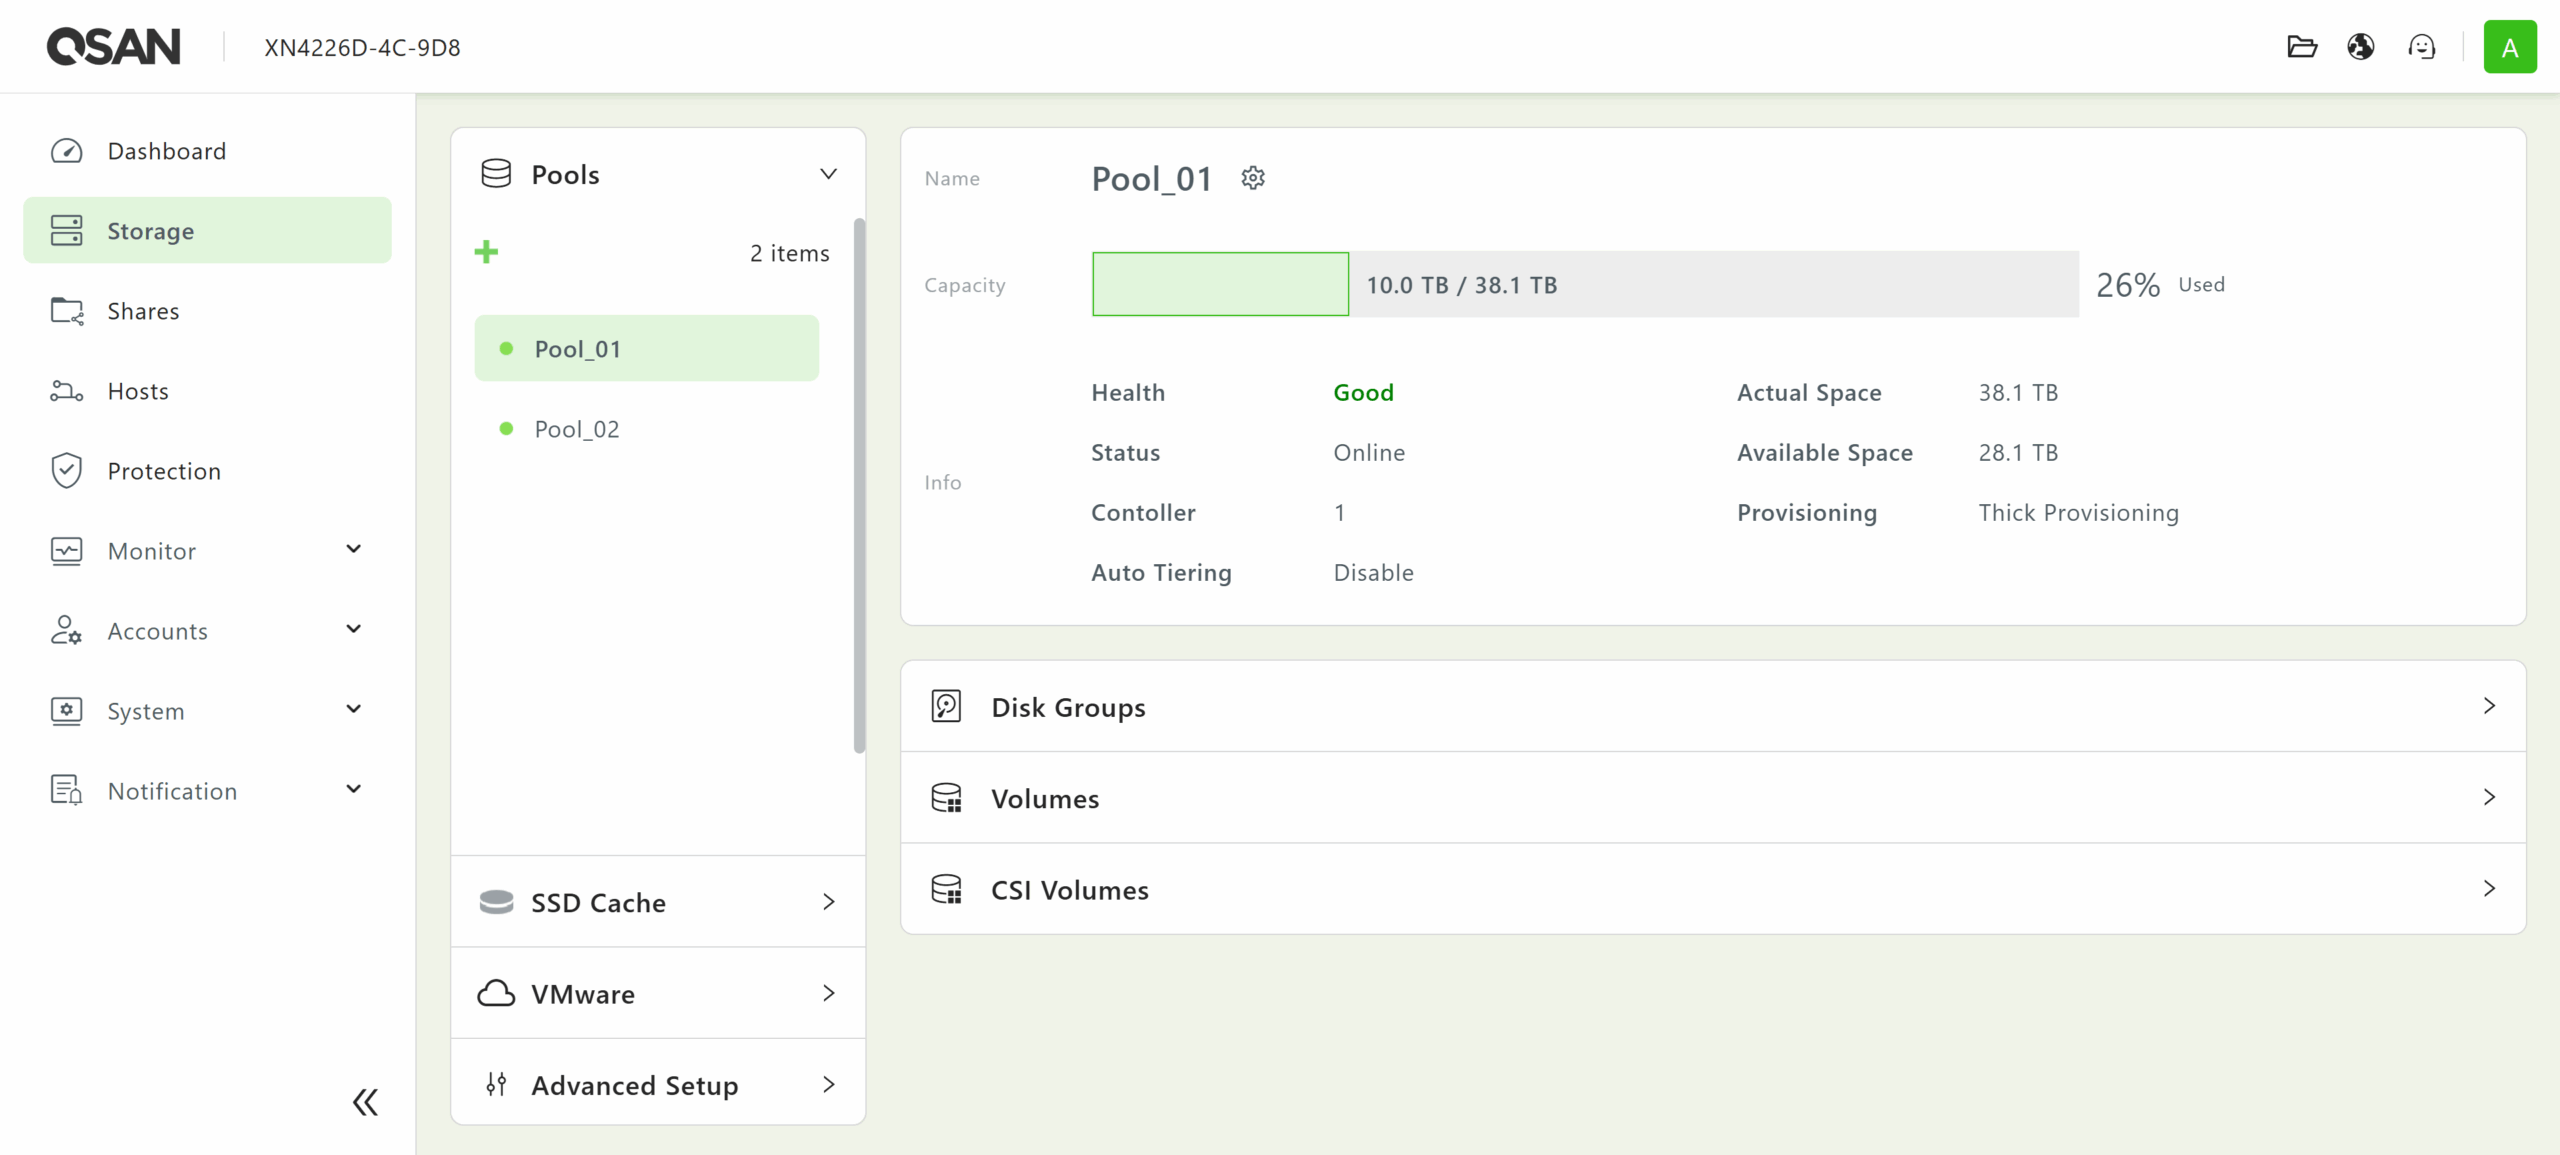
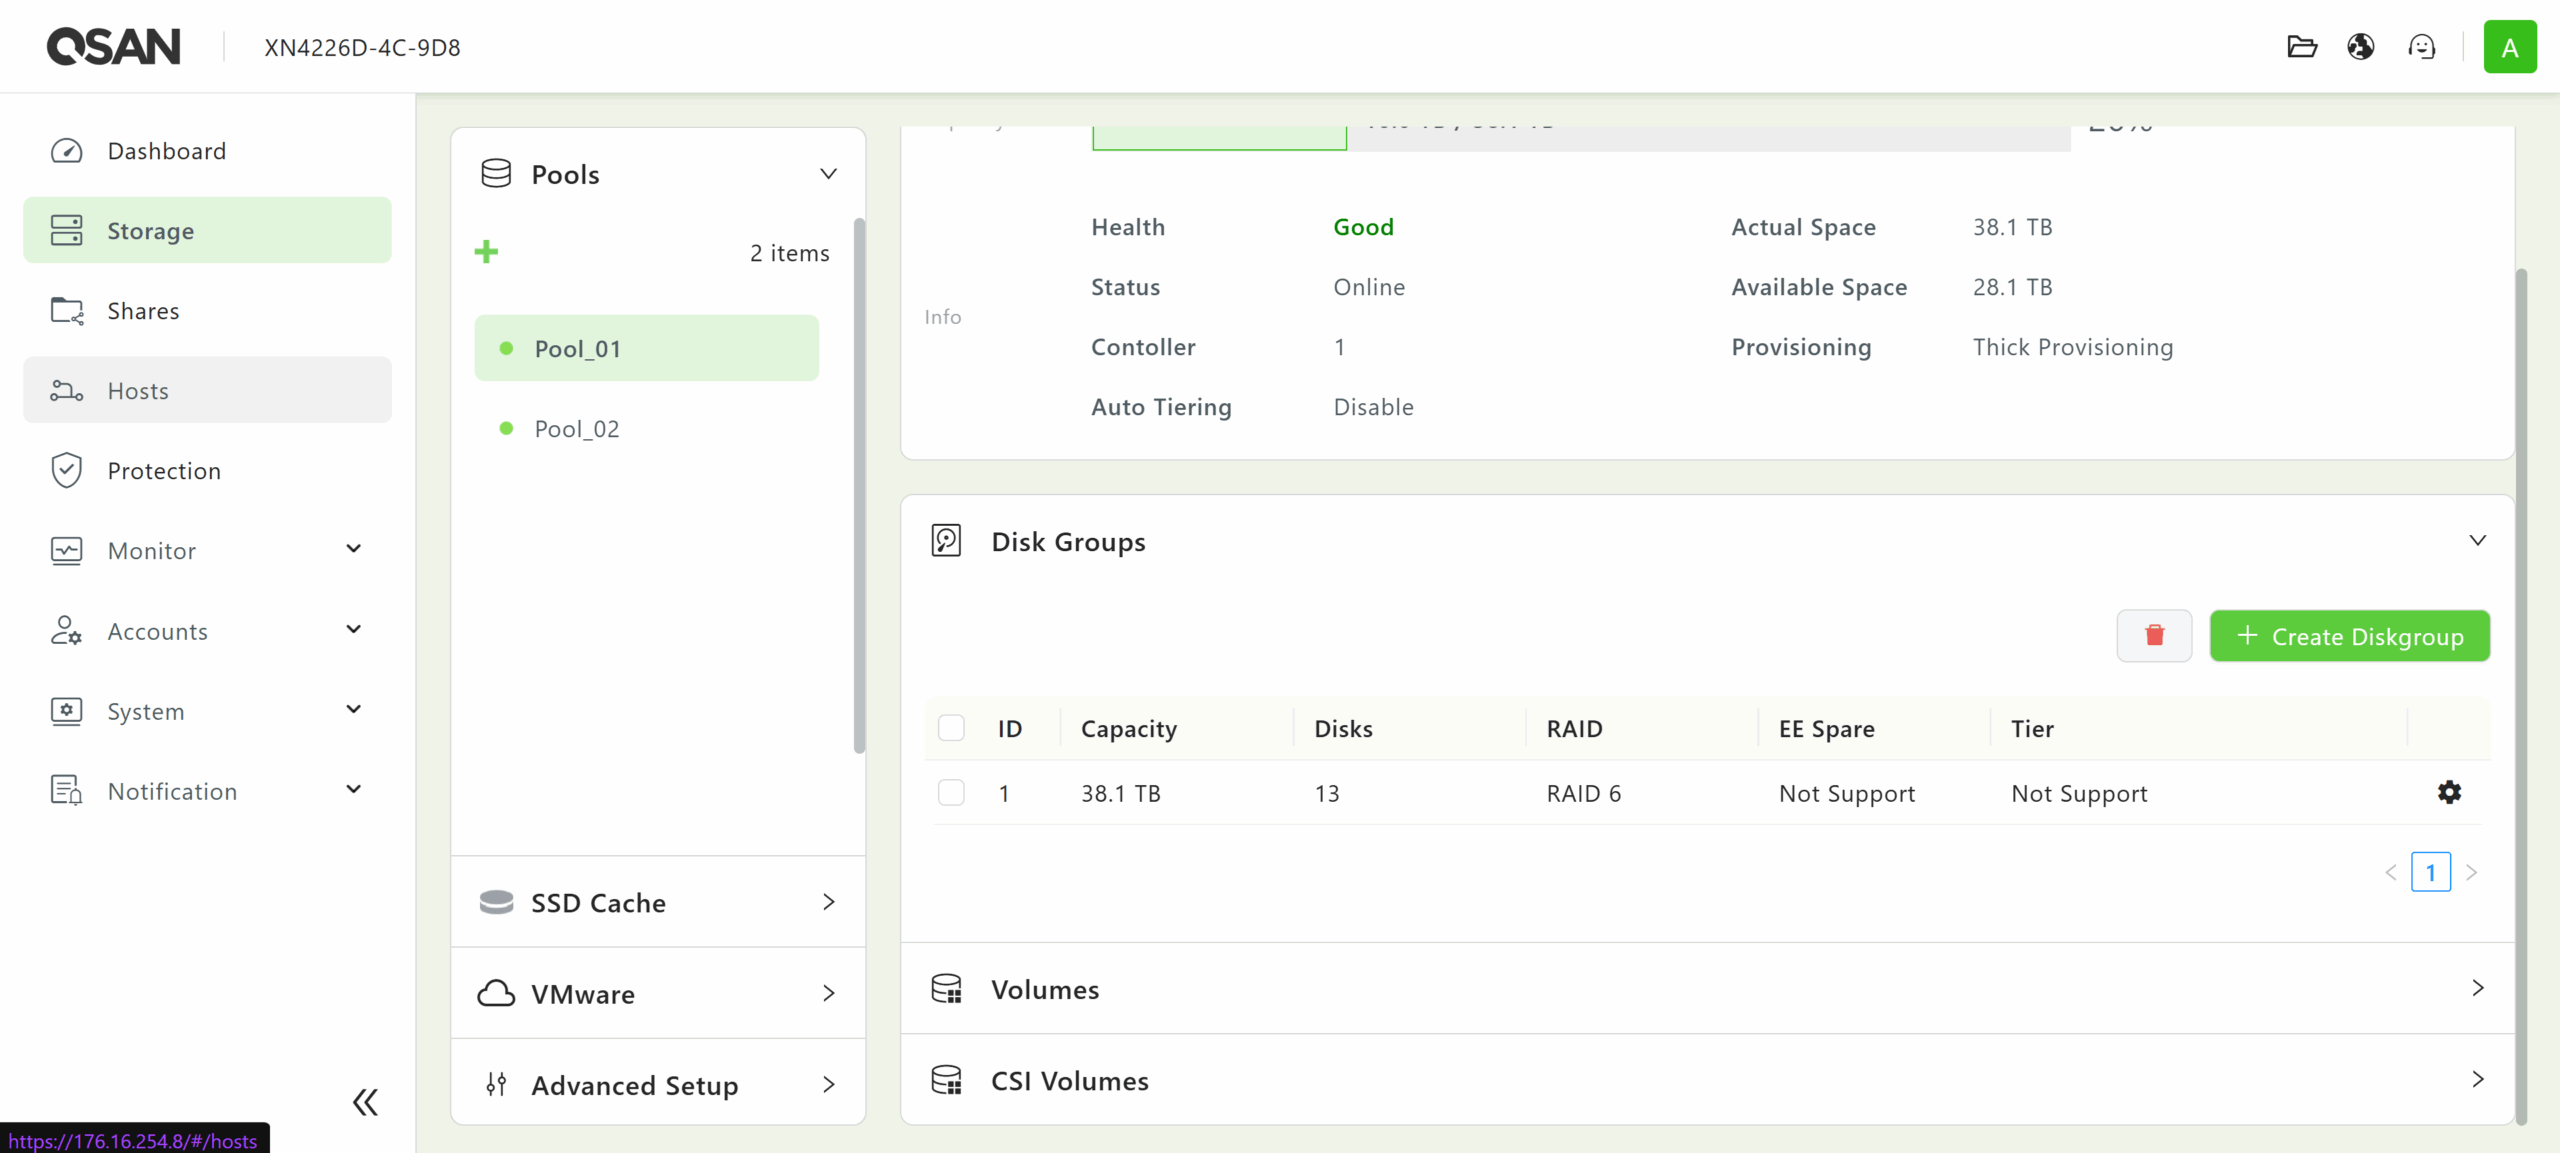
I gruppi di dischi che costituiscono ciascun pool possono essere gestiti nella scheda Gruppi di dischi. Questa funzionalità supporta vari livelli RAID, tra cui 0, 1, 5, 6, 10, 50, 60, 5EE, 6EE, 50EE e 60EE, a seconda del numero di unità già assegnate.
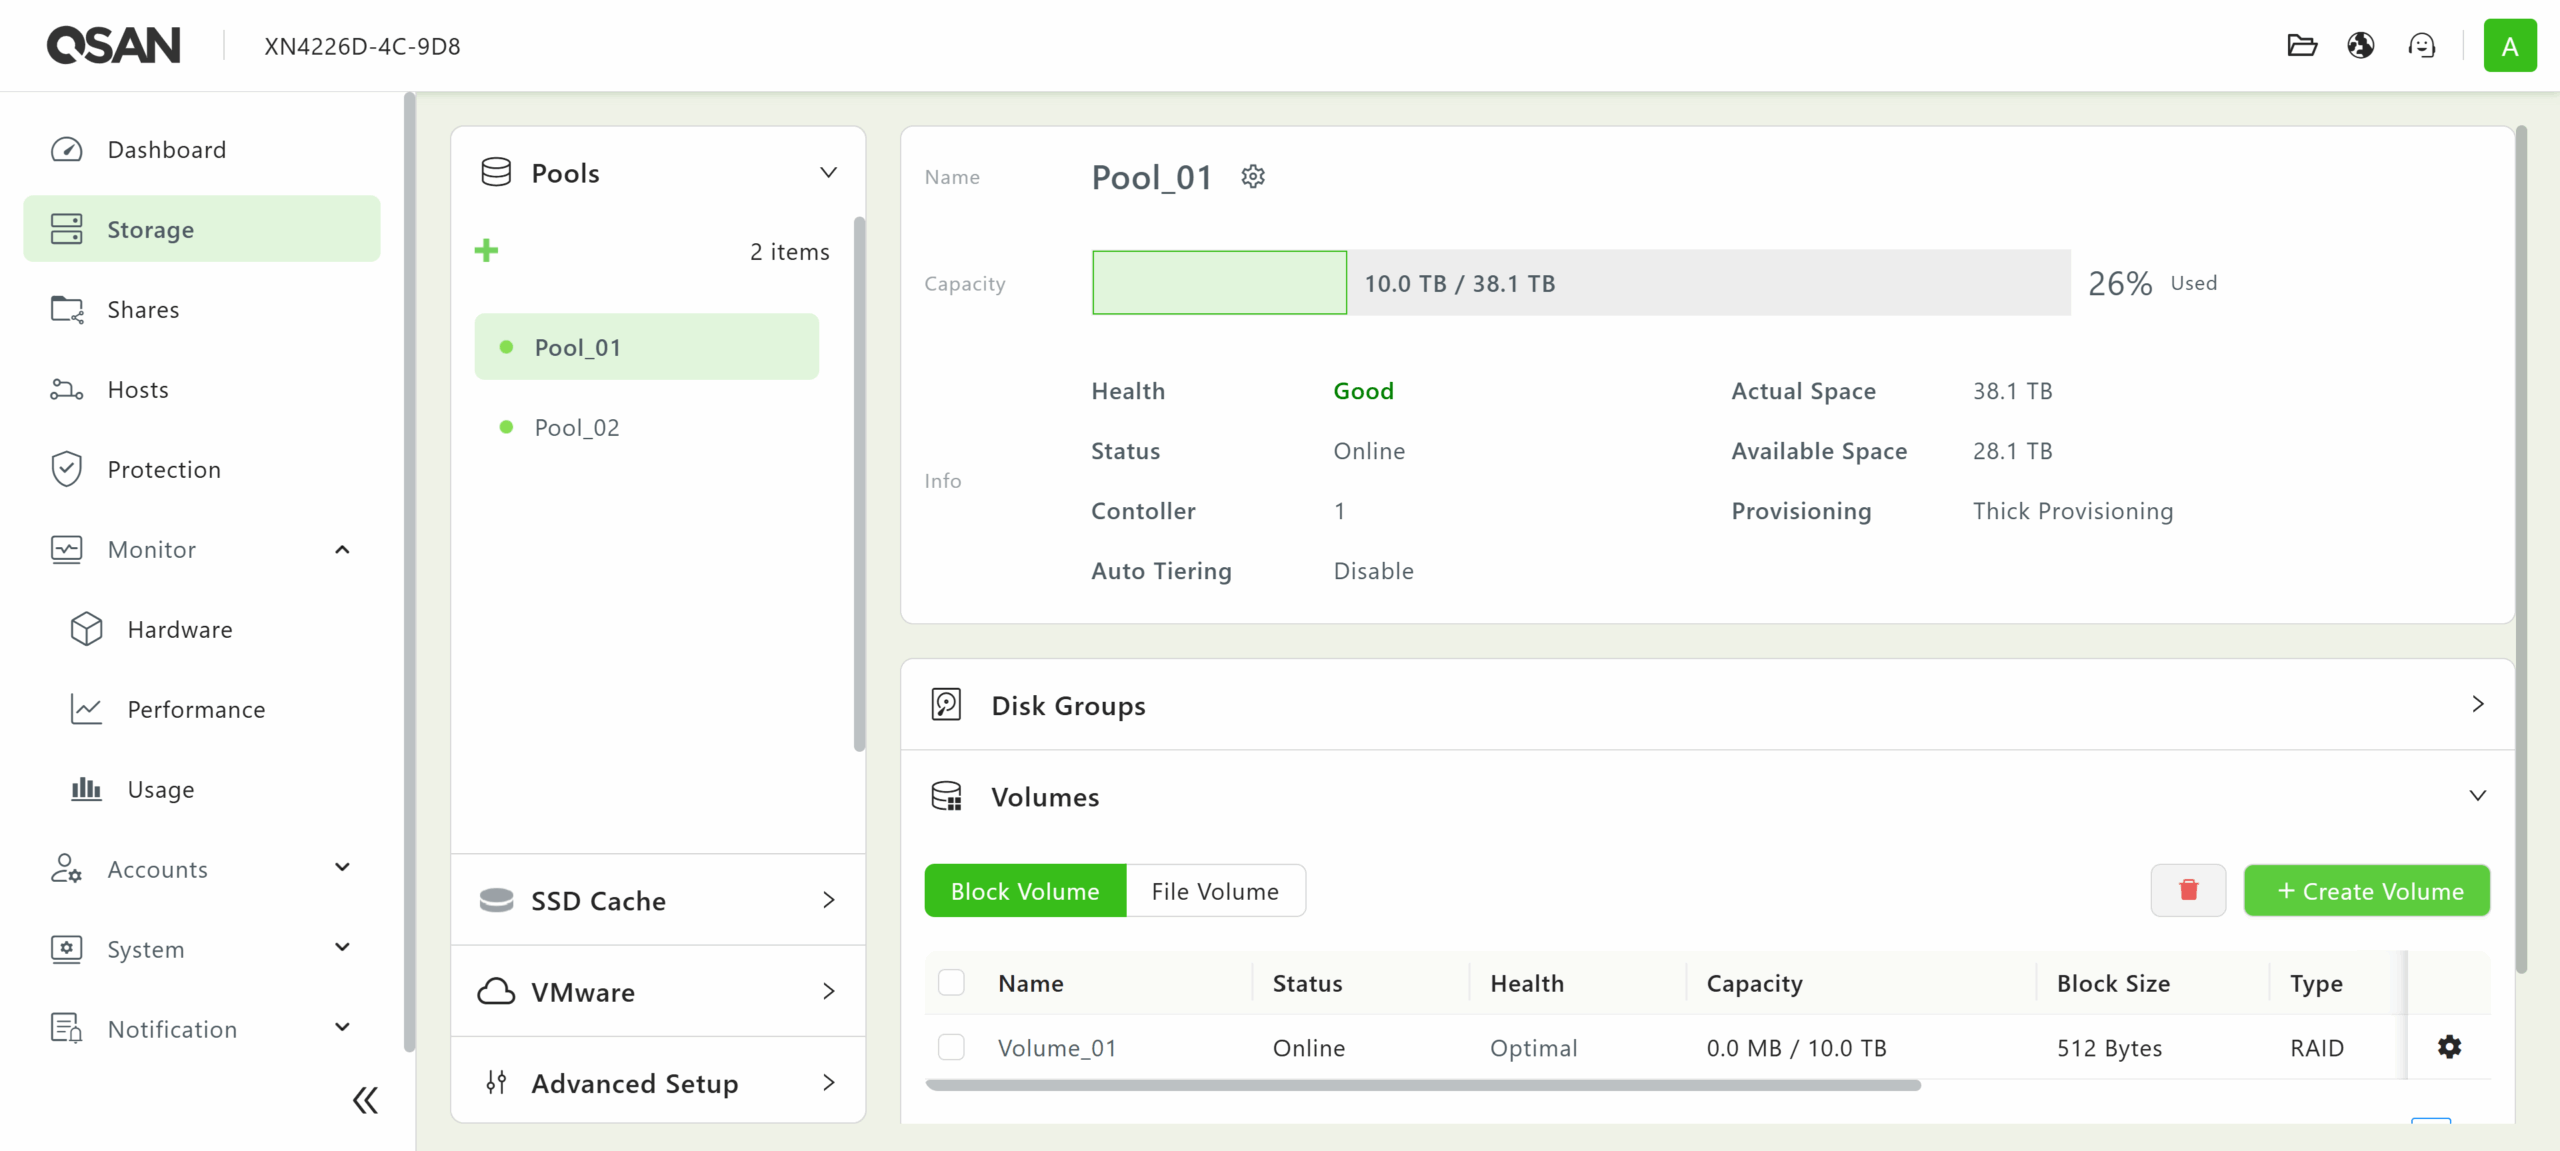
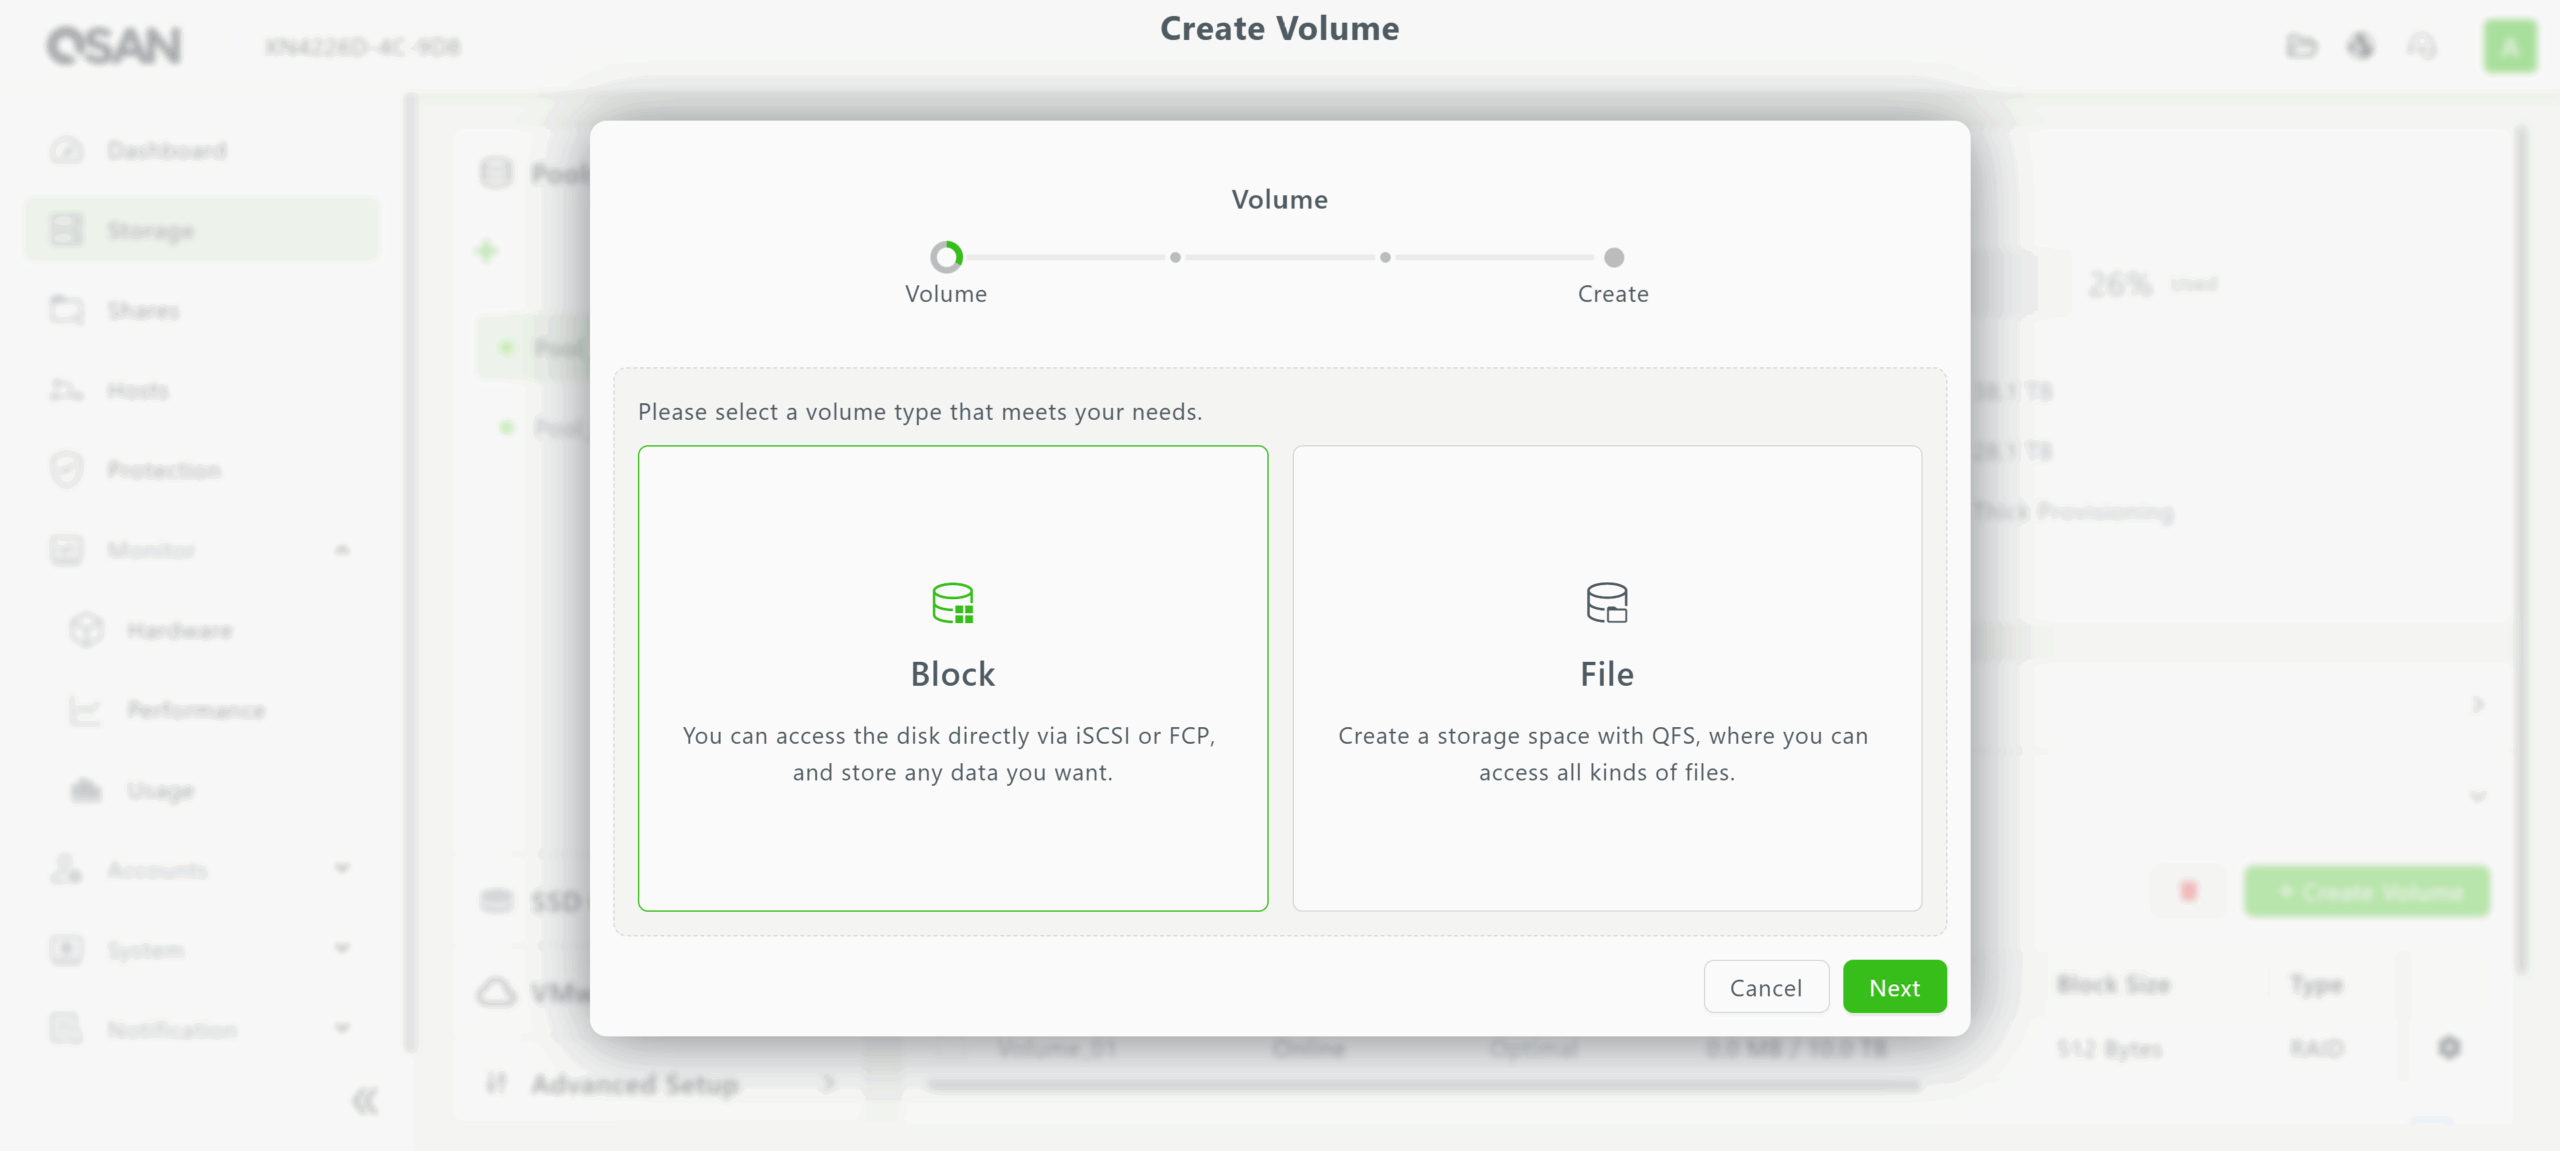
I volumi per esigenze di storage a blocchi e file possono quindi essere creati sulla base dei pool. Utilizzando la procedura guidata, è possibile impostare la capacità e le dimensioni dei blocchi di ciascun volume in base alle esigenze dei client connessi.
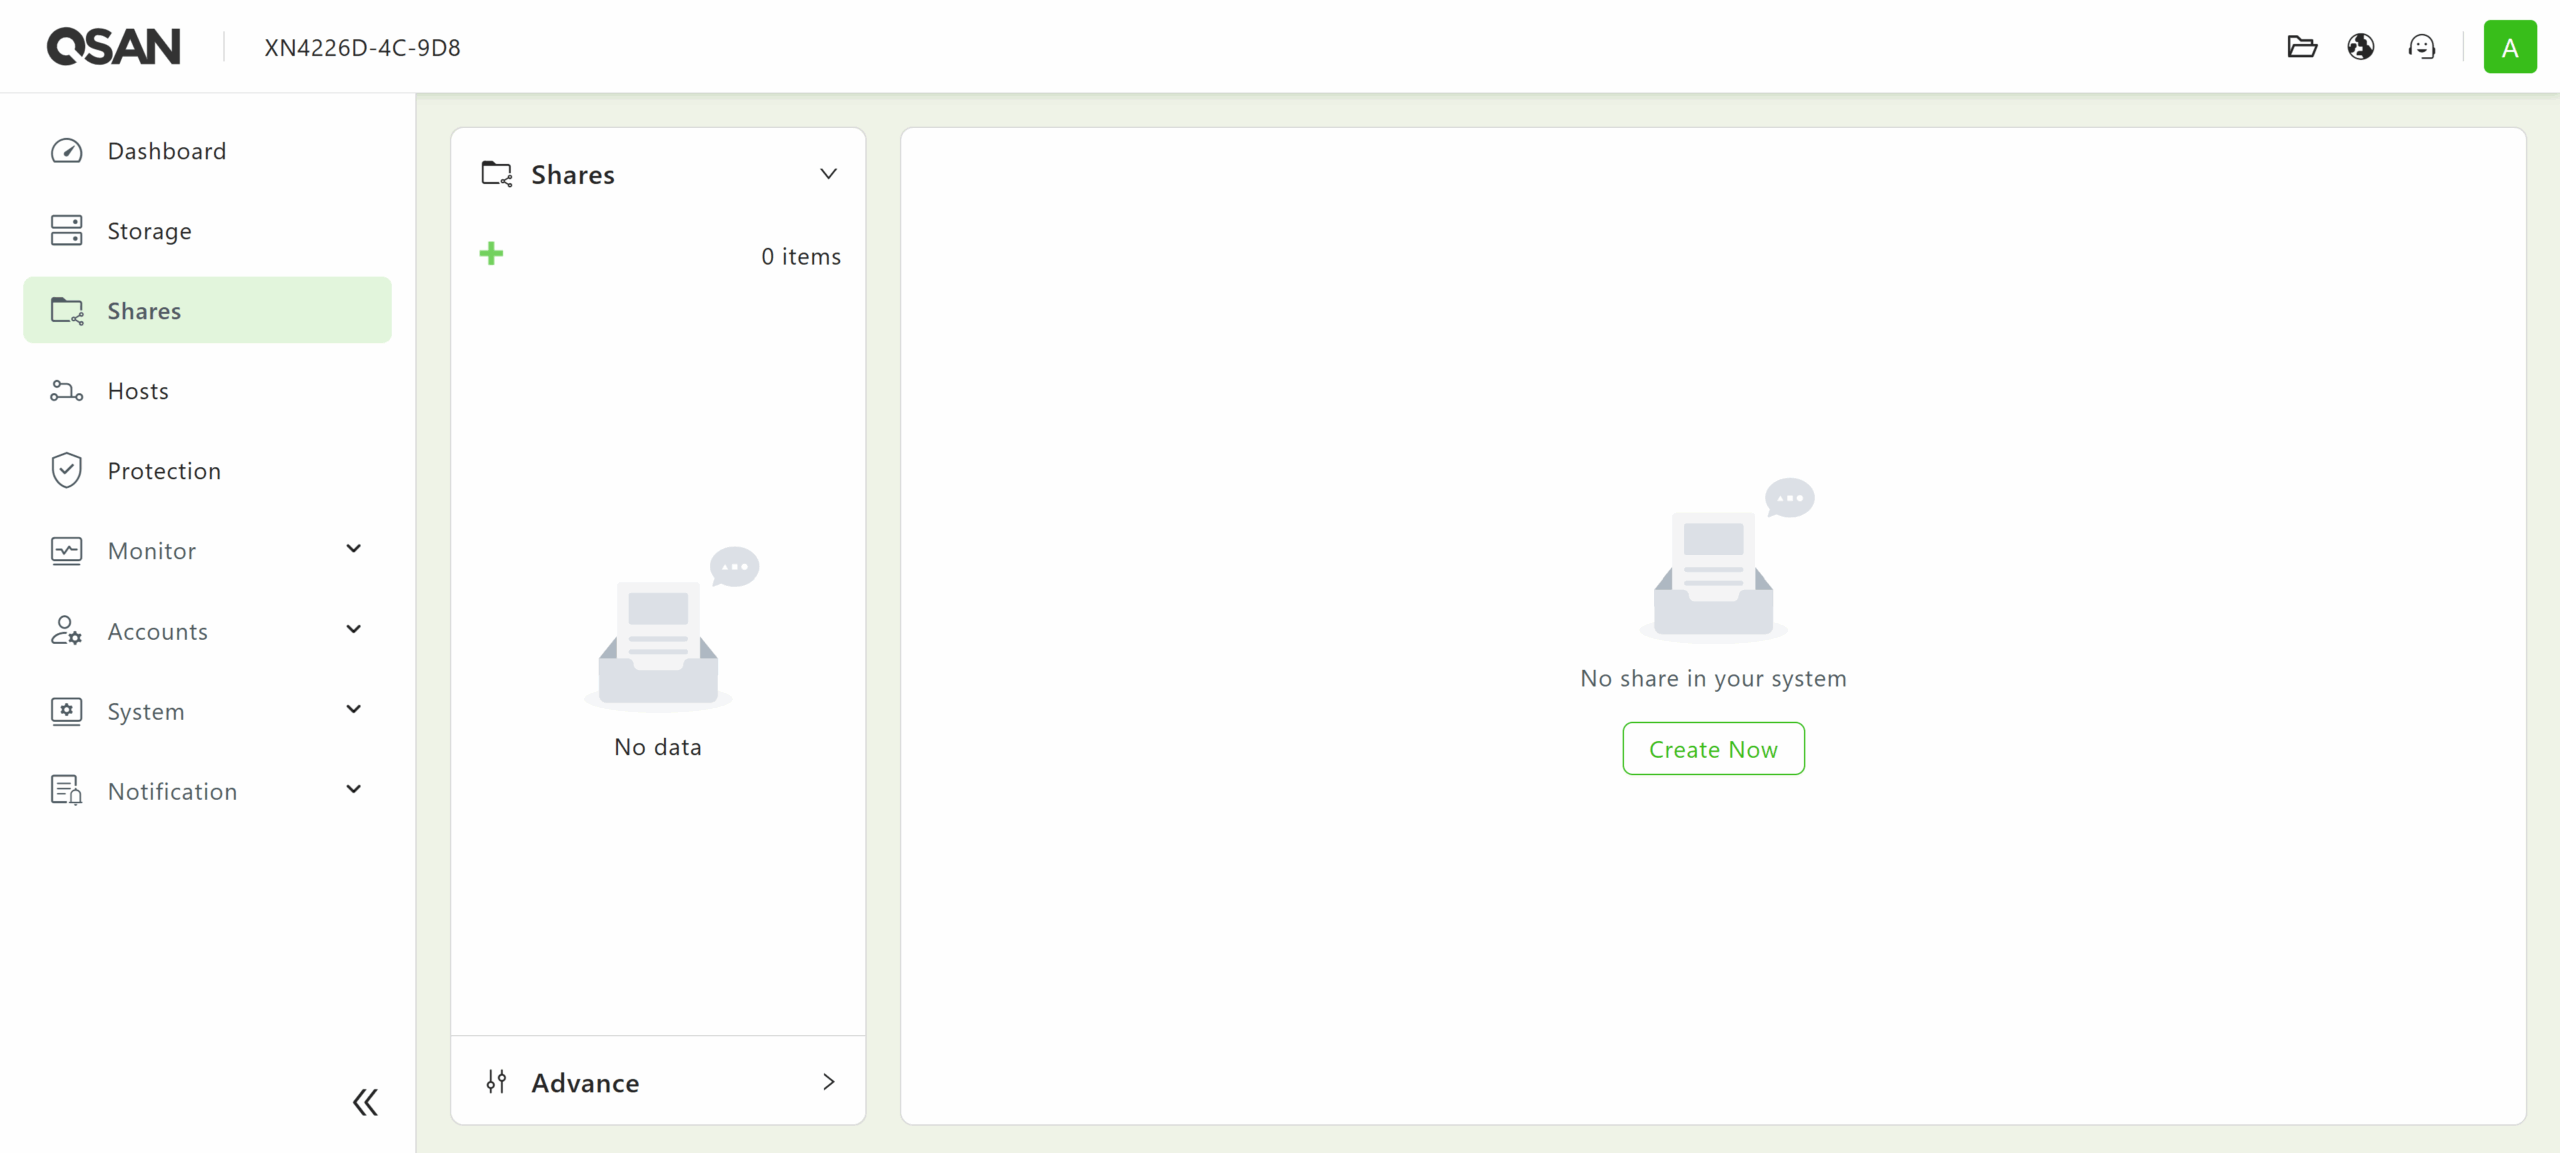
Scendendo nell'elenco, il menu Condivisioni può essere utilizzato per creare un oggetto di condivisione su un volume di file. I protocolli di condivisione supportati includono CIFS (SMB), FTP, NFS e WebDAV.
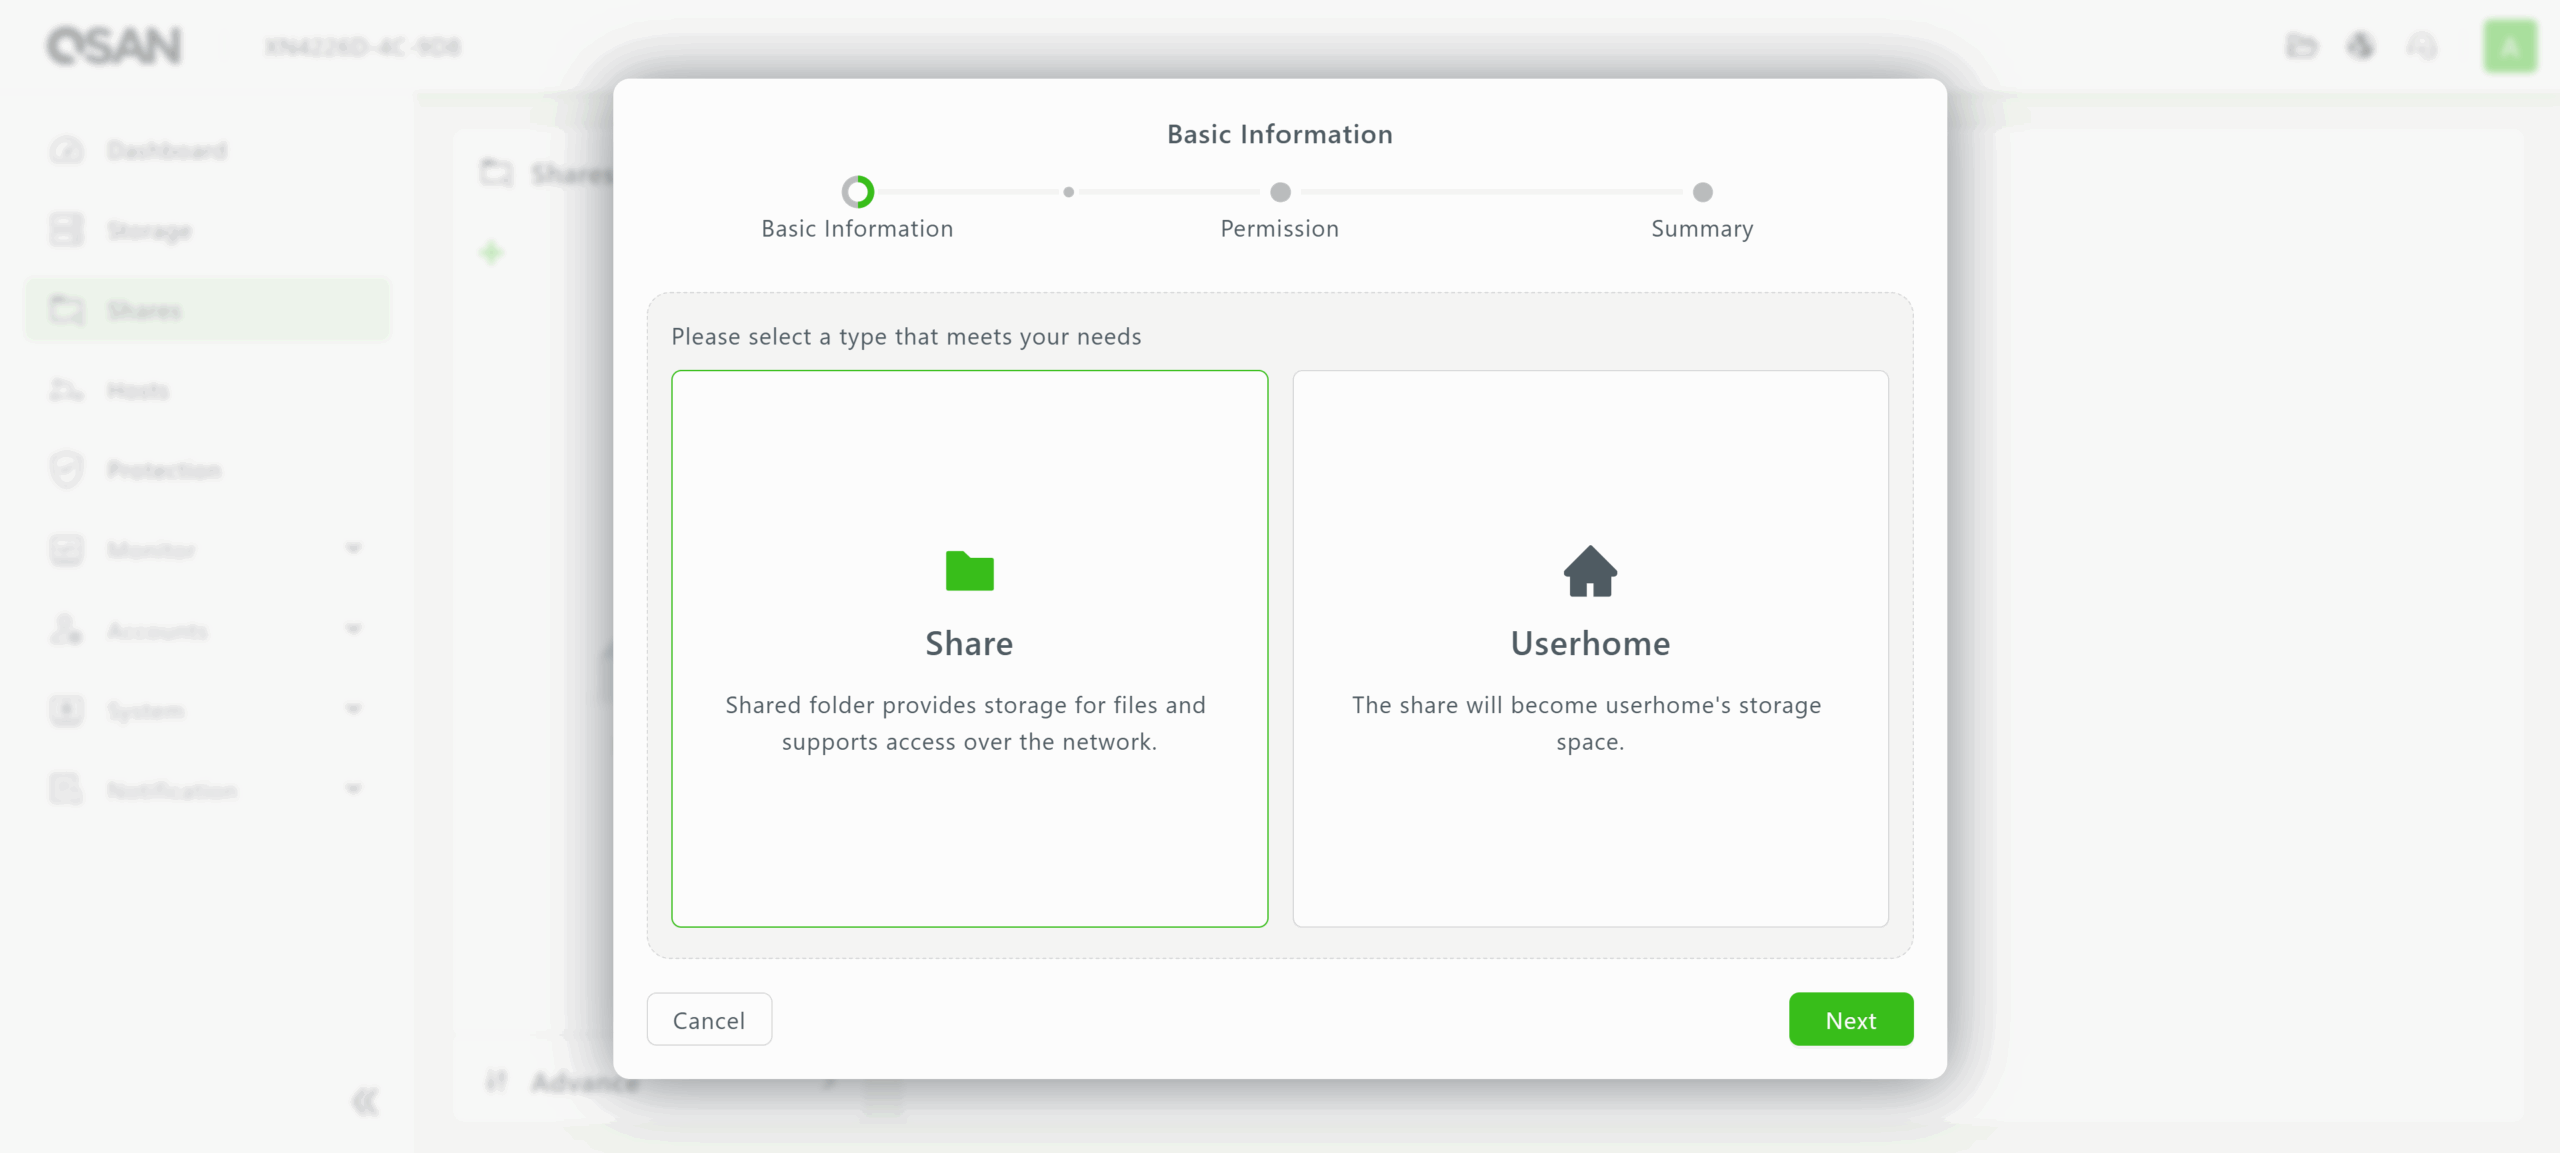
 Quando si crea una nuova condivisione, QSM 4 offre due opzioni: una condivisione di rete standard per ospitare file a cui potranno accedere più utenti e una condivisione userhome, progettata per contenere cartelle home per gli utenti a cui è possibile accedere solo individualmente.
Una volta creato un volume a blocchi o un volume di file con relativa condivisione, è necessario assegnargli un indirizzo IP o un nome host nel menu Host. Gli host sono organizzati in base alla loro corrispondenza con l'archiviazione a blocchi o con quella di file (condivisione), come mostrato nelle schermate seguenti.
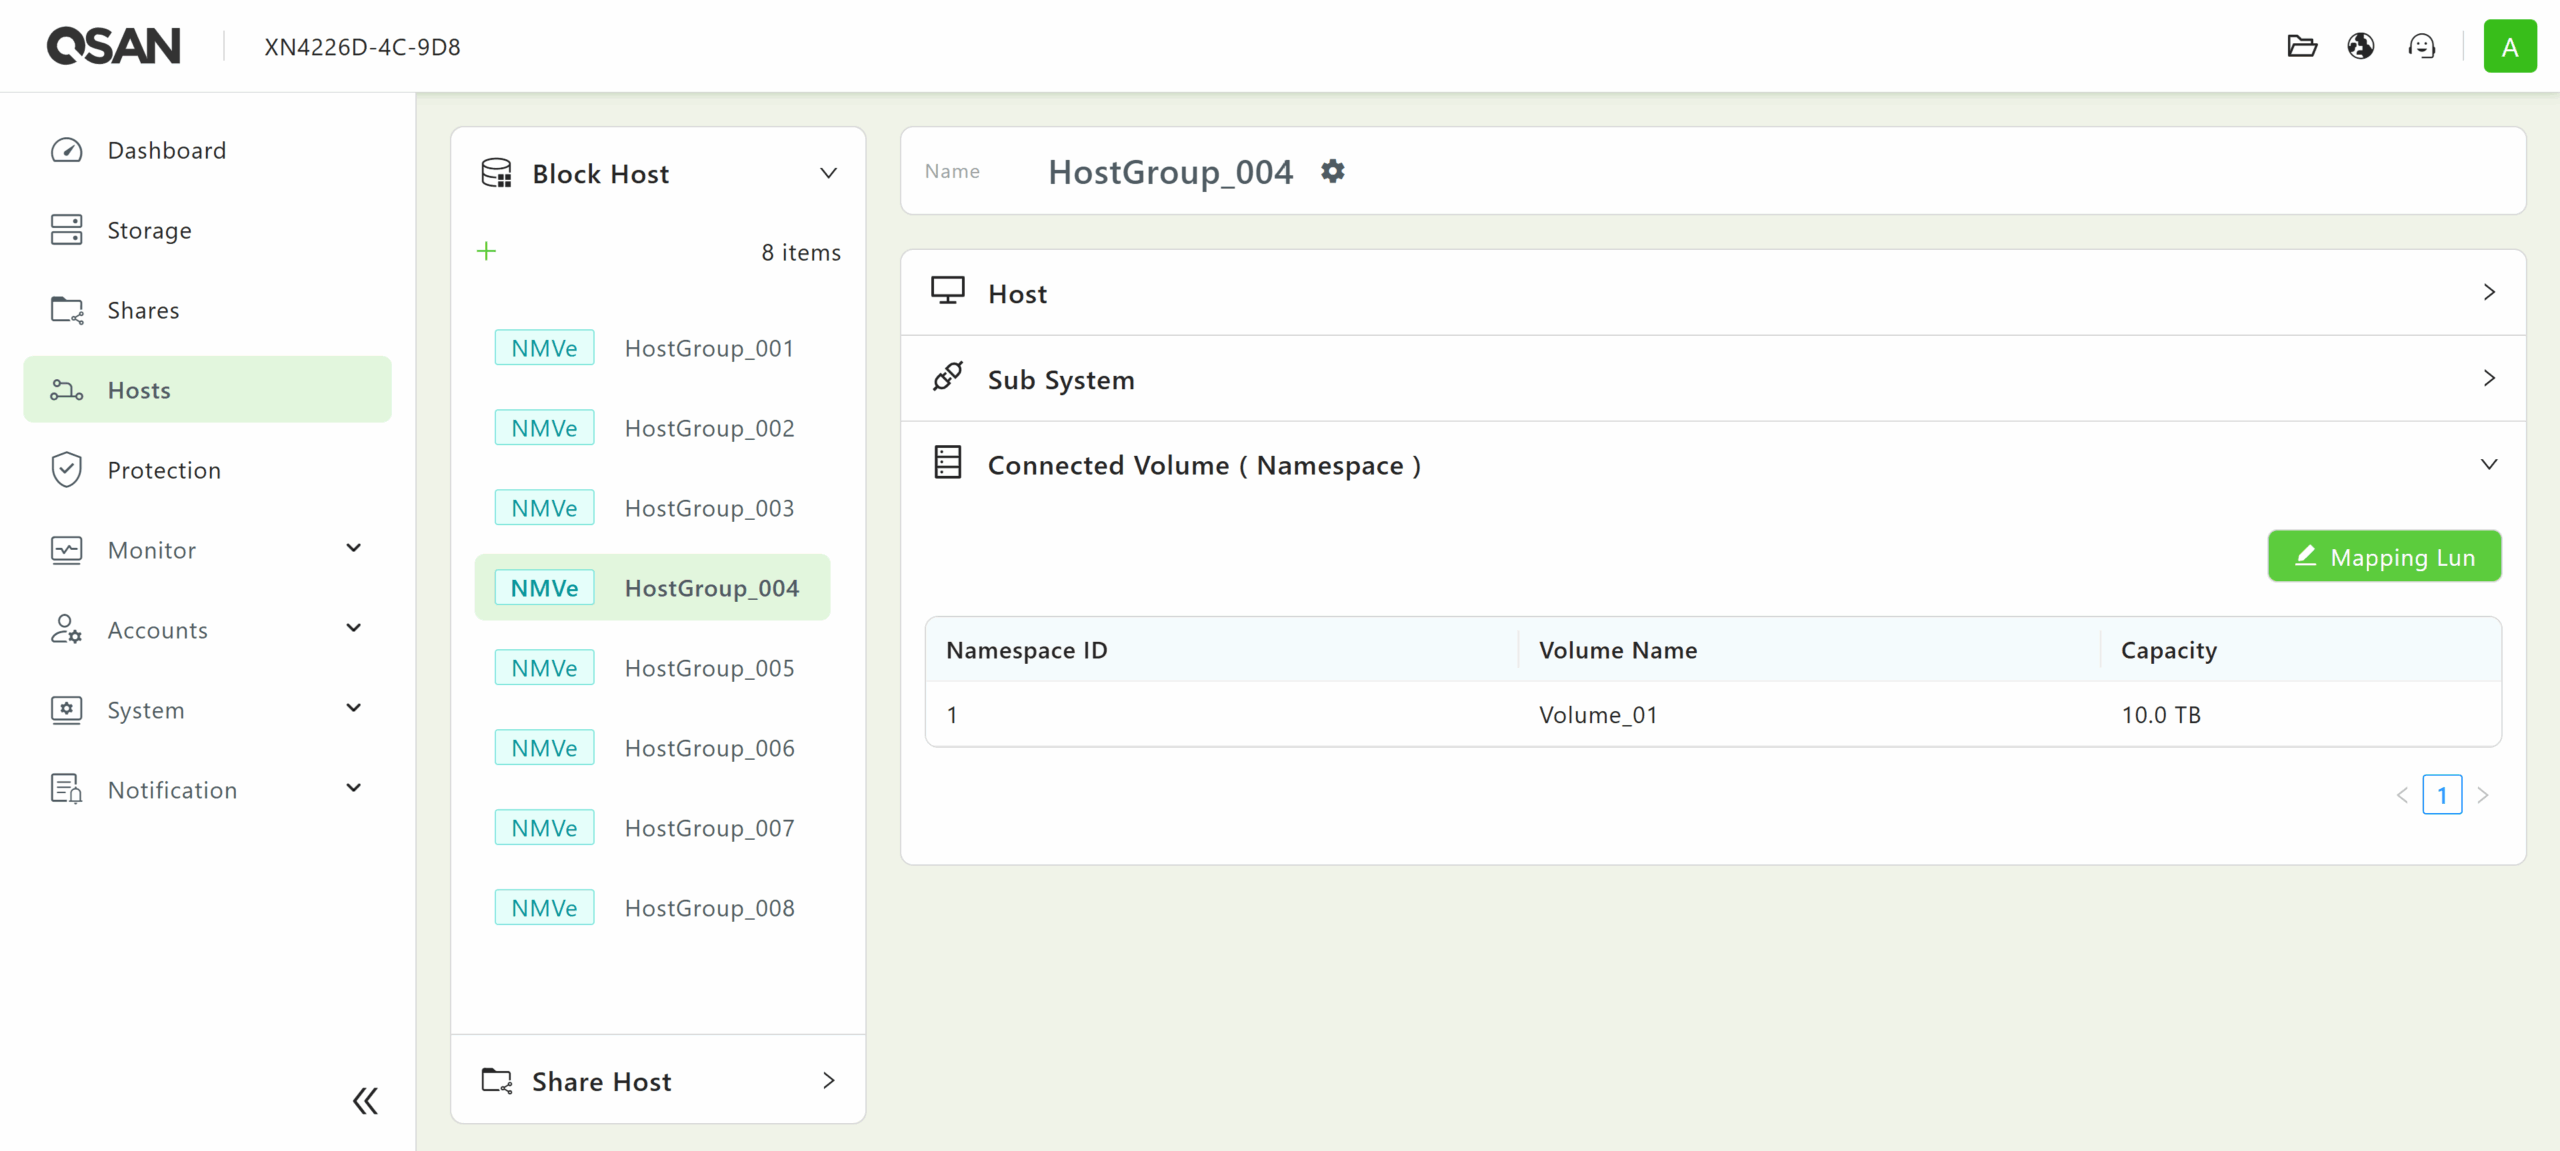
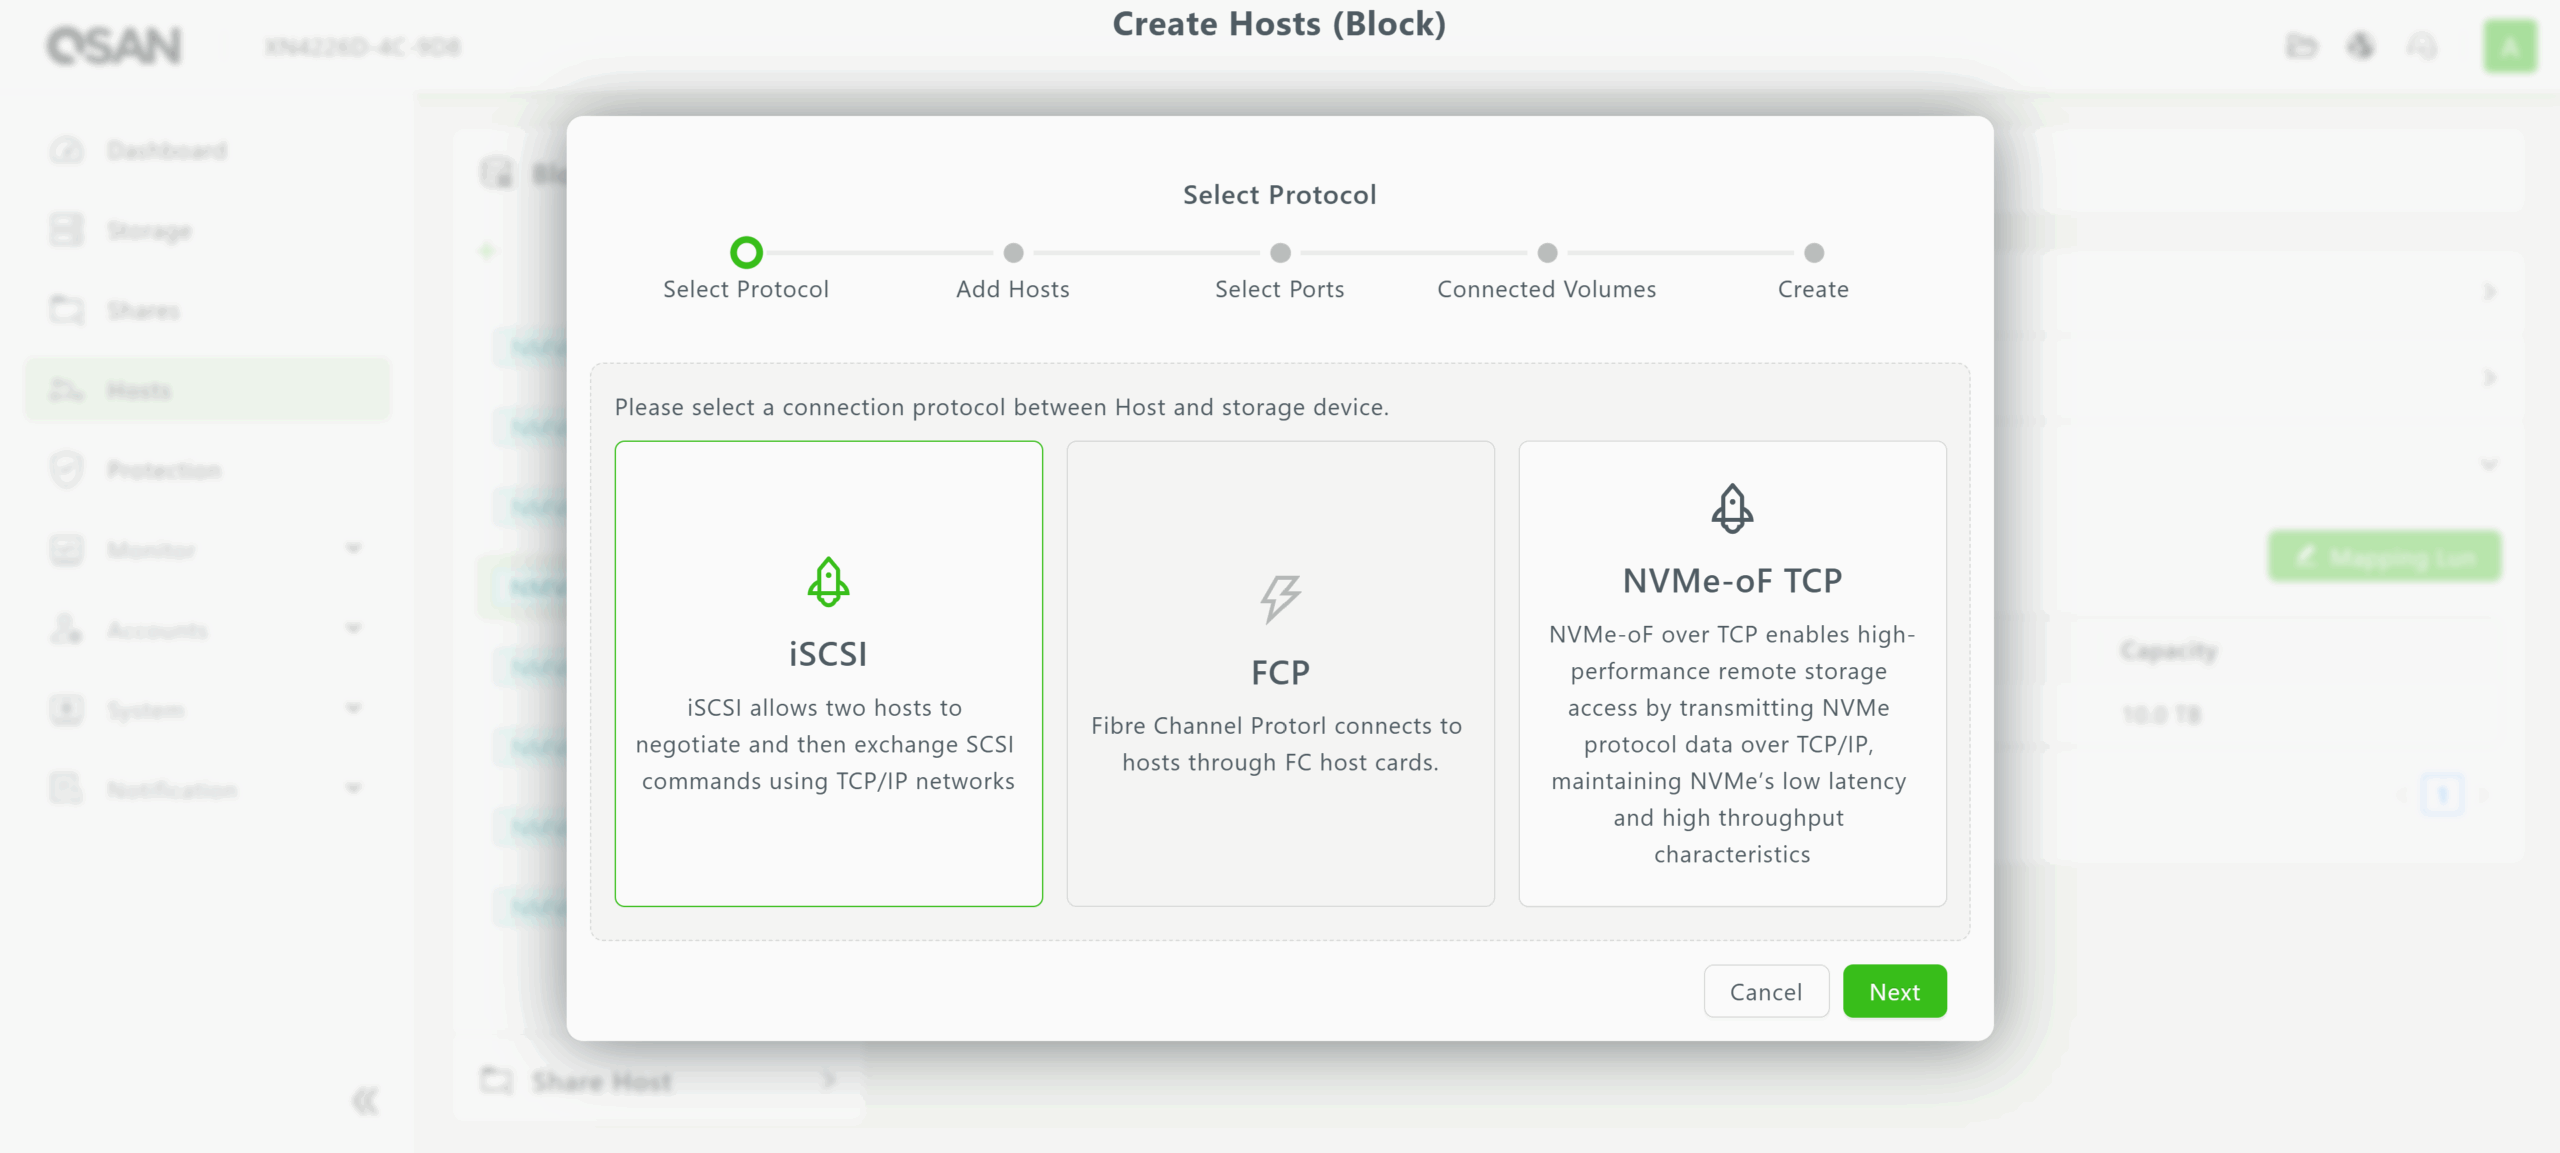
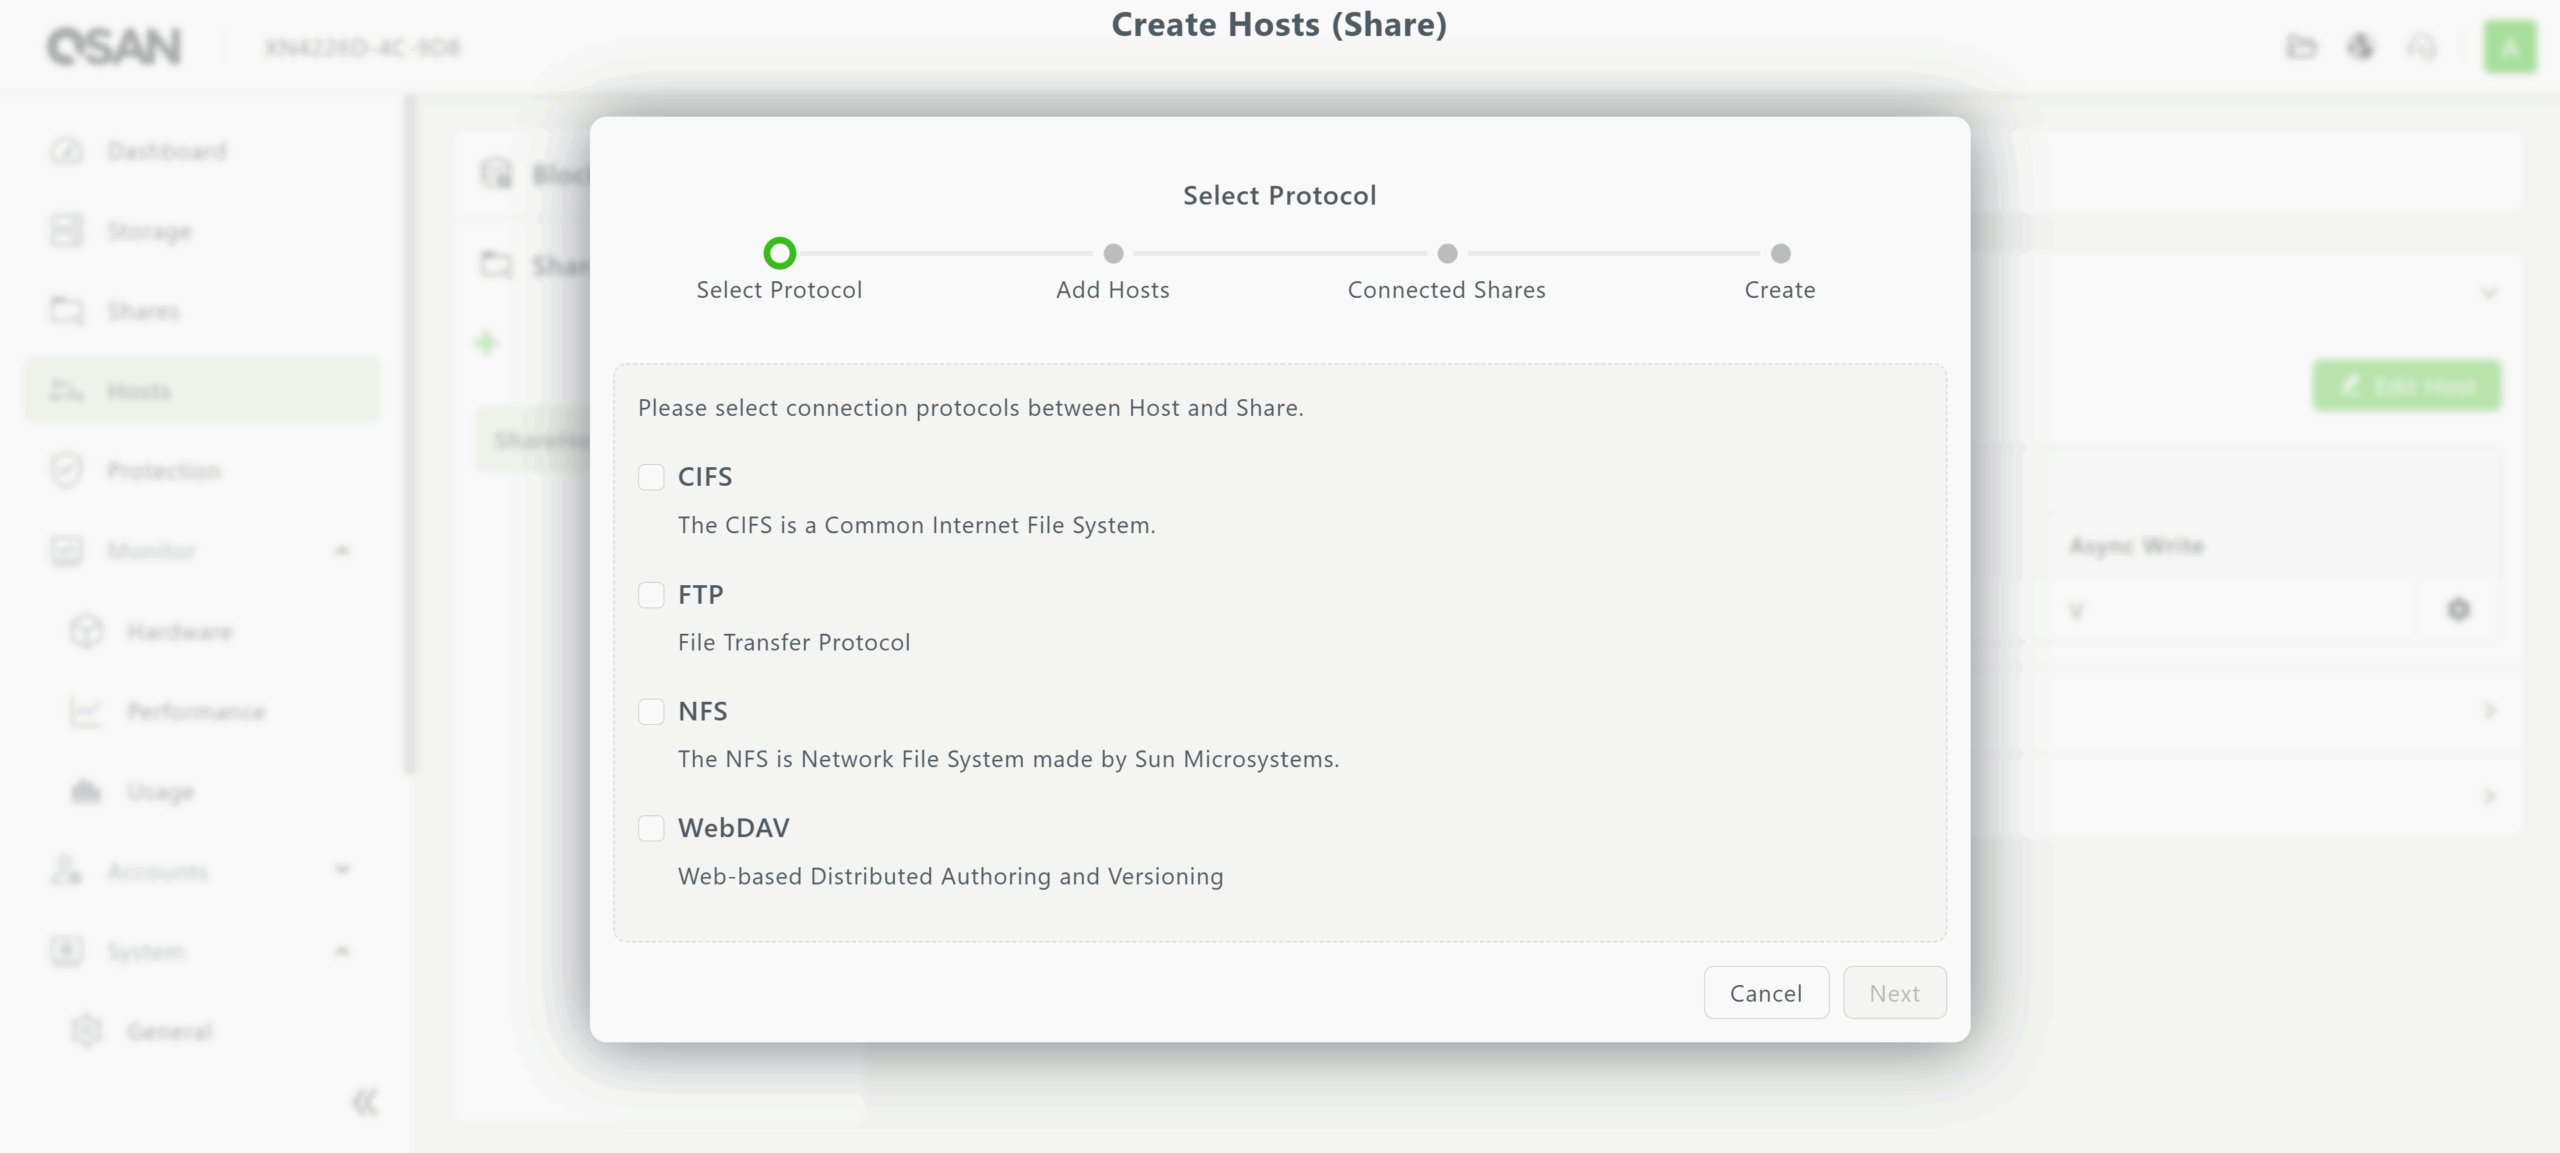
Gli host per l'archiviazione a blocchi possono utilizzare iSCSI, FCP o NVMe-oF su TCP per un volume. Al contrario, gli host per l'archiviazione di file (condivisione) possono supportare più protocolli contemporaneamente, offrendo una flessibilità essenziale per i data center con diversi requisiti di condivisione dei file.
QSM 4 offre inoltre funzionalità di monitoraggio di base nel menu Monitor, visualizzando gli stati di vari moduli hardware e unità all'interno dell'array, nonché statistiche sull'utilizzo di unità, pool di archiviazione, CPU e memoria.
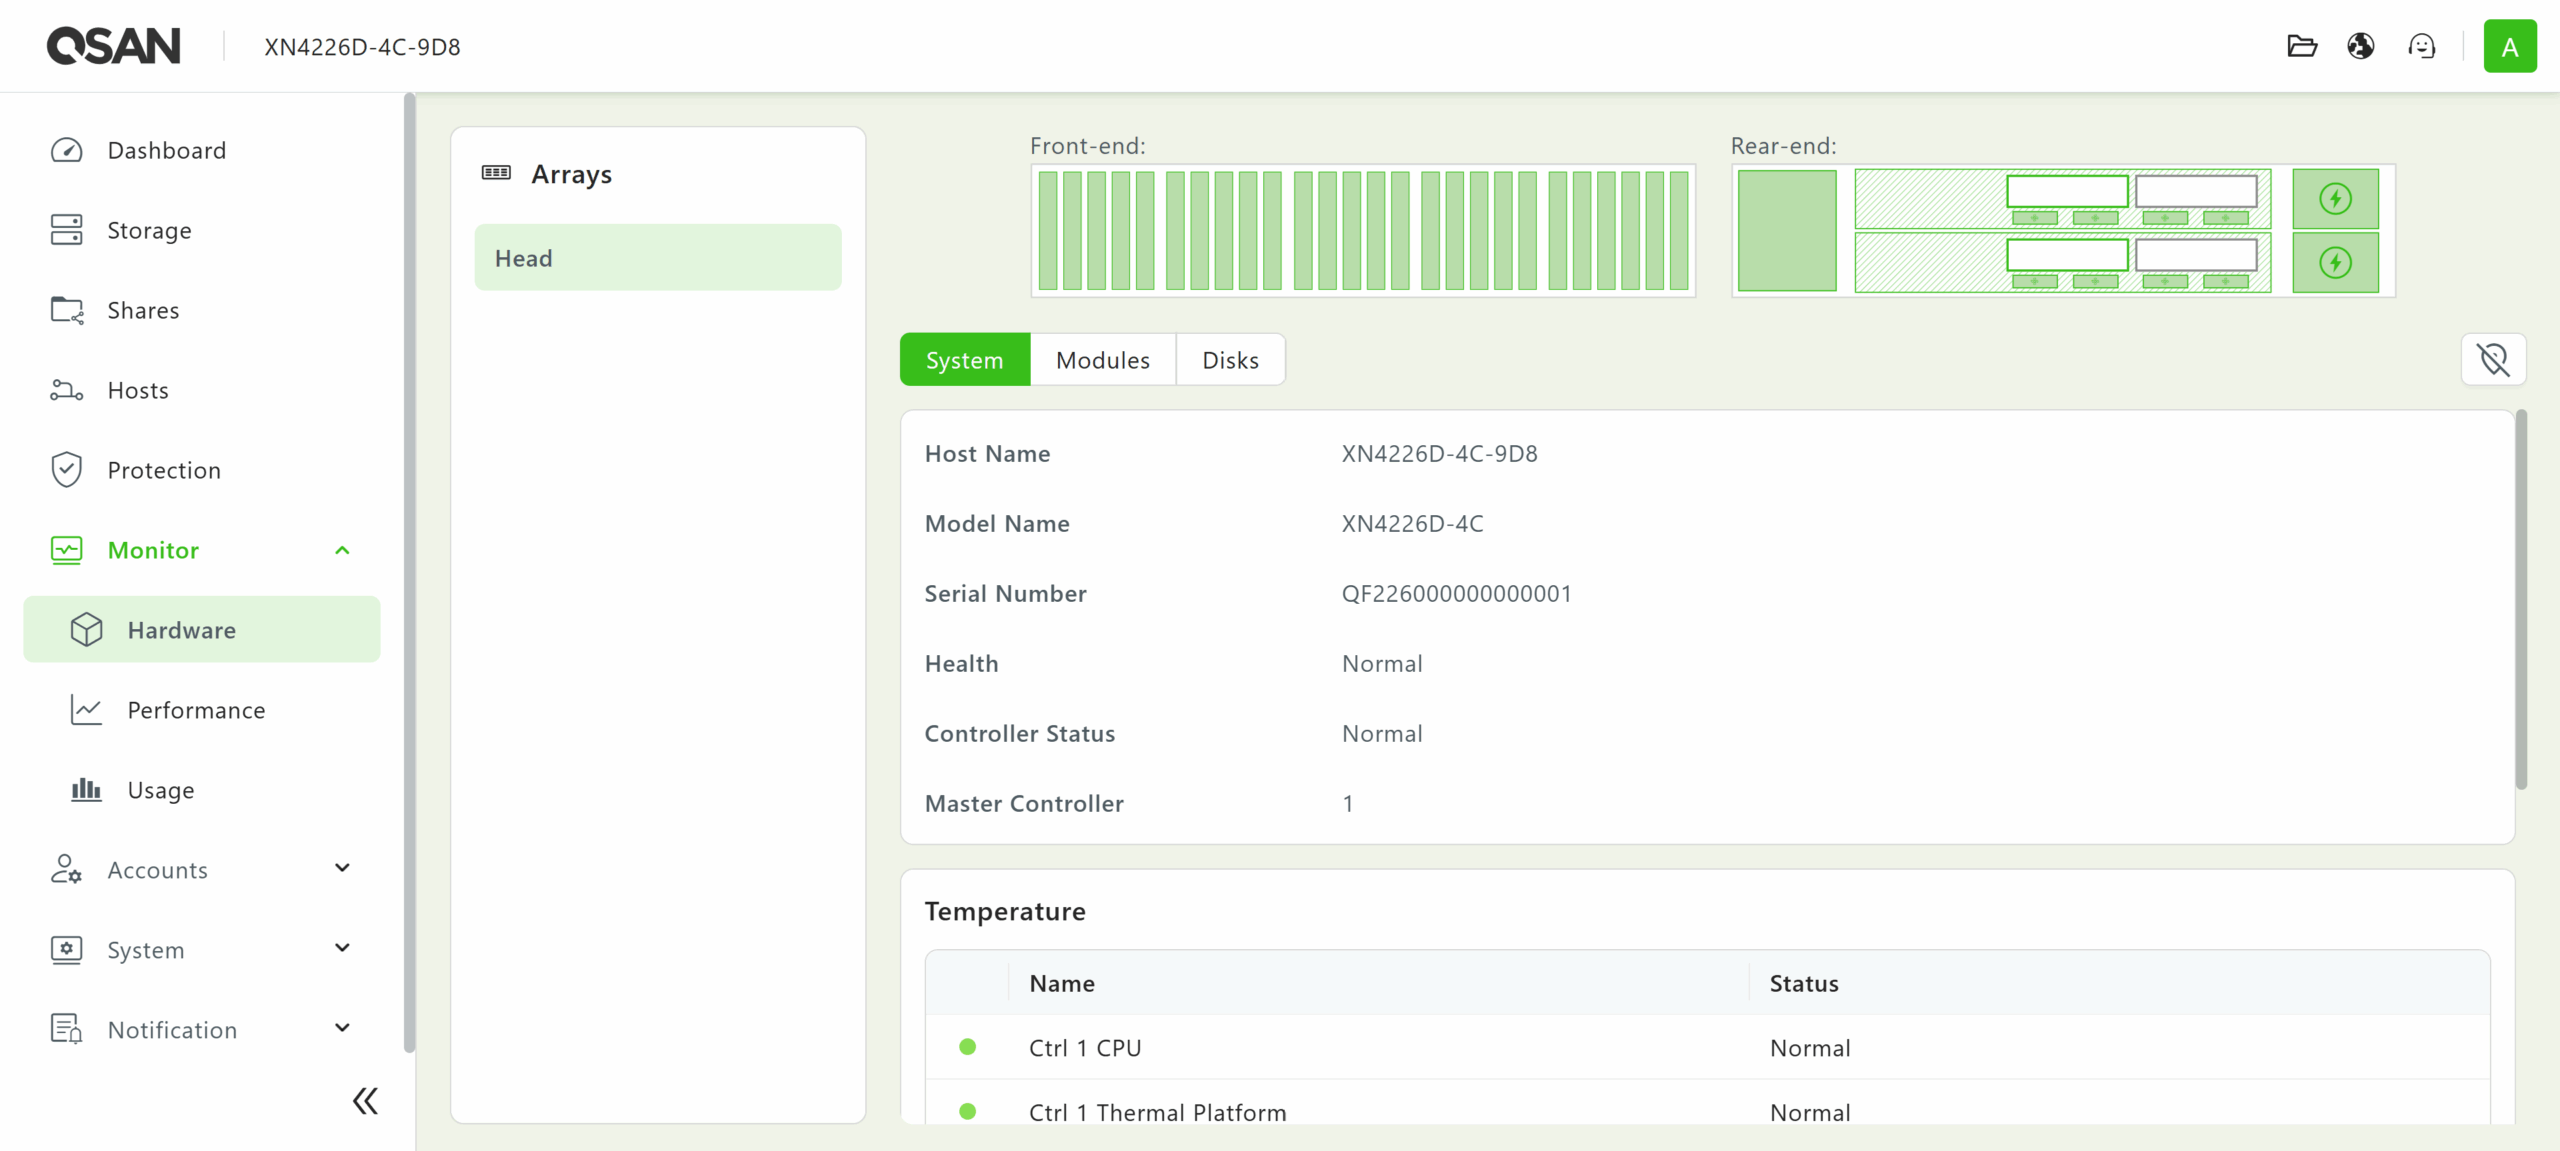
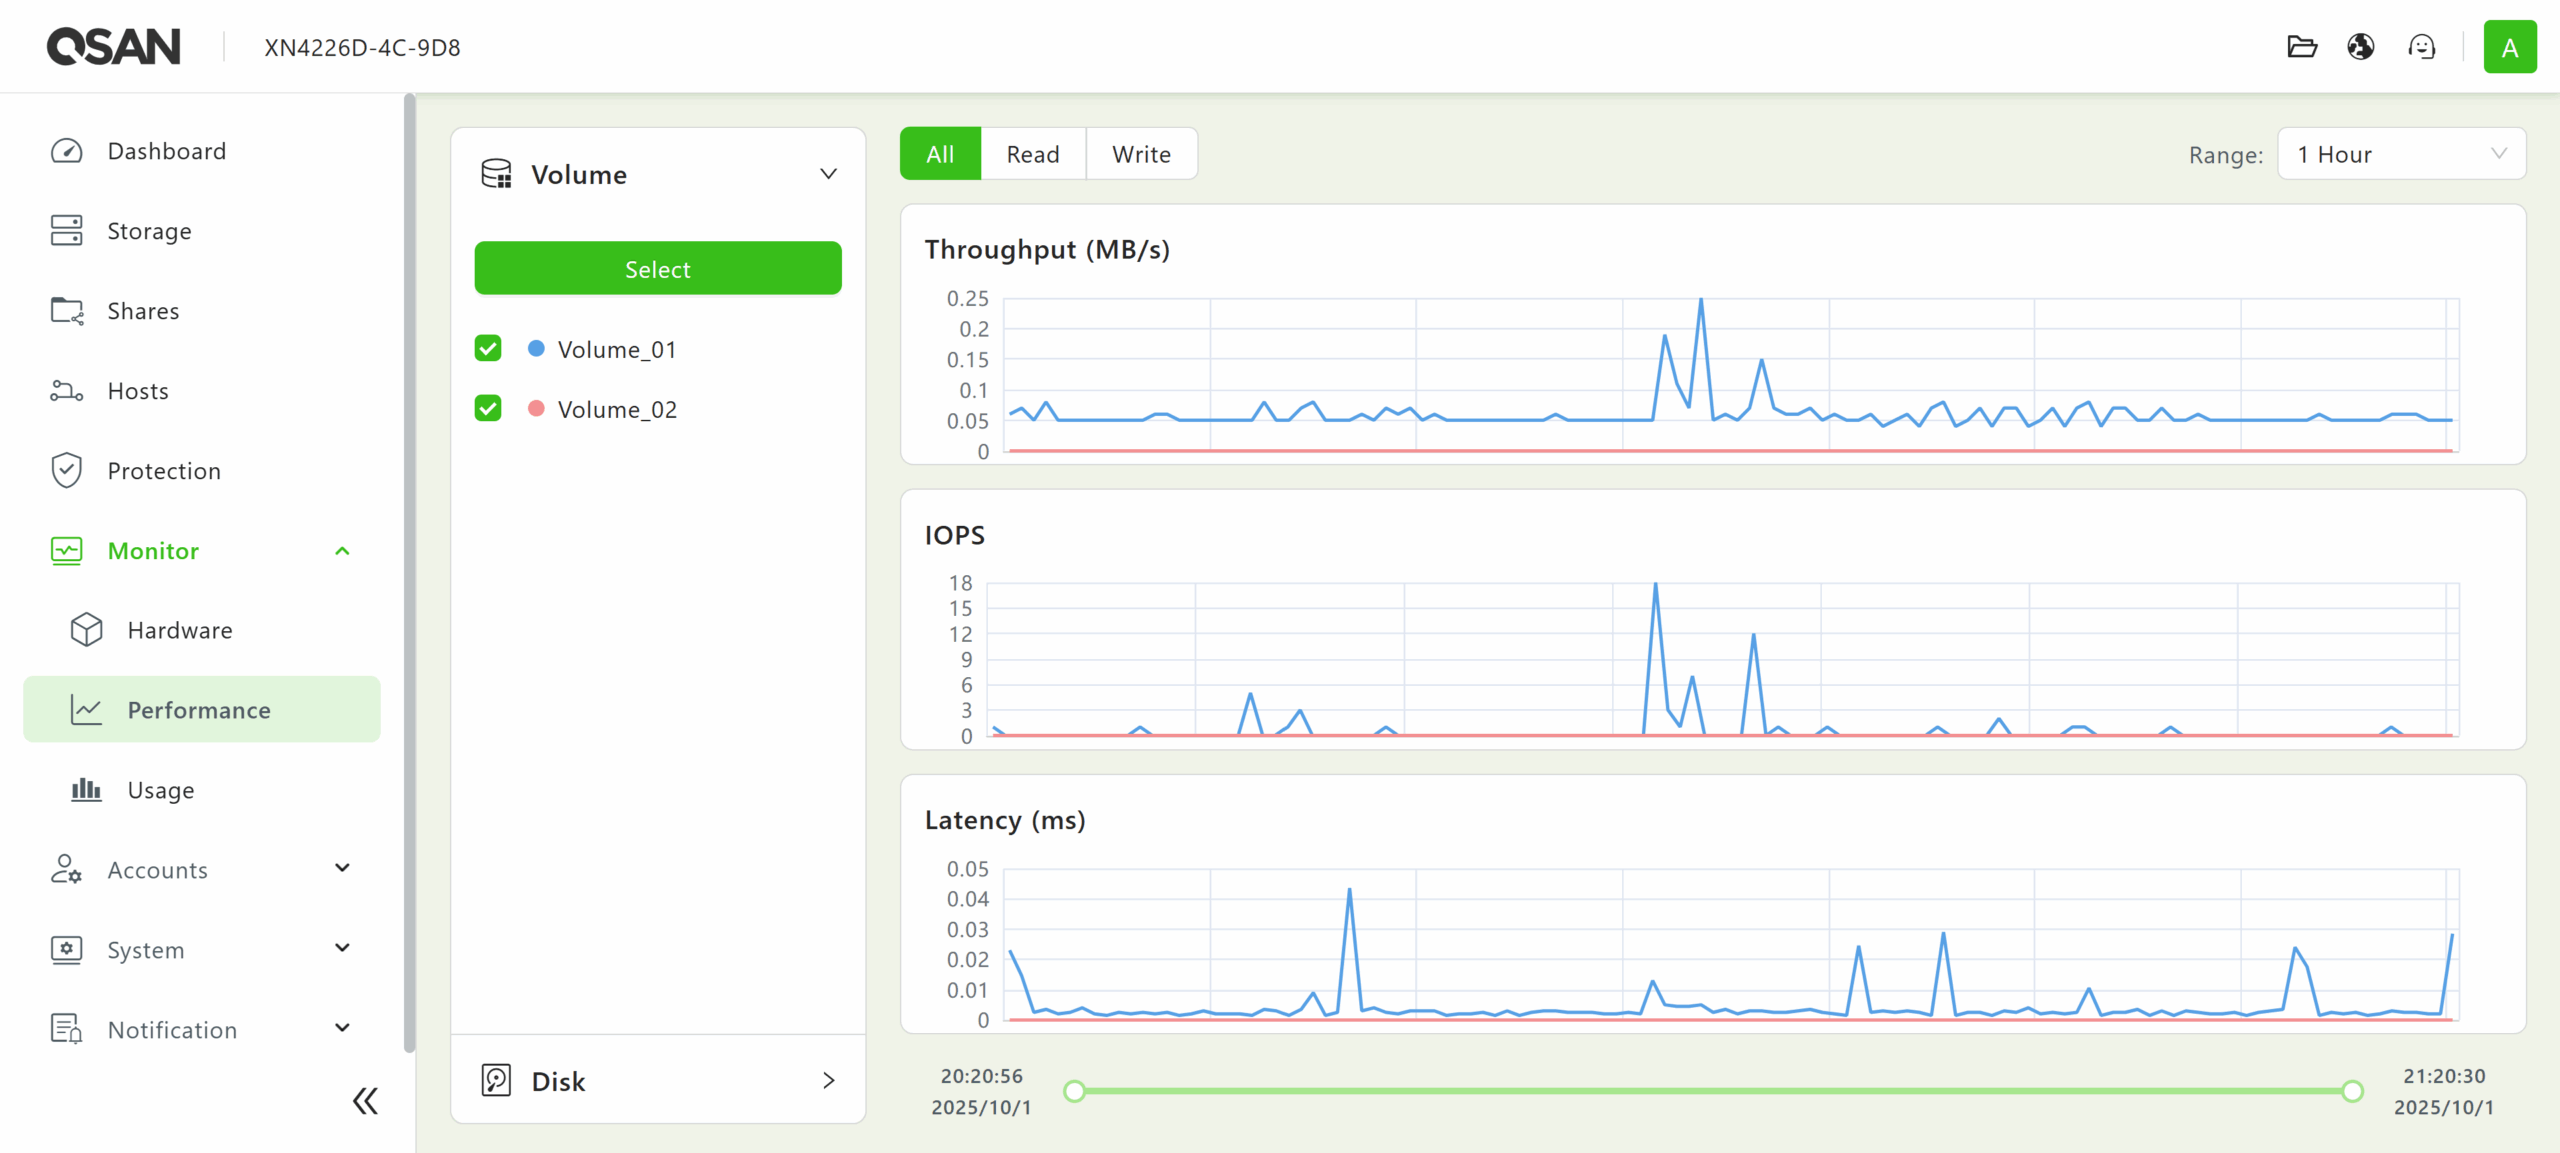
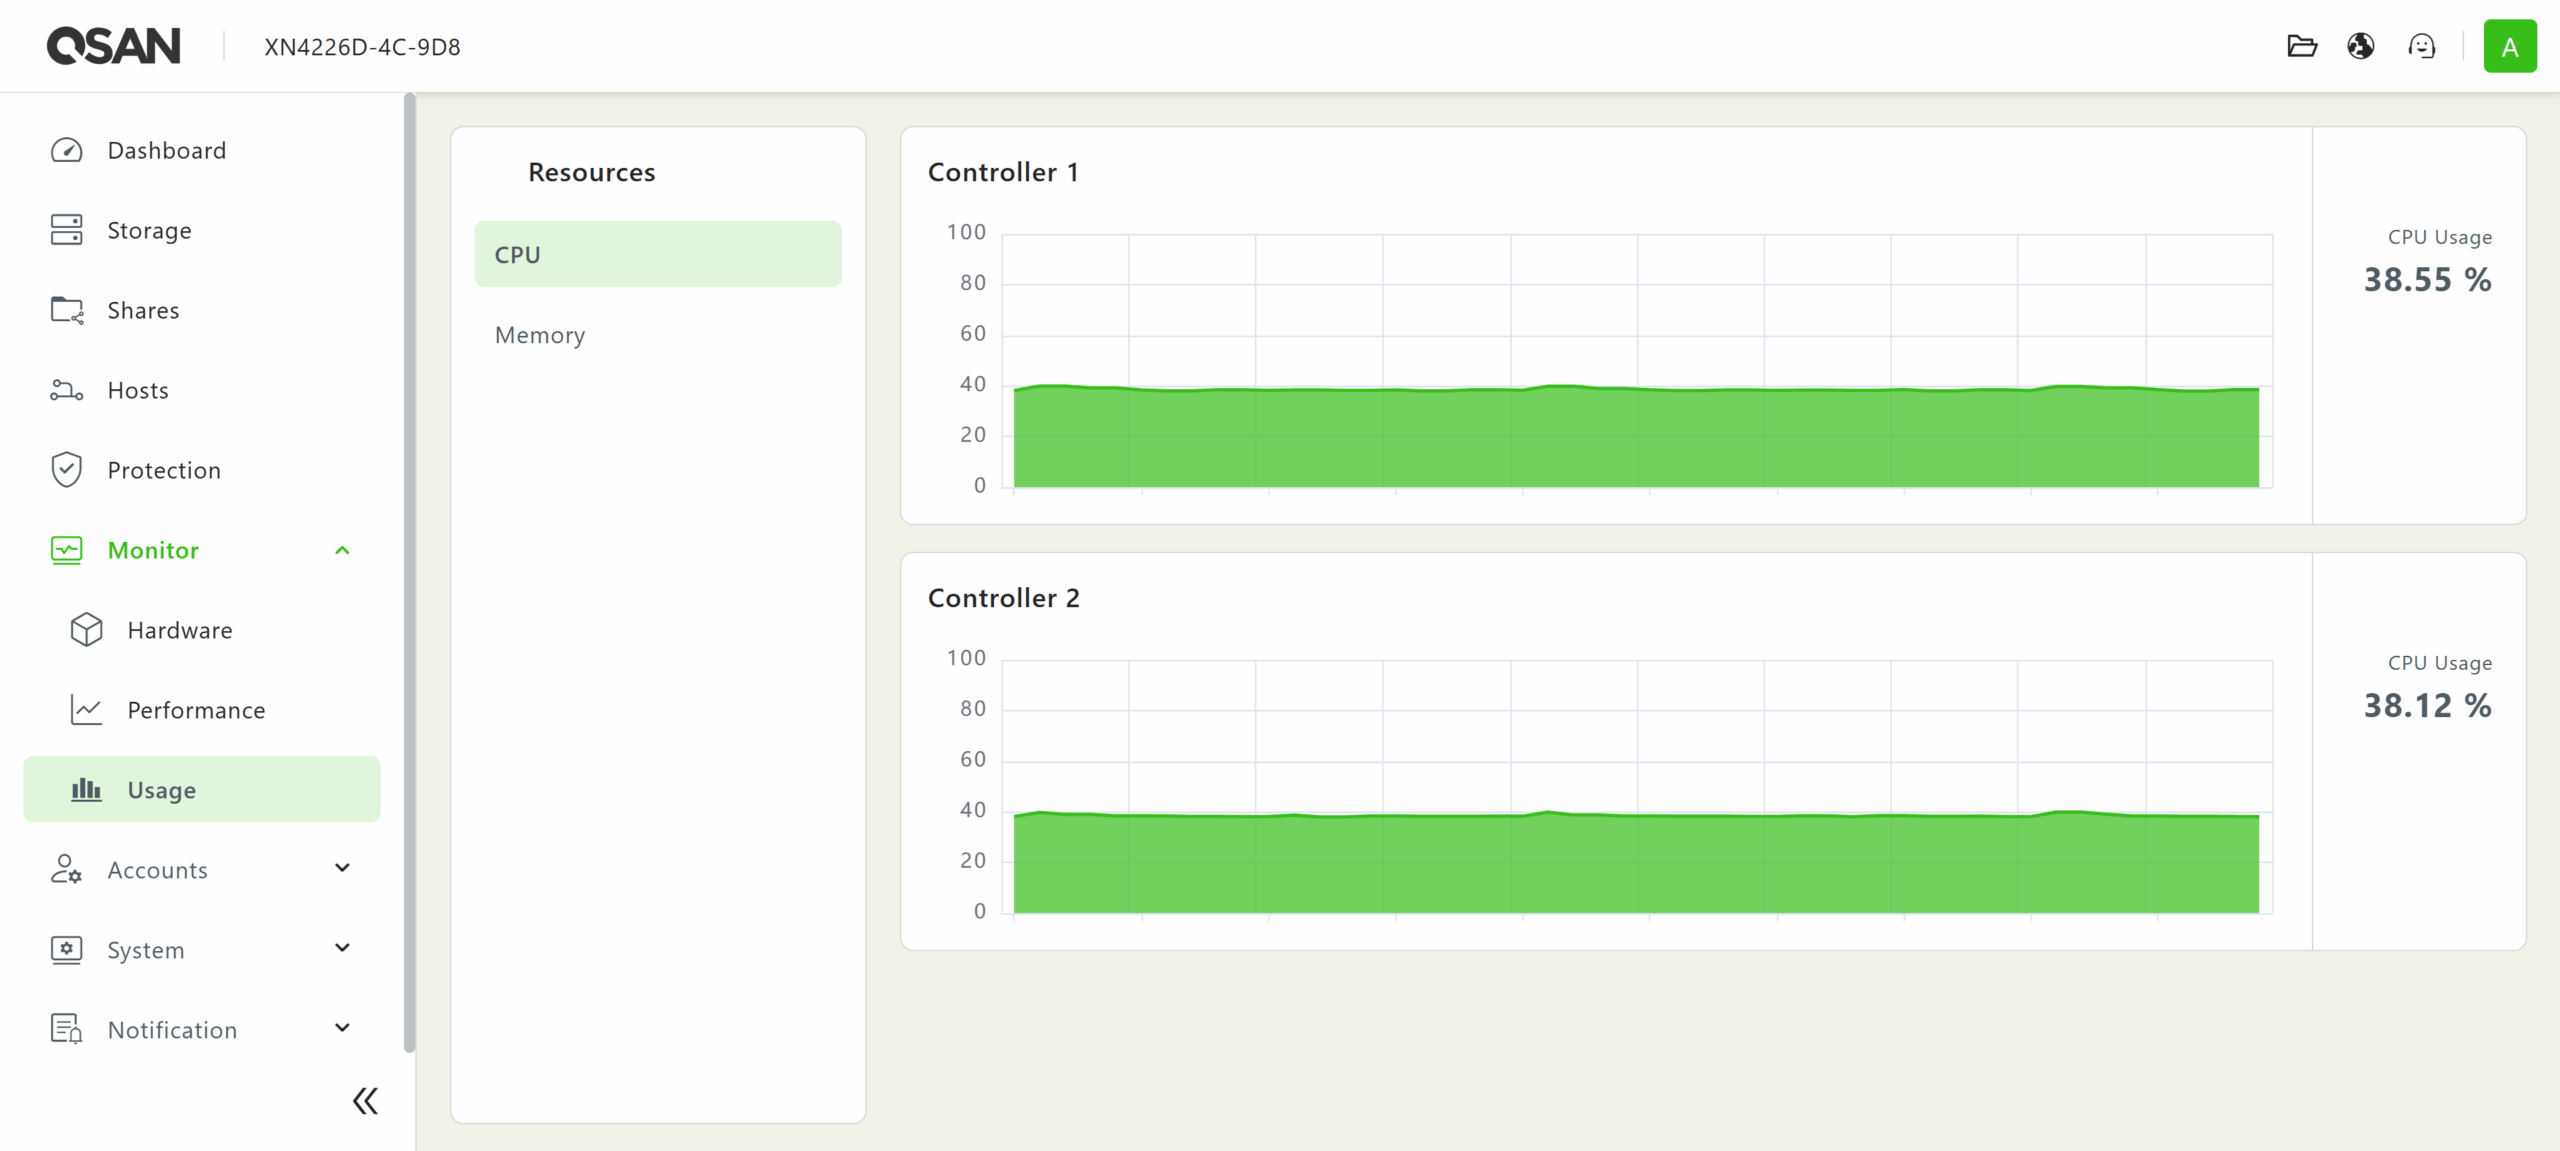
L'interfaccia utente web di QSM 4 offre anche la gestione di utenti, gruppi e domini nel menu Account. Sono inoltre disponibili varie opzioni di configurazione a livello SAN nel menu Sistema. Le funzionalità di registrazione e avviso sono accessibili dal menu Notifiche. Infine, le icone QSAN File Manager, Supporto Lingue e Disconnessione/Gestione Alimentazione si trovano nell'angolo in alto a destra della barra dei menu.
Semplice integrazione Proxmox
Proxmox supporta nativamente NVMe over Fabrics (NVMe-oF), consentendo una facile integrazione di array di storage ad alte prestazioni in un cluster. Il processo inizia con il provisioning dei target NVMe-oF sul sistema di storage. Quindi, si utilizza l'host Proxmox per individuare e connettersi a tali target. Una volta stabilita la connessione, è necessario configurare il sistema per garantire che queste connessioni persistano anche dopo i riavvii.
Nel nostro esempio, la scoperta viene eseguita utilizzando comandi shell, che specificano l'indirizzo IP e la porta di servizio dell'array.
nvme discover -t tcp -a 172.16.16.100 -s 4420
nvme discover -t tcp -a 172.13.13.100 -s 4420
Successivamente, connettiti agli spazi dei nomi forniti facendo riferimento ai loro NQN.
nvme connect -t tcp -n nqn.2024-11.com.qsan:dev4 -a 172.16.16.100 -s 4420
nvme connect -t tcp -n nqn.2024-11.com.qsan:dev6 -a 172.13.13.100 -s 4420
Per garantire che la configurazione sia persistente anche dopo i riavvii, gli indirizzi di individuazione possono essere aggiunti al file di configurazione di individuazione NVMe.
echo "discover -t tcp -a 172.16.16.100 -s 4420" | tee -a /etc/nvme/discovery.conf
echo "discover -t tcp -a 172.13.13.100 -s 4420" | tee -a /etc/nvme/discovery.conf
Infine, abilitare il servizio di connessione automatica in modo che Proxmox ristabilisca automaticamente le sessioni NVMe all'avvio.
systemctl enable nvmf-autoconnect.serviceProxmox può essere integrato perfettamente con l'archiviazione QSAN, offrendo le prestazioni a bassa latenza e ad alta larghezza di banda di NVMe insieme alla flessibilità dei fabric in rete.
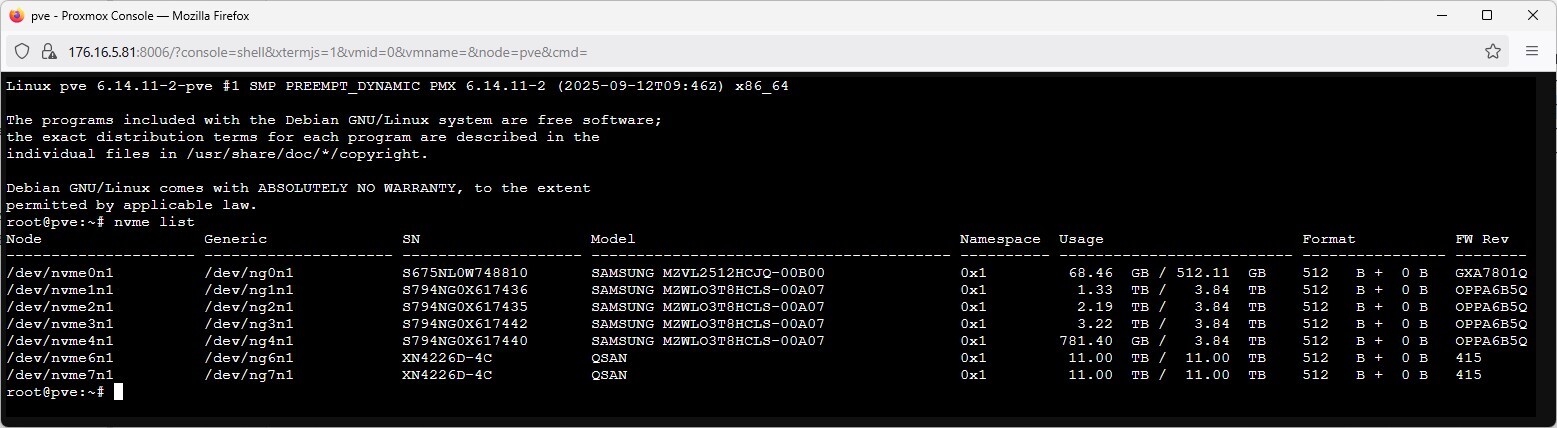
Dopo aver collegato il nostro QSAN, possiamo emettere il comando "nvme list" dalla shell Proxmox per visualizzare tutti i dispositivi NVMe, dove i volumi QSAN appena aggiunti appaiono come /dev/nvme6n1 e /dev/nvme7n1, ciascuno con 11 TB di spazio di archiviazione.
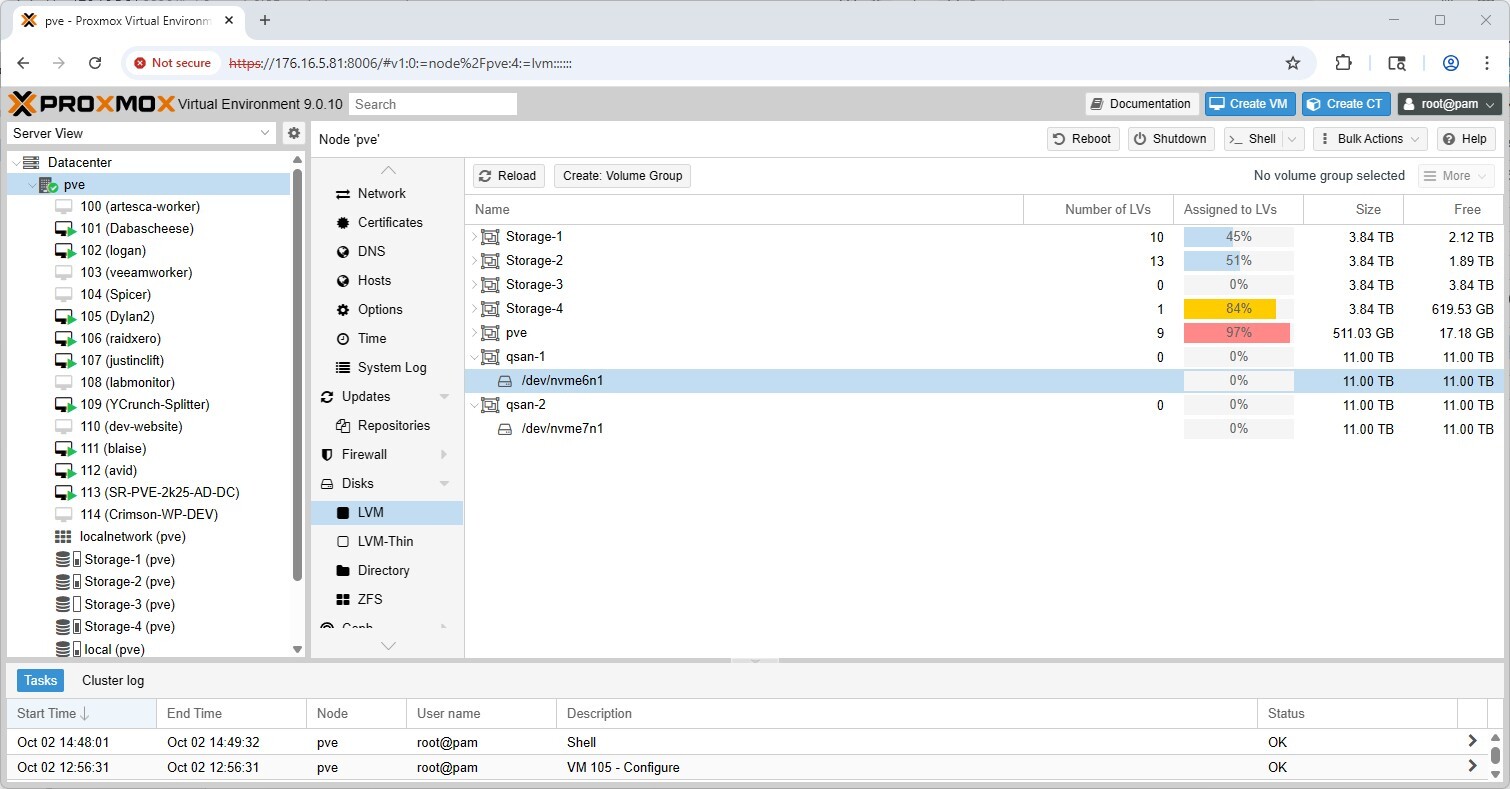
Una volta che l'archiviazione QSAN è visibile nell'interfaccia utente grafica di Proxmox, possiamo creare un nuovo gruppo di volumi LVM: pve > Dischi > LVM, i due dispositivi da 11 TB (/dev/nvme6n1 e /dev/nvme7n1) vengono visualizzati e possono essere inizializzati come gruppi di volumi separati (ad esempio, qsan-1 e qsan-2) per l'utilizzo con VM e container.
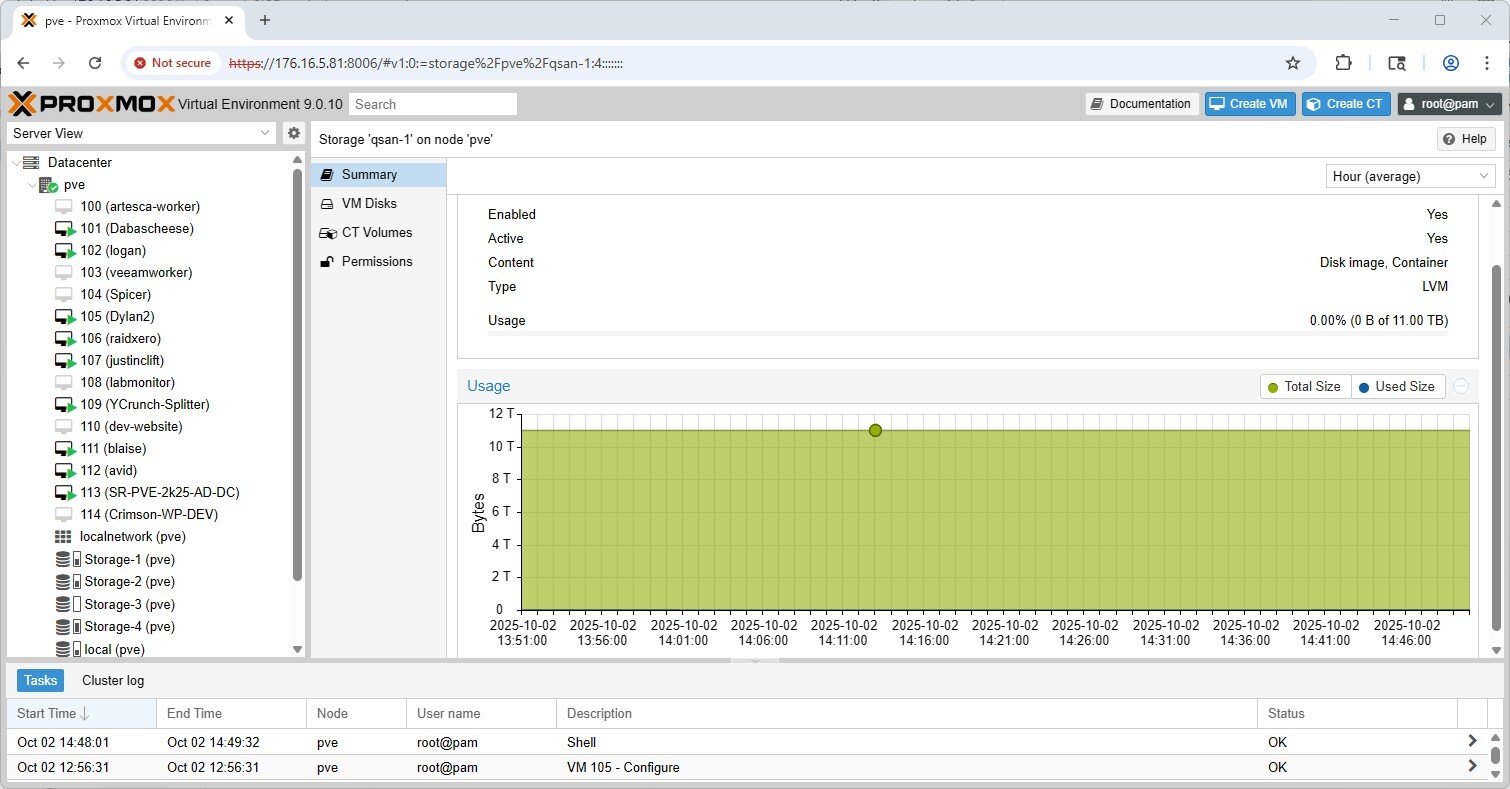
Facendo clic su uno dei nostri nuovi pool LVM (qsan-1) nel riquadro di archiviazione, è possibile verificare che sia online, abilitato e disponibile per l'uso, con la capacità completa di 11 TB e pronto per il provisioning di VM e container.
Test di Performance
Abbiamo testato il QSAN XN4226D in due ambienti, sfruttando diverse piattaforme di test. Il nostro primo ambiente era basato su un Dell PowerEdge R750, dotato di 4 schede di rete NVIDIA ConnectX-5 dual-port 25G. Abbiamo collegato direttamente il QSAN XN4226D a questo server utilizzando otto cavi DAC. Questa configurazione ha sfruttato tutte le porte di rete disponibili sul QSAN, consentendoci di evidenziare le sue massime prestazioni.
Per il test FIO, abbiamo utilizzato due pool di storage RAID6, creando otto volumi a blocchi distribuiti uniformemente su entrambi i controller. Ogni volume è stato assegnato a un target univoco, dedicando un singolo indirizzo IP a ciascun volume. Su questa piattaforma abbiamo misurato sia RDMA NVMe-oF che TCP.
Il secondo ambiente per GDSIO sfruttava un Dell PowerEdge R7715, dotato di due GPU NVIDIA H100 e una scheda di rete Broadcom 25G a quattro porte. In questo ambiente, abbiamo mantenuto lo stesso layout dei volumi QSAN, sebbene ne abbiamo ridotto il numero da otto a quattro. Con una scheda di rete a quattro porte, abbiamo utilizzato quattro connessioni 25G per collegare direttamente il server all'array di storage.
Benchmark delle prestazioni FIO
Per misurare le prestazioni di storage del QSAN XN4226D, abbiamo applicato metriche comuni del settore e utilizzato lo strumento FIO. Ogni dispositivo di storage viene sottoposto allo stesso processo di test, che include una fase di precondizionamento che prevede due riempimenti completi dell'unità con un carico di lavoro di scrittura sequenziale, seguita dalla misurazione delle prestazioni in stato stazionario. Al variare del tipo di carico di lavoro misurato, eseguiamo un altro riempimento di precondizionamento con la nuova dimensione di trasferimento.
In questa sezione ci concentreremo sui seguenti benchmark FIO:
- 1M sequenziale
- 64K casuale
- 16K casuale
- 4K casuale
Larghezza di banda di scrittura sequenziale 1M
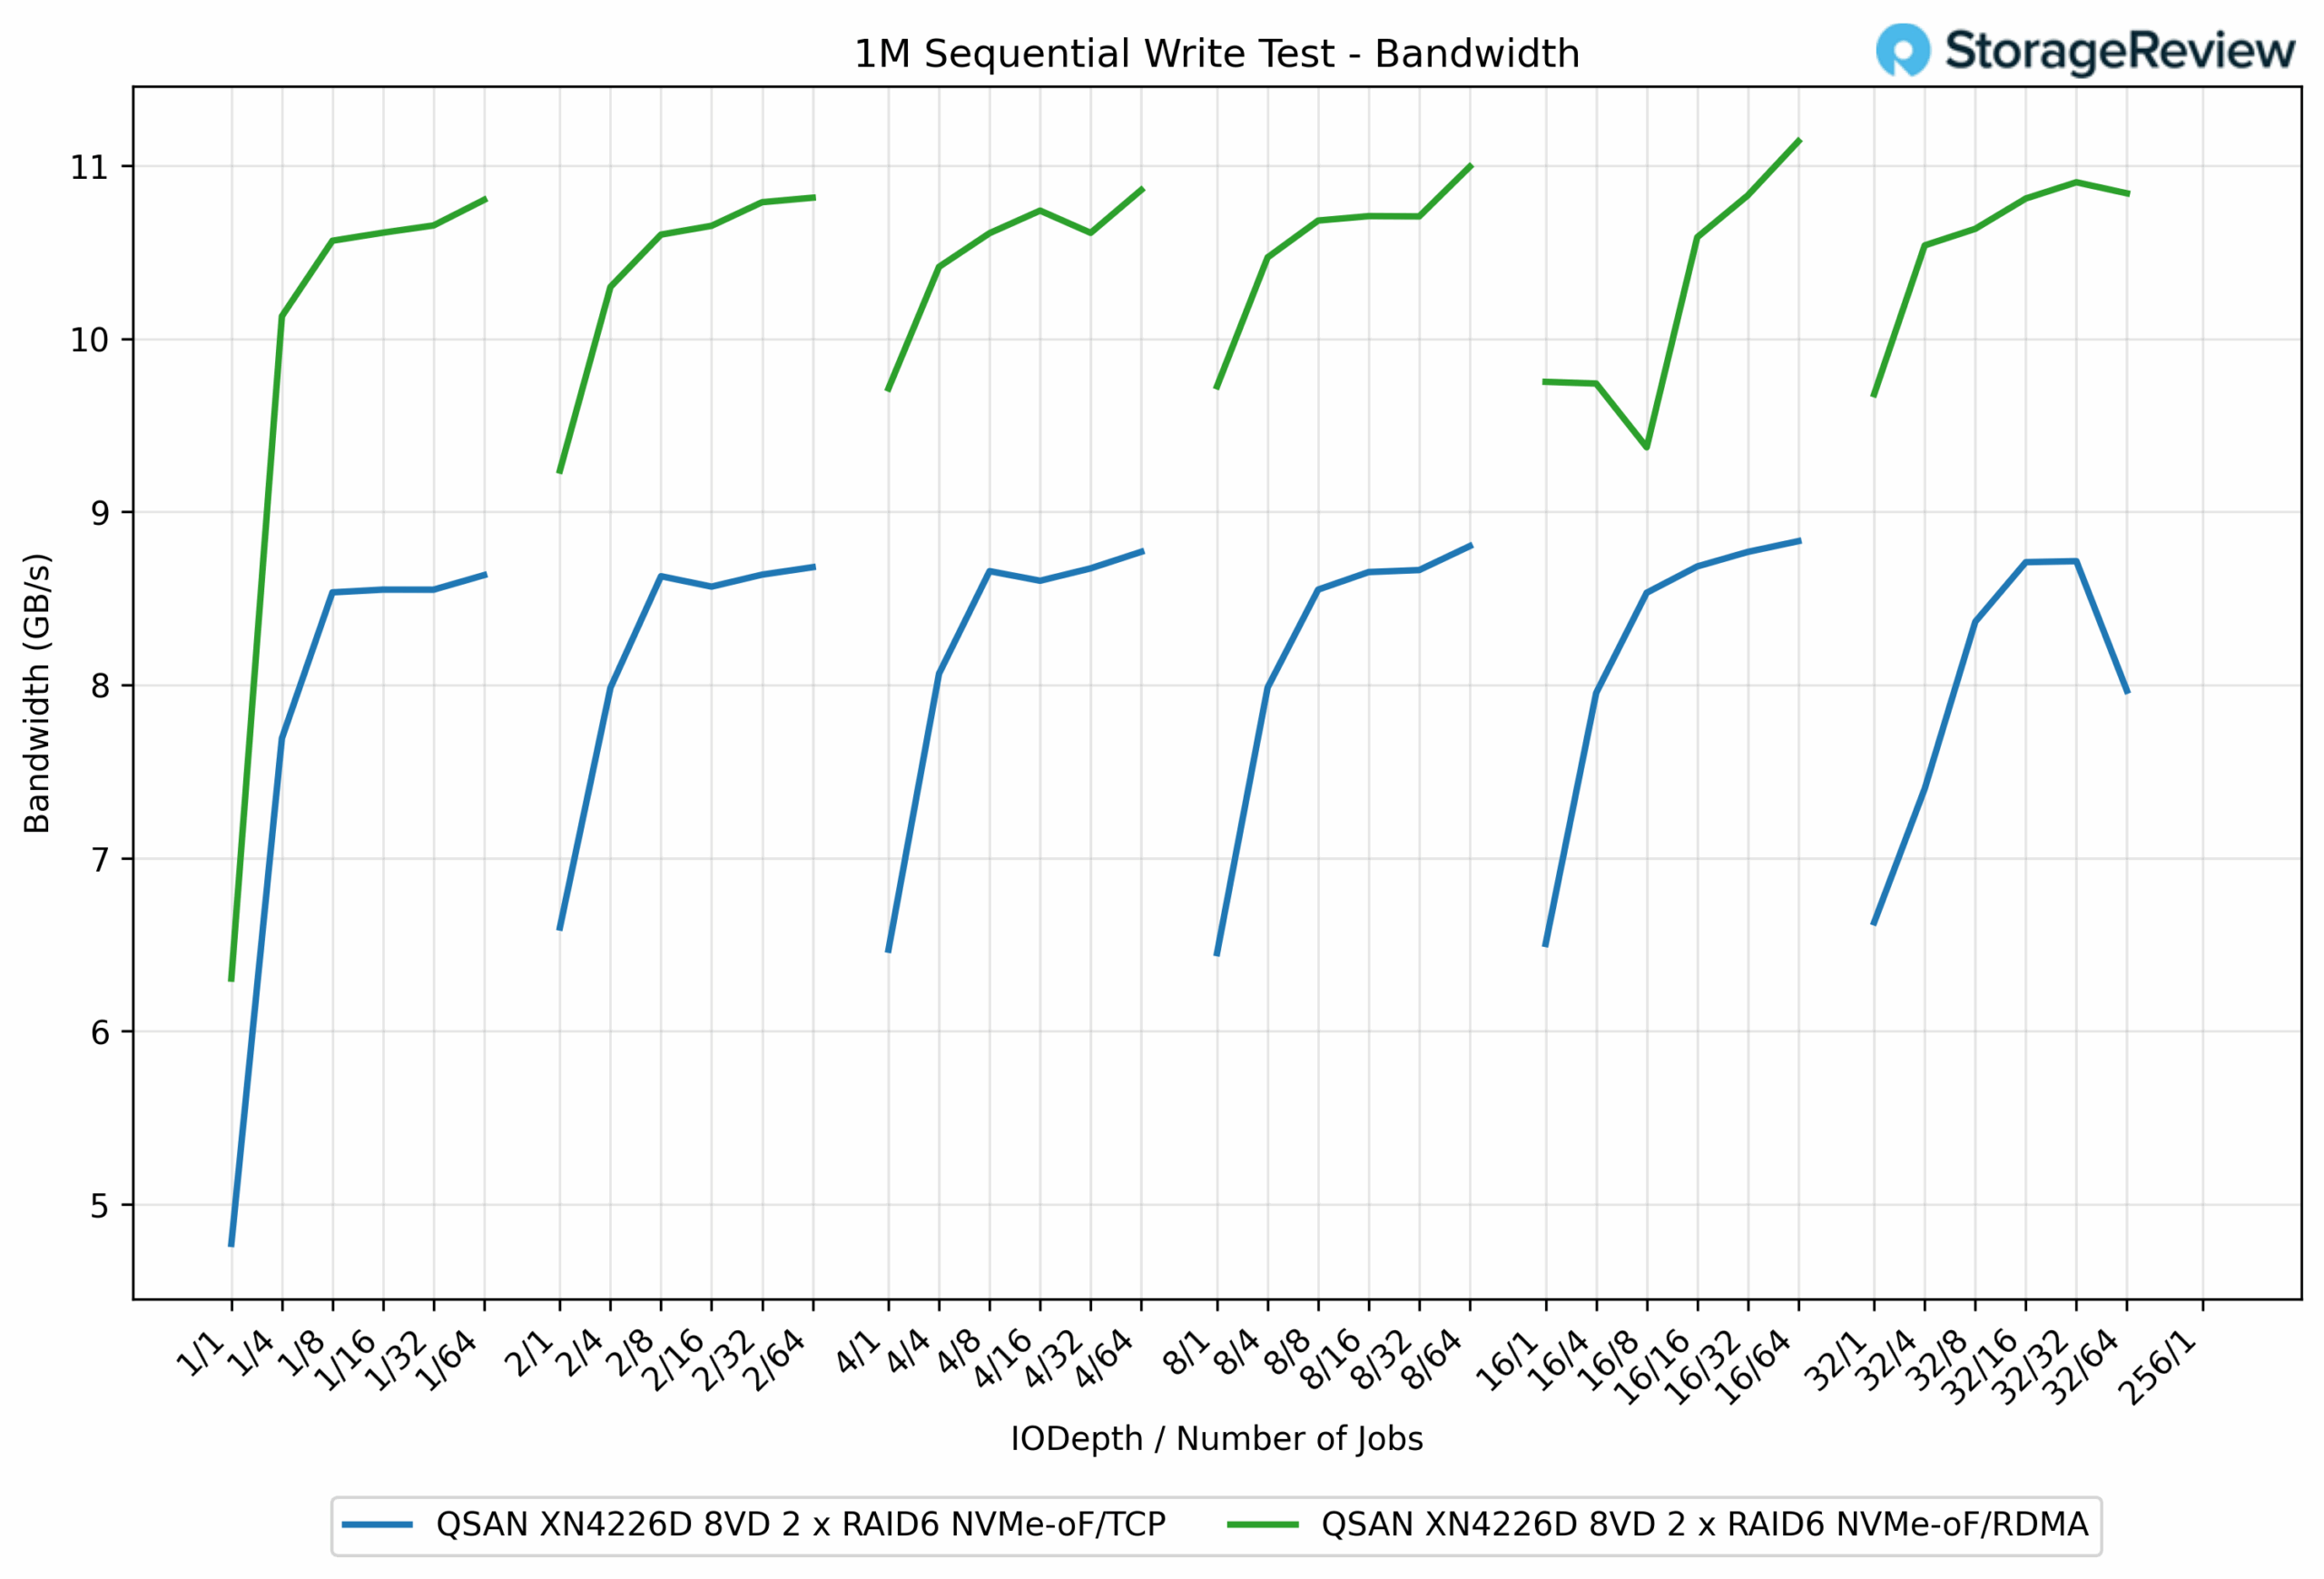
Nel test di scrittura sequenziale 1M, NVMe su RDMA ha costantemente offerto una larghezza di banda maggiore su quasi tutte le profondità di coda e il numero di job rispetto a NVMe su TCP. Al picco, RDMA ha raggiunto 11.14 GB/s, mentre TCP ha raggiunto un massimo di 8.83 GB/s, con una differenza di circa il 26% a favore di RDMA. Anche a profondità di coda inferiori, RDMA ha mantenuto il suo vantaggio. Ad esempio, nel job QD1/1, ha raggiunto 6.30 GB/s, superando di circa il 32% i 4.77 GB/s di TCP.
Il divario prestazionale tra i due protocolli si è ridotto leggermente con l'aumento dei carichi di lavoro, ma RDMA ha comunque dimostrato un chiaro vantaggio. TCP si è costantemente attestato nell'intervallo tra 8.5 e 8.8 GB/s in diversi punti di test, mentre RDMA ha spesso superato la soglia dei 10.5 GB/s, raggiungendo un picco di poco superiore a 11 GB/s.
Latenza di scrittura sequenziale 1M
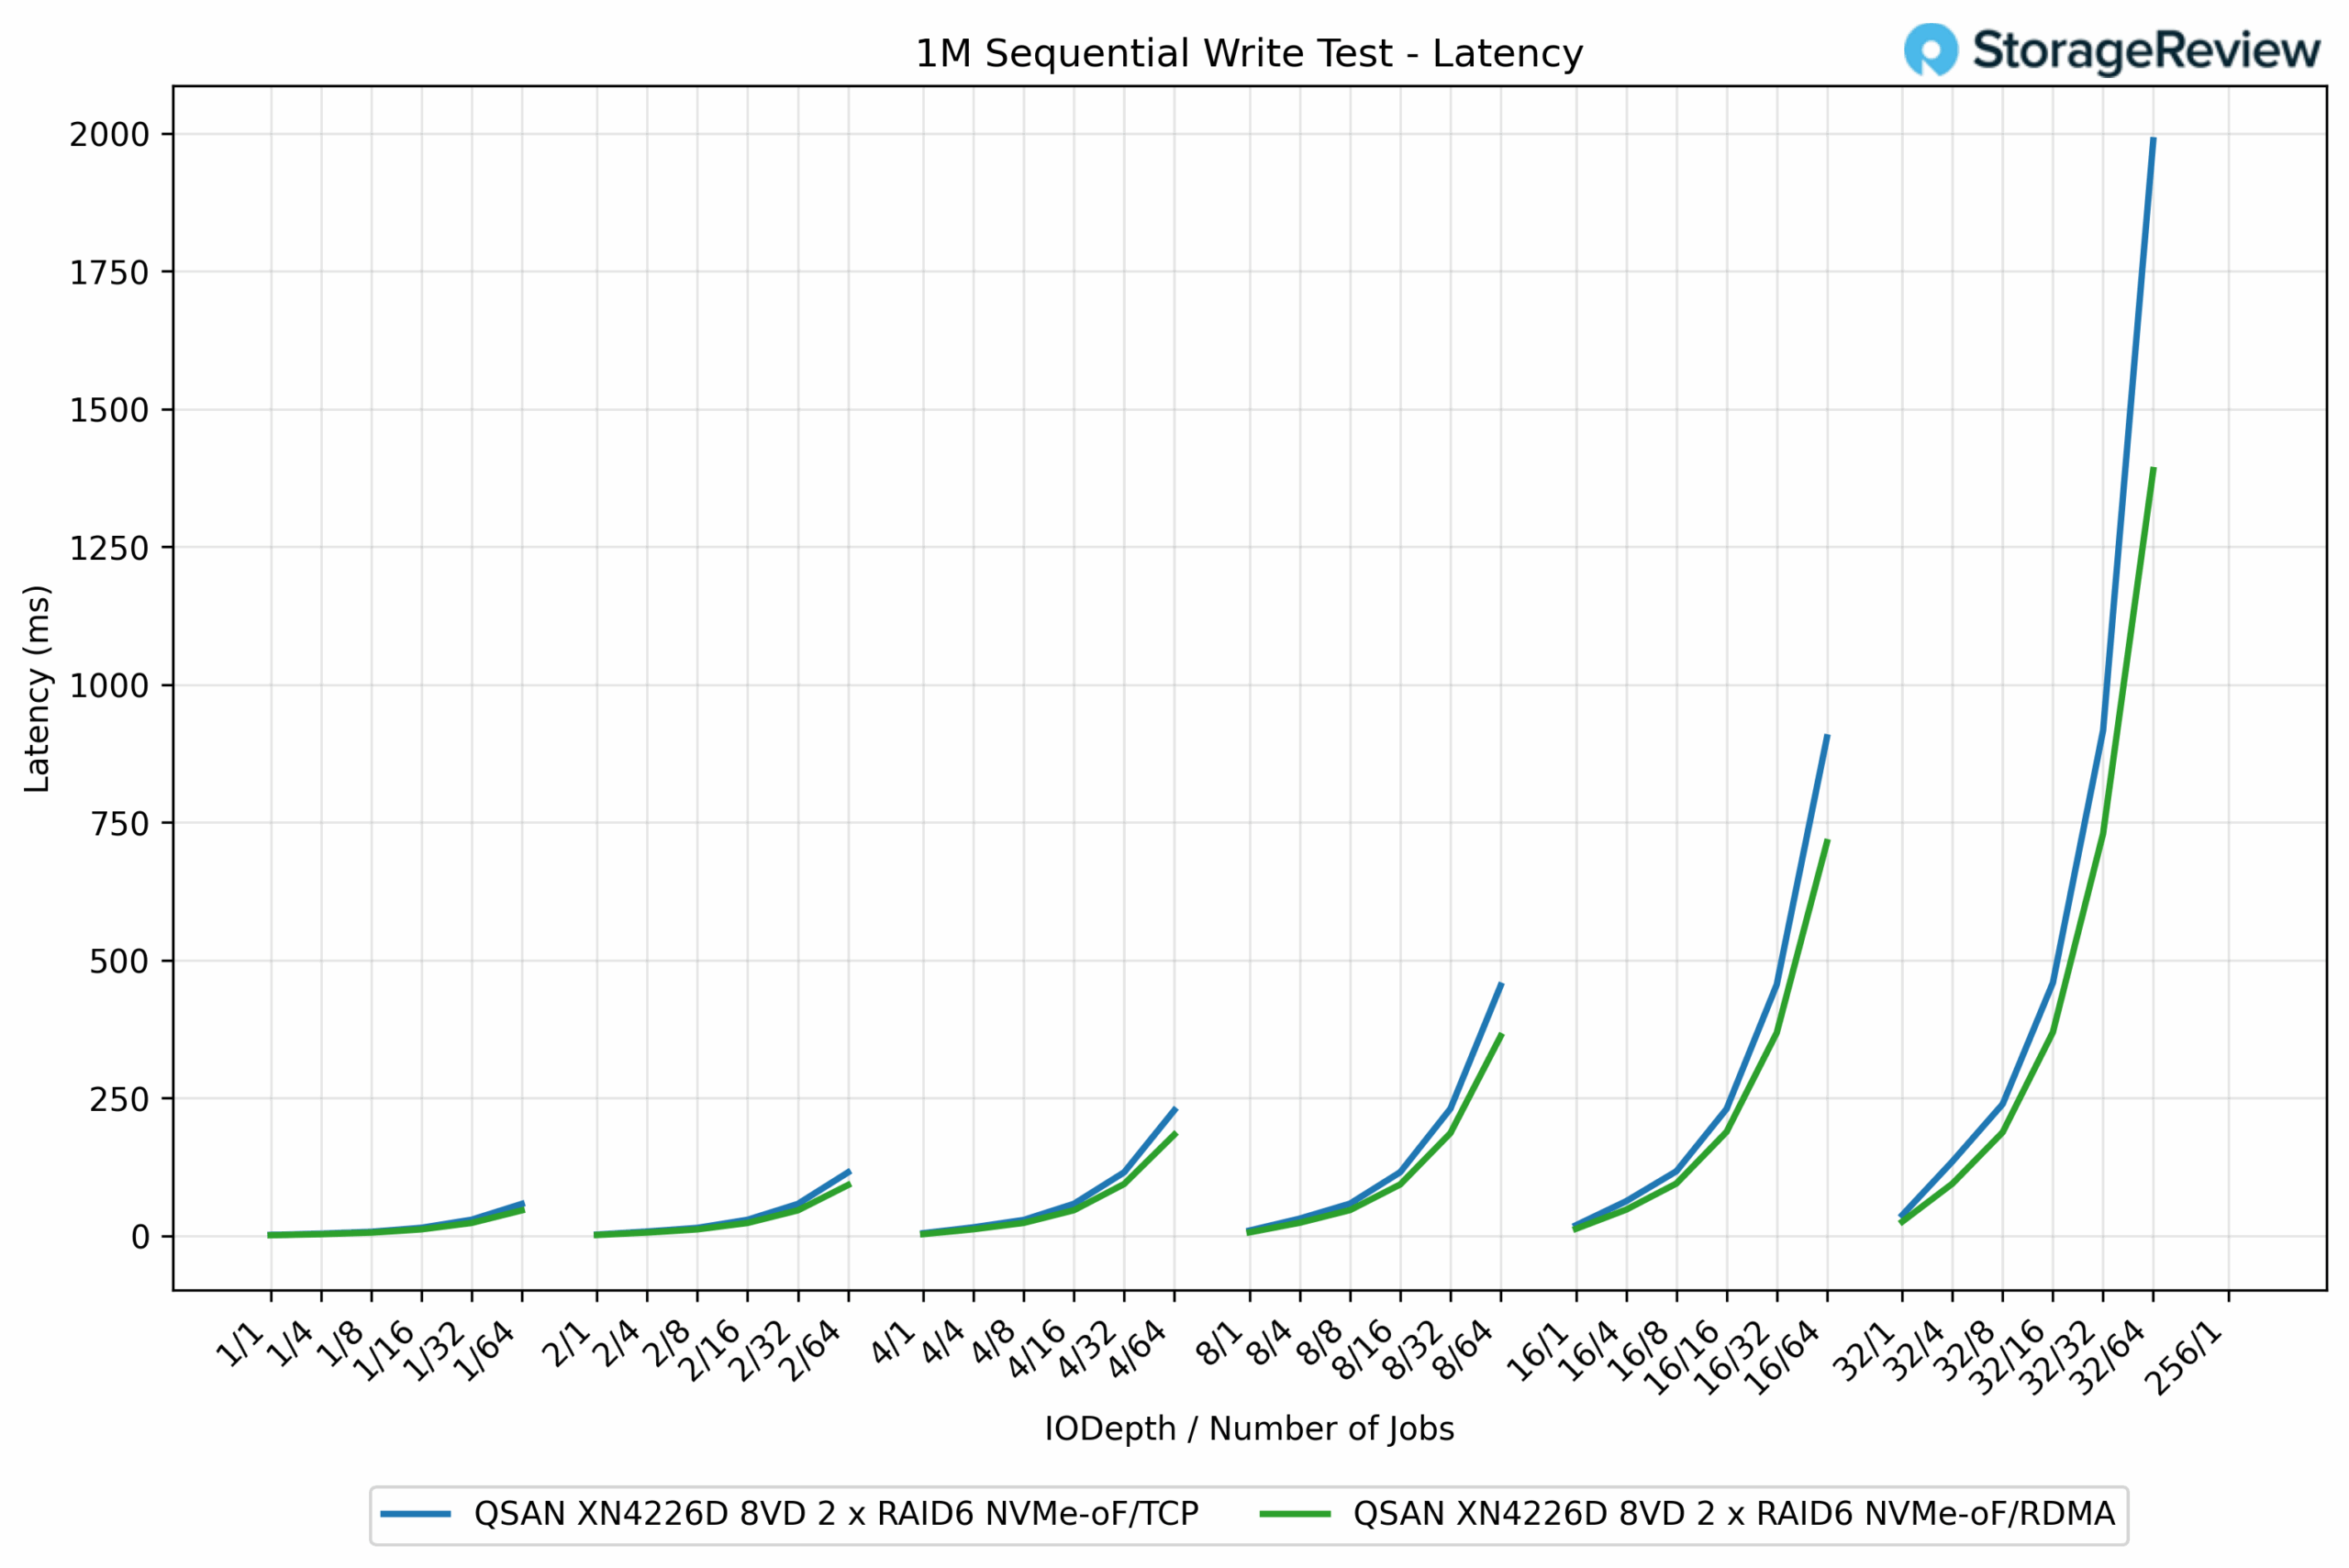
Nel test di latenza di scrittura sequenziale a 1M, RDMA ha mantenuto ancora una volta un chiaro vantaggio in termini di efficienza rispetto a TCP nella maggior parte delle profondità di coda e del numero di processi. Con carichi di lavoro più leggeri, i due protocolli hanno seguito un andamento simile, entrambi con latenze inferiori a 5 ms. Tuttavia, con l'aumentare della concorrenza, le differenze sono diventate più evidenti. Ad esempio, con i processi QD16/16, RDMA ha misurato 368.48 ms, mentre TCP ha registrato 455.95 ms, con un miglioramento del 19% per RDMA.
La divergenza è diventata ancora più significativa a scale estreme. Nel job QD256/1, RDMA ha completato il processo a 1,389.16 ms, mentre TCP è salito a 1,987.39 ms, riflettendo una riduzione della latenza del 43% a favore di RDMA. Questa tendenza evidenzia la capacità di RDMA di sostenere un throughput più elevato mantenendo sotto controllo la latenza, in particolare in scenari con carichi elevati.
Larghezza di banda di lettura sequenziale 1M
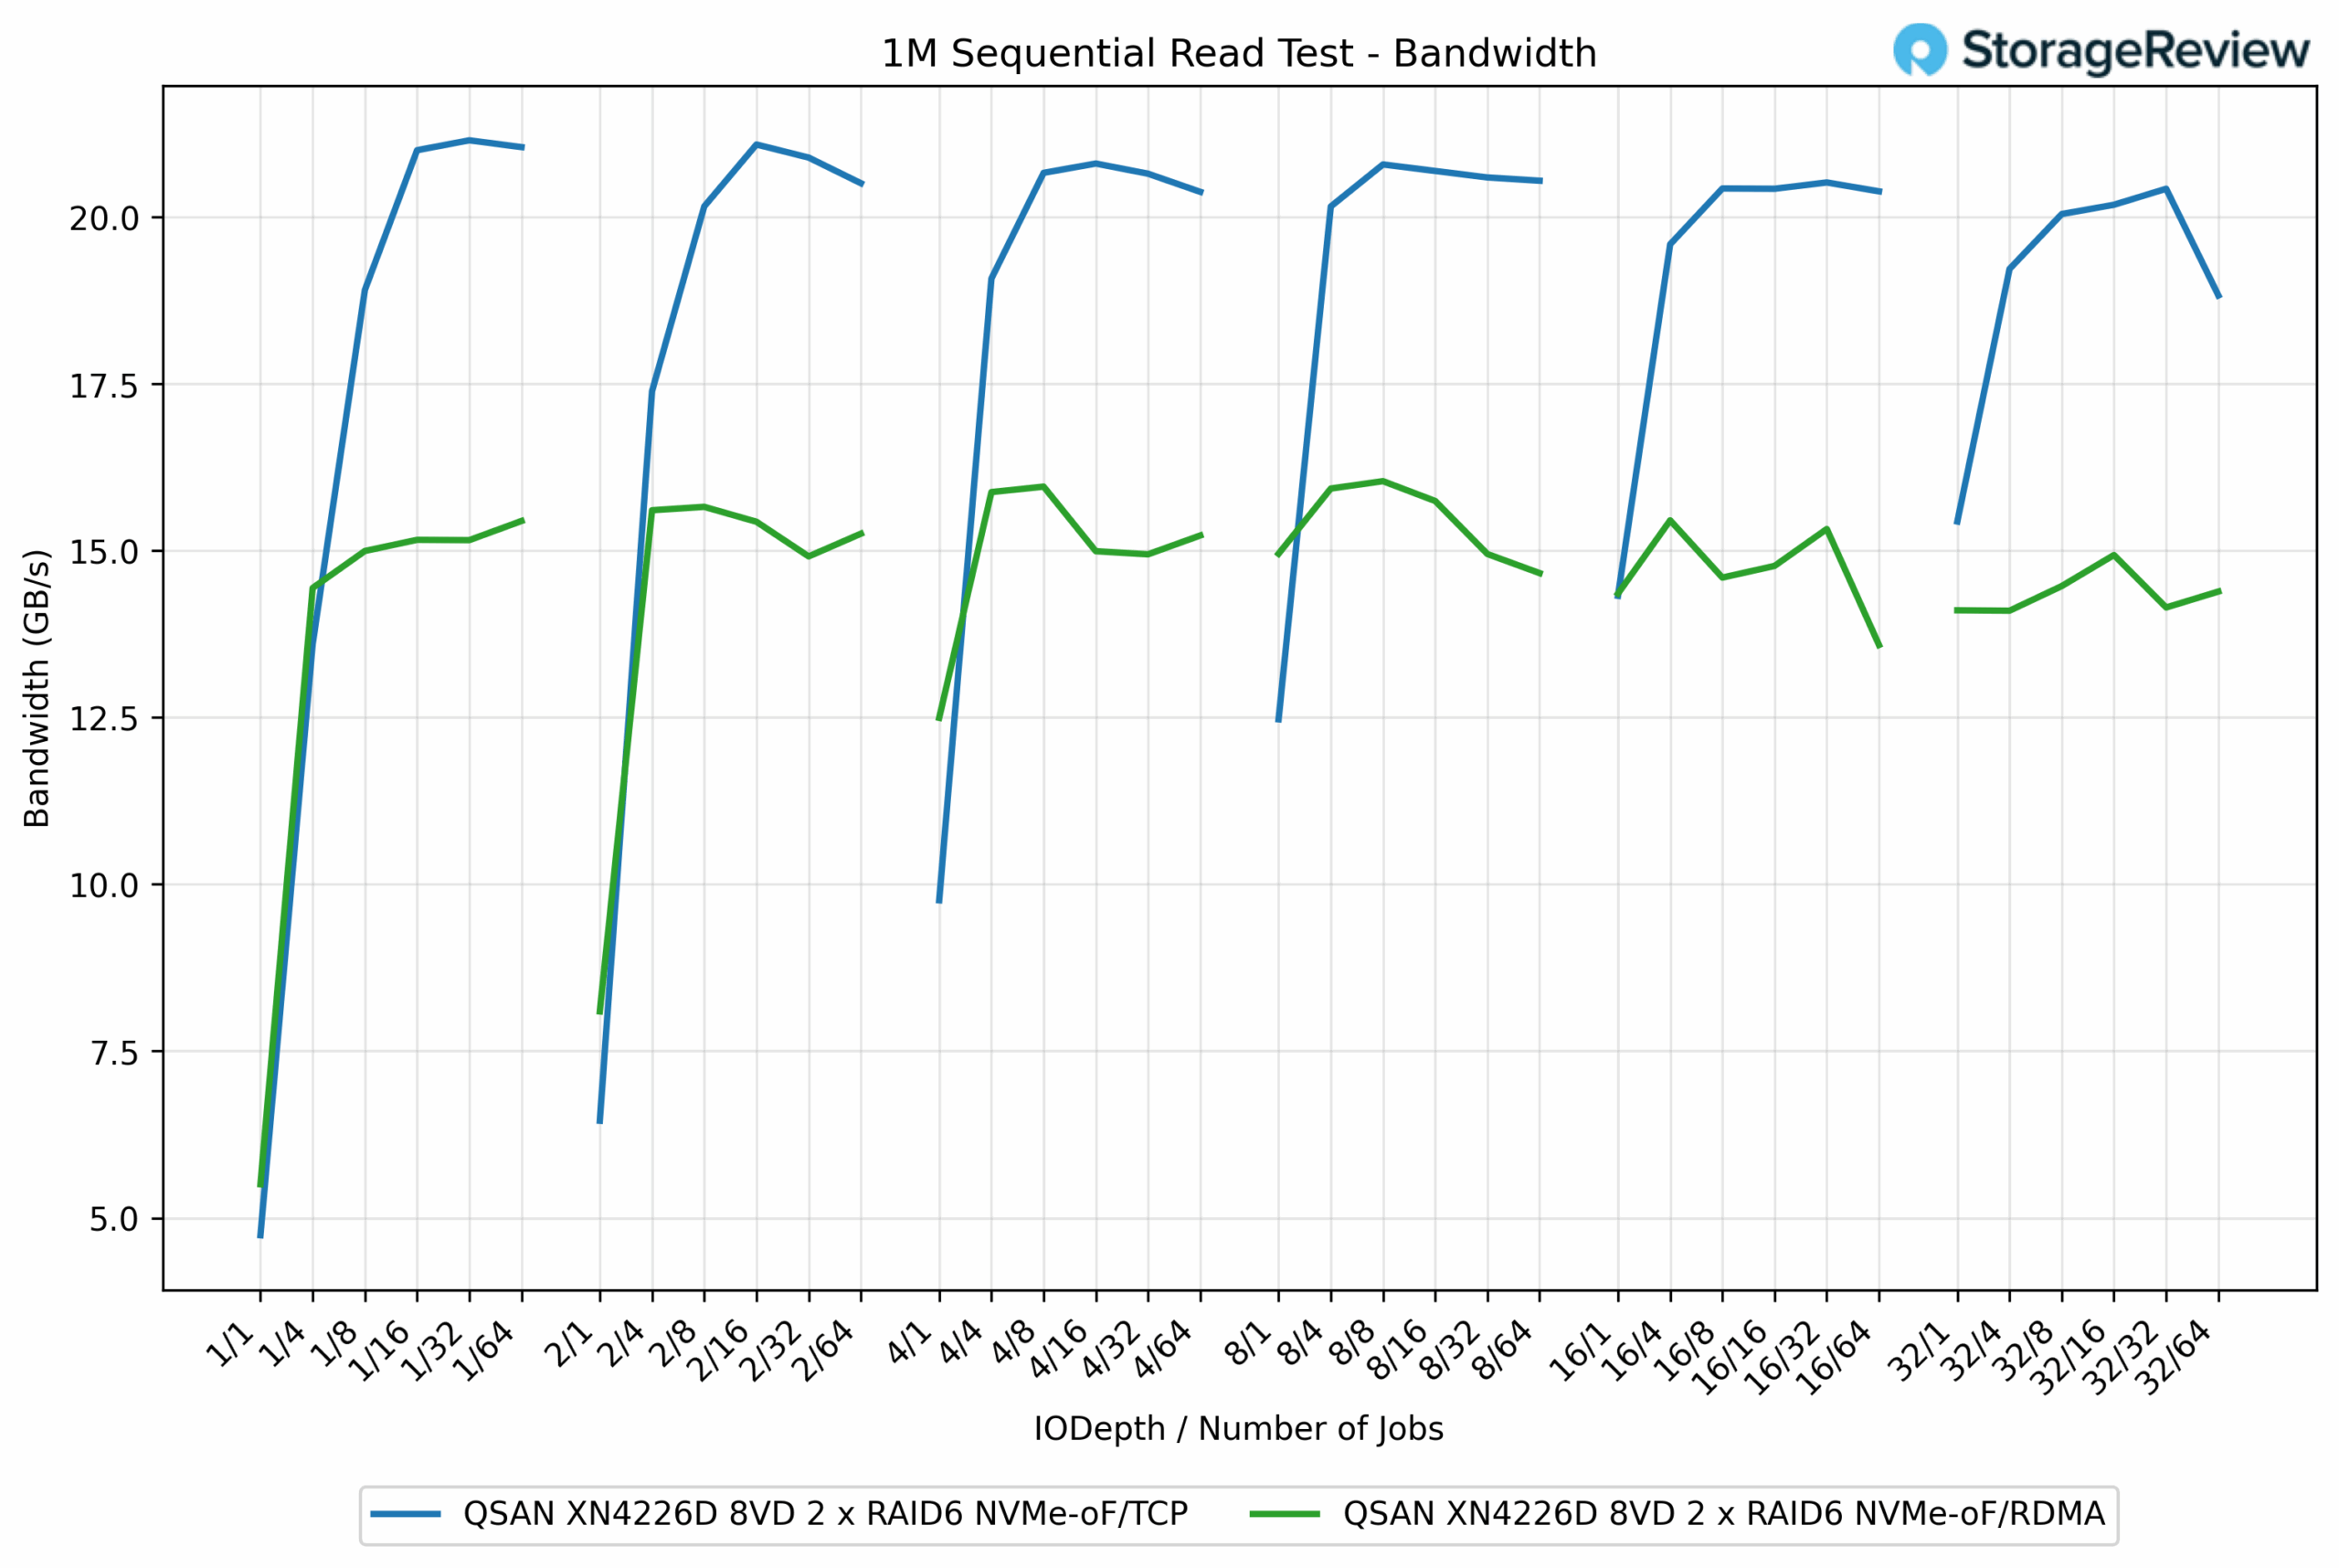
Nel test di lettura sequenziale 1M, la dinamica delle prestazioni è cambiata, con TCP che ha nettamente superato RDMA su tutta la linea. TCP ha raggiunto un picco di 21.21 GB/s, mentre RDMA ha raggiunto i 15.96 GB/s, con una differenza di circa il 33% a favore di TCP. Anche a profondità di coda inferiori, TCP ha guadagnato rapidamente terreno. Ad esempio, nei job QD1/4, TCP ha raggiunto i 18.91 GB/s, rispetto ai 15.05 GB/s di RDMA, con un divario di oltre il 25%.
Il vantaggio del TCP è stato costante su quasi ogni scala di carico di lavoro. Una volta raggiunta la saturazione, il TCP ha mantenuto risultati nell'intervallo 20-21 GB/s, mentre il RDMA si è stabilizzato su valori prossimi ai 15 GB/s. Ciò indica che, mentre il RDMA eccelle nelle operazioni ad alta intensità di scrittura e sensibili alla latenza, il TCP dimostra una maggiore efficienza della larghezza di banda in lettura sequenziale con la configurazione RAID6 NVMe testata.
Latenza di lettura sequenziale 1M
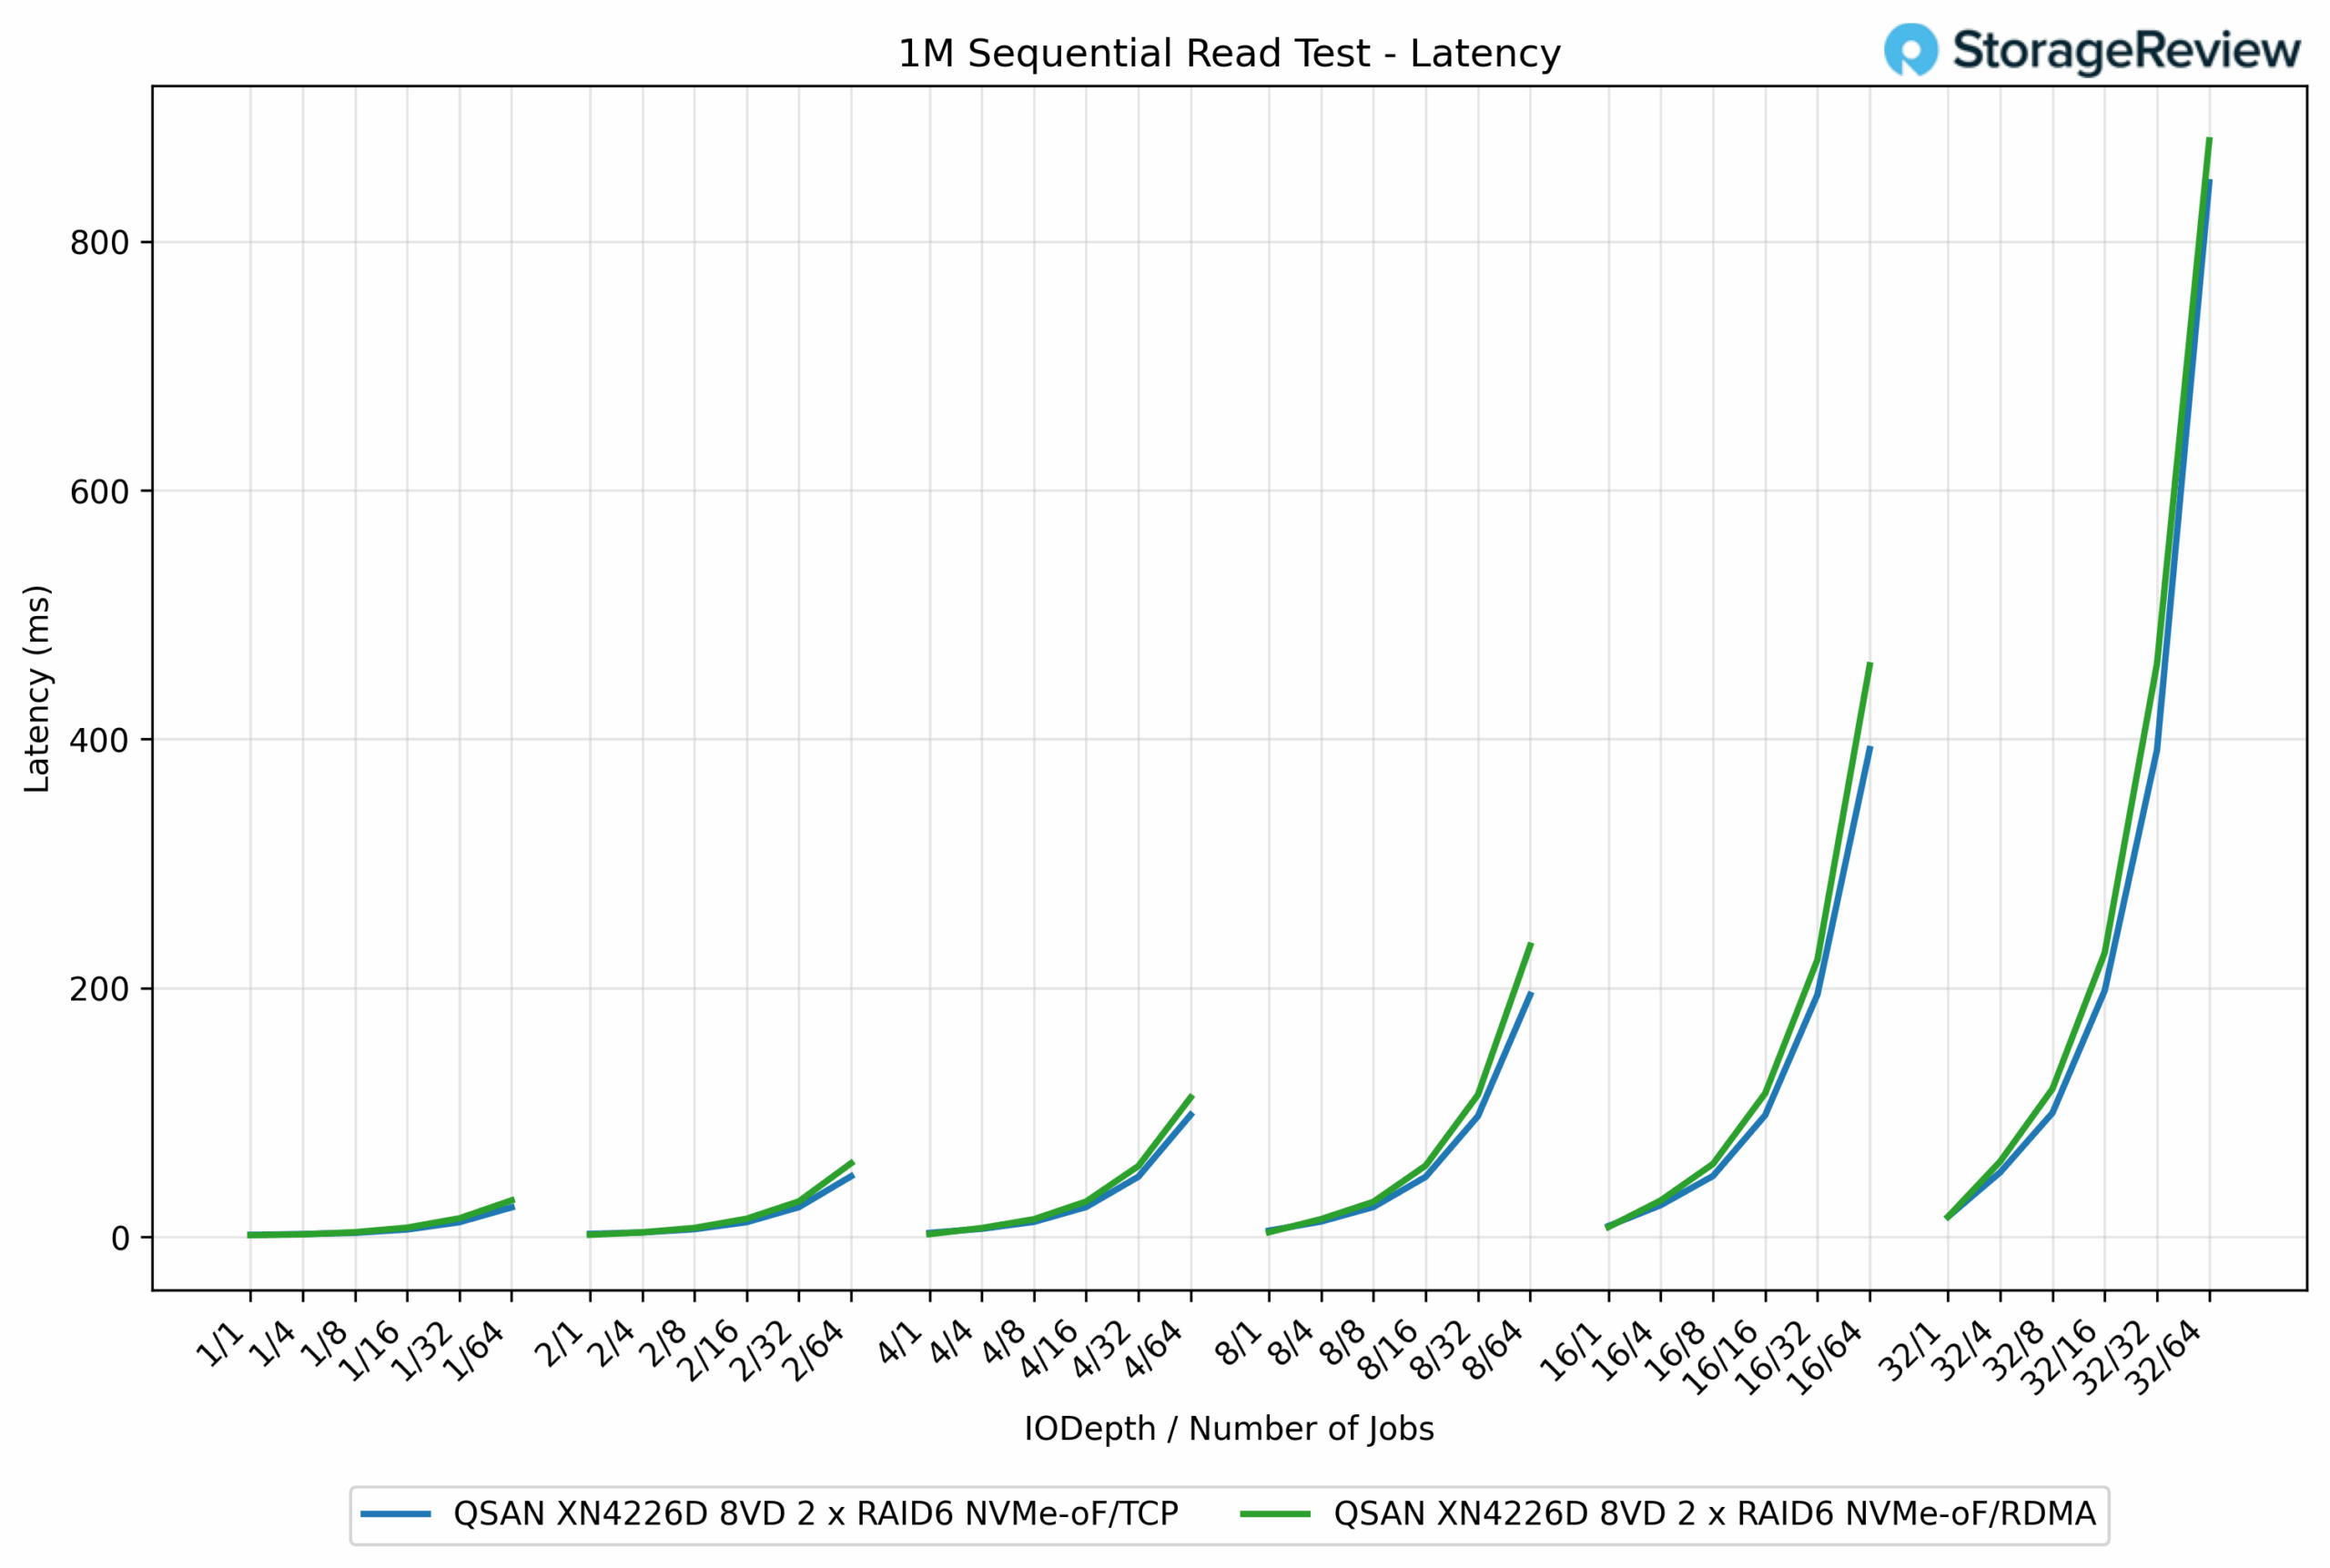
Nel test di latenza di lettura sequenziale a 1M, i risultati sono stati più simili tra i due protocolli, sebbene RDMA abbia generalmente mantenuto un leggero vantaggio a profondità di coda più elevate. Con carichi di lavoro più leggeri, i profili di latenza sono stati pressoché identici, entrambi rimanendo al di sotto dei 5 ms fino a quando la concorrenza non ha iniziato ad aumentare. Ad esempio, con i job QD8/64, TCP ha registrato 234.09 ms, mentre RDMA ha registrato un valore inferiore a 194.54 ms, con una riduzione del 17%.
Questa tendenza è proseguita anche con carichi di lavoro più pesanti. Con processi QD32/64, RDMA ha registrato 847.59 ms, rispetto agli 881.31 ms di TCP, un miglioramento del 3.8%, ma comunque coerente con il minore overhead di stack di RDMA. Detto questo, entrambi i protocolli hanno scalato in modo simile, con una latenza che aumentava prevedibilmente con l'intensificarsi del carico di lavoro.
64k IOPS di scrittura casuale
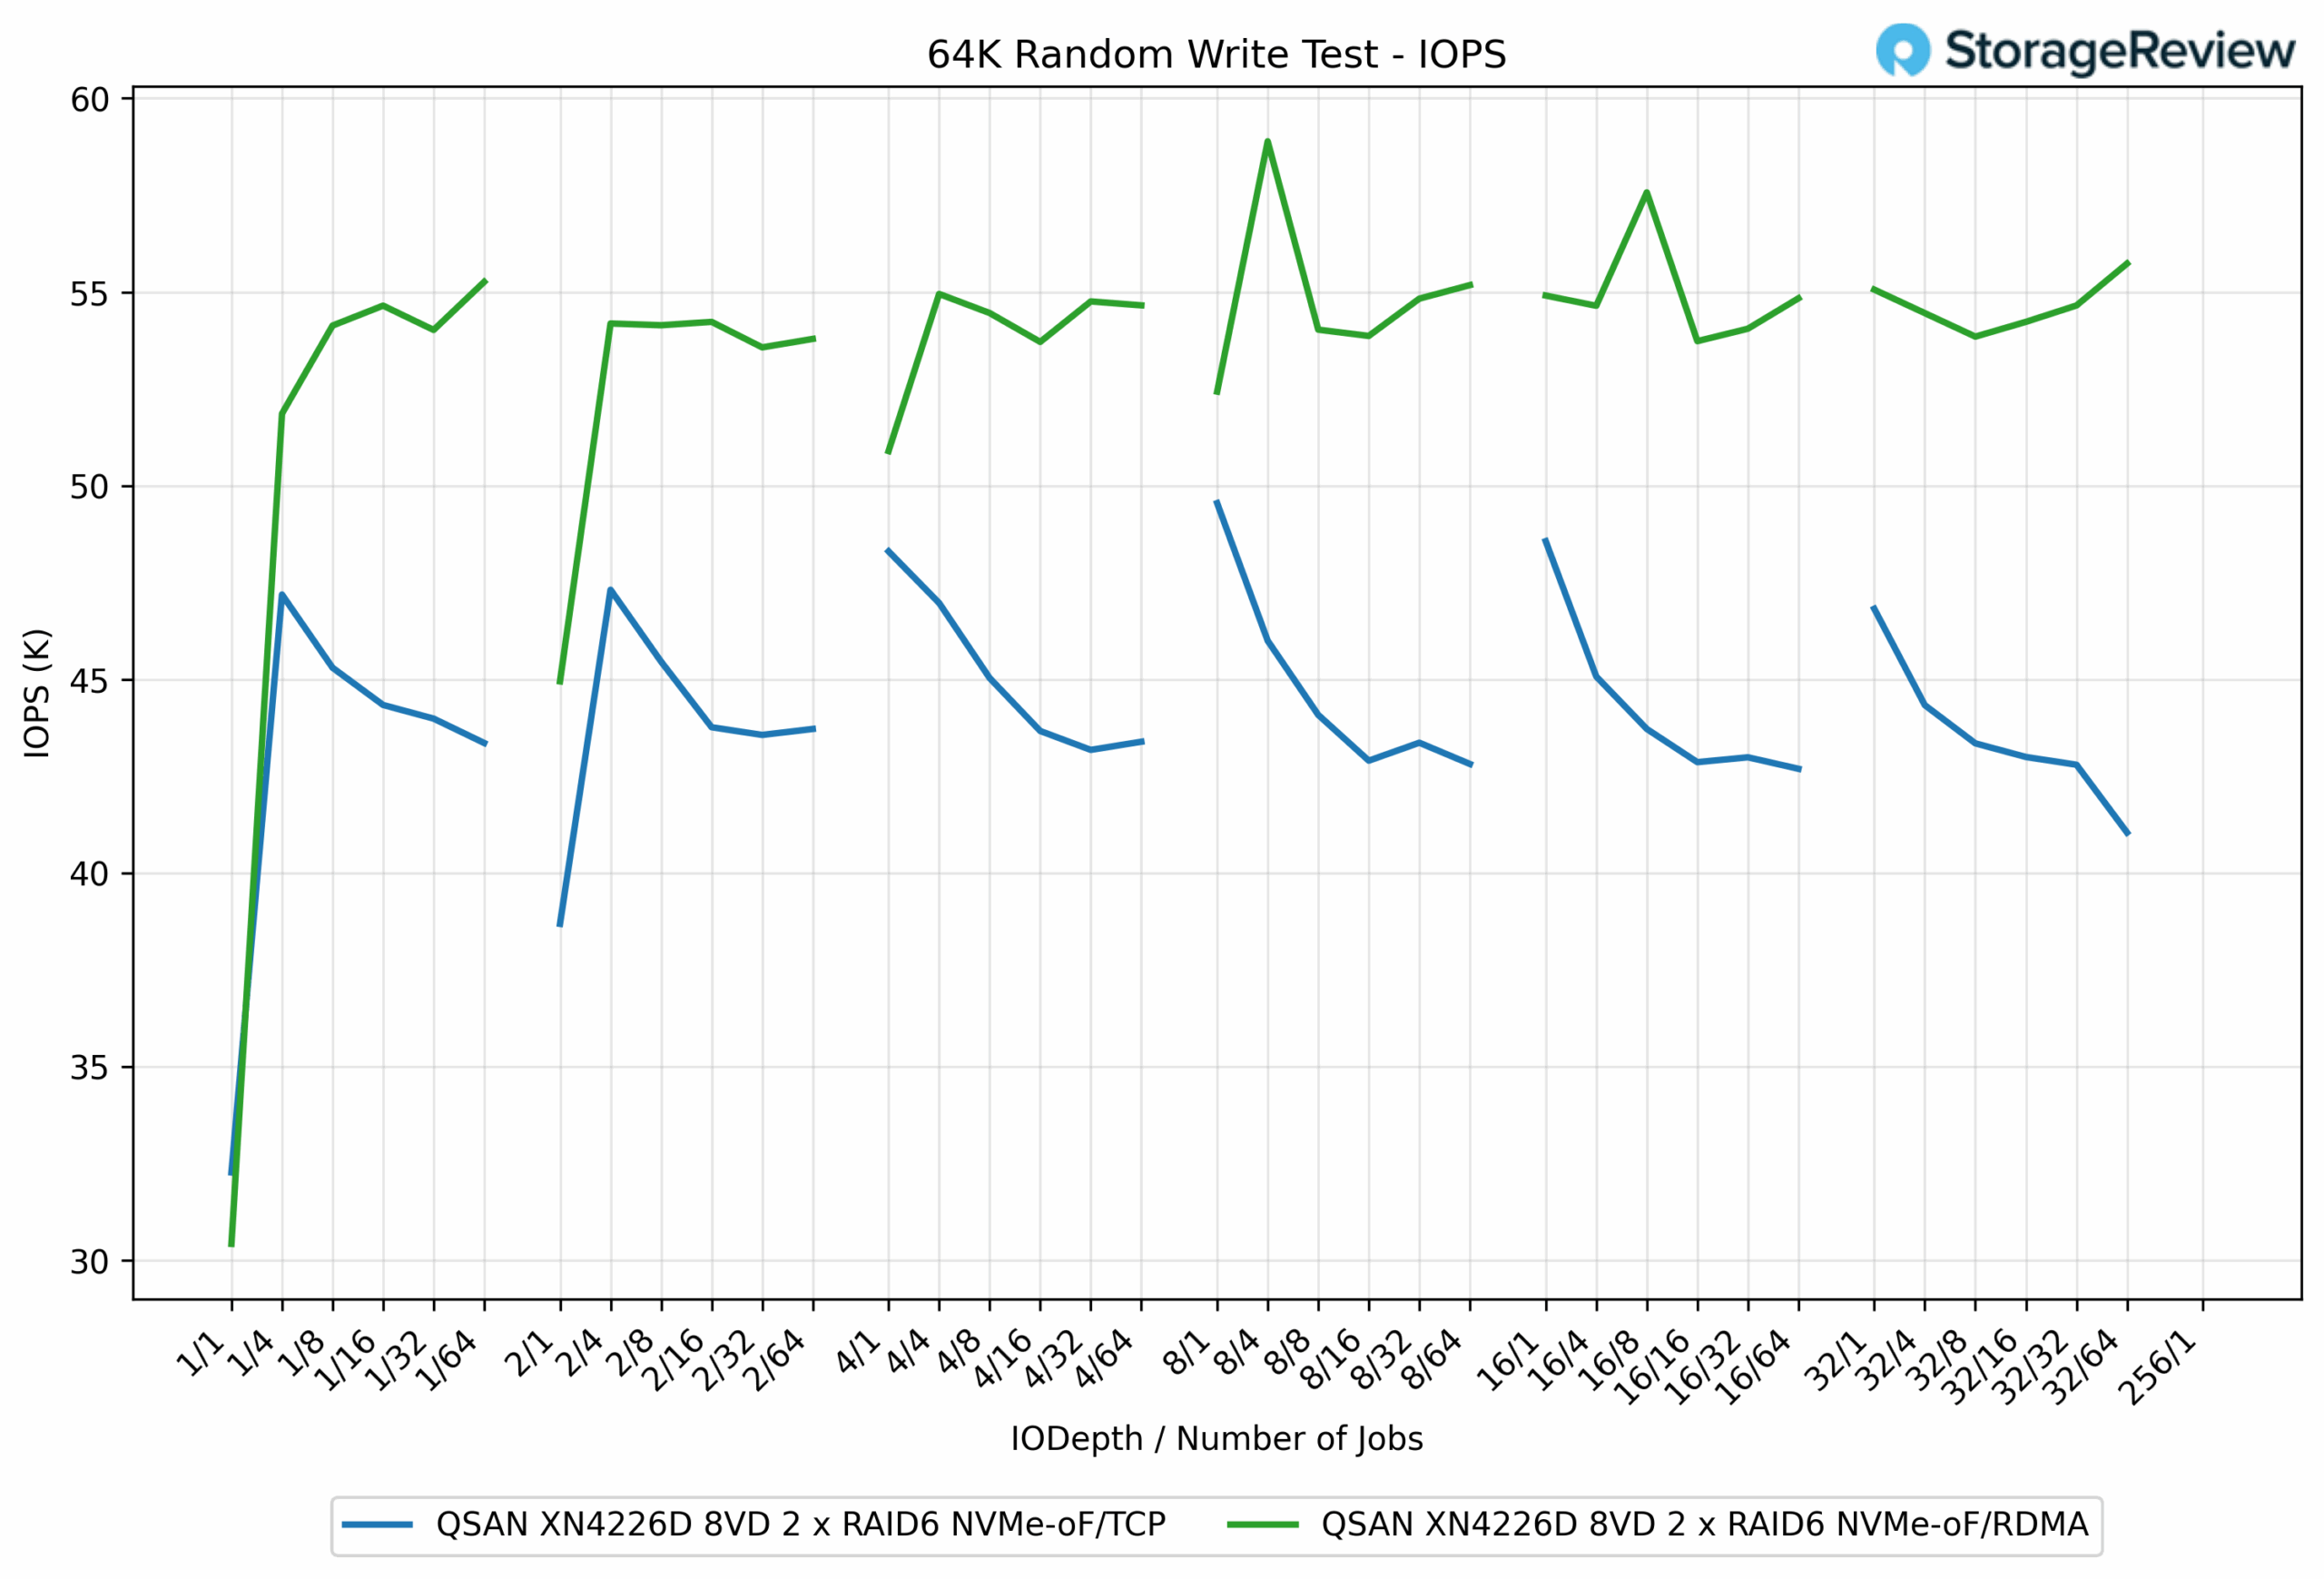
Nel test di scrittura casuale a 64K, RDMA ha costantemente fornito IOPS più elevati rispetto a TCP, evidenziando la sua efficienza nella gestione di operazioni casuali parallelizzate. Al picco, RDMA ha raggiunto 58.89K IOPS, mentre TCP si è attestato a 48.57K IOPS, segnando un vantaggio prestazionale del 21%.
Il divario tra i due protocolli è stato presente durante l'intero test. Ad esempio, nei job QD1/16, RDMA ha registrato 54.13K IOPS, rispetto ai 45.30K IOPS di TCP, una differenza di quasi il 16%. Con l'ulteriore aumento del carico di lavoro, RDMA ha mantenuto risultati nell'intervallo 53K-55K IOPS, mentre TCP ha mantenuto un intervallo 42K-46K IOPS.
Latenza di scrittura casuale di 64K
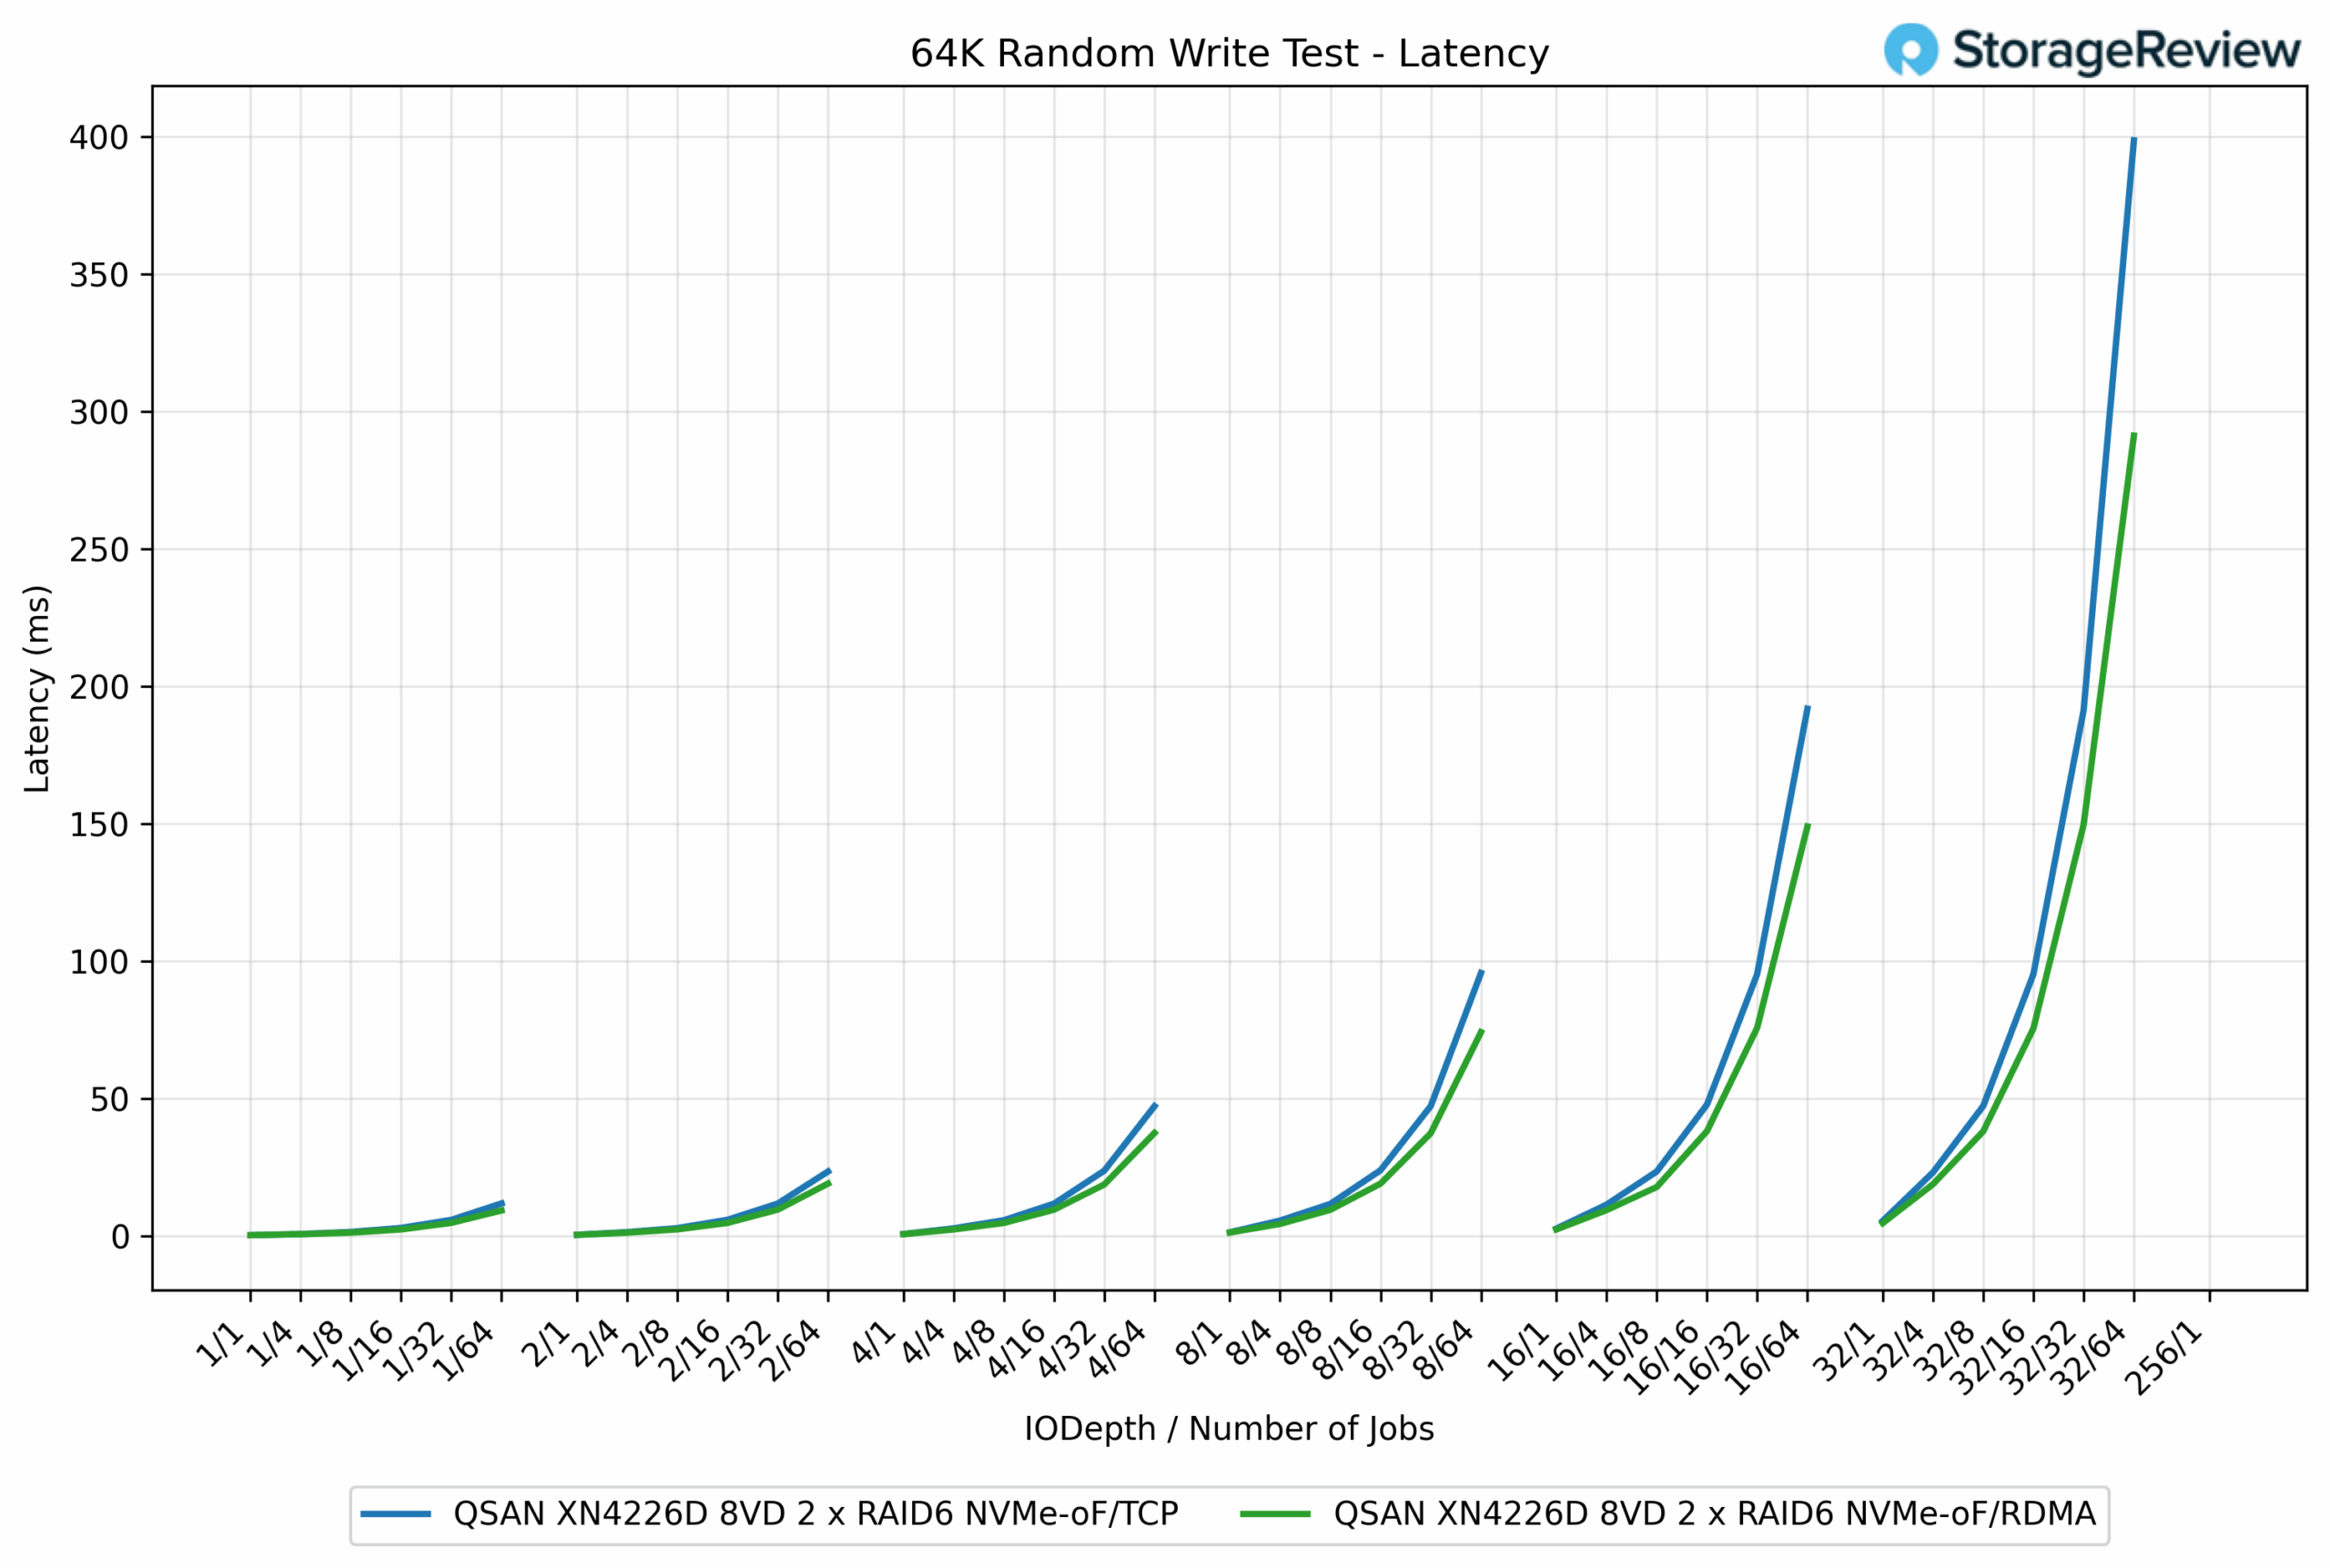
Nel test di latenza di scrittura casuale a 64K, RDMA ha dimostrato ancora una volta tempi di risposta inferiori rispetto a TCP, in particolare all'aumentare della profondità della coda e del numero di processi. A carichi inferiori, entrambi i protocolli hanno funzionato in modo quasi identico, rimanendo al di sotto di 1 ms. Ad esempio, nel processo QD1/1, TCP ha misurato 0.26 ms, mentre RDMA è rimasto sostanzialmente invariato a 0.25 ms.
Tuttavia, con l'aumentare del carico di lavoro, RDMA ha mantenuto il suo vantaggio in termini di efficienza. Nei job QD16/64, RDMA ha registrato 74.09 ms, rispetto ai 95.64 ms di TCP, una differenza di circa il 23%. Il divario si è ulteriormente ampliato sotto stress massimo nel job QD256/1, dove RDMA ha registrato 291.13 ms, mentre TCP è balzato a 398.56 ms, quasi il 37% in più.
IOPS di lettura casuale 64K
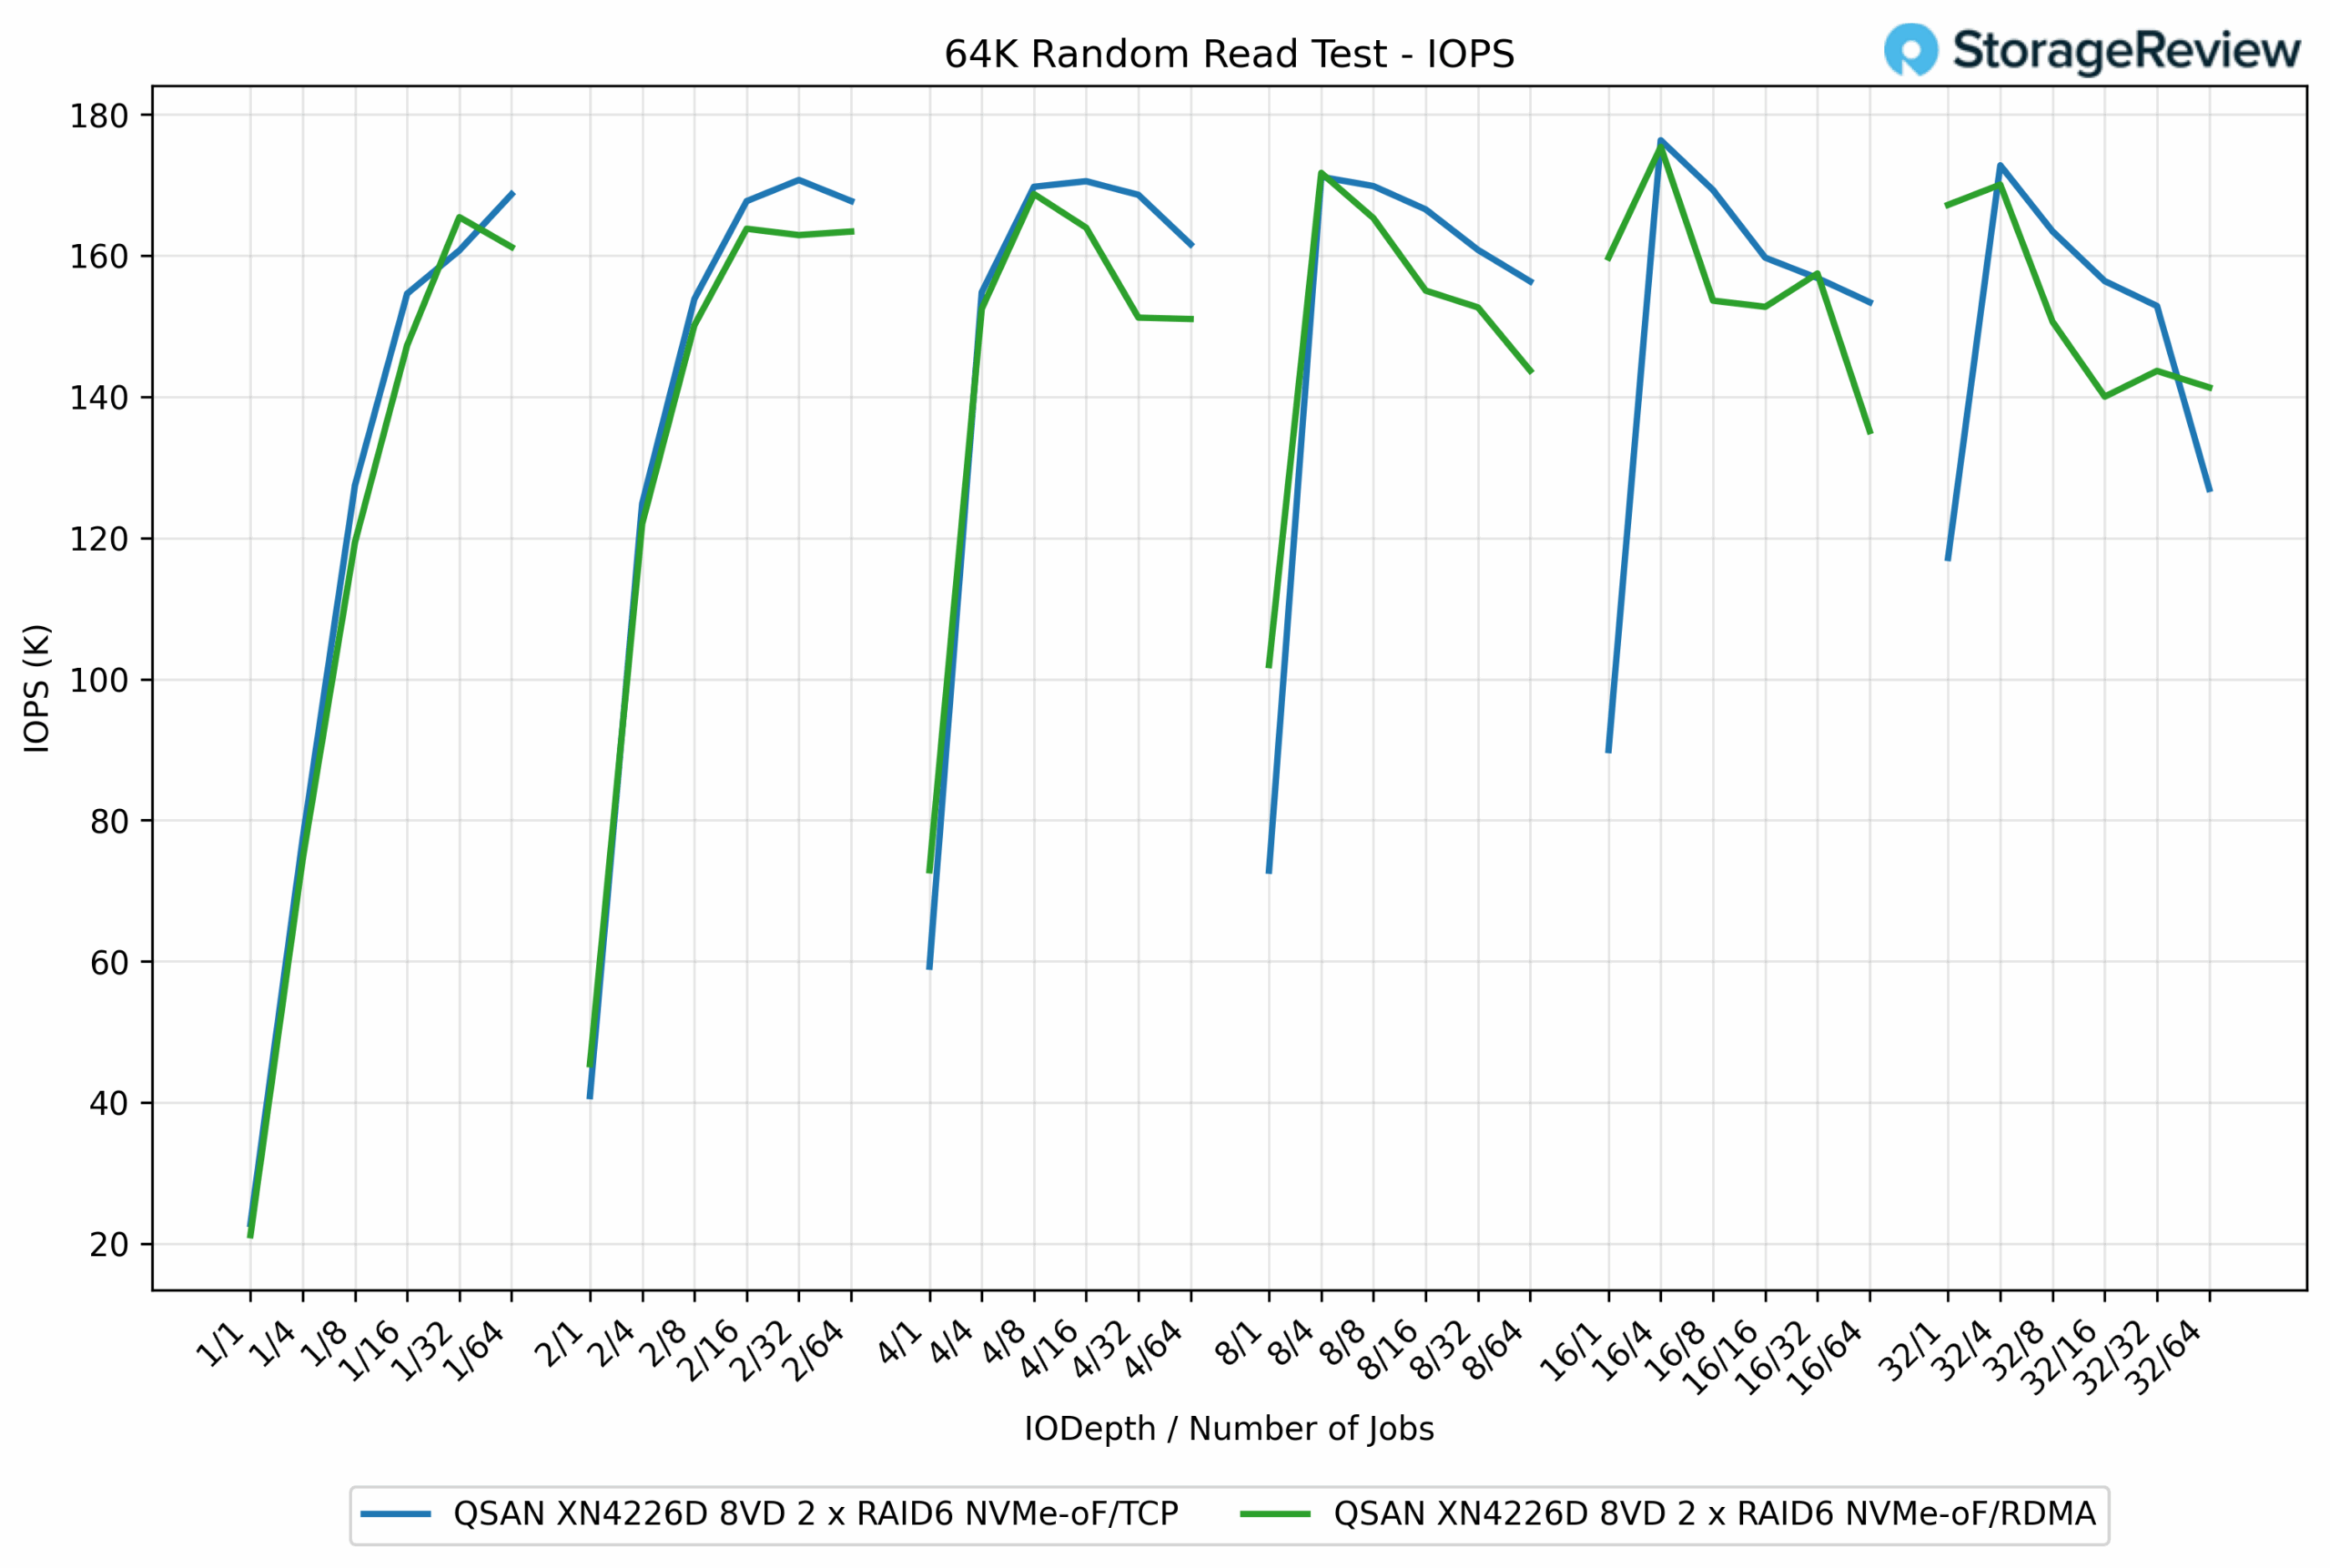
Nel test di lettura casuale a 64K, TCP e RDMA hanno offerto prestazioni complessivamente molto simili, con un leggero spostamento del vantaggio tra i due protocolli a seconda del carico di lavoro. TCP ha raggiunto un picco di 176.33K IOPS, mentre RDMA si è piazzato subito dietro a 175.40K IOPS, con una differenza di solo lo 0.5%.
A profondità moderate, i risultati sono rimasti strettamente raggruppati. Ad esempio, nei job QD4/16, TCP ha registrato 168.60K IOPS, mentre RDMA ha seguito con 163.94K IOPS, un divario inferiore al 2.8%. In altri punti, RDMA ha registrato un leggero aumento, come nei job QD8/1, dove ha raggiunto 171.71K IOPS rispetto ai 171.15K IOPS di TCP, sostanzialmente in parità.
Latenza di lettura casuale di 64K
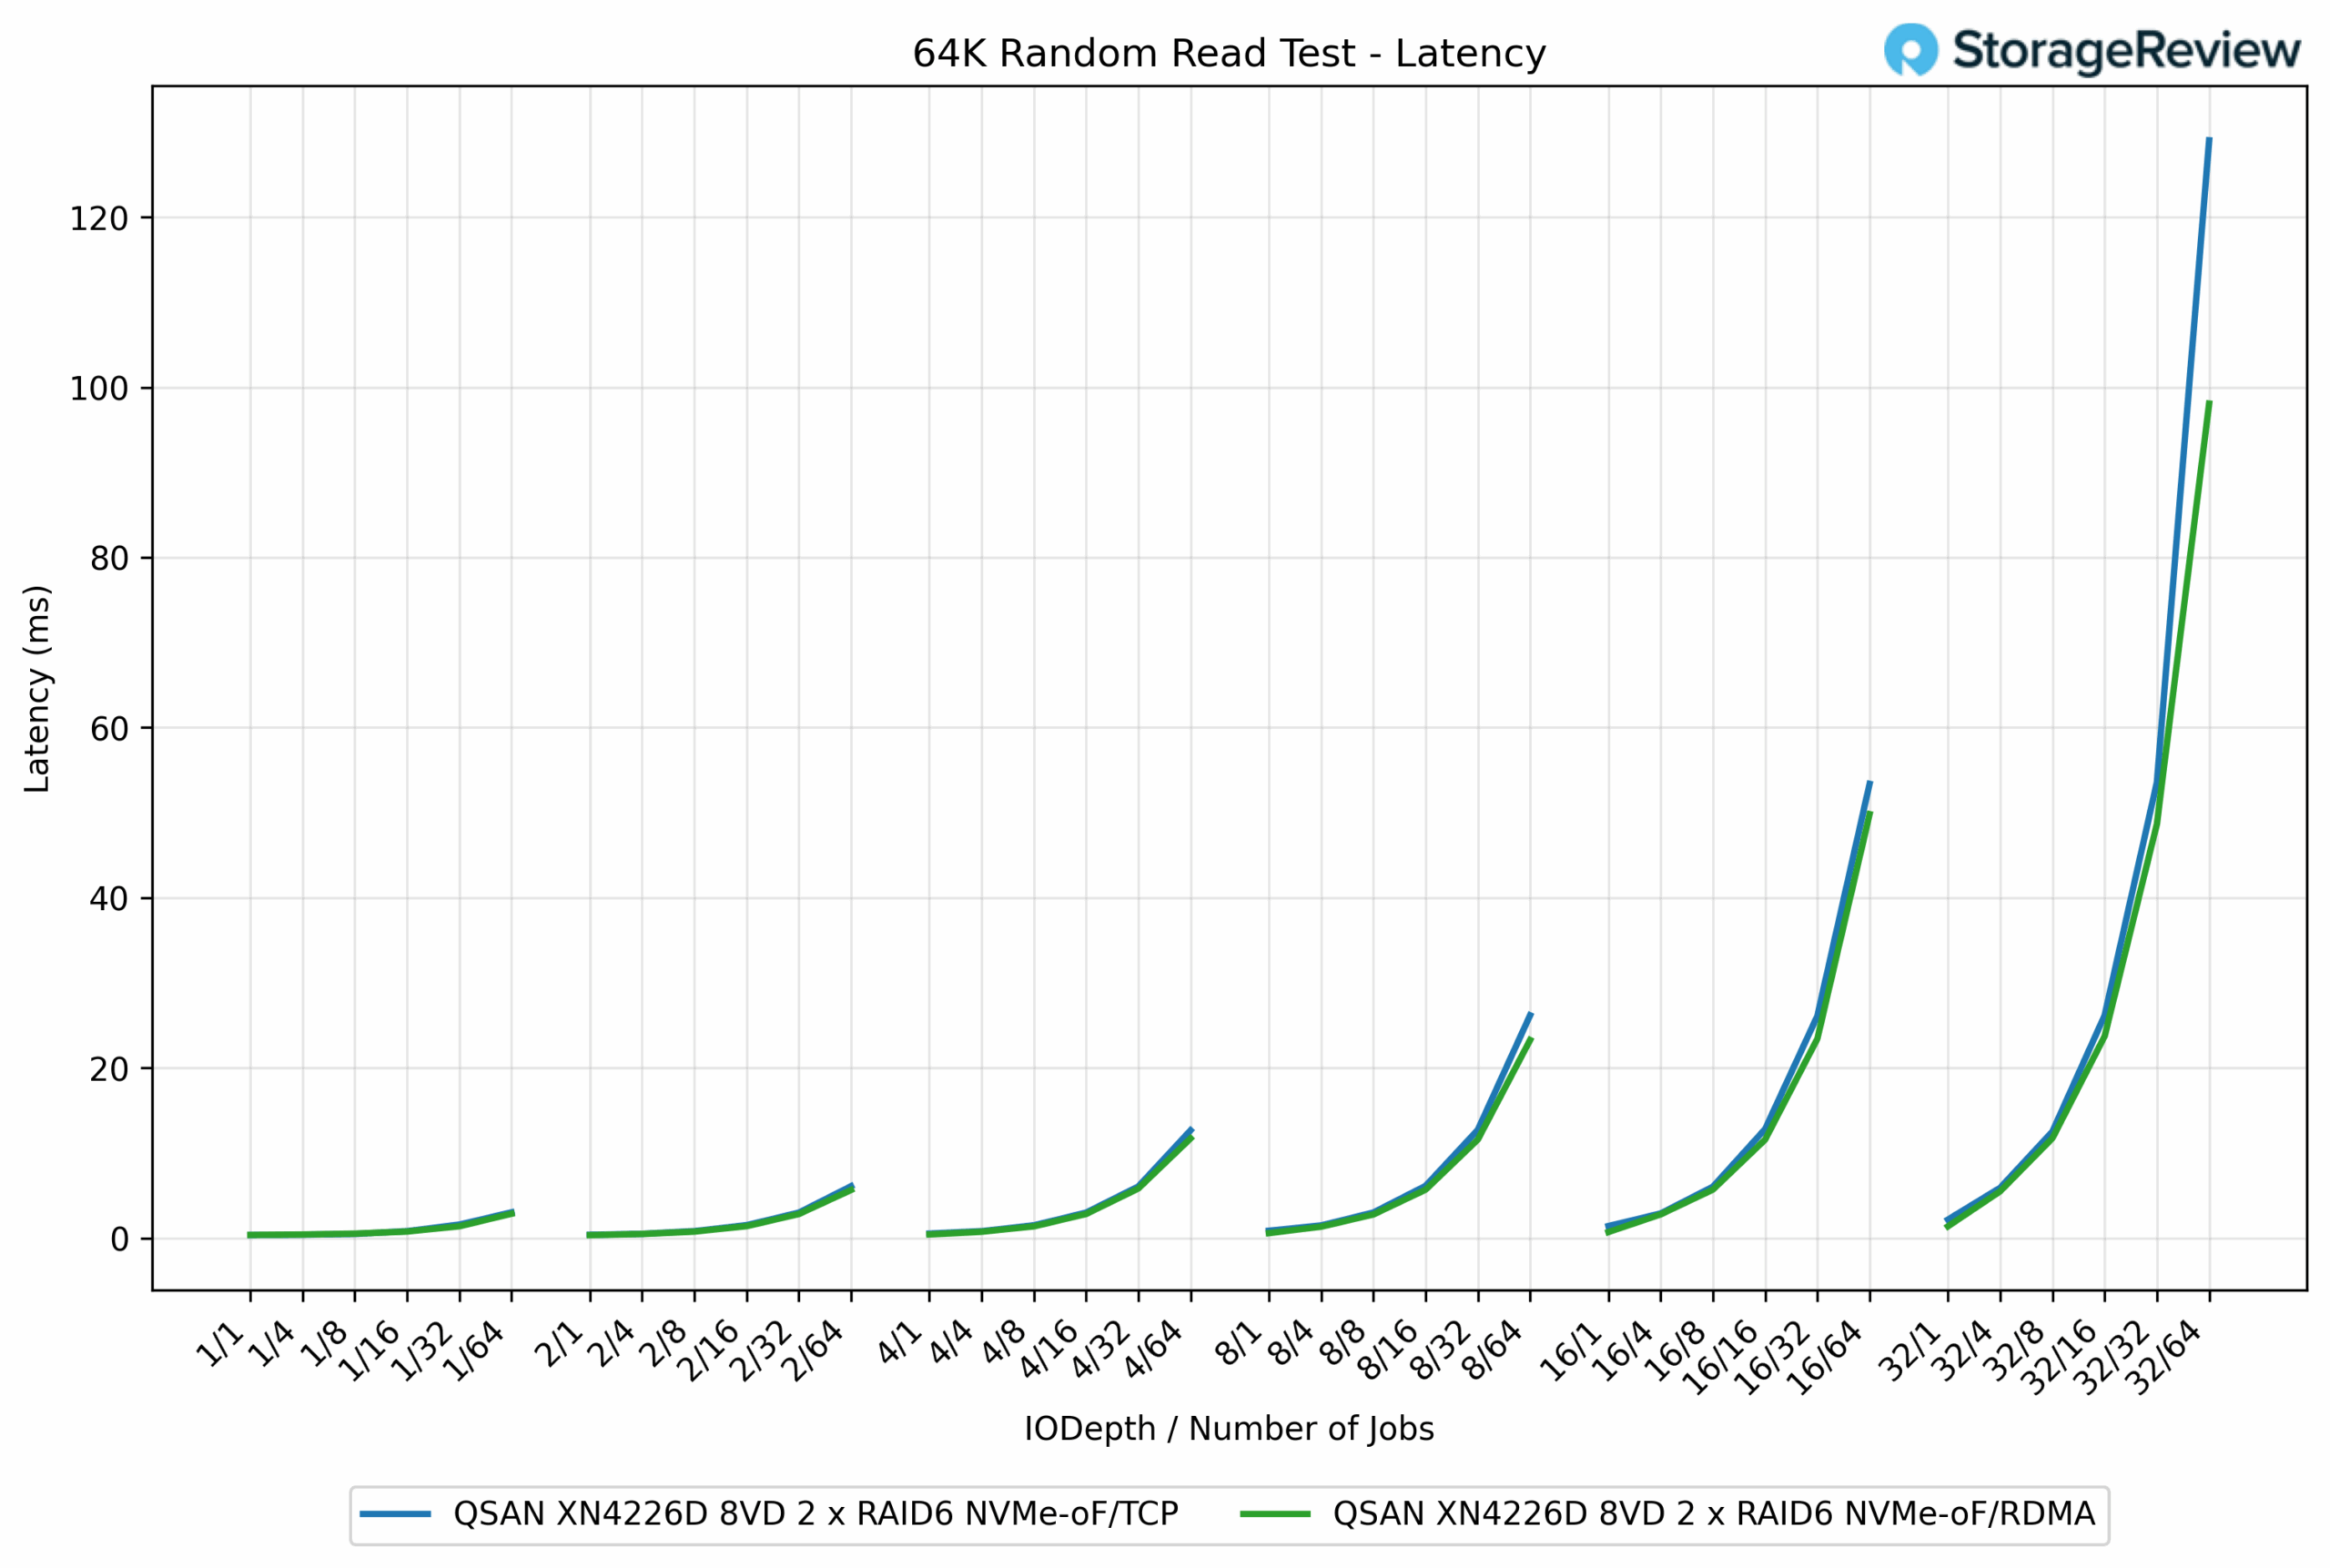
Nel test di latenza in lettura casuale a 64K, i due protocolli hanno seguito un andamento molto simile, sebbene RDMA abbia mostrato un modesto vantaggio sotto carichi più elevati. Con carichi di lavoro leggeri, sia TCP che RDMA hanno fornito latenze inferiori a 1 ms, sostanzialmente indistinguibili. Ad esempio, nel job QD1/1, TCP ha misurato 0.43 ms rispetto agli 0.38 ms di RDMA.
Con l'aumentare della concorrenza, la differenza è diventata più evidente. A QD16/64 job, RDMA ha registrato 23.28 ms, mentre TCP 26.19 ms, con un miglioramento del 12%. Lo spread si è ampliato in condizioni di massimo stress, dove RDMA si è attestato a 98.08 ms contro i 129.02 ms di TCP, con una riduzione del 24%.
IOPS in scrittura casuale 16K
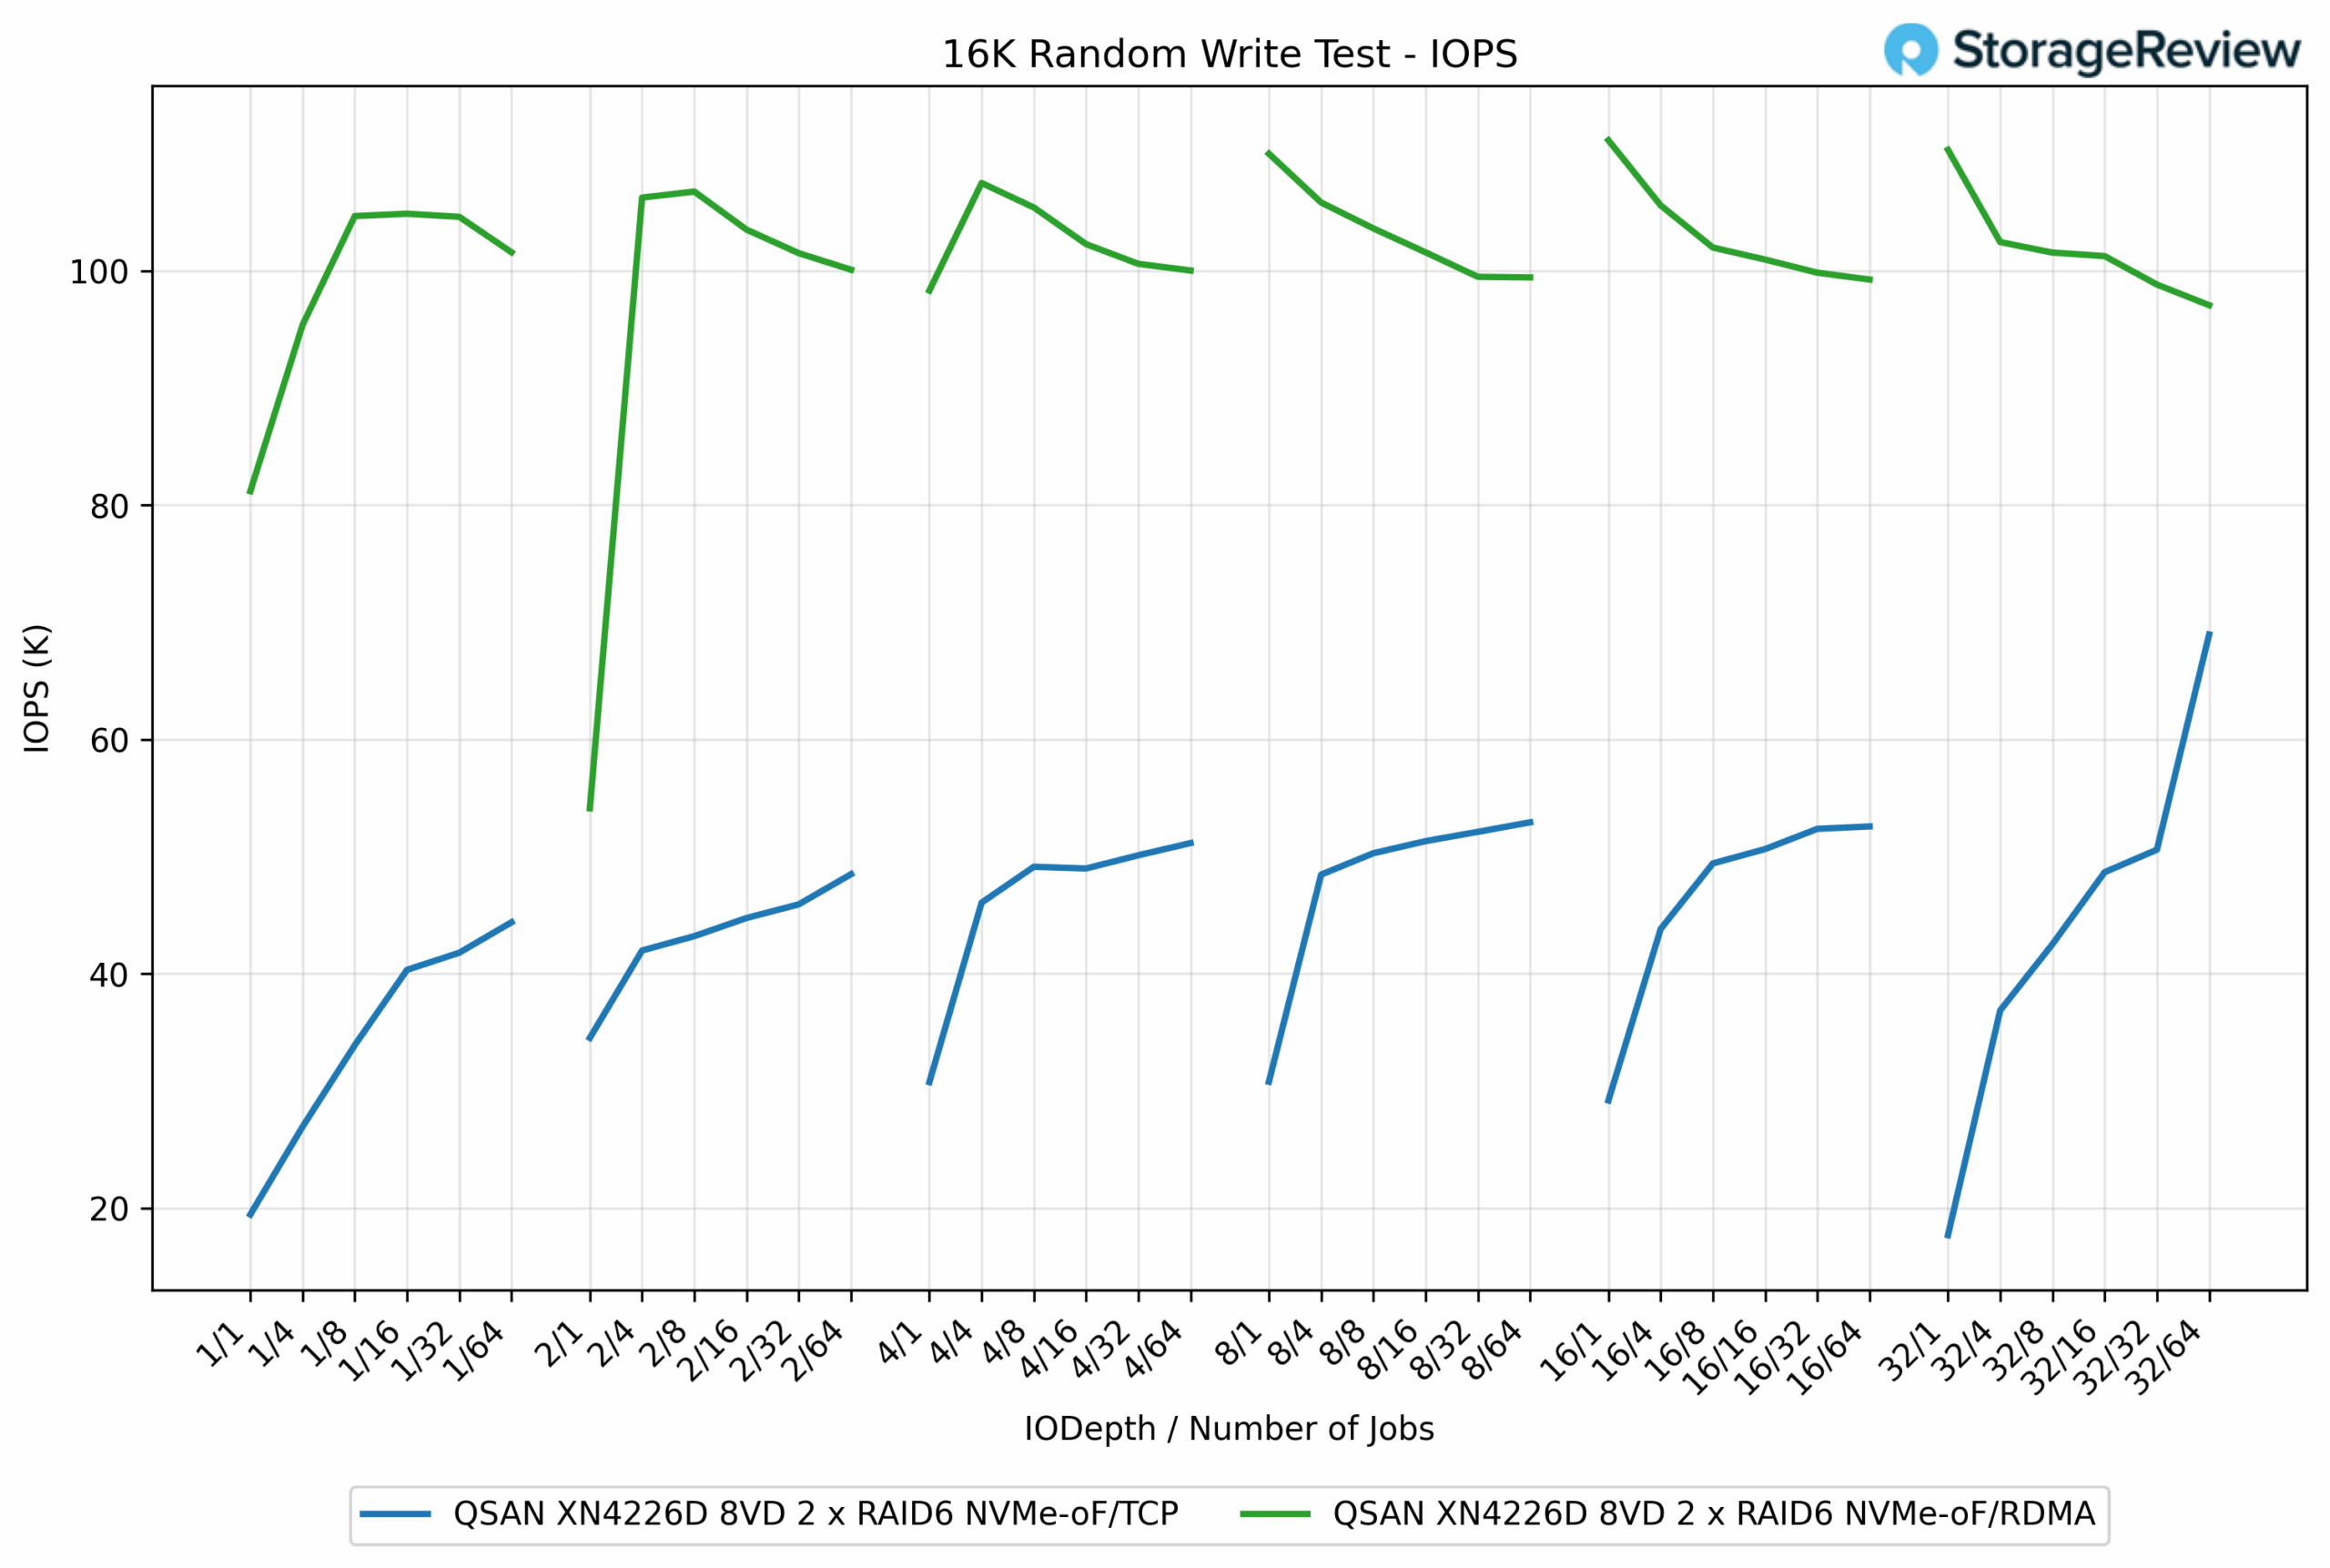
Nel test di scrittura casuale a 16K, il divario prestazionale tra i due protocolli è stato sostanziale, con RDMA che ha fornito più del doppio degli IOPS di TCP nella maggior parte dei casi. RDMA ha raggiunto un picco di 111.13K IOPS, mentre TCP ha raggiunto un massimo di 68.95K IOPS, con un vantaggio del 61% per RDMA.
A profondità di coda inferiori, la differenza era evidente. Ad esempio, nei job QD1/16, RDMA ha misurato 104.86K IOPS, rispetto ai 41.78K IOPS di TCP, il che si traduce in un aumento del 151% a favore di RDMA. Nell'intero intervallo di carico di lavoro, RDMA ha mantenuto costantemente risultati nell'intervallo da 100K a 111K IOPS, mentre TCP è rimasto generalmente nell'intervallo da 40K a 50K IOPS, fatta eccezione per un picco tardivo alla massima profondità.
Latenza di scrittura casuale di 16K
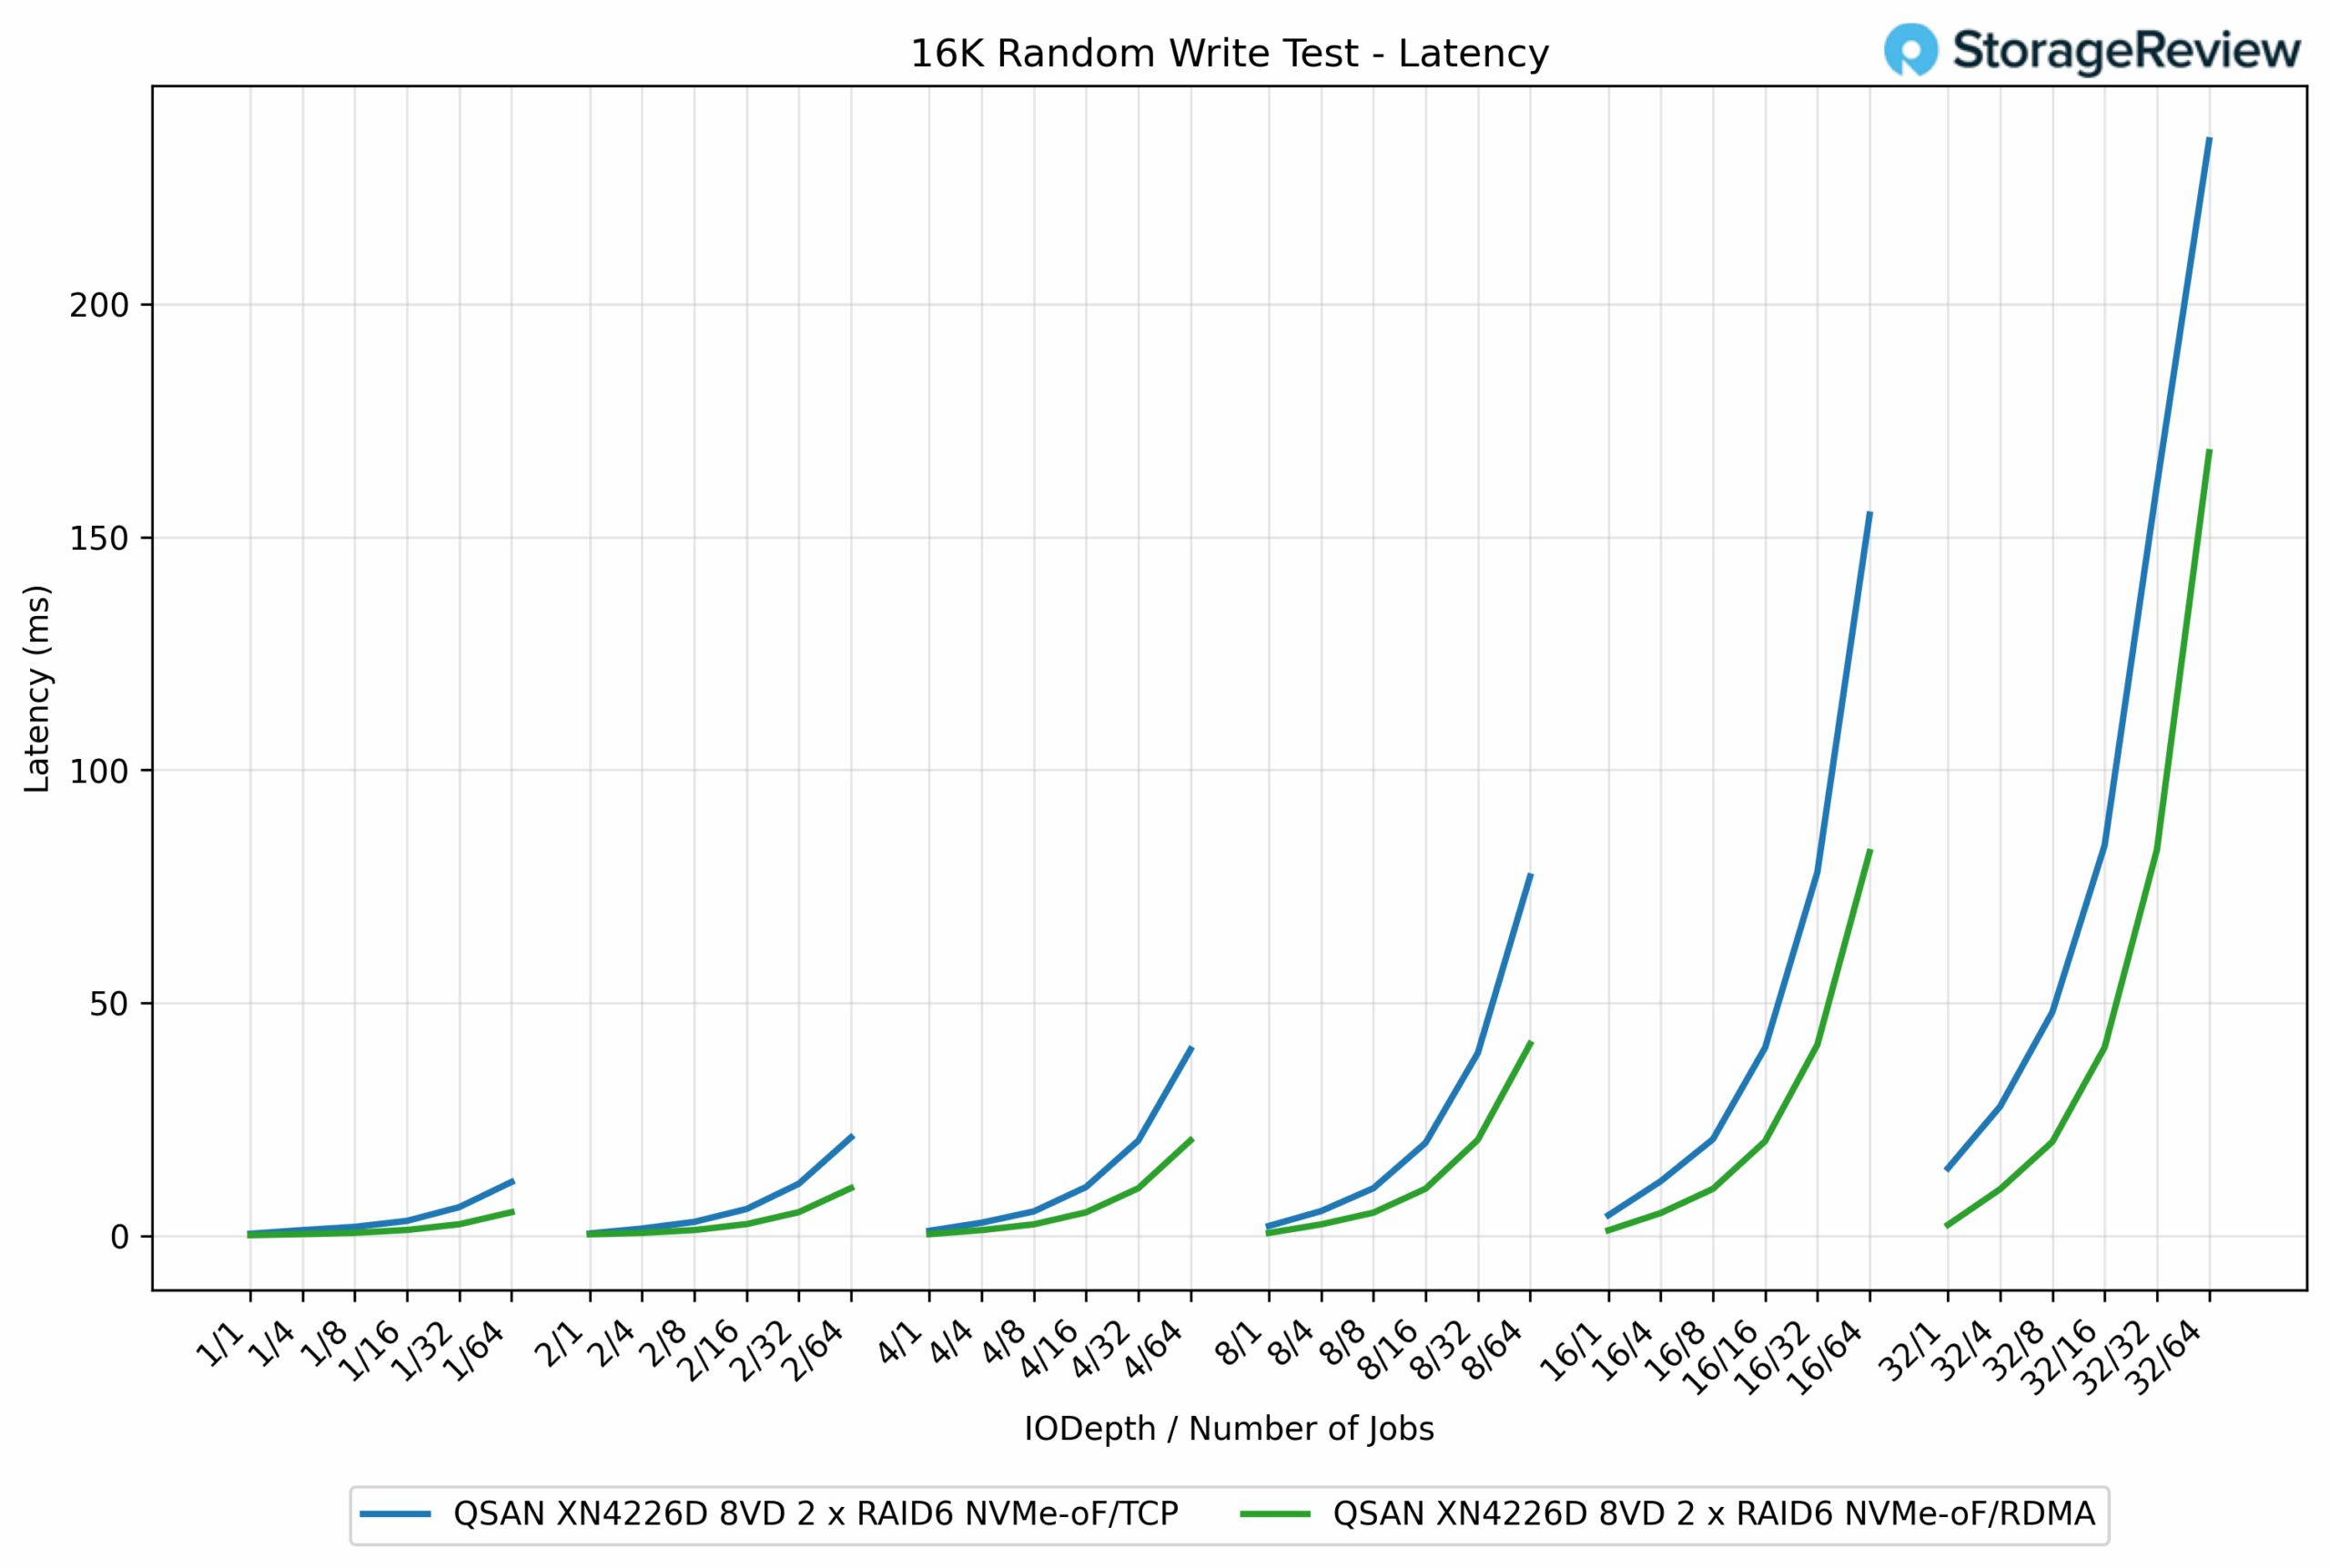
Nel test di latenza di scrittura casuale a 16K, RDMA ha mantenuto ancora una volta un chiaro vantaggio su TCP con l'aumentare dei carichi di lavoro. Con carichi più leggeri, entrambi i protocolli erano pressoché identici, con tempi di risposta inferiori a 2 ms. Ad esempio, nel job QD1/1, TCP ha misurato 0.40 ms rispetto agli 0.41 ms di RDMA.
Con l'aumentare della concorrenza, RDMA ha iniziato a separarsi. A QD16/64 processi, RDMA ha registrato 21.15 ms, mentre TCP si è attestato a 77.12 ms, con una drastica riduzione del 72%. Questo vantaggio si è mantenuto alle profondità più elevate. A QD32/64 processi, RDMA si è completato in 161.13 ms, rispetto ai 235.17 ms di TCP, con un miglioramento del 31%.
IOPS di lettura casuale 16K
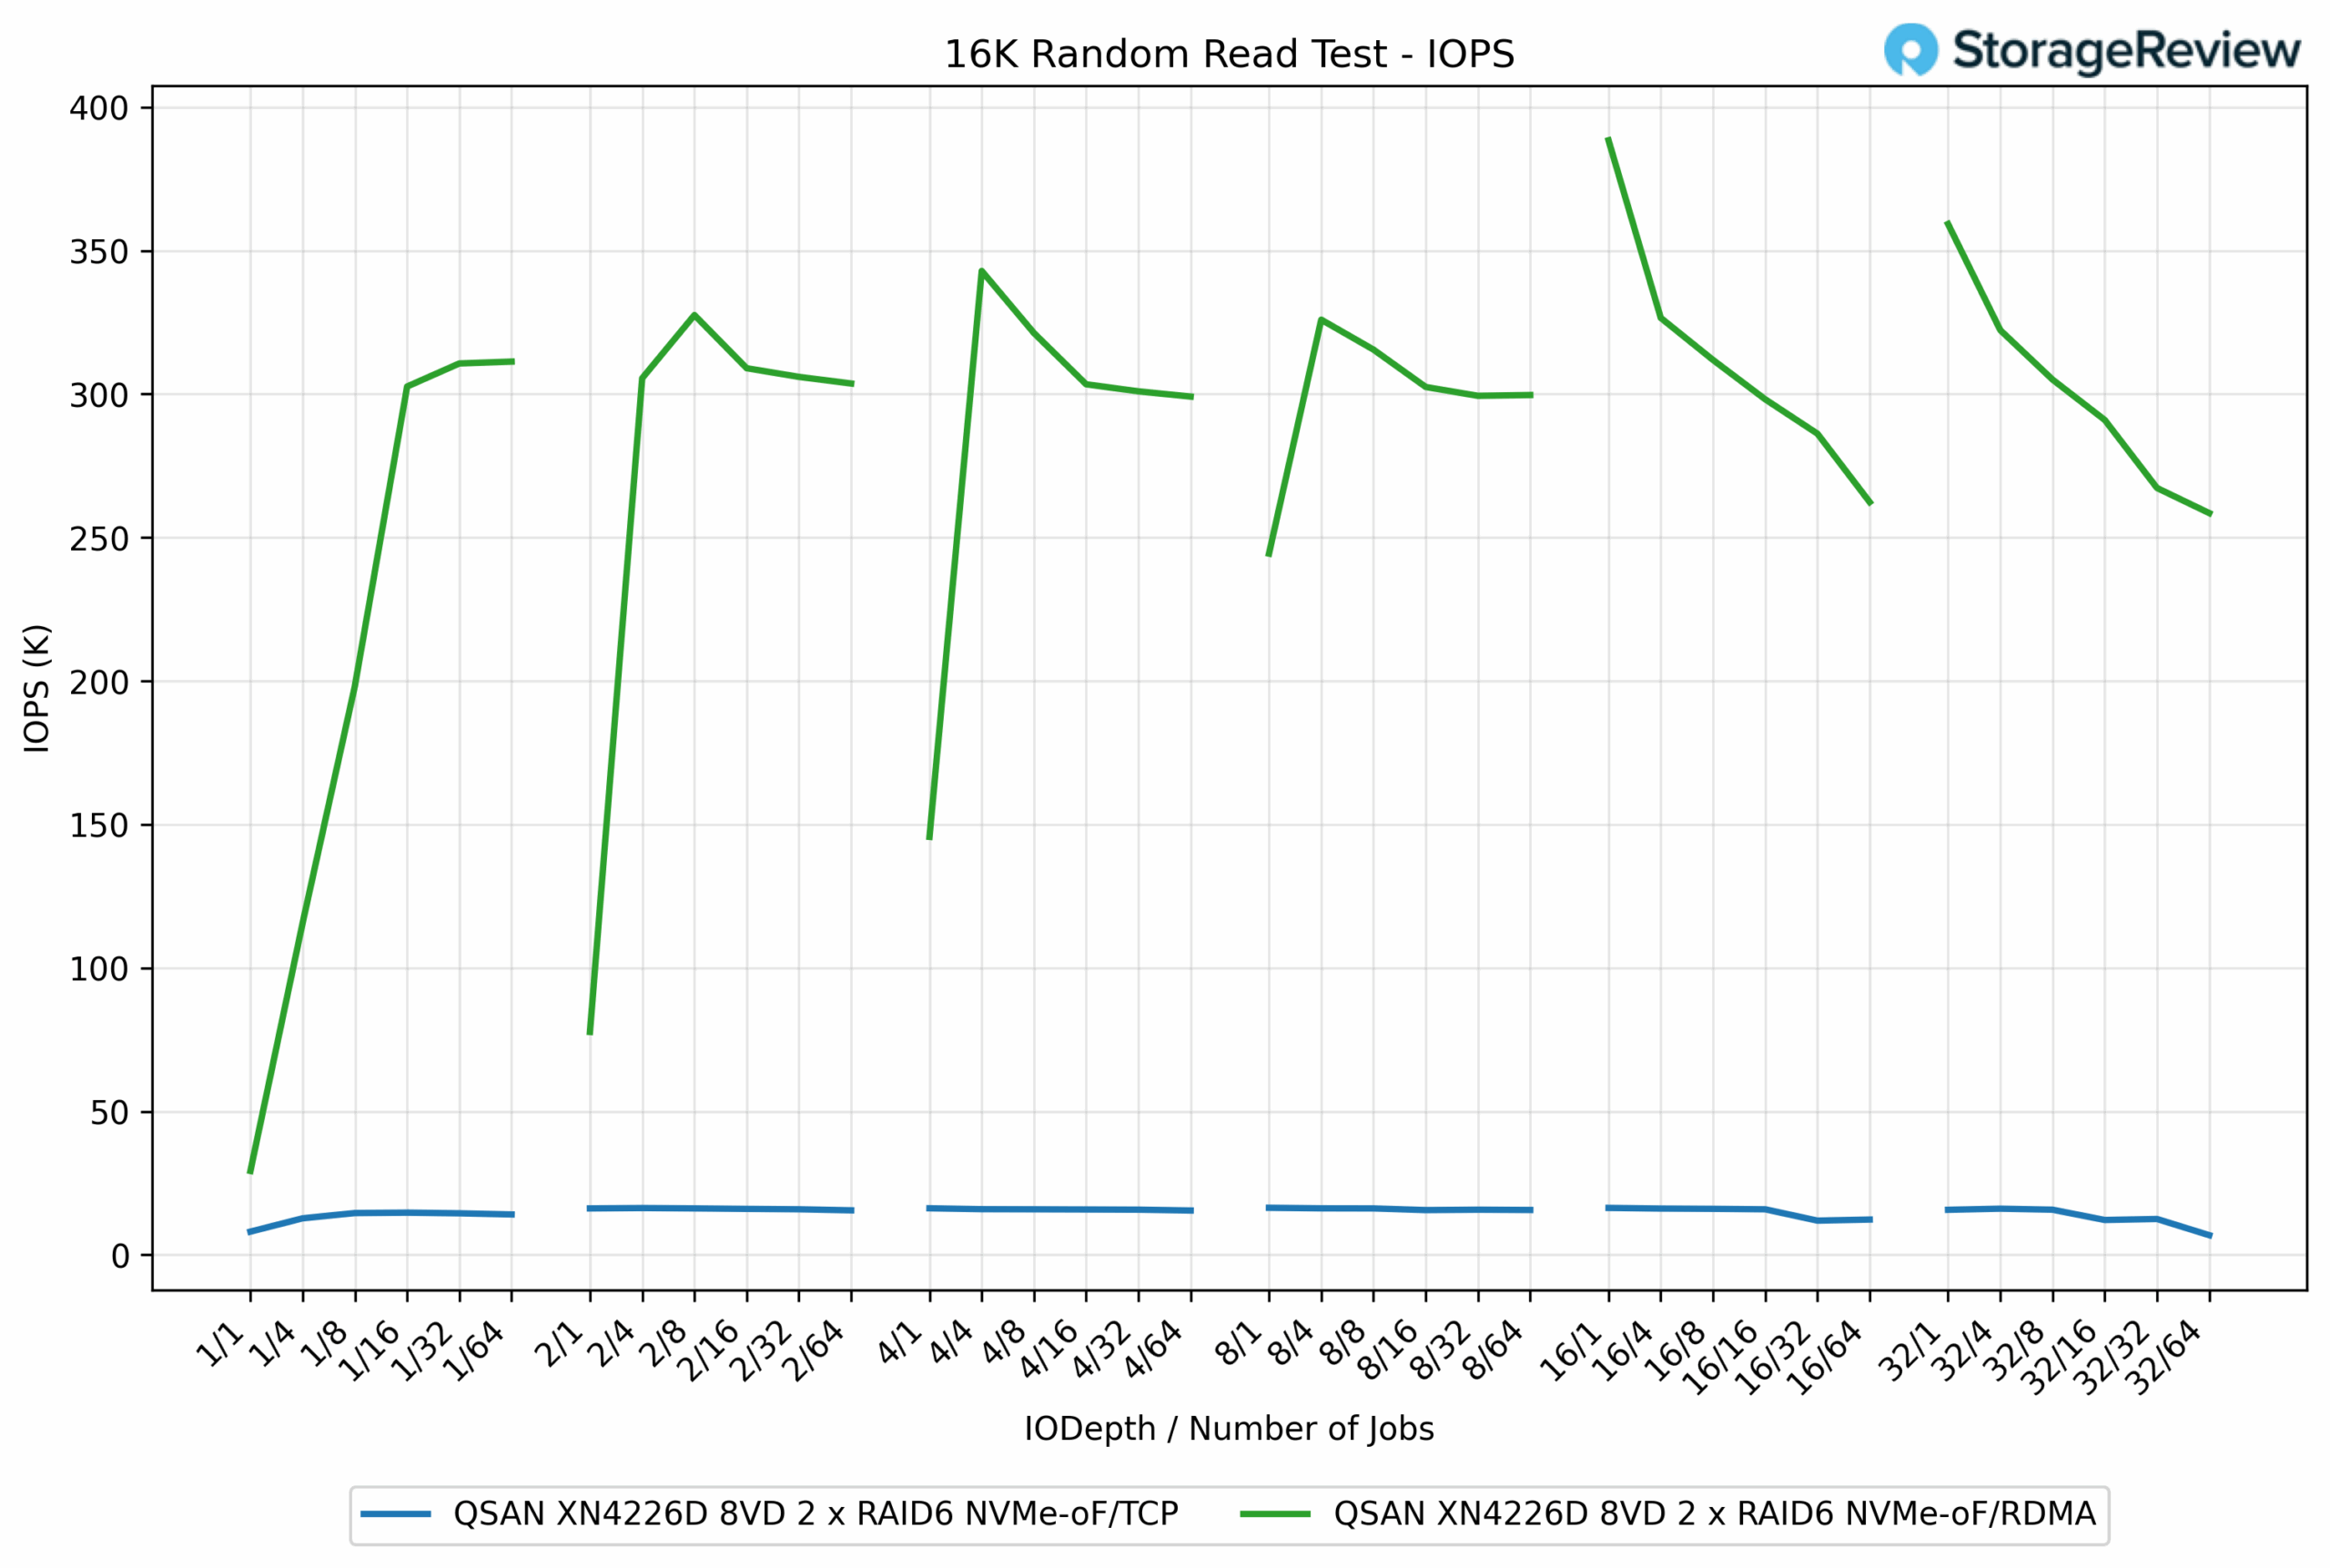
Nel test di lettura casuale a 16K, RDMA ha superato nettamente TCP nell'intera gamma di carichi di lavoro. RDMA ha raggiunto un picco di 388.44K IOPS, mentre TCP si è fermato a soli 16.42K IOPS, dimostrando un vantaggio di oltre 23 volte per RDMA.
La disparità era evidente fin dall'inizio. Nel job QD1/1, RDMA erogava 29.27K IOPS, mentre TCP ne gestiva solo 8.10K. Con l'aumento della concorrenza, RDMA è rapidamente passata a un intervallo di IOPS compreso tra 300K e 380K, mentre TCP si è stabilizzato intorno a 15K-16K IOPS, anche a profondità di coda più elevate.
Latenza di lettura casuale 16K
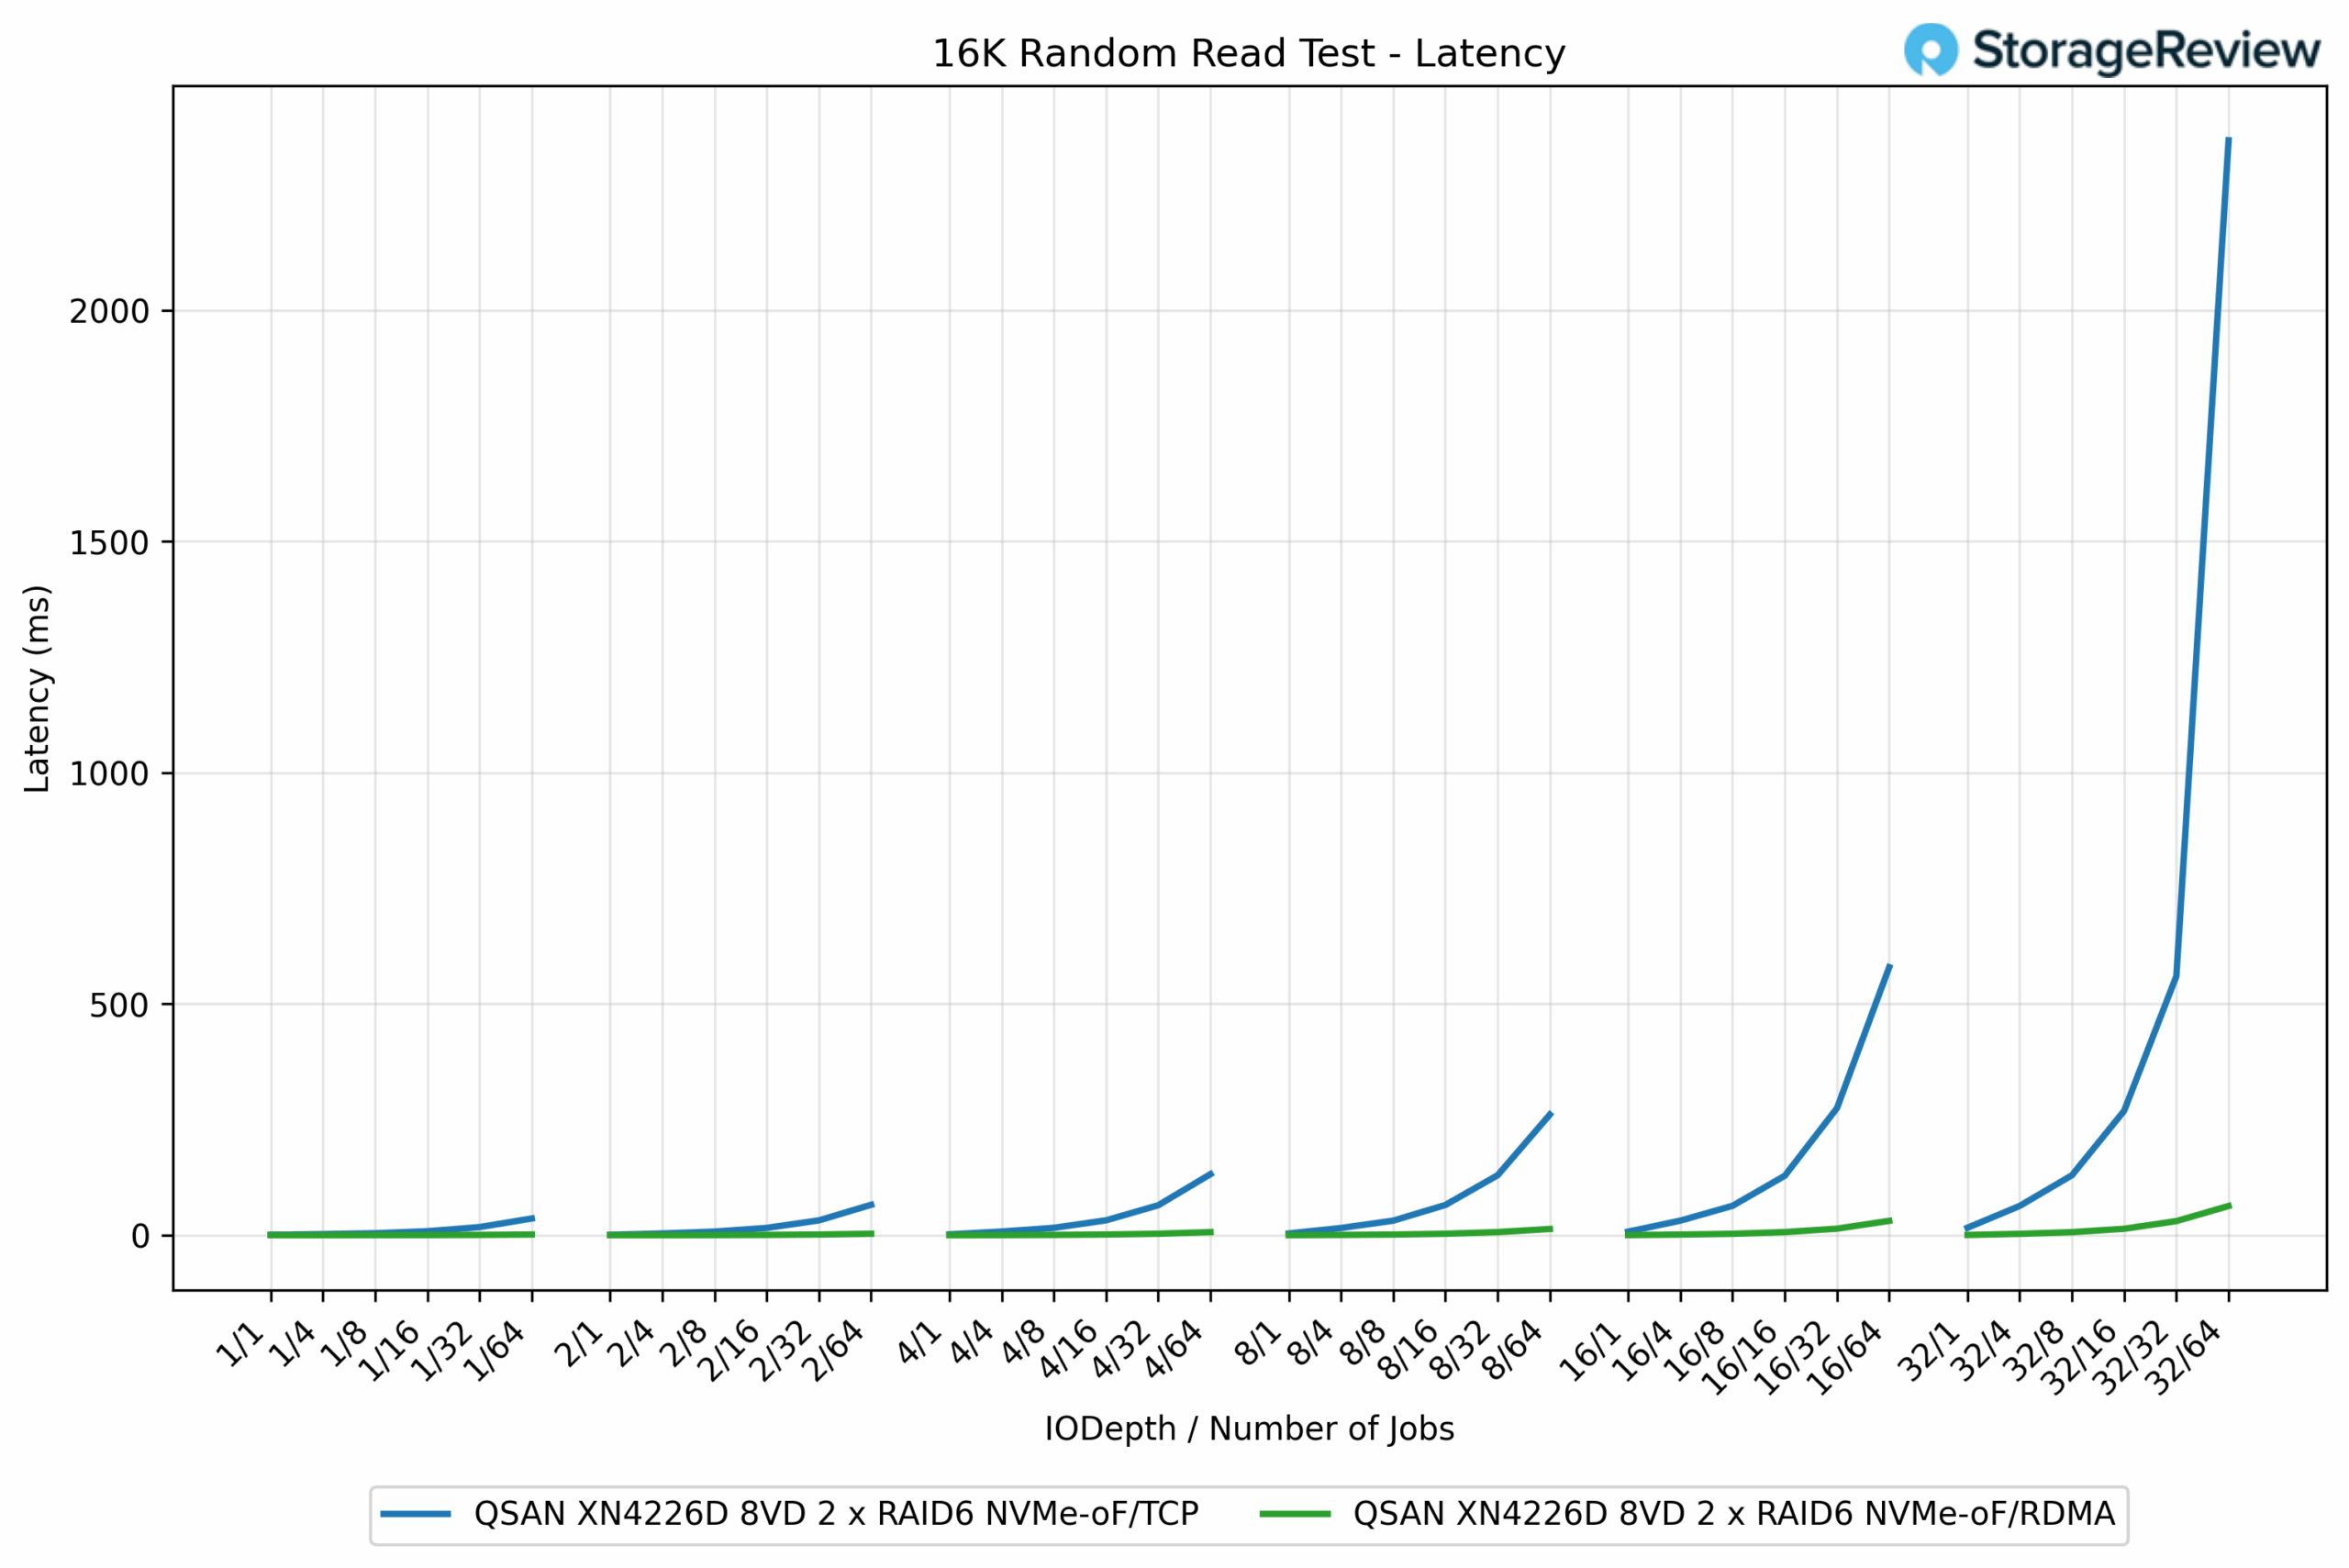
Nel test di latenza di lettura casuale a 16K, la differenza tra RDMA e TCP è stata notevole, rispecchiando i risultati IOPS. Con carichi di lavoro leggeri, i due protocolli erano quasi identici, con latenze comprese tra 1 e 10 ms.
Con l'aumento dei carichi di lavoro, RDMA ha mantenuto la latenza sotto controllo, mentre TCP si è deteriorato significativamente. Nei processi Q8/64, RDMA ha registrato un tempo di 13.65 ms, rispetto ai 260.90 ms di TCP, con un miglioramento di quasi 19 volte. Infine, i processi QD32/64 hanno completato RDMA in 63.28 ms, mentre TCP ha impiegato 2,366.99 ms, quasi 37 volte in più.
IOPS in scrittura casuale 4K
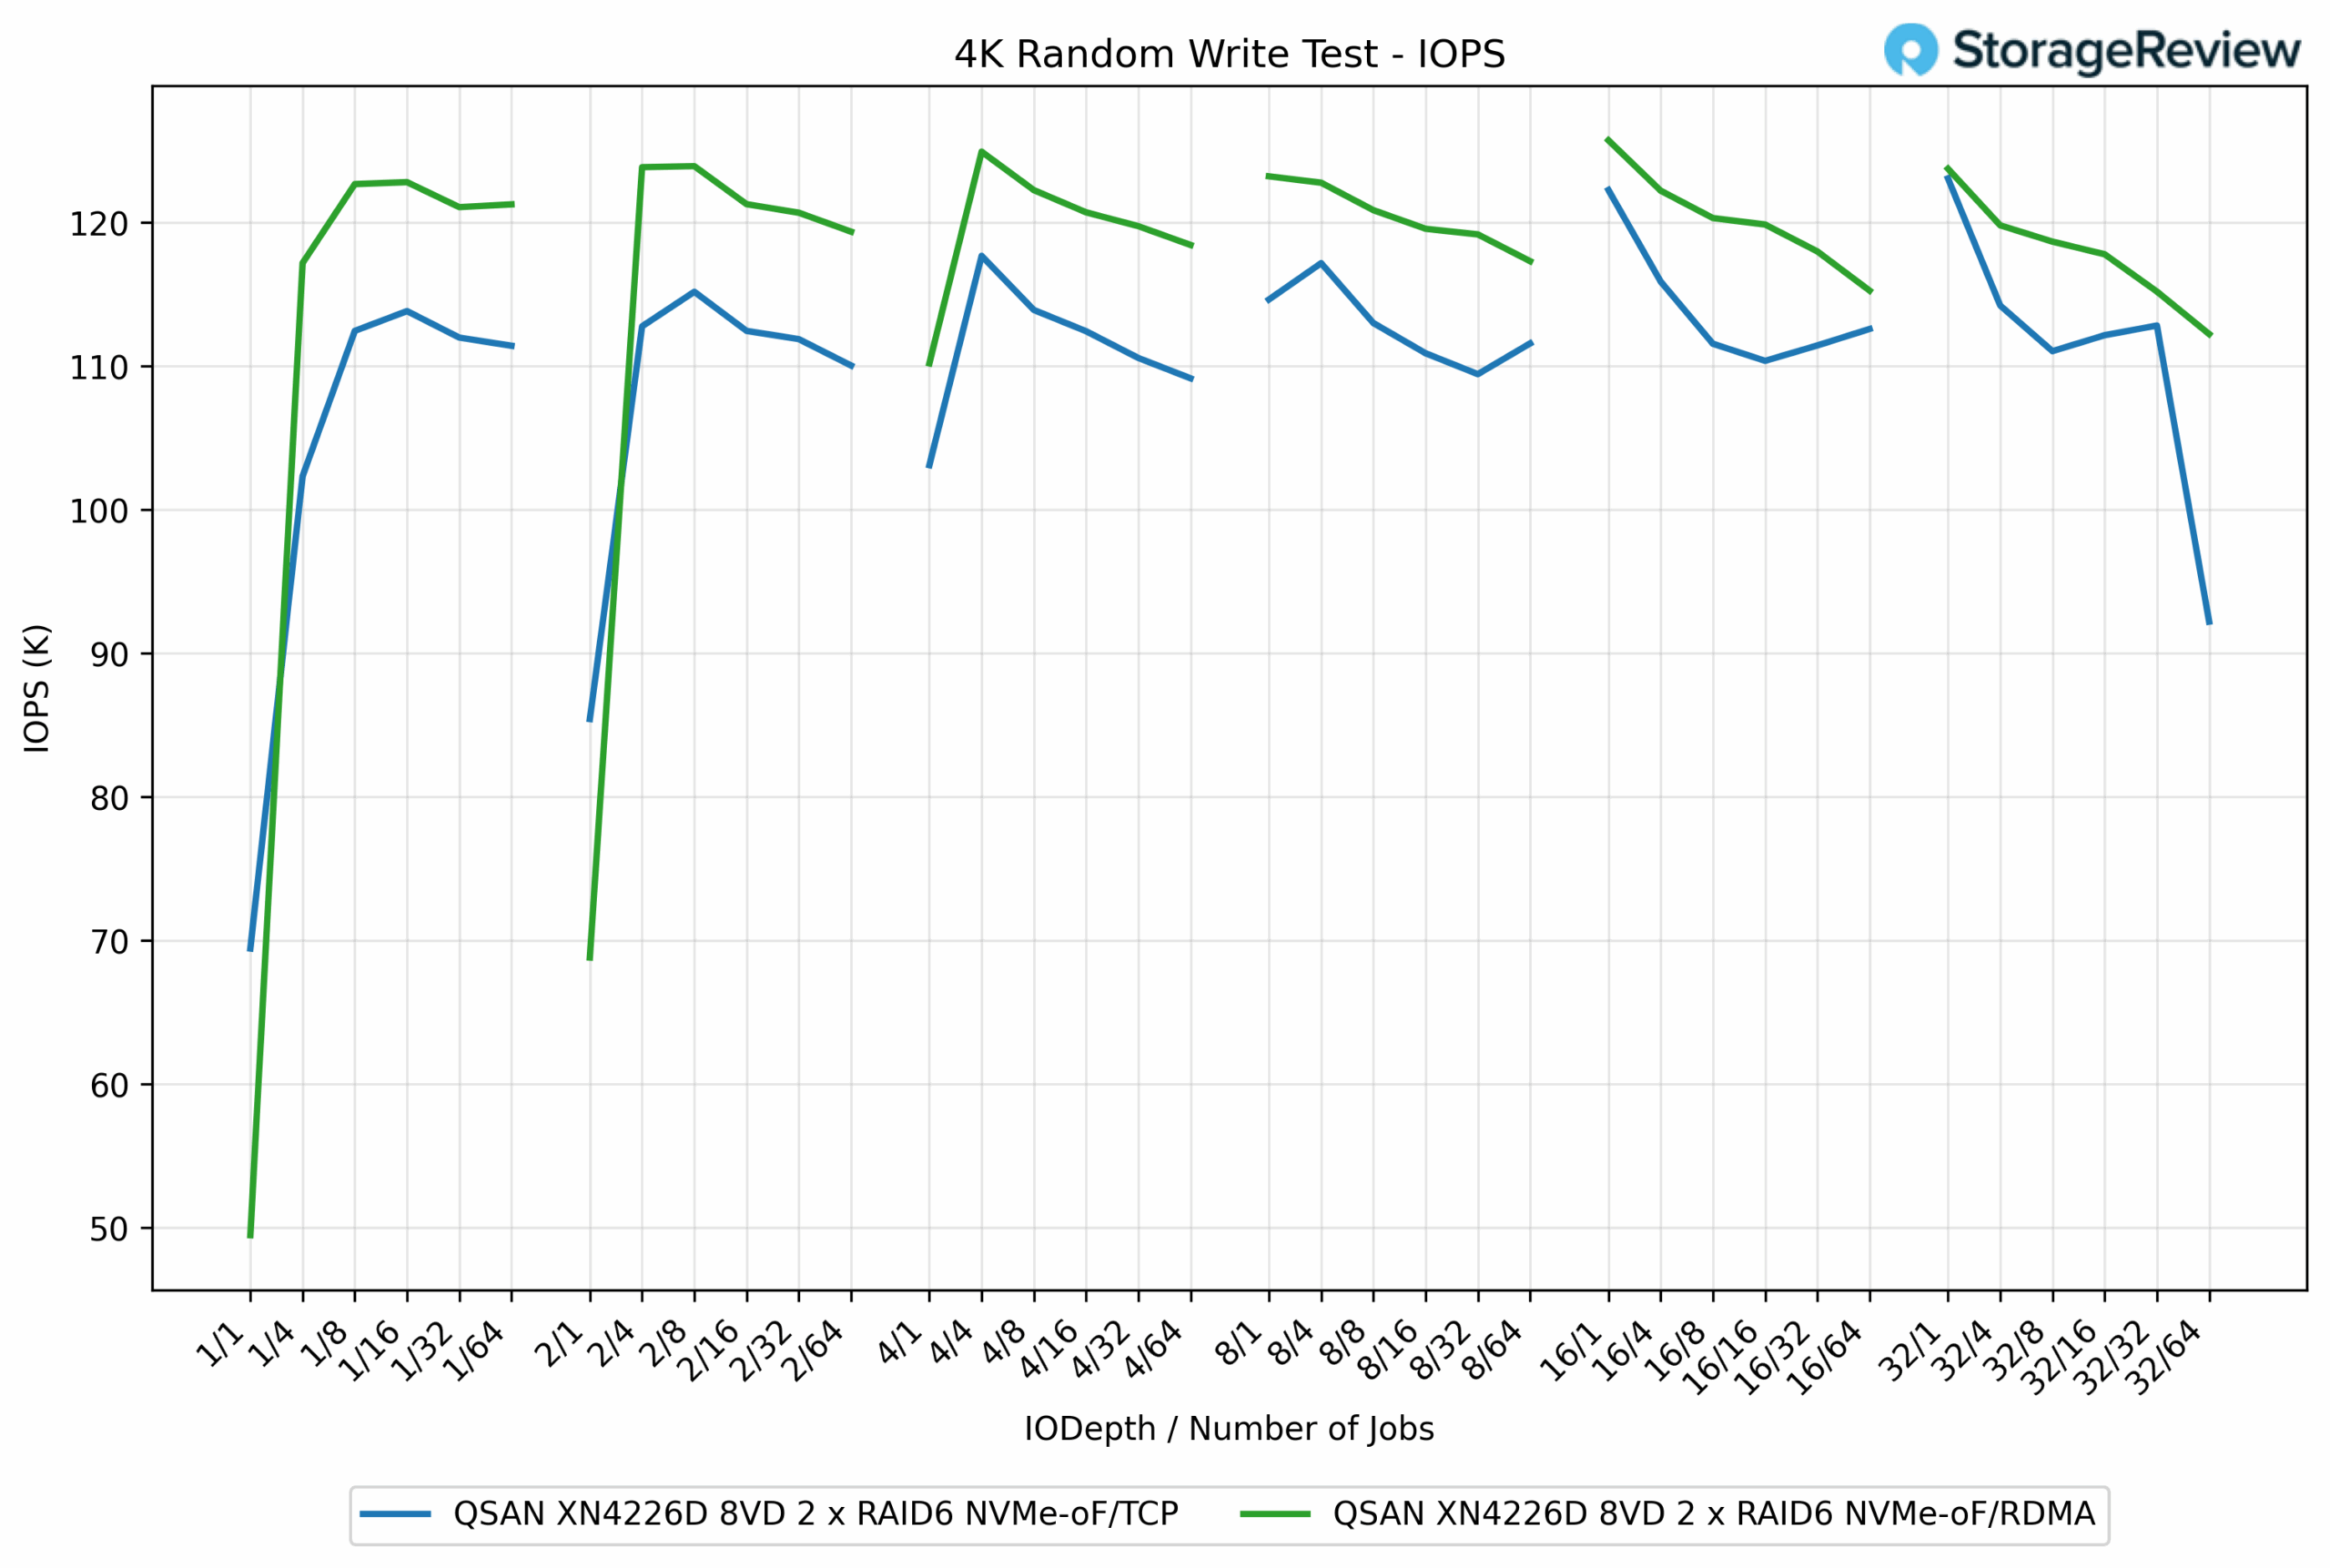
Nel test di scrittura casuale 4K, RDMA ha costantemente superato TCP, sebbene il margine fosse inferiore rispetto ai carichi di lavoro con blocchi di dimensioni maggiori. RDMA ha raggiunto un picco di 125.73K IOPS, mentre TCP ha raggiunto 115.89K IOPS, con un vantaggio di circa l'8.5% per RDMA.
A profondità di coda inferiori, TCP è rimasto leggermente indietro rispetto a RDMA, pur offrendo prestazioni competitive. Ad esempio, nei job QD1/16, RDMA ha raggiunto 122.82K IOPS, rispetto ai 111.91K IOPS di TCP, con un miglioramento di quasi il 10%. Nella maggior parte dei punti di test, RDMA si è attestato nell'intervallo tra 120K e 125K IOPS, mentre TCP ha mantenuto risultati tra 110K e 116K IOPS, con un calo tardivo nei job QD32/64 a 92.21K IOPS.
Latenza di scrittura casuale di 4K
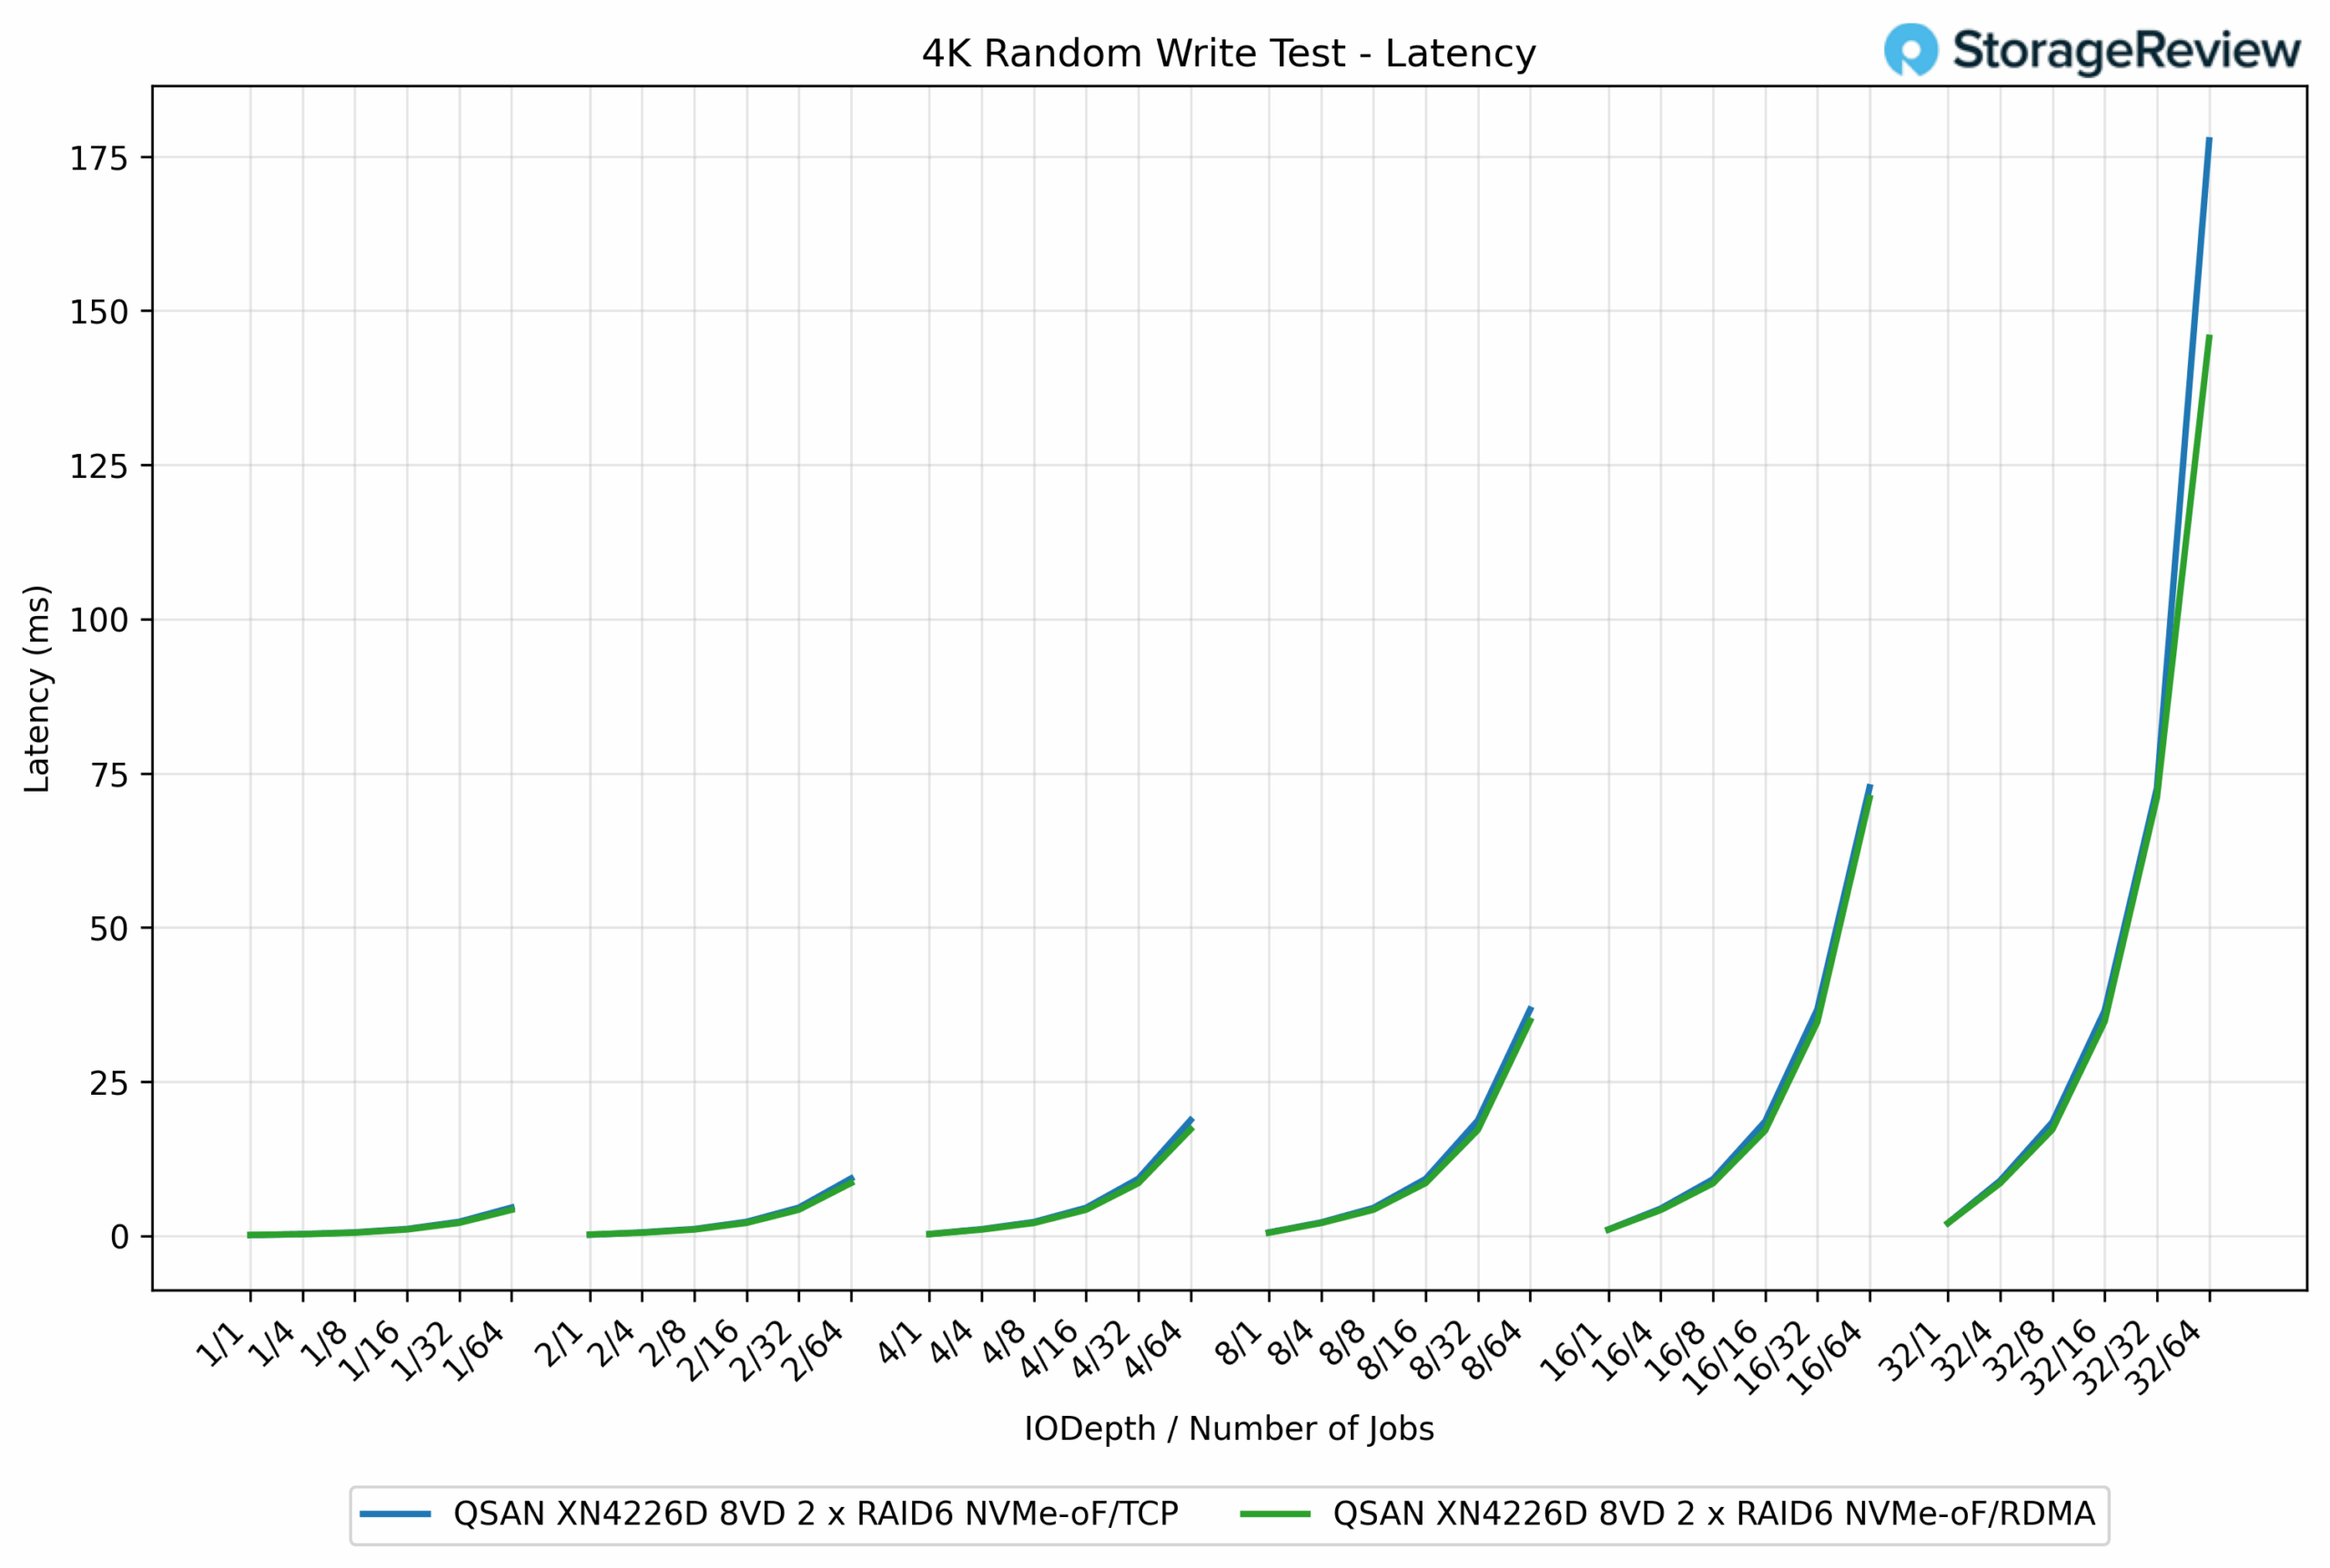
Nel test di latenza in scrittura casuale 4K, RDMA ha mostrato costantemente tempi di risposta inferiori rispetto a TCP, sebbene i margini fossero più ristretti rispetto ai carichi di lavoro a blocchi più grandi. Con carichi più leggeri, entrambi i protocolli erano pressoché identici, rimanendo entrambi al di sotto di 1 ms. Ad esempio, a QD1/1, TCP ha misurato 0.16 ms, mentre RDMA si è attestato a 0.21 ms.
Con l'aumentare della concorrenza, le differenze sono diventate più evidenti. A QD16/64 job, RDMA ha registrato 19.36 ms, rispetto ai 36.20 ms di TCP, con una riduzione del 46% della latenza per RDMA. Alla massima profondità, RDMA ha completato il processo in 145.61 ms, mentre TCP è salito a 177.62 ms, con un miglioramento del 22% per RDMA.
IOPS di lettura casuale 4K
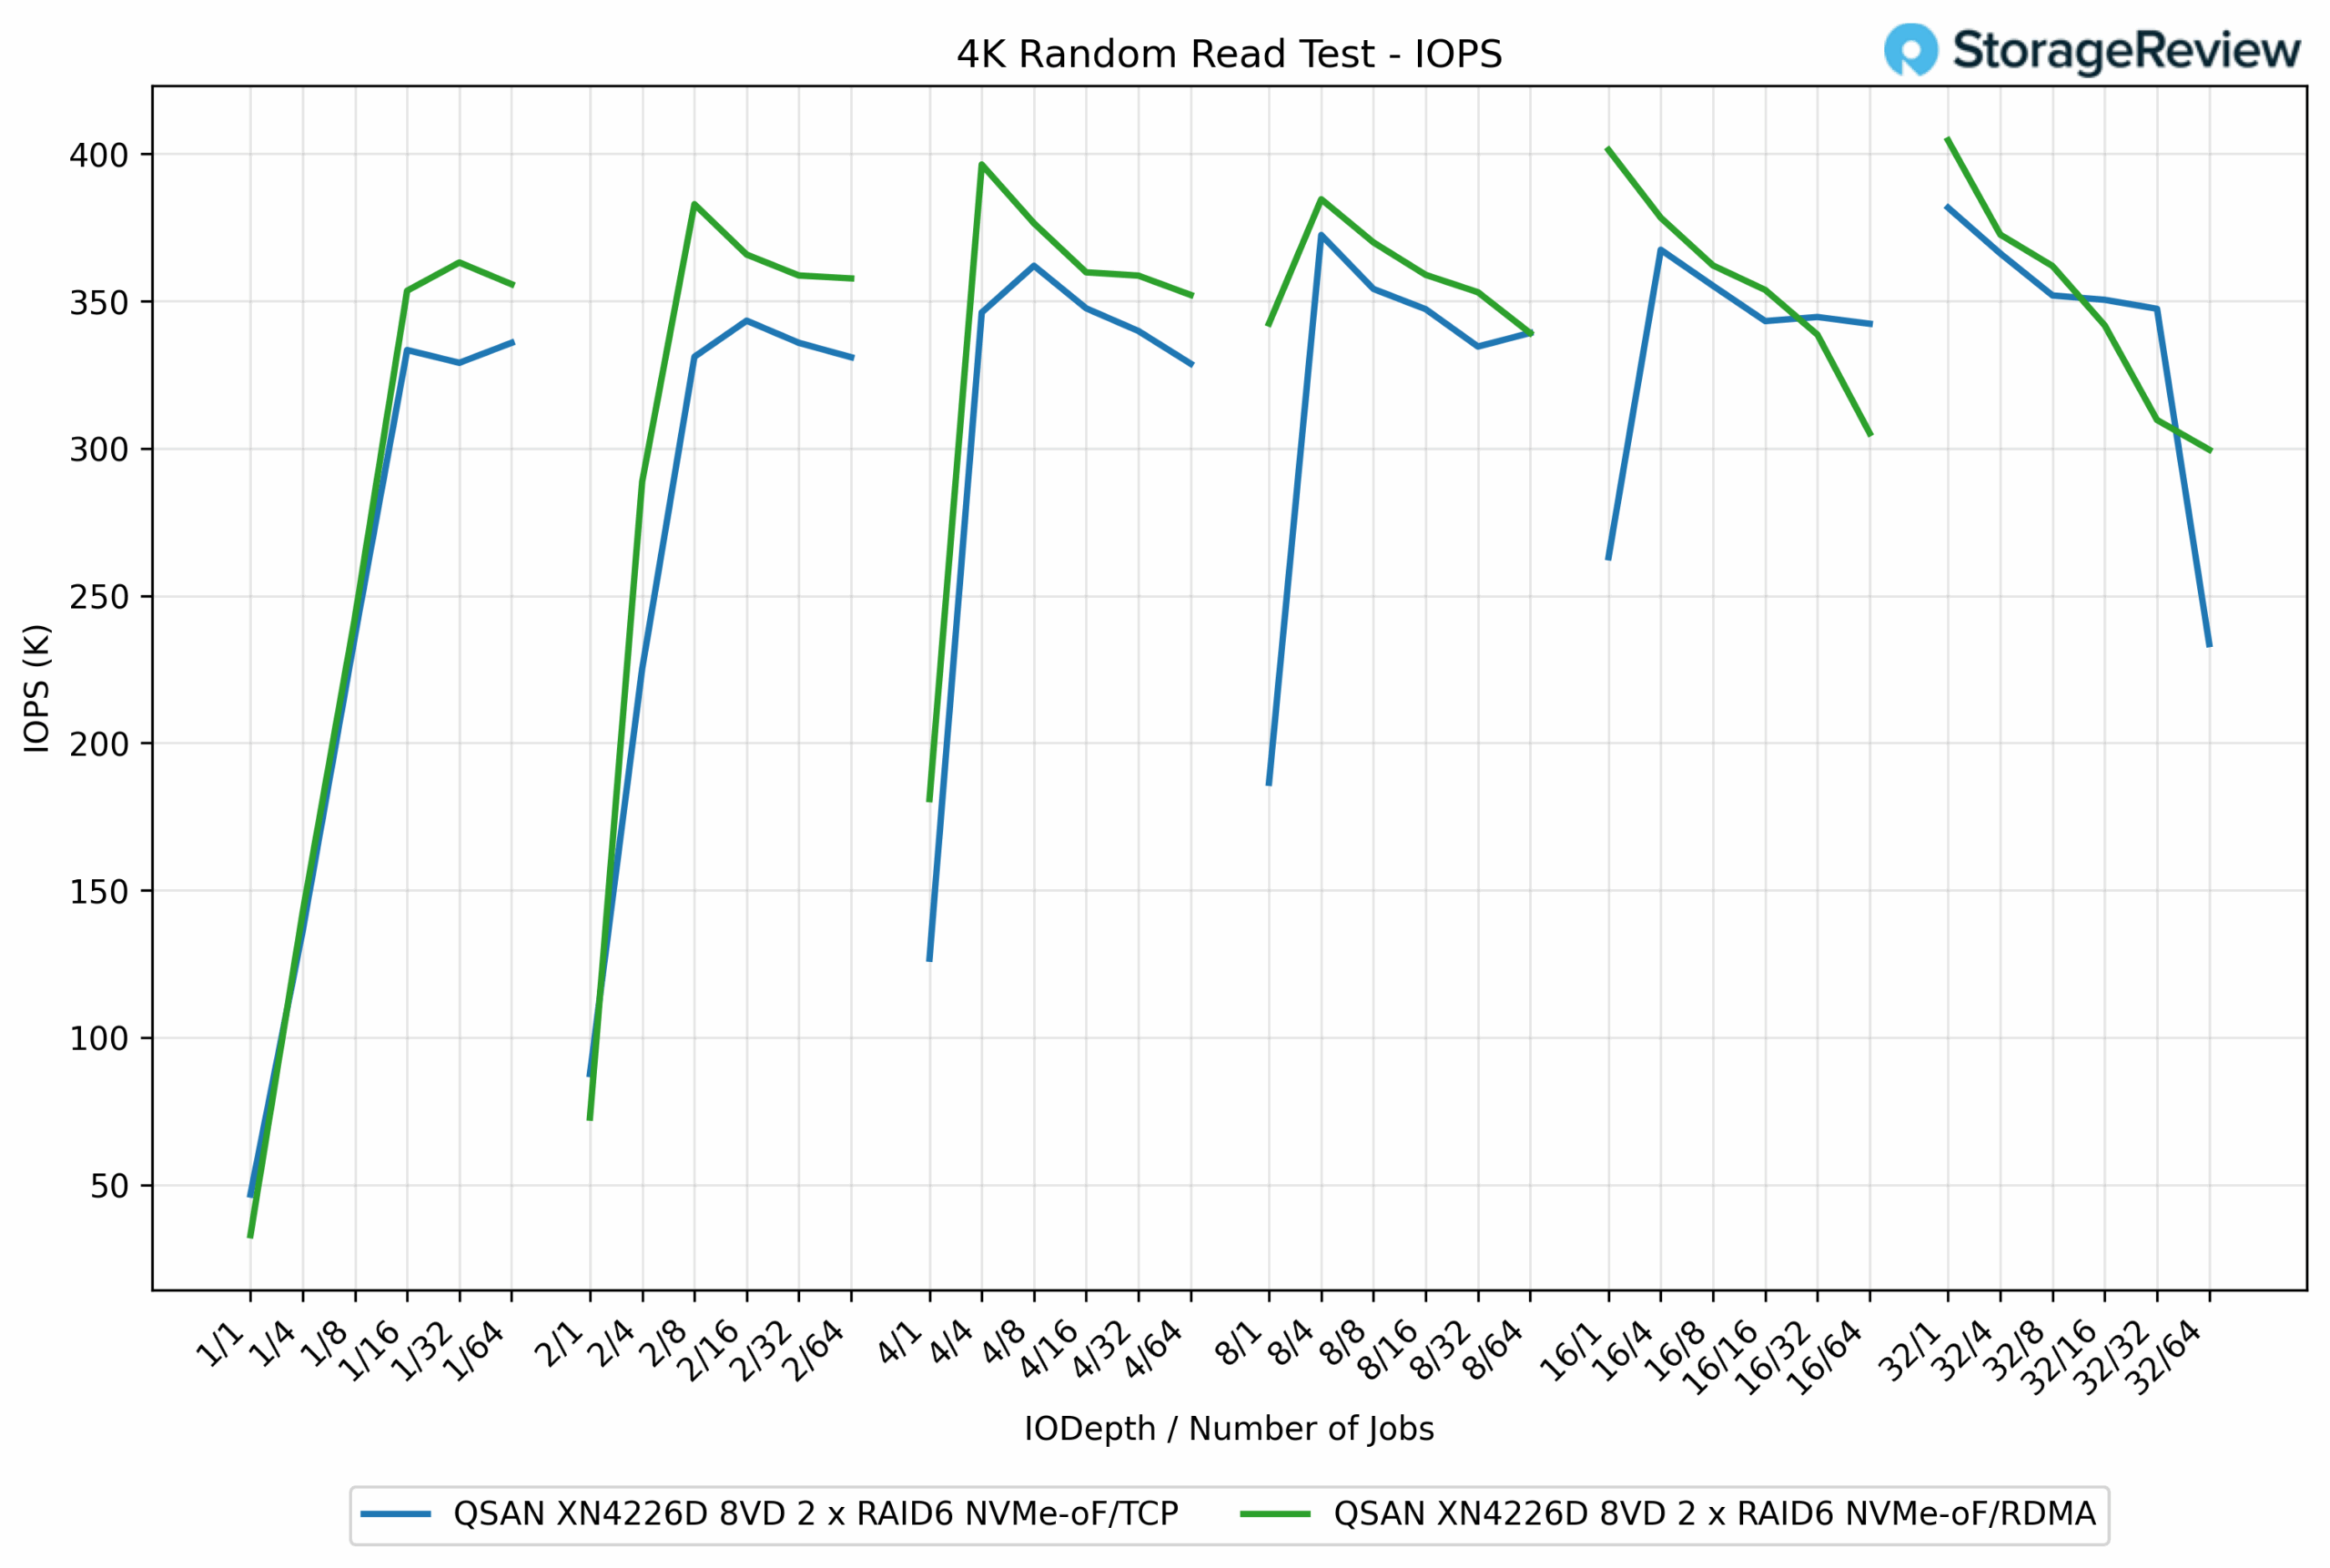
Nel test di lettura casuale 4K, entrambi i protocolli hanno offerto prestazioni elevate, sebbene RDMA abbia mantenuto costantemente un leggero vantaggio su TCP. RDMA ha raggiunto un picco di 404.64K IOPS, mentre TCP ha raggiunto i 382.96K IOPS, dando a RDMA un vantaggio del 5.7%.
A profondità inferiori, i risultati erano già a favore di RDMA. Ad esempio, nei job QD1/16, RDMA ha raggiunto 353.57K IOPS, rispetto ai 329.10K IOPS di TCP, una differenza di circa il 7.5%. Con l'aumento dei carichi di lavoro, RDMA ha mantenuto la sua leadership, operando tipicamente nell'intervallo 360K-400K IOPS, mentre TCP si è mantenuto più vicino a 330K-380K IOPS.
Latenza di lettura casuale di 4K
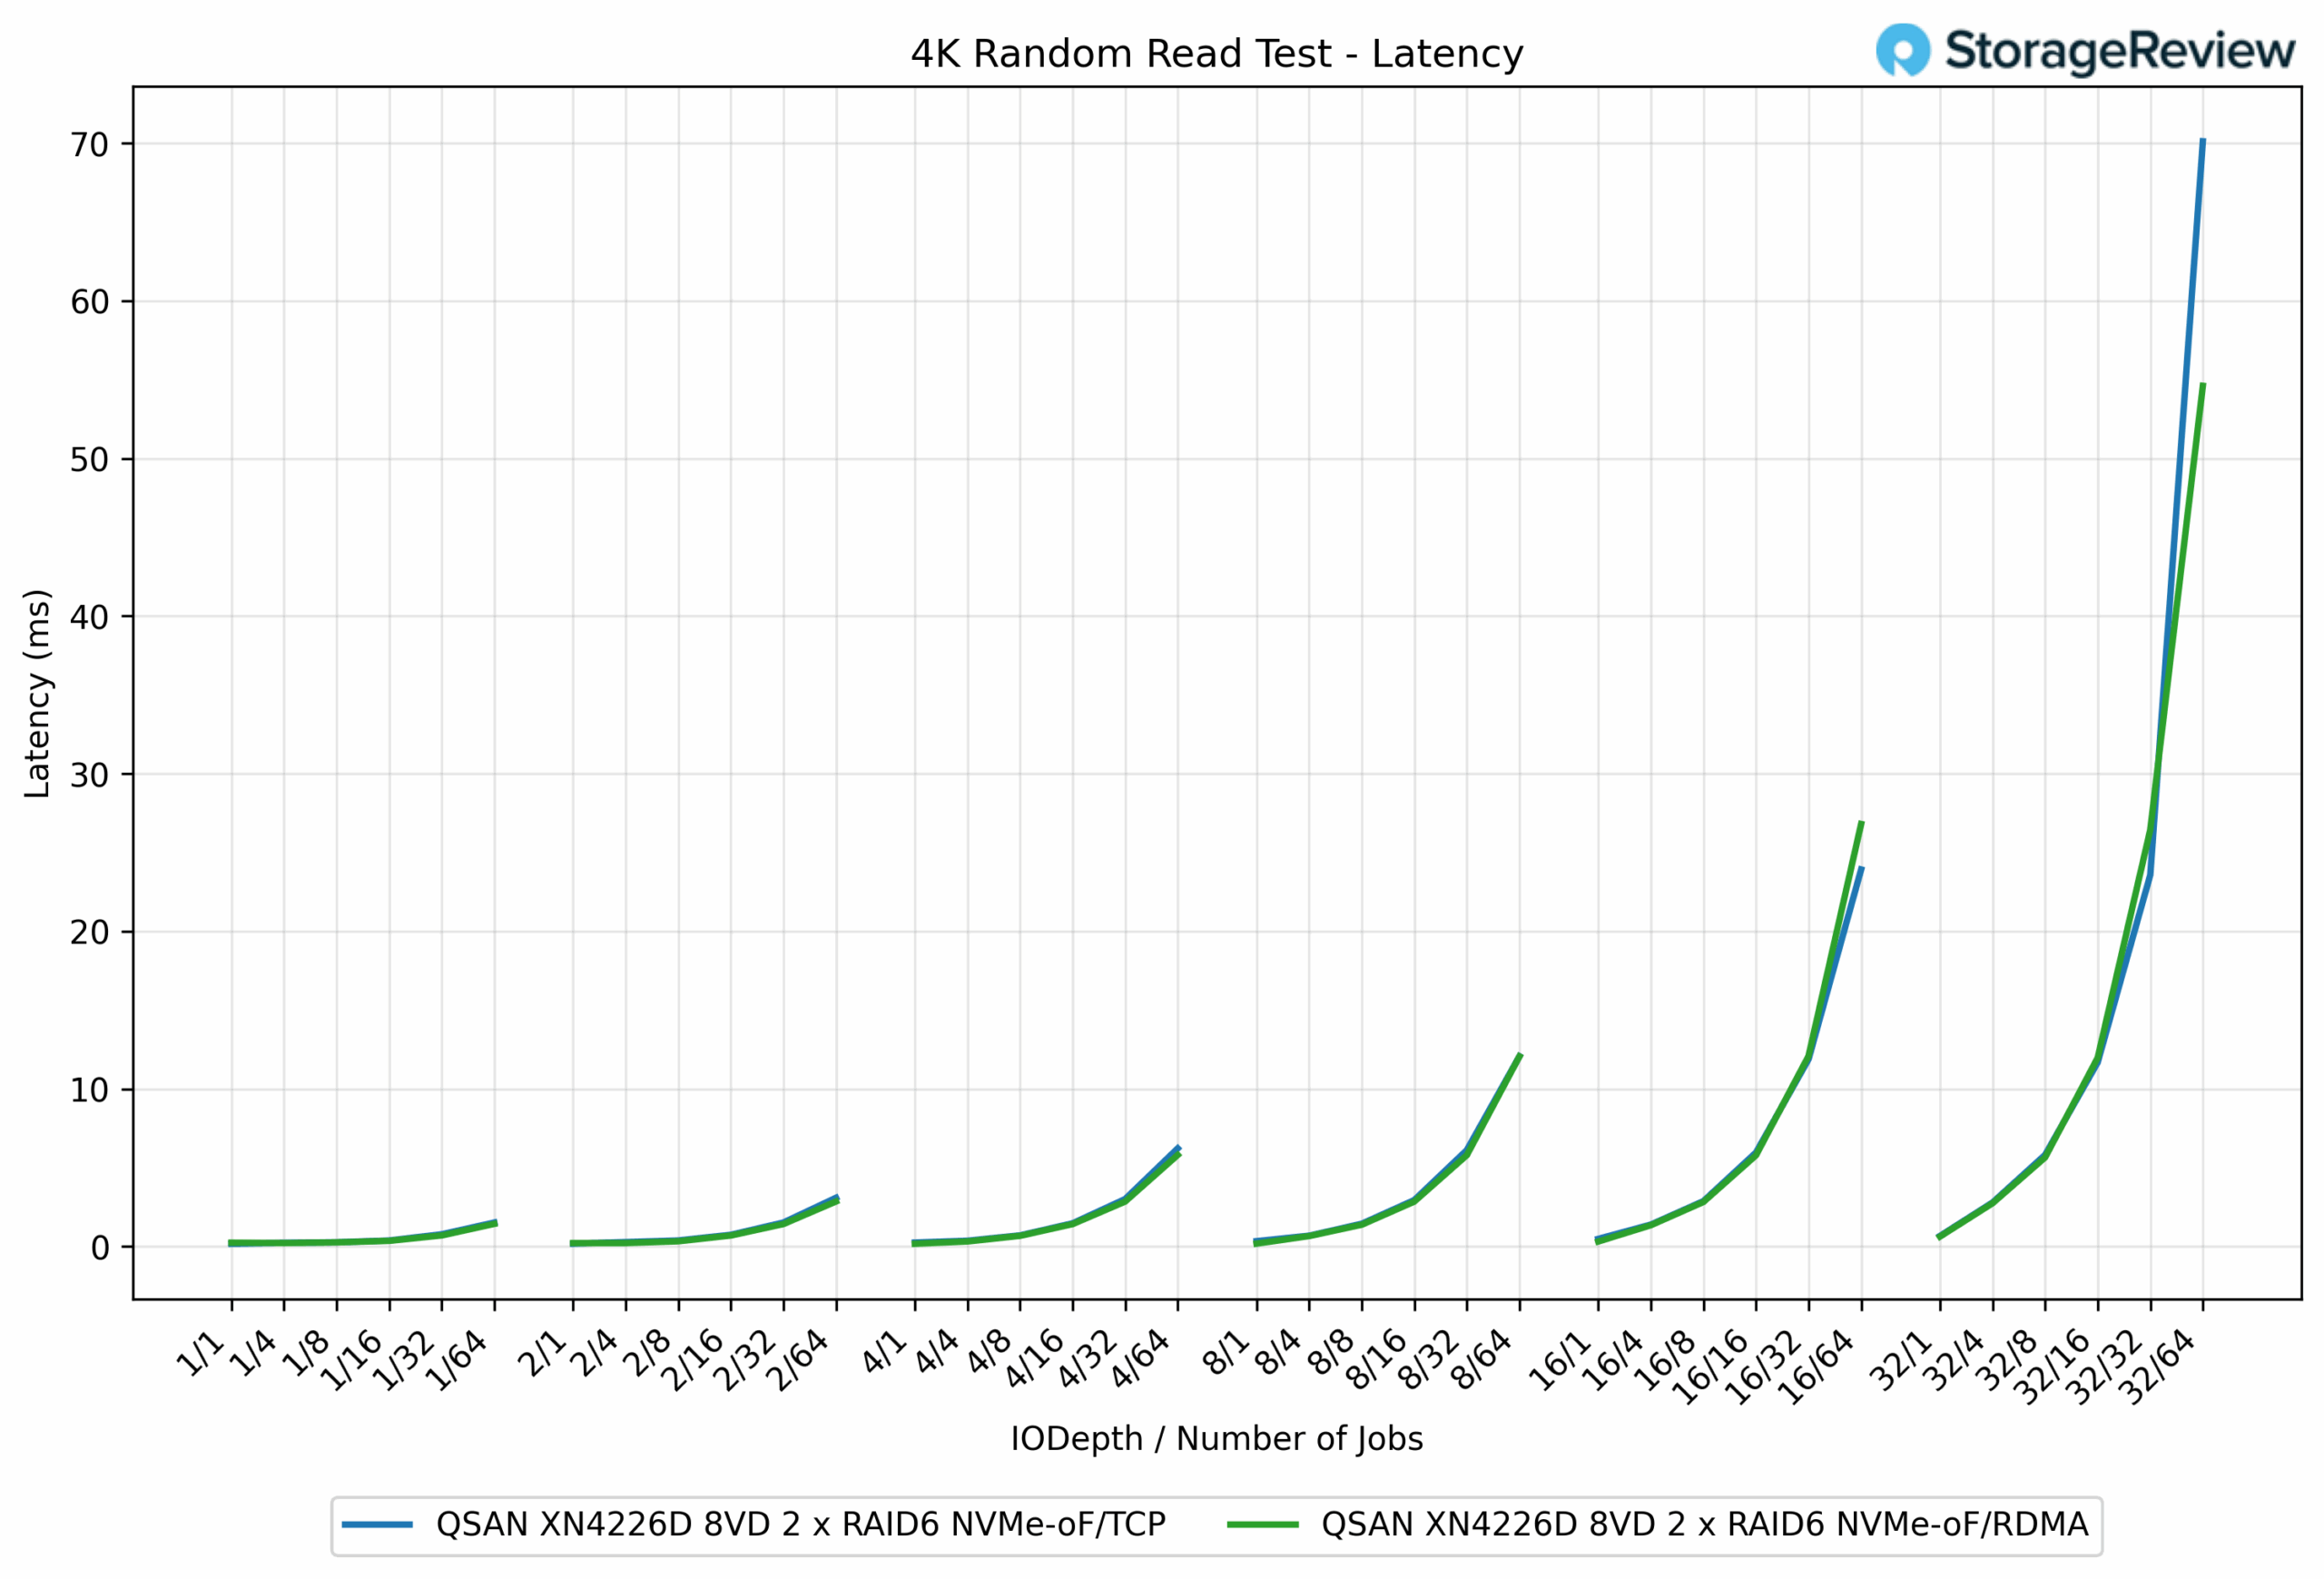
Nel test di latenza di lettura casuale 4K, RDMA ha dimostrato un chiaro vantaggio in termini di efficienza rispetto a TCP, in particolare all'aumentare della scalabilità dei carichi di lavoro. A profondità di coda ridotte, i due protocolli erano pressoché identici. Ad esempio, nel job QD1/1, TCP ha registrato 0.24 ms, mentre RDMA si è posizionato appena dietro, con 0.27 ms.
Con l'aumento della concorrenza, RDMA ha preso il sopravvento. Nei processi QD16/64, RDMA ha registrato un tempo di completamento di 23.92 ms, mentre TCP si è attestato a 26.81 ms, con un miglioramento del 10.8%. Al carico massimo di processi QD32/64, RDMA ha completato i processi in 54.61 ms, mentre TCP è balzato a 70.12 ms, con una riduzione del 22% della latenza per RDMA.
Prestazioni di archiviazione GPUDirect
Uno dei test che abbiamo condotto su questo banco di prova è stato il test GPUDirect Storage (GDS) di Magnum IO. GDS è una funzionalità sviluppata da NVIDIA che consente alle GPU di bypassare la CPU quando accedono ai dati archiviati su unità NVMe o altri dispositivi di archiviazione ad alta velocità. Invece di instradare i dati attraverso la CPU e la memoria di sistema, GDS consente la comunicazione diretta tra la GPU e il dispositivo di archiviazione, riducendo significativamente la latenza e migliorando il throughput dei dati.
Come funziona GPUDirect Storage
Tradizionalmente, quando una GPU elabora i dati memorizzati su un'unità NVMe, i dati devono prima passare attraverso la CPU e la memoria di sistema prima di raggiungere la GPU. Questo processo introduce colli di bottiglia, poiché la CPU diventa un intermediario, aggiungendo latenza e consumando preziose risorse di sistema. GPUDirect Storage elimina questa inefficienza consentendo alla GPU di accedere ai dati direttamente dal dispositivo di archiviazione tramite il bus PCIe. Questo percorso diretto riduce il sovraccarico associato allo spostamento dei dati, consentendo trasferimenti più rapidi ed efficienti.
I carichi di lavoro di intelligenza artificiale, in particolare quelli che coinvolgono il deep learning, richiedono un elevato utilizzo di dati. L'addestramento di reti neurali di grandi dimensioni richiede l'elaborazione di terabyte di dati e qualsiasi ritardo nel trasferimento dei dati può portare a GPU sottoutilizzate e tempi di addestramento più lunghi. GPUDirect Storage affronta questa sfida garantendo che i dati vengano inviati alla GPU il più rapidamente possibile, riducendo al minimo i tempi di inattività e massimizzando l'efficienza computazionale.
Inoltre, GDS è particolarmente utile per carichi di lavoro che comportano lo streaming di grandi set di dati, come l'elaborazione video, l'elaborazione del linguaggio naturale o l'inferenza in tempo reale. Riducendo la dipendenza dalla CPU, GDS accelera lo spostamento dei dati e libera risorse della CPU per altre attività, migliorando ulteriormente le prestazioni complessive del sistema.
Oltre alla larghezza di banda pura, GPUDirect con NVMe-oF (TCP/RDMA) offre anche I/O a bassissima latenza. Questo garantisce che le GPU non siano mai a corto di dati, rendendo il sistema ideale per l'inferenza AI in tempo reale, le pipeline di analisi e la riproduzione video.
Per molte implementazioni pratiche, ciò si traduce in una velocità di trasmissione utilizzabile di 100-200 GbE, allineandosi perfettamente con carichi di lavoro quali l'inferenza AI (2-4 GPU), la produzione multimediale (riproduzione broadcast, caching edge OTT), l'analisi video di sorveglianza e il checkpointing HPC.
Leggi produttività
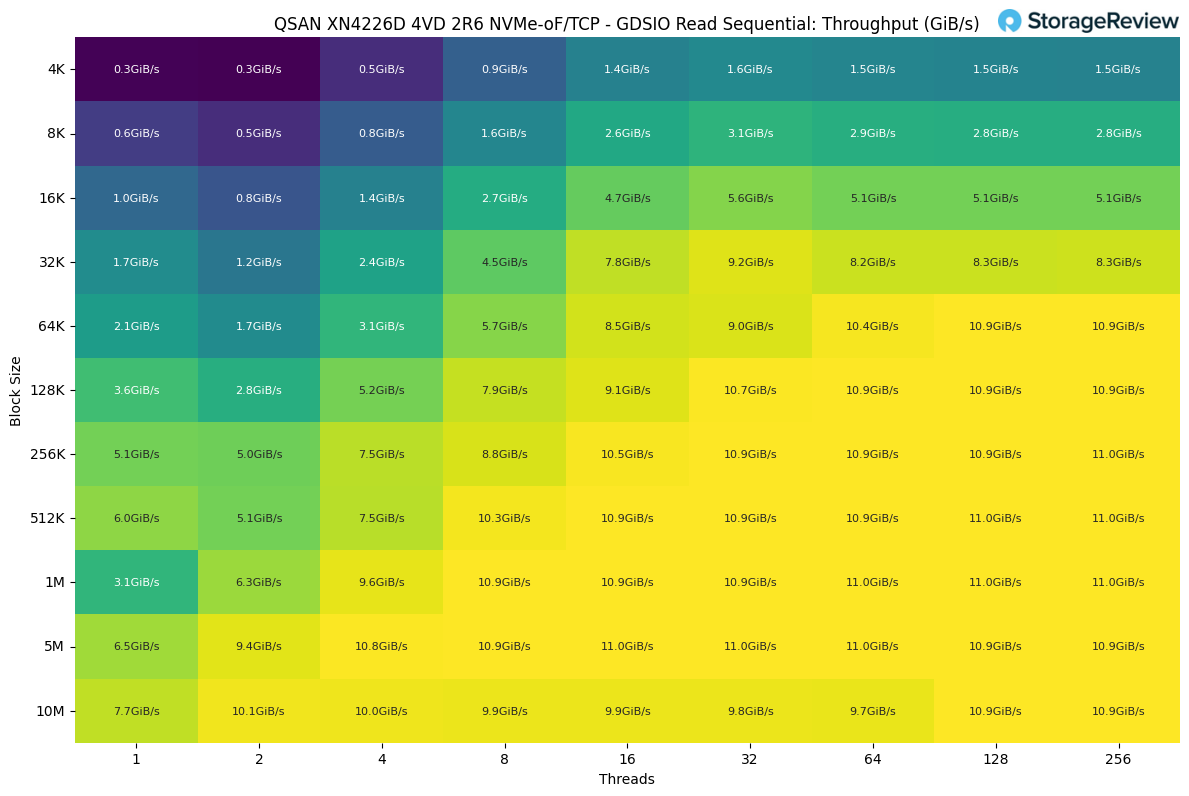
Nel carico di lavoro di lettura sequenziale GDSIO, la produttività è aumentata costantemente sia con la dimensione dei blocchi che con il numero di thread, raggiungendo un massimo di 11.0 GiB/s su più punti di test. I risultati più elevati sono stati mantenuti una volta che le dimensioni dei blocchi hanno raggiunto 512K e oltre, dove la produttività si è costantemente stabilizzata tra 10.9 e 11.0 GiB/s, indipendentemente dal numero di thread.
Con blocchi di dimensioni inferiori, le prestazioni iniziali erano molto più basse. Ad esempio, con blocchi da 4K, il throughput partiva da soli 0.3 GiB/s con un singolo thread e si stabilizzava a 1.5 GiB/s anche con 256 thread. Al contrario, l'aumento della dimensione del blocco a 64K consentiva al sistema di scalare fino a 10.9 GiB/s, quasi saturando il throughput con un numero maggiore di thread.
Il punto ottimale sembrava essere intorno ai blocchi da 128K a 256K, dove il throughput superava i 10 GiB/s con 32 o più thread e rimaneva costante per le dimensioni di blocco più grandi testate. Questo dimostra come la piattaforma raggiunga la piena saturazione della larghezza di banda quando le dimensioni dei blocchi diventano sufficientemente grandi, con solo guadagni incrementali oltre i 256K.
Leggi la latenza
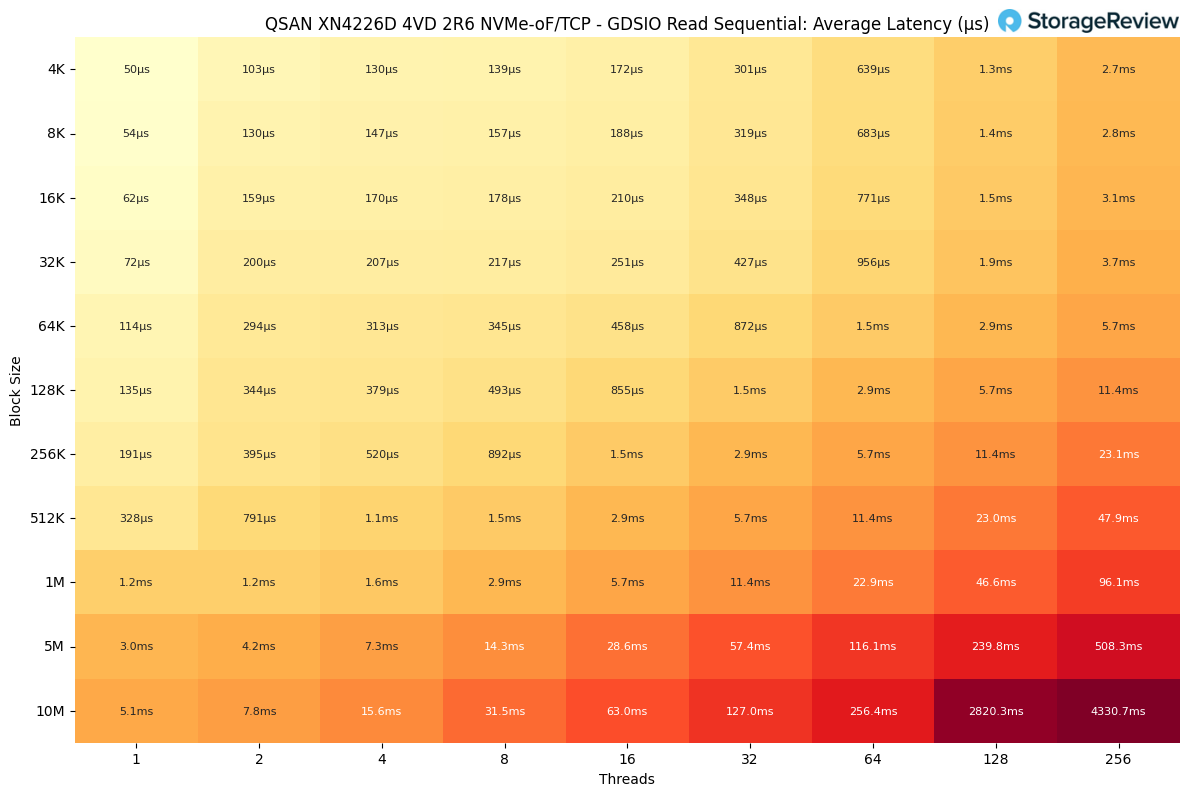
Nei risultati di latenza della lettura sequenziale GDSIO, i tempi di risposta sono aumentati in modo prevedibile sia con la dimensione del blocco che con il numero di thread. Con i carichi di lavoro più piccoli, la latenza è rimasta estremamente bassa. Ad esempio, con blocchi da 4K in un singolo thread, la latenza si è attestata su soli 50 µs, rimanendo al di sotto dei 200 µs fino a blocchi da 32K con una concorrenza minima.
Con l'aumento del numero di thread, la latenza ha iniziato ad aumentare in modo più evidente. A blocchi da 64K e 64 thread, la latenza ha raggiunto 1.5 ms, raddoppiando a 2.9 ms a 128 thread e salendo a 5.7 ms a 256 thread. Al contrario, blocchi di dimensioni inferiori, come 4K e 8K, si sono spinti solo nell'intervallo 2.7-2.8 ms, anche al massimo di 256 thread, mostrando un controllo più rigoroso a granularità più fini.
Blocchi di dimensioni maggiori hanno creato salti più significativi. A 1 milione di blocchi e 256 thread, la latenza ha raggiunto 96.1 ms, mentre a 10 milioni di blocchi e 256 thread ha raggiunto i 4.3 s, mostrando chiaramente i limiti di scalabilità del sistema in condizioni estreme.
Velocità di scrittura
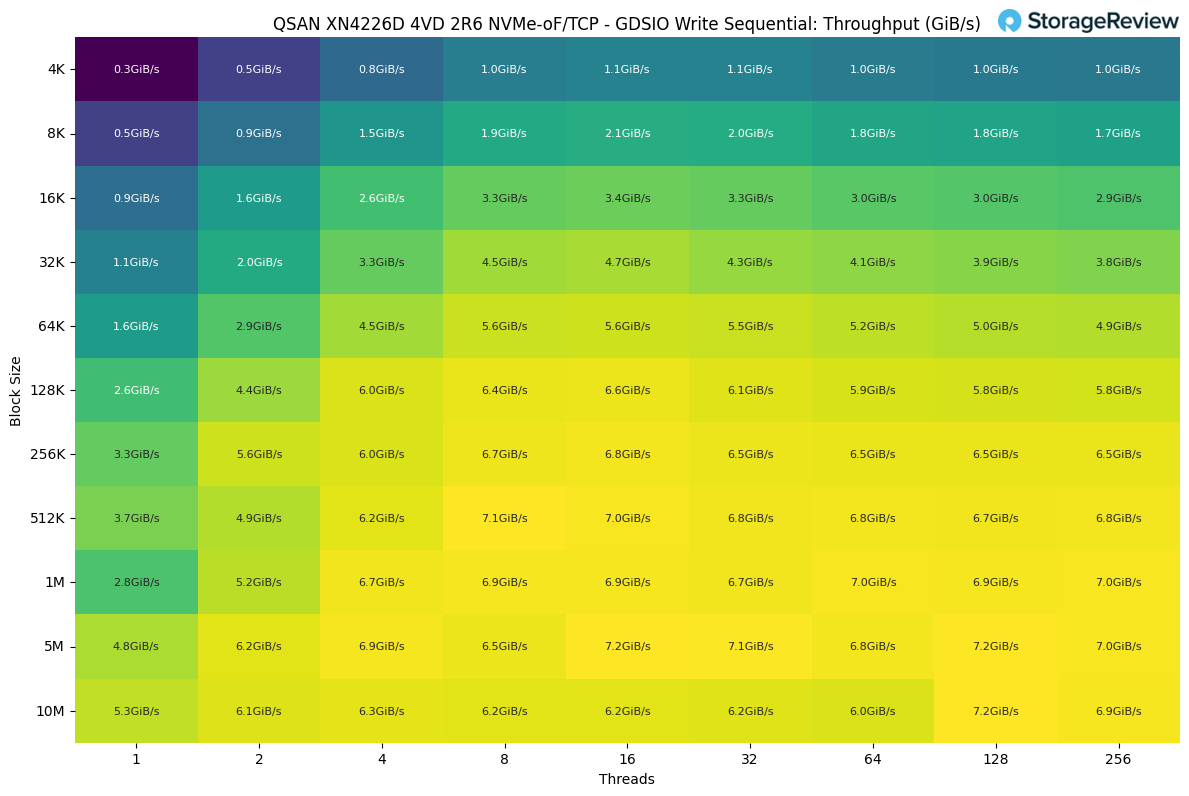
Nel carico di lavoro di scrittura sequenziale GDSIO, la velocità effettiva è aumentata sia in base alla dimensione dei blocchi che al numero di thread, ma si è stabilizzata ben al di sotto del limite massimo delle prestazioni di lettura. Il sistema ha raggiunto un picco di 7.2 GiB/s, utilizzando blocchi di dimensioni maggiori, come 5 M e 10 M, a 128 thread.
Con blocchi di dimensioni più piccole, il throughput era modesto. Con blocchi da 4K, le prestazioni partivano da 0.3 GiB/s con un singolo thread e salivano a 1.0 GiB/s con 32 thread, per poi stabilizzarsi. L'aumento delle dimensioni dei blocchi a 64K sbloccava maggiore larghezza di banda, raggiungendo 5.6 GiB/s con otto thread, prima di diminuire leggermente con una concorrenza più elevata.
Il miglior equilibrio si è verificato tra 512 e 1 blocchi, con un throughput compreso tra 6.7 e 7.1 GiB/s su diversi thread, a indicare che il sistema aveva raggiunto la saturazione in questo intervallo. Oltre tale limite, i thread aggiuntivi non hanno prodotto guadagni significativi e, in alcuni casi, le prestazioni sono addirittura diminuite leggermente a causa dell'aumento del sovraccarico.
Scrivi latenza
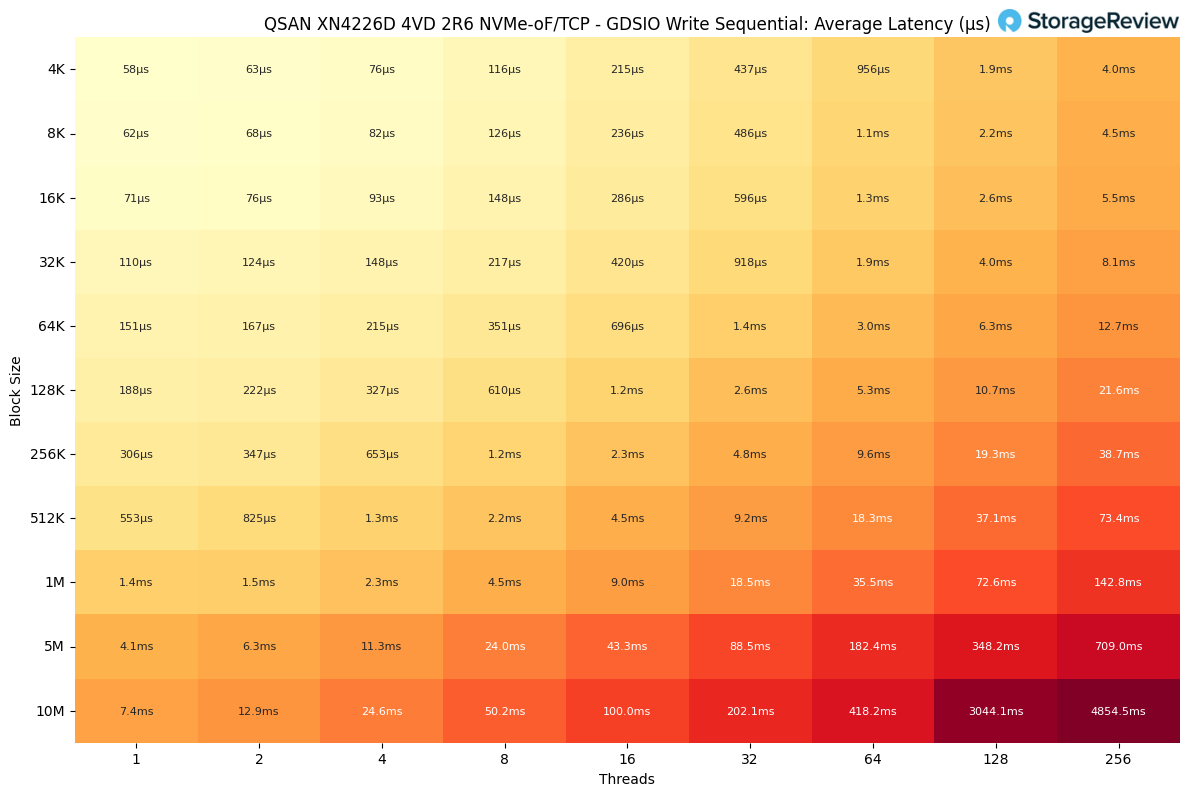
Nei risultati di latenza di scrittura sequenziale GDSIO, i tempi di risposta sono aumentati gradualmente con dimensioni di blocco inferiori, ma sono aumentati bruscamente con l'aumentare sia delle dimensioni del blocco sia del numero di thread.
Con carichi di lavoro minimi, la latenza è stata minima. Con blocchi da 4K e un singolo thread, la latenza media è stata di soli 58 µs, rimanendo inferiore a 200 µs con blocchi da 16K e fino a quattro thread. Anche con blocchi da 32K e concorrenza moderata, la latenza è rimasta inferiore a 1 ms.
Con la transizione del sistema a blocchi di dimensioni maggiori, i ritardi sono diventati più pronunciati. A 128 blocchi e 64 thread, la latenza ha raggiunto i 5.3 ms, raddoppiando ulteriormente a 10.7 ms a 128 thread. Con 512 blocchi, i risultati si sono ulteriormente estesi, raggiungendo i 73.4 ms a 256 thread.
Nei casi più pesanti, blocchi da 5M e 10M a 256 thread, si è registrato un picco drammatico nella latenza, rispettivamente a 709 ms e 4.8 secondi, rivelando i limiti superiori della scalabilità della scrittura sequenziale.
Considerazioni finali
L'XN4226D di QSAN si posiziona esattamente dove molti team IT ne hanno bisogno. Si tratta di una piattaforma NVMe unificata a doppio controller che supporta sia i protocolli moderni che quelli legacy senza richiedere modifiche all'architettura. Nei nostri test, TCP ha registrato letture sequenziali di grandi dimensioni a 21.21 GB/s, mentre RDMA ha prodotto le scritture sequenziali di grandi dimensioni più elevate a 11.14 GB/s e ha mantenuto la latenza inferiore con l'aumentare della concorrenza. A blocchi di dimensioni inferiori, RDMA ha costantemente migliorato l'efficienza della scrittura casuale e ha tenuto sotto controllo il comportamento di coda. La conclusione è semplice. Utilizzate NVMe-oF TCP per un'ampia compatibilità e un'elevata larghezza di banda in lettura, e scegliete RDMA quando la latenza e la coerenza in scrittura sono più importanti.
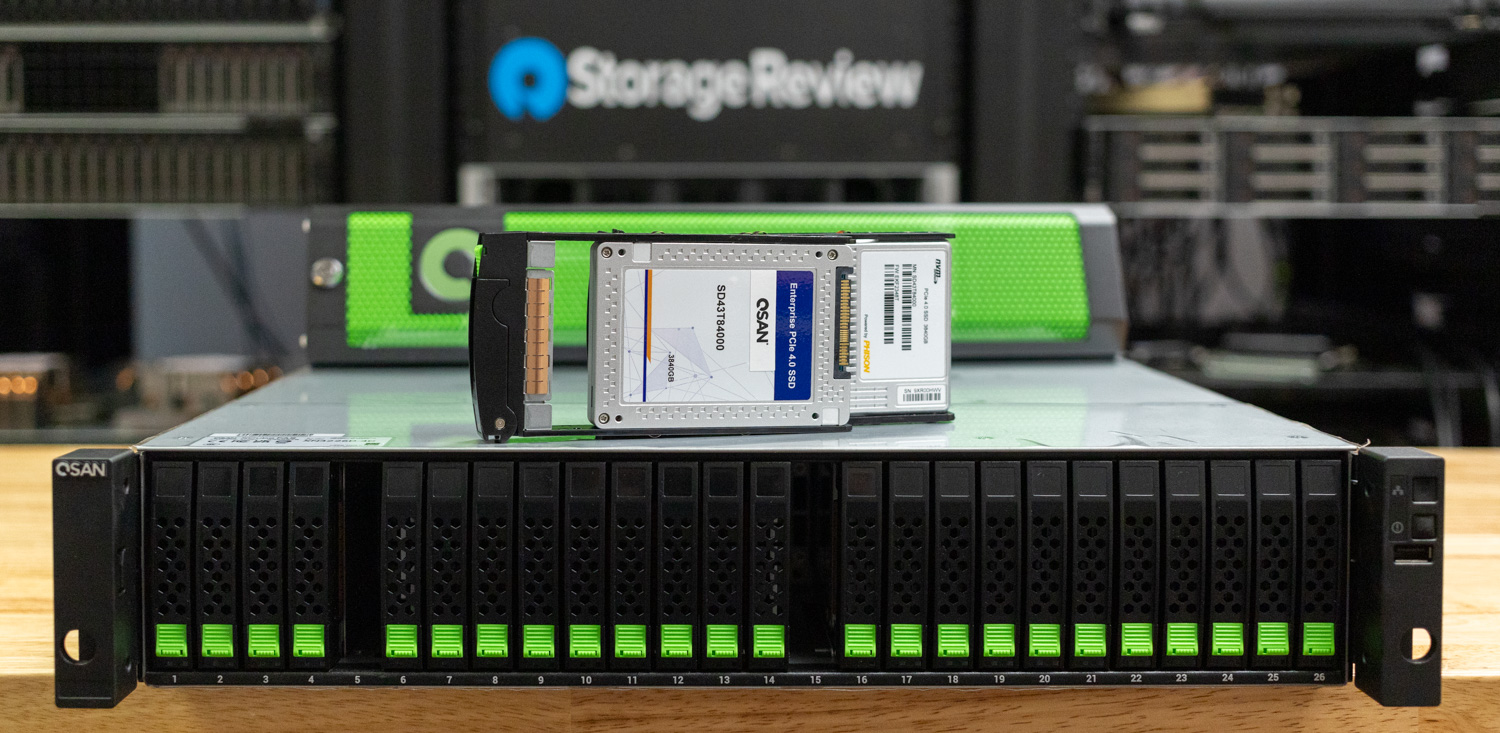
L'ingombro hardware è pratico. Sono disponibili 26 alloggiamenti frontali per unità NVMe U.2 o U.3 in uno chassis 2U, con alta disponibilità attiva e semplice espansione verso gli scaffali SAS quando la capacità ha la priorità sulla velocità grezza delle unità NVMe. QSM 4 offre i servizi dati previsti e un'interfaccia utente intuitiva, oltre a un'API REST che facilita l'integrazione perfetta con l'automazione esistente. I piccoli team IT troveranno QSM 4 facile da configurare e gestire. Per convalidare questa caratteristica, abbiamo integrato facilmente il nostro cluster Proxmox, fornendo a tali VM l'accesso a storage ad alta velocità. Per carichi di lavoro più avanzati, QSAN è ben posizionato per soddisfare le esigenze di intelligenza artificiale delle PMI.
Per le organizzazioni che apprezzano prestazioni prevedibili, gestione pulita e copertura multiprotocollo, l'XN4226D è sicuramente consigliato. Offre un throughput NVMe reale, un'elevata latenza in scrittura con RDMA e un'esperienza software che non rallenta le prestazioni. Aggiungendo un prezzo ragionevole, questa piattaforma QSAN può supportare ambienti misti senza problemi.


 Amazon