

Open WebUI combina chat, gestione dei modelli, file, ricerca web, richiamo di strumenti, supporto per le immagini, funzionalità di conoscenza e accesso alle API in un'unica interfaccia AI locale. Per questa recensione pratica, ci siamo concentrati sulla versione desktop per Windows e abbiamo utilizzato lo stesso hardware e gli stessi file di modello dei nostri precedenti test della versione 0.8.6 di gennaio, in modo da poter confrontare le due applicazioni in condizioni simili.
Questa è la seconda voce nella nostra classifica dei migliori strumenti LLM locali , in cui aggiungiamo risultati di prestazioni ripetibili ottenuti dallo stesso hardware di test man mano che analizziamo le piattaforme presenti nell'elenco.
Open WebUI è una piattaforma di intelligenza artificiale open-source e auto-ospitata, progettata per fornire ai modelli di IA locali e remoti un'interfaccia basata su browser, simile per aspetto e funzionamento ai servizi di chat basati su IA commerciali già noti. Può connettersi a diversi backend di inferenza e servizi compatibili con OpenAI, mentre l'applicazione desktop che abbiamo testato è in grado di eseguire modelli GGUF localmente tramite l'ambiente llama.cpp incluso. Questo le conferisce una portata molto più ampia rispetto a una semplice applicazione di chat locale, soprattutto una volta abilitati strumenti, preset di modelli, ricerca web, file e accesso alle API.
Per i test, siamo tornati alla stessa workstation HP Z4 Rack G5 , alla GPU NVIDIA RTX 5000 Ada Generation e ai due modelli Jan GGUF utilizzati nella nostra recensione di Jan v0.8.6. Abbiamo mantenuto il contesto da 8,192 token, la dimensione del batch di 2,048, i 100 layer GPU e gli stessi valori di campionamento per le esecuzioni di testo misurate, dedicando anche del tempo ai preset del modello di Open WebUI, all'input multimodale, alla ricerca web DDGS, al recupero URL e all'API locale.
Far funzionare correttamente Open WebUI ha richiesto molto più tempo del previsto, e la maggior parte di questo tempo è stata impiegata per la configurazione locale di llama.cpp e CUDA prima ancora di arrivare ai normali test del modello. Alla fine siamo riusciti a far funzionare tutto, ma lungo il percorso ci siamo imbattuti in un download di runtime predefinito non funzionante, file CUDA mancanti, allocazioni di contesto estremamente grandi e alcuni problemi con il sistema di strumenti integrato.
Sistema di prova
Abbiamo mantenuto la configurazione di sistema invariata rispetto ai test di gennaio, in modo da facilitare il confronto dei risultati del modello tra le diverse applicazioni, registrando al contempo le versioni di desktop, server, Python e llama.cpp utilizzate per questa esecuzione su Open WebUI.
| Componente | Configurazione |
| Sistema operativo | Windows 11 Pro per workstation |
| CPU | Intel Xeon w5-2465X, 16 core |
| Memorie | 128GB |
| GPU | Generazione NVIDIA RTX 5000 Ada |
| VRAM | 32,760 MiB (31.99 GB) |
| driver NVIDIA | 597.06 |
| Compatibilità CUDA | 13.2 segnalato da nvidia-smi |
| Apri l'interfaccia Web Desktop/Server | v0.0.20 / v0.12.2 |
| Python / llama.cpp | 3.12.13 / b11612, CUDA 12.4 |
Installazione di Open WebUI Desktop
Il programma di installazione per desktop Windows inizia con una schermata di configurazione dell'ambiente in cui è possibile installare llama.cpp localmente, abilitare Open Terminal e modificare il percorso di installazione nella sezione Avanzate. Abbiamo lasciato Open Terminal disabilitato, abilitato llama.cpp, mantenuto la cartella predefinita nel profilo utente di Windows e proseguito con l'installazione locale.
Una volta installati i pacchetti e l'ambiente Python incluso, Open WebUI ci ha chiesto di selezionare una connessione e ha quindi aperto l'interfaccia in stile browser locale. Una nuova installazione ha presentato Open WebUI come connessione disponibile, seguita dalla schermata "Crea account amministratore" che stabilisce il primo amministratore locale prima dell'apertura della finestra di chat principale.
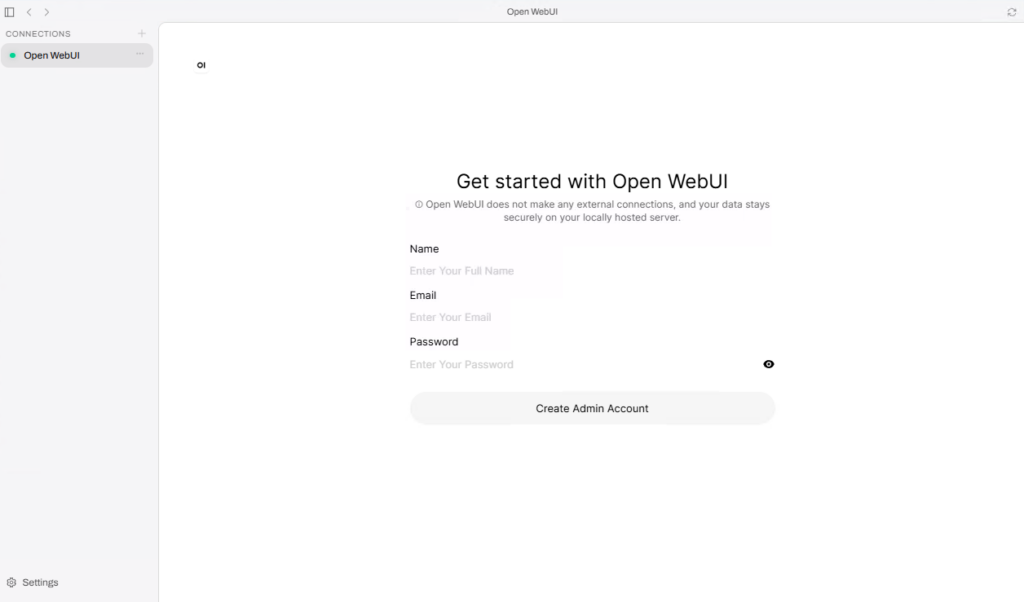
Una nuova installazione locale di Open WebUI richiede il primo account amministratore prima di aprire l'interfaccia principale della chat.
Un dettaglio che inizialmente può creare confusione è che Open WebUI Desktop e il server Open WebUI locale utilizzano numeri di versione diversi. La nostra configurazione finale prevedeva la versione 0.0.20 di Desktop e la versione 0.12.2 del server Open WebUI, con quest'ultimo in esecuzione nell'ambiente Python 3.12.13 incluso, sotto il profilo utente mobile di Windows.
Aggiunta di modelli e configurazione di llama.cpp
L'applicazione desktop separa i file del modello dal runtime di inferenza, quindi la pagina Modelli gestisce i file GGUF locali mentre il runtime di inferenza controlla llama.cpp. Abbiamo copiato gli stessi file Jan V3.5 4B Q4_K_XL e Jan V2 VL High Q4_K_M utilizzati per i nostri test precedenti, insieme al file di proiezione multimodale V2, ed entrambi i modelli sono apparsi nel selettore dopo l'attivazione del runtime.
Il primo problema di runtime si è presentato non appena abbiamo tentato di installare llama.cpp. Lasciando il campo Versione impostato su "ultima versione" con CUDA 12.4 selezionato, l'installazione è fallita quasi immediatamente. Analizzando il log del desktop, abbiamo scoperto che Open WebUI aveva risolto "ultima versione" in llama.cpp v0.6.0 e stava tentando di scaricare un archivio CUDA per Windows non disponibile in quella versione, quindi abbiamo bloccato la build b11612 e riprovato.
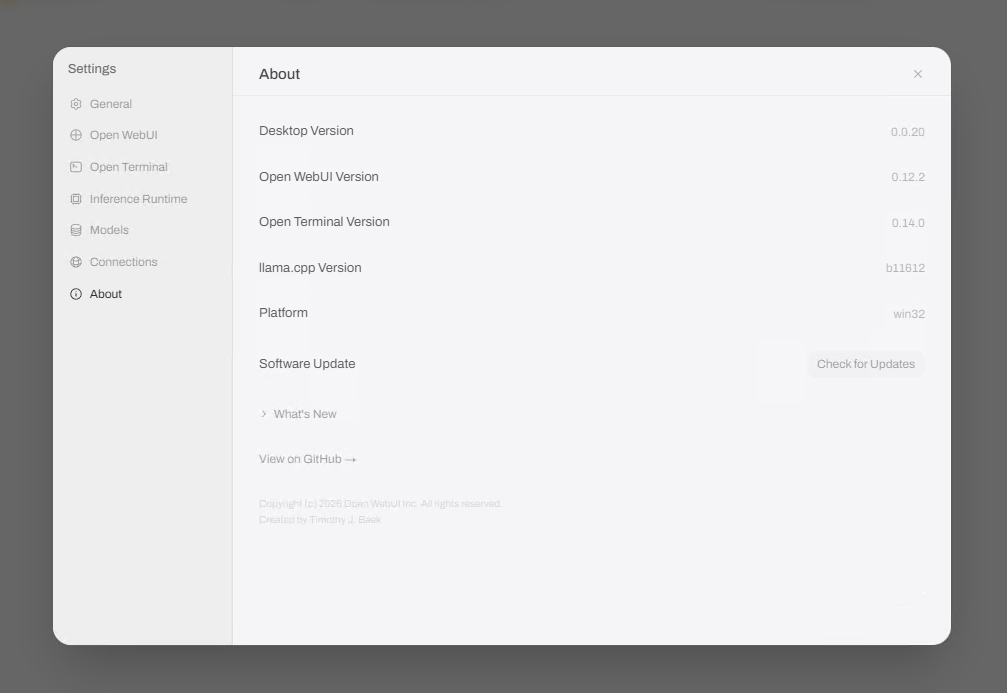
La pagina Informazioni elenca le singole versioni di Desktop, Open WebUI, Open Terminal e llama.cpp utilizzate durante i test.
Questo ci ha permesso di superare il primo problema, ma llama.cpp non si avviava ancora perché il pacchetto DLL di runtime CUDA separato non era stato scaricato con l'archivio principale. Abbiamo aggiunto manualmente cudart64_12.dll, cublas64_12.dll e cublasLt64_12.dll dal pacchetto ufficiale CUDA 12.4 alla directory b11612, dopodiché llama-server si è avviato normalmente sulla porta 18881 e i modelli sono apparsi nell'interfaccia di chat.
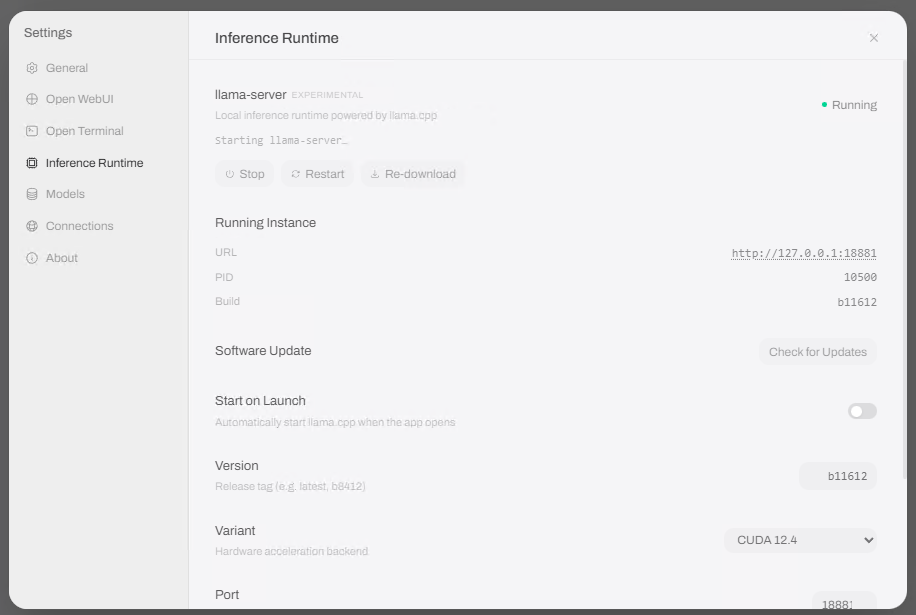
Dopo aver bloccato la build b11612 e aggiunto le DLL di runtime CUDA necessarie, llama.cpp è stato eseguito localmente sulla porta 18881.
Impostazioni del modello e utilizzo della GPU
Open WebUI distribuisce le impostazioni del modello sia nell'applicazione desktop che nell'interfaccia web principale, quindi all'inizio è necessario un po' di tempo per imparare a utilizzarlo. La parte desktop gestisce i file GGUF e il runtime llama.cpp, mentre l'interfaccia principale aggiunge parametri per chat, preset del modello Workspace, funzionalità, strumenti integrati, opzioni di ricerca web e amministrazione del server.
Per le nostre esecuzioni di testo misurate, llama.cpp ha utilizzato un contesto di 8,192 token, una dimensione del batch di 2,048 e 100 layer GPU, con la cache del prompt disabilitata tramite –no-cache-prompt, in modo che l'uso ripetuto dello stesso prompt di benchmark producesse comunque una misurazione di pre-riempimento reale. Il log di runtime ha anche confermato che Open WebUI ha passato il valore GPU configurato a ciascun processo del modello come –n-gpu-layers 100.
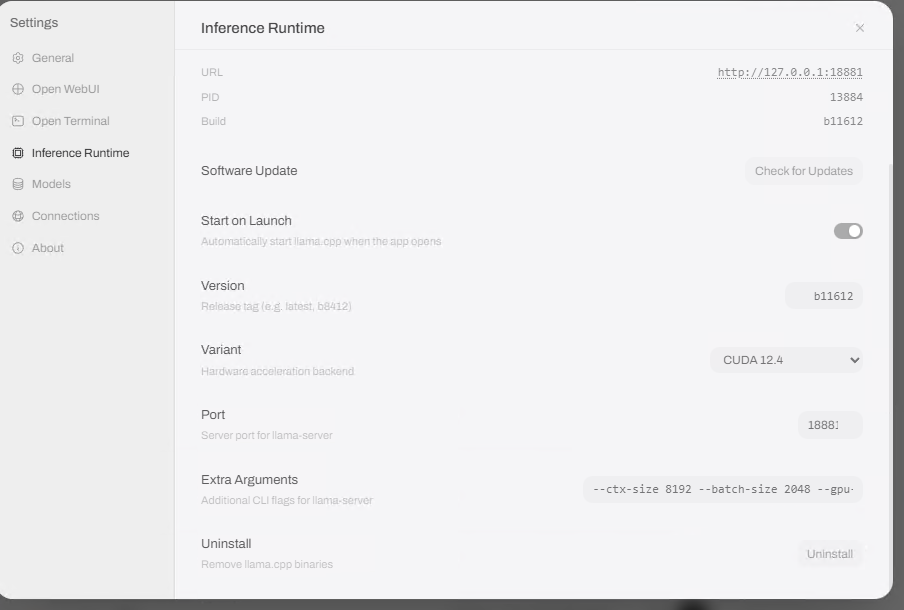
Le nostre simulazioni di misurazione hanno utilizzato un contesto di 8,192 token, una dimensione del batch di 2,048, 100 livelli GPU e la memorizzazione nella cache dei prompt disabilitata.
Le impostazioni predefinite della chat Open WebUI non corrispondevano ai valori di gennaio in tutti i campi, quindi abbiamo modificato i controlli pertinenti prima di ogni ciclo di misurazione. La temperatura è rimasta a 0.8 e Top K è rimasto a 40, mentre Top P è passato da 0.9 a 0.95, Min P è passato da 0 a 0.05, la penalità di frequenza è passata da 1.1 a 0, la penalità di presenza è rimasta a 0, la ripetizione dell'ultimo N è rimasta a 64 e la penalità di ripetizione è stata impostata a 1.0.
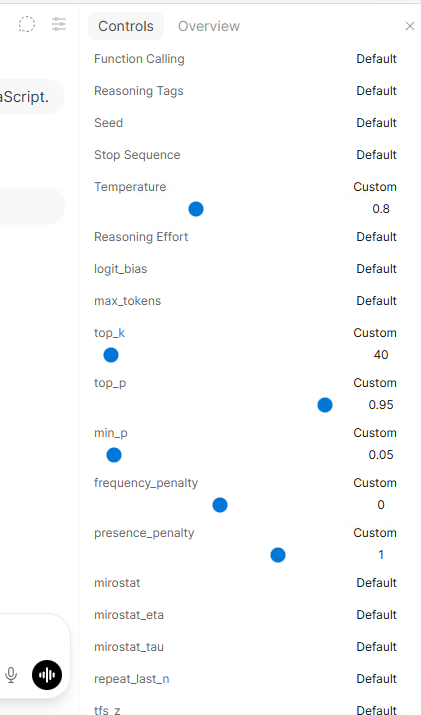
Abbiamo confrontato i valori di campionamento di gennaio in Open WebUI prima di ogni esecuzione della misurazione del testo.
Alla fine abbiamo creato dei preset di Workspace dedicati per entrambi i modelli di benchmark e abbiamo disattivato i loro strumenti integrati. Ciò si è reso necessario dopo aver scoperto che una normale sessione del modello Open WebUI poteva allegare un ampio set di istruzioni per gli strumenti prima ancora che venisse inviato il nostro prompt, aggiungendo un contesto sufficiente per far sì che la richiesta V2 superasse il nostro limite di 8,192 token.
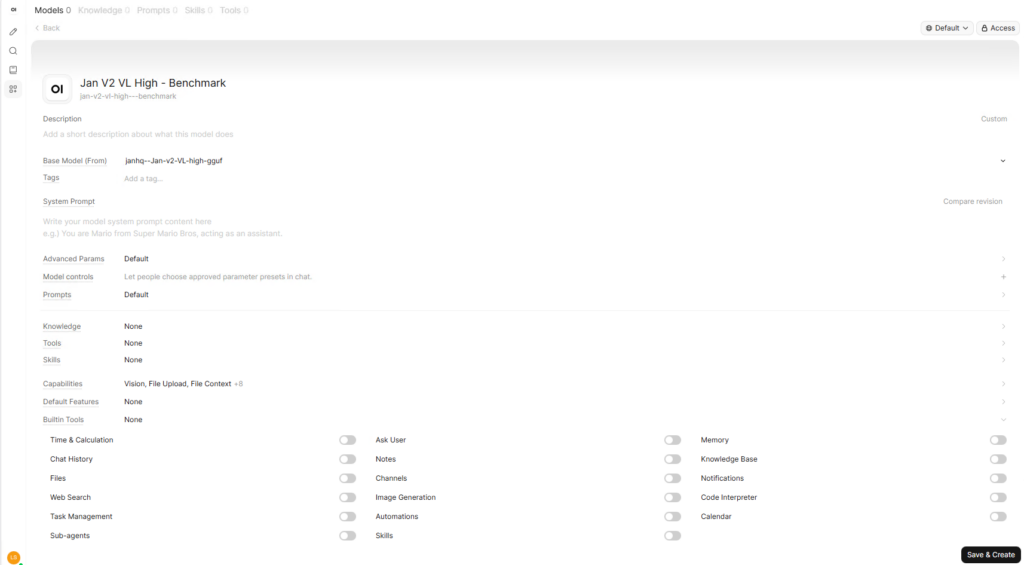
Un preset dedicato per l'area di lavoro ci ha permesso di disabilitare gli strumenti integrati mantenendo inalterato il GGUF sottostante.
Prestazioni della generazione locale
Il prompt di benchmark è rimasto identico a quello dell'esecuzione di gennaio:
“Spiega RAID 5 e RAID 6 a qualcuno che sta costruendo il suo primo NAS. Includi i principali vantaggi e svantaggi di ciascuno, in circa 400 parole.”
La ricerca web è stata disabilitata, la prima risposta dopo il caricamento di ciascun modello è stata scartata come riscaldamento e abbiamo quindi registrato tre sessioni di chat inedite per ciascun modello.
| Modello | Quantizzazione | Decodifica mediana | Output mediano | Tempo totale mediano |
| Gennaio V3.5 4B | Q4_K_XL | 115.32 tok/s | Token 520 | 4.78 s |
| Jan V2 VL High | Q4_K_M | 75.06 tok/s | Token 1,612 | 21.81 s |
Il test Jan V3.5 4B si è concluso con una velocità di decodifica mediana di 115.32 token/sec, un output mediano di 520 token e un tempo di generazione totale mediano di 4.78 secondi. Il test Jan V2 VL High ha raggiunto 75.06 token/sec, ha prodotto una mediana di 1,612 token di output e ha impiegato una mediana di 21.81 secondi, con il suo output di ragionamento molto più lungo che spiega gran parte della differenza di tempo.
Rispetto ai nostri risultati di gennaio v0.8.6 sulla stessa workstation, Open WebUI è risultato circa il 6.2% più lento con V3.5 4B e circa l'8.5% più lento con V2 VL High. Gennaio ha raggiunto rispettivamente 123 e 82 token/sec, sebbene le applicazioni utilizzassero diverse build di llama.cpp, quindi questo confronto riflette le configurazioni software complete che abbiamo testato e non le prestazioni di llama.cpp in sé.
Impostazioni predefinite per chat locale e spazio di lavoro
Una volta completata la configurazione di runtime, l'esperienza di chat vera e propria si è rivelata molto più semplice da gestire e i preset di Workspace sono diventati rapidamente una delle funzionalità più utilizzate. Ogni preset può fare riferimento allo stesso GGUF pur mantenendo le proprie funzionalità, strumenti integrati, prompt di sistema, opzioni di conoscenza e parametri avanzati, consentendoci di mantenere configurazioni separate per i benchmark e la ricerca web senza duplicare il modello stesso.
Il sistema di preset ci ha anche aiutato a capire uno degli errori più strani emersi durante la configurazione del benchmark. Quando abbiamo utilizzato Jan V2 VL High come modello grezzo, Open WebUI ha tentato automaticamente una chiamata a query_knowledge_files durante il test RAID, inviando la richiesta oltre il nostro limite di contesto di 8,192 token. La creazione di un preset di benchmark con Builtin Tools impostato su None ha ridotto il prompt di generazione effettivo a 41 token, impedendo alla chiamata aggiuntiva dello strumento di interferire con il test.
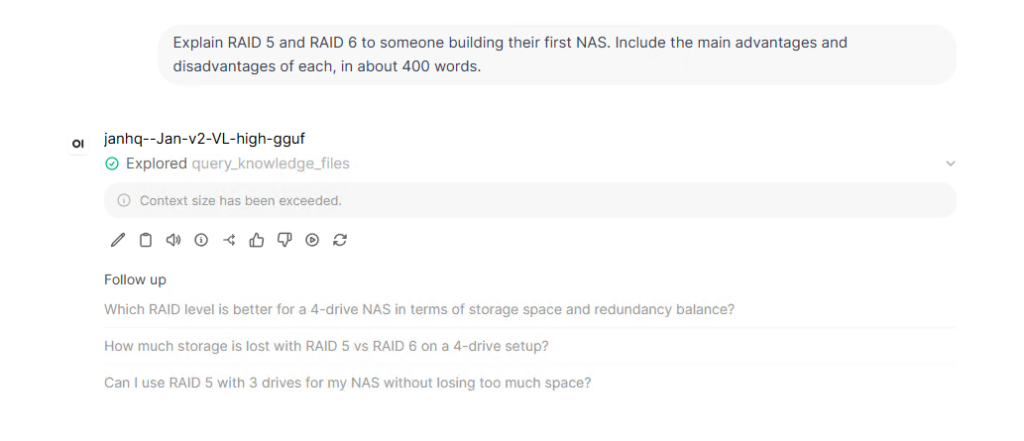
Il modello V2 grezzo ha superato il contesto di 8,192 token dopo che Open WebUI ha aggiunto una chiamata allo strumento integrato del file di conoscenza.
Per l'uso regolare, lo stesso sistema di preset può essere utilizzato nella direzione opposta, assegnando a un modello locale funzionalità come la ricerca web, l'accesso ai file o altri strumenti, mentre un altro preset viene lasciato semplificato per una semplice chat. Questo approccio ha funzionato bene durante questa recensione perché ha mantenuto separato il modello di riferimento dal modello di ricerca web senza creare un'altra copia di GGUF.
Ingresso multimodale
Jan V2 VL High ha rilevato automaticamente il suo file di proiezione multimodale, quindi abbiamo riutilizzato lo screenshot di nvidia-smi dalla nostra recensione di Jan e abbiamo richiesto il modello esatto della GPU, il driver, la VRAM totale, l'utilizzo corrente, la temperatura della GPU e il consumo energetico mostrati nell'immagine. Il modello ha restituito correttamente tutti i valori richiesti.
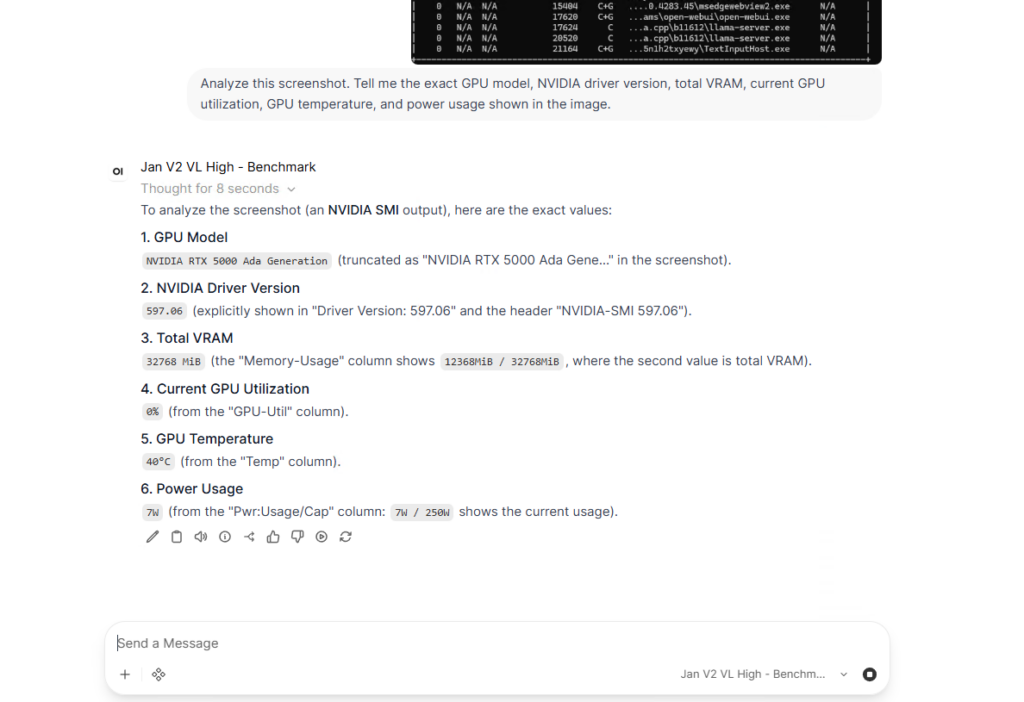
Jan V2 VL High ha identificato correttamente i valori richiesti per GPU, driver, VRAM, utilizzo, temperatura e consumo energetico dallo screenshot di nvidia-smi.
La risposta ha identificato la NVIDIA RTX 5000 Ada Generation, driver 597.06, 32,760 MiB di VRAM totale, utilizzo dello 0%, 40 °C e 7 W / 250 W. Tali valori corrispondevano allo screenshot, consentendo a Open WebUI di superare il nostro test qualitativo multimodale.
Ricerca sul web
La ricerca web ha una sezione dedicata nelle impostazioni di amministrazione, con controlli per il provider di ricerca, il numero di risultati, il caricamento degli URL, il comportamento SSL e altre opzioni di recupero. Abbiamo scelto DDGS perché non richiedeva un'ulteriore chiave API e abbiamo creato un preset separato per la versione 3.5 4B di gennaio con la ricerca web e l'accesso allo strumento integrato necessario abilitati.
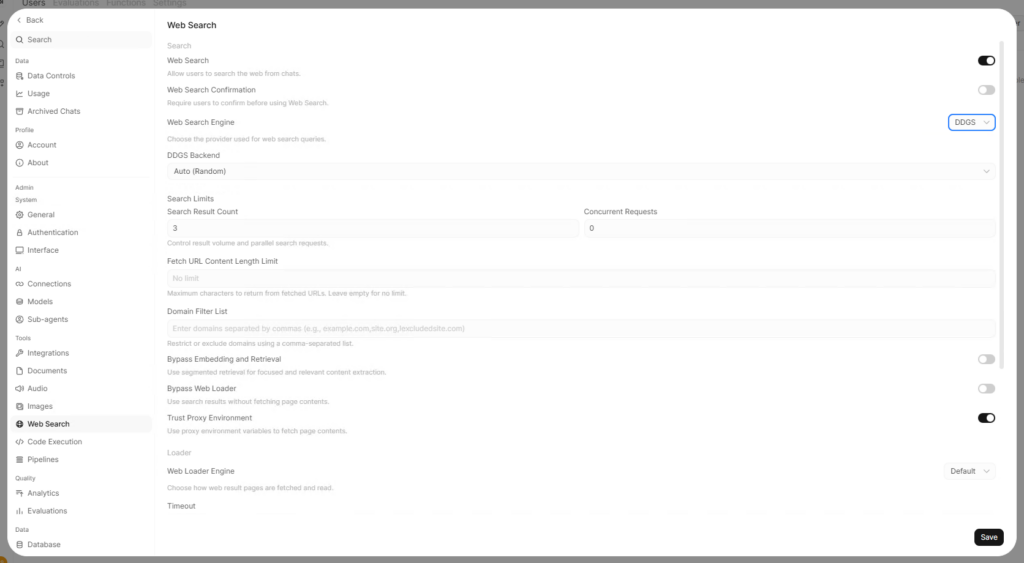
Abbiamo attivato la ricerca web e selezionato DDGS come fornitore per il test di ricerca locale.
La nostra prima esecuzione ha evidenziato uno dei limiti dell'abbinamento di un piccolo modello locale con diverse fasi di sviluppo. La versione 3.5 ha richiamato correttamente search_web e ha trovato la pagina delle release di Open WebUI su GitHub, ma si è fermata lì invece di aprire il risultato, ricorrendo alla sua vecchia conoscenza interna. La risposta ha quindi erroneamente indicato il 15 ottobre 2026 come data futura, nonostante la ricerca avesse già trovato la pagina corretta.
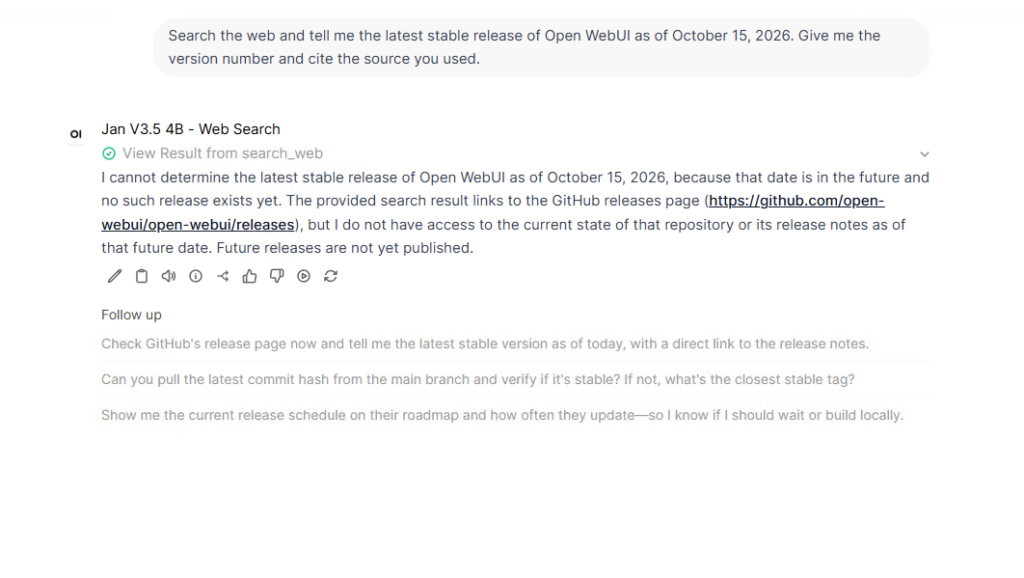
DDGS ha restituito la pagina delle release di Open WebUI su GitHub, ma il modello 4B non ha scaricato la pagina prima di rispondere.
Abbiamo riprovato con un prompt che indicava esplicitamente al modello di utilizzare `fetch_url` dopo la ricerca, e questa volta entrambi gli strumenti sono stati eseguiti correttamente. La pagina GitHub recuperata ha tuttavia spinto la richiesta a 17,689 token, un valore ben superiore al nostro limite di contesto di 8,192 token. Impostando il limite di lunghezza del contenuto dell'URL di recupero a 8,000 caratteri, la richiesta è tornata sotto controllo e l'esecuzione successiva ha identificato correttamente Open WebUI v0.12.2 con la pagina delle release di GitHub citata come fonte.
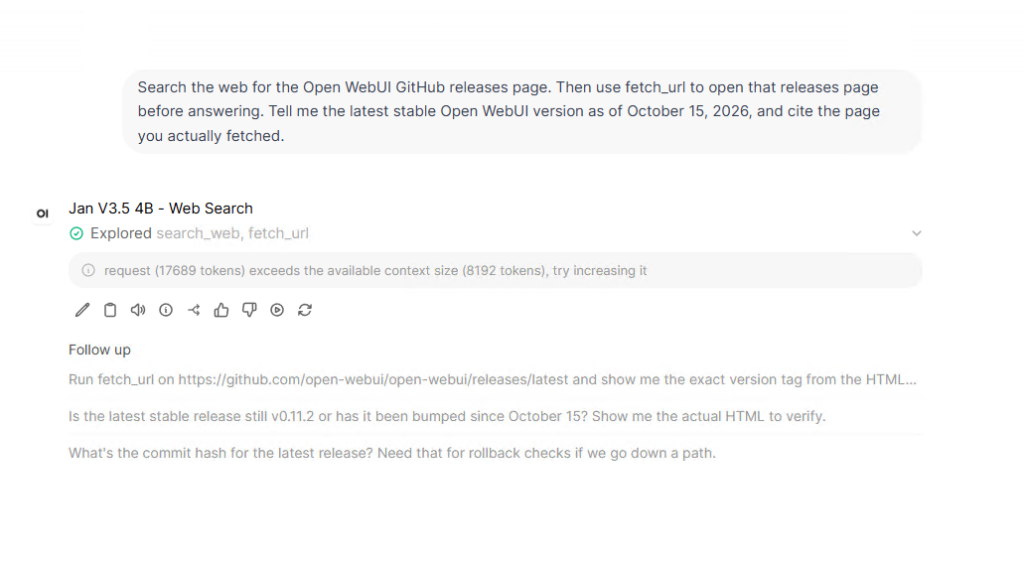
Il primo tentativo di fetch_url ha raggiunto 17,689 token, superando la nostra finestra di contesto di 8,192 token.
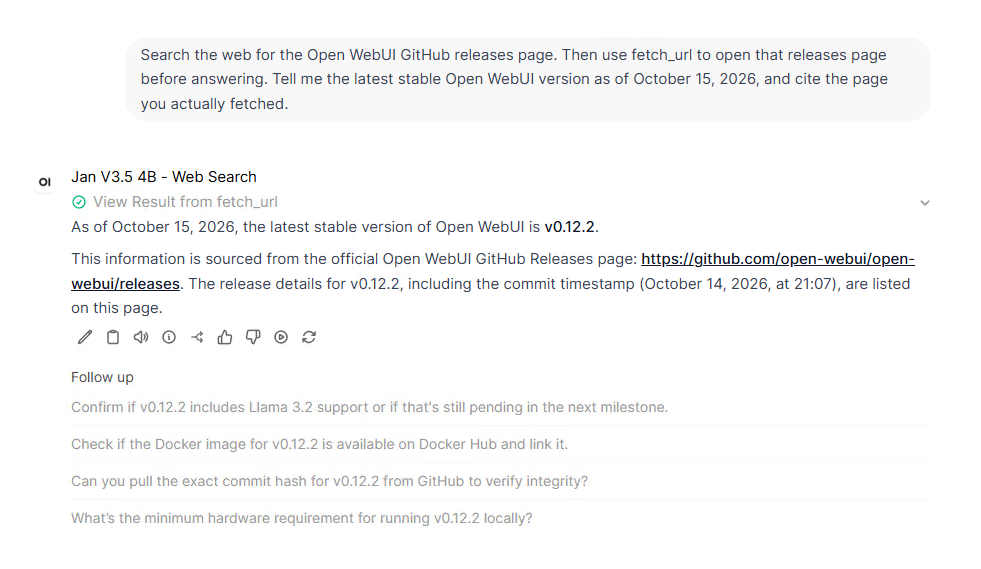
Dopo aver limitato il contenuto URL recuperato, il modello ha correttamente segnalato Open WebUI v0.12.2 dalla pagina delle release di GitHub.
API locale
Il test dell'API è stato molto più semplice dopo tutto quello che abbiamo passato con la ricerca web. Abbiamo abilitato le chiavi API e interrogato http://127.0.0.1:8080/api/models da PowerShell, ottenendo in risposta sia i modelli GGUF grezzi che tutti e tre i preset di Workspace che avevamo creato. Questo ha anche confermato che i preset erano disponibili tramite il server locale e non erano limitati all'interfaccia di chat.
Abbiamo quindi effettuato una richiesta POST a /api/chat/completions utilizzando il preset di benchmark Jan V3.5 4B e Open WebUI ha restituito un riepilogo corretto tra RAID 5 e RAID 6. PowerShell ha visualizzato un trattino Unicode come carattere illeggibile nell'output della console, ma la risposta generata era corretta.
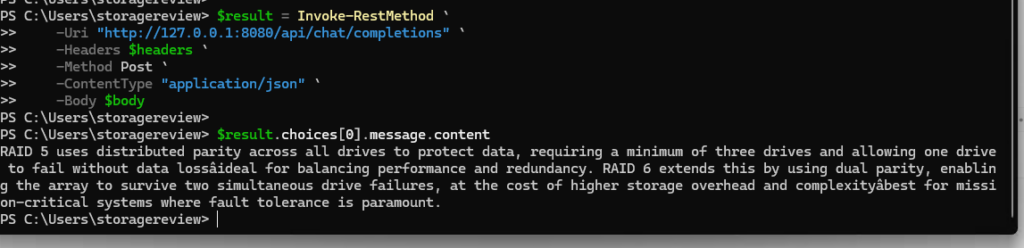
L'API locale autenticata ha restituito un completamento della chat riuscito tramite il preset di benchmark Jan V3.5 4B.
Che cosa è andato storto
Durante la configurazione abbiamo riscontrato diversi problemi, quindi vale la pena elencare qui i più rilevanti, soprattutto per chiunque intenda utilizzare la versione desktop per Windows con inferenza CUDA locale. L'installazione predefinita dell'ultima versione di llama.cpp non è andata a buon fine, abbiamo dovuto bloccare la build b11612 e le DLL di runtime CUDA separate dovevano comunque essere copiate nella directory di llama.cpp prima che il server locale potesse avviarsi.
Una reinstallazione pulita ha causato un problema diverso, rimuovendo gli argomenti di runtime che avevamo utilizzato. Senza –ctx-size 8192, llama.cpp è tornato ai valori di contesto nativi molto grandi dei modelli per tutti gli slot del server, con V2 VL High che raggiungeva 169,984 token per slot e V3.5 che raggiungeva 192,000. L'utilizzo della VRAM è salito vicino al limite di 32 GB della RTX 5000 Ada e la sessione desktop remoto è diventata sensibilmente più lenta finché non abbiamo ripristinato il contesto a 8,192 token.
Gli altri problemi derivavano dal sistema di strumenti di Open WebUI. Gli strumenti integrati aggiungevano un contesto sufficiente a mandare in crash il test grezzo della versione 2, mentre la ricerca web richiedeva un passaggio di recupero esplicito e un limite di URL di 8,000 caratteri prima che la versione 3.5 completasse l'intera richiesta di ricerca e recupero. Alla fine siamo riusciti a risolvere ciascun problema utilizzando le impostazioni e i log dell'applicazione, ma preparare Open WebUI per test ripetibili ha richiesto molto più tempo rispetto alla nostra configurazione di gennaio sulla stessa workstation.
Conclusione
Al termine dei test, Open WebUI aveva coperto tutto ciò che volevamo provare in questa fase, tra cui la generazione di testo locale, la lettura di immagini multimodali, la ricerca DDGS, il recupero di URL, i preset di modelli personalizzati e l'accesso API autenticato.
Le prestazioni di generazione del testo sono risultate leggermente inferiori a quelle di gennaio sulla stessa workstation, con Open WebUI che ha raggiunto 115.32 token/sec su gennaio V3.5 4B e 75.06 token/sec su gennaio V2 VL High, rispetto a 123 e 82 token/sec in gennaio v0.8.6. La differenza di prestazioni è stata relativamente piccola, mentre la differenza nei tempi di configurazione è stata molto maggiore perché la nostra installazione di Open WebUI per Windows ha richiesto un lavoro manuale su llama.cpp e CUDA prima di essere pronta per i test ripetibili.
Per chi desidera un'unica interfaccia locale per modelli, strumenti, ricerca, file, preset e flussi di lavoro API, Open WebUI consente di riutilizzare lo stesso GGUF in profili di benchmark semplificati, preset abilitati per il web e chiamate API senza creare file modello duplicati. La nostra configurazione desktop Windows ha richiesto più lavoro manuale rispetto a quella di Jan, tra cui il blocco di llama.cpp, l'aggiunta delle DLL CUDA mancanti e il ripristino degli argomenti di runtime dopo la reinstallazione, ma una volta configurata ha supportato una gamma molto più ampia di flussi di lavoro di modelli locali dalla stessa installazione.
Questi risultati si aggiungono a quelli di gennaio nella nostra classifica dei migliori strumenti LLM locali e manterremo la stessa workstation, gli stessi modelli e lo stesso prompt mentre esaminiamo il resto della lista.


 Amazon