

Il programma JumpStart di Supermicro adotta un approccio molto diverso alla valutazione dell'hardware. Invece di una breve demo predefinita in un ambiente di laboratorio condiviso, JumpStart offre ai clienti qualificati un accesso gratuito e limitato nel tempo a un catalogo di server di produzione reali. Dalle nuove piattaforme X14 con Intel Xeon 6 ai sistemi H14 con AMD EPYC di quinta generazione e configurazioni con GPU HGX di grandi dimensioni, i clienti prenotano i sistemi, accedono da remoto ed eseguono i propri carichi di lavoro come se l'hardware si trovasse nel proprio rack.
Il valore aziendale diventa evidente quando si prendono decisioni rapide e consapevoli sulla piattaforma. Sviluppare una proof of concept realistica per l'intelligenza artificiale o il calcolo ad alte prestazioni di solito significa attendere l'hardware di valutazione, coordinarsi con diversi fornitori e sperare che la configurazione di test sia sufficientemente vicina a quella che si prevede di implementare. JumpStart elimina questo attrito. I team possono convalidare le prestazioni, verificare la compatibilità del software, esplorare il comportamento energetico e termico e confrontare le architetture senza dover bruciare cicli di laboratorio interni o spedire un pallet di server in tutto il paese. Per la maggior parte delle organizzazioni, una settimana dedicata alla configurazione corretta è sufficiente per confermare che una piattaforma soddisfi le proprie esigenze o per escluderla prima che diventi un impegno.
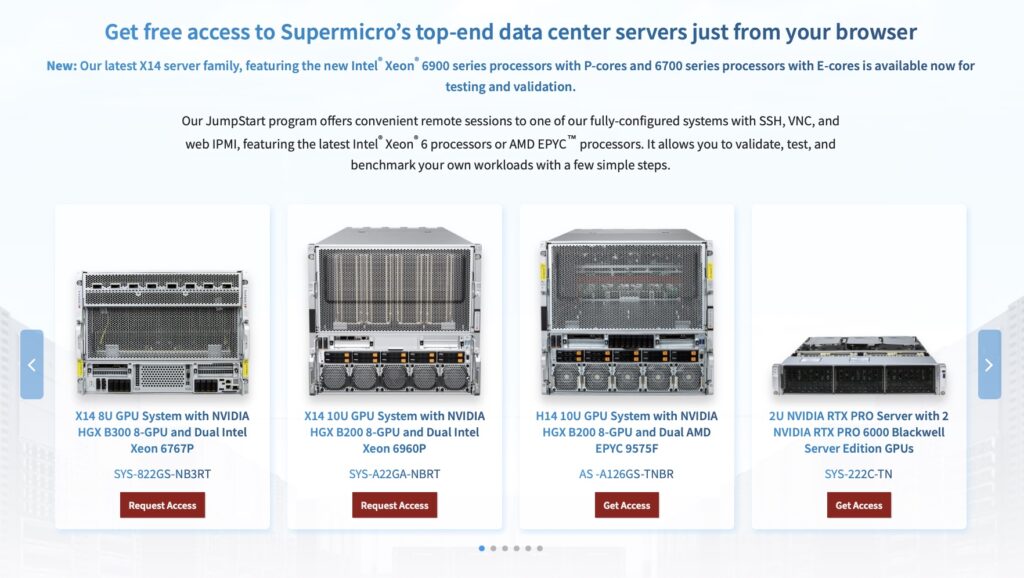
Pagina di lancio di Supermicro JumpStart
Ciò che rende JumpStart particolarmente interessante non è solo il numero di sistemi online, ma anche la profondità della tecnologia che Supermicro è disposta a mettere a disposizione. Tra le scelte più gettonate figurano server GPU X14 con acceleratori Intel Xeon 6 e NVIDIA, piattaforme H14 ottimizzate per l'elaborazione densa della CPU con AMD EPYC di quinta generazione e sistemi incentrati sullo storage che combinano CPU moderne con tutti i backend NVMe. Nella fascia alta, Supermicro offre già l'accesso ai sistemi HGX di classe B200 e B300 per l'addestramento e l'inferenza dell'intelligenza artificiale e utilizza JumpStart per offrire anticipazioni, basate su accordi di riservatezza (NDA), su piattaforme di prossima generazione non ancora ampiamente distribuite. Non abbiamo visto nessun altro OEM così aggressivo nel trasformare l'infrastruttura pre-GA in un'esperienza di laboratorio remoto strutturata e ripetibile.
La maggior parte degli ambienti demo dei fornitori si limita a laboratori di soluzioni guidate o sandbox di prodotto ristretti. Questi sono utili per apprendere gli strumenti di gestione e i flussi di lavoro di orchestrazione, ma raramente forniscono l'accesso root a un server di livello superiore o la libertà di installare ed eseguire il proprio stack. JumpStart si comporta molto più come un rack in prestito in un data center remoto. Quando si prenota un sistema specifico, si ottiene il controllo completo tramite SSH, VNC e IPMI per tutta la durata della prenotazione, e Supermicro cancella e ricostruisce l'ambiente prima che il cliente successivo lo utilizzi. In pratica, sembra meno una demo di marketing e più un breve e mirato coinvolgimento in un laboratorio remoto ben gestito.
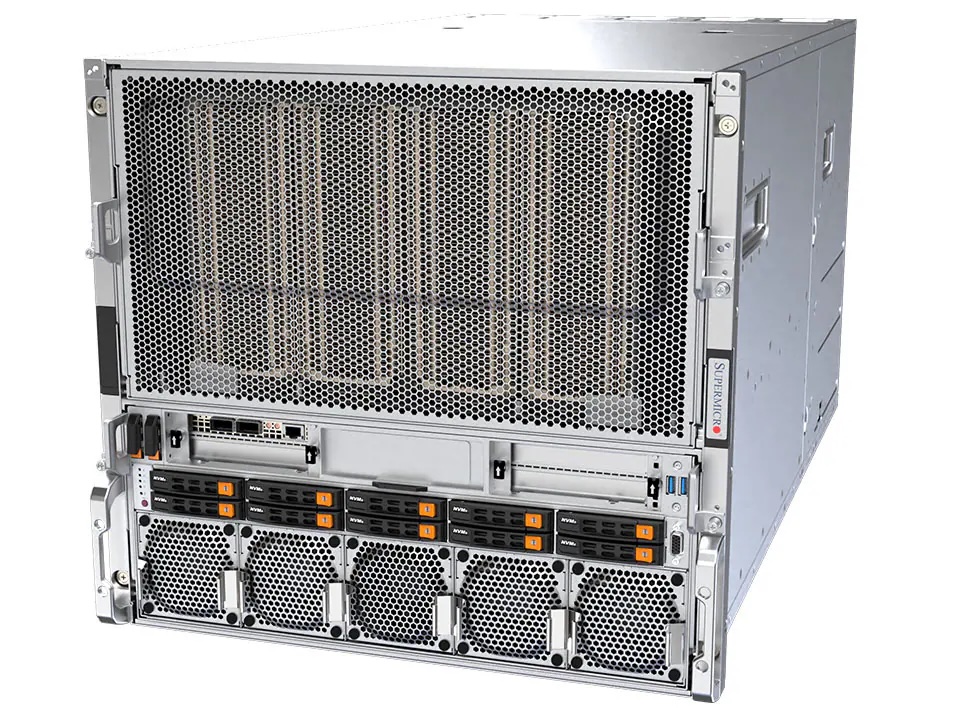
Sistema Supermicro JumpStart X14 B200
Per questa analisi, Supermicro ha fornito a StorageReview l'accesso a JumpStart esattamente come lo utilizzerebbe un cliente. Abbiamo prenotato del tempo su un sistema GPU X14 10U dotato di una scheda madre NVIDIA HGX B200 a 8 GPU e due processori Intel Xeon Platinum 6960P di sesta generazione. Il server era configurato con 3 TB di memoria DDR5-6400 ECC, una combinazione di SSD M.2 e U.2 NVMe per l'archiviazione locale e otto GPU B200, ciascuna con 180 GB di HBM3e. Nel corso di una settimana, abbiamo utilizzato questa piattaforma per verificare a campione i carichi di lavoro di intelligenza artificiale e il comportamento del sistema, concentrandoci sul tipo di domande a cui i clienti reali desiderano una risposta prima di impegnarsi in una nuova generazione di infrastrutture.
La nostra settimana nel programma Supermicro JumpStart
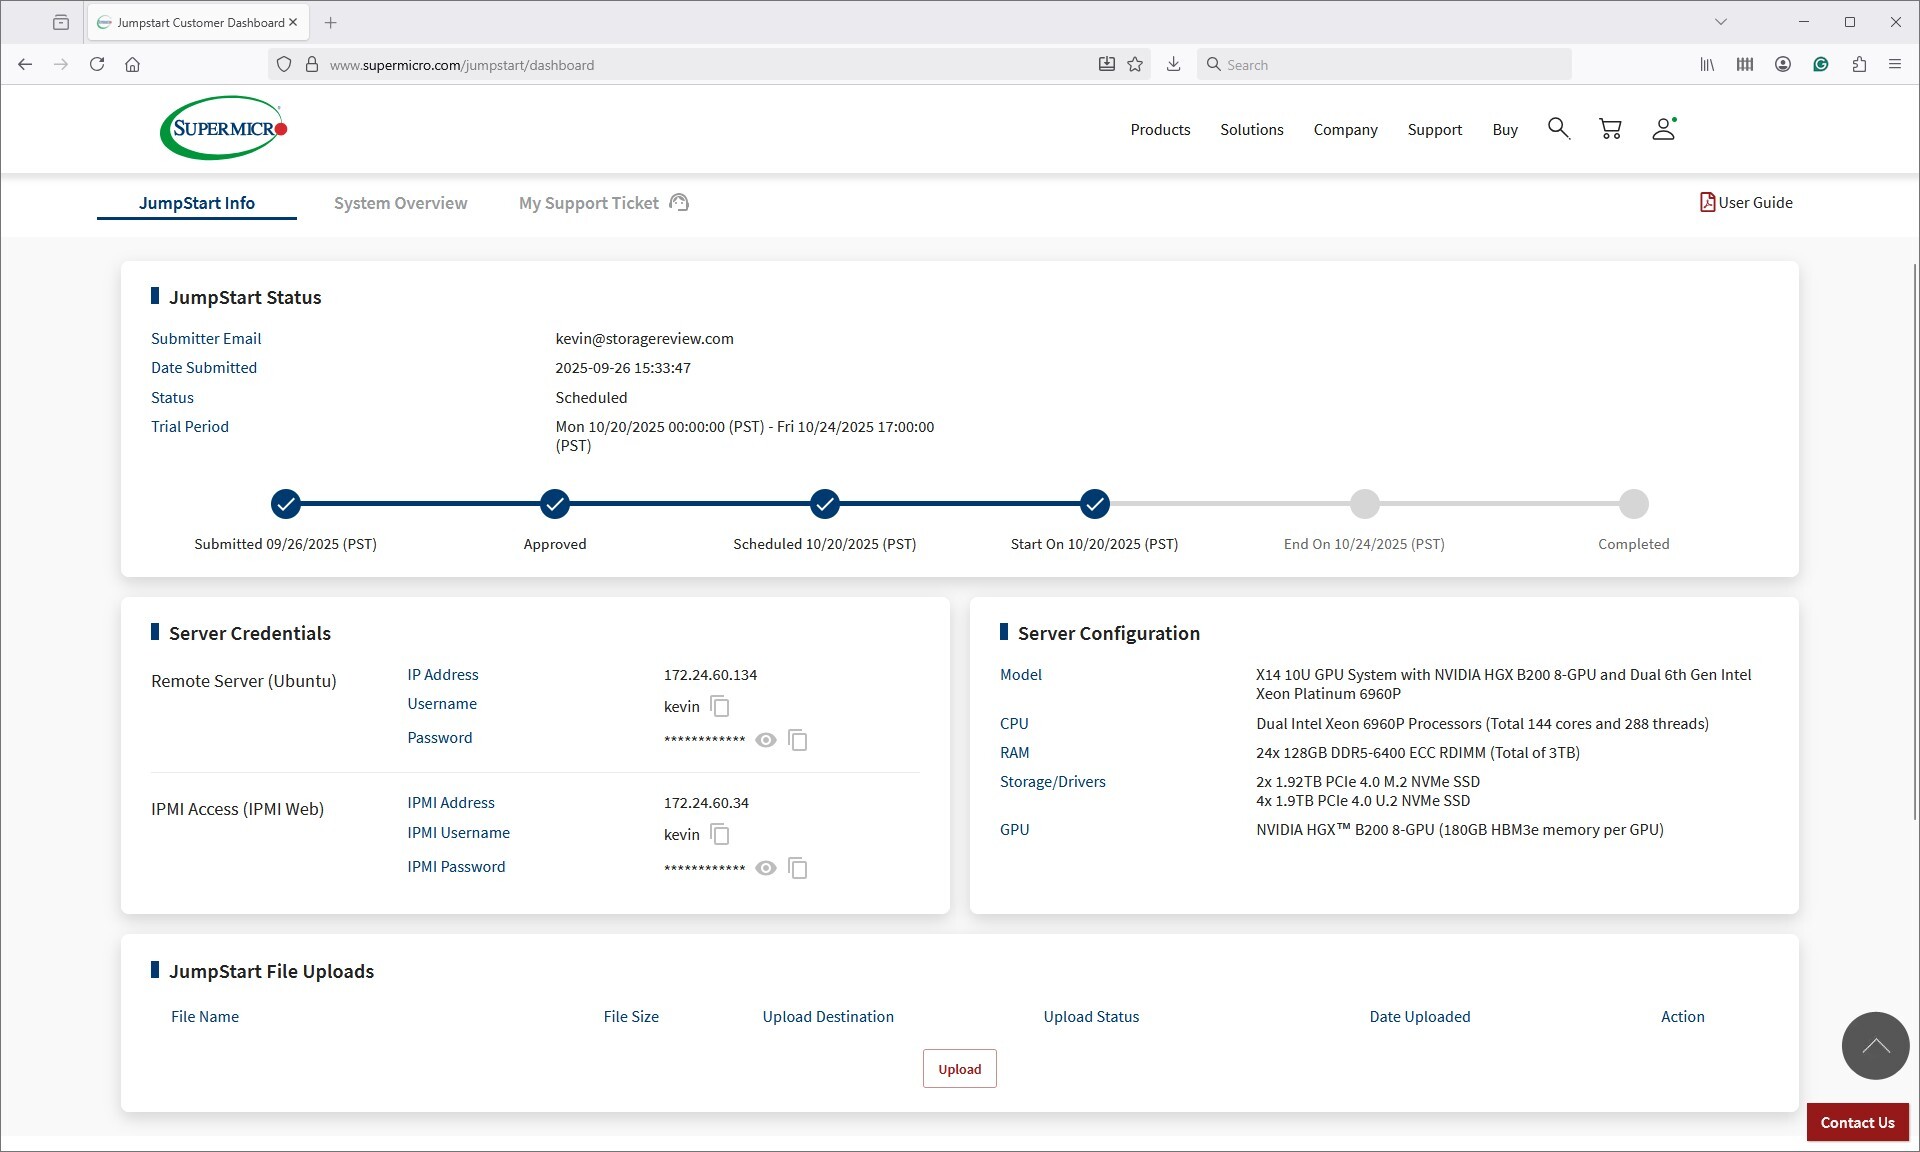
Una volta aperta la finestra di prenotazione, il portale JumpStart è diventato il fulcro centrale dei nostri test. La dashboard iniziale, mostrata di seguito, illustrava la tempistica della prenotazione e forniva tutto il necessario per iniziare, comprese le credenziali SSH per l'ambiente Ubuntu remoto e l'accesso IPMI completo. Avendo entrambe le interfacce immediatamente disponibili, abbiamo potuto iniziare a convalidare il sistema in pochi minuti, anziché attendere il provisioning o l'intervento del supporto.
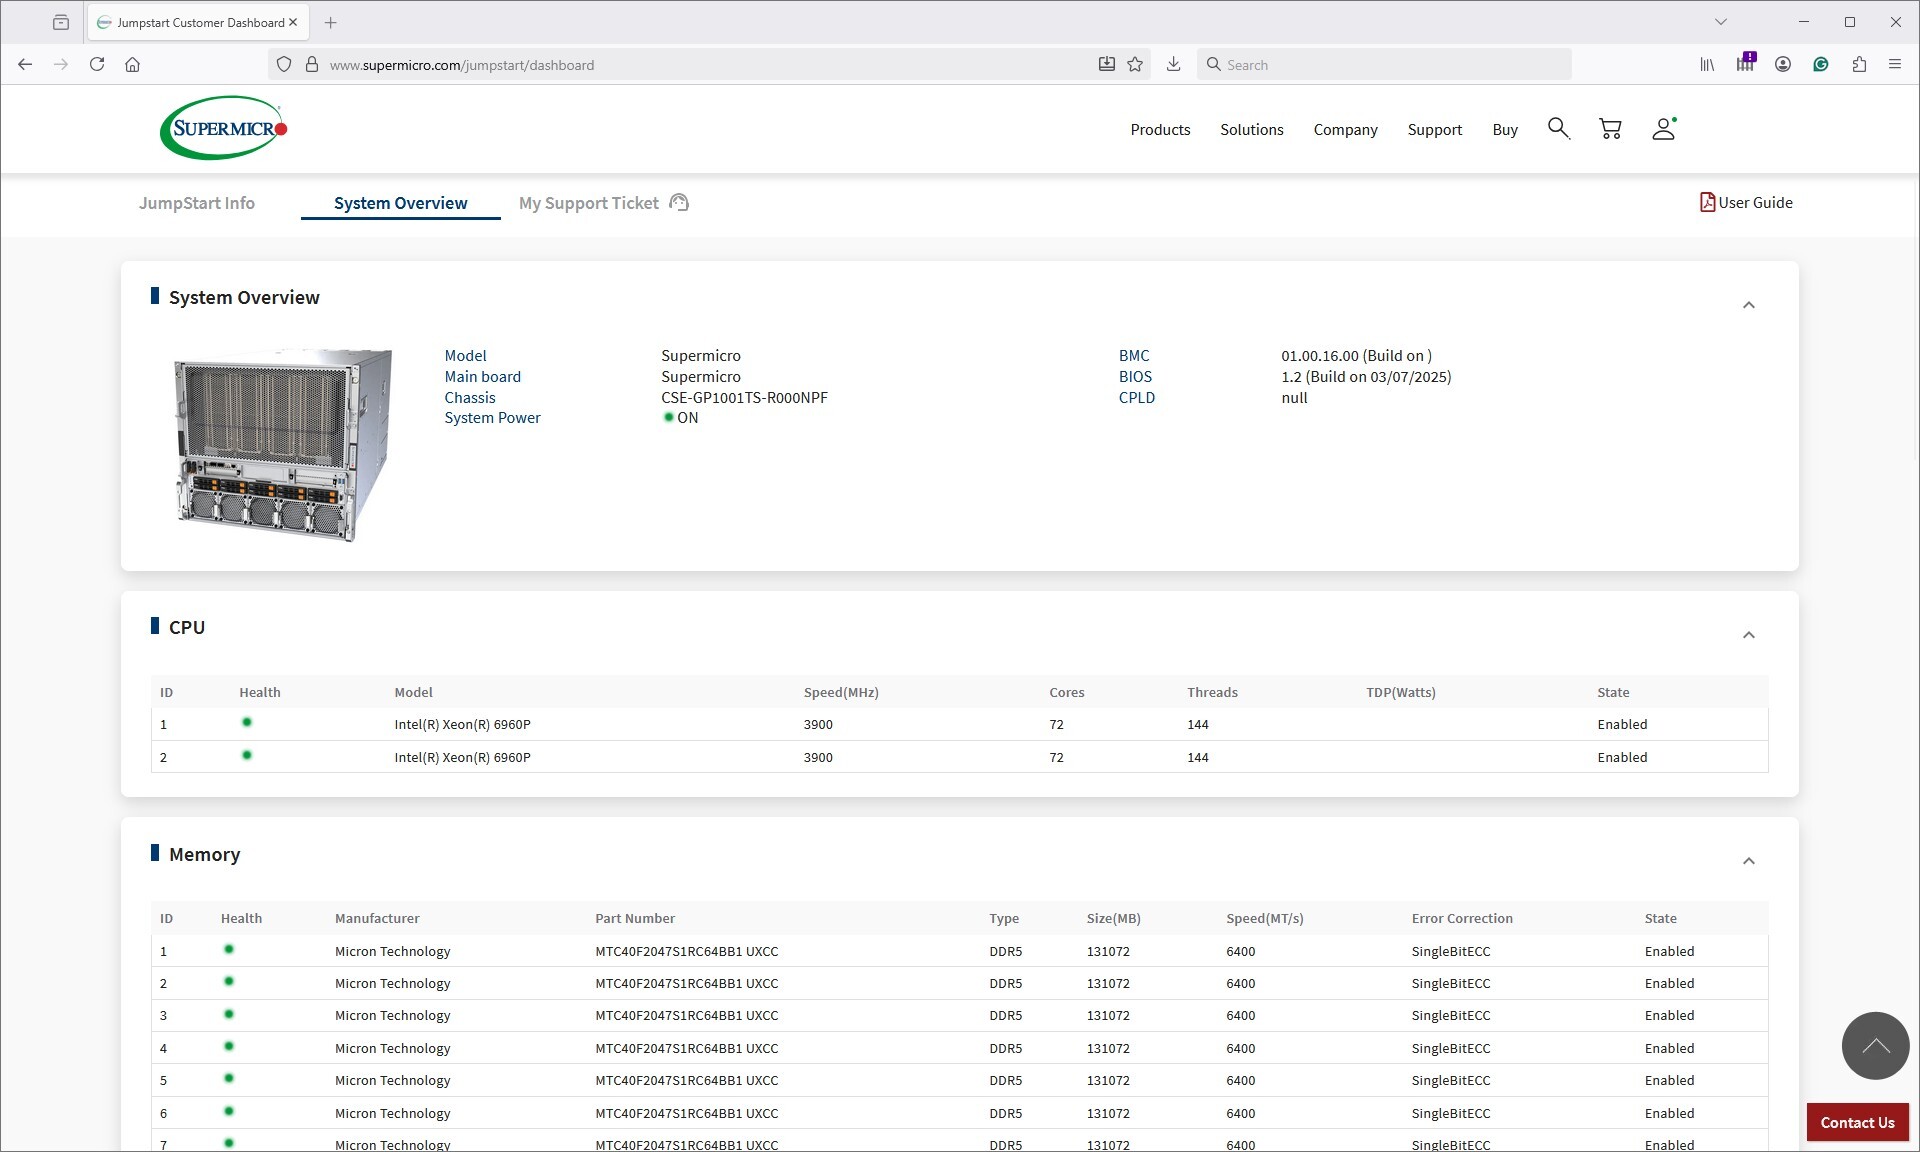
Il primo passo del nostro flusso di lavoro è stato confermare che l'hardware fosse pronto. Utilizzando la pagina Panoramica del sistema nel portale (vedere la schermata qui sotto), abbiamo verificato che lo chassis fosse acceso, che entrambe le CPU fossero state rilevate, che la memoria fosse completamente popolata e che il BMC segnalasse lo stato di salute del sistema "green". Questo rapido controllo è diventato una pratica standard nelle nostre valutazioni di laboratorio e la visibilità remota tramite il portale ha semplificato tale processo.
Una volta convalidato il sistema, siamo passati al lavoro pratico. Il caricamento dei file per le risorse di test è stato gestito direttamente tramite l'interfaccia JumpStart, eliminando la consueta difficoltà di staging dei set di dati su una piattaforma remota. Da lì, ci siamo connessi tramite SSH per la distribuzione dei carichi di lavoro e abbiamo utilizzato la console remota tramite IPMI quando avevamo bisogno di un accesso di basso livello o per osservare il comportamento di avvio.
Il flusso di lavoro durante la settimana è stato molto simile a quello delle apparecchiature operative nel nostro laboratorio. Siamo stati in grado di avviare, arrestare e iterare rapidamente i carichi di lavoro, riavviare la piattaforma quando necessario e monitorare il comportamento dell'hardware senza coinvolgere il supporto Supermicro. La combinazione di accesso a livello di sistema operativo e controllo totale fuori banda ha reso l'ambiente prevedibile ed efficiente per cicli di test brevi.
Al termine della prenotazione, il sistema è stato automaticamente ripristinato e resettato, concludendo l'incarico in modo netto. Questa struttura prevedibile ci ha permesso di concentrarci sui test piuttosto che sulla logistica e ci ha garantito di sfruttare appieno la finestra di accesso limitata.
Prestazioni di archiviazione GPUDirect
Uno dei test che abbiamo condotto sulla piattaforma Supermicro X14 è stato il test GPUDirect Storage (GDS) di Magnum IO. GDS è una funzionalità sviluppata da NVIDIA che consente alle GPU di bypassare la CPU quando accedono ai dati archiviati su unità NVMe o altri dispositivi di archiviazione ad alta velocità. Invece di instradare i dati attraverso la CPU e la memoria di sistema, GDS consente la comunicazione diretta tra la GPU e il dispositivo di archiviazione, riducendo significativamente la latenza e migliorando la velocità di trasmissione dei dati.
Come funziona GPUDirect Storage
Tradizionalmente, quando una GPU elabora i dati memorizzati su un'unità NVMe, i dati devono prima passare attraverso la CPU e la memoria di sistema prima di raggiungere la GPU. Questo processo introduce colli di bottiglia, poiché la CPU diventa un intermediario, aggiungendo latenza e consumando preziose risorse di sistema. GPUDirect Storage elimina questa inefficienza consentendo alla GPU di accedere ai dati direttamente dal dispositivo di archiviazione tramite il bus PCIe. Questo percorso diretto riduce il sovraccarico di trasferimento dei dati, consentendo trasferimenti più rapidi ed efficienti.
I carichi di lavoro di intelligenza artificiale, in particolare quelli che coinvolgono il deep learning, richiedono un elevato utilizzo di dati. L'addestramento di reti neurali di grandi dimensioni richiede l'elaborazione di terabyte di dati e qualsiasi ritardo nel trasferimento dei dati può portare a GPU sottoutilizzate e tempi di addestramento più lunghi. GPUDirect Storage affronta questa sfida garantendo che i dati vengano inviati alla GPU il più rapidamente possibile, riducendo al minimo i tempi di inattività e massimizzando l'efficienza computazionale.
Inoltre, GDS è particolarmente utile per carichi di lavoro che comportano lo streaming di grandi set di dati, come l'elaborazione video, l'elaborazione del linguaggio naturale o l'inferenza in tempo reale. Riducendo la dipendenza dalla CPU, GDS accelera lo spostamento dei dati e libera risorse della CPU per altre attività, migliorando ulteriormente le prestazioni complessive del sistema.
Oltre alla larghezza di banda pura, GPUDirect con NVMe-oF (TCP/RDMA) offre anche I/O a bassissima latenza. Questo garantisce che le GPU non siano mai a corto di dati, rendendo il sistema ideale per l'inferenza AI in tempo reale, le pipeline di analisi e la riproduzione video.
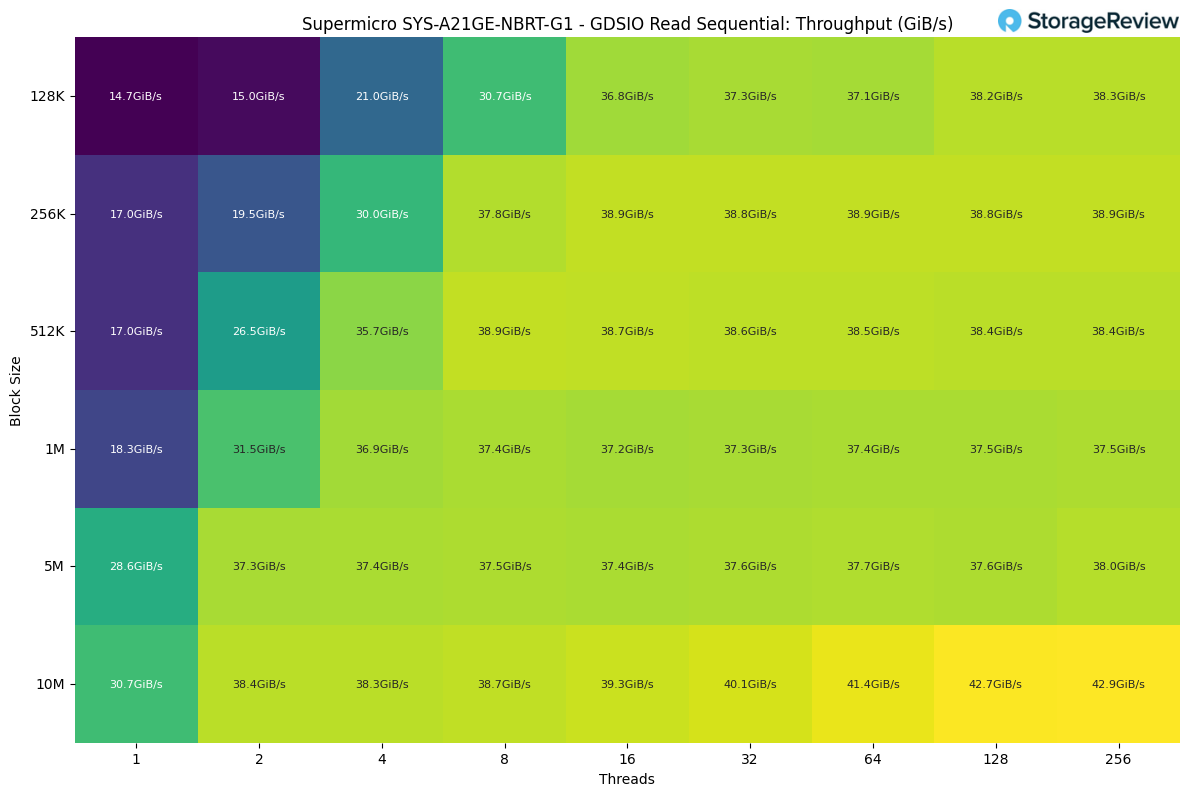
Velocità di lettura sequenziale GDSIO
Per i nostri test di lettura sequenziale GDSIO sulla piattaforma B200, il carico di lavoro è iniziato modestamente, con un singolo thread che raggiungeva circa 14-15 GiB/s, a seconda della dimensione del blocco. Non appena abbiamo aumentato sia il numero di thread che la dimensione del blocco, le prestazioni sono migliorate rapidamente. Il passaggio a 2 e 4 thread ha portato il throughput nell'intervallo 20-36 GiB/s, a dimostrazione dell'ottima scalabilità del sistema una volta introdotto il parallelismo.
La vera accelerazione si è verificata una volta raggiunti otto o più thread, momento in cui la maggior parte dei carichi di lavoro si è stabilizzata nell'intervallo elevato di 30 GiB/s. I blocchi più grandi hanno tratto i maggiori benefici, con dimensioni da 5 M e 10 M che hanno costantemente fornito numeri elevati su tutti i conteggi di thread.
La velocità di elaborazione ha raggiunto il massimo a circa 43 GiB/s con una dimensione del blocco di 10 M a 256 thread, rappresentando la più alta velocità di lettura sequenziale sostenuta osservata in questo test.
Latenza sequenziale di lettura GDSIO
Per quanto riguarda la latenza, il carico di lavoro è partito molto reattivo, con letture single-thread nell'intervallo 0.06-0.1 ms per blocchi più piccoli. Con l'aumentare dei thread, la latenza è gradualmente aumentata, mantenendosi al di sotto di 1 ms fino al punto di 8 thread per la maggior parte dei carichi di lavoro.
Una volta superati i 16 thread, le dimensioni dei blocchi più grandi hanno iniziato a spingersi in territori di diversi millisecondi, man mano che il percorso di archiviazione diventava più saturo. La latenza più elevata si è verificata alla fine del test, dove un blocco da 10 M con 256 thread ha raggiunto un picco di poco superiore a 1.2 secondi (circa 1200 ms), riflettendo un carico nel caso peggiore progettato per sovraccaricare il sistema.

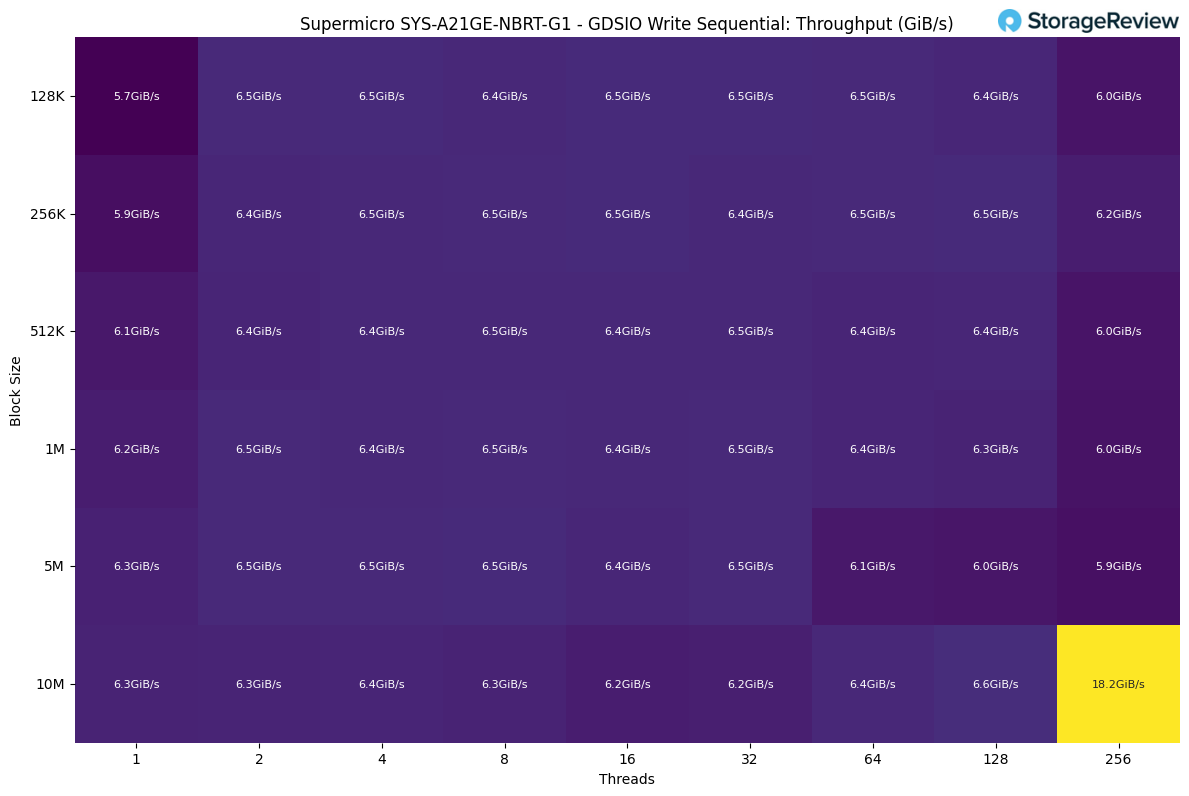
Velocità di scrittura sequenziale GDSIO
Per le scritture sequenziali, le prestazioni sono state molto più stabili rispetto alle letture. Il carico di lavoro si è stabilizzato rapidamente, con la maggior parte delle combinazioni di thread e dimensioni dei blocchi che si attestavano intorno a 6.3-6.5 GiB/s. Ciò indica che il percorso di scrittura raggiunge presto un limite costante, probabilmente legato ai supporti di archiviazione e al buffering piuttosto che ai limiti della GPU o del PCIe.
L'aumento del numero di thread non ha avuto un impatto significativo, poiché la velocità effettiva è rimasta sostanzialmente invariata da 2 a 128 thread. L'unico risultato degno di nota è stato raggiunto alla fine, dove una dimensione del blocco di 10 Mb a 256 thread ha raggiunto un picco di 18.2 GiB/s, mostrando un breve vantaggio quando il sistema può sfruttare appieno le code profonde e l'aggregazione delle scritture.
Latenza sequenziale di scrittura GDSIO
La latenza in scrittura era inizialmente relativamente bassa, con carichi di lavoro single-thread che si attestavano intorno a 0.15-0.5 ms su blocchi di dimensioni inferiori. Con l'aumentare dei thread, la latenza è aumentata in modo molto più aggressivo rispetto al lato lettura, attestandosi nell'intervallo 1-4 ms con quattro thread e 4-9 ms con otto thread.
Una volta raggiunti i 32 thread con blocchi di dimensioni maggiori, la latenza è aumentata drasticamente, con blocchi da 5 M e 10 M che hanno raggiunto un intervallo di 170-350 ms. Il caso più estremo è stato il blocco da 10 M a 256 thread, che ha raggiunto un picco di poco inferiore ai 3 secondi (circa 2900 ms), a dimostrazione della rapidità con cui il percorso di scrittura si satura sotto un carico parallelo elevato.

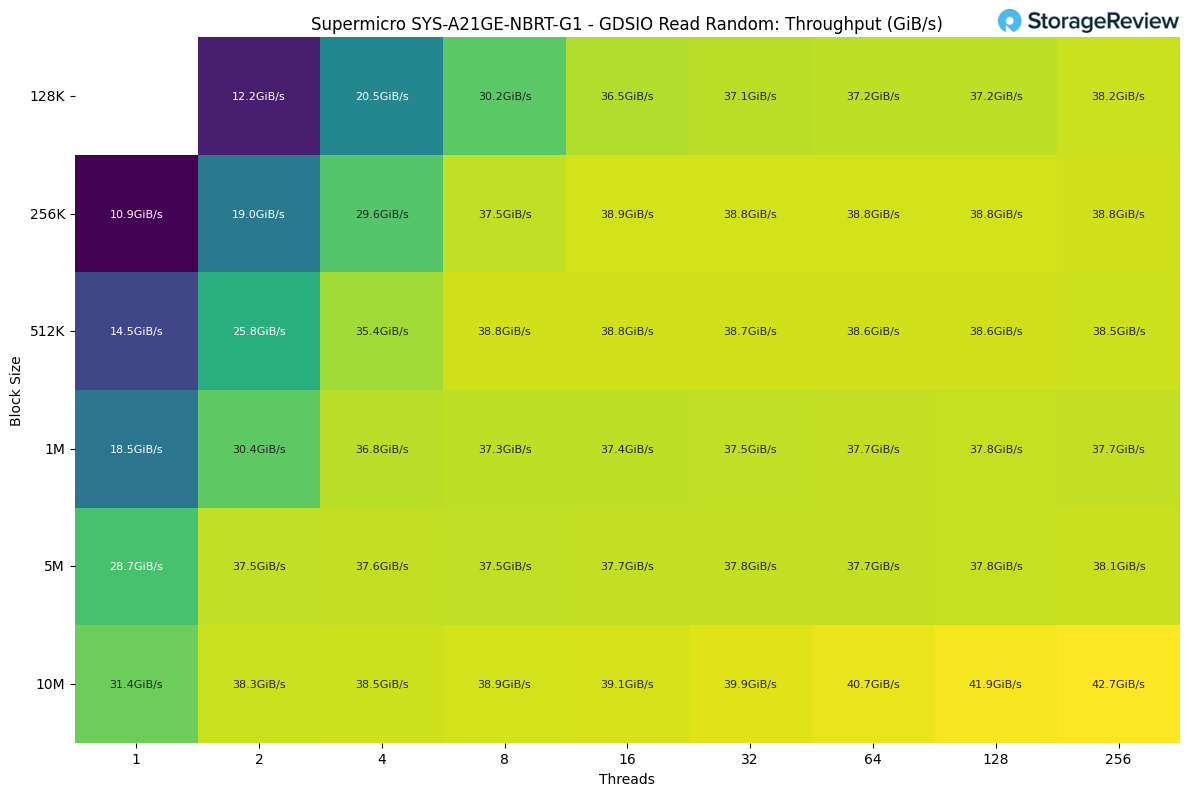
Velocità di lettura casuale GDSIO
Per le letture casuali, il carico di lavoro è aumentato rapidamente. Le prestazioni a thread singolo variavano da circa 11 a 31 GiB/s, a seconda della dimensione del blocco, con blocchi più grandi che beneficiavano immediatamente di una maggiore larghezza di banda. Una volta passati a due e quattro thread, la produttività è salita a 20-36 GiB/s, mostrando un notevole ridimensionamento fin dall'inizio.
Da 8 thread in su, il sistema si è stabilizzato su un plateau stabile nell'intervallo di 30 GiB/s, molto simile a quanto osservato nel test di lettura sequenziale. Il risultato più elevato è stato ottenuto con una dimensione del blocco di 10 M e 256 thread, con un picco di circa 42.7 GiB/s.
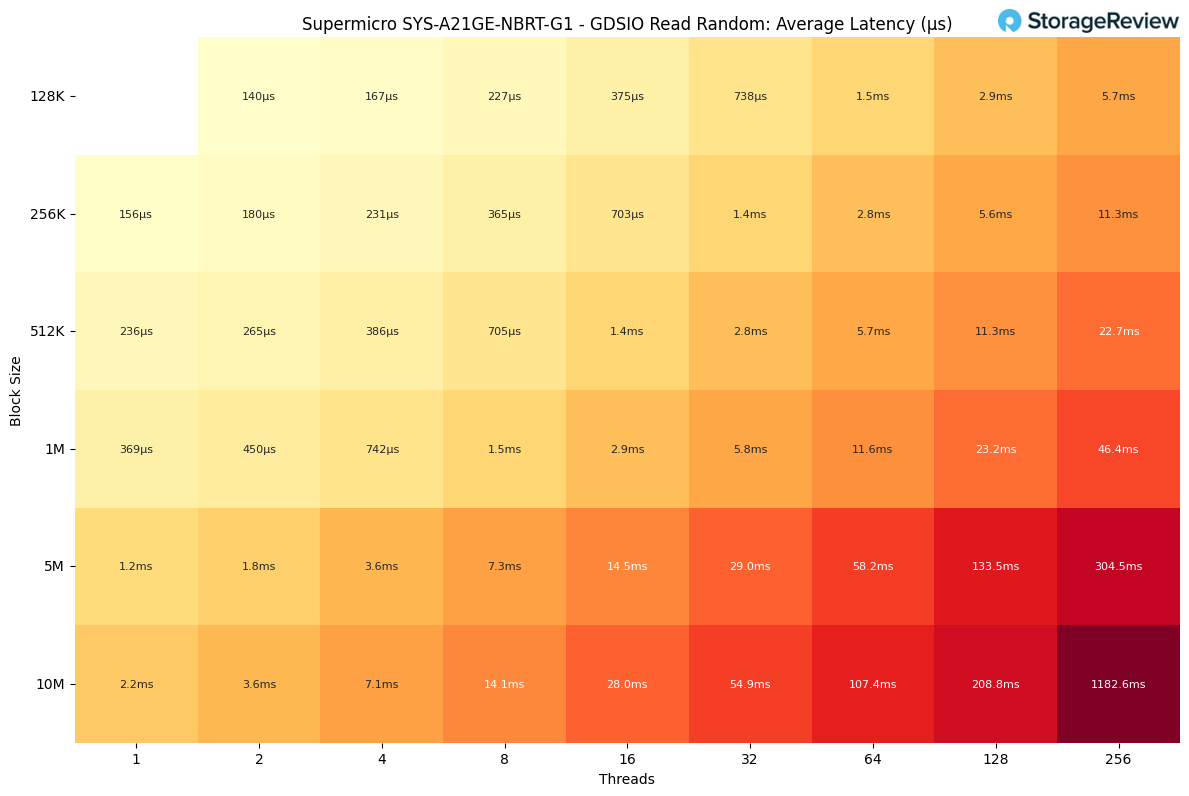
Latenza di lettura casuale GDSIO
La latenza di lettura casuale era inizialmente molto bassa, con carichi di lavoro a thread singolo che si attestavano intorno a 0.15-0.4 ms su blocchi di dimensioni inferiori. Con l'aumentare dei thread, la latenza è aumentata gradualmente, rimanendo inferiore a 1 ms fino al punto di 4 thread e raggiungendo circa 1-3 ms dopo otto thread.
Una volta passati a 32 thread e blocchi più grandi, la latenza è aumentata più bruscamente, con trasferimenti da 5M e 10M che si sono spinti nell'intervallo 30-55 ms. Il caso più estremo si è verificato a 256 thread con una dimensione del blocco di 10M, dove la latenza ha raggiunto il picco a poco più di 1.1 secondi (circa 1180 ms).
Velocità di scrittura casuale GDSIO
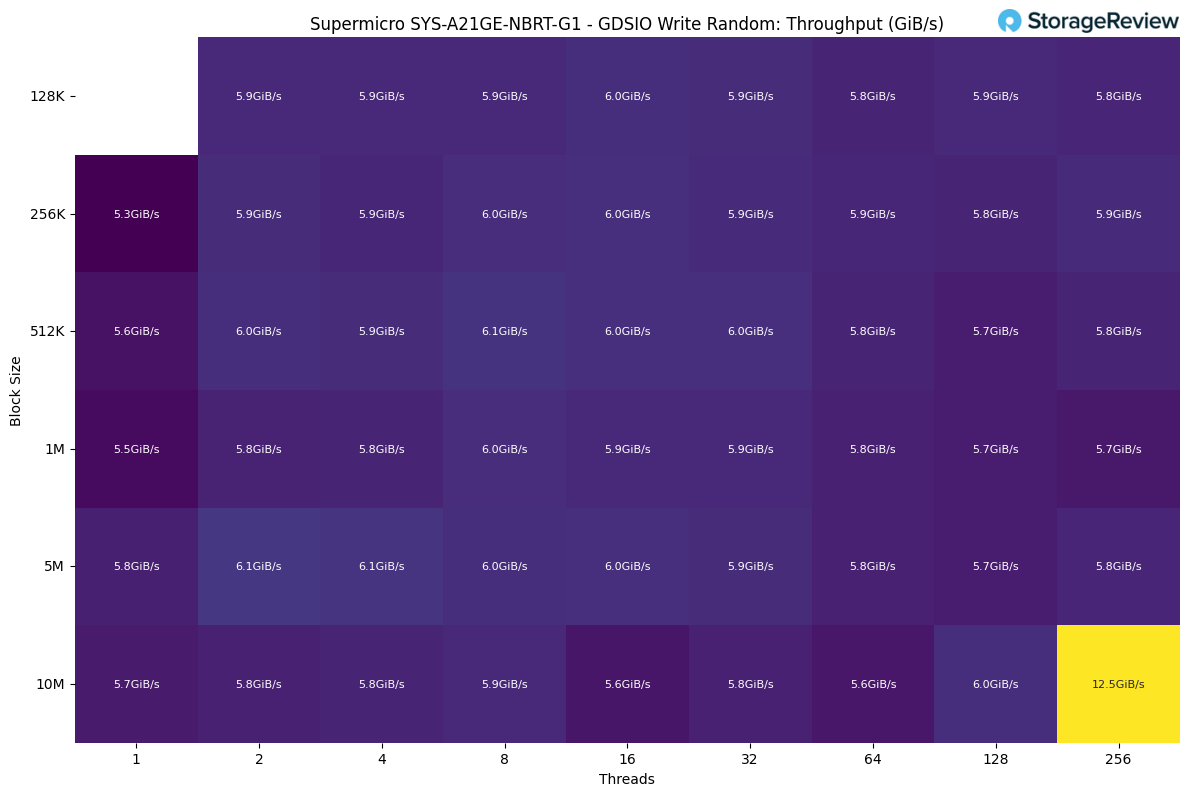
Le prestazioni di scrittura casuale sono state molto costanti su tutta la linea, con la maggior parte delle dimensioni dei blocchi e dei conteggi dei thread che si attestavano intorno a 5.8-6.1 GiB/s. Il carico di lavoro ha raggiunto questo livello quasi immediatamente e ha mostrato un ridimensionamento minimo con l'introduzione di thread aggiuntivi, a indicare che il percorso di scrittura raggiunge precocemente il suo limite.
L'unico valore anomalo degno di nota si è verificato alla fine del test, dove una dimensione del blocco di 10 M a 256 thread ha raggiunto brevemente i 12.5 GiB/s, probabilmente beneficiando del deep queueing e dell'aggregazione di scrittura sotto un carico parallelo pesante.
Latenza di scrittura casuale GDSIO
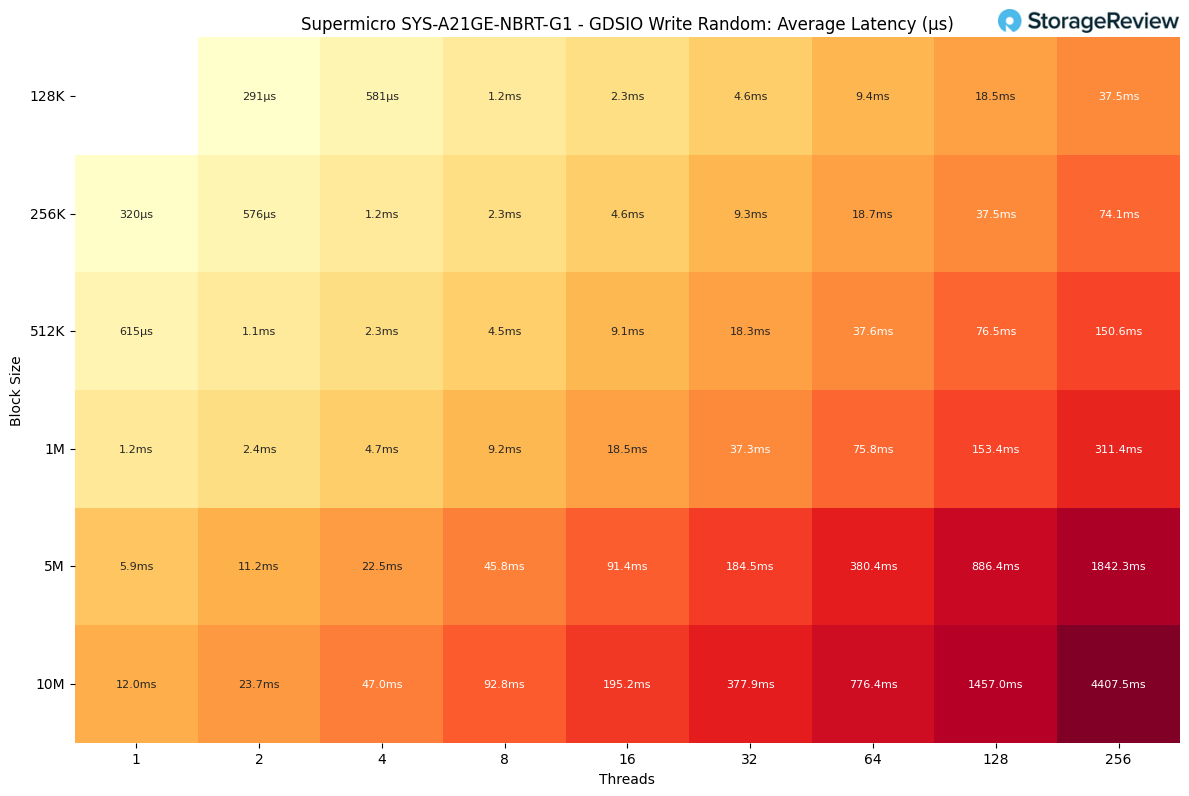
La latenza di scrittura casuale era inizialmente relativamente bassa, con prestazioni single-thread comprese tra circa 0.6 e 1.2 ms per blocchi di dimensioni inferiori e tra 5 e 12 ms per i trasferimenti più grandi. Con l'aumentare della concorrenza, la latenza è aumentata rapidamente, raggiungendo 4-9 ms per otto thread e 18-38 ms per 32 thread.
Oltre quel punto, il percorso di scrittura si è saturato. Le dimensioni dei blocchi più grandi sono balzate nell'intervallo 150-380 ms a 64 thread, e il continuo ridimensionamento ha aumentato notevolmente la latenza. Il caso peggiore si è verificato con blocchi da 10 Mb a 256 thread, con un massimo di circa 4.4 secondi.
vLLM Online Serving – Prestazioni di inferenza LLM
vLLM è il motore di inferenza e di servizio ad alta produttività più diffuso per gli LLM. Il benchmark di servizio online vLLM è uno strumento di valutazione delle prestazioni che misura le capacità di servizio reali di questo motore di inferenza in caso di richieste simultanee. Simula carichi di lavoro di produzione inviando richieste a un server vLLM in esecuzione con parametri configurabili, tra cui frequenza di richiesta, lunghezza di input/output e numero di client simultanei. Il benchmark misura metriche chiave, tra cui throughput (token al secondo), tempo per il primo token e tempo per token di output (TPOT), aiutando gli utenti a comprendere le prestazioni di vLLM in diverse condizioni di carico.
Abbiamo testato le prestazioni di inferenza su una suite completa di modelli che abbracciano varie architetture, scale di parametri e strategie di quantizzazione per valutare la produttività in base a diversi profili di concorrenza.
Prestazioni del modello denso
I modelli densi seguono l'architettura LLM convenzionale, in cui tutti i parametri e le attivazioni vengono coinvolti durante l'inferenza, con conseguente elaborazione più intensiva dal punto di vista computazionale rispetto alle controparti sparse. Per valutare in modo completo le caratteristiche prestazionali su diverse scale di modelli e strategie di quantizzazione, abbiamo confrontato diverse configurazioni di modelli densi della famiglia Llama 3.1 8B.
La nostra suite di test includeva valutazioni di Meta Llama 3.1 8B su tre formati di precisione: la configurazione standard, più le versioni quantizzate FP8 e FP4 che utilizzano il formato NVFP4 di NVIDIA. È importante notare che vLLM attualmente utilizza il kernel Marlin per i modelli quantizzati NVFP4 e che i vantaggi prestazionali completi di questo formato di quantizzazione non sono ancora stati sfruttati appieno in questi benchmark. Future ottimizzazioni di vLLM mirate alle operazioni native del core tensore NVFP4 potrebbero apportare ulteriori miglioramenti delle prestazioni. Questa strategia di selezione del modello consente un confronto diretto delle prestazioni, isolando al contempo l'impatto della quantizzazione progressiva sul throughput di inferenza.
Prestazioni Llama 3.1 8B
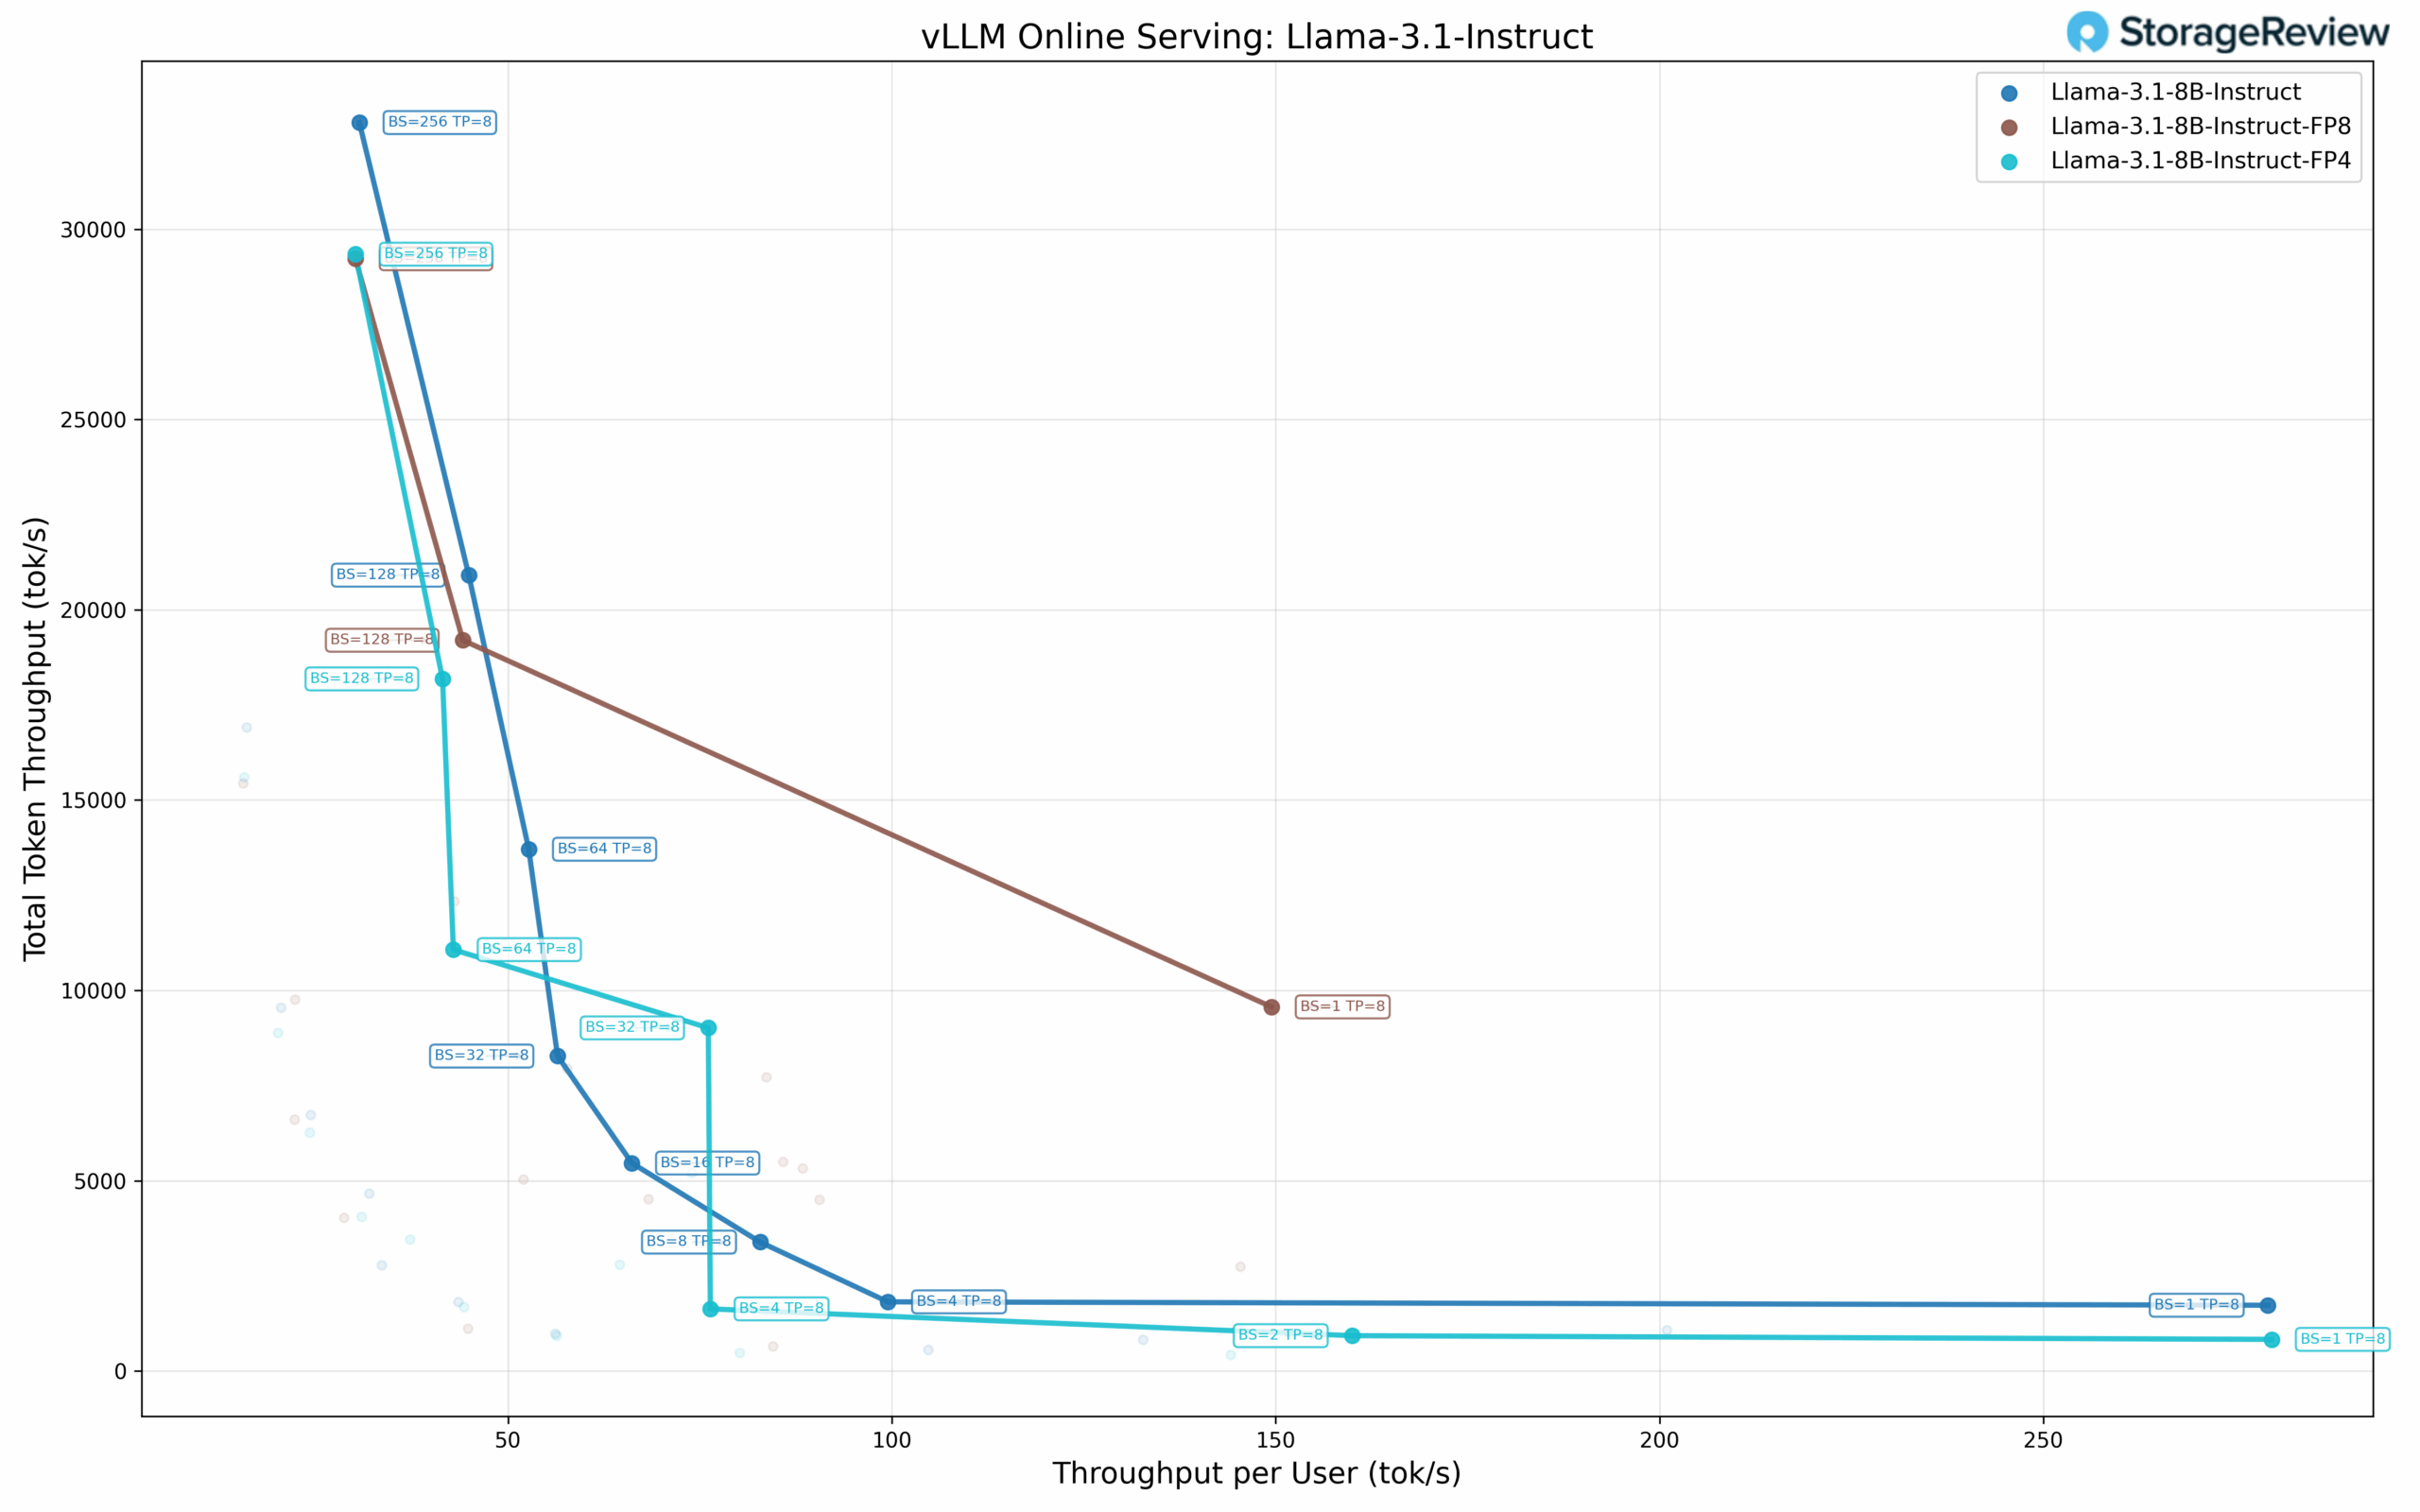
Il modello Llama 3.1 8B a precisione standard mostra le seguenti caratteristiche di scalabilità tra i diversi livelli di concorrenza. Con concorrenza a singolo utente (BS=1), il modello fornisce 279.27 tok/s per utente, con una produttività totale di 1,727.62 tok/s e un TPOT di 3.37 ms. All'aumentare delle dimensioni del batch, la produttività per utente diminuisce, mentre la produttività totale aumenta. Con BS=8, il modello raggiunge 82.85 tok/s per utente, con 3,386.48 tok/s totali e 3.28 ms di TPOT. Le prestazioni continuano a scalare fino a BS=32 (56.46 tok/s per utente, 8,274.66 tok/s totali) e BS=64 (52.70 tok/s per utente, 13,707.66 tok/s totali).
Il modello raggiunge la sua massima produttività totale a BS=256, erogando 32,797.67 tok/s, con 30.64 tok/s per utente e un TPOT di 16.13 ms. Ciò rappresenta un aumento di 19 volte della produttività totale rispetto alle prestazioni di un singolo utente. I valori di TPOT rimangono nell'intervallo 3-4 ms fino a BS=64, aumentando a 16.13 ms a BS=256.
Prestazioni Llama 3.1 8B FP8
La variante quantizzata FP8 mostra caratteristiche diverse. A BS=1, raggiunge 149.46 tok/s per utente, con una produttività totale di 9,565.20 tok/s e un TPOT di 3.44 ms. L'analisi della frontiera di Pareto rivela tre punti ottimali (BS=1, BS=128, BS=256).
A BS=128, il modello eroga 44.12 tok/s per utente con 19,198.40 tok/s totali e 11.04 ms
TPOT. La massima produttività totale si ottiene a BS=256 con 29,219.67 tok/s totali, 30.13 tok/s per utente e 13.26 ms TPOT. La variante FP8 raggiunge una produttività totale massima inferiore rispetto alla precisione standard (29.2K contro 32.8K tok/s).
Prestazioni Llama 3.1 8B FP4
La configurazione quantizzata FP4 mostra i seguenti risultati. Con concorrenza monoutente (BS=1), raggiunge 279.73 tok/s per utente, una produttività totale di 830.46 tok/s e 3.43 ms TPOT.
Il modello FP4 mostra sette punti di frontiera di Pareto. A BS=2, eroga 159.95 tok/s per utente, 928.60 tok/s totali e 3.43 ms di TPOT. Le prestazioni continuano a crescere fino a BS=4 (76.36 tok/s per utente, 1,631.69 tok/s totali) e BS=32 (76.09 tok/s per utente, 9,014.29 tok/s totali). Il modello raggiunge la massima produttività totale a BS=256 con 29,340.89 tok/s totali, 30.13 tok/s per utente e 16.18 ms di TPOT.
Prestazioni del modello sparso
I modelli sparsi, in particolare le architetture Mixture of Experts (MoE), rappresentano un approccio emergente per scalare in modo efficiente i modelli linguistici. Queste architetture mantengono un numero elevato di parametri totali attivando solo un sottoinsieme di parametri per token, offrendo potenzialmente prestazioni migliori per parametro attivo.
Abbiamo valutato due architetture MoE: DeepSeek-R1, un modello incentrato sul ragionamento, e Qwen3 Coder 30B-A3B, un'architettura sparsa specializzata per la generazione di codice. DeepSeek-R1 è il modello incentrato sul ragionamento più diffuso, con caratteristiche prestazionali distintive rispetto ai modelli linguistici tradizionali. Il modello Qwen3 Coder mantiene una dimensione completa di 30 miliardi di parametri, attivandone solo 3 miliardi per token generato. Abbiamo eseguito il benchmarking di Qwen3 Coder sia nella variante standard che in quella quantizzata FP8 per comprendere le caratteristiche prestazionali delle diverse strategie di quantizzazione.
Prestazioni DeepSeek-R1
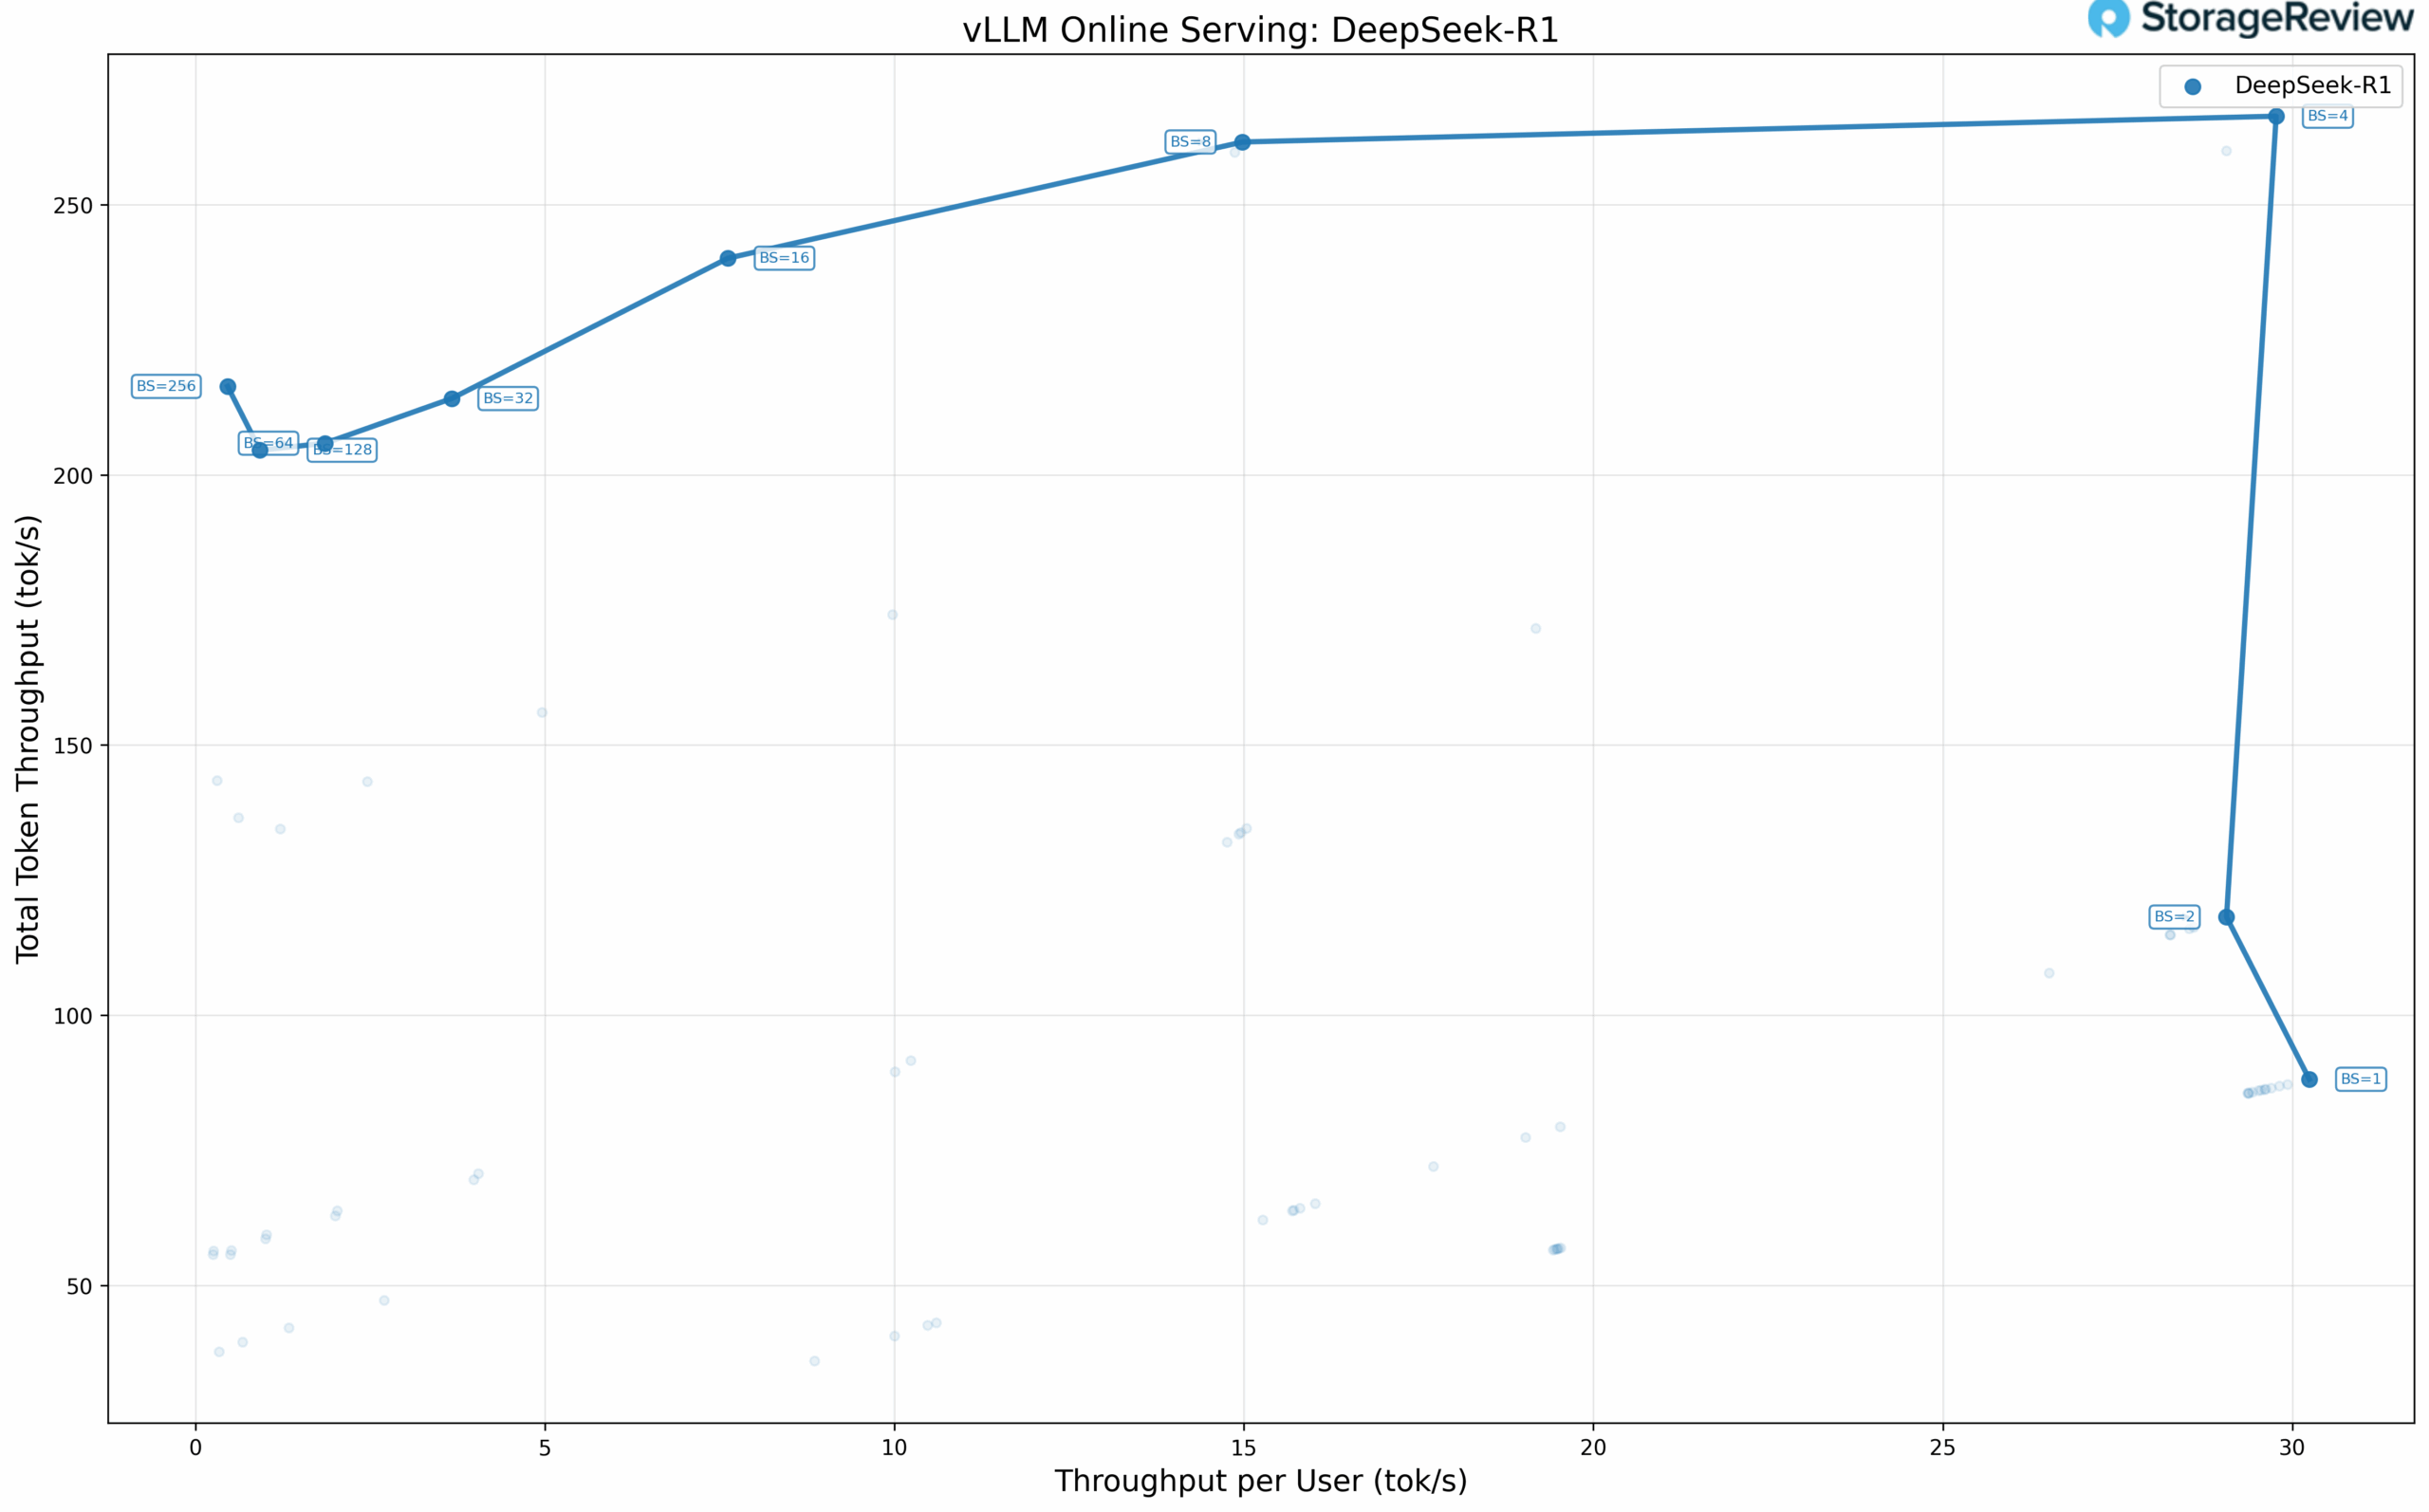
Il modello DeepSeek-R1 mostra un interessante comportamento di scalabilità in base alle dimensioni dei batch. Con concorrenza a singolo utente (BS=1), il modello raggiunge 30.24 tok/s per utente, una produttività totale di 88.13 tok/s e 29.85 ms di TPOT. Scalando a BS=4, le prestazioni raggiungono 29.77 tok/s per utente, con una produttività totale di 266.40 tok/s e 32.04 ms di TPOT, che rappresenta la produttività totale massima raggiunta in tutte le configurazioni.
Le prestazioni di DeepSeek-R1 raggiungono un plateau oltre BS=4. A BS=8, la produttività per utente scende drasticamente a 14.98 tok/s e il calo continua a batch di dimensioni maggiori, raggiungendo solo 0.46 tok/s per utente a BS=256. La produttività totale rimane relativamente stabile tra 200 e 260 tok/s tra BS=4 e BS=256, poiché il modello non può scalare con richieste simultanee aggiuntive su un singolo nodo, con conseguente aumento della latenza senza significativi guadagni di produttività. Un aspetto importante da notare è che B200 DGX è una delle poche soluzioni a server singolo in grado di eseguire questo modello di grandi dimensioni.
Prestazioni del coder Qwen3 30B-A3B
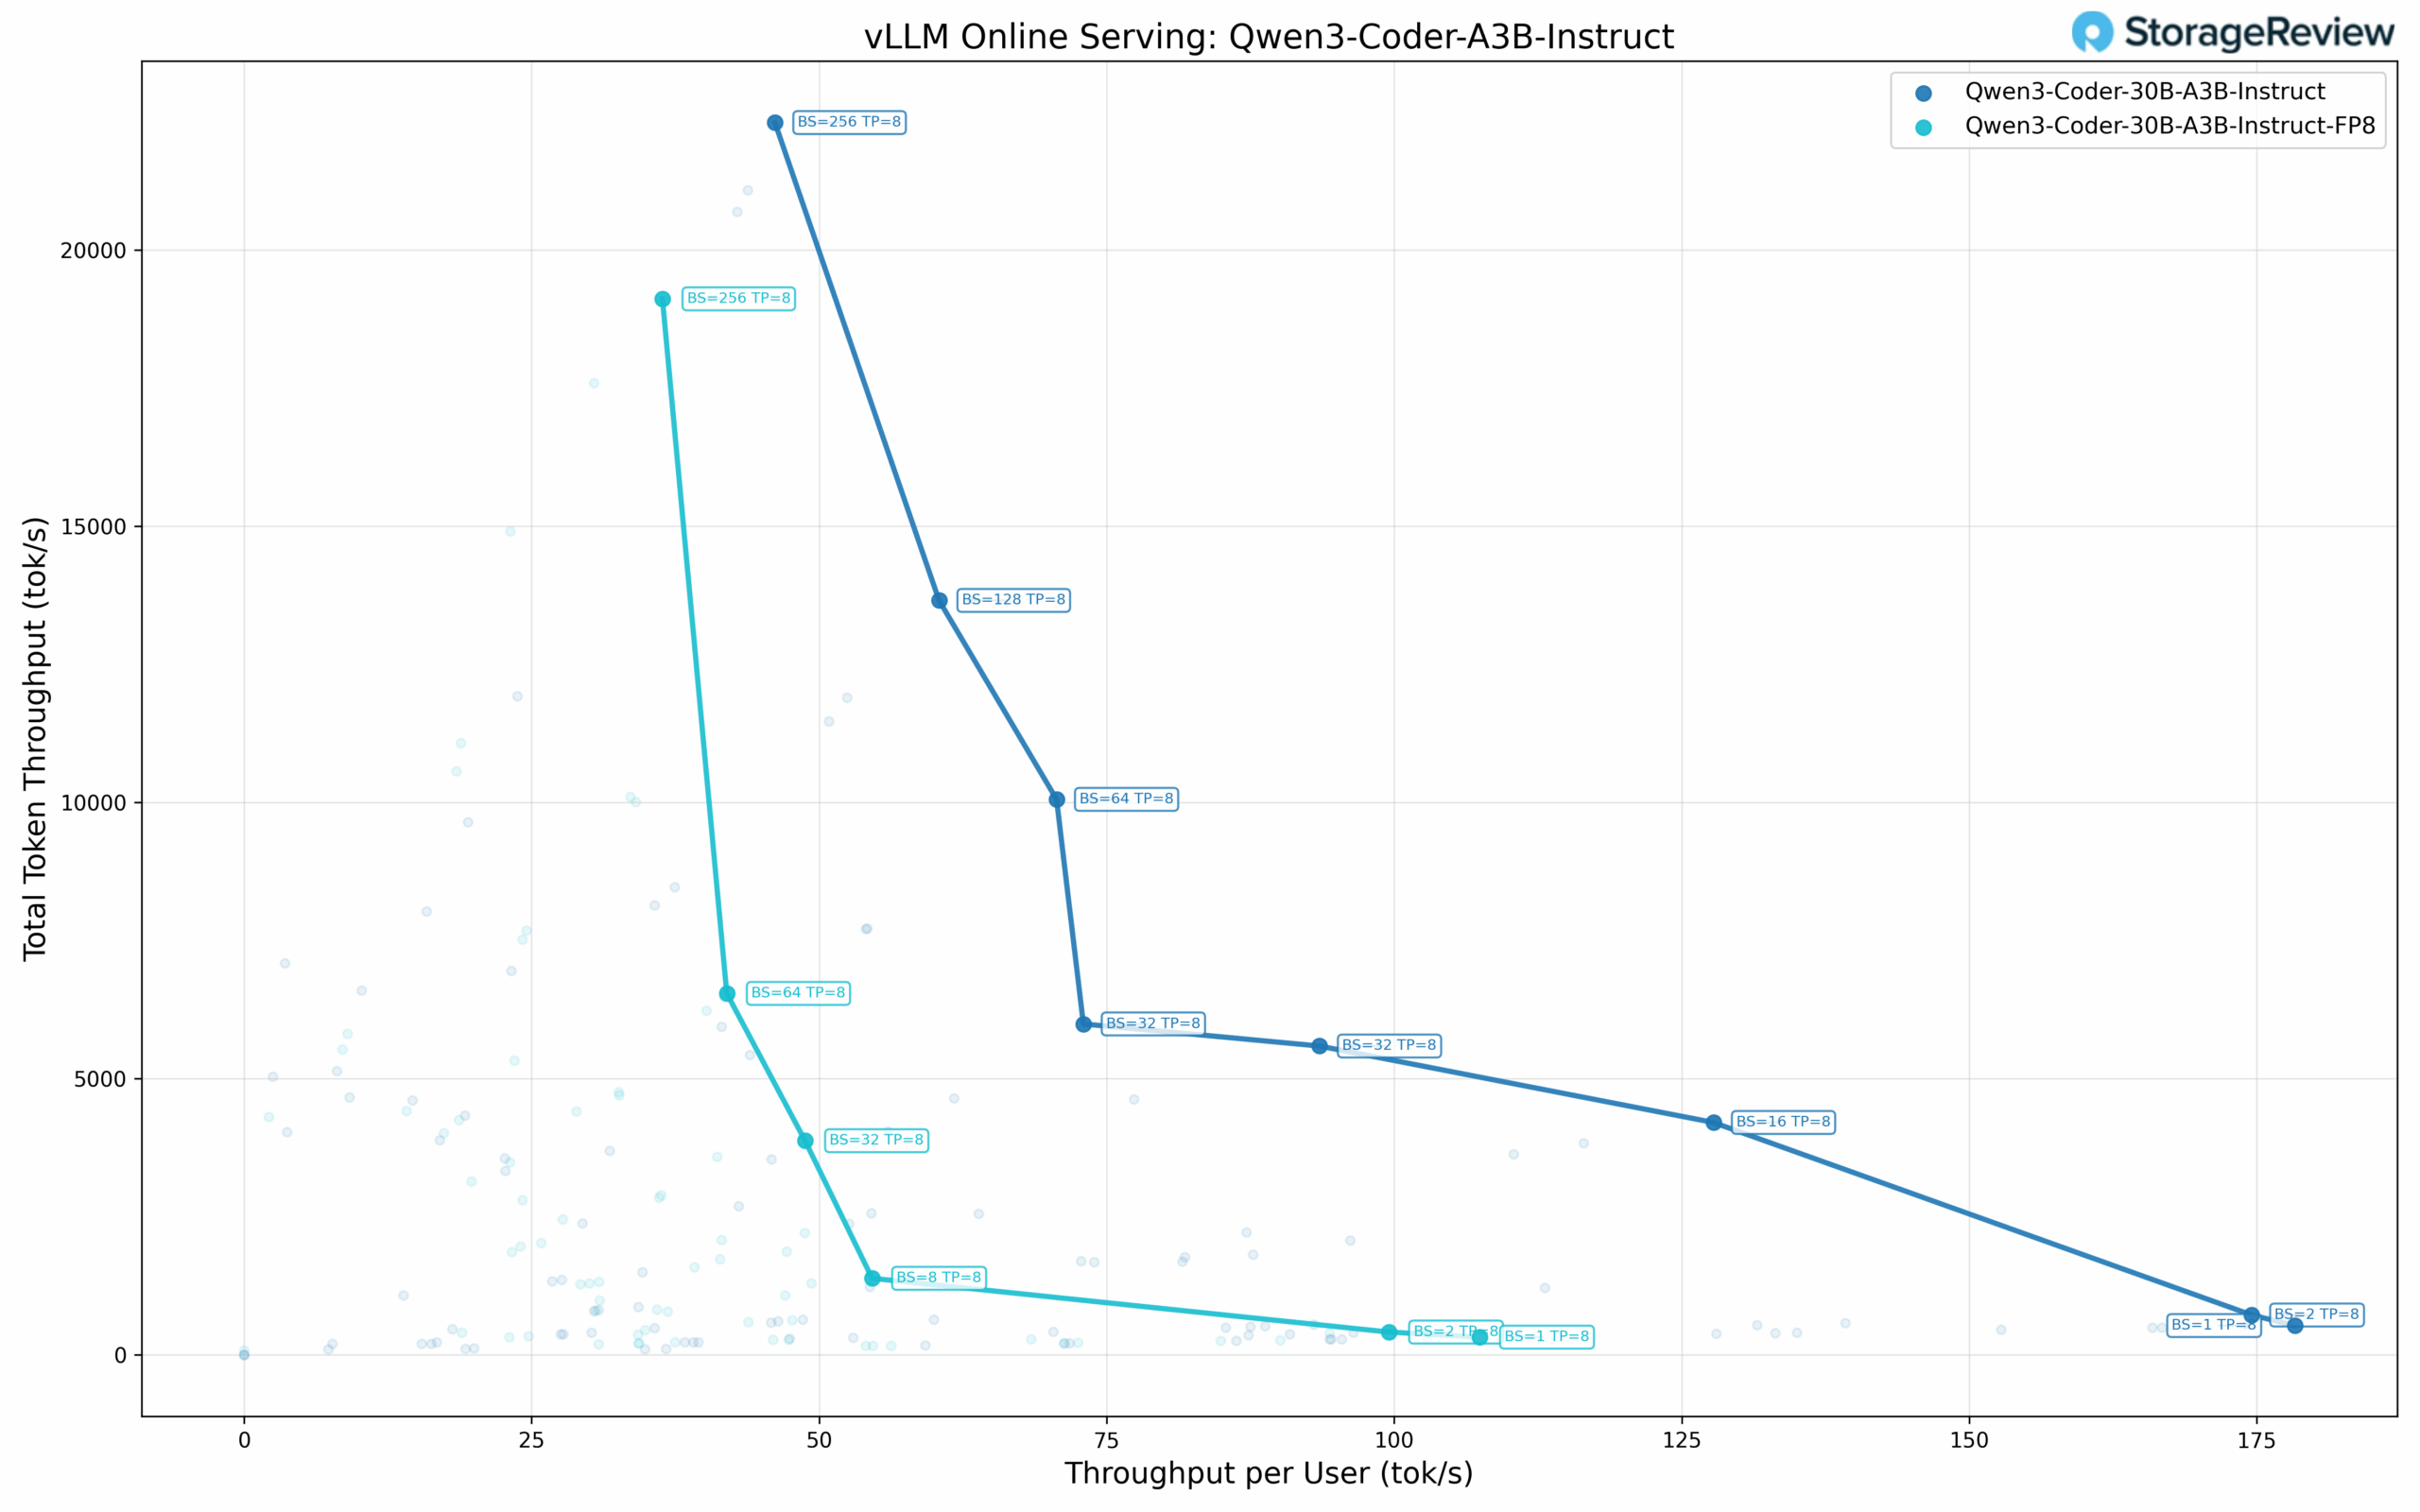
Il coder Qwen3 a precisione standard mostra la seguente scalabilità tra i livelli di concorrenza. Con concorrenza a singolo utente (BS=1), il modello raggiunge 178.30 tok/s per utente, 527.25 tok/s di throughput totale e 5.46 ms di TPOT. Con BS=2, le prestazioni raggiungono 174.56 tok/s per utente con 718.70 tok/s totali e 5.60 ms di TPOT. All'aumentare delle dimensioni del batch, il throughput per utente diminuisce, mentre il throughput totale continua a scalare: BS=16 fornisce 127.76 tok/s per utente, 4,204.40 tok/s totali e 6.93 ms di TPOT.
Il modello raggiunge la sua massima produttività totale a BS=256, raggiungendo un totale di 22,305.88 tok/s con 46.16 tok/s per utente e 17.64 ms di TPOT. La frontiera di Pareto include otto punti distinti, con una voce duplicata a BS=32 (72.97 tok/s e 93.50 tok/s per utente, che probabilmente rappresentano configurazioni diverse). I valori di TPOT rimangono nell'intervallo 5-9 ms fino a BS=64.
Prestazioni Qwen3 Coder 30B-A3B FP8
La variante quantizzata FP8 presenta le seguenti caratteristiche prestazionali. Con concorrenza a singolo utente (BS=1), fornisce 107.46 tok/s per utente, 317.75 tok/s di throughput totale e 9.16 ms di TPOT. Con BS=2, il modello raggiunge 99.55 tok/s per utente con 409.87 tok/s di throughput totale e 9.86 ms di TPOT.
Scalabilità a batch di dimensioni maggiori: BS=8 eroga 54.60 tok/s per utente con 1,383.13 tok/s totali e 10.24 ms TPOT, mentre BS=32 raggiunge 48.78 tok/s per utente con 3,874.21 tok/s totali e 10.67 ms TPOT. La produttività totale massima si ottiene con BS=256 con 19,114.86 tok/s totali, 36.38 tok/s per utente e 20.00 ms TPOT. Ciò rappresenta circa l'86% della produttività massima con precisione standard.
Prestazioni del tipo di dati di microscalatura
Il microscaling rappresenta un approccio di quantizzazione avanzato che applica fattori di scala a grana fine a piccoli blocchi di pesi anziché una quantizzazione uniforme su grandi gruppi di parametri. Il formato NVFP4 di NVIDIA implementa questa tecnica attraverso una rappresentazione in virgola mobile bloccata in cui ogni blocco di microscala di 8-32 valori condivide un esponente comune come fattore di scala. Questo approccio granulare preserva la precisione numerica ottenendo al contempo una rappresentazione a 4 bit, mantenendo la gamma dinamica critica per le architetture a trasformatore. Il formato si integra con l'architettura Tensor Core di NVIDIA, consentendo un calcolo efficiente a precisione mista con decompressione al volo durante le operazioni sulla matrice.
Abbiamo valutato i modelli OSS GPT di OpenAI a due scale di parametri utilizzando la quantizzazione NVFP4: la variante da 20B e la variante più grande da 120B. Questi benchmark dimostrano come la quantizzazione microscaling si comporta su modelli di diverse dimensioni.
Prestazioni GPT-OSS-20B
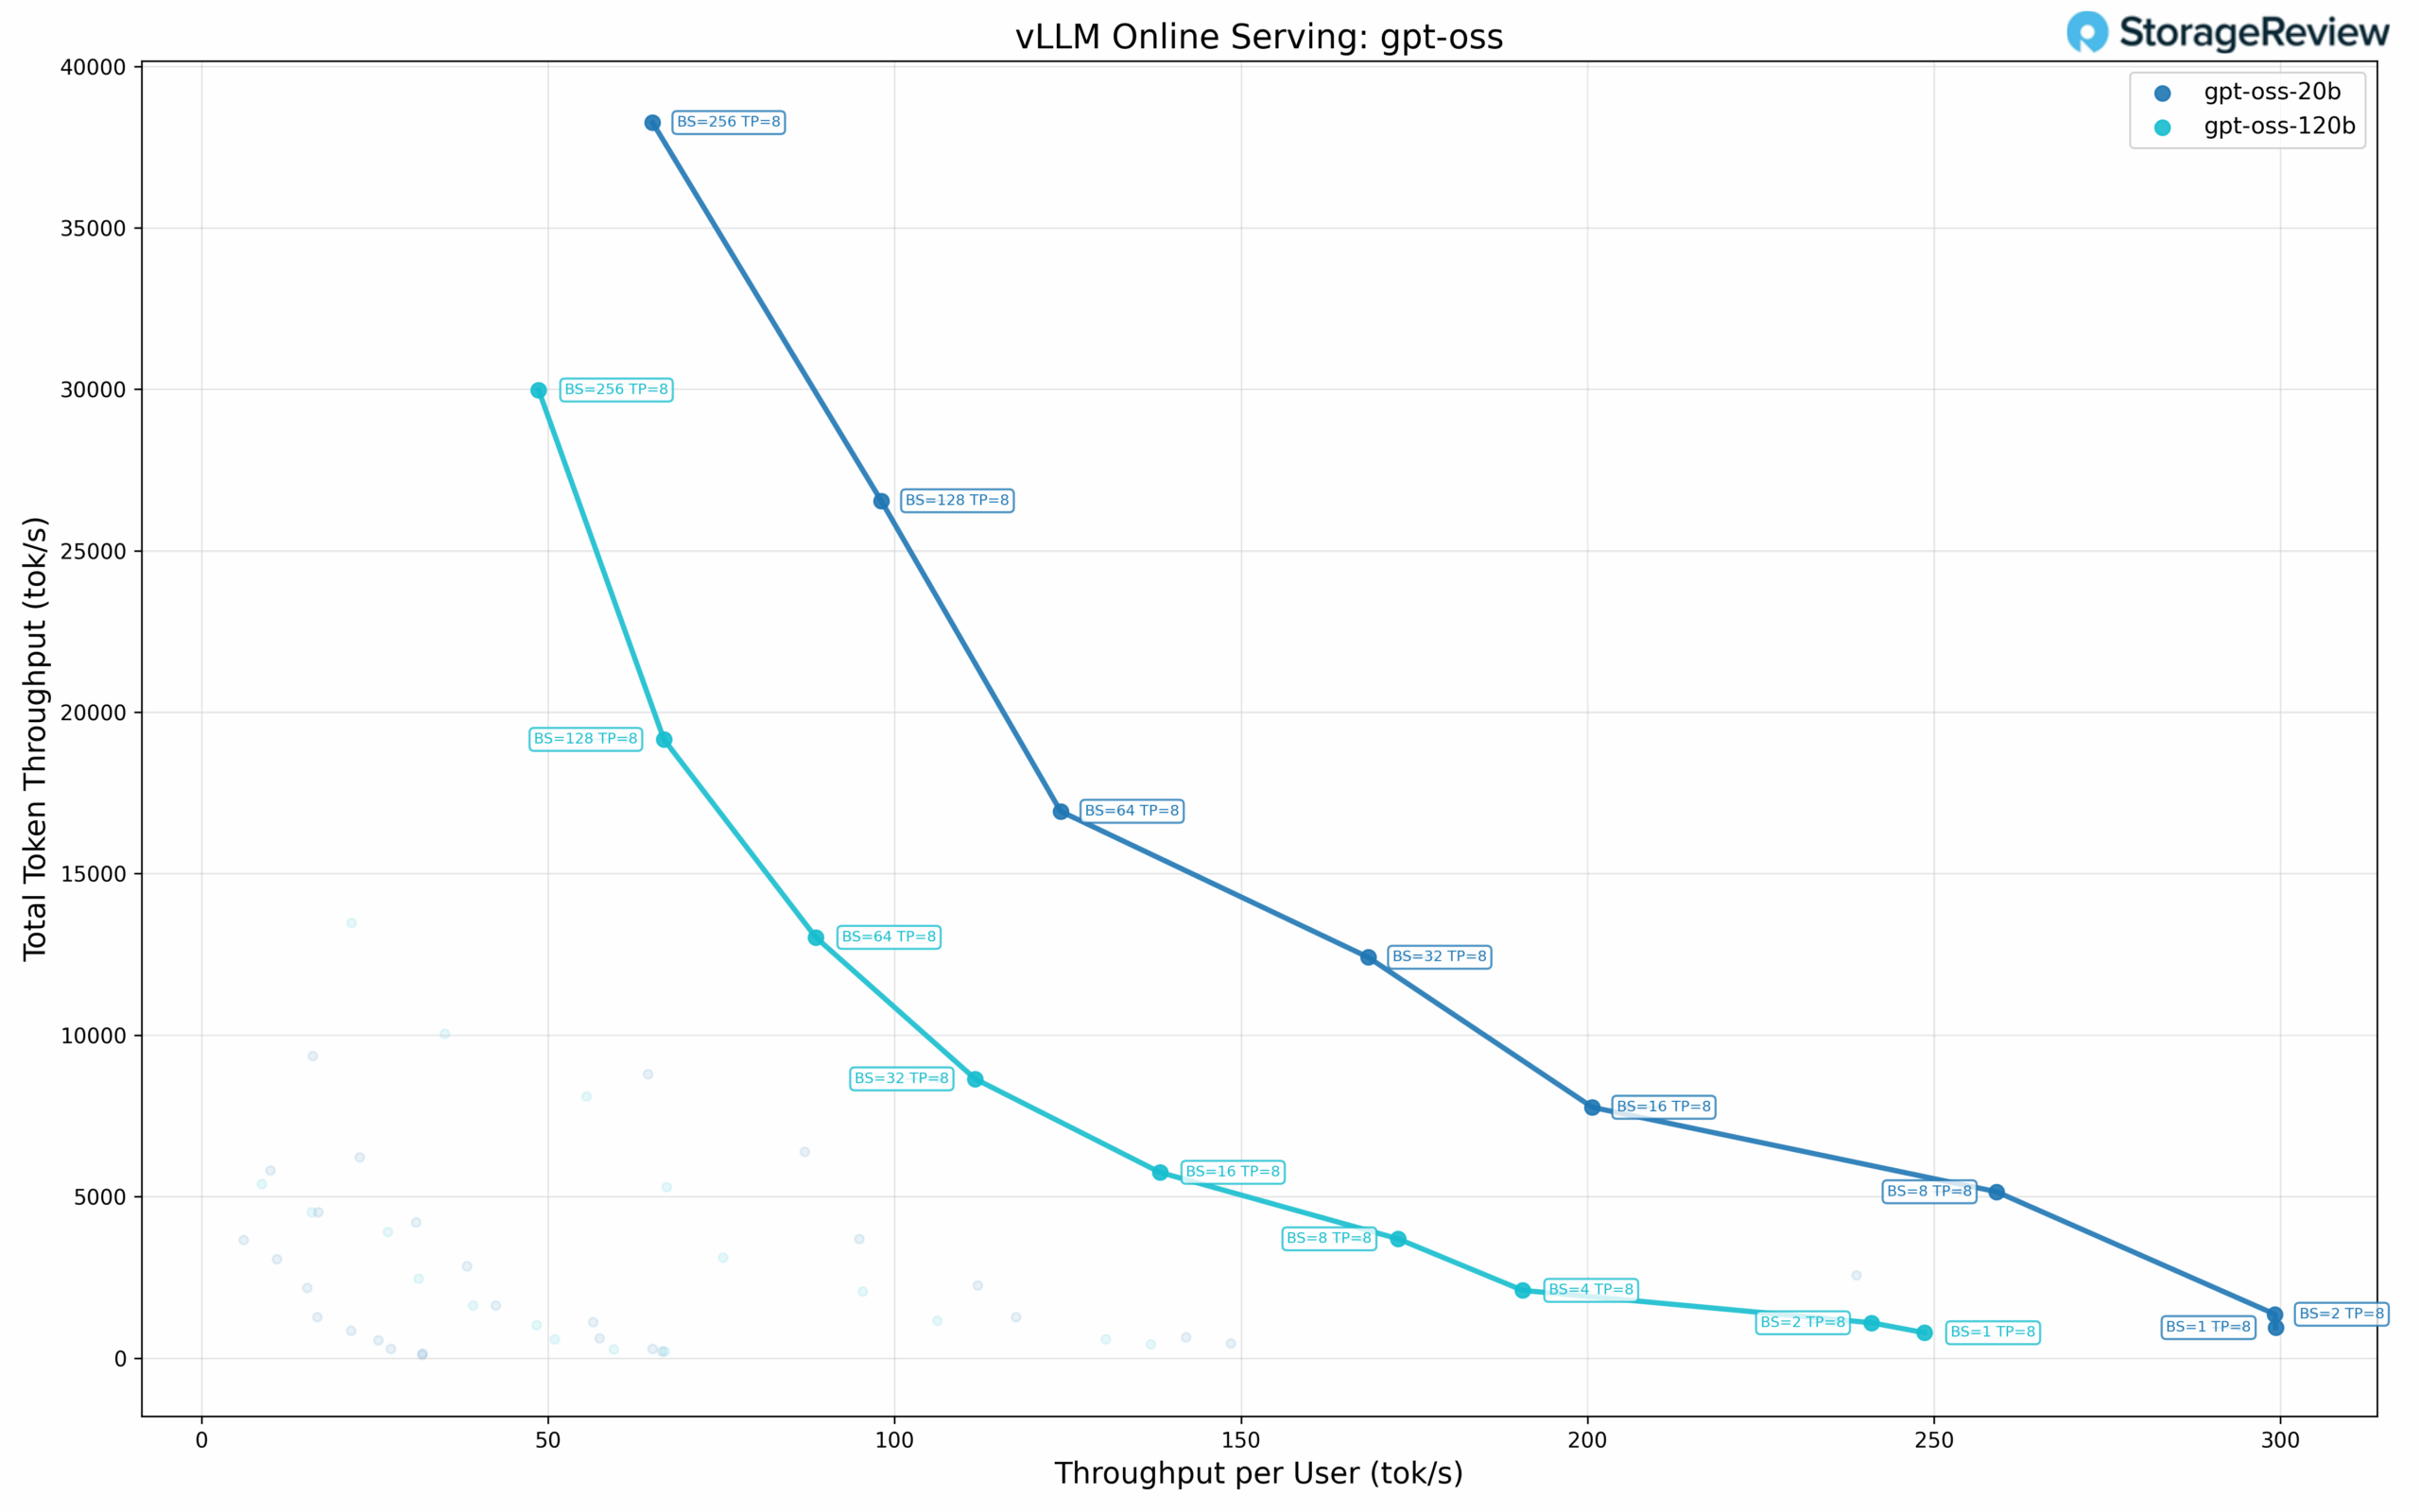
Il modello a parametri 20B raggiunge le seguenti prestazioni per tutte le dimensioni dei batch. Con concorrenza a singolo utente (BS=1), fornisce 299.28 tok/s per utente, 943.43 tok/s di throughput totale e 3.23 ms di TPOT. Con BS=2, il modello mantiene 299.19 tok/s per utente con 1,356.87 tok/s totali e 3.19 ms di TPOT.
Scalabilità a batch di dimensioni maggiori: BS=8 raggiunge 259.02 tok/s per utente con 5,149.59 tok/s totali e 3.42 ms TPOT, mentre BS=16 eroga 200.69 tok/s per utente con 7,765.73 tok/s totali e 3.77 ms TPOT. Il modello continua a scalare attraverso BS=32 (168.34 tok/s per utente, 12,411.72 tok/s totali) e BS=64 (123.96 tok/s per utente, 16,931.47 tok/s totali).
La produttività totale si verifica a BS=256, raggiungendo un totale di 38,258.50 tok/s con 65.08 tok/s per utente e 9.39 ms di TPOT. Ciò rappresenta un aumento di 40.5 volte della produttività totale rispetto alle prestazioni di un singolo utente. I valori di TPOT rimangono nell'intervallo 3-5 ms fino a BS=32. La frontiera di Pareto include otto punti distinti.
Prestazioni GPT-OSS-120B
Il modello con parametri più grandi, pari a 120B, mantiene le seguenti prestazioni nonostante l'aumento del numero di parametri. Con concorrenza a singolo utente (BS=1), raggiunge 248.62 tok/s per utente, 783.73 tok/s di throughput totale e 3.89 ms di TPOT. Con BS=2, il modello fornisce 240.99 tok/s per utente, 1,092.91 tok/s di throughput totale e 3.99 ms di TPOT.
Le prestazioni continuano a crescere con batch di dimensioni maggiori: BS=4 raggiunge 190.63 tok/s per utente con 2,096.73 tok/s totali e 4.22 ms TPOT, mentre BS=8 fornisce 172.66 tok/s per utente con 3,692.10 tok/s totali e 4.54 ms TPOT. L'aumento della velocità di trasmissione attraverso BS=16 (138.28 tok/s per utente, 5,751.41 tok/s totali), BS=32 (111.63 tok/s per utente, 8,646.05 tok/s totali) e BS=64 (88.64 tok/s per utente, 13,027.97 tok/s totali) mostra un'espansione costante della produttività.
Il modello raggiunge la sua massima produttività totale a BS=256, erogando 29,976.99 tok/s, con 48.64 tok/s per utente e un TPOT di 12.53 ms. Ciò rappresenta un aumento di 38.2 volte della produttività totale rispetto alle prestazioni di un singolo utente. La produttività totale massima è pari a circa il 78% del picco del modello a 20B. La frontiera di Pareto include nove punti distinti, il numero maggiore tra tutti i modelli testati.
Prestazioni inaspettate del modello quantizzato
I risultati del modello quantizzato sono stati inaspettati e meritano ulteriori approfondimenti. In diversi casi, le versioni quantizzate NVFP4 e FP8 dei modelli non hanno ottenuto i miglioramenti prestazionali attesi rispetto alle loro controparti a precisione nativa. Ad esempio, il modello Llama 3.1 8B FP4 ha raggiunto solo 830.46 tok/s di throughput totale a BS=1, rispetto ai 1,727.62 tok/s della variante a precisione standard, nonostante un throughput per utente simile. A batch di dimensioni maggiori, mentre i modelli quantizzati si sono avvicinati al throughput a precisione standard (29.2-29.3 K tok/s contro 32.8 K tok/s a BS=256), i risultati complessivi suggeriscono che l'attuale implementazione di vLLM potrebbe non essere completamente ottimizzata per Blackwell.
Abbiamo intenzione di condurre ulteriori test su vLLM e di confrontarlo con TensorRT-LLM per vedere quali prestazioni possono aspettarsi oggi gli utenti finali.
Supermicro JumpStart cambia le regole del gioco AI PoC
Il programma JumpStart di Supermicro mantiene ciò che promette: accesso reale e illimitato a hardware di livello produttivo, senza la logistica, i ritardi di spedizione o le spese di laboratorio di un PoC tradizionale. La nostra settimana JumpStart sulla piattaforma X14 HGX B200 è iniziata rapidamente, si è svolta senza intoppi e ci ha permesso di valutare le prestazioni allo stesso modo in cui avremmo valutato le apparecchiature nei nostri rack.
Per le organizzazioni che prendono decisioni rapide sull'infrastruttura di intelligenza artificiale, questo tipo di accesso alla piattaforma può comprimere settimane di pianificazione in pochi giorni. Se l'obiettivo è convalidare la produttività della GPU, il comportamento dello storage, le prestazioni del modello o semplicemente confermare la compatibilità dello stack, JumpStart fornisce risposte con il minimo sforzo. È un approccio alla valutazione dell'hardware basato sulla fiducia e vorremmo che più fornitori lo adottassero.



 Amazon