

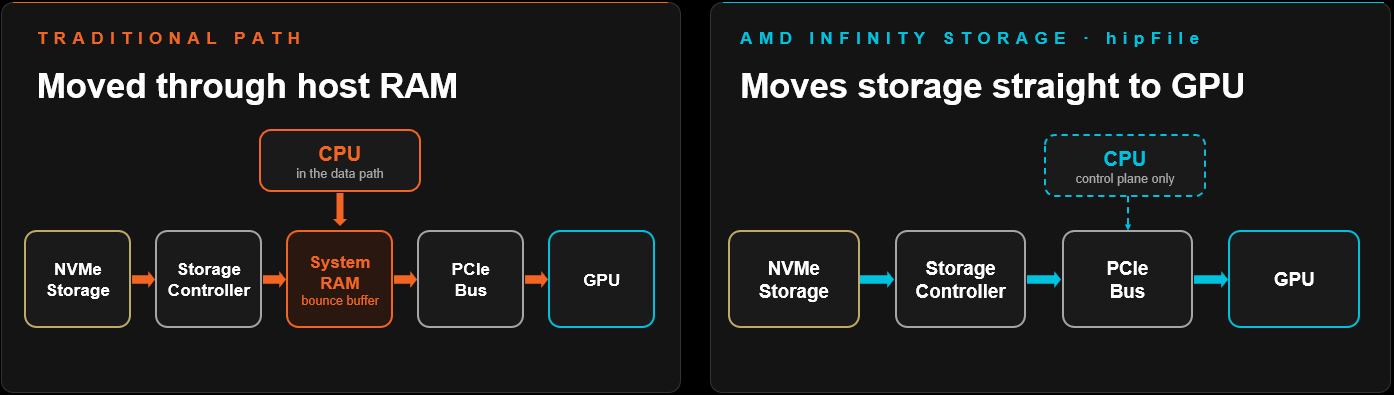
10월 5일에 출시된 AMD ROCm 10.1은 스토리지와 GPU 간의 경로에 중점을 두었습니다. 체크포인트 파일, 키-값 캐시, 모델 가중치는 이제 가속기 메모리 용량을 초과하는 경우가 빈번해지며, 이러한 경우 데이터 이동에 소요되는 시간이 연산 시간보다 반복 시간에 더 큰 영향을 미치게 됩니다. 이번 릴리스에서는 ROCm 7.14에 도입된 직접 스토리지 스택인 AMD Infinity Storage를 확장하여 스토리지 액세스를 HIP 런타임에 통합하고 NUMA를 지원하는 호스트 메모리를 추가함으로써 데이터가 CPU 메모리를 거치지 않고 바로 GPU에 도달하도록 했습니다.
GPU 직접 스토리지 파이프라인 및 NUMA 인식 메모리
AMD Infinity Storage의 hipFILE 라이브러리에 비동기 고속 경로 백엔드가 추가되었습니다. 읽기 및 쓰기 요청은 HIP 스트림에서 직접 실행되므로 기존 방식에서 필요한 호스트 메모리 스테이징 단계를 건너뛸 수 있습니다. AMD는 이를 통해 체크포인트 엔진 및 KV 캐시 오프로드의 지연 시간을 줄이면서도 지속적인 대역폭을 유지할 수 있다고 밝혔습니다. 릴리스 노트에는 hipFileReadAsync() 및 hipFileWriteAsync() 함수가 이제 고속 경로를 지원한다고 명시되어 있습니다.
배치 I/O API는 여러 파일 요청을 한 번에 제출하고 이를 내부 작업자 스레드 풀에 분산시켜 대규모 데이터 세트를 가져오는 학습 작업 시 스토리지 큐를 항상 가득 채웁니다. 원격 측정 데이터도 함께 확장됩니다. hipFileGetStatsL1, L2, L3는 점진적으로 더 자세한 I/O 통계를 반환하며, 이러한 카운터는 ROCm 프로파일러에 제공되어 운영자가 파이프라인이 컴퓨팅, 메모리 또는 데이터 전송에 의해 제한되는지 여부를 파악할 수 있도록 합니다.
듀얼 소켓 호스트에서 잘못된 소켓에 할당된 버퍼는 모든 전송 시 소켓 간 페널티를 발생시킵니다. ROCm 10.1은 hipMemLocationTypeHostNuma 및 hipMemLocationTypeHostNumaCurrent를 통해 HIP 가상 메모리 관리 API를 확장하여 호스트 메모리를 생성, 예약, 매핑 및 해제 과정 전반에 걸쳐 특정 NUMA 노드에 배치할 수 있도록 합니다. RCCL과 같은 라이브러리는 이를 기반으로 NUMA 로컬 제로 카피 통신 버퍼를 구축하여 호스트-장치 간 트래픽이 소켓 인터커넥트를 거치지 않도록 할 수 있습니다.
ROCm CLI v1.0.0 및 AI 에이전트 워크플로
ROCm CLI가 Linux, Windows 및 WSL2용 단일 바이너리로 v1.0.0에 도달했습니다. 이 버전은 AMD GPU에서 로컬 AI 워크로드를 설치, 구성 및 실행합니다. vLLM에 필요한 flash-attn 및 amd-aiter 휠을 자동으로 감지하고, 업데이트된 ROCm 10 패키지 레이아웃을 지원하며, 스크립트 또는 CI 환경에서 완전 비대화형 설치를 위한 플래그를 추가했습니다. 전체 화면 TUI 대시보드는 모델 서빙과 함께 실시간 GPU 원격 측정 데이터를 표시하고, 엔드포인트 응답 여부를 확인할 수 있는 로컬 채팅 창을 제공합니다.
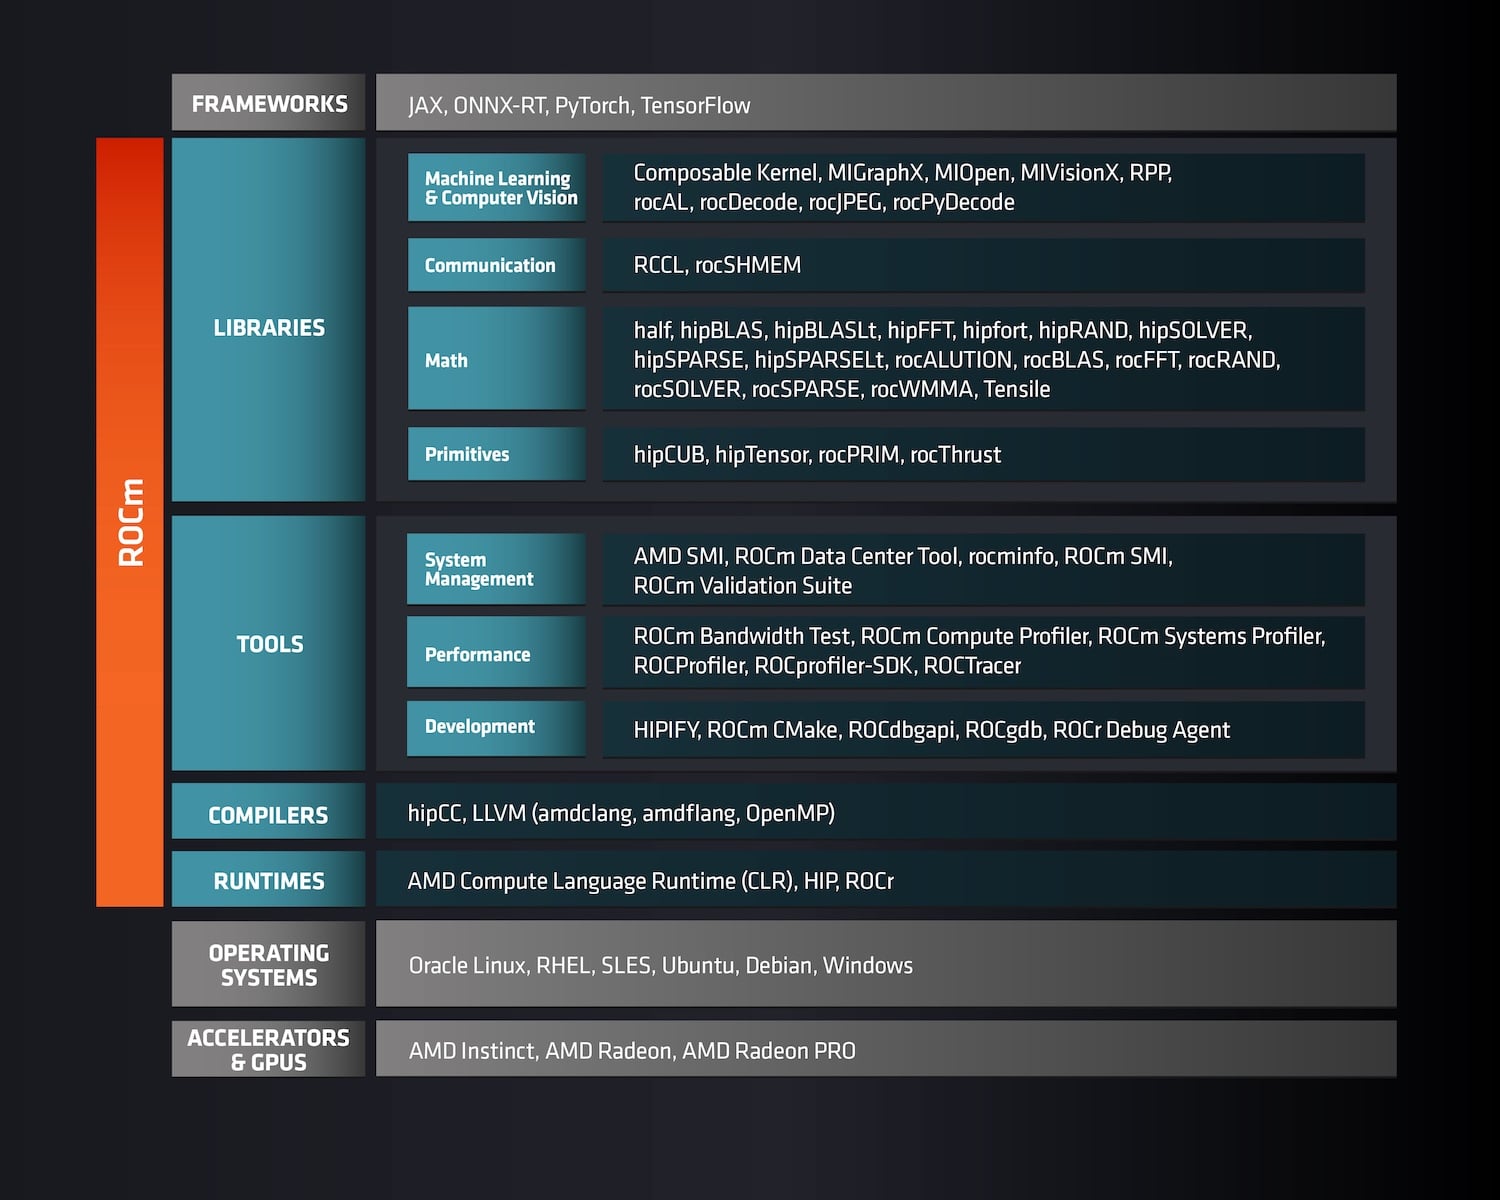
Claude Code 및 Codex와 같은 코딩 에이전트용 패키지 통합 도구인 AMD Skills에 두 가지가 추가되었습니다. quark-install은 AMD Quark를 해당 PyTorch 빌드와 함께 설정하고, quark-torch-llm-ptq는 FP8 및 INT4와 같은 방식을 사용하여 PyTorch 및 Hugging Face LLM에 대한 학습 후 양자화를 실행합니다.
프로파일링 및 원격 측정 현대화
ROCprofiler-SDK에 커널 리플레이 기능이 베타 버전으로 추가되었습니다. GPU 하드웨어는 디스패치당 제한된 수의 성능 카운터만 제공하기 때문에, 이전에는 전체 카운터 세트를 수집하려면 카운터 그룹별로 애플리케이션 전체를 다시 실행해야 했습니다. 커널 리플레이 기능은 각 디스패치를 제자리에서 다시 실행하고, 패스 사이에 GPU 메모리를 재설정하여 한 번의 실행으로 전체 카운터 세트를 수집합니다. 또한, 이 SDK는 PyTorch Kineto 및 Triton Proton에서 실행 중 어느 지점에서든 프로파일링을 시작하고 중지할 수 있도록 지원하며, 코딩 도우미가 rocprofv3 PC 샘플링을 통해 컴퓨팅 스톨을 찾을 수 있도록 하는 PC 샘플링 에이전트 스킬을 제공합니다.
ROCm Compute Profiler의 루프라인 보고서가 이제 대화형 HTML 페이지로 제공되므로 엔지니어는 단일 커널을 분리하고 캐시 레벨 간에 연산 강도 축을 전환할 수 있습니다. PC 샘플링 보고서는 커널별로 제공되며, 개별 명령어에 대한 샘플 수와 스톨 횟수까지 자세히 분석할 수 있습니다. 또한 vLLM 프로파일링에 대한 새로운 가이드가 추가되었습니다. ROCm Systems Profiler는 Gorgon Point 1, 2, 3 APU(gfx1150, gfx1152, gfx1153)에 대한 Linux 트레이싱 기능을 추가했으며, ROCm Optiq는 이제 rocprofv3 프로파일을 Systems Profiler 트레이스 및 Compute Profiler 분석 결과와 함께 시각화합니다.
AMD SMI(amd-smi)는 이번 릴리스에서 표준 빌드에서 제거된 ROCm SMI를 대체합니다. AMD SMI는 Linux 및 Windows 환경에서 베어메탈 및 가상화된 환경 모두에서 AMD GPU, CPU 및 APU를 지원하며, CLI, C 라이브러리(amd_smi_lib), Python, Go 및 Rust 바인딩을 제공합니다. 컨테이너 인식 기능은 containerd, CRI-O, Podman, LXC 및 LXD는 물론 Kubernetes Pod까지 확장되어 클러스터 관리자가 GPU 프로세스 및 사용률을 해당 컨테이너와 연결할 수 있습니다.
핵심 컴파일러 업데이트, 라이브러리 및 런타임 지원
툴체인이 LLVM 23에서 LLVM 24로 업그레이드되었으며, clang_major 매크로도 이제 24를 보고합니다. 컴파일러 버전을 고정하거나 libLLVM에 링크하는 사용자는 업그레이드 전에 이 부분을 확인해야 합니다. 증분 빌드는 디바이스 코드 링크 시간 최적화로 생성된 파티션을 캐싱하여 속도가 향상되었으며, 변경되지 않은 파티션은 다음 빌드에서 재사용됩니다.
컴포저블 커널(Composable Kernel)은 Radeon GPU에서 어텐션 처리 속도를 향상시키고 디스패처에 더 많은 양자화된 행렬 곱셈 유형을 추가합니다. MIGraphX는 백엔드 컴파일러를 rocMLIR에서 rocMLIRTriton으로 변경했는데, AMD는 이를 통해 추론 성능이 향상되고 모델 컴파일 시간이 단축되는 경우가 많으며 컴파일러가 상위 Triton과 동기화된 상태를 유지한다고 밝혔습니다. rocSPARSE는 ELLPACK(ELL) 형식으로 저장된 행렬에 대해 변환 단계 없이 직접 삼각 함수 해법을 실행합니다.
ROCm Core SDK 스레딩 라이브러리에 새롭게 추가된 hipThreads는 표준 C++ 스레딩 개념을 Linux 및 Windows 환경의 AMD GPU에서 사용할 수 있도록 지원합니다. hipThreads의 목적은 CPU 스레드로 작성된 기존 코드를 HIP 커널 및 동기화 기본 요소로 완전히 재작성하지 않고도 GPU에서 가속화하는 것입니다.
Windows Subsystem for Linux 2(WSL2)가 기술 미리보기 버전으로 출시되었습니다. 표준 Linux 패키지는 게스트 운영 체제에 설치되며, GPU 반가상화 기능은 Windows 호스트 드라이버에서 처리합니다. 이번 미리보기에서는 .deb 패키지와 Python wheel 파일은 지원되지만 RPM 패키지는 지원되지 않으며, 프로파일링, 디버깅, KFD 관련 도구는 아직 WSL2에서 작동하지 않습니다. 가상화 측면에서는 Ubuntu 26.04 LTS에서 호스트와 게스트 모두 KVM SR-IOV를 지원하며, AMD의 GIM 가상화 드라이버 버전 9.3.0.K와 함께 사용할 수 있습니다.
지원되는 하드웨어 목록에는 Instinct MI355X, MI350X 및 MI350P, MI300 및 MI200 시리즈, 나머지 Radeon AI PRO R9700 제품군, 그리고 Ryzen AI 프로세서와 함께 Radeon AI PRO R9600이 추가되었습니다.


 아마존