

DDN은 ISC 2026에서 AI 및 HPC 데이터 플랫폼 포트폴리오의 대폭 확장을 발표하며, GPU 활용도 향상, AI 추론 속도 향상, 대규모 AI 인프라 구축 간소화를 위해 설계된 새로운 하드웨어, 소프트웨어 및 플랫폼 기능을 소개했습니다.
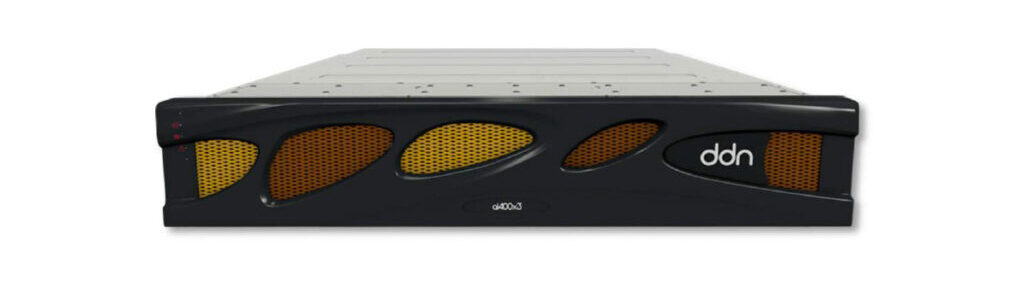
이번 발표에는 AI400X3M 스토리지 어플라이언스, NVIDIA Dynamo 와 통합된 DDN의 분산형 KV 캐시 가속 기술의 정식 출시, 그리고 회사의 AI 데이터 플랫폼 전반에 걸친 새로운 보안, 관찰 가능성 및 인프라 관리 기능이 포함됩니다.
DDN은 이번 업데이트가 데이터 준비, 모델 학습, 추론, 검색 증강 생성(RAG), 추론 모델 및 에이전트 기반 AI 워크로드를 포함한 AI 데이터 파이프라인 전반의 병목 현상을 해결하기 위한 것이라고 밝혔습니다. 회사는 GPU 활용률을 높이는 동시에 전력 소비와 인프라 비용을 절감하여 인프라 효율성을 개선하는 데 집중하고 있습니다.
DDN의 CEO 겸 공동 창립자인 알렉스 부자리는 최신 AI 인프라는 컴퓨팅 리소스만으로는 부족하다고 강조했습니다. 그는 효율적인 데이터 관리, 보안 및 운영 가시성이 실제 AI 환경 구축에 필수적인 요소가 되었다고 언급하며, DDN의 최신 제품들은 GPU 효율성 향상, 추론 비용 절감, 그리고 최초 토큰 생성 시간 단축에 초점을 맞추고 있다고 밝혔습니다.
AI400X3M은 AI 및 HPC 성능 밀도 향상을 목표로 합니다.
이번 발표의 핵심은 DDN의 EXAScaler 병렬 파일 시스템을 기반으로 구축된 최신 어플라이언스인 AI400X3M입니다.
AI400X3M 사양
| 성능 | |
| 순차 읽기 성능 | 최대 190GB/s |
| 순차적 쓰기 성능 | 최대 110GB/s |
| 무작위 읽기 IOPS | 8M |
| 시스템 특징 | |
| 플랫폼 | 액티브/액티브 스토리지 컨트롤러를 갖춘 AI용 EXAScaler 공유 병렬 파일 시스템 어플라이언스(완전 솔루션) |
| 어플라이언스별 호스트 포트 | 4개의 XDR/400GbE OSFP 또는 8x NDR200/200GbE QSFP112 |
| 드라이브 지원 | 24개의 2.5인치 듀얼 포트, 핫스왑 가능 PCIe G5 NVMe 슬롯 |
| 용량 옵션 | 120/250/500TB 및 1PB/2PB 사용 가능 용량 |
| 표준 펌웨어 기능 | LUN 매핑 및 마스킹, 지능형 쓰기 스트라이핑, 읽기 QoS, 데이터 무결성 검사/수정, 인터페이스 옵션(CLI, GUI, Python API), RELP 지원을 포함한 아웃바운드 시스템 로그, 상태 변경 메시지(이메일 및 SNMP 트랩을 통해) |
| 안전 및 규정 준수 | |
| 안전 | IEC/EN/UL/CSA 62368-1, GB4943 |
| EMC | EN 55032 클래스 A, EN 55035, EN 61000-3-2, EN 61000-3-3, FCC 파트 15 클래스 A, VCCI 클래스 A, ICES-003 클래스 A, GB/T9254 클래스 A, BSMI 클래스 A |
| 환경 | RoHS, REACH, WEEE, ERP Lot9X |
| 물리적 속성 | |
| 폼 팩터 | 2U 랙 마운트 |
| 크기 | 높이 : 3.43 "(87mm) 폭 : 17.56 "(446mm) 깊이: 베젤 제외 856mm(33.7인치), 전체 길이 895mm(35.2인치) 조절식 랙 레일: 26.75인치~34.0인치(680~860mm) |
| 중량(평량) | 빈 상태 무게 44kg (98파운드), 최대 적재량 49kg (108파운드) |
| 전력 및 냉각 | |
| 입력 전압 | 200~240V 50/60Hz |
| 전원 공급 장치 | 핫스왑 가능, 이중화, IEC60320-C20 입력 포트 2개 |
| 운영 환경 | |
| 온도 범위 | 5는 C 30 ° C (° F를 41하는 86 ° F)를 행 ° |
| 상대 습도 | 8 % –80 % 비 응축 |
| 고도 | 3,117피트(950m) @ 30°C — 10,000피트(3,048m) @ 23°C |
이 플랫폼은 최대 190GB/s의 처리량과 이전 세대 대비 최대 35% 향상된 읽기 성능을 제공합니다. DDN은 또한 단일 랙 내에서 최대 30PB까지 확장 가능한 구성을 지원하며, 플래시와 HDD 스토리지를 결합하여 성능, 용량 및 비용의 균형을 맞추는 하이브리드 디스크를 지원합니다.
이 장치는 AI 모델 학습, 추론, 체크포인트, HPC 시뮬레이션 및 스토리지 처리량이 GPU 활용도에 직접적인 영향을 미칠 수 있는 기타 고도로 병렬화된 워크로드를 위해 설계되었습니다. 2026년 3분기 말까지 일반 출시될 예정입니다.
분산형 KV 캐시가 이제 정식 출시되었습니다.
NVIDIA GTC 2026에서 기술 미리보기를 선보인 후, DDN은 NVIDIA Dynamo를 통합한 분산형 KV 캐시 가속 아키텍처를 공식 출시했습니다. 이 기능은 Infinia 객체 스토리지 플랫폼과 EXAScaler 파일 시스템 모두에서 사용할 수 있습니다.
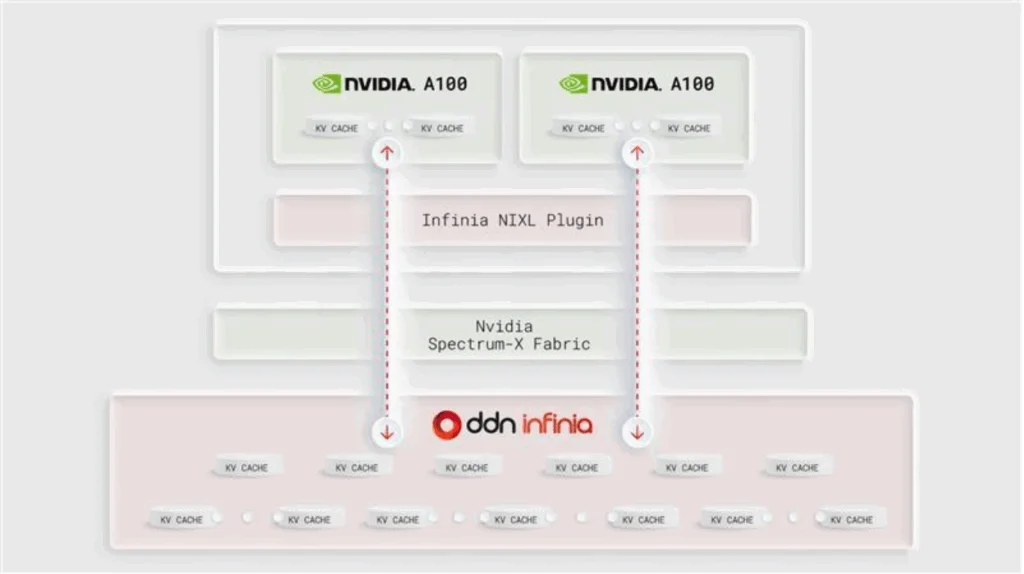
분산 아키텍처는 모델 컨텍스트를 위해 로컬 GPU 메모리에 의존하는 대신 DDN의 데이터 플랫폼에서 KV 캐시 데이터를 저장하고 검색하여 추론 중 메모리 병목 현상을 줄입니다.
DDN은 자사 플랫폼이 NVIDIA Dynamo, vLLM 및 기타 최신 추론 프레임워크를 지원하는 동시에 여러 추론 노드에서 공유 분산 KV 캐시를 사용할 수 있도록 한다고 밝혔습니다. 이 회사는 대규모 추론 워크로드에서 KV 캐시 로딩 속도가 최대 55배 빨라지고, GPU 활용률 향상, 토큰 생성 속도 증가, 대규모 언어 모델 배포를 위한 인프라 비용 절감 등의 이점을 제공한다고 주장합니다.
이 기술은 대규모 모델 컨텍스트에 반복적으로 접근하는 장기 컨텍스트 추론, 검색 증강 생성, 추론 모델 및 에이전트 기반 AI 워크플로에 도움이 되도록 설계되었습니다.
통합 AI 데이터 파이프라인
DDN은 또한 추론을 위한 Infinia 객체 스토리지와 모델 학습 및 체크포인트를 위한 EXAScaler를 단일 AI 데이터 인프라에 통합하는 보다 광범위한 전략을 설명했습니다.
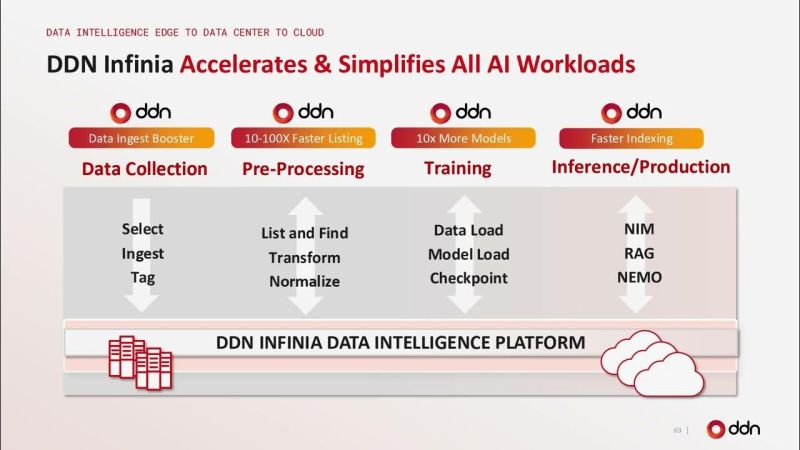
회사 측은 Infinia가 낮은 지연 시간의 메타데이터 작업, 높은 동시성, 그리고 추론 집약적인 워크로드에 최적화된 객체 성능을 제공하며, EXAScaler는 고성능 학습 환경을 지속적으로 지원한다고 밝혔습니다. 두 플랫폼은 함께 데이터 사일로를 제거하고 AI 수명 주기 전반에 걸쳐 높은 GPU 활용률을 유지하는 것을 목표로 합니다.
새로운 보안 및 인프라 기능
추가 플랫폼 개선 사항은 베어메탈 멀티테넌시, KMIP 기반 암호화 및 키 관리, 운영 가시성을 위한 VictoriaLogs 통합, 확장된 멀티테넌트 API를 포함하여 엔터프라이즈 배포 요구 사항에 중점을 둡니다.

스토리지 측면에서 DDN은 지능형 파일 고정(file pinning) 및 NAND 가속 핫 풀(Hot Pool) 기능을 도입하여 자주 액세스하는 데이터는 플래시에 유지하고 사용 빈도가 낮은 데이터는 비용이 저렴한 하드 드라이브로 자동 분산 저장할 수 있도록 했습니다. 회사 측은 이러한 기능이 스토리지 효율성을 향상시키고 플래시 용량 요구 사항을 줄이도록 설계되었다고 밝혔습니다.
클라우드 AI의 지속적인 확장
DDN은 또한 Google Cloud와 함께 발표한 Managed Lustre 개발 및 EXAScaler 기반의 Google Cloud Managed Luster를 사용하는 Salesforce 배포 사례를 포함하여 자사의 클라우드 AI 인프라 제품의 지속적인 도입을 강조했습니다.
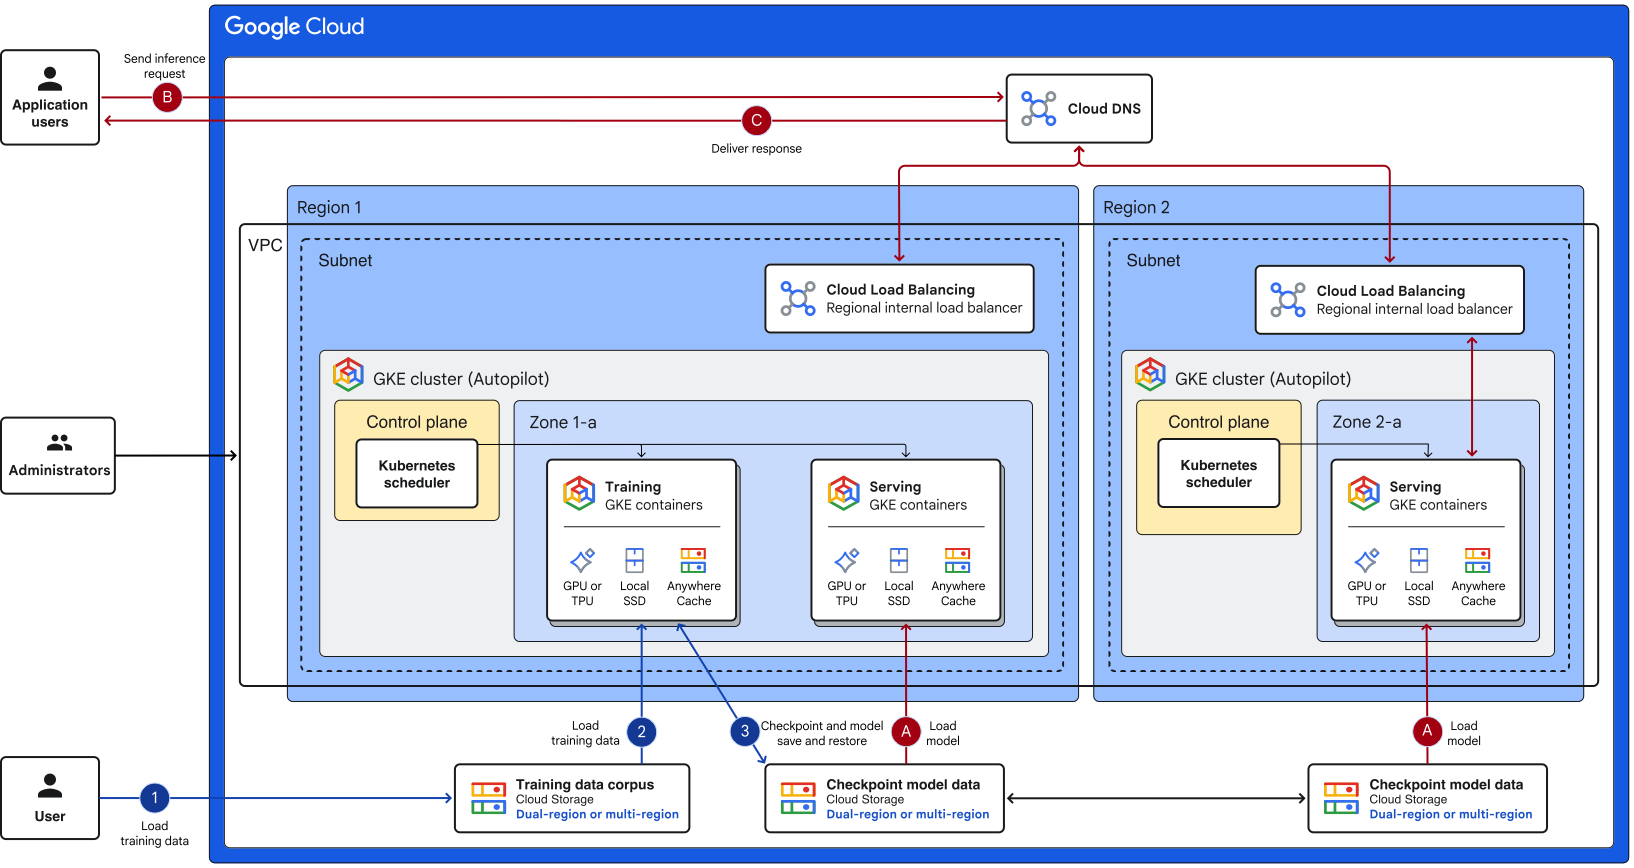
DDN에 따르면 Salesforce 구현을 통해 모델 학습 속도가 1.5배 빨라지고, I/O 지연 시간이 75% 감소했으며, 학습 비용이 42% 절감되어 대규모 AI 환경에서 스토리지 병목 현상을 줄이는 것이 얼마나 효과적인지 입증했습니다.
DDN은 최근 발표를 통해 병렬 스토리지를 넘어 AI 데이터 오케스트레이션, 추론 가속 및 인프라 관리까지 포트폴리오를 확장하고 있으며, 이를 통해 기업, 클라우드, 연구 및 국가 차원의 AI 배포 환경에서 대규모 GPU를 활용할 수 있도록 플랫폼을 강화하고 있습니다.


 아마존