

구글은 8세대 TPU 라인업에 두 가지 시스템을 추가했습니다. 하나는 TPU 8t 실리콘 기반의 기밀 컴퓨팅 시스템인 TPU 8tx이고, 다른 하나는 장기 컨텍스트 추론을 위해 하나의 패키지에 두 개의 TPU 8i 칩을 탑재한 TPU 8i Max입니다. 이 두 시스템은 구글이 지난 4월 클라우드 넥스트에서 선보인 TPU 8t 학습 칩과 TPU 8i 추론 칩 에 더해지며 , 구글은 한 해에 네 가지 TPU 시스템을 출시한 것은 이번이 처음이라고 밝혔습니다.
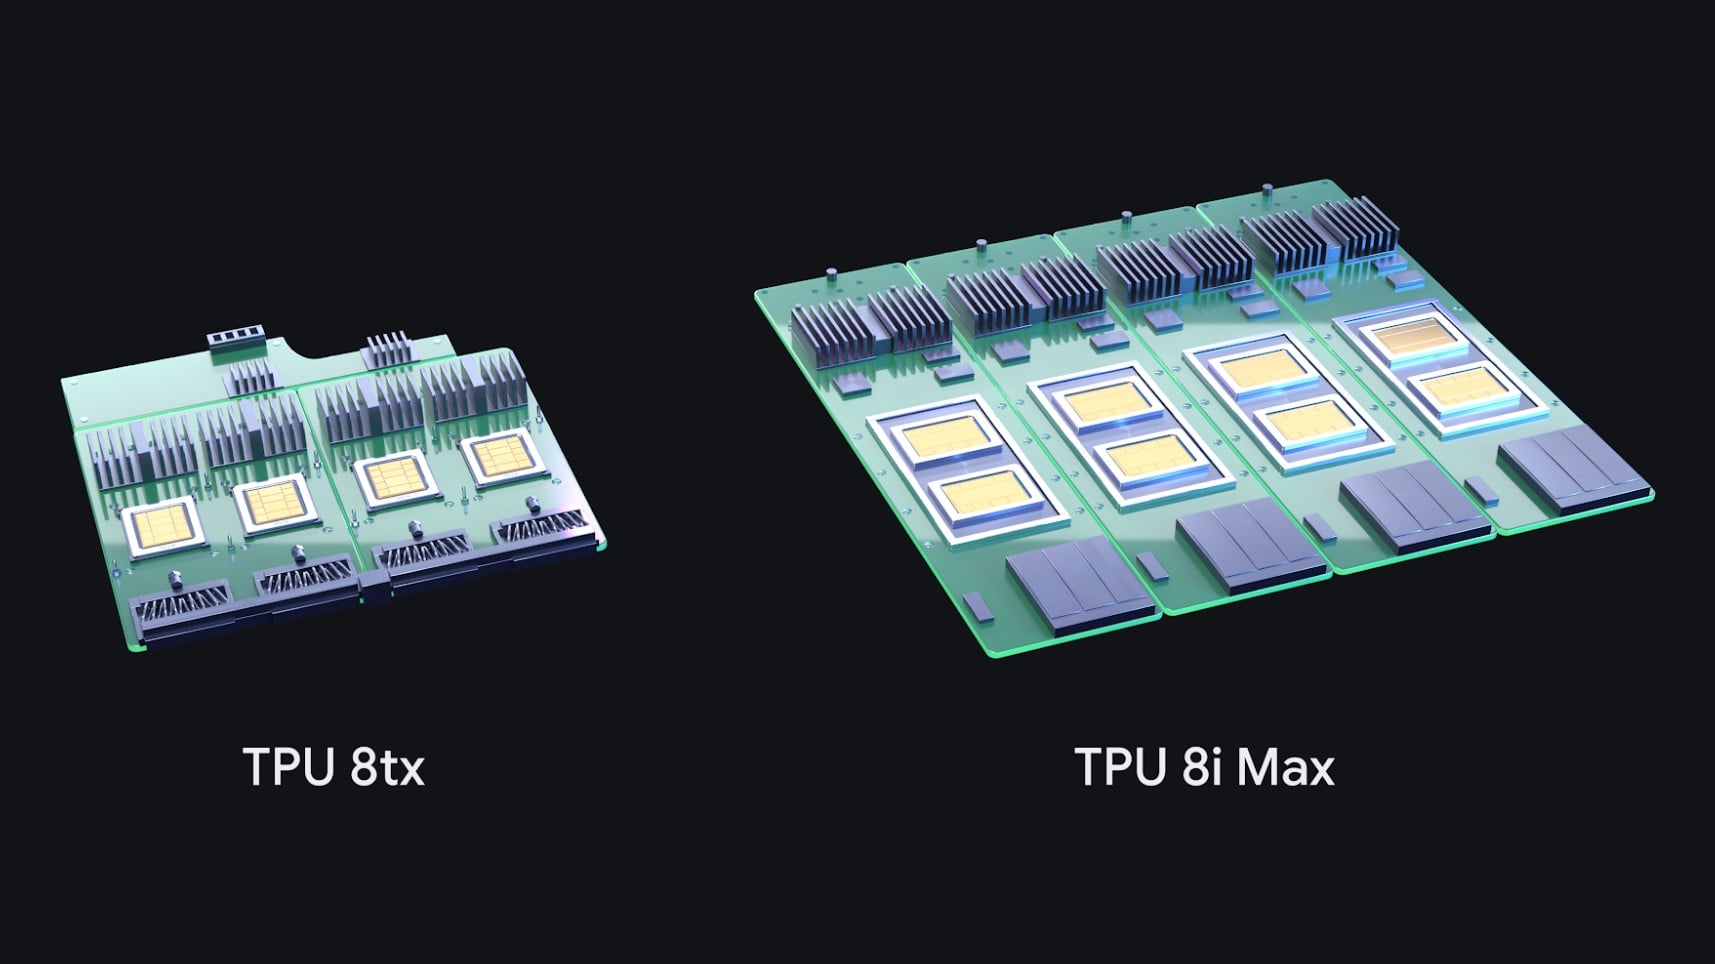
구글은 이번에 추가된 두 제품을 기존 칩을 기반으로 구축된 새로운 시스템으로 설명하며, 패키징, 고속 메모리, 네트워킹 및 보안을 실리콘 주변에서 변경하여 워크로드에 맞게 조정한다고 밝혔습니다. 또한 이러한 모듈식 접근 방식을 통해 몇 달 안에 특수 구성을 제공할 수 있다고 강조했습니다. 구글에 따르면 TPU는 현재 첨단 연구소, 거래 회사, 소매업체, 대학 등 약 100개 고객사를 확보했으며, 일부 고객사는 이제 데이터 센터에 TPU를 직접 배포할 수 있습니다.
TPU 8tx: TPU 8t 실리콘 기반의 기밀 컴퓨팅
TPU 8tx는 TPU 8t와 동일한 실리콘을 사용하고 5세대 AMD EPYC 호스트 CPU와 결합하며, 하드웨어에 기밀 컴퓨팅 기능을 내장하여 사용 중 데이터와 모델 가중치를 보호하고 격리합니다. 구글은 PCIe 링크 암호화, 암호화 증명, 보안 메모리 인클레이브 등을 보안 기능으로 명시하고 있으며, 민감한 데이터와 함께 최첨단 또는 독점 모델 및 에이전트를 운영하는 규제 대상 기업 및 정부 기관을 대상으로 합니다.

TPU 8tx는 구글이 TPU 8i를 위해 개발한 저지연 Boardfly 네트워크를 채택했습니다. 구글에 따르면 이 네트워크는 TPU 8t보다 최대 2배 낮은 지연 시간을 제공하면서도 성능 저하는 거의 없습니다. 구글은 TPU 8tx를 안전한 추론 및 소규모 학습에 적합하게 설계하여, 팀이 비공개 데이터를 사용하여 모델을 미세 조정하고, 대규모 모델을 소규모 모델로 축소하고, 민감한 데이터를 여러 클러스터 간에 이동하지 않고도 강화 학습을 통해 에이전트를 학습할 수 있도록 합니다.
TPU 8i Max: 패키지당 2개의 추론 칩
TPU 8i Max는 수십 개의 에이전트가 전체 코드베이스에서 작동하거나 수 시간 분량의 비디오를 재생하는 것과 같은 워크로드에 필요한 메모리 대역폭을 목표로 설계되었습니다. 구글은 하나의 패키지에 두 개의 TPU 8i 칩을 결합하여 TPU 8i 대비 컴퓨팅 성능, 온칩 SRAM 및 HBM 대역폭을 두 배로 늘렸습니다. 구글은 TPU 8i 출시 당시 SRAM 용량을 384MB로 명시했으므로, 두 배가 된 8i Max 패키지당 SRAM 용량은 768MB가 됩니다. HBM 용량은 아직 공개되지 않았습니다. 구글은 8i Max가 기존 랙 공간에 두 배의 실리콘을 탑재할 수 있기 때문에 단위 면적당, 단위 전력 소비량당 더 높은 컴퓨팅 성능을 제공한다고 밝혔습니다.

구글은 이제 8세대 시스템을 에이전트 작업 단계에 따라 네 가지로 분류합니다. TPU 8t는 확장형 학습, TPU 8i는 저지연 추론, TPU 8tx는 기밀 컴퓨팅, 그리고 TPU 8i Max는 대규모 컨텍스트 윈도우와 랙당 최고 수준의 컴퓨팅 밀도를 제공합니다. 구글은 TPU 8tx와 TPU 8i Max의 구글 클라우드 고객 출시 시점이나 가격 정보는 아직 공개하지 않았습니다.

TPU 동기화, 클라우드 경로 및 GKE 동적 슬라이싱
구글은 칩의 HBM, 호스트의 DRAM, 공유 스토리지, 데이터 센터 네트워크를 단일 메모리 계층 구조로 처리하는 C++ 라이브러리인 TPU Sync를 오픈 소스로 공개했습니다. TPU Sync는 키-값 캐시를 칩에서 분리하여 계층화하고, 프리필 노드에서 디코딩 노드로 컨텍스트를 스트리밍하며, 트레이너에서 샘플러로 강화 학습 가중치를 동기화합니다. 구글에 따르면 TPU Sync는 키-값 전송 지연 시간을 90% 이상 줄이고, 235억~480억 개의 파라미터를 가진 개방형 가중치 혼합 모델에서 첫 번째 토큰 생성 시간을 평균 90% 단축합니다.
Gemini의 기반이 되는 Google DeepMind 런타임인 Cloud Pathways가 이제 Google Kubernetes Engine에서 정식으로 제공됩니다. Cloud Pathways는 단일 컨트롤러를 사용하여 사전 학습, 강화 학습 및 멀티 호스트 추론을 위해 여러 슬라이스에 걸쳐 TPU 시스템을 오케스트레이션하고, 1분 미만의 슬라이스 핫 스와핑 및 탄력적인 리샤딩을 통해 하드웨어 장애 발생 시에도 장시간 실행되는 작업을 계속 지원합니다.
GKE 동적 슬라이싱(GKE dynamic slicing)은 광 회로 스위칭을 사용하여 TPU 큐브를 더 큰 토폴로지로 조립하거나 노드 풀을 다시 생성하지 않고 더 작고 격리된 워크로드로 분할합니다. 구글은 이 기술이 작업 시작 시간을 최대 5배 단축하고 오류 복구 속도를 최대 4.5배 향상시킨다고 밝혔습니다. 미리 보기로 제공되는 TPU 에이전트 제품군은 Claude Code, Cursor, Google Antigravity와 같은 코딩 도구에 통합되어 워크로드를 온보딩하고, 병목 현상을 진단하고, 커널을 자동 튜닝합니다. 또한 새로운 오픈 소스 XLA Serving Engine은 C++ 런타임에서 Python으로 학습된 모델을 TPU, GPU 및 CPU 전반에 걸쳐 제공합니다.



 아마존