

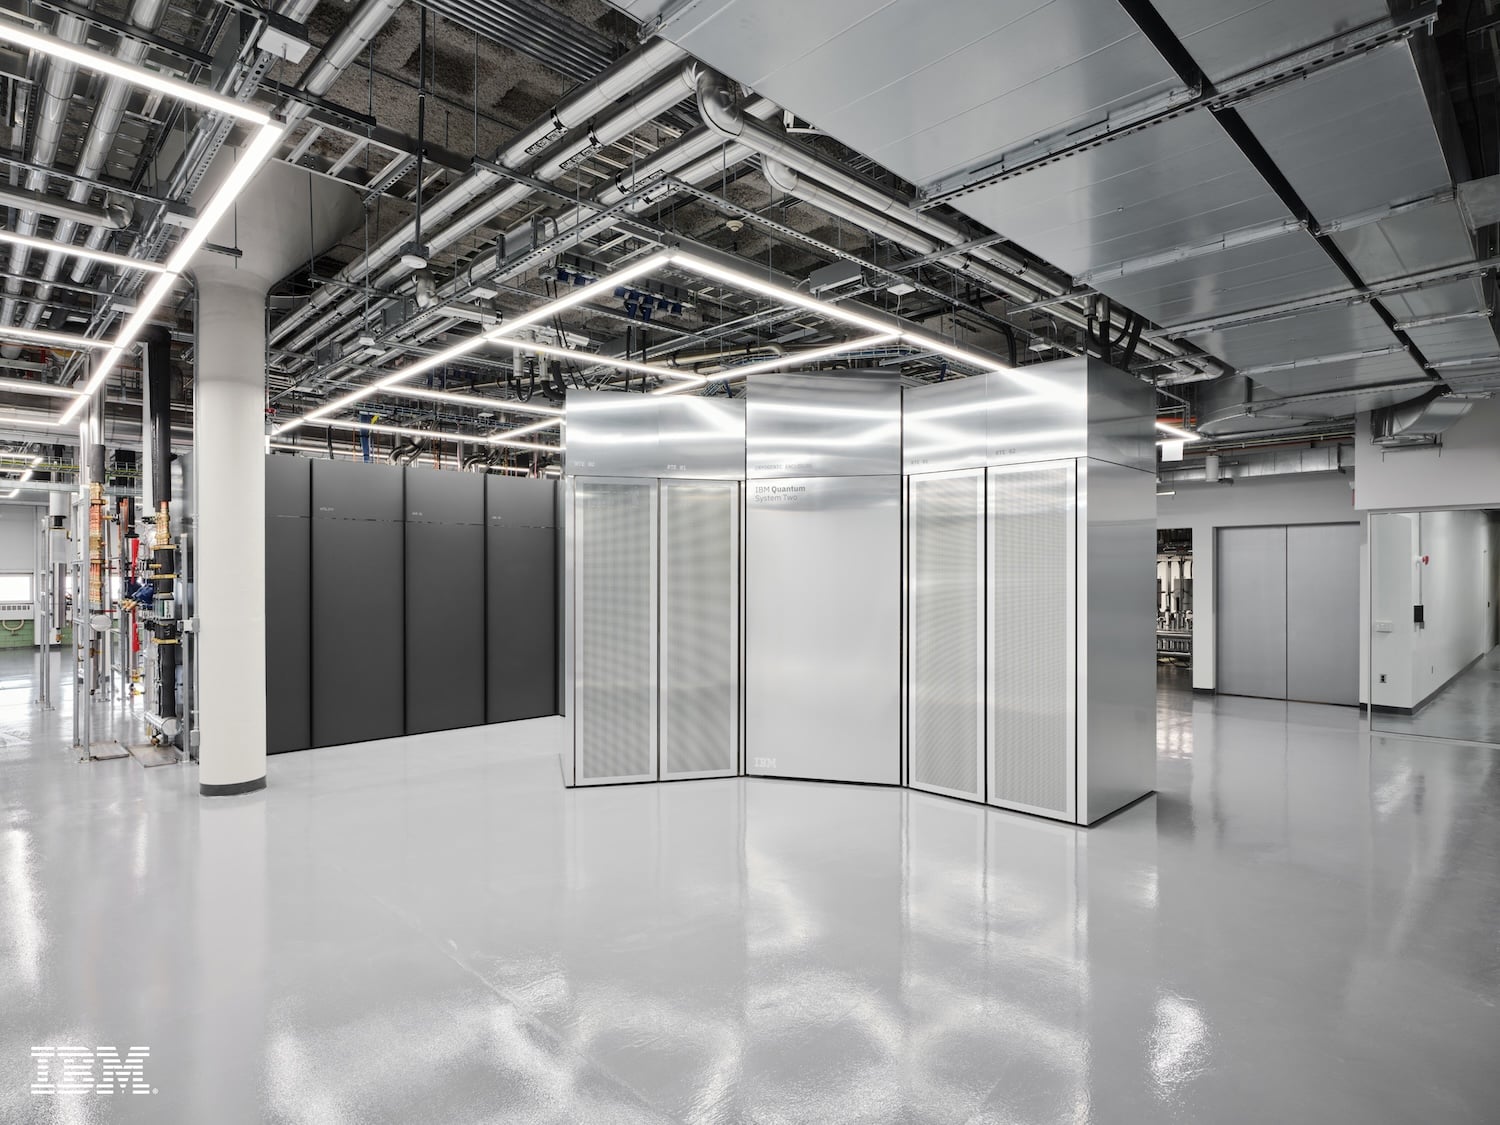
IBM, AMD, 그리고 미국 에너지부 산하 오크리지 국립연구소(ORNL)의 양자과학센터는 오늘 양자 및 고전 하드웨어를 동일 시설에 두고 구축한 양자 오류 수정 공동 설계 플랫폼을 공개했습니다. 뉴욕주 포킵시에 위치한 IBM 양자 연구소에는 120큐비트 IBM 퀀텀 나이트호크 프로세서를 비롯한 IBM 양자 컴퓨터들이 AMD 인스팅트 MI355X GPU와 5세대 AMD EPYC CPU를 기반으로 구축된 ORNL의 고성능 컴퓨팅 시스템인 움브라(Umbra)와 함께 설치되어 있습니다. AMD 하드웨어는 디코딩, 최적화, 소프트웨어 오케스트레이션 등 연구의 고전적 측면을 담당합니다.
양자 오류 수정을 위한 고전 컴퓨팅
오류 정정 코드는 양자 정보를 여러 물리적 큐비트에 분산시키고 문제 발생 징후를 반복적으로 검사합니다. 일반 컴퓨터는 각 검사 결과를 읽고 어떤 큐비트에 오류가 발생했는지 파악하는데, IBM에서는 이 작업을 디코딩이라고 부릅니다. 디코더는 양자 프로세서의 처리 속도를 따라잡아야 합니다. 오늘날 양자 컴퓨터와 고성능 컴퓨팅(HPC) 클러스터는 같은 시설에 있는 경우가 드물기 때문에 연구원들은 클라우드를 통해 양자 컴퓨터에 접근하고, 별도의 시스템에서 일반 컴퓨터 작업을 수행하며, 각각의 API를 통해 두 시스템을 연결합니다. 이러한 데이터 전달 과정은 매번 지연을 초래하고 연구팀이 수행할 수 있는 실험의 범위를 제한합니다.
이 플랫폼은 두 부분을 나란히 배치하여 연구원들이 자체적으로 인프라를 구축하지 않고도 플랫폼이 지원하도록 설계된 워크플로우 내에서 실제 양자 하드웨어를 사용하여 오류 수정을 테스트할 수 있도록 합니다. IBM에 따르면 이 연구는 단일 스택 내에서 연결된 코드, 시공간 코드, 알고리즘 인식 디코더, 하드웨어 인식 회로 최적화 및 컴파일, 소프트웨어 오케스트레이션을 포괄합니다.
한 가지 목표는 계층적 오류 정정입니다. 이는 모듈 내의 큐비트를 보호하는 내부 코드를, 내부 코드의 논리 큐비트를 감싸는 외부 코드 아래에 계층적으로 배치하는 방식입니다. IBM 연구에 따르면 이 접근 방식은 각 계층에서 디코딩이 이루어지며, 물리적 오류율이 1,000분의 1일 때 1조 개의 논리 연산을 수행할 수 있다고 합니다.
양자과학센터 소장인 트래비스 험블은 "움브라를 통해 이제 새로운 아이디어를 시험하고, 대규모 접근 방식을 평가하며, 더욱 안정적인 양자 컴퓨터를 위한 기반을 구축할 것입니다."라고 말했습니다.
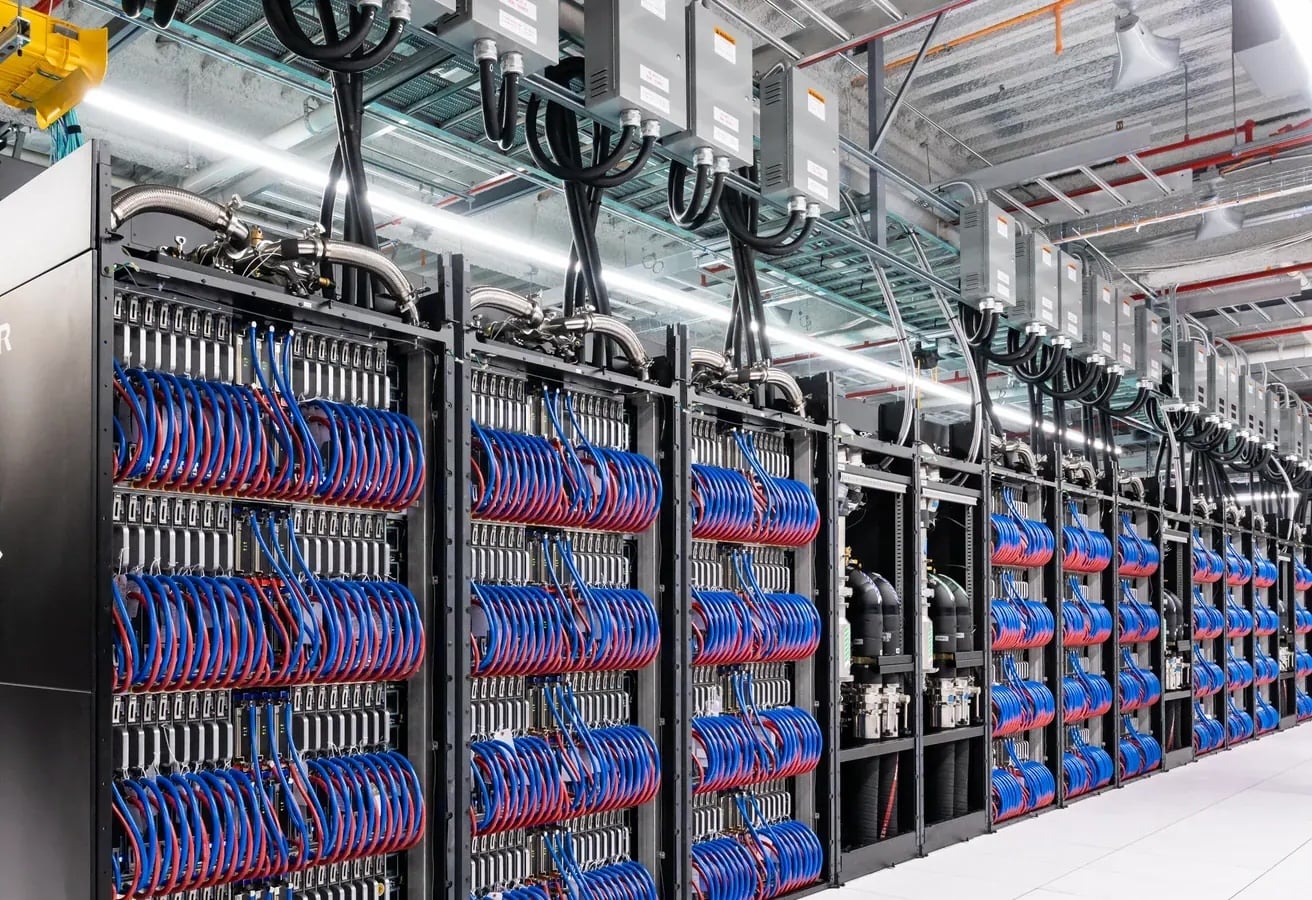
Umbra에 MI355X GPU와 5세대 EPYC CPU가 탑재되었습니다.
양자 컴퓨팅 측면에서 Nighthawk는 연구원들에게 IBM 프로세서 아키텍처 중 최고 수준인 정사각형 격자 연결성, 높은 회로 처리량, 그리고 IBM의 양자 시스템 API를 통한 실시간 펄스 제어 기능을 제공합니다. 연구원들은 회로 중간에 큐비트를 측정하고, 결과를 실시간으로 처리하며, 큐비트를 노이즈로부터 보호하는 신호의 정확한 타이밍을 설정하고, 원시 측정 신호를 직접 다룰 수 있습니다. 이를 통해 연구팀은 각 오류 수정 방법이 사용하는 큐비트, 시간, 샘플 및 기존 자원의 비용을 비교하고 GPU 가속이 가장 효과적인 부분을 찾아낼 수 있습니다.
기존 양자 컴퓨팅 측면에서 MI355X 가속기는 연구원들이 대규모로 디코더를 학습하고 평가할 수 있도록 지원하며, EPYC CPU는 오케스트레이션을 담당합니다. 이러한 코로케이션을 통해 디코딩 및 조건부 실행(양자 프로그램이 계산 중간에 측정한 값을 기반으로 다음 연산을 선택하는 방식)의 지연 시간을 최소화할 수 있습니다. IBM과 AMD는 이번 배포에 대한 노드 수, GPU 또는 CPU 수량, 디코딩 지연 시간, 벤치마크 결과 등을 공개하지 않았습니다. AMD는 하이브리드 양자 전략 의 일환으로 저지연 제어 및 판독을 위한 적응형 SoC와 FPGA, 그리고 양자 가속기 오케스트레이션을 위한 ROCm을 별도로 설명했지만 , 이번 발표에서 이러한 기술들이 Umbra에 포함될 것이라는 언급은 없었습니다.
이 플랫폼은 세 기관 간의 기존 협력을 확장한 것입니다. IBM과 ORNL은 양자 과학 센터를 통해 이미 협력하고 있으며, IBM 양자 컴퓨터와 프론티어 슈퍼컴퓨터를 활용하여 자기 물질을 시뮬레이션하고 핵융합 연료 후보 물질의 분자 구조를 계산하는 워크로드를 시연했습니다. IBM은 AMD와 협력하여 AMD GPU를 사용하여 샘플 기반 양자 대각화에서 고전적 대각화 단계를 가속화하고 있으며, 두 회사는 AMD 칩에서 양자 오류를 해독하는 알고리즘을 시연했습니다.
ORNL 슈퍼컴퓨팅과의 연결 계획
이 플랫폼은 테네시주 오크리지에 있는 오크리지 리더십 컴퓨팅 시설(Oak Ridge Leadership Computing Facility)과 연결될 예정이며, 오크리지 국립연구소(ORNL)는 AMD 기반 슈퍼컴퓨터인 Lux와의 연결도 설명했습니다. 이를 통해 양자 컴퓨팅 작업은 연구소의 광범위한 AI 및 과학 컴퓨팅 인프라의 일부로 실행될 수 있습니다. IBM과 AMD는 이번 협력을 통해 차세대 AMD 컴퓨팅, 네트워킹 및 오픈 소스 소프트웨어를 양자 컴퓨터와 함께 공동 설계하는 방법을 모색할 것이라고 밝혔습니다. 이러한 연결은 계획된 것이며, 발표에는 플랫폼의 완료일, 외부 접근 일정 또는 일반 출시 시점에 대한 구체적인 내용은 포함되지 않았습니다.
이러한 노력은 미국 에너지부(DOE)의 양자 창세기 임무(Quantum Genesis Mission)와 2028년까지 과학적으로 의미 있는 양자 컴퓨터를 개발하려는 목표와 일맥상통합니다. 이 임무의 Q 경쟁(Q Competition)은 2028년 말까지 100개의 논리 큐비트로 100,000만 번의 고난이도 연산을 수행하는 것을 목표로 하고 있으며, IBM의 현재 실험은 70개의 논리 큐비트와 438번의 고난이도 연산에 도달하여 연산 횟수에서 약 230배의 격차를 보입니다. IBM은 이번 실험을 통해 오류 수정 및 고성능 컴퓨팅(HPC) 워크플로우에 대해 얻은 지식을 2029년까지 출시할 예정인 내결함성 양자 컴퓨터인 IBM 퀀텀 스타링(IBM Quantum Starling) 에 활용할 것이라고 밝혔습니다.
AMD의 수석 부사장 겸 최고 기술 책임자인 마크 파퍼마스터는 "이 공동 설계 플랫폼은 내결함성 양자 컴퓨팅을 현실로 만들기 위해 필요한 확장 가능하고 효율적인 컴퓨팅 인프라를 구축하는 데 중요한 단계입니다."라고 말했습니다.


 아마존