

Supermicro는 오늘 IBM 및 NVIDIA와 협력하여 장기 컨텍스트 추론에 필요한 키-값 상태를 GPU에서 공유 올플래시 계층으로 옮기는 KV 캐시 스토리지 솔루션을 발표했습니다. 이 패키지는 AMD EPYC 9005 프로세서 기반의 Supermicro 페타스케일 스토리지 서버, IBM 스토리지 스케일, NVIDIA 다이나모, NVIDIA 스펙트럼-X 이더넷을 결합한 것으로, IBM이 레드북으로 발표한 검증된 레퍼런스 아키텍처를 기반으로 합니다. 가장 주목할 만한 결과는 컨텍스트를 처음부터 다시 계산하는 GPU를 사용할 경우 130,000만 개의 토큰 프롬프트에서 첫 번째 토큰을 처리하는 데 걸리는 시간이 56배 단축된다는 것입니다.
KV 캐시에 스토리지 계층이 필요한 이유
추론은 두 단계로 진행됩니다. 첫 번째 단계인 사전 채우기(prefill)에서는 프롬프트를 토큰으로 변환하여 모델을 통해 중간 키-값 상태를 생성하고, 두 번째 단계인 디코딩(decode)에서는 이러한 상태를 기반으로 토큰을 하나씩 순차적으로 입력하여 응답을 생성합니다. 키-값 상태를 영구 캐시에 저장함으로써 시스템은 다음 턴, 다음 에이전트 단계 또는 동일한 컨텍스트를 공유하는 다음 요청에 대해 해당 상태를 재사용하고 재계산을 생략할 수 있습니다.
에이전트 기반 워크플로, 코딩 도우미, 장기 컨텍스트 RAG 및 다중 턴 애플리케이션은 GPU 및 CPU 메모리를 빠르게 오버플로시킬 만큼 많은 상태를 생성하므로 Supermicro, IBM 및 NVIDIA가 네트워크 스토리지 계층을 만들고 있습니다.
이 설계에서 NVIDIA Dynamo는 캐시 계층 구조를 관리하고 NIXL을 통해 블록을 이동시키며, IBM Storage Scale Erasure Code Edition은 공유 파일 계층을 제공하고, 페타스케일 서버는 플래시 메모리와 그 뒤에 있는 PCIe Gen5 레인을 제공합니다. Supermicro는 세 회사가 높은 동시 접속 환경과 혼잡한 인접 네트워크 트래픽이 있는 클러스터 수준에서 스택을 테스트했으며, 공장 출하 시 랙 통합 및 현장 배포를 통해 구축 시간을 몇 주에서 며칠로 단축하는 턴키 방식으로 이 솔루션을 제공한다고 홍보하고 있습니다.
테스트된 구성
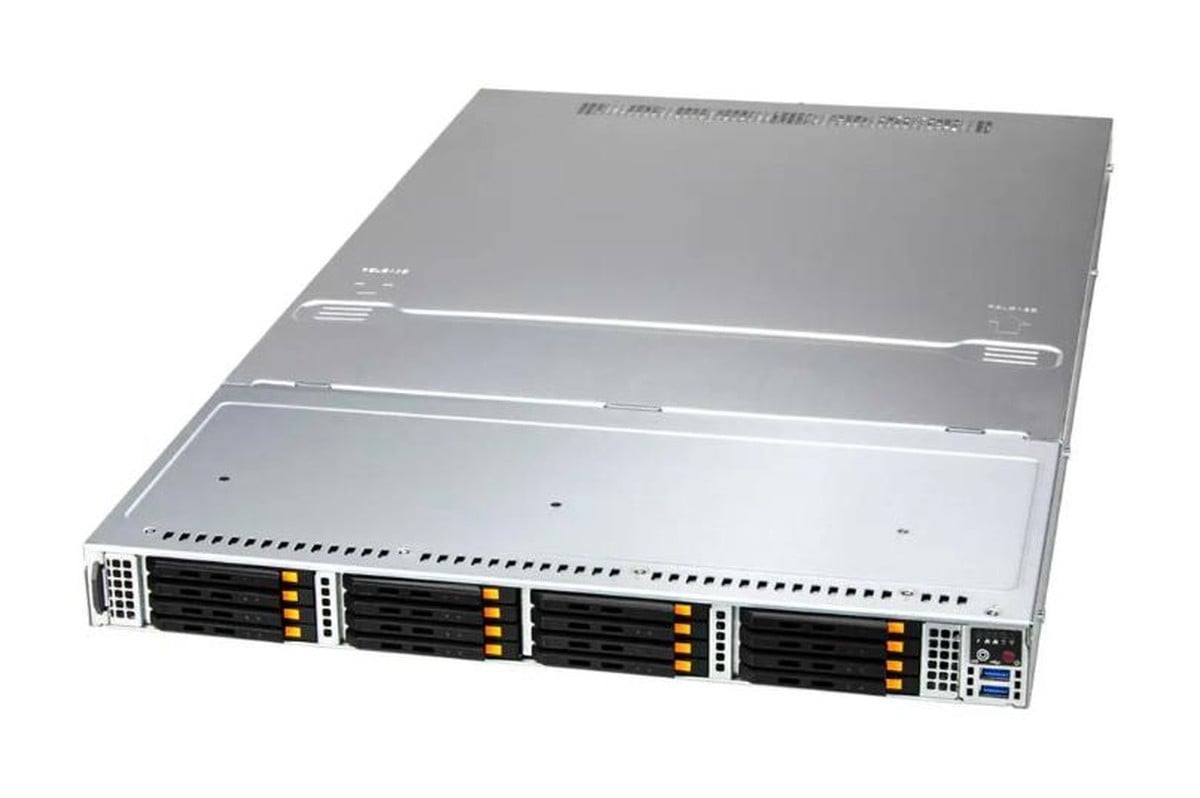
참조 아키텍처는 Supermicro ASG-1115S-NE316R 페타스케일 노드 8개를 사용하며, 각 노드는 AMD EPYC 9535 프로세서 1개와 Micron 7.68TB E3.S NVMe 드라이브 16개를 탑재한 1U 시스템입니다. 이를 통해 각 노드에는 122.88TB의 플래시 메모리가, 8개 노드 전체에는 약 983TB의 저장 용량이 제공됩니다. 각 노드는 클라이언트 측에 듀얼 포트 200Gb NVIDIA BlueField-3 B3220 칩셋을, 스토리지 백엔드에는 400Gb ConnectX-7 칩셋을 탑재하고 있으며, 스파인-리프 구조로 구성된 Spectrum-X SN5600 스위치 3대와 800Gb/s 업링크를 갖추고 있습니다.
스토리지 노드는 8+2P 이레이저 코드 레이아웃으로 RHEL 9.6 및 IBM Storage Scale ECE 6.0.0.1을 실행하며, IBM은 이전 테스트에서 이 8개 노드 계층의 읽기 처리량을 315GB/s로 발표했습니다.
| 구성 요소 | KV 캐시 참조 아키텍처(테스트 결과 기준) |
|---|---|
| 스토리지 계층 | |
| 스토리지 노드 | 8개 Supermicro ASG-1115S-NE316R (1U, 단일 소켓) |
| 노드당 CPU | AMD EPYC 9535, PCIe Gen5 128레인(NVMe용 64레인, 네트워킹용 64레인) |
| 노드별 플래시 | 16개의 마이크론 7.68TB E3.S NVMe (총 122.88TB의 실제 용량) |
| 노드별 네트워크 | NVIDIA BlueField-3 B3220, 듀얼 포트 200Gb(클라이언트 측) NVIDIA ConnectX-7 400Gb(스토리지 백엔드) |
| 스위칭 | NVIDIA Spectrum-X SN5600 3개, 스파인 및 리프 구성, 800Gb/s 업링크 |
| 저장 소프트웨어 | IBM Storage Scale Erasure Code Edition 6.0.0.1, 8+2P RHEL 9.6 |
| 추론 클라이언트 | |
| 시스템 | Supermicro SYS-212GB-FNR (NVIDIA MGX), Ubuntu 24.04 |
| 벤치마크에 사용된 GPU | NVIDIA RTX PRO 6000 Blackwell 1개, 가중치 및 CUDA 그래프 처리 후 KV 캐시에 19.6GiB 여유 공간 있음 |
| 클라이언트 네트워킹 | NVIDIA BlueField-3 B3140H 400Gb/s 칩셋 2개 탑재, 최대 80GB/s 클라이언트 대역폭 제공 |
| 모델 및 소프트웨어 | openai/gpt-oss-120b (MXFP4) vLLM 0.14.1 NVIDIA Dynamo 0.9.0 (NIXL 포함) NVIDIA AIPerf 벤치마크 클라이언트 |
| 캐시 계층화 | 호스트 및 로컬 계층이 0으로 설정되었습니다. 캐시된 140만 개의 토큰은 모두 스토리지 스케일 계층에서 제공됩니다. |
벤치마크 클라이언트는 Supermicro SYS-212GB-FNR MGX 시스템 하나이며, 결과는 해당 시스템에 탑재된 NVIDIA RTX PRO 6000 Blackwell GPU에서 vLLM 0.14.1 및 Dynamo 0.9.0 환경 하에 MXFP4로 인코딩된 openai/gpt-oss-120b 모델을 실행하여 얻은 것입니다.
가중치 및 CUDA 그래프를 처리한 후, KV 캐시를 위해 19.6GiB의 GPU 메모리가 남았으며, 이는 GPU 자체에서 약 1.14만 개의 토큰을 저장하기에 충분합니다. 테스트를 위해 호스트 메모리와 로컬 계층은 0으로 설정하여 모든 캐시된 블록이 Storage Scale에서 반환되도록 했으며, 따라서 결과는 혼합 계층 구조의 도움 없이 스토리지 경로 자체의 성능을 측정합니다.
첫 토큰 획득 시간 56배, 처리량 22배
캐시가 없는 경우, 120B 모델의 첫 번째 토큰 처리 시간(TTFT)은 입력 토큰 10,000개에서 0.572초에서 130,000개에서 32.14초로 증가했는데, 이는 GPU가 전체 컨텍스트를 다시 계산했기 때문입니다. Storage Scale의 KV 캐시를 사용했을 때, TTFT는 동일한 범위에서 0.193초에서 0.57초 사이를 유지했는데, 이는 130,000개 토큰 지점에서 56배 높은 수치이며 Supermicro가 발표에서 언급한 0.377초의 차이와도 일치합니다. IBM, Supermicro 및 NVIDIA에서 이러한 테스트를 수행했으며, 당사는 해당 테스트를 수행하거나 결과를 검토하지 않았습니다.
처리량 테스트는 28개의 동시 연결을 통해 200개의 요청을 전송했으며, 이는 총 24만 개의 토큰과 825GB의 KV 캐시 데이터를 포함하는 100개의 고유 프롬프트에서 추출되었습니다. 캐시는 비어 있는 상태에서 시작되었습니다. 재계산 기준선은 초당 0.19개의 요청을 처리하는 데 1,048초가 걸렸습니다. 스토리지 스케일 계층은 초당 4.26개의 요청을 처리하는 데 46.94초가 걸렸으며, 이는 캐시를 채우는 데 필요한 콜드 스타트 비용을 포함한 수치로 22배 향상된 결과입니다.
세 번째 실행에서는 동일한 패브릭을 통해 서로 관련 없는 네트워크 트래픽 200GB/s를 전송하는 클라이언트 4개를 추가했습니다. 캐시된 구성은 초당 3.6개의 요청을 처리했고 200개의 요청을 처리하는 데 55.56초가 걸렸습니다. 이는 깨끗한 상태에서의 실행보다 약 9초 느리지만 기준치의 18배에 달하는 수치입니다. IBM은 이러한 약간의 성능 저하가 Spectrum-X 패브릭이 캐시 트래픽을 백그라운드 부하와 분리하기 때문이라고 설명합니다.
"에이전트 AI와 장기 컨텍스트 애플리케이션은 여러 단계에 걸쳐 컨텍스트를 효율적으로 재사용하는 데 의존하며, NVIDIA Dynamo는 분산 추론을 오케스트레이션하여 기업이 모든 GPU에서 더 많은 유효 처리량을 얻을 수 있도록 지원합니다."라고 NVIDIA AI 추론 제품 책임자인 슈루티 코파르카르(Shruti Koparkar)는 말했습니다. "이 KV 캐시 솔루션은 NVIDIA Dynamo와 Spectrum-X 이더넷을 Supermicro 페타스케일 스토리지 서버 및 IBM Storage Scale과 결합하여 고성능 공유 스토리지 계층을 구축함으로써 중복 연산을 줄이고 최초 토큰 획득 시간을 단축하며 고객이 탄력적인 AI 추론 서비스를 확장할 수 있도록 지원합니다."
사이즈와 숫자에 담겨 있지 않은 것들
IBM의 사이징 가이드에 따르면 4노드 구성은 7B~34B 모델과 최대 64개의 GPU에 대해 67%의 가용 용량을 제공하며, 테스트를 거친 8노드 구성은 70B~120B 모델과 100~256개의 GPU(읽기 대역폭 100~300GB/s 필요)에 대해 80%의 가용 용량을 제공합니다. 16개 이상의 노드는 더 큰 모델과 300개 이상의 GPU(읽기 대역폭 300GB/s 이상 필요)에 대해 16+3P의 가용 용량을 제공하며 84%의 가용 용량을 제공합니다. Storage Scale ECE 자체는 3개의 스토리지 서버부터 최대 256개까지 확장 가능합니다.
주요한 한계점은 단일 GPU 테스트 설정입니다. 레퍼런스 아키텍처는 수백 개의 GPU를 지원하도록 설계되었지만, 논문에 제시된 모든 결과는 IBM이 315GB/s로 평가한 8노드, 983TB 플래시 스토리지 계층에서 RTX PRO 6000 하나만을 사용하여 얻은 것이므로 스토리지 용량은 포화 상태에 훨씬 못 미쳤습니다. 또한 이 테스트는 전체 GPU 클러스터가 동시에 캐시를 사용할 때 TTFT가 어떻게 유지되는지를 보여주지 않습니다.
Supermicro는 패키지 솔루션의 가격이나 출시일을 공개하지 않았으며, 발표 내용에도 GPU 사용률 수치는 포함되지 않았습니다. 이 접근 방식은 DDN의 AI400X3M에 탑재된 Dynamo 통합 KV 캐시 가속 과 유사한 영역이지만 , 차이점은 이 스택이 일반 Supermicro 서버와 이더넷을 기반으로 IBM 파일 시스템에서 실행된다는 점입니다.
슈퍼마이크로의 사장 겸 CEO인 찰스 리앙은 “AI 워크로드가 학습에서 추론으로 확장됨에 따라, 에이전트형 AI와 장기 컨텍스트, 다중 턴 생성형 AI의 특징인 높은 처리량의 추론 워크로드를 배포하는 기업과 네오클라우드 환경은 GPU 효율성을 향상시키기 위해 병목 현상을 제거해야 합니다.”라고 말했습니다. “IBM 및 NVIDIA와의 협업을 통해 개발된 당사의 솔루션은 이러한 성능 향상 효과를 명확하게 보여줍니다.”



 아마존