

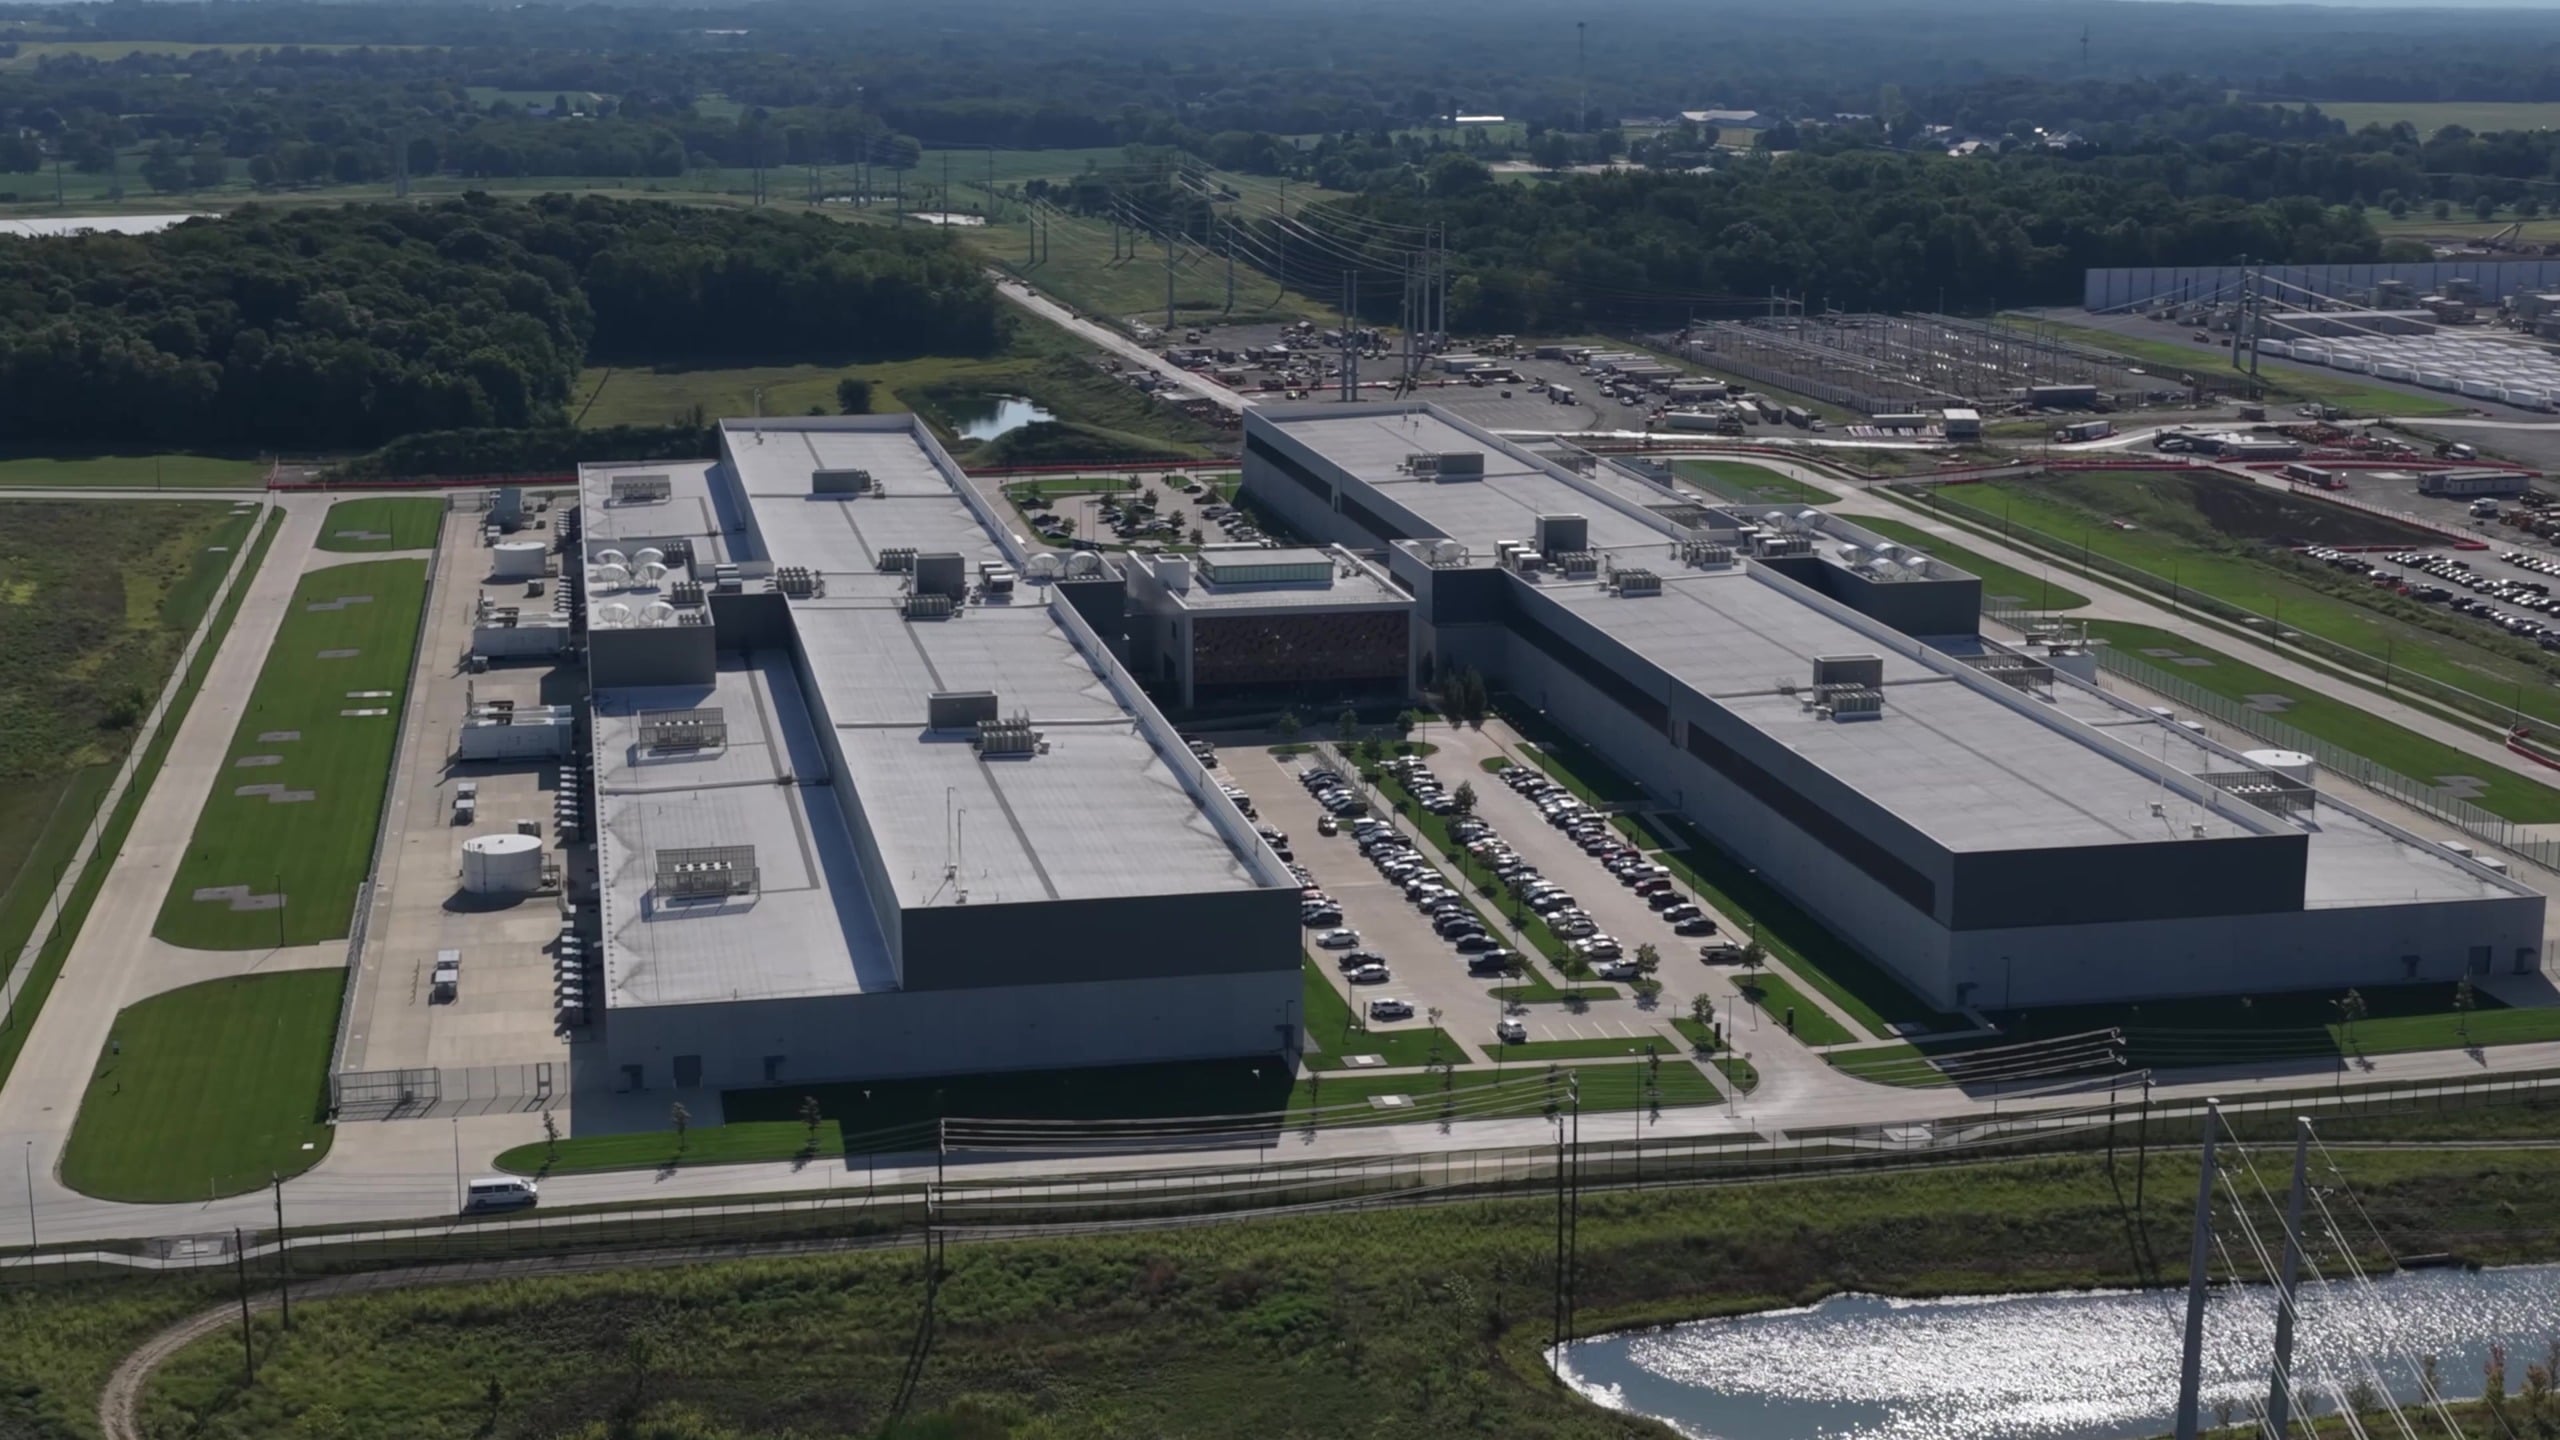
Meta는 오늘 오하이오주 뉴올버니에 구축 중인 기가와트급 AI 슈퍼클러스터인 프로메테우스(Prometheus)에 대한 자세한 내용을 공개했습니다. 1단계는 완료되었으며, Muse Wonder 모델을 포함한 Muse 기반 모델 제품군 학습이 진행되었습니다. Meta는 현재 이 슈퍼클러스터가 약 100만 개의 GPU를 사용하는 규모로 확장되고 있다고 밝혔습니다. 2년 전만 해도 이 부지는 웹 트래픽을 처리하는 일반 데이터 센터였습니다. Meta 엔지니어인 케빈 리, 야샤르 바야니, 아흐메드 샤리프, 이지운 송이 작성한 이번 게시물은 하드웨어, 네트워크, 그리고 학습 작업이 원활하게 진행되도록 하는 안정성 확보 작업에 대해 자세히 다룹니다.
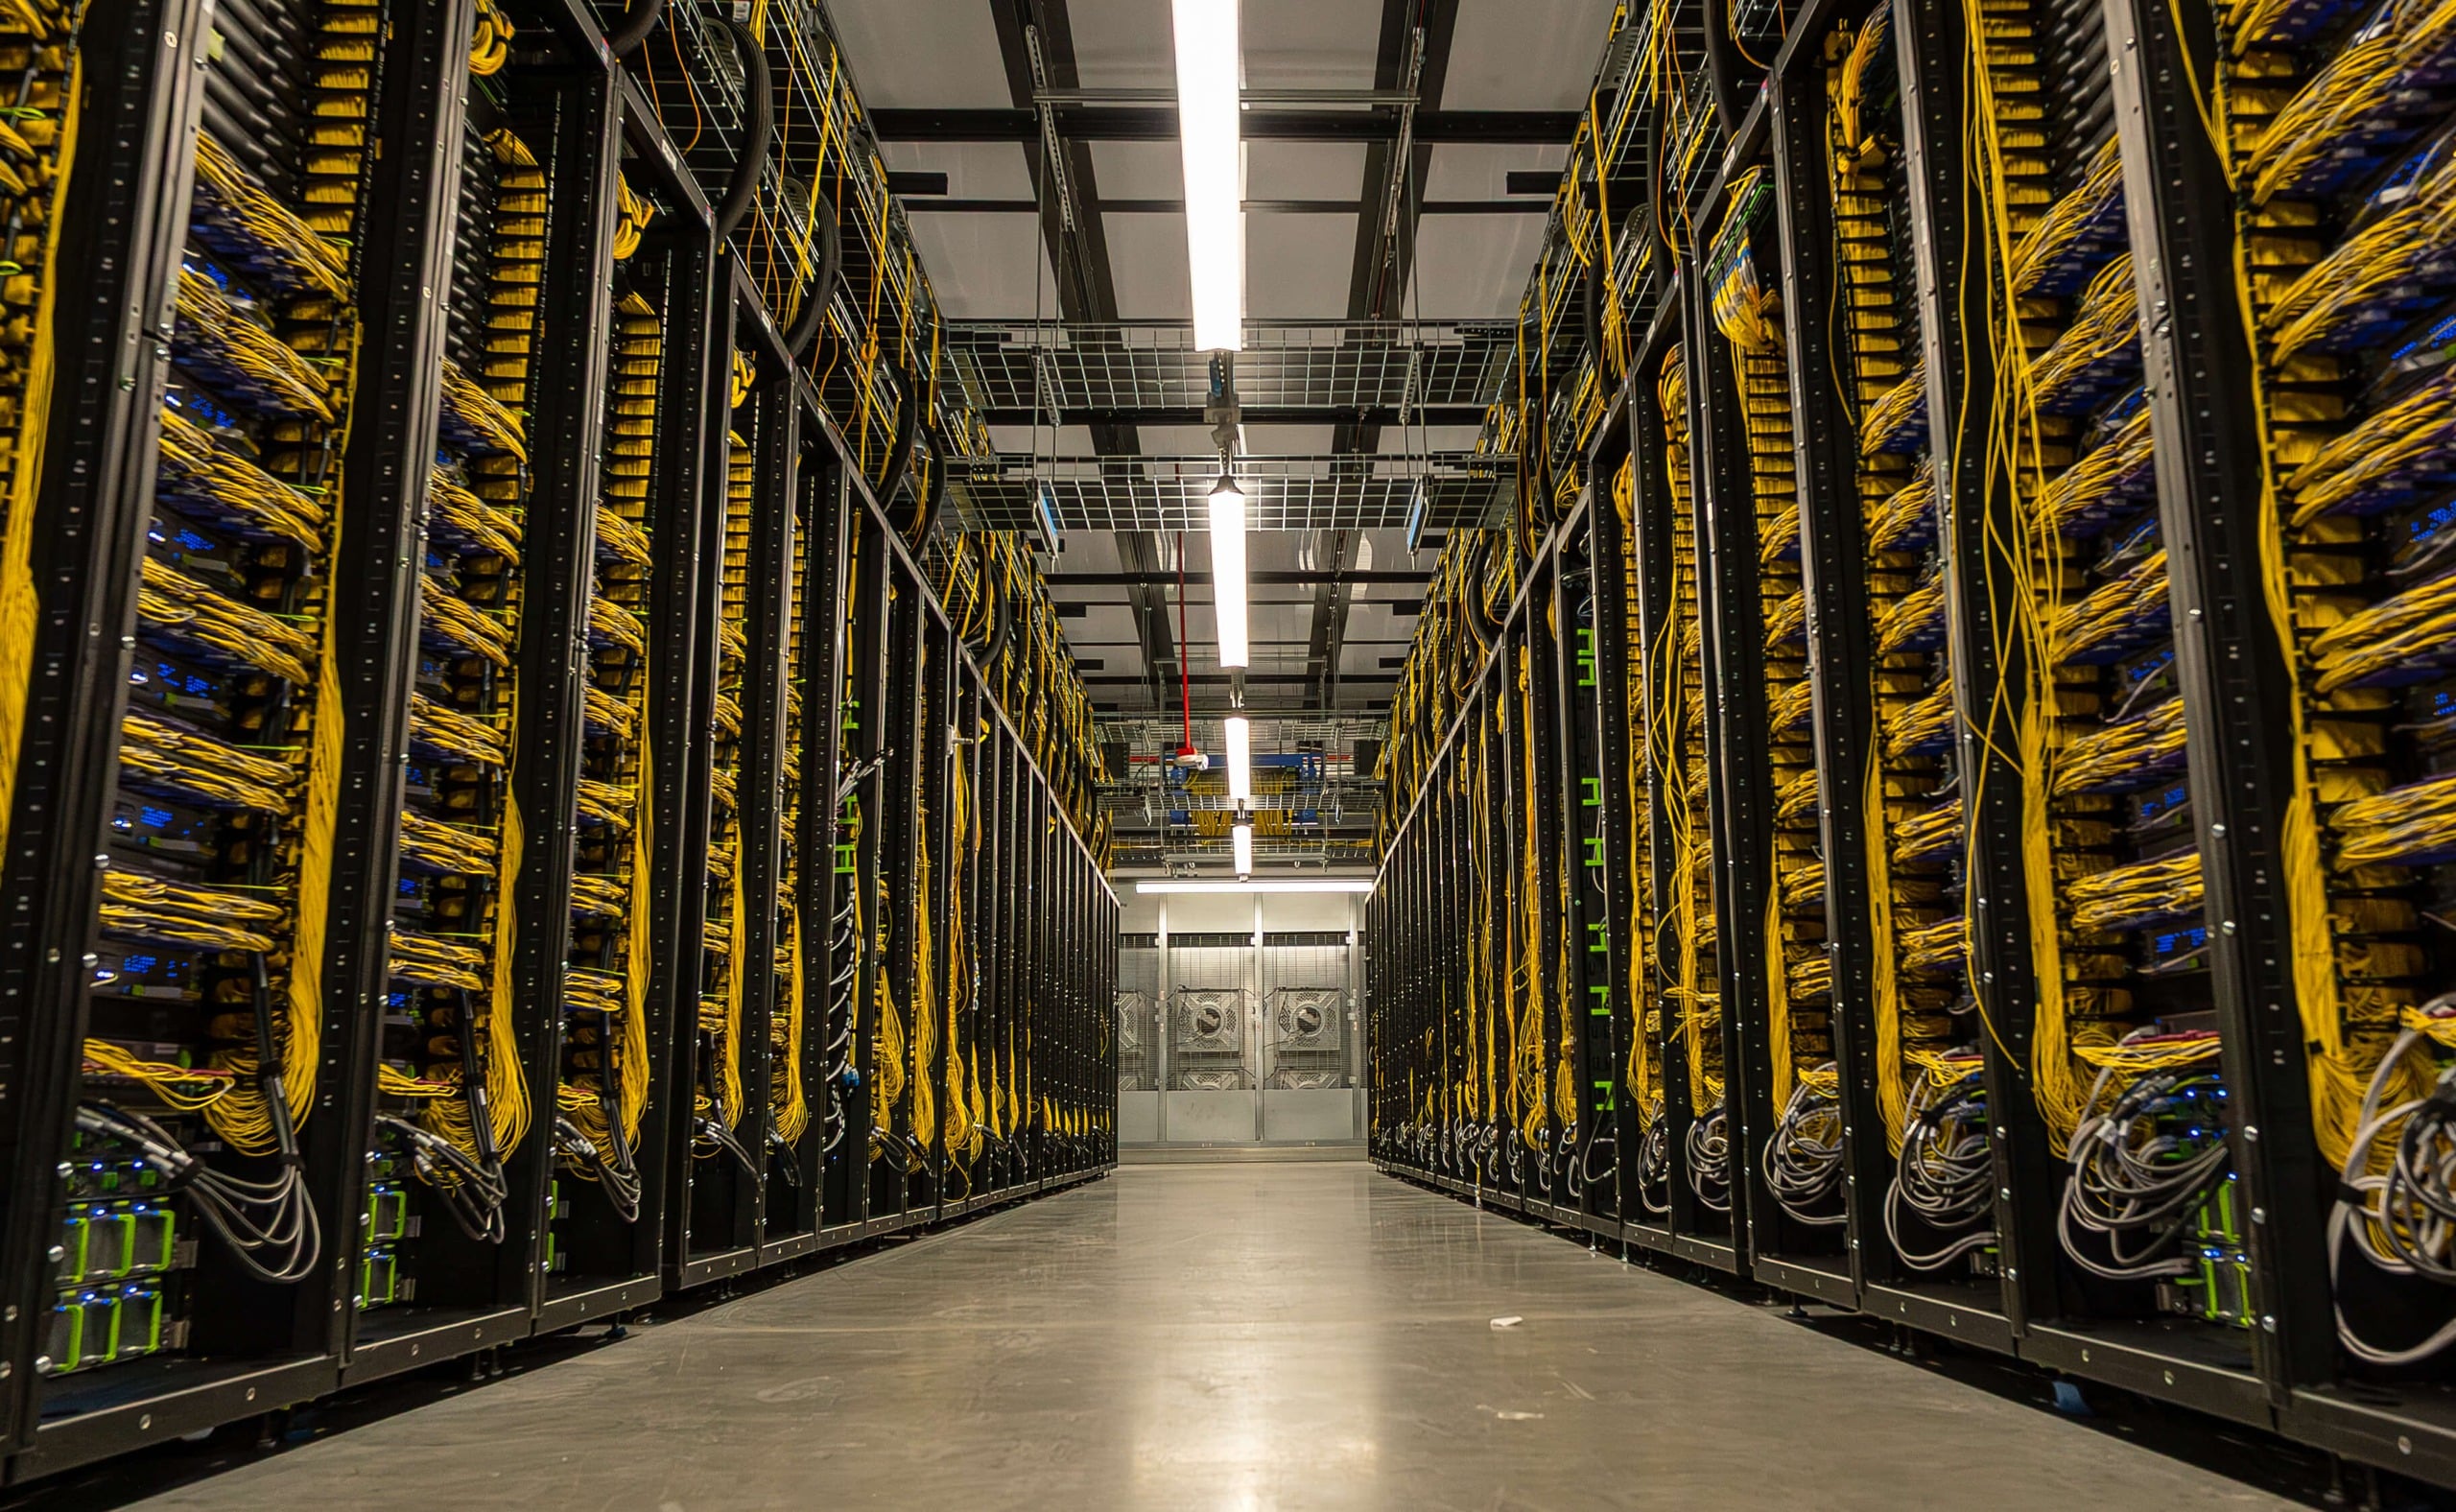
Meta는 대규모 학습 작업 실행과 관련된 가장 흥미로운 데이터 중 하나인 신뢰성 수치를 공개했습니다. Meta는 Muse Wonder 사전 학습 실행에서 85% 이상의 처리량(goodput)을, 강화 학습 실행에서는 90% 이상의 처리량을 기록했으며, 이러한 실행 동안 평균 중단 시간(MTBI)은 약 47,000 GPU 시간이라고 보고했습니다. 이후 배포된 펌웨어 수정으로 MTBI는 54,000 GPU 시간을 넘어섰습니다. Meta의 목표는 하루에 8,000개의 GPU당 두 번의 중단이며, 이는 중단 간 약 100,000 GPU 시간에 해당합니다.
두 세대의 NVL72가 생산 중이며, Vera Rubin이 다음 주자로 나설 예정입니다.
프로메테우스는 현재 두 가지 NVIDIA GPU 플랫폼을 운영하고 있으며, 두 플랫폼 모두 72개의 GPU가 하나의 NVLink 도메인을 공유하는 NVL72 랙 아키텍처를 기반으로 합니다. 세 번째 플랫폼은 베라 루빈 NVL72를 기반으로 하며 곧 출시될 예정입니다. 메타가 카탈리나라고 부르는 첫 번째 플랫폼은 Ariel 변형의 GB200 NVL72를 사용합니다. 이 플랫폼은 메타가 오픈 컴퓨트 프로젝트에 기여한 고성능 랙 디자인인 오픈 랙 V3를 기반으로 구축되었으며, 랙당 36개의 GPU가 탑재된 2랙 구성입니다. 각 블랙웰 GPU는 그레이스 CPU와 두 개의 ConnectX-7 400G NIC와 연결되어 1:1 CPU-GPU 비율을 제공하며, 각 GPU는 800G의 확장 대역폭을 활용할 수 있습니다.
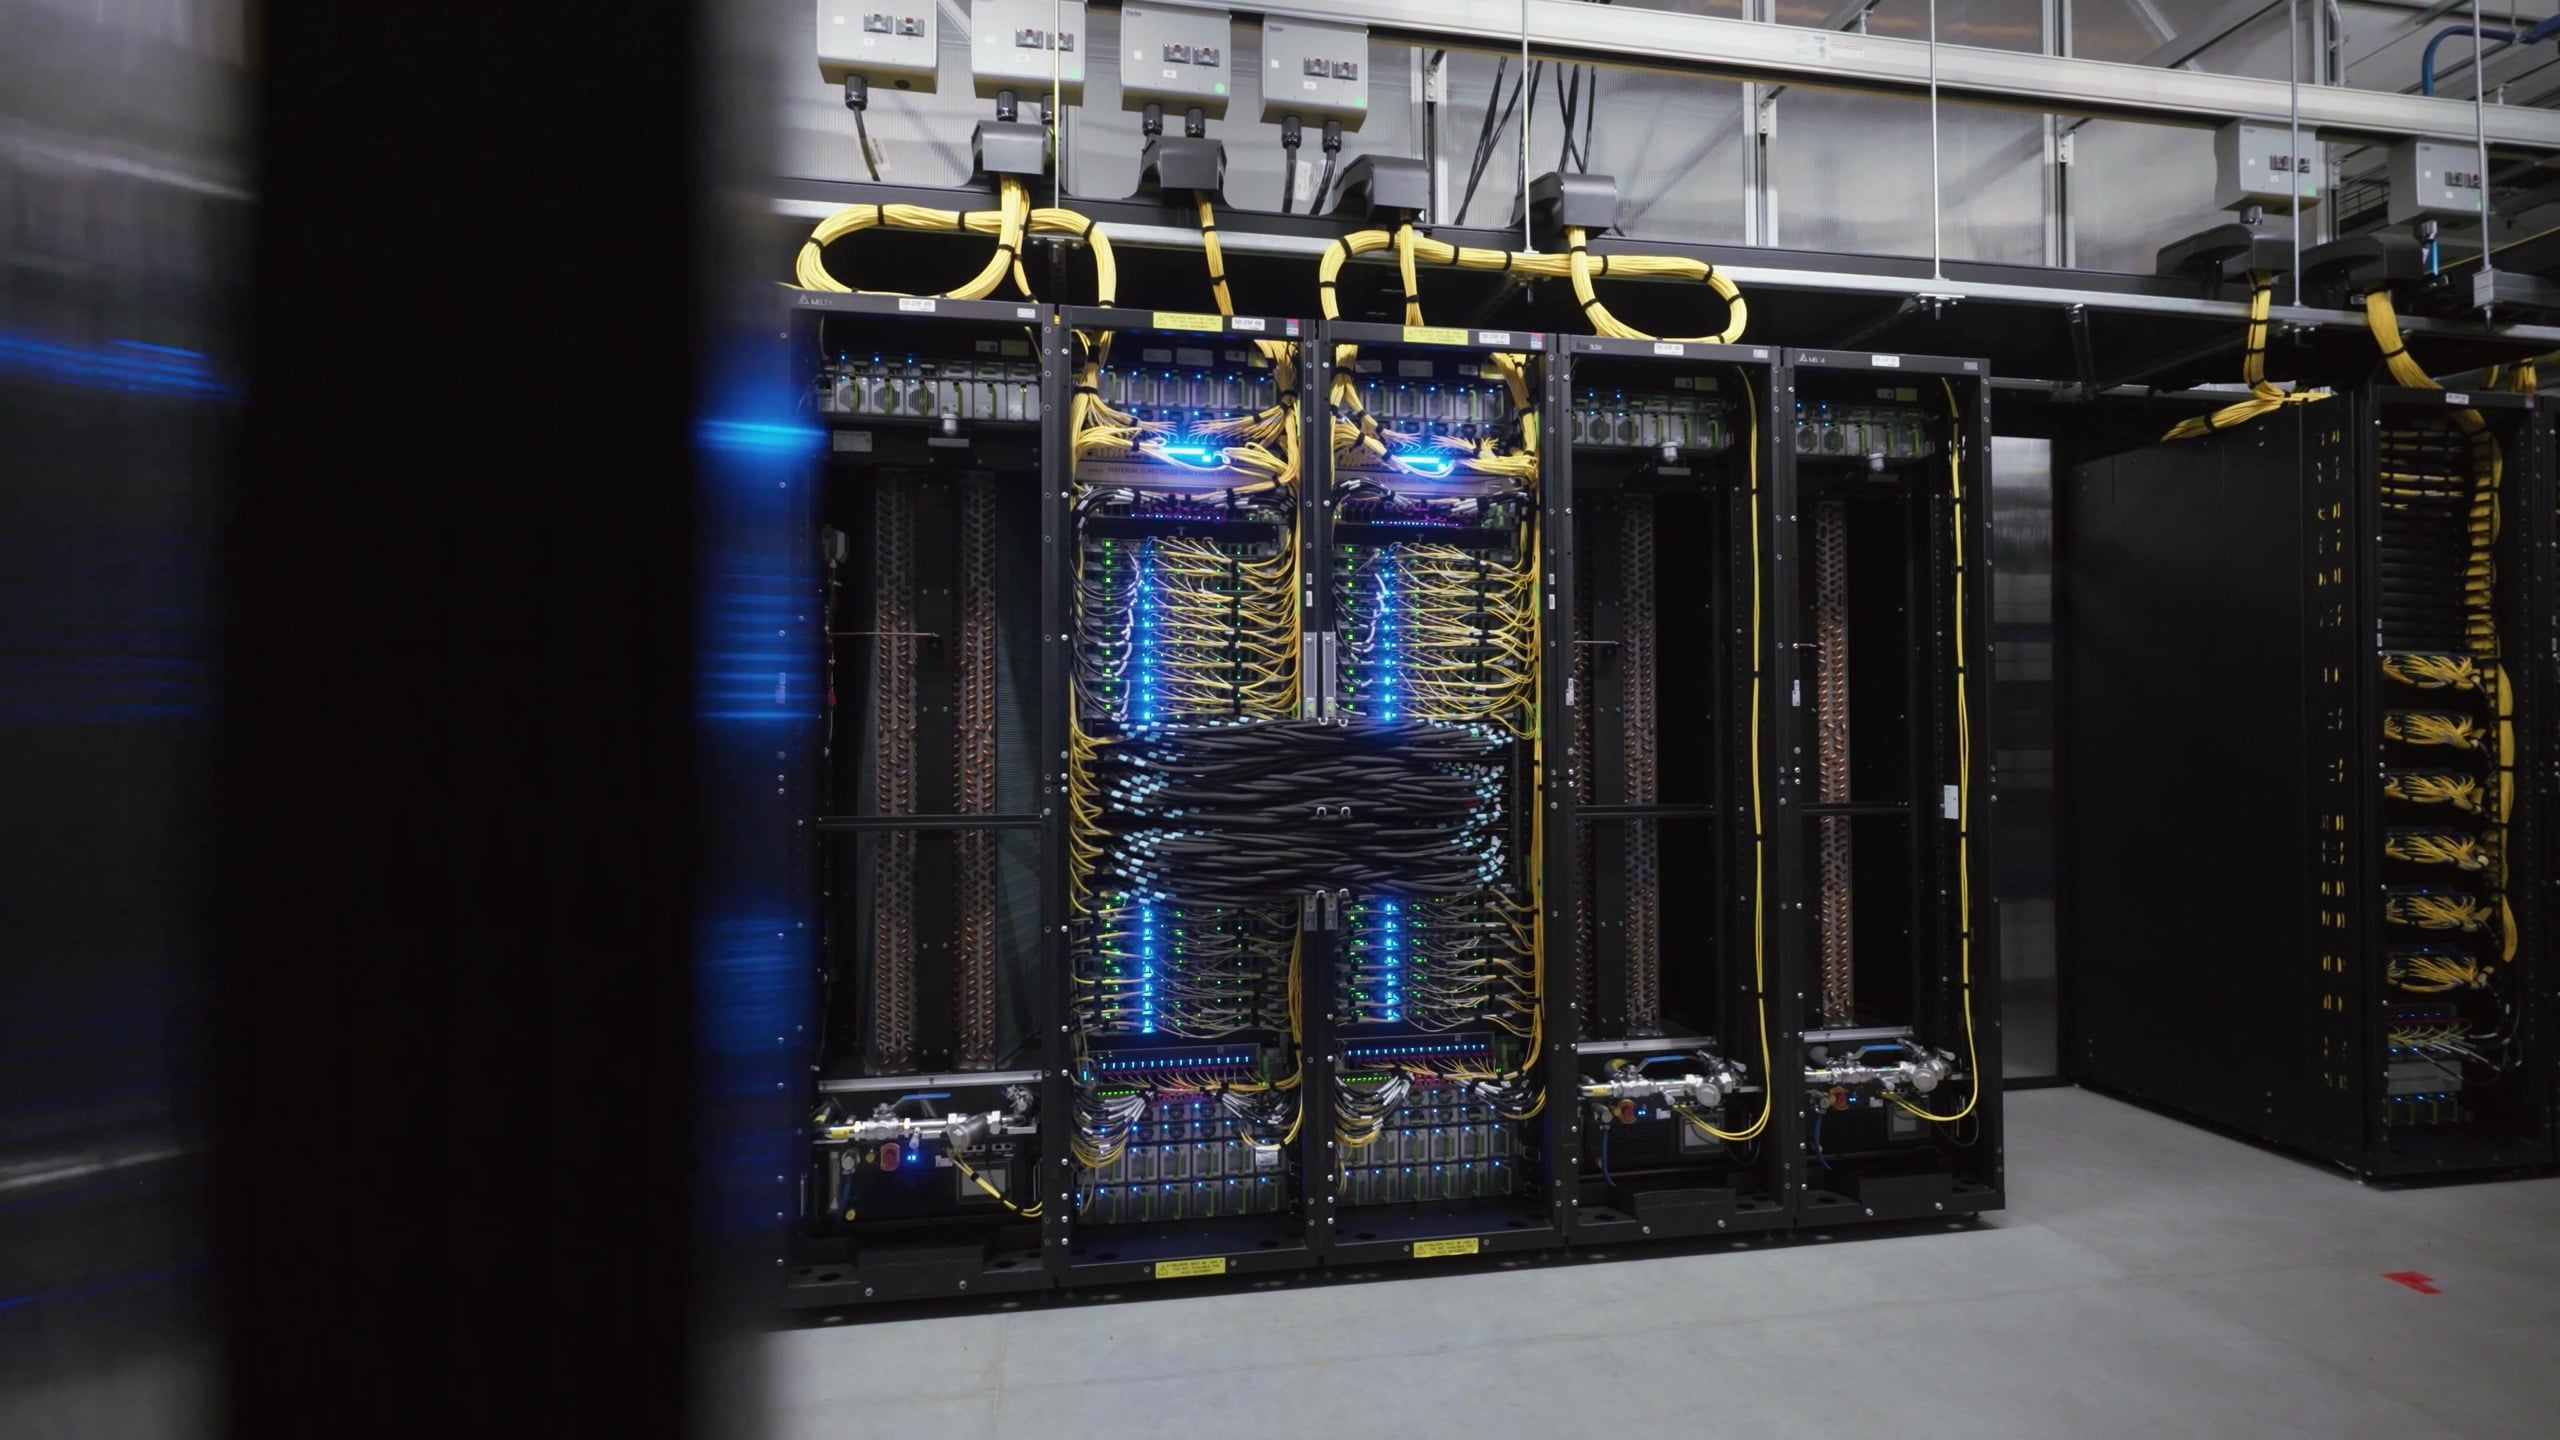
Meta는 Ariel을 선택한 이유로 GB200 NVL72가 H100을 훨씬 뛰어넘는 FLOPS, HBM 대역폭, 스케일업 대역폭 및 도메인 크기를 제공했기 때문이라고 밝혔습니다. 반면 표준 스케일아웃은 GPU당 400G에 머무르게 되는데, 이러한 불균형이 성능 저하로 이어질 것으로 예상했기 때문입니다. Meta에 따르면, Catalina 한 쌍은 72개의 Blackwell GPU와 13.4TB의 HBM3e(GPU당 192GB)를 탑재하고, 최대 720 PFLOPS의 FP8 학습 연산 성능(FP4에서는 1,440 PFLOPS), 도메인 내 130TB/s의 NVLink 대역폭, 576TB/s의 총 메모리 대역폭을 제공하며, 두 랙에서 약 120kW의 전력을 소비합니다.
두 번째 플랫폼인 Clemente는 GB300 NVL72로 업그레이드되었습니다. GPU당 HBM 용량은 1.5배 증가한 288GB이며, 고밀도 FP4 처리량도 비슷한 비율로 증가하고, 어텐션 가속 성능은 거의 두 배로 향상되었습니다. ConnectX-8 SuperNIC는 GPU당 800G의 대역폭을 기본적으로 제공하므로 Meta가 Ariel에 설계한 확장 여유 공간이 기본이 되며, 2:1의 GPU 대 CPU 비율로 72개의 GPU 도메인 전체를 단일 랙에 설치할 수 있습니다. Meta는 20.7TB의 HBM3e, 1엑사플롭 이상의 최대 FP4 연산 능력, 130TB/s의 NVLink 대역폭(GPU당 양방향 1.8TB/s), 랙당 약 135kW의 전력 소비, 그리고 GB200 NVL72 대비 5~10%의 성능 향상을 제공합니다.
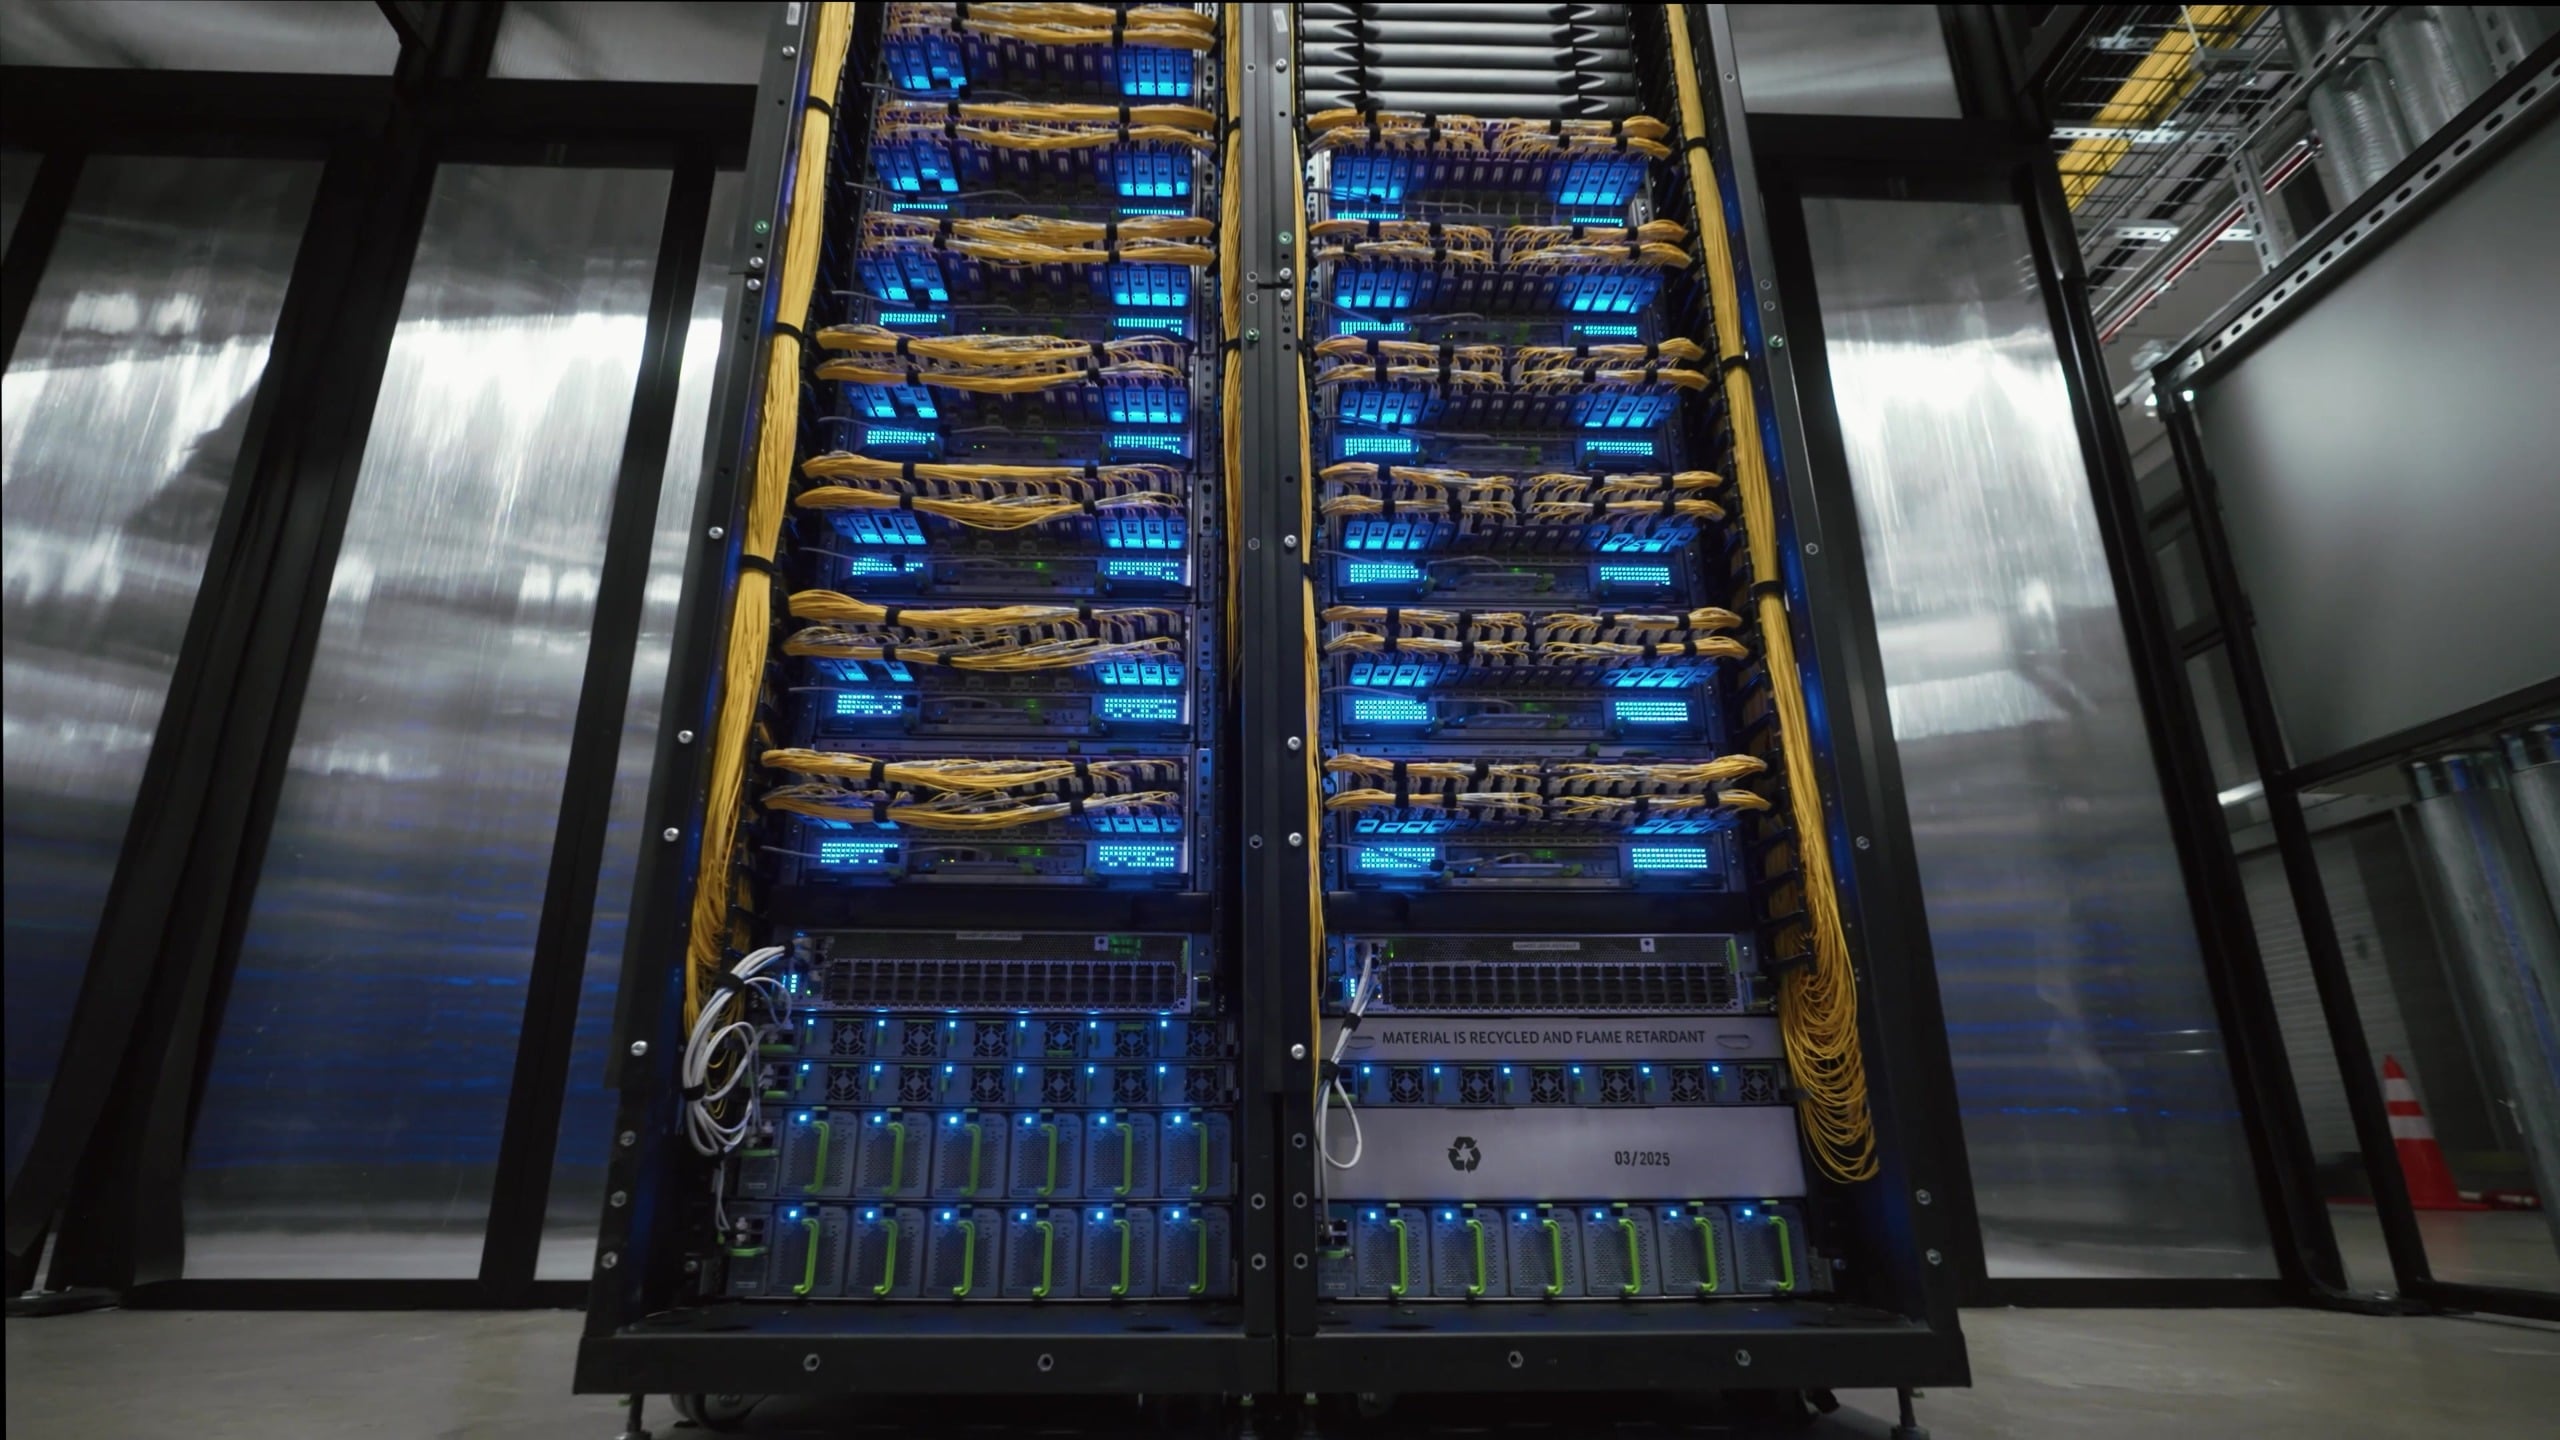
Clemente는 최신 AI 최적화 건물에서 Meta의 모듈식 공기 보조 액체 냉각 방식 또는 시설 액체 냉각 방식을 사용하여 시스템을 구축하며, Meta는 케이블 수가 줄어들어 유지보수성이 향상된다고 밝혔습니다.
Meta의 차세대 플랫폼인 San Miguel은 Vera Rubin NVL72를 동일한 네트워크 패브릭에 통합할 예정입니다. Meta가 공개한 해당 랙의 사양은 GPU당 288GB의 HBM4 메모리(19.2TB/s 대역폭), 최대 FP4 학습 연산 성능 2.52 exaFLOPS, FP8 연산 성능 1.26 exaFLOPS, NVLink 대역폭 216TB/s(GPU당 3TB/s), 총 메모리 대역폭 약 1,500TB/s, 랙당 170kW 이상의 완전 액체 냉각 컴퓨팅 트레이, 그리고 GB300 NVL72 대비 와트당 성능 10~20% 향상입니다. CoreWeave는 이달 초 Vera Rubin NVL72를 상용화했습니다 .
건물 간 연결을 위한 전용 이더넷 백엔드
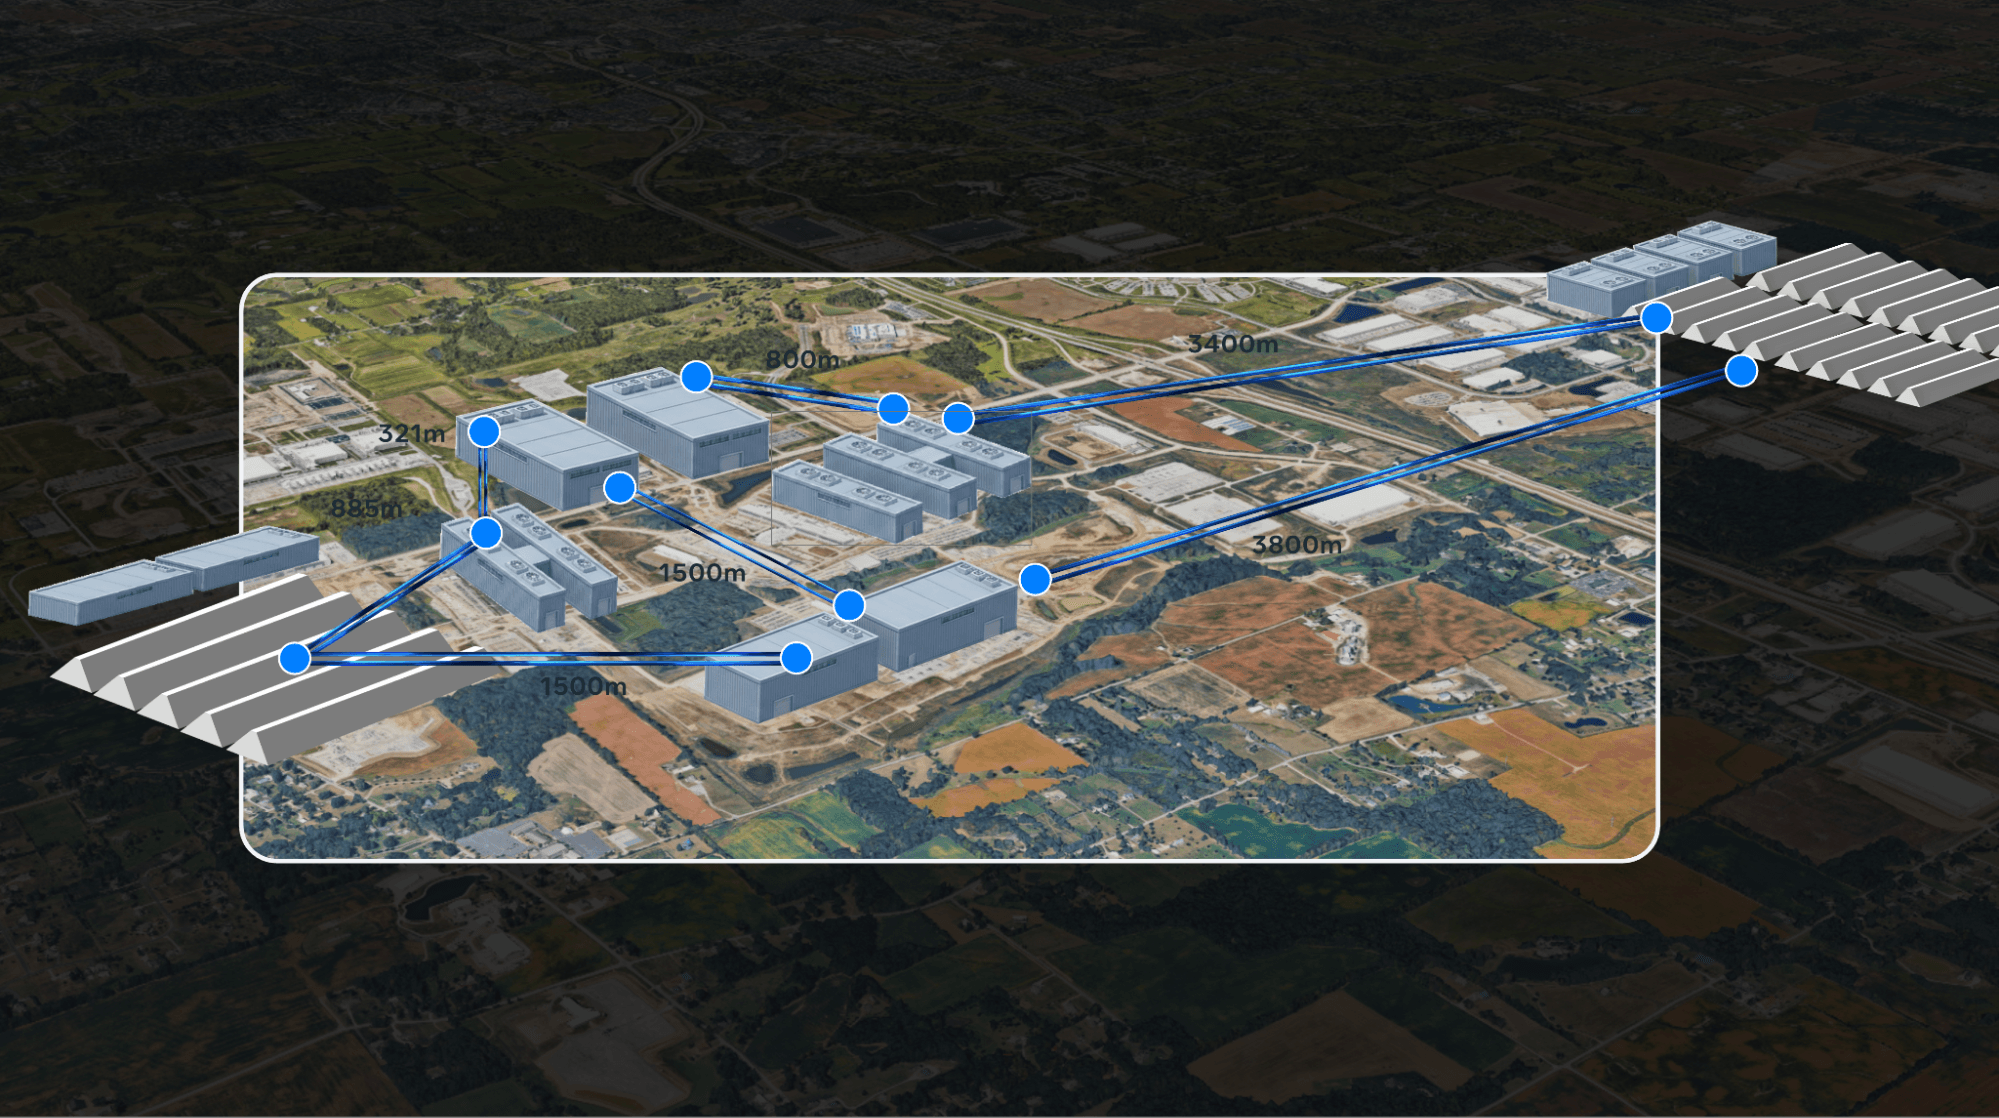
훈련 트래픽은 일반 서비스 트래픽을 처리하는 프런트엔드 네트워크와는 별도로 이더넷을 통해 두 번째 데이터 센터 네트워크에서 실행됩니다. 이러한 설계는 훈련 작업의 형태를 따릅니다. 데이터 병렬 복제본은 지연 시간에 민감하고 대역폭 사용량이 많은 집합체를 건물 내부에 유지하는 반면, 복제본 간의 비교적 안정적인 트래픽은 건물을 연결하는 집계 계층을 통과합니다. Meta는 이와 동일한 계층 구조를 이전에 구축한 24,000개 GPU 규모의 건물형 클러스터와 100,000개 이상의 GPU를 사용하는 지역 클러스터에 적용한 후 Prometheus로 확장했습니다.
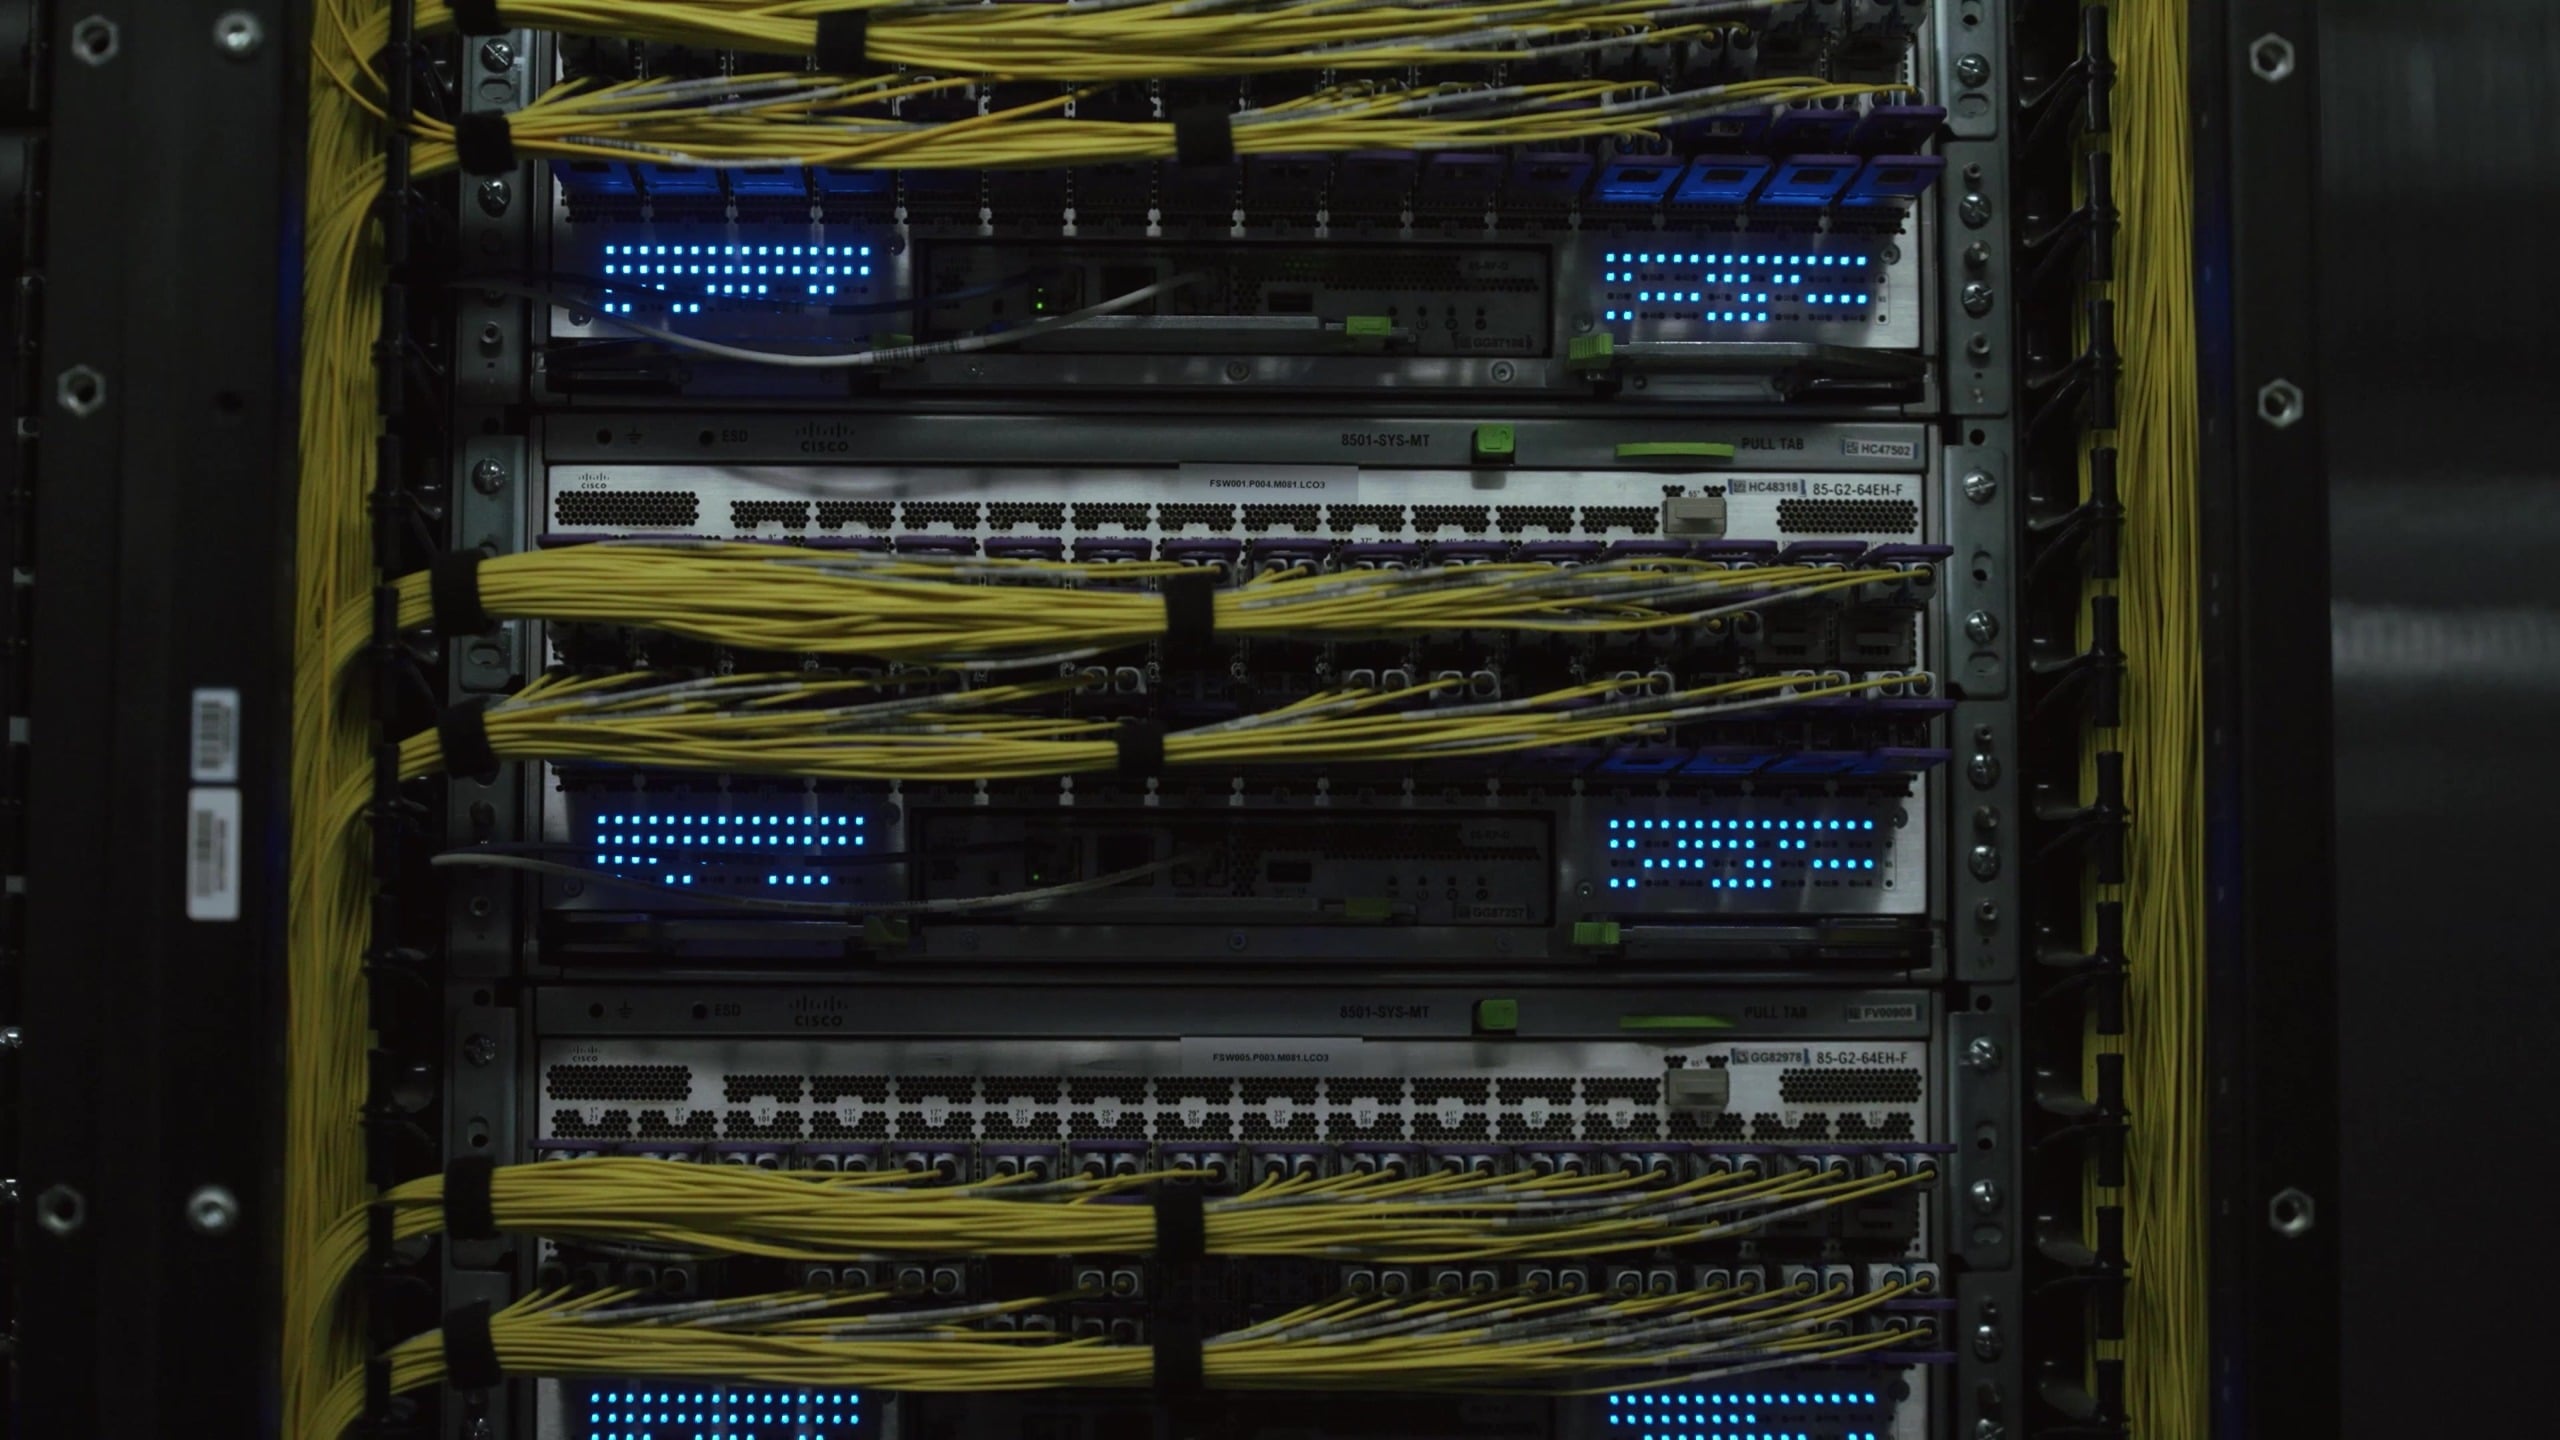
각 건물 패브릭은 최대 20,736개의 GPU를 연결합니다. Meta의 초기 설계는 서브패킷 멀티패스 라우팅, 패브릭 내 재정렬, 가상 출력 큐, 크레딧 기반 흐름 제어를 사용하여 훈련 집단의 몇몇 대규모 장기 흐름이 충돌하지 않도록 하는 분산형 스케줄링 패브릭이었습니다. NIC가 엔드포인트에서 패킷 재정렬 기능을 갖추게 되면서 Meta는 얕은 버퍼를 사용하는 51.2T 스위치 기반의 비스케줄링 패브릭으로 전환했습니다. 사용된 스위치는 동적 로드 밸런싱 기능을 갖춘 Minipack3와 ConnectX NIC에서 적응형 라우팅을 지원하는 NVIDIA Spectrum-4 ASIC를 사용하는 Minipack3N이며, 두 스위치 모두 Meta의 FBOSS 네트워크 스택을 실행합니다.
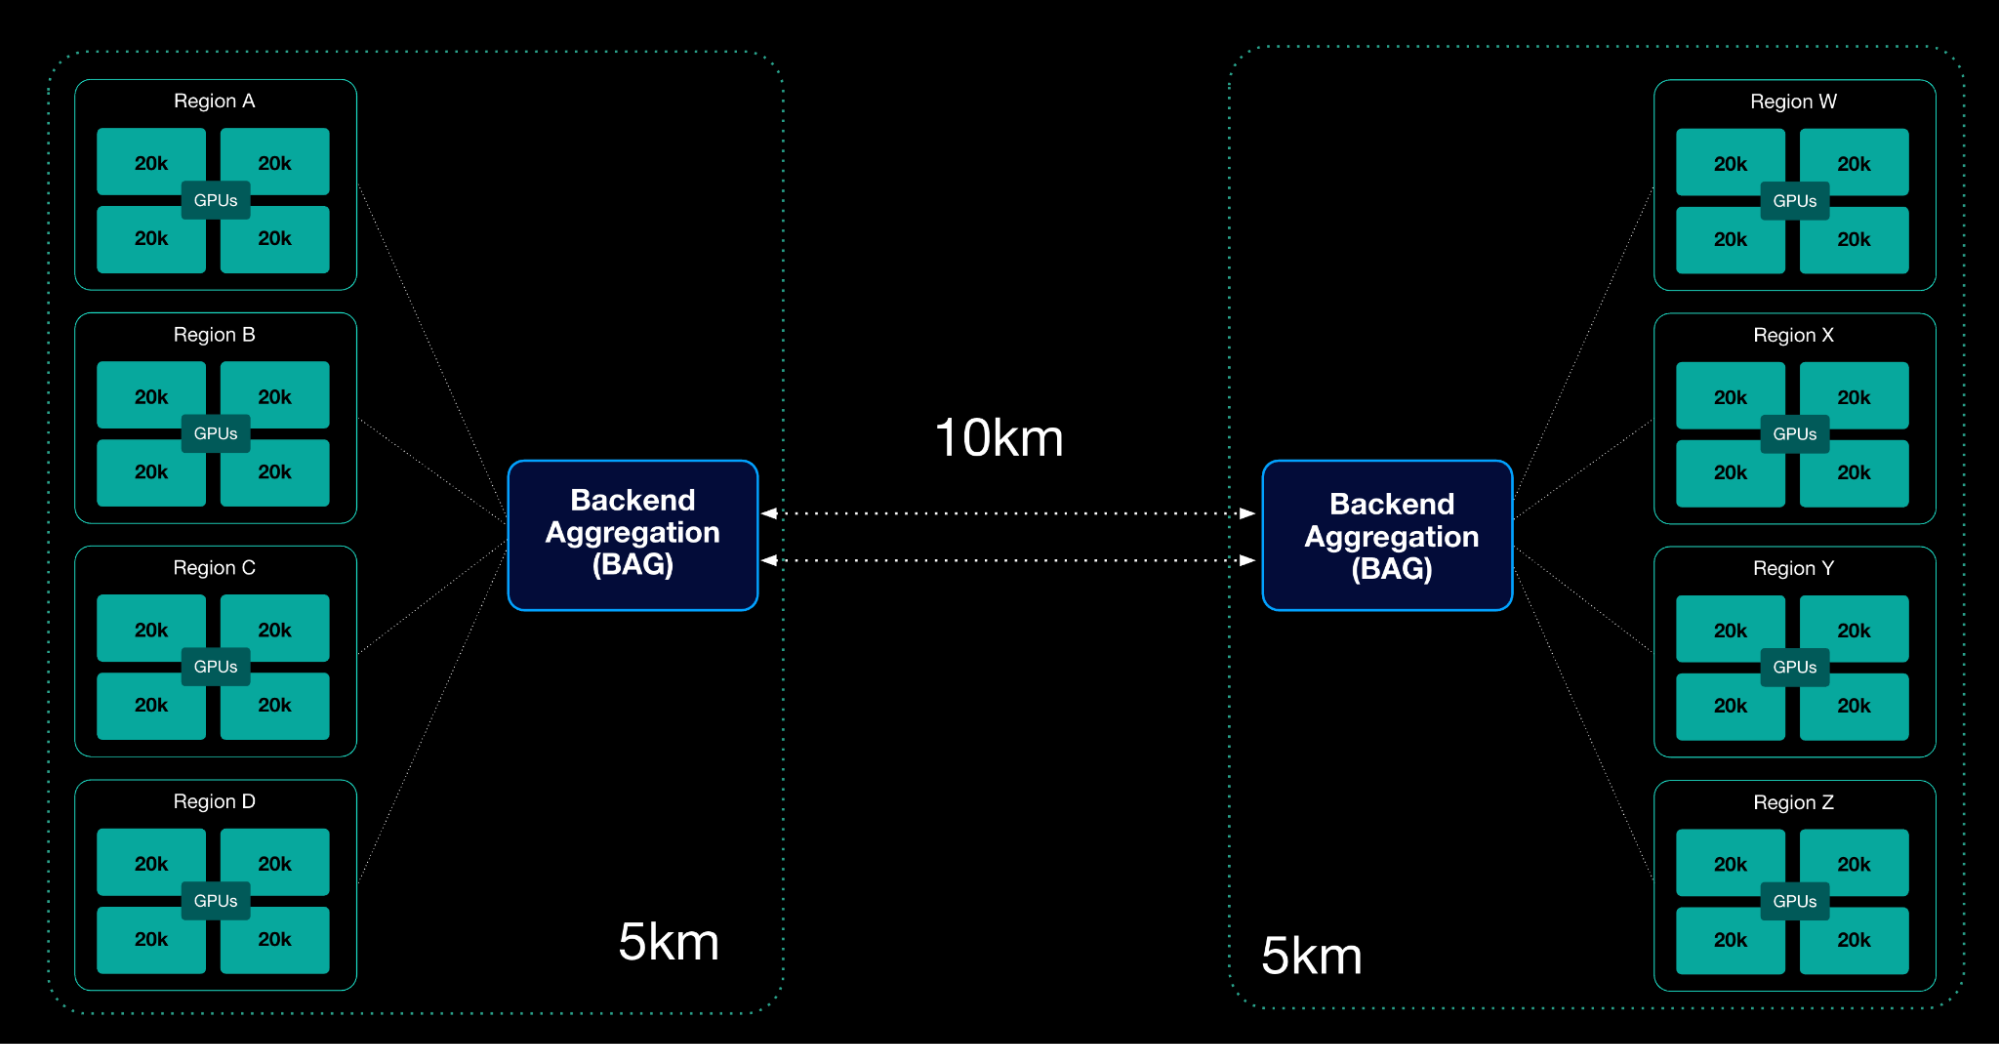
건물 위에는 아리스타 7800 시리즈 섀시와 딥 버퍼링 기능을 갖춘 브로드컴 제리코3 실리콘을 기반으로 구축된 다계층 허브 앤 스포크 방식의 백엔드 집계 네트워크가 자리 잡고 있습니다. 이 네트워크는 2km에서 100km 이상에 이르는 거리에 걸쳐 있으며, 지역 쌍 간에 초당 수 페타비트의 데이터를 전송합니다. 메타는 빛의 속도에 가까운 지연 시간 때문에 이러한 장거리에서 사전 학습을 실행하는 데 메타 슈퍼인텔리전스 연구소와의 전담 최적화 작업이 필요했다고 밝혔습니다. 이 네트워크의 기반 시설에는 수백만 마일의 광섬유, 수만 대의 스위치, 그리고 건물 내부에 설치된 2x400G FR4 LITE 플러그형 모듈부터 약 10km 이상의 링크에 사용되는 800G-ZR 코히런트 광 모듈까지 수백만 개의 광 모듈이 포함되어 있습니다.
72개의 GPU 중 64개가 작업을 수행합니다.
H100 세대의 8개 GPU NVLink 도메인에서 NVL72로 전환하면서 장애 발생 시 영향 범위가 9배로 늘어났습니다. 이에 따라 Meta는 72개 GPU 랙을 기준으로 용량을 계획하고 있습니다. 병렬 학습은 2의 거듭제곱 크기의 그룹에 가장 적합하기 때문에 각 NVL72 도메인은 64개 GPU 슬라이스를 실행하고 나머지 8개 GPU는 랙 내 예비용으로 보관합니다. GPU에 장애가 발생하면 예비 GPU가 해당 기능을 인계받아 복구를 기다리지 않고 마지막 체크포인트부터 작업을 다시 시작합니다. 랙 전체 장애에 대비하여 Meta는 약 2%의 추가 랙을 예비로 보유하고 있습니다.
32,768개의 GPU를 사용하는 학습 실행에는 523개의 NVL72 랙, 즉 37,656개의 GPU가 필요하며, 이는 활성 풋프린트보다 약 13% 높은 수치입니다. 이 중 11%는 72개 슬라이스 중 64개를 사용하는 구성에서 비롯됩니다. 이러한 안정성을 뒷받침하는 신호 무결성 부담은 상당합니다. 단일 NVL72 도메인은 200Gbps 속도로 작동하는 5,184개의 튜닝된 차동 쌍 링크를 지원하며, 각 링크는 GPU SerDes, 컴퓨팅 트레이 PCB, 케이블 카트리지 및 스위치 트레이 인터페이스를 통과합니다.
두 가지 복구 경로가 발생하는 오류를 처리합니다. 오류가 하나의 데이터 병렬 복제본에만 국한될 경우, Meta의 병렬 처리 인식 내결함성 기능은 해당 복제본을 오프라인으로 전환하고 나머지 클러스터는 학습을 계속 진행하며, 해당 복제본은 예비 호스트에서 재시작하고 동기화합니다. 더 큰 오류가 발생하면 전체 작업이 마지막 체크포인트로 되돌아가므로, Meta는 자주 체크포인트를 생성하여 기울기 및 옵티마이저 데이터를 포함한 모델 상태를 델타 체크포인트 및 인메모리 스테이징을 사용하는 다중 계층 스토리지에 비동기적으로 저장함으로써 처리량 저하를 최소화합니다.
업무 중단 횟수 99% 감소
이러한 수치들이 보여주는 모든 발전에도 불구하고, 프로메테우스는 처음부터 안정적이지는 않았습니다. 2025년 중반 초기 단계에서는 중단률이 하루에 8,000개의 GPU당 거의 1,000건에 달하는 최고치를 기록했습니다. 1년간의 협업을 통해 중단률은 99% 감소했으며, 현재 클러스터는 각각 수만 개의 GPU를 사용하는 여러 학습 작업을 병렬로 안정적으로 처리하고 있습니다. 메타는 NVIDIA와의 공동 엔지니어링 모델 덕분에 이러한 성과를 달성했다고 설명합니다. 이 모델에서 NVIDIA 팀은 뉴 올버니(New Albany) 사이트에 상주하며 원격 측정 데이터를 공유하고, 모든 중단 사태의 근본 원인을 분석하는 공동 문제 해결 회의를 진행합니다. 메타는 스케줄링 및 인프라 수정 작업을 담당하고, NVIDIA는 펌웨어, 신호 진단 및 메모리 관리를 담당합니다.
GB200에서 가장 먼저 발생한 병목 현상은 NVLink 신호 무결성 문제였습니다. 클러스터에 600,000만 개 이상의 NVLink 연결이 존재하면서 링크 상태가 불안정할 경우 잦은 복구 작업이 발생했기에, Meta는 생산 전에 취약한 링크를 찾아내기 위해 지속적인 원격 측정, 자동 플래깅, L11 진단 테스트 실행 기능을 추가했습니다. GB300이 더 큰 메모리를 탑재하면서 HBM 및 LPDDR 메모리 오류가 주요 원인으로 떠올랐고, 이에 대응하여 HBM 펌웨어 설정 개선, 메모리 스크러빙, LPDDR 오류 수정 알고리즘 개선, 성능 저하 장치 사전 폐기 등의 조치를 시행했습니다. 스위치 상태는 밀리초 단위로 모니터링되며, 집계 계층의 링크 이벤트는 GPU 트래픽을 중단하지 않고 하드웨어에서 재라우팅됩니다.
수십만 대의 1세대 가속기를 운영하면서 하드웨어 성숙도는 그 자체로 하나의 전문 분야가 되었습니다. Meta의 펌웨어 자동화 시스템은 몇 시간 만에 10만 대 이상의 GPU에 드라이버 및 펌웨어 수정 사항을 배포할 수 있으며, GB200 출시 초기 7시간 이상 걸리던 P90 단일 포드 업그레이드 시간은 2시간으로 단축되었습니다. 전력 공급 스트레스 테스트는 단일 GPU의 1,400W 부하 조건에서 PSU 모듈과 전압 조정기의 동작을 검사하며, 모든 수정된 시스템은 검증을 통과할 때까지 격리됩니다. Meta는 3월에 안정성 스프린트를 진행하여 스택 전반에 걸쳐 수정 사항을 동기화했습니다.
전력 과도 현상 및 혼합 냉각 시스템
동기식 트레이닝은 전력을 동기화하여 사용하며, 수만 개의 GPU가 컴퓨팅 단계 또는 통신 단계에 동시에 진입하면 클러스터 부하가 30~40%까지 변동될 수 있습니다. 또한 대규모 작업을 시작하거나 일시 중지하면 몇 초 만에 수십 메가와트의 전력이 변동될 수 있습니다. Meta의 클러스터 전체 전력 관리 프레임워크인 Dynamo Dimmer는 클러스터가 전력 한계에 가까워짐에 따라 GPU 전력을 점진적으로 제한하여 작업이 계속 실행되도록 합니다. 랙 레벨 배터리 백업 모듈은 전력 급증을 흡수하고, 커패시터 트레이는 피크를 완화하며, 시설 규모의 배터리 에너지 저장 장치가 그 뒤에 배치되어 있고, Meta는 전력 회사와 협력하여 부하 프로파일을 관리합니다.
프로메테우스는 개방형 데이터 센터, 신속 구축 구조물, 임대 시설, 그리고 AI 전용 건물 등 다양한 환경에 걸쳐 빠르게 구축되었기 때문에 건물별 냉각 방식이 다릅니다. 기존 공간에는 모듈식 공기 보조 액체 냉각 방식이 사용되었고, AI에 최적화된 건물에는 폐쇄 루프 방식의 시설 액체 냉각 방식이 적용되었습니다. 메타는 이 방식이 GPU 서버를 냉각하는 가장 효율적이고 물 사용량도 가장 적은 방식이라고 설명합니다. 메타는 OCP를 통해 액체 냉각 네트워크 랙인 IcePack과 같은 설계 정보를 공유했습니다. 훨씬 작은 규모의 GB300 NVL72 액체 냉각 구축 사례를 보려면 Giga Computing의 GAIFA 테스트베드를 참조하십시오.
다음은 하이페리온입니다
Meta는 GB300 NVL72와 Vera Rubin NVL72 랙을 혼합하여 Prometheus를 지속적으로 확장할 예정이며, Vera Rubin은 기존 네트워크 패브릭의 San Miguel 플랫폼을 통해 도입될 것입니다. 뉴 올버니에서 얻은 교훈은 Meta가 루이지애나주 리치랜드 패리시에 처음부터 설계 중인 슈퍼클러스터 Hyperion에 반영되고 있습니다. Hyperion은 폐쇄형 액체 냉각 시스템, Entergy를 통한 완전한 전력망 연결, 그리고 차세대 네트워크 설계를 특징으로 합니다. Meta는 두 사이트 모두에서 에너지 비용을 전액 부담하고 있으며, 사용량에 맞춰 새로운 청정 재생 에너지 발전량을 확보하고 있다고 밝혔습니다.
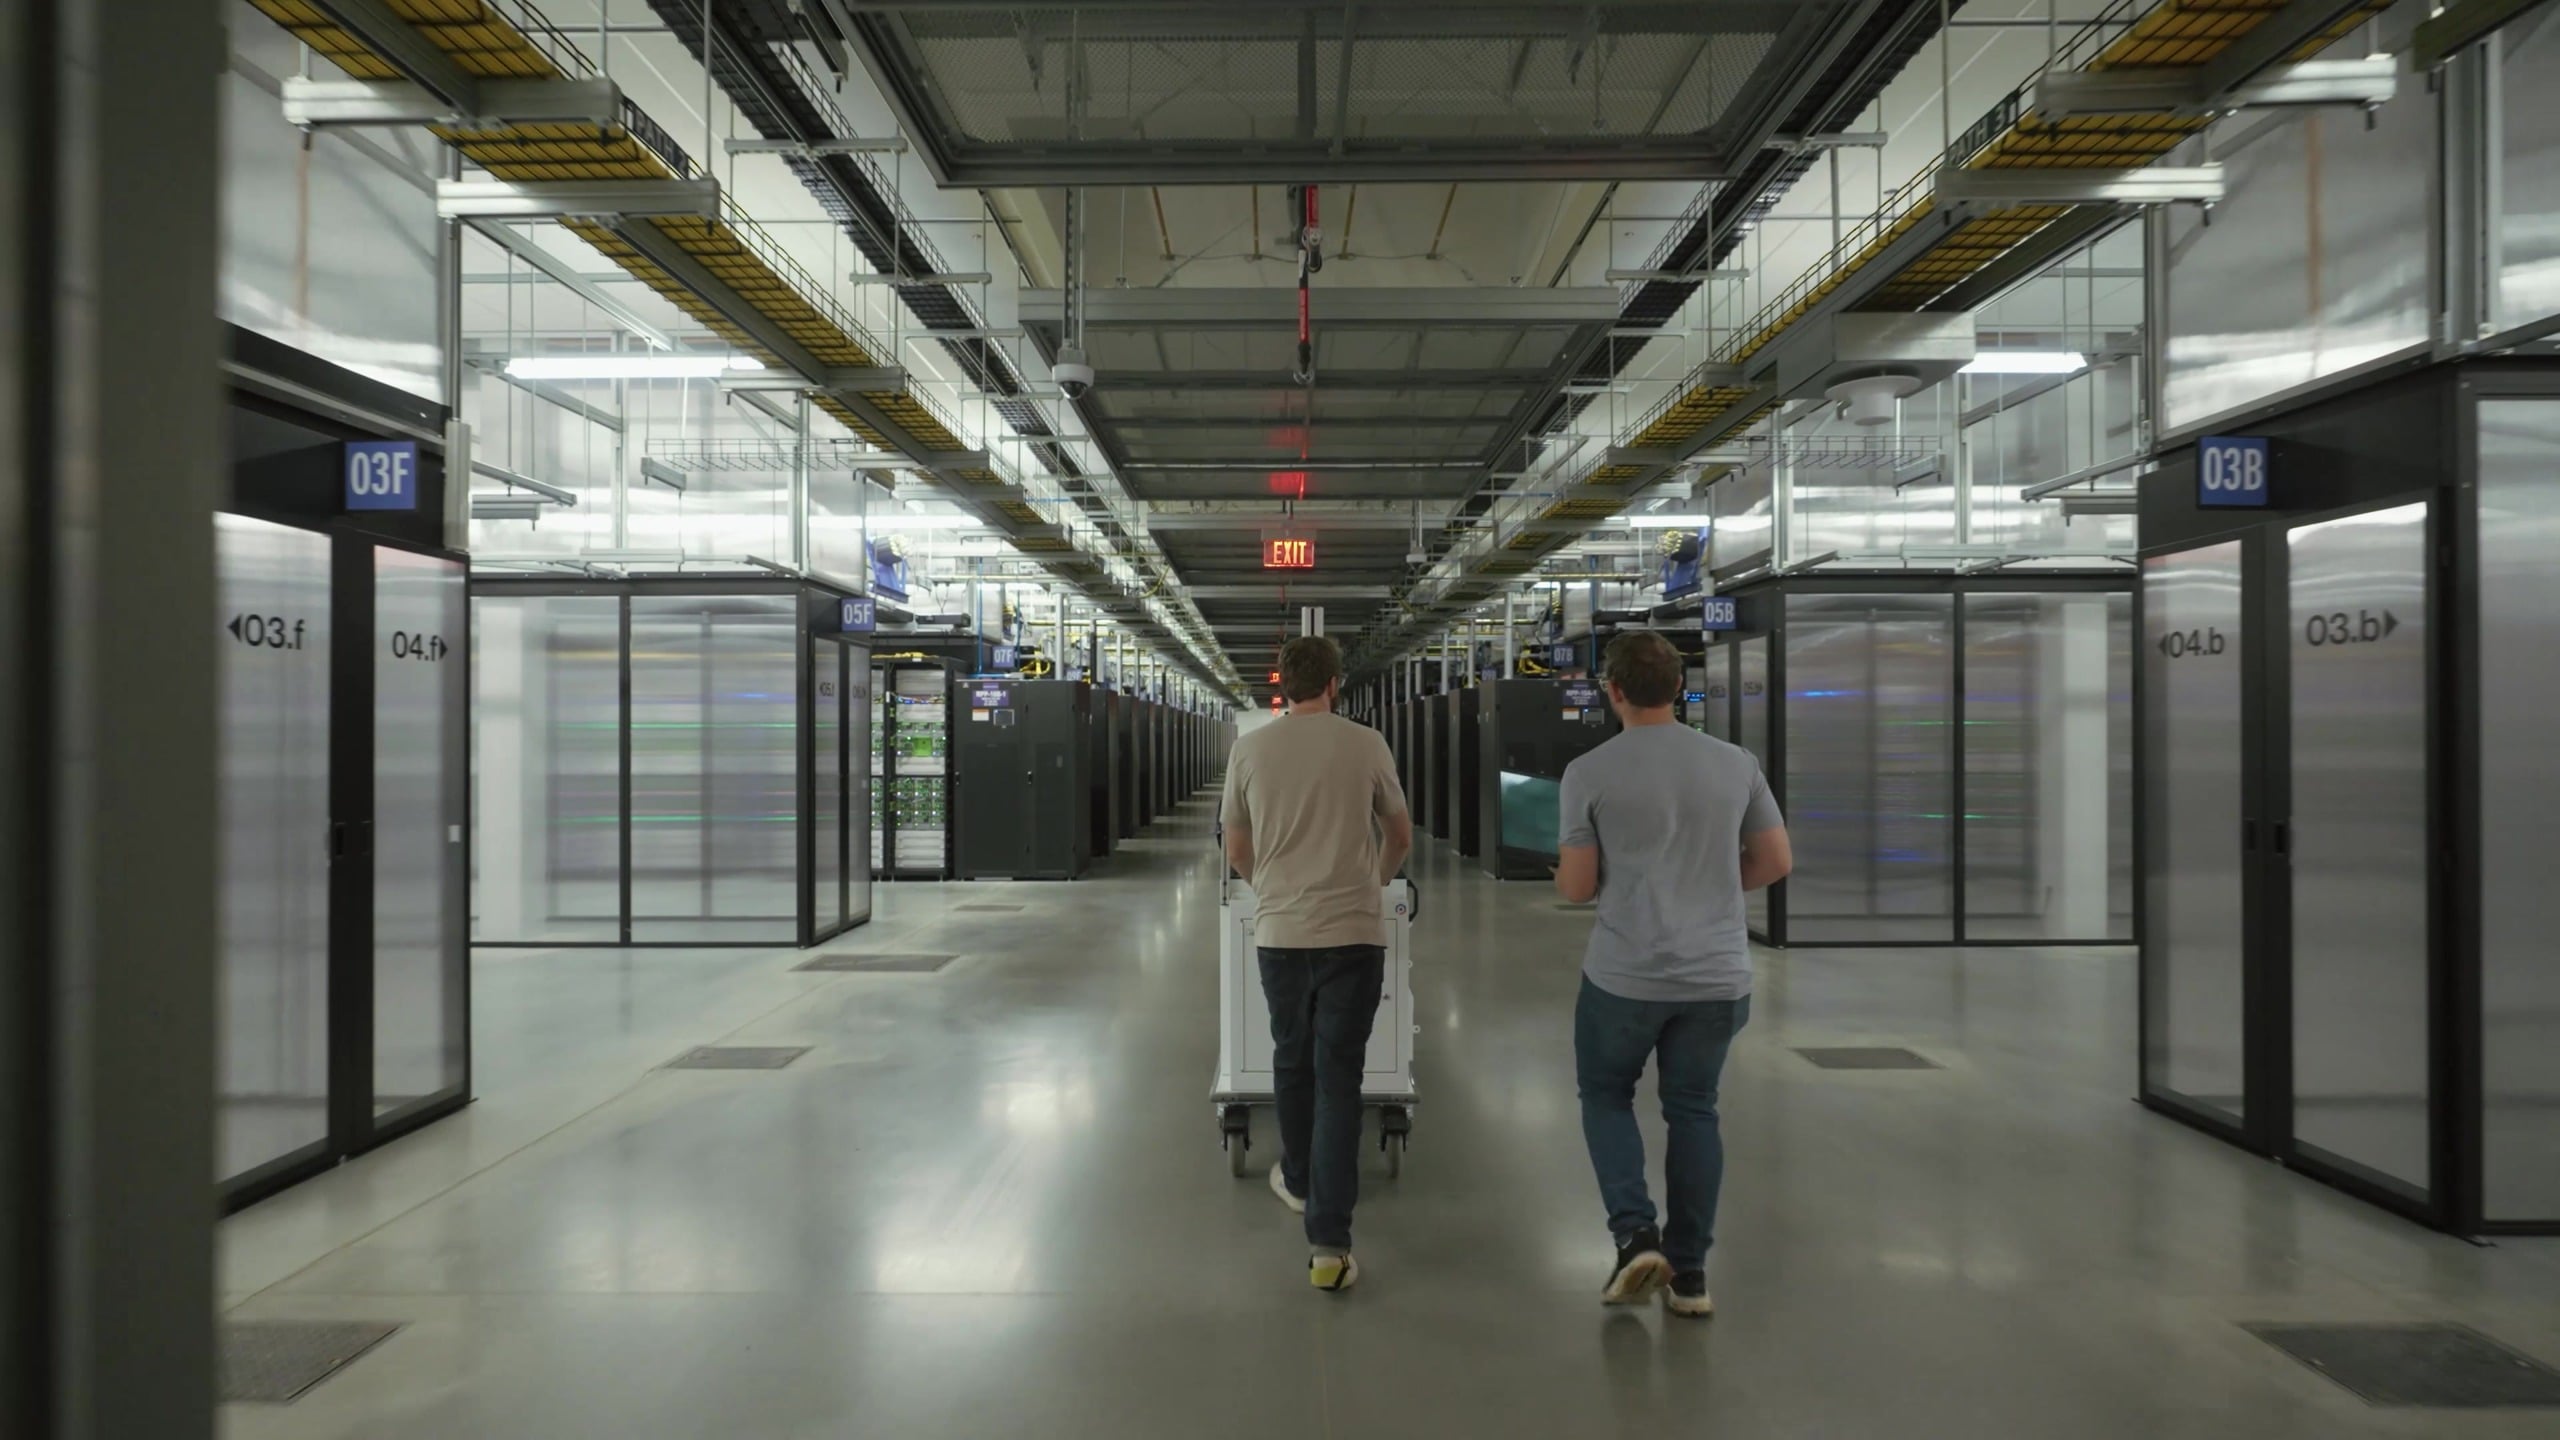
Meta가 공개한 내용의 대부분은 하이퍼스케일 업체들이 일반적으로 공개하지 않는 운영 세부 정보입니다. 예를 들어 예비 GPU 구성, 중단율, 펌웨어 배포 시간, Ariel 구성 선택 이유 등이 있습니다. 핵심은 이 규모에서는 하드웨어가 시작점에 불과하며, 수십만 개의 GPU를 유용한 학습 용량으로 전환하는 작업은 네트워크, 내결함성, 원격 측정에 있다는 것입니다. 대규모 AI 배포를 고려하는 기업에게 Meta의 심층 분석은 최소한 문제가 발생할 수 있는 부분을 파악하고 데이터 센터 전체에 걸쳐 사전 계획을 세우는 데 좋은 출발점이 될 것입니다.



 아마존