

CoreWeave는 샌프란시스코에서 열린 Fully Connected 2026 컨퍼런스에서 NVIDIA Vera Rubin NVL72를 상용 환경에 도입했으며, Cognition이 최초로 실제 워크로드를 실행하는 고객이 되었습니다. Cognition 엔지니어들은 동일한 상호작용 환경에서 SWE-2 추론 시 GB200 NVL72 기준 대비 GPU당 총 토큰 처리량이 최대 4.8배, 강화 학습 시 GPU당 출력 토큰 처리량이 최대 3.8배 증가했다고 보고했습니다. 두 결과 모두 Cognition이 CoreWeave 클라우드에서 실제 운영 환경과 유사한 에이전트 워크로드를 사용하여 자체적으로 수행한 벤치마크이며, 모델 크기, 컨텍스트 길이 또는 배치 설정은 공개되지 않았습니다.
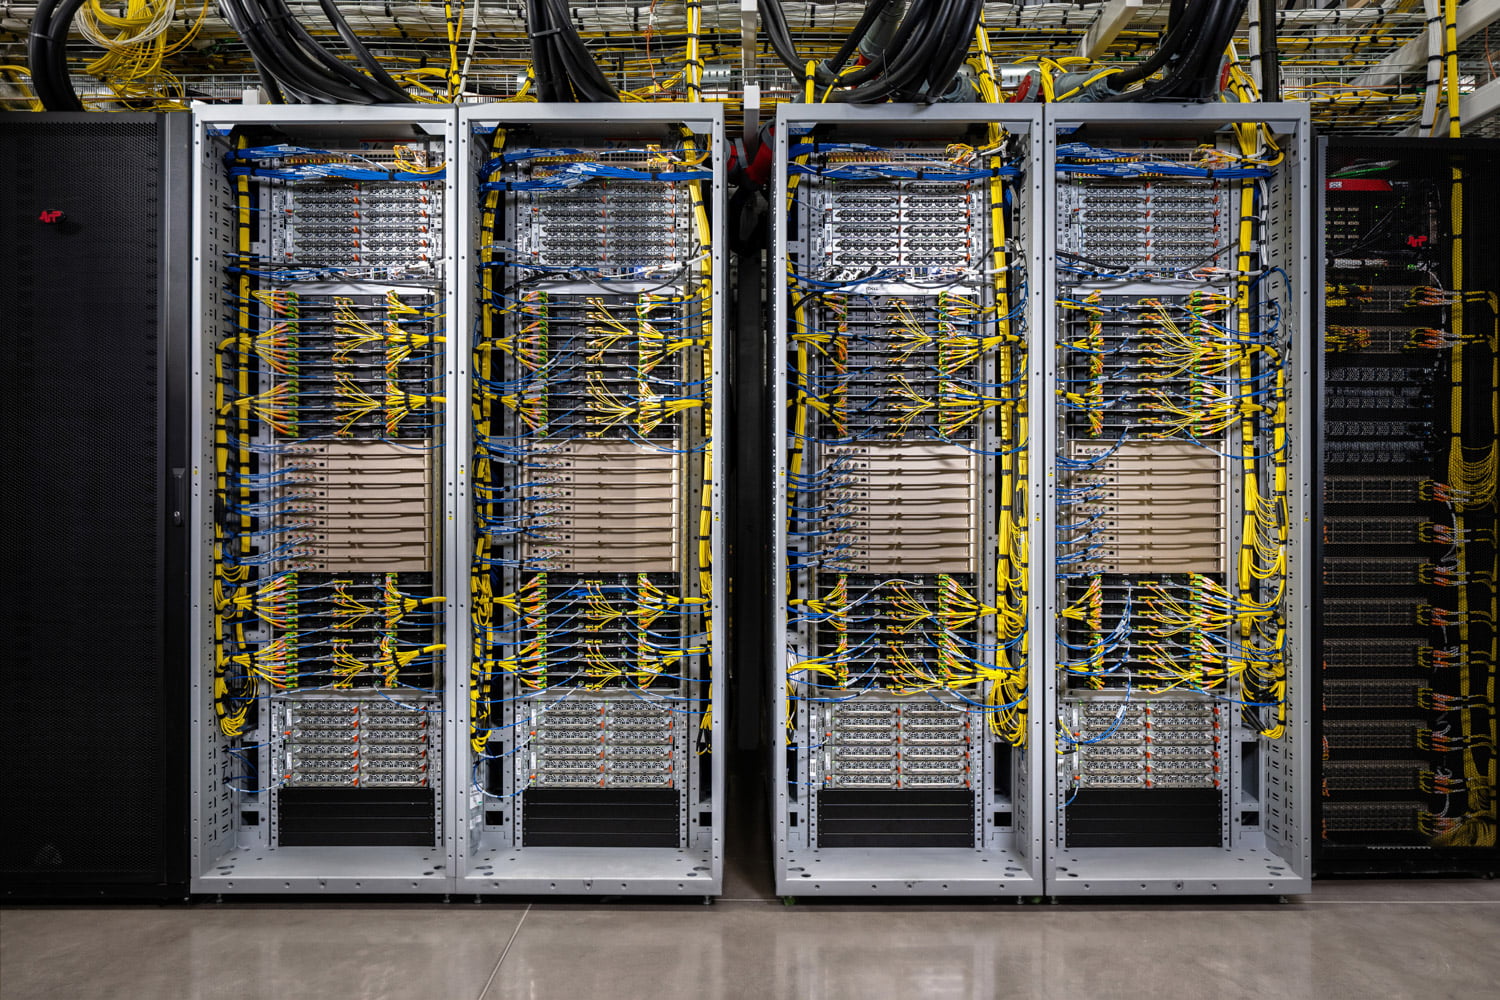
Vera Rubin NVL72, CoreWeave 생산에 진입
Cognition은 CoreWeave에서 Devin에 대한 학습, 강화 학습 및 프로덕션 추론을 실행합니다. CoreWeave는 9월 초에 Vera Rubin NVL72 클러스터를 구축했으며, 랙 인계 후 며칠 만에 Cognition의 워크로드를 실행할 수 있었다고 밝혔습니다. 또한 Cognition의 실행을 고객이 직접 수행한 최초의 Vera Rubin 추론 벤치마크라고 설명했습니다. Cognition은 SWE-2 결과가 GPU당 더 많은 동시 Devin 세션 수와 더 빠른 연구 처리 속도를 의미한다고 강조합니다.
CoreWeave의 보도 자료에 따르면 Vera Rubin NVL72가 출시되었습니다. 하지만 CoreWeave의 Cognition 배포 관련 블로그 게시물에서는 공급이 제한적이라고 언급했으므로 당분간 할당이 제한될 것으로 예상됩니다. 고객은 CoreWeave의 GB200 NVL72 및 GB300 NVL72 플릿과 동일한 소프트웨어 및 운영 모델(CoreWeave Kubernetes Service, SUNK, Mission Control, Sandboxes 및 서버리스 추론)을 통해 Vera Rubin NVL72를 실행할 수 있습니다.
델에서 제작한 NVL72 랙(GPU당 두 개의 ConnectX-9 SuperNIC 탑재)과 랙이 실제 운영 환경에 배포되기 전에 CoreWeave가 수행하는 단계별 검증 과정은 지난 9월 멀티랙 구축 기사 에서 다뤘던 내용입니다 . 이번 기사의 새로운 소식은 해당 랙을 사용하는 유료 고객이 생겼다는 것입니다.
NVIDIA Vera CPU 타겟 에이전트 샌드박스 밀도
CoreWeave는 에이전트 기반 작업(샌드박스 실행, 강화 학습 환경, 도구 호출, 코드 실행, GPU 학습 및 추론 작업 관련 데이터 처리 등)을 위한 독립형 컴퓨팅 계층으로 NVIDIA Vera CPU를 포트폴리오에 추가할 예정입니다. 출시일은 "곧 출시 예정"이라는 말 외에는 구체적인 정보가 공개되지 않았습니다.
CoreWeave 기반 Vera 노드는 88코어 Vera CPU 두 개와 1.5TB RAM, 15.36TB 로컬 NVMe 스토리지, 그리고 800Gbps 속도의 BlueField-4 DPU로 구성됩니다. 전체 랙에는 128개의 CPU와 11,264개의 코어, BlueField-4 DPU, 그리고 Spectrum-X 이더넷 스위칭이 탑재되며, CoreWeave에 따르면 11,000개 이상의 동시 격리 환경을 지원합니다. CoreWeave는 자체 테스트에서 Vera 기반 에이전트 샌드박스 시작 속도가 공개되지 않은 x86 CPU보다 3배 이상 빠르다고 보고했습니다. Vera는 GPU 플릿과 동일한 플랫폼 및 소비 모델(스팟 용량 포함)로 베어메탈 환경에서 실행될 예정입니다.
CoreWeave Forge는 개발과 생산을 연결합니다.
이번 전시회에서 출시된 CoreWeave Forge는 가중치 및 편향 모델, OpenPipe의 학습 후 처리 기능, 그리고 오픈 소스 Marimo 노트북 프로젝트를 모델 및 에이전트 개발을 위한 하나의 레이어로 통합합니다. 실험 추적, 평가, 에이전트 추적, 체크포인트, 샌드박스 실행, 학습 후 처리, 추론 배포 등의 기능을 제공하며, CoreWeave는 다양한 모델, 프레임워크, 그리고 다른 클라우드 환경에서도 사용 가능하다고 밝혔습니다. MasterClass와 Canva는 이미 CoreWeave Forge를 기반으로 개발에 착수했습니다.
Forge는 무료, Pro, Enterprise 에디션으로 제공되며, Pro 에디션은 월 60달러부터 시작하고 30일 무료 체험판을 이용할 수 있습니다. 현재 정식 출시된 기능은 ARIA, 샌드박스, 가중치 및 편향 모델, 서버리스 SFT, 서버리스 RL, 레지스트리, 노트북, 그리고 서버리스 및 전용 추론입니다. 미리 보기로 제공되는 기능은 에이전트 렌즈, 모델 증류, 그리고 RL 롤아웃입니다. RL 롤아웃을 사용하면 학습 루프가 계속 실행되는 동안 체크포인트를 실제 배포 환경에 로드할 수 있습니다.
CoreWeave의 발표에 따르면 Agent Lens는 익명의 범용 최첨단 LLM과 비교했을 때 심각한 오류를 20% 더 많이 감지하고 비용을 10분의 1로 줄여 문제를 해결한다고 합니다. 하지만 회사 블로그 게시물에서는 비용을 절반으로 낮춘다고 언급했으므로 이 수치는 참고용으로만 보는 것이 좋습니다. 서버리스 강화 학습은 자체 관리형 환경보다 1.4배 빠른 학습 속도와 40% 낮은 비용을 제공한다고 주장합니다. 하지만 두 경우 모두 워크로드, 모델, 하드웨어 및 방법론에 대한 구체적인 정보는 제공되지 않았습니다.
파트너 네트워크 및 임상 추론 배포
오늘부터 이용 가능한 CoreWeave 파트너 네트워크는 인프라, 데이터 서비스, ISV, 보안, 모델 및 추론 전반에 걸쳐 CoreWeave가 실제 운영 환경에서 테스트를 거치고 고객 요구에 따라 검증한 통합 기능을 제공합니다. 주요 파트너로는 CrowdStrike, VAST Data, Reflection, ClickHouse, LanceDB, Inferact, RadixArk, IBM, Red Hat 등이 있습니다. Exa, Parallel Web Systems, You.com은 CoreWeave에서 호스팅되는 에이전트용 공유 검색 통합을 통해 참여하며, 이 기능은 발표 후 몇 주 내에 출시될 예정입니다. CoreWeave의 핵심은 고객이 기존 서비스 레이어, 관찰 가능성, 런북 및 보안 도구를 그대로 유지하면서 워크로드를 클라우드로 이전할 수 있다는 점입니다.
연간 약 5만 명의 환자에게 15개 주에 걸쳐 가정 방문 1차 진료, 완화 치료 및 호스피스 서비스를 제공하는 Ennoble Care는 임상 AI 추론을 위해 CoreWeave 클라우드를 선택했습니다. 이 시스템은 CoreWeave Kubernetes Service(CKS)를 통해 NVIDIA RTX PRO 6000 Blackwell Server Edition 노드에서 실행되며, 하드웨어 기반 격리 및 임상 데이터에 대한 제로 트러스트 제어, 그리고 직접적인 엔지니어링 지원이 포함됩니다. CoreWeave는 플랫폼, 워크로드 또는 테스트 구성을 명시하지 않고도 CKS가 일반적인 클라우드 대안보다 8~10배 빠른 속도로 컨테이너를 생성할 수 있다고 주장합니다.


 아마존