

마이크로소프트는 오늘 OCP 글로벌 서밋에서 자사 자체 개발 추론 가속기인 Azure Maia 300을 공개했습니다. 이는 3세대 제품으로, 멀티 칩렛 형태로 설계된 최초의 제품입니다. 각 가속기는 TSMC N2P 컴퓨팅 다이와 8개의 HBM4 스택을 결합하여 288GB 메모리를 제공하며, 950W TDP 내에서 18TB/s의 처리량을 자랑합니다. Maia 300 랙은 167kW의 전력 소비로 96개의 가속기를 수용할 수 있습니다. 마이크로소프트는 Maia 300이 주요 GPU 기반 시스템보다 메가와트당 40% 더 많은 토큰을 처리하고, 랙 규모 토큰 처리량은 Maia 200보다 최대 7배 높다고 주장합니다. 마이크로소프트는 이를 수 기가와트 규모의 Maia 구축 사업의 일환으로 2027년부터 상용 배포를 시작할 예정입니다.
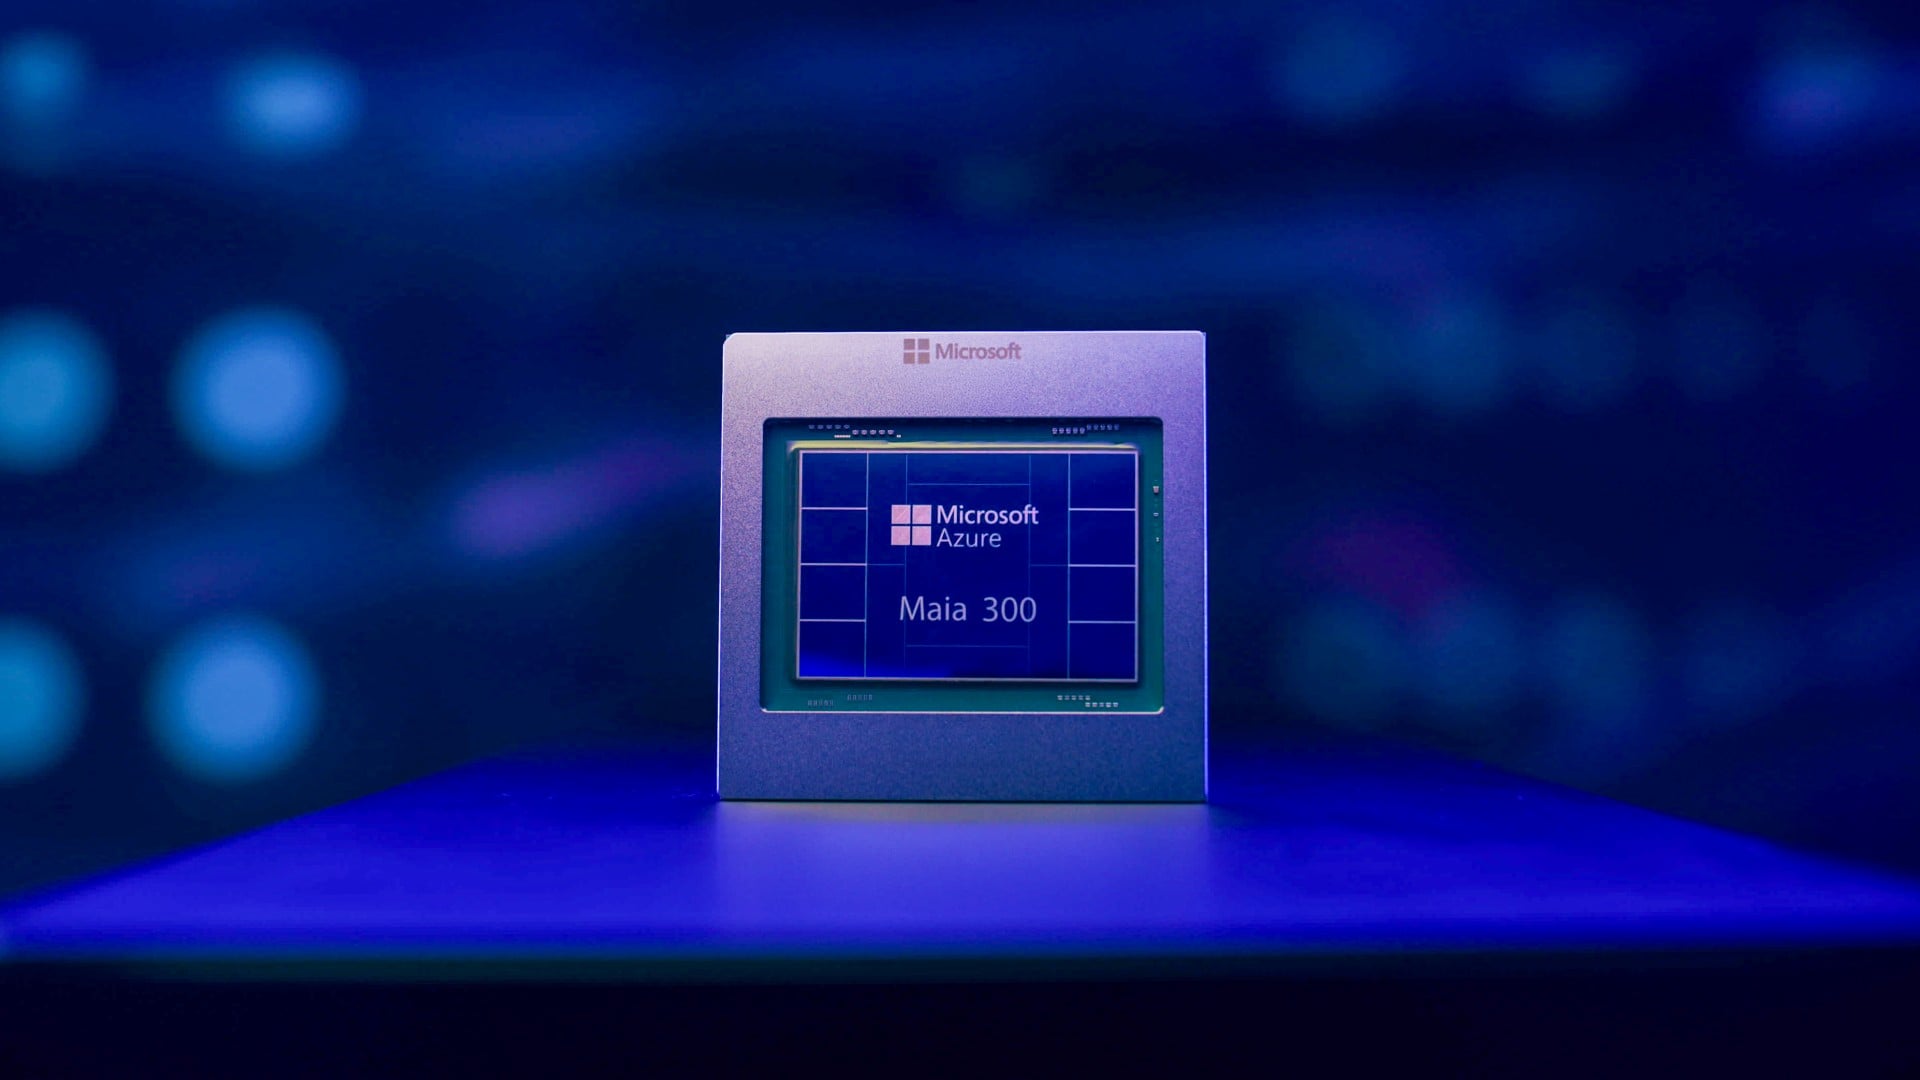
Maia 300 실리콘: N2P 컴퓨팅 다이, 8개의 HBM4 스택, 32개의 400G 포트
Maia 200은 6개의 HBM3E 스택을 갖춘 단일 N3P 다이였습니다. Maia 300은 설계를 N2P 기반의 메인 컴퓨팅 다이, 2개의 I/O 다이, 그리고 4개의 메모리 다이로 분리했으며, 8개의 HBM4 스택을 통해 용량은 216GB에서 288GB로, 대역폭은 7.1TB/s에서 18TB/s로 향상되었습니다. 최대 컴퓨팅 성능은 FP4에서 13.8 POPS, FP8에서 6.9 POPS로 소폭 향상되었는데, 이는 이전 세대의 10.1 POPS와 5.1 POPS에서 증가한 수치입니다. 따라서 FP4 컴퓨팅 성능은 37% 향상되었고, 메모리 대역폭은 2.5배 증가했습니다. 마이크로소프트는 이 칩에 대해 대역폭은 2.5배, 용량은 33% 증가했으며, 전력 효율(와트당)은 Maia 200의 약 2배라고 요약했습니다.
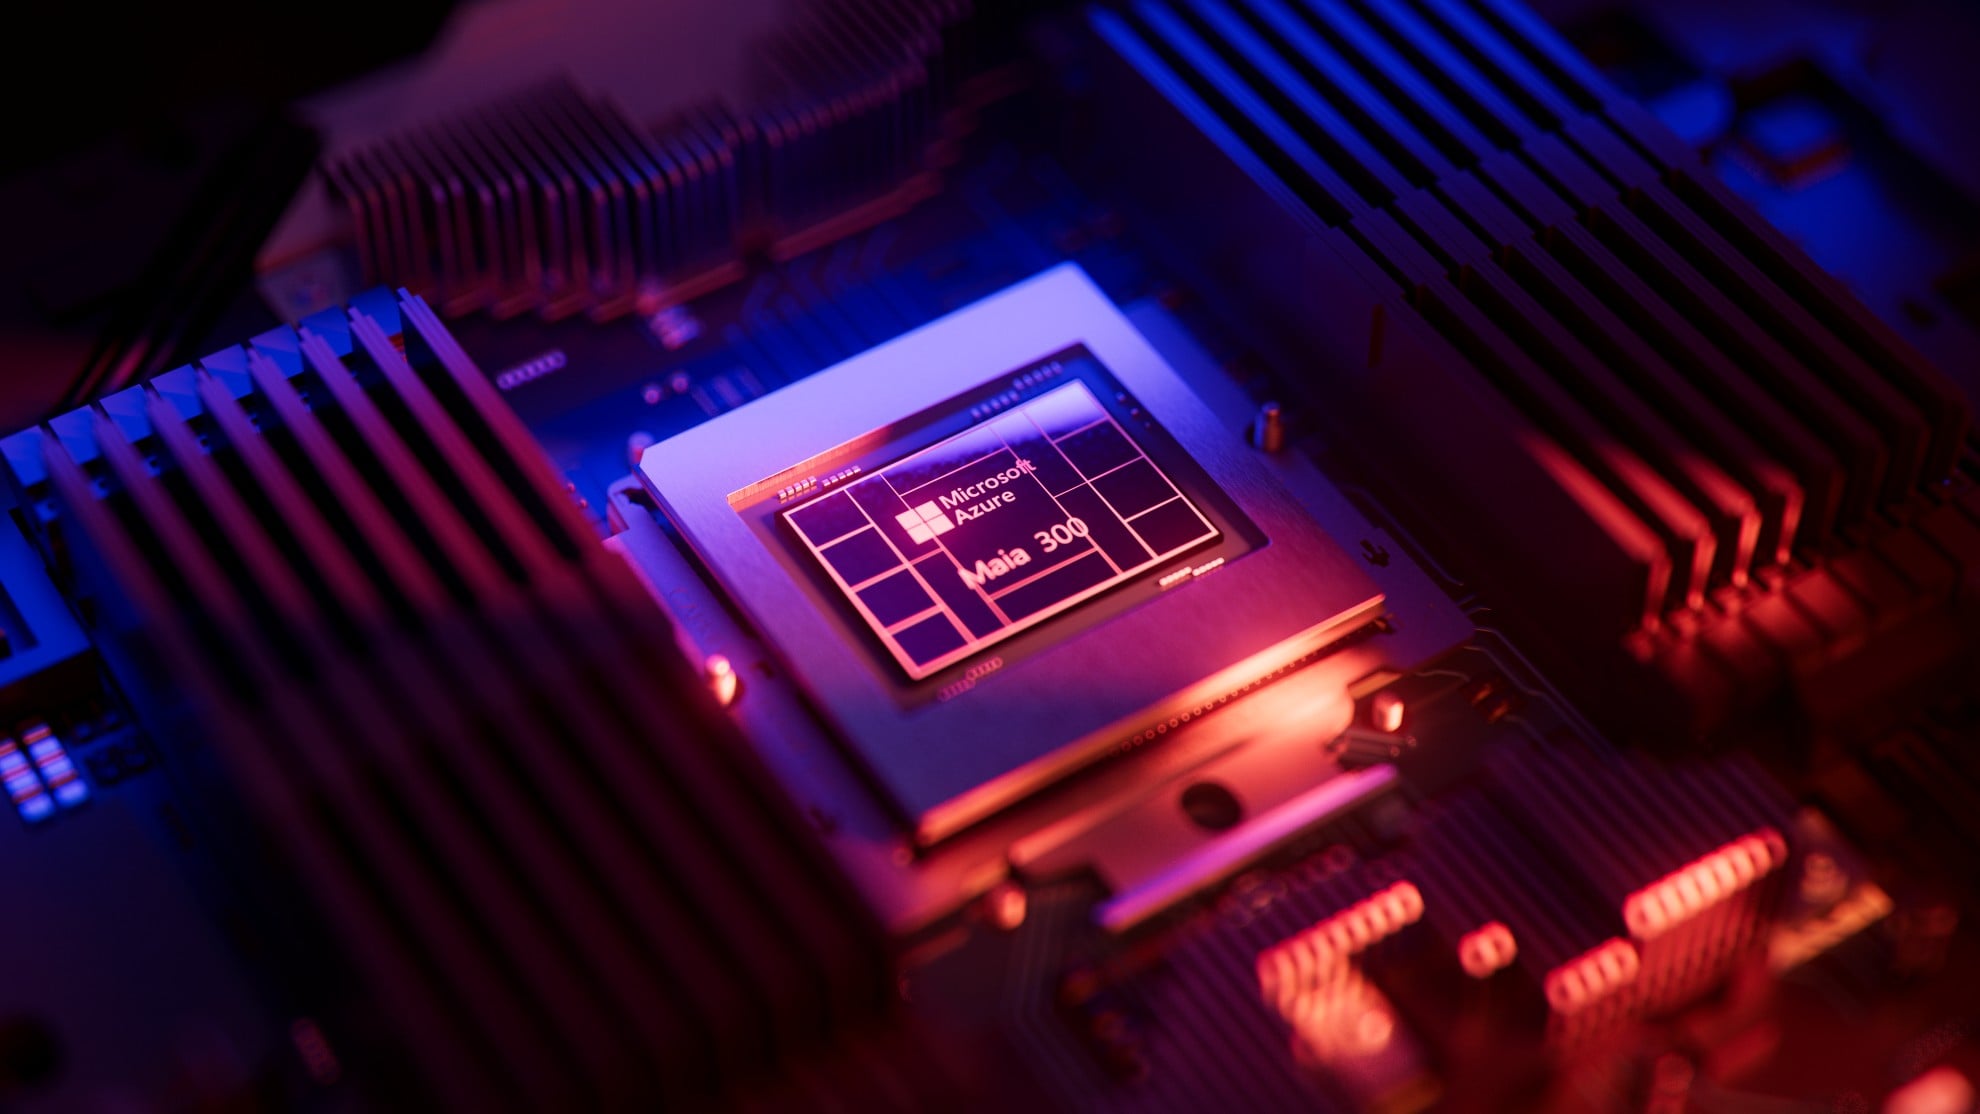
컴퓨팅 영역은 12개의 타일로 구성된 4개의 클러스터로 이루어져 있으며, 각 타일에는 텐서 유닛, 벡터 프로세서, 리셰이퍼, DMA 엔진 및 로컬 SRAM이 탑재되어 있습니다. 그 위에는 공유 클러스터 SRAM과 온칩 네트워크(NOC)가 있습니다. 마이크로소프트는 이러한 방식을 소프트웨어 정의 데이터플로우 아키텍처라고 부릅니다. 소프트웨어가 로컬 메모리, DMA 엔진 및 네트워크를 통해 데이터를 배치합니다. 이 SoC는 호스트에 PCIe Gen6 x16 슬롯을 제공하고, 온칩 AI 네트워크 컨트롤러(확장형 패브릭)를 통해 32개의 400Gb/s 이더넷 포트를 제공합니다.
Maia 300에서는 메모리 구성이 칩렛 전체에 걸쳐 균일 액세스 방식에서 NUMA 레이아웃으로 변경되어 데이터를 사용하는 연산 영역 근처에 배치할 수 있게 되었습니다. 또한 향상된 MXFP4와 하드웨어 데이터 유형 변환을 통해 정밀도가 더욱 낮아져 연산 영역과 KV 캐시 스토리지 모두에서 토큰당 이동되는 바이트 수를 줄이는 것을 목표로 합니다. 커널은 온칩 SRAM을 소프트웨어로 관리되는 스크래치패드로 사용하여 HBM 트래픽을 줄일 수도 있습니다. 마이크로소프트는 이러한 변경 사항 덕분에 와트당 성능이 향상되었다고 주장하며, TDP는 750W에서 950W로 증가했지만 와트당 성능은 2.5배 이상 향상되었다고 밝혔습니다.
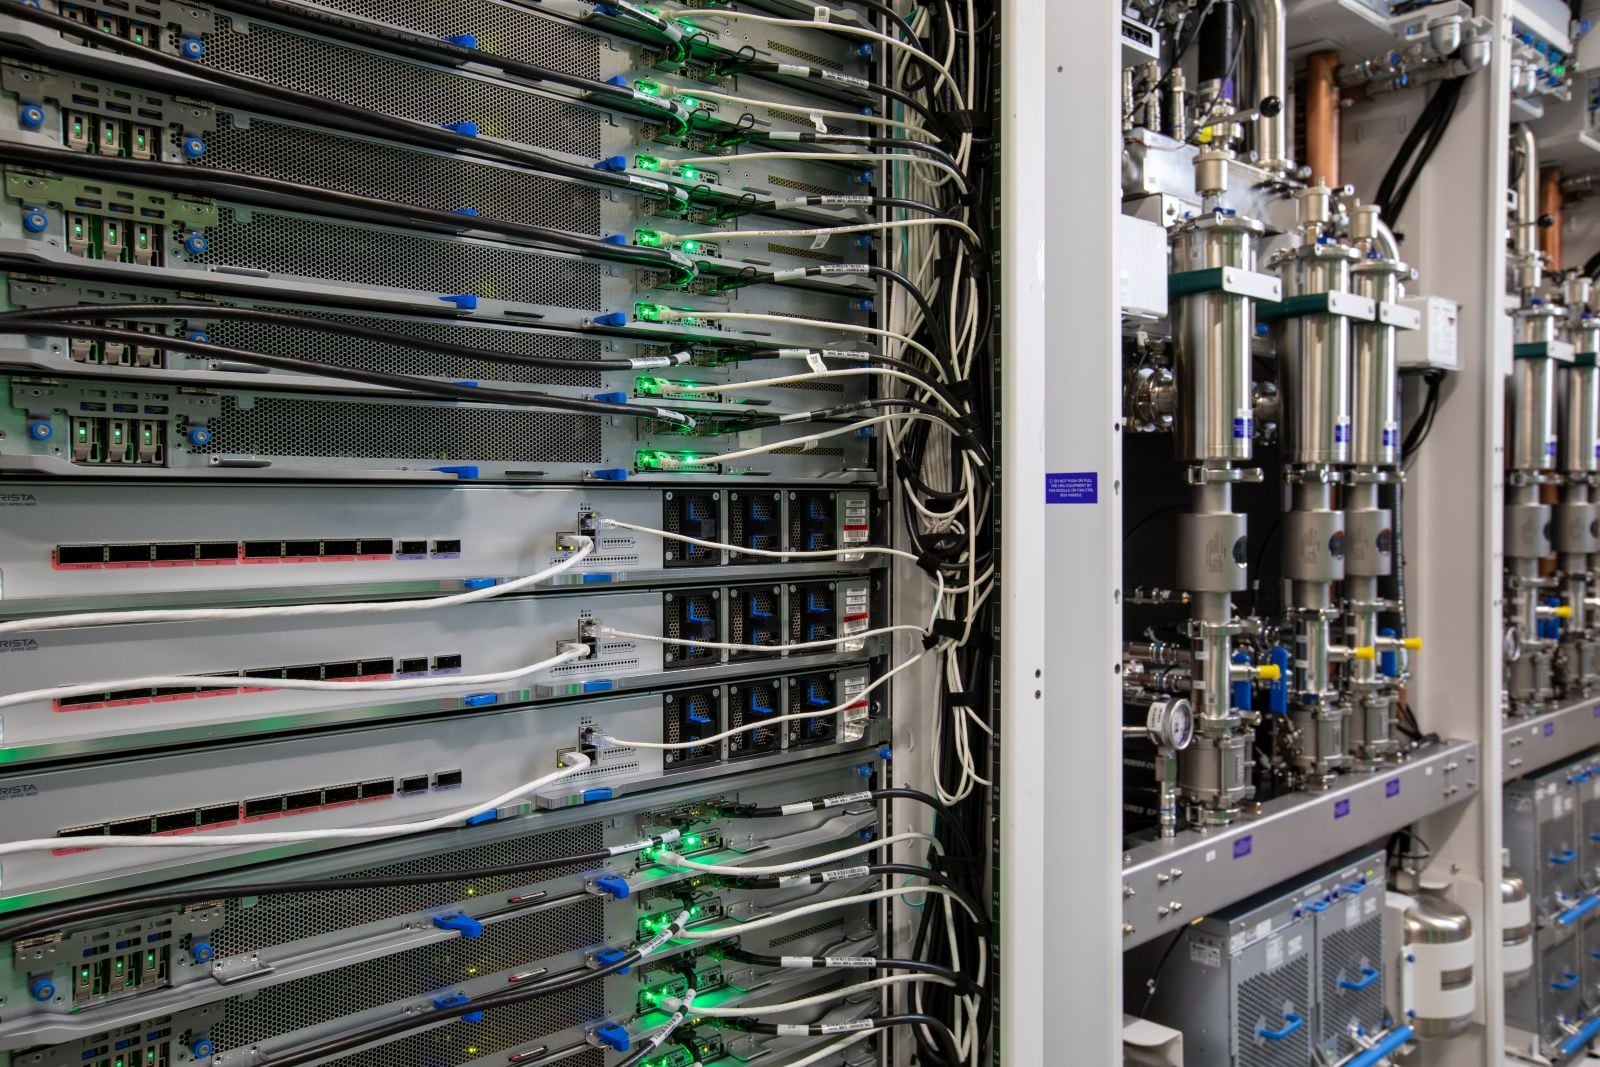
랙당 96개의 액셀러레이터, 슈퍼포드에는 총 12,288개가 장착됩니다.
Maia 300 랙은 가속기 수를 96개로 두 배로 늘리고 랙 전력을 64kW에서 167kW로 향상시킵니다. 네트워킹, 냉각 및 전력 변환을 포함하면 가속기 슬롯당 약 1.74kW의 전력이 소모됩니다. Microsoft의 자료에 따르면, 랙 전체에 걸쳐 27.6TB의 HBM 저장 용량, 1,728TB/s의 HBM 대역폭, 그리고 1,324 POPS의 FP4 처리량을 제공합니다. 이는 Maia 200 랙의 10.4TB, 341TB/s, 485 POPS와 비교됩니다. 가속기당 양방향 확장 대역폭은 2.8TB/s에서 3.2TB/s로 증가하며, Microsoft의 맞춤형 AI 전송을 사용하는 2계층 이더넷 확장 네트워크는 이제 최대 12,288개의 가속기로 구성된 슈퍼포드를 지원할 수 있습니다. 이는 이전 세대의 약 6,000개에서 두 배로 증가한 수치입니다.
마이크로소프트의 랙 다이어그램은 스케일업 패브릭을 통해 여러 랙에 분산된 작업과, 각 샤드 간의 전문가 병렬 트래픽을 보여줍니다. 이는 대규모 전문가 혼합 모델이 서비스 시점에 생성하는 트래픽 패턴입니다. 마이크로소프트는 동일한 통신 모델이 슈퍼포드 내의 모든 가속기에 적용된다고 밝혔으므로, 16개의 가속기를 사용하는 작업과 4개의 랙에 걸쳐 있는 작업은 동일한 의미 체계를 사용합니다.
마이아 300 사양
| 스펙 | 마야 300 | 마야 200 |
|---|---|---|
| 가속 자 | ||
| 방법 | 멀티 칩렛, N2P 컴퓨팅 다이 | 모놀리식 N3P |
| FP4 피크 | 13.8 팝스 | 10.1 팝스 |
| FP8 피크 | 6.9 팝스 | 5.1 팝스 |
| SoC TDP | 950W | 750W |
| HBM | 8 x HBM4, 288GB, 18TB/s | 6 x HBM3E, 216GB, 7.1TB/s |
| 호스트 인터페이스 | PCIe 6세대 x16 | 명시되지 않음 |
| 확장 대역폭(양방향) | 3.2TB/초 | 2.8TB/초 |
| 백엔드 네트워크 | AI 전송 기능을 갖춘 2단계 이더넷 확장, 32 x 400Gb/s | AI 전송을 활용한 2단계 이더넷 확장 |
| 랙 및 스케일업 도메인 | ||
| 랙당 가속기 수 | 96 | 48 |
| 랙 전원 | 167kW | 64kW |
| 랙 HBM 용량 | 27.6TB | 10.4TB |
| 랙 HBM 대역폭 | 1,728TB/초 | 341TB/초 |
| 랙 FP4 피크 | 1,324 팝스 | 485 팝스 |
| 스케일업 도메인 | 약 12,288개의 가속기 | 약 6,000개의 가속기 |
마이아 300은 어떤 위치에 있으며, 주장의 근거는 무엇인가?
Maia 200은 현재 Microsoft Copilot 및 MAI 모델 팀에서 사용되고 있으며, GitHub Copilot과 Microsoft Foundry도 연말까지 Maia 200으로 전환될 예정입니다. Microsoft는 미국, 유럽, 호주 전역에 Maia 200을 배포하고 있으며, Teams, Copilot 및 Cowork에 내장된 AI 기능을 위해 자사 GPU 인프라보다 와트당 최대 1.7배 더 많은 토큰을 제공한다고 밝혔습니다.
마이크로소프트의 클라우드 및 AI 부문 총괄 부사장인 스콧 거스리는 마이아 300 발표에서 "2027년부터 Azure Maia 제품군을 수 기가와트 규모로 확장하여 마이아를 마이크로소프트 제품 및 서비스의 주요 추론 시스템으로 만들 계획"이라고 밝혔습니다. NVIDIA와 AMD는 여전히 마이크로소프트의 학습용 GPU로 사용되고 있으며, 마이크로소프트는 마이아를 Azure 고객이 임대할 수 있는 인스턴스 유형으로 제공하지 않습니다. 주요 효율성 주장인 "주요 GPU 기반 시스템보다 메가와트당 40% 더 많은 토큰"은 사용된 GPU, 모델 또는 서비스 구성에 대한 구체적인 정보를 제공하지 않으며, 마이아는 마이크로소프트 내부에서만 실행되므로 회사 외부에서는 테스트할 수 없습니다.
공개된 사양은 설계를 뒷받침합니다. 가속기당 메모리 대역폭은 2.5배 증가했고, FP4 연산 능력은 37% 향상되었으며, 이 랙은 2.6배의 전력 소비로 Maia 200 랙 대비 5.1배의 HBM 대역폭을 제공합니다. 이 칩은 병목 현상이 연산 장치에 전달되는 장기 컨텍스트 및 에이전트 추론의 디코딩 단계에 최적화되어 있으며, 하이퍼스케일러가 워크로드를 처음부터 끝까지 관리할 때 추론 파트의 크기를 어떻게 결정하는지 보여줍니다. 저희는 1월에 Maia 200 출시 소식을 전해드렸 으며, 마이크로소프트는 11월 Ignite에서 더 자세한 내용을 공개할 예정이라고 밝혔습니다.



 아마존