

NVIDIA는 Vera Rubin NVL72 플랫폼을 보완하도록 설계된 전용 대화형 추론 가속기인 NVIDIA Groq 3 LPX 의 양산 버전을 발표했습니다 . 기업 AI 워크로드가 단순한 모델 사전 학습에서 실시간 추론 및 자율 에이전트 오케스트레이션으로 전환됨에 따라 인프라 요구 사항도 변화하고 있습니다. 에이전트 기반 워크플로는 반복적이고 다단계적인 실행을 필요로 하며, 토큰 생성 중 발생하는 지연 시간은 자동화된 추론 경로, 외부 도구 쿼리 및 다중 에이전트 통신 전반에 걸쳐 누적될 수 있습니다.
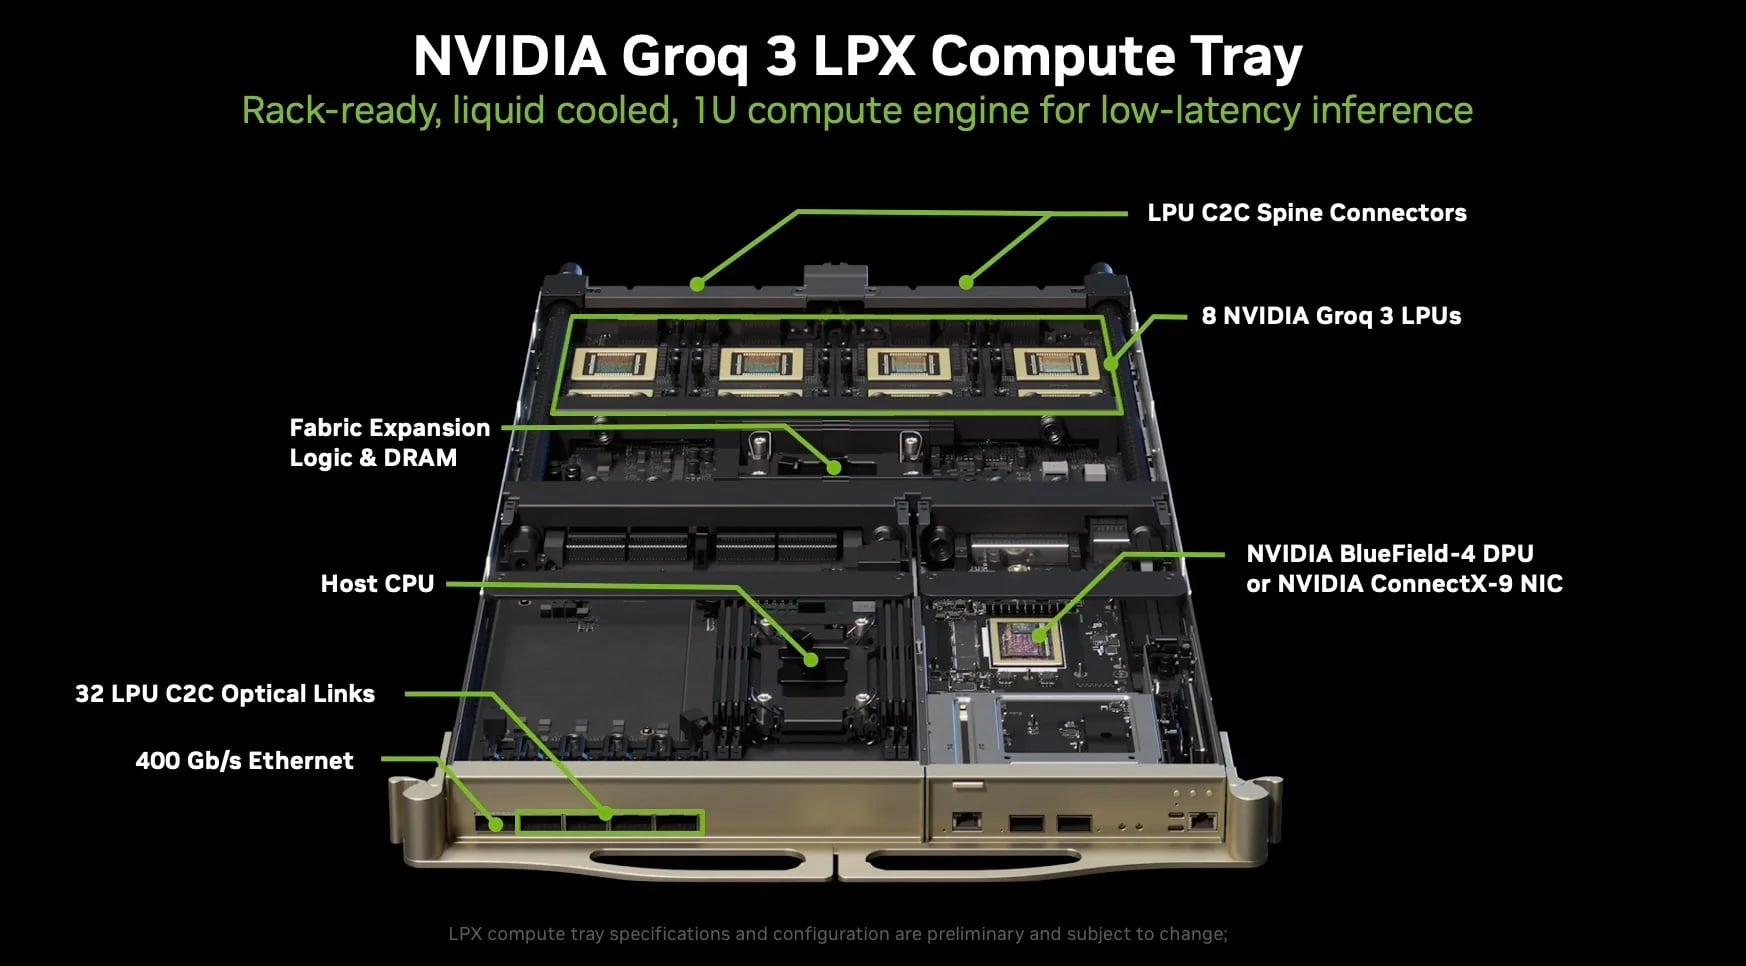
Groq 3 LPX 아키텍처는 특히 디코딩 단계에서 탁월한 성능을 발휘합니다. 각 2U 액체 냉각 컴퓨팅 트레이에는 호스트 CPU, 패브릭 확장 로직 및 DRAM과 함께 16개의 Groq 3 LPU가 탑재되며, BlueField-4 DPU 또는 ConnectX-9 NIC가 제공됩니다. 또한 32개의 LPU 칩 간 광 링크와 400Gb/s 이더넷이 전면에 연결됩니다. Vera Rubin NVL72 시스템과 함께 이기종 환경을 구축할 경우, NVIDIA Rubin GPU는 대규모 입력 데이터 세트에서 컨텍스트 수집 및 사전 채우기 계산을 처리하고, Groq 3 LPX 장치는 지연 시간에 민감한 토큰 출력 생성을 처리합니다.
아키텍처 및 벤치마크 성능
오픈소스 Gemma 4 31B 모델을 10만 토큰 컨텍스트 윈도우에서 실행한 표준 Artificial Analysis 성능 평가에서 Groq 3 LPX는 초당 3,400개의 토큰을 처리하는 속도를 기록했습니다. NVIDIA는 이 처리량이 동일한 장기 컨텍스트 매개변수를 사용하는 다른 플랫폼보다 4배 빠르다고 언급했으며, Artificial Analysis는 이를 해당 모델에서 측정된 가장 빠른 결과로 기록했습니다. 이 비교 결과는 주의 깊게 살펴볼 필요가 있습니다. NVIDIA의 수치는 8월 21일에 측정된 비공개 사전 출시 엔드포인트에서 나온 것이며, 경쟁사의 수치는 실제 서버리스 프로덕션 엔드포인트에서 측정된 것입니다. 10만 토큰 윈도우에서 극도로 빠른 생성 속도를 유지하는 것은 방대한 코드 저장소, 복잡한 API 스키마 및 방대한 기술 문서를 지속적으로 분석하는 엔터프라이즈 에이전트 아키텍처에 필수적입니다.

물리적 시스템 아키텍처 관점에서 볼 때, 랙 규모의 Groq 3 LPX 배포는 고속의 칩 간 직접 연결을 통해 연결된 최대 256개의 LP30 가속기를 포함합니다.
클라우드 배포 및 시스템 생태계
초기 상용화 단계는 전문 클라우드 서비스 제공업체들을 중심으로 진행되고 있습니다. 네비우스(Nebius)는 Groq 3 LPX를 배포하는 최초의 AI 클라우드 파트너로 선정되었으며, 네비우스 토큰 팩토리(Nebius Token Factory) 프로덕션 추론 서비스에 해당 하드웨어를 도입할 계획입니다. 이 아키텍처는 개발자들이 기존 API 인터페이스를 통해 실시간 추론 가속 기능을 활용할 수 있도록 설계되었으며, 코드베이스를 새로운 프레임워크 추상화로 마이그레이션할 필요가 없습니다. 추론 서비스 제공업체인 Groq는 이 플랫폼을 가장 먼저 도입할 기업 중 하나가 될 것으로 예상됩니다.


NVIDIA는 이번 출시와 함께 해당 랙에 적용되는 플랫폼 연산 알고리즘을 업데이트하여, 14만 토큰 규모의 에이전트 코딩 워크로드에서 Vera Rubin NVL72가 GB300 NVL72 대비 메가와트당 토큰 처리량이 최대 30배 향상되었다고 밝혔습니다. 사용자 간 상호작용 목표가 높아질수록 이러한 이점은 더욱 커집니다. 이 하드웨어 구현은 NVIDIA의 풀 스택 Rubin AI 팩토리 인프라에 통합되며, 이 인프라는 5가지 전용 랙 구성에 걸쳐 7개의 개별 칩으로 구성됩니다.
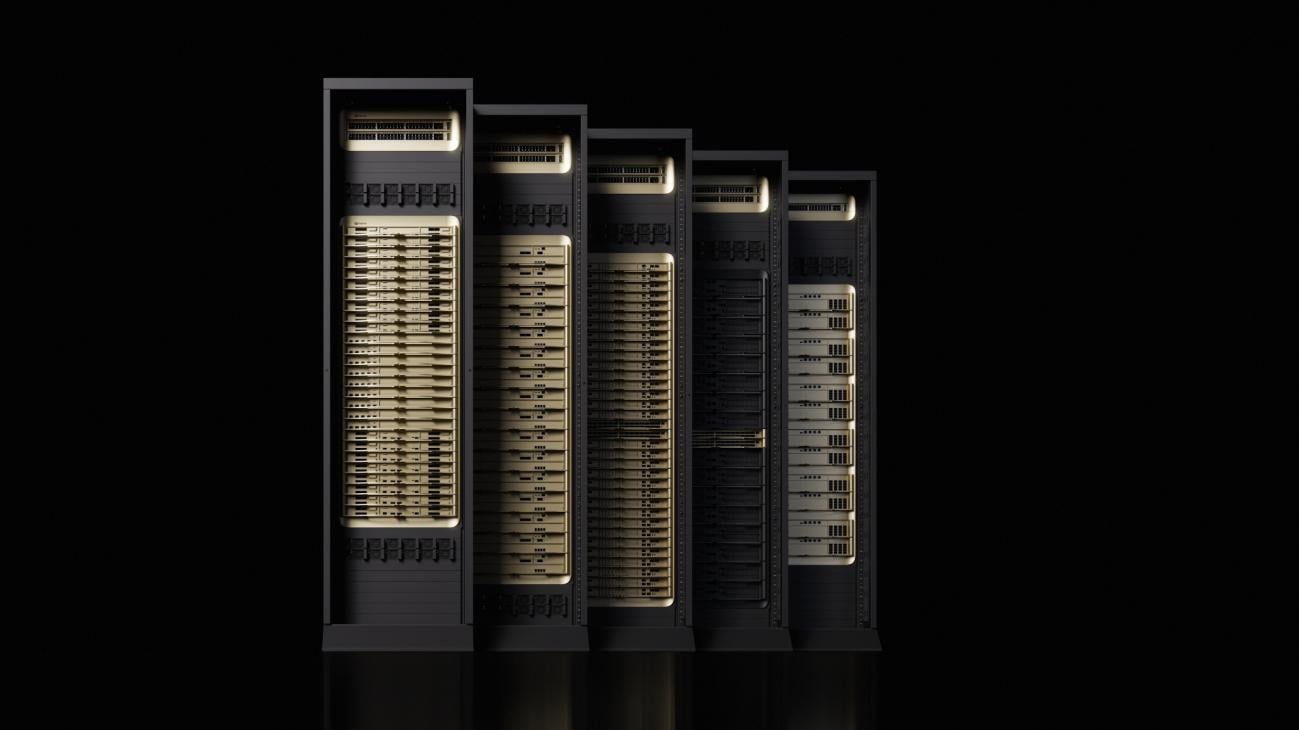
Rubin 및 LPX 컴퓨팅 클러스터와 함께 작동하는 시스템 요소에는 NVIDIA Vera CPU 랙, Vera BlueField-4 STX 스토리지 어레이 및 NVIDIA Spectrum-6 SPX 네트워킹 패브릭이 포함됩니다.
NVIDIA와 Nebius의 입장은 무엇일까요?
“추론은 AI 성장의 원동력입니다. NVIDIA Grace Blackwell과 NVL72는 성능과 효율성 면에서 전례 없는 도약을 통해 대규모 언어 모델 추론에 혁명을 일으켰습니다.”라고 NVIDIA의 창립자 겸 CEO인 젠슨 황은 말했습니다. “Vera Rubin은 에이전트 기반 AI 시대를 위해 설계된 워크로드 최적화 AI 팩토리 구성을 통해 이러한 비전을 확장하고, 초고속 토큰 생성을 위한 LPX로 성능의 한계를 뛰어넘습니다.”
네비우스는 사용자가 실제로 경험하는 지연 시간 측면에서 그 가치를 설명했습니다. 네비우스의 최고 기술 책임자인 다닐라 슈탄은 "추론 과정에서 생성 단계는 AI 시스템의 실제 응답성을 결정하는 중요한 단계이며, NVIDIA Groq 3 LPX는 바로 이 단계를 가속화하도록 설계되었습니다."라고 말했습니다. "네비우스 토큰 팩토리를 통해 이를 상용화하는 최초의 AI 클라우드로서, 개발자들이 이미 사용하고 있는 동일한 API를 통해 에이전트 루프의 모든 단계가 즉각적으로 느껴지도록 보장하고 있으며, 새로운 스택으로 마이그레이션할 필요가 없습니다."
Spectrum-X 멀티플레인 및 스케일인 인프라
NVIDIA는 이러한 대규모 추론 공장의 네트워킹 요구 사항을 지원하기 위해 Spectrum-X 멀티플레인 이더넷 아키텍처를 강조했습니다. 기존 클러스터 확장 방식은 최신 밀도 한계를 넘어서면 세 번째 스위칭 계층을 추가해야 하는 경우가 많은데, 이로 인해 지연 시간 증가, 광 케이블 비용 상승, 전력 소모 증가 등의 문제가 발생합니다. Spectrum-X 멀티플레인은 호스트 네트워크 인터페이스를 여러 개의 독립적인 플레인으로 분할하고, 각 플레인이 512,000개의 GPU까지 확장 가능한 평면형 2계층 네트워크를 실행하도록 설계하여 이러한 문제를 해결합니다.

트래픽 관리 및 장애 완화는 NVIDIA ConnectX-9 SuperNIC에서 실리콘 내에서 처리되며, 102.4Tb/s Spectrum-6 이더넷 ASIC과 결합 시 GPU당 최대 1,600Gb/s의 네트워크 속도를 지원합니다. Spectrum-XGS 이더넷은 동일한 코드 설계를 시설 간에 확장하여 NVIDIA가 다중 사이트 NCCL 집합체의 속도를 1.9배 향상시킨다고 밝혔습니다. 8개 평면 토폴로지에서 하드웨어 장애 조치는 장애가 발생한 경로를 즉시 우회하여 트래픽을 재라우팅함으로써 전체 네트워크 대역폭의 약 90%를 유지합니다. NVIDIA는 하드웨어 복구 속도가 소프트웨어 기반 다중 평면 로드 밸런싱보다 11배 빠르다고 주장하며, 이는 AI 공장 생산성을 1.6배 향상시키는 효과를 가져온다고 설명합니다.

이와 동시에 NVIDIA는 BlueField-4 데이터 처리 장치와 DOCA 소프트웨어 스택을 결합한 Scale-In 네트워킹 기술을 선보였습니다 . Scale-In은 북-남 인프라 패브릭을 대상으로 하며, 멀티테넌트 격리, 회선 속도의 인실리콘 암호화, 원격 측정 및 고성능 스토리지 데이터 경로를 호스트 프로세서에서 오프로드합니다.
맞춤형 실리콘 통합을 위한 NVLink Fusion
NVIDIA는 하이브리드 아키텍처를 필요로 하는 하이퍼스케일 운영자를 위해 NVLink Fusion도 선보였습니다. 이 프레임워크를 통해 타사 맞춤형 XPU 및 CPU를 NVIDIA의 6세대 NVLink 및 NVLink-C2C 스케일업 네트워킹 패브릭에 직접 통합할 수 있습니다. 모듈형 NVIDIA MGX 섀시 설계도와 관리 소프트웨어를 활용하여 데이터 센터 운영자는 전력, 열 및 네트워킹 랙 설계를 표준화하는 동시에 워크로드 변화에 따라 GPU, LPU 및 맞춤형 실리콘의 비율을 조정할 수 있습니다.
NVIDIA는 Hot Chips에서 Vera Rubin 관련 두 번째 발표를 했습니다. SpaceXAI는 Grok의 에이전트 워크로드에 Vera CPU를 채택했으며 , 최적화된 Vera Rubin NVL72를 1세대 Starmind 위성에 탑재하여 궤도에 올릴 계획입니다.


 아마존