

NVIDIA는 GTC 베를린에서 Minerva를 발표했습니다. Minerva는 GPU, 네트워킹, 스토리지, 스케줄러 및 이러한 장치에서 실행되는 AI 워크로드에서 원격 측정 데이터를 수집한 다음 머신 러닝을 적용하여 학습 작업 속도를 저하시키기 전에 성능 저하 구성 요소를 찾아냅니다. Dell Technologies, Lenovo 및 Supermicro는 자사의 AI 팩토리 운영 포트폴리오에 Minerva를 제공할 예정이며, IREN은 이미 Minerva를 사용하고 있고, IBM, Jio, Lambda, Quake AI, Tesla, Aolani 및 Bitdeer AI는 도입을 계획하고 있습니다. NVIDIA는 가격 및 일반 출시일을 아직 발표하지 않았습니다.
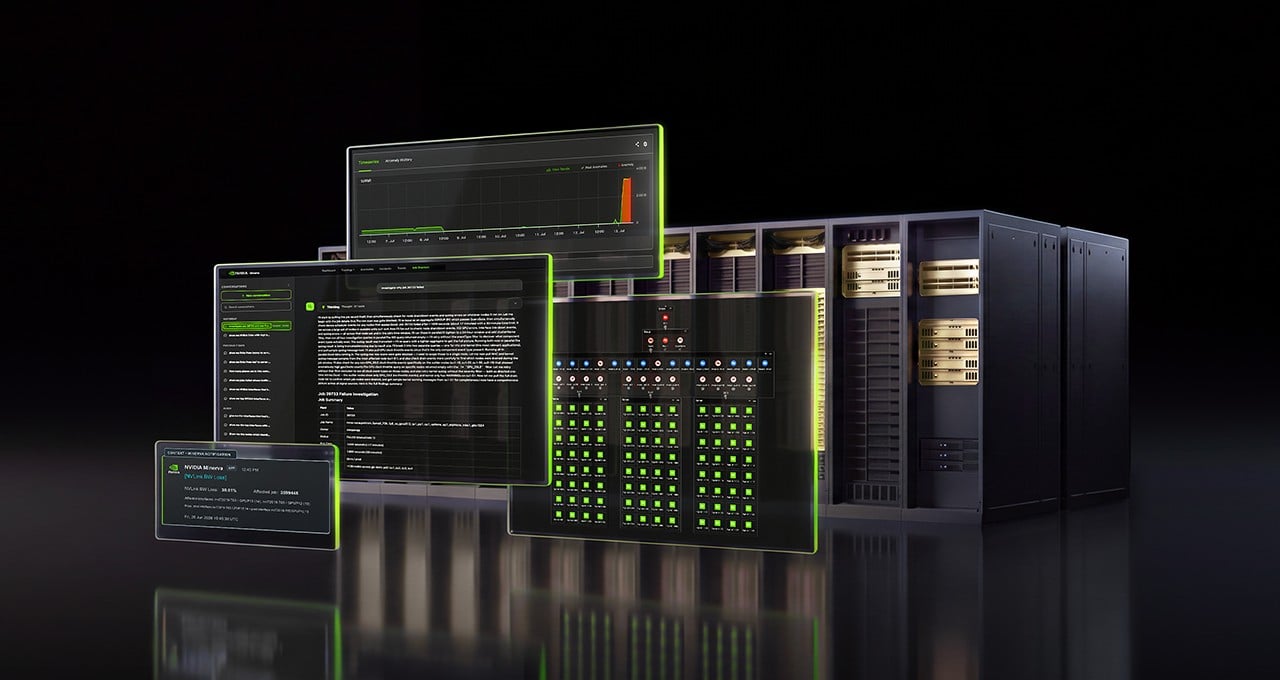
Minerva가 해결하고자 하는 문제는 모든 대규모 클러스터 운영자가 알고 있는 문제입니다. 고속 패브릭에서 수천 개의 GPU가 하나의 머신처럼 작동하기 때문에 특정 부품 하나가 사양을 벗어나면 전체 작업에 악영향을 미칩니다. NVIDIA는 예를 들어, 인접한 GPU보다 온도가 높은 GPU나 부하 시 성능이 저하되는 NVMe 드라이브와 같은 상황을 제시합니다. 이러한 데이터 신호는 현재 네트워킹 도구, 컴퓨팅 도구, 머신러닝 팀의 대시보드 등에서 각각 다른 시각으로 동일한 클러스터를 모니터링하는 데 사용됩니다.
미네르바가 보는 것
Minerva는 GPU, SuperNIC, 스위치, 케이블 및 이러한 요소에 예약된 작업을 매핑하는 동적 지식 그래프를 구축한 다음, NVIDIA가 시간당 수십억 개의 데이터 포인트라고 설명하는 데이터를 지도 학습 및 비지도 학습을 통해 분석합니다. 이 모델은 공장의 정상적인 동작을 학습하고, 이전에 본 적 없는 이상 징후를 표시하고, 발생 가능한 오류를 예측하고, 토폴로지를 사용하여 관련 이벤트를 상호 연관시킵니다. 따라서 수십만 개의 GPU가 있는 NVIDIA 규모의 공장에서 학습 작업 속도가 느릴 경우 해당 구성 요소를 추적할 수 있습니다.
출력은 관련 이벤트가 단일 항목으로 그룹화되고 예상 근본 원인이 첨부되는 사건 단위로 구성됩니다. NVIDIA는 이를 통해 수많은 경고 대신 실행 가능한 단일 항목으로 대응할 수 있다고 설명합니다. 내장된 도우미는 실시간 원격 측정 데이터를 기반으로 자연어 질문에 답변하고 해결 방법을 권장하며, 플랫폼은 외부 에이전트 도구와 연결됩니다. 운영자는 사람이 직접 해결 조치를 적용할지, 아니면 Minerva가 인프라 API 및 외부 시스템을 통해 자동화에 맡길지 선택할 수 있습니다.
NVIDIA는 이를 AI 팩토리 생산량이라는 지표로 설명하며, GPU 사용 시간, 유효 처리량, 클러스터 가동 시간, 토큰 생산량 등을 기준으로 측정합니다. NVIDIA는 이를 통해 서비스 중단 간격이 길어지고, 복구 속도가 빨라지며, 문제 해결을 위한 알림 횟수가 줄어들고, 운영팀이 사후 대응에서 사전 예방적 유지보수로 전환할 수 있다고 주장합니다. 하지만 이는 NVIDIA의 주장일 뿐 구체적인 수치는 공개되지 않았습니다. NVIDIA는 Minerva의 평균 복구 시간이나 가동 시간 수치를 발표하지 않았습니다.
스택에서 위치
NVIDIA는 이미 레퍼런스 디자인용 운영 소프트웨어를 판매하고 있습니다. 2025년 3월에 출시된 Mission Control은 Base Command Manager를 통한 클러스터 프로비저닝, Run:ai를 통한 워크로드 관리, 원격 측정, 그리고 DGX SuperPOD 시스템의 자율 작업 복구를 지원합니다. Minerva 발표와 같은 주에 NVIDIA는 AI 팩토리 수명주기 관리를 위한 세 가지 오픈 소스 DSX OS 구성 요소를 개발자 프리뷰로 공개했습니다. 이 구성 요소에는 네트워크 구성을 위한 Config Manager, 랙 수준의 전원, 인벤토리, 펌웨어 및 스위치 관리를 위한 Rack Management Service, 그리고 분산 워크로드를 사용하여 GPU 클러스터를 검증하는 Cluster Readiness Engine이 포함됩니다.
미네르바가 해결하고자 하는 문제의 규모는 지난주 메타의 프로메테우스 관련 글 에서 여실히 드러났습니다 . 메타는 각 NVL72 도메인을 64개의 GPU로 구성된 슬라이스로 운영하고 나머지 8개의 GPU는 랙 내 예비용으로 보유하며, 전체 랙의 약 2%를 예비로 유지하고, 수리된 모든 시스템은 검증을 통과할 때까지 격리합니다. NVIDIA 엔지니어들과 함께 현장에서 1년간 근본 원인 분석을 진행한 결과, 시스템 중단 횟수를 99% 줄였고, 평균 중단 간격(MTBF)을 54,000 GPU 시간 이상으로 늘렸으며, 목표는 100,000 GPU 시간입니다.
이는 특수 설계된 원격 측정 파이프라인과 NVIDIA와의 공동 문제 해결 팀을 운영하는 하이퍼스케일러입니다. Minerva는 이러한 체계를 패키지화한 버전으로, GPU, 패브릭 및 스토리지 상태에 대한 하이퍼스케일러급 가시성과 예비 및 재시작 워크플로를 원하는 기업이나 네오클라우드 환경에 바로 적용 가능한 솔루션에 가깝습니다. 또한 랙을 판매하는 OEM 업체에서 바로 제공됩니다.
NVIDIA는 Minerva가 Mission Control이나 DSX OS와 어떤 관련이 있는지, 소프트웨어, 어플라이언스 또는 호스팅 서비스 형태로 출시될지, Dell, Lenovo 및 Supermicro의 OEM 패키징이 어떤 모습일지에 대해 언급하지 않았습니다. 제품 설명서 페이지에서는 사용자가 사용자 가이드를 얻으려면 NVIDIA 계정 담당팀에 문의하도록 안내하고 있습니다. NVIDIA는 IREN이 현재 Minerva를 사용하여 AI 공장을 최적화하고 있다고 밝혔습니다.
IREN의 최고 기술 책임자인 데니스 스크리니코프는 "NVIDIA Minerva는 운영팀에게 네트워크 전체, GPU 및 그 위에서 실행 중인 작업에 대한 통합적인 시각을 제공합니다."라고 말하며, 이 덕분에 팀이 사전 예방적 유지 관리에 더 많은 시간을 할애할 수 있게 되었다고 덧붙였습니다.
스토리지 측면에서 흥미로운 점은 부하 시 드라이브 동작이 GPU 및 패브릭 원격 측정 데이터와 함께 입력값으로 사용된다는 것입니다. NVMe 장치의 속도 저하는 체크포인트 또는 데이터 로딩 단계에서 멈추기 전까지는 GPU 사용률에 거의 나타나지 않기 때문입니다. 스토리지 원격 측정 데이터가 얼마나 심층적으로 분석되는지, 그리고 어떤 OEM 및 어레이 플랫폼이 이 데이터를 제공하는지는 이 솔루션이 시장에 출시됨에 따라 자세히 살펴볼 만한 흥미로운 부분입니다.



 아마존