

엔비디아는 컴퓨텍스 2025에서 흥미로운 발표를 쏟아냈습니다. 세미 커스텀 AI 인프라, 엔터프라이즈 AI 팩토리, 누구나 사용할 수 있는 AI 개발 도구, 그리고 휴머노이드 로봇 공학을 위한 고급 플랫폼에 이르는 새로운 기술들을 공개하며, 컴퓨팅 및 산업의 모든 영역에 AI가 융합되는 속도가 크게 빨라질 것임을 예고했습니다.
NVLink Fusion: 반맞춤형 AI 인프라의 새로운 시대를 열다
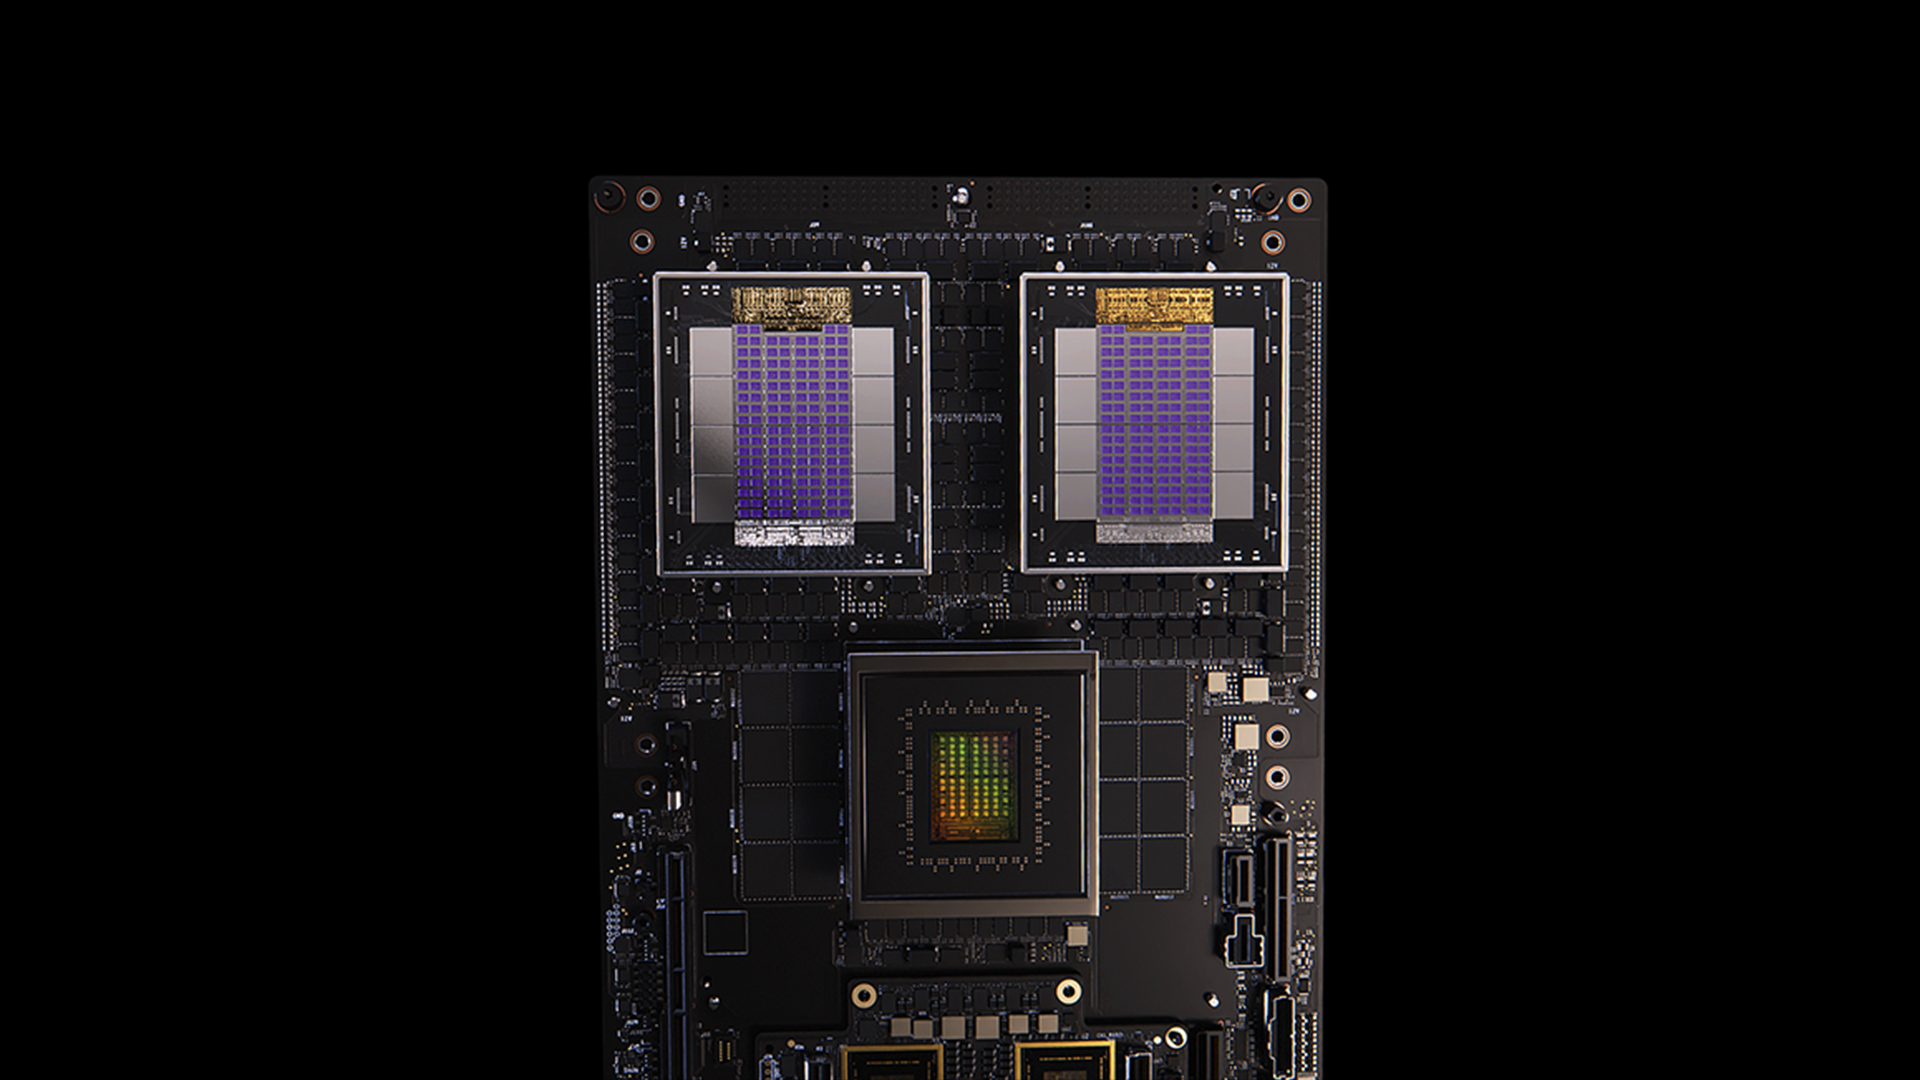
컴퓨텍스에서 엔비디아가 발표한 주요 발표 중 하나는 NVLink를 공개한다는 것이었습니다. 엔비디아는 NVLink Fusion을 통해 업계가 자사의 기술을 엔비디아의 고급 상호 연결 기술과 통합하여 세미커스텀 AI 인프라를 구축할 수 있도록 지원하는 IP와 새로운 실리콘 기반을 제공합니다.
고객은 맞춤형 ASIC을 개발하거나 CPU를 고성능 스케일업 패브릭에 직접 연결할 수 있습니다. 예를 들어, 기업은 C2C 링크를 사용하여 맞춤형 CPU를 NVIDIA GPU와 연결하거나, 반대로 NVLink를 통해 상호 연결된 NVIDIA의 Grace 또는 Vera와 같은 차세대 CPU에 특수 AI ASIC을 통합할 수 있습니다. 현세대 칩 간 인터페이스는 CPU와 GPU 간에 최대 900GB/s의 양방향 대역폭을 제공합니다. 또한, 더욱 확장된 5세대 NVLink 플랫폼은 GPU당 최대 1.8TB/s의 양방향 대역폭을 자랑합니다.

이는 업계에 매우 흥미로운 소식입니다. AI 가속기를 개발하는 기업들은 이제 매력적인 선택권을 갖게 되었습니다. 바로 다음과 같은 새로운 개방형 표준을 선택할 수 있다는 것입니다. UALink개방성을 추구하지만, 현재 NVIDIA의 기존 상호 연결 속도에는 미치지 못하고 있으며 아직 개발 단계에 있습니다. NVLink Fusion을 사용하면 현재 사용 가능한 가장 빠른 스케일업 상호 연결과 통합하여 최첨단 성능과 NVIDIA의 포괄적이고 완성도 높은 소프트웨어 제품군에 즉시 액세스할 수 있습니다.

이미 많은 업계 파트너들이 참여하고 있습니다. 맞춤형 AI 실리콘과 특화 인프라를 구축하기 위해 NVLink Fusion을 채택하는 주요 업체로는 ASIC 및 IP 파트너인 MediaTek, Marvell, Alchip Technologies, Astera Labs, Synopsys, Cadence가 있습니다. 또한 CPU 혁신 기업인 Fujitsu와 Qualcomm Technologies도 NVIDIA GPU 및 NVLink 생태계와 연동되는 맞춤형 CPU를 개발할 계획입니다.
Blackwell Pro 6000 서버: 엔터프라이즈 AI 공장에 활력을 불어넣다

컴퓨텍스에서 엔비디아가 발표한 또 다른 중요한 발표는 엔비디아 RTX PRO 블랙웰 서버를 통해 엔터프라이즈 AI 혁신을 이루는 것이었습니다. 핵심 GPU인 RTX PRO 6000 블랙웰은 워크스테이션과 동일한 견고한 아키텍처를 공유하지만, 보다 표준적인 서버 설계와의 통합은 엔비디아 ConnectX-8(CX8)이라는 독특한 혁신 기술을 통해 크게 향상되었습니다. 젠슨 황은 이를 "스위치가 먼저고 네트워킹 칩은 그 다음"이라고 설명했습니다.

진정한 혁신은 CX8이 서버 내 GPU 간, 그리고 여러 서버 간에 고속 동서 트래픽을 직접 지원하는 방식에 있습니다. 황 대표가 언급했듯이, 이 기능 덕분에 RTX PRO 6000 GPU는 까다로운 추론 워크로드를 효율적으로 처리할 수 있으며, 플래그십 Blackwell GB200 및 GB300 AI 팩토리 시스템의 NVLink에서 볼 수 있는 고대역폭 상호 연결성을 그대로 구현합니다. 기존의 느린 경로를 거치지 않고 GPU 간에 직접 통신하는 이 방식은 RTX PRO Blackwell 서버를 기업 추론 환경에 최적화된 솔루션으로 만들어 줍니다. NVIDIA Dynamo와 같은 소프트웨어와 함께 사용하면 이러한 서버는 매우 효율적이고 확장 가능한 AI 에이전트 배포 및 운영을 제공합니다.

실제 보드도 살펴보았습니다. RTX PRO 6000 Blackwell GPU를 장착할 수 있는 800개의 PCIe 슬롯이 있습니다. 이 슬롯 외에도 메인 마더보드에 연결되는 4개의 PCIe 연결 포트가 있습니다. 그리고 이번 행사의 하이라이트는 8개의 CXXNUMX 칩으로 구동되는 XNUMX개의 XNUMXGbps 네트워킹 연결 포트입니다. 이러한 고속 포트는 강력한 서버 간 통신을 지원하여 기업이 여러 대의 RTX PRO Blackwell 서버를 강력한 클러스터로 네트워킹하여 추론 기능을 확장할 수 있도록 합니다.
마지막으로, 황 CEO는 성능 향상을 강조하며 새로운 RTX PRO Blackwell 서버가 Lama 1.7B 추론에서 Hopper H100 HGX 시스템보다 70배 높은 성능을 제공하는 벤치마크를 발표했습니다. 더욱 인상적인 것은 DeepSeek R1 모델의 경우, Blackwell 서버가 이전 세대의 최첨단 H100보다 XNUMX배 향상된 성능을 보였다는 것입니다. 초당 토큰 수와 사용자당 초당 토큰 수의 이러한 상당한 증가는 서버가 높은 처리량과 낮은 지연 시간의 대화형 AI 작업을 처리할 수 있는 역량을 보여준다는 것을 보여줍니다.
휴머노이드 로봇, 엔비디아 젯슨 토르, 그리고 프로젝트 GR00T: 물리적 AI의 최전선을 개척하다
엔비디아는 급성장하는 휴머노이드 로봇 분야에 대한 계획을 강조하며, "물리적 AI" 개발을 가속화하도록 설계된 엔비디아 아이작 플랫폼의 중요한 발전을 공개했습니다. 젠슨 황에 따르면, 새로운 젯슨 토르 로봇 프로세서는 이제 막 생산을 시작한 이 프로젝트의 핵심입니다. 젯슨 토르는 차세대 휴머노이드 로봇과 자율 시스템을 위한 강력하고 에너지 효율적인 두뇌 역할을 하도록 설계되었습니다.

하드웨어를 보완하는 것은 NVIDIA Isaac GR00T N1.5입니다. 이는 인간형 로봇의 추론 및 기술을 위한 NVIDIA의 개방형 일반화 기반 모델의 업데이트된 버전입니다. 황 CEO는 GR00T N1.5가 오픈 소스로 공개되었으며 수천 건의 다운로드를 기록하며 큰 관심을 모았다고 발표했습니다. 이 모델은 로봇이 복잡한 명령을 이해하고 역동적인 인간 환경에서 다양한 작업을 수행할 수 있는 지능을 제공하는 것을 목표로 합니다.
로봇 공학에서 중요한 과제는 방대하고 다양한 학습 데이터 세트를 확보하는 것입니다. NVIDIA는 NVIDIA Cosmos 물리 AI 세계 기반 모델을 활용한 획기적인 청사진인 Isaac GR00T-Dreams를 통해 이 문제를 해결합니다. Huang은 이를 AI를 활용하여 인간의 시연을 증폭시키는 "실제 데이터 대 실제 데이터 워크플로"라고 설명했습니다. 개발자는 먼저 사람이 원격으로 조작하는 작업 시연을 통해 Cosmos를 미세 조정할 수 있습니다. 그런 다음 GR00T-Dreams를 사용하여 새로운 시나리오나 지침을 모델에 입력하여 로봇이 새로운 동작을 수행하는 수많은 "꿈"이라는 합성 비디오 시퀀스를 생성할 수 있습니다 . 이러한 2D 꿈 비디오는 3D 동작 궤적으로 변환되어 GR00T 로봇 모델을 학습시킵니다. Huang은 "이제 소수의 인간 시연팀이 수천 명의 작업을 수행할 수 있습니다."라고 설명하며 데이터 생성 규모를 획기적으로 확장하는 방식을 강조했습니다.
GitHub에서 시뮬레이션을 위해 오픈소스로 공개된 Isaac Sim, 로봇 학습을 위한 Isaac Lab, Google DeepMind와 Disney Research가 함께 개발한 고급 Newton 물리 엔진, 그리고 Cosmos 세계 모델을 아우르는 이 전체 생태계는 포괄적인 클라우드-로봇 플랫폼을 제공합니다. 황은 "물리적 AI와 로봇 공학이 차세대 산업 혁명을 가져올 것"이라고 전망하며, "브라운필드" 인간 환경에 특화된 휴머노이드 로봇이 잠재적으로 "차세대 수조 달러 규모의 산업"이 될 것이라고 예측합니다.
DGX Spark, Station 및 Cloud Lepton
NVIDIA는 글로벌 클라우드 마켓플레이스부터 강력한 개인용 AI 슈퍼컴퓨터까지 DGX 제품에 대한 주요 업데이트를 통해 고성능 컴퓨팅에 대한 액세스를 지원하기 위한 노력을 계속했습니다.
중요한 신규 이니셔티브 중 하나는 NVIDIA DGX Cloud Lepton입니다. 이 AI 플랫폼은 전 세계 AI 개발자들을 수만 개의 GPU와 연결하도록 설계된 컴퓨팅 마켓플레이스를 갖추고 있습니다. 이 플랫폼은 CoreWeave, Crusoe, Foxconn, SoftBank Corp.와 같은 NVIDIA 클라우드 파트너의 글로벌 네트워크에서 클라우드 AI 서비스와 GPU 용량에 대한 액세스를 통합하는 것을 목표로 합니다. 이러한 파트너들은 DGX Cloud Lepton 마켓플레이스에서 NVIDIA Blackwell을 비롯한 NVIDIA 아키텍처 GPU를 제공합니다. 개발자는 온디맨드 및 장기적인 요구에 맞춰 특정 지역의 컴퓨팅 용량을 활용하여 전략적이고 독립적인 AI 운영을 지원할 수 있습니다. DGX Cloud Lepton은 NIM 및 NeMo 마이크로서비스를 포함한 NVIDIA 소프트웨어 스택과 통합되어 AI 애플리케이션 개발 및 배포를 간소화하고, NCP와 협력하여 전 지구적 규모의 AI 팩토리를 구축합니다.
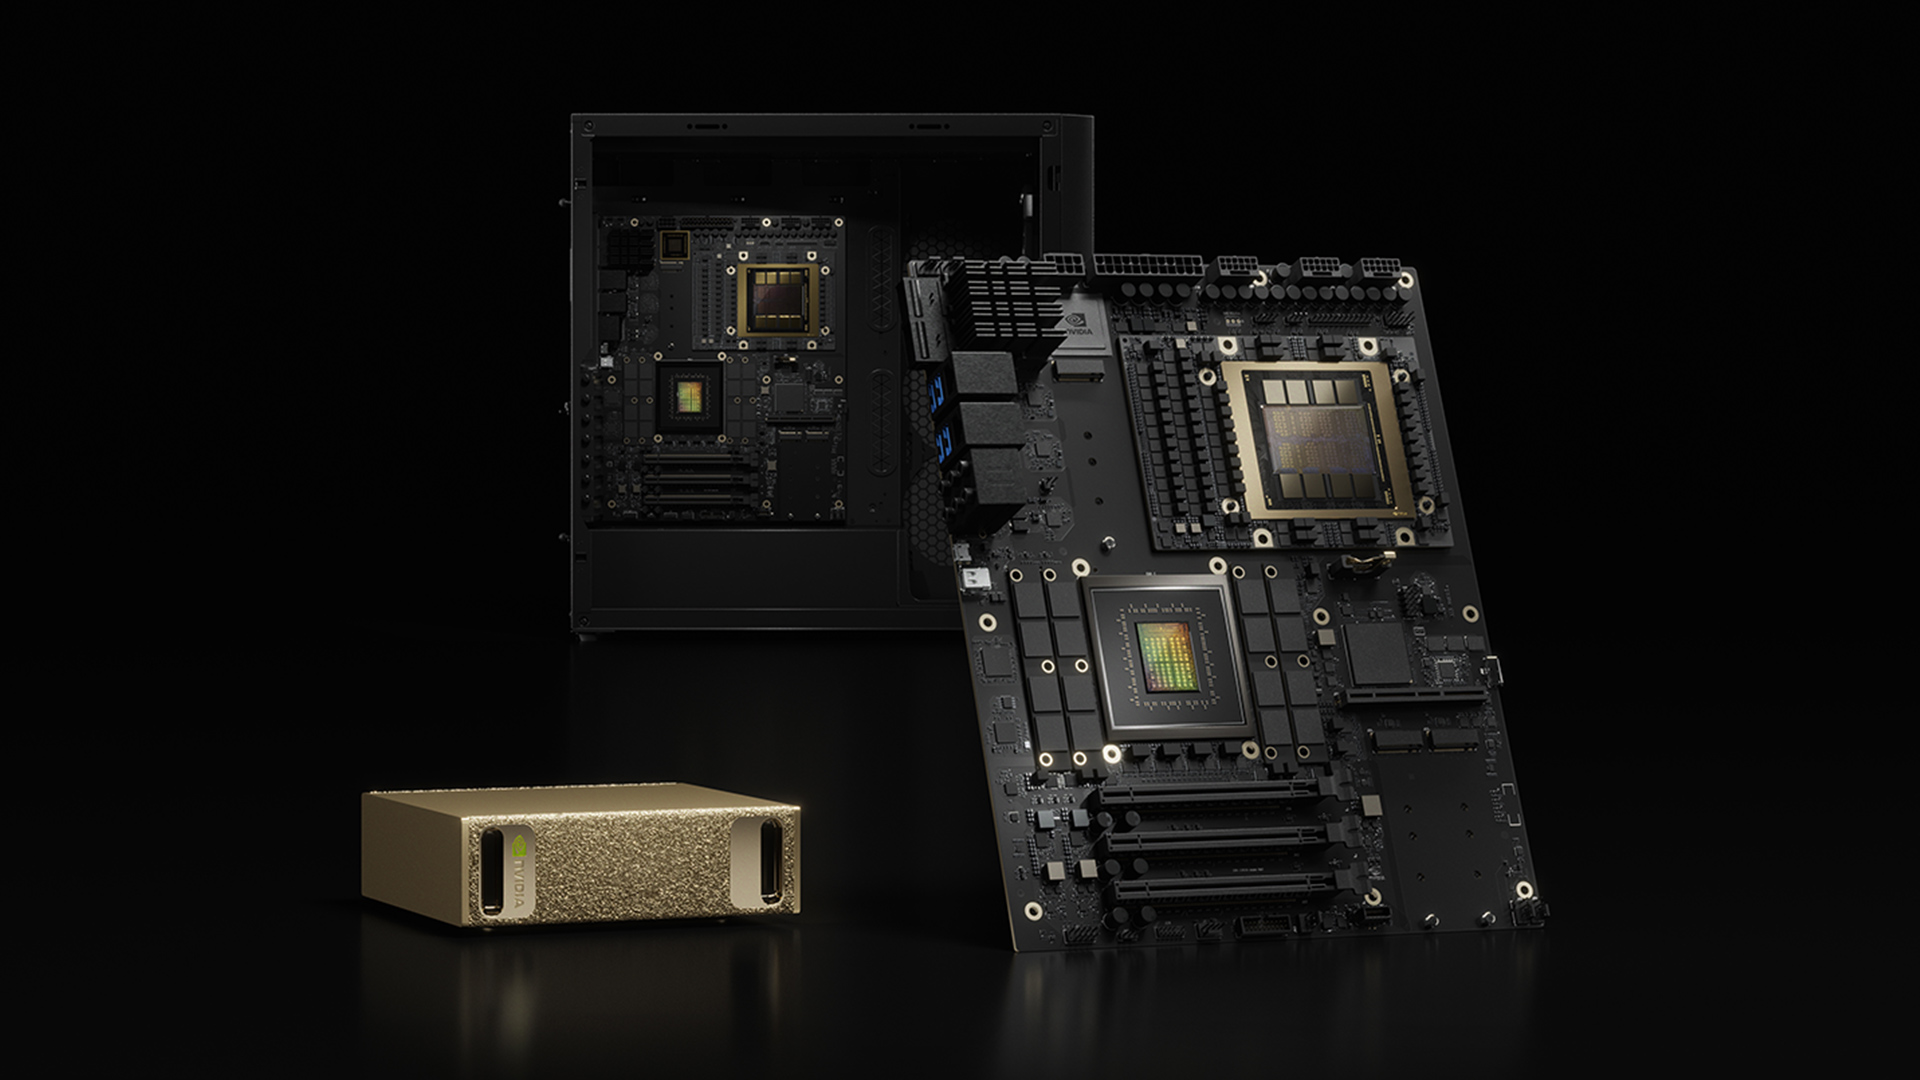
DGX Cloud Lepton이 광범위한 클라우드 접근성에 중점을 두는 반면, NVIDIA는 개인용 AI 슈퍼컴퓨터인 NVIDIA DGX Spark와 DGX Station의 확장된 생태계를 강조했습니다. 더욱 다양한 공급업체와의 파트너십 확대와 가용성 증대에 중점을 두었습니다. 이러한 시스템은 전용 AI 클라우드 환경을 원하는 개발자, 학생, 연구자를 위한 AI 네이티브 컴퓨터로 자리매김했습니다.
- NVIDIA GB10 Grace Blackwell Superchip으로 구동되는 DGX Spark는 최대 1페타플롭의 AI 컴퓨팅 성능을 제공합니다. 현재 양산 단계에 있으며, Acer, ASUS, Dell Technologies, GIGABYTE, HP, Lenovo, MSI 등 다양한 파트너사를 통해 곧 출시될 예정입니다.
- DGX Station은 최대 300페타플롭의 AI 성능을 제공하는 NVIDIA GB20 Grace Blackwell Ultra Desktop Superchip을 탑재하여 더욱 광범위한 파트너사에서 채택되고 있습니다. 올해 말 ASUS, Dell Technologies, GIGABYTE, HP, MSI에서 출시될 예정이며, XNUMX조 개의 매개변수로 구성된 AI 모델을 실행할 수 있는 데스크톱 솔루션을 제공합니다.
엔비디아 RTX 5060 출시

NVIDIA는 Computex에서 광범위한 발표를 마무리하며 NVIDIA GeForce RTX 5060도 출시했습니다. 오늘부터 파트너사의 추가 카드 폼팩터와 새로운 게이밍 노트북에 통합된 형태로 출시되는 RTX 5060은 더 많은 사용자에게 뛰어난 성능과 기능을 제공하는 것을 목표로 합니다.
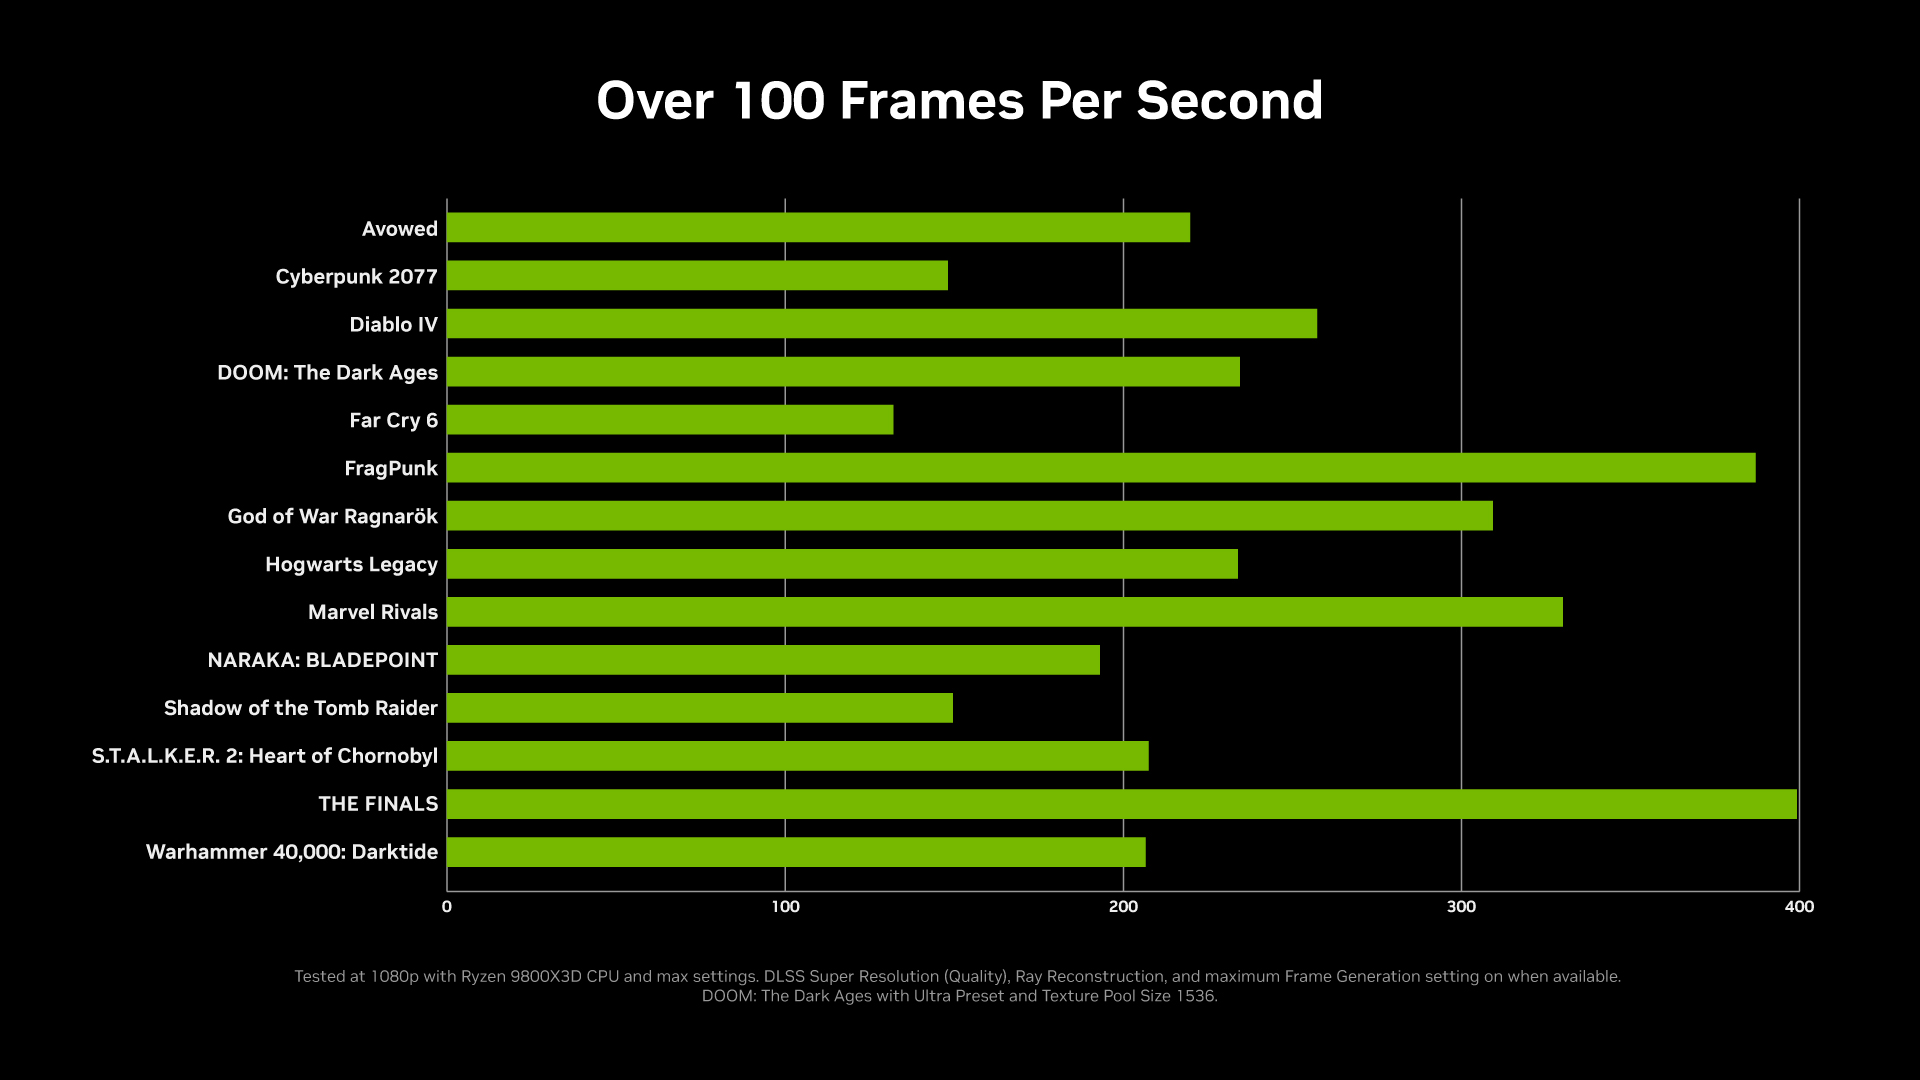
블랙웰 아키텍처 기반의 RTX 5060은 NVIDIA의 최신 AI 기반 초고해상도 및 프레임 생성 기술을 활용하여 DLSS 4를 지원합니다. 614 AI TOPS(INT4)를 자랑하며, 향상된 AI 처리 성능을 제공합니다. 5세대 텐서 코어와 4세대 RT 코어를 탑재하여 레이 트레이싱 및 AI 성능을 향상시켰습니다. 미디어 처리를 위해 9세대 NVIDIA 인코더(NVENC) 6개와 5060세대 NVIDIA 디코더(NVDEC) 8개가 포함되어 있습니다. RTX 7은 448GB GDDRXNUMX 메모리를 탑재하여 초당 XNUMXGB의 메모리 대역폭을 제공하여 최신 게임 타이틀과 크리에이티브 워크로드에 원활한 성능을 보장합니다.
이러한 업데이트는 광범위한 클라우드 네트워크나 전용 고성능 데스크톱 시스템을 통해 강력한 AI 도구와 컴퓨팅 리소스를 보다 쉽게 사용할 수 있도록 하는 NVIDIA의 전략을 전체적으로 나타내며, 모든 규모의 개발자가 AI 혁신에 참여할 수 있도록 보장합니다.


 아마존