

지금까지 GPU가 읽는 모든 스토리지 데이터는 호스트 CPU를 거쳐야 했습니다. CPU는 파일 시스템을 관리하고, 명령을 제출하고, 데이터를 반환합니다. 이러한 오버헤드는 대용량 순차 전송에는 미미하지만, 초당 수백만 건의 512바이트 연산을 처리할 때는 병목 현상이 됩니다. NVIDIA는 샌타클라라에서 열린 FMS 2026에서 이러한 병목 현상을 해결하기 위한 새로운 소프트웨어와 업계 차원의 이니셔티브를 발표했습니다.
이번 발표의 핵심은 GPU가 스토리지에서 직접 읽고 쓸 수 있도록 하는 API인 cuFile입니다. NVIDIA는 cuFile과 이를 지원하는 소프트웨어 스택 전체를 오픈소스로 공개했으며, 코드는 GitHub의 새로운 XIO-SIG 조직에서 호스팅됩니다. 창립 관리자로는 Google, Intel, Meta, NVIDIA 등이 참여하고 있습니다. 또한 NVIDIA는 GTC 2025부터 공개적으로 논의되어 온 Storage-Next 이니셔티브를 공식 출범했습니다. Storage-Next에는 DDN, KIOXIA, Micron을 비롯한 40개 이상의 스토리지 및 플래시 공급업체와 컨트롤러 제조업체, 냉각 전문업체, 표준화 기구가 참여하고 있습니다. 이들 참여 기업은 CPU가 아닌 GPU가 클라이언트 역할을 할 때 스토리지 장치가 어떻게 동작해야 하는지를 공동으로 정의하고 있습니다.
문제점: 호스트 매개 I/O
GPU 시스템은 전통적으로 호스트 중심의 I/O 모델로 작동해 왔습니다. CPU는 GPU 작업을 스케줄링하고, 데이터를 준비하며, GPU와 네트워크 또는 스토리지 간의 모든 전송을 시작합니다. 각 작업은 다음과 같은 순서를 따릅니다. GPU 커널이 완료되면 제어권이 CPU로 돌아오고, CPU는 전송을 설정한 후 다음 커널이 실행됩니다. 작업당 비용은 주로 커널 실행 및 CPU-GPU 동기화 오버헤드로, 마이크로초 단위로 측정됩니다. 대용량 전송의 경우 이 오버헤드는 무시할 수 있지만, 세밀한 작업의 경우에는 상당한 영향을 미칩니다.
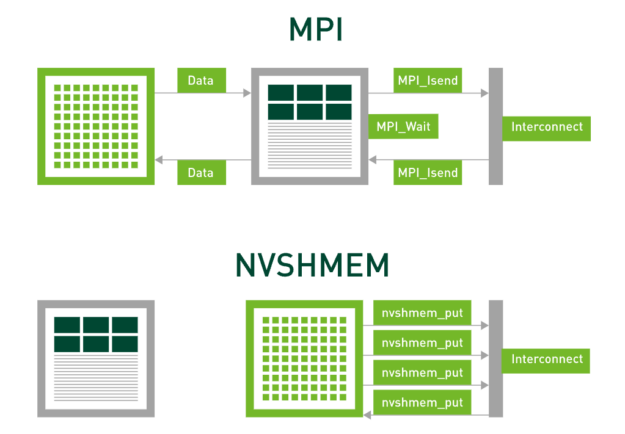
NVIDIA는 NVSHMEM을 통해 GPU 간 통신에서 호스트의 개입을 없애고, 디바이스 코드가 직접 전송을 시작하고 연산과 중첩할 수 있도록 했습니다. 이는 상당한 영향을 미쳤습니다. GROMACS가 헤일로 교환 통신을 MPI에서 NVSHMEM으로 전환했을 때, 통신이 핵심 경로에서 제거되어 연산과 완전히 중첩되었습니다.
스토리지는 호스트 매개 모델을 유지합니다. NVMe 드라이브에서 읽기를 수행하면 여전히 CPU로 제어권이 반환되고 파일 시스템이 실행된 후 완료될 때까지 기다립니다. 학습은 읽기 작업의 크기가 크고 빈도가 낮기 때문에 이러한 방식을 허용합니다. 하지만 추론은 그렇지 않습니다. KV 캐시 항목, 임베딩 및 벡터 검색 결과를 제공하는 과정에서 초당 수백만 건의 작은 무작위 읽기 작업이 발생하며, CPU는 이 모든 작업을 처리해야 합니다.
GPU 기반 I/O 및 SCADA
SCADA(확장형 가속 데이터 액세스)는 NVSHMEM 모델을 스토리지에 적용하여 GPU가 자체 스토리지 I/O를 시작하고 관리할 수 있도록 합니다.
이 연구의 기반이 되는 프로젝트는 NVIDIA, IBM, 일리노이 대학교, 버팔로 대학교가 ASPLOS 2023에서 발표한 BaM(Big Accelerator Memory)입니다. BaM은 GPU가 NVMe 드라이브를 직접 관리하고, 스레드에서 생성되는 작은 요청들을 통합 및 캐싱하여 호스트 개입 없이 드라이브 포화 상태에 이르는 큐 깊이를 유지하는 방식을 시연했습니다. 동일한 하드웨어에서 BaM은 데이터 분석 워크로드를 CPU 기반 액세스보다 5.3배 빠르게 실행했으며, 그래프 워크로드는 동일한 데이터를 호스트 메모리에 저장하는 것보다 최대 21.7배 낮은 하드웨어 비용으로 플래시 메모리에서 실행했습니다.
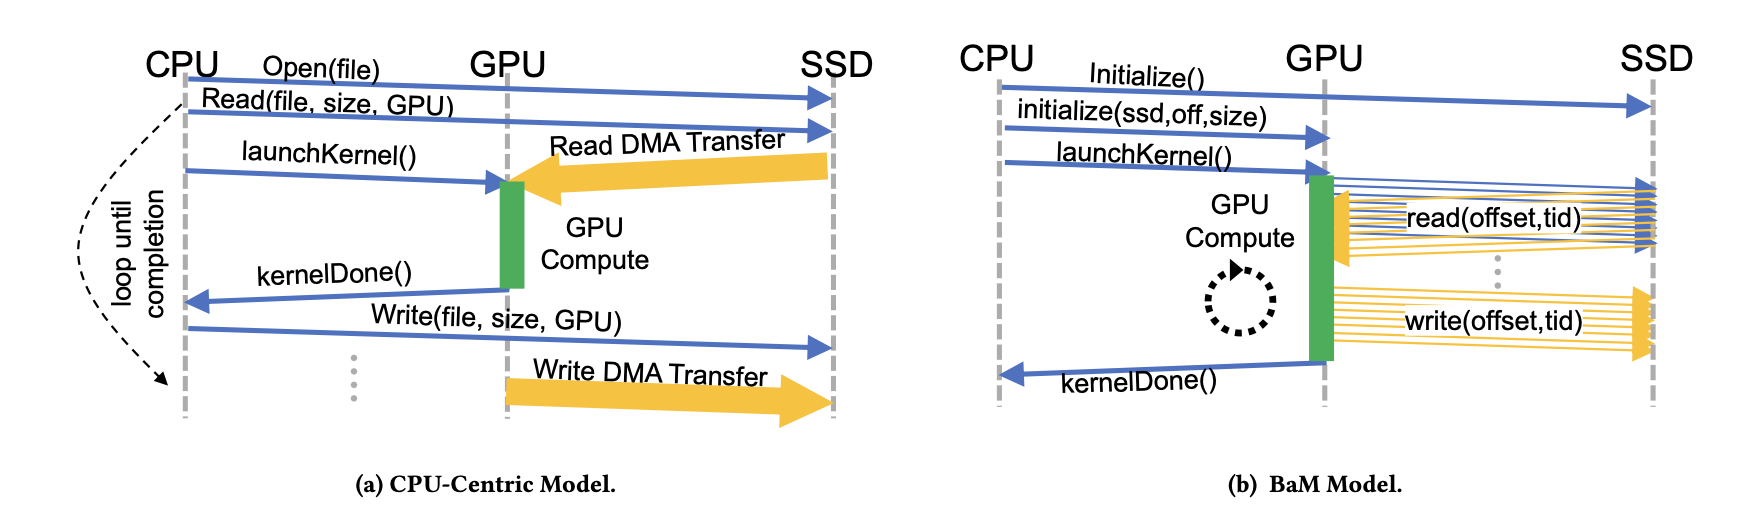
SCADA는 제품화된 형태입니다. GPU 런타임은 커널 스레드와 스토리지 사이에 위치합니다. 이 런타임은 분산된 작은 요청들을 통합하여 GPU 캐시에서 제공되는 읽기 작업이나 로컬 NVMe 드라이브 또는 원격 스토리지 서버와 같은 드라이브에 발행되는 읽기 작업으로 처리합니다.
공유 드라이브에 대한 직접적인 접근은 제한되어야 합니다. 접근이 제한되면 한 애플리케이션이 다른 애플리케이션의 데이터를 읽거나 손상시킬 수 있기 때문입니다. NVIDIA는 권한 수준을 분리하는 설계를 채택했습니다. 애플리케이션의 성능에 중요한 부분은 신뢰할 수 있는 컴퓨팅 환경 외부에서 비특권으로 실행됩니다. 특권 구성 요소는 표준 Linux 보안 메커니즘을 사용하여 각 애플리케이션과 설정 시 승인된 스토리지 간에 보호된 접근을 구성합니다. NVIDIA는 이러한 분리와 Linux 기반 상호 운용성을 CUDA 스택을 폐쇄형 구성 요소가 아닌 오픈 소스로 출시한 이유로 꼽습니다.
SCADA와 GPUDirect 스토리지의 차이점은 무엇인가요?
모든 스토리지 작업에는 데이터 경로(이동되는 바이트)와 제어 경로(요청 구성, 제출 및 완료 처리)가 있습니다. 2019년에 도입되어 2021년부터 출시된 GPUDirect Storage(GDS)는 데이터 경로에서 CPU를 제거했습니다. cuFile을 통해 데이터는 호스트 RAM의 바운스 버퍼 없이 드라이브와 GPU 메모리 간에 DMA 방식으로 이동합니다. NVIDIA의 출시 자료에 따르면 DGX-2의 CPU 경로 최대 속도는 50GB/s였지만, GDS는 경로를 결합하여 최대 200GB/s에 근접하는 속도를 낼 수 있으며, DDN, VAST, WEKA, Pure Storage 등 주요 AI 스토리지 공급업체들이 GDS에 대한 인증을 받았습니다. 제어 경로는 여전히 CPU에 남아 있습니다. 호스트 소프트웨어는 여전히 가져올 데이터를 결정하고 모든 요청을 발행하며, GPU는 DMA 시작자가 아닌 대상 역할을 합니다.
대용량 데이터 전송 시에는 이러한 분할이 적절합니다. 1MB 읽기 작업의 경우 제어 경로 비용이 거의 발생하지 않습니다. 하지만 512바이트부터는 비율이 역전됩니다. 요청당 고정 비용이 지배적이 되어 CPU가 드라이브보다 훨씬 먼저 포화 상태에 이르게 됩니다. SCADA 시스템은 이러한 문제를 해결하기 위해 제어 경로를 GPU로 옮깁니다. GPU는 수십만 개의 작업을 동시에 처리함으로써 메모리 지연 시간을 흡수하는 것과 같은 방식으로 작업당 지연 시간을 흡수합니다.
cuFile은 대량 전송에, SCADA는 대량의 소량 무작위 읽기에 사용되며, 이 두 가지는 공존합니다.
Storage-Next와 512바이트 문제
SCADA는 GPU 측을 담당하고, Storage-Next는 드라이브 측을 담당하는데, 현재는 다른 워크로드에 최적화되어 있습니다.
엔터프라이즈 SSD는 데이터베이스 및 가상화 액세스 패턴에 맞춰 10년 동안 4KB 랜덤 읽기에 최적화되어 왔습니다. 대부분의 컨트롤러는 512바이트 읽기와 4KB 읽기를 처리하는 데 거의 동일한 작업량을 사용하므로 4KB 미만의 요청도 4KB 읽기에 필요한 비용으로 처리됩니다. 추론 액세스 패턴은 더 작습니다. 임베딩은 수백 바이트 정도이고, KV 캐시 블록은 1KB 미만입니다. 4KB에 최적화된 드라이브에서 이러한 데이터를 처리하려면 읽기 증폭률이 8배로 높아져 대역폭과 컨트롤러 캐시가 낭비됩니다. 수십 테라바이트에 달하는 작은 객체들을 처리할 때, 이러한 증폭률은 플래시 메모리가 메모리 계층으로 사용될 수 있는지 여부를 결정짓는 중요한 요소가 됩니다.
Storage-Next는 더 작은 단위에 맞춰 드라이브, 컨트롤러 및 시스템을 재설계하는 프로젝트입니다. 이미 진행 중인 GTC 2025에서 공개되었으며, 전력 및 테일 레이턴시 제약 조건 하에서 GPU당 512바이트 IOPS를 극대화하는 것을 목표로 한다고 밝혔습니다. FMS에서 NVIDIA는 40개 이상의 스토리지 및 플래시 공급업체와 함께 Storage-Next에 회원 번호를 부여하고 SCADA를 개발 프레임워크로 지정했습니다.
참고 결과는 SCADA 프로그래밍 모델에서 단일 서버를 사용하여 2억 3천만 512바이트 랜덤 읽기 IOPS를 달성한 마이크론의 SC25 데모입니다. 이 시스템은 H3 플랫폼 팔콘 6048 섀시에 장착된 3개의 H100 드라이브와 3개의 브로드컴 PEX90000 Gen6 스위치 뒤에 44개의 마이크론 9650 PCIe Gen6 SSD를 사용했습니다. 이 수치는 44개 드라이브의 총 550만 IOPS 정격의 약 95%에 해당합니다.
그 수치의 구성이 중요합니다. 2억 3천만 건의 512바이트 읽기는 대략 초당 118GB의 페이로드에 해당하며, 이는 이러한 드라이브 4~5개를 순차적으로 사용할 수 있는 양입니다. 핵심은 작업 횟수입니다. 호스트 소프트웨어로 이를 유지하려면 제출 및 완료 처리에만 수십 개의 CPU 코어가 소모되지만, 데모에 사용된 단일 CPU는 사실상 유휴 상태였습니다. GPU의 10만 개 이상의 스레드에 분산시키면 스레드당 초당 수천 건의 작업만 처리하게 됩니다.
이제 SSD 성능이 핵심 관건입니다. 마이크론의 9650은 최초의 PCIe Gen6 SSD로, 순차 읽기 속도 28GB/s, 랜덤 읽기 IOPS 5.5만이라는 기록적인 성능을 자랑합니다. 마이크론은 데모에서 드라이브 1개부터 44개까지 선형적으로 확장 가능하다고 밝혔습니다. 키옥시아의 GP 시리즈는 512바이트 액세스에 최적화된 XL 플래시 SSD로 , 스토리지 넥스트(Storage-Next) 프로젝트 하에 개발되고 있습니다. NVIDIA의 스토리지 넥스트 로드맵은 PCIe Gen7 SSD가 각각 100억 IOPS를 유지하는 것을 목표로 하고 있으며, 마벨을 포함한 컨트롤러 제조사들은 현재 이 목표를 향해 설계에 박차를 가하고 있습니다. 이러한 성능을 달성하기 위해서는 컨트롤러 재설계, 소규모 페이로드에 적합한 오류 수정 기능, 그리고 GPU 네이티브 드라이브 동작을 정의하는 표준이 필요합니다.
훈련 및 추론에 대한 매핑
두 경로는 두 가지 접근 패턴에 해당합니다. 학습은 대역폭 제약이 있습니다. 대용량의 순차적 샤드를 스트리밍하고 주기적으로 수 테라바이트 크기의 체크포인트를 기록하는데, 이 동안 GPU는 유휴 상태가 됩니다. 이러한 전송 크기에서는 CPU 오버헤드가 무시할 수 있을 정도로 작으므로 GDS와 최근 오픈 소스로 공개된 cuFile 스택이 GPU당 GB/s 및 체크포인트 지속 시간 기준으로 측정되는 올바른 인터페이스로 남아 있습니다.
추론은 IOPS에 의해 제한됩니다. KV 캐시( 대화에서 이미 처리된 모든 토큰의 주의 상태)는 컨텍스트 길이에 따라 증가합니다. 에이전트 기반 배포 환경에서는 수천 개의 동시 대화가 실행되므로 GPU 메모리 용량을 빠르게 초과하게 되며, 제거된 항목을 다시 계산하는 데 드는 GPU 시간은 다시 읽어들이는 데 드는 시간보다 더 많이 소모됩니다. 표준 설계는 GPU 메모리에서 시스템 메모리, 플래시 메모리로 캐시가 확장되는 계층형 캐시를 사용하며, 대량의 소량 무작위 읽기를 통해 캐시를 다시 채웁니다. 벡터 검색 및 임베딩 조회도 동일한 패턴을 보입니다. 이것이 SCADA에서 목표로 하는 액세스 형태이며, NVIDIA가 대역폭 대신 512바이트 IOPS를 제시하는 이유입니다. 메모리가 아닌 플래시 메모리에서 KV 캐시를 제공하면 각 GPU가 지원하는 컨텍스트 및 동시 사용자 수가 증가하여 사용자당 서비스 비용이 결정됩니다.
하드웨어: Vera BlueField-4 STX 및 CMX
플랫폼 계층은 NVIDIA Vera BlueField-4 STX 로 , GTC 2026에서 발표되어 이번 주에 확장된 랙 스케일 스토리지 아키텍처입니다. STX는 Vera Rubin 플랫폼과 BlueField-4 스토리지 프로세서를 결합한 것으로, 각 프로세서는 Vera Arm 코어와 800Gb/s의 통합 네트워킹을 결합하고 BlueField-3보다 약 6배 높은 컴퓨팅 성능을 제공합니다.
NVIDIA는 FMS에서 해당 코어에 대한 벤치마크 결과를 발표했습니다. 모든 트래픽에 적용되는 인라인 데이터 서비스 스토리지 시스템을 대표하는 2단계 압축 및 암호화 파이프라인은 Vera에서 x86 CPU보다 최대 3.21배 빠른 처리량을 보였습니다. 이는 현재 스토리지 컨트롤러에서 x86 코어를 사용하는 암호화, 압축 및 검증 작업이 더 낮은 전력으로 Vera 실리콘에서 수행될 수 있음을 시사합니다. NVIDIA의 BlueField용 소프트웨어 프레임워크인 DOCA는 데이터 경로에서 보안 정책을 적용합니다. STX 기반의 CMX 컨텍스트 메모리 스토리지는 BlueField-4 뒤에 플래시 메모리를 풀링하여 장기 컨텍스트 추론을 위한 공유 KV 캐시 계층으로 사용합니다. DDN, Dell, HPE, IBM, VAST Data, WEKA 등의 파트너 시스템은 2026년 하반기에 출시될 예정입니다.
생각을 폐쇄
전략적 구조는 명확합니다. NVIDIA는 GPU가 스토리지에 접근하는 데 사용할 인터페이스를 공개하고, 구현 코드를 오픈소스로 제공하며, 40개 이상의 벤더를 조직하여 하드웨어 동작을 표준화하고 있습니다. cuFile을 공개하는 것은 NVIDIA가 이 계층을 CUDA 내부에 유지해 온 기존 방식에서 벗어난 것입니다. 하지만 GPU 기반 스토리지 인터페이스는 드라이브, 컨트롤러, 어레이 벤더들이 이를 지원하는 제품을 개발해야만 그 효과를 발휘합니다. 인텔이 유지보수 파트너로 참여한 것은 주목할 만한 신호입니다. 현재 스토리지 시스템에 사용되는 x86 실리콘의 주요 공급업체가 I/O 경로에서 실리콘을 제거하는 소프트웨어를 지원하고 있기 때문입니다.
마이크론의 시연은 실현 가능성을 입증했습니다. 3개의 GPU가 44개의 Gen6 드라이브를 업계에서 부차적인 요소로 여겨왔던 블록 크기에서 정격 용량의 약 95%까지 구동했습니다. 이제 남은 것은 실행입니다. 코드가 GitHub에 공개되고, SCADA 시스템이 프레임워크에서 CUDA 지원 구성 요소로 발전하며, 벤더들이 읽기 성능에 최적화된 소형 SSD를 대량으로 출시하는 것입니다. 위의 수치는 NVIDIA와 파트너사의 자료이며, 독립적인 측정 결과가 아닙니다. STX 시스템이 올해 하반기에 연구실에 도착하면 해당 수치를 검증할 예정입니다.


 아마존