

Smart IOPS와 H3 Platform은 최대 10억 개의 랜덤 읽기 IOPS를 목표로 하는 AI 컴퓨팅 스토리지 플랫폼을 발표했습니다. 이 시스템은 Smart IOPS의 Unobtanium T50 솔리드 스테이트 드라이브와 NVIDIA 가속 컴퓨팅 및 네트워킹 기술을 기반으로 설계된 공랭식 H3 Platform 어플라이언스를 결합한 것입니다.
이 플랫폼은 고도로 병렬화된 세밀한 I/O를 통해 대규모 데이터 세트에 액세스하기 위해 GPU가 필요한 데이터 집약적인 AI 추론 및 분석 워크로드를 대상으로 합니다. NVIDIA의 Storage-Next 이니셔티브와 SCADA(Scaled Accelerated Data Access ) 프로그래밍 모델을 지원하도록 설계되었습니다. 이러한 기술을 통해 애플리케이션 작업 세트가 로컬 GPU 메모리를 초과할 경우 GPU가 NVMe 스토리지에 대한 액세스를 시작할 수 있습니다.
GPU 연산과 스토리지 간의 거리를 줄임으로써, 이 아키텍처는 CPU 제어 경로 오버헤드를 감소시키고 가속기에 데이터를 지속적으로 공급하는 데 도움을 주도록 설계되었습니다. 이 접근 방식은 그래프 신경망, 벡터 검색, 추천 시스템, 검색 증강 생성, 임베딩 저장소 및 대량의 작고 무작위적인 요청을 생성하는 기타 희소 분석 애플리케이션과 같은 워크로드에 적합합니다.
스마트 아이옵스의 CEO인 아슈토시 다스는 "AI 인프라는 스토리지가 수동적인 저장소처럼 작동하는 것이 아니라 컴퓨팅 패브릭의 능동적인 확장 기능처럼 작동해야 하는 단계에 접어들고 있다"고 말했다.
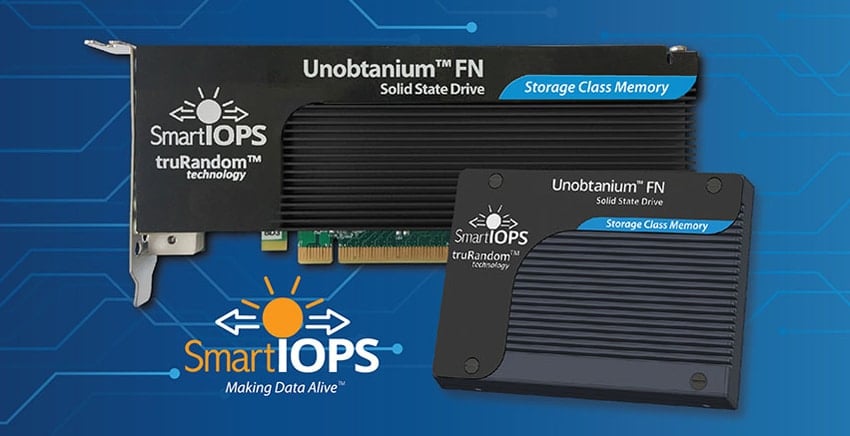
스마트 IOPS 언옵타늄 T50
Unobtanium T50은 E3.S 폼팩터의 PCIe Gen6 x4, NVMe 2.0 장치입니다. Smart IOPS는 512바이트 블록 크기에서 최대 50천만 랜덤 읽기 IOPS와 10천만 랜덤 쓰기 IOPS를 제공합니다. 순차 성능은 읽기 최대 28GB/s, 쓰기 최대 24GB/s입니다. 이 범위의 순차 처리량은 이미 대량 생산 중인 PCIe Gen6 엔터프라이즈 SSD 와 동일하며 , 특히 512바이트 랜덤 읽기 IOPS 수치가 차별화된 사양입니다.
4개의 T50 장치는 장치 수준에서 최대 2억 개의 랜덤 읽기 IOPS를 제공할 수 있습니다. Smart IOPS는 이러한 성능이 NVIDIA Rubin을 포함한 차세대 PCIe Gen6 x16 GPU의 I/O 요구 사항을 충족한다고 명시하고 있습니다. 실제 성능은 워크로드 특성, 소프트웨어, PCIe 토폴로지, 시스템 구성 및 기타 시스템 수준 요인에 따라 달라집니다.
| 스마트 IOPS ACS 언옵타늄 T50 | |
| 예비 사양 | |
|---|---|
| 성능 | |
| 무작위 읽기 | 최대 50만 IOPS |
| 임의 쓰기 | 최대 10만 IOPS |
| 블록 크기 | 512 바이트 |
| 순차 읽기 | 최대 28GB/s |
| 순차 쓰기 | 최대 24GB/s |
| 하드웨어 | |
| 생산 능력 | 9TB, 18TB 및 36TB |
| 미디어 | 유사 SLC 모드로 작동하는 TLC NAND; 특수 저지연 SLC NAND 지원 |
| 폼 팩터 | E3.S 2T |
| 인터페이스 | PCIe Gen6 x4; NVMe 2.0 |
| 이용 가능 여부 (Availability) | |
| 예정된 이용 가능 여부 | 평가용 샘플 제공: 2027년 1분기; 생산: 2027년 2분기 |
| H3 플랫폼 고성능 IOPS 어플라이언스 | |
| 예비 사양 | |
|---|---|
| 컴퓨팅 및 네트워킹 | |
| GPU | NVIDIA RTX PRO 6000 블랙웰 서버 에디션 GPU 4개 |
| 네트워킹 | 4 × NVIDIA ConnectX-8 |
| 스토리지 | |
| SSD 베이 | 고성능 IOPS SSD용 E3.S 2T 슬롯 20개 |
| 슬롯당 전력 | E3.S 슬롯당 최대 60W |
| 시스템 | |
| 냉각 | 공냉식 |
| 이용 가능 여부 (Availability) | |
| 예정된 이용 가능 여부 | 평가 시스템 출시: 2027년 1분기; 생산 개시: 2027년 2분기 |
| 예비 사양이며, 예고 없이 변경될 수 있습니다. | |
T50은 널리 사용되는 TLC NAND를 유사 SLC 모드로 동작시키는 스마트 IOPS TruRandom 컨트롤러 아키텍처를 사용합니다. 회사 측은 이러한 접근 방식을 통해 여러 인증된 NAND 공급업체의 제품을 활용하면서도 플래시 산업 전반의 제조 규모와 공급망 역량을 유지할 수 있다고 설명합니다. 또한, 워크로드 또는 구축 경제성에 따라 특수 저지연 NAND도 지원할 수 있습니다.
H3 플랫폼 어플라이언스
H3 플랫폼은 NVIDIA RTX PRO 6000 Blackwell Server Edition GPU 4개, NVIDIA ConnectX-8 네트워크 어댑터 4개, 그리고 E3.S 2TB 스토리지 슬롯 20개를 탑재한 공랭식 어플라이언스를 개발 중입니다. 각 슬롯은 최대 60와트를 지원하도록 설계되어 고성능 스토리지 장치에 필요한 전력 및 열 관리 용량을 제공합니다.
20개의 슬롯에 T50 디바이스를 장착한 이 시스템은 최대 10억 개의 랜덤 읽기 IOPS를 목표로 설계되었습니다. 이 구성은 GPU 기반 소규모 블록 스토리지 워크로드를 평가하고 배포하기 위해 단일 플랫폼에서 GPU 컴퓨팅, 네트워킹 및 스토리지 연결성의 균형을 맞추는 것을 목표로 합니다.
H3 플랫폼의 창립자이자 CEO인 브라이언 팬은 “차세대 AI 시스템은 분리된 컴퓨팅, 네트워크 및 스토리지 구성 요소가 아니라 통합된 데이터 경로로 설계되어야 한다”고 말했습니다. 이 설계는 공랭식 폼팩터를 유지하면서 고성능 IOPS를 제공하는 E3.S 스토리지를 GPU 및 고속 네트워크 어댑터와 함께 배치합니다.
높은 IOPS는 이러한 워크로드에 매우 중요합니다. 대역폭만으로는 스토리지 시스템이 불규칙적이고 동시적인 액세스를 얼마나 효율적으로 처리하는지 설명할 수 없기 때문입니다. 여러 GPU 스레드에서 생성되는 작은 블록 요청은 CPU 기반 스토리지 아키텍처에서 큐잉 및 동기화 오버헤드를 드러낼 수 있습니다. IOPS가 높고 지연 시간이 짧은 장치는 더 많은 동시 요청을 처리할 수 있으며, GPU가 데이터를 기다리는 시간을 줄일 수 있습니다.
Smart IOPS 및 H3 플랫폼은 2027년 1분기에 평가 샘플 및 시스템이 제공될 것으로 예상됩니다. 양산은 2027년 2분기에 계획되어 있습니다. 사양, 구성 및 일정은 예비적인 것이며 변경될 수 있습니다. 고객 인증, 소프트웨어 생태계 준비 및 NVIDIA의 검증 또는 승인은 별개의 프로세스이며 본 발표에 포함되지 않습니다.


 아마존