

델 프로 맥스 16 플러스에는 두 가지 이야기가 있는데, 이 두 이야기는 서로 상반된 방향으로 흘러갑니다. 하나는 최고급 모바일 워크스테이션으로서의 면모입니다. 인텔 24코어 코어 울트라 9 285HX 프로세서, 최대 256GB의 CAMM2 메모리, 3개의 M.2 슬롯, 최대 5000 시리즈 NVIDIA RTX PRO 블랙웰 그래픽 카드(24GB GDDR7 메모리), MIL-STD-810H 방호 등급, 그리고 델이 엔지니어링에 심혈을 기울인 것이 분명한 섀시가 특징입니다.
다른 하나는 이번에 살펴볼 SKU로, GPU 대신 퀄컴 AIC100 PC 추론 카드를 탑재했습니다. 이 카드는 2019년 클라우드 AI 100 실리콘을 기반으로 하는 듀얼 SoC 모듈이며, 대부분의 최신 추론 워크로드를 실행하기 어렵게 만드는 소프트웨어 스택을 사용합니다. 이는 플래그십 섀시에 적합하지 않은 가속기가 탑재되었을 때 어떤 일이 발생하는지, 그리고 고객이 구매 계약서에 서명하기 전에 AI 솔루션의 소프트웨어 스택을 이해해야 하는 이유를 보여주는 사례입니다. 그 이유를 살펴보기 전에 노트북 전체를 먼저 살펴보겠습니다.
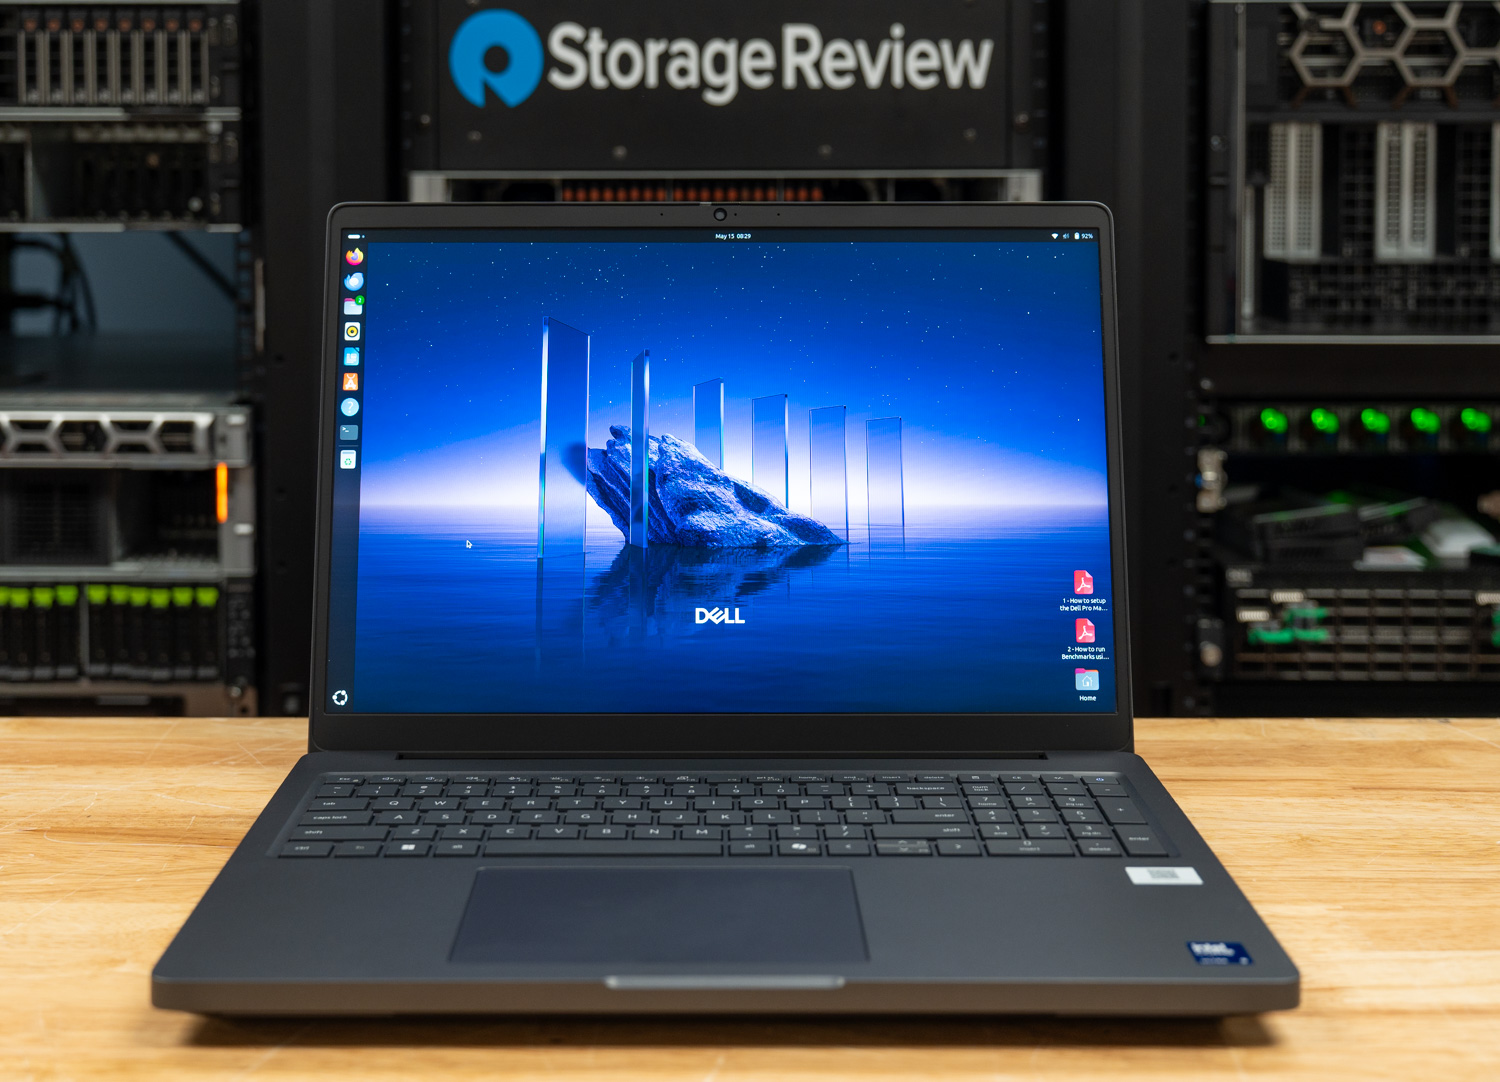
델의 Pro Max 워크스테이션 라인업 최상단에 위치한 Pro Max 16 Plus는 보급형 Pro Max 16과 슬림형 Pro Max 16 Premium보다 강력한 성능을 제공합니다. 핵심은 확장 가능한 인텔 Core Ultra 9 285HX 프로세서로, 55W의 전력 소모와 5.5GHz의 터보 부스트 클럭을 갖춘 24코어 칩입니다. 모든 CPU 구성은 인텔 vPro Enterprise를 지원하여 기업용 노트북으로서의 면모를 더욱 강화합니다. 가격은 2,779달러부터 시작합니다.
그래픽 옵션은 인텔 통합 그래픽부터 NVIDIA의 블랙웰 기반 RTX PRO 1000, 그리고 이전에 리뷰했던 24GB GDDR7 메모리를 탑재한 RTX PRO 5000까지 다양하게 제공됩니다. 저장 장치 및 메모리 구성 또한 넉넉합니다. 3개의 M.2 Gen5 슬롯을 통해 최대 12TB의 저장 용량을 제공하며, Dell의 CAMM2 모듈을 통해 최대 128GB의 DDR5-6400 메모리를 지원합니다.
디스플레이 옵션은 기본 1920 x 1200 IPS 패널부터 생생한 3840 x 2400 OLED 터치스크린까지 다양합니다. 중간급 옵션인 1920 x 1200 패널은 두 가지 옵션의 중간 단계로, 500니트의 밝기, 120Hz 가변 주사율, 그리고 DCI-P3 색역을 완벽하게 지원합니다. 100개 이상의 ISV 인증을 획득하여 크리에이티브 전문가들은 애플리케이션을 원활하게 실행할 수 있습니다.
지문 인식기, 스마트 카드 지원, NFC, 얼굴 인식을 위한 8MP 적외선 카메라, Dell Control Vault 3 등 기업 수준의 보안 기능을 갖추고 있습니다. 3년 표준 보증이 제공되어 이 노트북이 전문적인 업무를 위한 강력한 도구임을 강조합니다.
Dell Pro Max 16 Plus 사양
| 스펙 | 델 프로 맥스 16 플러스 |
|---|---|
| 플랫폼 | |
| 프로세서 | 인텔 코어 울트라 5 245HX 인텔 코어 울트라 7 265HX 인텔 코어 울트라 9 285HX |
| 운영체제 | 윈도우 11 프로 우분투 리눅스 24.04 LTS |
| 메모리 | 16GB-128GB CSoDIMM 또는 CAMM2, 슬롯 1개 |
| 그래픽 및 AI 가속 | |
| 그래픽 카드 | 인텔 통합 그래픽 엔비디아 RTX 프로 1000 8GB 엔비디아 RTX 프로 2000 8GB 엔비디아 RTX 프로 3000 12GB 엔비디아 RTX 프로 4000 16GB 엔비디아 RTX 프로 5000 24GB 퀄컴 AI 클라우드 100 64GB (32GB x 2) |
| 보관 및 디스플레이 | |
| 스토리지 | 최대 3개의 M.2 SSD, 각각 4TB 사용 가능한 RAID 0/1/5 |
| 디스플레이 | 16인치 16:10 1920×1200, 300니트, 45% NTSC, 60Hz, 비터치 1920×1200, 500니트, 100% DCI-P3, 120Hz VRR, 터치 불가 3840×2400, 500니트, OLED, 터치 |
| 연결 및 전원 | |
| 카메라 | 8MP 적외선 |
| 무선 네트워킹 | Intel Wi-Fi 7 BE200(Bluetooth 5.4 포함 또는 미포함) 사용 가능한 모바일 광대역 |
| 배터리 | 6셀 96Whr |
| 전원 어댑터 | 165W 또는 280W |
| 보안 및 물리적 | |
| 보안 기능 | IR 웹캠 지문 판독기 스마트 카드 리더 NFC 컨트롤 볼트 3 |
| 치수 및 무게 | 1.22 x 10.18 x 14.17인치 시작 무게: 5.63파운드 |
| 품질 보증 | 표준 3년, 다음 영업일 현장 수리 |
빌드 및 디자인
이전에 리뷰했던 제품과 마찬가지로, Pro Max 16 Plus는 극한 환경에서의 내구성을 보장하는 MIL-STD-810H 인증을 획득할 정도로 견고합니다. 델은 지속 가능성을 중시하여 재활용 플라스틱, 재활용 마그네슘 및 코발트, 그리고 바이오 기반 플라스틱을 소재로 사용했습니다. 실제로 만져보면 섀시가 매우 견고하게 느껴지며, 휘어짐이 전혀 느껴지지 않습니다. 한마디로 탱크처럼 튼튼하게 만들어졌습니다.
이 제품은 꽤 묵직한 기기입니다. 두께가 1.22인치(받침대 포함)이고 무게가 5.63파운드부터 시작하는 만큼, 잦은 이동을 위해 설계된 것은 아니지만, 10.18 x 14.17인치의 크기는 16인치 16:10 디스플레이치고는 비교적 컴팩트합니다. 웹캠은 덮개 상단에 있으며, 슬라이딩 방식의 프라이버시 셔터가 함께 제공됩니다. 저희 리뷰 제품에는 얼굴 인식을 위한 적외선(IR) 버전이 탑재되어 있습니다.
미적인 측면에서 델의 디자인은 지나치게 절제되어 있습니다. 회색과 검정색의 외관과 은은한 브랜드 로고는 기능성을 디자인보다 우선시하는 제품임을 강조합니다. 프로 맥스 프리미엄 라인은 성능과 확장성을 희생하는 대신 시각적인 화려함을 더했습니다.
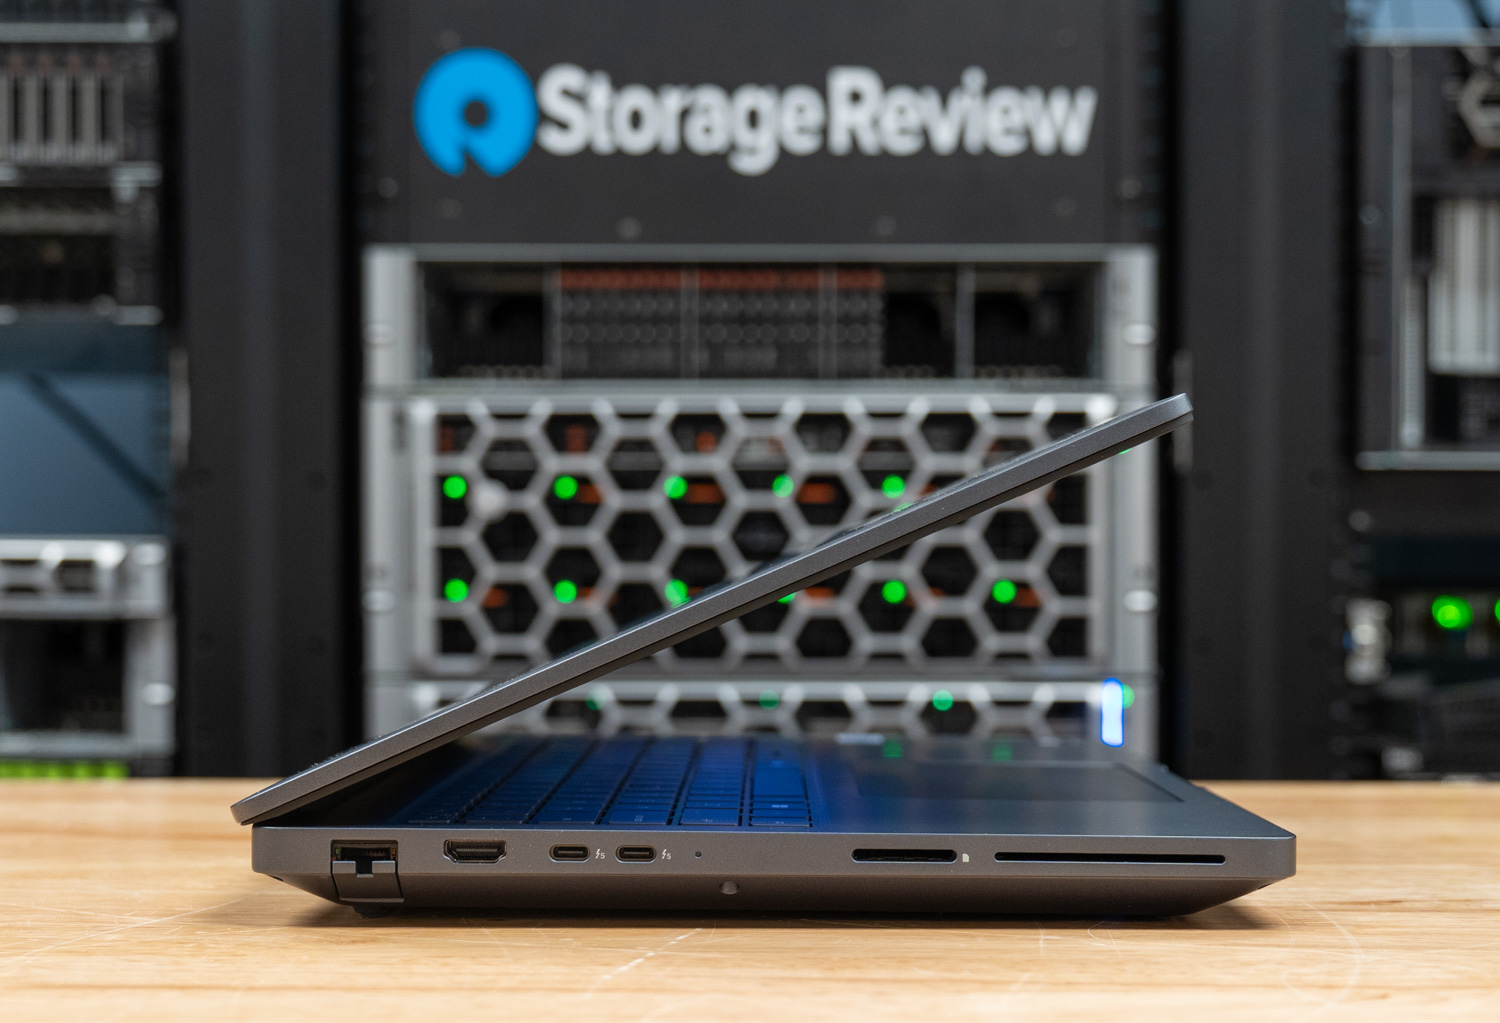
포괄적인 포트 선택은 왼쪽 가장자리에서 시작됩니다.
- 2.5Gbps RJ45 이더넷
- HDMI 2.1 출력
- Thunderbolt 5(USB-C) 포트 XNUMX개
- SD 카드 리더
- 선택 사양 스마트카드 슬롯
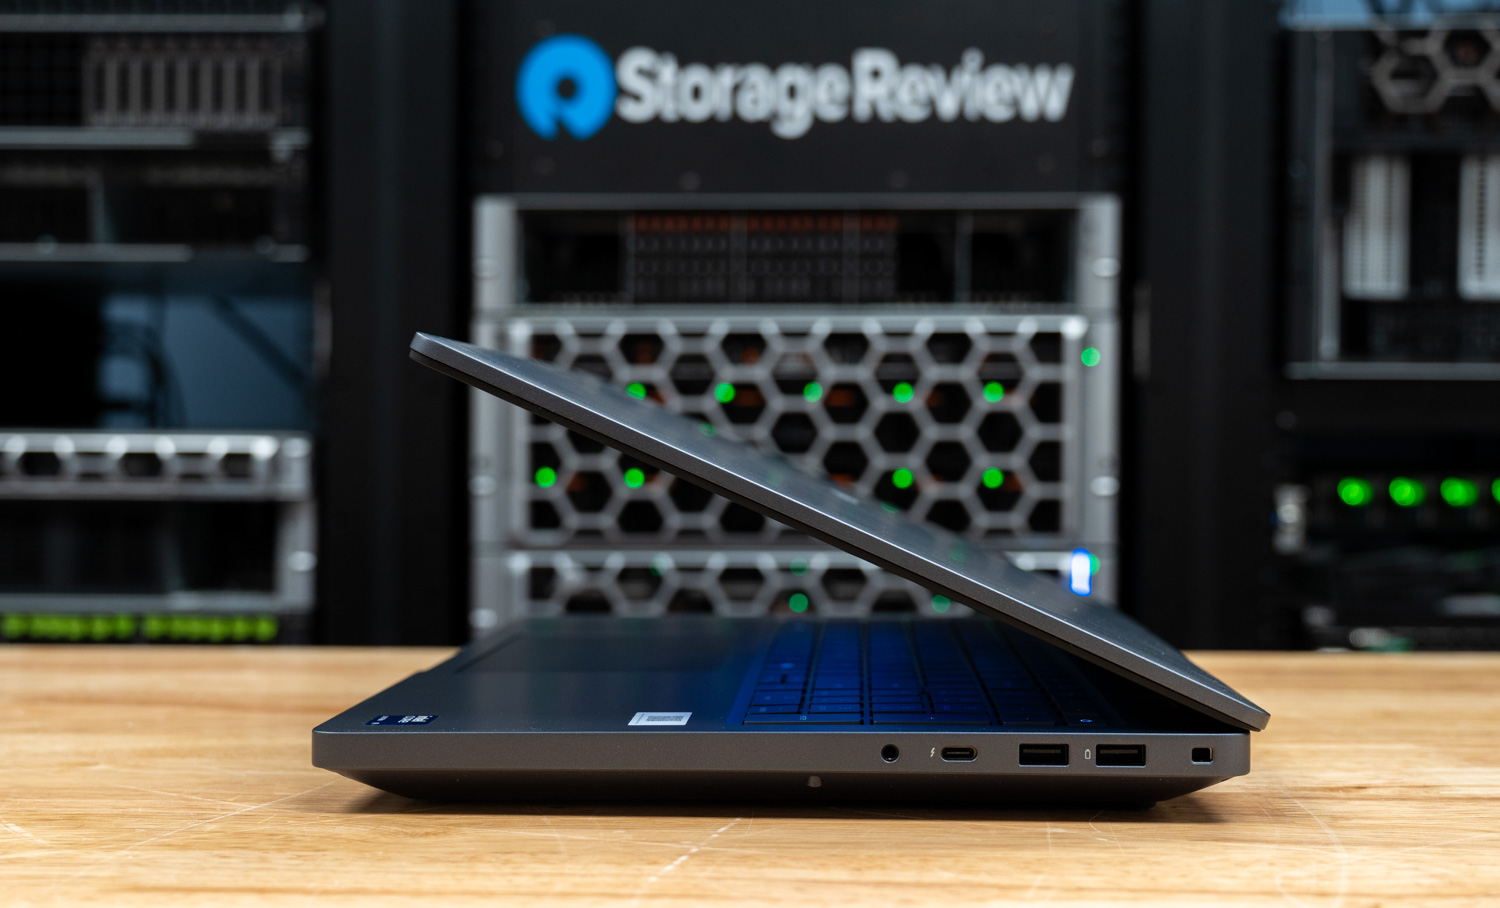
오른쪽으로:
- 3.5mm 오디오 잭
- 썬더 볼트 4 (USB-C)
- USB 3.2 Gen1 Type-A 포트 2개
- 잠금 슬롯
후면에는 포트가 없습니다. 무선 연결은 Wi-Fi 7 및 Bluetooth 5.4를 지원하는 Intel BE200 모듈로 처리됩니다. 사용자 지정 구성에서는 Bluetooth를 제외할 수 있으며, 5G 모바일 광대역도 사용할 수 있습니다.
화면 및 입력 장치
리뷰용 제품은 델의 16인치 1920x1200 해상도 디스플레이에 120Hz VRR 패널이 탑재되어 있어 일상적인 사용에서 뛰어난 화질을 제공합니다. 색감은 생생하며, 100% DCI-P3 색역을 지원하여 색상에 민감한 작업에도 적합합니다(단, 색상 보정 후 사용). 500니트의 밝기는 밝은 사무실이나 스튜디오 환경에서도 눈이 편안하게 작업할 수 있도록 도와줍니다.
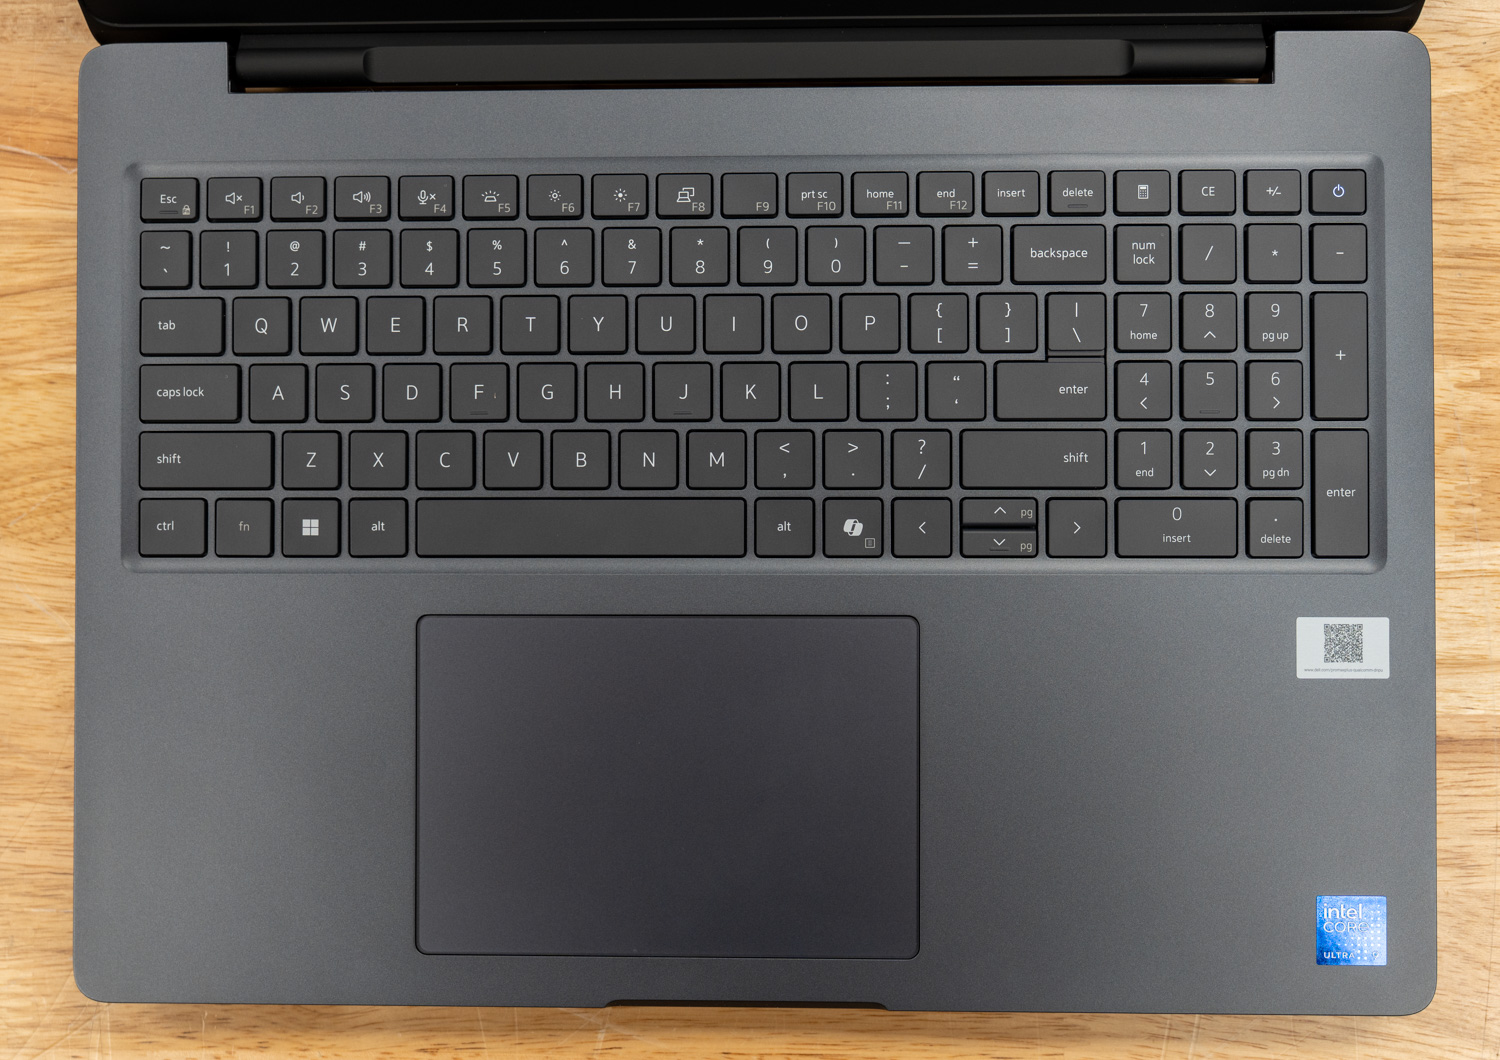
델 키보드는 장시간 타이핑에 적합하며, 풀 사이즈 키는 가볍고 반응성이 뛰어난 키감과 선명한 촉각 피드백을 제공합니다. 흰색 백라이트는 어두운 환경에서도 키를 잘 보이게 해줍니다. 키 배열은 대체로 일반적이지만, 방향키의 크기가 고르지 않아 오타가 발생할 수 있으며, Home 키와 End 키의 위치는 특히 불편합니다. 이 키들은 F11 키와 F12 키와 같은 위치에 있어, Fn-Lock(Fn + Esc)을 활성화하여 기능 키를 우선적으로 사용하려면 Fn + F11 또는 F12를 눌러야 합니다. Page Up과 Page Down 전용 키가 있었다면 좋았겠지만, 대신 이 기능들은 이미 키보드에서 가장 사용하기 불편한 위아래 방향키의 보조 기능으로 제공됩니다. 오른쪽 상단에 있는 전원 버튼은 지문 센서 기능도 겸하고 있습니다.
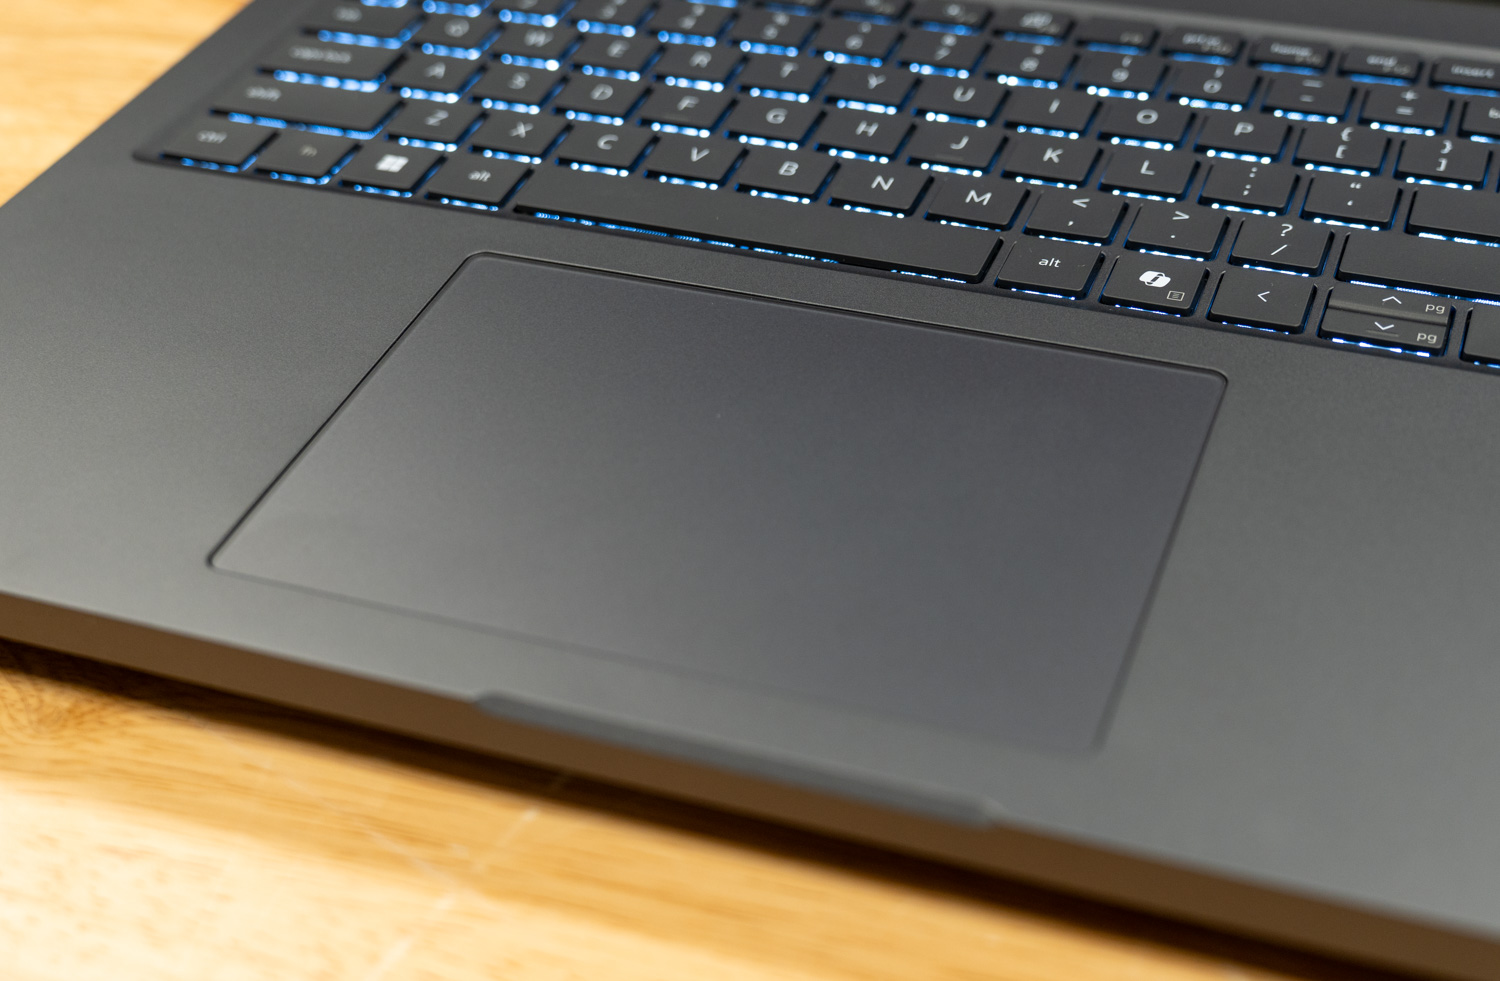
넉넉한 크기의 터치패드는 16인치 크기에 잘 어울립니다. 매끄러운 눈부심 방지 표면은 정확한 트래킹을 제공하며, 팜 리젝션 기능은 테스트 내내 완벽하게 작동했습니다.
업그레이드 가능성
Pro Max 16 Plus는 확장성을 염두에 두고 설계되어 상당한 업그레이드 가능성을 제공합니다. 3개의 M.2 Gen5 스토리지 슬롯, CAMM2 메모리 슬롯, 그리고 교체 가능한 USB-C 포트를 포함한 여러 모듈식 구성 요소를 갖추고 있습니다.
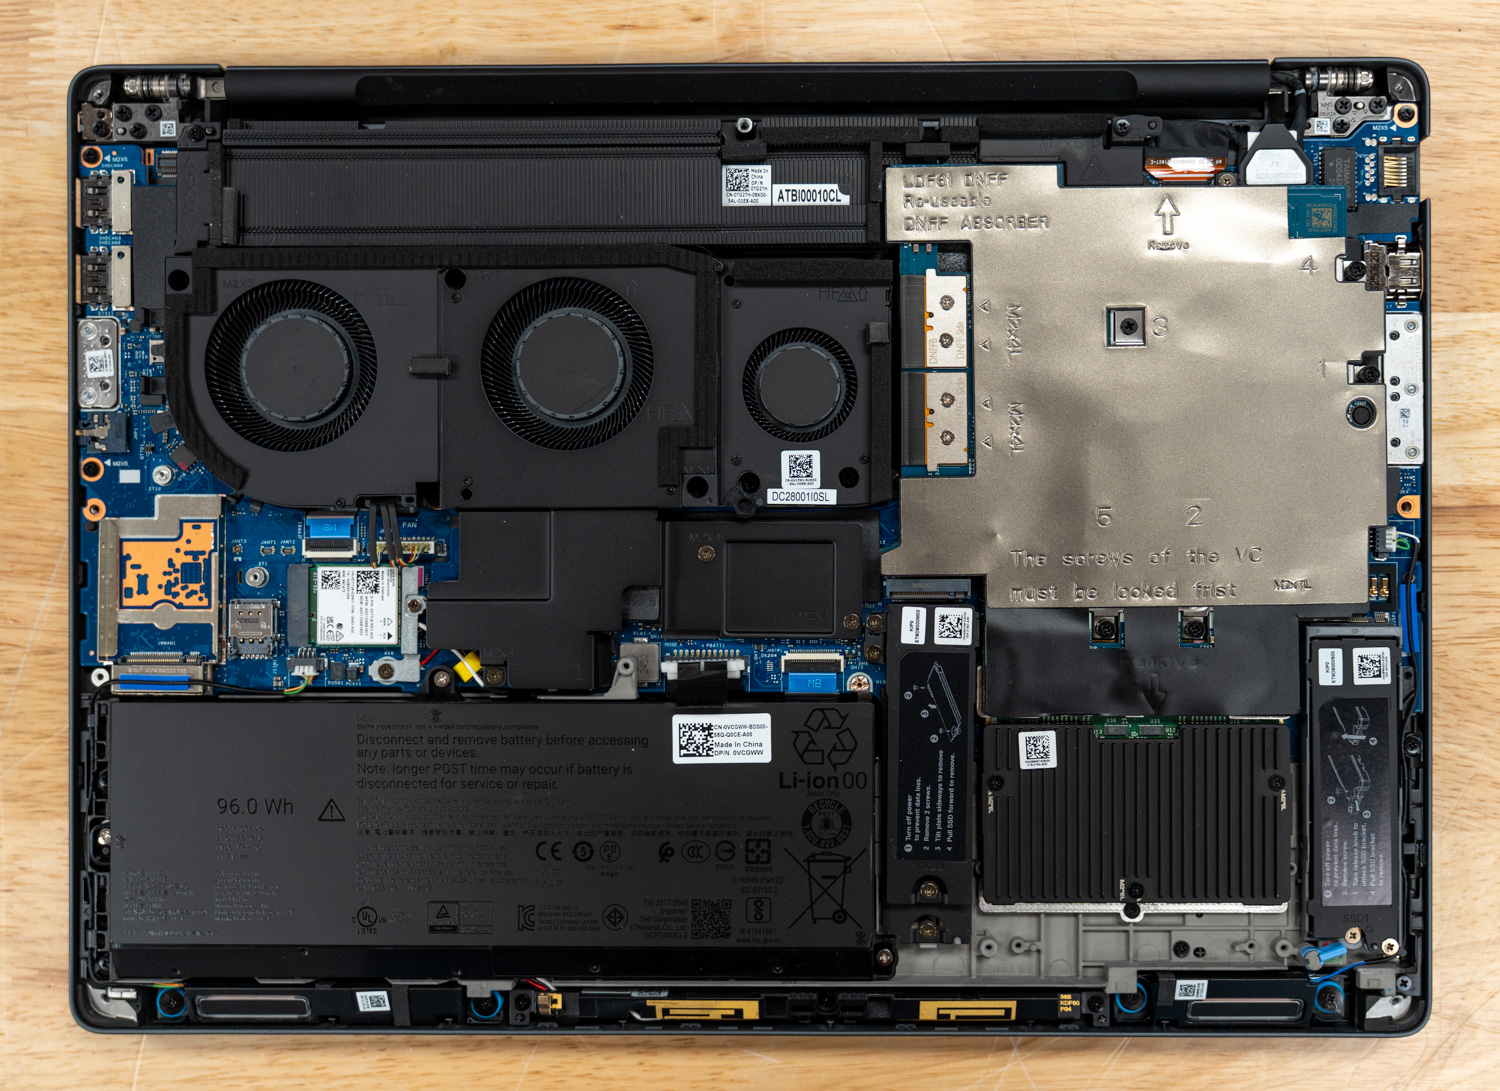
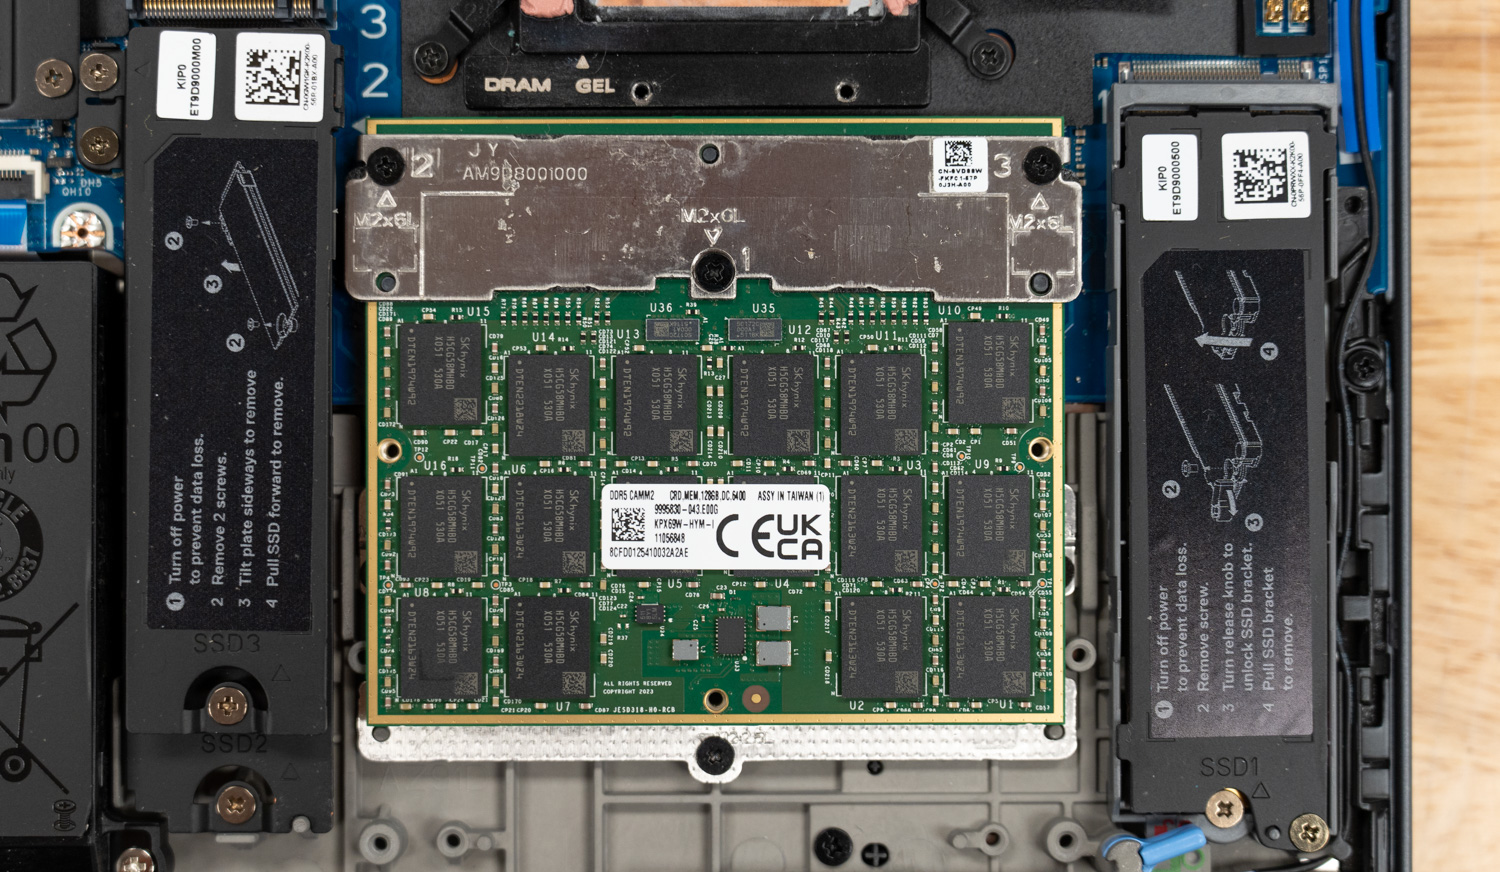
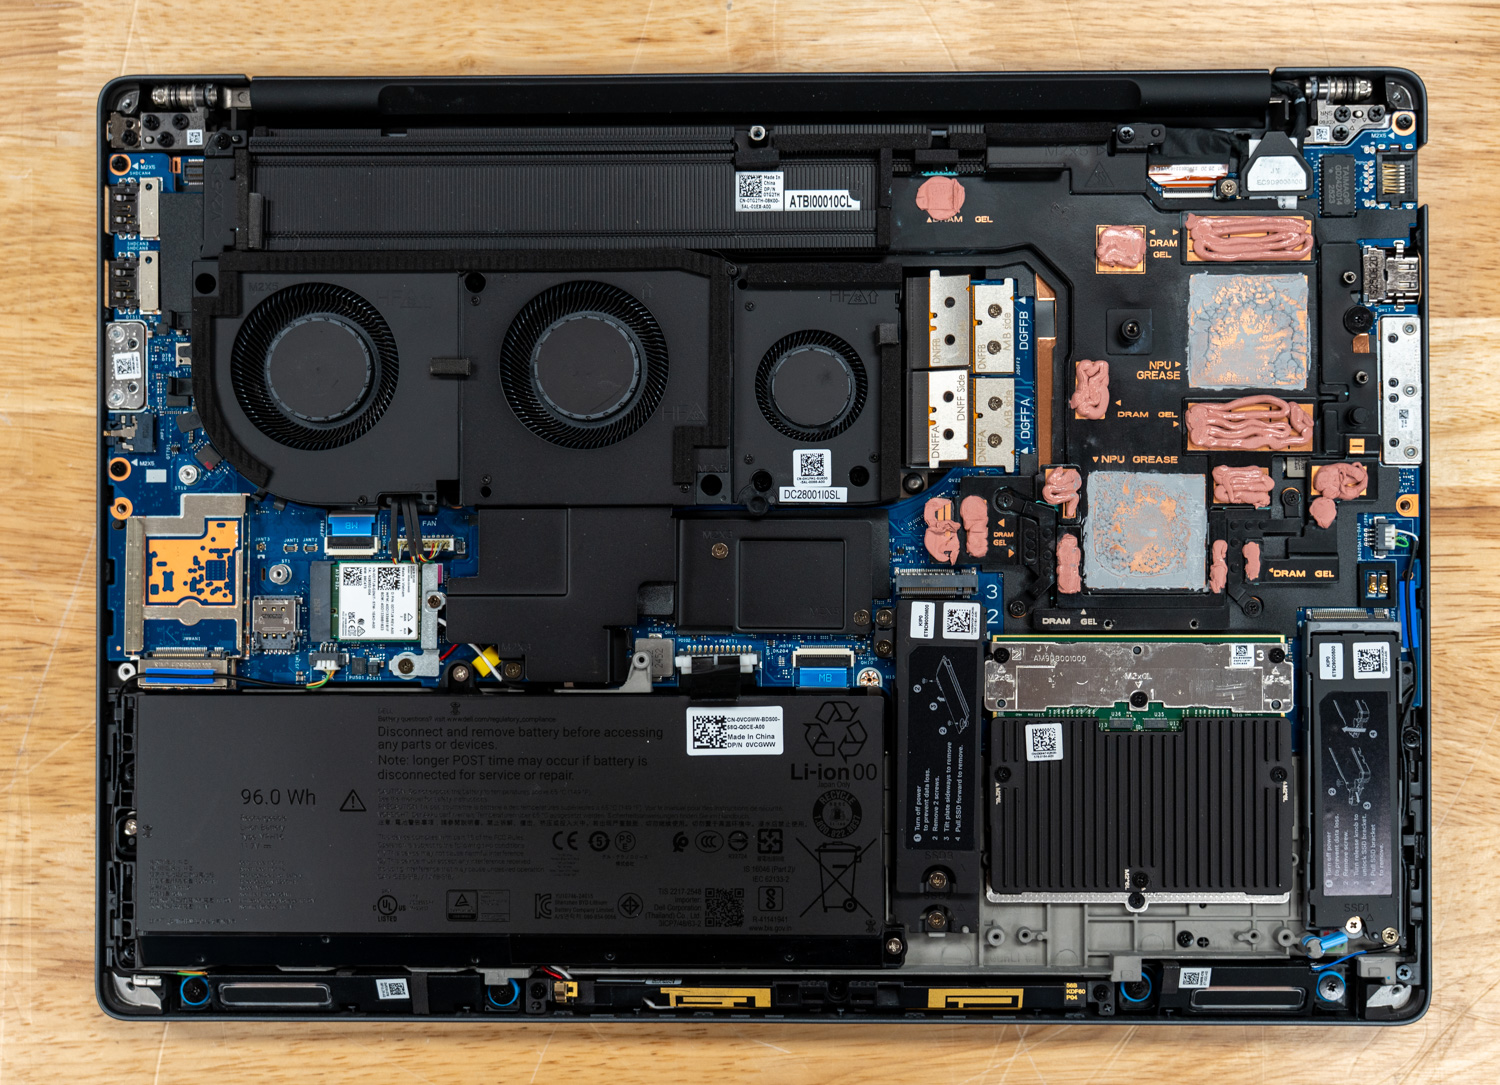
내부 접근은 간단합니다. 테두리 나사를 풀고 하단 패널을 뒤에서 앞으로 들어 올리면 됩니다. 내부에는 강력한 3개의 팬으로 구성된 냉각 시스템과 넉넉한 96Whr 배터리가 있습니다. CAMM2 메모리 모듈은 오른쪽 하단에 전용 방열판 아래에 위치하고 있으며, 양쪽에는 M.2 슬롯이 있습니다. 사진으로는 잘 보이지 않지만, 왼쪽에 있는 M.2 슬롯은 실제로 동일한 공간에 두 개의 드라이브를 장착할 수 있는 적층형 슬롯입니다. 사용자가 교체할 수 있는 M.2 무선 카드는 배터리 바로 위에 있습니다.
이번 행사의 주인공: 퀄컴 AIC100
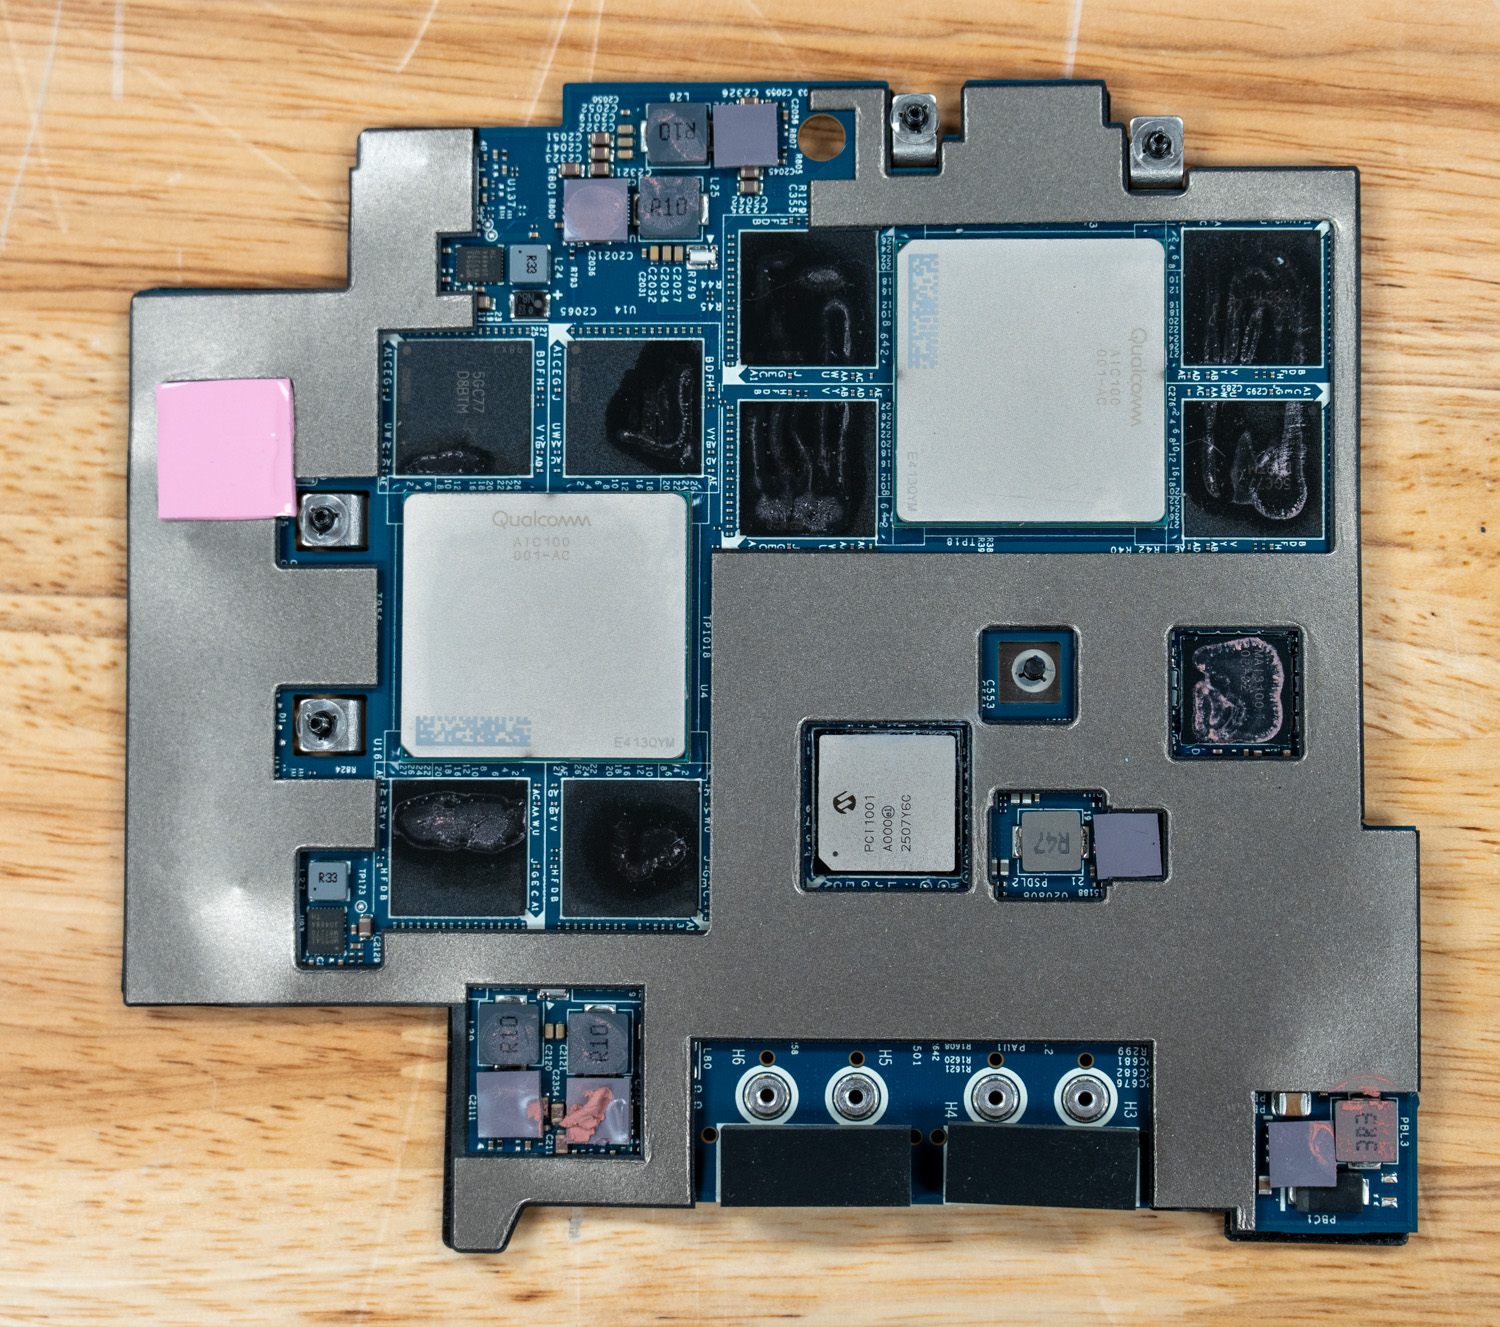
이번 리뷰 대상인 델 제품은 퀄컴 AI 100 NPU를 탑재하고 있으며, 이 NPU는 두 개의 퀄컴 클라우드 AI 100 SoC가 나란히 배치된 단일 모듈입니다. 각 SoC는 16개의 AI 코어를 제공하여 모듈 전체에서 총 32개의 AI 코어를 지원하며, 각각 32GB의 LPDDR4x 메모리를 탑재하여 호스트에 두 개의 개별 NPU로 제공됩니다.
델과 퀄컴은 약 450 TOPS의 INT8 처리량과 100억 개 파라미터 범위의 모델을 실행할 수 있는 능력을 광고하고 있으며, 델은 노트북에서 로컬로 실행되는 Llama 4 Scout(109억 파라미터, MoE)를 공개적으로 시연했습니다. 두 SoC는 Linux QAIC 가속기 드라이버를 통해 호스트와 통신하며, 펌웨어 블롭은 linux-firmware에 업스트림됩니다.
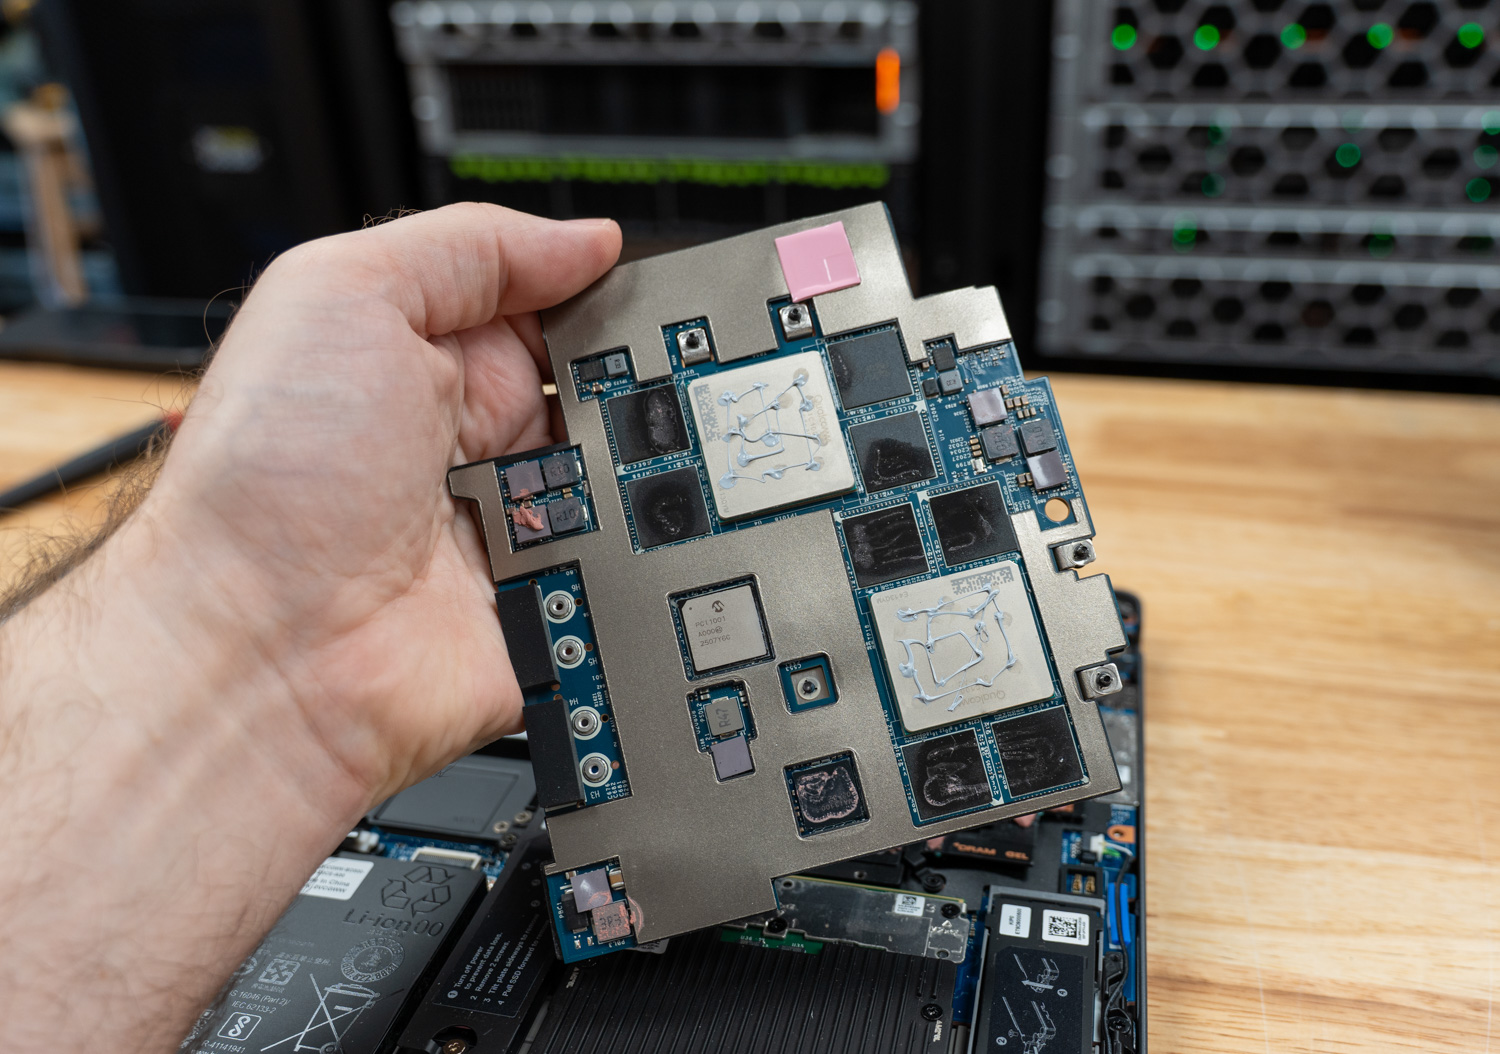
지금까지는 그럴듯해 보입니다. 숫자 자체는 크지만, 문제는 그 숫자 아래에 있는 실리콘입니다.
퀄컴은 2019년 4월에 클라우드 AI 100을 발표하고, 2020년 말에 샘플을 제공했으며, 2021년 상반기에 상용 출시를 시작했습니다. 이 칩은 7nm 공정으로 제작되었으며, 2100MHz로 동작하는 64비트 LPDDR4X 컨트롤러 4개(LPDDR4X-4200)를 사용하여 SoC당 136GB/s의 메모리 대역폭을 제공한다고 퀄컴의 클라우드 AI 아키텍처 문서에 명시되어 있습니다.
이 칩은 원래 PCIe 폼팩터를 염두에 두고 설계되었습니다. 이러한 칩 두 개를 맞춤형 모듈에 탑재하여 2025년형 노트북에 넣는다고 해서 근본적인 설계상의 차이가 생기는 것은 아닙니다. 2019년 당시의 실리콘과 메모리 기술을 그대로 가져와 이름만 바꾸고 아키텍처는 동일한 제품군으로 만든 것입니다. 델 프로 맥스 16 플러스에 탑재될 당시, 업계는 이미 HBM2e, HBM3, HBM3e, LPDDR5X를 거쳐 이제는 고성능 AI 가속기에 GDDR7과 HBM4를 도입하고 있는 추세입니다.
하지만 메모리 대역폭보다 더 근본적인 문제가 있습니다. 업계에는 AI 추론 문제를 매우 깊이 이해하는 뛰어난 칩 설계 및 엔지니어링 팀이 많으며, 클라우드 AI 100 아키텍처 자체도 충분히 훌륭할 수 있습니다. 문제는 제품의 성패를 좌우하는 소프트웨어 엔지니어들이 이미 다른 생태계, 즉 CUDA에 막대한 투자를 했다는 점입니다. 강력한 전환 동기가 없다면 개발자들은 이미 훌륭한 지원, 문서, 그리고 커뮤니티의 도움을 받는 툴체인을 고수할 수밖에 없습니다. NVIDIA는 일찌감치 개발자 기반을 확보하고 거대한 커뮤니티를 구축했습니다. AMD는 이 분야에서 수년간 뒤처졌지만, 최근 ROCm 개정판은 정말 훌륭하며 격차를 좁히고 있습니다. Modular의 Mojo나 MAX 같은 솔루션은 동일한 코드로 NVIDIA 또는 AMD를 대상으로 할 수 있게 해주고, 때로는 네이티브 런타임보다 뛰어난 성능을 보여주기도 합니다. 하지만 다른 모든 가속기는 소프트웨어 지원 부족으로 인해 대중적인 채택에 어려움을 겪고 있습니다.
'공개적인 채택'이 핵심입니다. 구글 같은 대기업은 TPU의 성능을 극대화하기 위해 XLA와 JAX에 수십억 달러를 투자할 수 있습니다 . 자금력이 풍부한 스타트업이나 AI 연구소는 자신들이 개발한 특정 모델에 맞는 맞춤형 커널을 만들 수 있고, 다른 사람들이 자신들이 만든 스택을 복제할 수 없다는 사실에 신경 쓰지 않습니다. 그들은 자신들이 직면한 문제를 해결하기 위해 개발하는 것이기 때문입니다. 하지만 일반 소비자나 대부분의 기업에게 있어, 활발한 개발자 생태계가 없는 액셀러레이터는 사실상 무용지물입니다. 모델을 적용하는 데 몇 주씩 허비하게 될 것이고, Hugging Face에서 새로운 아키텍처를 출시하는 순간, CUDA나 ROCm을 사용하는 사람들이 출시 당일부터 지원을 받는 동안 여러분은 재컴파일 작업(또는 지원되지 않는 모델 오류)에 직면하게 될 것입니다.
그러니까 분명히 말씀드리겠습니다. 이 노트북에 탑재된 AIC100은 완전히 쓸모없습니다. 개인이나 기업 모두 이 제품을 구매해서는 안 됩니다. 특히 기업이라면 자체적인 워크로드에 맞춰 추론 시스템을 처음부터 구축하고 유지 관리할 수 있는 엔지니어링 자원과 의지가 확고하지 않다면 더욱 그렇습니다.
소프트웨어 및 툴의 현실
해당 권고 사항이 왜 그토록 가혹한지 이해하려면 이 카드의 배송 추론이 실제로 무엇을 의미하는지 살펴봐야 합니다.
사용자가 직접 사용하는 부분은 두 개의 SDK와 하나의 래퍼 라이브러리로 나뉩니다. Qualcomm Cloud AI Platform SDK는 커널 드라이버(메인라인 Linux의 업스트림 accel/qaic 드라이버), 디바이스 펌웨어, 온카드 런타임 및 저수준 API를 제공합니다. Apps SDK는 그 위에 구축되어 qaic-exec 컴파일러, qaic-runner 추론 CLI, QAIC 실행 공급자를 통한 ONNX 런타임 통합, Python 바인딩 및 vLLM 포크를 제공합니다. QEfficient라고도 하는 Qualcomm efficient-transformers 라이브러리는 AIC100에 필요한 정적 형상, KV 캐시 레이아웃 및 그래프 변환을 사용하여 널리 사용되는 LLM 아키텍처를 재구현하는 Hugging Face Transformers 래퍼입니다. Qualcomm AI Hub는 AIC100보다는 Snapdragon급 디바이스를 대상으로 하는 별도의 모델 카탈로그 및 컴파일 서비스 제품이지만, 브랜드는 동일합니다.
컴파일 경로는 엄격합니다. PyTorch 모델을 torch.export 또는 ONNX를 사용하여 내보낸 다음, -convert-to-fp16, -mxfp6-matmul과 같은 플래그, 배치 크기, 컨텍스트 길이, 대상 SoC 개수와 함께 qaic-exec에 입력합니다. 컴파일러는 사전 스케줄링 및 메모리 배치를 수행한 후, 메모리 레이아웃, KV 캐시 모양, 배치 크기, 프리필 시퀀스 길이 및 컨텍스트 길이를 고정하는 밀봉된 바이너리인 QPC(Qualcomm Program Container)를 생성합니다. JIT는 사용되지 않습니다. Qualcomm의 LLM 문서에 따르면, 사전 AI 100 컴파일러는 프롬프트 길이, 생성 길이, KV 캐시 및 배치 크기를 기반으로 장치 리소스를 미리 할당하며, Cloud AI 100은 정적 입력 모양만 지원합니다. 이러한 컴파일 시간 매개변수를 변경하면 전체 컴파일이 다시 시작되며, 작은 모델의 경우 몇 분, 큰 모델의 경우 몇 시간이 걸릴 수 있습니다.
지원되는 아키텍처 목록은 매우 짧습니다. Dell이 고객에게 안내하는 QEfficient 라이브러리와 Zentree에서 호스팅하는 사전 구축된 QPC 카탈로그는 대부분 구형 모델만 지원하며, 2026년에 실제로 사용할 만한 모델은 몇 개에 불과합니다.
최신 FP8 네이티브 체크포인트는 재양자화를 필요로 합니다. 인기 있는 GPT-OSS 모델처럼 MXFP4로 기본 제공되는 모델의 경우, 가중치를 바로 적용하는 것이 아니라 변환 및 재컴파일 과정을 거쳐야 합니다. 이러한 과정은 노력만 한다면 해결할 수 있지만, 지속적인 부담이 될 수 있습니다.
다음으로 동시성 문제가 있는데, 이는 개발자가 기본 성능에 집중하더라도 노트북의 한계를 드러내는 부분입니다. Dell에서 제공하는 컨테이너 이미지(사용자가 다운로드하여 vLLM으로 실행하도록 안내하는 이미지)는 Zentree에서 특정 형태로 사전 컴파일한 QPC를 기반으로 하며, 기본 컨테이너는 동시성 1로만 실행됩니다. 입력 또는 출력 시퀀스 형태와 관계없이 특정 모델에 대해 고정된 처리량만 제공됩니다. 여러 병렬 요청이 동시에 실행되지 않고, vLLM에 의해 순차적으로 처리됩니다. 동적 배치 처리가 불가능하며, vLLM이나 SGLang이 AMD 또는 AMD GPU에서 무료로 제공하는 연속 배치 처리를 사용할 수 없습니다. 동시성 1 이상을 얻으려면 더 큰 배치 크기로 QPC를 다시 컴파일해야 합니다.
델은 이 노트북을 개발자들에게 어필하는 예시를 제시하는데, 오늘날 개발자들이 가장 많이 사용하는 AI 활용 사례는 Claude Code, OpenCode 등의 도구를 사용한 바이브 코딩입니다. 이러한 도구에 대한 단일 요청은 여러 개의 병렬 LLM 호출로 분산될 수 있습니다. 기본적으로 이러한 NPU는 이러한 요청을 큐에 넣고 병렬이 아닌 순차적으로 처리하므로 NVIDIA Spark에서 몇 초면 완료될 작업이 이 시스템에서는 몇 분이 걸릴 수 있습니다.
성능
Dell에서 테스트용으로 제공한 시스템은 다음과 같은 구성을 가지고 있습니다.
- 인텔 코어 울트라 9 285HX CPU
- 퀄컴 AIC100 PC 추론 카드
- 128GB 6400MTs CAMM2 DDR5
- 4TB SSD
수치를 제시하기 전에 방법론에 대한 설명을 드리겠습니다. 앞서 설명드린 바와 같이, AIC100은 배치 크기, 시퀀스 길이 및 KV 캐시 레이아웃이 고정된 사전 컴파일된 QPC를 실행합니다. Dell은 Zentree에 호스팅된 엄선된 사전 컴파일된 QPC 세트와 첫 부팅 시 이를 다운로드하는 vLLM 컨테이너 이미지를 이 노트북과 함께 제공합니다. Dell의 레퍼런스 컨테이너를 통해 동시 실행률 1로 제공되는 이 사전 컴파일된 QPC 세트가 최종 사용자가 노트북을 개봉하고 Dell의 설명서를 따를 때 실제로 받게 되는 구성이며, 저희가 벤치마킹한 구성도 바로 이 구성입니다.
우리는 다른 방식으로도 작업을 수행할 수 있는 도구를 갖추고 있습니다. qaic-exec를 추출하고, 체크포인트를 생성하고, torch.export를 통해 내보내고, 다시 양자화하고, 더 큰 배치 크기로 QPC를 재컴파일한 다음 vLLM을 통해 다시 실행할 수도 있습니다. 원한다면 QAIC 가속기 드라이버에 대한 사용자 지정 커널을 작성할 수도 있습니다. 하지만 그렇게 하지 않기로 했습니다. 이 노트북의 목표 시장인 개발자, AI에 관심 있는 엔지니어, 그리고 기업 시범 운영팀의 대다수는 그런 작업을 하지 않을 것이기 때문입니다. 그들은 컨테이너를 추출하고 실행한 다음 결과물을 보고 제품을 평가할 것입니다. 그래서 우리는 그 결과를 측정했습니다.
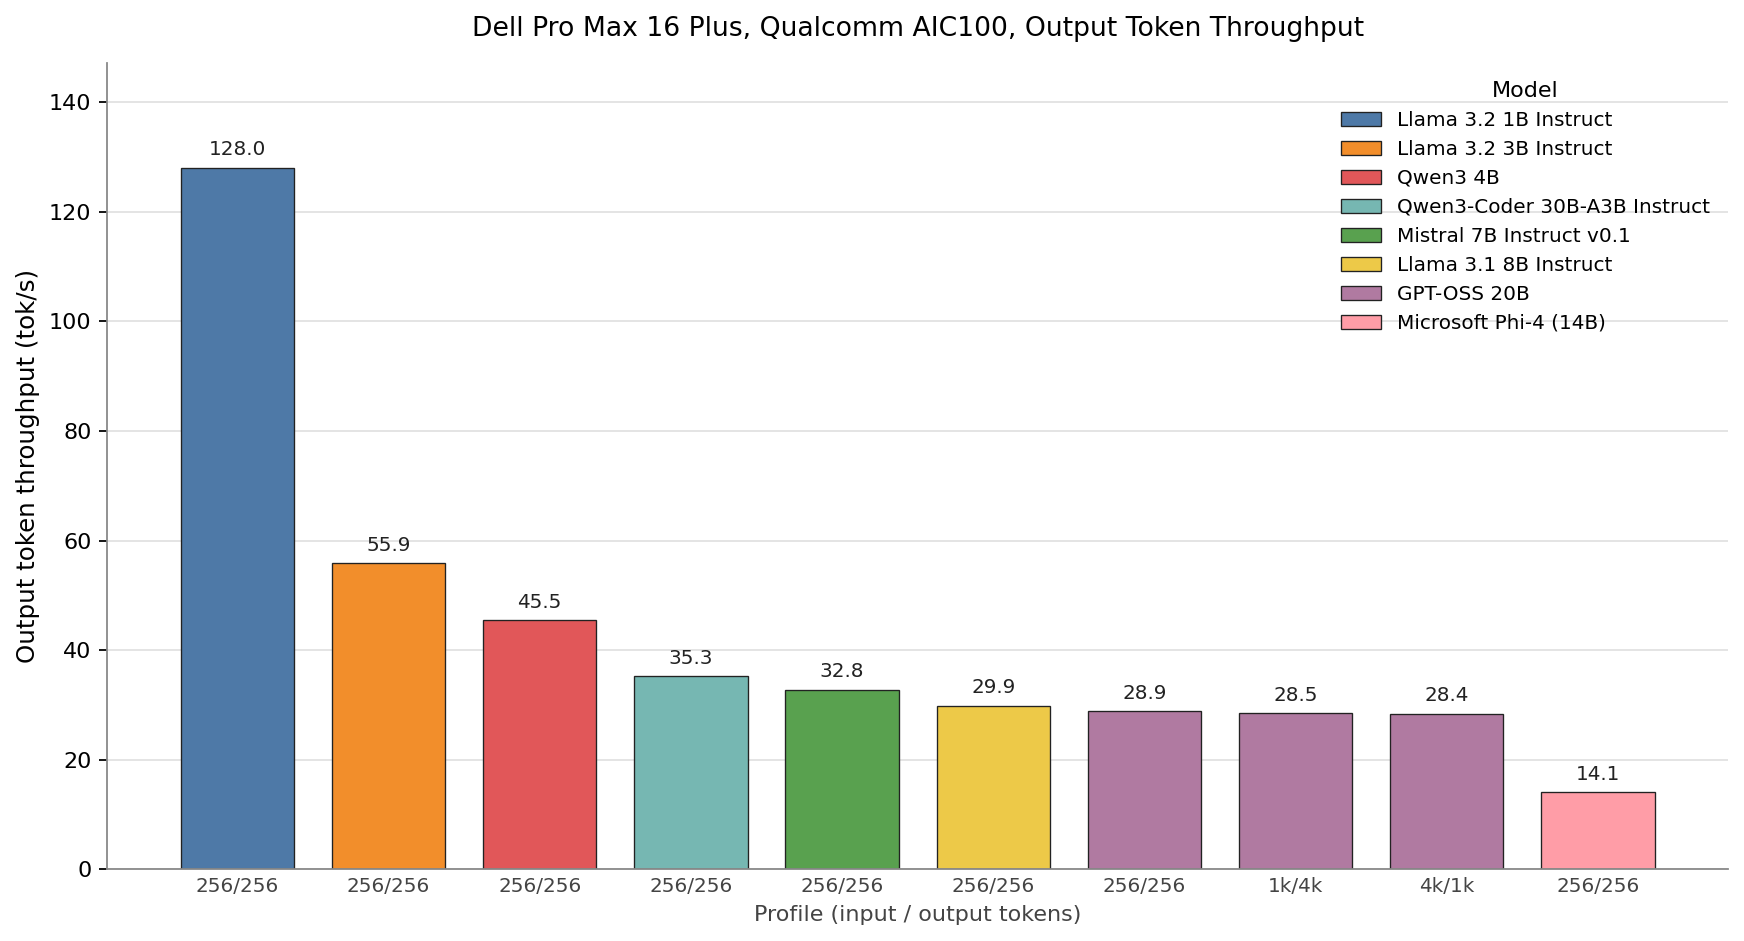
각 막대는 MXFP6 가중치와 MXINT8 KV 캐시를 사용하는 Qualcomm 컴파일 QPC를 나타내며, 이는 Dell에서 출하하는 모든 제품에 사용되는 정밀도입니다. 차트에서 100 TPS를 초과하는 모델은 Llama 3.2 1B뿐이며, 128 TPS를 기록했습니다. 그 뒤를 이어 Llama 3.2 3B가 56 TPS, Qwen3 4B가 45 TPS, Qwen3-Coder 30B-A3B가 35 TPS, Mistral 7B가 33 TPS, 그리고 Llama 3.1 8B가 30 TPS를 기록했습니다. GPT-OSS 20B는 256/256, 1k/4k, 4k/1k 프로파일에서 각각 28.9, 28.5, 28.4 TPS를 기록하며, 퀄컴 문서에서 AOT 컴파일러에 대해 약속한 내용, 즉 특정 셰이프에 대한 QPC가 구축되면 디코딩 속도가 고정되고 프롬프트 길이가 토큰당 비용에 영향을 미치지 않는다는 점을 확인시켜 줍니다. Phi-4는 14 TPS로 차트의 마지막을 장식합니다.
위의 모델보다 더 큰 모델도 이 카드에 탑재할 수 있지만, 벤치마킹은 진행하지 않았습니다. 예를 들어 Dell에서 공개적으로 시연하는 Llama 4 Scout 모델의 경우, 정밀도를 INT4까지 더 낮춰야 하며, 실제로는 양자화가 덜 된 작은 모델이 양자화가 많이 된 큰 모델보다 많은 작업 부하에서 더 나은 성능을 보입니다.
기본 제공되는 vLLM 컨테이너는 모든 QPC를 batch_size=1로 실행하며, 실제로 두 개의 요청을 동시에 보내도 처리량이 두 배로 늘어나지 않는다는 것을 확인했습니다. 두 번째 요청은 첫 번째 요청이 완료될 때까지 소프트웨어 큐에서 대기할 뿐입니다. 기본 스택에는 연속 배치 처리, 실행 중 배치 처리 또는 예측 디코딩 기능이 없습니다. Claude Code나 OpenCode처럼 단일 사용자 턴에서 여러 개의 병렬 LLM 호출을 실행하는 코딩 에이전트의 경우, 이러한 단일 스트림 제한으로 인해 몇 초면 응답해야 할 시간이 몇 분씩 걸리는 대기 시간으로 변합니다. 배치 크기를 늘리려면 호스트에서 QPC를 다시 컴파일해야 하는데, 이는 이미 피했던 문제로 다시 돌아가는 것입니다.
NVIDIA Spark와 비교해 보겠습니다. 256/256 입력 및 출력 시퀀스 길이에서 Spark는 Dell의 Qualcomm AIC 100이 20B 모델을 실행하는 것보다 더 빠르게 120B 모델을 실행할 수 있습니다. 게다가 이 수치는 Spark가 제공할 수 있는 최고의 성능도 아닙니다. 이 결과는 출시 당시 소프트웨어 버전의 Marlin 커널을 사용하여 수집되었기 때문입니다.
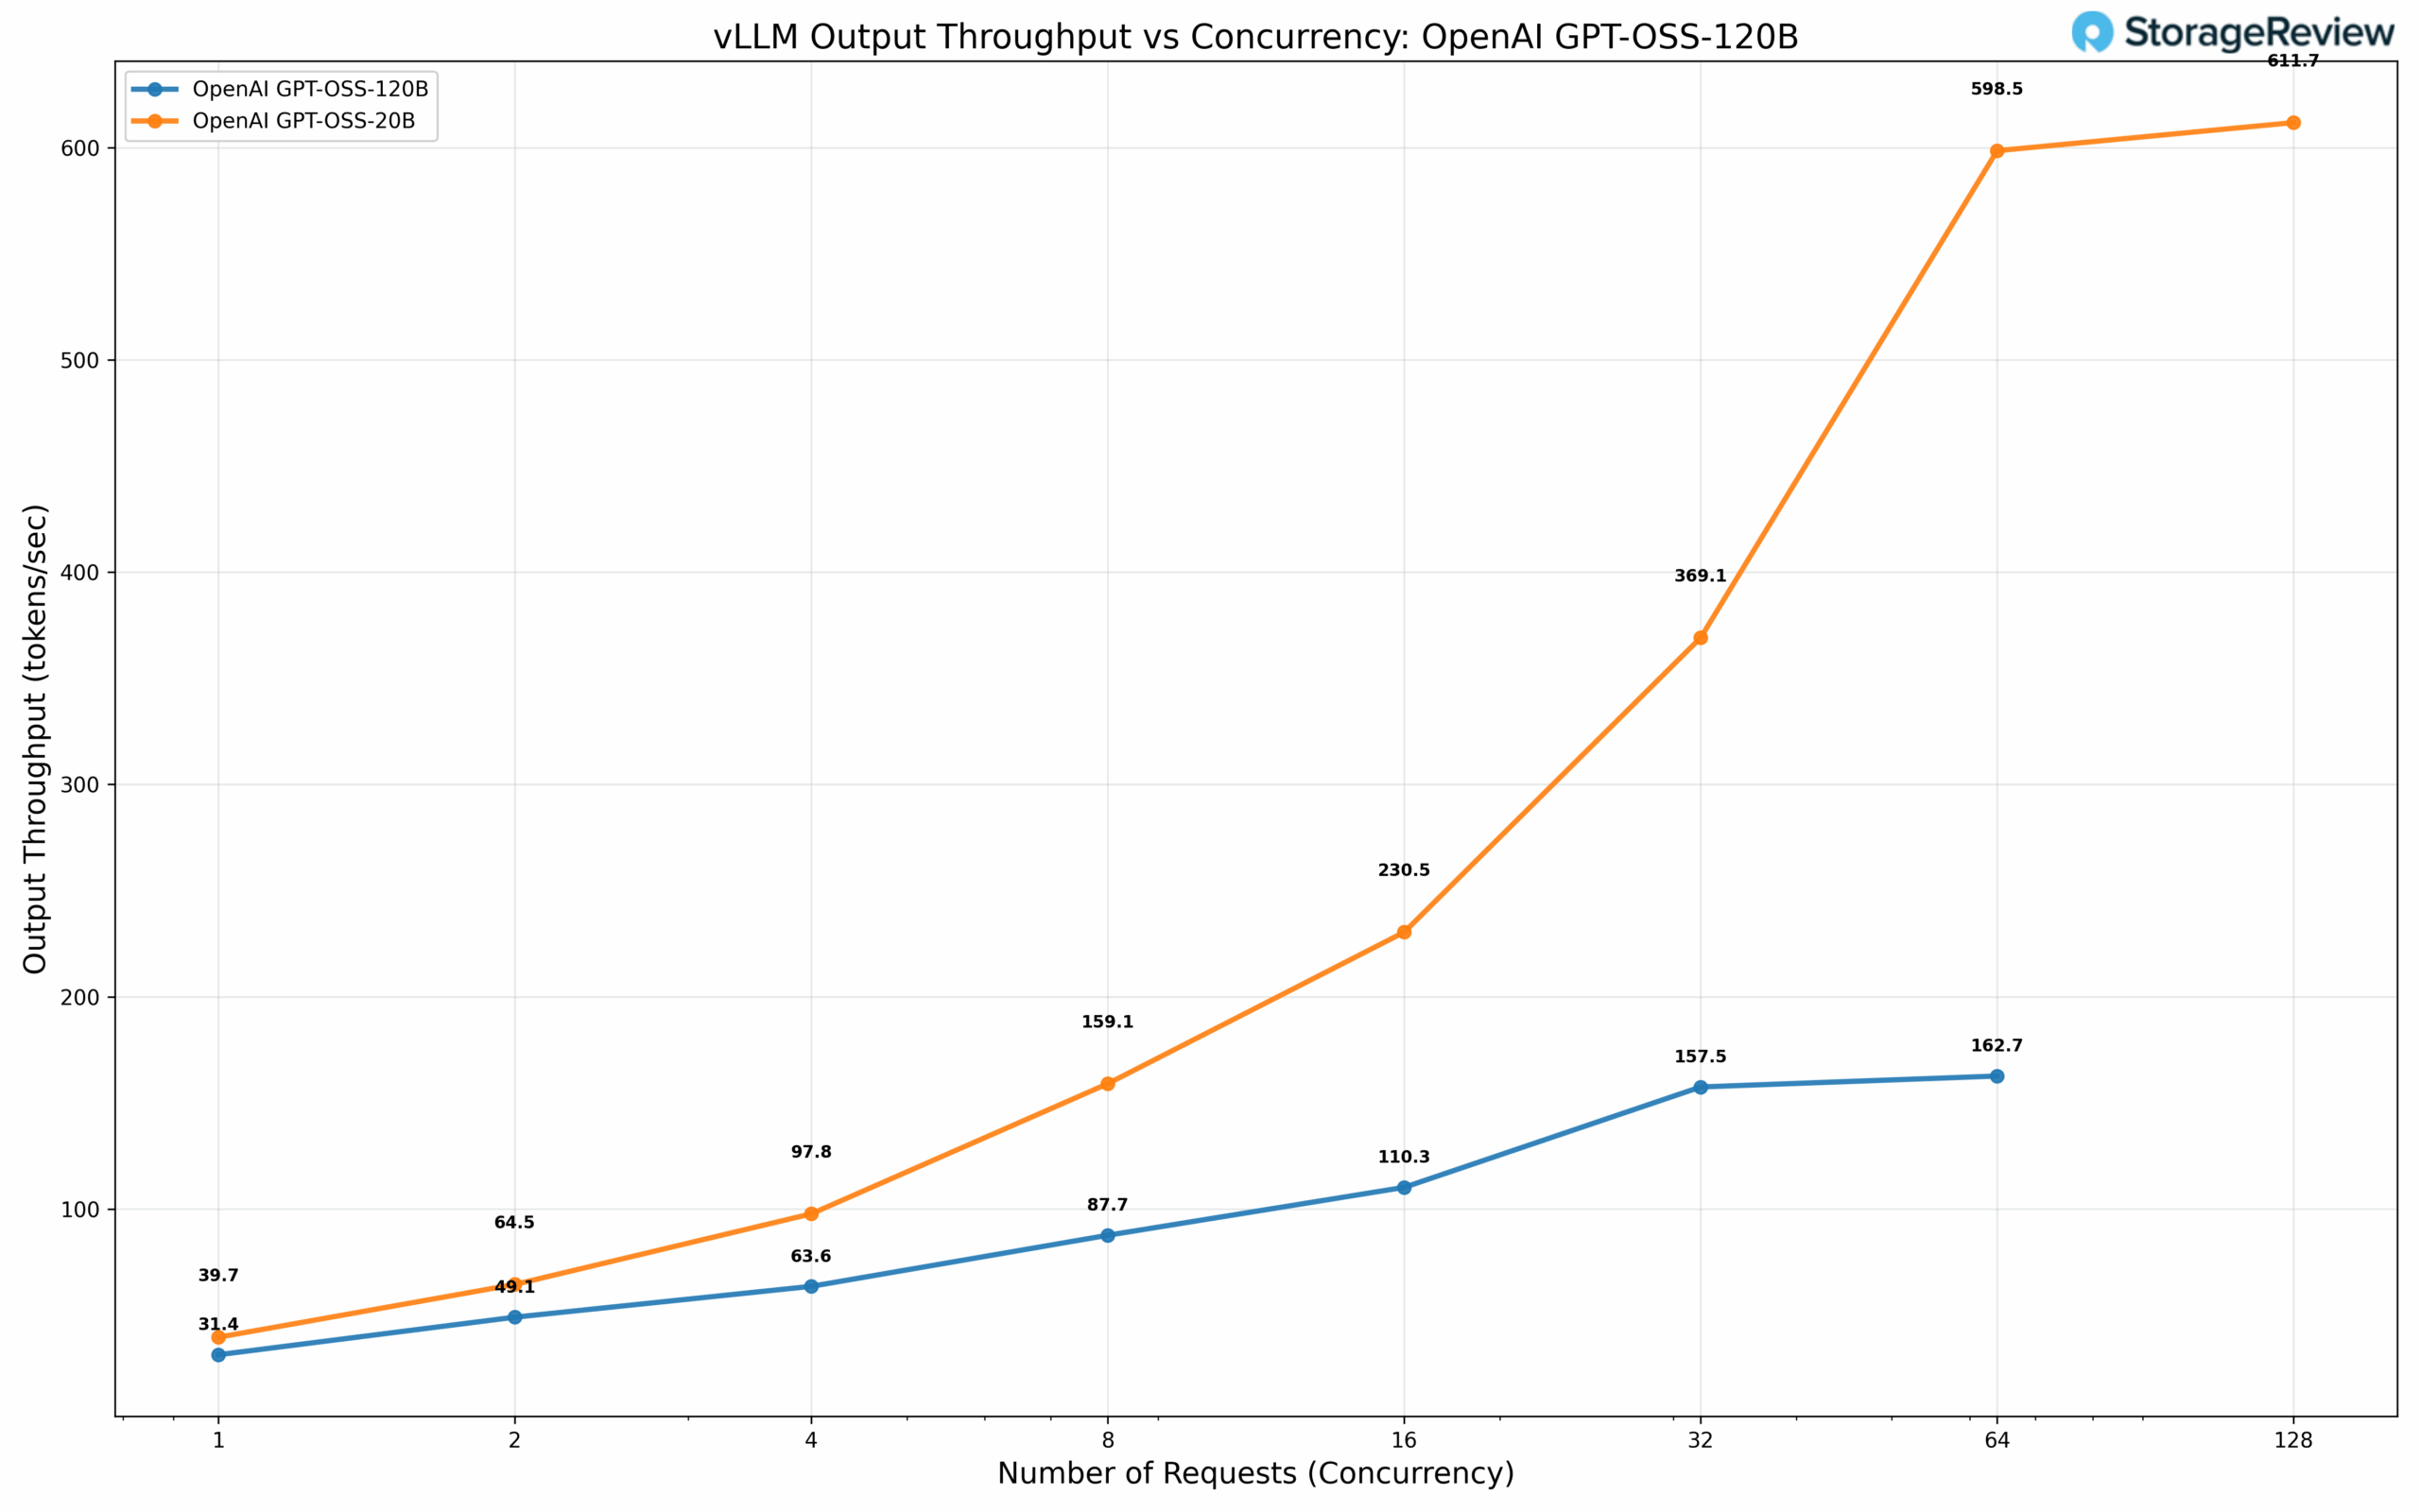
결론은 제한적입니다. 단일 사용자, 단일 대화, 그리고 SoC당 136GB/s의 LPDDR4X 메모리가 제약 조건이 되지 않는 소형 모델(Llama 3.2 1B, 그리고 어쩌면 Llama 3.2 3B)의 경우, 이 노트북에 탑재된 AIC100은 쓸만합니다. 하지만 고객이 실제로 받는 구성에서 그보다 더 큰 규모의 환경에서는, 단일 스트림 디코딩과 퀄컴이 미리 준비하지 않은 형태의 데이터를 처리하는 정적 컴파일 파이프라인 때문에 이 가속기는 옆에 있는 인텔 코어 울트라 HX의 통합 NPU 및 통합 GPU보다 성능이 떨어지고, 심지어 같은 섀시에 장착할 수 있는 NVIDIA 외장 그래픽 카드와도 비교할 수 없습니다.
단순 사양만 비교해 보면, NVIDIA Spark는 273GB/s의 대역폭을 제공하고 , 단일 칩에서 FP8(E4M3) 연산의 최대 부동 소수점 연산 성능(MAMF)은 200TFLOPs로 측정되었습니다 . QAIC는 2개의 칩을 사용하여 272GB/s의 대역폭과 435TFLOPS의 INT8 연산 성능을 제공한다고 광고하고 있습니다. 따라서 이론적으로는 두 제품의 성능이 비슷해야 하지만, 퀄컴 제품이 소프트웨어적인 차이로 인해 뒤처지는 것입니다.
이 제품은 누구를 위한 것이며, 구매해야 할까요?
오늘날 진지한 AI 작업을 하려는 사람이라면 누구든 이 구성은 절대 구매하지 마십시오.
델 미국 스토어에서는 Pro Max 16 Plus의 AIC100 SKU를 최고 사양(Core Ultra 9 285HX, 128GB RAM, 4TB SSD)이 14,871.56달러, 중간 사양(Core Ultra 7 265HX, 64GB, 1TB)이 9,661.56달러, 기본 사양이 8,831.56달러에 판매하고 있습니다. 모든 모델은 우분투 리눅스만 설치되어 출고되며, 윈도우 지원은 곧 제공될 예정입니다. 테스트 결과, 이 제품의 가격대는 14,000달러에서 15,000달러 사이로 예상됩니다.
참고로 NVIDIA의 DGX Spark는 현재 4,699달러에 판매되고 있습니다. 이 가격으로 GB10 Grace Blackwell Superchip , 128GB의 통합 LPDDR5X 메모리, 4TB NVMe, Blackwell GPU, 그리고 약 1페타플롭의 FP4 AI 컴퓨팅 성능을 모두 얻을 수 있으며, CUDA 소프트웨어 스택, TensorRT-LLM, NIM, 그리고 NVIDIA의 모든 생태계가 지원됩니다. DGX Spark 한 대만으로도 이 노트북에 탑재된 AIC100보다 거의 모든 현실적인 AI 워크로드에서 뛰어난 성능을 발휘하며, 올해 채용된 AI 엔지니어라면 누구나 이미 사용법을 알고 있는 소프트웨어로 이러한 성능을 구현할 수 있습니다. 저희 리뷰 제품 가격으로 DGX Spark 세 대를 구매하고, 각각 모니터, 주변기기, 책상까지 갖춰주고도 돈이 남을 정도입니다. 소규모 AI 개발이 취향에 맞지 않는다면, 인텔 285K, 128GB DDR5 RAM, NVIDIA RTX Pro 6000 GPU를 탑재한 Dell Pro Max Tower T2 워크스테이션 도 SSD 용량에 따라 약 15,000달러 정도에 구입할 수 있습니다.
델이 훌륭한 본체에 전자 폐기물과 다름없는 부품을 집어넣었다는 느낌을 지울 수 없습니다. RTX PRO 5000이 탑재된 Pro Max 16 Plus는 환상적인 모바일 워크스테이션입니다. 하지만 동일한 모델에 AIC100을 탑재하면 델의 보증 하에 엉망진창인 과학 실험처럼 보입니다.
맺음말
만약 당신이 몇 년 후 이 글을 읽고 있는 DIY 애호가이고, 떨이 판매대에서 200~300달러에 이런 노트북을 발견한다면, 꼭 사세요. 이 시스템은 수리와 업그레이드가 가능하고, 키보드도 훌륭하며, AIC100 모듈을 활용해서 주말 프로젝트로 흥미로운 기능을 구현하는 것은 이 하드웨어가 마땅히 누려야 할 부담 없는 즐거움입니다.
오늘날 진지하게 AI 작업을 하려는 사람이라면 Pro Max 16 Plus에 다른 가속기를 장착하는 것이 훨씬 낫습니다. NVIDIA RTX PRO 모바일 GPU, 심지어 보급형 RTX PRO 1000조차도 AIC100 모듈보다 훨씬 나은 성능을 제공할 것입니다. 인텔 코어 울트라 HX의 통합 NPU는 Windows ML, OpenVINO 및 기존 PC AI 스택과 호환되므로 많은 실제 시나리오에서 더 나은 선택이 될 수 있습니다.
델에 제안하고 싶은 한 가지 사항이 있습니다. Pro Max 16 Plus는 훌륭한 섀시이며, Pro Max 라인은 시장에서 가장 강력한 모바일 워크스테이션 플랫폼 중 하나입니다. 하지만 현재 출시된 AIC100 SKU는 그 기준에 전혀 부합하지 않습니다. 실험용 또는 개발자용 사전 테스트 제품 라인을 별도로 출시하고, 이를 명확히 표시한다면, 델은 아직 완성도가 떨어지는 제품에 Pro Max라는 브랜드 이름을 붙이지 않고도, 새로운 가속기를 사용해보고 싶어하는 고객들에게 제품을 제공할 수 있을 것입니다. Pro Max 브랜드는 보호할 가치가 있으며, 실험적인 하드웨어를 위한 적절한 플랫폼을 마련하면서도 브랜드를 보호할 수 있는 깔끔한 방법이 분명히 있습니다.


 아마존