

지난 몇 년 동안 대규모 언어 모델을 로컬에서 실행하는 것이 훨씬 쉬워졌지만, 모델을 다운로드하는 것과 유용한 데스크톱 환경을 갖추는 것 사이에는 여전히 격차가 존재합니다. Jan은 ChatGPT의 대안으로, 친숙한 채팅 스타일 인터페이스를 갖춘 오픈 소스 데스크톱 앱을 제공하며, 대부분의 설정 작업을 앱 내에서 처리할 수 있습니다. llama.cpp를 통해 다운로드한 모델을 로컬에서 실행할 수 있을 뿐 아니라 호스팅된 AI 서비스에도 연결할 수 있으므로, 동일한 인터페이스에서 로컬 모델과 클라우드 기반 모델을 모두 사용할 수 있습니다.
이번 실습 가이드는 저희가 자체 테스트 하드웨어를 사용하여 목록에 있는 플랫폼들을 하나씩 테스트하면서 얻은 반복 가능한 성능 결과를 추가하고 있는 ' 최고의 로컬 LLM 도구' 순위표 와 관련된 첫 번째 가이드이기도 합니다.
Jan은 기본적인 로컬 채팅 외에도 내장 모델 허브, 웹 검색 및 페이지 가져오기, 이미지 입력, MCP 통합, OpenAI 호환 로컬 API를 포함하고 있습니다.
이번 실습에서는 Intel Xeon w5-2465X, 128GB RAM, 32GB VRAM을 탑재한 NVIDIA RTX 5000 Ada Generation GPU가 장착된 Windows 11 Pro for Workstations 기반의 HP Z4 Rack G5 워크스테이션에 Jan을 처음부터 설치하여 설치 과정, Jan의 로컬 모델 관리 방식, GPU 가속 자동 작동 여부, 그리고 모든 것이 실행된 후 주요 기능들의 동작 방식을 살펴보았습니다.
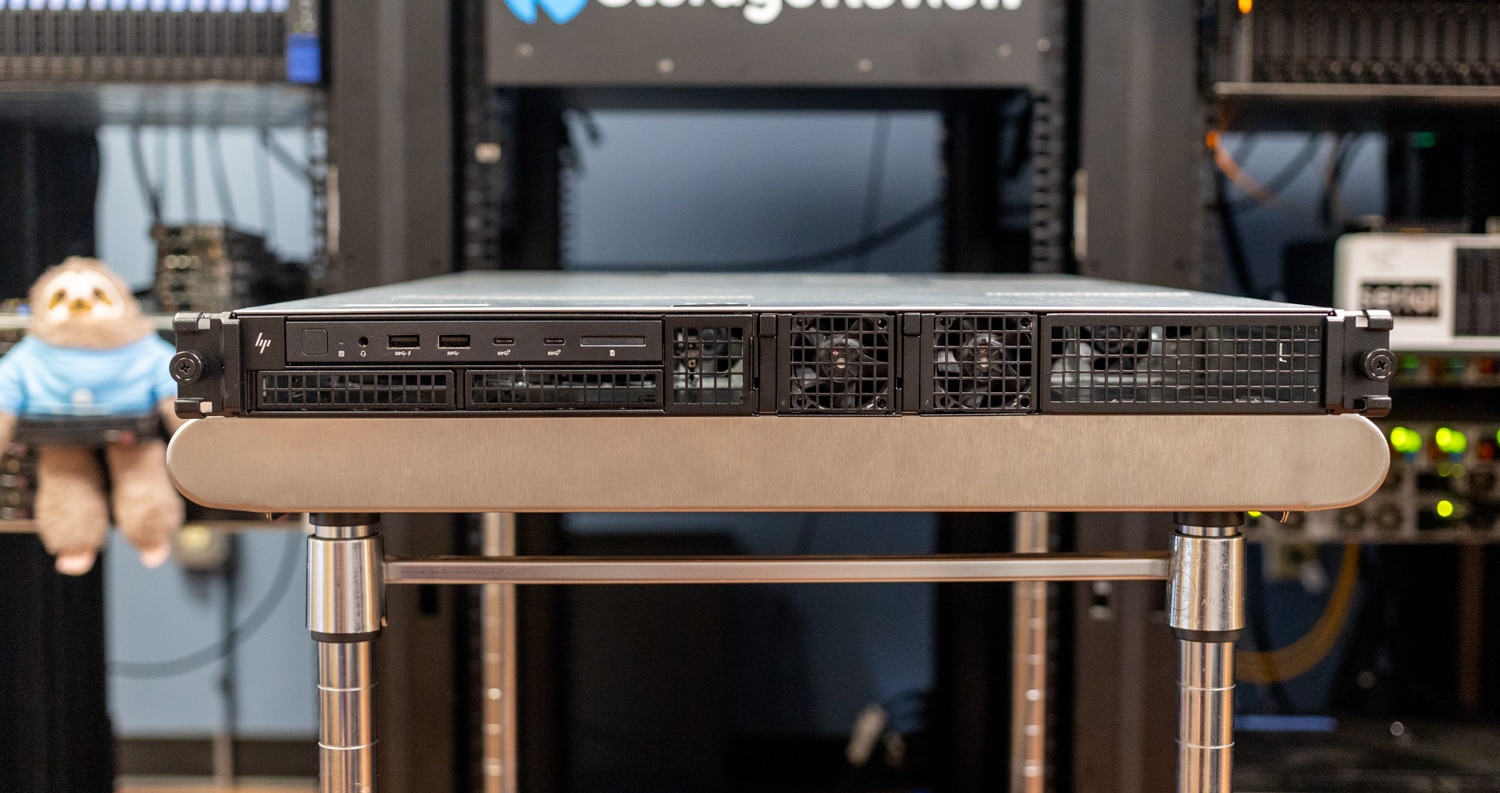
Jan은 첫 번째 버전과 최종 게시 사이에 여러 변경 사항이 있었으며, 이 리뷰가 공개되기 직전에 v0.8.5와 v0.8.6 버전이 출시되었습니다. 최신 릴리스에서는 이전 빌드의 여러 부분을 개선했는데, 여기에는 llama.cpp를 Jan에 직접 포함시키는 것, GPU 오프로드 구성 방식 변경, 병렬 시퀀스 기본값 조정, 그리고 대화 프롬프트 캐싱 추가 등이 포함됩니다. 이러한 변경 사항은 로컬 추론에 영향을 미치기 때문에, 저희는 v0.8.6으로 업데이트하고 게시 전에 모든 성능 테스트를 다시 실행했습니다.
시험 시스템
| 구성 요소 | 구성 |
|---|---|
| 운영체제 | 워크스테이션용 Windows 11 Pro |
| CPU | 인텔 제온 w5-2465X, 16코어 |
| 메모리 | 128GB |
| GPU | NVIDIA RTX 5000 Ada 세대 |
| VRAM | 32GB |
| NVIDIA 드라이버 | 597.06 |
| CUDA 호환성 | 13.2 (nvidia-smi) |
| 월 | v0.8.6 |
| 라마.cpp | 0.5.0, 빌드 b11146 |
Jan은 하드웨어 설정 페이지를 통해 CPU, 시스템 메모리, RTX 5000 Ada를 포함한 시스템 하드웨어를 정확하게 감지했습니다. NVIDIA 드라이버가 이미 설치된 이 시스템에서 Jan은 모델을 로드하기 전에 애플리케이션 내에서 추가적인 CUDA 설정을 할 필요 없이 GPU 가속을 활성화했습니다.
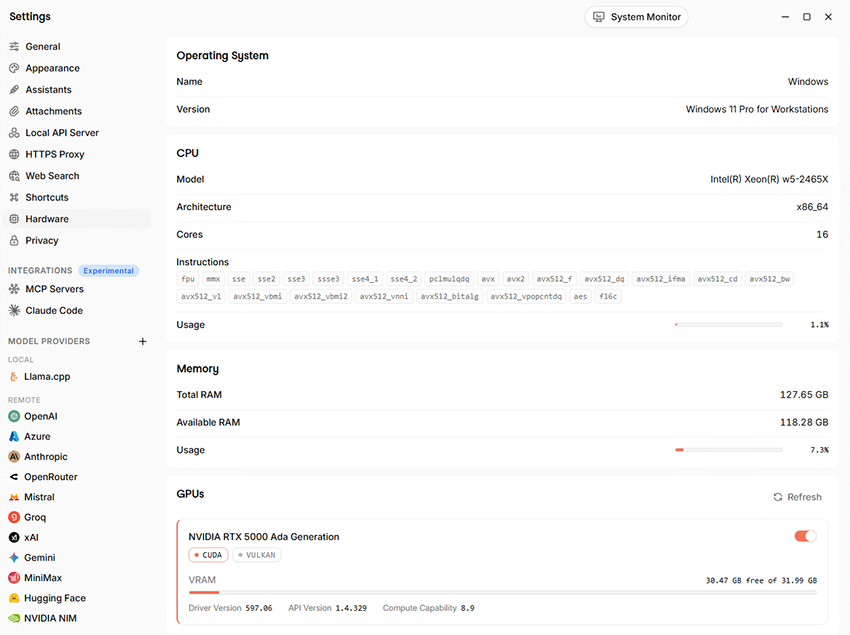
Jan v0.8.6 버전에서 Xeon w5-2465X, 127.65GB RAM, 그리고 31.99GB VRAM을 탑재한 NVIDIA RTX 5000 Ada Generation이 감지되었습니다.
Jan 설치 및 시작하기
Windows 설치는 표준 .exe 설치 프로그램을 사용하며, 처음 실행하면 Jan의 메인 채팅 인터페이스로 바로 들어갑니다. Jan은 로컬 모델을 사용하기 위해 계정을 요구하지 않았습니다. 처음 실행 시 익명 사용 데이터를 공유할지 묻고, 권장 로컬 모델인 Jan V3.5를 다운로드하도록 제안했습니다.
Jan V3.5의 초기 다운로드 용량은 2.8GB로 표시되었습니다. 다운로드 버튼을 클릭하면 앱 내에서 다운로드가 시작되었고, 완료되면 Jan에서 성공 알림을 표시했습니다. 설치가 완료되면 채팅창 상단의 선택기에서 해당 모델을 사용할 수 있게 되었습니다.
Jan은 첫 출시에서 권장되는 Jan V3.5 로컬 버전을 2.8GB 다운로드 파일로 제공합니다.
모델 검색 및 다운로드
Jan's Hub는 모델 검색 및 설치를 애플리케이션 내에서 처리하며, Hugging Face의 모델에 직접 접근할 수 있고 다운로드 시작 전에 유용한 정보를 확인할 수 있습니다. 각 항목에는 다운로드 크기, 양자화 방식, 기능 태그, 하드웨어 적합성 표시기가 포함되어 있어 사용 가능한 메모리와 GPU에 적합한 모델을 쉽게 찾을 수 있습니다.
저희 RTX 5000 Ada 시스템에서는 여러 모델에 녹색 "호환" 라벨이 붙어 있었습니다. 허브에는 Jan V3.5 4B용 2.5GB Q4_K_M 옵션이 표시되었고, Jan V2 VL High는 4.7GB로 표시되었으며 멀티모달 및 툴 지원이 포함되어 있었습니다. 동일 모델 카드에서도 다른 변형 버전이 제공되었습니다.
Jan은 llama.cpp를 통해 로컬에서 실행되는 모델 외에도 OpenAI, Anthropic, Gemini, Groq, Mistral과 같은 제공업체에서 호스팅하는 모델을 사용할 수 있습니다. 이를 통해 사용자는 다운로드한 모델과 클라우드 기반 모델을 하나의 인터페이스에서 관리할 수 있으며, Hub를 사용하면 GGUF 파일을 찾고 설치 전에 메모리 요구 사항을 확인하는 등의 수동 작업을 상당 부분 줄일 수 있습니다.
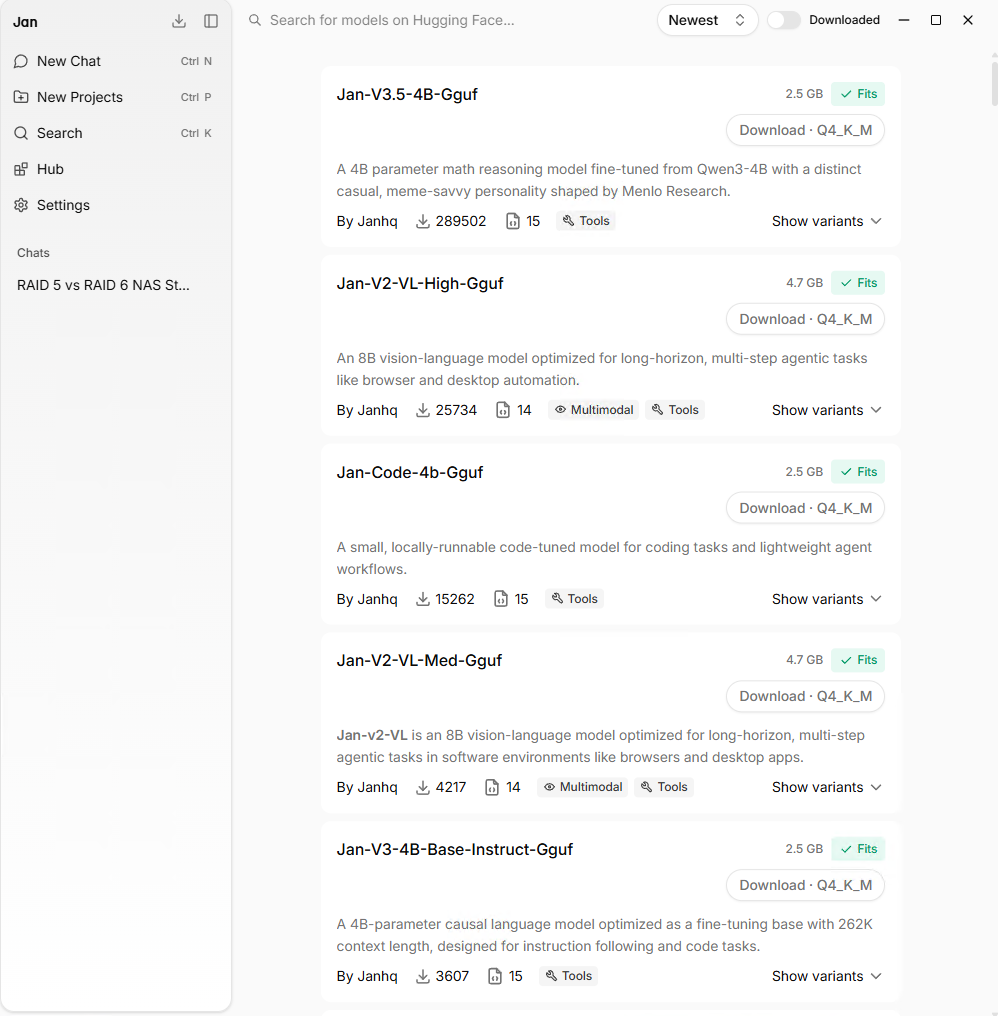
허브는 설치 전에 다운로드 크기, 양자화, 모델 특징 및 하드웨어 적합성 상태를 표시합니다.
저희는 Jan V2 VL High를 두 번째 모델로 다운로드했는데, 그 이유는 이 버전이 이미지 지원 기능을 추가하면서도 RTX 5000 Ada의 32GB 프레임 버퍼에 쉽게 들어갈 수 있었기 때문입니다.
모델 설정 및 GPU 사용
v0.8.5 및 v0.8.6 업데이트 주기 동안 도입된 주요 변경 사항 중 하나는 llama.cpp가 이제 애플리케이션에 포함되었다는 점입니다. 이전 빌드에서는 llama.cpp가 별도로 관리되었습니다. 저희 설치 환경에서는 llama.cpp 0.5.0, 빌드 b11146이 표시되었으며, 병렬 시퀀스는 0으로 설정되어 llama.cpp가 기본 동작을 사용하도록 되어 있었습니다. 또한 세션 간 대화 기억 기능은 각 대화의 프롬프트 캐시를 디스크에 저장하도록 활성화되어 있었습니다.
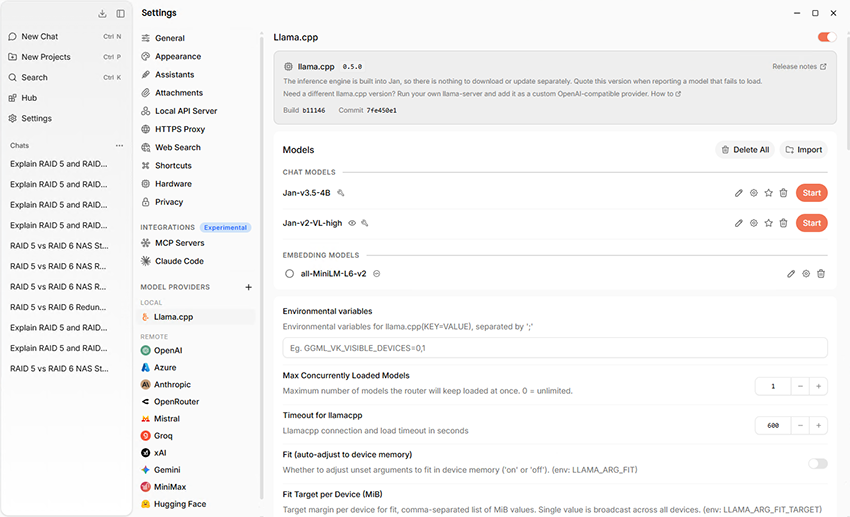
Jan v0.8.6에는 llama.cpp 0.5.0이 애플리케이션에 직접 포함되어 있으며, 로컬 모델 공급자 설정에 빌드 번호 b11146이 표시됩니다.
Jan V3.5 4B가 설치된 경우, 활성 모델 옆의 톱니바퀴 아이콘을 통해 샘플링 및 런타임 설정에 접근할 수 있습니다. 저희 설치 환경에서는 Jan이 온도 0.8, Top P 0.95, Top K 40, Min P 0.05, 그리고 Repeat Penalty 1을 표시했습니다.
최근 런타임 변경으로 기본 GPU 오프로드 동작이 바뀌었지만, 업그레이드된 Jan V3.5 4B 및 Jan V2 VL High 프로파일은 v0.8.6에서도 여전히 100개의 GPU 레이어를 표시했으므로 재실행 시 해당 값을 변경하지 않고 그대로 두었습니다. 추가 제어 옵션으로는 8,192 토큰 컨텍스트 크기, Mixture of Experts 가중치에 대한 CPU 설정, KV 캐시 오프로드, 그리고 2,048 배치 크기가 있습니다. 이러한 옵션을 사용하면 명령줄이나 별도의 구성 파일을 편집하지 않고도 Jan에서 직접 메모리 사용량과 추론 동작을 조정할 수 있습니다.
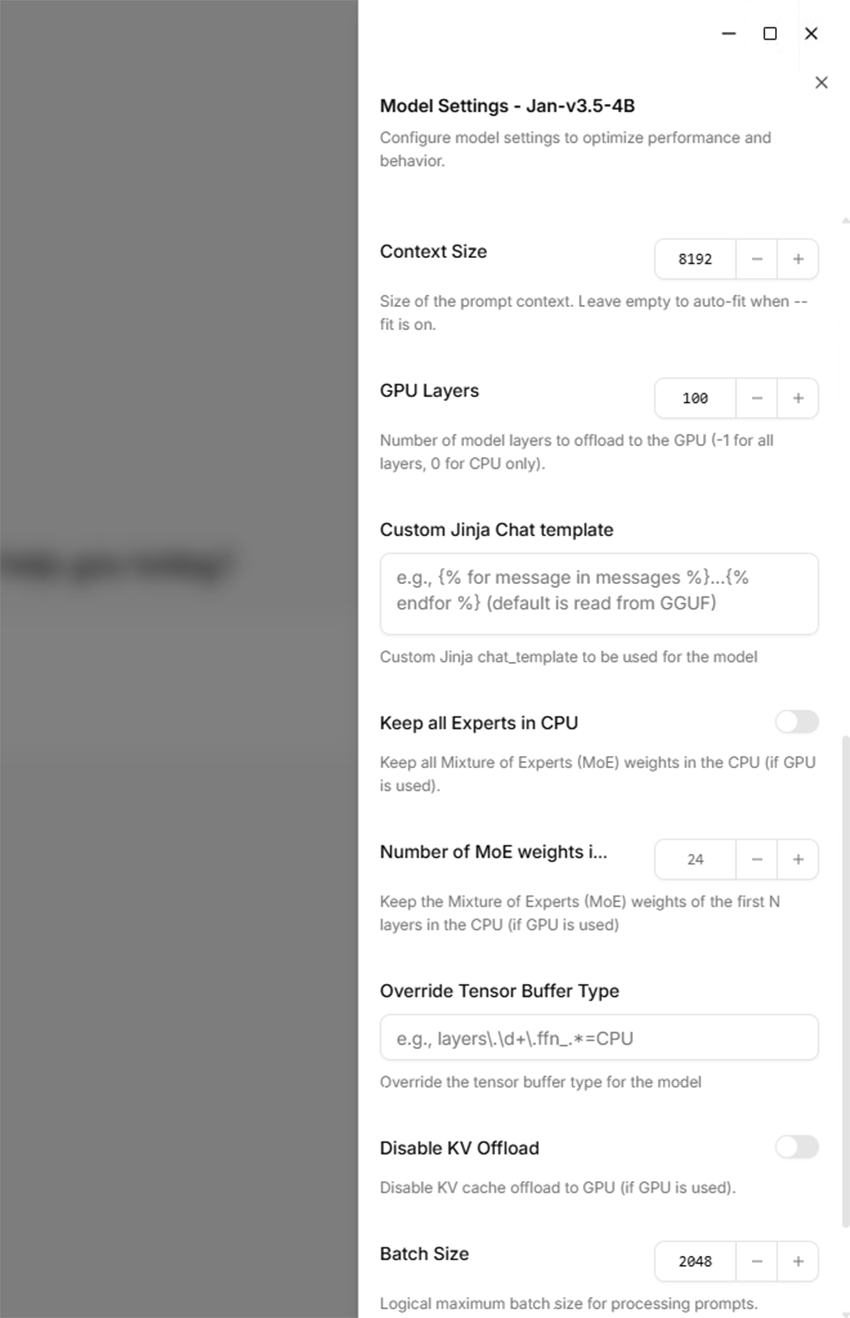
업그레이드된 Jan V3.5 4B 프로파일은 v0.8.6에서와 마찬가지로 컨텍스트 크기 8,192 토큰, GPU 레이어 100개, 배치 크기 2,048을 유지했습니다.
지역 발전 성능
RTX 5000 Ada에서 두 모델 모두 실행한 후, 업데이트된 런타임 환경에서 디코딩 속도를 측정하기 위해 Jan v0.8.6 버전에서 텍스트 생성 테스트를 반복했습니다. 웹 검색은 비활성화하고, 컨텍스트 크기는 8,192 토큰으로 유지했으며, GPU 레이어는 업그레이드된 모델 프로필에서 유지된 값인 100으로, 배치 크기는 2,048로 설정했습니다.
모든 실행에서 동일한 텍스트 기반 프롬프트를 사용했습니다. "처음 NAS를 구축하는 사람에게 RAID 5와 RAID 6에 대해 설명하세요. 각 방식의 주요 장점과 단점을 포함하여 약 400단어로 설명하세요." 각 모델을 로드한 후 첫 번째 응답은 워밍업으로 간주하여 폐기했고, 이후 세 개의 새로운 스레드에서 세 번의 측정 실행을 진행했습니다.
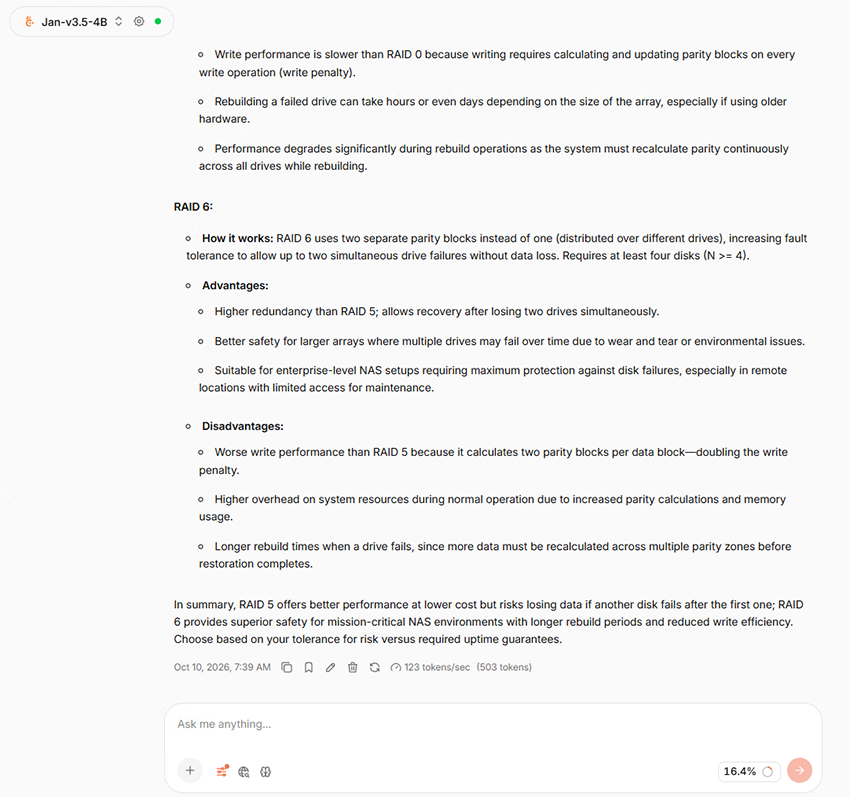
Jan V3.5 4B는 이번 측정 실행에서 503개의 Jan 보고 출력 토큰과 함께 초당 123 토큰을 기록했으며, 이는 3회 실행 테스트의 중간값과 일치합니다.
Jan V3.5 4B Q4_K_XL은 세 번의 측정 실행에서 평균 디코딩 속도 123 토큰/초를 기록했으며, 1월에 보고된 출력 토큰의 평균 개수는 503개, GPU 메모리 사용량의 최대값은 4,839MiB였습니다. Jan V2 VL High Q4_K_M은 평균 82 토큰/초의 디코딩 속도, 1월에 보고된 출력 토큰 1,728개, GPU 메모리 사용량의 최대값 8,197MiB를 기록했습니다.
llama.cpp의 타이밍 라인은 Jan의 화면 디코딩 수치와도 유사한 결과를 보였으며, Jan V3.5 4B의 경우 중간 평가 속도는 122.55 토큰/초, Jan V2 VL High의 경우 82.30 토큰/초였습니다. v0.8.6에서는 대화 프롬프트 캐싱이 활성화되었고, 여러 번 반복 실행한 결과 하나의 프롬프트 토큰만 평가되는 것으로 나타났기 때문에 사전 채우기 중간값은 보고하지 않았습니다. 캐시된 값은 전체 프롬프트 처리 성능을 비교하는 데 유용한 자료가 되지 못합니다.
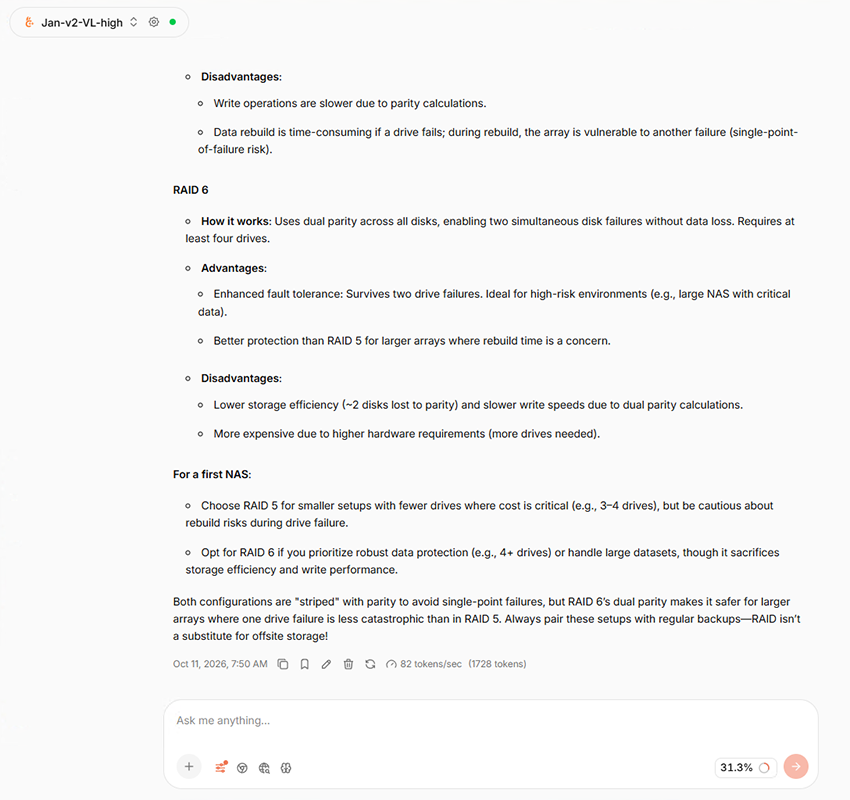
Jan V2 VL High는 이번 측정 실행에서 1,728개의 1월 보고 출력 토큰을 기록하며 초당 82개의 토큰을 처리했으며, 이는 3회 실행 테스트의 중간값과 일치합니다.
| 모델 | 정량화 | 출력 토큰 | 디코드 속도 | GPU 메모리 |
|---|---|---|---|---|
| 1월 V3.5 4B | Q4_K_XL | 503 | 123 토크/초 | 4,839 MiB |
| 1월 V2 VL 하이 | Q4_K_M | 1,728 | 82 토크/초 | 8,197 MiB |
참고: 출력 토큰 수, 디코딩 속도 및 GPU 메모리 수치는 워밍업 실행 1회를 제외한 후 측정된 3회 실행의 중앙값입니다. GPU 메모리는 각 측정 실행 동안 관찰된 최대 메모리 사용량의 중앙값입니다. Jan V2 VL High의 출력 토큰 수는 추론 토큰을 포함하는 것으로 보입니다. 표시된 답변이 약 400단어였지만 Jan은 훨씬 더 많은 토큰을 보고했기 때문입니다. 따라서 Jan V2 VL High의 출력 토큰 수는 Jan V3.5 4B와 직접 비교해서는 안 됩니다.
Jan을 로컬 채팅에 사용하기
Jan의 메인 인터페이스는 모델이 설치되면 탐색하기 쉽습니다. 최근 대화는 왼쪽 사이드바에 표시되고, 활성 모델은 상단에 계속 표시되며, 첨부 파일과 도구는 프롬프트 필드 바로 아래에 있습니다.
설치된 모델 간 전환은 몇 번의 클릭만으로 가능합니다. Jan은 응답이 끝날 때 토큰 수와 생성 속도를 포함한 정보를 표시합니다. 추론 모델은 생성하는 동안 사고 과정을 표시할 수 있지만, 표시되는 세부 정보의 수준은 사용되는 모델에 따라 다릅니다.
첫 번째 로컬 테스트에서는 Jan에게 NAS를 구축하는 사람을 위해 RAID 5와 RAID 6의 차이점을 설명해 달라고 요청했습니다. 두 다운로드 모델 모두 요청을 완료했으며, Jan V2 VL High는 더 긴 답변을 생성하고 8,197MiB의 GPU 메모리를 사용한 반면, 4B 모델은 4,839MiB를 사용했습니다.
웹 검색
Jan은 채팅 인터페이스에 웹 검색 및 페이지 가져오기 기능을 직접 포함하고 있어, 해당 기능이 활성화된 경우 지원되는 모델이 최신 온라인 정보를 대화에 가져올 수 있습니다. Jan v0.8.6으로 업데이트한 후 웹 검색 기능을 활성화하고 Jan V2 VL High에 로컬 테스트에서 사용했던 것과 동일한 RAID 5 대 RAID 6 질문을 하여 이전 웹 검색 테스트를 반복했습니다.
Jan은 최신 정보가 도움이 될 수 있다고 판단하여 온라인 검색을 요청하는 메시지가 없었음에도 불구하고 웹 검색을 시도했습니다. 추론 과정을 살펴보면, 모델은 검색 쿼리를 제출하기 전에 최신 NAS 권장 사항을 확인하기로 결정한 것으로 나타났습니다. 이번 실행에서는 구성된 Exa 서비스가 무료 MCP 사용량 제한에 도달하여 검색을 완료할 수 없었지만, Jan V2 VL High 버전이 외부 정보가 유용할 수 있다고 판단할 경우 자동으로 웹 검색을 호출한다는 사실은 확인되었습니다.
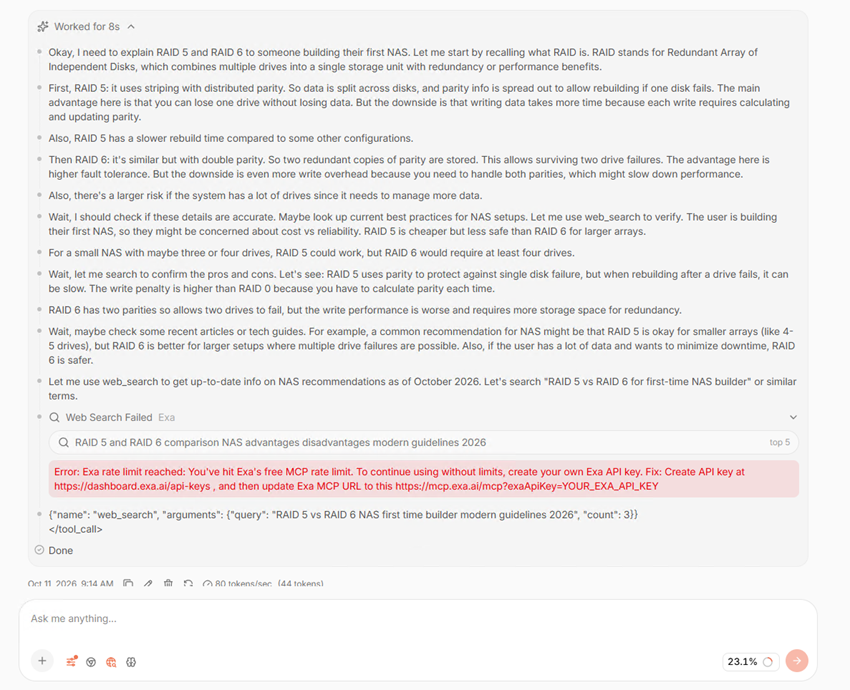
Jan v0.8.6에서 웹 검색이 활성화된 경우, Jan V2 VL High는 RAID 쿼리 중에 자동으로 온라인 검색을 시도했지만, Exa의 무료 MCP 사용량 제한으로 인해 요청이 차단되었습니다.
Jan은 MCP도 지원하는데, 이를 통해 브라우저 상호 작용 및 기타 통합 옵션을 포함하여 호환되는 외부 도구 및 서비스를 애플리케이션에 연결할 수 있습니다. 이번 세션에서는 MCP를 테스트하지 않았지만, MCP가 포함됨으로써 사용자는 로컬에서 실행되는 모델이 표준 채팅 인터페이스를 넘어 액세스하고 수행할 수 있는 기능을 확장할 수 있는 또 다른 방법을 갖게 됩니다.
멀티모달 입력
Jan v0.8.6으로 업데이트 후 이미지 입력을 재테스트하기 위해 Jan V2 VL High에 새로운 nvidia-smi 스크린샷을 첨부하고 이미지에 표시된 GPU 모델, NVIDIA 드라이버 버전, 총 VRAM 용량, GPU 사용률, GPU 온도 및 전력 사용량을 식별하도록 요청했습니다. 그 결과, 모델은 NVIDIA RTX 5000 Ada 세대, 드라이버 버전 597.06, VRAM 32,760 MiB, GPU 사용률 1%, 온도 35°C, 전력 사용량 4W/250W 등 6가지 값을 모두 정확하게 식별했습니다.
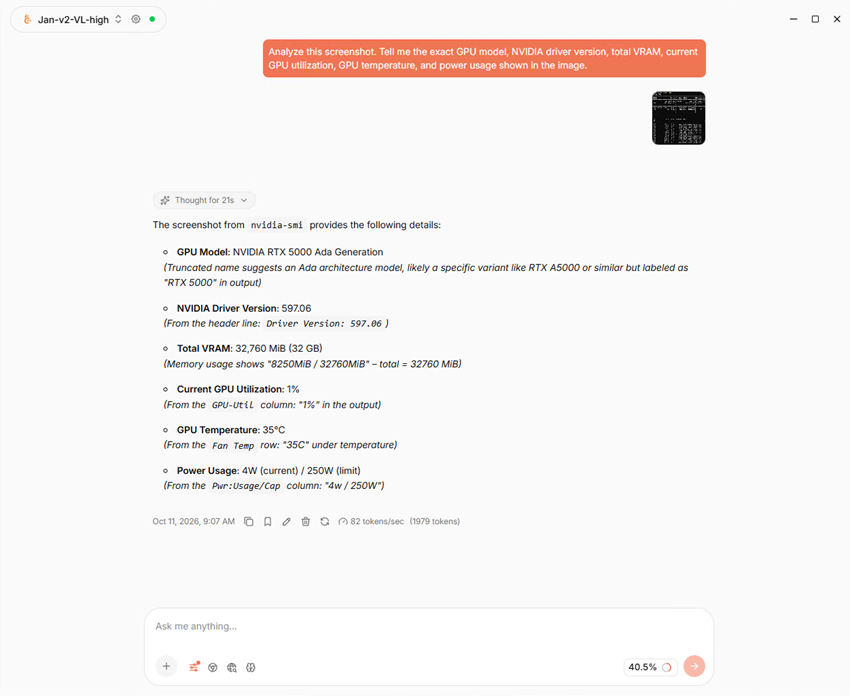
Jan V2 VL High는 Jan v0.8.6의 새로운 nvidia-smi 스크린샷에서 요청된 6가지 하드웨어 값을 모두 정확하게 식별했습니다.
이는 1월에 출시된 초기 멀티모달 테스트보다 개선된 결과입니다. 초기 테스트에서는 응답 시간의 상당 부분을 터미널 레이아웃을 분석하는 데 소비했습니다. 모델은 여전히 응답하기 전에 21초 동안 추론하는 데 시간을 썼고, Jan은 1,979개의 출력 토큰을 보고했지만, 화면에 표시되는 응답은 간결했고 요청에 직접적으로 답변했습니다.
로컬 API 서버
Jan에는 설정 메뉴에서 접근 가능한 OpenAI 호환 로컬 API 서버도 포함되어 있습니다. 저희는 Jan V3.5 4B를 기본 로컬 API 모델로 선택하고 인터페이스에서 직접 서버를 시작했습니다.
Jan은 서버가 다음 시간대에서 실행 중이라고 보고했습니다.
http://127.0.0.1:1337/v1
내장 서버 로그는 성공적인 실행을 확인시켜 주었고, Jan은 또한 대화형 API 문서에 대한 접근 권한을 제공했습니다.
PowerShell을 사용하여 로컬 API가 예상대로 작동하는지 확인했습니다. 먼저 /v1/models에 쿼리를 실행하여 설치된 모델 목록을 확인했는데, 여기에는 Jan V2 VL High도 포함되어 있었습니다. 그 다음 Jan-v3.5-4B-Q4_K_XL에 RAID 6에 대한 한 문장 설명을 요청하는 채팅 완성 요청을 보냈고, Jan은 PowerShell에서 직접 응답을 반환했습니다.
"RAID 6는 데이터 블록당 두 개의 독립적인 패리티 블록을 사용하여 데이터 이중화를 제공하는 디스크 어레이 구성으로, 최대 두 개의 디스크에 장애가 발생하더라도 데이터 손실 없이 어레이를 유지할 수 있습니다."
답변에는 사실 오류 하나가 있었습니다. RAID 6는 데이터 블록당 패리티 블록 2개가 아니라 스트라이프당 패리티 블록 2개를 사용합니다.
두 요청 모두 정상적으로 작동함에 따라, OpenAI 호환 엔드포인트를 지원하는 소프트웨어는 데스크톱 채팅 인터페이스를 통해 모든 메시지를 보내지 않고도 Jan이 다운로드한 모델과 직접 통신할 수 있음을 확인했습니다.
무엇이 잘못 되었습니까
초기 테스트에서 나타난 주요 문제는 멀티모달 테스트에서 발생했습니다. Jan V2 VL High 모델은 nvidia-smi 스크린샷은 이해했지만, 간단한 데이터 추출 요청을 처리하는 데 너무 오랜 시간이 걸렸습니다. 위에서 설명한 v0.8.6 재테스트에서는 6개의 값을 모두 간결하게 응답했지만, 21초의 추론 시간과 1,979개의 출력 토큰이 보고된 것은 모델이 여전히 응답하기 전에 많은 작업을 수행한다는 것을 보여줍니다.
v0.8.6 버전에서 웹 검색 재테스트를 진행한 결과, 1월 이후 발생한 문제에 직면했습니다. 구성된 Exa 서비스가 무료 MCP 사용량 제한에 도달하여 RAID 관련 질문 중에 모델이 시도한 자동 검색을 완료할 수 없었습니다. 웹 검색 기능을 사용하는 경우, 일반적인 사용에 충분한 여유 공간을 확보하여 검색 공급자를 구성해야 합니다.
위에서 언급한 사항들을 제외하면, v0.8.6 테스트는 순조롭게 진행되었습니다. 여섯 번의 반복된 로컬 생성 실행 모두 충돌, 모델 로드 실패 또는 GPU 감지 문제 없이 완료되었습니다.
맺음말
Windows에서 로컬 LLM을 실행하는 데 관심이 있는 분들을 위해, 1월 버전 0.8.6에서는 설정 작업을 대폭 간소화하면서도 모델 실행 방식을 조정할 수 있는 충분한 여지를 남겨두었습니다. 저희 테스트 시스템에서는 RTX 5000 Ada를 자동으로 감지했고, 다운로드한 두 모델 모두 GPU 가속을 사용했으며, Hub는 다운로드 전에 모델 크기와 하드웨어 적합성 정보를 표시해 주었습니다. 초보자에게는 충분한 안내를 제공하면서도 컨텍스트 크기, GPU 레이어, 메모리 옵션과 같은 세부적인 설정을 통해 더욱 세밀한 제어가 가능한 기능을 제공합니다.
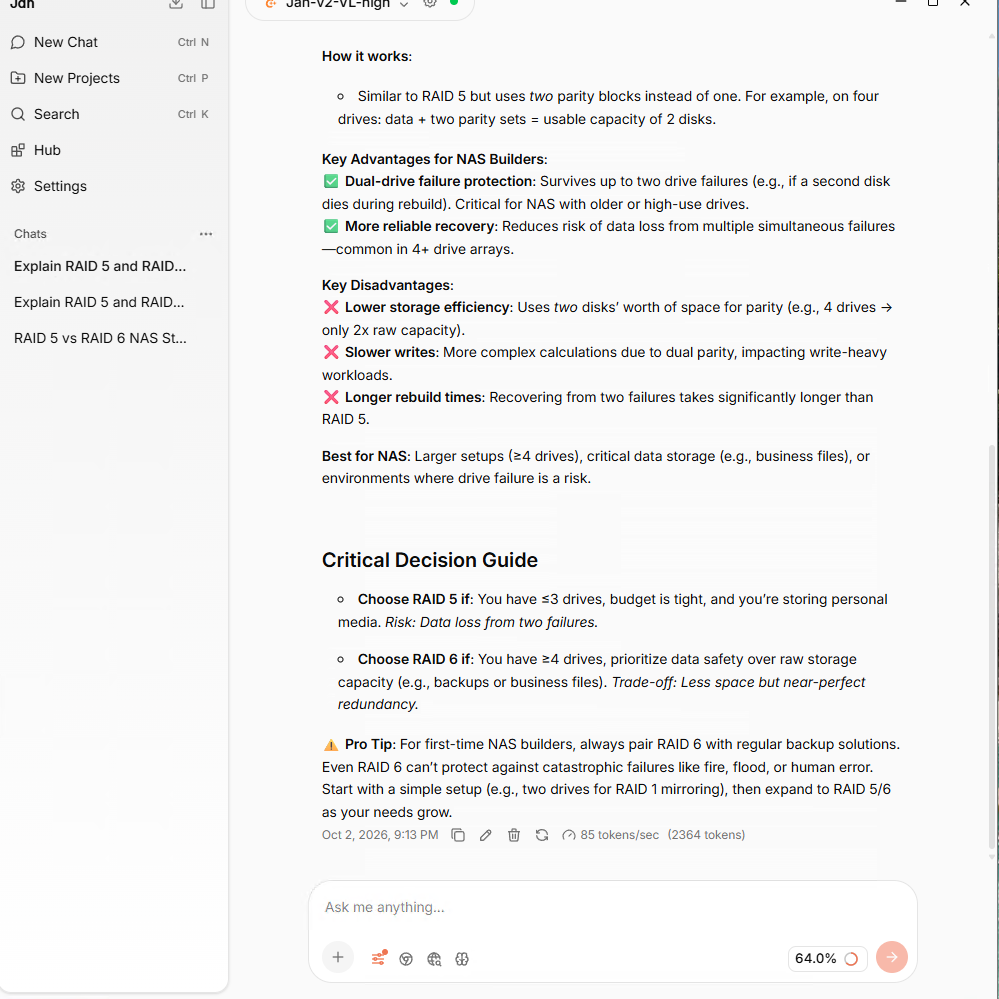
Jan V2 VL High는 로컬 RAID 비교를 완료했으며 응답 아래에 세대 정보를 표시했습니다.
Jan은 로컬 모델 실행 및 채팅 창 제공을 훨씬 뛰어넘어 동일한 인터페이스에 다양한 기능을 추가합니다. 저희는 대화에서 직접 웹 검색을 테스트하고, Jan V2 VL High를 사용하여 이미지 입력을 테스트했으며, 로컬 llama.cpp 모델과 함께 원격 AI 제공업체를 사용할 수 있음을 확인하고, PowerShell에서 OpenAI 호환 API에 요청을 보냈습니다.
RTX 5000 Ada 시스템에서 Jan V3.5 4B 버전은 업데이트된 텍스트 생성 테스트에서 평균 123 토큰/초를 기록한 반면, Jan V2 VL High 버전은 82 토큰/초를 기록했습니다. 또한, v0.8.6 업데이트 이후 반복 수행된 멀티모달 테스트에서 Jan V2 VL High 버전은 훨씬 더 간결한 응답을 보여주었으며, nvidia-smi 스크린샷에서 요청된 6가지 값을 모두 정확하게 식별했습니다.
Jan은 세션 내내 안정적으로 작동했으며, 새로 설치한 상태에서 GPU에서 로컬 모델을 실행하는 데에는 설치 프로그램 하나, 모델 다운로드 하나, 그리고 몇 번의 클릭만으로 충분했습니다.
저희는 최고의 지역 LLM 도구 순위표 에 추가 항목들을 검토하면서 동일한 테스트 방법을 사용할 예정이며 , 독자 여러분께 동일한 하드웨어에서의 성능 결과와 기능 및 일상적인 사용상의 차이점을 함께 제공할 것입니다.


 아마존