

NVIDIA RTX PRO 4500 Blackwell Server Edition은 기업에서 이미 보유하고 있는 서버를 위해 NVIDIA가 설계한 그래픽 카드입니다. 이 제품은 싱글 슬롯, 팬리스 쿨링 방식의 165W 보드로, 32GB의 GDDR7 메모리와 Blackwell 아키텍처의 모든 기능을 갖추고 있습니다. 5세대 텐서 코어(FP4 연산 지원), 4세대 RT 코어, 3개의 인코더와 3개의 디코더, 그리고 16GB 파티션 두 개로 분할하여 사용할 수 있는 멀티 인스턴스 GPU 지원 기능을 제공합니다. NVIDIA RTX PRO 서버 라인업의 엔트리 모델인 L4를 대체하며, 2U PowerEdge, ProLiant, ThinkSystem 서버에 전력 소모나 쿨링 문제 없이 장착할 수 있습니다.

NVIDIA는 이 그래픽 카드를 '적정 크기'로 홍보하고 있습니다. 대부분의 기업은 AI 공장을 구축하는 것이 아니라, 랙 전력에 엄격한 제약이 있는 공랭식 기존 데이터 센터를 운영하고 있으며, 새로운 서버급을 필요로 하지 않는 초기 단계의 가속 컴퓨팅 솔루션이 필요하다는 것입니다. 또는 엣지 컴퓨팅 환경에서 작업하는 기업들도 있는데, RTX PRO 4500은 이러한 환경에서 배포 가능한 워크로드 및 전력 제약 조건에 더 적합합니다.
RTX PRO 6000 Blackwell은 96GB 메모리와 최대 600W 전력 소비로 해당 시장의 최상위를 차지합니다. 4500은 동일한 아키텍처를 유지하면서 나머지 사양을 거의 절반으로 줄였습니다. 따라서 소형 모델을 사용하거나, 소규모 작업을 많이 수행하거나, 전력 소비 대비 성능을 중시하는 고객은 불필요한 성능 향상 비용을 지불하지 않고 Blackwell을 선택할 수 있습니다.
이 GPU 클래스의 워크로드는 소규모 언어 모델 추론, 비전 AI 및 비디오 분석, 벡터 검색 및 임베딩 생성, 트랜스코딩, vGPU 20 기반의 가상 워크스테이션 등 잘 알려져 있습니다. 소규모 및 중규모 모델 추론에서 L4 응답 속도가 5배 이상 향상되었고, 네모트론(Nemotron) 모델에서는 최대 10배까지 향상되었다고 주장합니다. 출시 파트너로는 엣지 비디오 분야의 NTT DATA, 시퀀싱 분야의 Pacific Biosciences, AI-RAN 기지국 분야의 Nokia 등이 있습니다. AWS는 G6를 대체하기 위해 이 GPU를 기반으로 새로운 G7 인스턴스를 구축했습니다.
저희는 이미 RTX PRO 4500 엣지 리뷰 에서 HPE ProLiant DL145 Gen11에 탑재된 L4 스토리지와 이 카드를 비교 테스트했으며 , 당시 RTX PRO 6000은 L4 스토리지보다 2.7배 높은 처리량을 보여주었습니다. 이번 리뷰에서는 지난 2년간 메인스트림 추론 카드로 자리 잡은 350W 듀얼 슬롯 L40S와 RTX PRO 6000의 성능 차이가 얼마나 되는지, 그리고 상위 모델인 RTX PRO 6000이 추가 메모리와 전력 측면에서 어떤 장점을 제공하는지 살펴보겠습니다.
이를 확인하기 위해 Dell PowerEdge R770 에 4500을 장착하고 L40S 및 L4와 비교 테스트를 진행했습니다. 또한 Dell Pro Max Tower T2 의 RTX PRO 6000 Blackwell 데이터를 기본 600W와 R770의 GPU 슬롯에 허용되는 450W 제한으로 설정하여 추가하고, 두 가지 컨텍스트 길이로 네 가지 모델에서 vLLM 온라인 서빙을 실행했습니다.
간략하게 미리 살펴보자면, 일반적인 채팅 및 상담원 컨텍스트 길이에서 4500은 FP8 및 BF16 모델에서 L40S와 비슷한 성능을 절반 이하의 전력으로 보여줍니다. 8K 입력에서는 32GB 프레임 버퍼의 한계가 드러나며, NVIDIA가 블랙웰의 핵심 기술로 내세우는 NVFP4 정밀도는 이 vLLM 빌드에서 다른 제품들과 비슷한 성능을 보여줍니다.
주요 요점
- L40S의 단일 슬롯 165W 처리량: 512토큰 입력 및 출력에서 4500은 우리가 실행한 모든 FP8 및 BF16 모델에서 L40S와 동등하거나 약간 우수한 성능을 보였습니다. Ministral 3 14B FP8에서는 1,107 토큰/초 대 995 토큰/초, Ministral 3 3B에서는 2,006 토큰/초 대 1,988 토큰/초를 기록했는데, 이는 4500 카드의 전력 용량은 L40S의 47%에 불과하고 슬롯 수도 절반 수준입니다.
- 대체하는 L4 모델의 약 3배 크기입니다. 짧은 컨텍스트에서 L4의 출력 처리량보다 2.8배에서 3.6배 높은 성능을 제공하며, 보드 전력 소모는 L4의 2.3배입니다.
- 32GB에는 용량 제한이 있습니다. 8K 입력에서 4500은 L40S보다 17~33% 뒤처졌으며, 동시 접속자 수가 8에 도달했을 때 성능 곡선이 평탄해진 반면 L40S는 16까지 계속 상승했습니다. 이러한 평탄화는 KV 캐시 용량 부족 때문이며, 32GB가 그 한계입니다.
- NVFP4는 모든 카드에 소프트웨어 기술이 접목된 결과물입니다. Qwen3.8-27B NVFP4에서 4500은 동시 접속자 32명에서 초당 320개의 토큰을 처리했고, FP4 하드웨어가 전혀 없는 L40S는 480개, RTX PRO 6000은 621개를 처리했습니다. 이 vLLM 빌드에서 NVFP4 경로는 어떤 시스템에서도 메모리 대역폭에 따라 성능이 향상되지 않았으며, MAMF 스윕 결과 4500의 FP4 하드웨어는 FP8에서 280.1 TFLOPS를 기록한 반면, 568.6 TFLOPS를 기록했습니다.
- 더 큰 카드로 누릴 수 있는 혜택: 델 R770 GPU 슬롯의 최대 전력 제한인 450W로 제한된 RTX PRO 6000은 단기 컨텍스트에서는 4500보다 약 2배, 8K 해상도에서는 2.5배에서 3.2배 높은 성능을 보였습니다. 최대 600W 전력을 사용할 경우 단기 컨텍스트에서는 1~2%, 장기 컨텍스트에서는 4~9%의 성능 향상이 있었으므로, 6000이 4500보다 우수한 성능의 대부분은 메모리 성능에서 비롯된 것으로 볼 수 있습니다.
NVIDIA RTX PRO 4500 블랙웰 서버 에디션 사양
RTX PRO 4500 Blackwell이라는 이름을 사용하는 두 가지 카드가 있는데, 비슷하지만 동일한 제품은 아닙니다. GTC 2025에서 발표된 워크스테이션 에디션은 200W 소비전력의 듀얼 슬롯 액티브 쿨링 방식 그래픽 카드로, 4개의 DisplayPort 출력과 896GB/s의 메모리 대역폭을 제공합니다. 이번에 리뷰하는 서버 에디션은 GTC 2026에서 공개되었으며, 165W 소비전력의 싱글 슬롯 패시브 쿨링 방식 헤드리스 보드로 800GB/s의 메모리 대역폭을 제공합니다. 이 제품은 DisplayPort 출력과 클럭 속도를 일부 희생하는 대신 데이터 센터에 특화된 기능들을 탑재했습니다. MIG(Micro-Induced Gradient), 기밀 컴퓨팅(Confidential Computing), 세 번째 NVENC 및 NVDEC 포트, 그리고 vGPU 20 지원 등이 포함됩니다. 두 제품 모두 10,496코어 GPU와 32GB의 GDDR7 ECC 메모리를 탑재하고 있습니다.
NVIDIA의 데이터에 따르면 이 칩은 TSMC 4nm 맞춤형 실리콘 378mm²에 45.6억 개의 트랜지스터와 82개의 4세대 RT 코어(SM 82개, Tensor 코어 328개)를 탑재하고 있습니다. 이는 RTX 5080과 동일한 GB203 다이 제품군의 사양을 약간 낮춘 버전입니다. 아래의 Tensor 코어 성능 수치는 NVIDIA에서 제공한 스파스(sparsity) 기준 최대값이며, 덴스(dense) 기준은 절반입니다. NVIDIA의 peakTOPS 바이너리 테스트 결과에서도 이 카드에서 측정된 FP8 연산 성능은 805 TFLOPS, FP16 연산 성능은 403 TFLOPS로 확인되었습니다.
| 스펙 | RTX PRO 4500 블랙웰 SE | L4 | L40S | RTX PRO 6000 블랙웰 SE |
|---|---|---|---|---|
| 플랫폼 개요 | ||||
| 아키텍처 | 엔비디아 블랙웰 | NVIDIA 에이다 러브레이스 | NVIDIA 에이다 러브레이스 | 엔비디아 블랙웰 |
| 쿠다 코어 | 10,496 | 7,424 | 18,176 | 24,064 |
| RT 코어 | 82(4세대) | 58(3세대) | 142(3세대) | 188(4세대) |
| GPU 메모리 | 32GB GDDR7(ECC 포함) | 24GB GDDR6 | 48GB GDDR6(ECC 포함) | 96GB GDDR7(ECC 포함) |
| 메모리 인터페이스 | 256-bit | 192-bit | 384-bit | 512-bit |
| 메모리 대역폭 | 800GB / s | 300GB / s | 864GB / s | 1,597GB / s |
| 성능 (NVIDIA 최고 수치, 희소성을 고려한 텐서 처리 속도) | ||||
| FP32 | 51 TFLOPS | 30.3 TFLOPS | 91.6 TFLOPS | 120 TFLOPS |
| FP16 / BF16 텐서 | 406 TFLOPS | 242 TFLOPS | 733 TFLOPS | 1PFLOPS |
| FP8 텐서 | 811 TFLOPS | 485 TFLOPS | 1,466 TFLOPS | 2PFLOPS |
| FP4 텐서 | 1.6PFLOPS | 지원되지 않음 | 지원되지 않음 | 4PFLOPS |
| RT 코어 성능 | 154 TFLOPS | 목록에 없음 | 209 TFLOPS | 355 TFLOPS |
| 전력 및 폼 팩터 | ||||
| 최대 보드 전력 | 165W | 72W | 350W | 최대 600W(구성 가능) |
| 폼 팩터 | 단일 슬롯, FHFL 4.4 "X 10.5" |
싱글 슬롯, HHHL | 듀얼 슬롯, FHFL 4.4 "X 10.5" |
듀얼 슬롯, FHFL(공기) 싱글 슬롯, FHXL(액체) |
| 열의 | 수동 | 수동 | 수동 | 수동(공기) 또는 액체 |
| 전원 커넥터 | PCIe CEM1 5핀 16개 | 슬롯 전원 공급 | 1x 16- 핀 | PCIe CEM1 5핀 16개 |
| 상호 연결 | PCIe 5.0 x16 | PCIe 4.0 x16 | PCIe 4.0 x16 | PCIe 5.0 x16 |
| 중량(평량) | 1,055g | 목록에 없음 | 목록에 없음 | 목록에 없음 |
| 기능 | ||||
| 멀티 인스턴스 GPU | 최대 2x 16GB | 아니 | 아니 | 최대 4x 24GB |
| NVENC / NVDEC | 3x / 3x | 2x / 4x | 3x / 3x | 4x / 4x |
| 기밀 컴퓨팅 | 지원 | 아니 | 아니 | 지원 |
| vGPU 지원 | 예 (vGPU 20) | 가능 | 가능 | 가능 |
설계 및 구축
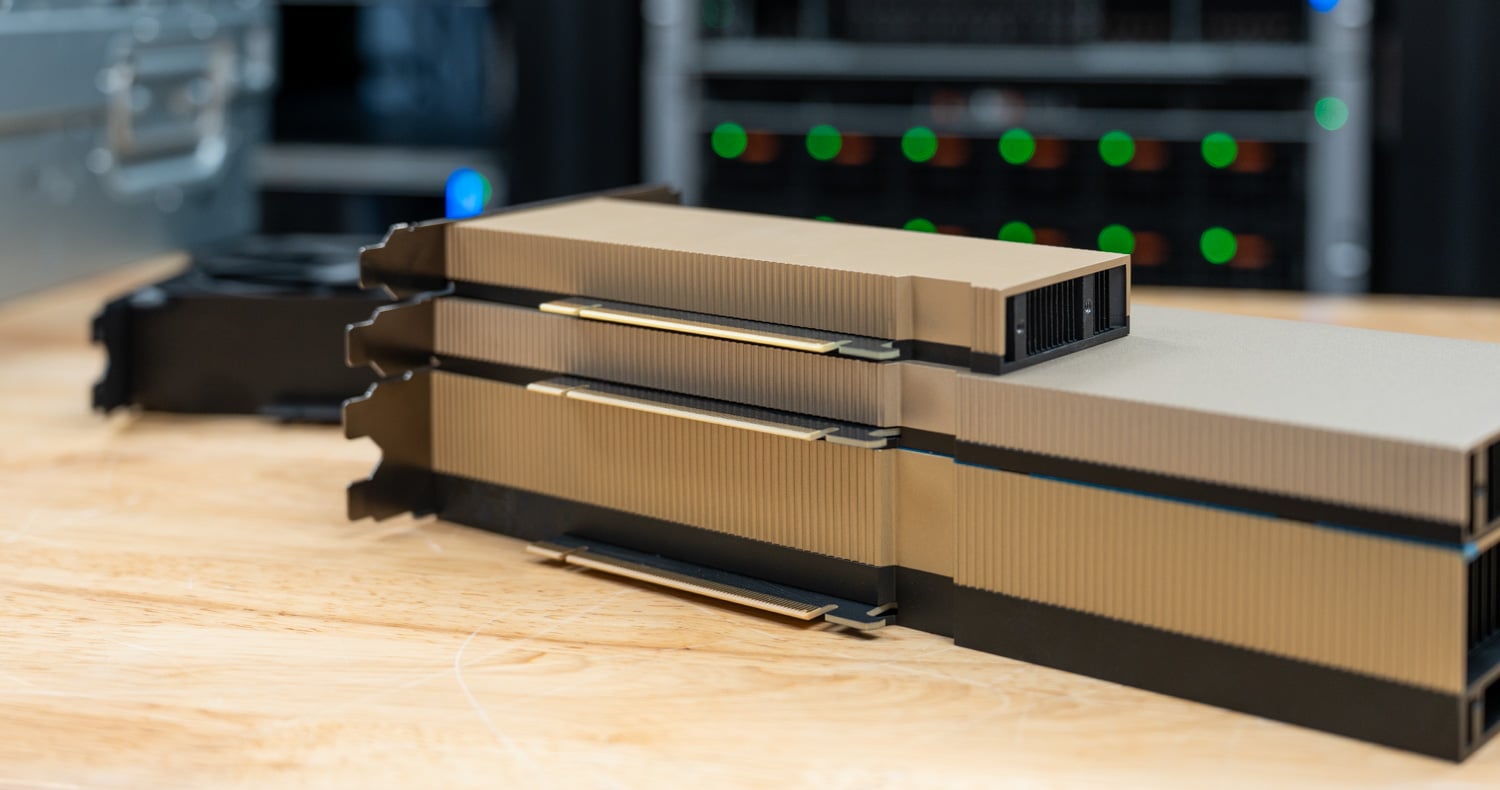
4500 서버 에디션은 높이 4.4인치, 길이 10.5인치의 풀 사이즈 보드로, 케이스 슬롯 하나를 차지합니다. 이는 하프 사이즈, 하프 사이즈였던 L4 보드와 비교했을 때 중요한 변화입니다. L4 보드는 여전히 벤치마크 비교 대상이지만, 메모리, 16핀 전원 입력 단자, 그리고 케이스 내부 공기 흐름만으로 165W의 열을 방출할 수 있는 방열판을 위한 공간을 확보하기 위해 폼팩터가 풀 사이즈로 변경되었습니다.

그 폼팩터는 L4와의 가장 큰 차이점입니다. L4는 모든 HHHL 슬롯에 맞고 슬롯에서 72W의 전력을 공급받았기 때문에 1U 서버나 소형 엣지 박스에 사용되었습니다. 반면 4500은 풀 사이즈, 풀 길이이며 16핀 케이블이 필요합니다. 우리가 사용하는 1U 메인스트림 서버, 특히 델의 최신 1U 파워엣지 라인은 해당 커넥터가 없는 HHHL 또는 FHHL 카드까지만 지원합니다.
실제로 이 카드는 2U 크기이거나 FHFL 슬롯을 중심으로 제작된 몇몇 화이트박스 1U 섀시용이므로, 1U 또는 엣지 박스용으로 L4를 구매한 업체는 바로 교체할 수 있는 제품을 얻지 못합니다.
L4를 위에, L40S를 아래에 나란히 쌓아 올리는 방식 때문에 4500은 슬롯이 하나만 필요한 반면 L40S는 두 개가 필요합니다. 따라서 2U 서버에 더블 와이드 카드 4개를 장착할 수 있지만, 4500은 최대 8개까지 장착할 수 있으며, AWS의 G7 인스턴스는 호스트당 최대 8개의 4500을 실행합니다.
전원은 RTX PRO 6000과 동일한 PCIe CEM5 16핀 커넥터 하나를 통해 공급되며, 보조 8핀 옵션은 없습니다. 냉각은 전적으로 팬을 이용한 수동 방식이므로, 서버의 팬에 의존하며 공기 순환이 원활하지 않은 케이스에서는 성능 저하(스로틀링)가 발생할 수 있습니다. 이는 해당 등급의 GPU에서 일반적인 현상이며, 다른 모든 GPU도 동일한 요구 사항을 충족해야 합니다.
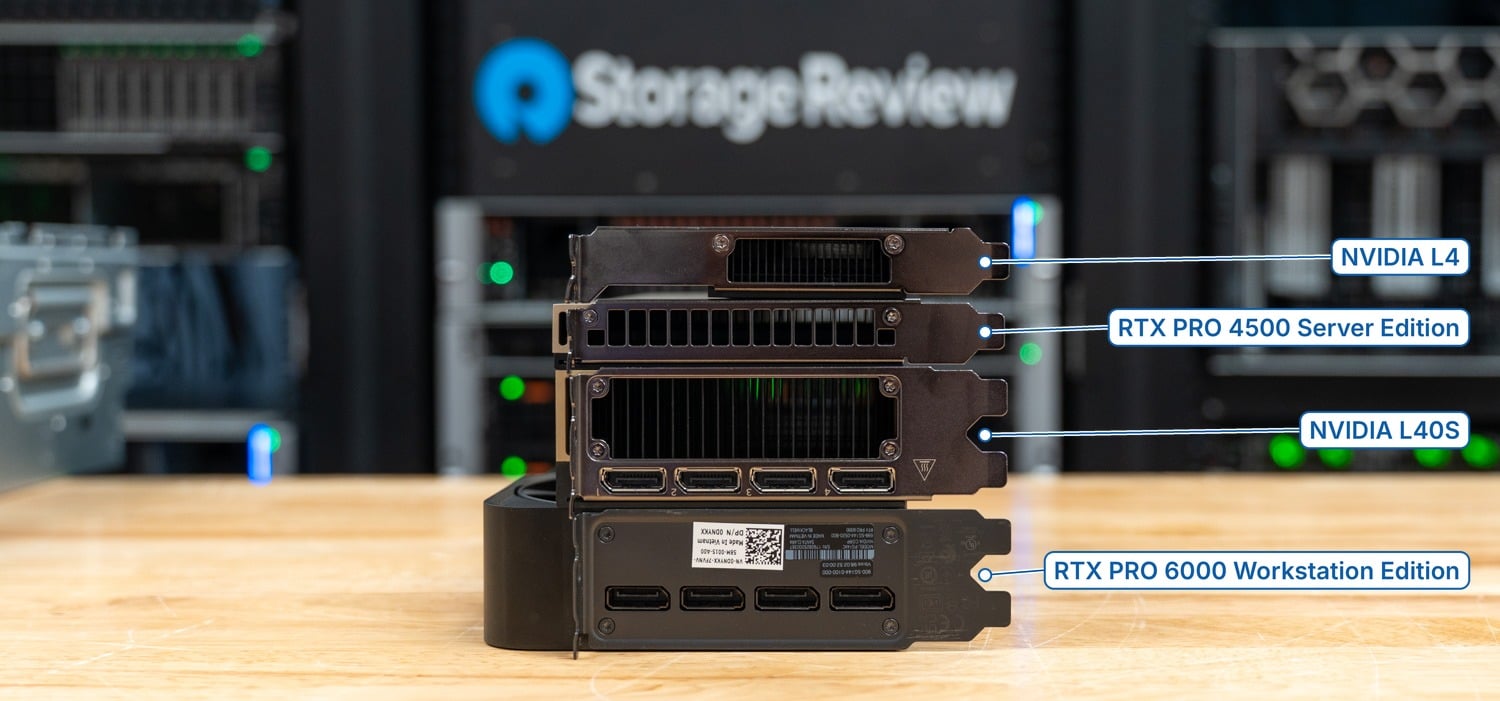
이 그래픽 카드는 디스플레이 출력 포트가 없으므로 vGPU 가상 워크스테이션이나 렌더링과 같은 그래픽 작업은 모두 네트워크를 통해 이루어지며, 브래킷에는 통풍구가 있습니다. 9세대 NVENC 엔진 3개와 6세대 NVDEC 엔진 3개를 탑재하여 L4 칩셋보다 4:2:2 H.264 및 HEVC 인코딩/디코딩 기능을 향상시켰으며, NVIDIA는 NVDEC 엔진당 H.264 디코딩 처리량이 L4 칩셋 대비 2배 증가했다고 밝혔습니다. 아래 브래킷 사진에서 차이점을 확인할 수 있습니다. L4 칩셋과 RTX 4500은 통풍구만 있는 반면, L40S와 RTX PRO 6000 워크스테이션 에디션은 각각 4개의 DisplayPort 출력을 제공합니다.
RTX PRO 4500 Blackwell 서버 에디션은 어디에 적합할까요?
NVIDIA는 이 그래픽 카드의 "핵심 가치는 165W의 저전력, 패시브 방식의 싱글 슬롯 디자인에 AI, 컴퓨팅, 그래픽 및 비디오 가속 기능을 결합한 것"이라고 설명하며, "랙 밀도, 전력 소비 및 냉각이 주요 제약 조건인" 서버 환경에 최적화되어 있다고 강조합니다. 이 제품은 NVIDIA가 RTX PRO 서버 포트폴리오의 주류 데이터 센터 및 엣지 부문으로 분류하는 제품군에 속하며, RTX PRO 6000 Blackwell Server Edition 바로 아래, 그리고 그보다 상위에 위치합니다. 즉, Blackwell 서버 라인의 엔트리 모델입니다.
NVIDIA는 L4 캐시 대비 Nemotron Nano 모델을 사용한 소규모 모델 추론에서 최대 10배(L4의 FP8 대비 4500의 NVFP4), Cosmos Reason 2를 사용한 비디오 요약에서 최대 4배, 4K 해상도에서의 SPECviewperf 15에서 1.9배, 스트리밍 밀도에서 1.8배의 성능 향상을 제시합니다. CPU 대비로는 Milvus의 cuVS CAGRA를 사용한 벡터 데이터베이스 작업에서 최대 50배, 비전 AI에서 최대 100배의 성능 향상을 제시하며, 두 결과 모두 8개의 그래픽 카드를 탑재한 4500 서버에서 듀얼 소켓 EPYC 9654 시스템과 비교하여 측정되었습니다.
델 서버 팀은 32GB 4500 3개의 가격이 96GB 6000 1개와 거의 비슷하기 때문에 4500이 일반적인 랙에서 사용될 것으로 예상한다고 밝혔습니다. 이 경우 일반적으로 더 큰 용량의 카드가 유리합니다. 4500은 GPU가 없거나 L4 스토리지가 없는 서버에 적합하며, 6000을 하나 이상 장착하도록 설계된 서버에는 최적의 선택이 아닙니다.
테스트 설정
저희는 인텔 제온 6787P 프로세서 두 개(각 86코어)와 32개의 DIMM 슬롯에 2TB의 DDR5-6400 메모리가 장착된 Dell PowerEdge R770 서버에 NVIDIA 드라이버 595.71.05를 설치하고, 4500, L40S, L4 그래픽 카드를 장착했습니다. 테스트에는 CUDA 13.4.1 기반의 vLLM 0.27.1을 실행하는 NGC vLLM 26.08-py3 컨테이너를 사용했으므로, 모든 카드의 소프트웨어 스택은 동일합니다. 각 카드는 기본 전력 제한에서 개별적으로 테스트되었으며, R770은 각 카드에 정격 전력을 모두 공급합니다. Dell에 따르면 해당 섀시에서 L4는 72W, 4500은 165W, L40S는 350W입니다.
RTX PRO 6000 Blackwell은 Dell Pro Max Tower T2에 탑재된 워크스테이션 카드이며, 동일한 컨테이너와 드라이버를 사용합니다. NVIDIA는 워크스테이션 버전과 서버 버전의 소비 전력을 600W로 동일하게 표기하고 있으며, 테스트 결과도 동일하게 나타났기 때문에 서버 버전을 기준으로 설명했습니다. 참고로, RTX PRO 6000 서버 카드의 확장성에 대해 더 자세히 알고 싶으시다면 XE7740에 탑재된 RTX PRO 6000 서버 버전 리뷰를 참고하시기 바랍니다.
저희는 6000 시리즈를 두 번 테스트했습니다. 한 번은 기본 전력인 600W로, 다른 한 번은 nvidia-smi를 통해 검증된 450W 전력 제한을 적용한 상태로 테스트했습니다. 450W는 R770 그래픽 카드가 GPU 슬롯에 장착된 6000 시리즈에 공급할 수 있는 최대 전력이며, 일반적인 2U 서버에서 4500과 6000 중 하나를 선택하는 구매자가 비교 기준으로 삼아야 할 수치이기 때문입니다. 6000 시리즈의 호스트 플랫폼은 다르지만, 이러한 GPU 부하 환경에서는 CPU와 PCIe 구성이 결과에 미치는 영향이 전력 제한보다 훨씬 적습니다.
우리는 vLLM의 온라인 서비스 벤치마크를 사용하여 동시 접속자 수 1, 2, 4, 8, 16, 32에서 두 가지 요청 형태를 적용했습니다. 첫 번째는 입력 토큰 512개와 출력 토큰 512개로 채팅 및 짧은 상담원 턴을 근사화한 형태이고, 두 번째는 입력 토큰 8,192개와 출력 토큰 1,024개로 사전 채우기가 주를 이루고 키-값 캐시가 가득 차는 RAG 및 문서 작업을 근사화한 형태입니다. 모델은 가능한 한 그룹 내에서 가장 작은 카드에 맞도록 선택했으며, 따라서 L4의 24GB가 최소 기준이 됩니다. 사용된 모델은 BF16 형식의 Ministral 3 3B Reasoning 및 Ministral 3 8B Reasoning, FP8 형식의 Ministral 3 14B Instruct, 그리고 32GB 이상의 카드에는 적합하지만 L4에는 적합하지 않은 NVFP4 형식의 Qwen3.8-27B입니다.
각 동시 접속 수준에서의 출력 토큰 처리량을 보고하고, 사전 입력 토큰을 포함한 총 처리량이 결과에 영향을 미치는 경우 이를 인용합니다.
여기에 없는 것은 48GB 이상의 카드만 지원하는 대용량 모델, MIG 파티셔닝, vGPU, 비디오 트랜스코딩, 전력 사용량 측정 기능, 4500 시리즈 카드 두 장으로 구성된 모델, 그리고 이 등급 이상의 데이터센터용 카드입니다.
최대 달성 가능 Matmul FLOPS(MAMF)
MAMF는 각 정밀도에서 그래픽 카드가 도달하는 최대 연산 처리량을 보고하는 지속적인 고밀도 GEMM 테스트로, 서빙 스택을 제외한 FP4 하드웨어의 작동 여부를 확인하는 가장 쉬운 방법입니다. 4500은 BF16에서 135.9 TFLOPS, FP8에서 280.1 TFLOPS, NVFP4에서 568.6 TFLOPS를 기록했으며, 정밀도가 낮아질수록 처리량이 거의 두 배로 증가했습니다. NVIDIA의 고밀도 테스트 최고 성능인 202, 406, 811 TFLOPS와 비교하면 모든 정밀도에서 최고 성능의 67%~70% 수준이며, NVIDIA의 cuBLAS 테스트 결과인 133, 275, 534 TFLOPS와도 유사한 결과를 보입니다.
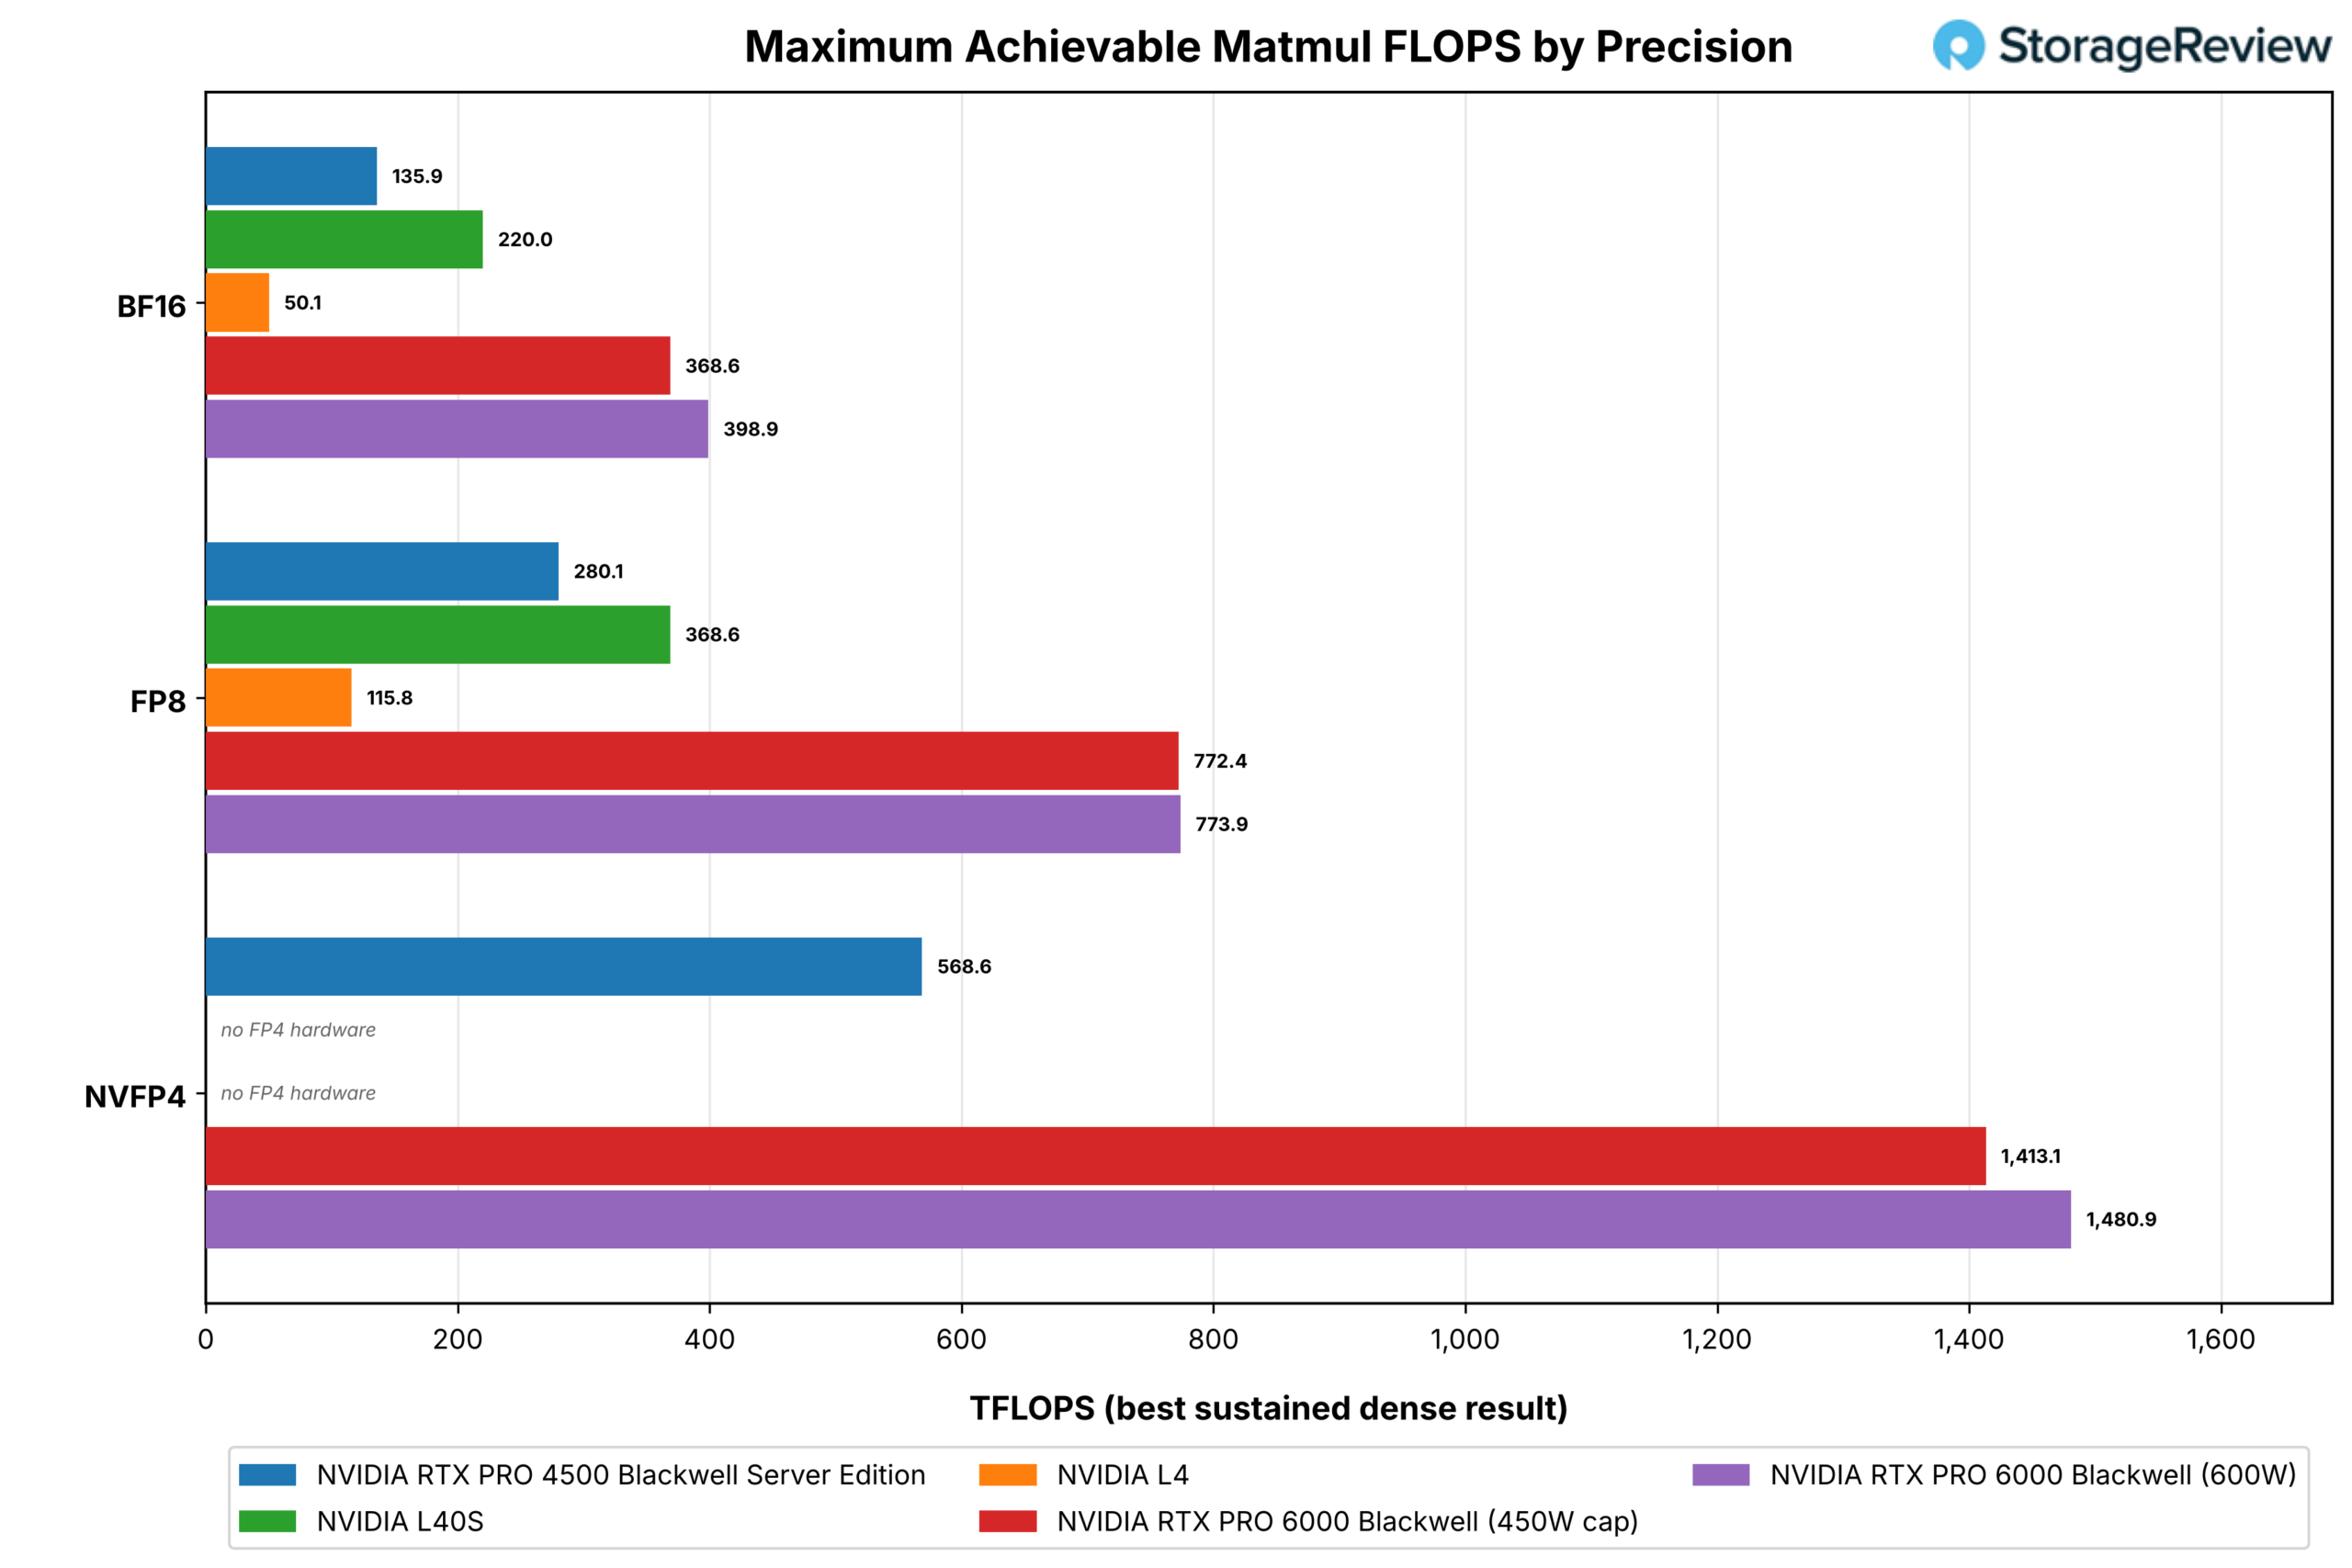
RTX PRO 6000은 비슷한 확장성을 보이며 600W에서 398.9, 773.9, 1,480.9 TFLOPS를 달성했는데, 이는 세 가지 정밀도 모두에서 4500보다 2.6배에서 2.9배 높은 수치로, 다이 크기와 전력 예산 예측과 일치합니다. 450W 제한에서는 368.6, 772.4, 1,413.1 TFLOPS를 기록했습니다. FP8은 변동이 없었고, BF16은 8%, NVFP4는 5% 감소했는데, 이는 6000의 FP8 텐서 경로가 이 테스트에서 450W 미만에 위치하고 나머지 두 정밀도는 한계치에 근접함을 의미합니다. L40S는 BF16과 FP8에서 각각 220.0과 368.6 TFLOPS를, L4는 각각 50.1과 115.8 TFLOPS를 기록했습니다. 두 Ada 카드 모두 FP4 텐서 하드웨어를 갖추고 있지 않습니다.
유용한 비교 대상은 4500 시리즈의 NVFP4 결과와 다른 모든 시리즈의 FP8 결과를 비교하는 것입니다. 568.6 TFLOPS는 L40S의 FP8 최대 성능의 1.5배이며, 165W 카드에서 6000 시리즈 최대 성능의 74%에 해당합니다. 이것이 바로 FP4의 장점이며, GEMM 레벨에서 이미 존재합니다. 이어지는 vLLM 서빙 결과는 이 빌드에서 아직 서빙 스택에 도달하지 않았음을 보여주고, MAMF 결과는 NVFP4 커널이 따라잡음에 따라 서빙 수치가 계속 증가할 것임을 시사합니다.
vLLM 온라인 서비스: 간략한 개요 (512/512)
간략한 맥락에서 4500의 장점이 드러납니다. 세 가지 FP8 및 BF16 모델에서 동시 실행 32일 때 출력 처리량은 Ministral 3 14B에서 1,107 토큰/초(L40S의 995 토큰/초 대비), Ministral 3 8B에서 1,017 토큰/초(L40S의 1,005 토큰/초 대비), Ministral 3 3B에서 2,006 토큰/초(L40S의 1,988 토큰/초 대비)를 기록했습니다. 이 모든 결과는 165W의 Blackwell 카드가 350W의 Ada 카드와 동등하거나 그 이상의 성능을 보여주는 것이며, 동시 실행 1부터 32까지 그래프가 거의 비슷하게 나타나므로 이는 최고치만을 나타낸 결과가 아닙니다. L4는 동일 모델에서 각각 364, 279, 704 토큰/초를 기록했는데, 이는 4500이 이전 모델보다 2.8배에서 3.6배 높은 성능임을 의미합니다.

RTX PRO 6000은 블랙웰 아키텍처의 나머지 부분이 제공하는 성능을 보여줍니다. 450W로 제한했을 때, 동일한 세 가지 모델에서 각각 2,161, 2,042, 4,069 토큰/초를 기록했는데, 이는 RTX 4500보다 1.95배에서 2.03배 높은 수치입니다. 최대 전력인 600W에서는 2,283, 2,139, 4,155 토큰/초를 기록하여 2.06배에서 2.1배 높은 성능을 보였습니다. 두 RTX 6000 시리즈의 성능 곡선은 모든 모델에서 동시 접속자 수 16까지는 거의 동일하며, 32에서는 2~5% 정도의 차이만 보입니다. 따라서 단기적인 테스트에서는 마지막 150W 차이가 성능에 큰 영향을 미치지 않습니다. RTX 4500과 비교했을 때, 이는 메모리 용량이 3배 더 크고, R770의 경우 슬롯 전력 소모량이 2.7배 더 큰 카드에서 두 배의 처리량을 보여주는 것입니다.

요청당 512개의 사전 충전 토큰을 포함한 총 처리량은 다음과 같은 순서를 따릅니다. 14B 모델의 4500은 2,215 토큰/초, L40S는 1,990, L4는 727 토큰/초이며, 6000은 최대 4,323, 600W에서는 4,566 토큰/초입니다. L4와의 차이는 8B 모델에서 3.6배로 가장 크고, 3B 모델에서 2.8배로 가장 작으며, L40S와의 차이는 4500이 12% 이상 우세하지 않습니다.

vLLM 온라인 서비스: 장기 컨텍스트(8K/1K)
8,192개의 입력 토큰에 도달하면 상황이 달라지는데, 그 이유는 곡선의 모양에서 확인할 수 있습니다. Ministral 3 14B FP8에서 4500은 동시 입력 수 8까지 L40S와 비슷한 성능을 보이다가 약 180 토큰/초에서 평탄해지는 반면, L40S는 동시 입력 수 16에서 230 토큰/초까지 계속 유지됩니다. 8B 모델에서도 마찬가지입니다. 4500은 동시 입력 수 32에서 185 토큰/초를 기록하고 L40S는 277 토큰/초를 기록하며, 4500은 동시 입력 수 8에서, L40S는 동시 입력 수 16에서 평탄해집니다. 3B 모델에서는 두 카드 모두 동시 입력 수 16에서 평탄해지는데, 4500은 384 토큰/초, L40S는 475 토큰/초를 기록합니다.

이유는 KV 캐시 용량 때문입니다. 모든 동시 8K 요청에는 해당 컨텍스트가 카드에 상주해야 하는데, 가중치가 로드된 후에는 32GB 프레임 버퍼가 48GB 프레임 버퍼보다 저장할 수 있는 컨텍스트 수가 적습니다. vLLM이 KV 공간이 부족해지면 유용한 동시성을 더 이상 추가하지 못하고 처리량 그래프가 평탄해집니다. 이러한 이유로 4500은 동시성 32에서 L40S에 비해 17~33% 낮은 성능을 보입니다. 짧은 컨텍스트 결과에서 알 수 있듯이 컴퓨팅 측면이 병목 현상은 아닙니다. 24GB 캐시와 300GB/s의 처리량을 가진 L4는 모든 모델에서 동시성 4부터 34~130 토큰/s로 평탄한 성능을 보입니다.

6000 시리즈의 96GB 메모리는 이 테스트에서 용량 부족 현상을 전혀 보이지 않았으며, 모든 모델에서 성능 곡선은 32까지 꾸준히 상승했습니다. 450W 제한에서는 552, 589, 973 토큰/초를 기록했는데, 이는 4500 시리즈 대비 2.5배에서 3.2배 높은 수치입니다. 600W에서는 608, 639, 1,033 토큰/초를 기록하여 2.7배에서 3.5배 높은 성능을 보였습니다. 전력 제한이 드러나는 유일한 부분은 바로 이 성능입니다. 장기 컨텍스트 사전 채우기로 인해 6000 시리즈는 컴퓨팅 성능 제한에 더 오래 노출되므로, 전력 제한이 걸린 카드는 동시 실행 16과 32에서 4~9%의 성능 저하를 보인 반면, 단기 컨텍스트에서는 2~5%의 성능 저하를 보였습니다. 어느 경우든 4500 시리즈와의 성능 차이는 2배에서 약 3배로 벌어지는데, 이는 전력보다는 메모리 용량 차이 때문입니다.

문서 질의응답, 장시간 컨텍스트에 걸친 RAG 작업 또는 대용량 도구 출력을 처리하는 에이전트 작업과 같은 워크로드의 경우 메모리가 가장 중요한 사양이며, 4500의 32GB는 동시 처리량에 제약이 됩니다. 하지만 채팅, 분류 또는 짧은 에이전트 턴의 경우에는 그렇지 않습니다. 8K/1K에서의 총 처리량은 사전 입력에 의해 좌우되며, 순서는 동일하게 유지됩니다. 14B 모델의 4500은 1,713 토큰/초, L40S는 2,070, L4는 381 토큰/초이며, 6000은 최대 4,971, 600W에서는 5,474 토큰/초로 나타납니다.
NVFP4: 소프트웨어가 한계를 정하는 곳
NVFP4 기반의 Qwen3.8-27B는 블랙웰 아키텍처에 탑재된 FP4 텐서 하드웨어를 사용하는 유일한 모델이며, 그 결과 이번 리뷰에서 가장 평탄한 성능 곡선을 보여줍니다. 짧은 컨텍스트 테스트에서 동시 접속자 32명일 때, RTX 4500은 초당 320개의 출력 토큰을 생성했고, L40S, 480, RTX PRO 6000은 최대 출력 621개, 600W 전력 소모 시 616개를 기록했습니다. 동시 접속자 1명일 때는 27B 모델에서 모든 카드가 초당 17~22개의 토큰을 처리했는데, 1.6TB/s GDDR7 메모리를 탑재한 RTX 6000도 마찬가지였습니다. 동일한 카드가 14B FP8 모델에서는 단일 스트림으로 초당 99개의 토큰을 처리했습니다.

L40S에는 FP4 텐서 하드웨어가 없으므로 vLLM은 가중치를 역양자화하고 더 높은 정밀도로 계산하는 NVFP4 체크포인트를 실행합니다. 이는 메모리 대역폭에 제약이 따르는 방식이지만, 4500보다 1.5배 빠른 성능을 보여줍니다. 4500과 동일한 FP4 하드웨어를 갖추고 대역폭이 2배 높은 6000은 다른 모든 부분에서 4500보다 약 2배 빠른 성능을 보이며, 450W와 600W에서의 전력 소비량은 모든 동시 실행 수준에서 1% 이내의 차이를 보이므로 커널 역시 전력 제약을 받지 않습니다.
메모리 대역폭에 따라 변하지 않는 단일 스트림 처리량과 GPU 종류에 관계없이 480~621의 동시 접속 제한(concurrency-32)을 보이는 네 가지 시리즈 모두에서 나타나는 패턴은 이 vLLM 빌드의 NVFP4 커널 경로가 모든 카드에서 한계점임을 시사합니다.

8K/1K 테스트에서 4500은 동시 접속자 32명일 때 초당 153 토큰을 처리했는데, 이는 L40S의 190, 6000의 402(캐시 제한 적용 시) 및 425(캐시 제한 미적용 시)와 비교됩니다. 이는 FP8 및 BF16 모델에서 보였던 것과 동일한 KV 캐시 제한 양상이며, 6000의 96GB 캐시가 다른 제품들의 성능 정체 속에서도 지속적으로 상승하는 이유입니다.
NVIDIA는 이 그래픽 카드에서 Llama 3.1 8B(2K/256)에서 FP4 처리량 1,221 토큰/초, Nemotron 3 Nano 30B A3B(TensorRT-LLM)에서 905 토큰/초를 기록했으므로, NVIDIA 스택에서는 하드웨어 성능이 우수합니다. 오늘 발표된 데이터는 이 카드의 NVFP4가 우리가 테스트한 모든 GPU에서 공통적으로 나타나는 vLLM 소프트웨어 기반 기술임을 보여주며, FP4 처리량을 중요하게 생각하는 구매자는 해당 그래픽 카드를 사용하기 전에 서버 스택을 테스트해야 한다는 것을 시사합니다.
정격 와트당 처리량
이번 테스트에서는 전력을 측정하지 않았으므로, 이번에 제공되는 효율 계산은 각 카드의 테스트된 전력 제한을 기준으로 합니다. Ministral 3 14B FP8 동시 실행 32에서 RTX 4500은 정격 와트당 6.7개의 출력 토큰/초를 제공하며, L40S는 2.8개, L4는 5.1개, 450W 제한 전력을 사용하는 RTX PRO 6000은 4.8개, 600W 제한 전력을 사용하는 6000은 3.8개입니다. 3B 모델에서도 이 비율은 동일하게 유지되어 RTX 4500은 12.2개, L40S는 5.7개, L4는 9.8개, 전력 제한 전력을 사용하는 6000은 9.0개, 600W 제한 전력을 사용하는 6000은 6.9개입니다.
4500은 단기적인 효율성 측면에서 이 그룹 내에서 가장 효율적인 카드이며, 전력 소비가 제한된 6000만이 그에 근접합니다. 6000의 전력 소비를 450W로 낮추면 처리량은 2~5% 감소하지만 전력 예산의 25%를 되찾게 되므로 효율성 수치가 25% 향상됩니다. L4는 72W라는 매우 작은 분모 덕분에 이 지표에서 경쟁력을 유지하지만, 동일한 처리량을 달성하려면 3배 더 많은 슬롯과 서버가 필요하며, 이는 4500이 개발된 목적입니다.
8K/1K에서는 순서가 바뀝니다. 14B 모델의 경우 4500은 정격 와트당 1.2 토큰/초, 최대 출력 6000은 1.2, 600W 6000은 1.0 토큰/초, L40S는 0.7 토큰/초를 기록합니다. 4500의 KV 캐시 용량이 소진되면 처리량은 더 이상 증가하지 않지만 전력 등급은 그대로 유지되므로, 장기 컨텍스트에서는 450W 6000이 효율성 면에서 4500과 동등하며 슬롯당 2.9배 더 많은 작업을 처리합니다.
맺음말
RTX PRO 4500 Blackwell Server Edition은 NVIDIA가 설명한 대로 Blackwell 아키텍처를 기존 L4급 칩셋에 맞는 슬롯, 전력 소비량, 섀시에 탑재했습니다. 대부분의 메인스트림 서버에서 사용되는 소규모 및 중규모 명령어 세트와 추론 모델을 채팅 수준의 컨텍스트에서 처리하는 경우, L40S급 성능에 버금가는 전력 소비량과 L4급 칩셋 대비 40배에 달하는 처리량을 단일 슬롯 카드로 제공합니다.
물론 한계는 있습니다. 메모리부터 살펴보면, 32GB는 이 카드가 대상으로 하는 모델에는 충분한 용량이지만, 장시간 컨텍스트 처리 시에는 동시 처리량에 한계가 있습니다. 이 부분에서는 L40S의 48GB, 특히 6000 시리즈의 96GB가 훨씬 앞서 나가며, 동일한 서버에서 허용하는 전력 소비량으로 설정하더라도 6000 시리즈는 동일한 요청 형태에서 4500 시리즈보다 약 3배 빠른 성능을 보여줍니다.
블랙웰의 핵심 정밀도인 NVFP4는 이 vLLM 빌드에서 FP4 하드웨어가 없는 카드와 비슷한 성능을 보입니다. MAMF 스윕 결과 FP4 하드웨어가 GEMM 레벨에서 카드의 FP8 속도보다 두 배 빠른 속도를 제공하는 것으로 나타났지만, FP4의 이점은 자체 스택에서 검증해야 합니다. 하지만 소프트웨어 개선을 통해 더 큰 성능 향상을 기대할 수 있습니다.
2U 서버 또는 FHFL 카드를 장착할 수 있는 1U 섀시를 사용하는 사용자 중 전력이나 냉각 시스템을 변경하지 않고 추론, 비전 AI, 트랜스코딩 또는 가상 워크스테이션 용량을 추가해야 하는 경우 RTX PRO 4500이 탁월한 선택입니다. 또한, 24GB 메모리로는 부족한 L4 서버를 운영하는 사용자라면 4500에 만족할 것입니다. 하지만 워크로드가 장기 컨텍스트이거나 멀티테넌트 환경으로 인해 카드당 48GB 이상의 메모리가 필요한 조직의 경우 RTX PRO 6000이 더 나은 선택입니다.
NVIDIA는 이러한 그래픽 카드에 대해 두 개의 명확한 영역을 지정하여 훌륭한 성과를 거두었으며, 4500은 165W의 전력 소모만으로 L4와 6000 사이의 엣지 AI 격차를 메웁니다.
순위표: RTX PRO 4500 Blackwell Server Edition은 최고의 엔터프라이즈 GPU 순위표에서 최고의 단일 슬롯 GPU로 선정되었으며, 이 리뷰에서 다룬 L40S 및 RTX PRO 6000 데이터도 해당 순위표에 포함되어 있습니다.



 아마존