

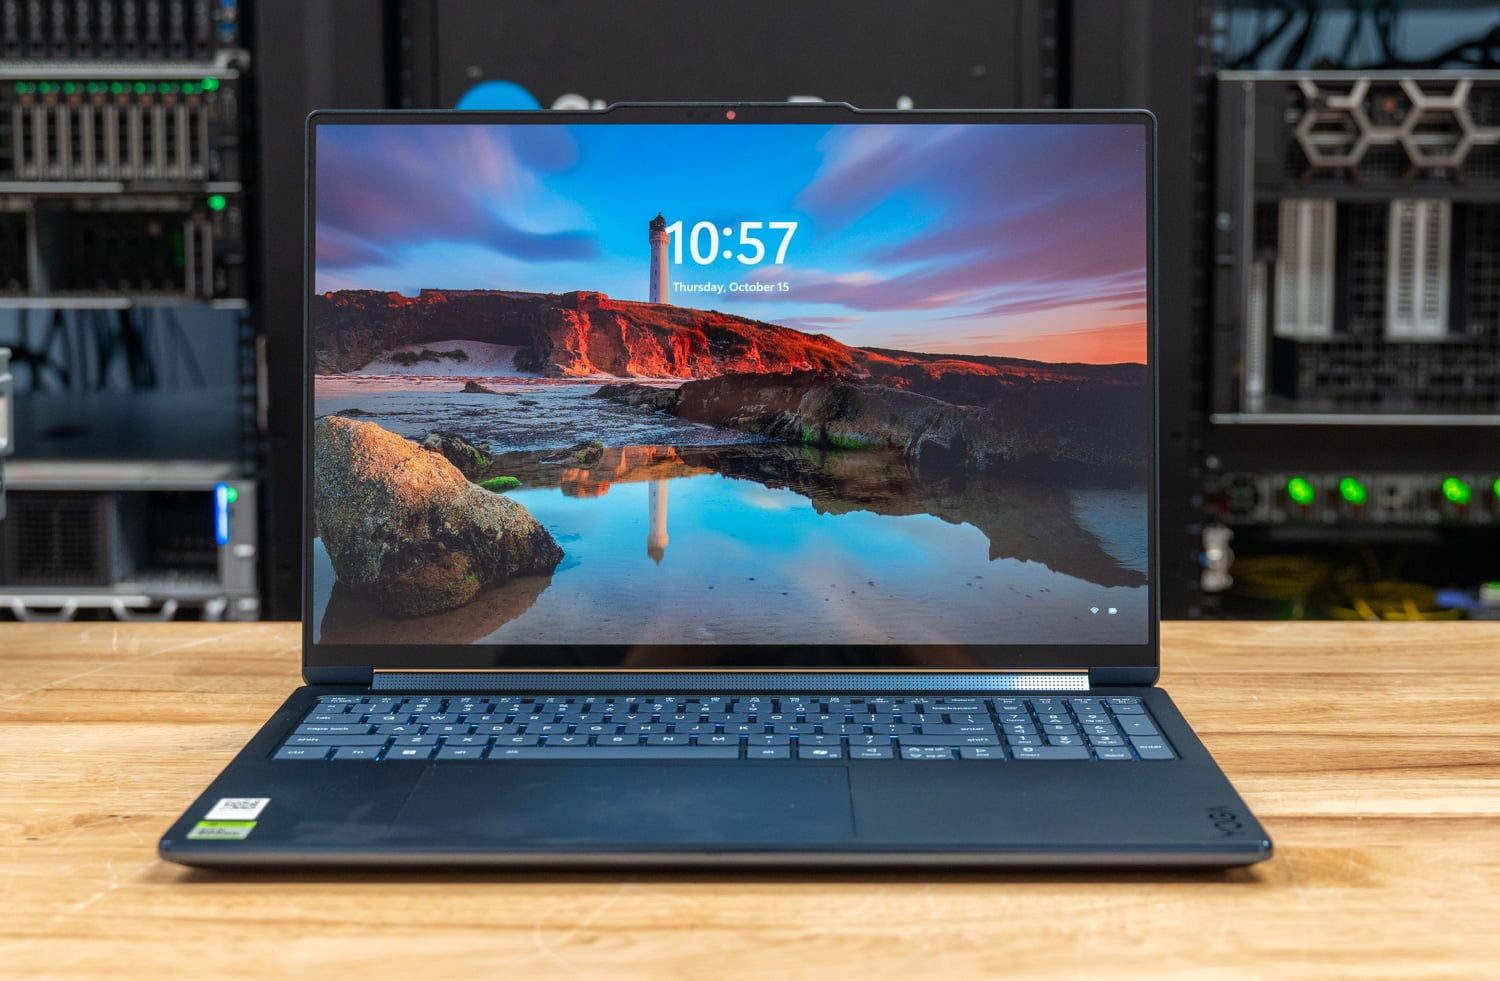
레노버 Yoga 9n 2-in-1 16은 NVIDIA RTX Spark N1X 프로세서를 탑재한 컨버터블 노트북입니다. 16인치 OLED 터치스크린은 힌지를 통해 태블릿 모드와 텐트 모드로 접을 수 있으며, 펜 입력이 가능한 햅틱 터치패드와 0.69인치 두께의 알루미늄 섀시를 갖추고 있습니다. 저희 테스트 제품은 20코어 N1X 프로세서(6,144코어 Blackwell GPU), 64GB LPDDR5X RAM, 1TB Gen4 SSD를 탑재했으며, 베스트 바이에서 이 구성으로 판매하는 가격은 3,749.99달러입니다. 18코어, 32GB RAM, 1TB SSD 모델은 3,099.99달러에 판매됩니다.
세 가지 비교 시스템을 통해 Yoga의 성능을 분석했습니다. 128GB 용량의 HP OmniBook Ultra 16은 16인치 클램쉘 디자인에 동일한 20코어 N1X 프로세서를 탑재했으며, 저희가 테스트한 RTX Spark 노트북 중 가장 빠른 성능을 자랑하므로 Yoga의 쿨링 튜닝이 어떤 부분에서 타협점을 보이는지 비교하는 기준으로 삼았습니다. Lenovo Pro 9n 15 는 18코어 프로세서를 탑재한 Yoga의 형제 모델이며, Razer Blade 16은 Surface Laptop Ultra 리뷰 에서 RTX 5090으로 64비트 제품군을 선도했던 경험을 바탕으로 비교 대상으로 선정했습니다. 이 외에도 디자인 및 외관, AI 성능, CPU, 메모리, 게임 성능, 발열, 저장 장치 등을 자세히 살펴보았으며, 배터리 성능은 새로운 테스트 장비가 준비되는 대로 공개할 예정입니다.
Yoga의 성능을 가늠하는 가장 중요한 지표는 온도입니다. OmniBook이 모든 코어에 부하를 걸어 98°C까지 온도가 올라가는 상황에서도 Yoga의 CPU 온도는 최고 71~86°C에 머물렀고, 30분간의 지속적인 테스트에서도 72°C를 유지하며 안정적인 성능을 보여주었습니다. 레노버는 이러한 성능 향상의 비결로 통풍구를 확장하고 열팽창을 높인 재설계된 열 관리 시스템과, 컨버터블 힌지 설계를 통해 통풍구 뒤쪽에 공기 흐름을 위한 공간을 확보한 점을 들었습니다. 하지만 이러한 설계 변경으로 인해 모든 코어의 클럭 속도가 다소 낮아졌고, 대부분의 멀티스레드 테스트에서 Yoga 4는 OmniBook보다 최대 10% 정도 성능이 떨어지지만, 싱글 스레드 테스트에서는 동일한 성능을 보였습니다.
주요 요점
- 32GB의 GPU 메모리는 당사의 S 등급 모델을 최고 속도로 구동합니다. 코딩 에이전트는 초당 58.0 토큰으로 gpt-oss:20b를 생성했는데, 이는 128GB OmniBook과 동일한 속도이며, MLPerf는 해당 속도의 5% 이내의 오차 범위 내에서 작동했습니다. Tier M의 Qwen3.6-35B-A3B는 약 40GB의 GPU 메모리가 필요하므로 Yoga는 이 테스트를 수행하지 않습니다.
- 저희가 테스트해본 RTX Spark 노트북 중 가장 멋진 제품입니다: Cinebench에서 최고 출력 시 72°C, 지속적인 루프 실행 동안 72°C를 기록한 반면, OmniBook에서는 첫 번째 패스 100%에서 안정 상태일 때 98°C를 기록했습니다.
- 25도에서 CPU 처리량의 몇 퍼센트 정도: 시네벤치 2026 멀티코어 점수는 6,292점으로 옴니북보다 10% 낮고 레이저 블레이드 16보다 22% 높으며, 싱글코어 점수는 557.0점으로 HP와 동일합니다.
- 크리에이터를 위해 만들어진 컨버터블: 최대 밝기 1,100니트의 2.8K OLED 디스플레이, 함께 제공되는 Yoga Pen Gen 2와 호환되는 햅틱 터치패드, 회전식 사운드바에 탑재된 트위터, 그리고 4.28파운드(약 1.9kg) 무게의 본체에 99.9Wh 배터리가 내장되어 있습니다.
- QLC 스토리지는 약점입니다. Gen4 QLC SSD는 순차 읽기 속도는 6,874MB/s였지만 4K 랜덤 쓰기 IOPS는 68.9으로 그룹 내 최저치를 기록했으며, 초기 부팅 시 약 2초 정도 지연시키는 결과를 초래했습니다.
빌드 및 디자인
Yoga 9n 2-in-1은 레노버의 컨버터블 디자인을 채택하여 디스플레이를 태블릿, 텐트, 스탠드 모드로 접을 수 있습니다. 상단과 하단 섀시는 코스믹 블루 색상의 알루미늄으로 제작되었으며, 가장 얇게 펼쳤을 때 크기는 14.17 x 9.57 x 0.69인치이고, 무게는 4.28파운드부터 시작합니다. 레노버는 이 디자인이 MIL-STD-810H 테스트를 통과했으며, 하단 커버에는 50% 재활용 알루미늄이 사용되었다고 밝혔습니다.

손에 쥐었을 때 Yoga는 Pro 9n과 마찬가지로 둥근 모서리와 포트 배치를 가지고 있으며, 덮개는 자석으로 고정됩니다. 키보드는 숫자 키패드가 포함된 풀 사이즈 레이아웃으로 견고한 느낌을 주며, 유리 소재의 Force Pad는 양손을 동시에 사용할 수 있을 만큼 충분히 큽니다. Yoga는 Pro 9n보다 폭이 약간 더 넓고, 힌지를 통해 디스플레이를 완전히 뒤로 접어 태블릿 모드로 사용할 수 있어 Pro 9n의 클램셸 디자인보다 방열판 통풍구와 힌지 사이의 공간이 더 넓습니다.
냉각 성능은 Yoga가 우리가 테스트한 다른 RTX Spark 노트북과 차별화되는 부분입니다. 레노버는 통풍구를 확대하고 하단에 열 방출용 돌출부를 추가하여 열 관리 시스템을 재설계했으며, 컨버터블 힌지 덕분에 섀시 후면에 공기 흐름을 위한 공간이 더 확보되었습니다. 그 결과 Stockfish 테스트에서 CPU 온도가 71°C에 그쳤는데, OmniBook은 98°C를 기록했습니다. 발열 관련 내용은 클럭 속도가 낮아진 점에 대한 자세한 분석에서 확인할 수 있습니다.

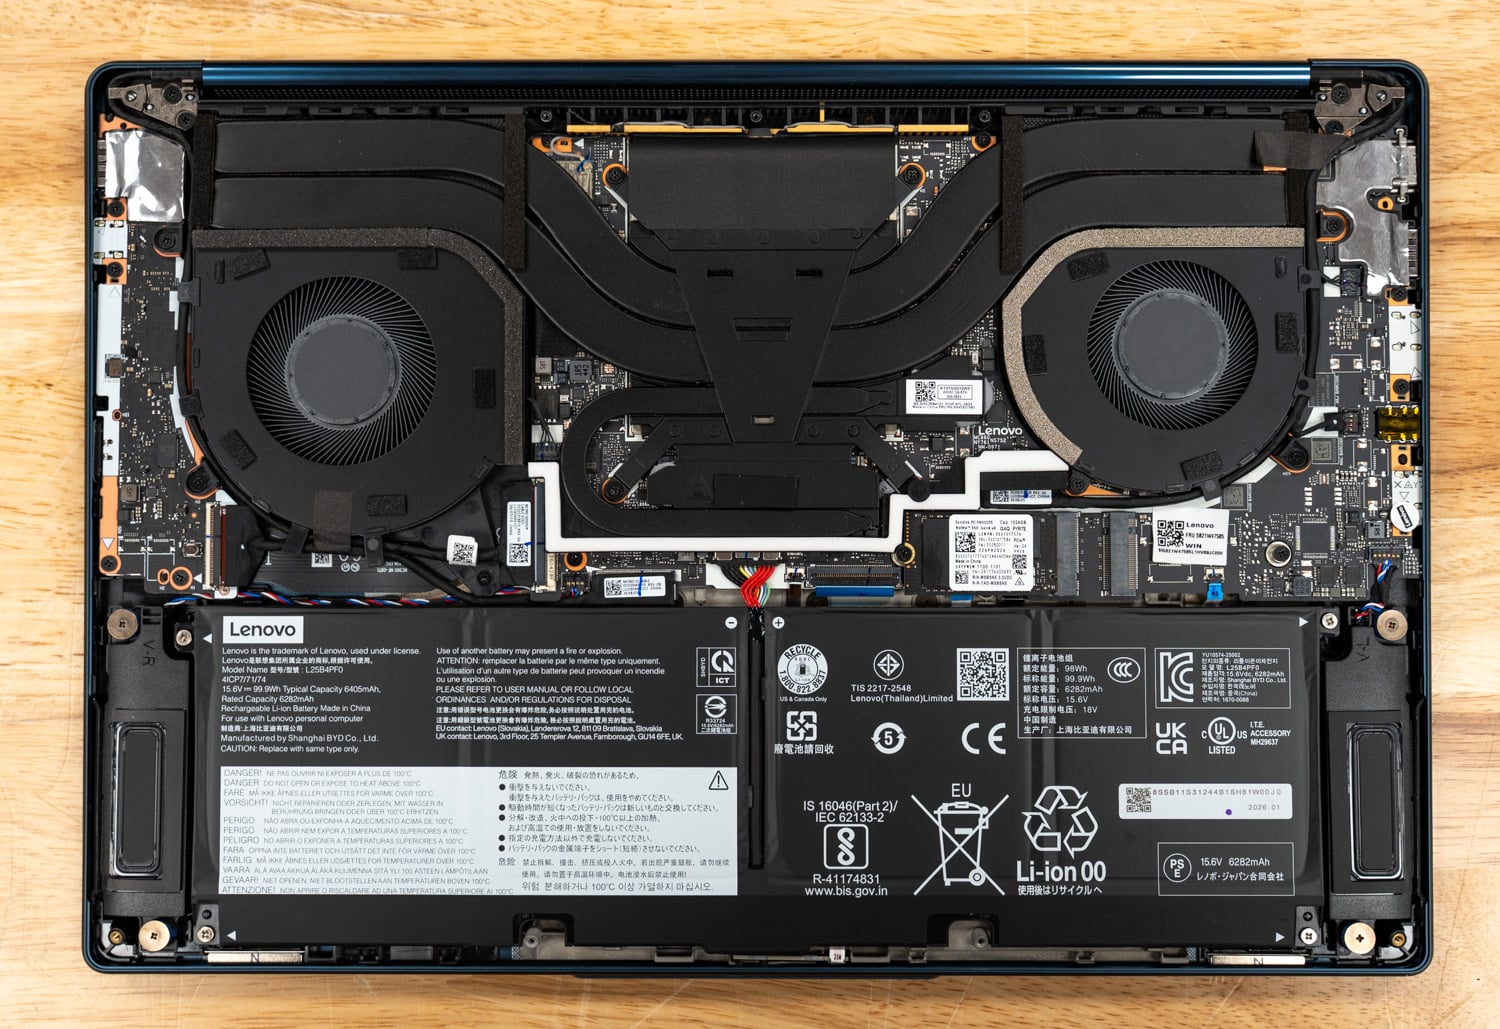
아래쪽에는 천공된 흡기 그릴이 하단 커버 뒷부분의 대부분을 덮고 있으며, 배기구는 힌지 아래쪽 후면 가장자리를 따라 나 있습니다. 커버를 제거하면 두 개의 팬이 후면 모서리에 위치하고, 히트 파이프가 있는 넓은 방열판 어셈블리가 그 사이에 보드 중앙을 가로지릅니다.
언뜻 보면 Pro 9n과 동일한 쿨러와 팬 어셈블리처럼 보이지만, Yoga 9n은 덕트가 없는 팬을 사용합니다. Pro 9n에는 두 팬 모두 흡입구를 부분적으로 막는 작은 반달 모양 커버가 있습니다. M.2 2242 SSD는 보드 중앙의 방열판 아래에 위치하고, 그 옆에는 Lenovo에서 제공하는 두 번째 M.2 슬롯이 있습니다. 99.9Wh 배터리는 섀시 앞쪽 절반을 차지하고 있으며, 양쪽 측면 앞쪽 슬릿을 통해 소리를 내는 우퍼 인클로저가 그 양쪽에 자리 잡고 있습니다.
레노버 제품을 다른 NVIDIA 모바일 플랫폼과 차별화하는 설계 특징 중 하나는 다른 제품들이 2280 M.2 베이 하나만 사용하는 반면, Yoga는 2242 M.2 베이 두 개를 탑재했다는 점입니다. 덕분에 Yoga는 두 번째 드라이브 옵션을 제공하지만, 2242 SSD는 용량이 작고 일반적으로 2280 SSD보다 성능이 떨어지기 때문에 저장 용량 면에서 성능 차이가 나타납니다.
16인치 PureSight Pro OLED 터치스크린은 2880 x 1800 해상도에 30Hz에서 120Hz까지 가변 주사율을 지원합니다. 레노버는 HDR 모드에서 최대 밝기 1,100니트, sRGB 및 P3 색역 100% 지원, Delta E 1 미만, Dolby Vision, VESA DisplayHDR True Black 1000 인증을 제공한다고 밝혔습니다. 오디오 시스템은 회전식 사운드바 힌지에 2W 우퍼 4개와 2W 트위터 2개를 탑재하여 모든 모드에서 트위터가 사용자를 향하도록 설계되었습니다.

키보드는 1.5mm 키 스트로크, 백라이트, 그리고 코파일럿 키를 갖추고 있습니다. 키보드 아래에는 햅틱 센서가 내장된 포스 패드가 있으며, 이 패드는 AES 3.0을 지원하는 Yoga Pen Gen 2의 드로잉 표면으로도 활용할 수 있습니다. Yoga Pen Gen 2는 8,192단계의 압력 감지 및 기울기 감지 기능을 제공하며, USB-C로 충전되고, 자석 케이스에 보관하여 노트북 덮개 뒷면에 부착할 수 있습니다. 9.2MP 적외선 카메라는 전자식 셔터를 탑재했으며, 3개의 마이크가 음성 인식을 담당합니다.
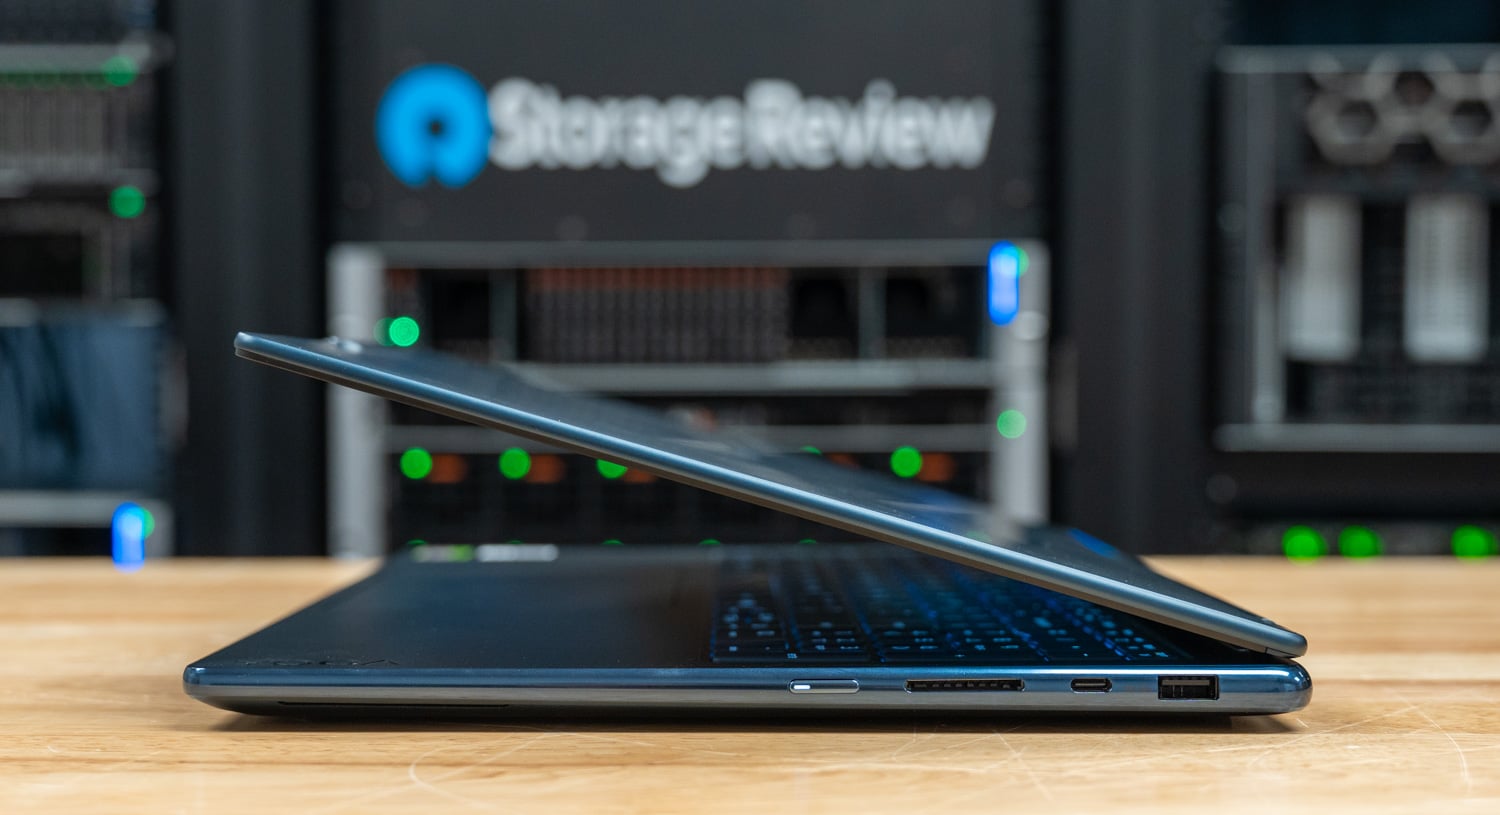
왼쪽 측면에는 HDMI 2.1, 10Gbps 속도의 USB-A 포트, Power Delivery 및 DisplayPort 2.1을 지원하는 40Gbps 속도의 USB-4 포트, 그리고 헤드폰 잭이 있습니다. 오른쪽 측면에는 전원 버튼, UHS-I SD 카드 리더기, 두 번째 USB-4 포트, 그리고 두 번째 USB-A 포트가 있으며, 두 개의 USB-A 포트 중 하나는 항상 켜져 있습니다. 무선 연결은 Wi-Fi 7과 Bluetooth 5.4를 지원하며, 99.9Wh 배터리는 Lenovo에서 15분 충전으로 3시간 사용이 가능하다고 하는 Rapid Charge Express를 지원합니다.

RTX Spark N1X 플랫폼
RTX Spark는 N1X 슈퍼칩을 기반으로 하는 Windows PC 제품군으로, DGX Spark 의 GB10 칩의 노트북 버전 이며, 저희 Surface Laptop Ultra 리뷰에서 해당 플랫폼을 다루었습니다. Yoga는 최상위 사양의 칩셋을 탑재했는데, 20코어 Grace CPU(10개의 고속 코어와 10개의 효율 코어, SMT 미지원)와 6,144코어 Blackwell RTX GPU가 조합되어 있습니다.
NVIDIA는 노트북용 N1X 설계에 45~80W의 전력 범위를 제공하며, 제조사가 이 범위 내에서 노트북을 어떻게 냉각하는가가 칩 자체만큼이나 결과에 큰 영향을 미칩니다. 레노버는 Yoga를 70W, HP는 OmniBook을 최대 70W, 그리고 Lenovo Pro 9n을 최대 80W로 표기했지만, 동일한 부하 조건에서 세 제품 모두 클럭 속도와 온도가 다르게 나타납니다.
N1X의 LPDDR5X 메모리는 CPU와 GPU가 공유하며, BIOS가 아닌 NVIDIA 앱의 설정을 통해 Windows가 GPU에 할당하는 메모리 비율을 결정할 수 있으므로 데스크톱에서 이 비율을 변경할 수 있습니다.
저희가 사용한 64GB Yoga는 32GB GPU/32GB CPU로 구성되어 있습니다. 이는 S 등급 로컬 AI 모델에는 적합하지만, 약 40GB가 필요한 M 등급에는 적합하지 않습니다. 모든 RTX Spark 시스템과 마찬가지로, 메모리 용량은 구매 시 용량을 결정하는 데 중요한 제약 조건입니다.
고정된 메모리 분할은 NVIDIA의 문제가 아니라 Windows의 제한 사항입니다. Windows는 DGX Spark의 Linux 스택처럼 CPU와 GPU 간의 통합 메모리 사용을 아직 지원하지 않기 때문에 메모리 할당을 미리 설정해야 합니다. NVIDIA와 Microsoft가 이 기능을 지원하기 위해 협력하고 있는 것으로 알고 있습니다.
Windows 11 26H1은 Arm64에서 실행됩니다. x64 애플리케이션은 Prism 에뮬레이션을 거치고, 저희 제품군은 모든 오픈 소스 워크로드의 네이티브 Arm64 빌드를 사용하므로 CPU 행은 실리콘을 비교합니다.
레노버 요가 9n 2-in-1 16 사양
| 스펙 | 레노버 요가 9n 2-in-1 16 (83N7000UUS) |
|---|---|
| 플랫폼 개요 | |
| 프로세서 | NVIDIA RTX Spark N1X, 20코어 CPU 및 6,144코어 Blackwell RTX GPU (테스트 기준) NVIDIA RTX Spark N1X, 18코어 CPU 및 5,120코어 Blackwell RTX GPU |
| 메모리 | 64GB 납땜형 LPDDR5X-9400, 256비트(테스트 기준); 최대 64GB까지 지원 32GB GPU / 32GB 시스템 분할 (테스트 결과 기준) |
| 스토리지 | 1TB PCIe Gen4 QLC M.2 2242 SSD 샌디스크 PC SN5100S 1TB (테스트 결과) |
| 운영체제 | Windows 11 (Arm64); 테스트 환경: Windows 11 Home |
| 디스플레이 및 입출력 | |
| 디스플레이 | 16인치 2.8K(2880 x 1800) PureSight Pro OLED 터치스크린, 30-120Hz VRR, 16:10 화면비 최대 밝기 1,100니트(HDR), sRGB 및 P3 색역 100%, Delta E <1, Dolby Vision VESA DisplayHDR True Black 1000, 유리 |
| 포트 | USB4 40Gbps 포트 2개 (USB PD 3.0, DisplayPort 2.1 지원) USB-A 10Gbps 포트 2개 (하나는 상시 전원 공급) HDMI 2.1 포트 1개 (최대 8K/60Hz 지원) SD 카드 리더기(UHS-I) 1개 헤드폰/마이크 콤보 잭 1개 |
| Wireless | Wi-Fi 7 (802.11be 2×2), 블루투스 5.4 |
| 카메라 | 9.2MP + IR (전자식 셔터 포함) |
| 오디오 | 6개의 스피커: 회전식 사운드바에 장착된 2W 우퍼 4개, 2W 트위터 2개; 돌비 애트모스 지원 3개의 마이크 |
| 입력 | 백라이트 키보드, 1.5mm 키 스트로크, 코파일럿 키 펜 지원 기능이 있는 햅틱 포스 패드 Yoga Pen 2세대 (AES 3.0, 8,192단계 필압 감지, 포함) |
| 힘과 신체 | |
| 배터리 | 99.9Wh, 급속 충전 익스프레스 |
| 열 설계 | 확대된 통풍구와 방열판; 70W TDP (레노버 기준) |
| 크기 | 14.17 x 9.57 x 0.69인치(360 x 243.1 x 17.5mm) |
| 중량(평량) | 4.28파운드(1.94kg)부터 시작 |
| 색상 및 재질 | 코스믹 블루 색상, 알루미늄 상하단; MIL-STD-810H 테스트 완료 |
| 가격 | |
| 가격 (최저가) | 3,099.99달러(18코어, 32GB, 1TB); 3,749.99달러(20코어, 64GB, 1TB, 테스트 모델) |
테스트 설정 및 방법론
저희 Yoga 9n 2-in-1 리뷰 시스템은 6,144코어의 Blackwell GPU를 탑재한 RTX Spark N1X, GPU와 시스템에 각각 32/32로 분할된 64GB의 LPDDR5X-9400 메모리, 그리고 1TB Sandisk SN5100S Gen4 SSD를 Windows 11 Home 26H1(Arm64) 운영체제에 연결하여 사용했습니다. 벤치마크는 Lenovo의 성능 모드에서 실행했습니다.
이 비교에 포함된 모든 시스템은 OEM 드라이버 및 유틸리티가 포함된 공장 출고 상태의 Windows 이미지를 사용하여 자체 개발한 Windows 클라이언트 벤치마크 도구인 sr-client 1.2를 전체 실행 및 피크 프로파일로 실행했습니다. 이 도구는 모든 시스템에 동일한 실험실 설정을 적용합니다. 즉, Windows 전원 모드는 최적 성능으로 설정하고, 전원 어댑터를 연결한 상태이며, 디스플레이 밝기는 50%로 설정하고, 모든 절전 및 화면 꺼짐 타이머를 비활성화하고, Windows 방화벽 및 UAC 프롬프트를 끕니다. 각 결과는 반복 실행의 중앙값이며, 결과값의 편차가 2%를 초과하는 경우 재실행 후 유효한 결과로 간주합니다.
| 시스템 | CPU | 메모리 | GPU는 GPU 및 AI 테스트에 사용됩니다. | SSD | 운영 체제 및 성능 모드 |
|---|---|---|---|---|---|
| 레노버 요가 9n 2-in-1 16인치 | NVIDIA RTX Spark N1X, 20C / 20T | 64GB LPDDR5X-9400 (32GB GPU / 32GB 시스템 분할) | 6,144코어 블랙웰 RTX (통합형, 32GB 사용 가능 메모리) | 샌디스크 PC SN5100S 1TB, Gen4 x4 | Windows 11 Home 26H1 (Arm64), Lenovo 성능 모드 |
| HP 옴니북 울트라 16 (128GB) | NVIDIA RTX Spark N1X, 20C / 20T | 128GB LPDDR5X-9400 (64GB GPU / 64GB 시스템 분할) | 6,144코어 블랙웰 RTX (통합형, 62.5GB 사용 가능 메모리) | 샌디스크 PC SN8050S 2TB, Gen5 x4 | Windows 11 Pro 26H1 (Arm64), HP 퍼포먼스 |
| 레노버 프로 9n 15 | NVIDIA RTX Spark N1X, 18C / 18T | 32GB LPDDR5X-9400 (12GB GPU / 20GB 시스템 분할) | 5,120코어 블랙웰 RTX (통합형, 12GB 사용 가능 메모리) | 삼성 MZAL81T0HFLB 1TB, Gen4 x4 | Windows 11 Pro 26H1 (Arm64), Lenovo 성능 모드 |
| Razer의 블레이드 16 | AMD 라이젠 AI 9 HX 370, 12코어/24스레드 | 32GB LPDDR5X-8000 | NVIDIA GeForce RTX 5090 노트북 GPU, 24GB | 삼성 MZVL22T0 2TB, 4세대 x4 | Windows 11 Home 25H2 (x64), Razer Synapse 성능 |
아래 표에서 두 가지 레이블이 반복적으로 나타납니다. "실행 안 함"은 하드웨어가 테스트 기준을 충족하지 못해 테스트 시작을 거부했음을 의미하며, 이는 대부분 모델의 GPU 메모리 용량이 부족하기 때문입니다. Yoga의 32GB와 Blade 16의 24GB는 M 등급 미만이며, Pro 9n의 12GB는 두 등급 모두에 미치지 못합니다. 동일한 레이블은 12GB Pro 9n에서 건너뛴 OpenBLAS 메모리 크기를 나타냅니다.
N/A는 해당 하드웨어에 테스트가 적용되지 않음을 의미합니다. 예를 들어 SMT 기능이 없는 칩의 SMT 싱글 코어 테스트 또는 네이티브 빌드를 실행하는 x64 시스템의 에뮬레이션 행 등이 이에 해당합니다. RTX Spark 시스템에서 Prism을 통해 x64 소프트웨어를 실행한 경우 해당 데이터에는 N/A로 표시됩니다.
로컬 AI 성능
로컬 AI 성능은 GPU가 모델을 실행하는 속도와 모델 적합성에 달려 있습니다. Yoga의 32GB GPU 사용 가능 메모리는 티어 S 모델인 gpt-oss:20b를 128GB OmniBook과 동일한 세대 속도로 실행하지만, OmniBook의 62.5GB가 빛을 발하는 티어 M에는 미치지 못합니다.
MLPerf 클라이언트 v2.0
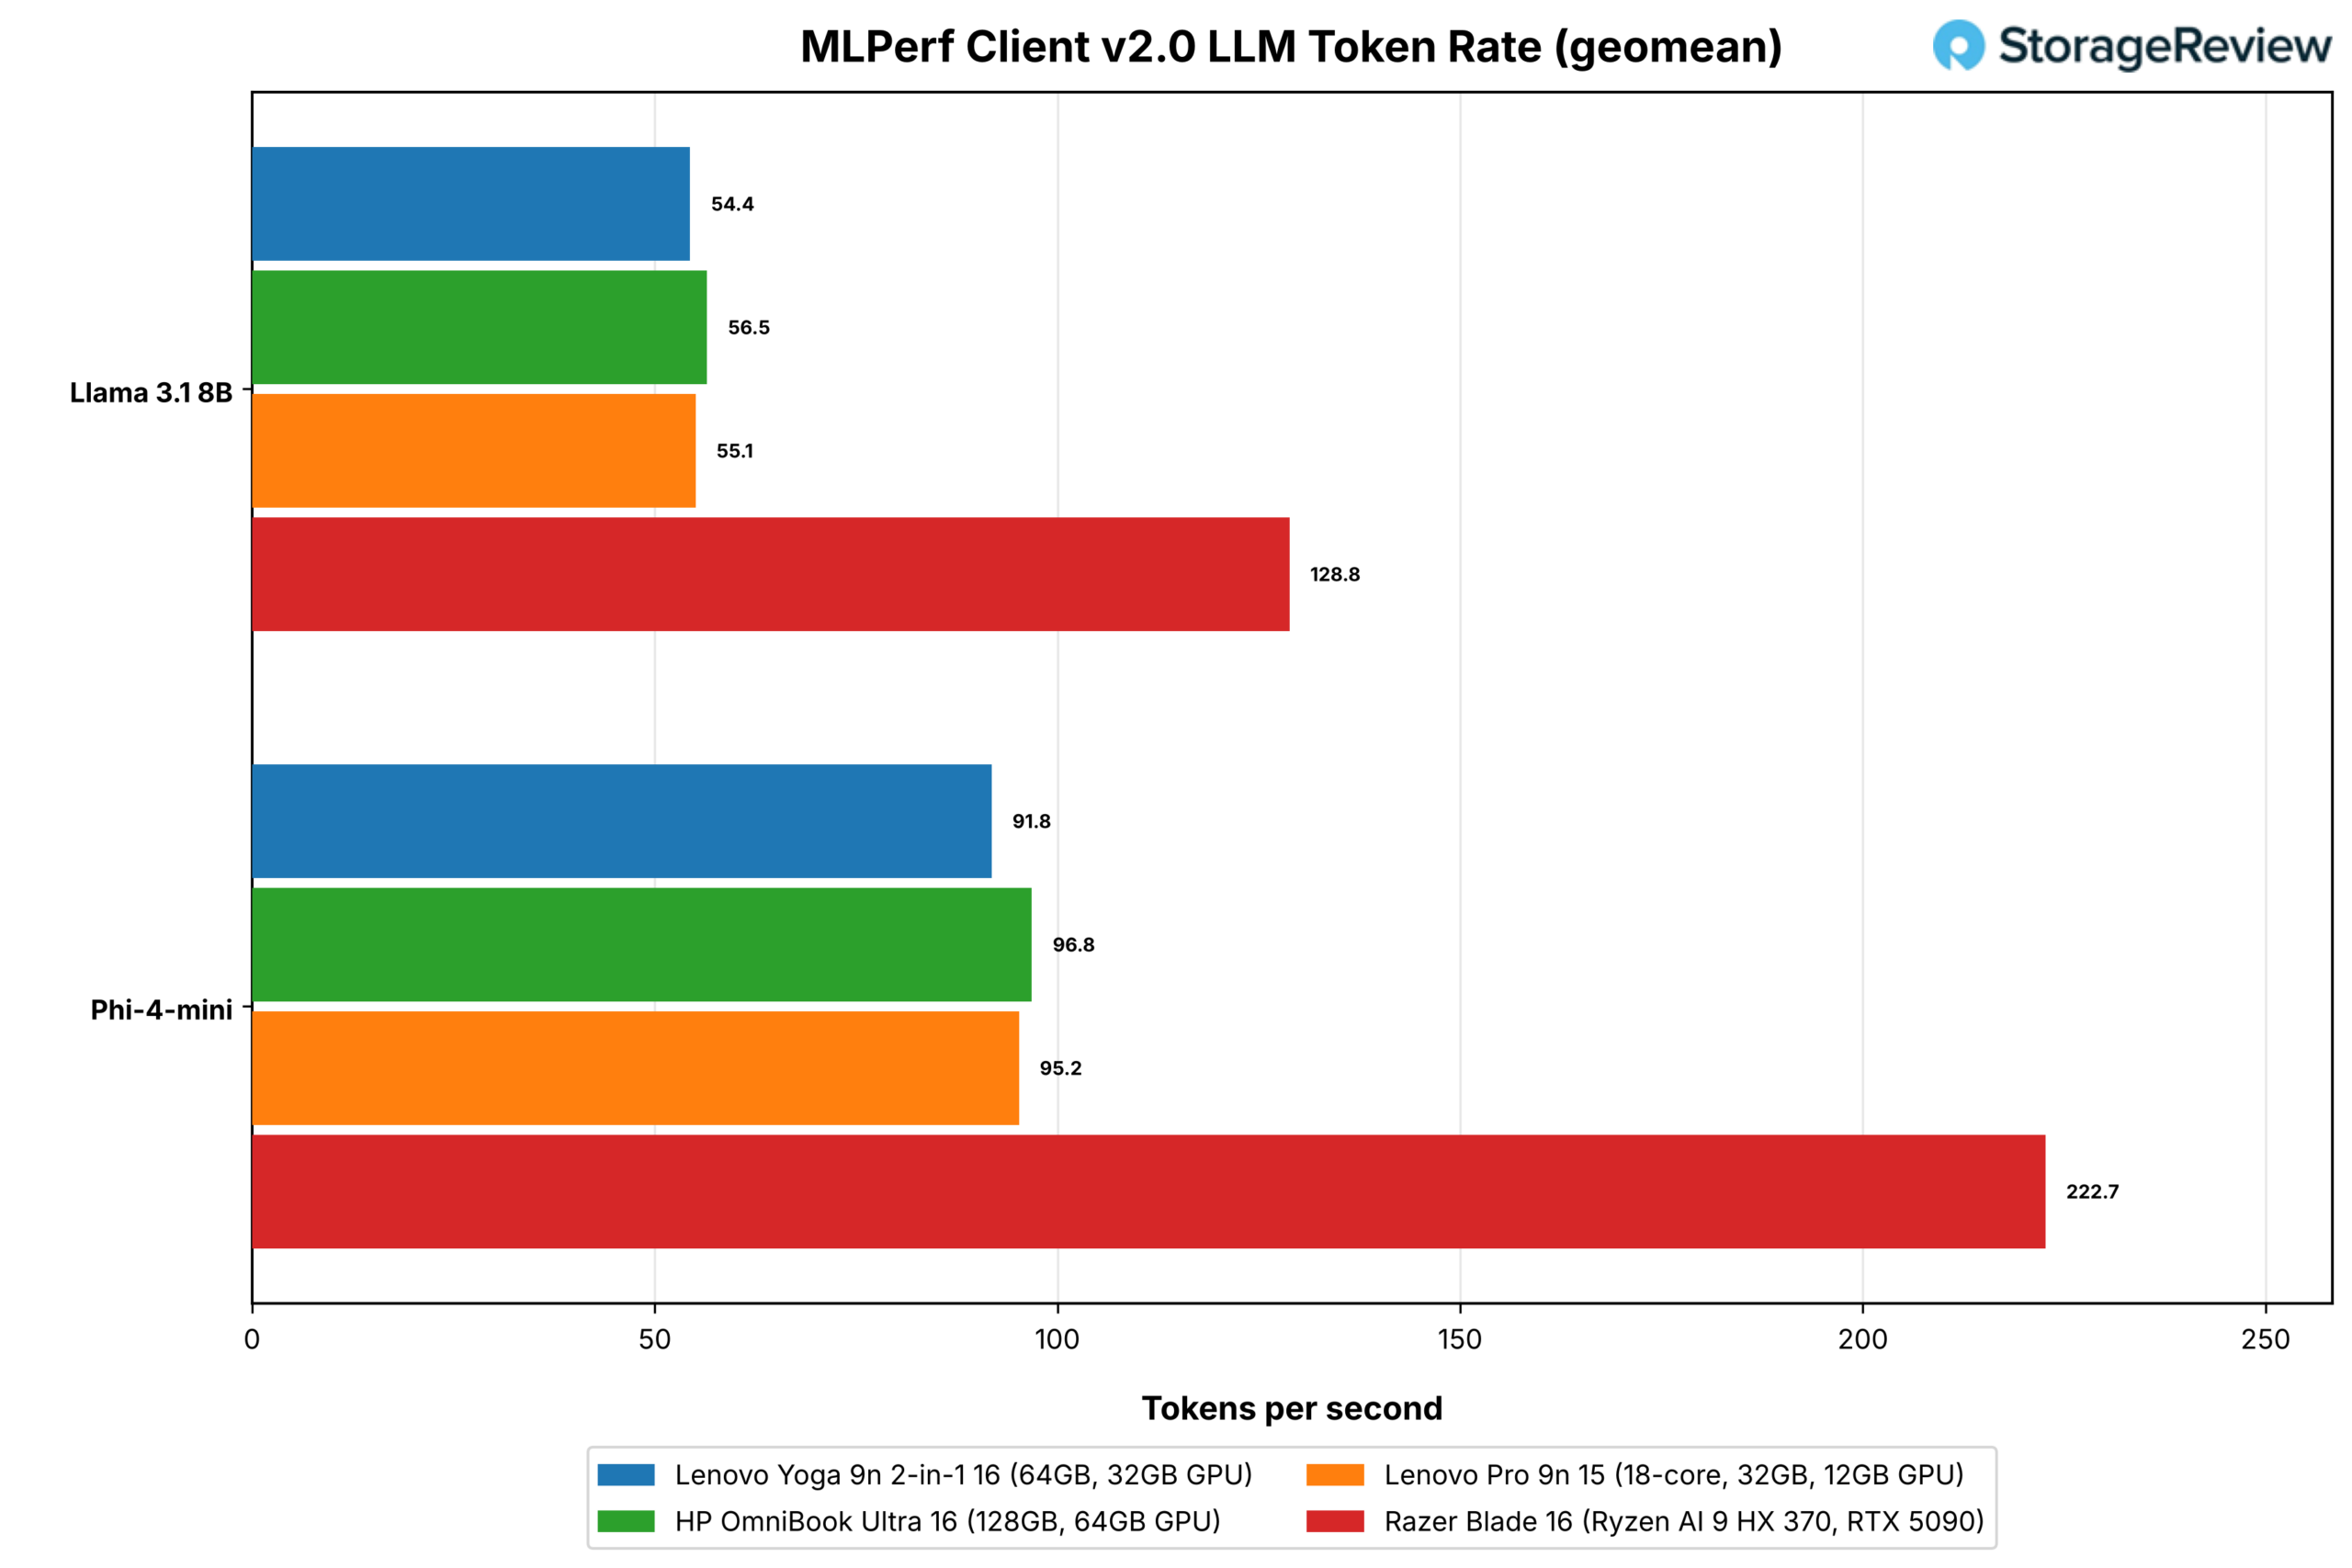
MLPerf 클라이언트는 Llama 3.1 8B 및 Phi-4-mini를 사용하여 5개의 프롬프트 범주를 실행하고 첫 번째 토큰까지의 시간과 그 이후의 토큰 생성률을 기하 평균으로 보고합니다. 여기 있는 모든 시스템은 CUDA를 사용하는 llama.cpp를 사용하므로 엔진은 동일하며, 행은 하드웨어 성능을 비교합니다. 에이전트 시나리오에서는 Llama 3.1 8B가 소프트웨어 엔지니어링 에이전트와 데이터 분석가 에이전트로 실행되어 여러 턴에 걸쳐 도구를 호출합니다.
| MLPerf 클라이언트 v2.0 | 요가 9n 2-in-1 16 | 옴니북 울트라 16 (128GB) | 프로 9n 15 | Razer의 블레이드 16 |
|---|---|---|---|---|
| Llama 3.1 8B, 첫 번째 토큰까지의 시간, 기하평균(초, 낮을수록 좋음) | 0.353 | 0.274 | 0.303 | 0.149 |
| Llama 3.1 8B, 토큰 비율, 기하평균(tok/s) | 54.4 | 56.5 | 55.1 | 128.8 |
| Phi-4-mini, 첫 번째 토큰 생성 시간, 기하평균(s, 낮을수록 좋음) | 0.158 | 0.130 | 0.135 | 0.074 |
| Phi-4-mini, 토큰 비율, 기하평균(토크/초) | 91.8 | 96.8 | 95.2 | 222.7 |
| 데이터 분석 에이전트, 엔드 투 엔드 (s, 낮을수록 좋음) | 59.7 | 53.0 | 56.2 | 27.8 |
| 데이터 분석 에이전트, 토큰 비율(tok/s) | 45.3 | 48.5 | 46.9 | 108.3 |
| SWE 에이전트, 엔드 투 엔드(s, 낮을수록 좋음) | 51.6 | 45.3 | 48.0 | 24.6 |
| SWE 에이전트, 토큰 비율(tok/s) | 43.0 | 46.6 | 44.5 | 102.5 |
Yoga는 Llama 3.1 8B에서 초당 54.4 토큰, Phi-4-mini에서 초당 91.8 토큰을 기록했는데, 이는 OmniBook보다 각각 4%와 5% 낮은 수치입니다. 특히 첫 번째 토큰 처리에서 격차가 더욱 커지는데, 이 처리는 메모리 대역폭보다 연산 능력에 더 의존합니다. Yoga는 Llama 3.1에서 0.353초가 걸린 반면 HP는 0.274초가 걸렸고, 18코어 Pro 9n에도 뒤처졌습니다. 이러한 결과는 Lenovo의 쿨링 튜닝이 GPU와 CPU 모두에 적용되었음을 시사합니다. Yoga는 세 N1X 시스템 중 가장 낮은 CPU 클럭에서도 MLPerf를 실행했기 때문입니다.
에이전트 기반 시나리오에서 Yoga는 데이터 분석가 에이전트의 경우 59.7초, 소프트웨어 엔지니어 에이전트의 경우 51.6초가 소요되어 OmniBook보다 13~14% 더 오래 걸렸으며, Blade 16은 Yoga보다 절반도 안 되는 시간에 두 에이전트 모두 작업을 완료했습니다.
모델 로딩
이 테스트는 Ollama에서 로컬 모델을 SSD에서 첫 번째 토큰을 생성할 때까지 걸리는 시간을 콜드 로드(파일 캐시가 비워진 상태)와 웜 로드(파일이 이미 메모리에 있는 상태) 모두에서 측정하고, 콜드 로드 시 SSD 읽기 속도를 보고합니다. S 등급은 GPU 사용 가능 메모리가 16GB 이상인 시스템에서 gpt-oss:20b(12.8GB)를 사용하고, M 등급은 약 40GB 이상의 시스템에서 Qwen3.6-35B-A3B(21.1GB)를 추가합니다.
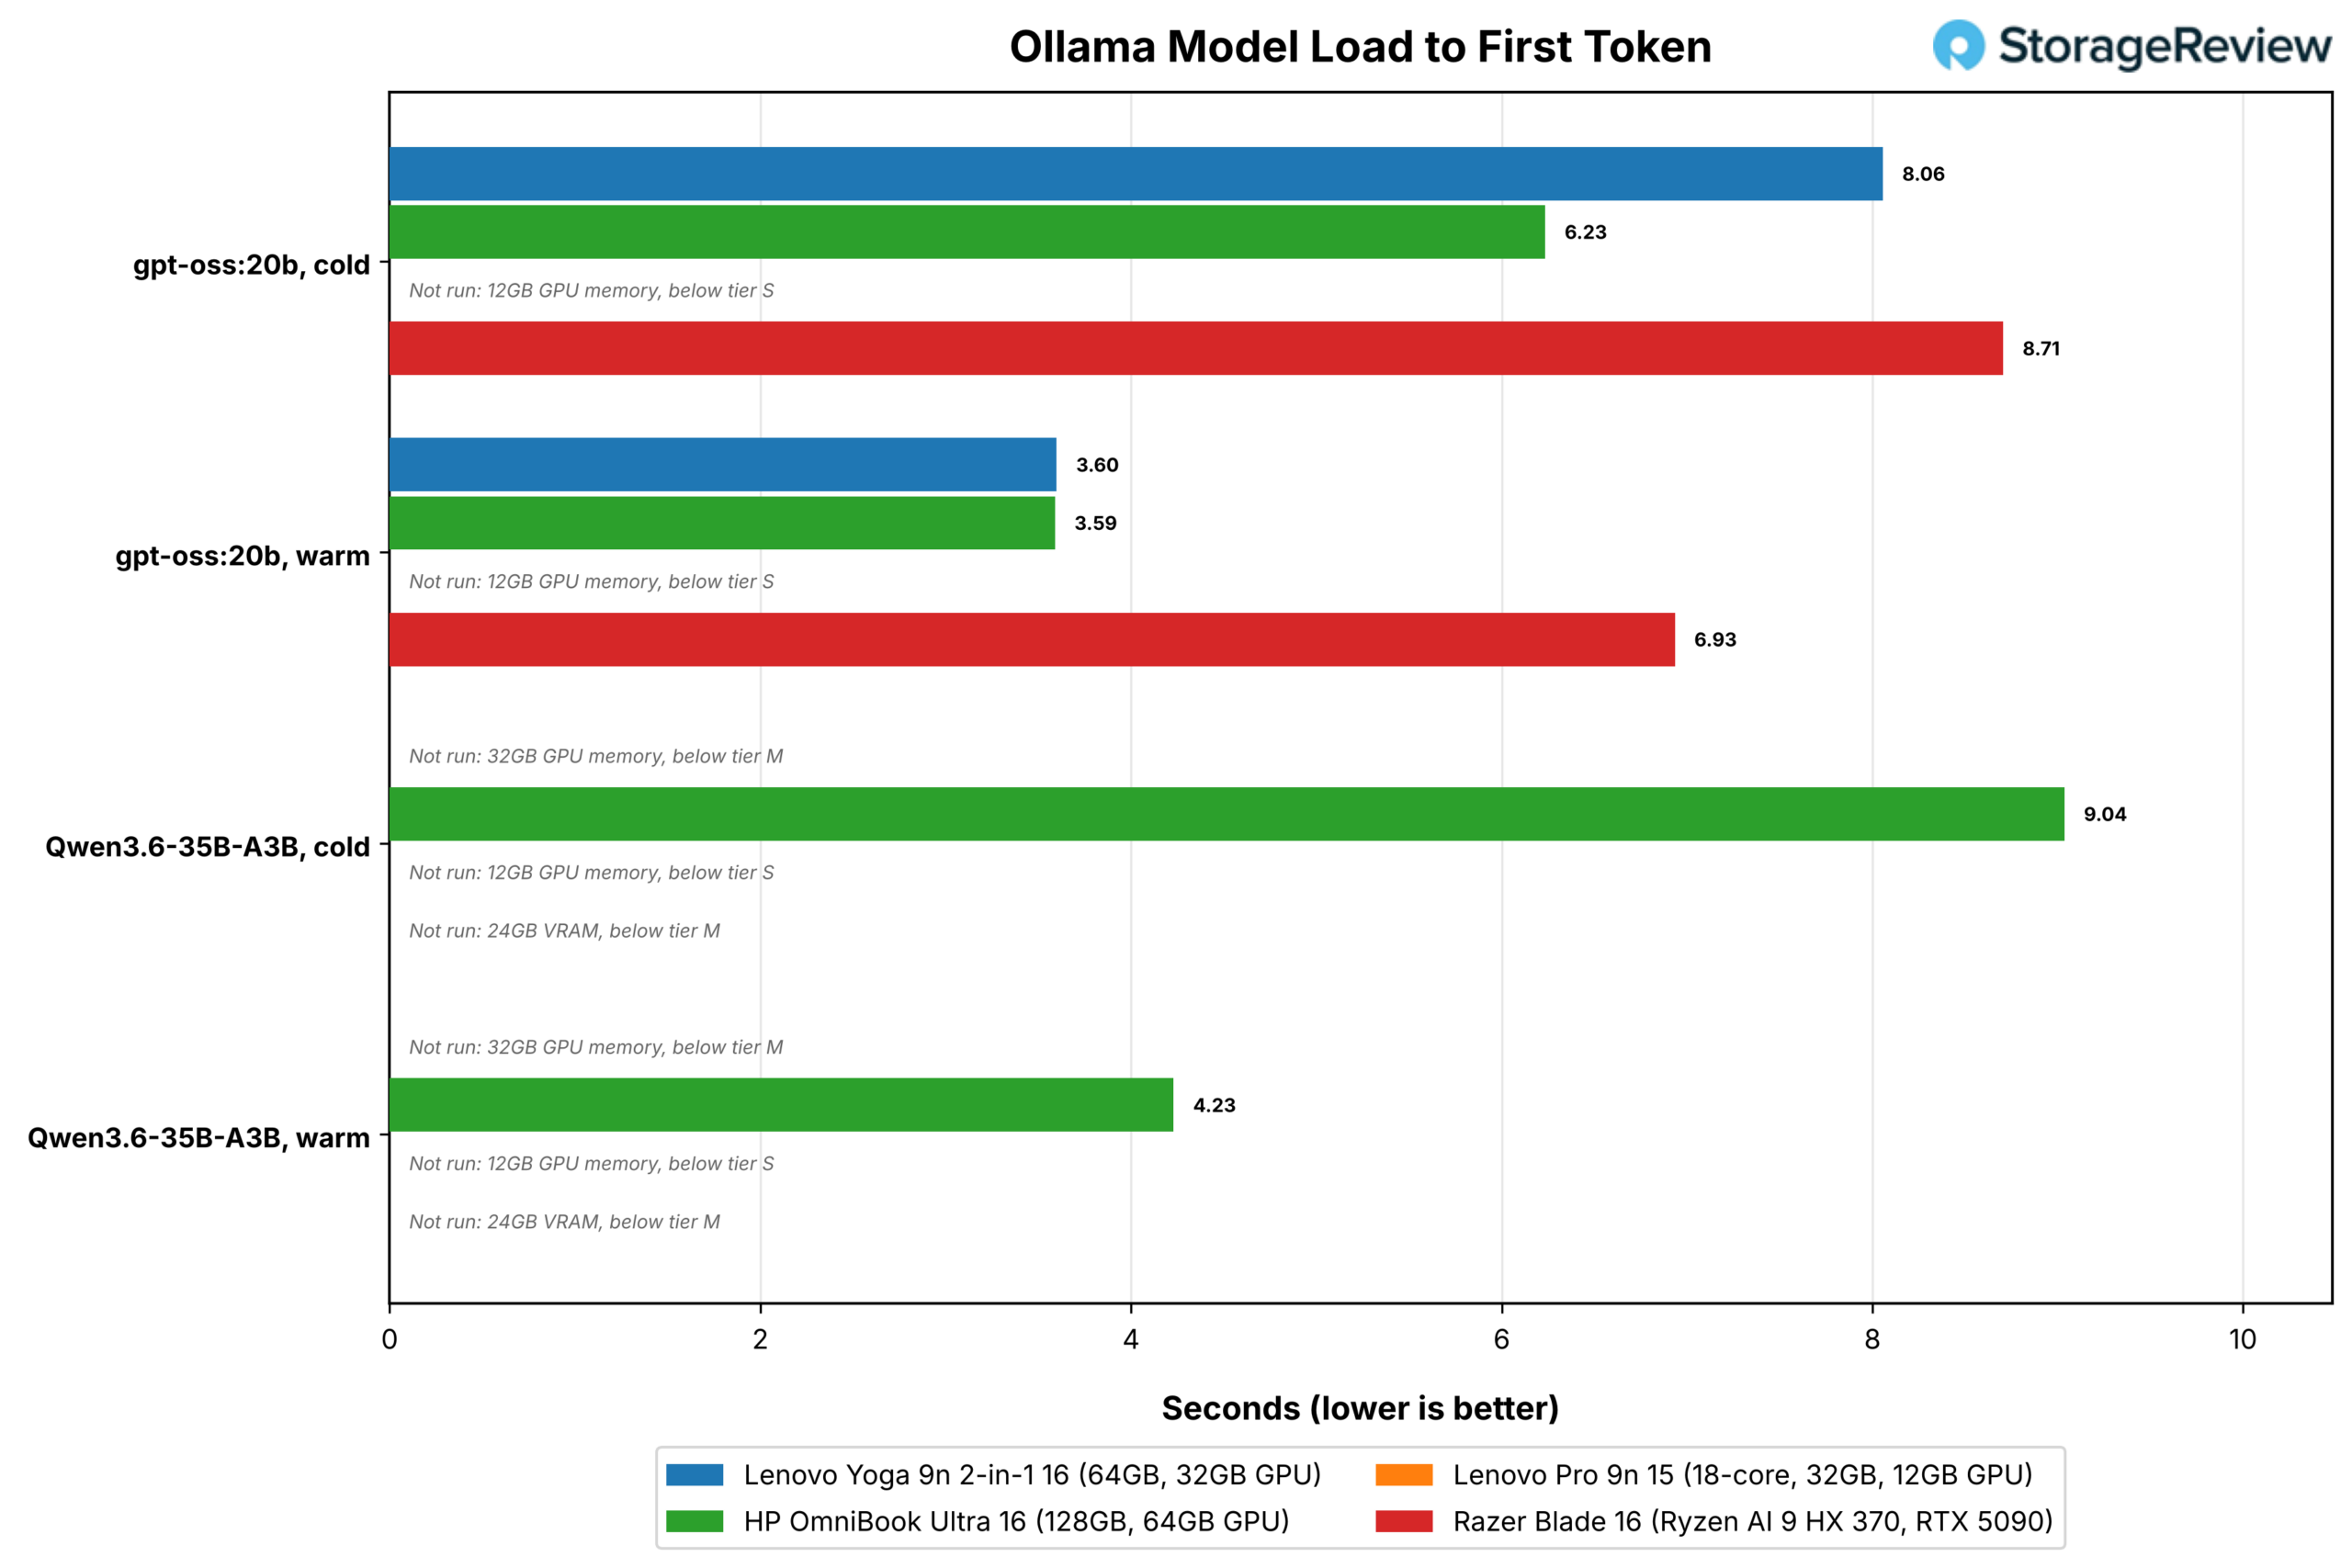
| 모델 로딩(메모리 매핑 켜짐) | 요가 9n 2-in-1 16 | 옴니북 울트라 16 (128GB) | 프로 9n 15 | Razer의 블레이드 16 |
|---|---|---|---|---|
| gpt-oss:20b, 첫 번째 토큰에 콜드 로드(s, 낮을수록 좋음) | 8.06 | 6.23 | 실행되지 않음 (12GB GPU 메모리) | 8.71 |
| gpt-oss:20b, 첫 번째 토큰에 대한 웜 로딩(s, 낮을수록 좋음) | 3.60 | 3.59 | 실행되지 않음 (12GB GPU 메모리) | 6.93 |
| gpt-oss:20b, 콜드로드 시 읽기 처리량(MB/s) | 2,480 | 3,044 | 실행되지 않음 (12GB GPU 메모리) | 3,874 |
| Qwen3.6-35B-A3B, 첫 번째 토큰에 콜드 로드(s, 낮을수록 좋음) | 실행되지 않음 (32GB GPU 메모리, M 등급 미만) | 9.04 | 실행되지 않음 (12GB GPU 메모리) | 실행 불가 (24GB VRAM, M 등급 미만) |
| Qwen3.6-35B-A3B, 첫 번째 토큰에 웜 로드(s, 낮을수록 좋음) | 실행되지 않음 (32GB GPU 메모리, M 등급 미만) | 4.23 | 실행되지 않음 (12GB GPU 메모리) | 실행 불가 (24GB VRAM, M 등급 미만) |
따뜻한 상태에서 Yoga는 gpt-oss:20b를 첫 번째 토큰까지 읽는 데 3.60초가 걸려 OmniBook의 3.59초와 동일했습니다. 차가운 상태에서는 8.06초가 걸렸는데, 이는 Yoga의 QLC 드라이브가 부하 시 2,480MB/s의 속도로 데이터를 읽은 반면 OmniBook의 Gen5 드라이브는 3,044MB/s로 읽었기 때문입니다. Blade 16은 차가운 상태와 따뜻한 상태 모두에서 8.71초와 6.93초로 가장 느렸는데, 이는 데이터를 읽은 후 PCIe를 거쳐 VRAM으로 이동해야 하기 때문입니다.
코딩 에이전트
Codex CLI는 고정된 저장소에 있는 코딩 작업을 통해 Ollama에서 제공하는 로컬 모델을 실행합니다. 저장소의 11개 테스트가 모두 통과하면 실행이 성공합니다. 세 번의 실행에 대한 평균 소요 시간, 성공 횟수 및 생성률을 보고합니다. 에이전트와 사용자 동시 실행 테스트에서는 에이전트와 Speedometer를 함께 실행하여 각각 단독으로 실행할 때와 비교하여 속도가 얼마나 저하되는지 보고합니다.

| Codex CLI 코딩 에이전트 | 요가 9n 2-in-1 16 | 옴니북 울트라 16 (128GB) | 프로 9n 15 | Razer의 블레이드 16 |
|---|---|---|---|---|
| 티어 S, gpt-oss:20b 64K: 실제 소요 시간(초, 낮을수록 좋음) | 132.5 | 115.3 | 실행되지 않음 (12GB GPU 메모리) | 64.4 |
| S등급: 성공 (3건 중) | 2 | 3 | 실행되지 않음 (12GB GPU 메모리) | 2 |
| S등급: 생성률(tok/s) | 58.0 | 58.0 | 실행되지 않음 (12GB GPU 메모리) | 137.9 |
| 티어 M, gpt-oss:20b 128K: 실제 소요 시간(초, 낮을수록 좋음) | 실행되지 않음 (32GB GPU 메모리, M 등급 미만) | 152.1 | 실행되지 않음 (12GB GPU 메모리) | 실행 불가 (24GB VRAM, M 등급 미만) |
| 티어 M, gpt-oss:20b 128K: 성공 횟수(3회 중) | 실행되지 않음 (32GB GPU 메모리, M 등급 미만) | 3 | 실행되지 않음 (12GB GPU 메모리) | 실행 불가 (24GB VRAM, M 등급 미만) |
| 티어 M, Qwen3.6-35B-A3B 64K: 실제 소요 시간(초, 낮을수록 좋음) | 실행되지 않음 (32GB GPU 메모리, M 등급 미만) | 72.0 | 실행되지 않음 (12GB GPU 메모리) | 실행 불가 (24GB VRAM, M 등급 미만) |
| 티어 M, Qwen3.6-35B-A3B 64K: 성공 횟수(3회 중) | 실행되지 않음 (32GB GPU 메모리, M 등급 미만) | 3 | 실행되지 않음 (12GB GPU 메모리) | 실행 불가 (24GB VRAM, M 등급 미만) |
| 티어 M, Qwen3.6-35B-A3B 64K: 생성 속도(tok/s) | 실행되지 않음 (32GB GPU 메모리, M 등급 미만) | 89.5 | 실행되지 않음 (12GB GPU 메모리) | 실행 불가 (24GB VRAM, M 등급 미만) |
| 에이전트 옆에 있는 속도계 (점수) | 14.1 | 21.2 | 실행되지 않음 (12GB GPU 메모리) | 36.3 |
| 에이전트 옆의 속도계 감속(x, 낮을수록 좋음) | 2.44 | 1.73 | 실행되지 않음 (12GB GPU 메모리) | 1.06 |
| 에이전트 속도계 옆의 속도 저하(x, 낮을수록 좋음) | 1.03 | 1.04 | 실행되지 않음 (12GB GPU 메모리) | 1.05 |
S 등급 작업에서 Yoga는 OmniBook과 동일한 초당 58.0 토큰을 생성했으며, 완료 시간은 132.5초로 HP의 115.3초보다 느렸습니다. 세 번의 실행 중 두 번을 통과했는데, 이는 Blade 16과 동일한 결과입니다. gpt-oss:20b는 저희가 테스트한 여러 시스템에서 세 번 실행 중 한 번 정도 실패하므로, 성공 횟수는 하드웨어 성능보다는 모델의 특성을 더 잘 보여줍니다. Blade 16은 초당 137.9 토큰을 생성하며 64.4초 만에 완료했습니다.
Yoga에서 동시성 테스트가 가장 어려웠습니다. 에이전트가 실행 중일 때 Speedometer 점수는 36.1에서 14.1로 떨어져 2.44배 느려졌습니다. 이는 OmniBook의 1.73배, Blade 16의 1.06배와 비교되는 수치입니다. OmniBook과 Blade 16에서는 모델이 외장 GPU에서 실행되어 CPU에는 영향을 주지 않습니다. 에이전트 자체의 속도 저하는 3%에 불과했으므로, Yoga는 전력과 공유 메모리를 놓고 경쟁할 때 백그라운드 작업을 브라우저보다 우선시하는 것으로 보입니다.
검색 증강 생성
저희 RAG 테스트는 20,963개의 SQuAD v1.1 지문을 nomic-embed-text를 사용하여 임베딩하고, 2,000개의 질문 각각에 대해 상위 5개의 지문을 추출한 다음, 그중 400개에 대해 Phi-4-mini를 사용하여 참조 답변과 비교하여 정확한 일치도와 F1 점수를 계산합니다. 모델은 모든 시스템에서 실행되므로 이는 속도 비교입니다.

| RAG | 요가 9n 2-in-1 16 | 옴니북 울트라 16 (128GB) | 프로 9n 15 | Razer의 블레이드 16 |
|---|---|---|---|---|
| 섭취 시간, 20,963회 통과 (초, 낮을수록 좋음) | 188.8 | 187.0 | 191.8 | 131.0 |
| 검색 쿼리 시간, p50 (밀리초, 낮을수록 좋음) | 22.6 | 23.3 | 24.2 | 20.9 |
| 답변, Phi-4-mini 첫 번째 토큰까지의 시간, p50(s, 낮을수록 좋음) | 0.181 | 0.155 | 0.171 | 0.109 |
| 답변, 신속 처리(tok/s) | 5,837 | 7,142 | 6,268 | 11,560 |
| 답변, 생성률(tok/s) | 91.1 | 104.4 | 96.6 | 209.2 |
| 답변해야 할 질문, 50페이지 (s, 낮을수록 좋음) | 0.262 | 0.227 | 0.252 | 0.159 |
| 답변 F1 (%) | 73.97 | 73.97 | 74.27 | 74.47 |
Yoga는 입력 시간(188.8초 대 187.0초)과 검색 시간에서는 OmniBook과 유사했지만, 응답 속도에서는 뒤처졌습니다. Phi-4-mini는 초당 5,837개의 토큰을 처리했고(OmniBook은 7,142개), 응답 생성 속도는 91.1개(OmniBook은 104.4개)였습니다. 일반적인 질문의 경우, 질의부터 응답까지 0.262초가 걸렸는데, HP는 0.227초, Blade 16은 0.159초였습니다. 정확도는 Yoga와 OmniBook에서 동일했습니다.
CPU 성능
Yoga의 CPU 성능은 한 가지 규칙을 따릅니다. 단일 스레드에서는 OmniBook과 비슷한 성능을 보이지만, 모든 코어를 고려했을 때는 뒤처집니다. 단일 스레드 실행 결과는 HP OmniBook과 약 2% 이내의 차이를 보였으며, Yoga는 여기 있는 모든 RTX Spark 시스템 중에서 7-Zip 단일 스레드, PyPerformance go, regex_compile 테스트에서 가장 우수한 결과를 기록했습니다. 멀티 스레드 실행 결과는 2~28% 정도 뒤처지는데, 대부분 4~10% 정도의 차이를 보였고, Stockfish와 OpenBLAS에서 가장 큰 격차를 나타냈습니다. Razer Blade 16과 비교했을 때는 렌더링, 압축, 컴파일 성능에서 Yoga가 여전히 우위를 점합니다.
Cinebench 2026 및 지속 부하
Cinebench 2026은 Maxon의 Redshift 엔진을 사용하여 CPU에서 장면을 렌더링하고 싱글 코어, SMT 싱글 코어(하나의 물리적 코어에서 두 개의 스레드 실행), 멀티 코어 처리량을 측정합니다. 그런 다음 약 30분 동안 멀티 코어 실행을 반복하는 지속적인 루프를 수행하고 안정 상태를 첫 번째 실행 결과와 비교합니다.

| 시네벤치 2026 (점수, 높을수록 좋음) | 요가 9n 2-in-1 16 | 옴니북 울트라 16 (128GB) | 프로 9n 15 | Razer의 블레이드 16 |
|---|---|---|---|---|
| 단일 코어 | 557.0 | 558.6 | 518.2 | 480.0 |
| SMT 싱글 코어 | N/A | N/A | N/A | 661.3 |
| 멀티 코어 | 6,292 | 7,004 | 6,394 | 5,179 |
| 지속 루프, 첫 번째 패스 | 6,248 | 6,954 | 6,346 | 5,162 |
| 지속 루프, 정상 상태 | 6,256 | 6,942 | 6,416 | 5,206 |
| 정상 상태 / 첫 번째 통과 | 1.001 | 0.998 | 1.011 | 1.009 |
Yoga는 멀티코어 점수 6,292점을 기록했는데, 이는 OmniBook의 7,004점보다 10% 낮고, 18코어 Pro 9n보다 2% 낮으며, Blade 16보다 22% 높은 점수입니다. 싱글코어 점수는 557.0점으로 HP와 동일합니다. 지속 루프 테스트 결과는 가장 안정적이었는데, 6,256점의 안정 상태 점수는 첫 번째 패스의 100.1%를 유지했으며, CPU 온도는 72°C, 클럭 속도는 3,015MHz로 내내 유지되었습니다.
7-Zip, Blender, HandBrake 및 LLVM
7-Zip의 내장 벤치마크는 모든 스레드와 하나의 코어에서 LZMA 압축 및 압축 해제 처리량을 보고합니다. Blender 4.5는 CPU에서 Cycles를 사용하여 Monster, Junkshop 및 Classroom 장면을 렌더링합니다. HandBrake는 x265 및 SVT-AV1 코덱을 사용하여 4K60 클립 60초 분량을 소프트웨어로 인코딩하고, LLVM 테스트는 Clang과 Ninja를 사용하여 LLVM 21.1.4 전체 트리를 컴파일합니다.

| 7-Zip, 단일 스레드(GIPS, 수치가 높을수록 좋음) | 요가 9n 2-in-1 16 | 옴니북 울트라 16 (128GB) | 프로 9n 15 | Razer의 블레이드 16 |
|---|---|---|---|---|
| 금액 | 9.12 | 9.09 | 8.93 | 9.24 |
| 압축하다 | 7.35 | 7.31 | 7.26 | 7.28 |
| 압축 해제 | 10.88 | 10.87 | 10.59 | 11.20 |


7-Zip 테스트에서 Yoga는 모든 스레드에서 145.3 GIPS를 기록했는데, 이는 OmniBook보다 4% 낮고 Blade 16보다 15% 높은 수치입니다. 단일 스레드 성능은 9.12 GIPS로 RTX Spark 시스템 중 최고였습니다. Blender 테스트에서는 Monster와 Classroom 모두 HP보다 5% 뒤처졌고, LLVM 빌드 시간은 217.2초로 Blade 16의 206.6초보다 34% 빨랐습니다.
HandBrake의 x265 인코딩은 38.6fps로 실행되었으며, 이는 OmniBook보다 6% 낮은 수치입니다. SVT-AV1은 모든 RTX Spark 시스템에서 약 15fps를 기록한 반면, Blade 16에서는 77.3fps를 기록하여 SVT-AV1의 Arm64 코드 경로가 병목 현상의 원인임을 시사합니다.
Stockfish, primesieve, Python 및 브라우저
Stockfish는 체스 검색 속도를 초당 수백만 개의 노드로 보고합니다. primesieve는 모든 스레드에서 10^12 미만의 소수를, 하나의 스레드에서는 10^11 미만의 소수를 계산합니다. PyPerformance는 하나의 빠른 코어에 고정하여 세 가지 CPython 벤치마크를 실행하고, Speedometer 3.1은 Microsoft Edge에서 웹 애플리케이션의 응답성을 측정합니다. 마지막 두 줄은 Prism 에뮬레이션을 사용하여 7-Zip의 x64 버전을 실행합니다.
| Test | 요가 9n 2-in-1 16 | 옴니북 울트라 16 (128GB) | 프로 9n 15 | Razer의 블레이드 16 |
|---|---|---|---|---|
| 스톡피쉬 벤치, 모든 스레드(Mnps, 높을수록 좋음) | 13.42 | 16.28 | 15.20 | 17.96 |
| 스톡피쉬 벤치, 스레드 1개 (Mnps, 높을수록 좋음) | 1.72 | 1.73 | 1.70 | 2.04 |
| 소수체 1e12, 모든 스레드 (s, 값이 낮을수록 좋음) | 10.77 | 9.57 | 10.56 | 10.60 |
| 소수체 1e11, 스레드 1개 (s 값이 낮을수록 좋음) | 12.01 | 12.03 | 12.34 | 6.67 |
| PyPerformance go (ms, 낮을수록 좋음) | 110.6 | 111.2 | 114.1 | 75.2 |
| PyPerformance nbody (ms, 낮을수록 좋음) | 80.5 | 80.4 | 82.5 | 60.8 |
| PyPerformance regex_compile (ms, 낮을수록 좋음) | 84.3 | 84.6 | 86.7 | 69.7 |
| Speedometer 3.1, Edge (점수, 높을수록 좋음) | 36.1 | 36.7 | 33.9 | 38.4 |
| 에뮬레이션 환경에서 x64 7-Zip 실행, 모든 스레드 사용 (GIPS) | 124.3 | 127.0 | 117.6 | 해당 없음(네이티브 x64) |
| 에뮬레이션 환경에서 x64 7-Zip 실행, 단일 스레드(GIPS) | 8.25 | 8.26 | 7.94 | 해당 없음(네이티브 x64) |
Stockfish 벤치마크 결과는 클럭 속도 차이를 가장 명확하게 보여줍니다. 모든 스레드에서 Yoga는 13.42 Mnps를 기록하며 OmniBook과 18코어 Pro 9n의 15.20 Mnps보다 18% 뒤처졌습니다. 하지만 단일 스레드에서는 두 제품 모두와 동일한 약 1.7 Mnps를 기록했습니다. Stockfish 테스트에서 Yoga는 3,057MHz의 클럭 속도와 71°C의 온도를 유지했고, HP는 3,269MHz의 클럭 속도와 98°C를 기록했습니다. 따라서 Yoga는 클럭 속도가 약 6% 낮고 온도는 약 27°C 더 낮습니다.
단일 스레드 테스트에서는 RTX Spark 시스템 중 Yoga가 가장 빠른 PyPerformance 실행 시간(110.6ms)과 Speedometer 점수(36.1)를 기록하며 우위를 점했습니다. 하지만 Python, primesieve, Stockfish, 그리고 웹 브라우저 테스트에서는 Blade 16이 가장 빠른 성능을 보였으며, 단일 스레드 primesieve 테스트에서 6.67초를 기록한 반면 다른 시스템은 12.01초를 기록했습니다. 7-Zip의 x64 빌드는 에뮬레이션 환경에서 124.3 GIPS를 기록했는데, 이는 네이티브 성능의 86%에 해당합니다.
GROMACS, OpenBLAS 및 메모리
GROMACS는 16개 코어에서 benchMEM 분자 동역학 사례를 실행하고 최적의 레이아웃에 대한 하루 시뮬레이션 시간을 나노초 단위로 보고합니다. OpenBLAS 테스트는 모든 코어와 최상위 코어 클래스에서만 HPL 스타일의 배정밀도 LU 분해를 세 가지 문제 크기로 실행하고 DGEMM 행렬 곱셈을 수행하며, 이는 테스트 스위트에서 가장 높은 지속적인 부동 소수점 부하를 발생시킵니다. STREAM은 지속적인 메모리 대역폭을 측정하고, 지연 시간 행은 단일 액세스 메모리 지연 시간과 코어 간 지연 시간을 측정합니다.
| 테스트 결과 (높을수록 좋음) | 요가 9n 2-in-1 16 | 옴니북 울트라 16 (128GB) | 프로 9n 15 | Razer의 블레이드 16 |
|---|---|---|---|---|
| GROMACS benchMEM, 최적 레이아웃(ns/day) | 17.15 | 17.47 | 16.88 | 26.41 |
| OpenBLAS LU N=10000, 모든 코어(GFLOPS) | 281.3 | 324.0 | 303.4 | 400.9 |
| OpenBLAS LU N=20000, 모든 코어(GFLOPS) | 298.6 | 329.6 | 318.1 | 454.4 |
| OpenBLAS LU N=40000, 모든 코어(GFLOPS) | 282.5 | 348.8 | 실행되지 않음 (11.9GB 필요) | 498.5 |
| OpenBLAS LU N=20000, 최상위 코어 클래스(GFLOPS) | 273.2 | 380.5 | 403.8 | 240.4 |
| OpenBLAS DGEMM M=8000, 모든 코어(GFLOPS) | 312.7 | 398.5 | 357.6 | 455.4 |
| OpenBLAS DGEMM M=8000, 최상위 코어 클래스(GFLOPS) | 346.7 | 488.7 | 448.3 | 252.4 |
GROMACS 테스트에서는 Yoga가 17.15ns/day로 RTX Spark 시스템 간의 성능 차이가 미미했지만, OpenBLAS 테스트에서는 가장 큰 격차가 나타났습니다. Yoga는 모든 코어를 사용한 N=20000 LU 솔빙에서 298.6 GFLOPS를 기록하며 OmniBook보다 9% 뒤처졌고, DGEMM 테스트에서는 22%나 뒤쳐졌습니다. OmniBook이 우위를 점하는 최상위 코어만 사용한 테스트에서는 Yoga가 273.2 GFLOPS로 OmniBook의 380.5 GFLOPS에 비해 더욱 뒤처졌습니다. Yoga는 64GB 구성에서 충분한 메모리 용량을 갖춘 N=40000을 포함한 모든 규모의 테스트를 85°C를 넘지 않는 온도로 완료했습니다.

| Test | 요가 9n 2-in-1 16 | 옴니북 울트라 16 (128GB) | 프로 9n 15 | Razer의 블레이드 16 |
|---|---|---|---|---|
| 스트림 복사 속도(MB/s, 높을수록 좋음) | 118,738 | 130,790 | 127,682 | 43,731 |
| 스트림 트라이어드(MB/s, 높을수록 좋음) | 112,067 | 122,260 | 120,272 | 48,298 |
| 메모리 지연 시간, 1GiB 버퍼, 4KiB 페이지 (ns, 낮을수록 좋음) | 141.8 | 143.1 | 143.4 | 129.6 |
| 코어 간 지연 시간, 모든 쌍의 평균값(ns, 낮을수록 좋음) | 162.8 | 156.8 | 160.6 | 57.0 |
STREAM Triad는 Yoga에서 112,067MB/s를 기록했는데, 이는 OmniBook보다 8% 낮고 Blade 16보다 2.3배 높은 수치입니다. 따라서 Yoga의 낮은 클럭 속도가 메모리 서브시스템에도 영향을 미치는 것으로 보입니다. 메모리 지연 시간은 141.8ns로, 여기 있는 RTX Spark 시스템 중 가장 낮았으며, 코어 간 지연 시간은 162.8ns로 플랫폼 평균과 일치합니다.
게임 및 GPU 인코딩
SuperTuxKart 1.5는 내장 벤치마크를 1080p 전체 화면 해상도, 최고 설정, Vsync 끄기 조건에서 실행합니다. 한 번은 게임의 네이티브 Arm64 빌드에서, 다른 한 번은 에뮬레이션을 통해 실행되는 x64 빌드에서 실행합니다. FFmpeg는 동일한 4K60 클립을 NVENC HEVC 코덱을 사용하여 8Mbps로 인코딩하고, 가능한 경우 Media Foundation HEVC 인코더를 사용하여 인코딩합니다.

| 테스트 결과 (높을수록 좋음) | 요가 9n 2-in-1 16 | 옴니북 울트라 16 (128GB) | 프로 9n 15 | Razer의 블레이드 16 |
|---|---|---|---|---|
| SuperTuxKart 1080p 울트라 설정, 네이티브, 평균 (fps) | 216.4 | 225.9 | 218.4 | 200.0 |
| SuperTuxKart 1080p 울트라, 네이티브, 안정적인 (fps) | 131 | 143 | 140 | 115 |
| SuperTuxKart 1080p 울트라 설정, 64비트 에뮬레이션, 평균 프레임 속도(fps) | 186.8 | 266.5 | 248.6 | 해당 없음(네이티브 x64) |
| SuperTuxKart 1080p 울트라 설정, 에뮬레이션 모드(x64), 안정적인 프레임 속도(fps) | 93 | 141 | 94 | 해당 없음(네이티브 x64) |
| FFmpeg NVENC HEVC, 4K60, 8Mbps(fps) | 139 | 138 | 139 | 132 |
| FFmpeg 미디어 파운데이션 HEVC(fps) | 65 | 66 | 55 | N/A |
Yoga는 네이티브 빌드에서 평균 216.4fps를 기록했는데, 이는 OmniBook보다 4% 낮고 Pro 9n과는 1% 이내의 차이이며 Blade 16의 200.0fps보다 높은 수치입니다. 1080p 해상도에서는 모든 시스템에서 CPU가 프레임 속도를 결정하기 때문입니다. 한 가지 주목할 만한 결과는 Yoga의 x64 빌드를 에뮬레이션으로 실행했을 때 평균 186.8fps를 기록하여 네이티브 빌드보다 느렸다는 점입니다. 반면 OmniBook과 Pro 9n은 에뮬레이션 빌드를 더 빠르게 실행했으므로 이를 확인하기 위해 테스트를 다시 진행할 예정입니다. 하드웨어 인코딩 성능은 모든 기기에서 비슷했으며, Yoga는 NVENC HEVC에서 139fps를 기록했습니다.
열전달
Yoga는 우리가 테스트한 모든 RTX Spark 노트북보다 발열이 적었습니다. CPU 테스트에서 Yoga의 최고 온도는 Stockfish에서 71°C, HandBrake에서 86°C를 기록한 반면, OmniBook은 동일한 테스트에서 모두 98°C를 기록했습니다. 30분 동안 지속된 테스트에서 Yoga의 평균 온도는 70°C로 HP의 98°C보다 낮았습니다. RTX Spark 시스템은 Windows 열 영역을 통해서만 CPU 온도를 보고하는데, Yoga에서 사용하는 열 영역 센서가 HP에서 사용하는 센서와 다를 수 있지만, 클럭 속도와 전력 소모량을 보면 대부분의 온도 차이는 타당하다고 볼 수 있습니다.
| CPU 온도, 최대/평균 (섭씨) | 요가 9n 2-in-1 16 | 옴니북 울트라 16 (128GB) | 프로 9n 15 | Razer의 블레이드 16 |
|---|---|---|---|---|
| Cinebench 2026 | 72 / 65 | 98 / 83 | 92 / 70 | 96 / 78 |
| 7 - 우편 번호 | 76 / 62 | 98 / 78 | 83 / 63 | 99 / 84 |
| 건어 | 71 / 69 | 98 / 97 | 88 / 83 | 92 / 90 |
| 믹서기 | 80 / 75 | 98 / 96 | 91 / 80 | 95 / 87 |
| 수동 브레이크 | 86 / 71 | 98 / 86 | 93 / 74 | 92 / 86 |
| LLVM 빌드 | 81 / 75 | 98 / 92 | 87 / 79 | 98 / 93 |
| GROMACS | 84 / 81 | 98 / 96 | 89 / 85 | 97 / 94 |
| 오픈블라스 | 85 / 74 | 98 / 95 | 92 / 83 | 91 / 87 |
| STREAM | 64 / 59 | 98 / 96 | 78 / 66 | 75 / 71 |
| 슈퍼턱스카트 | 68 / 62 | 95 / 82 | 74 / 68 | 89 / 82 |
| MLPerf 클라이언트 | 72 / 60 | 93 / 84 | 76 / 66 | 97 / 76 |
| 코딩 에이전트 | 71 / 67 | 90 / 79 | 실행되지 않음 | 91 / 84 |
| RAG | 84 / 75 | 94 / 90 | 76 / 71 | 88 / 83 |
| 지속 루프 | 72 / 70 | 98 / 98 | 92 / 87 | 94 / 90 |
발열을 줄이기 위해 코어 클럭 속도를 낮췄습니다. 지속적인 루프 테스트에서 Yoga는 3,015MHz를 유지한 반면 OmniBook은 3,239MHz, Pro 9n은 3,288MHz를 기록했습니다. 이러한 클럭 속도 차이가 Yoga의 멀티스레드 성능 저하의 주요 원인입니다. 레노버는 Yoga의 소비 전력을 70W로 책정했는데, 이는 HP가 OmniBook에 제시한 수치와 동일합니다. 따라서 이러한 차이는 전력 소비 감소보다는 온도와 소음을 줄이기 위한 최적화 전략으로 보입니다.
Yoga는 성능 저하가 없습니다. 우리가 테스트한 모든 RTX Spark 시스템과 마찬가지로 부하가 지속되는 동안 클럭 속도를 일정하게 유지하며, 동일한 테스트에서 OmniBook이 도달하는 98°C보다 12~27°C 낮은 온도로 작동합니다.
| 평균 CPU 클럭 속도(MHz) | 요가 9n 2-in-1 16 | 옴니북 울트라 16 (128GB) | 프로 9n 15 | Razer의 블레이드 16 |
|---|---|---|---|---|
| Cinebench 2026 | 2,799 | 2,962 | 2,951 | 4,158 |
| 7 - 우편 번호 | 2,722 | 2,838 | 2,849 | 4,014 |
| 건어 | 3,057 | 3,269 | 3,292 | 3,645 |
| 믹서기 | 3,111 | 3,123 | 3,216 | 3,729 |
| 수동 브레이크 | 2,687 | 2,756 | 2,834 | 3,814 |
| LLVM 빌드 | 3,083 | 3,151 | 3,197 | 3,697 |
| GROMACS | 3,226 | 3,308 | 3,367 | 3,874 |
| 오픈블라스 | 2,890 | 3,024 | 3,192 | 4,274 |
| STREAM | 3,077 | 3,258 | 3,101 | 3,684 |
| 슈퍼턱스카트 | 2,002 | 1,957 | 2,017 | 4,349 |
| MLPerf 클라이언트 | 1,935 | 2,114 | 2,027 | 3,593 |
| 코딩 에이전트 | 1,945 | 2,078 | 실행되지 않음 | 3,789 |
| RAG | 2,707 | 2,749 | 2,760 | 3,764 |
| 지속 루프 | 3,015 | 3,239 | 3,288 | 3,726 |
노트북을 태블릿처럼 손에 들거나 무릎 위에 올려놓고 사용하는 경우가 많다는 점을 고려하면, 이러한 온도 조절은 합리적입니다. 30분 동안 렌더링 작업을 하는 동안 72°C를 유지하는 16인치 컨버터블 노트북과 98°C까지 온도가 올라가는 노트북은 사용 경험이 완전히 다릅니다. 렌더링 및 컴파일 성능에서 몇 퍼센트 정도의 차이만 발생할 뿐입니다. Yoga의 SSD는 스토리지 테스트에서 최고 67°C를 기록했습니다.
스토리지 성능
저희 스토리지 테스트는 fio의 네 모서리(fio.fio.next)를 사용하여 부팅 드라이브에 대해 5GB 및 25GB 용량으로 파일 시스템 및 원시 장치(raw device)를 모두 테스트하고, 25GB 테스트 결과를 여기에 보고합니다. 원시 장치 테스트는 NTFS 및 BitLocker를 거치지 않으므로 두 결과 간의 차이는 드라이브 성능이 Windows I/O 경로를 얼마나 견뎌내는지를 보여줍니다. Yoga와 Pro 9n에서는 BitLocker 보호 기능이 비활성화되었고, OmniBook에서는 활성화되었습니다.


| fio, 25GB 용량, QD32 | 요가 9n 2-in-1 16 | 옴니북 울트라 16 (128GB) | 프로 9n 15 | Razer의 블레이드 16 |
|---|---|---|---|---|
| 순차 읽기 128K, 파일 시스템(MB/s) | 6,874 | 13,833 | 7,024 | 7,125 |
| 순차 읽기 128K, 원시 장치(MB/s) | 6,975 | 12,479 | 7,165 | 7,134 |
| 순차 쓰기 속도 128K(MB/s) | 5,905 | 11,719 | 5,699 | 5,250 |
| 4K 랜덤 읽기, 파일 시스템, 최대 IOPS(초당 입출력 횟수) | 394,468 | 437,833 | 338,936 | 694,597 |
| 랜덤 읽기 4K, 원시 장치, 최대(IOPS) | 765,766 | 1,888,501 | 973,106 | 993,050 |
| 랜덤 쓰기 4K, 최대 (IOPS) | 68,923 | 228,354 | 192,000 | 648,446 |
| 원시/파일 시스템 임의 읽기 | SR 1.94x | SR 4.31x | SR 2.87x | SR 1.43x |
| 랜덤 읽기 4K, 4개 작업, p99 지연 시간(미국 기준, 낮을수록 좋음) | 522 | 643 | 578 | 444 |
| 랜덤 쓰기 4K, 4개 작업, p99 지연 시간(미국 기준, 낮을수록 좋음) | 12,255 | 586 | 758 | 371 |
| 구동 온도, 최대 (섭씨) | 67 | 52 | 78 | 60 |
레노버는 이 Yoga 모델에 PCIe Gen4 QLC M.2 2242 드라이브를 탑재했는데, 저희 테스트 차량에는 1TB Sandisk SN5100S가 장착되어 있습니다. 이 드라이브는 순차 읽기 속도 6,874MB/s, 순차 쓰기 속도 5,905MB/s를 기록했는데, 이는 Pro 9n 및 Blade 16에 탑재된 Gen4 드라이브와 비슷한 수준이며 OmniBook의 Gen5 드라이브의 절반 정도에 해당합니다. BitLocker 보호 기능을 해제한 상태에서 파일 시스템 무작위 읽기 속도는 394.5 IOPS로, 전체 용량 765.8 IOPS의 52%를 유지했는데, 이는 OmniBook보다 훨씬 적은 손실률입니다.
랜덤 쓰기 성능은 이 드라이브의 약점이며, SN5100S는 25GB 용량에서 4K 랜덤 쓰기 IOPS가 최대 68.9K에 그쳤습니다. 이는 Pro 9n의 192.0K의 약 3분의 1, Blade 16의 10분의 1 수준입니다. 또한, 4개 작업에서 p99 쓰기 지연 시간은 12.3ms로, 다른 시스템의 1ms 미만에 비해 저조했습니다. 5GB 용량에서는 동일한 테스트 결과가 반복마다 크게 변동하여 부분적인 테스트로 표시되었으므로 재실행 중입니다. QLC 드라이브는 일상적인 사용과 모델 로딩에는 충분하지만, 이 구성에서는 가장 먼저 교체해야 할 부품입니다.
맺음말
레노버 Yoga 9n 2-in-1 16은 저희가 테스트한 RTX Spark 노트북 중 가장 발열이 적은 제품이며, 유일한 컨버터블 노트북이기도 합니다. 레노버의 열 설계는 확장된 통풍구, 돌출된 방열판, 그리고 공기 흐름을 위한 공간을 확보한 힌지를 통해 모든 코어에 부하가 걸린 상태에서도 N1X의 온도를 71~86°C로 유지했습니다. 반면 HP OmniBook Ultra 16은 98°C까지 올라갔고, Yoga는 30분 동안 온도 저하 없이 안정적으로 작동했습니다. 2.8K OLED 디스플레이, 펜 입력이 가능한 Force Pad, 회전식 사운드바, 그리고 99.9Wh 배터리는 이 새로운 RTX Spark 제품군에서 가장 완벽한 크리에이티브 노트북으로 만들어줍니다.

이러한 편의성을 위해 지불한 비용은 최대 잠재력 대비 몇 퍼센트 낮은 성능입니다. Yoga의 모든 코어 클럭은 OmniBook보다 최대 약 220MHz 낮으며, 멀티 스레드 성능은 대부분의 테스트에서 4~10% 뒤처지고, Stockfish와 OpenBLAS에서는 더 큰 격차를 보입니다. 싱글 스레드 성능은 HP와 동일하지만, GPU 작업에서는 약 4~18% 뒤쳐집니다. 32GB GPU는 S 등급 모델은 최대 속도로 구동하지만 M 등급 모델은 그렇지 못하며, QLC SSD는 그룹 내에서 가장 낮은 랜덤 쓰기 성능을 보였습니다.
다른 모든 Spark 제품과 마찬가지로 플랫폼 관련 주의 사항이 여기에도 적용됩니다. Windows on Arm I/O 경로, x64 빌드보다 뒤처지는 SVT-AV1과 같은 Arm64 포트, 그리고 코딩 에이전트 실행 중 브라우저 속도를 2.44배 저하시키는 공유 메모리 버스 등이 그 예입니다. 이러한 제품들이 출시됨에 따라 소프트웨어 생태계가 빠르게 발전할 것으로 기대합니다.
펜, 태블릿 모드, OLED 디스플레이는 물론 로컬 AI와 20코어 CPU까지 원하는 크리에이터에게 Yoga 9n 2-in-1은 RTX Spark 플랫폼의 성능을 거의 그대로 유지하면서도 발열은 훨씬 적습니다. 하지만 모든 코어의 처리량 중 상위 10% 또는 M 등급 모델을 우선시하는 구매자라면 128GB 버전을 고려하는 것이 좋습니다.

순위표: 레노버 Yoga 9n 2-in-1 16은 로컬 AI에 가장 적합한 노트북 순위표에서 가장 발열이 적은 RTX Spark 노트북으로 선정되었습니다.



 아마존