

NVIDIA는 데이터 센터 시장에서 CPU를 GPU에 데이터를 공급하는 보조 칩 정도로만 여겼습니다. 첫 번째 서버 프로세서인 Grace도 이러한 기조를 따랐습니다. Grace는 Arm의 Neoverse V2 코어를 그대로 사용했으며, 주로 Grace Hopper와 Grace Blackwell 슈퍼칩의 CPU 부분으로 출시되었습니다. 하지만 이 슈퍼칩들은 NVIDIA 플랫폼에 중요한 한 가지 요소를 도입했습니다. 바로 NVLink-C2C입니다. NVLink-C2C는 CPU와 GPU가 PCIe보다 훨씬 높은 대역폭으로 서로의 메모리에 일관성 있게 접근할 수 있도록 해주는 기술입니다.
후속 제품인 Vera는 훨씬 더 야심찬 제품입니다. NVIDIA의 맞춤형 Arm 코어인 Olympus를 기반으로 완전히 새롭게 설계되었습니다. Olympus는 Armv9.2를 구현하며, 각 Vera CPU는 88개의 코어와 176개의 스레드를 갖추고 있습니다. 새로운 코어와 더불어 메모리 서브시스템 또한 주목할 만한 특징입니다. 각 CPU는 SOCAMM 모듈에서 최대 1.5TB의 LPDDR5X를 지원하며, 소켓당 최대 대역폭은 1.2TB/s로 알려져 있습니다. 이를 통해 Vera는 모바일급 DRAM의 전력 효율성을 유지하면서도 메모리를 현장에서 교체할 수 있습니다. 테스트 서버의 두 소켓에서 측정한 결과 최대 대역폭은 2.4TB/s에 달했으며, STREAM Triad에서 2,073GB/s를 기록했습니다.
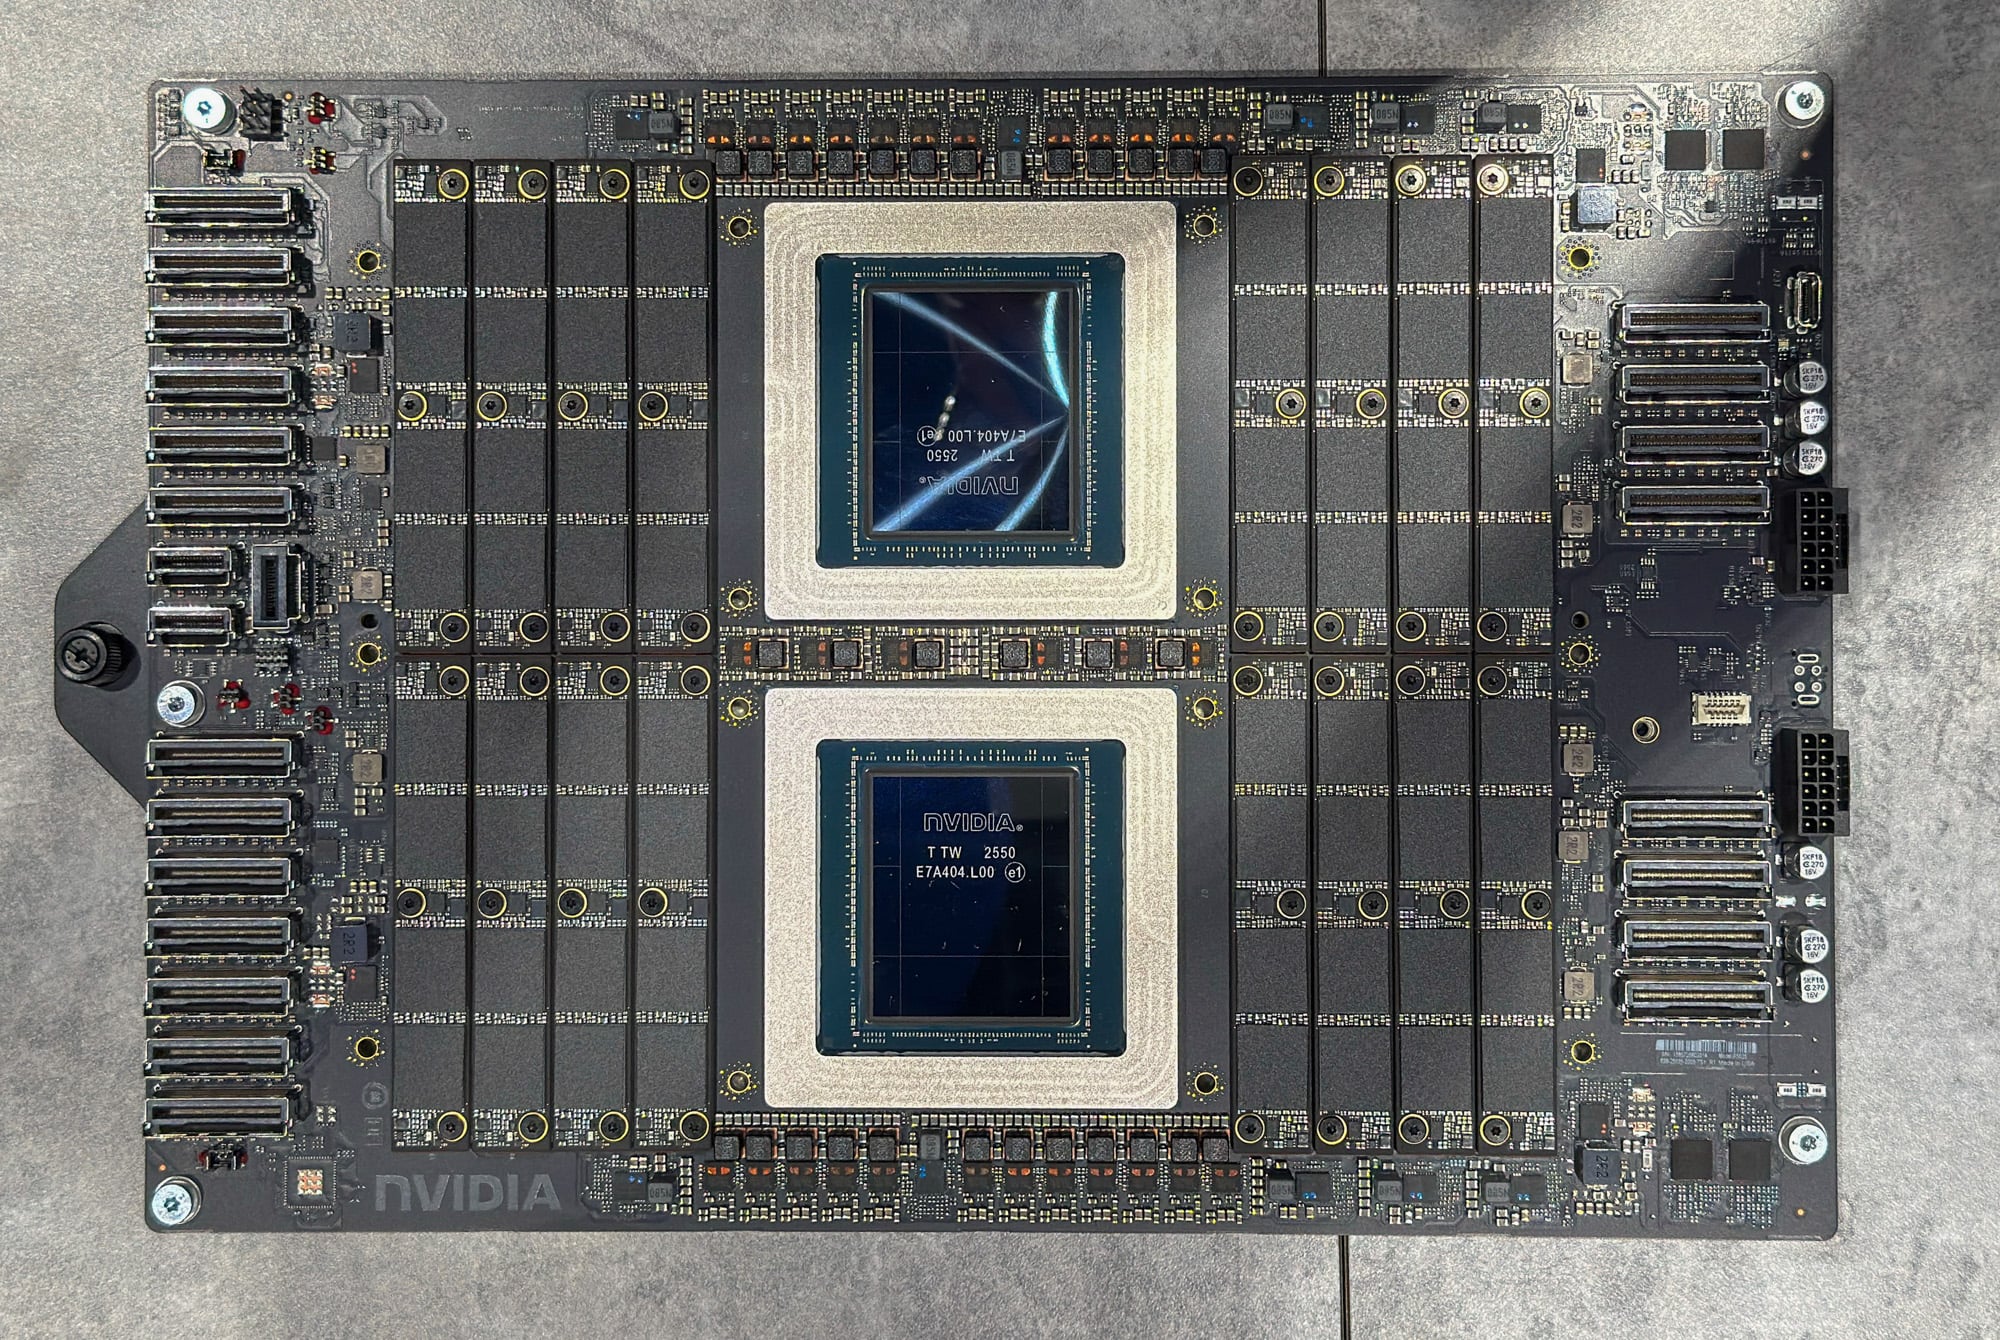
그러한 야심은 Vera의 적용 분야에까지 확장됩니다. Vera는 여전히 Vera Rubin 시스템의 슈퍼칩의 일부로 제공되지만, NVIDIA는 이를 BlueField-4 STX 스토리지 플랫폼과 에이전트 샌드박스용 독립형 CPU 서버로도 확장했습니다. Vera는 OEM, 하이퍼스케일러, NCP(네트워크 서비스 제공업체)로부터도 폭넓은 지원을 받고 있습니다. Dell, HPE, Supermicro는 자사 제품 라인업에 Vera 서버를 추가했으며, 하이퍼스케일러와 NCP는 Vera를 주류 제품으로 만들 준비를 하고 있습니다. 이러한 광범위한 공급은 중요한 의미를 지닙니다. 왜냐하면, 우리의 결과에서 보여주듯이 Vera는 x86 경쟁 제품들과 강력한 경쟁 상대이며, 기업들이 공급망을 다변화하는 데 도움이 되는 제3의 CPU 공급업체를 제공하기 때문입니다.
주요 요점
- x86 시스템마다 메모리 대역폭이 두 배 이상 증가합니다. Vera 소켓 두 개는 STREAM Triad에서 2TB/s 이상의 속도를 유지했는데, 이는 우리가 테스트한 최고의 DDR5 서버보다 2.3배 빠른 속도입니다. NVLink-C2C를 통해 다른 소켓의 메모리를 읽을 때조차도 Vera 코어는 로컬 메모리에서 얻는 어떤 x86 소켓보다 더 많은 대역폭을 활용했으며, hugepages를 사용한 로컬 지연 시간은 EPYC 9175F보다 13% 낮았습니다.
- 광범위한 중견 시장을 겨냥한 균형 잡힌 칩입니다. 3.4GHz 올림푸스 코어 하나는 5.0GHz EPYC 9175F보다 7-Zip 압축 속도가 12% 더 빨랐으며, 세 가지 단일 스레드 Python 테스트 중 두 가지에서 EPYC 9175F를 능가했습니다. 최대 부하 시, Vera는 절반도 안 되는 코어 수로 EPYC 9965의 7-Zip 처리량의 63%~72%에 도달했으며, 단일 스레드 성능에서는 AMD의 코어별 특화 제품과, 전체 시스템 처리량에서는 AMD의 특화 제품과 거의 비슷한 성능을 보였습니다.
- 벡터 및 암호화 작업은 명백한 약점입니다. 6개의 128비트 SVE2 파이프는 512비트 AVX-512 코드 처리 속도에 미치지 못합니다. 동일한 16개 코어 환경에서 Vera는 GROMACS benchMEM을 EPYC 9175F의 절반, EPYC 9965의 3분의 2 속도로 실행했으며, 단일 코어에서 AES-256-GCM 암호화를 실행하는 데에는 9175F 속도의 약 3분의 1 정도의 속도를 보였습니다. 전체 시스템에서는 384코어 EPYC 9965가 GROMACS benchPEP와 AES 모두에서 약 3배 빠른 성능을 나타냈습니다.
- 메모리 제약형 HPC는 대역폭을 속도로 전환합니다. 대규모 OpenFOAM 메쉬에서 Vera는 384코어 EPYC 9965보다 1.44배, 240코어 Xeon 6978P보다 1.20배 빠른 성능을 보였습니다. 더 작은 메쉬에서는 x86 L3 캐시의 용량이 성능에 더 큰 영향을 미치는데, Vera는 9965와 12% 이내의 차이로 2위를 기록했습니다.
- 데이터베이스와 분석 분야는 이미 경쟁이 치열합니다. HammerDB TPROC-C 단일 소켓 테스트에서 Vera의 88개 코어는 PostgreSQL에서 192개 코어의 EPYC 9965 소켓보다 26%, MariaDB에서 8% 더 빠른 성능을 보였습니다. 반면 MySQL에서는 19%, VillageSQL에서는 15% 뒤처졌습니다. Xeon 6787P는 다섯 가지 엔진 모두에서 Vera에 뒤쳐졌습니다. 또한 Vera는 ClickBench 핫런을 EPYC 9965보다 23% 더 빠른 시간에 완료했으며, 256GB Valkey 작업 세트에서 34% 더 많은 요청을 처리했습니다.
기술 사양
| 스펙 | NVIDIA Vera CPU |
|---|---|
| 컴퓨팅 및 전력 | |
| 핵심 | NVIDIA Olympus, Armv9.2 (SVE2 및 FP8 지원) |
| 소켓당 코어 및 스레드 수 | 88코어, 176스레드(NVIDIA 공간 멀티스레딩) |
| 클럭 속도(측정값) | 3.41GHz |
| TDP | 250W~450W 구성 가능 |
| 냉각 | 공기 또는 액체 |
| 캐시 | |
| L1 명령어 | 코어당 64KB |
| L1 데이터 | 코어당 96KB, 6방향 |
| L2 | 코어당 2MB, 비공개 |
| 시스템 레벨 캐시(L3) | 소켓당 164MB, Arm MPAM 파티셔닝 |
| 구조 | 2세대 확장형 일관성 패브릭, 3.4TB/s 이분법 |
| 메모리 | |
| 타입 | 소켓당 8개의 SOCAMM2 모듈에 LPDDR5X가 탑재되어 있습니다. |
| 컨트롤러 | 8개의 128비트(총 1,024비트) |
| 속도 | 최대 9,600MT/s |
| 대역폭 | 소켓당 최대 1.2TB/s (제조사 기준) |
| 생산 능력 | 소켓당 256GB ~ 1.5TB |
| I / O | |
| PCIe | Gen6, 소켓당 88레인(CPU 전용 플랫폼) x16, x8, x4, x2 분기 |
| CXL | 3.1. 유형 3 메모리 확장 및 풀링 |
| NV링크-C2C | 2세대, 1.8TB/s 양방향, 일관성 있는, 인증된 암호화 |
| 보안 | |
| 기밀 컴퓨팅 | Arm CCA 영역, RME-DA 및 RME-CDA, TDISP, VM별 키 |
엔비디아가 CPU 사업에 진출하려는 이유는 무엇일까요?
Vera가 NVIDIA에 왜 중요한지 이해하려면 회사의 성장 과정을 살펴보아야 합니다. NVIDIA는 GPU를 중심으로 데이터 센터 입지를 구축한 후, GPU를 구동하는 데 필요한 인프라로 확장했습니다. 하드웨어 측면에서는 2020년 Mellanox 인수를 통해 서버를 연결하고 서버 간 데이터를 전송하는 네트워킹 기술을 확보했습니다. 소프트웨어 측면에서는 CUDA, DOCA 및 광범위한 소프트웨어 스택을 통해 하드웨어 프로그래밍 및 운영 방식에 대한 NVIDIA의 영향력을 확대했습니다. 이러한 요소들이 결합되어 NVIDIA는 가속 컴퓨팅 플랫폼의 상당 부분을 장악하게 되었습니다.
하지만 플랫폼에는 여전히 범용 CPU가 필요했습니다. 운영 체제를 실행하고, 데이터를 준비하고, 애플리케이션을 관리하고, 가속기로 전송되는 작업을 조율할 무언가가 필요했습니다. NVIDIA가 사업을 확장하는 동안 인텔과 AMD가 그 역할을 상당 부분 담당했습니다. 이로 인해 NVIDIA는 곤란한 입장에 놓였습니다. GPU, 네트워크, 그리고 대부분의 소프트웨어를 공급할 수 있었지만, 서버의 핵심인 프로세서는 여전히 다른 회사의 제품에 의존해야 했기 때문입니다.
Grace는 이러한 상황을 바꾸기 위한 첫 번째 중요한 발걸음이었습니다. Arm Neoverse V2 코어를 기반으로 구축된 Grace는 NVIDIA에게 데이터 센터용 CPU를 제공하고 NVLink-C2C를 통해 해당 CPU와 GPU를 더욱 긴밀하게 연결할 수 있는 방법을 제시했습니다. 그러나 Grace는 성능 격차를 해소해야 할 필요성을 남겼습니다. 메모리 대역폭과 효율성 덕분에 AI 호스트 CPU로서 경쟁력을 갖추었지만, 대부분의 다른 워크로드에서는 선두 x86 프로세서가 여전히 상당한 우위를 점했습니다. 이러한 불균형적인 성능은 Grace를 EPYC 또는 Xeon 서버를 대체할 범용 프로세서로 선택하는 데 있어 제약 요인이 되었습니다.
Vera는 Grace의 Neoverse V2 코어를 NVIDIA의 맞춤형 Olympus 설계로 교체하고 메모리 대역폭과 용량을 대폭 향상시켜 이러한 격차를 상당 부분 해소했습니다. NVIDIA는 GPU, DPU 및 네트워킹과 함께 경쟁력 있는 CPU를 제공함으로써 서버당 지출에서 더 큰 점유율을 확보할 수 있습니다. 또한 이를 통해 회사는 자사 생태계와 구성 요소의 상호 작용 방식을 더욱 효과적으로 제어할 수 있습니다. CPU 코어, 메모리 서브시스템, 인터커넥트 및 GPU를 동일한 요구 사항에 맞춰 설계할 수 있기 때문입니다. 최대 1.8TB/s의 속도를 제공하는 Vera의 CPU-GPU 코히런트 링크는 이러한 통합의 구체적인 예입니다.
각 시스템의 지출 비중을 늘리는 것은 전체적인 그림의 일부일 뿐입니다. 강화 학습(RL)과 에이전트형 AI는 NVIDIA가 독립형 CPU 시스템을 제공해야 하는 또 다른 이유를 제공합니다. 에이전트는 단순히 응답을 생성하는 것 이상의 작업을 수행합니다. 도구를 호출하고, 정보를 검색하고, 코드를 실행하고, 결과를 확인한 후 다음 작업을 결정합니다. 이러한 실행의 대부분은 CPU에서 이루어지며, 다음 모델 단계가 CPU 작업 결과에 의존하는 경우 실행 속도가 느리면 전체 시퀀스가 지연됩니다. 따라서 코어별 성능, 메모리 지연 시간, 부하 시 예측 가능한 동작은 에이전트의 응답성에 중요한 요소가 됩니다.
올림푸스 코어
이러한 요구 사항은 Vera의 88개 Olympus 코어 설계와 밀접하게 연관되어 있으며, 이 코어들은 소켓 전체가 사용 중일 때에도 각 코어에서 강력한 성능을 유지하는 것을 최우선 과제로 삼고 있습니다. Olympus는 NVIDIA가 구현한 Armv9.2 명령어 세트로, Grace에 사용된 Neoverse V2 코어를 대체합니다. 이러한 차이점은 중요합니다. Arm은 프로세서가 실행하는 명령어를 정의하는 반면, NVIDIA는 이러한 명령어를 가져오고, 스케줄링하고, 실행하는 메커니즘을 설계했습니다. 이러한 제어를 통해 NVIDIA는 여러 작업을 동시에 실행하면서 개별 작업을 빠르게 완료하는 것을 목표로 코어를 최적화할 수 있습니다.
그 목표의 첫 번째 단계는 IPC(클럭 사이클당 명령어 처리량)입니다. IPC는 코어가 클럭 사이클당 평균적으로 완료하는 명령어 수를 나타냅니다. 클럭 속도는 이러한 사이클이 발생하는 빈도를 결정하고, 마이크로아키텍처는 사이클 내에 처리할 수 있는 유용한 작업량을 결정합니다. NVIDIA는 이전 세대 대비 IPC가 1.5배 향상되었다고 주장합니다. 우리가 관찰한 최고 클럭 속도는 3.41GHz였지만, Vera의 아키텍처는 사이클당 더 많은 작업을 처리하고 부하 상태에서도 그 속도를 유지하는 데 중점을 둡니다. 컴파일러, 인터프리터 또는 데이터베이스 작업과 같이 일련의 종속적인 단계를 거쳐야 하는 작업의 경우, 단순히 코어 수를 늘리는 것만으로는 해당 작업 순서를 더 빠르게 완료할 수 없기 때문에 이러한 아키텍처의 핵심적인 특징입니다.
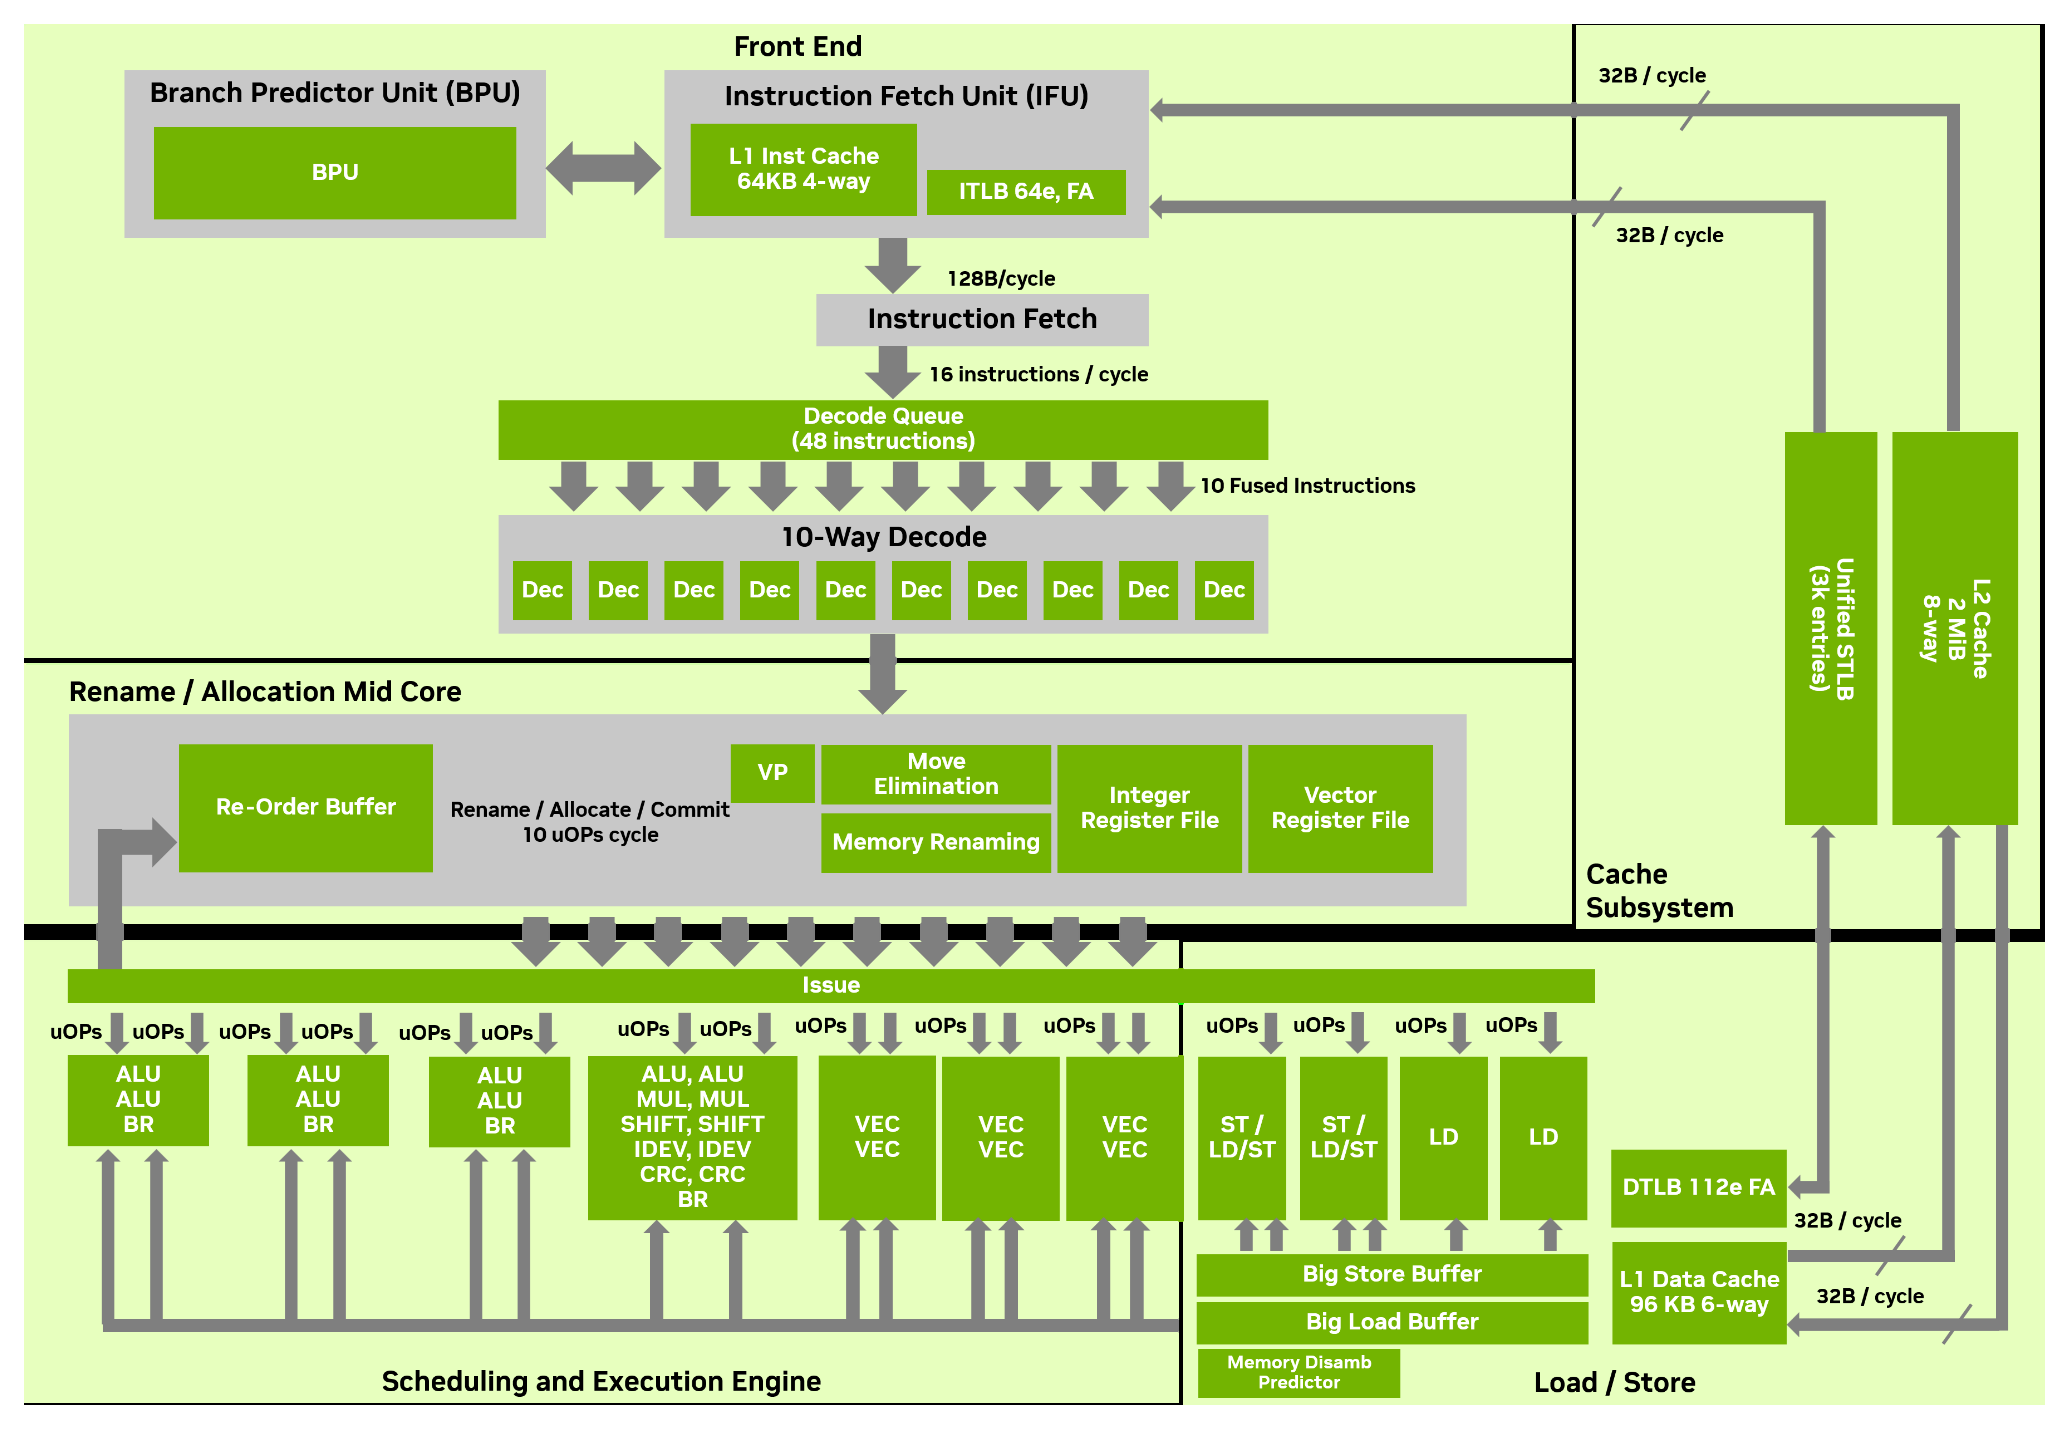
IPC(Instruction Per Cycle)를 달성하려면 유용한 명령어를 꾸준히 공급하는 것이 중요합니다. 올림푸스의 프런트 엔드, 즉 프로그램 명령어를 가져와 디코딩하는 코어 부분은 사이클당 최대 10개의 명령어를 디코딩할 수 있습니다. 하지만 이 용량은 명령어가 지속적으로 공급될 때만 의미가 있는데, 소프트웨어가 코드 경로 간에 자주 분기할 경우 이러한 공급이 원활하지 못하게 됩니다. 따라서 올림푸스는 신경망 기반 분기 예측기와 다른 특수 예측기를 결합하여 사이클당 최대 두 개의 분기를 지원합니다. 더 나은 예측은 코어가 필요한 명령어를 가져오는 데 도움이 되므로 잘못된 경로를 실행하거나 오류 발생 후 재시작하는 데 소요되는 시간을 줄여줍니다.
명령어를 불러와 디코딩한 후, 올림푸스는 순서에 상관없이 실행하여 앞선 명령어가 대기하는 동안 진행할 수 있는 작업을 찾아냅니다. 예를 들어, 한 연산이 메모리를 기다리는 동안 독립적인 계산이 그보다 먼저 실행될 수 있습니다. 큰 명령어 윈도우는 프로세서가 이러한 독립적인 작업을 찾을 수 있는 더 많은 기회를 제공합니다.
그럼에도 불구하고, 위에서 설명한 종속적인 일련의 작업처럼 각 단계가 이전 단계의 결과를 필요로 하는 경우에는 이러한 접근 방식이 적합하지 않습니다. 이러한 경우를 위해 올림푸스는 종속적인 작업이 예측된 값으로 시작하도록 하고, 실제 결과가 나오면 해당 값을 확인하는 값 예측 기능을 사용합니다. 정확한 예측은 이러한 종속성 체인에서 발생하는 대기 시간을 줄일 수 있지만, 잘못된 예측은 예측 작업을 수정하고 다시 계산해야 하므로 시간이 더 오래 걸립니다.
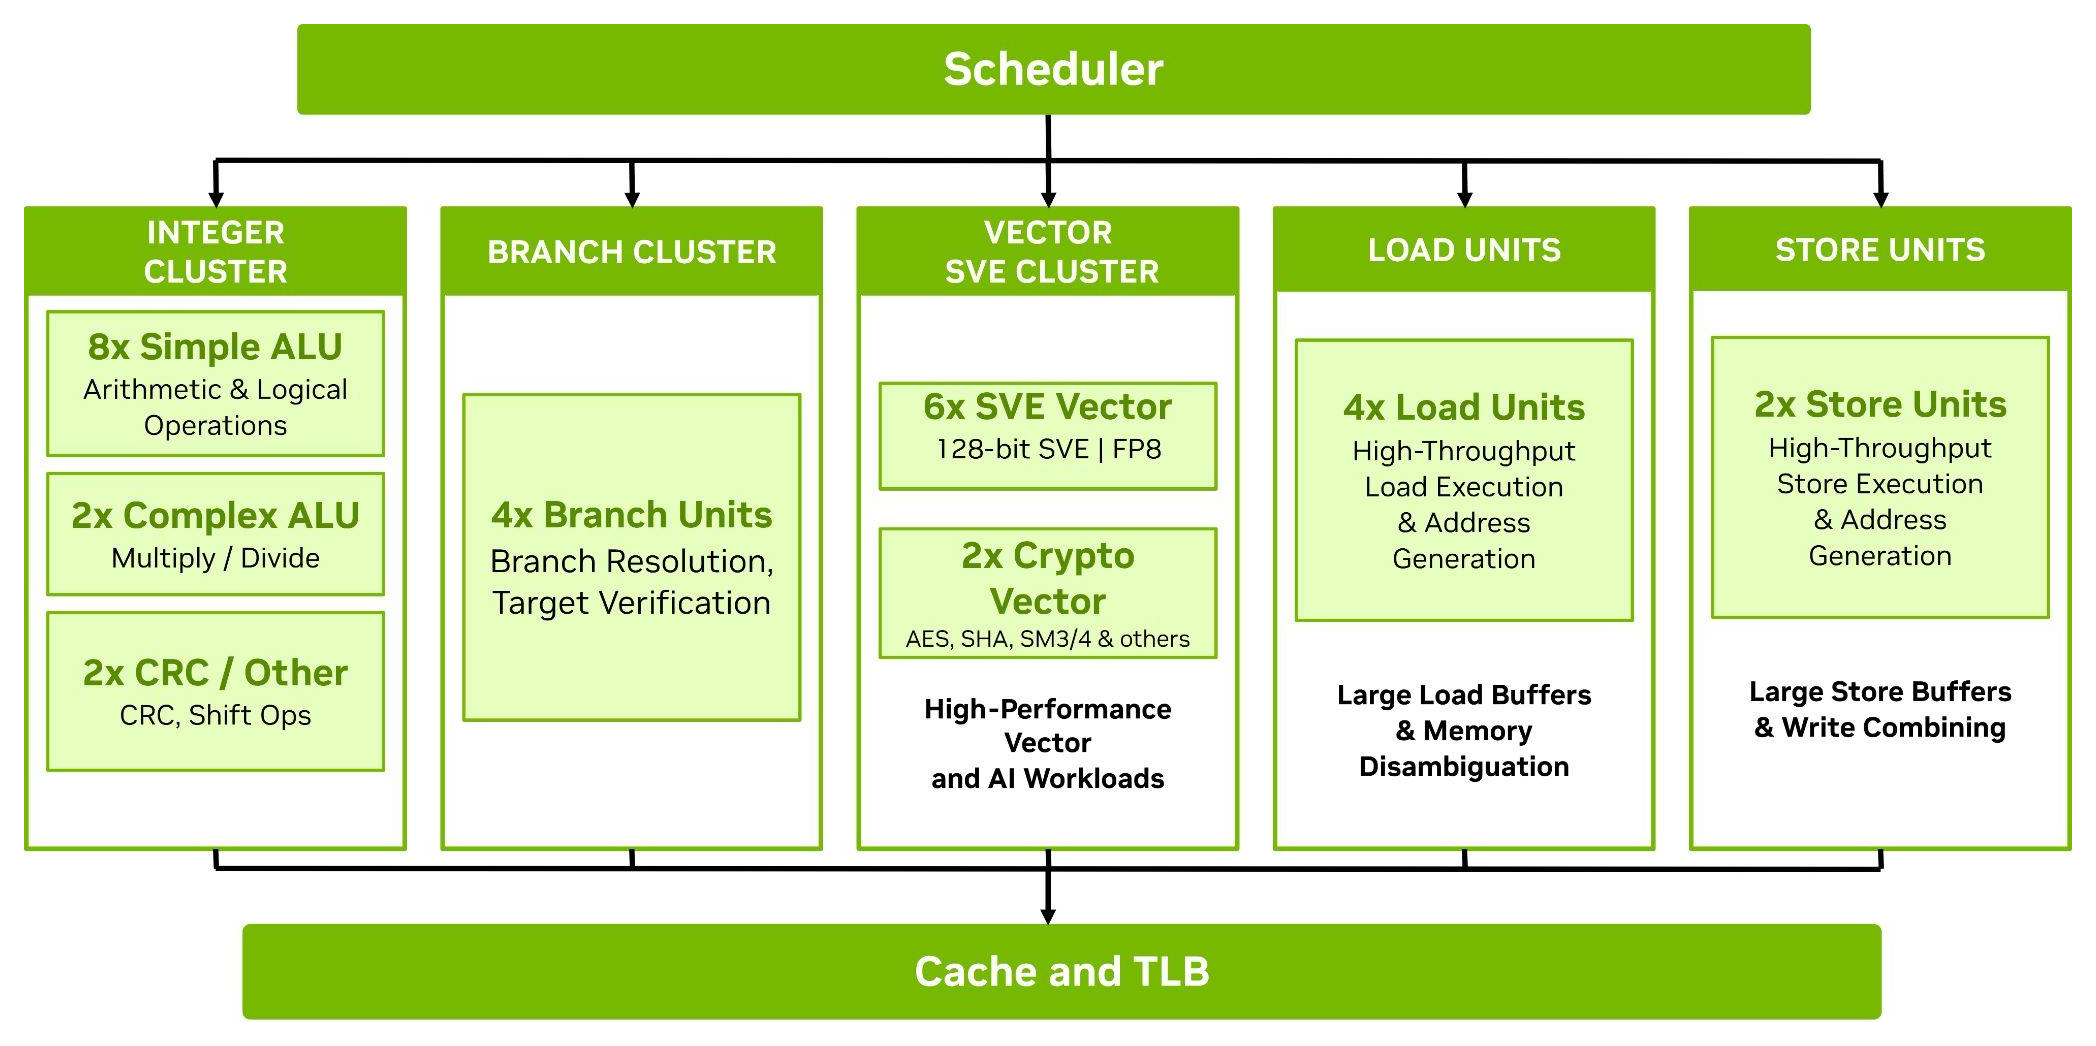
실행 엔진은 이러한 명령어 공급을 완성된 작업으로 변환할 수 있는 충분한 용량을 필요로 합니다. 올림푸스는 광범위한 정수 실행 리소스와 전용 분기 장치, 4개의 로드 파이프라인, 2개의 스토어 파이프라인을 결합했습니다. 이러한 리소스는 각기 다른 요구 사항을 충족합니다. 정수 장치는 산술, 비교 및 논리 연산을 처리하고, 분기 장치는 제어 흐름을 결정하며, 로드/스토어 파이프라인은 코어와 캐시 간에 데이터를 이동시킵니다. 이러한 균형은 매우 중요합니다. 왜냐하면 명령어가 실행 또는 메모리 병목 현상으로 인해 단순히 정체된다면 더 넓은 디코더를 사용하더라도 큰 이점을 얻을 수 없기 때문입니다.
올림푸스는 이러한 스칼라 리소스 외에도 SVE2를 지원하는 6개의 128비트 벡터 파이프라인을 갖추고 있으며, 2개의 파이프라인에서는 FP8 지원 및 암호화 기능을 제공합니다. 벡터 명령어는 여러 데이터 요소에 연산을 적용하므로 수치 계산, 압축 및 데이터 처리에 유용합니다.
이 부분은 올림푸스가 분명한 절충안을 제시하는 영역 중 하나입니다. 올림푸스의 128비트 벡터 폭은 경쟁사의 x86 프로세서에서 AVX-512를 통해 사용할 수 있는 512비트 폭보다 작습니다. 이러한 차이는 최적화된 수치 연산 커널과 토크나이저에 중요한 영향을 미치지만, 애플리케이션 성능은 특정 명령어의 처리량, 생성된 코드, 그리고 데이터 공급량에도 좌우됩니다. 따라서 GROMACS와 같은 과학 응용 프로그램은 설계의 강점을 시험하는 또 다른 영역으로 남을 것입니다.
스칼라든 벡터든 이러한 실행 리소스는 모두 데이터가 제때 도착하는 것에 의존하므로 자주 사용되는 데이터를 실행 엔진 가까이에 두는 것이 매우 중요합니다. 각 코어에는 64KB의 명령어 캐시, 96KB의 데이터 캐시, 그리고 2MB의 전용 L2 캐시가 있습니다. 작은 1차 캐시는 가장 즉시 사용 가능한 명령어와 데이터에 빠르게 접근할 수 있도록 해주고, 더 큰 L2 캐시는 프로세서를 통해 더 멀리 이동하기 전에 코어의 작업 세트를 더 많이 유지합니다. 모든 코어에 상당한 크기의 전용 L2 캐시를 제공하는 것은 동일한 코어별 목표를 달성하는 데 도움이 됩니다. 즉, 더 많은 작업을 로컬에서 처리하여 공유 캐시와 메인 메모리에 대한 부담을 줄일 수 있습니다.
프리페칭은 명령어가 요청하기 전에 데이터를 미리 가져와 캐시를 보완합니다. 올림푸스는 일반적인 접근 패턴을 위한 프리페처 외에도 A[B[i]]와 같이 하나의 조회 결과가 다른 조회 결과의 인덱스를 제공하는 간접 접근을 위한 그래프 프리페처를 제공합니다. 이러한 관계를 학습한 후, 하드웨어는 프로그램이 요구하기 전에 두 번째 데이터를 가져오기 시작할 수 있습니다. 이는 그래프 처리 및 기타 불규칙적인 워크로드에서 흔히 발생하는 문제, 즉 프로세서의 실행 용량은 충분하지만 다음 데이터를 찾는 데 시간이 걸리는 문제를 해결하는 데 도움이 됩니다.
올림푸스의 마지막 부분은 목표의 나머지 절반, 즉 여러 작업을 동시에 실행하는 데 초점을 맞춥니다. 각 코어는 두 개의 하드웨어 스레드를 지원하여 Vera는 소켓당 176개의 스레드를 사용할 수 있습니다. NVIDIA는 이 방식을 공간 멀티스레딩(Spatial Multithreading)이라고 부릅니다. 코어는 리소스를 하나의 활성 스레드에 집중하거나 두 개의 활성 스레드에 분산할 수 있으므로, 하나의 명령어 스트림에 실행 용량을 집중할지 아니면 더 많은 동시 작업을 지원할지 선택할 수 있습니다.
NVIDIA의 목표는 두 스레드 간의 간섭을 줄여 두 스레드가 모두 바쁠 때 성능을 더욱 예측 가능하게 만드는 것입니다. 이는 부하가 걸린 상태에서 에이전트 워크로드가 의존하는 예측 가능성과 동일합니다. 두 스레드는 여전히 물리적 코어와 더 넓은 메모리 시스템을 공유하므로 리소스를 분할한다고 해서 애플리케이션 지연 시간이 고정되는 것은 아닙니다.
패브릭, 메모리 및 I/O
개별 코어 외에도 88개의 코어를 효율적으로 활용하려면 DRAM에 대한 빠른 연결 이상의 것이 필요합니다. 코어들은 데이터를 교환하고, 공유 캐시에 접근하며, 연결된 장치와 통신해야 합니다. Vera는 NVIDIA의 2세대 확장형 일관성 패브릭(Scalable Coherency Fabric)을 통해 이러한 리소스들을 연결합니다. 이 패브릭은 내부 메시 구조로, 공유 데이터의 캐시된 복사본의 일관성도 유지합니다. 코어, 패브릭, 그리고 164MB 시스템 레벨 캐시는 하나의 컴퓨팅 다이에 탑재되며, 메모리 컨트롤러와 I/O는 인접한 칩렛에 위치합니다. NVIDIA는 이 패브릭의 대역폭을 3.4TB/s로 평가하는데, 이는 메인 메모리 대역폭과는 별개로 메시 전체의 트래픽 용량을 측정하는 지표입니다.
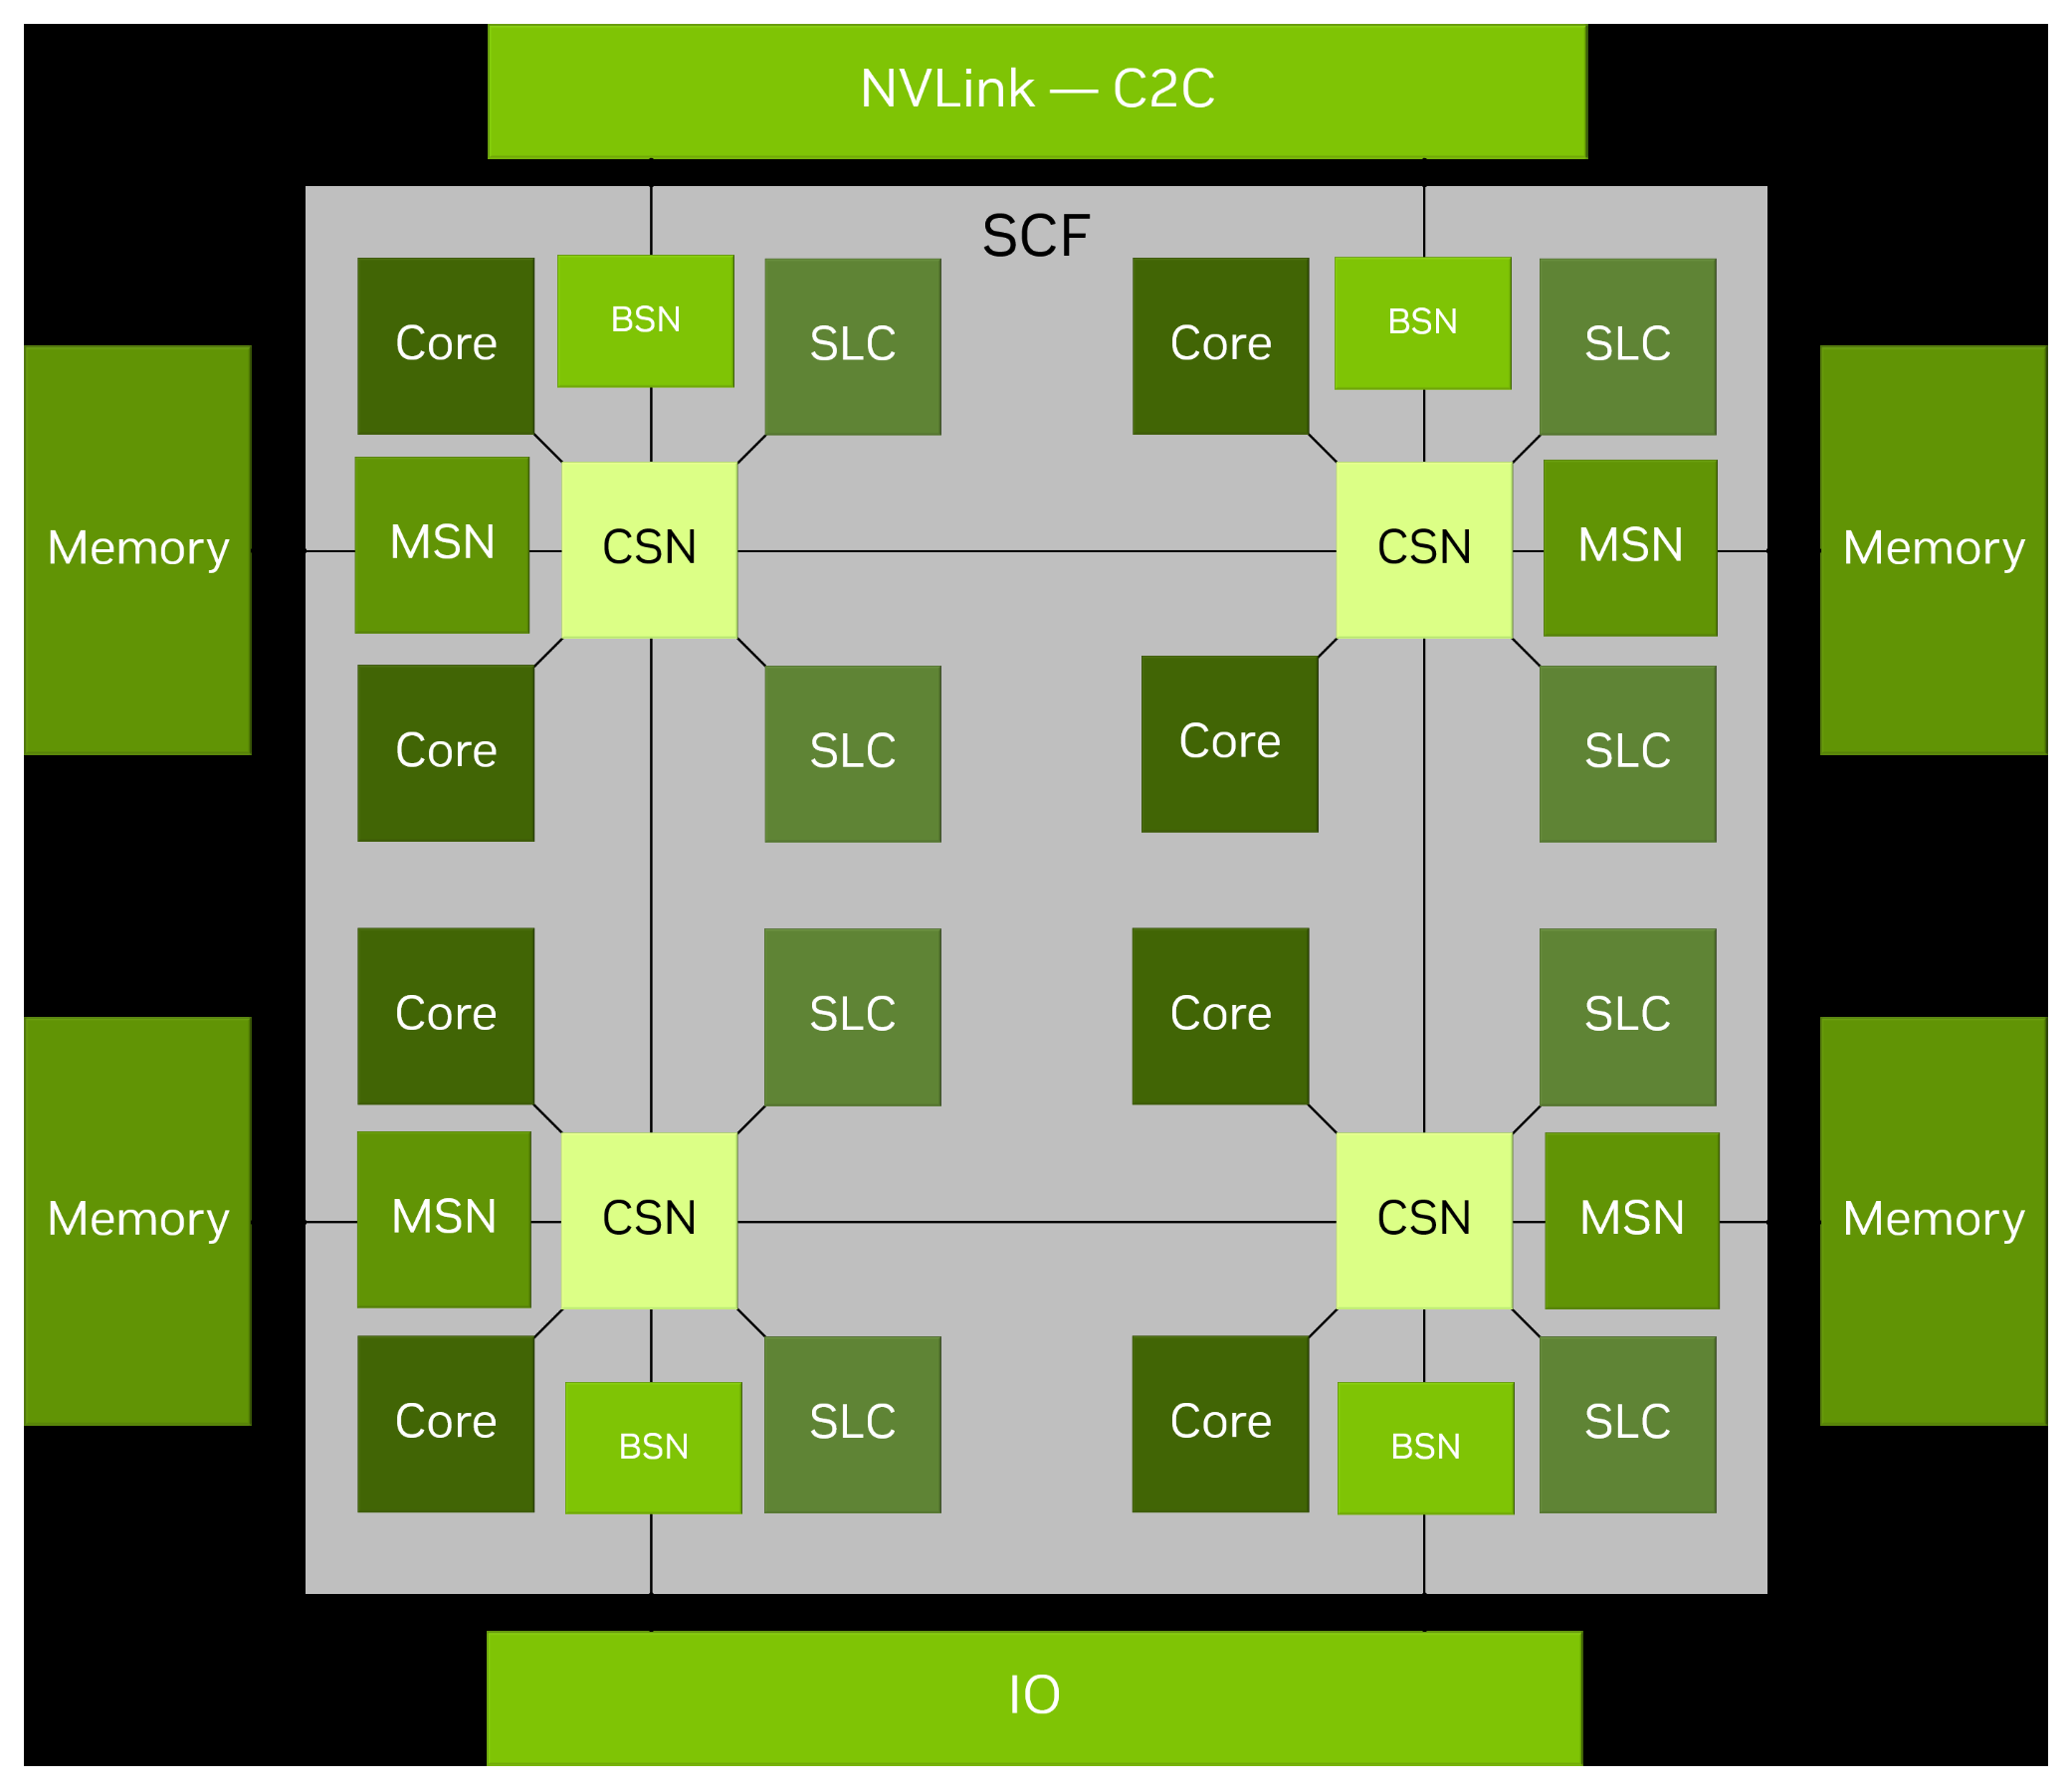
단일 칩 레이아웃 덕분에 코어 간 통신이나 공유 캐시 접근 시 별도의 컴퓨팅 칩 간 데이터 전송이 필요 없습니다. 소프트웨어 측면에서 Vera는 소켓당 하나의 NUMA 노드를 제공합니다. 운영 체제는 각 소켓을 하나의 코어 그룹과 로컬에 연결된 메모리로 인식합니다. 이는 소켓 내 배치를 간소화하지만, 메시 네트워크 내 모든 경로의 지연 시간이 동일하다는 것을 의미하지는 않습니다. 2소켓 서버는 여전히 2개의 NUMA 노드를 가지며, 다른 소켓의 메모리에 접근하는 것과 로컬 메모리에 접근하는 것은 서로 다른 방식으로 처리됩니다.
각 소켓 내에는 앞서 설명한 개인 L2 캐시보다 한 단계 위에 공유 시스템 레벨 캐시(L3)가 있습니다. 이를 통해 코어는 DRAM에 접근하지 않고도 데이터를 재사용할 수 있으며, 소켓 전체에서 공유 용량을 사용할 수 있습니다. 164MB는 상당한 용량이지만, 일부 경쟁 프로세서는 훨씬 더 큰 L3 캐시를 제공합니다. 이는 반복적으로 접근하는 작업 세트가 코어의 L2 캐시에 비해 너무 크지만 더 큰 공유 캐시에 저장될 수 있는 경우에 중요합니다. 데이터가 메모리에서 가져와야 할 때는 높은 DRAM 대역폭이 도움이 되지만, 애초에 메모리 접근을 피하는 것의 이점은 사라지지 않습니다.
해당 용량이 공유되기 때문에 Vera는 Arm MPAM도 지원하여 시스템 소프트웨어가 공유 캐시 용량을 분할하고 워크로드 간 메모리 대역폭 할당을 관리할 수 있도록 합니다.
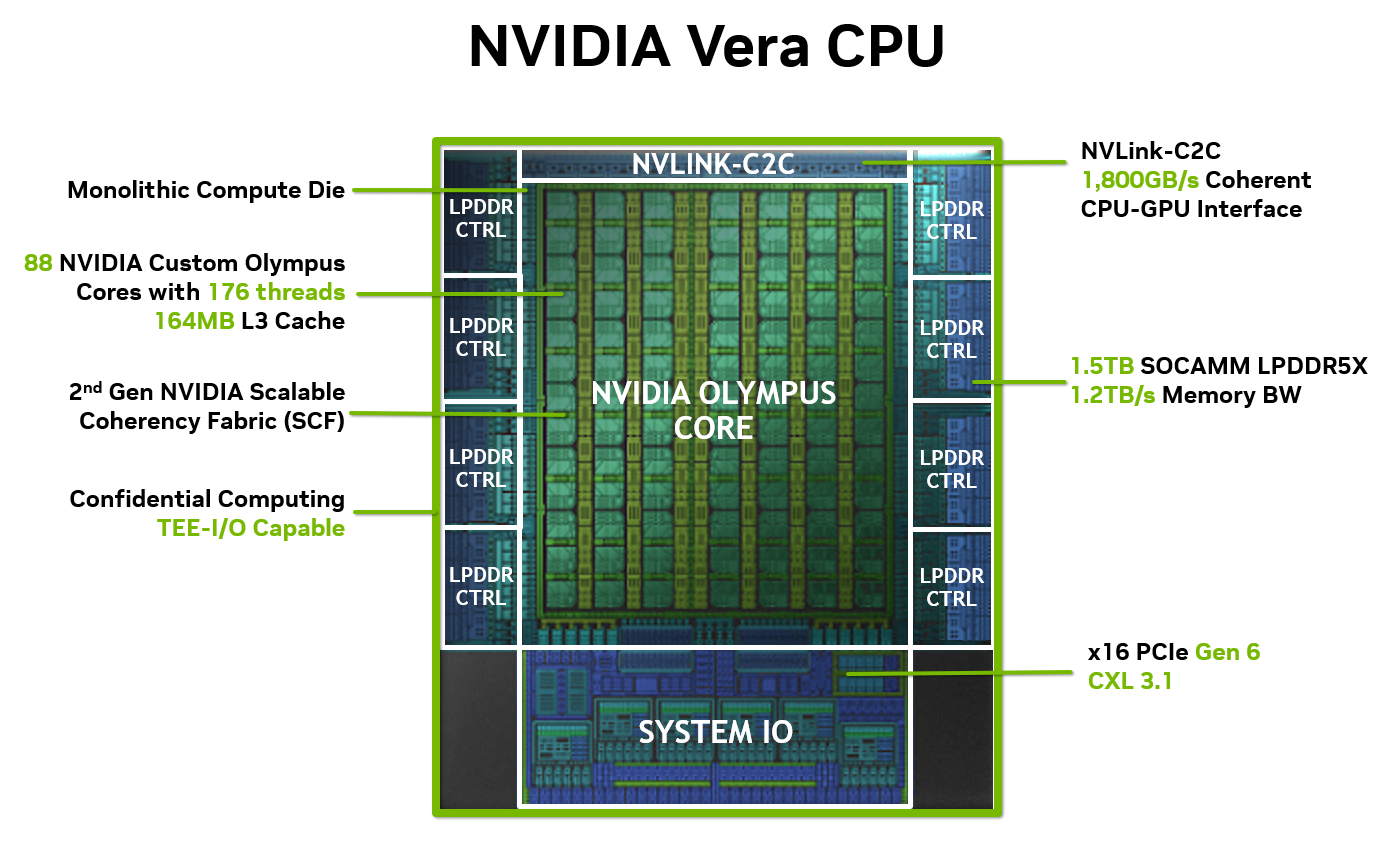
메인 메모리에 접근할 때, Vera는 상당한 대역폭을 활용할 수 있습니다. 8개의 128비트 LPDDR5X 컨트롤러는 1,024비트 통합 인터페이스를 제공하며, 소켓당 최대 9,600MT/s의 속도로 작동하여 정격 1.2TB/s의 처리량을 제공합니다. 메모리는 탈착식 SOCAMM2 모듈 8개에 탑재되어 LPDDR5X와 현장 교체 가능 모듈을 결합했습니다. 이를 통해 Vera는 메모리를 납땜할 필요 없이 광범위하고 빠른 메모리 인터페이스를 사용할 수 있습니다.
하지만 단순히 대역폭만 보는 것은 전체적인 상황을 파악하는 데 도움이 되지 않습니다. 더 중요한 관계는 대역폭과 이를 공유하는 코어 수 사이의 관계입니다. 정격 대역폭 1.2TB/s를 88개의 코어로 나누면 물리적 코어당 약 13.6GB/s가 됩니다. 이는 프로세서의 대역폭 분배 균형을 나타내는 지표일 뿐, 각 스레드에 할당된 대역폭이나 보장된 대역폭을 의미하는 것은 아닙니다. 메모리 대역폭을 그에 맞춰 늘리지 않고 코어 수를 늘리면 이 비율은 감소합니다.
측정된 스트림 대역폭을 물리적 코어 수로 나누면 Vera에서는 코어당 11.8GB/s가 나오는 반면, 240코어 Xeon 6978P 시스템에서는 3.8GB/s에 불과합니다. 이는 Vera가 컴퓨팅 리소스 대비 상당한 메모리 처리량을 제공한다는 구체적인 사례입니다.
전력 효율성 또한 이러한 설계 선택의 중요한 부분입니다. NVIDIA는 용량에 따라 LPDDR5X 메모리 서브시스템을 완전히 구성했을 때 약 30W에서 40W 정도의 전력을 소비할 것으로 예상합니다. LPDDR5X의 장점은 이러한 대역폭을 제공하면서도 서버 전체 전력 소비에 미치는 영향을 최소화하여 시스템의 전력 및 냉각 예산을 연산 작업에 더 많이 활용할 수 있도록 한다는 점입니다.
대역폭과 효율성만으로는 데이터 용량을 정확히 알 수 없으며, 용량은 별개의 고려 사항입니다. NVIDIA는 소켓당 최대 1.5TB의 LPDDR5X 메모리를 직접 연결하거나, 두 개의 소켓을 통해 최대 3TB까지 지원한다고 명시하고 있습니다. 작업 세트를 메모리에 상주시켜야 하는 워크로드의 경우, 전송 속도가 아무리 빨라도 용량 부족을 보완할 수는 없습니다.
직접 연결된 용량이 부족한 경우, Vera의 I/O는 추가 용량 확보 경로와 장치 연결을 제공합니다. 독립형 CPU 플랫폼은 네트워킹, 스토리지 및 가속기를 위해 소켓당 88개의 PCIe Gen6 레인을 제공하며, Vera Rubin 구성은 96개의 레인을 제공합니다. 메모리 측면에서는 CXL 3.1 지원에 Type 3 메모리 장치와 메모리 풀링이 포함되어 SOCAMM2 모듈 용량을 넘어 확장할 수 있습니다. 확장된 메모리는 직접 연결된 LPDDR5X와는 다른 액세스 경로를 사용하므로 성능은 별도로 평가해야 합니다.
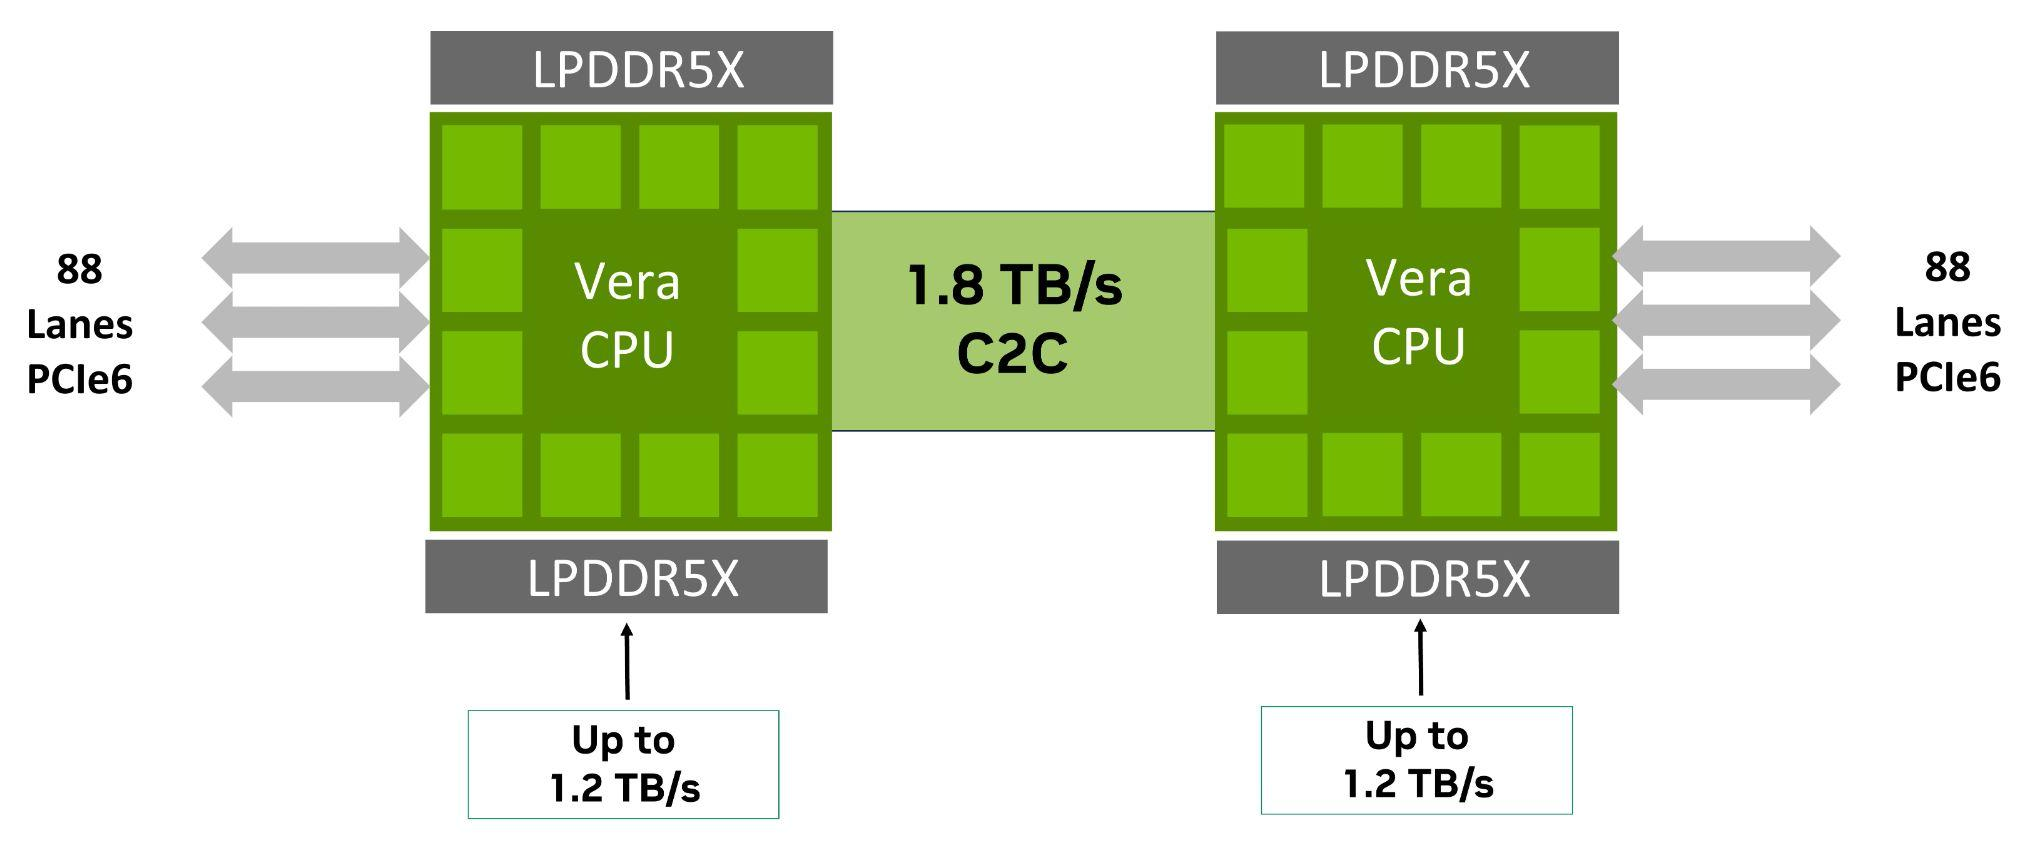
마지막으로, 프로세서 간 통신을 위해 Vera는 Grace 슈퍼칩에 처음 도입된 링크의 후속 기술인 2세대 NVLink-C2C를 사용합니다. 이 링크는 듀얼 소켓 서버에서 두 개의 Vera CPU를 연결하거나 슈퍼칩에서 Vera와 Rubin GPU를 연결합니다. 이 링크는 최대 1.8TB/s의 양방향 대역폭(각 방향으로 900GB/s)을 제공하며, NVIDIA가 CPU 사업에 진출하게 된 핵심 동기인 긴밀한 CPU-GPU 통합을 반영합니다.
MGX Vera C2 레퍼런스 서버 내부
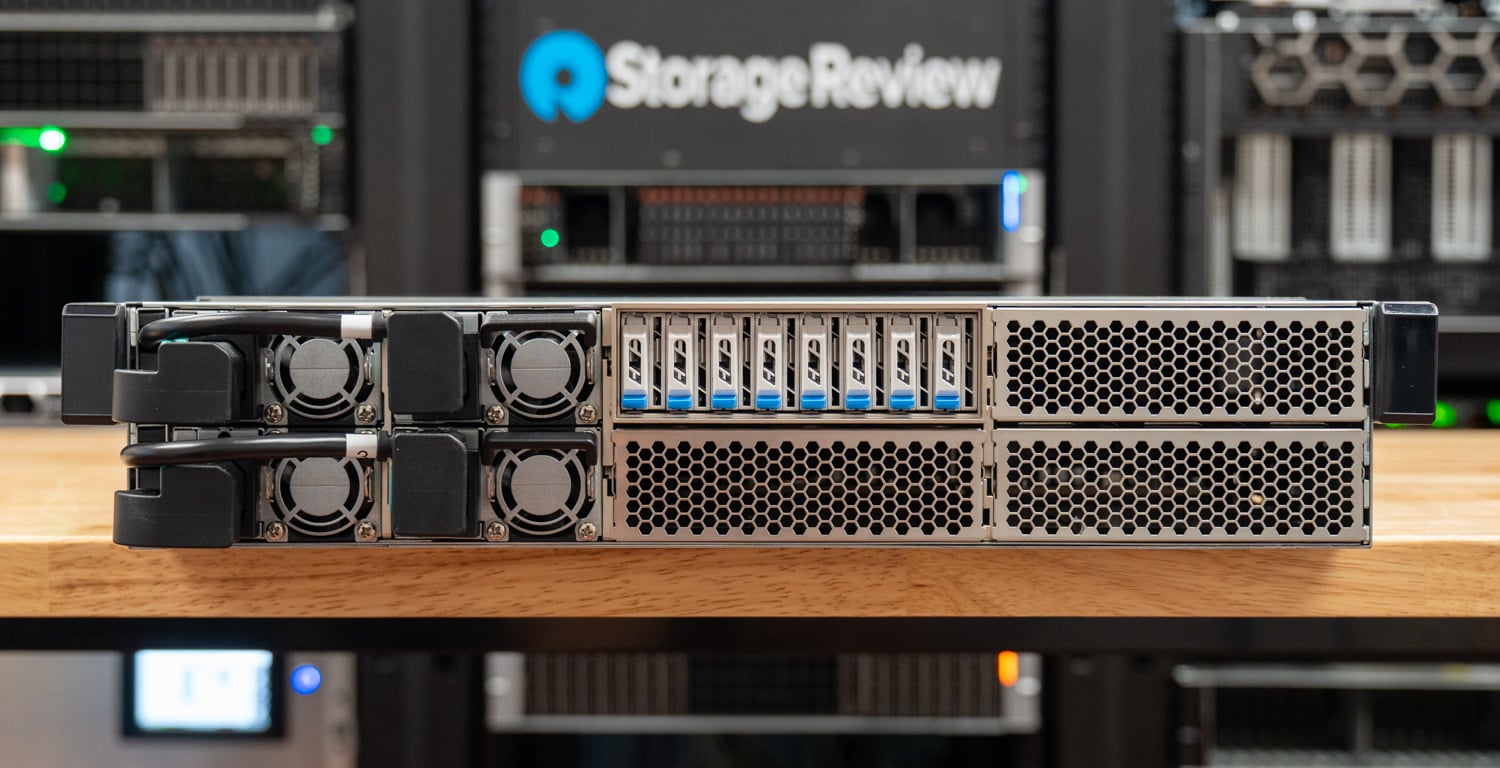
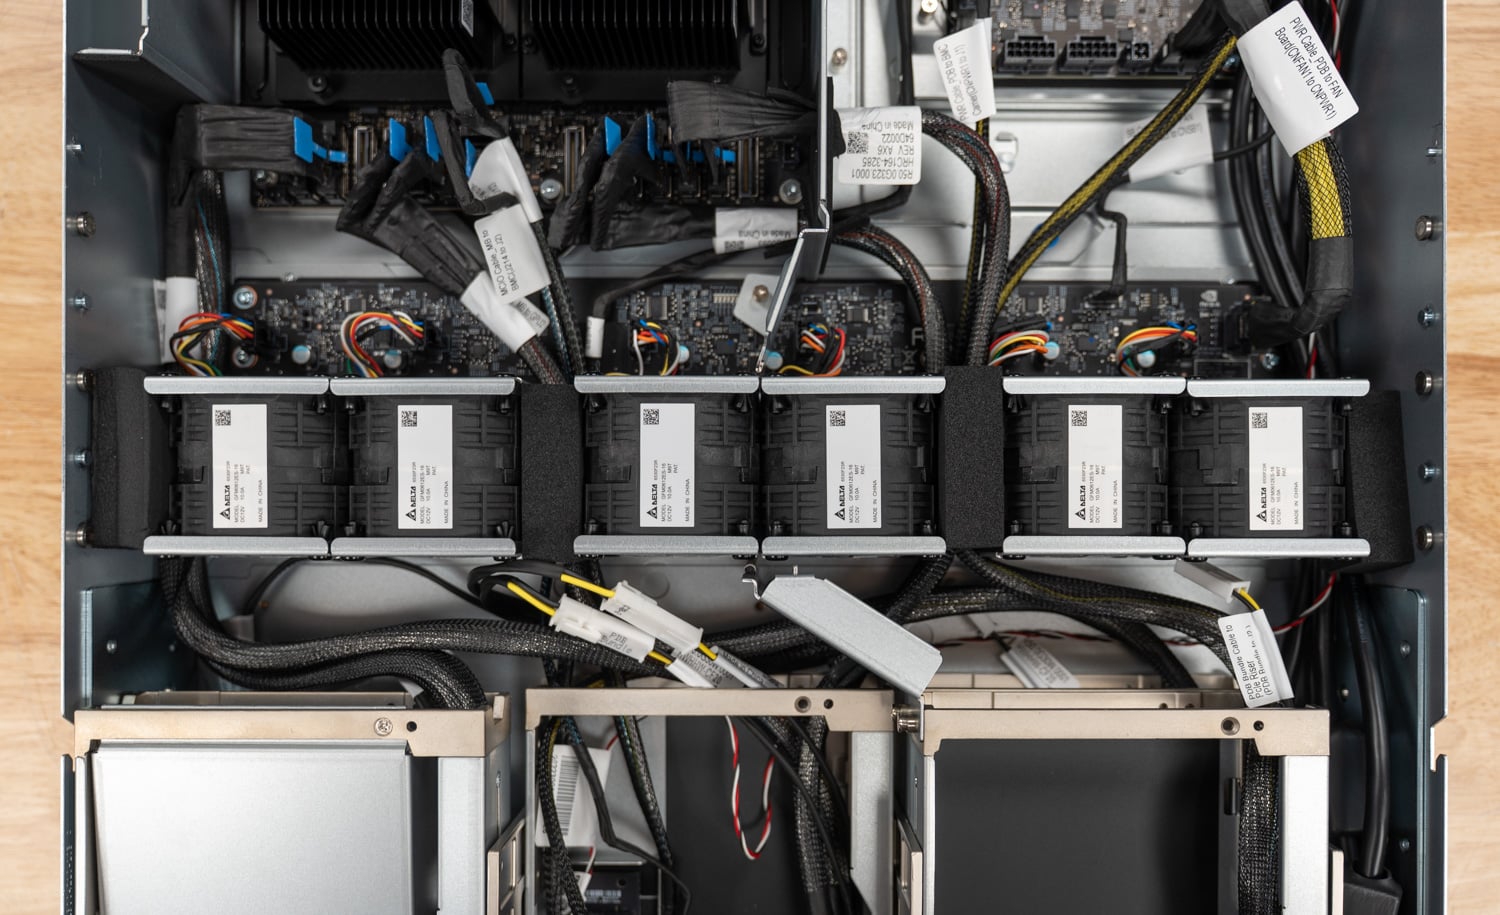
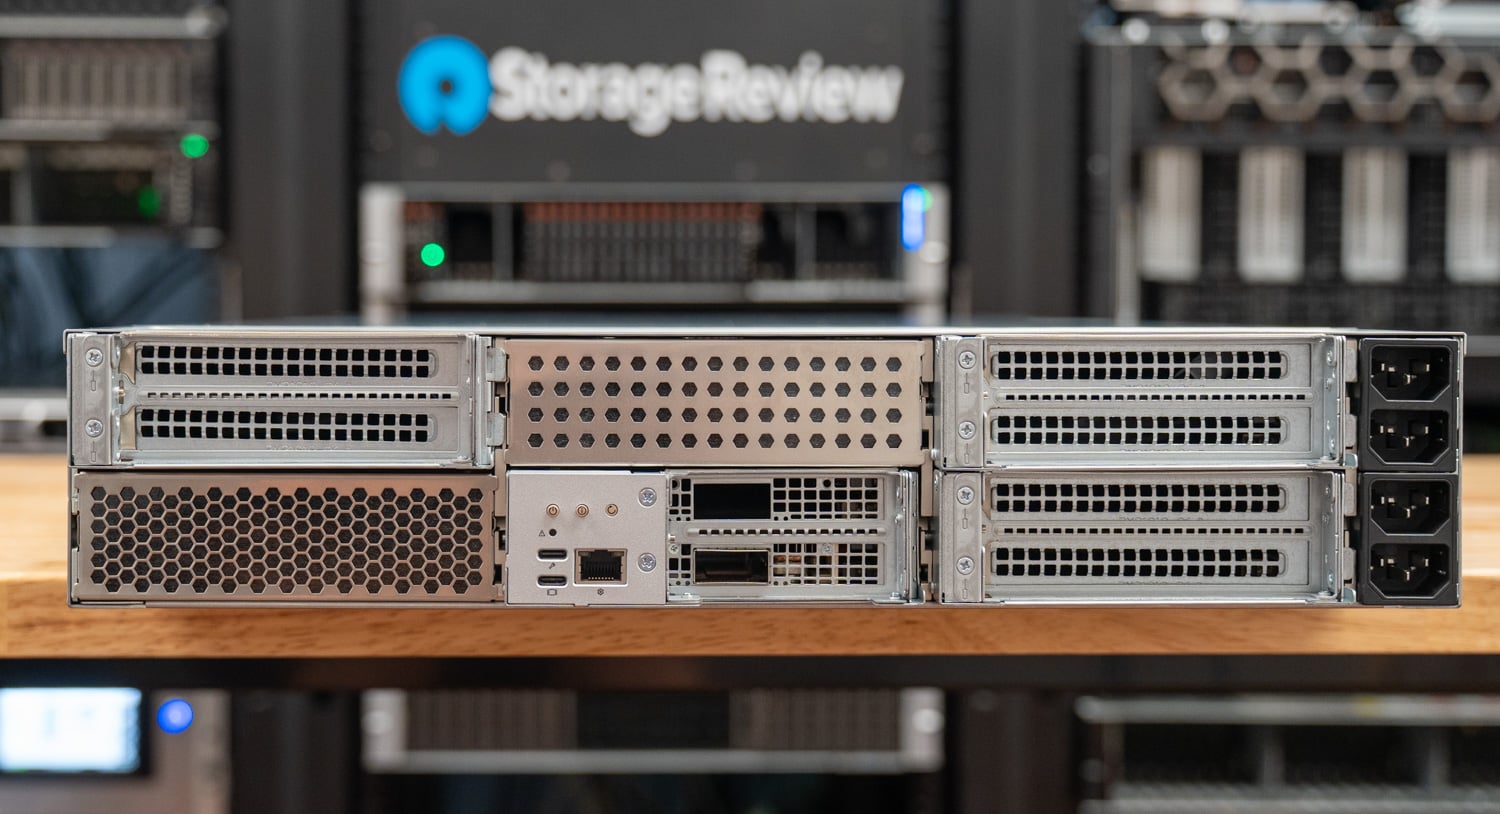
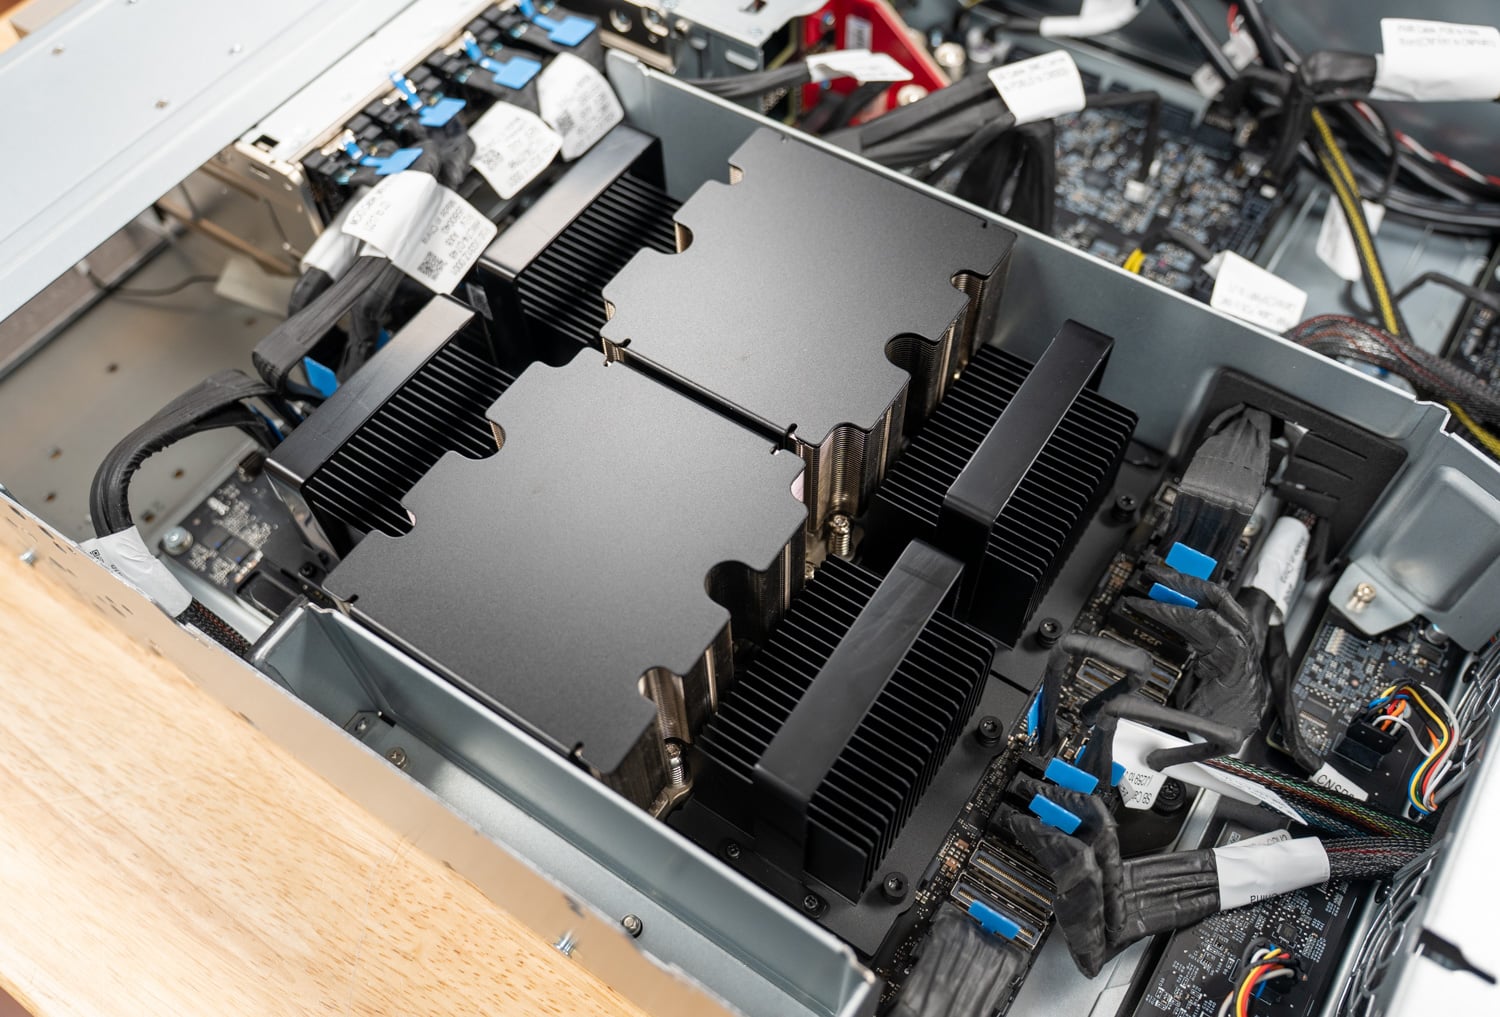
이번 리뷰 제품은 NVIDIA의 MGX Vera C2로, NVIDIA 파트너사들이 최초의 Vera 시스템 구축 기반으로 사용하는 듀얼 소켓 공랭식 2U 레퍼런스 서버입니다. 전면 패널 상단에는 8개의 E1.S 베이가 나란히 배치되어 있으며, 그 옆에는 핫스왑 방식의 Delta 전원 공급 장치 4개가 자리하고 있습니다. 나머지 전면부는 벌집형 흡기 매니폴드로 채워져 있습니다. 전원 공급 장치가 전면에서 전원을 공급받기 때문에 랙 설치 시 후면은 I/O 케이블 정리에 용이하며, PCIe 라이저와 관리 I/O 포트가 배치되어 있습니다.
내부에는 두 개의 Vera CPU가 패시브 히트싱크 아래 나란히 배치되어 있으며, 양쪽 측면에는 SOCAMM2 모듈이 장착되어 있습니다. 드라이브 베이 바로 뒤 섀시 중앙에는 6개의 팬 모듈이 벽처럼 배치되어 두 소켓 모두에 공기를 불어넣고, 각 팬 쌍 사이에는 폼 블록이 공기 흐름을 유도합니다. 냉각 관점에서 볼 때, 이러한 레이아웃은 매우 잘 설계되었습니다.
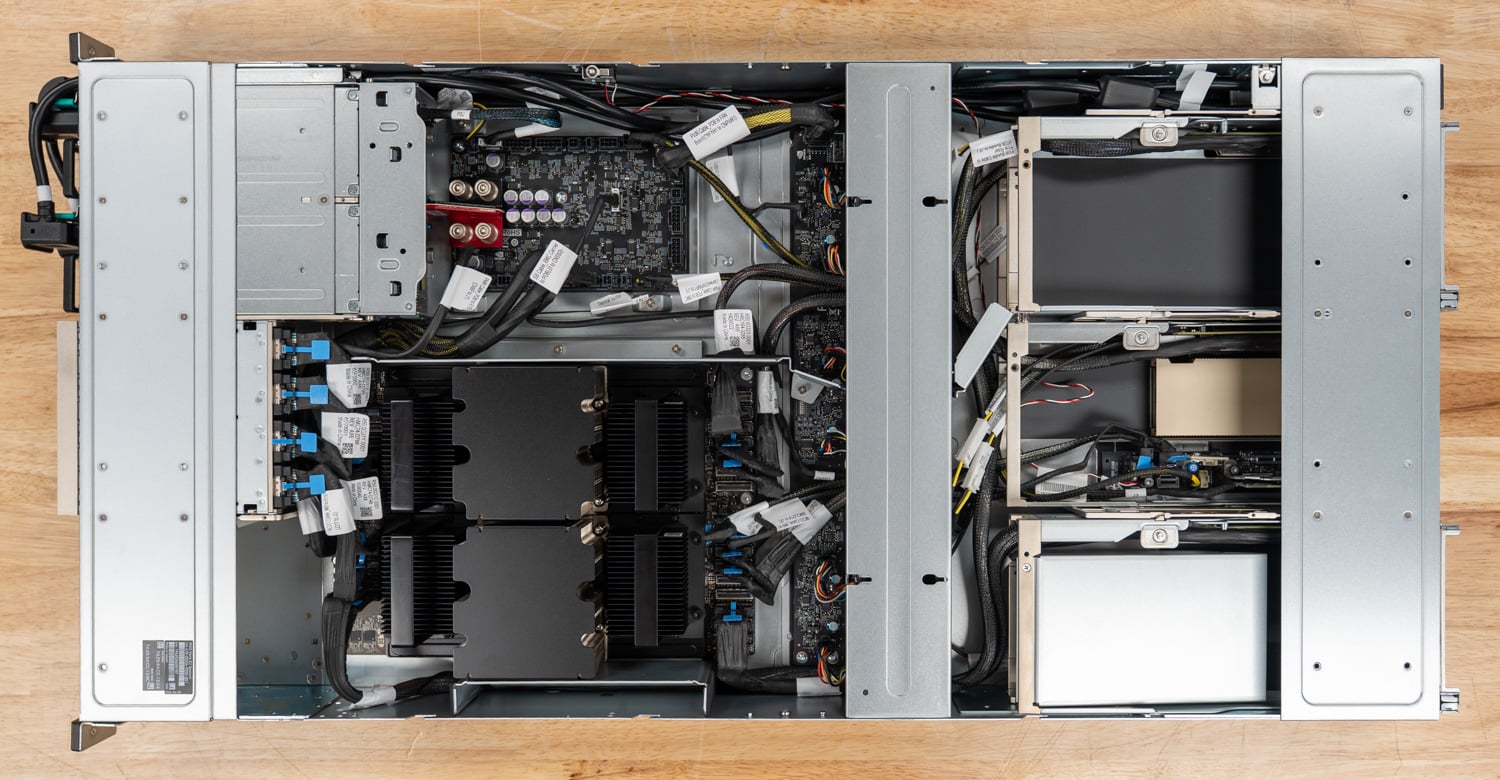
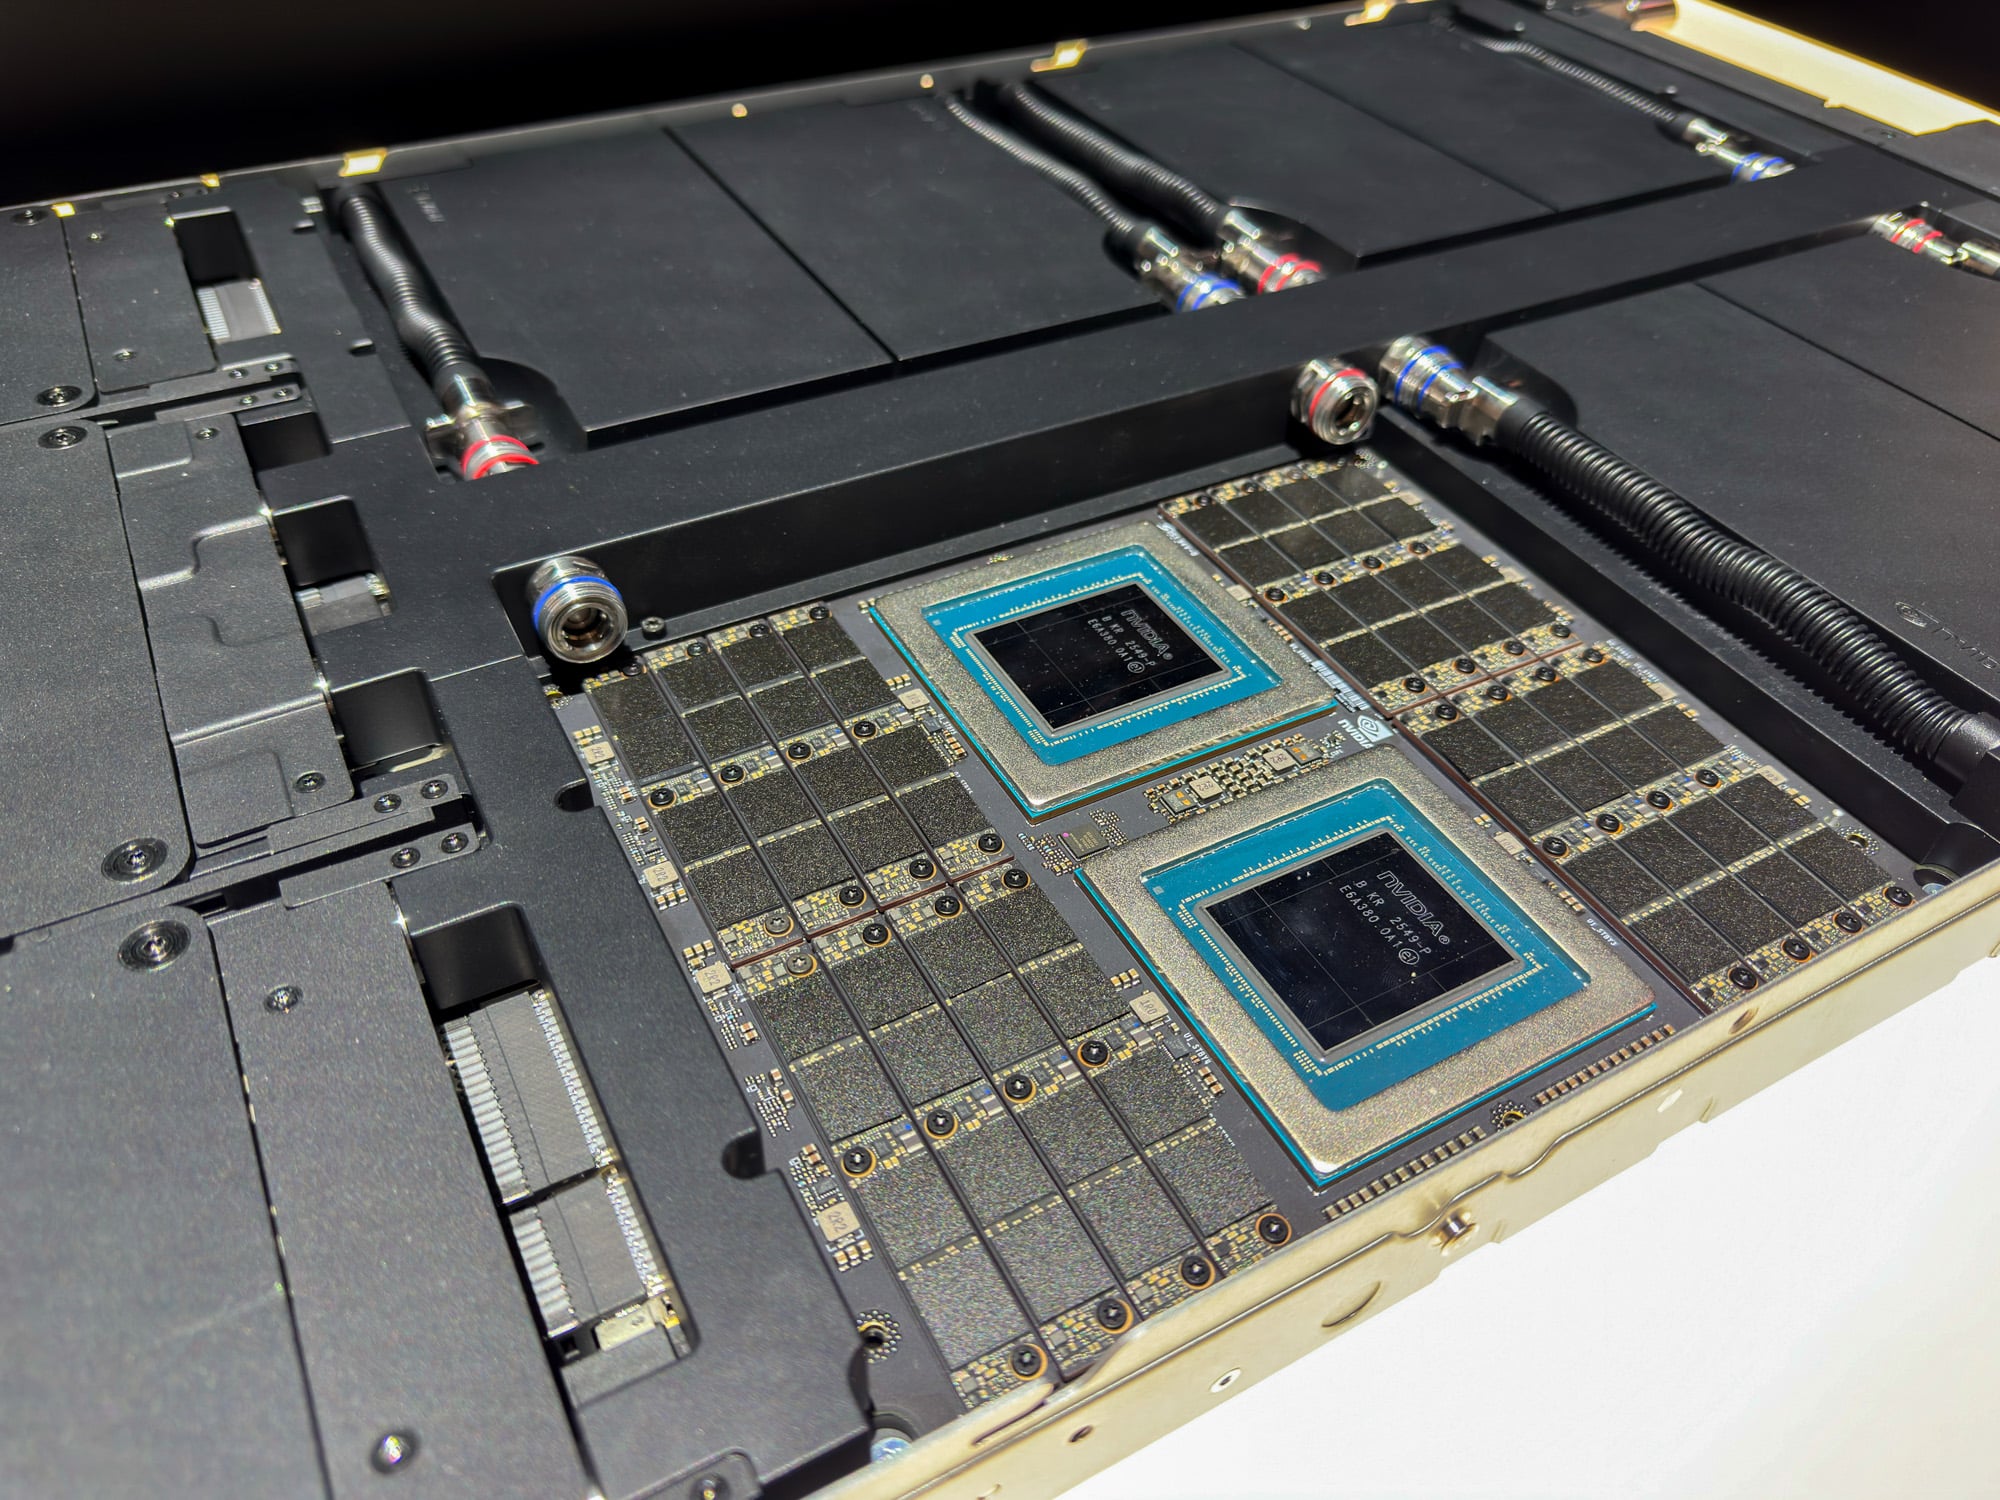
두 프로세서 모두 소켓 없이 PCB에 직접 장착되는데, 이는 NVIDIA가 Vera를 슈퍼칩에 탑재하는 방식과 동일합니다. 16개의 SOCAMM2 슬롯이 두 패키지를 둘러싸고 있어 프로세서는 교체할 수 없지만 메모리는 현장에서 교체 가능합니다. 즉, CPU를 교체하려면 보드를 교체해야 합니다. 지난여름에는 동일한 보드의 수랭식 버전도 살펴보았는데, 이 버전은 SOCAMM2 모듈은 공랭식으로 냉각하면서 보드 상단을 가로질러 프로세서 냉각판에 퀵 커넥트 냉각 라인을 연결하는 방식입니다.
중앙 부분에는 최대 800G 네트워킹을 지원하는 NVIDIA ConnectX-8 어댑터가 있으며, 후면 패널에는 USB, DisplayPort 및 대역 외 관리를 위한 전용 네트워크 포트가 있습니다.
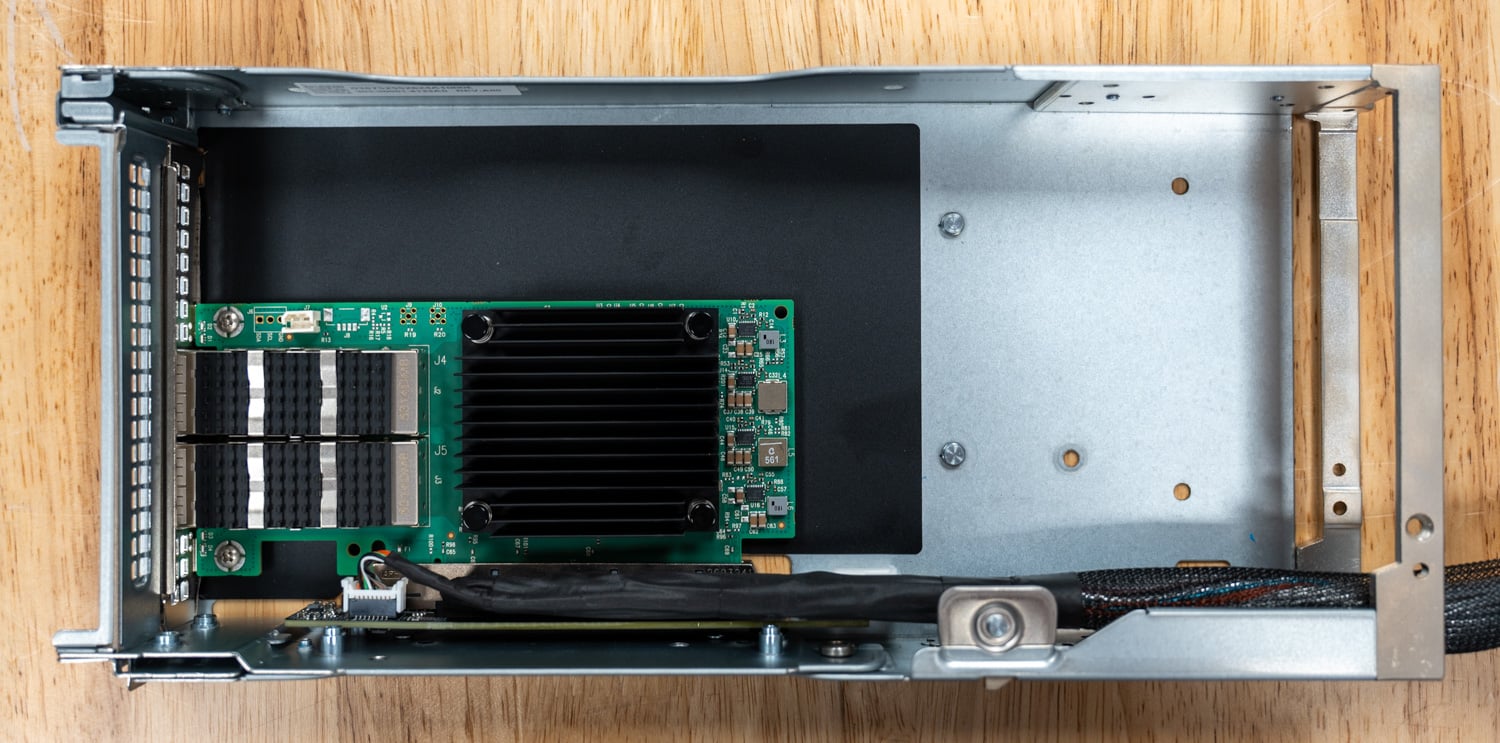
이 플랫폼은 모듈식 설계가 뛰어나 다양한 스토리지 및 후면 PCIe 구성을 지원하지만, 이러한 유연성은 서비스 시간 증가라는 단점을 수반합니다. 3개의 FHFL PCIe 라이저는 언뜻 보기에 서비스가 간편해 보입니다. 일반적인 서버에서는 카드를 교체하려면 라이저를 분리하고, 지지 탭을 뒤집거나 나사를 제거한 다음 카드를 밀어내면 됩니다.
Vera 서버에서는 먼저 팬 커버를 분리하고, 하나 이상의 폼 블록을 제거한 다음, 라이저의 전원 및 PCIe 케이블을 분리하여 들어 올려야 합니다. 그래야만 전체 라이저 어셈블리를 섀시 후면으로 밀어낼 수 있습니다. 라이저가 완전히 분리되면 카드를 교체하기 위해 분해해야 하고, 교체 후에는 다시 조립해야 합니다. 일반 서버에서는 몇 초면 끝나는 작업이 Vera 서버에서는 라이저 하나당 5~10분 정도 소요됩니다.
실제로 랙 내부에서 서비스를 제공하려면 서버를 랙에서 랙 안팎으로 옮겨야 하므로 대부분의 구성 요소 교체는 서버를 작업대로 옮겨 서비스를 제공해야 합니다.
성능 및 벤치마크
이 벤치마크 테스트는 개별 스레드부터 전체 시스템을 사용하는 워크로드에 이르기까지 Vera의 설계가 성능에 어떻게 반영되는지 살펴봅니다. 메모리 대역폭 및 지연 시간, 과학 컴퓨팅, 범용 소프트웨어 및 데이터베이스를 포함하는 테스트를 통해 프로세서가 코어와 메모리 시스템에 대한 다양한 요구 사항을 어떻게 처리하는지 보여줍니다.
테스트 시스템
| 시스템 | NVIDIA MGX Vera C2 | Dell PowerEdge R7725 | Dell PowerEdge R7725 | 델 파워에지 R770AP | Dell PowerEdge R770 | Dell PowerEdge R760 |
|---|---|---|---|---|---|---|
| 프로세서 | ||||||
| CPU | NVIDIA Vera | AMD EPYC 9965 | AMD EPYC 9175F | 인텔 제온 6978P | 인텔 제온 6787P | 인텔 제온 플래티넘 8592+ |
| 소켓 | 2 | |||||
| CPU당 코어/스레드 수 | 88 / 176 | 192 / 384 | 16 / 32 | 120 / 240 | 86 / 172 | 64 / 128 |
| 기본 시계 | 3.4 GHz | 2.25 GHz | 4.2 GHz | 2.1 GHz | 2.0 GHz | 1.9 GHz |
| 최대 시계 | 3.4 GHz | 3.7 GHz | 5.0 GHz | 3.9 GHz | 3.8 GHz | 3.9 GHz |
| 메모리 | ||||||
| 구성 | 16x 96GB 마이크론 SOCAMM2 | 24x 128GB | 24x 64GB | 32x 64GB | 16x 64GB | |
| 유형/속도 | LPDDR5X-9600 | DDR5-6400 | DDR5-5200 | DDR5-4800 | ||
| 총 용량 | 1.5TB | 3TB | 1.5TB | 2TB | 1TB | |
| 스토리지 | ||||||
| SSD | Solidigm D7-PS1010 7.68TB | Solidigm D7-PS1030 12.8TB | 마이크론 9550 PRO 7.68TB | Solidigm D7-PS1010 7.68TB | 삼성 PM1745 6.4TB | 솔리드다임 D7-P5520 3.84TB |
| SSD 링크 | PCIe 5세대 x4 | PCIe 5세대 x2 | PCIe 5세대 x4 | PCIe 4세대 x4 | ||
| 펌웨어 | ||||||
| 시스템 BIOS | NV_SBIOS 06.07.01.06 | 1.5.3 | 1.2.1 | 1.8.5 | 2.8.2 | |
| BIOS 프로필 | 태만 | 성능 | ||||
| 소프트웨어 스택 | ||||||
| OS | 우분투 LTS 26.04.1 | 우분투 LTS 24.04.5 | ||||
| 핵심 | 7.0.0-2022-nvidia-bos | 6.8.0 - 142 / 6.8.0 - 146 | 6.8.0-147 | 6.8.0-138 | 6.8.0 - 142 / 6.8.0 - 146 | 6.8.0 - 142 / 6.8.0 - 146 |
| GCC | 15.2.0 | 13.3.0 | ||||
| glibc에 | 2.43 | 2.39 | ||||
| MPI 열기 | 5.0.10 | 4.1.6 | ||||
| 오픈JDK | 11.0.32 | |||||
저희는 Vera를 최적의 메모리 구성을 갖춘 5가지 Dell PowerEdge 구성과 비교하고, AMD의 가장 많은 코어 수와 높은 클럭 속도를 자랑하는 EPYC 프로세서와 현세대 및 이전 세대 Xeon 프로세서를 포함하는 동일한 테스트 스위트를 사용하여 테스트했습니다.
올림푸스 지원이 GCC 15에서 처음 도입되었기 때문에 Vera는 위에 나열된 x86 시스템보다 최신 소프트웨어 스택을 사용했습니다. 벤치마크 버전, 입력 및 빌드 플래그는 모든 시스템에서 동일했습니다.
메모리 대역폭
메모리는 Vera가 x86과 가장 크게 다른 부분이므로, 테스트는 여기서부터 시작했습니다. 16GiB 어레이에서 물리적 코어당 하나의 OpenMP 스레드를 사용하여 STREAM Triad를 테스트했습니다. 주요 테스트는 시스템의 모든 코어를 사용하고 각 스레드의 데이터가 동일한 소켓에 저장되도록 했습니다. 그런 다음 소켓 0의 코어가 먼저 로컬 메모리를 읽은 다음 원격 소켓의 메모리를 읽도록 하고, 모든 코어가 두 소켓에 걸쳐 페이지를 번갈아 읽도록 하여 테스트를 반복했습니다. 아래 차트는 SMT를 비활성화한 상태에서 각 서버에 대한 전체 시스템 Triad 결과를 보여줍니다.
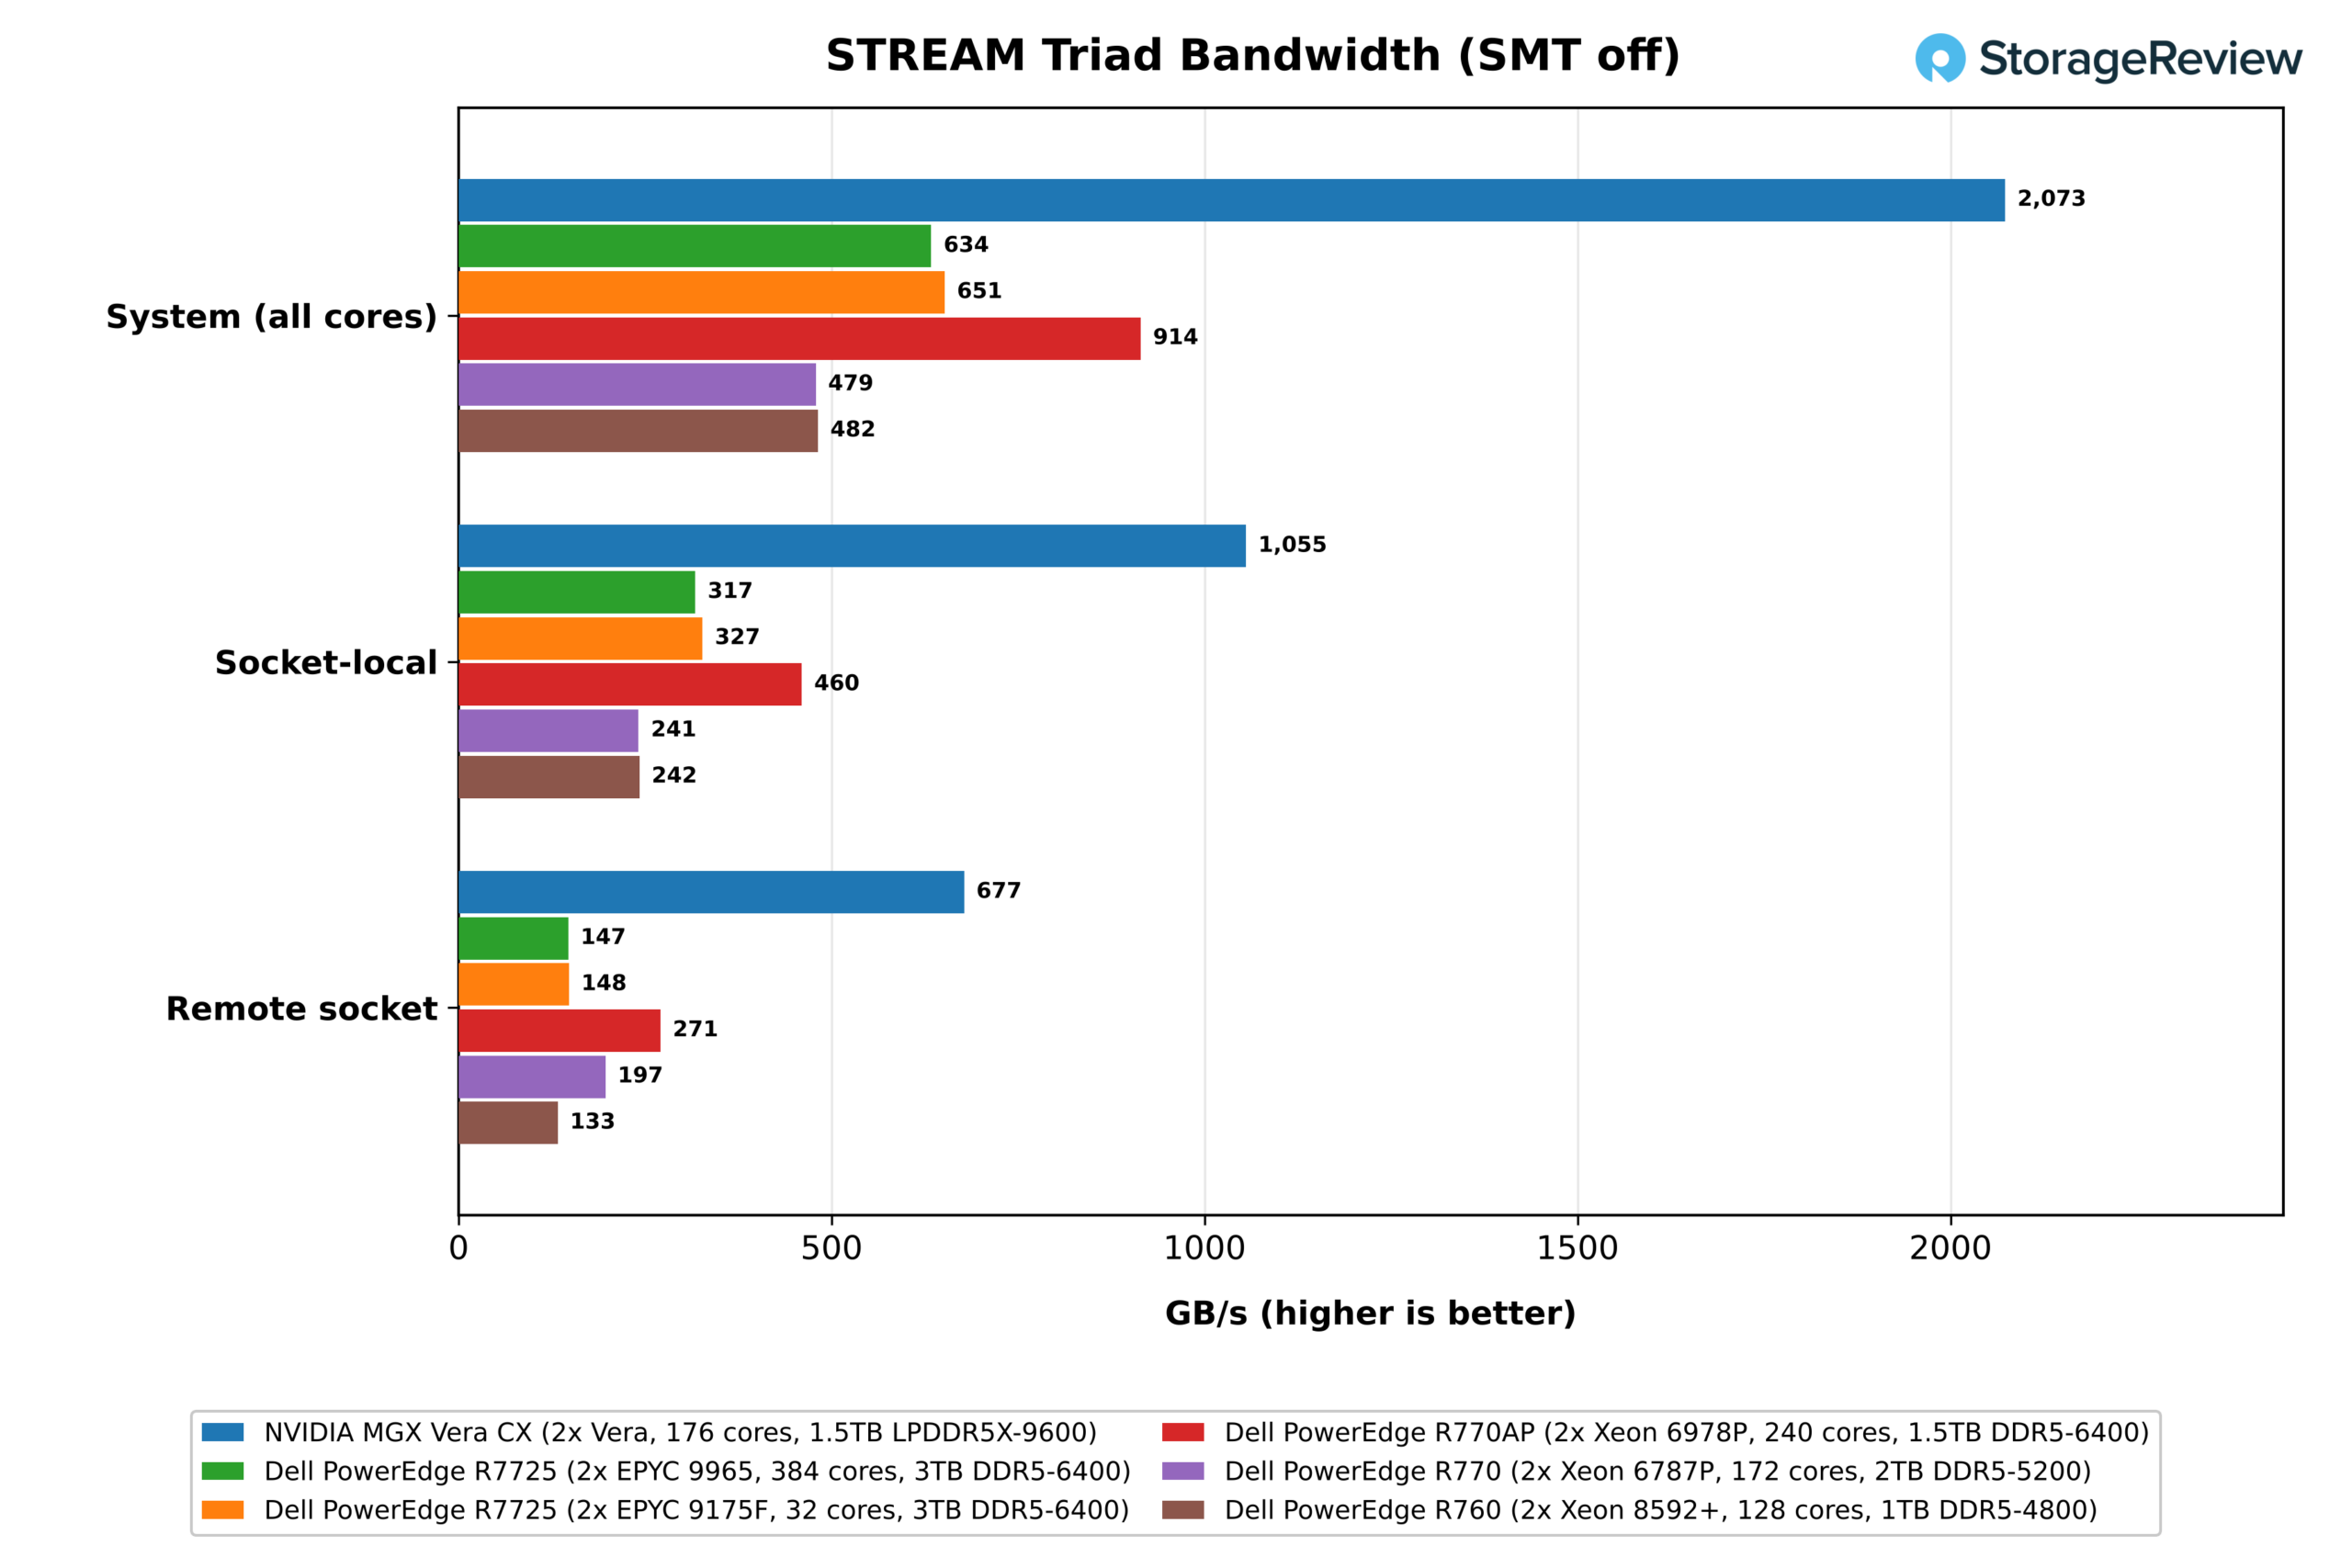
Vera는 2,073GB/s의 속도를 유지하며 듀얼 소켓 기준 2.4TB/s 정격의 86%를 달성했습니다. 가장 근접한 x86 시스템은 Xeon 6978P로, 24채널 DDR5-6400 메모리를 사용하여 914GB/s의 속도를 기록했는데, 이는 이론상 최대 속도인 1,229GB/s의 74%에 해당하며 Vera보다 2.3배 높은 수치입니다. 두 EPYC 시스템 역시 동일한 24채널 DDR5-6400 메모리를 사용했지만, 32코어 9175F는 651GB/s, 384코어 9965는 634GB/s로 Vera보다 훨씬 낮은 성능을 보였습니다. 이는 최대 속도의 52%에 불과하며 Vera보다 3.3배 낮은 수준입니다. 마지막으로, Xeon 6787P와 8592+는 더 느린 DDR5-5200과 DDR5-4800 메모리를 사용하여 각각 479GB/s와 482GB/s의 속도를 기록하며 가장 낮은 성능을 보였습니다.
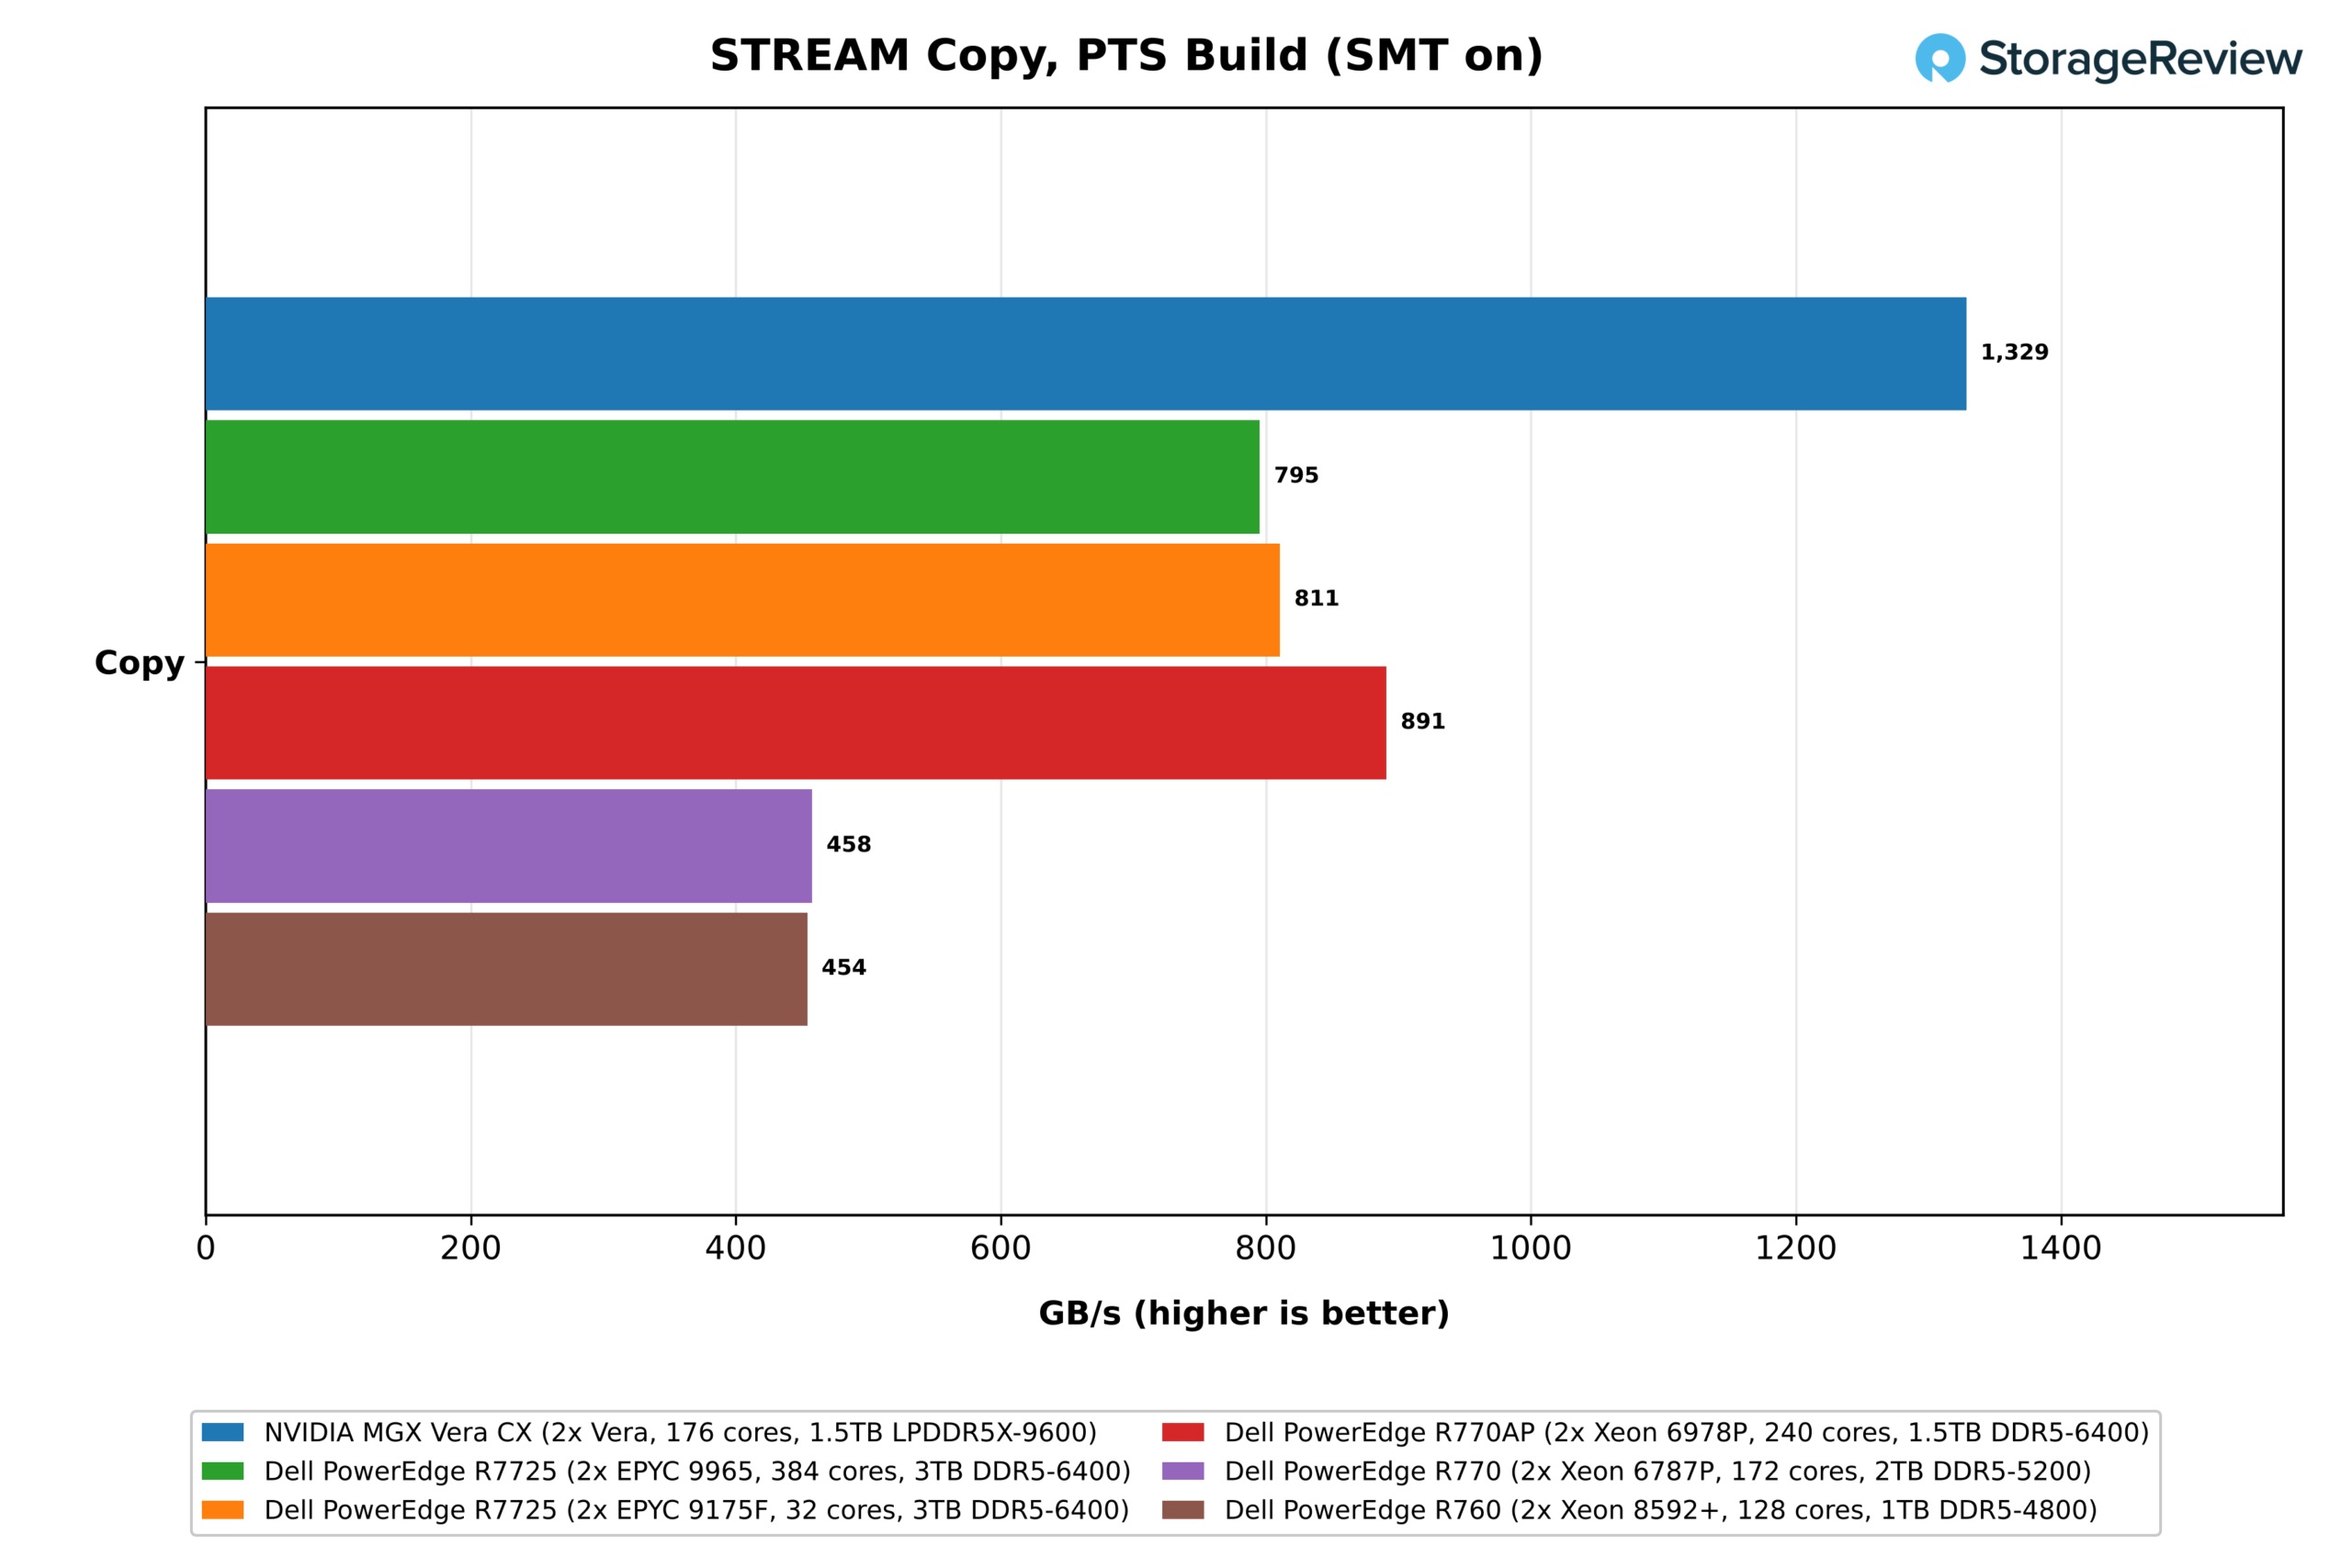
EPYC 성능 저하의 일부 원인은 STREAM의 트래픽 계산 방식 때문입니다. STREAM은 일반 GCC로 빌드되는데, 일반 GCC는 스트리밍 스토어를 생성하지 않으므로 캐시 미스가 발생하는 스토어는 먼저 대상 라인을 메모리에서 읽습니다. STREAM은 이 읽기 작업을 계산에 포함하지 않기 때문에 Triad는 어디에서 발생하든 트래픽을 1/4 정도 적게 계산합니다. AMD의 Zen 코어는 모든 스토어 작업에서 이 읽기 작업을 처리합니다. NVIDIA의 초기 Grace와 같은 Arm 코어는 전체 라인 쓰기를 감지하고 읽기를 건너뛰며, Intel의 최신 Xeon 코어는 메모리 부하가 높을 때 대부분의 읽기 작업을 건너뛸 수 있습니다.
별도로 제작된 Phoronix Test Suite의 STREAM 빌드도 같은 결과를 보여줍니다. SMT를 끄고 실행했을 때, 복사 속도는 9965에서 832GB/s, 9175F에서 873GB/s를 기록했는데, 이는 테스트 스위트 빌드의 551GB/s 및 570GB/s보다 약 1.5배 높은 수치이며, 추가 읽기 작업이 제거되었을 때 예상되는 복사 속도 향상과 일치합니다. Xeon 프로세서의 경우 두 빌드의 성능 차이는 9% 이내였습니다.
계산되지 않은 읽기 횟수를 고려하여 조정하면 9965는 약 845GB/s를 처리했는데, 이는 최대치의 약 69%에 해당하며, Vera의 처리량 차이는 약 2.5배로 좁혀집니다. 6978P는 훨씬 적은 보정이 필요하므로 2.3배라는 수치가 해당 데이터 세트에서 가장 보수적인 비교 기준입니다.
소켓별로 테스트를 나누어 보면 패브릭이 코어에 로컬로 저장되지 않은 데이터를 어떻게 처리하는지 알 수 있습니다. 소켓 0의 코어는 로컬 메모리를 읽을 때 1,055GB/s의 속도를 기록했는데, 이는 소켓당 정격 속도인 1.2TB/s의 88%에 해당하며, 테스트에 사용된 모든 x86 서버보다 높은 수치입니다. NVLink-C2C를 통해 다른 소켓의 메모리를 읽을 때는 동일한 코어가 677GB/s의 속도를 유지했는데, 이는 로컬 속도의 64%에 해당합니다. Xeon 6978P는 59%, EPYC 9175F는 45%를 기록했습니다(원격 148GB/s, 로컬 327GB/s). 따라서 잘못된 소켓에 워크로드를 배치하더라도 x86 소켓이 로컬 메모리에서 읽을 때의 최대 속도인 6978P의 460GB/s보다 더 높은 대역폭을 얻을 수 있습니다.
Vera의 최종 테스트로, NUMA를 인식하지 않는 애플리케이션에서 사용하는 경우인 STREAM Triad 인터리브 페이지를 두 소켓 모두에 걸쳐 전송하는 방식으로 테스트한 결과, Vera는 1,372GB/s의 성능을 보여주었으며, 이는 6978P의 전체 시스템 성능보다 1.5배 높은 수치입니다.
숨어 있음
대역폭은 메모리 성능의 절반에 불과합니다. 지연 시간은 코어가 캐시 미스가 발생할 때마다 대기하는 시간을 결정하며, 특히 메모리 포인터를 따라 이동하는 코드에 매우 중요합니다. 우리는 tinymembench를 사용하여 지연 시간을 측정합니다. 이 테스트는 소켓 0의 단일 스레드에서 1GiB 버퍼에 대한 임의 읽기 작업을 수행하는 데 걸리는 시간을 측정합니다. EPYC 9175F는 이 테스트 결과를 제공하는 유일한 x86 시스템이므로, 여기서는 EPYC 9175F를 비교 대상으로 사용합니다.
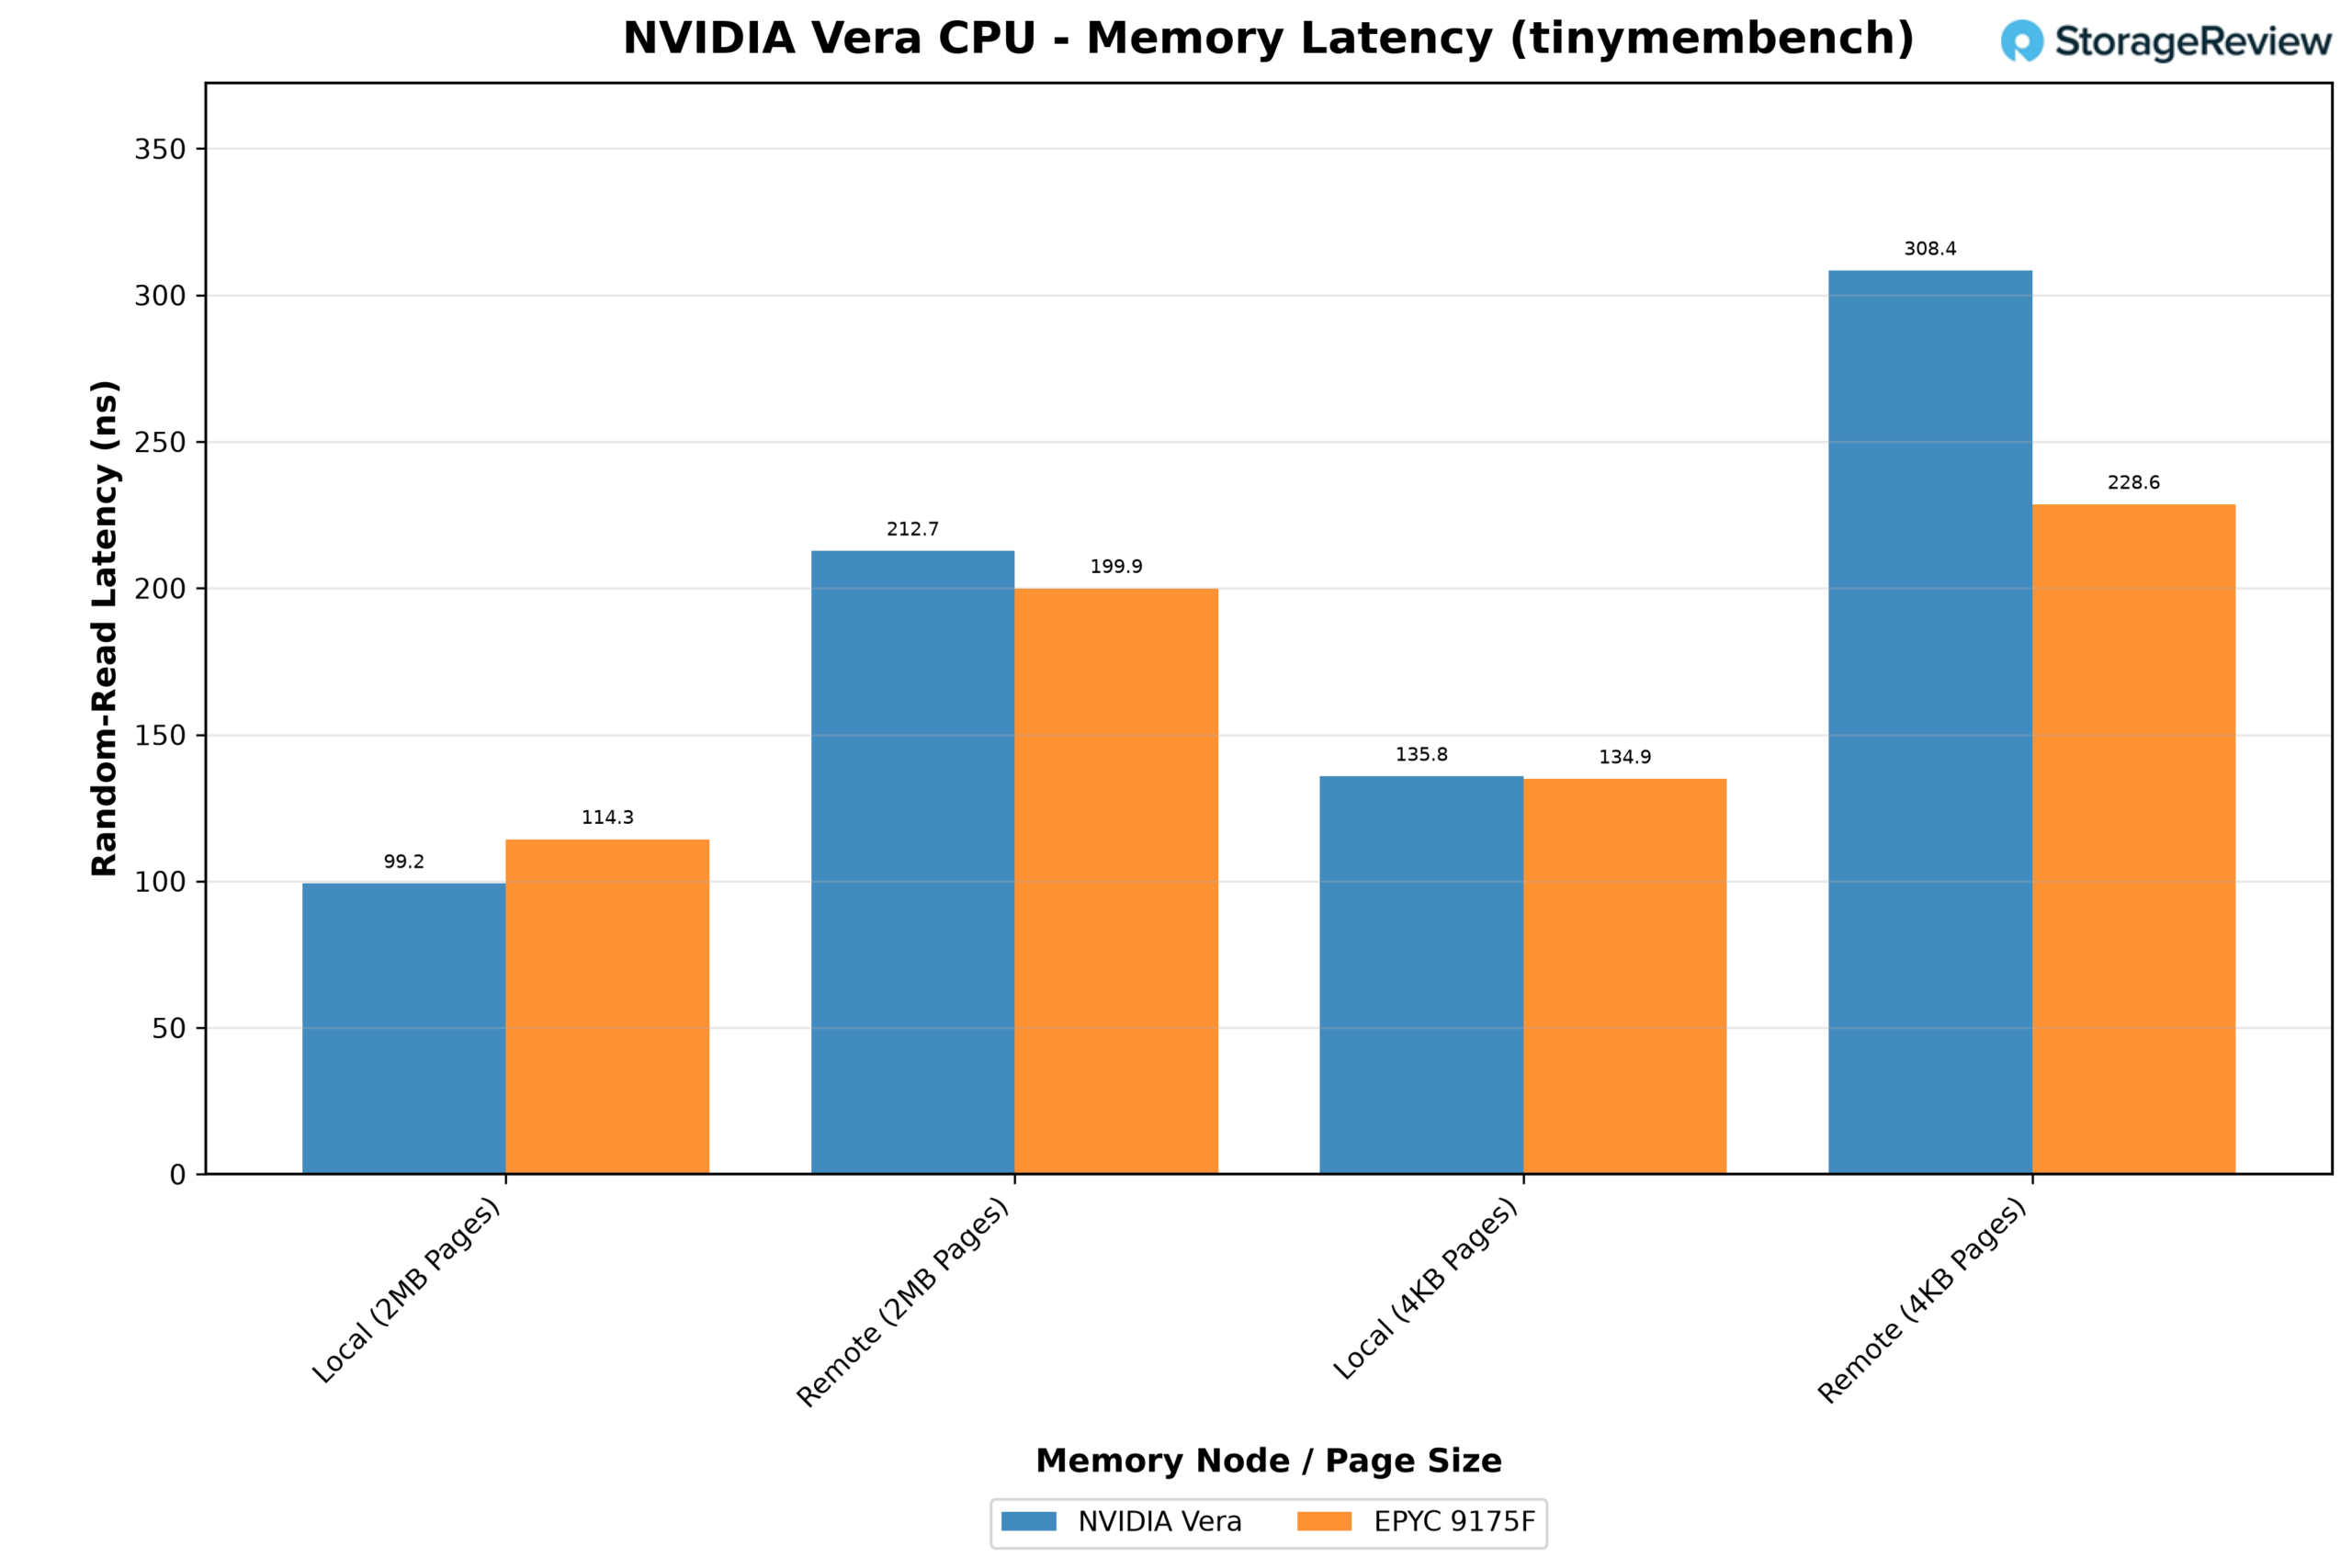
로컬 메모리 읽기에서 Vera는 EPYC보다 빠릅니다. 2MB 대용량 페이지를 사용할 경우, 로컬 읽기에 Vera는 99.2ns가 걸린 반면 9175F는 114.3ns가 걸려 13% 더 빨랐습니다. 표준 4KB 페이지를 사용할 때는 두 프로세서 모두 약 135ns로 비슷한 속도를 보였습니다. 하지만 다른 소켓으로 데이터를 전송할 때는 NVLink-C2C의 성능 차이가 드러납니다. 원격 읽기에 Vera는 212.7ns가 걸려 로컬 읽기 시간의 약 2.1배를 기록한 반면, EPYC는 199.9ns로 로컬 읽기 시간의 1.75배에 그쳤습니다.
Vera는 페이지 크기에 더 민감합니다. 주소 변환 오류가 모든 읽기 작업에 누적되는 4KB 페이지의 경우, 로컬 지연 시간이 37% 증가했고 원격 지연 시간은 308.4ns에 달했습니다. 이는 EPYC에서 18% 증가한 수치와 228.6ns를 기록한 것과 비교됩니다. Vera에서는 대용량 페이지를 실행해야 합니다.
HPC
대역폭과 지연 시간은 메모리 시스템을 독립적으로 설명하는 요소입니다. 과학 응용 프로그램은 메모리 시스템과 코어가 함께 작동해야 할 때 어떤 일이 발생하는지 보여주며, 저희의 두 가지 HPC 테스트는 CPU 설계의 매우 다른 부분을 활용합니다.
분자 동역학 코드인 GROMACS는 대부분의 시간을 벡터 연산에 소비하며, 각 SIMD 폭에 대해 수동으로 작성된 반복문을 사용합니다. 따라서 GROMACS는 올림푸스 섹션에서 설명한 트레이드오프, 즉 x86 파트의 512비트 AVX-512 유닛과 6개의 128비트 SVE2 파이프 간의 성능 차이를 가장 직접적으로 테스트할 수 있는 사례입니다. 전산 유체 역학 솔버인 OpenFOAM은 대규모 희소 행렬을 처리하고 메모리 대기 시간에 많은 시간을 소비하므로, 위에서 측정한 대역폭이 실제 응용 프로그램에서도 유효한지 여부를 보여줍니다.
GROMACS
저희는 benchPEP를 사용하여 GROMACS 2025.3을 테스트했습니다. 이 테스트는 서버의 모든 물리적 코어에서 실행되는 12만 개 원자 규모의 사례입니다. 빌드에는 Vera 시스템에서 ARM_SVE를, 모든 x86 시스템에서 AVX-512를 사용했으며, 테스트 스위트의 고정 입력과 비활성화된 PME 튜닝 덕분에 모든 플랫폼에서 동일한 작업이 실행되었습니다.
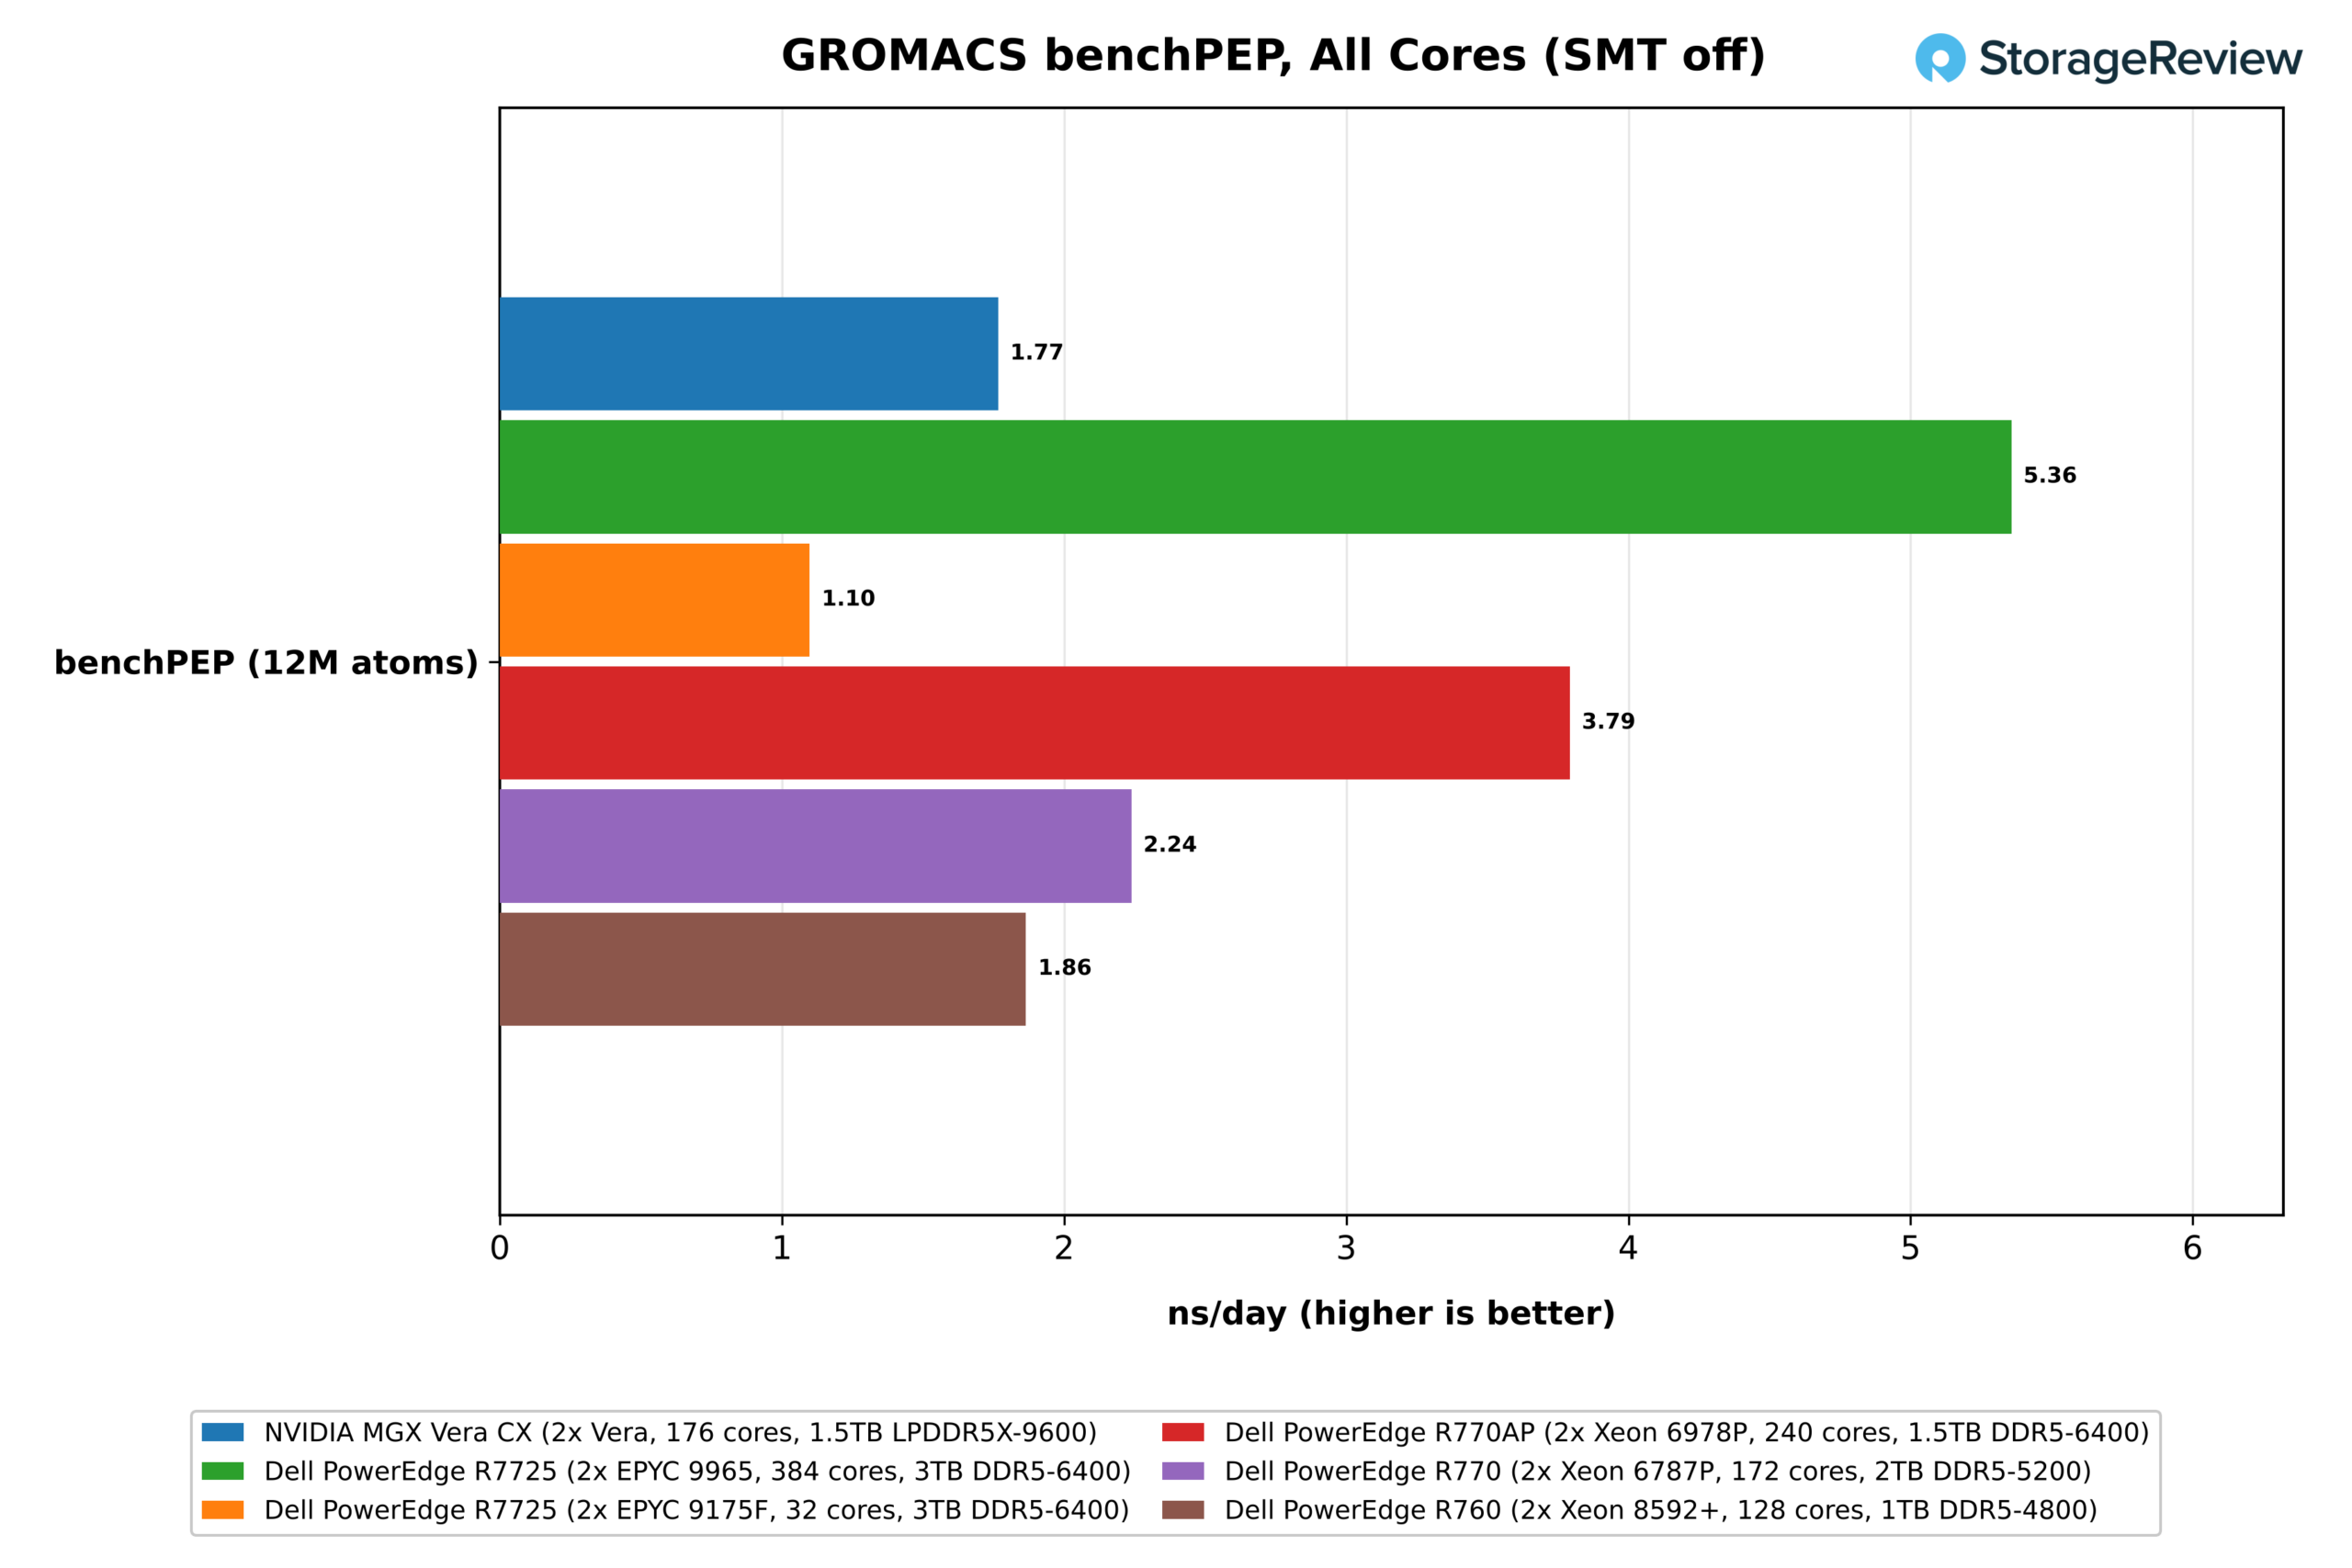
SMT를 끄고 벤치마크 PEP를 실행한 결과, Vera는 1.77ns/day를 기록했습니다. 384코어 EPYC 9965가 5.36ns/day로 Vera보다 3.0배 빠른 성능을 보였고, 그 뒤를 이어 240코어 Xeon 6978P가 3.79ns/day(2.1배), 172코어 Xeon 6787P가 2.24ns/day(1.27배)를 기록했습니다. 128코어 Xeon 8592+ 또한 1.87ns/day로 Vera보다 앞섰으며, 32코어 EPYC 9175F만이 1.10ns/day로 Vera보다 약간 뒤처졌습니다. 코어 수로 정규화하면 이러한 성능 차이의 상당 부분이 아키텍처 차이에 의한 것임을 알 수 있습니다. Vera는 코어당 하루 0.0100ns의 처리량을 보이는 반면, 6787P는 0.0130ns, 9965는 0.0140ns, 8592+는 0.0146ns, 6978P는 0.0158ns를 보입니다. 따라서 대형 x86 부품과의 성능 차이는 부분적으로는 코어 수 때문이고, 부분적으로는 코어당 처리량 때문입니다.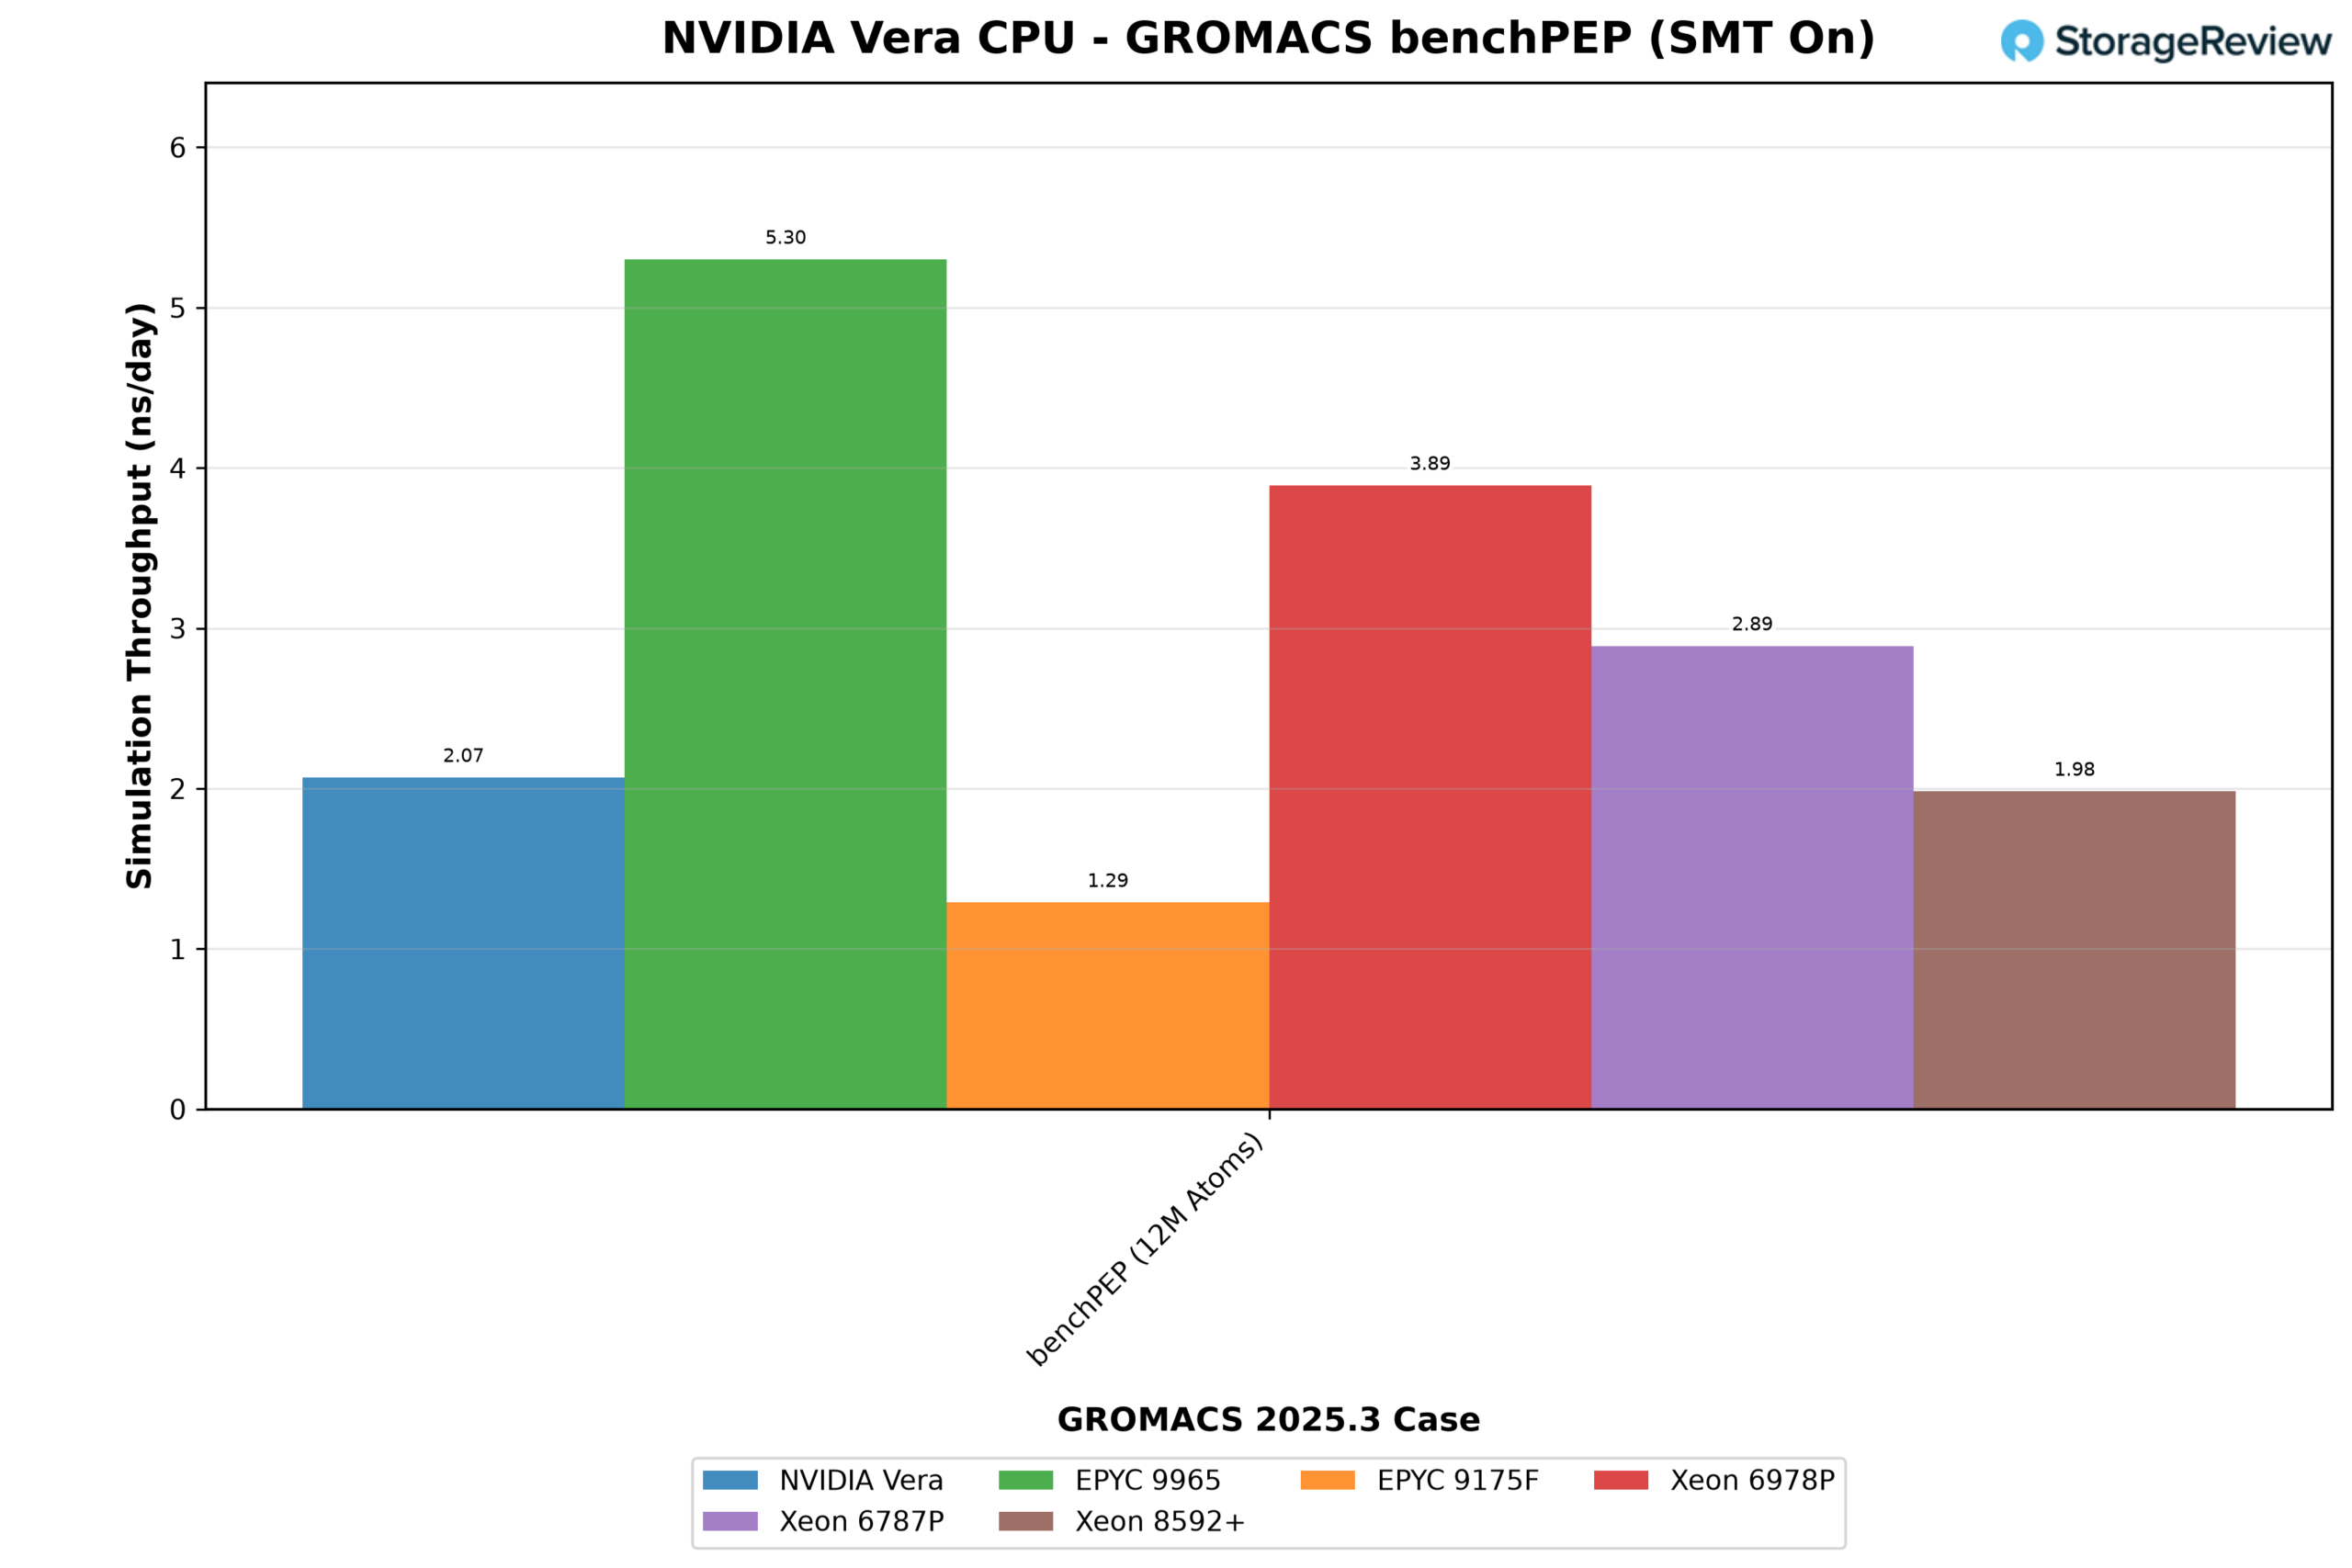
공간 멀티스레딩(SMT)은 이러한 격차를 어느 정도 만회해 줍니다. SMT를 활성화하자 Vera의 결과가 17% 향상되어 2.07ns/일이 되었으며, 최적의 레이아웃은 352개의 하드웨어 스레드를 모두 스레드-MPI 랭크로 실행하는 것이었습니다. 이는 이전 테스트에서 SMT가 Xeon 6978P(3%) 또는 8592+(11%)에 제공했던 향상보다 더 큰 수치이며, EPYC 9965에서는 SMT를 활성화했을 때 3.5%의 성능 저하가 나타났습니다. 두 스레드 간에 리소스가 분할됨에 따라 각 랭크는 코어의 일부를 할당받게 되며, 솔버의 벡터 연산과 메모리 지연이 혼합되어 단일 랭크보다 이러한 할당량을 더 효율적으로 활용하는 것으로 보입니다.
benchMEM 사례는 82,000개 원자로 구성된 시스템을 모든 플랫폼의 소켓 0에 있는 16개의 물리적 코어에서 실행하여 코어별 성능 차이를 분리해냅니다. 따라서 코어 수는 고려 대상에서 제외되며, 결과는 벡터 처리량, 캐시 및 로컬 메모리를 반영합니다.
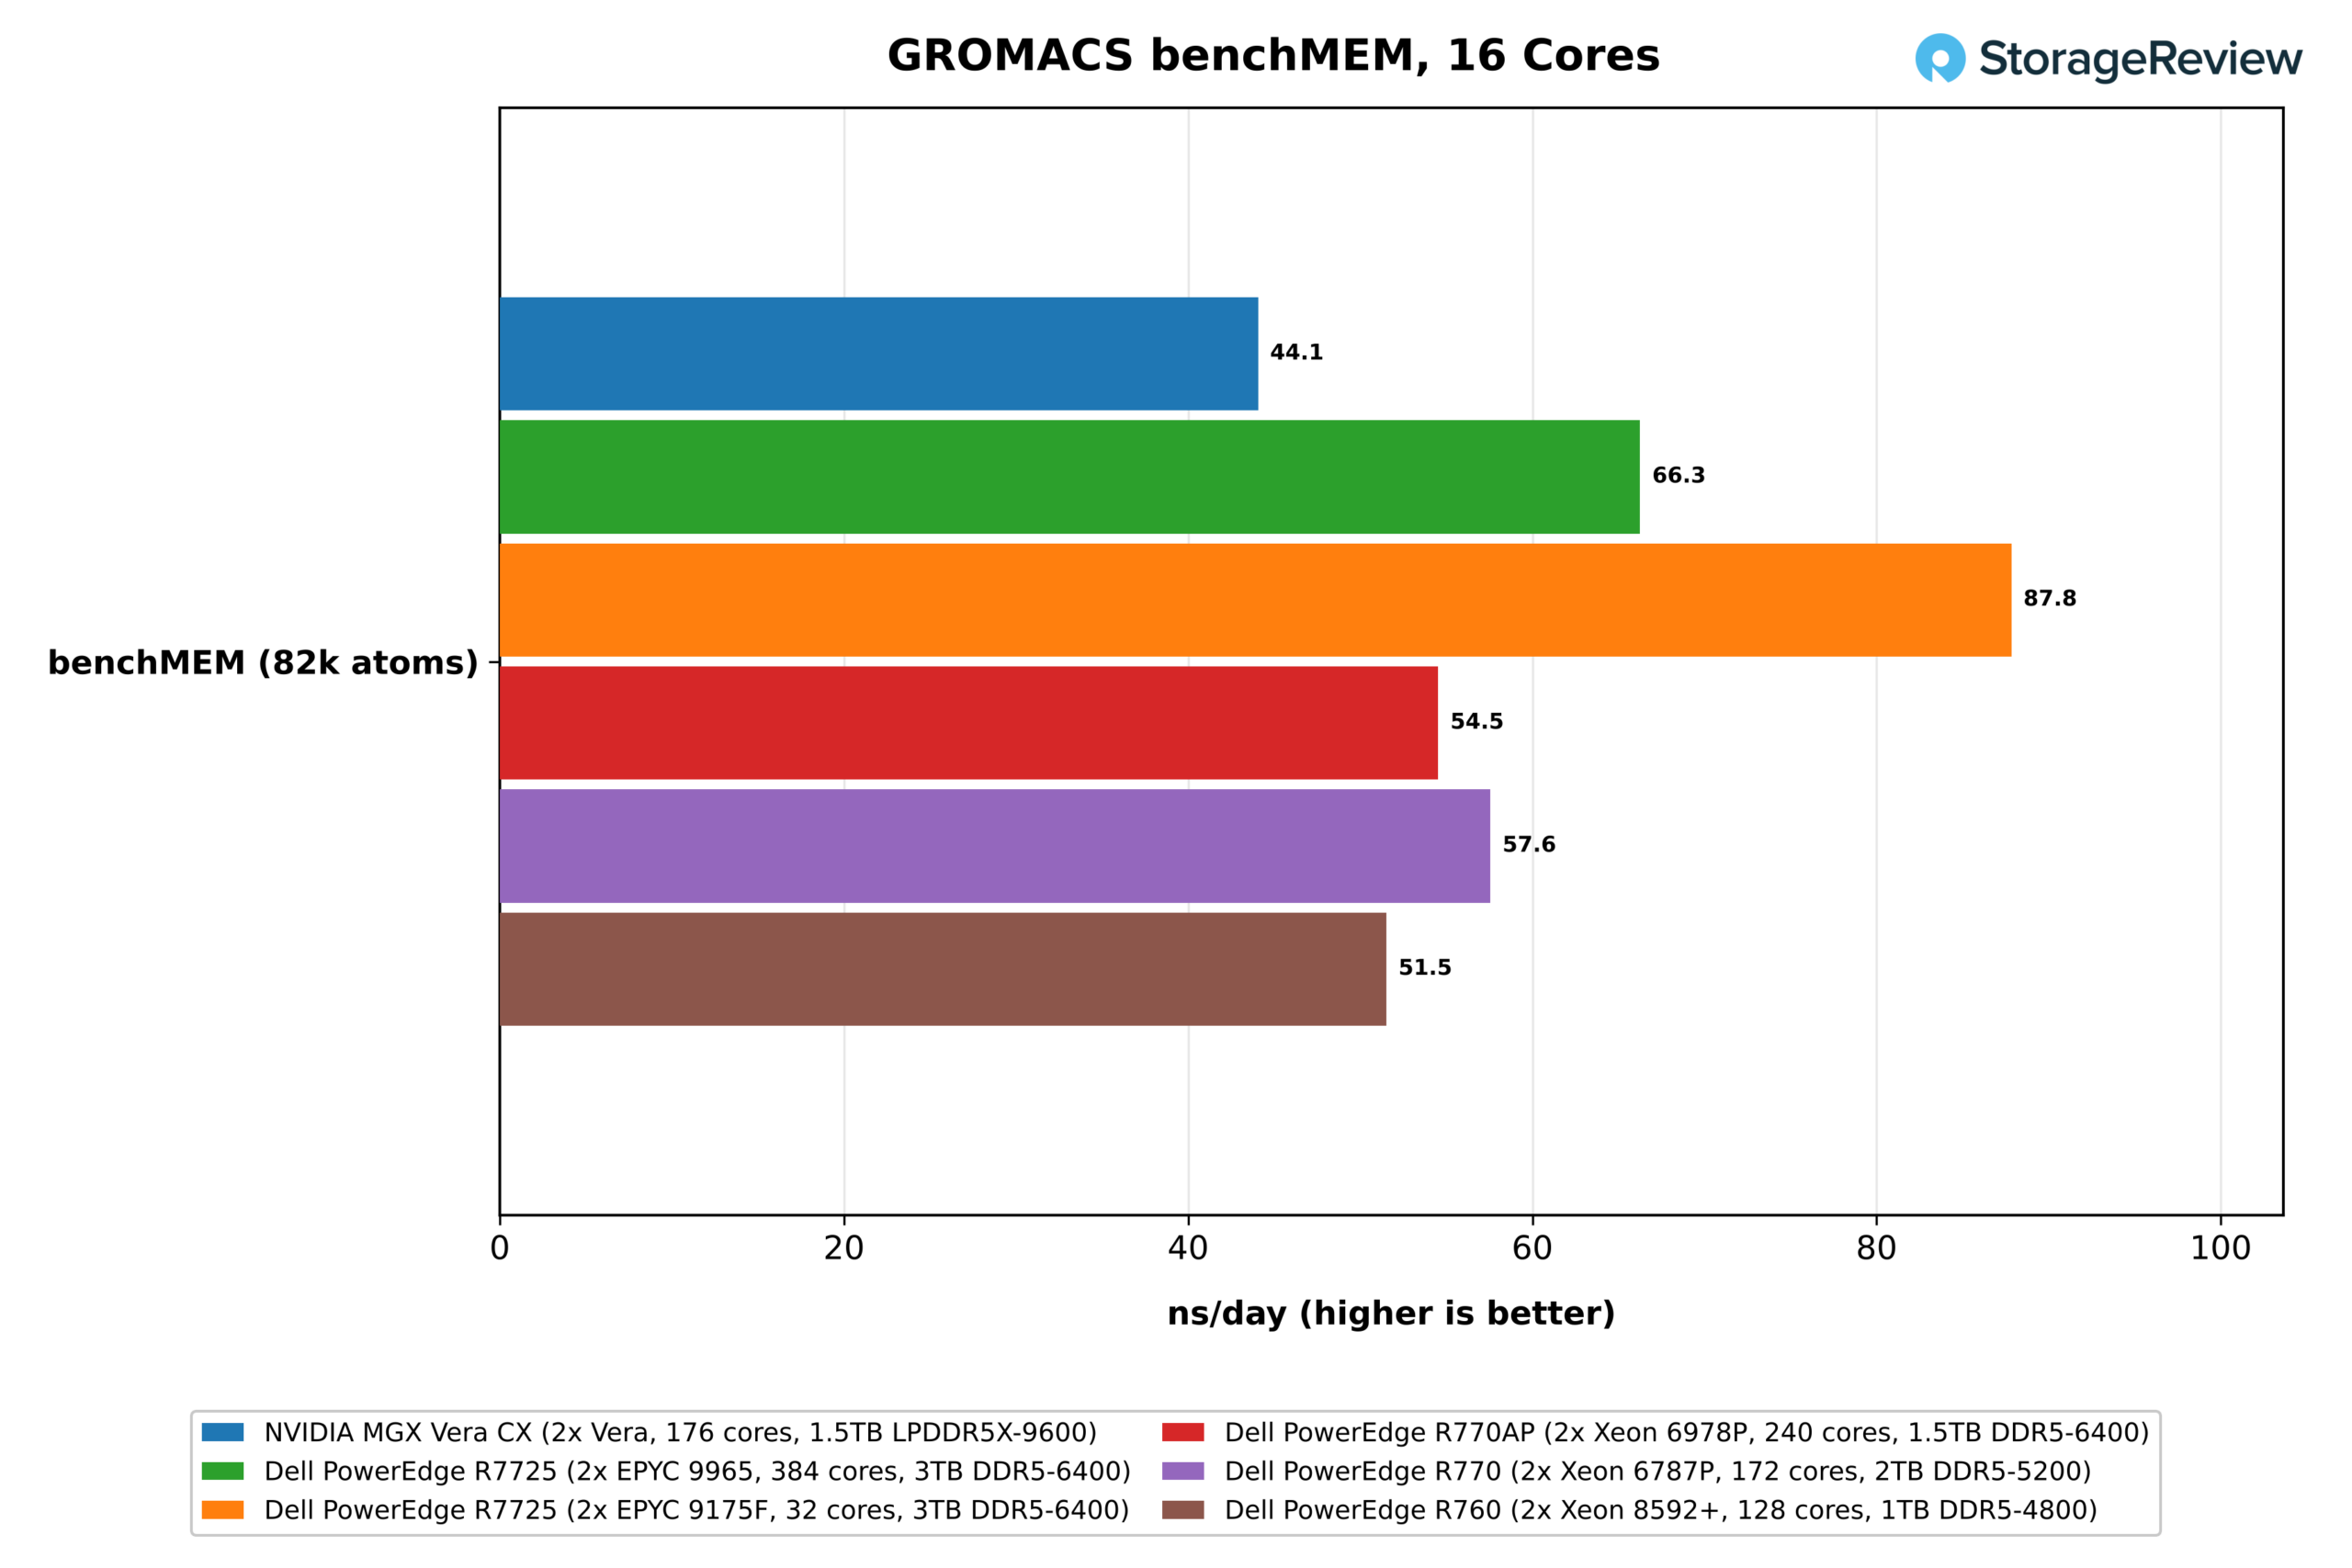
여기서 Vera는 44.1ns/일을 기록했습니다. 5.0GHz EPYC 9175F는 이보다 두 배 높은 87.8ns를 기록했고, EPYC 9965는 66.3ns로 Vera보다 1.5배 빨랐으며, Xeon 6787P(57.6ns), 6978P(54.5ns), 8592+(51.5ns)보다 앞섰습니다.
따라서 Vera의 16코어 슬라이스는 Zen 5c의 16코어 슬라이스가 수행하는 작업량의 약 3분의 2를 처리합니다. Zen 5c의 16개 코어는 32MB L3 캐시 하나를 공유하는 반면, Vera는 164MB 시스템 레벨 캐시를 활용할 수 있음에도 불구하고 이러한 결과가 나타납니다. 이는 512비트 벡터용으로 작성된 코드에서 128비트 벡터를 사용할 때 발생하는 비용을 가장 명확하게 보여주는 측정 결과입니다. 9175F가 9965보다 우수한 성능을 보이는 이유는 클럭 속도 차이(5.0GHz 대 3.7GHz) 때문입니다.
OpenFOAM
OpenFOAM은 벡터 유닛에서 메모리 시스템으로 압력을 이동시킵니다. 우리는 물리적 코어당 하나의 MPI 랭크를 사용하여 두 가지 메쉬 크기(2.98만 셀의 중간 메쉬와 22.6만 셀의 대형 메쉬)로 driverFastback 자동차 공기역학 사례에 OpenFOAM 13을 실행했습니다.
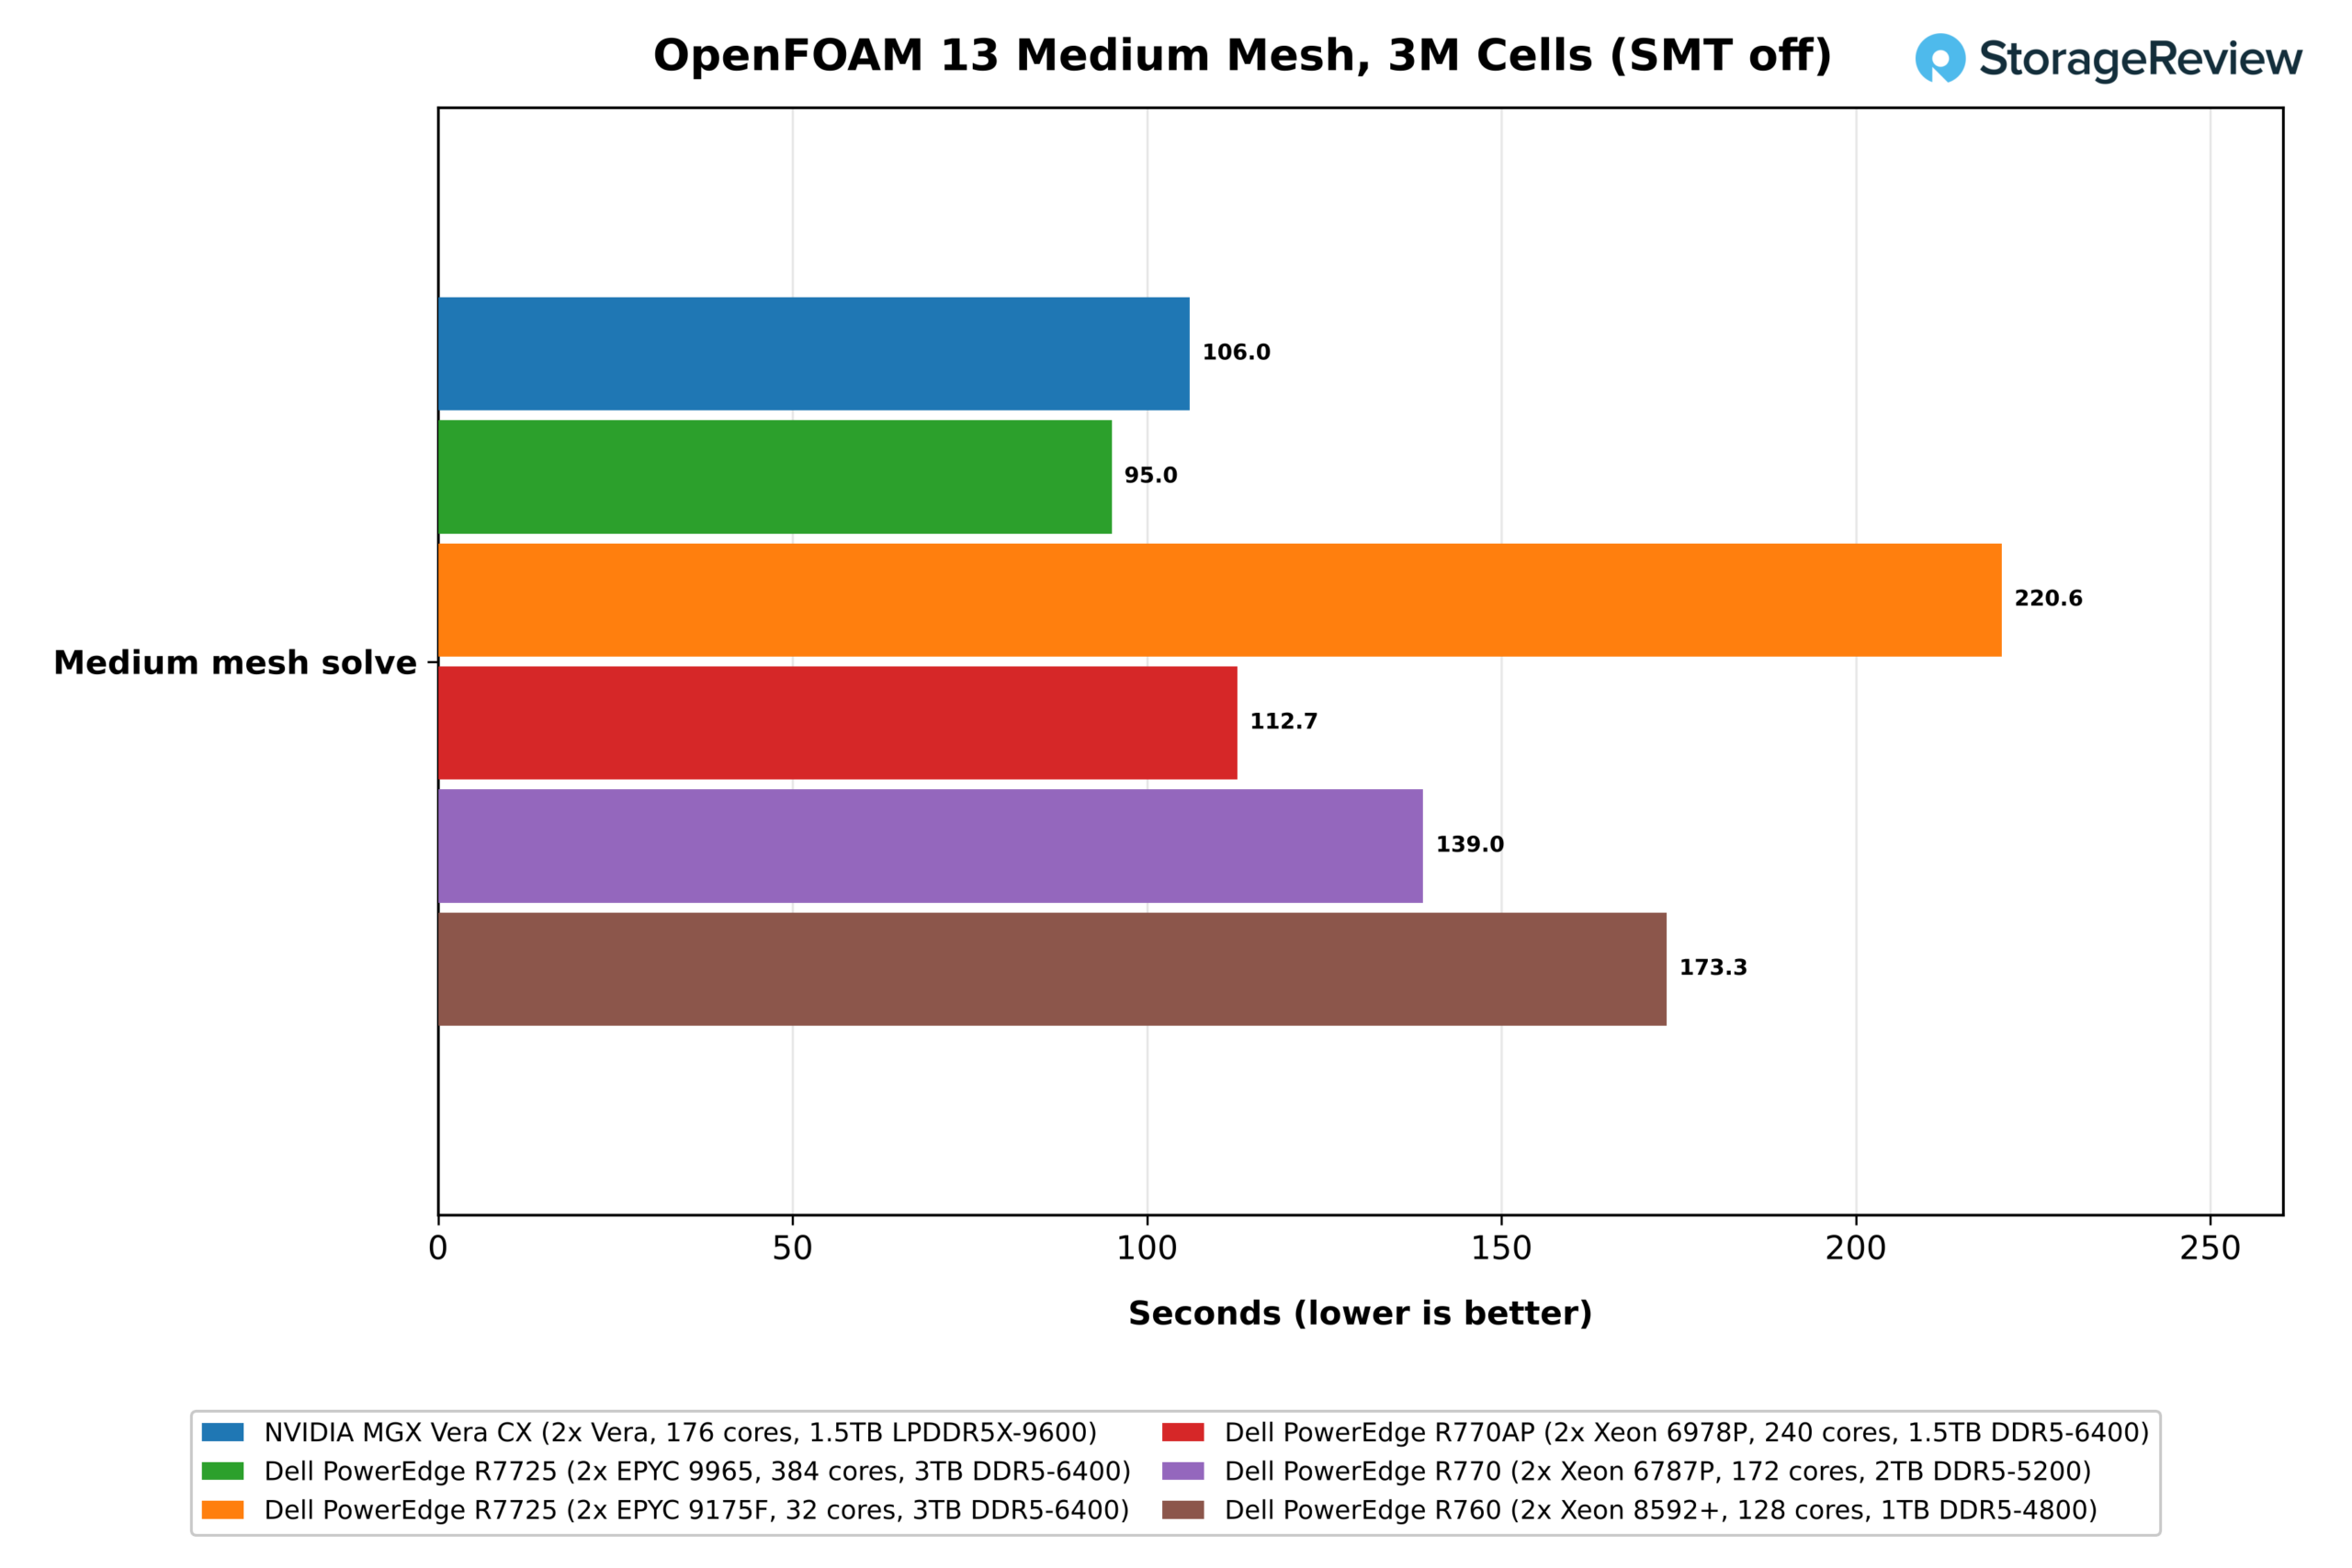
Vera는 중간 크기 메쉬를 106.0초 만에 해결했으며, EPYC 9965는 95.0초, Xeon 6978P는 112.7초, 6787P는 139.0초, 8592+는 173.3초, 32코어 9175F는 220.6초가 걸렸습니다. 이 크기에서는 384코어의 9965가 가장 빠른 성능을 보였고, Vera는 12% 더 오래 걸렸지만 240코어 Xeon보다 6% 앞서 두 번째로 빠른 결과를 기록했습니다. 3백만 개의 셀만 가진 x86 프로세서의 더 큰 L3 캐시가 더 많은 데이터를 저장하는 역할을 하는 것으로 보이며, 결국 코어 수가 성능을 좌우하는 요인이 됩니다.
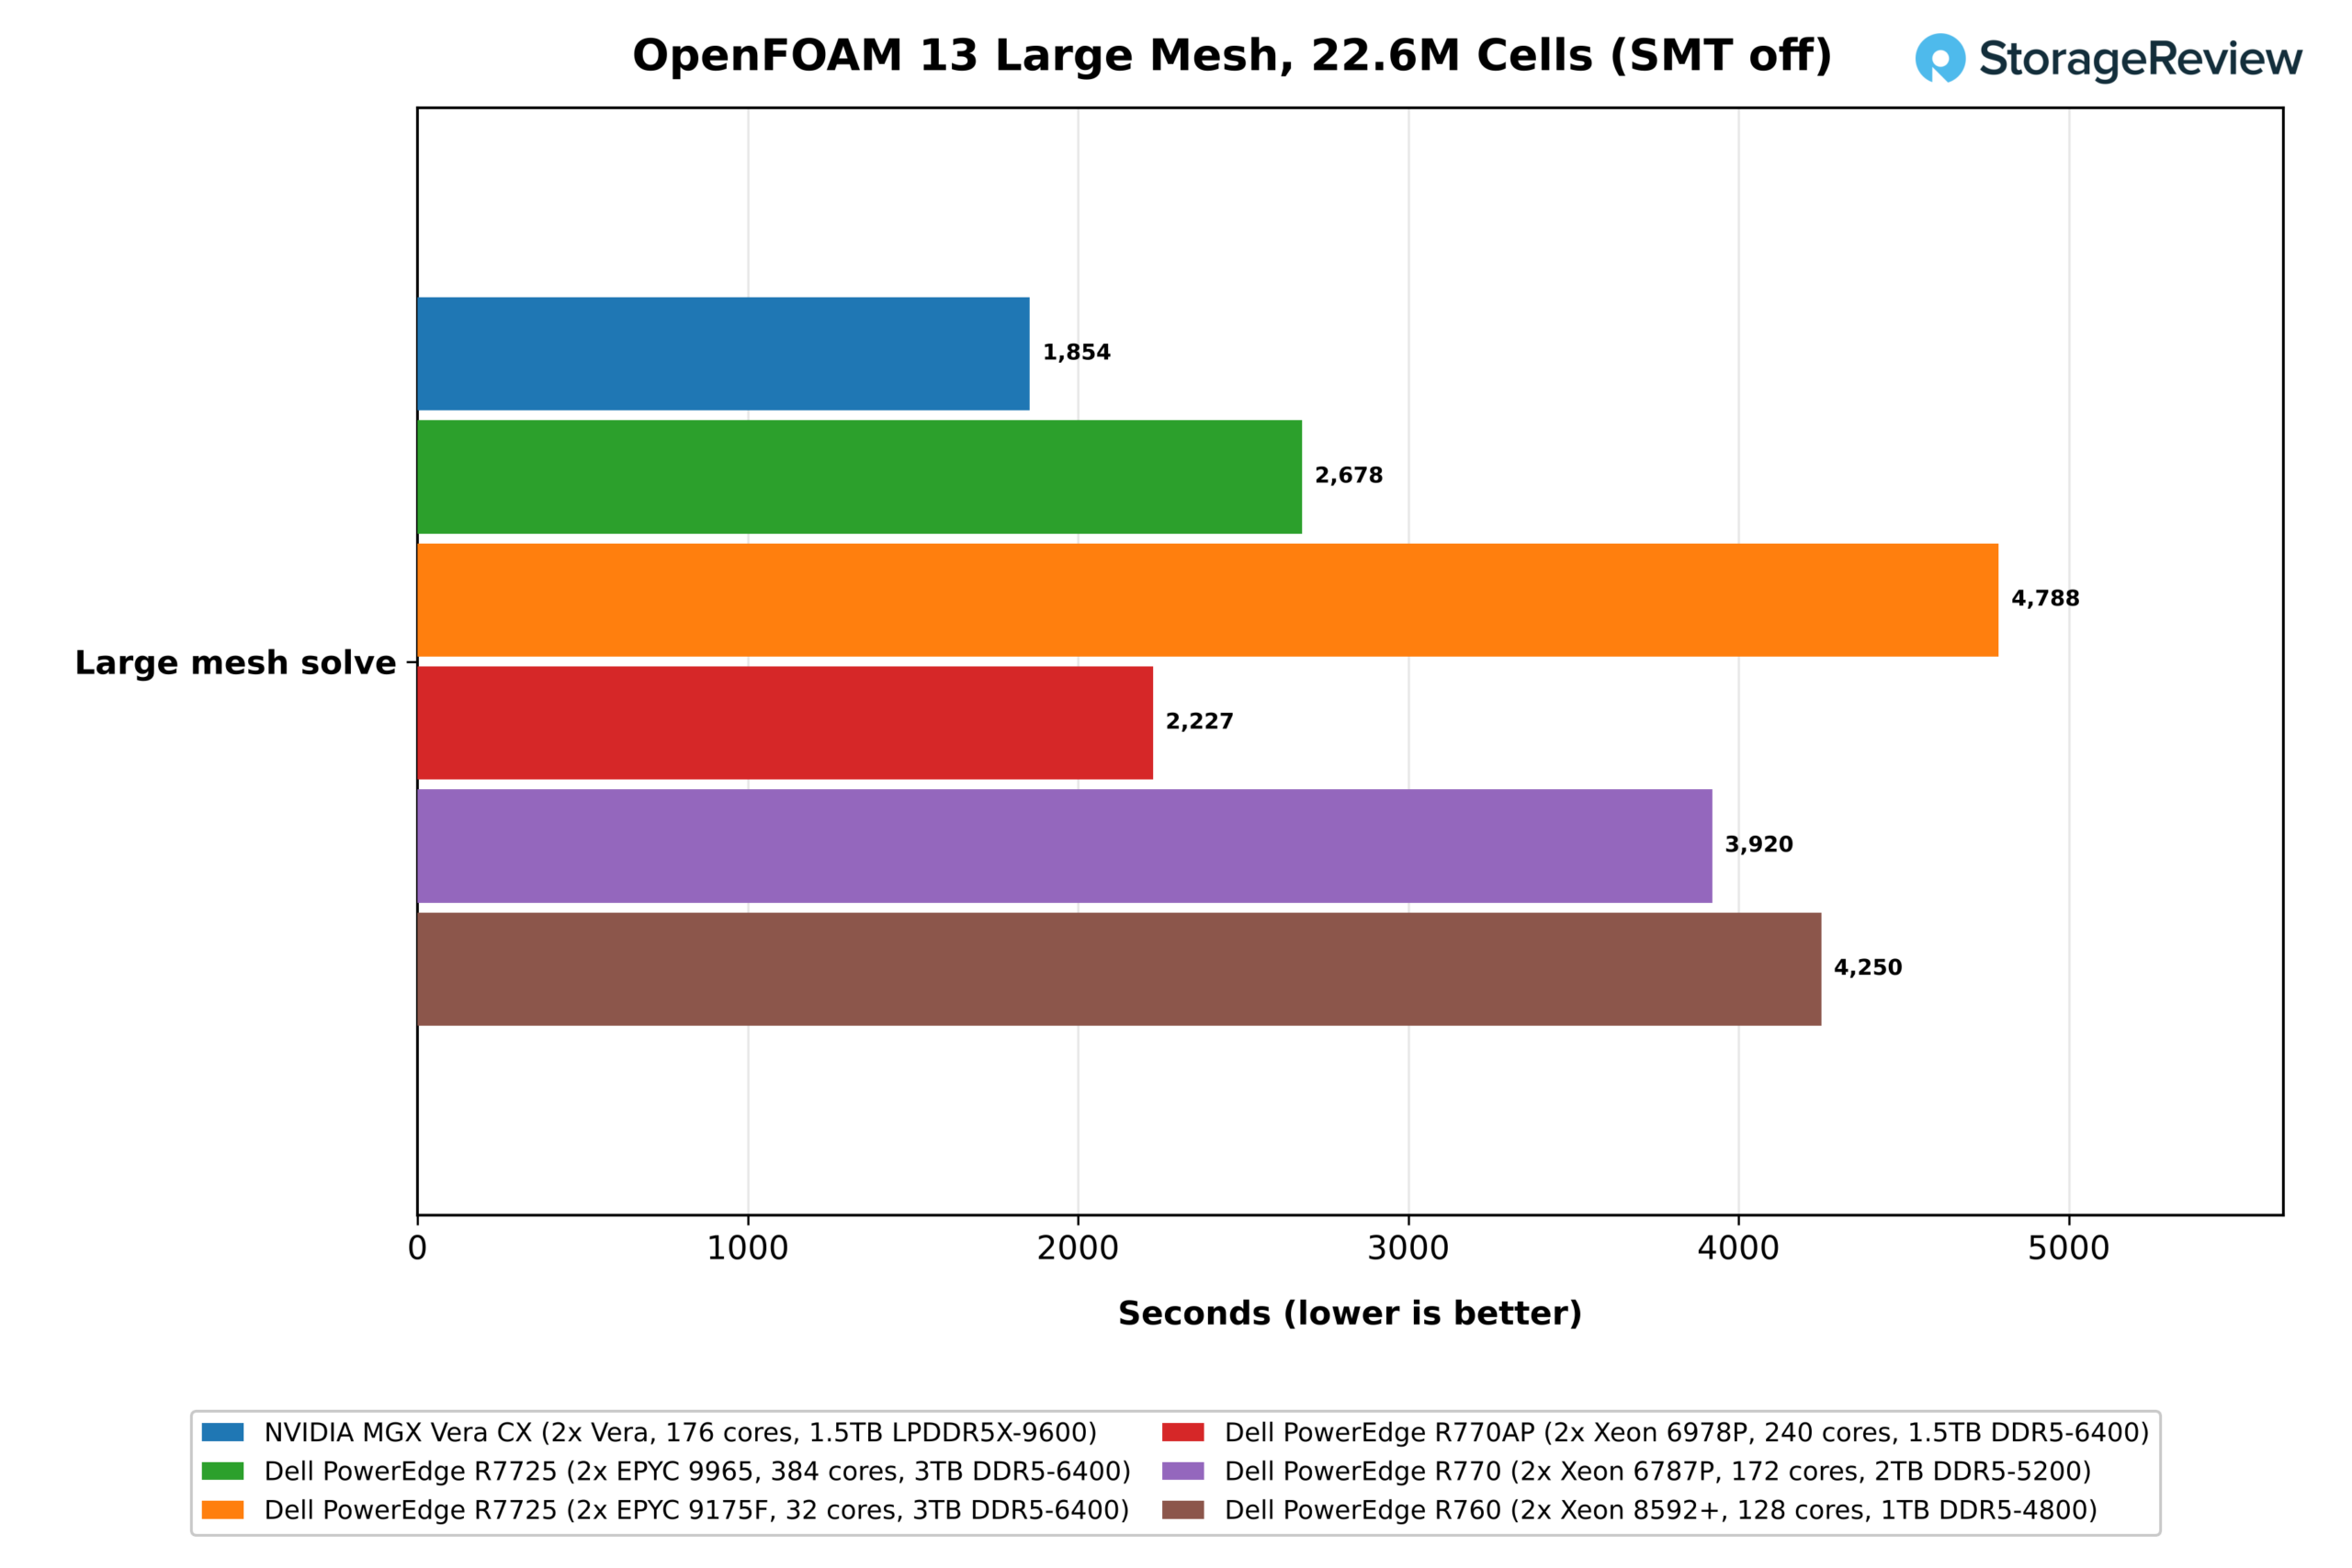
대규모 메시 테스트에서는 순서가 뒤바뀌어 Vera가 1,854초 만에 문제를 해결했는데, 이는 Xeon 6978P의 2,227초, EPYC 9965의 2,678초, 6787P의 3,920초, 8592+의 4,250초, 9175F의 4,788초보다 빠른 속도입니다. 따라서 Vera는 384코어 AMD 서버보다 1.44배, 240코어 Intel 서버보다 1.20배 빠릅니다. 또한 Vera는 소켓당 정격 최대 전력 소비량인 450W를 준수하는 반면, 9965는 500W를 준수합니다.
분석 및 인메모리 데이터
HPC 테스트 결과는 Vera의 대역폭이 과학 문제 해결 도구에 어떤 영향을 미치는지 보여주었습니다. 데이터 서비스는 동일한 메모리 시스템을 각기 다른 방식으로 활용하며, 두 가지 테스트는 정반대의 관점에서 메모리에 부하를 줍니다. ClickBench는 대규모 데이터 열을 스캔하고 집계하는 분석 쿼리를 실행하는데, 각 쿼리가 모든 코어에 분산되므로 코어 수가 많고 이를 처리할 수 있는 충분한 대역폭을 갖춘 시스템에 유리합니다. 반면, 인메모리 키-값 저장소인 Valkey는 각각 단일 값을 읽거나 쓰는 수백만 개의 작은 요청을 처리하므로, 개별 코어가 요청을 처리하는 속도와 데이터가 캐시 용량을 초과했을 때 메모리 지연 시간 및 대역폭에 더 크게 의존합니다.
클릭벤치
ClickHouse 26.8에서 100억 행 규모의 웹 분석 테이블을 대상으로 ClickBench를 사용하여 43개의 쿼리를 실행했습니다. 모든 쿼리가 페이지 캐시에서 데이터를 읽어오는 핫 합계는 시스템이 컬럼형 스캔 및 집계에 얼마나 많은 코어를 활용할 수 있는지, 그리고 메모리가 이러한 코어에 얼마나 효율적으로 데이터를 공급하는지를 측정합니다. 콜드 합계는 각 쿼리의 첫 번째 실행 전에 서버 재시작과 SSD 읽기 작업을 추가합니다.
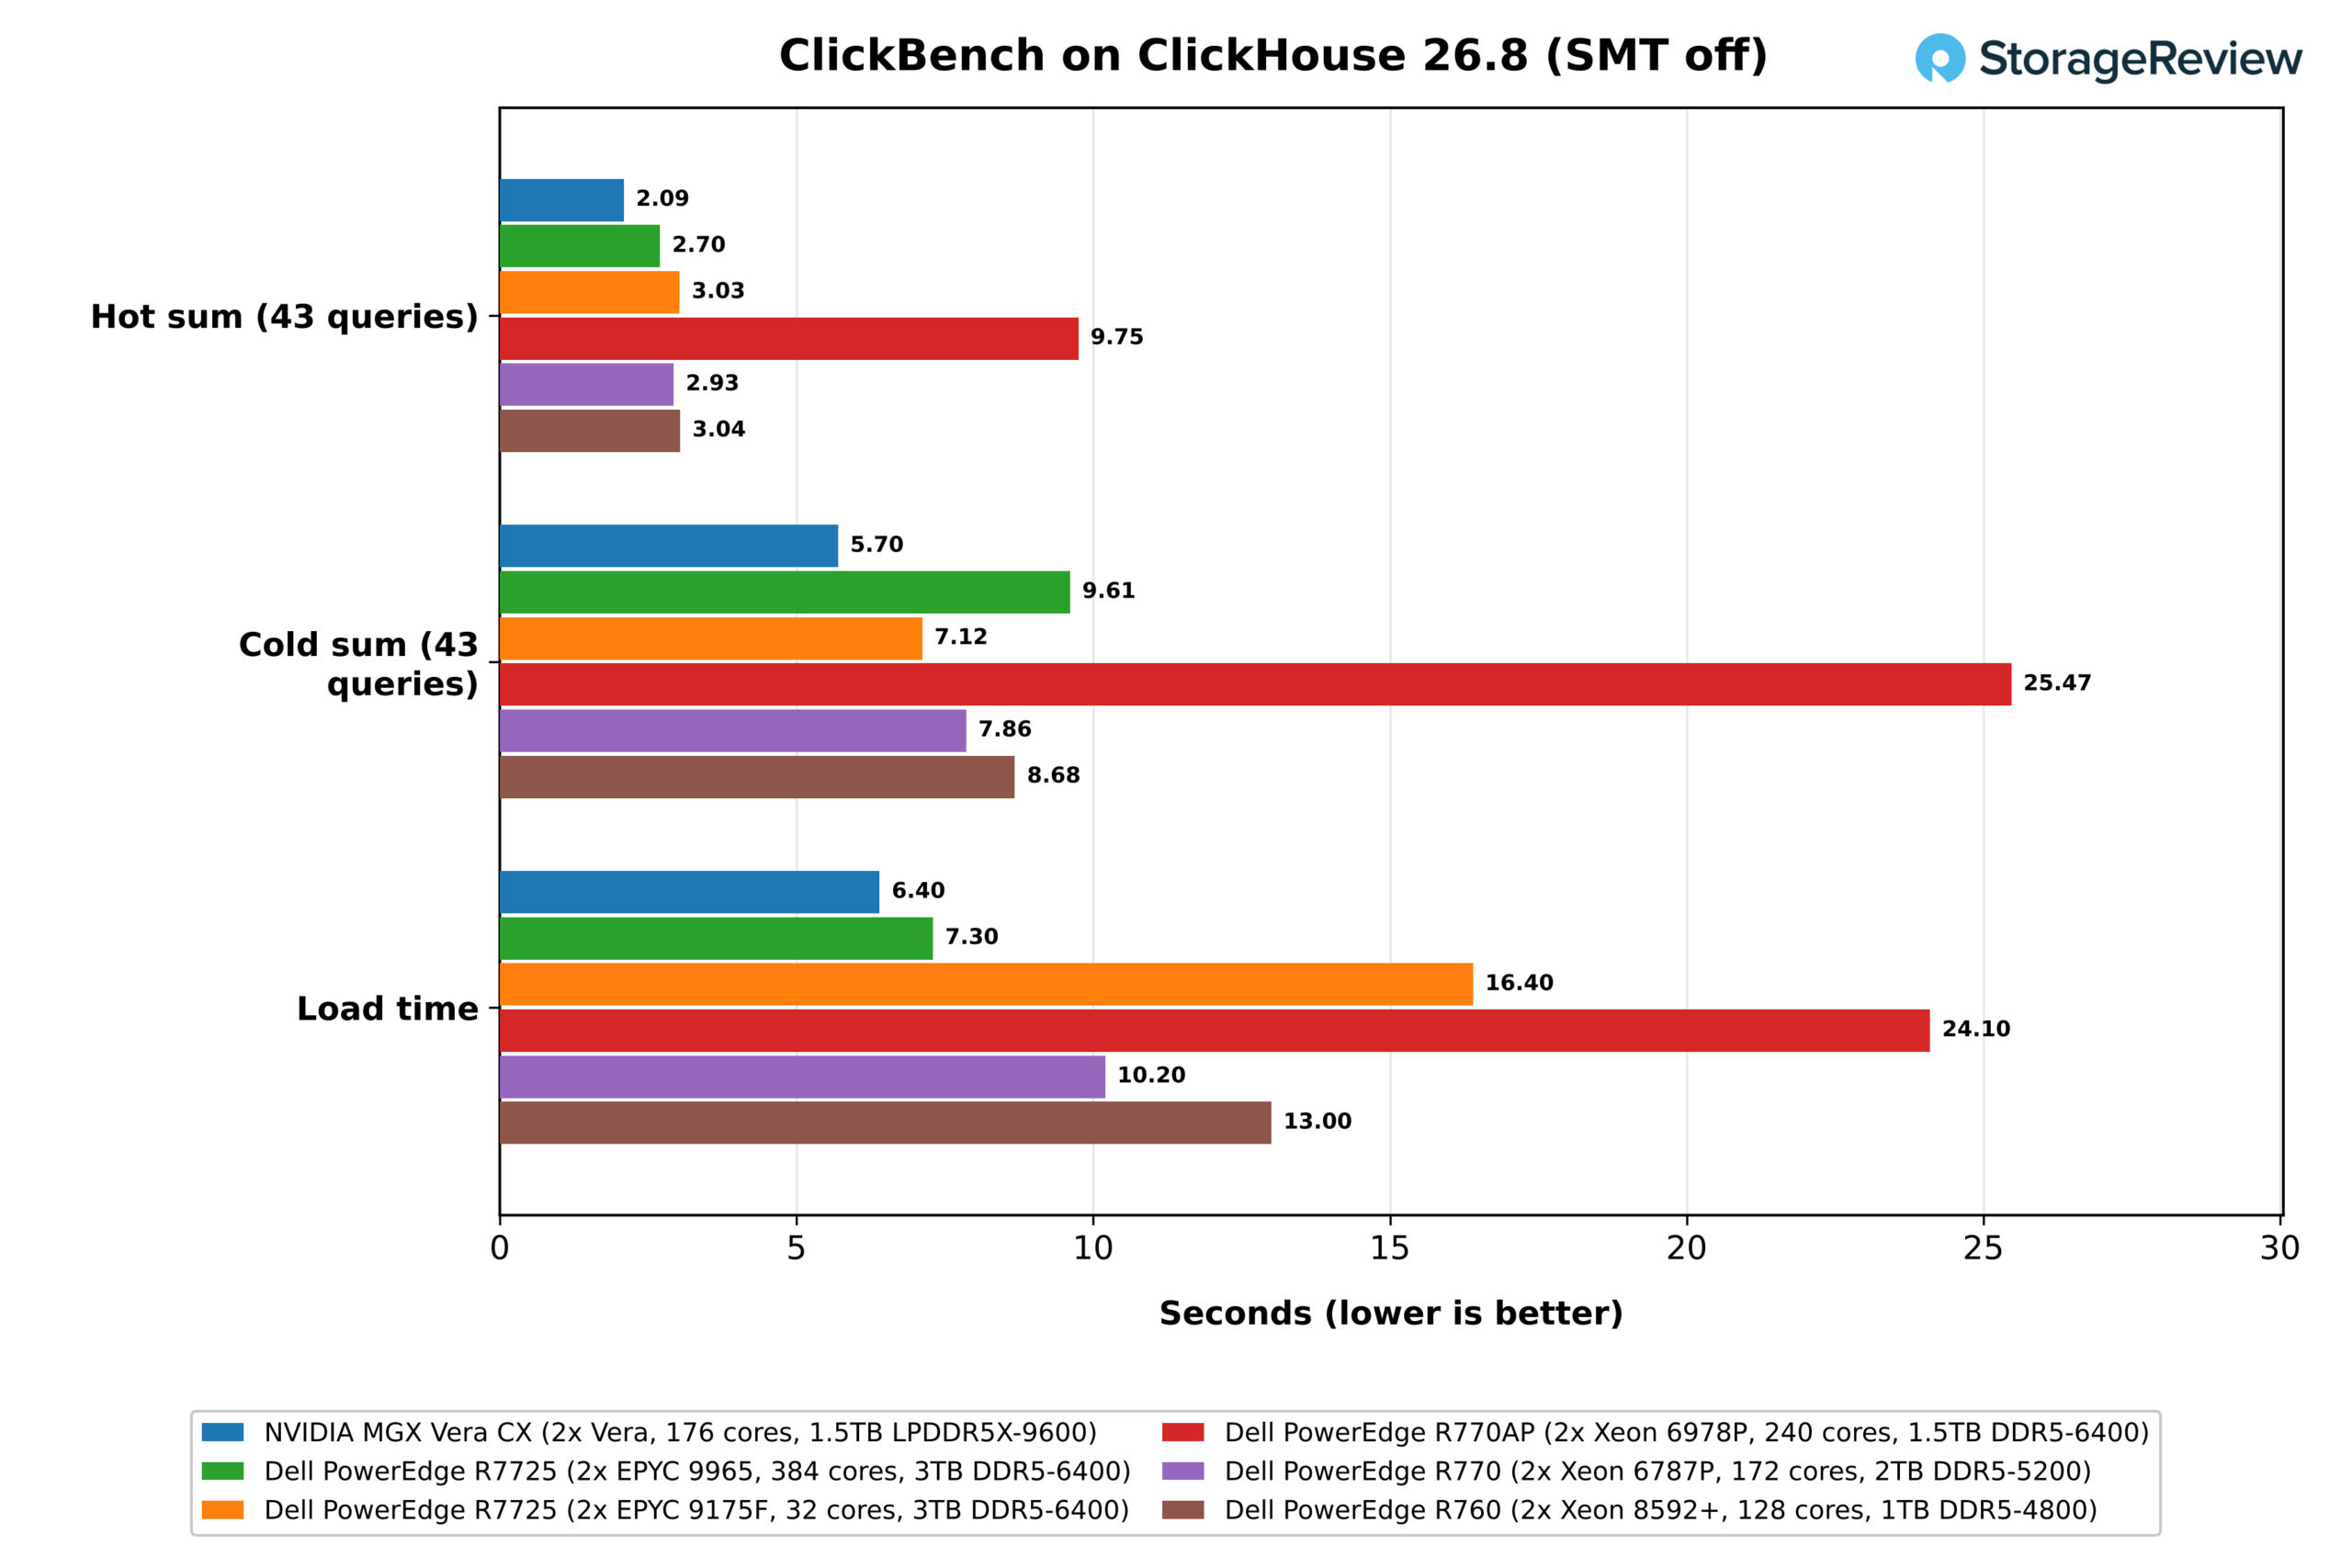
SMT를 끄고 테스트한 결과, Vera는 2.09초 만에 핫런을 완료하여 테스트 세트에서 가장 빠른 결과를 보였습니다. EPYC 9965는 2.70초로 Vera보다 1.29배 빠른 속도를 기록했으며, Xeon 6787P, EPYC 9175F, Xeon 8592+는 2.93초에서 3.04초 사이로 거의 비슷한 속도를 보였습니다. 이러한 속도 차이는 코어 수와 대역폭의 균형을 반영합니다. 384코어의 9965는 코어 수는 많지만 코어당 대역폭이 낮고, 32코어의 9175F는 그 반대이며, Vera는 176코어에 코어당 대역폭이 두 제품보다 세 배 이상 높습니다.
Vera는 5.70초로 콜드 런(냉각 후 부팅)에서도 가장 빠른 기록을 세웠으며, 그 뒤를 9175F(7.12초), 6787P(7.86초), 8592+(8.68초), 9965(9.61초)가 이었습니다. 콜드 런 성능은 저장 장치의 성능에 더 크게 좌우되며, 드라이브 연결 방식도 각기 다릅니다. Vera와 6787P는 Gen5 x4, 두 EPYC 시스템은 x2, 8592+는 Gen4를 사용합니다.
Vera는 15GB 데이터셋을 6.4초 만에 로드하여 9965의 7.3초, 나머지 프로세서의 10.2~16.4초보다 빠른 속도를 보였습니다. Xeon 6978P는 로드 시간 9.75초(실행 시)와 25.47초(실행 시)로 다른 Xeon 프로세서들과 큰 차이를 보였는데, 그 이유는 아직 밝혀지지 않았으므로 순위에서 제외했습니다.
공간 멀티스레딩을 활성화하자 Vera의 처리 속도가 핫 모드에서 2.31초, 콜드 모드에서 6.09초로 느려졌으며, 이는 핫 모드 처리 속도에서 10%의 페널티가 발생한 것입니다. 각 코어의 리소스를 두 개의 스레드로 분할하는 것은 ClickHouse의 스캔 속도에 이득보다 손해를 더 많이 가져왔습니다.
발키
Valkey는 단일 메인 스레드에서 명령을 실행하며, I/O 스레드는 일정 수준까지만 지원합니다. 따라서 배포 규모는 샤드를 추가하여 확장할 수 있는데, 한 인스턴스에 코어를 더 할당해도 성능 향상은 미미하기 때문입니다. 본 연구에서는 Valkey를 두 가지 방식으로 분석합니다. 첫째, 동일한 코어를 할당받았을 때 단일 샤드의 성능을, 둘째, 소켓에 여러 샤드를 연결했을 때 각 샤드의 성능을 비교합니다. 두 테스트 모두 클라이언트는 동일한 머신의 다른 소켓에서 실행되므로 네트워크 카드는 사용되지 않습니다.
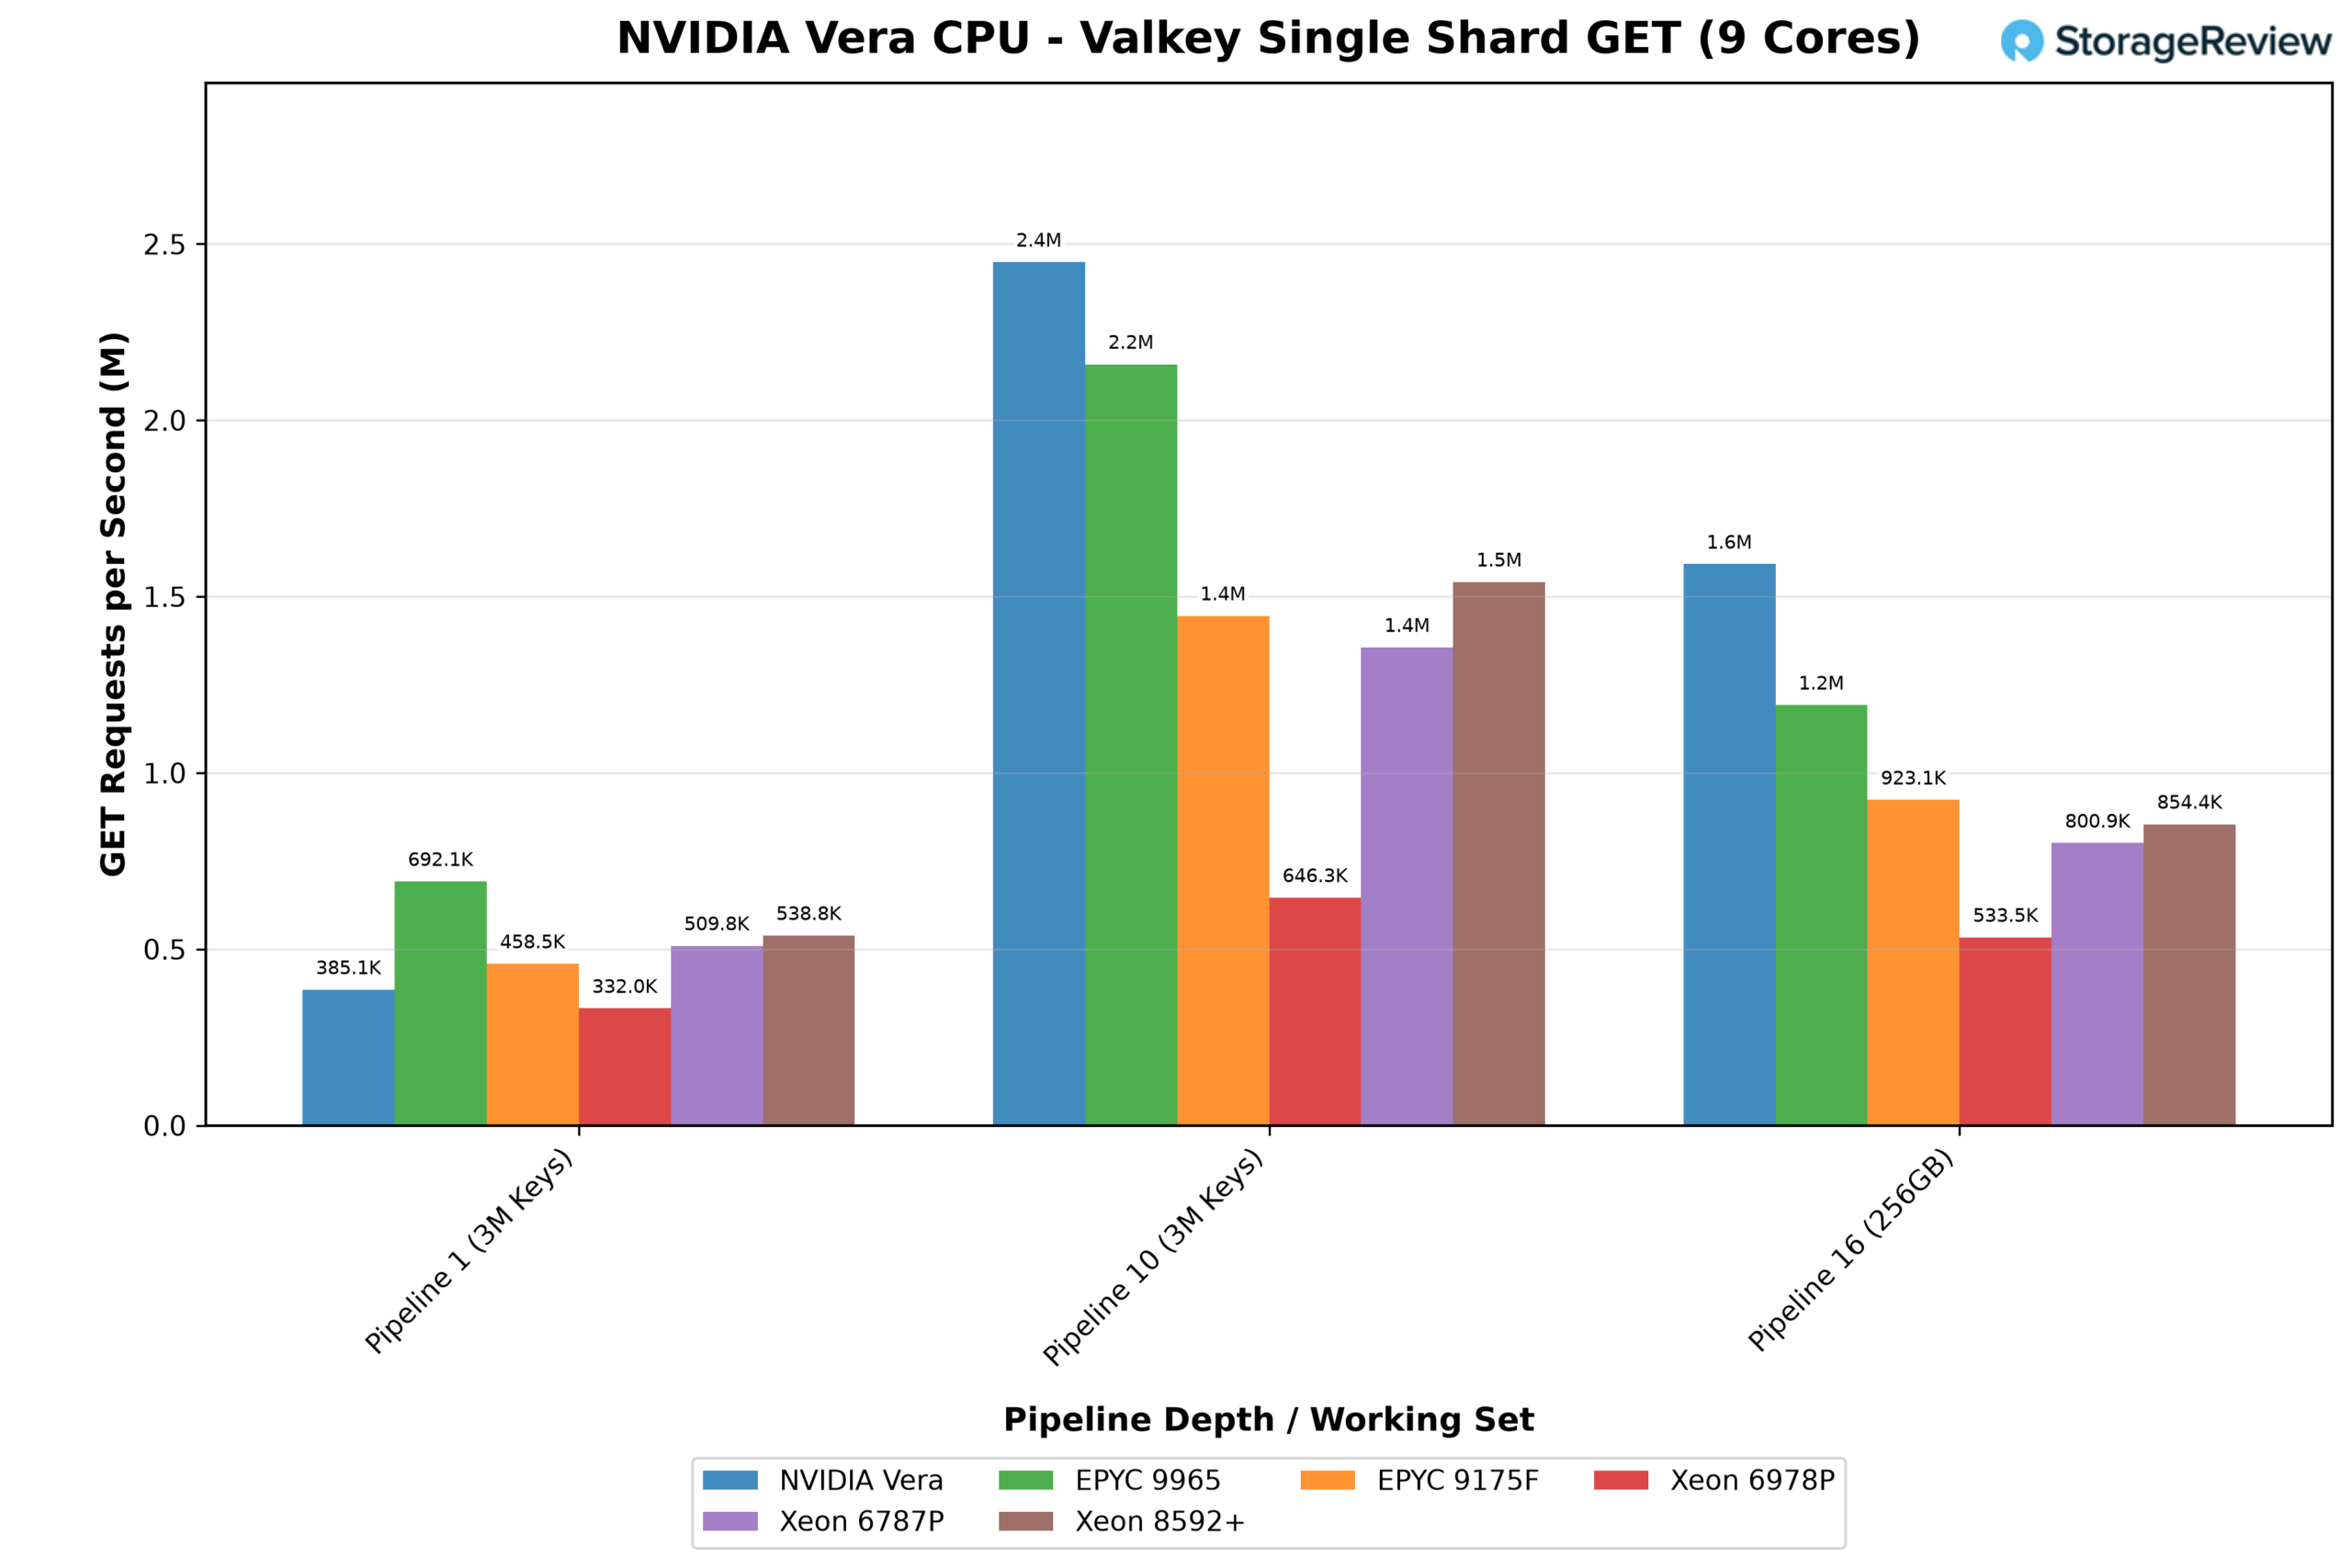
단일 샤드 테스트에서는 각 플랫폼에서 하나의 Valkey 서버에 9개의 물리적 코어를 할당합니다. 이 서버는 300만 개의 키로 구성된 데이터 세트를 처리하는데, 요청은 하나씩 순차적으로 전송된 후 10개씩 배치로 전송됩니다. 그 다음에는 캐시 용량을 초과하는 256GB 데이터 세트를 16개씩 배치로 전송합니다. 요청이 하나씩 순차적으로 전송될 때, 각 요청은 다음 요청이 전송되기 전에 왕복 통신을 완료해야 하는데, 바로 이 부분에서 Vera의 성능이 가장 취약합니다. Vera의 샤드는 초당 385,000개의 GET 요청을 처리했는데, 이는 Xeon 6978P에 이어 두 번째로 높은 수치이며, EPYC 9965는 692,000개로 가장 높은 성능을 보였습니다. Vera의 p99 지연 시간 또한 1.76ms로, 9965의 1.08ms보다 높았습니다.
배치 처리를 통해 왕복 비용이 대부분 제거되면서 Vera가 선두로 나섰습니다. 10개 배치로 처리했을 때 Vera 샤드는 초당 2.45만 건의 GET 요청을 처리했는데, 이는 9965보다 13% 더 높은 수치이며 모든 Xeon 프로세서보다 훨씬 앞선 기록입니다. 256GB 데이터 세트에서는 격차가 더욱 벌어졌습니다. 거의 모든 요청이 메모리로 전송되는 상황에서 Vera는 초당 1.59만 건의 GET 요청을 처리했는데, 이는 9965보다 34% 더 높은 수치이며, 나머지 프로세서들은 0.53만 건에서 0.92만 건 사이의 처리량을 보였습니다. SET 테스트 결과도 두 테스트 모두에서 동일한 양상을 보였습니다.
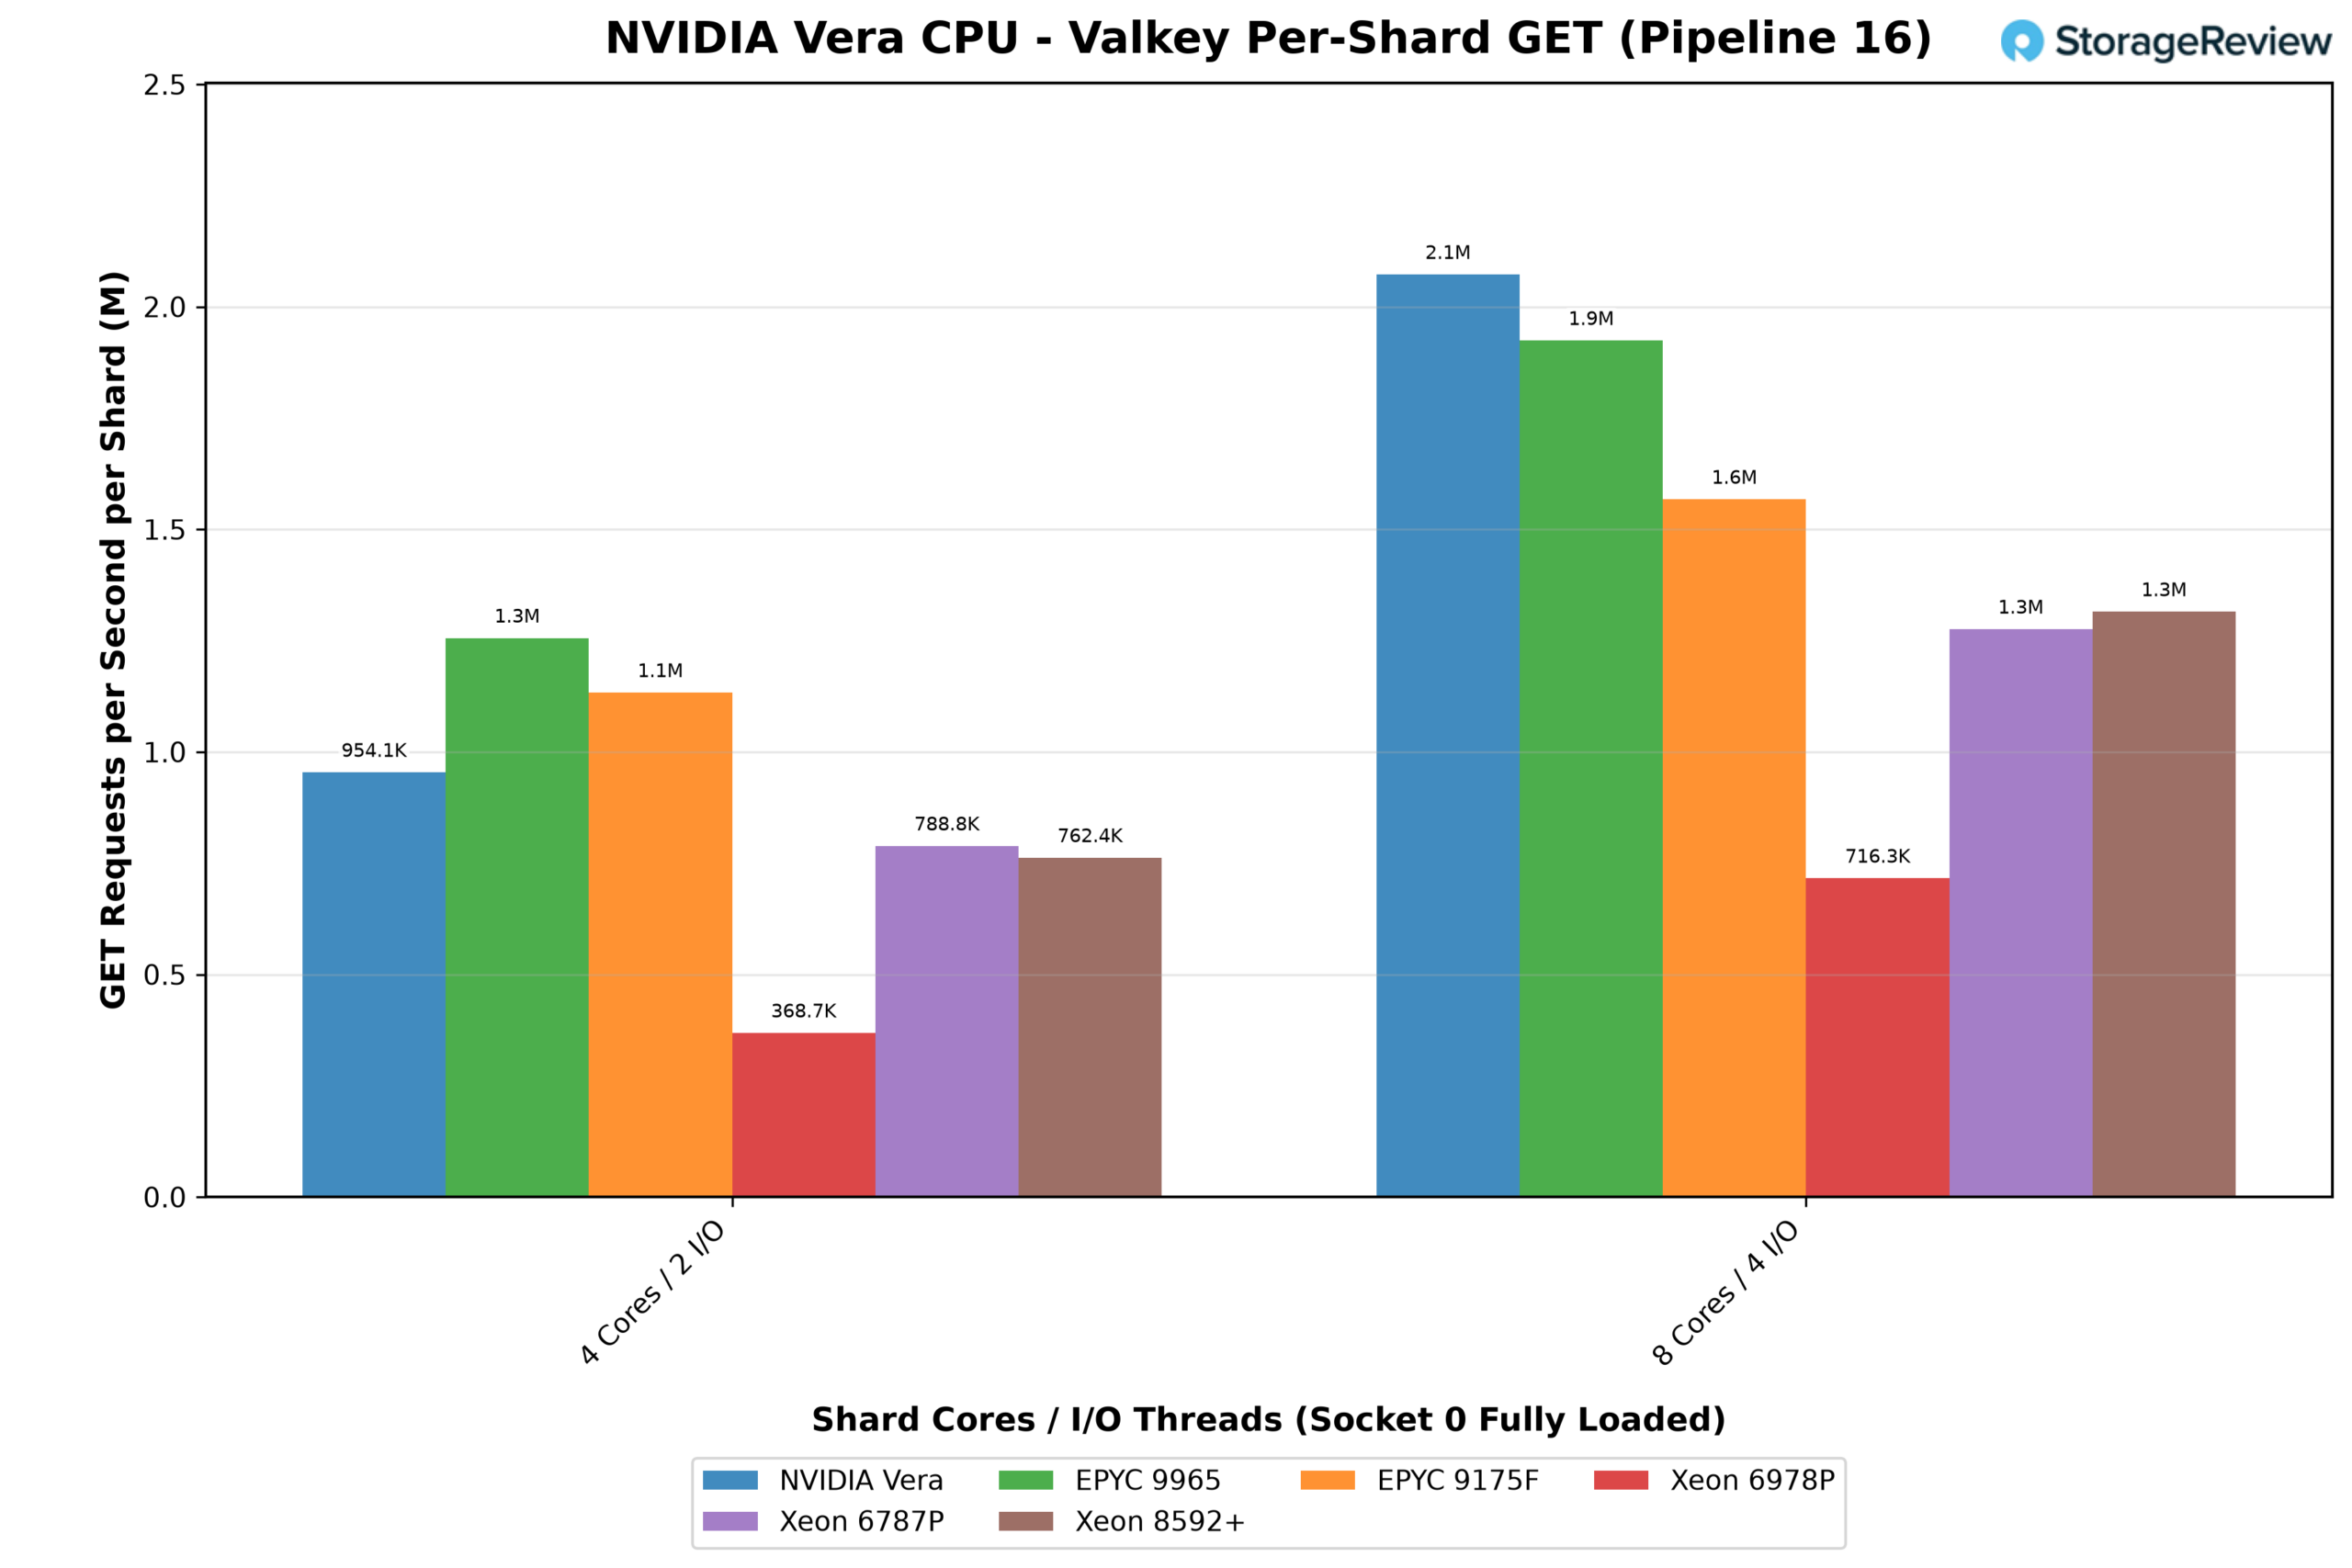
소켓 모드는 소켓 0에 4개 또는 8개의 코어로 구성된 동일한 샤드를 배치하여 모든 샤드가 동시에 트래픽을 처리하도록 하는데, 이는 전용 Valkey 호스트의 작동 방식과 더 유사합니다. 8코어 샤드와 16개 배치로 구성된 환경에서 각 Vera 샤드는 초당 2.07만 건의 GET 요청을 처리했는데, 이는 9965의 1.92만 건을 앞서고 Xeon 6787P 및 8592+보다 약 1.6배 빠른 속도입니다. 다만, p99 지연 시간은 9965의 약 0.5ms에 비해 2.2ms로 증가했습니다.
더 작은 4코어 샤드에서는 AMD가 우위를 점했습니다. 9965는 샤드당 1.26M GET으로 Vera의 0.95M을 앞섰지만, Vera는 여전히 모든 Xeon 프로세서 중에서 가장 빠른 성능을 보였습니다. 요청을 한 번에 하나씩 전송하는 방식에서는 9965의 샤드가 크기에 관계없이 Vera보다 1.5배에서 1.7배 빨랐으며, 6787P와 8592+ 또한 8코어 샤드에서 앞섰습니다.
소켓의 총 처리량은 밀도에 따라 결정됩니다. Vera 소켓은 8코어 샤드 11개를 수용하여 초당 2280만 건의 GET 요청을 처리하는 반면, 9965는 192개의 코어를 통해 4코어 샤드 48개를 수용하여 초당 6030만 건의 요청을 처리합니다. 각 샤드에 8개 이상의 코어가 할당되고 요청이 일괄 처리될 경우 Vera가 가장 빠른 샤드 처리 속도를 제공하지만, 9965는 소켓에 Vera보다 두 배 이상 많은 샤드를 수용할 수 있습니다.
단일 스레드 및 처리량
Valkey와 ClickBench는 코어만큼이나 메모리 시스템에 크게 의존했습니다. 이 섹션에서는 코어 자체와 앞서 설명한 Olympus의 두 가지 목표, 즉 개별 작업을 빠르게 완료하고 전체 소켓이 사용 중일 때에도 그 속도를 유지하는 것에 대해 살펴봅니다. 7-Zip, OpenSSL, Python은 각각 하나의 코어에 고정된 단일 스레드로 실행되어 Olympus 코어가 단독으로 수행할 수 있는 성능을 보여줍니다. 그런 다음 7-Zip과 OpenSSL을 시스템의 모든 스레드에서 다시 실행하여 모든 코어가 동일한 캐시와 메모리를 놓고 경쟁할 때 코어별 속도가 얼마나 유지되는지 보여줍니다.
7 - 우편 번호
7-Zip의 LZMA 압축은 분기가 많고 메모리 접근이 예측 불가능한 정수 코드이며, 이는 Olympus의 10개 비트 단위 프런트엔드와 그래프 프리페처가 설계된 목적과 일치합니다.
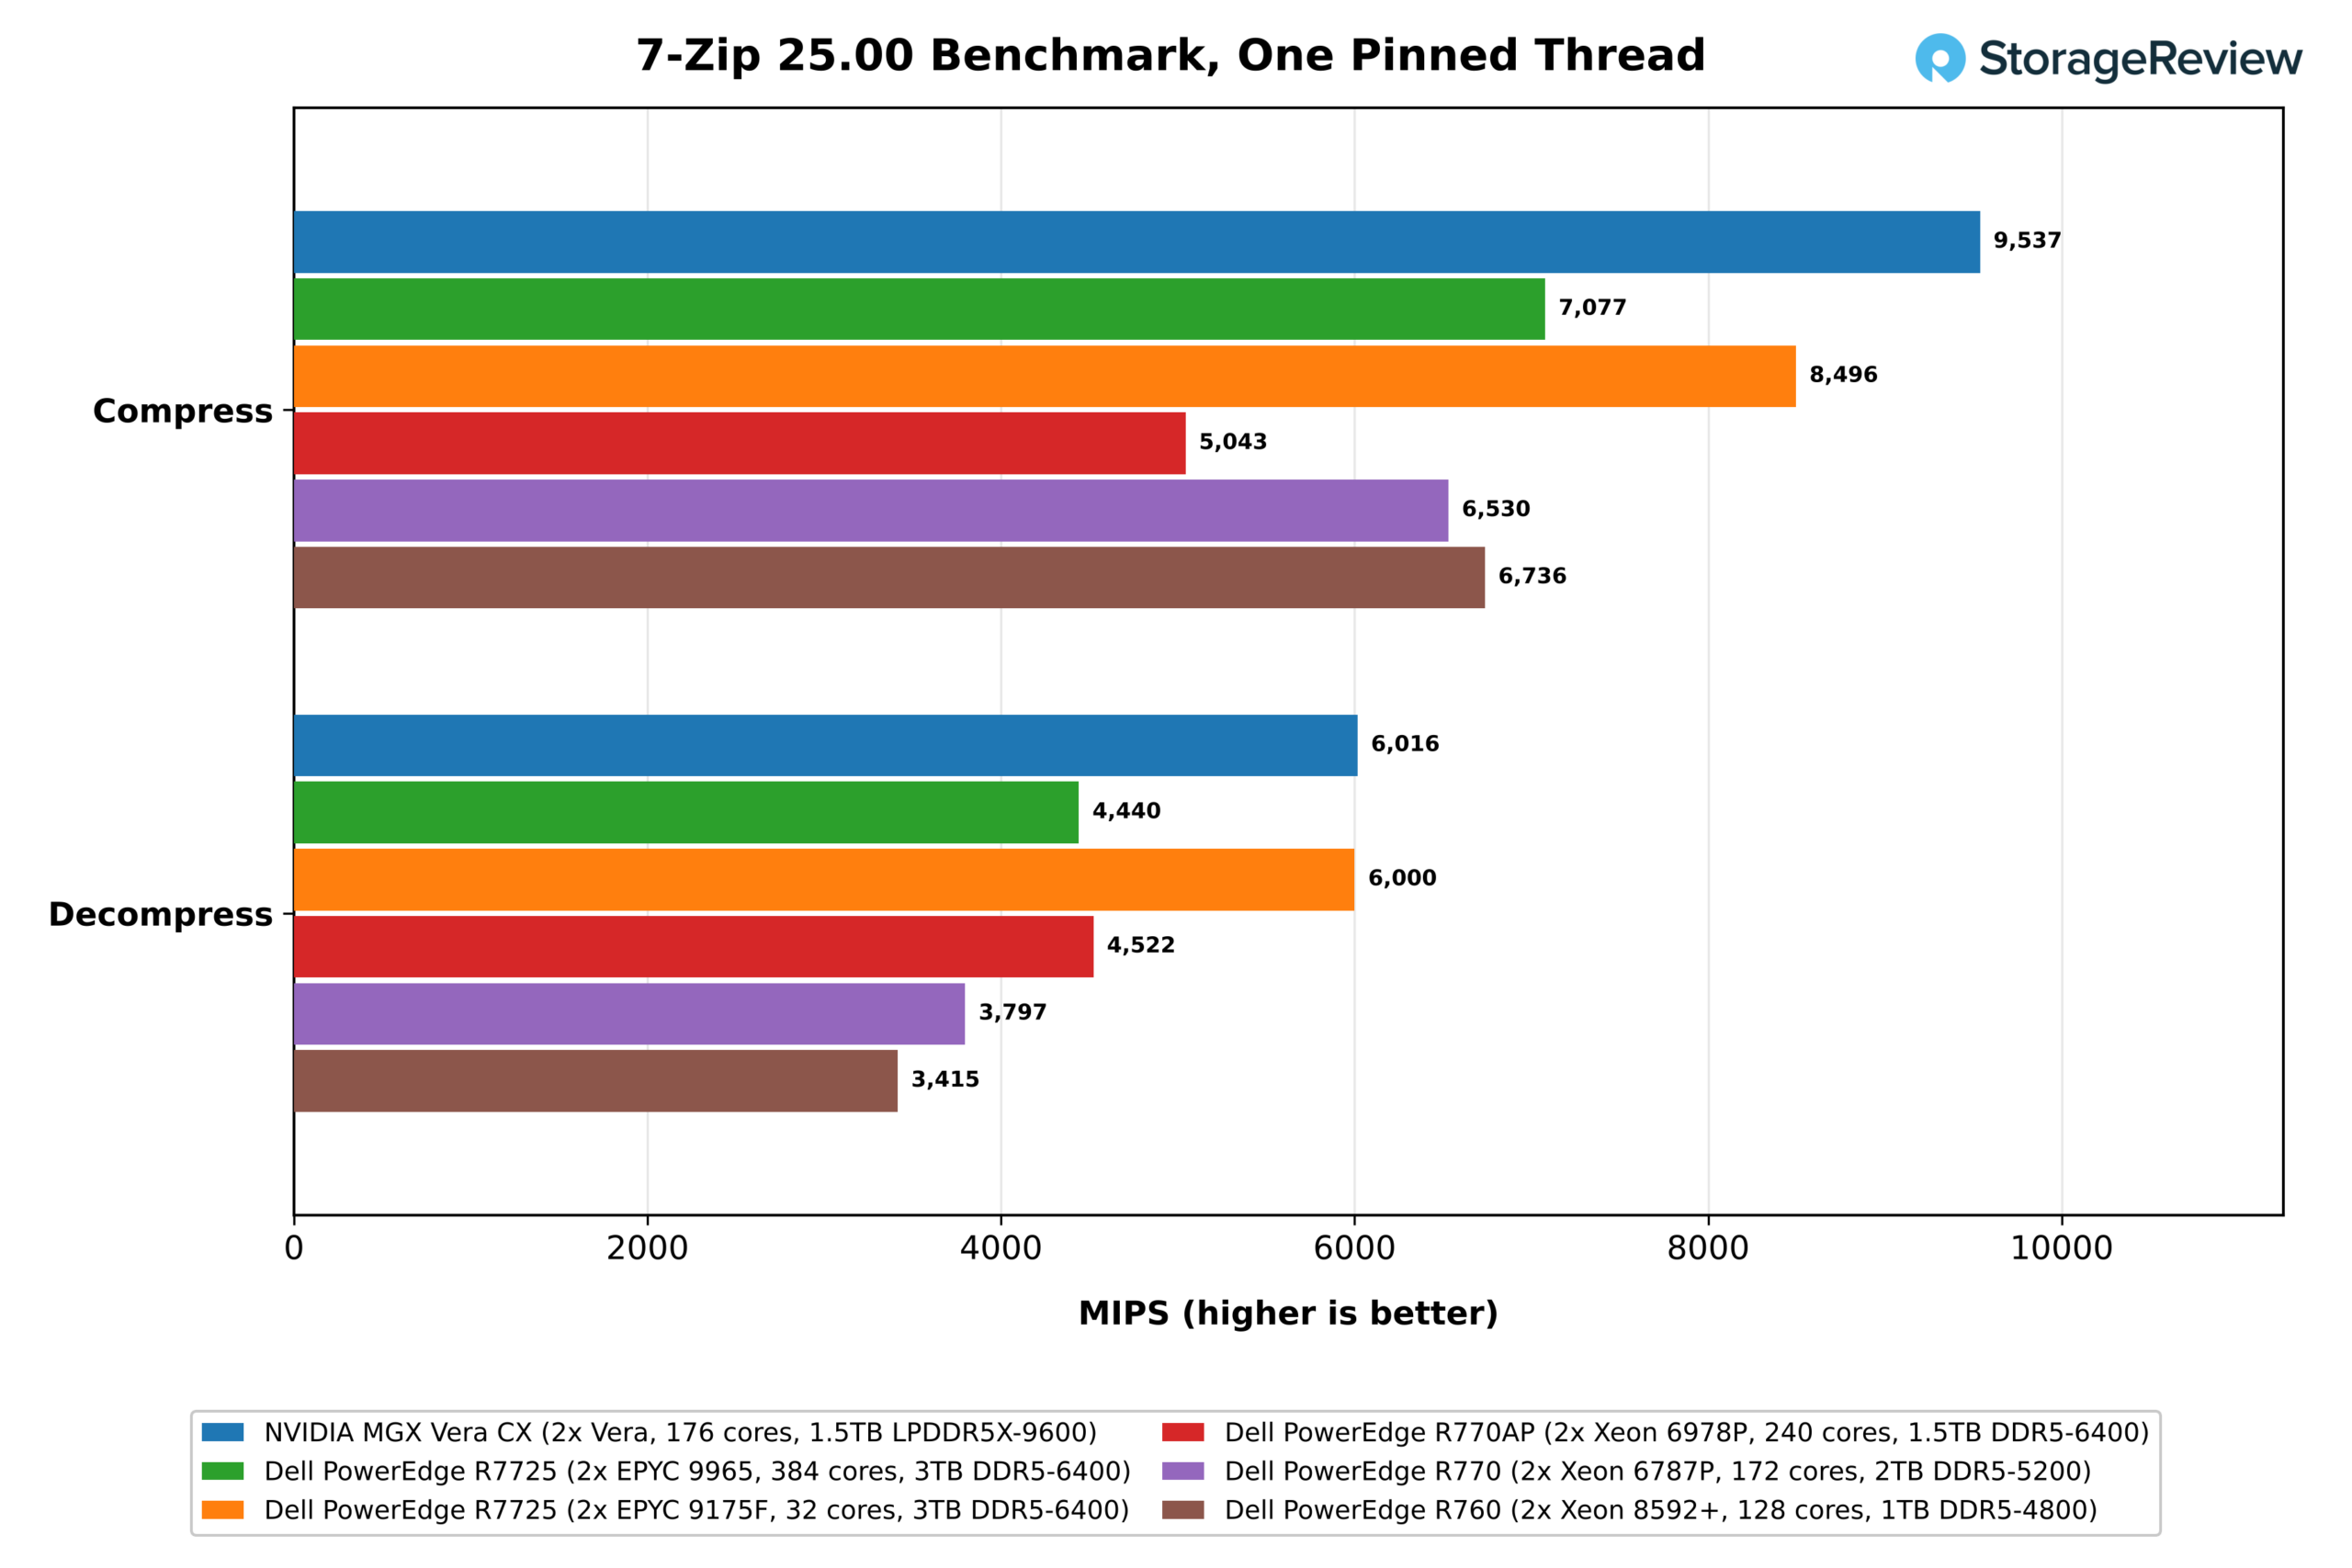
단일 스레드 성능에서 올림푸스는 테스트 대상 중 가장 빠른 압축 속도를 기록했습니다. 9,537 MIPS에 도달하여, 가장 빠른 x86 코어인 5.0GHz EPYC 9175F보다 12% 앞섰으며, EPYC 9965와 모든 Xeon 프로세서보다 훨씬 우수했습니다. 압축 해제 성능은 Vera가 6,016 MIPS, 9175F가 6,000 MIPS로 거의 동일했으며, 다른 시스템들은 20% 이내의 차이를 보였습니다.
모든 스레드를 실행해 보면 전체 시스템이 바쁠 때 리드가 얼마나 유지되는지 알 수 있습니다.
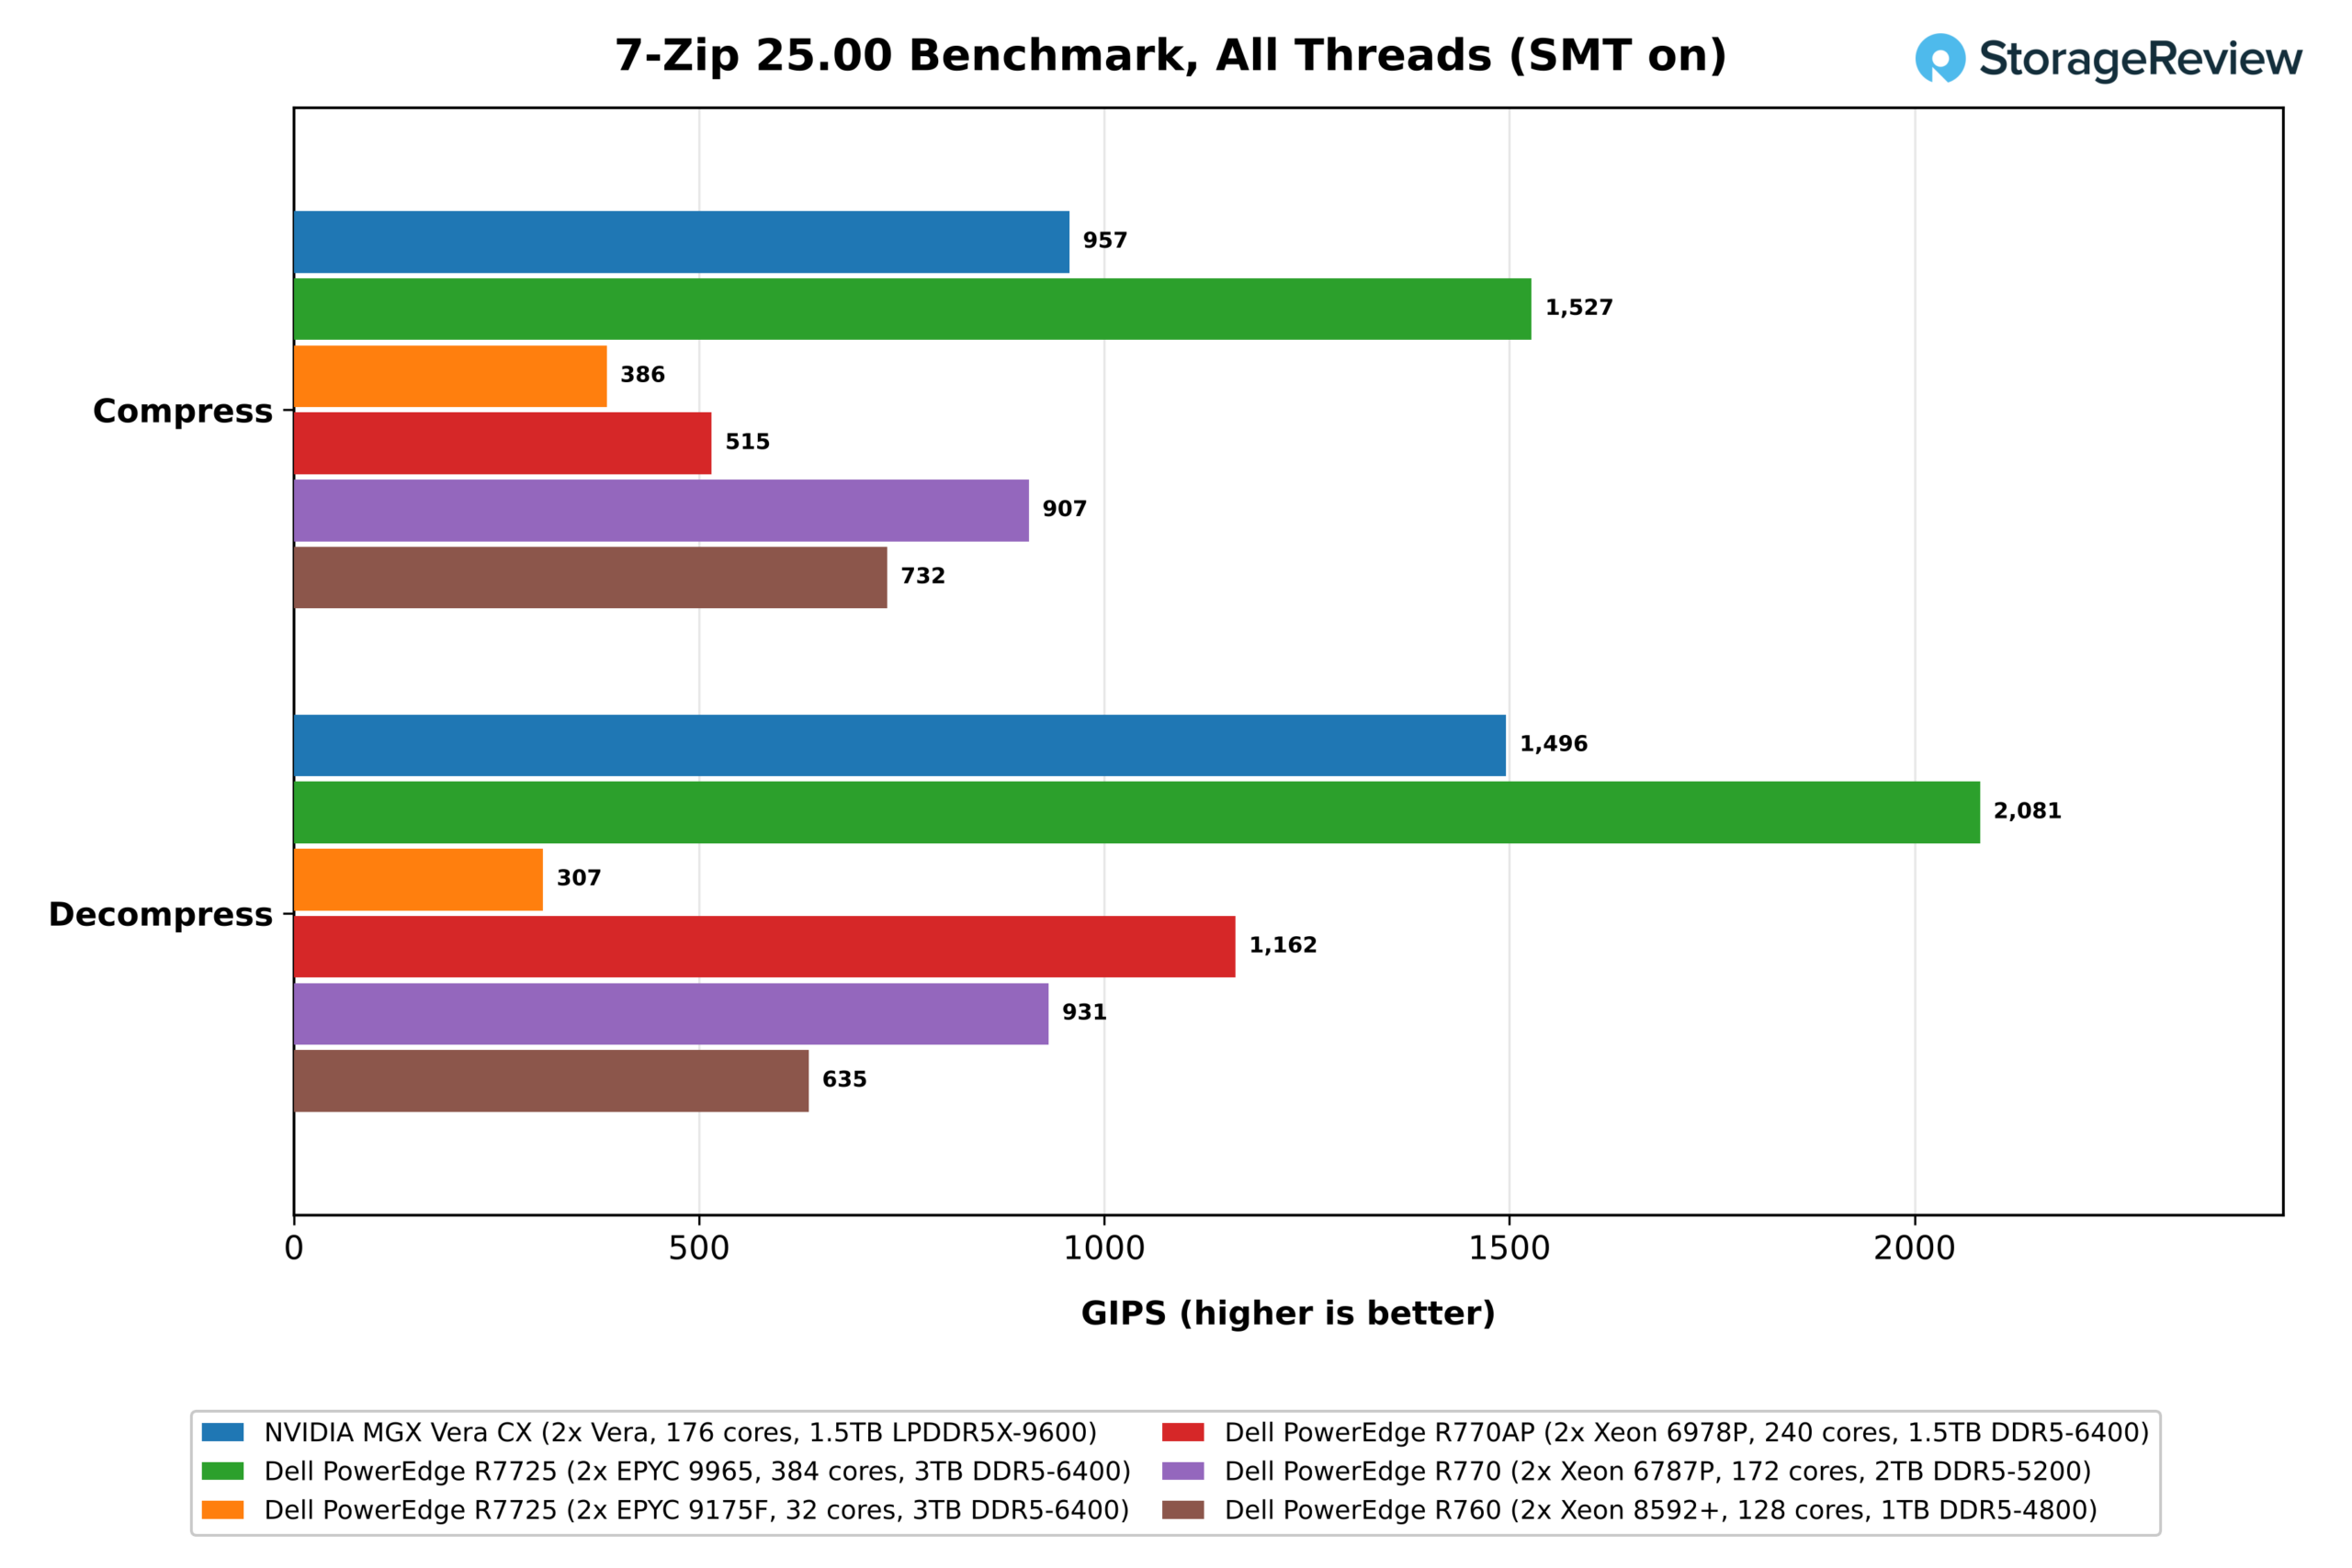
모든 스레드가 활발하게 작동한 결과, EPYC 9965의 768개 스레드는 압축에서 1,527 GIPS, 압축 해제에서 2,081 GIPS를 기록하며 1위를 차지했습니다. Vera의 352개 스레드는 957 GIPS와 1,496 GIPS로 2위를 기록하며 모든 Xeon 프로세서를 앞섰고, 6787P가 907 GIPS와 931 GIPS로 그 뒤를 바짝 쫓았습니다. 물리적 코어당 성능도 우수합니다. 코어당 5.4 GIPS의 압축 성능은 6787P 및 8592+와 동일하며 9965의 4.0 GIPS를 능가하고, 코어당 8.5 GIPS의 압축 성능은 9965보다 57% 높으며 모든 Xeon 프로세서를 앞섭니다. 소켓의 캐시와 메모리를 공유하는 코어 수가 훨씬 적은 32코어 9175F만이 코어당 성능 면에서 Vera보다 우수했습니다.
OpenSSL을
OpenSSL의 AES-256-GCM 테스트는 Vera가 가장 큰 약점을 보이는 부분입니다. Olympus의 6개 128비트 SVE2 파이프 중 암호화 명령어를 실행할 수 있는 것은 단 2개뿐인 반면, x86 아키텍처 기반의 Vera는 VAES를 사용하여 512비트 레지스터에서 AES를 실행할 수 있습니다.
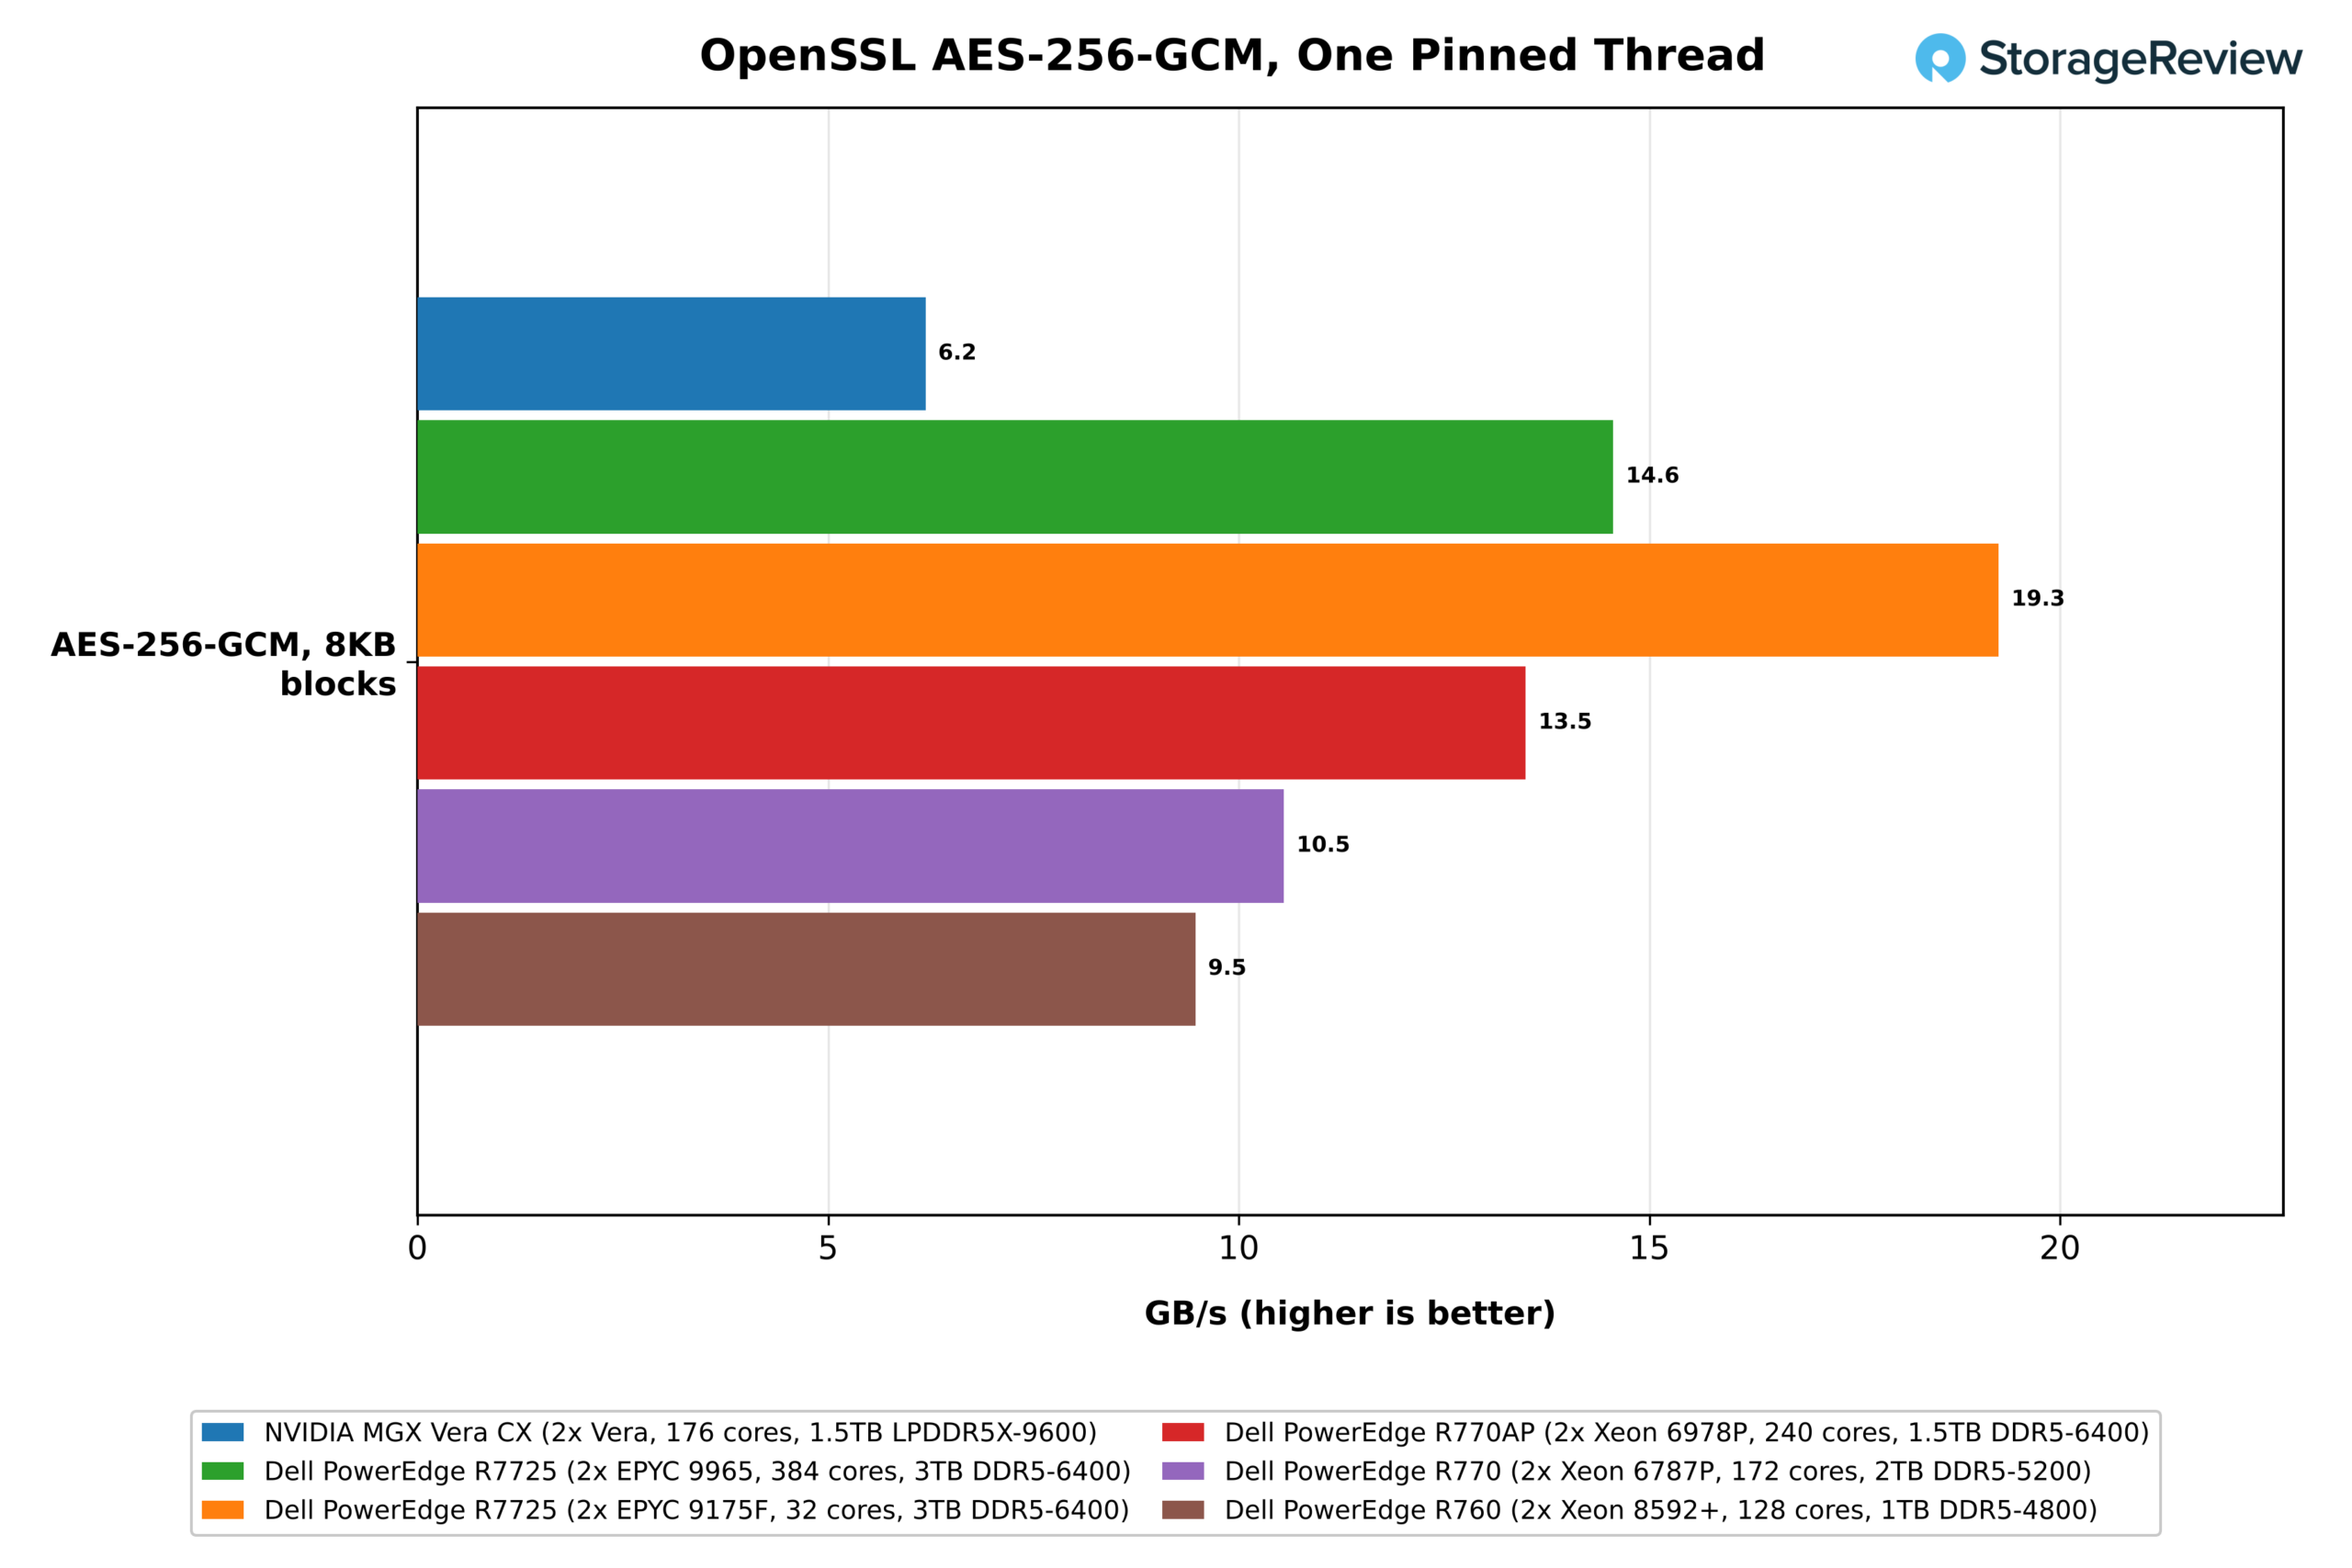
성능 차이는 단일 스레드에서 가장 확연히 드러납니다. 올림푸스 코어 하나는 6.2GB/s의 암호화 속도를 보였는데, 이는 EPYC 9175F의 19.3GB/s의 약 3분의 1 수준이며, EPYC 9965의 14.6GB/s와 Xeon 6978P의 13.5GB/s에도 훨씬 못 미칩니다.
모든 스레드에서 x86 시스템은 코어 수 순으로 정렬되는데, 이는 코어당 성능 부족이 Vera에 어떤 영향을 미치는지 보여줍니다.
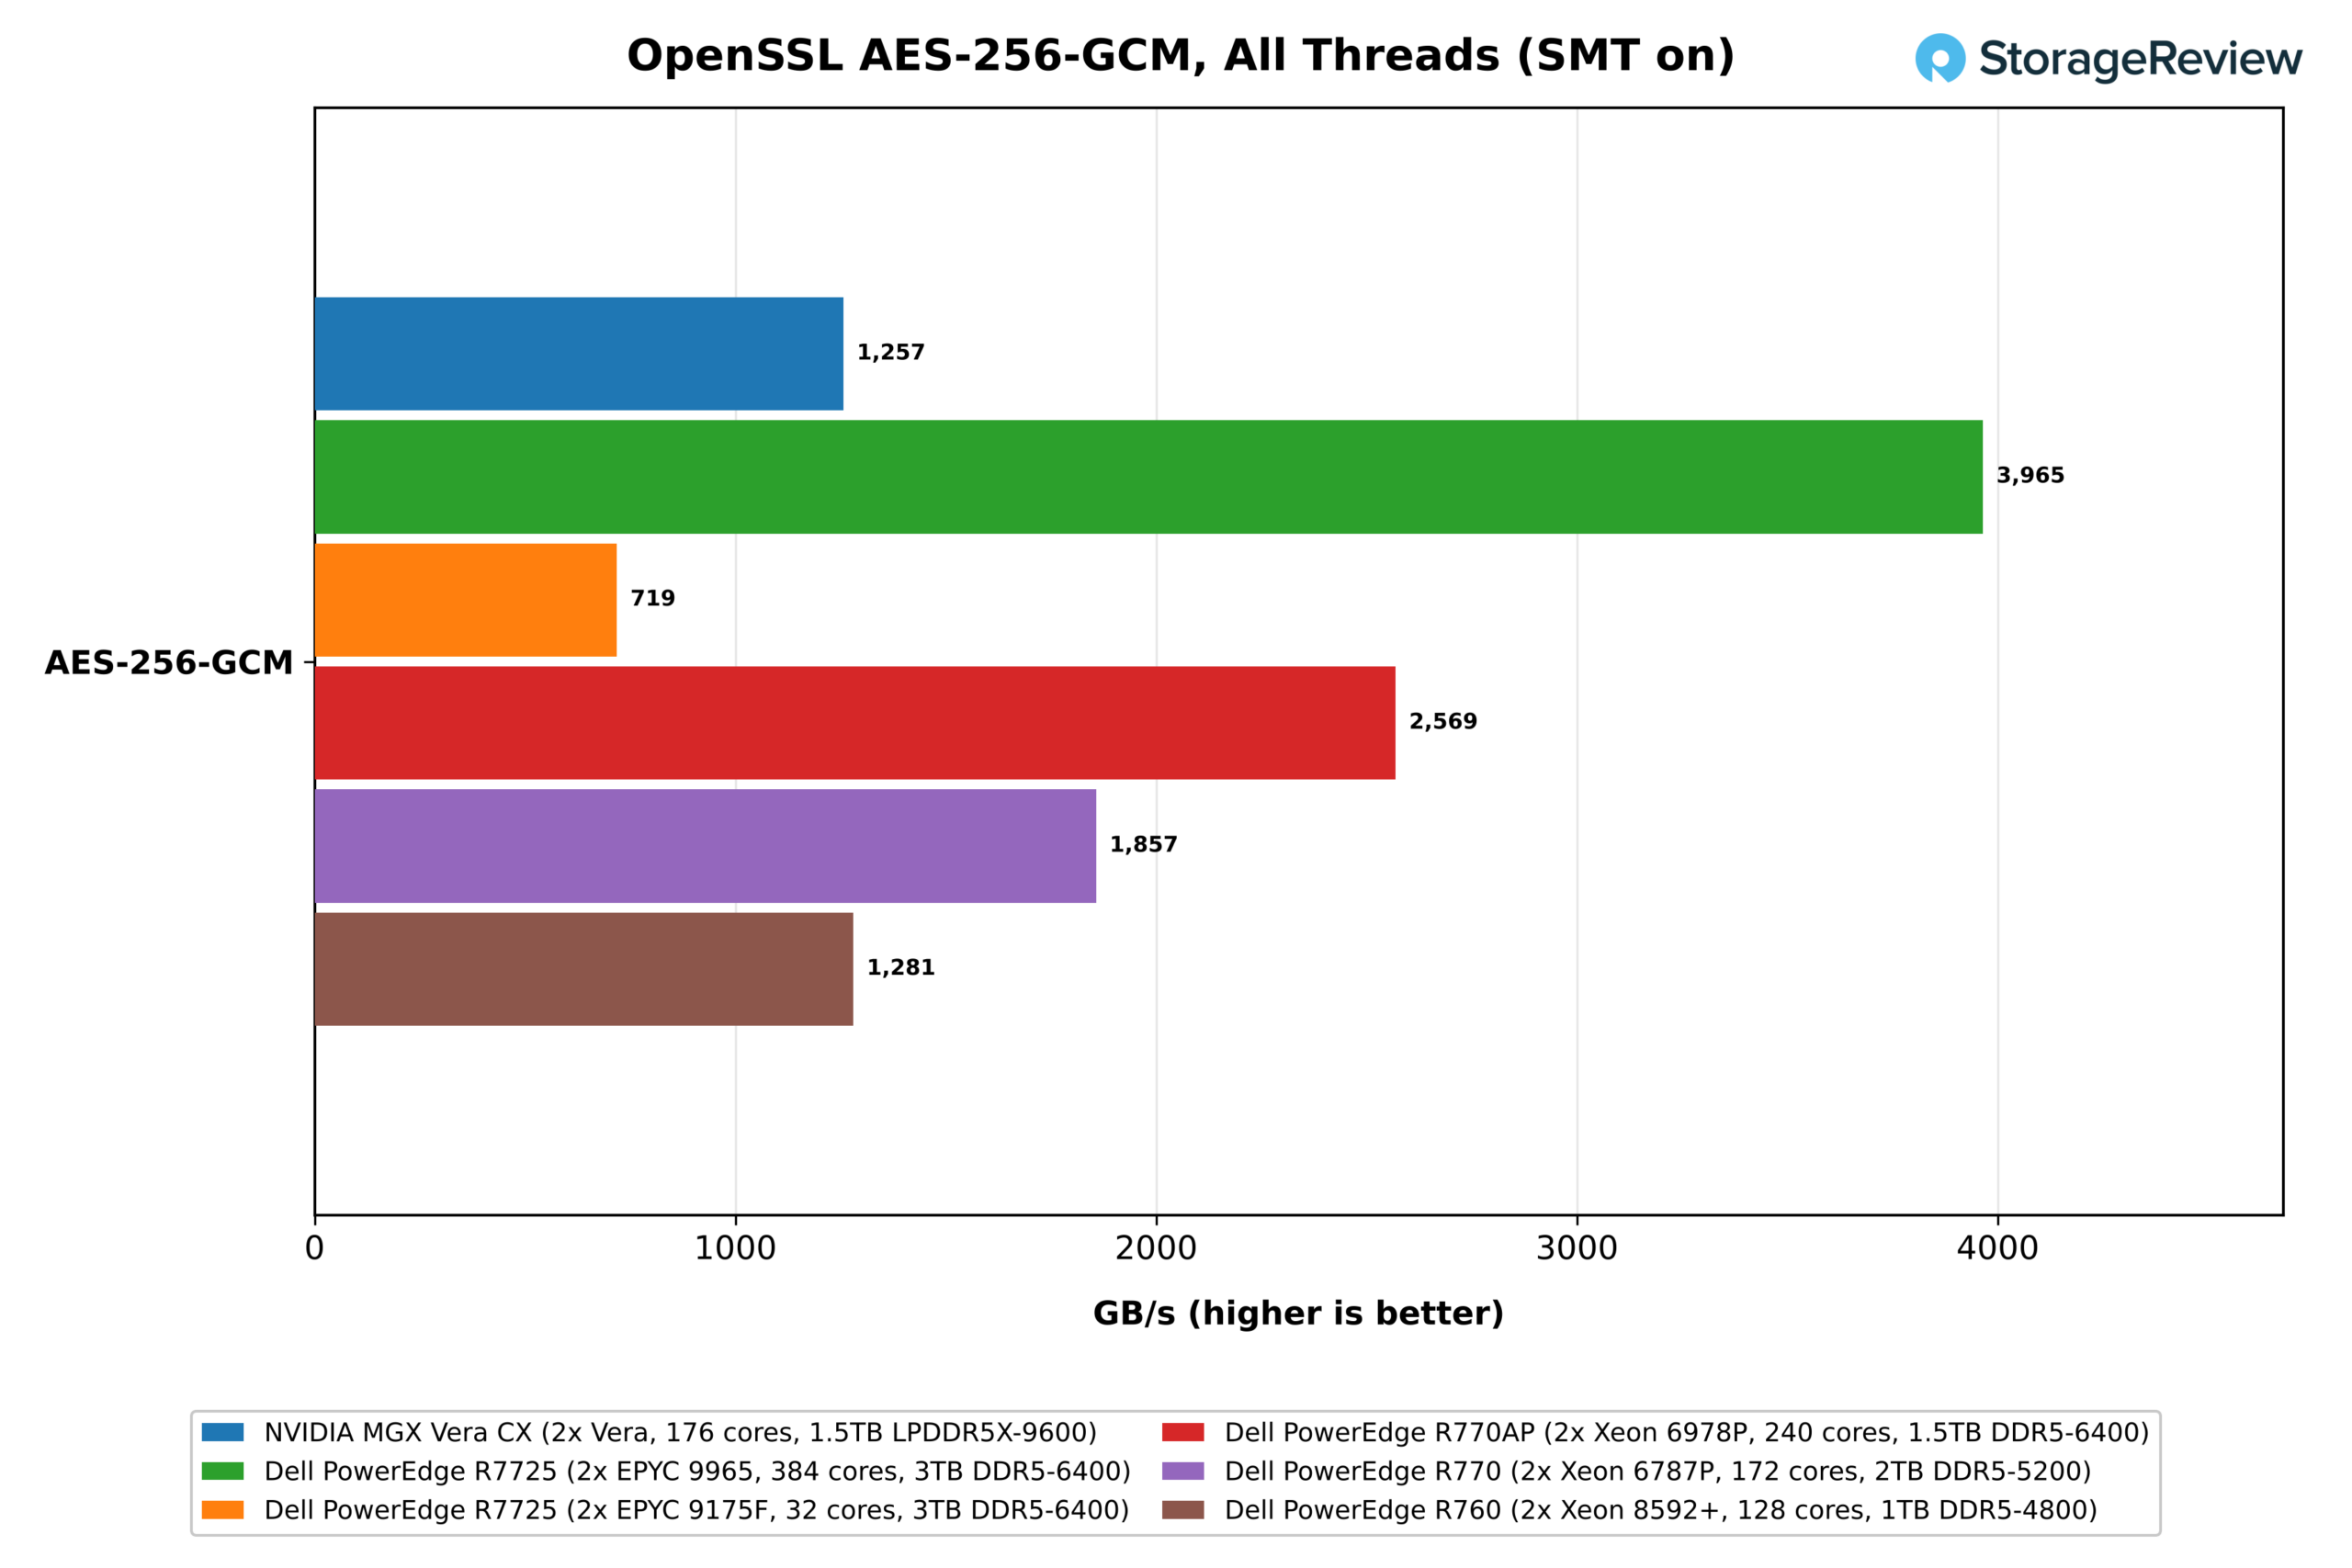
352개의 스레드가 모두 활성화된 상태에서 Vera는 1.26TB/s의 처리 속도를 기록했는데, 이는 128코어 Xeon 8592+의 1.28TB/s와 동일한 수치이며 32코어 EPYC 9175F보다만 앞선 결과입니다. EPYC 9965는 3.96TB/s로 Vera의 약 3배에 달하는 처리 속도를 보였으며, 그 뒤를 Xeon 6978P(2.57TB/s)와 6787P(1.86TB/s)가 이었습니다.
Python
Python은 NVIDIA가 Vera를 통해 목표로 하는 에이전트 샌드박스의 핵심이며, pyperformance는 go(객체 중심 게임 트리 탐색), regex_compile(정규 표현식 컴파일), nbody(부동 소수점 물리 시뮬레이션) 등 세 가지 고정된 단일 스레드 테스트를 제공합니다. 여기서 한 가지 소프트웨어 차이점이 있는데, Vera는 Ubuntu 26.04의 Python 3.14.4를 실행한 반면, x86 시스템은 Ubuntu 24.04의 3.12.3을 실행했으며, 최신 버전은 인터프리터 속도 향상을 제공합니다.
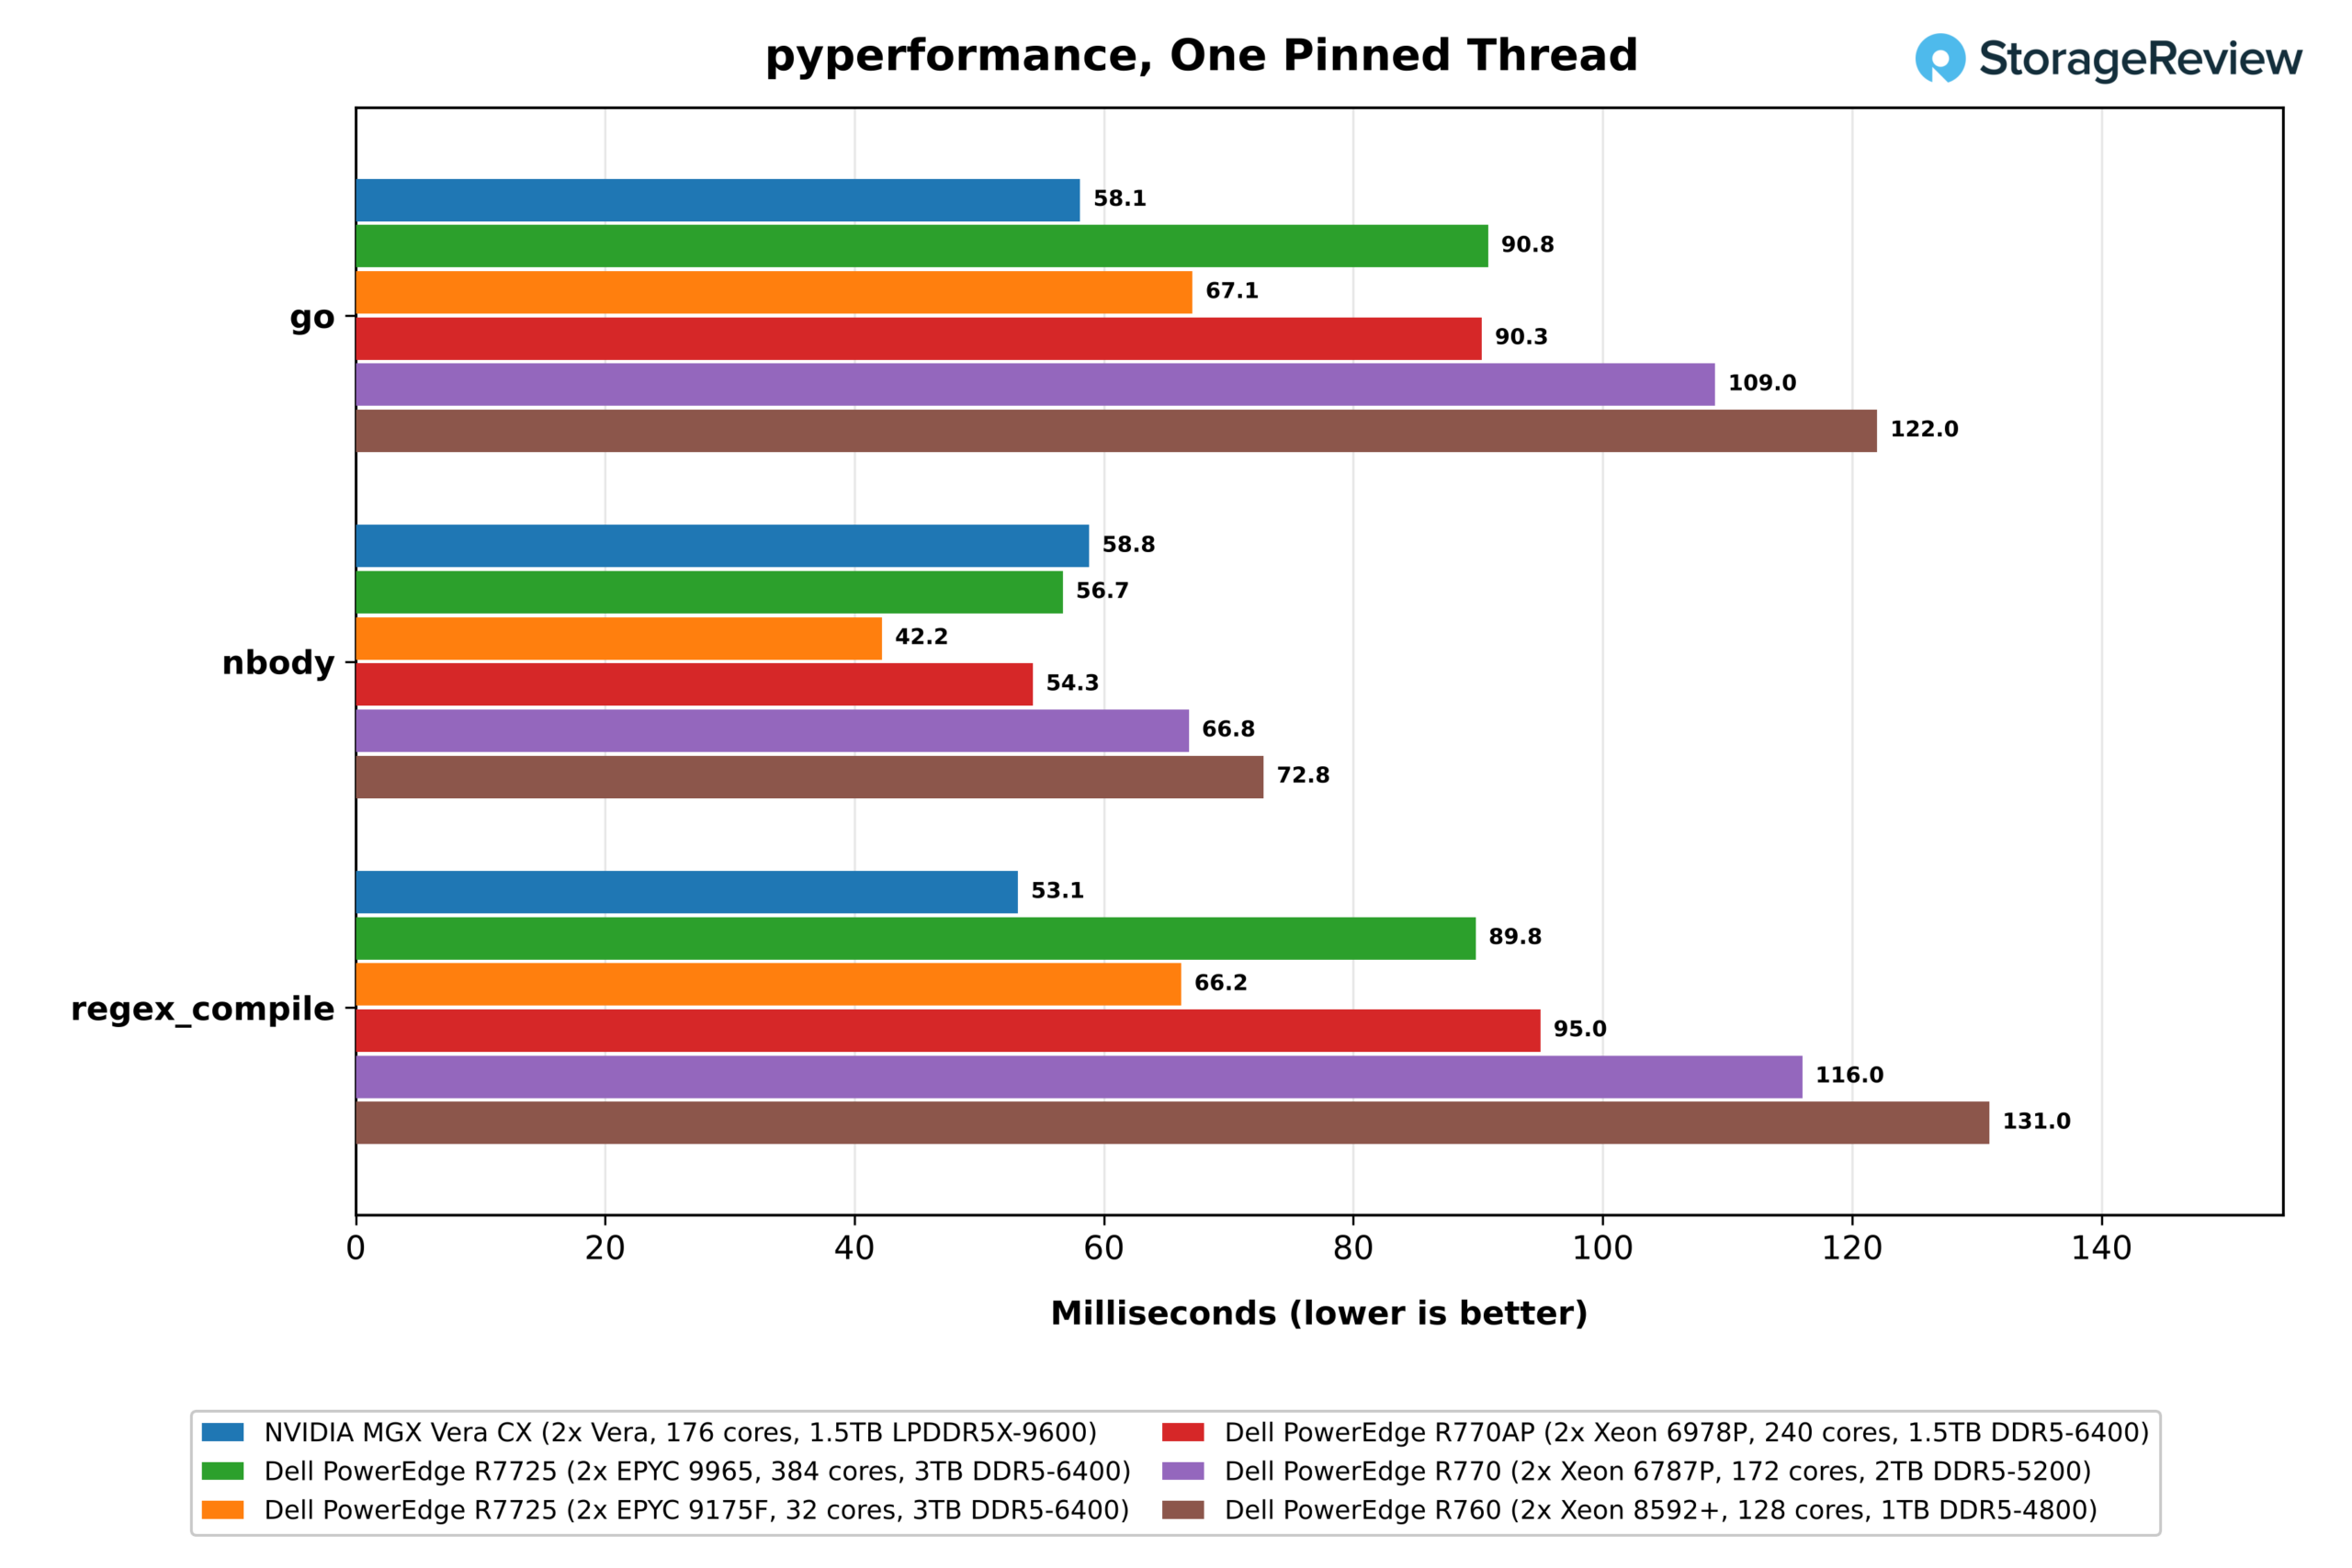
Vera는 분기 구조가 복잡하고 객체 지향적인 코드로 구성된 두 가지 테스트에서 모두 승리했습니다. go 테스트는 58.1ms 만에 완료되어, 여기 있는 x86 코어 중 가장 빠른 EPYC 9175F보다 15% 빠르고, 나머지 코어들보다 1.6배에서 2.1배 빠릅니다. regex_compile 테스트는 53.1ms 만에 완료되어 9175F보다 25% 빠르고 EPYC 9965보다 1.7배 빠른 더 큰 격차를 보였습니다. Vera는 최신 Python도 지원하므로, 위의 격차는 상한값으로 간주해야 합니다.
nbody는 반대로, 짧은 부동 소수점 루프와 작은 연산 영역 덕분에 높은 클럭 속도를 선호하여 5.0GHz 9175F가 42.2ms로 Vera의 58.8ms보다 39% 빠른 응답 속도를 기록했습니다. Xeon 6978P와 EPYC 9965 또한 Vera의 최신 Python을 사용했음에도 불구하고 각각 54.3ms와 56.7ms로 Vera보다 앞섰습니다.
웹 서버, JVM 및 스케줄러 지연 시간
마지막 테스트 그룹은 애플리케이션을 둘러싼 소프트웨어, 즉 웹 스택, 자바 가상 머신, 리눅스 스케줄러 및 컴파일러 툴체인을 다룹니다. 이러한 결과는 각 시스템에서 실행되는 스레드 수와 각 코어의 속도에 크게 좌우되므로 앞부분의 테스트 결과만큼 올림푸스 자체에 대한 정보를 많이 제공하지는 않지만, 베라 서버가 일반적인 서버 소프트웨어 환경에서 어떻게 작동하는지 보여줍니다.
NGINX
NGINX는 동일한 머신에서 실행되는 wrk 부하 생성기에 HTTPS 요청을 처리하므로 클라이언트와 서버가 동일한 코어를 놓고 경쟁하게 되며, 그 결과는 순수 코어 수보다는 TLS 및 HTTP 스택 사용량을 더 잘 반영합니다.
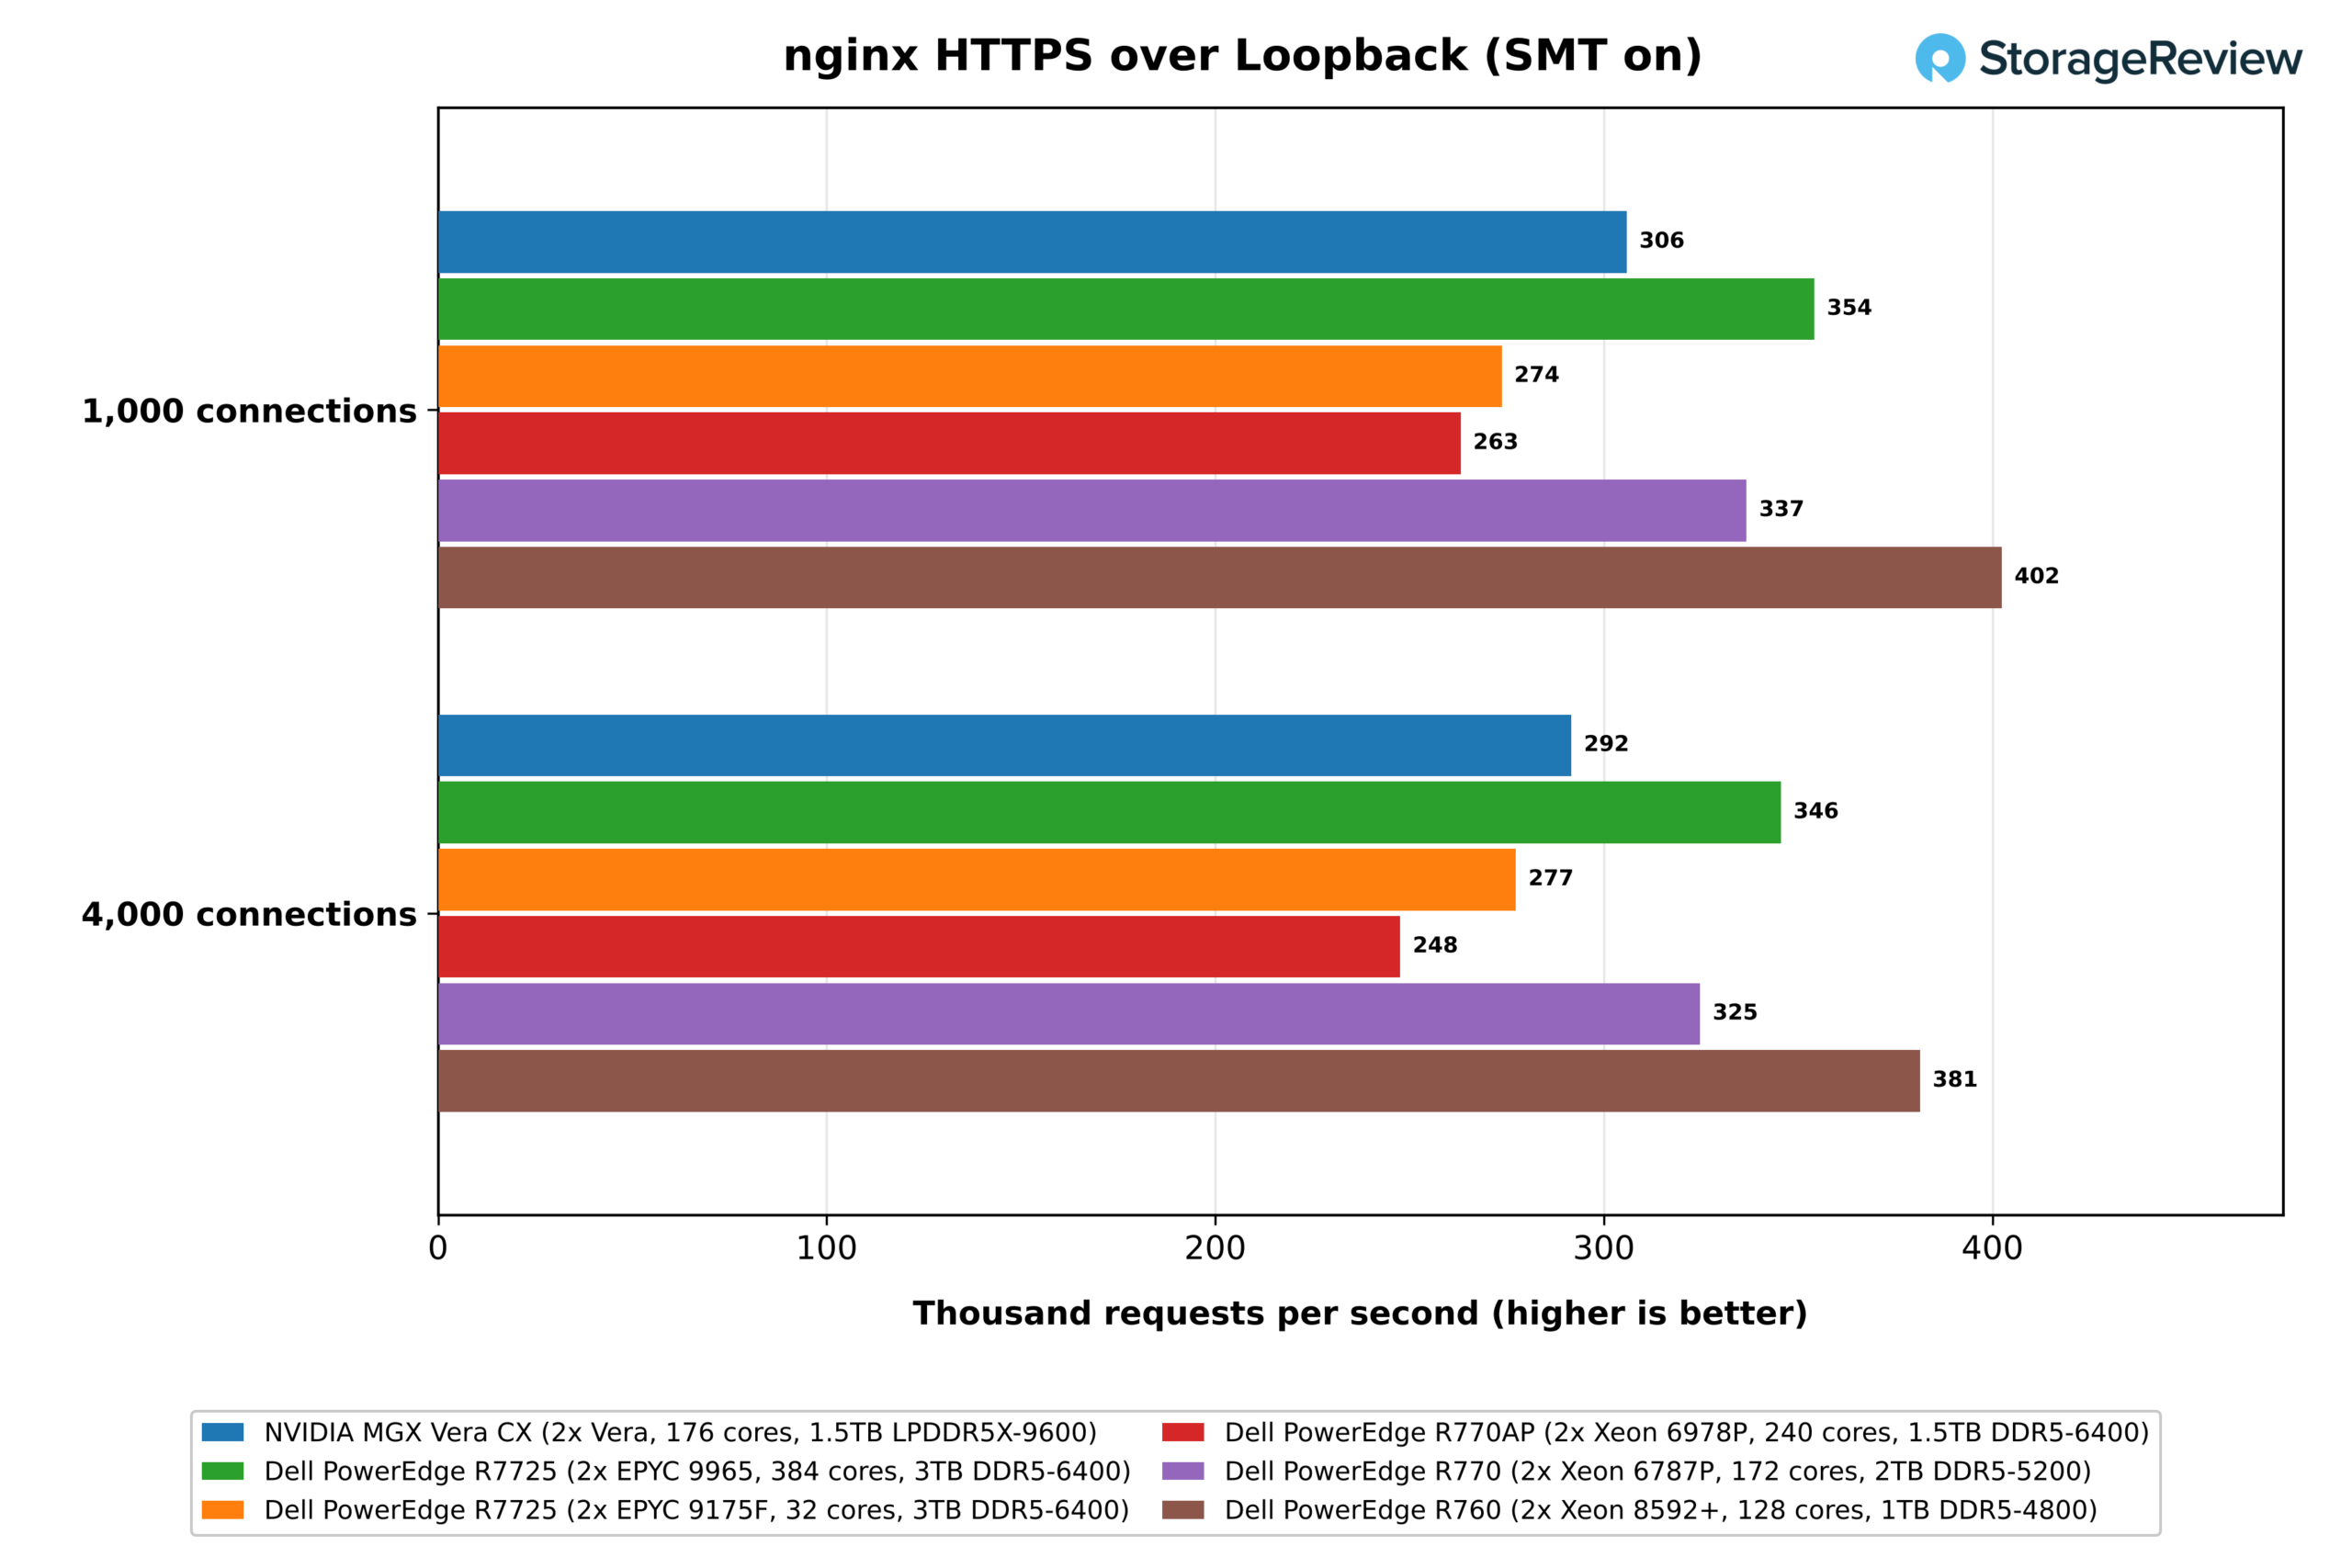
SMT를 활성화한 상태에서 Vera는 1,000개 연결 시 초당 306,000건, 4,000개 연결 시 초당 292,000건의 요청을 처리했습니다. 이는 Xeon 6978P의 263,000건에서 Xeon 8592+의 402,000건에 이르는 다른 시스템들의 중간 수준입니다. EPYC 9965는 354,000건, Xeon 6787P는 337,000건을 기록했으며, SMT를 비활성화하면 Vera의 처리량은 330,000건으로 증가했습니다. Vera의 네트워크 스택은 x86 시스템과 비교해도 손색이 없습니다.
입니다.
Renaissance는 OpenJDK 11에서 Java 워크로드를 실행합니다. Finagle HTTP 테스트는 Scala 네트워킹 스택을 테스트하고, Akka 테스트는 액터 모델 기반 동시성 프레임워크를 테스트합니다. 두 테스트 모두 JVM이 인식할 수 있는 모든 논리적 CPU에 작업을 분산시키므로 SMT를 켜고 끈 상태로 실행했습니다.
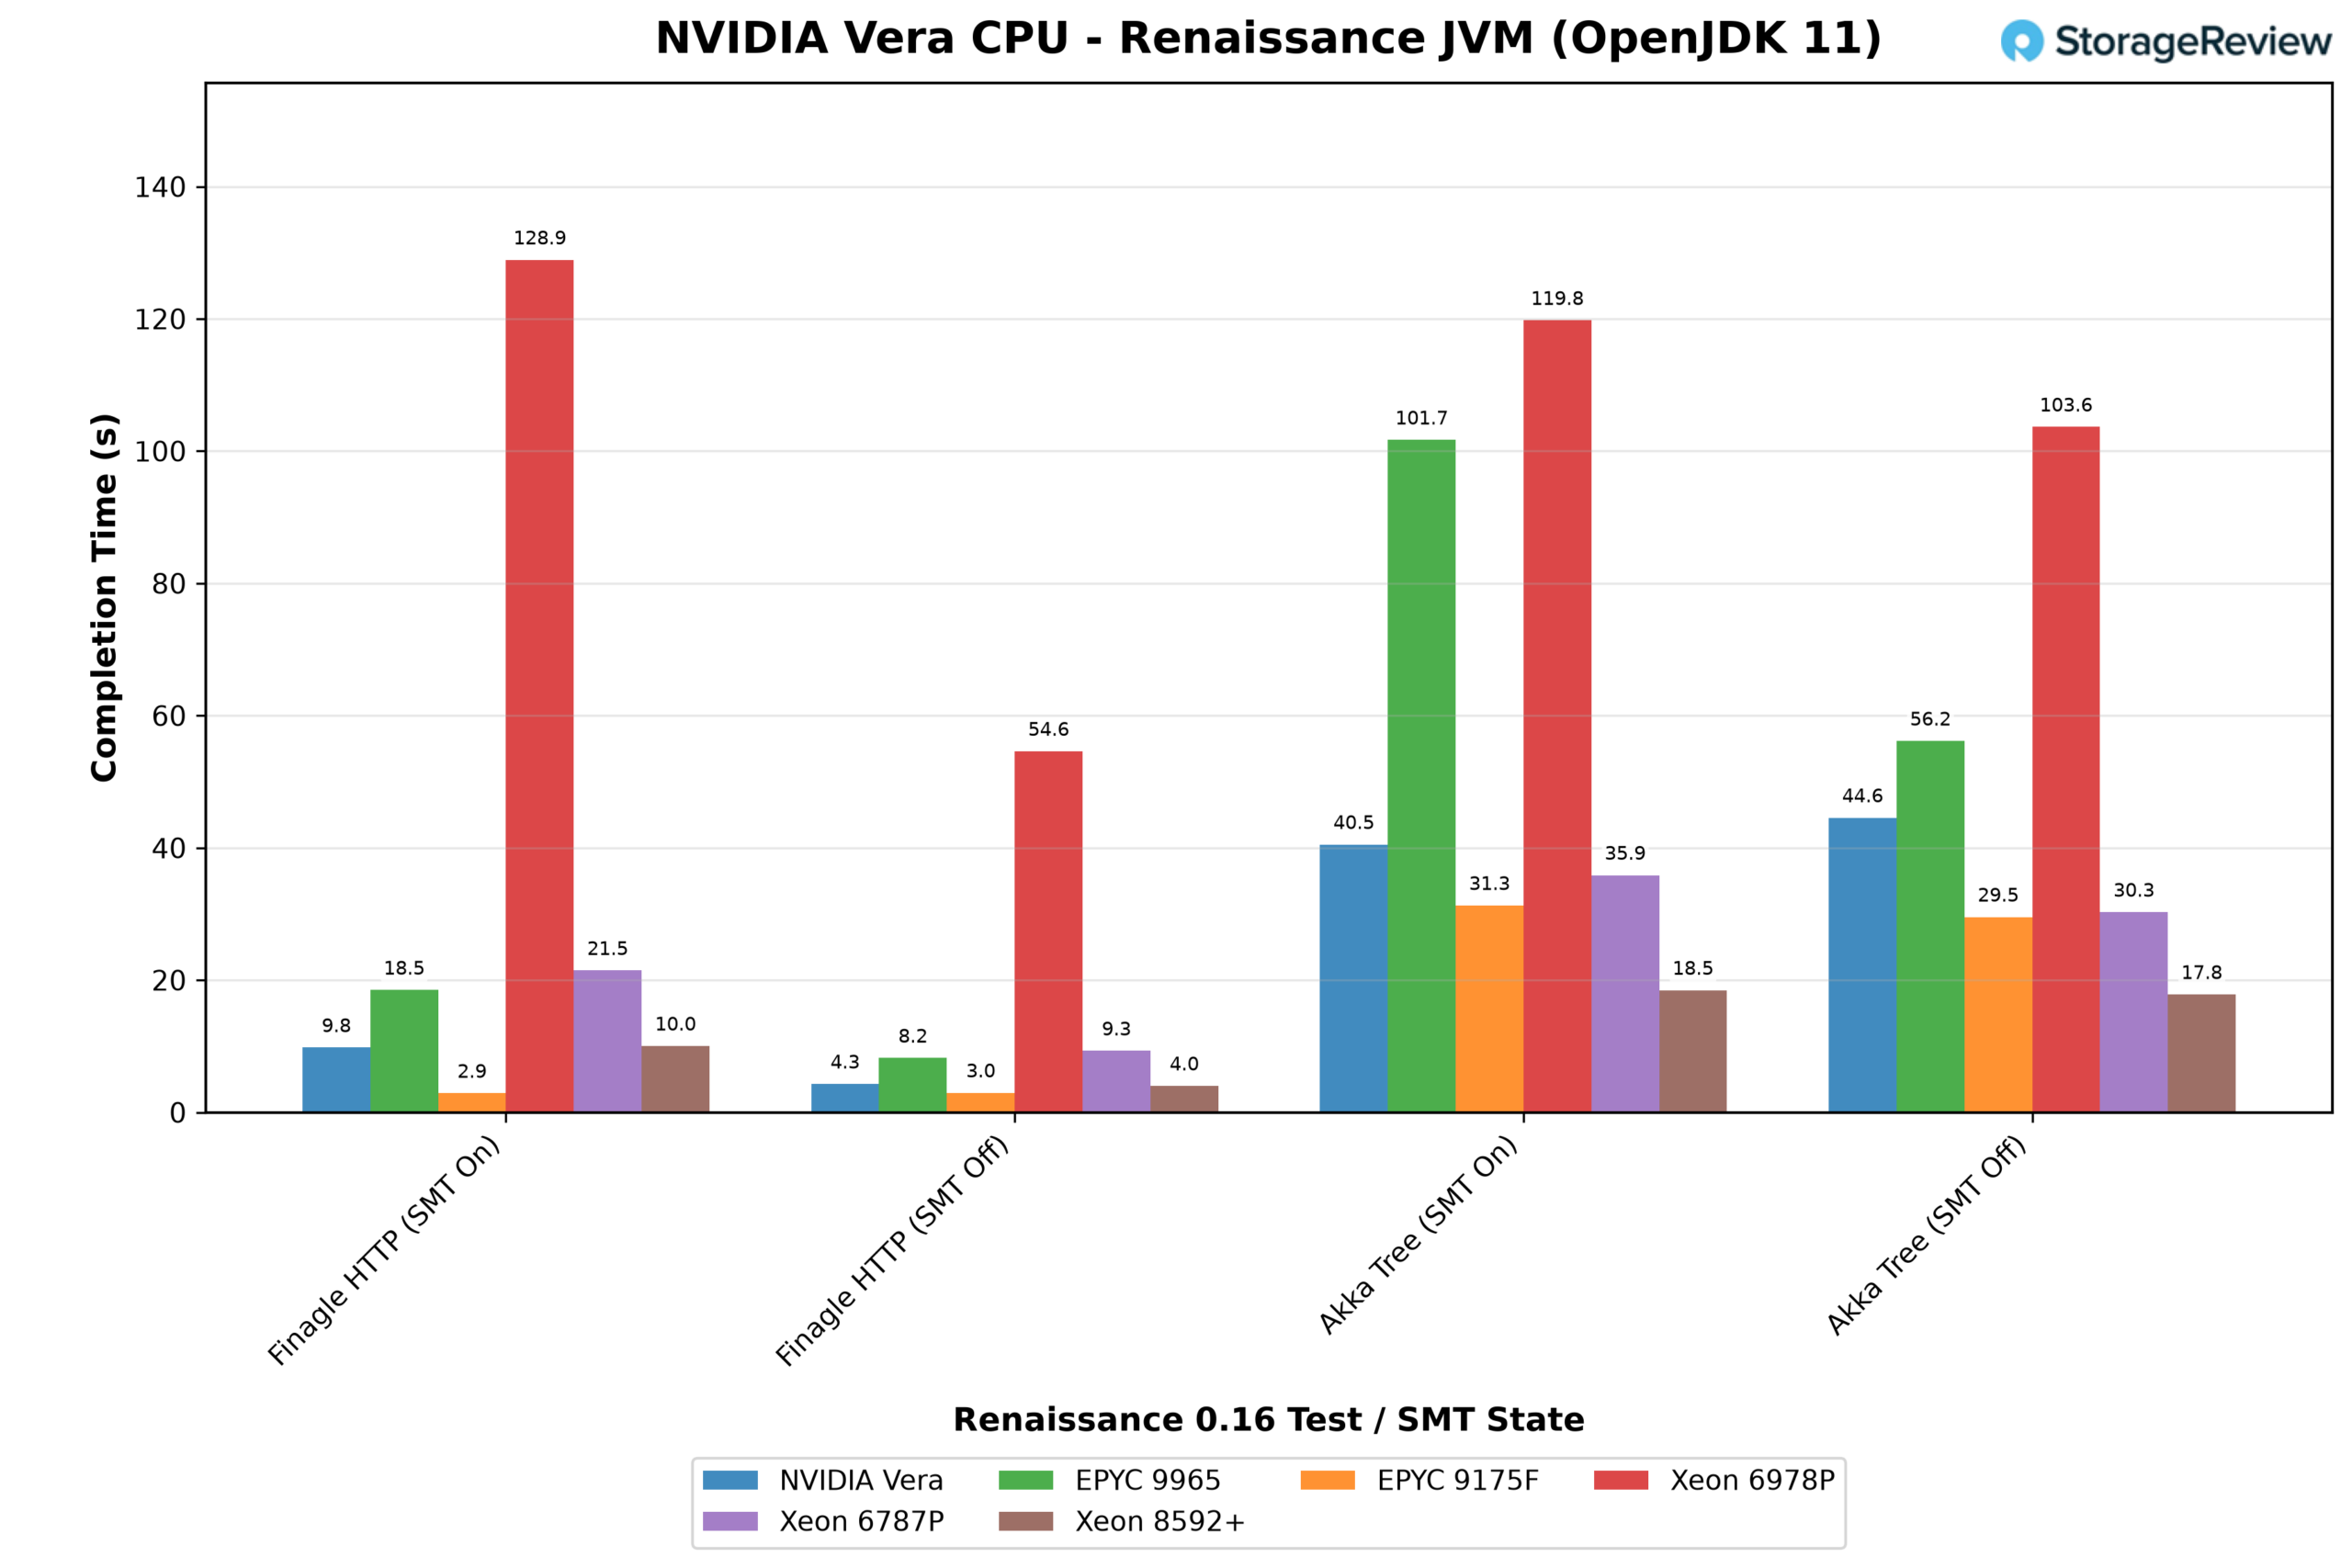
Finagle은 스레드 수가 적을수록 더 빠르게 실행됩니다. SMT를 끄면 스레드 수가 절반으로 줄어들어 Vera의 실행 시간이 9.8초에서 4.3초로 단축되었고, 더 큰 x86 시스템에서도 2.3배에서 2.5배 정도 향상되었습니다. 애초에 스레드 수가 적은 32코어 EPYC 9175F는 어떤 경우에도 약 3초로 가장 빠른 속도를 보였습니다.
Akka 테스트에서는 Xeon 8592+ 프로세서가 가장 우수한 성능을 보였는데, SMT를 켜거나 끄거나 상관없이 약 18초 만에 완료되었습니다. Vera는 SMT를 켠 상태에서 40.5초가 걸렸고, 가장 성능이 좋은 두 시스템인 EPYC 9965와 Xeon 6978P는 각각 101.7초와 119.8초로 가장 느렸습니다. 세 번째 Renaissance 테스트인 유전 알고리즘 테스트는 SMT를 켠 상태에서 6978P를 제외한 모든 시스템에서 1.6초에서 2.6초 사이에 완료되었으며, Vera는 2.6초가 걸렸습니다.
슈벤치
schbench는 Linux 스케줄러가 워커 스레드를 깨우는 속도를 측정하는 도구로, 메시지 스레드가 4개일 때는 논리 CPU당 약 1개의 워커가 실행되고, 32개일 때는 CPU당 약 8개의 워커가 실행됩니다. 워커 수는 시스템 규모에 따라 증가하므로, 대형 서버는 더 많은 작업을 처리합니다. 따라서 이 결과는 각 시스템에 최대 부하가 걸렸을 때의 지연 시간을 나타내는 것이며, 동일한 조건에서의 비교는 아닙니다.
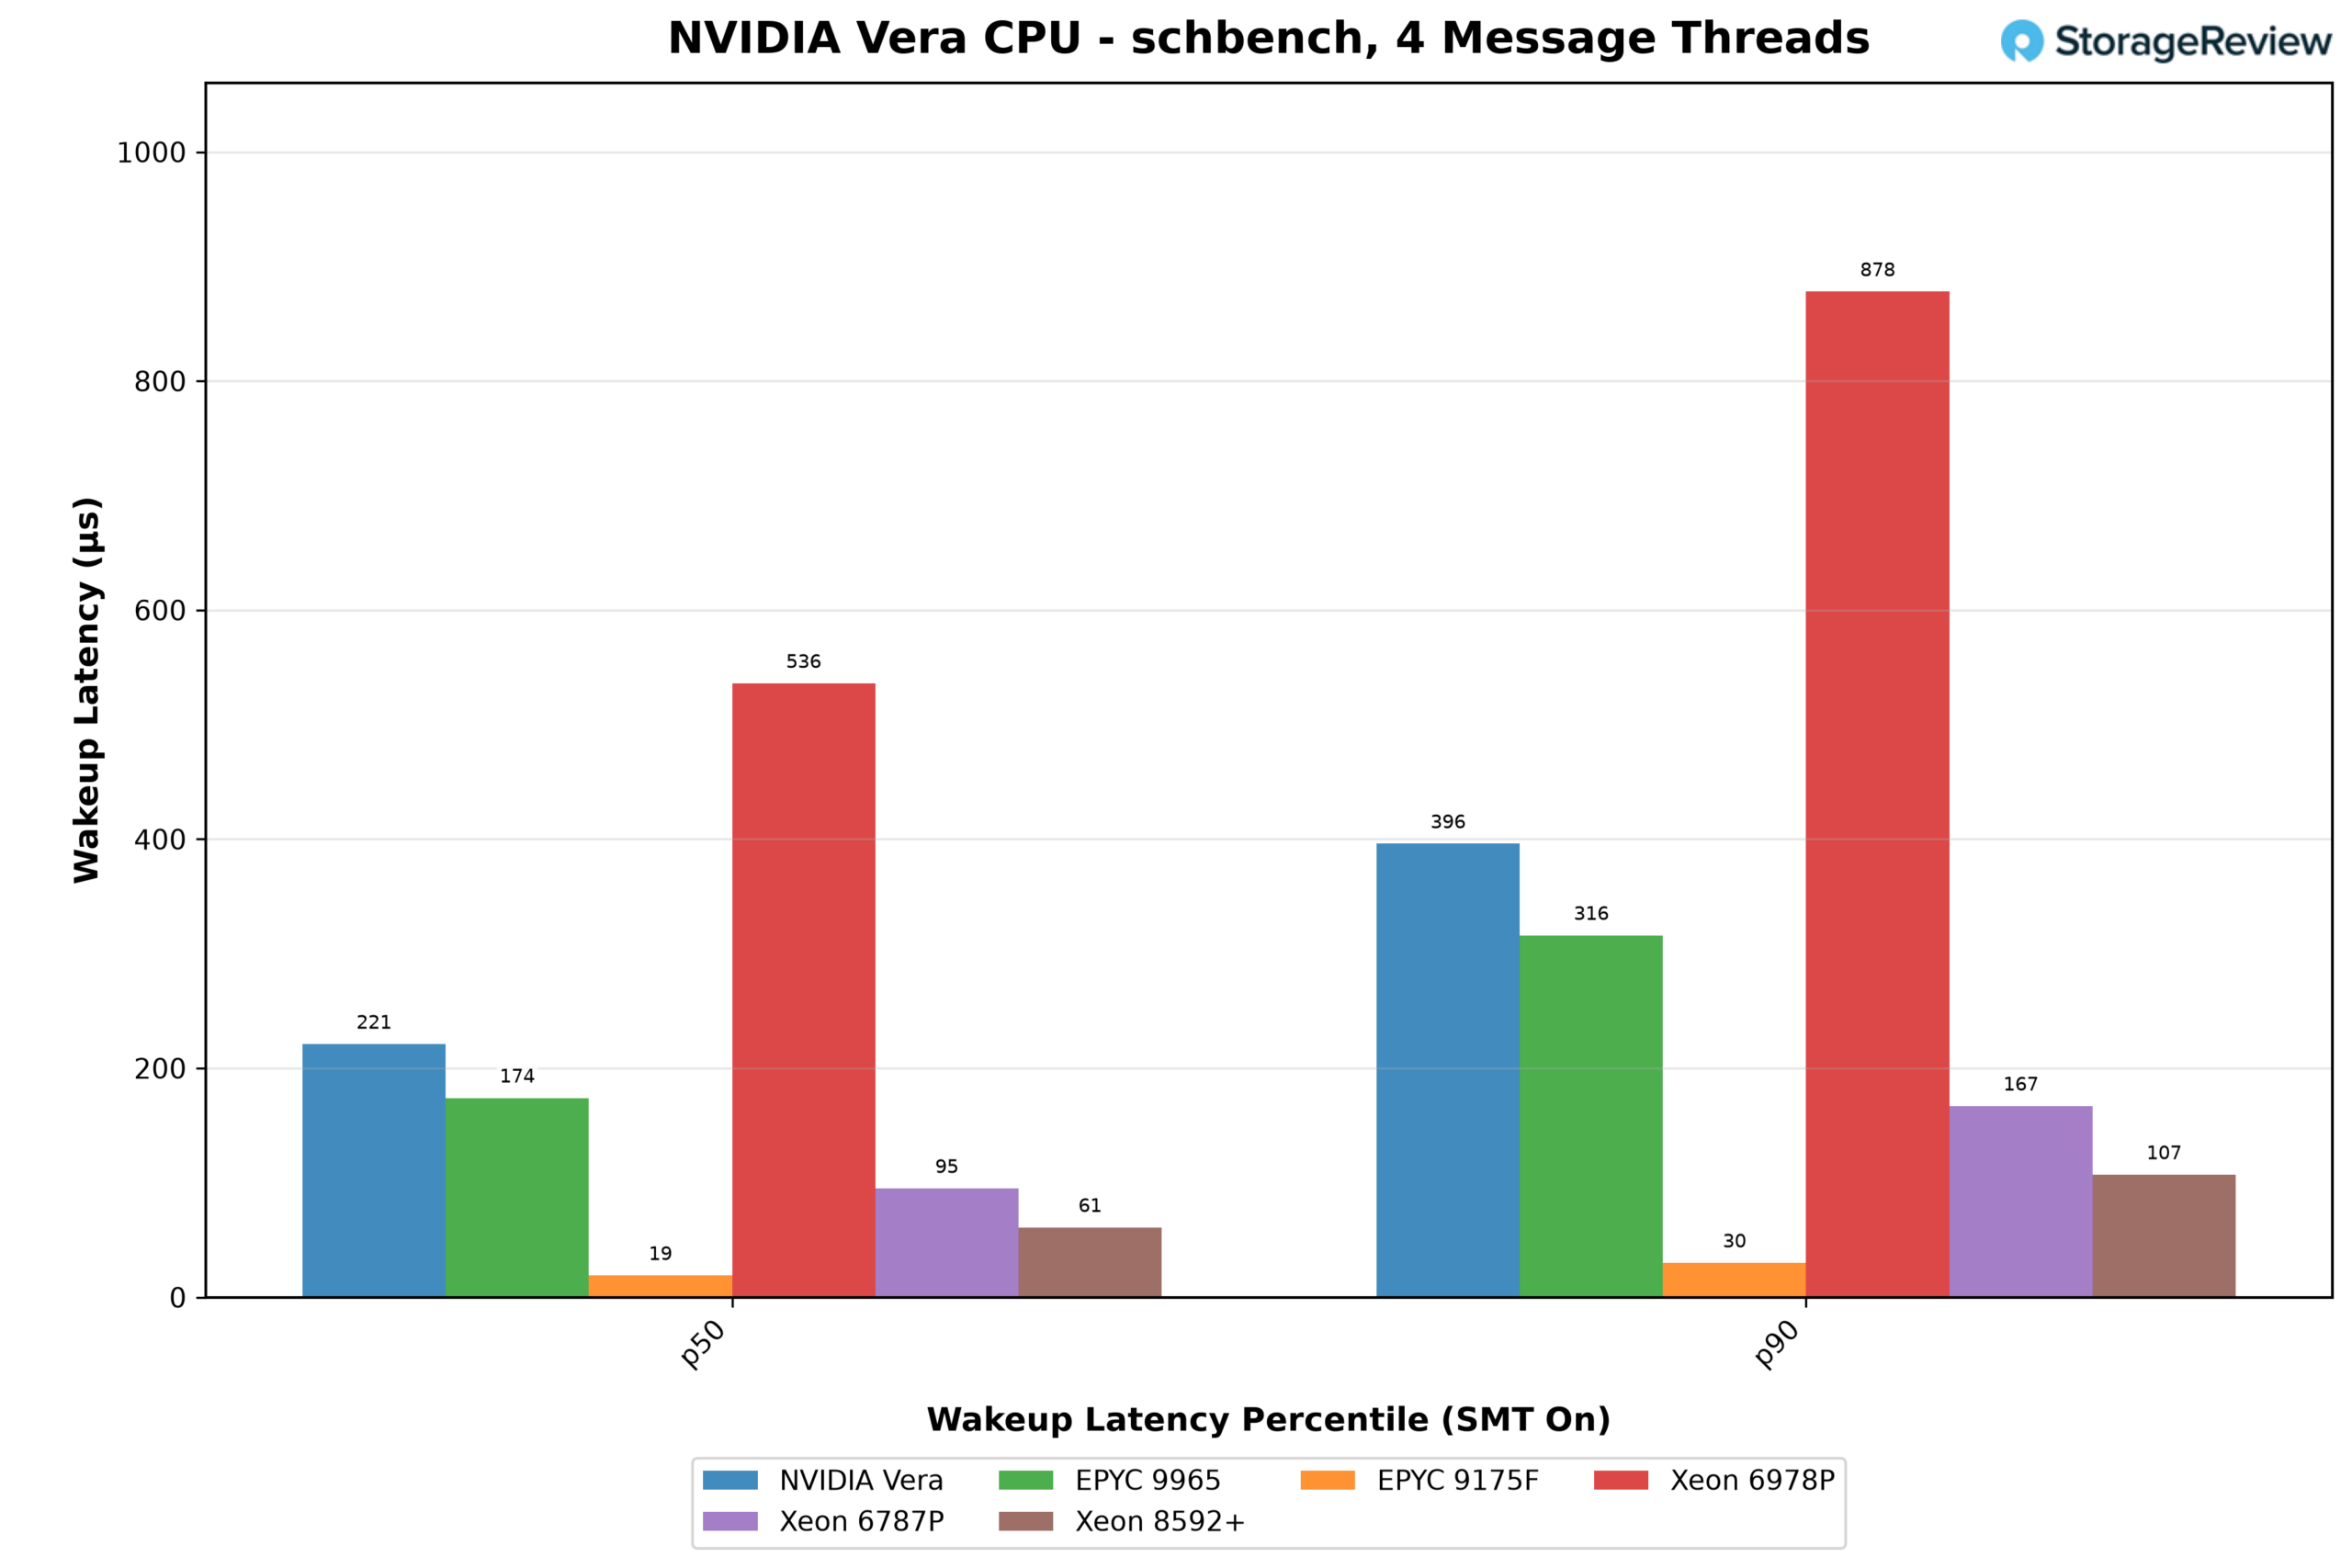
4개의 메시지 스레드를 사용했을 때, Vera의 중간 웨이크업 지연 시간은 221µs였고, p90은 396µs였습니다. 이는 Xeon 6978P(536µs 및 878µs)를 제외한 모든 시스템보다 높은 수치입니다. 가장 작은 사양의 시스템일수록 스레드를 가장 빠르게 깨웠는데, 32코어 EPYC 9175F가 19µs, 128코어 Xeon 8592+가 61µs를 기록했습니다.
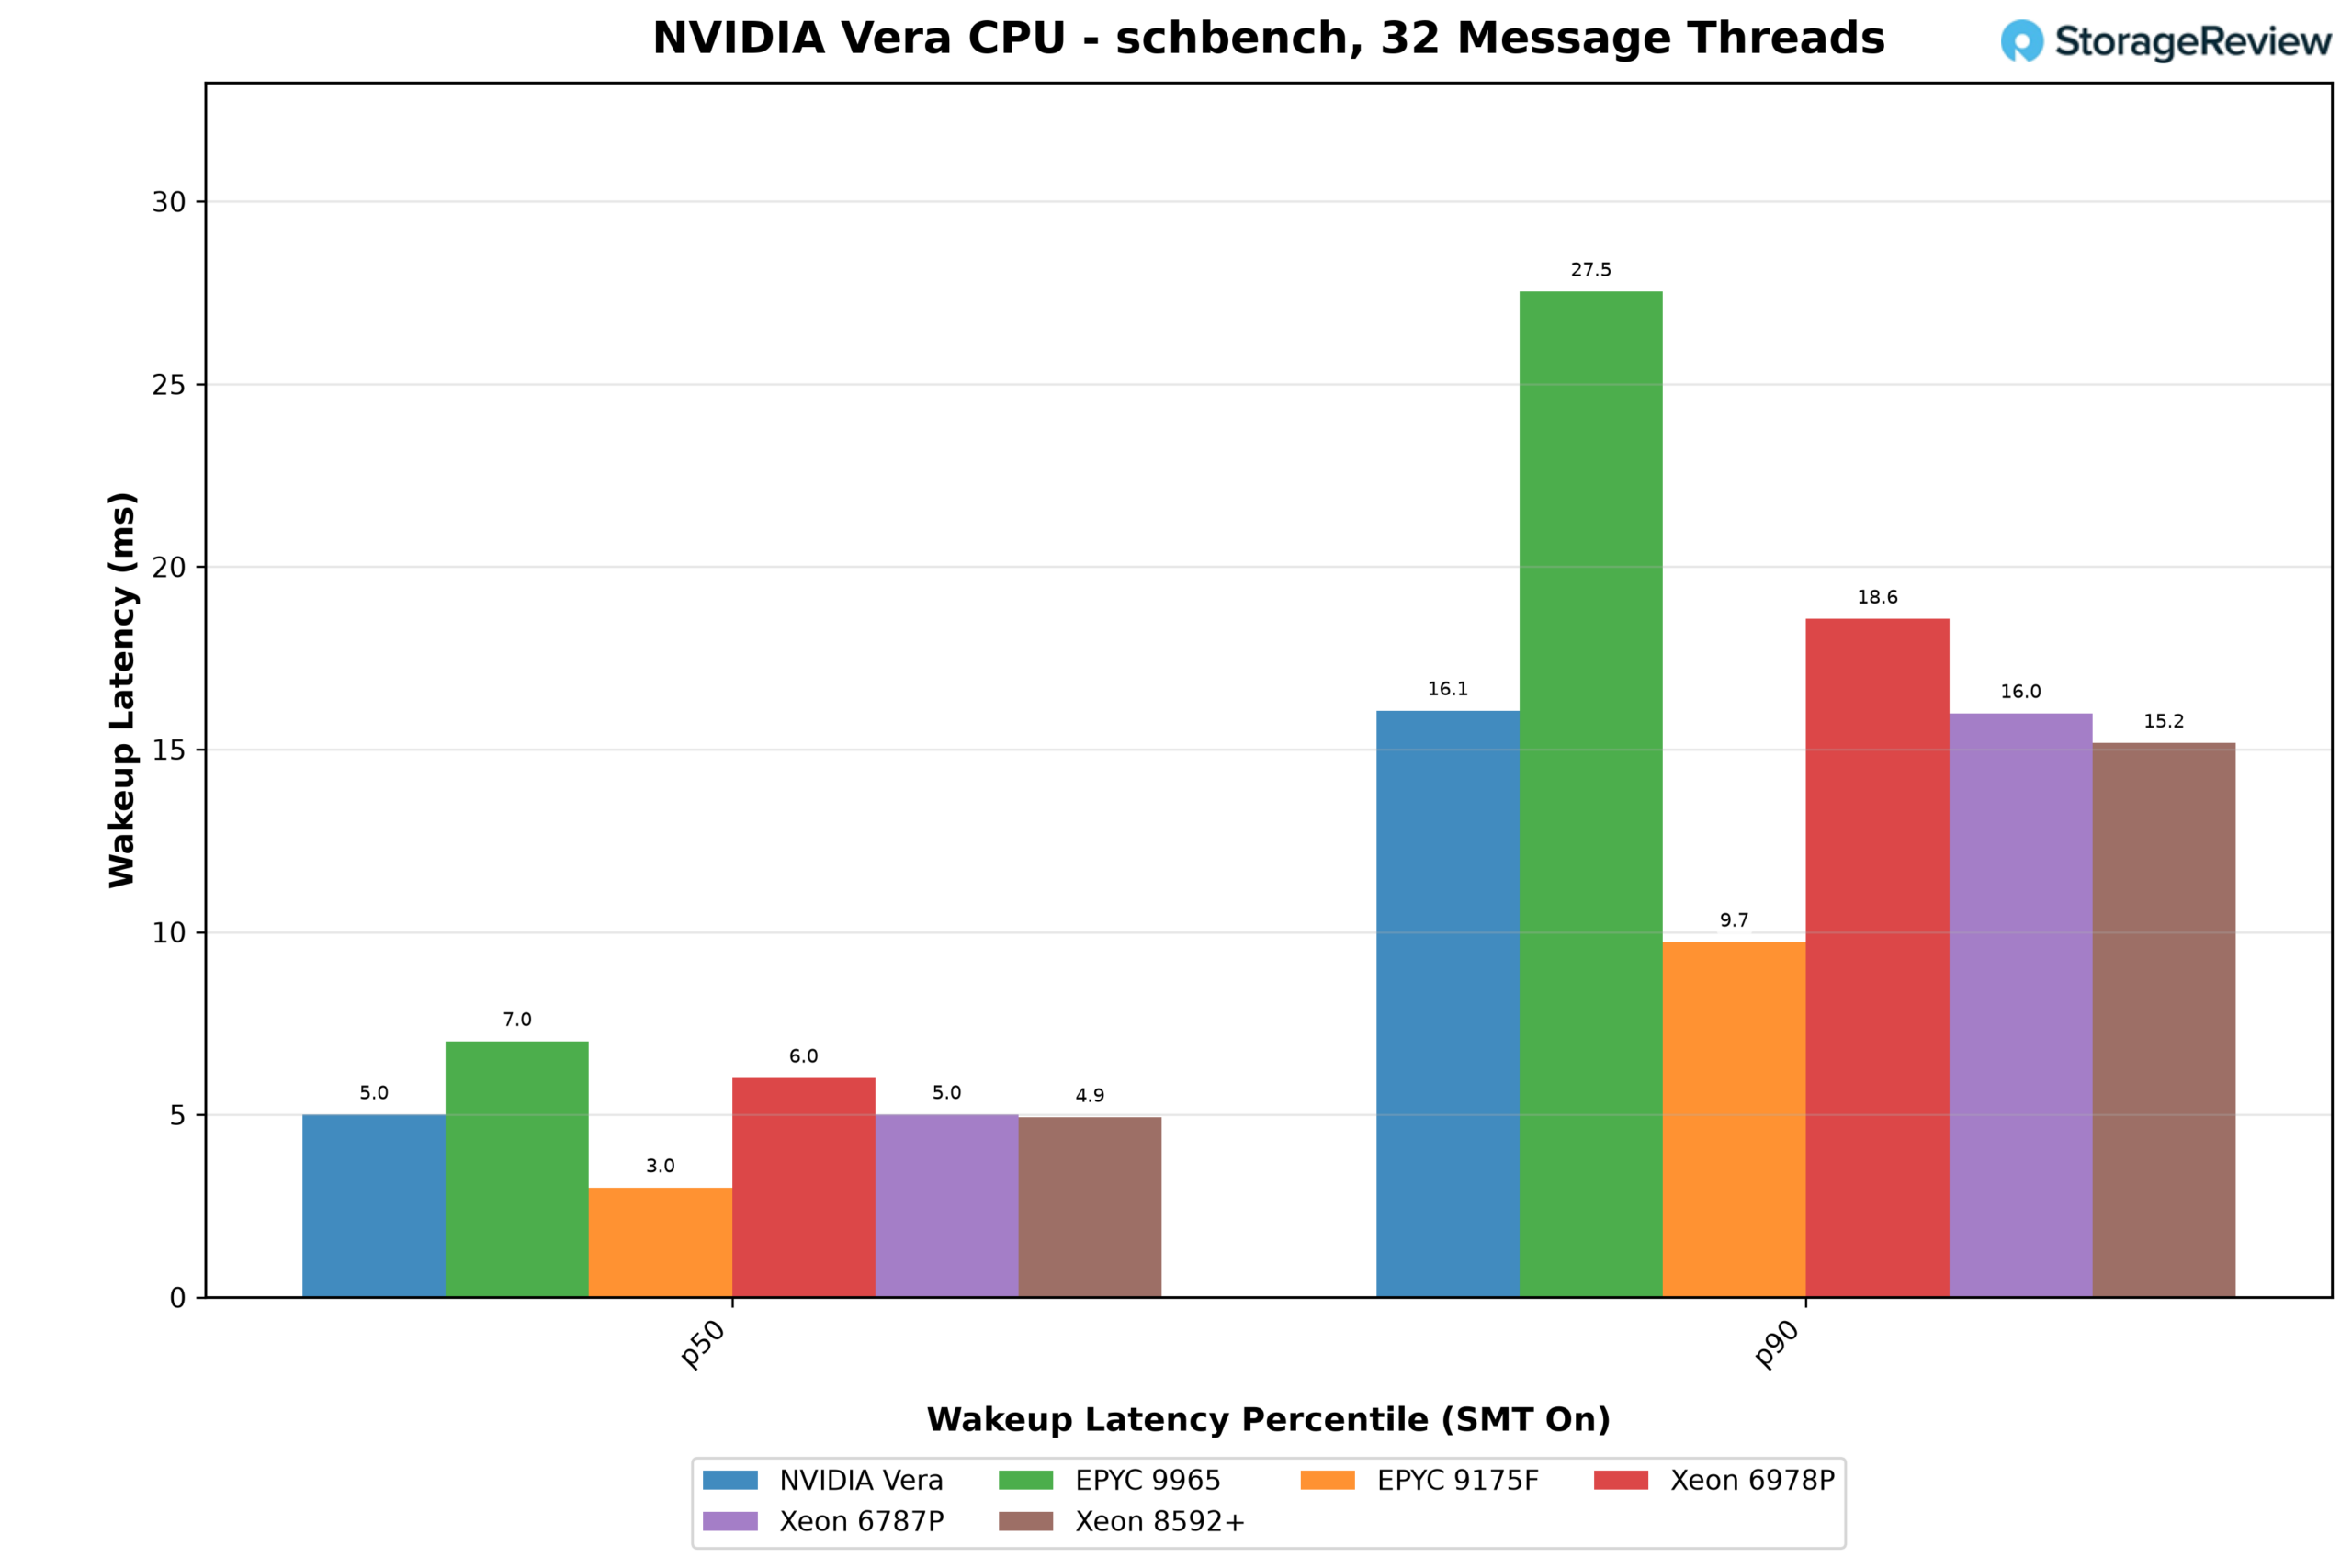
32개의 메시지 스레드로 과부하가 걸린 Vera는 중간 순위로 밀려났습니다. 5.0ms의 중앙값 응답 시간과 16.1ms의 p90 응답 시간은 Xeon 6787P 및 8592+와 비슷한 수준이었으며, 27.5ms의 p90 응답 시간을 기록한 Xeon 6978P와 EPYC 9965보다 앞섰습니다. 9175F만이 3.0ms의 중앙값 응답 시간과 9.7ms의 응답 시간으로 확실히 더 빨랐습니다.
리눅스 커널 빌드
이 섹션에서 순위를 매기지 않은 유일한 결과는 Linux 커널 allmodconfig 빌드입니다. Vera는 arm64 커널 트리를 컴파일하는데, 이는 다른 시스템에서 빌드하는 x86-64 트리와는 다른 모듈 및 드라이버 세트를 포함하고 있으며, 저희는 크로스 컴파일을 시도하지 않았습니다.
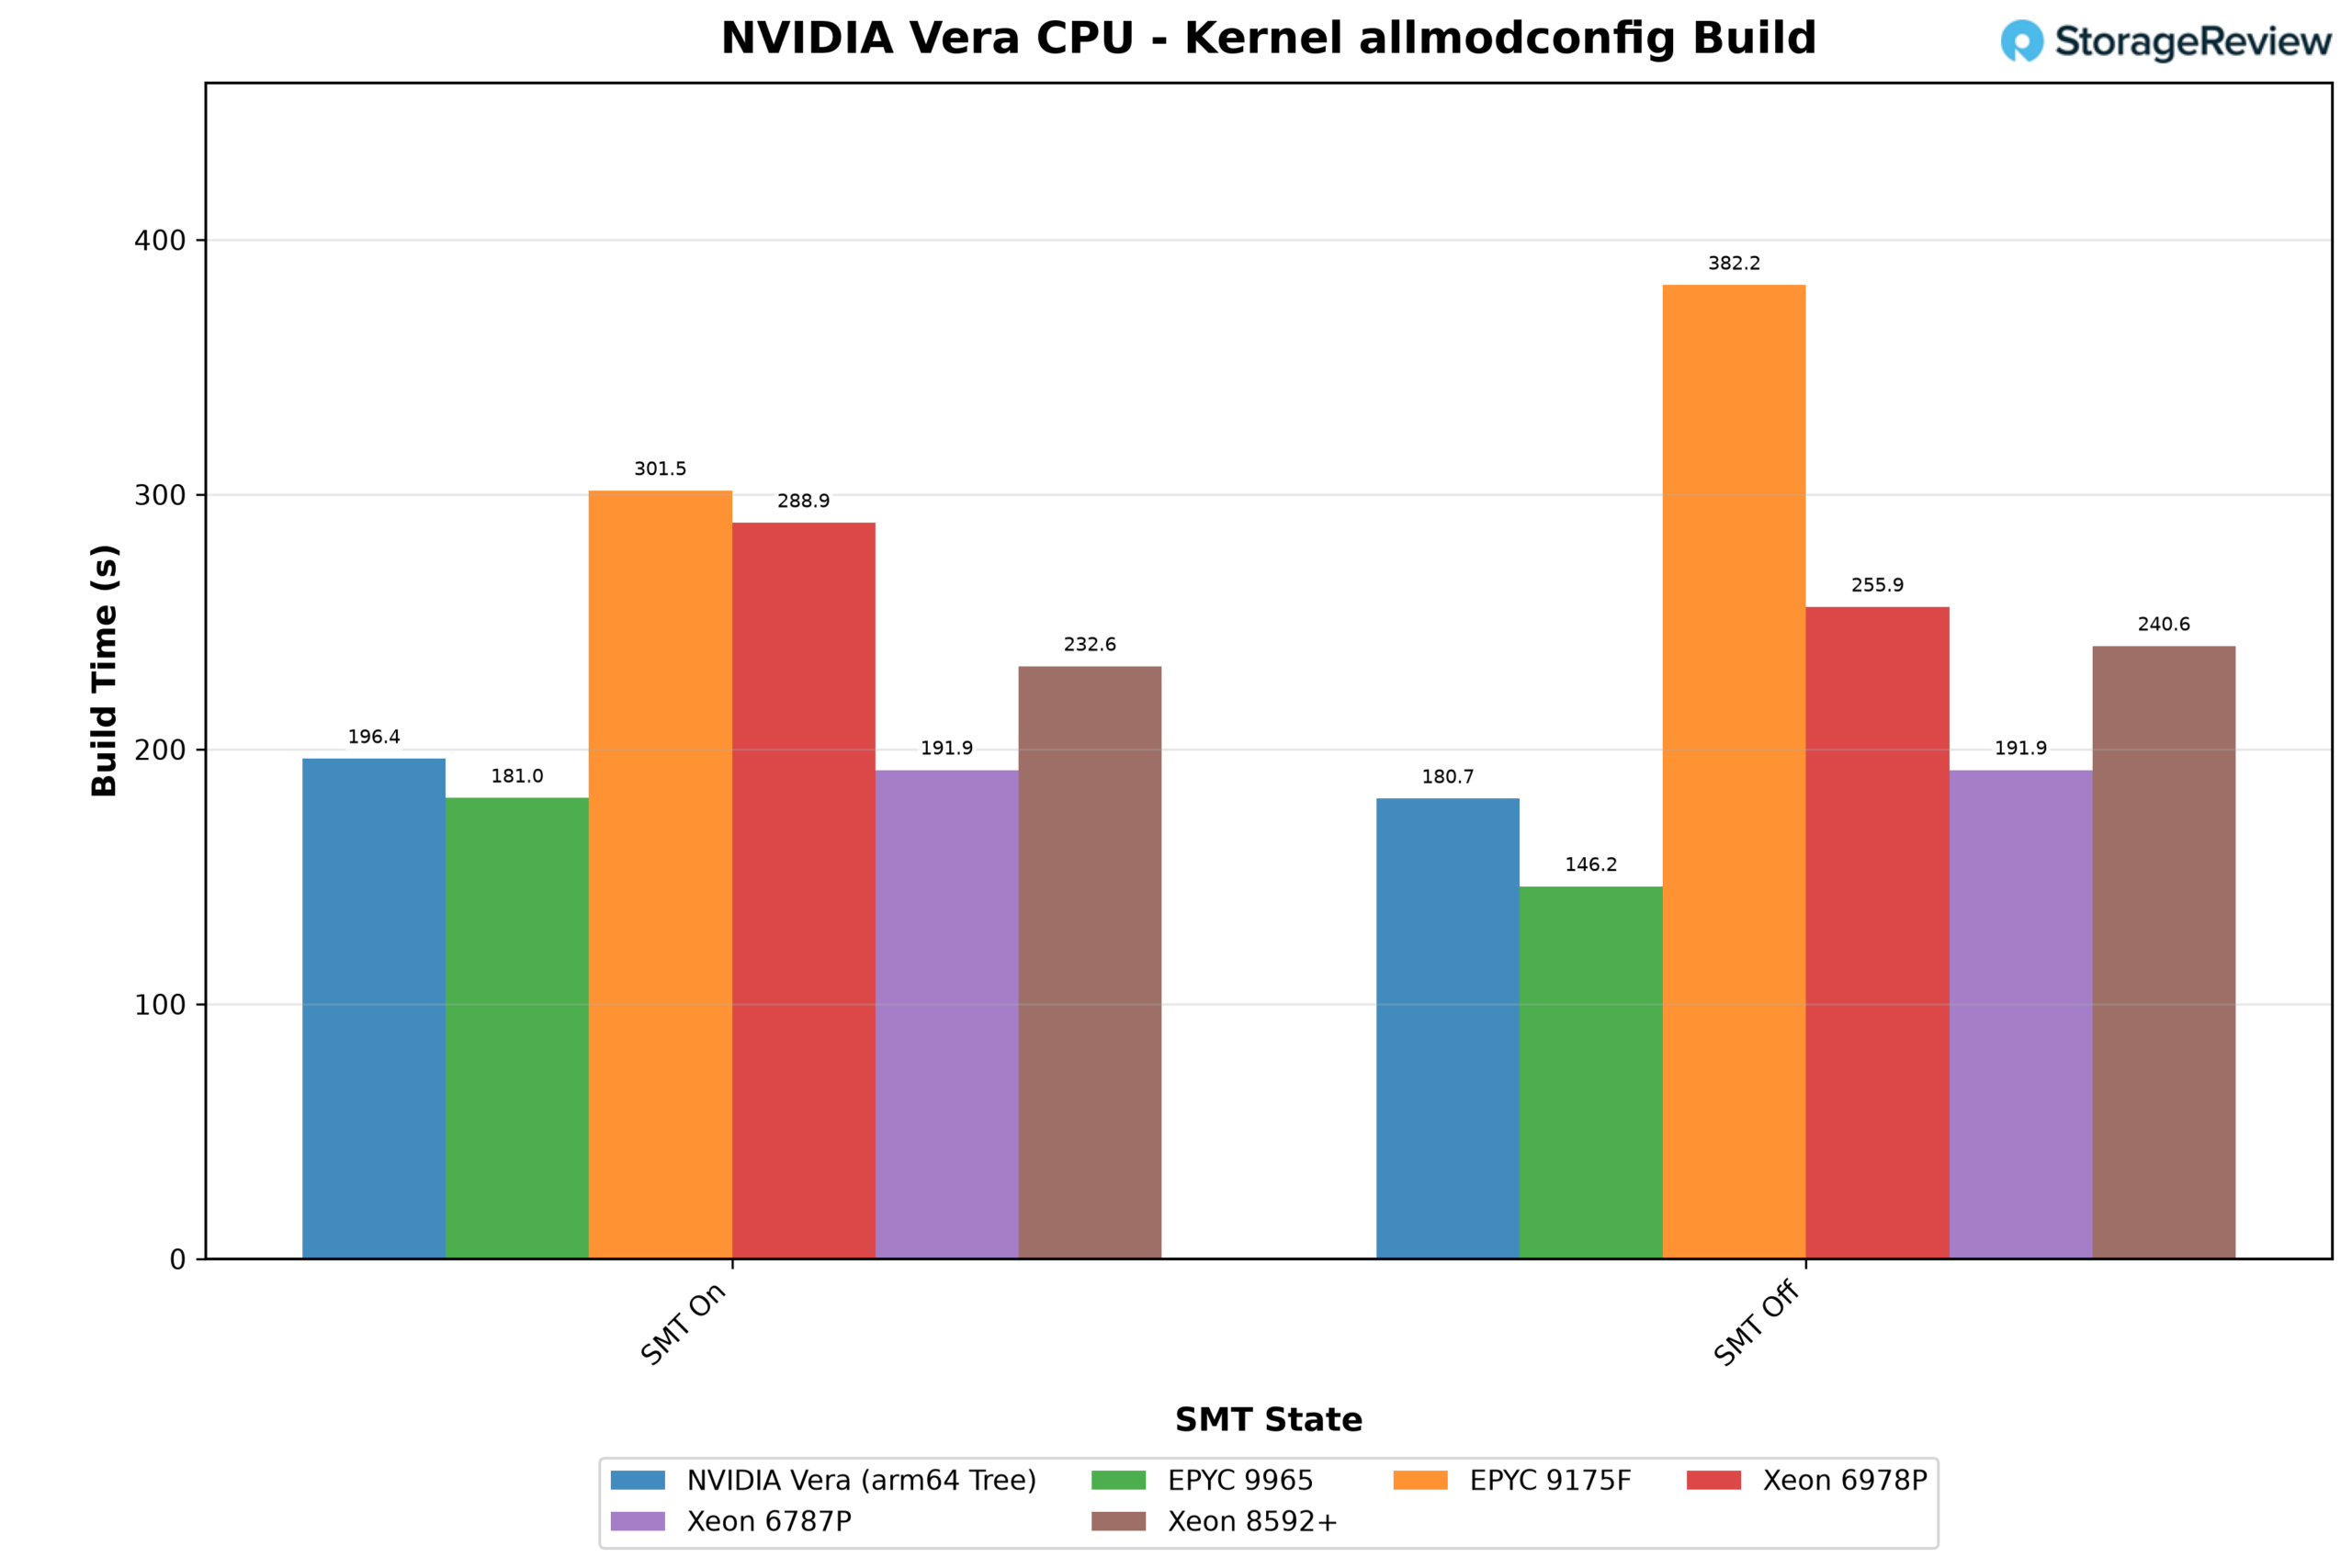
Vera는 SMT를 껐을 때 180.7초, SMT를 켰을 때 196.4초 만에 트리를 구축했으므로, 추가 스레드가 구축 속도를 저하시켰습니다. 네이티브 트리를 구축하는 데 걸린 시간은 x86 시스템 전반에 걸쳐 SMT를 끈 EPYC 9965에서 146.2초, 32코어 EPYC 9175F에서 382.2초까지 다양했습니다.
해머DB
데이터베이스 테스트를 위해 HammerDB의 개발자이자 유지 관리자인 스티브 쇼(Steve Shaw)를 초빙했습니다. 쇼는 Vera 서버, EPYC 9965가 탑재된 Dell PowerEdge R7725, 그리고 Xeon 6787P가 탑재된 PowerEdge R770에서 HammerDB의 TPROC-C 워크로드(TPC-C에서 파생되었지만 공개된 TPC 결과와는 직접 비교할 수 없는 OLTP 벤치마크)를 실행했습니다. 그는 각 서버에서 MariaDB 12.3.3 및 13.0.2, MySQL 26.7.0, VillageSQL 0.0.7, PostgreSQL 18.6 등 5개의 오픈 소스 엔진을 테스트했습니다. 데이터베이스 크기는 물리적 코어당 16개의 웨어하우스, 즉 단일 Vera 소켓의 경우 1,408개의 웨어하우스로 코어 수에 비례하여 확장되었습니다.
각 엔진은 단일 소켓과 두 개의 소켓에서 실행되었으며, 단일 소켓 실행 시에는 두 번째 소켓의 CPU를 오프라인으로 전환했습니다. 모든 시스템은 단일 소켓에서 더 나은 성능을 보였는데, 이는 데이터베이스 성능에서 일반적인 결과입니다. 15개 쌍 모두에서 두 번째 소켓을 추가하면 최대 처리량이 23%에서 47%까지 감소했으며, Vera에서는 29%에서 45%까지 감소했습니다. Shaw는 오픈 소스 데이터베이스가 코어 수를 다 사용하기 전에 확장 한계에 도달한다는 사실을 오랫동안 알고 있었습니다. 그 시점을 넘어서면 두 소켓에 걸쳐 캐시 일관성을 유지하는 데 드는 비용이 추가 코어 수보다 더 많이 발생합니다. 따라서 아래 차트에 표시된 단일 소켓 결과에 초점을 맞추었습니다.
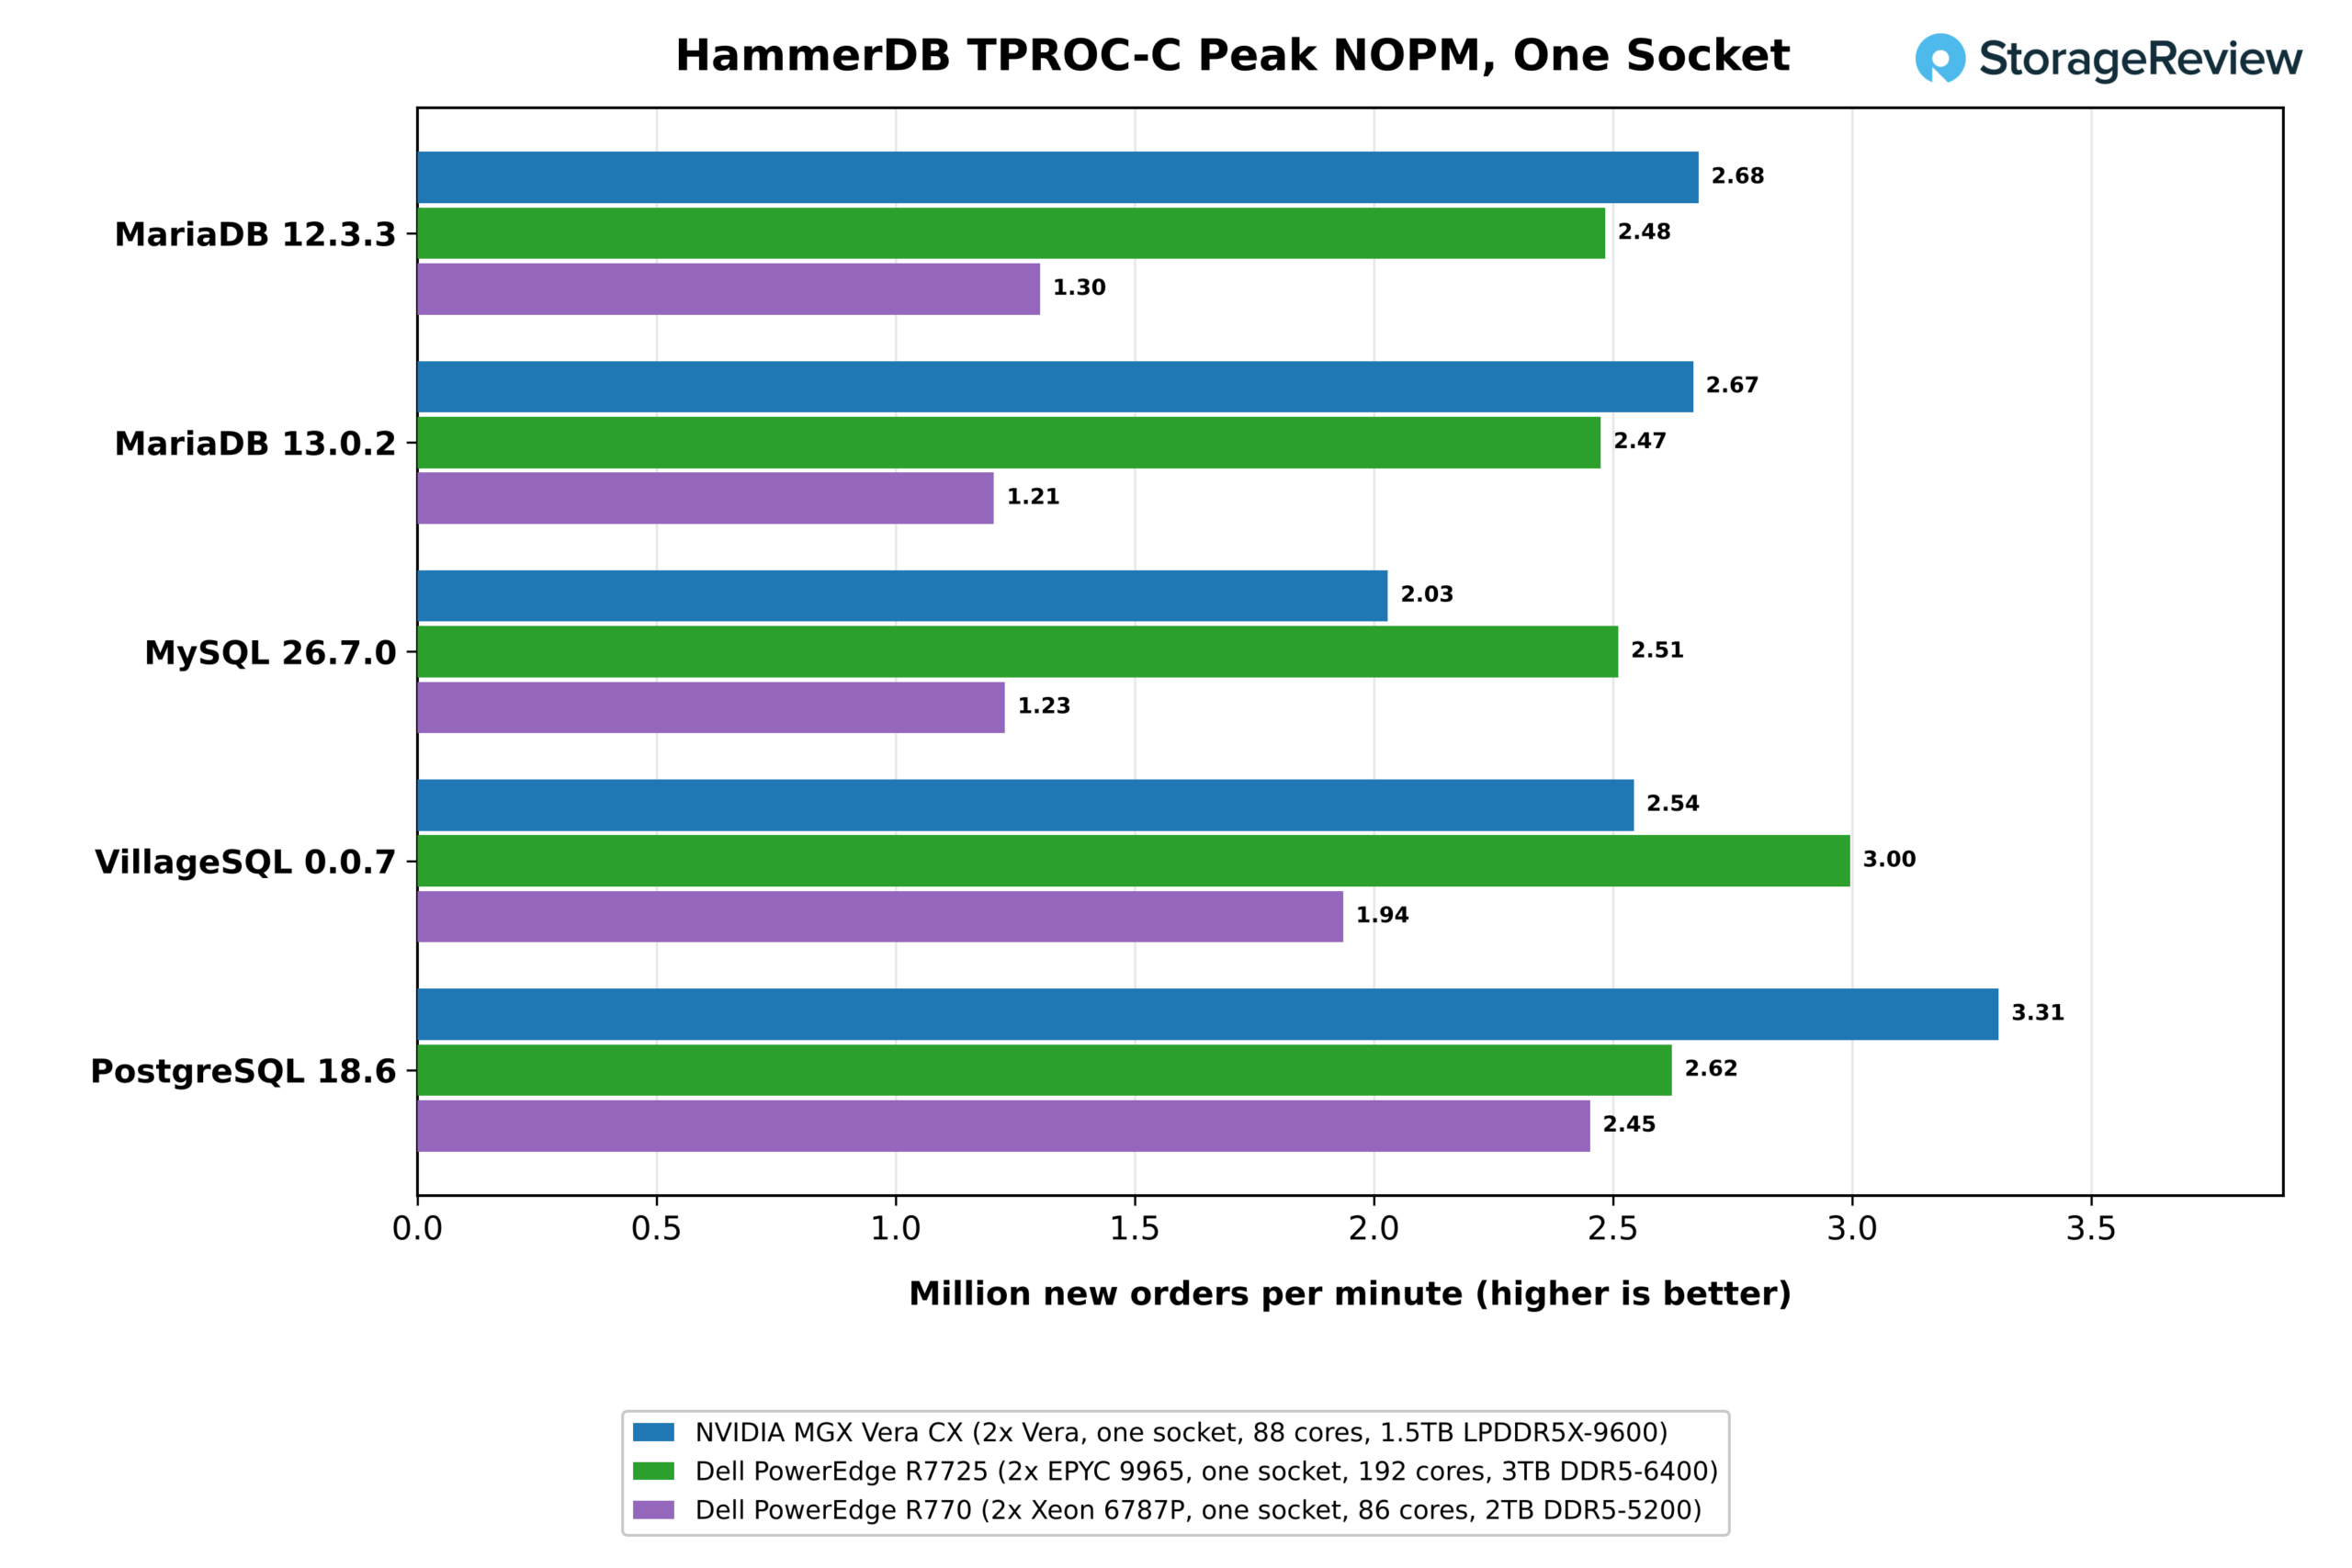
한 소켓에서 88개의 Vera 코어는 5개 엔진 중 3개에서 선두를 차지했습니다. PostgreSQL 18.6은 Vera에 가장 큰 격차를 안겨주었는데, 128명의 가상 사용자 기준으로 분당 3.31만 건의 신규 주문(NOPM)을 처리하며 192코어 EPYC 9965 소켓의 2.62만 건, 86코어 Xeon 6787P의 2.45만 건을 앞섰습니다. MariaDB 두 버전 모두 Vera가 2.68만 건과 2.67만 건으로 EPYC의 2.48만 건과 2.47만 건보다 우수한 성능을 보였습니다. AMD는 MySQL 26.7.0에서 2.51만 건으로 Vera의 2.03만 건을 앞섰고, VillageSQL에서는 3.00만 건으로 Vera의 2.54만 건을 앞섰습니다. Xeon은 5개 엔진 모두에서 1.21만 건에서 2.45만 건으로 Vera보다 뒤처졌으며, MariaDB 결과는 Vera의 절반에도 미치지 못했습니다.
이러한 차이는 각 엔진의 확장성 방식에 따른 것으로 보입니다. PostgreSQL의 연결당 프로세스 모델과 MariaDB의 InnoDB는 모두 많은 코어에 작업을 분산시키고 공유 메모리 트래픽이 많아 STREAM에서 각 Vera 소켓이 유지했던 1TB/s 이상의 로컬 대역폭을 활용합니다. MySQL과 VillageSQL은 내부 잠금 경합이 더 빨리 발생하므로 결과는 각 코어가 임계 영역을 얼마나 빨리 처리하는지에 더 크게 좌우되며, 바로 이 부분에서 9965가 우위를 점합니다. 10월 테스트 후 Shaw는 Arm이 전반적으로 가장 빠른 플랫폼이라고 평가하며 Arm이 "확실히 경쟁력 있는 데이터베이스 서버로 자리 잡았다"고 말했지만, 이전에 테스트했던 단일 소켓 96코어 EPYC가 Arm을 앞설 수도 있다고 덧붙였습니다.
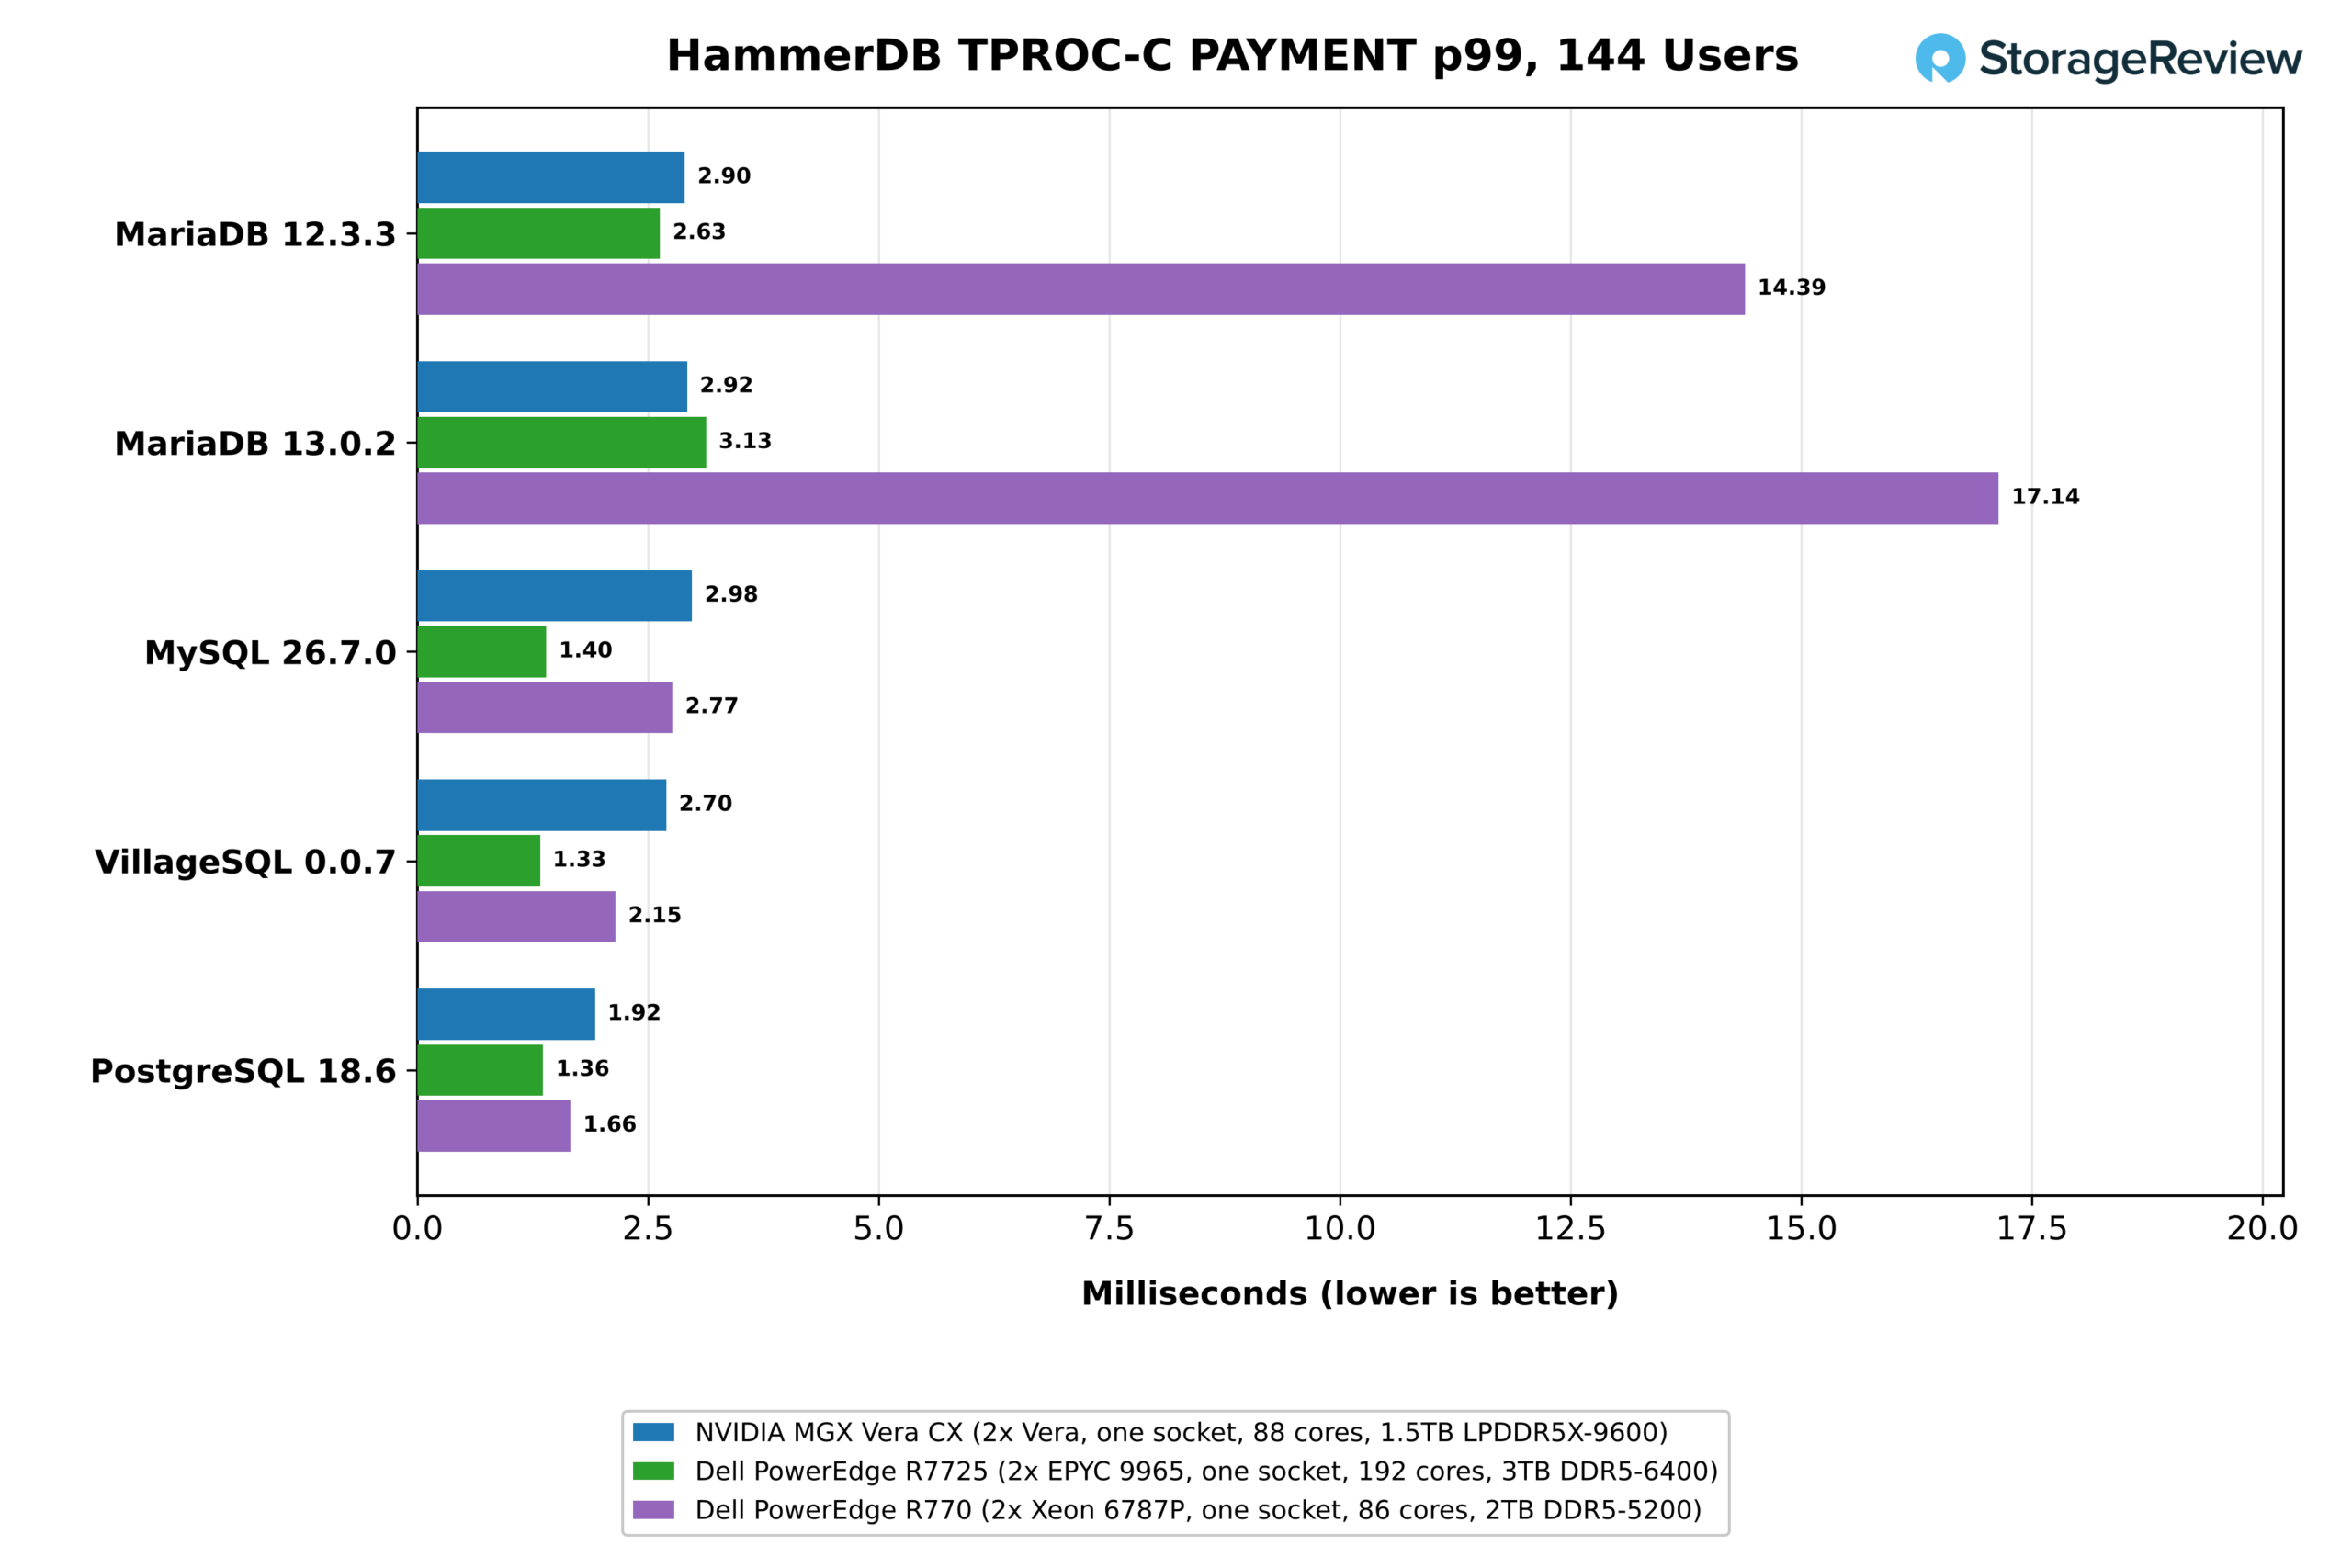
144명의 가상 사용자 부하에서 테일 레이턴시를 분석한 결과, 동일한 결과가 나타났습니다. Vera의 PAYMENT p99 레이턴시는 PostgreSQL에서 1.92ms, MySQL에서 2.98ms였습니다. EPYC 9965는 MySQL, VillageSQL, PostgreSQL에서 1.33ms에서 1.40ms 사이의 레이턴시를 기록하며 Vera보다 29%에서 53% 낮은 성능을 보였지만, MariaDB 13.0.2에서는 3.13ms로 Vera의 2.92ms보다 뒤처졌습니다. Xeon 6787P의 MariaDB 테일 레이턴시는 14.4ms와 17.1ms로, 동일 부하에서 처리량이 훨씬 낮은 점을 감안하면 두 프로세서 모두보다 몇 배나 높았습니다. 엔진 내부의 락 핸드오프가 Vera의 높은 테일 레이턴시의 원인일 가능성이 높으며, 이는 Valkey 테스트 결과와도 일치하는데, Valkey 테스트에서도 요청이 하나씩 전송되는 방식이 AMD에 유리하게 작용했습니다.
11월 테스트에서 쇼의 예상은 적중했는지 검증되었습니다. 그는 AMD의 새로운 256코어 EPYC 9996과 96코어 EPYC 9686F의 한 소켓에서 동일한 워크로드를 실행했고, 비교 대상에는 Vera의 소켓도 포함했습니다. 9996과 Vera는 서로 엔진 성능을 주고받았는데, Vera는 PostgreSQL과 MariaDB에서는 우위를 점했지만 EPYC는 테일 레이턴시에서 앞섰고, PostgreSQL에서는 96코어 EPYC가 Vera를 근소한 차이로 앞섰습니다. 전체 결과는 AMD EPYC Venice 리뷰 에서 확인할 수 있습니다.
"NVIDIA Vera에서 오픈소스 데이터베이스의 성능에 진심으로 감명받았습니다. Arm이 데이터베이스 성능 분야에서 최고 수준으로 경쟁하고 기업 시장에 매력적인 대안을 제시하는 것을 보니 정말 기쁩니다."라고 HammerDB의 개발자이자 관리자인 스티브 쇼는 테스트 후 소감을 밝혔습니다.
맺음말
베라(Vera)는 모든 부문에서 가장 빠른 프로세서는 아닙니다. AMD는 시장의 각 부문에 특화된 프로세서를 제공하기 때문입니다. 클럭 속도에 최적화된 EPYC 9175F는 코어당 속도에 중점을 두고 설계되었으며, 파이썬의 nbody, 단일 스레드 AES, 그리고 한 번에 하나씩 처리하는 Valkey 요청과 같이 빠른 클럭 속도가 중요한 작업에서 여전히 뛰어난 성능을 보여줍니다. EPYC 9965는 처리량에 중점을 두고 설계되었으며, GROMACS, 모든 스레드를 사용하는 7-Zip, AES, 그리고 소켓에 장착할 수 있는 Valkey 샤드 수와 같이 코어 수에 따라 성능이 향상되는 작업에서 우위를 점합니다.
Vera가 차별화되는 점은 중간 성능 영역, 특히 각 분야의 전문가들과 얼마나 근접한 성능을 보이는지에 있습니다. 단일 스레드 환경에서 Vera는 정수 연산 및 세 가지 Python 테스트 중 두 가지에서 9175F와 동등하거나 그 이상의 성능을 보였으며, 7-Zip 압축에서는 12% 더 빠르고, go와 regex_compile 실행에서는 각각 15%와 25% 더 빠른 속도를 기록했습니다. 다만 부동 소수점 연산과 암호화 연산에서는 다소 뒤처졌습니다.
전체 시스템에서 Vera는 9965의 모든 스레드 7-Zip 실행 속도의 63%~72%에 도달했고, 중간 크기 OpenFOAM 메시 테스트에서는 9965와 12% 이내의 차이를 보였으며, 메모리 성능이 향상됨에 따라 대형 메시 테스트와 ClickBench 테스트에서는 오히려 앞서 나갔습니다. 단일 스레드에서 코어당 성능 1위 제품과 근접한 성능을 유지하고, 전체 시스템 처리량에서도 1위 제품과 어깨를 나란히 하는 것이 Vera를 강력한 범용 프로세서로 만드는 요소입니다. 성능 면에서 크게 뒤처지지 않으면서 광범위한 중견 시장을 위한 단일 플랫폼을 원하는 구매자에게 Vera는 매우 매력적인 선택입니다.
Vera는 테스트한 어떤 x86 시스템보다 훨씬 뛰어난 메모리 대역폭을 제공합니다. 두 개의 Vera 소켓은 STREAM Triad에서 2,073GB/s의 속도를 유지했는데, 이는 여기 있는 최고의 DDR5 서버보다 2.3배 빠른 속도입니다. 또한 NVLink-C2C를 통해 소켓 간에도 이러한 대역폭을 유지할 수 있습니다. Vera의 코어는 다른 소켓의 메모리를 677GB/s의 속도로 읽는데, 이는 어떤 x86 소켓보다도 빠른 속도입니다.
메모리 제약이 심한 워크로드 테스트 결과가 이어졌습니다. 대규모 OpenFOAM 메시는 EPYC 9965보다 1.44배 빠르게 해결되었고, ClickBench의 핫런은 2.70초에서 2.09초로 단축되었으며, 256GB Valkey 워킹 세트는 34% 더 빠르게 실행되었습니다. 또한 단일 소켓 테스트에서 Vera는 PostgreSQL 기반 HammerDB와 두 MariaDB 버전 모두를 능가했습니다. 링크 비용은 지연 시간으로 나타납니다. 원격 읽기는 로컬 읽기보다 약 2.1배 더 오래 걸리는데, EPYC 9175F에서는 1.75배였습니다. 따라서 Vera에서도 NUMA 인식 배치와 대용량 페이지는 여전히 중요합니다.
약점은 놀랍도록 미미하며 설계상의 문제에서 직접적으로 비롯됩니다. 6개의 128비트 SVE2 파이프는 해당 파이프용으로 작성된 코드에서 512비트 AVX-512 유닛과 일치하지 않으므로, Vera의 16코어 슬라이스는 GROMACS benchMEM을 9175F의 절반, 9965의 3분의 2 속도로 실행했습니다. 암호화를 처리하는 파이프가 두 개뿐인 경우, 단일 Olympus 코어는 AES-256-GCM을 9175F의 약 3분의 1 속도로 암호화했습니다.
Vera의 미래는 OEM 파트너들의 역량에 크게 좌우될 것입니다. Dell의 PowerEdge R8822는 10월부터 출하를 시작했으며, M9882 Vera CPU 랙은 2027년 1분기에 출시될 예정입니다. HPE의 ProLiant Compute DL394 Gen12는 올가을 출시 예정이고, Supermicro는 256 CPU Vera 랙을 제공하며, 공랭식 1U 및 2U Vera 시스템 라인업을 갖추고 있습니다. ASUS, ASRock Rack, QCT, GIGABYTE, MSI, Compal, Foxconn, Pegatron, Wistron, Lenovo 등 여러 회사에서 Vera 설계안을 선보였습니다. Oracle Cloud는 Vera 인스턴스를 일반에 공개했으며 , CoreWeave, Nebius, Lambda 등이 뒤이어 출시될 예정입니다.
Vera는 일반적인 작업에서 x86 플래그십 프로세서와 어깨를 나란히 할 수 있는 최초의 Arm 서버 프로세서이며, 공랭식 듀얼 소켓 시스템에 2TB/s의 메모리 대역폭을 탑재한 최초의 프로세서입니다. 광범위한 중견 시장에서 Vera는 현재 충분히 경쟁력 있는 선택지이며, NVIDIA는 다른 어떤 회사도 제공하지 않는 메모리 서브시스템을 통해 CPU 시장에 진출했습니다. 벡터 연산 중심의 HPC 및 암호화 관련 서비스 분야에서는 x86 전문가들이 여전히 선두를 유지하고 있습니다. 저희는 OEM 시스템들이 연구실에 도착하는 대로 동일한 테스트 프로그램을 진행할 예정이며, NVIDIA가 이 프로세서를 개발한 목적에 부합하는 에이전트 샌드박스 환경부터 시작할 것입니다.
이 리뷰 이후 AMD의 EPYC Venice가 저희 연구실에 도착했으며, AMD EPYC Venice SP7 리뷰 와 Dell PowerEdge R9825 리뷰에서 256코어 EPYC 9996을 최신 펌웨어가 설치된 Vera를 사용하여 동일한 테스트 스위트로 검증했습니다.
순위표: NVIDIA Vera가 최고의 서버 순위표 에서 최고의 Arm 구현체로 선정되었습니다.


 아마존