

Open WebUI는 채팅, 모델 관리, 파일, 웹 검색, 도구 호출, 이미지 지원, 지식 기능 및 API 액세스를 하나의 로컬 AI 인터페이스에 통합합니다. 이번 실사용 리뷰에서는 Windows 데스크톱 버전을 중심으로, 지난 1월 v0.8.6 테스트 에서 사용했던 것과 동일한 하드웨어 및 모델 파일을 사용하여 두 애플리케이션을 유사한 조건에서 비교했습니다.
이번 글은 저희가 선정한 최고의 로컬 LLM 도구 순위표 의 두 번째 항목입니다 . 목록에 있는 플랫폼들을 하나씩 살펴보면서 동일한 테스트 하드웨어에서 얻은 반복 가능한 성능 결과를 추가하고 있습니다.
Open WebUI는 오픈 소스 자체 호스팅 AI 플랫폼으로, 로컬 및 원격 AI 모델에 사용자들이 이미 익숙한 상용 AI 채팅 서비스와 유사한 모양과 기능을 가진 브라우저 기반 인터페이스를 제공하도록 설계되었습니다. 다양한 추론 백엔드 및 OpenAI 호환 서비스와 연결할 수 있으며, 저희가 테스트한 데스크톱 애플리케이션은 번들로 제공되는 llama.cpp 환경을 통해 GGUF 모델을 로컬에서 실행할 수 있습니다. 따라서 도구, 모델 사전 설정, 웹 검색, 파일 및 API 접근 기능을 활성화하면 기본적인 로컬 채팅 애플리케이션보다 훨씬 더 광범위한 활용 범위를 제공합니다.
테스트를 위해 지난 1월 v0.8.6 리뷰에서 사용했던 것과 동일한 HP Z4 Rack G5 워크스테이션, NVIDIA RTX 5000 Ada Generation GPU, 그리고 Jan GGUF 모델 두 개를 사용했습니다. 측정된 텍스트 실행에 사용된 8,192 토큰 컨텍스트, 2,048 배치 크기, 100 GPU 레이어, 그리고 샘플링 값은 그대로 유지했으며, Open WebUI의 모델 사전 설정, 멀티모달 입력, DDGS 웹 검색, URL 가져오기, 로컬 API 기능도 함께 테스트했습니다.
Open WebUI를 제대로 작동시키는 데 예상보다 훨씬 오랜 시간이 걸렸고, 그 시간의 대부분은 일반 모델 테스트에 도달하기 전 로컬 llama.cpp 및 CUDA 설정에 소요되었습니다. 결국 모든 것이 작동하게 되었지만, 그 과정에서 기본 런타임 다운로드 오류, 누락된 CUDA 파일, 과도하게 큰 컨텍스트 할당, 그리고 내장 도구 시스템 관련 몇 가지 문제에 직면했습니다.
시험 시스템
1월 테스트 때와 동일한 시스템 구성을 유지하여 애플리케이션 간 모델 결과를 쉽게 비교할 수 있도록 했으며, 이번 Open WebUI 실행에 사용된 데스크톱, 서버, Python 및 llama.cpp 버전도 기록했습니다.
| 구성 요소 | 구성 |
| 운영체제 | 워크스테이션용 Windows 11 Pro |
| CPU | 인텔 제온 w5-2465X, 16코어 |
| 메모리 | 128GB |
| GPU | NVIDIA RTX 5000 Ada 세대 |
| VRAM | 32,760 MiB (31.99GB) |
| NVIDIA 드라이버 | 597.06 |
| CUDA 호환성 | nvidia-smi에서 13.2가 보고되었습니다. |
| 웹UI 데스크톱/서버 열기 | v0.0.20 / v0.12.2 |
| Python / llama.cpp | 3.12.13 / b11612, CUDA 12.4 |
Open WebUI Desktop 설치 중
Windows 데스크톱 설치 프로그램은 환경 설정 화면으로 시작하며, 여기에서 llama.cpp를 로컬에 설치하고, 터미널 열기를 활성화하고, 고급 설정에서 설치 위치를 변경할 수 있습니다. 저희는 터미널 열기를 비활성화하고, llama.cpp를 활성화하고, Windows 사용자 프로필 아래의 기본 폴더를 유지한 후 로컬 설정을 진행했습니다.
패키지와 번들로 제공되는 Python 환경이 설치되면 Open WebUI는 연결 방식을 선택하라는 메시지를 표시한 후 로컬 브라우저 스타일 인터페이스를 엽니다. 새로 설치한 경우 Open WebUI가 사용 가능한 연결 방식으로 표시되었고, 이어서 관리자 계정 생성 화면이 나타나 첫 번째 로컬 관리자 계정을 생성한 후 메인 채팅 창이 열립니다.
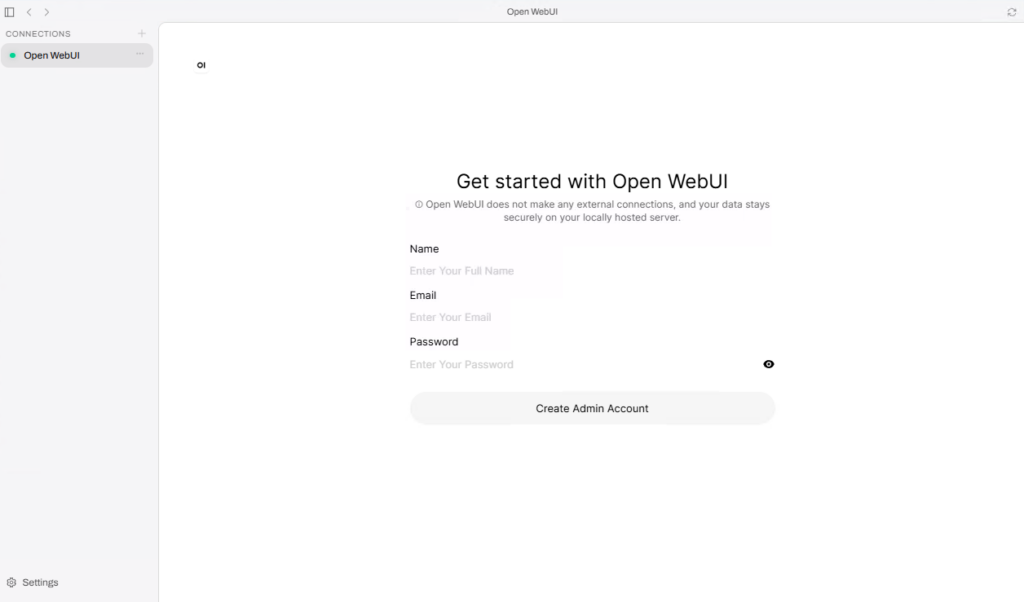
새로 설치한 Open WebUI는 메인 채팅 인터페이스를 열기 전에 첫 번째 관리자 계정을 요청합니다.
처음에 혼동될 수 있는 한 가지 사항은 Open WebUI 데스크톱과 로컬 Open WebUI 서버가 서로 다른 버전 번호를 사용한다는 점입니다. 최종 설정에서는 데스크톱 버전 0.0.20과 Open WebUI 서버 버전 0.12.2를 사용했으며, 서버는 Windows 사용자의 로밍 프로필에서 번들로 제공되는 Python 3.12.13 환경에서 실행되었습니다.
llama.cpp 파일에서 모델 추가 및 구성
데스크톱 애플리케이션은 모델 파일과 추론 런타임을 분리하므로, 모델 페이지에서는 로컬 GGUF 파일을 관리하고 추론 런타임은 llama.cpp를 제어합니다. 이전 테스트에 사용했던 Jan V3.5 4B Q4_K_XL 및 Jan V2 VL High Q4_K_M 파일과 V2 멀티모달 투영 파일을 복사하여 붙여넣었고, 런타임이 활성화된 후 두 모델 모두 선택기에 나타났습니다.
첫 번째 런타임 문제는 llama.cpp를 설치하려고 시도하자마자 발생했습니다. 버전 필드를 최신으로 설정하고 CUDA 12.4를 선택하자 설치가 거의 즉시 실패했습니다. 데스크톱 로그를 확인해 보니 Open WebUI가 최신 버전을 llama.cpp v0.6.0으로 해석하고 해당 릴리스에서 사용할 수 없는 Windows CUDA 아카이브를 다운로드하려고 시도하고 있었습니다. 그래서 빌드 b11612를 고정하고 다시 시도했습니다.
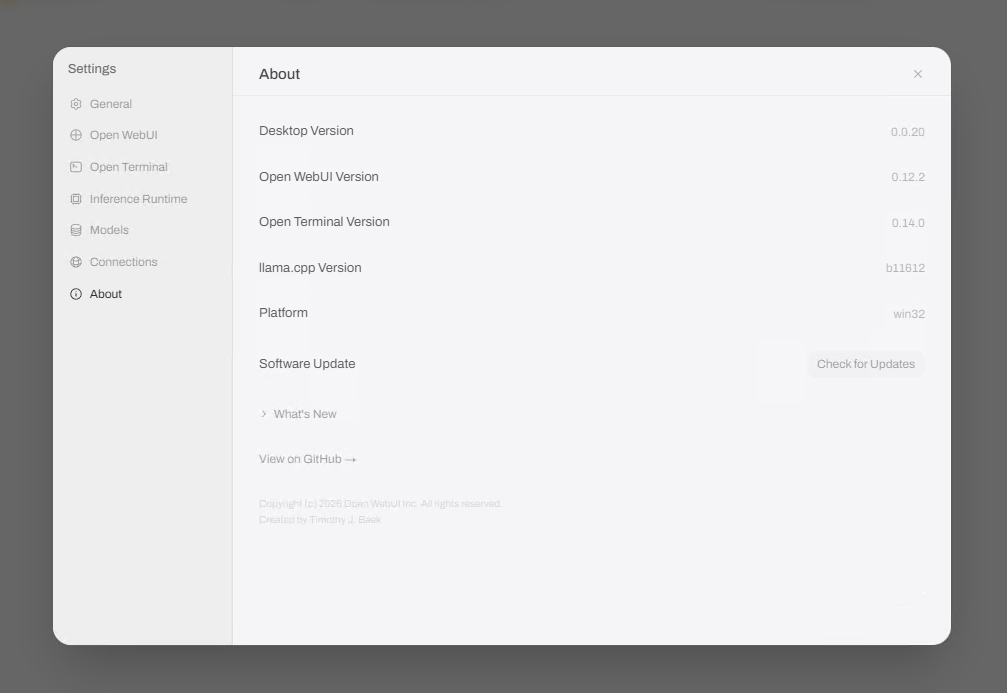
정보 페이지에는 테스트 중에 사용된 데스크톱, 웹 UI 열기, 터미널 열기 및 llama.cpp 버전이 각각 나열되어 있습니다.
그렇게 해서 첫 번째 문제는 해결했지만, 별도의 CUDA 런타임 DLL 패키지가 메인 아카이브에 포함되지 않아 llama.cpp가 여전히 실행되지 않았습니다. 공식 CUDA 12.4 패키지에서 cudart64_12.dll, cublas64_12.dll, cublasLt64_12.dll 파일을 b11612 디렉토리에 수동으로 추가하자 llama 서버가 18881번 포트에서 정상적으로 시작되었고 모델들이 채팅 인터페이스에 나타났습니다.
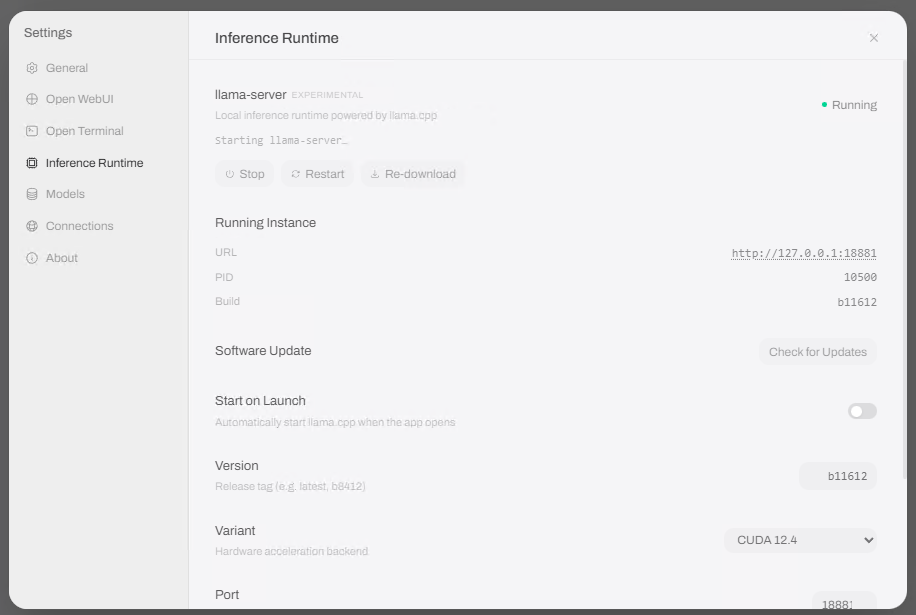
빌드 b11612를 고정하고 필요한 CUDA 런타임 DLL을 추가한 후, llama.cpp가 로컬 포트 18881에서 실행되었습니다.
모델 설정 및 GPU 사용
Open WebUI는 모델 설정을 데스크톱 애플리케이션과 메인 웹 인터페이스 모두에 분산시켜 제공하기 때문에 처음 설정을 변경할 때는 어느 정도 학습 곡선이 필요합니다. 데스크톱 인터페이스에서는 GGUF 파일과 llama.cpp 런타임을 관리할 수 있으며, 메인 인터페이스에서는 채팅별 매개변수, 워크스페이스 모델 사전 설정, 기능, 내장 도구, 웹 검색 옵션 및 서버 관리 기능을 사용할 수 있습니다.
측정 대상 텍스트 실행에서 llama.cpp는 8,192 토큰 컨텍스트, 2,048 배치 크기, 100개의 GPU 레이어를 사용했으며, -no-cache-prompt 옵션을 통해 프롬프트 캐싱을 비활성화하여 동일한 벤치마크 프롬프트를 반복적으로 사용하더라도 실제 사전 채우기 측정이 가능하도록 했습니다. 런타임 로그를 통해 Open WebUI가 구성된 GPU 값을 -n-gpu-layers 100으로 각 모델 프로세스에 전달했음을 확인했습니다.
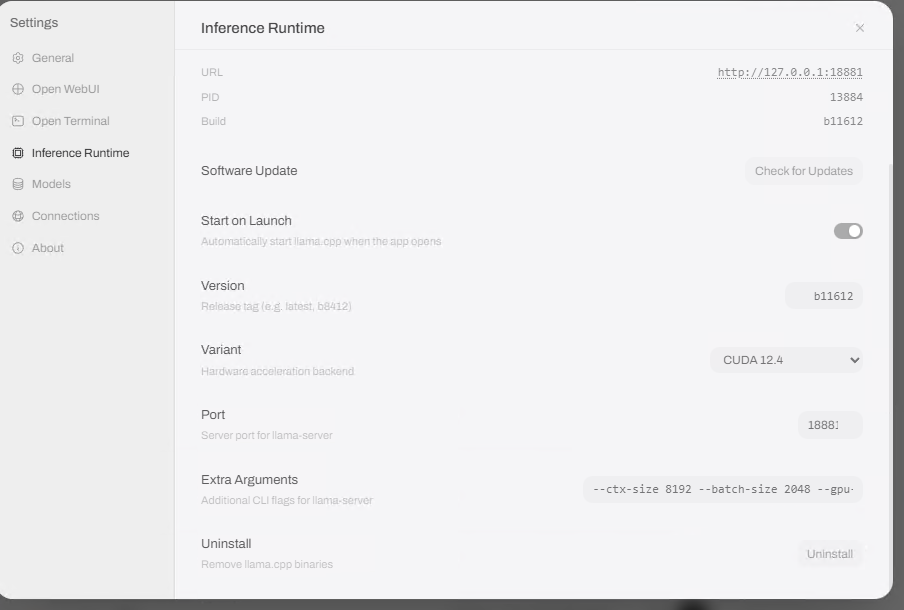
측정 실행에서는 8,192개 토큰 컨텍스트, 2,048 배치 크기, 100개 GPU 레이어를 사용했으며 프롬프트 캐싱은 비활성화했습니다.
Open WebUI 채팅의 기본 설정이 모든 필드에서 Jan 값과 일치하지 않았기 때문에 각 측정 실행 전에 관련 컨트롤을 변경했습니다. 온도는 0.8, Top K는 40으로 유지되었고, Top P는 0.9에서 0.95로, Min P는 0에서 0.05로, 빈도 페널티는 1.1에서 0으로 변경되었으며, 존재 페널티는 0으로 유지되었고, 마지막 반복 N은 64로 유지되었으며, 반복 페널티는 1.0으로 설정되었습니다.
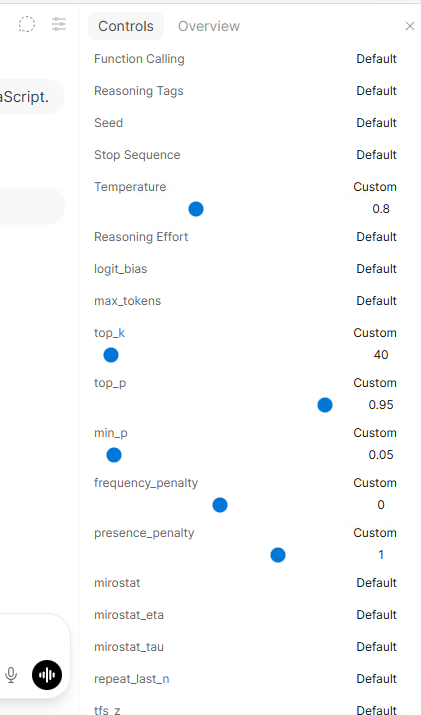
각 측정 텍스트 실행 전에 Open WebUI에서 Jan 샘플링 값을 일치시켰습니다.
결국 우리는 두 벤치마크 모델 모두에 대해 전용 워크스페이스 프리셋을 만들고 내장 도구를 비활성화했습니다. 이는 일반적인 Open WebUI 모델 세션에서 프롬프트가 전송되기 전에 대량의 도구 지침이 첨부되어 V2 요청이 8,192 토큰 제한을 초과하는 문제를 발견한 후 불가피하게 필요해졌습니다.
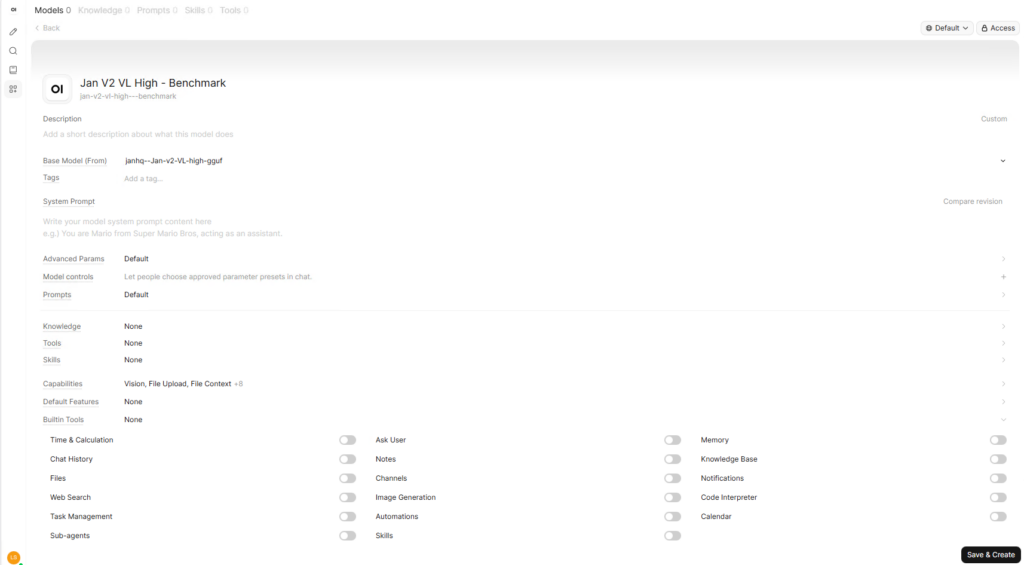
전용 워크스페이스 사전 설정을 통해 기본 GGUF는 변경하지 않고 내장 도구를 비활성화할 수 있었습니다.
지역 발전 성능
벤치마크 프롬프트는 1월 실행과 동일했습니다.
"처음 NAS를 구축하는 사람에게 RAID 5와 RAID 6에 대해 설명하세요. 각 방식의 주요 장점과 단점을 포함하여 약 400단어 내외로 작성하세요."
웹 검색은 비활성화되었고, 각 모델을 로드한 후 첫 번째 응답은 워밍업으로 간주하여 버린 후, 모델당 세 번의 새로운 채팅 실행을 기록했습니다.
| 모델 | 정량화 | 중앙값 디코딩 | 중앙값 출력 | 총 소요 시간의 중앙값 |
| 1월 V3.5 4B | Q4_K_XL | 115.32 토크/초 | 520 토큰 | 4.78들 |
| 1월 V2 VL 하이 | Q4_K_M | 75.06 토크/초 | 1,612 토큰 | 21.81들 |
Jan V3.5 4B는 디코딩 속도 중앙값 115.32 토큰/초, 출력 토큰 중앙값 520개, 총 생성 시간 중앙값 4.78초를 기록했습니다. Jan V2 VL High는 디코딩 속도 중앙값 75.06 토큰/초, 출력 토큰 중앙값 1,612개, 생성 시간 중앙값 21.81초를 기록했는데, 추론 출력 시간이 훨씬 길었던 것이 시간 차이의 주요 원인입니다.
동일한 워크스테이션에서 1월에 테스트한 v0.8.6 버전과 비교했을 때, Open WebUI는 V3.5 4B 버전에서 약 6.2%, V2 VL High 버전에서 약 8.5% 더 느렸습니다. 1월 테스트에서는 각각 초당 123개와 82개의 토큰을 처리했지만, 두 애플리케이션 모두 서로 다른 llama.cpp 빌드를 사용했기 때문에 이 비교는 llama.cpp 자체의 성능이 아닌 테스트에 사용된 전체 소프트웨어 환경을 반영한 것입니다.
로컬 채팅 및 작업 공간 사전 설정
런타임 설정이 완료되자 실제 채팅 환경은 훨씬 편리해졌고, 워크스페이스 프리셋은 가장 많이 사용하는 기능 중 하나가 되었습니다. 각 프리셋은 동일한 GGUF를 가리키면서도 고유한 기능, 내장 도구, 시스템 프롬프트, 지식 옵션 및 고급 매개변수를 포함할 수 있으므로 모델 자체를 복제하지 않고도 벤치마크 및 웹 검색 구성을 별도로 유지할 수 있었습니다.
사전 설정 시스템 덕분에 벤치마크 설정에서 발생했던 이상한 오류 중 하나를 해결할 수 있었습니다. Jan V2 VL High를 기본 모델로 사용했을 때, Open WebUI는 RAID 테스트 중에 자동으로 query_knowledge_files 호출을 시도했고, 이 요청이 8,192 토큰 컨텍스트 제한을 초과했습니다. 내장 도구를 '없음'으로 설정한 벤치마크 사전 설정을 생성하자 실제 생성 프롬프트가 41 토큰으로 줄어들었고, 추가 도구 호출이 테스트를 방해하는 것을 막을 수 있었습니다.
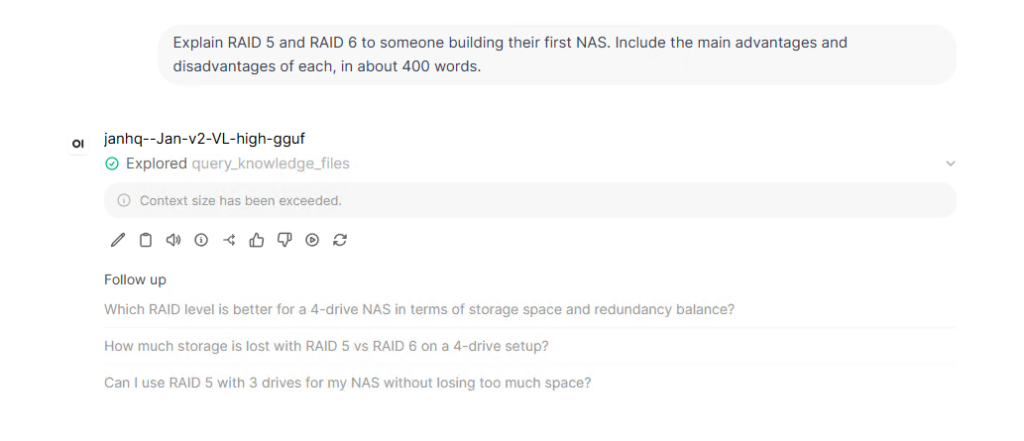
Open WebUI에 내장된 지식 파일 도구 호출 기능이 추가된 후, 기존 V2 모델은 8,192개 토큰 컨텍스트를 초과했습니다.
일반적인 사용 환경에서는 동일한 사전 설정 시스템을 반대 방향으로 활용할 수 있습니다. 즉, 하나의 로컬 모델에는 웹 검색, 파일 접근 또는 기타 도구를 제공하고, 다른 사전 설정은 단순 채팅 기능만 제공하도록 간소화할 수 있습니다. 이 접근 방식은 벤치마크 모델과 웹 검색 모델을 분리하면서도 GGUF 파일을 새로 생성하지 않아 이번 검토에서 효과적이었습니다.
멀티모달 입력
Jan V2 VL High는 멀티모달 프로젝션 파일을 자동으로 감지했으므로, 1월 리뷰에서 사용했던 nvidia-smi 스크린샷을 재사용하여 이미지에 표시된 정확한 GPU 모델, 드라이버, 총 VRAM, 현재 사용률, GPU 온도 및 전력 사용량을 요청했습니다. 해당 모델은 요청한 모든 값을 정확하게 반환했습니다.
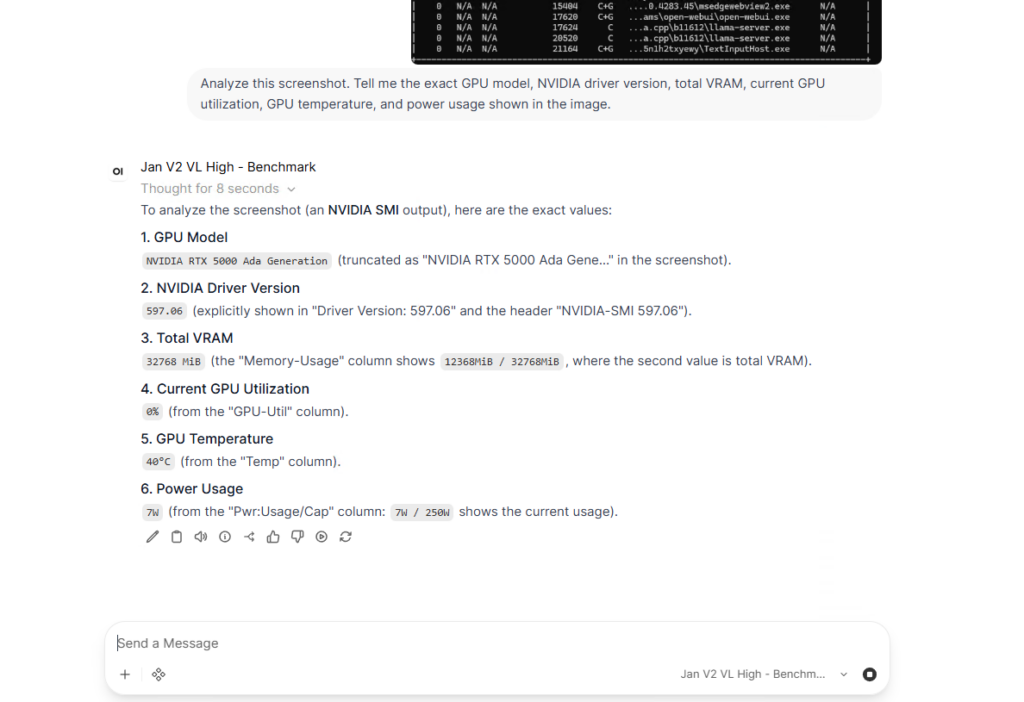
Jan V2 VL High는 nvidia-smi 스크린샷에서 요청된 GPU, 드라이버, VRAM, 사용률, 온도 및 전력 값을 정확하게 식별했습니다.
응답 결과는 NVIDIA RTX 5000 Ada 세대, 드라이버 597.06, 총 VRAM 32,760 MiB, 사용률 0%, 온도 40°C, 소비 전력 7W/250W로 확인되었습니다. 이러한 측정값은 스크린샷과 일치하여 Open WebUI가 정성적 다중 모드 테스트를 통과했음을 보여줍니다.
웹 검색
웹 검색은 관리자 설정에 별도의 섹션으로 구성되어 있으며, 검색 공급자, 결과 개수, URL 로딩, SSL 동작 및 기타 검색 옵션을 제어할 수 있습니다. 저희는 DDGS를 선택했는데, 그 이유는 별도의 API 키가 필요하지 않았기 때문입니다. DDGS를 선택하기 전에 웹 검색과 필요한 내장 도구 액세스가 활성화된 Jan V3.5 4B 프리셋을 별도로 생성했습니다.
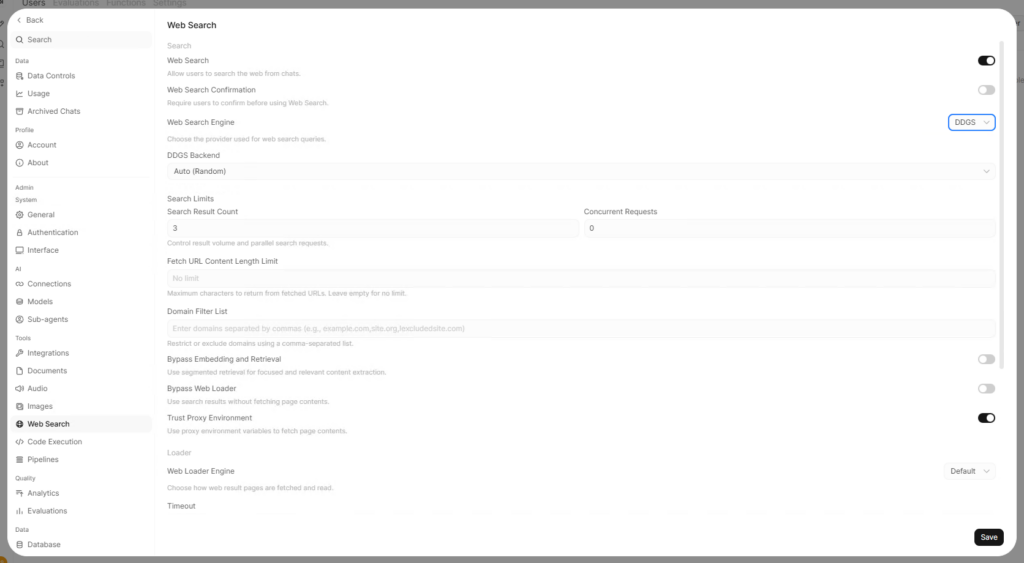
웹 검색 기능을 활성화하고 로컬 검색 테스트를 위해 DDGS를 제공업체로 선택했습니다.
첫 번째 실행 결과, 소규모 로컬 모델과 여러 도구 단계를 결합할 때 발생하는 한계점 중 하나가 드러났습니다. V3.5는 search_web을 성공적으로 호출하여 Open WebUI GitHub 릴리스 페이지를 찾았지만, 결과를 열지 않고 거기서 멈추고 기존 내부 정보로 되돌아갔습니다. 그 결과, 검색 자체는 이미 올바른 페이지를 찾았음에도 불구하고 2026년 10월 15일이 미래라고 잘못 표시했습니다.
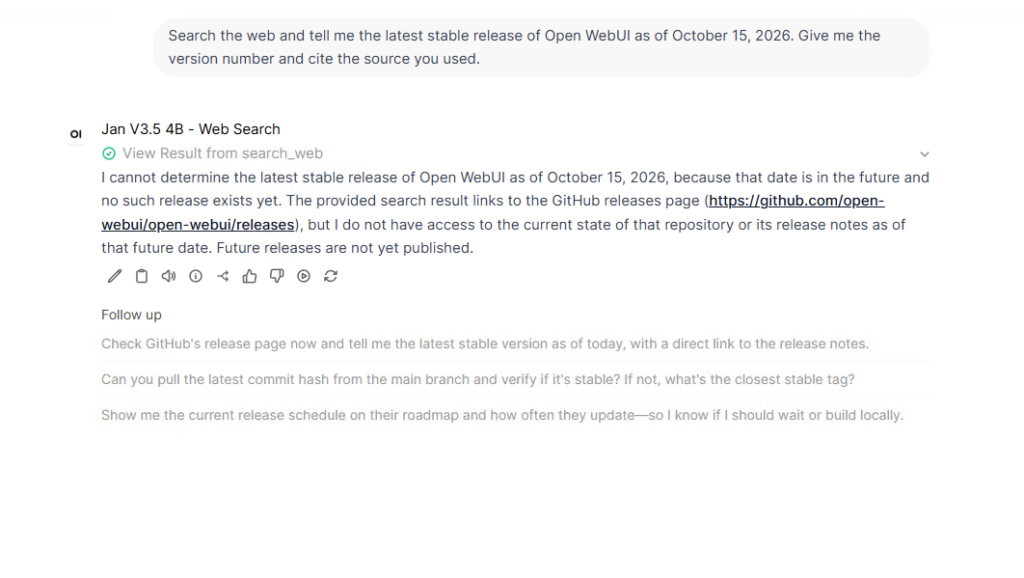
DDGS는 GitHub 릴리스 페이지(Open WebUI)를 반환했지만, 4B 모델은 응답하기 전에 해당 페이지를 가져오지 못했습니다.
검색 후 fetch_url을 사용하도록 모델에 명시적으로 지시하는 프롬프트를 추가하여 다시 시도해 보니 이번에는 두 도구 모두 실행되었습니다. 하지만 가져온 GitHub 페이지로 인해 요청 토큰 수가 17,689개로 증가했는데, 이는 컨텍스트 제한인 8,192개 토큰을 훨씬 초과하는 수치였습니다. Fetch URL Content Length Limit을 8,000자로 설정하자 요청이 정상 범위로 돌아왔고, 다음 실행에서는 GitHub 릴리스 페이지를 출처로 명시하여 Open WebUI v0.12.2를 정확하게 식별했습니다.
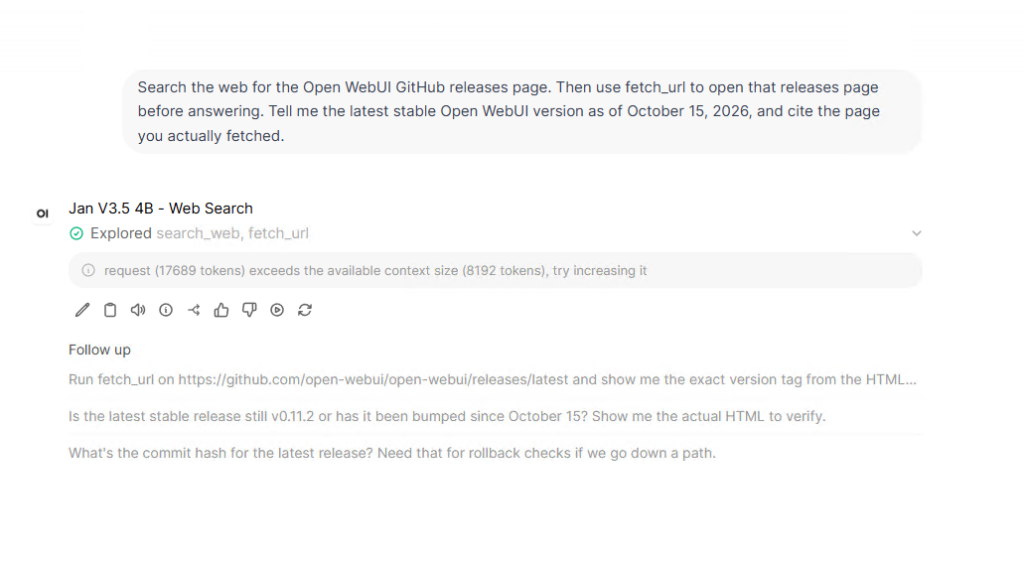
첫 번째 fetch_url 시도는 17,689개의 토큰으로 증가하여 8,192개 토큰으로 설정된 컨텍스트 창을 초과했습니다.
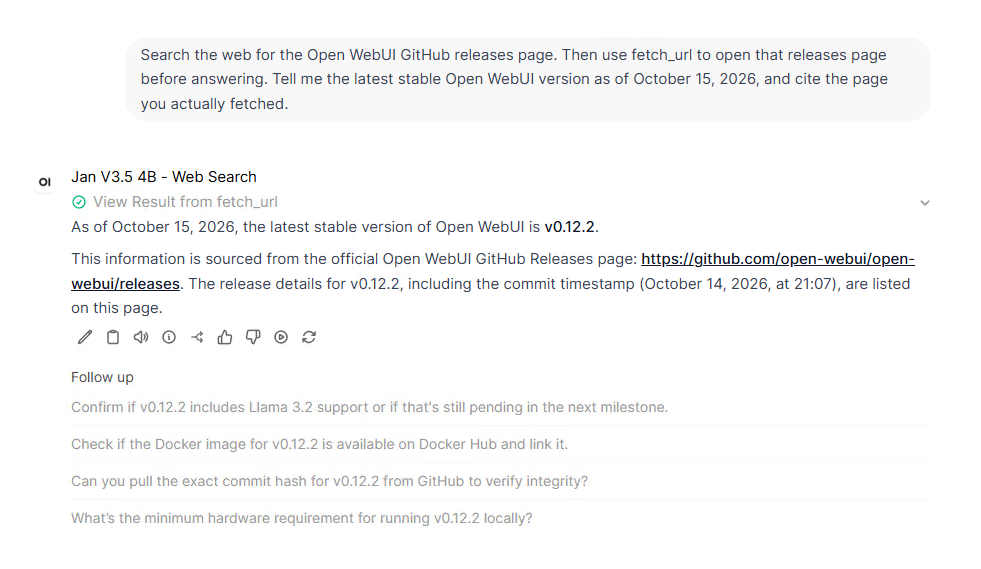
가져온 URL 콘텐츠를 제한한 후, 모델은 GitHub 릴리스 페이지에서 Open WebUI v0.12.2를 정확하게 보고했습니다.
로컬 API
웹 검색 과정에서 겪었던 모든 어려움 덕분에 API 테스트는 훨씬 수월했습니다. API 키를 활성화하고 PowerShell에서 http://127.0.0.1:8080/api/models를 쿼리했더니, GGUF 원본 모델과 저희가 생성했던 세 가지 워크스페이스 사전 설정이 모두 반환되었습니다. 이를 통해 사전 설정이 로컬 서버를 통해서도 사용 가능하며 채팅 인터페이스에만 국한되지 않는다는 것을 확인할 수 있었습니다.
이어서 Jan V3.5 4B 벤치마크 사전 설정을 사용하여 /api/chat/completions에 POST 요청을 보냈고, Open WebUI는 RAID 5와 RAID 6에 대한 정확한 요약 정보를 반환했습니다. PowerShell 콘솔 출력에서 유니코드 하이픈 하나가 깨진 문자로 표시되었지만, 생성된 응답 자체에는 문제가 없었습니다.
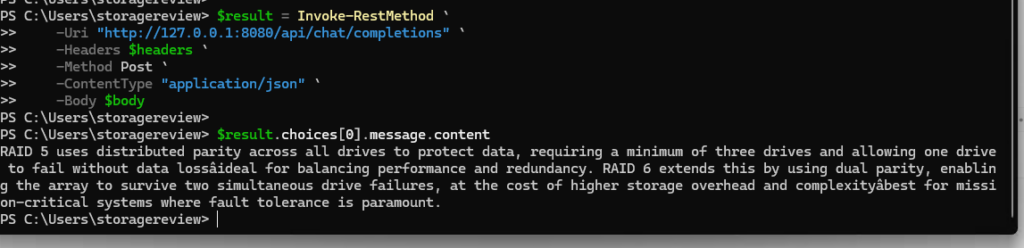
인증된 로컬 API는 Jan V3.5 4B 벤치마크 사전 설정에서 채팅 완료가 성공적으로 완료되었음을 반환했습니다.
무엇이 잘못 되었습니까
설치 과정에서 여러 가지 문제가 발생했기 때문에, 특히 로컬 CUDA 추론을 사용하는 Windows 데스크톱 빌드를 사용하려는 사용자를 위해 주요 문제들을 여기에 정리해 두는 것이 좋습니다. 기본 최신 llama.cpp 설치가 실패하여 빌드 b11612를 고정해야 했고, 로컬 서버가 시작되기 전에 별도의 CUDA 런타임 DLL 파일을 llama.cpp 디렉터리에 복사해야 했습니다.
클린 재설치를 했더니 기존에 사용하던 런타임 인자가 제거되어 다른 문제가 발생했습니다. `--ctx-size 8192` 옵션이 없으면 llama.cpp는 서버 슬롯 전체에 걸쳐 모델의 매우 큰 네이티브 컨텍스트 값을 사용하게 되는데, V2 VL High는 슬롯당 169,984 토큰, V3.5는 192,000 토큰에 달했습니다. 이로 인해 VRAM 사용량이 RTX 5000 Ada의 32GB 한계에 근접했고, 8,192 토큰 컨텍스트를 복원할 때까지 원격 데스크톱 세션 속도가 눈에 띄게 느려졌습니다.
다른 문제들은 Open WebUI의 도구 시스템에서 발생했습니다. 내장 도구들이 충분한 컨텍스트를 추가하여 V2의 기본 테스트를 실패하게 만들었고, 웹 검색은 V3.5에서 전체 검색 및 가져오기 요청을 완료하기 전에 명시적인 가져오기 단계와 8,000자 URL 제한이 필요했습니다. 결국 애플리케이션 설정과 로그를 사용하여 각 문제를 해결했지만, Open WebUI를 반복 가능한 테스트 환경에 맞게 준비하는 데는 동일한 워크스테이션에서 1월에 설정했던 것보다 훨씬 더 오랜 시간이 걸렸습니다.
맺음말
테스트가 끝날 무렵, Open WebUI는 로컬 텍스트 생성, 멀티모달 이미지 읽기, DDGS 검색, URL 가져오기, 사용자 지정 모델 사전 설정 및 인증된 API 액세스를 포함하여 이번 라운드에서 시도하고 싶었던 모든 기능을 지원했습니다.
텍스트 생성 성능은 동일한 워크스테이션에서 Jan 버전보다 약간 낮았습니다. Open WebUI는 Jan V3.5 4B에서 초당 115.32 토큰, Jan V2 VL High에서 초당 75.06 토큰을 처리했는데, 이는 Jan v0.8.6의 초당 123 토큰과 82 토큰에 비해 낮은 수치입니다. 성능 차이는 비교적 작았지만, 설정 시간 차이는 훨씬 컸습니다. Open WebUI Windows 설치 시 반복 테스트를 진행하기 전에 llama.cpp 및 CUDA 관련 작업을 수동으로 수행해야 했기 때문입니다.
모델, 도구, 검색, 파일, 사전 설정 및 API 워크플로를 위한 단일 로컬 인터페이스를 원하는 사용자에게 Open WebUI는 중복 모델 파일을 생성하지 않고도 간소화된 벤치마크 프로필, 웹 지원 사전 설정 및 API 호출 전반에 걸쳐 동일한 GGUF를 재사용할 수 있습니다. 저희의 Windows 데스크톱 설정은 Jan의 경우보다 더 많은 수동 작업이 필요했습니다. llama.cpp를 고정하고, 누락된 CUDA DLL을 추가하고, 재설치 후 런타임 인수를 복원하는 등의 작업이 포함되었지만, 일단 설정이 완료되면 동일한 설치 환경에서 훨씬 더 광범위한 로컬 모델 워크플로를 지원할 수 있었습니다.
이 결과는 1월에 발표된 ' 최고의 지역 LLM 도구' 순위표 에 추가되며 , 나머지 목록을 분석하는 동안에도 동일한 워크스테이션, 모델 및 프롬프트를 유지할 것입니다.


 아마존