

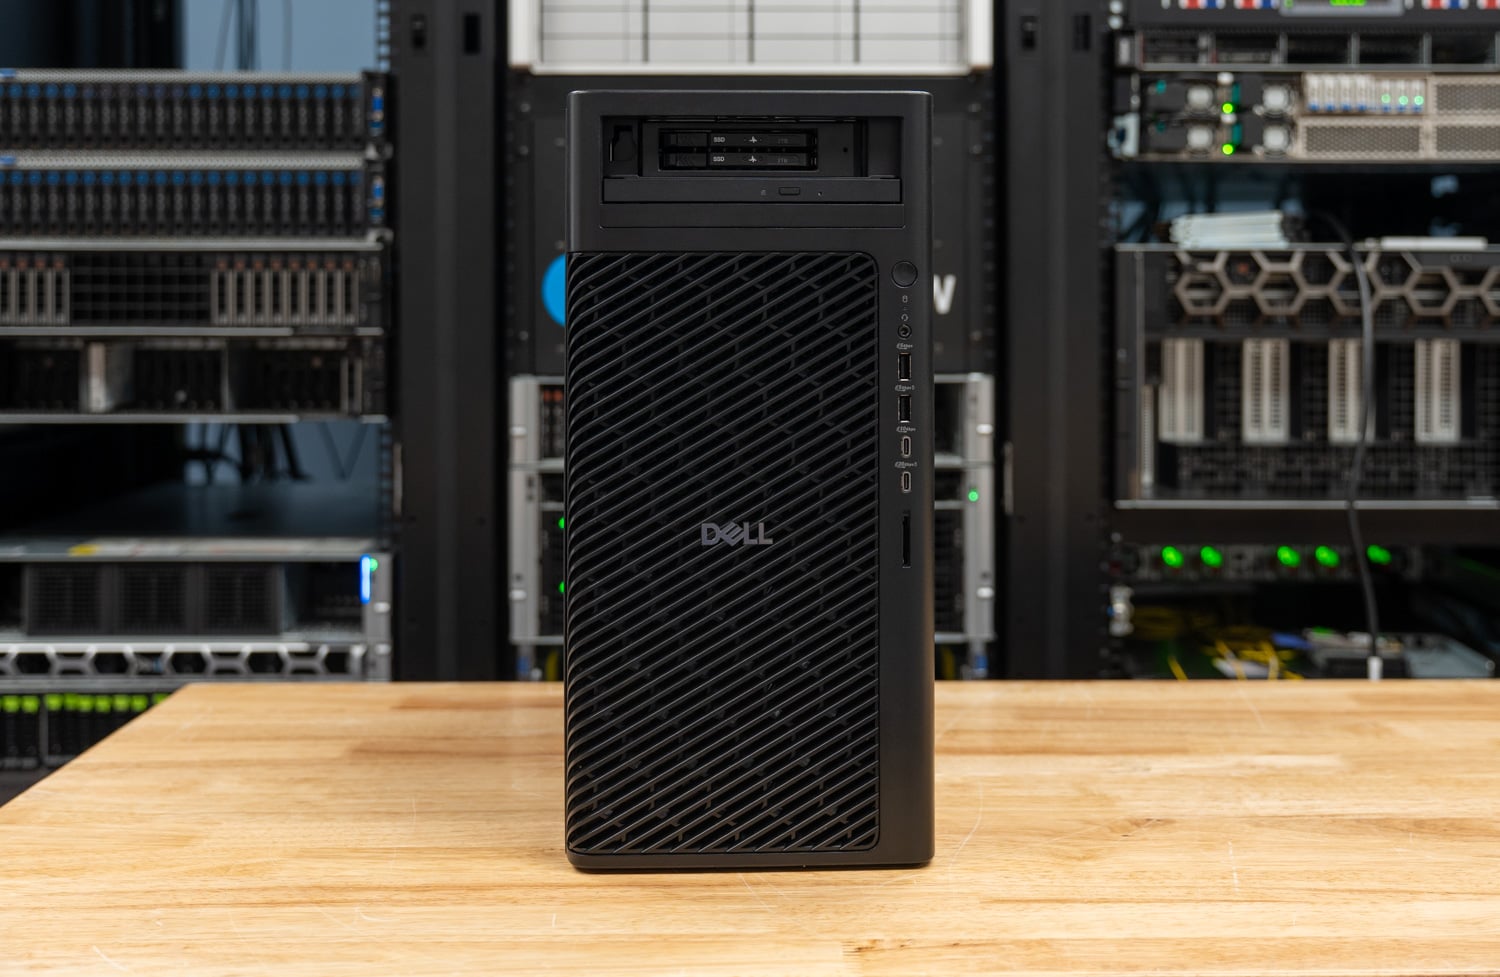
델 프로 프리시전 9 T2는 1년 전 델 프로 맥스 타워 T2 라는 이름으로 리뷰했던 싱글 GPU 타워의 제온 버전 으로, 두 가지 변화가 있습니다. 첫째, 델이 워크스테이션을 다시 프리시전 브랜드로 통합하면서 이름이 바뀌었고, 둘째, 동일한 32리터 섀시에 인텔 코어 울트라 9 285K 대신 제온 6이 탑재되어 새로운 플랫폼이 적용되었습니다. 저희가 리뷰한 제품은 24코어 제온 658X, 128GB DDR5-6400 RDIMM ECC, 300W RTX PRO 6000 블랙웰 맥스-Q, 그리고 전면 플렉스베이에 스트라이프 구성으로 장착된 2TB E3.S Gen5 드라이브 두 개가 탑재되어 있었습니다. 델 공식 웹사이트에서 동일한 구성으로 판매될 경우 가격은 약 28,300달러입니다.
저희는 매트릭스 방식으로 테스트를 진행했습니다. Pro Precision 9 T2는 기본 탑재된 Max-Q 그래픽 카드와 저희 Pro Max Tower T2에서 가져온 600W RTX PRO 6000 Blackwell 그래픽 카드를 모두 사용하여 전체 테스트 스위트를 실행했고, Core 기반 T2도 두 카드를 모두 사용하여 테스트했습니다. 따라서 아래 결과는 모두 네 개의 열로 구성되어 있으며, 각 열 쌍은 CPU 플랫폼 또는 GPU의 전력 제한이라는 두 가지 변수만을 분리하여 보여줍니다. 테스트 스위트는 지난주 RTX Spark 노트북 에서 사용했던 것과 동일하며 , 이번에 새롭게 추가된 몇 가지 항목이 포함되어 있습니다.
Xeon 프로세서는 처리량은 높지만 지연 시간은 늘어납니다. Pro Precision 9 T2는 Cinebench 2026 멀티코어 테스트에서 Core T2의 8,856점보다 높은 12,322점을 기록했고, LLVM 빌드 시간은 Core T2의 182.5초보다 빠른 140.2초, STREAM Triad 읽기 속도는 Core T2의 33,003MB/s보다 빠른 122,233MB/s를 기록했습니다. 하지만 싱글코어 Cinebench 점수는 Core T2의 564.4점보다 낮은 454.1점, Speedometer 점수는 Core T2의 46.3점보다 낮은 36.8점을 기록했습니다. 600W 전력 소모가 큰 이 그래픽 카드는 두 시스템 모두에서 LLM 디코딩에서 약 7~20%, 즉시 처리 및 확산에서 20~39%의 성능 향상을 가져오며, Xeon 시스템에서는 모든 코어 작업 시 CPU 성능을 4~5% 저하시킵니다.
주요 요점
- Xeon 6는 단일 소켓 타워형 케이스에 담긴 고성능 처리 플랫폼입니다. Cinebench 2026 멀티코어 테스트에서 12,322점을 기록하며 동일한 섀시의 Core Ultra 9 285K보다 39% 앞섰고, 7-Zip 테스트에서는 174.8 GIPS 대비 289.6 GIPS, DGEMM 테스트에서는 768 GFLOPS 대비 1,638 GFLOPS를 기록했으며, DDR5-6400 4채널 메모리 대역폭은 3.7배 향상되었습니다.
- 285K는 여전히 스레드당 속도 면에서 우위를 점하고 있습니다. Xeon은 Cinebench 싱글 코어 테스트에서 20%, Speedometer에서 21%, 싱글 스레드 Python 테스트에서 20~31% 뒤처지며, 코어 간 지연 시간은 56.2ns로 38.1ns보다 높습니다.
- GPU가 AI 결과를 결정하고, 600W 그래픽 카드는 프롬프트에 따라 전력을 소비합니다. MLPerf Llama 3.1 8B는 Max-Q 카드 사용 시 초당 230.9개의 토큰을 생성하고, 600W 카드 사용 시에는 초당 252.8개의 토큰을 생성하며, 첫 번째 토큰까지의 시간은 0.082초에서 0.059초로 단축되고, Qwen-Image 20B는 1024×1024 크기의 이미지를 렌더링하는 데 26.1초에서 19.7초로 단축되었습니다.
- 600W 그래픽 카드는 제온 CPU의 작업 부하를 4~5% 정도 높입니다. 시네벤치 멀티코어 점수는 12,322에서 11,705로, 30분 지속 루프 점수는 12,328에서 11,764로 떨어졌으며, 정상 상태 클럭은 4,274MHz에서 4,178MHz로 하락했습니다. 하지만 동일한 프로세서 교체를 해도 Core T2에서는 아무런 변화가 없었습니다.
- FlexBay에 있는 E3.S, Graid의 VROC로 스트라이프 처리됨: 전면 베이에는 E3.S Gen5 드라이브 두 개가 장착되는데, 이는 저희 연구실에서 타워 워크스테이션에 이러한 드라이브가 장착된 최초의 사례입니다. Dell의 RAID0 부팅 옵션은 Graid Technology의 VROC 기술을 사용하여 이 두 드라이브를 4,097GB 볼륨으로 구성합니다. 이 스트라이프는 순차 읽기 속도 9,332MB/s, 4K 랜덤 읽기 속도 최대 840.1K IOPS를 기록하며, Core T2에 장착된 단일 Gen5 M.2 드라이브의 1.78M IOPS와 비교됩니다.
프로 맥스부터 프로 프리시전까지
델은 2025년 초 모든 워크스테이션을 델 프로 맥스(Dell Pro Max)로 통합하면서 프리시전(Precision)이라는 이름을 단종시켰다가 다시 부활시켰습니다. 10월 7일, 델은 GB10과 GB300 데스크탑의 이름을 델 프로 맥스에서 델 프로 프리시전으로 변경했으며, 델닷컴(Dell.com)에서는 새로운 T4 및 T6 타워와 함께 프로 프리시전 9 T2를 같은 브랜드로 판매하고 있습니다. 프로 맥스라는 이름은 코어(Core) 기반 제품에 계속 사용되므로, 작년에 리뷰했던 코어 울트라(Core Ultra) 타워는 여전히 델 프로 맥스 타워 T2로 판매되고 있으며, 이번에 리뷰하는 제온(Xeon) 타워는 델 프로 프리시전 9 T2(모델명 PW9T2260)입니다.
T4와 T6는 이름 변경과 함께 Xeon 6으로 업그레이드되었으며, Dell은 확장성에 따라 세 가지 타워형 모델을 구분했습니다. Pro Precision 9 T4(PW9T4260)는 최대 86코어 Xeon 698X까지 지원하는 동일한 프로세서 라인업을 갖추고 있으며, 8개의 메모리 채널 모두에 최대 4TB의 DDR5-6400을 장착할 수 있는 16개의 DIMM 슬롯을 추가했습니다. 또한 1500W 파워 서플라이에 600W RTX PRO 6000 그래픽 카드 1개 또는 Max-Q 카드 2개를 장착할 수 있으며, 2400W 케이스를 옵션으로 선택할 수 있습니다.
Pro Precision 9 T6(PW9T6260)는 최상위 모델로, 6개의 슬롯과 2400W 파워 서플라이를 갖추고 있으며, 600W RTX PRO 6000 그래픽 카드 2개, Max-Q 카드 3개 또는 RTX PRO 5000 카드를 최대 5개까지 장착할 수 있습니다. T2는 싱글 GPU, 4채널 구성의 보급형 모델입니다.
두 제품은 외관상 완전히 동일하기 때문에 명칭의 정확성이 중요합니다. 387 x 187.7 x 438mm 크기의 32리터 섀시, 동일한 베젤과 전면 FlexBay, 그리고 Dell의 구성 도구에서 제공되는 동일한 RTX PRO 6000 Blackwell 옵션을 공유합니다. 따라서 차이점은 메인보드에 있습니다. Pro Max Tower T2는 24코어 Core Ultra 9 285K와 4개의 언버퍼드 DDR5 DIMM 슬롯을 제공하는 반면, Pro Precision 9 T2는 워크스테이션용 Intel Xeon 6( 지난 6월 베어보드 리뷰에서 다룬 Granite Rapids-WS 플랫폼)를 탑재하고, 등록형 ECC 메모리, 더 많은 PCIe 레인, 그리고 최상위 구성에서는 250W 프로세서를 제공합니다.

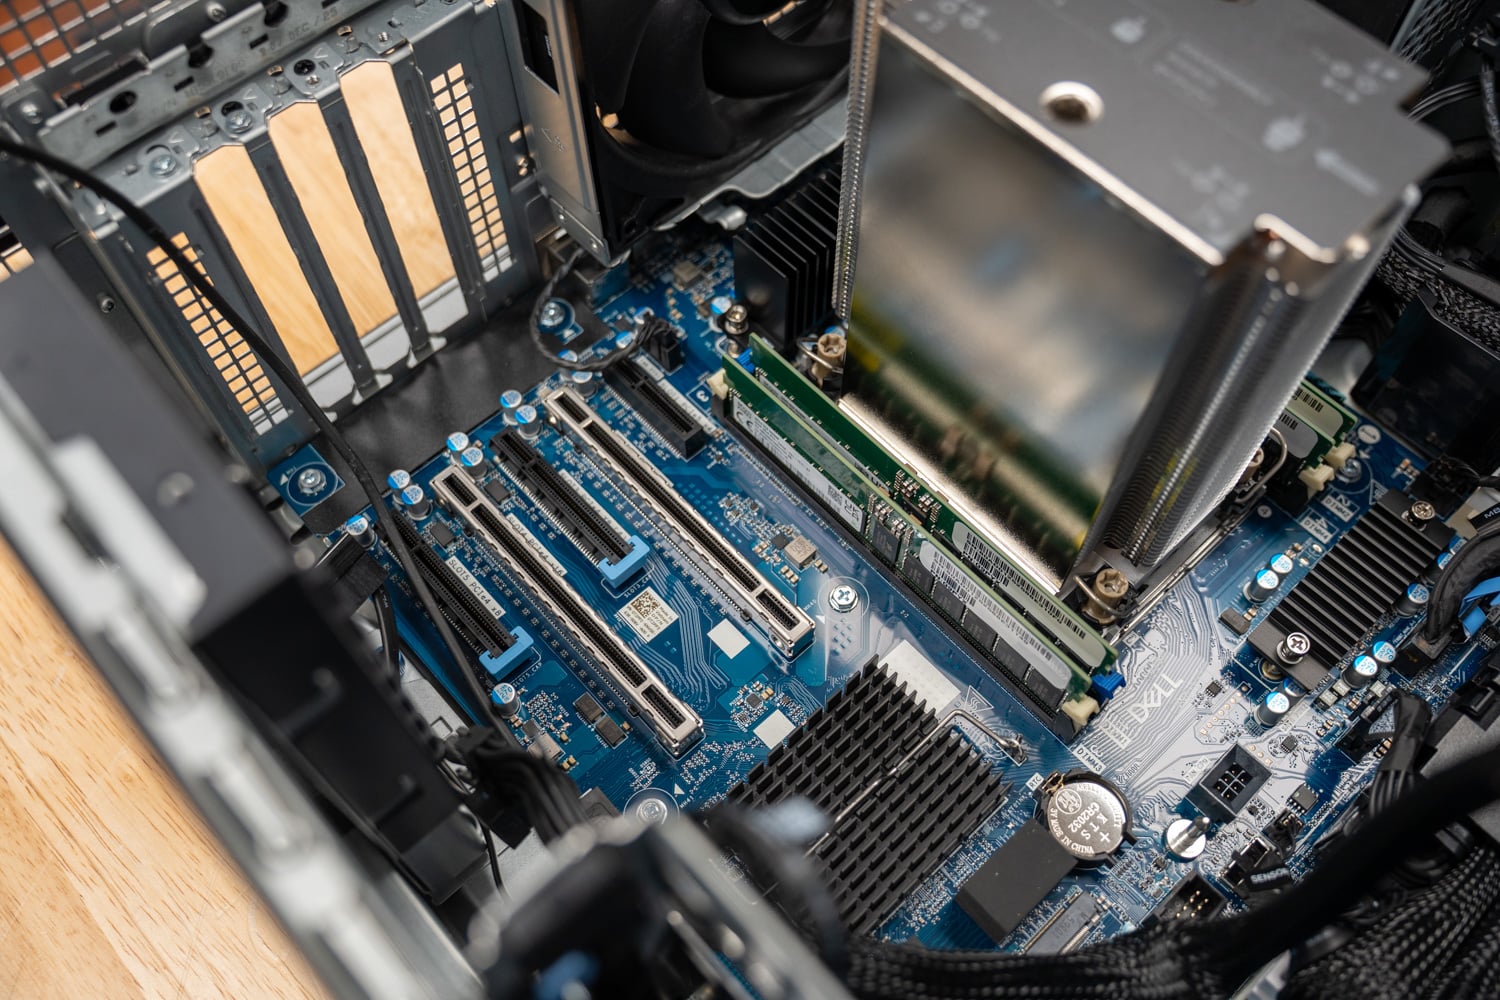
델은 Pro Precision 9 T2에 12코어 Xeon 634(150W)부터 24코어 658X(본 테스트 제품)까지 총 6가지 Xeon 6 프로세서를 제공하며, 634에서 658X로 업그레이드하려면 1,560달러의 추가 비용이 발생합니다. 658X는 24코어 48스레드를 3.0GHz 기본 클럭과 4.9GHz 터보 클럭으로 작동하며, 144MB의 L3 메모리를 탑재했는데, 이는 285K의 36MB보다 3배 많은 용량입니다. 또한 285K에는 없는 AVX-512와 AMX 코덱을 지원합니다. 이 칩은 8개의 DDR5-6400 채널과 128개의 Gen5 레인을 갖추고 있으며, T2 모델에는 4개의 DIMM 슬롯과 5개의 확장 슬롯이 제공되고, 더 큰 T4 및 T6 모델에는 나머지 슬롯이 제공됩니다.
| 플랫폼 | 델 프로 프리시전 9 T2 (테스트 결과) | 델 프로맥스 타워 T2 (테스트 결과) |
|---|---|---|
| 프로세서 | 인텔 제온 658X, 24코어/48스레드, 3.0~4.9GHz, 144MB L3 메모리, 250W | 인텔 코어 울트라 9 285K, 24코어/24스레드(8P + 16E), 최대 5.7GHz, 36MB L3 메모리, 125W |
| 명령어 세트 | AVX-512, AMX | AVX2(AVX-512 없음), Intel AI Boost NPU |
| 메모리 | 4 x 32GB DDR5-6400 RDIMM ECC (4채널, 최대 1TB) | 4 x 32GB DDR5-4400 ECC UDIMM |
| 확장 | Gen5 x16, Gen5 x4, Gen4 x16, Gen4 x8 2개(전기식 x4 1개 포함) | Gen5 x16 1개, Gen4 x4 1개, Gen3 x4 2개 |
| 테스트된 부팅 저장소 | 전면 FlexBay에 2개의 2TB E3.S Gen5 NVMe SSD, RAID0 (Graid Technology의 VROC) 구성, 총 4,097GB | 2TB SK 하이닉스 PCB01 M.2 Gen5 (싱글 드라이브) |
| 내부 M.2 | 3 x M.2 2280 Gen5 | Gen5 M.2 1개와 Gen4 M.2 2개 |
| 전원 공급 장치 | 750W 기본 출력, 500W 또는 1500W 옵션 (테스트 출력은 1500W) | 360W, 500W 또는 1500W (80 플러스 플래티넘) |
| 테스트 결과 그래픽 | RTX PRO 6000 Blackwell Max-Q (300W) 출고 상태 그대로 테스트했으며, 600W 카드도 함께 테스트했습니다. | RTX PRO 6000 블랙웰(600W) 출고 사양이며, Max-Q 카드도 함께 테스트했습니다. |
| 차대 | 387 x 187.7 x 438mm, 11.6~21.8kg | 387 x 187.7 x 438mm, 8.17~23kg |
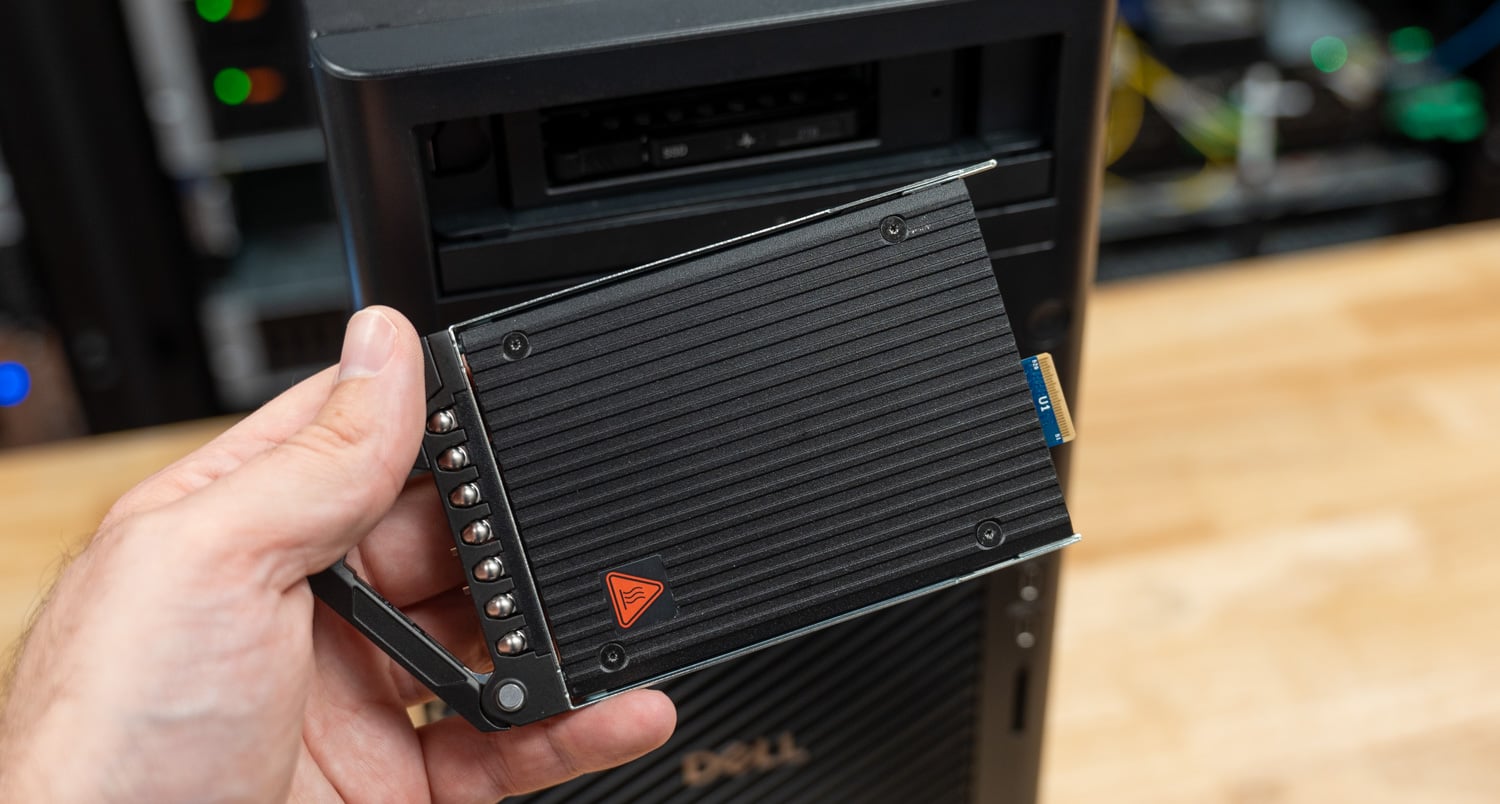
Core T2는 단일 M.2 드라이브에서 부팅되었지만, 저희가 테스트한 Pro Precision 9 T2는 Dell의 FlexBay NVMe 부팅 구성을 갖추고 있었습니다. 전면 베젤 뒤에 핫플러그 방식의 E3.S Gen5 드라이브 두 개가 장착되어 있었고, RAID0 부팅 옵션을 통해 4,097GB 용량의 단일 볼륨으로 구성되었습니다. E3.S는 M.2의 용량 한계를 훨씬 뛰어넘는 엔터프라이즈급 폼팩터로, 섀시를 열지 않고도 드라이브를 전면에서 장착할 수 있다는 장점이 있습니다. RAID 계층은 Graid Technology의 VROC 기술을 사용 했는데 , 이는 Graid가 작년에 인수하여 컴퓨텍스에서 재출시한 Intel VROC 코드이며, 저희 연구실에서 이 기술이 적용된 워크스테이션은 이번이 처음입니다.

600W 그래픽 카드는 약간의 추가 공간이 필요하지만, Max-Q 모델은 그렇지 않습니다. 저희 테스트 제품에는 GPU 옆 슬롯에 Intel E810-XXV 듀얼 포트 25GbE 어댑터가 장착되어 있었는데, 600W RTX PRO 6000을 설치하려면 이 어댑터를 제거해야 했습니다. 카드 쿨러가 옆 슬롯의 공간과 전원 공급 장치를 차지하기 때문입니다. 최고 성능의 카드와 고속 NIC를 모두 사용하려는 구매자는 주문 전에 슬롯 구성을 고려해야 하며, 1500W 파워 서플라이가 가장 적합한 조합입니다. 저희 테스트 제품에는 750W 기본 파워 서플라이에서 40달러를 추가한 1500W 옵션이 장착되어 있었습니다.
빌드 및 디자인
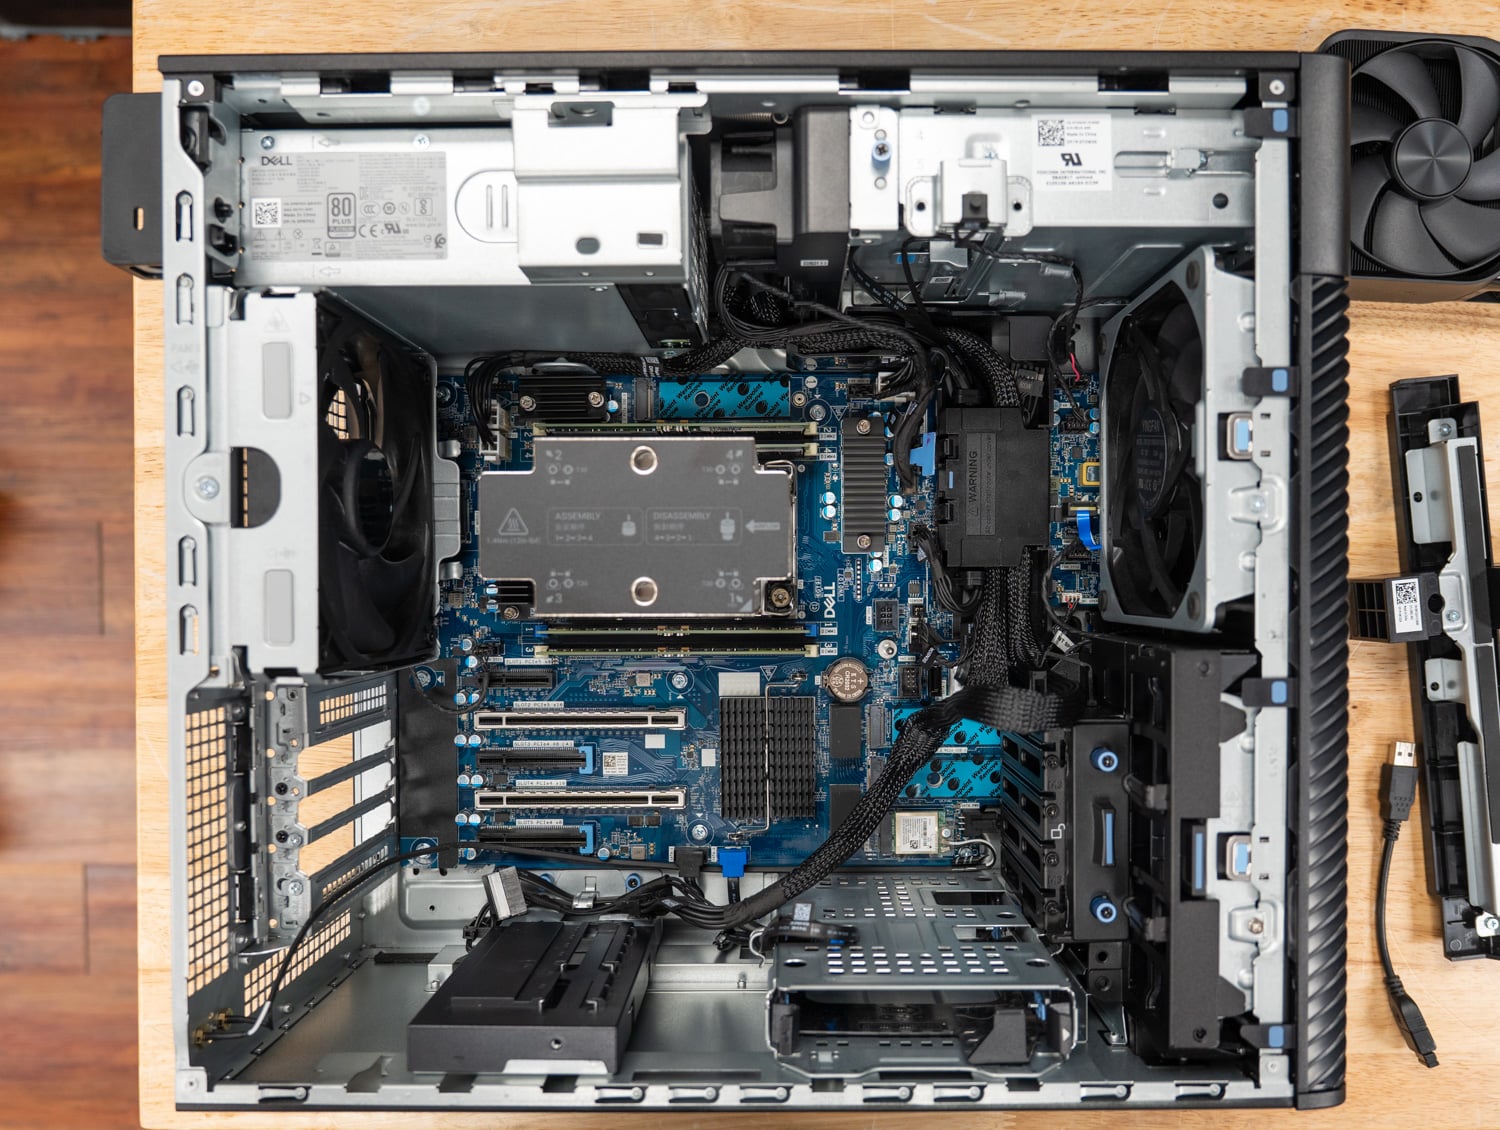
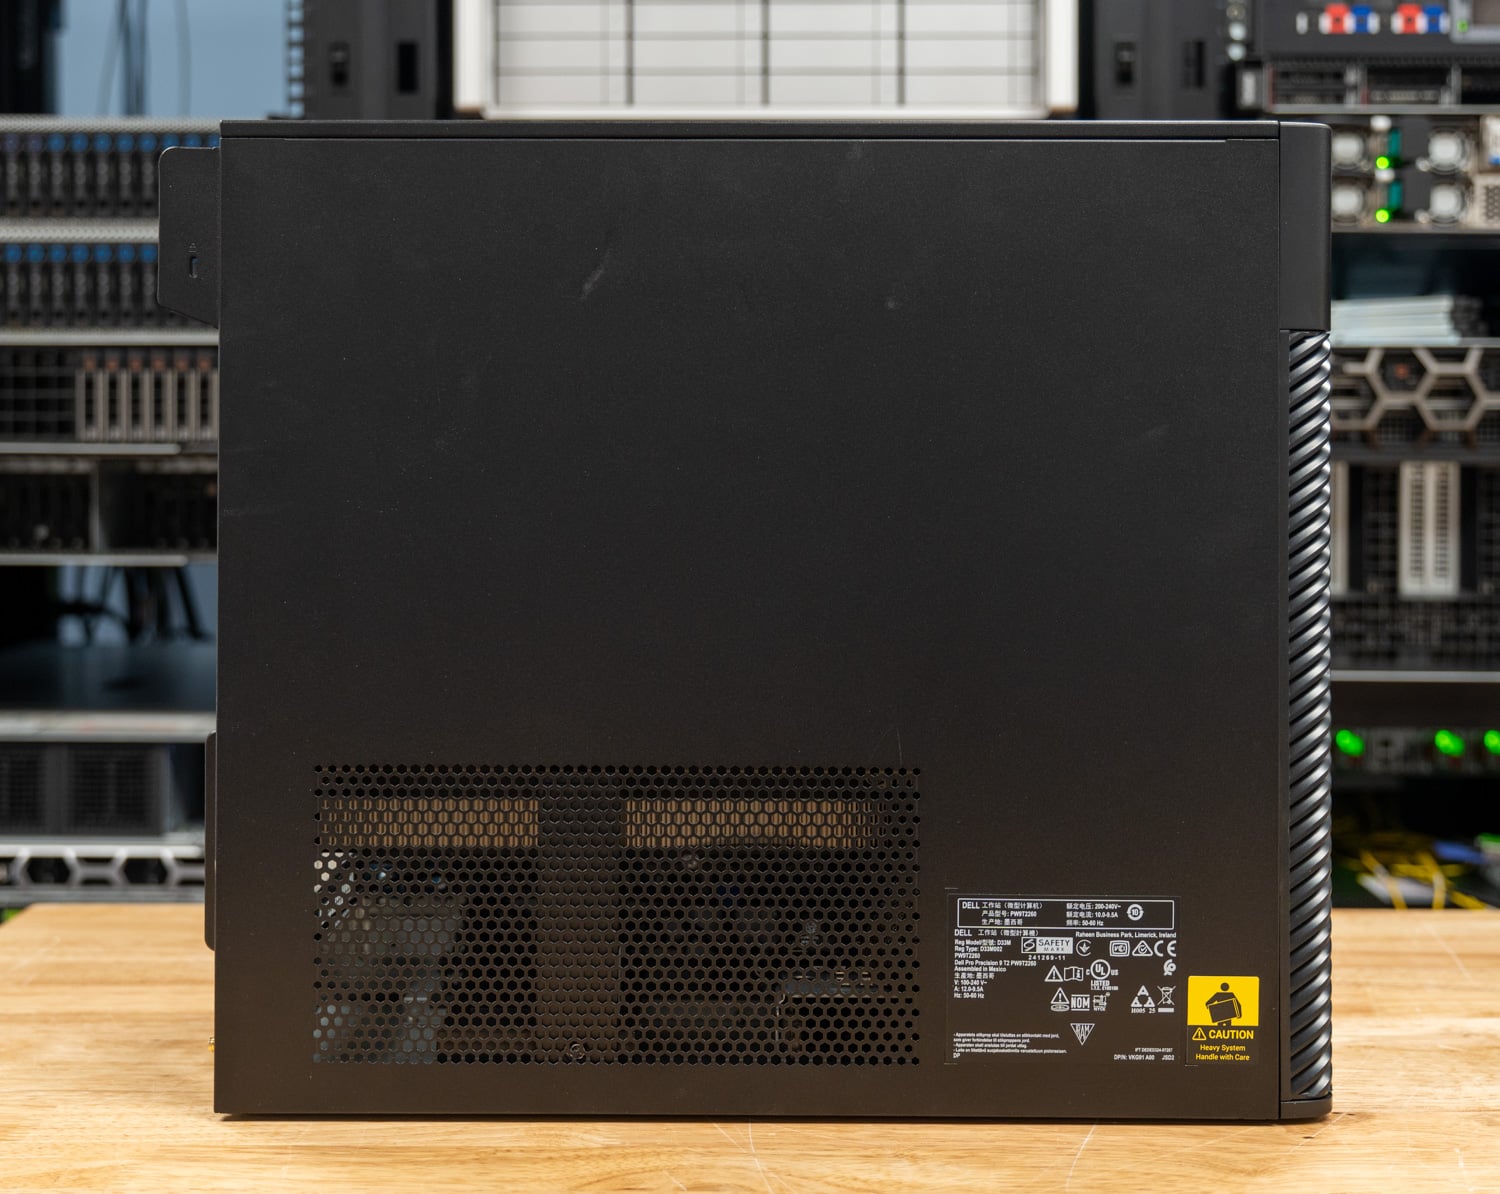
Pro Precision 9 T2는 Pro Max 버전과 동일한 공구 없이 조립 가능한 타워형 케이스를 사용하며, 전면에는 흡기용 메쉬 그릴이 있고, 측면 패널은 측면 래치와 고정식 나사로 여닫을 수 있으며, FlexBay와 옵션 사양인 슬림형 광학 드라이브는 하단 베젤 뒤쪽에 위치합니다. Dell은 케이스 무게를 빈 상태에서 11.6kg, 구성 시 최대 21.8kg으로 명시하고 있으며, 1500W 파워 서플라이, 658X 쿨러, 그리고 2슬롯 GPU를 장착한 저희 제품은 무게 범위의 상단에 해당합니다.

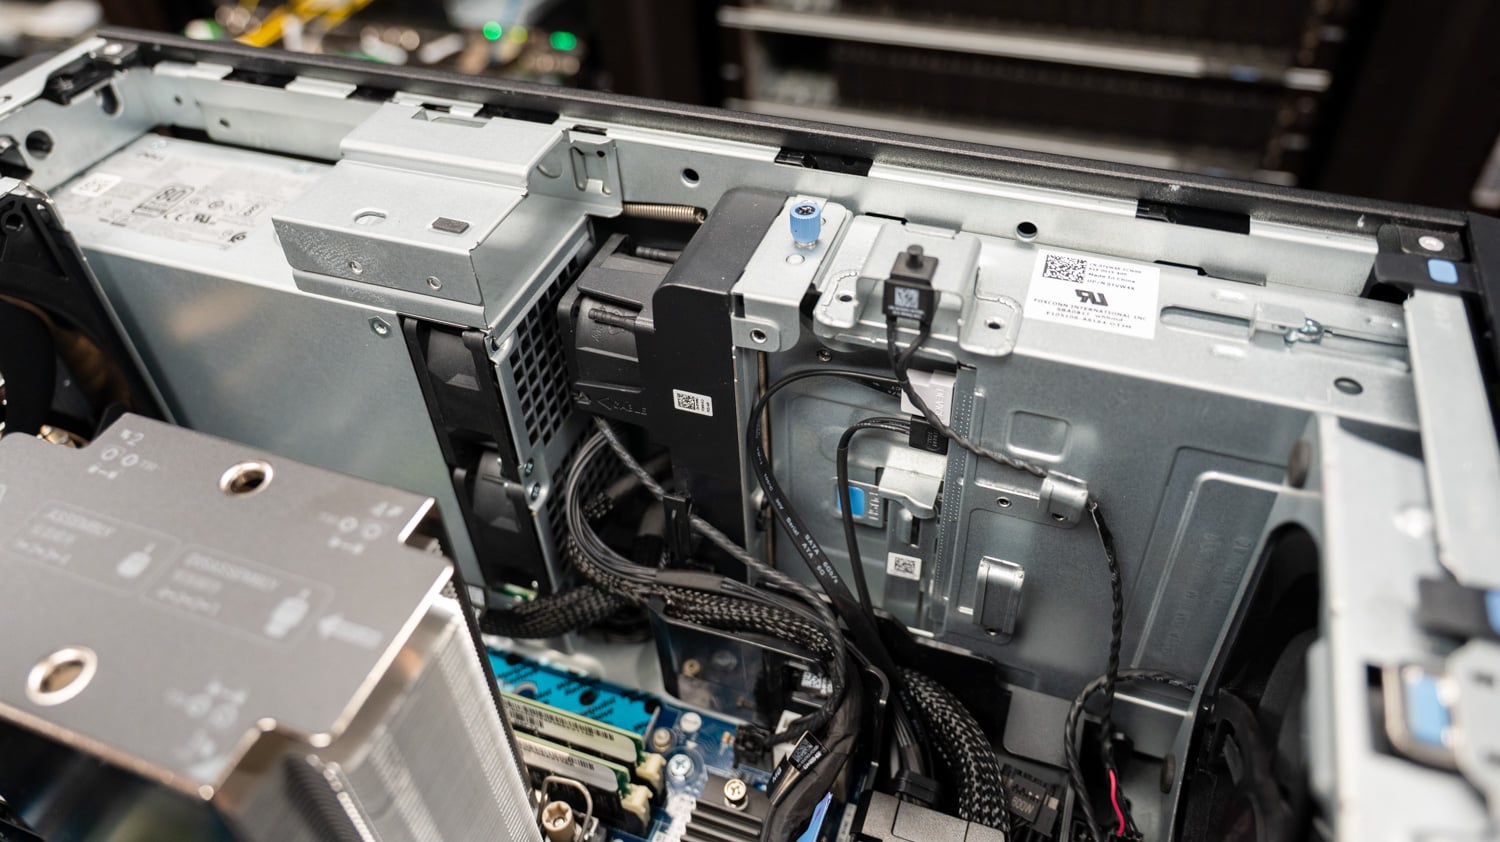
케이스 내부 구조는 공기 흐름을 중심으로 설계되었으며, Dell은 필요한 곳으로 정확하게 공기를 유도합니다. DIMM을 냉각하고 CPU에서 발생하는 뜨거운 공기를 케이스 밖으로 직접 배출하는 대형 냉각 덮개에는 팬이 내장되어 있습니다. 케이스를 열면 덮개가 케이스 구조에 어떻게 통합되어 있는지 확인할 수 있는데, 덮개의 하단 가장자리가 GPU 지지 브래킷에 닿아 있고 측면 덮개에 단단히 밀착되어 있습니다.
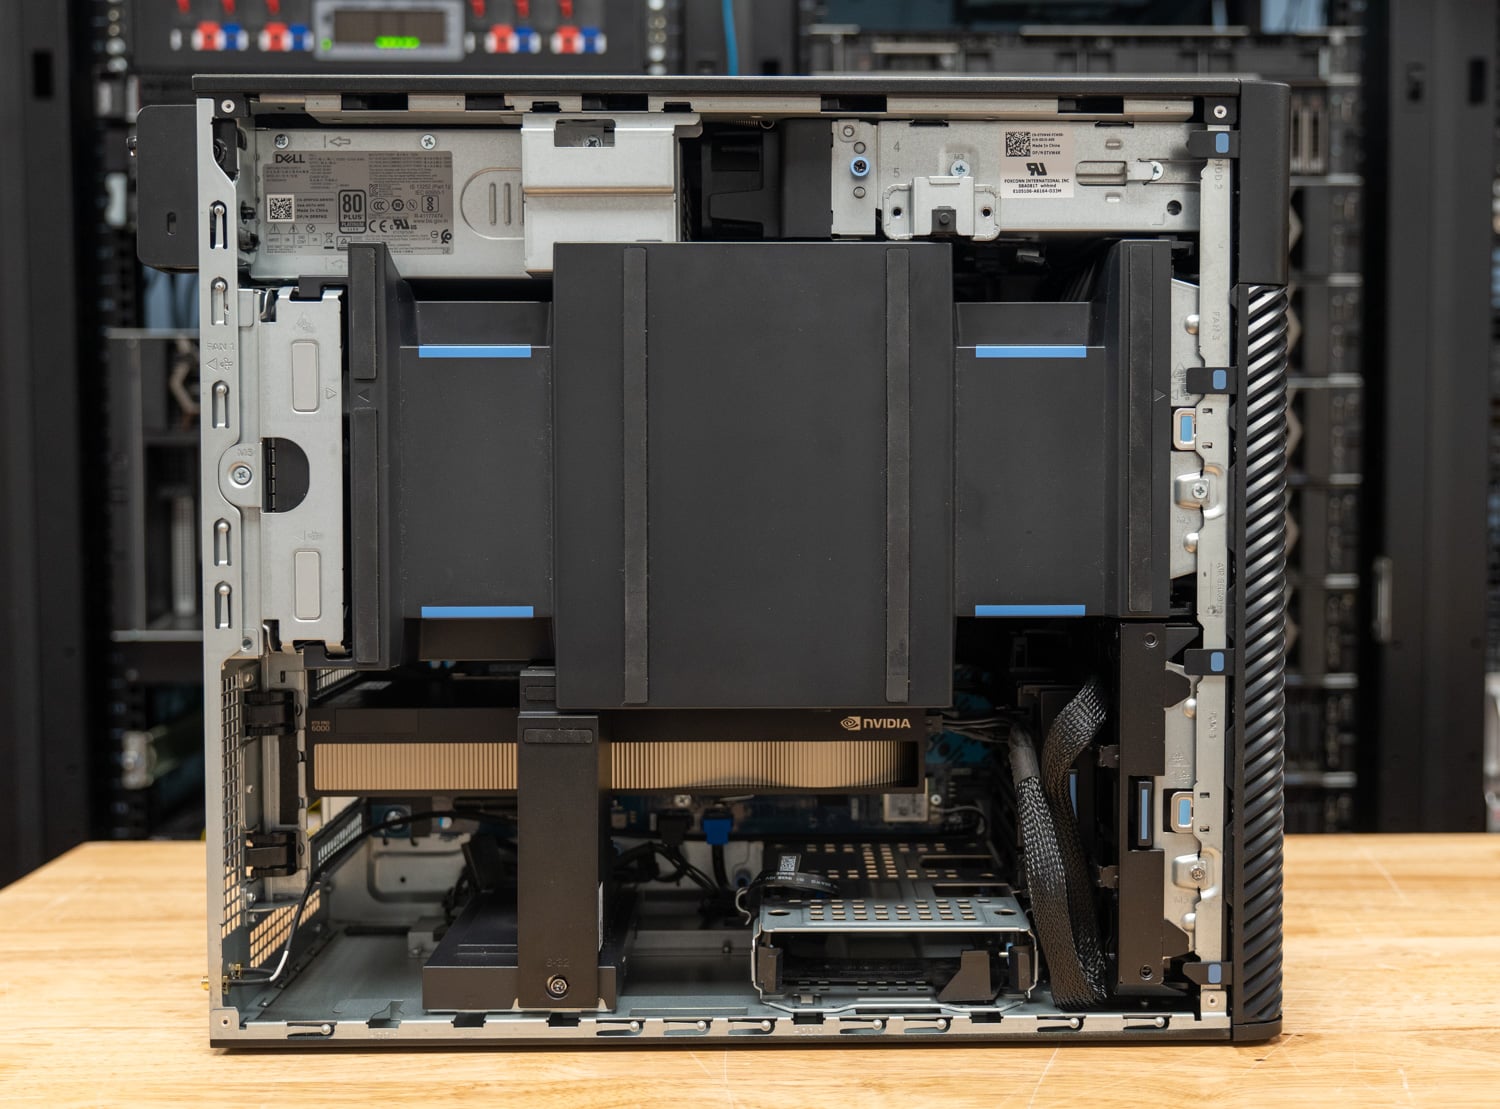
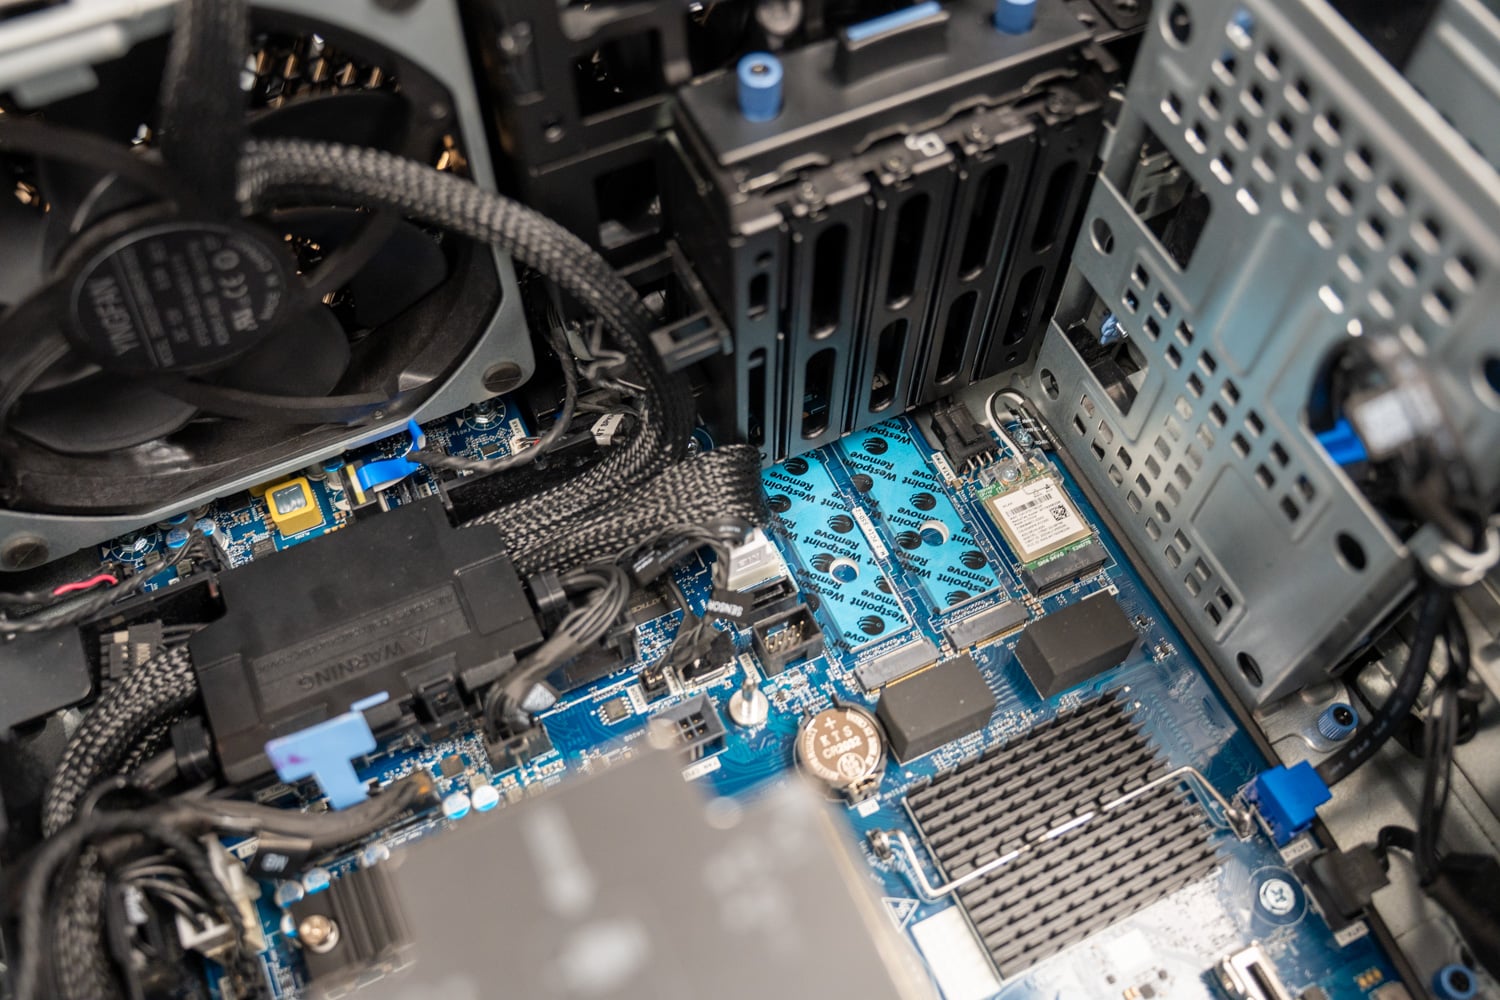
내부 레이아웃은 Pro Max 타워와 동일합니다. 프로세서와 4개의 DIMM 슬롯은 확장 영역 위에 위치하고, Gen5 x16 슬롯에 장착된 GPU는 고정 브래킷으로 지지되며, 파워 서플라이는 도구 없이 탈착할 수 있도록 손잡이가 달린 후면 장착부입니다. 5개의 슬롯 모두 풀 사이즈이며, 슬롯 2는 GPU용 Gen5 x16, 슬롯 1은 Gen5 x4, 나머지 3개는 Gen4로, 하나는 x16이고 나머지 두 개는 NIC, 스토리지 카드 또는 두 번째 GPU를 위한 개방형 x8 슬롯입니다. 전면 E3.S 베이 뒤쪽에는 3개의 내부 M.2 2280 Gen5 슬롯과 2개의 3.5인치 SATA 베이가 있습니다.
전면 I/O에는 헤드셋 잭, PowerShare 기능이 있는 20Gbps USB-C 포트, 10Gbps USB-C 포트, USB-A 포트 2개, 그리고 옵션으로 SD 카드 슬롯이 있습니다. 후면에는 오디오 라인 출력, 20Gbps 및 10Gbps USB-C 포트, SmartPower 기능이 있는 USB 2.0 포트 2개, 5Gbps USB-A 포트 2개, 1GbE 포트, 5GbE NIC 또는 USB-A 포트 2개를 추가할 수 있는 옵션 모듈 슬롯, 그리고 옵션으로 레거시 시리얼 포트가 있습니다. 저희 테스트 장치에는 내부 M.2 2230 슬롯에 MediaTek MT7925 Wi-Fi 7 카드와 600W GPU용으로 출시된 Intel E810-XXV 25GbE 카드가 추가되었습니다.

델 프로 프리시전 9 T2 사양
| 스펙 | 델 프로 프리시전 9 T2 (PW9T2260) |
|---|---|
| 플랫폼 개요 | |
| 프로세서 옵션 | Intel Xeon 634 (12코어, 150W), 636 (12코어, 170W), 638 (16코어, 180W), 654 (18코어, 200W), 656 (20코어, 210W), 658X (24코어/48스레드, 144MB L3, 250W) 테스트 결과 Xeon 658X |
| 메모리 | DDR5 RDIMM ECC, 5600 또는 6400 MT/s, 4개 슬롯, 최대 1TB(4 x 256GB) 지원 테스트 결과 128GB (32GB x 4) DDR5-6400 |
| 그래픽 옵션 | NVIDIA RTX A400, A1000, RTX PRO 2000/4000/4500/5000/6000 Blackwell(600W) / 6000 Blackwell Max-Q(300W), A800 Active; AMD Radeon Pro W7400; 일부 카드에서 듀얼 및 트리플 구성 지원 RTX PRO 6000 블랙웰 맥스-Q 워크스테이션 에디션, 96GB GDDR7 (테스트 결과) |
| 스토리지 | 전면 FlexBay: 최대 2개의 E3.S/NVMe 드라이브와 옵션으로 제공되는 슬림형 ODD 또는 3.5인치 SATA 베이 1개 장착 가능 내부: M.2 2280 Gen5 NVMe 3개, 3.5인치 SATA 2개 RAID: Graid Technology의 VROC를 사용하는 Intel VMD(RAID0 부팅, 내부 RAID0) 테스트 결과 2개의 2TB E3.S Gen5 NVMe SSD를 RAID0으로 구성(4,097GB)했습니다. |
| 확장 | 슬롯 1: Gen5 x4; 슬롯 2: Gen5 x16; 슬롯 3: Gen4 x8 (x4 전기 포트, 개방형); 슬롯 4: Gen4 x16; 슬롯 5: Gen4 x8 (개방형); Wi-Fi용 M.2 2230 |
| I / O | |
| 전면 포트 | PowerShare 기능이 있는 USB-C 20Gbps 포트 1개, USB-C 10Gbps 포트 1개, PowerShare 기능이 있는 USB-A 5Gbps 포트 1개, USB-A 5Gbps 포트 1개, 헤드셋 잭, SD 카드 슬롯(옵션) |
| 후면 포트 | USB-C 20Gbps 포트 1개, USB-C 10Gbps 포트 1개, USB 2.0(SmartPower) 포트 2개, USB-A 5Gbps 포트 2개, 오디오 라인 출력, RJ45 1GbE 포트 1개, 5GbE 또는 듀얼 USB-A 모듈(옵션), 시리얼 포트(옵션) |
| 네트워킹 테스트 결과 | Intel E810-XXV DA2 듀얼 포트 25GbE SFP28 (600W GPU 구동 시 제거됨); MediaTek MT7925 Wi-Fi 7, Bluetooth 5.4 |
| 힘과 신체 | |
| 전원 공급 장치 | 750W 기본 출력; 500W 또는 1500W 옵션 제공; 테스트 출력은 1500W입니다. |
| 크기 | 387 x 187.7 x 438mm (15.23 x 7.38 x 17.24 인치) |
| 중량(평량) | 최소 11.6kg(25.57lb) ~ 최대 21.8kg(48.06lb) |
| 운영체제 | Windows 11 Pro 워크스테이션(테스트 대상) 또는 Ubuntu Linux 24.04 LTS |
| 관리 및 보안 | 인텔 vPro, TPM 2.0, 섀시 침입 감지 스위치, 잠금식 베젤 옵션, 켄싱턴 슬롯 |
| 가격 | Dell.com 기본 구성 가격은 3,978달러(Xeon 634, 16GB, RTX A400, 256GB, 750W)이며, 테스트 사양은 약 28,300달러(Xeon 658X, 128GB DDR5-6400, RTX PRO 6000 Max-Q, RAID0 구성의 2TB Gen5 FlexBay 드라이브 2개, 1500W, 25GbE, Wi-Fi 7)입니다. Dell.com 가격은 2026년 10월 19일 기준입니다. |
해당 가격에는 두 가지 유의사항이 있습니다. Dell.com의 구성 도구에서는 FlexBay 드라이브가 2TB M.2 2280 Gen5 모듈로 개당 1,700달러로 표시되어 있지만, 저희 테스트 장비에는 E3.S 드라이브가 탑재되어 있습니다. Dell에 E3.S 옵션이 언제 온라인에 출시될지 문의한 상태입니다. 또한 Dell은 비즈니스 워크스테이션을 온라인 가격으로 구매하는 경우는 드물다고 솔직하게 밝히고 있으므로, 28,300달러는 대량 구매 및 계약 가격이 적용되는 상한선으로 간주해야 합니다. 메모리와 GPU 가격은 19,090달러이며, GPU 옵션은 300W 또는 600W 카드 중 어느 것을 선택하든 가격이 동일합니다.
델은 테스트에 사용된 이 제품의 가격을 31,700달러로 책정했는데, 이 가격에는 저희가 산정한 구성에 E810-XXV 25GbE 어댑터, Wi-Fi 7, 광학 드라이브, 3년간의 프로 서포트 서비스가 포함된 가격입니다.
테스트 설정 및 방법론
이 리뷰의 모든 결과는 Dell의 공장 출고 Windows 이미지와 Dell 드라이버, NVIDIA 드라이버 596.71을 사용하여 네 가지 구성 모두에서 자체 개발한 Windows 클라이언트 벤치마크 도구인 sr-client 1.2의 전체 실행 프로필로 측정한 것입니다. 벤치마크 도구는 모든 설정에서 동일한 설정을 적용했습니다. 즉, Windows 전원 모드는 최적 성능으로 설정하고, 모든 절전 및 화면 꺼짐 타이머를 비활성화했으며, Windows 방화벽 및 UAC 프롬프트는 해제하고, VBS 및 메모리 무결성은 기본 설정 그대로 유지했습니다. 각 결과는 반복 테스트의 중앙값이며, 결과값의 편차가 2%를 초과하는 경우 재실행 후 유효한 결과로 간주합니다.
아래 네 가지 구성은 타워 두 개와 GPU 두 개로 이루어져 있습니다. Pro Precision 9 T2는 Max-Q 그래픽 카드로 전체 테스트 스위트를 실행했고, Pro Max Tower T2에 탑재된 600W RTX PRO 6000 Blackwell로도 다시 실행했습니다. 또한 Pro Max Tower T2는 두 카드를 모두 순차적으로 실행했으므로, 타워 내 GPU 열은 카드만 다르고, GPU 내 타워 열은 플랫폼만 다릅니다. Core T2는 기본 제공되는 2TB Gen5 M.2 드라이브를 사용하고, Xeon T2는 두 개의 드라이브로 구성된 E3.S 스트라이프를 사용하므로, 저장 장치 및 모델 로딩 행은 구성된 그대로 비교합니다.
| 구성 | CPU | 메모리 | GPU | 부트 드라이브 | 운영 체제 및 전원 모드 |
|---|---|---|---|---|---|
| 델 프로 프리시전 9 T2 (PW9T2260), 맥스-Q | 인텔 제온 658X, 24코어/48스레드, 250W | 128GB DDR5-6400 RDIMM ECC (4 x 32GB) | NVIDIA RTX PRO 6000 블랙웰 맥스-Q 워크스테이션 에디션, 300W, 96GB | 2 x 2TB E3.S Gen5 NVMe, VROC RAID0 (부팅 볼륨 4,097GB) | Windows 11 Pro 워크스테이션 25H2, 최고의 성능 |
| 델 프로 프리시전 9 T2 (PW9T2260), 600W | 인텔 제온 658X, 24코어/48스레드, 250W | 128GB DDR5-6400 RDIMM ECC (4 x 32GB) | NVIDIA RTX PRO 6000 블랙웰 워크스테이션 에디션, 600W, 96GB | 2 x 2TB E3.S Gen5 NVMe, VROC RAID0 (부팅 볼륨 4,097GB) | Windows 11 Pro 워크스테이션 25H2, 최고의 성능 |
| 델 프로맥스 타워 T2(FCT2250), 맥스-Q | 인텔 코어 울트라 9 285K, 24코어/24스레드, 125W | 128GB DDR5-4400 ECC (4 x 32GB) | NVIDIA RTX PRO 6000 블랙웰 맥스-Q 워크스테이션 에디션, 300W, 96GB | SK 하이닉스 PCB01 2TB, Gen5 x4 | Windows 11 Pro 26H2, 최고의 성능 |
| 델 프로맥스 타워 T2 (FCT2250), 600W | 인텔 코어 울트라 9 285K, 24코어/24스레드, 125W | 128GB DDR5-4400 ECC (4 x 32GB) | NVIDIA RTX PRO 6000 블랙웰 워크스테이션 에디션, 600W, 96GB | SK 하이닉스 PCB01 2TB, Gen5 x4 | Windows 11 Pro 26H2, 최고의 성능 |
여기에는 여러 가지 테스트가 새롭게 추가되었습니다. 먼저 LLM 서빙 테스트는 llama-server를 네 가지 모델로 실행하고, 동시 요청 수를 1개부터 GPU 메모리에 들어갈 수 있는 최대치까지 변화시키면서 전체 및 사용자별 처리량, 첫 번째 토큰 획득 시간, 출력 토큰당 시간을 보고합니다. 이미지 생성 테스트는 FLUX.2 klein 4B, Z-Image Turbo 6B, Qwen-Image 20B를 사용하여 Q4_0, Q8_0, BF16 가중치로 1024×1024 크기의 이미지를 렌더링하고, 양자화된 출력 결과를 BF16과 비교하여 PSNR 및 SSIM으로 평가하여 속도와 품질을 동시에 측정합니다. 코딩 에이전트 테스트는 이제 Crush에서 실행되며, 에이전트-사용자 테스트는 브라우저 벤치마크를 세 번의 전체 패스로 제한하는 수정된 방식을 사용합니다.
표에는 N/A로 시작하는 세 가지 레이블이 반복적으로 나타나는데, 이는 해당 테스트가 하드웨어에 적용되지 않음을 의미합니다. SMT 기능이 없는 285K의 SMT 싱글 코어 테스트와 24개의 코어가 하나의 클래스로 분류되는 Xeon의 OpenBLAS 최상위 코어 클래스 테스트가 여기에 해당합니다. 부분 결과(Partial)는 테스트 스위트가 결과를 수용했음을 나타내며, 대부분 세 번의 실행 중 한 번 테스트에 실패한 코딩 에이전트 계층을 의미합니다. 두 데스크톱 모두 CPU 또는 GPU 온도를 테스트 스위트의 센서 경로에 제공하지 않았으므로, 이 리뷰에서는 열 표 대신 테스트별 평균 CPU 클럭을 보고합니다.
로컬 AI 성능
모든 구성에 96GB의 GDDR7 메모리가 탑재되어 있어 모델 용량은 충분하며, 모든 계층의 로컬 AI 스위트 테스트는 이 네 가지 카드 모두에서 실행됩니다. 따라서 결과는 GPU 전력 제한에 따라 나뉩니다. 메모리 대역폭이 테스트의 한계가 되는 경우 Max-Q 카드와 600W 카드의 성능이 비슷하고, 연산 능력이 한계가 되는 경우 600W 카드가 우위를 점합니다. CPU 플랫폼은 결과에 거의 영향을 미치지 않으며, 영향을 미치는 경우에도 그 방향성은 주목할 만합니다.
MLPerf 클라이언트 v2.0
MLPerf 클라이언트는 Llama 3.1 8B 및 Phi-4-mini를 사용하여 5개의 프롬프트 범주를 실행하고, 첫 번째 토큰까지의 시간과 그 이후의 토큰 생성률을 범주 전체에 걸쳐 기하 평균으로 보고합니다. 모든 구성에서 엔진으로는 CUDA 기반의 llama.cpp가 사용됩니다. 에이전트 시나리오에서는 Llama 3.1 8B가 데이터 분석가 에이전트와 소프트웨어 엔지니어링 에이전트로 실행되어 여러 턴에 걸쳐 도구를 호출합니다.

| MLPerf 클라이언트 v2.0 | 프로 프리시전 9 T2, 맥스큐 300W | 프로 프리시전 9 T2, 600W | 프로 맥스 타워 T2, 맥스-Q 300W | 프로 맥스 타워 T2, 600W |
|---|---|---|---|---|
| Llama 3.1 8B, 첫 번째 토큰까지의 시간, 기하평균(초, 낮을수록 좋음) | 0.082 | 0.059 | 0.082 | 0.060 |
| Llama 3.1 8B, 토큰 비율, 기하평균(tok/s) | 230.9 | 252.8 | 230.0 | 246.7 |
| Phi-4-mini, 첫 번째 토큰 생성 시간, 기하평균(s, 낮을수록 좋음) | 0.045 | 0.034 | 0.044 | 0.034 |
| Phi-4-mini, 토큰 비율, 기하평균(토크/초) | 345.9 | 379.0 | 351.0 | 374.3 |
| 데이터 분석 에이전트, 엔드 투 엔드 (s, 낮을수록 좋음) | 17.5 | 15.7 | 16.2 | 14.4 |
| 데이터 분석 에이전트, 토큰 비율(tok/s) | 202.9 | 223.9 | 202.3 | 218.4 |
| SWE 에이전트, 엔드 투 엔드(s, 낮을수록 좋음) | 16.2 | 14.9 | 14.6 | 13.5 |
| SWE 에이전트, 토큰 비율(tok/s) | 197.5 | 214.6 | 195.5 | 210.2 |
Max-Q 카드는 Xeon 타워와 Core 타워에서 Llama 3.1 8B를 초당 230.9 토큰, 230.0 토큰으로 처리했으며, Phi-4-mini는 동일한 GPU를 사용하여 각각 345.9와 351.0 토큰을 처리했습니다. 600W 카드는 Xeon 타워에서 이 속도를 초당 252.8과 379.0 토큰으로 향상시켜 약 9%의 성능 향상을 보였고, Llama의 첫 번째 토큰 응답 시간을 0.082초에서 0.059초로 28% 단축했습니다. 즉각적인 처리는 연산 능력에 따라 좌우되고, 디코딩은 대역폭에 따라 좌우되며, 두 카드가 동일한 메모리를 공유하기 때문에 전력 제한은 이후 토큰보다 첫 번째 토큰에서 훨씬 더 두드러지게 나타납니다.
CPU 플랫폼의 성능 차이는 에이전트 시나리오에서 나타납니다. 데이터 분석가 에이전트는 Max-Q 카드가 장착된 Core T2에서 16.2초, Xeon T2에서 17.5초 만에 완료되었고, 소프트웨어 엔지니어 에이전트는 Core T2에서 14.6초, Xeon T2에서 16.2초가 걸렸습니다. Xeon의 툴 호출 단계는 각 단계에서 약 1.5초 더 오래 걸렸습니다. 토큰 생성률은 1% 이내로 일치하므로, 차이는 모델 호출 사이에 CPU에서 실행되는 툴 때문이며, 285K의 더 빠른 코어가 이 단계에서 더 빨리 작업을 완료하는 것입니다.
모델 로딩
이 테스트는 Ollama에서 로컬 모델이 드라이브에서 첫 번째 토큰을 생성할 때까지 걸리는 시간을 측정합니다. 측정은 콜드 로드(파일 캐시가 비워진 상태)와 웜 로드(파일이 이미 메모리에 있는 상태) 모두에서 수행되며, 콜드 로드 시 드라이브 읽기 속도, 가중치가 GPU 메모리에 도달한 시간, 그리고 로드 효율성 수치를 보고합니다. 로드 효율성 수치는 로드 중 읽기 속도를 드라이브의 1MB 순차 최대 읽기 속도와 비교한 값입니다. 96GB의 VRAM을 사용했을 때, 세 가지 티어 모두 다음과 같은 성능을 보였습니다: gpt-oss:20b는 12.8GB, Qwen3.6-35B-A3B는 21.1GB, gpt-oss:120b는 60.9GB.

| 모델 로딩(메모리 매핑 켜짐) | 프로 프리시전 9 T2, 맥스큐 300W | 프로 프리시전 9 T2, 600W | 프로 맥스 타워 T2, 맥스-Q 300W | 프로 맥스 타워 T2, 600W |
|---|---|---|---|---|
| gpt-oss:20b, 첫 번째 토큰에 콜드 로드(s, 낮을수록 좋음) | 9.68 | 9.02 | 7.41 | 7.23 |
| gpt-oss:20b, 첫 번째 토큰에 대한 웜 로딩(s, 낮을수록 좋음) | 7.52 | 7.18 | 6.60 | 6.61 |
| gpt-oss:20b, GPU 메모리 도착 시간, 콜드(s, 낮을수록 좋음) | 4.44 | 4.33 | 3.00 | 2.95 |
| Qwen3.6-35B-A3B, 첫 번째 토큰에 콜드 로드(s, 낮을수록 좋음) | 13.31 | 12.32 | 11.62 | 11.01 |
| Qwen3.6-35B-A3B, 첫 번째 토큰에 웜 로드(s, 낮을수록 좋음) | 11.63 | 10.75 | 10.35 | 9.99 |
| gpt-oss:120b, 첫 번째 토큰에 콜드 로드(s, 낮을수록 좋음) | 32.06 | 32.44 | 28.54 | 28.11 |
| gpt-oss:120b, 첫 번째 토큰에 대한 웜 로딩(s, 낮을수록 좋음) | 27.18 | 26.49 | 25.58 | 25.73 |
| gpt-oss:120b, 콜드로드 시 읽기 처리량(MB/s) | 9,875 | 9,106 | 11,633 | 11,248 |
| gpt-oss:120b, GPU 메모리 도착 시간, 콜드(s, 낮을수록 좋음) | 11.33 | 11.57 | 7.74 | 7.63 |
| gpt-oss:120b 로드는 gpt-oss:20b에서 교체한 후 발생합니다(값이 낮을수록 좋습니다). | 14.30 | 13.97 | 11.89 | 11.93 |
| 드라이브 최대 성능, 디스크 속도 1MB 순차 읽기(MB/s) | 11,306 | 11,296 | 11,563 | 11,646 |
Core T2는 모든 모델을 더 빠르게 로드하는데, 그 이유는 드라이브 때문입니다. gpt-oss:120b는 Core T2에서 콜드 드라이브 상태에서 첫 번째 토큰을 28.54초 만에 로드한 반면, Xeon T2에서는 32.06초가 걸렸습니다. 61GB의 가중치 데이터는 7.74초 만에 GPU 메모리에 로드되었는데, 이는 11.33초보다 빠른 속도입니다. 단일 PCB01 드라이브는 11,633MB/s의 속도로 로드를 처리했는데, 이는 DiskSpd 최대치인 11,563MB/s에 거의 근접한 수치입니다. 반면 E3.S 스트라이프는 9,875MB/s의 속도로 로드를 처리했는데, 이는 자체 최대치인 11,306MB/s에 근접한 수치입니다. RAID 볼륨은 단일 드라이브만큼 빠르게 대용량 블록을 읽지만, Ollama의 메모리 매핑 로딩 경로를 통과하는 동안에는 그 속도를 유지하지 못합니다.
시스템이 이미 메모리에 로드된 상태이고 남은 작업은 VRAM으로의 전송 및 llama.cpp 설정뿐이므로, 초기 부하 시 로딩 시간은 1~2초로 단축됩니다. 예를 들어, gpt-oss:120b의 경우 Xeon T2에서 27.18초, gpt-oss:20b에서 7.52초 대 6.60초가 소요되었습니다. 예상대로 GPU 전력 제한은 로딩 시간에 일관된 차이를 보이지 않았습니다.
코딩 에이전트
터미널 코딩 에이전트인 Crush는 Ollama에서 제공하는 로컬 모델을 사용하여 고정된 저장소의 코딩 작업을 수행합니다. 저장소의 11개 테스트를 통과시키기 위해 최대 3번의 실행이 주어지며, 각 실행의 중앙값 소요 시간, 성공 횟수, 그리고 생성률을 보고합니다. 소요 시간은 모델이 사용하는 도구 호출 및 토큰 수에 따라 달라지는데, 이는 실행마다 변동하므로 생성률이 하드웨어 성능을 비교하는 데 더 적합한 지표입니다. 에이전트와 사용자 동시 실행 테스트에서는 에이전트와 Speedometer를 함께 실행하여 서로의 성능 저하 정도를 보고합니다.

| 크러쉬 코딩 에이전트 | 프로 프리시전 9 T2, 맥스큐 300W | 프로 프리시전 9 T2, 600W | 프로 맥스 타워 T2, 맥스-Q 300W | 프로 맥스 타워 T2, 600W |
|---|---|---|---|---|
| 티어 S, gpt-oss:20b, 64K 컨텍스트 | ||||
| 소요 시간(중앙값, 초 단위, 낮을수록 좋음) | 55.1 | 99.8 | 57.2 | 43.2 |
| 성공 횟수 (3회 중) | 3 | 2 | 3 | 2 |
| 생성 속도(토크/초) | 214.1 | 237.9 | 218.0 | 237.7 |
| 티어 M, Qwen3.6-35B-A3B, 64K 컨텍스트 | ||||
| 소요 시간(중앙값, 초 단위, 낮을수록 좋음) | 35.2 | 27.0 | 86.7 | 32.1 |
| 성공 횟수 (3회 중) | 3 | 3 | 3 | 3 |
| 생성 속도(토크/초) | 234.5 | 242.9 | 223.3 | 245.8 |
| 티어 L, Qwen3.6-35B-A3B, 128K 컨텍스트 | ||||
| 소요 시간(중앙값, 초 단위, 낮을수록 좋음) | 38.1 | 30.6 | 74.1 | 58.8 |
| 성공 횟수 (3회 중) | 3 | 3 | 3 | 3 |
| 생성 속도(토크/초) | 222.9 | 237.0 | 231.1 | 252.8 |
| 티어 W, gpt-oss:120b, 128K 컨텍스트 | ||||
| 소요 시간(중앙값, 초 단위, 낮을수록 좋음) | 49.1 | 37.9 | 56.6 | 30.8 |
| 성공 횟수 (3회 중) | 3 | 3 | 3 | 3 |
| 생성 속도(토크/초) | 160.9 | 177.1 | 158.5 | 174.4 |
| 사용자 옆에 있는 에이전트(gpt-oss:20b 및 Speedometer가 함께 있음) | ||||
| 에이전트 옆에 있는 속도계 (점수) | 36.6 | 36.7 | 43.2 | 45.2 |
| 속도계 속도 저하(x, 값이 낮을수록 좋음) | 1.005 | 1.011 | 1.053 | 1.044 |
| 속도계 옆 에이전트 생성 속도(tok/s) | 218.2 | 231.6 | 212.4 | 229.2 |
| 에이전트 속도 저하(x, 값이 낮을수록 좋음) | 1.006 | 1.009 | 1.023 | 0.998 |
모든 구성에서 가장 큰 모델인 gpt-oss:120b를 사용한 티어 W 작업의 세 번의 실행이 모두 완료되었으며, Xeon 타워에서는 초당 160.9~177.1개의 토큰을, Core 타워에서는 초당 158.5~174.4개의 토큰을 생성했습니다. 600W 그래픽 카드는 각 성능 향상에 약 10%의 기여를 했습니다. Qwen3.6 작업 또한 모든 환경에서 세 번의 실행을 모두 완료했으며, 초당 223~253개의 토큰을 생성했습니다. gpt-oss:20b 모델에서만 문제가 발생했습니다. 티어 S 작업은 네 가지 구성 중 두 가지 구성에서 세 번의 실행 중 한 번 실패했으며, 128K 컨텍스트를 사용하는 티어 M 작업(표시되지 않음)은 모든 환경에서 최소 한 번 이상 실패했습니다. 이러한 모델 동작은 하드웨어와 관계없이 유지되었습니다.
에이전트와 브라우저 벤치마크를 동시에 실행하는 것은 외장 GPU와 24개의 코어를 여유롭게 갖춘 데스크탑 시스템에서는 거의 비용이 들지 않습니다. 에이전트를 실행했을 때 Speedometer는 Xeon T2에서 1.005배, Core T2에서 1.053배 느려졌으며, 에이전트의 데이터 생성 속도는 두 경우 모두 2% 이하로 변동했습니다. 에이전트 실행 전 Xeon T2의 Speedometer 점수 36.6점은 Core T2의 43.2점보다 낮은데, 이는 Core T2 단독 실행 시와 동일한 이유, 즉 285K의 코어당 속도 때문입니다.
검색 증강 생성
저희 RAG 테스트는 20,963개의 SQuAD v1.1 지문을 nomic-embed-text를 사용하여 임베딩하고, 2,000개의 질문 각각에 대해 상위 5개의 지문을 추출한 다음, 그중 400개에 대해 Phi-4-mini를 사용하여 정답을 판별하고 참조 답변과의 일치도 및 F1 점수를 측정합니다. 모델 규모가 작기 때문에 이 테스트는 GPU 단계 사이의 CPU 측 벡터 검색을 포함한 전체 파이프라인을 측정합니다.

| RAG | 프로 프리시전 9 T2, 맥스큐 300W | 프로 프리시전 9 T2, 600W | 프로 맥스 타워 T2, 맥스-Q 300W | 프로 맥스 타워 T2, 600W |
|---|---|---|---|---|
| 섭취 시간, 20,963회 통과 (초, 낮을수록 좋음) | 128.5 | 125.5 | 108.1 | 103.0 |
| 임베딩 속도(tok/s) | 29,875 | 30,592 | 35,165 | 37,508 |
| 검색 쿼리 시간, p50 (밀리초, 낮을수록 좋음) | 30.6 | 27.2 | 23.4 | 18.7 |
| 답변, Phi-4-mini 첫 번째 토큰까지의 시간, p50(s, 낮을수록 좋음) | 0.099 | 0.087 | 0.089 | 0.083 |
| 답변, 신속 처리(tok/s) | 20,318 | 26,549 | 21,356 | 26,619 |
| 답변, 생성률(tok/s) | 296.4 | 337.8 | 324.3 | 344.1 |
| 답변해야 할 질문, 50페이지 (s, 낮을수록 좋음) | 0.152 | 0.133 | 0.130 | 0.120 |
| 리콜@5 (%) | 82.7 | 82.7 | 82.7 | 82.7 |
| 답변 F1 (%) | 74.65 | 74.65 | 74.65 | 74.65 |
Core T2는 이 파이프라인에서 더 빠른 속도를 보였습니다. 동일한 Max-Q 카드를 사용한 Xeon T2에서 128.5초가 걸린 반면, Core T2는 108.1초 만에 코퍼스를 입력했고, 중앙값 기준으로 30.6ms가 걸린 Xeon T2에서 23.4ms 만에 데이터를 검색했으며, 0.152초가 걸린 Xeon T2에서 0.130초 만에 질문에 답변했습니다. 임베딩과 검색 모두 CPU 병목 현상이 발생하는 단계가 있는데, 이 부분에서는 285K가 유리합니다. 600W 카드는 두 플랫폼 모두에서 프롬프트 처리 속도를 25~30% 향상시켜 Xeon T2의 초당 토큰 수를 20,318개에서 26,549개로 늘렸으며, 정확도는 모든 네 가지 구성에서 동일했습니다. 이는 온도 0도에서 동일한 모델을 사용했기 때문에 당연한 결과입니다.
LLM 제공
본 서빙 테스트는 Ministral 3 3B 및 8B(4,096개 토큰 프롬프트, 1,024개 토큰 출력), Qwen3.8 27B, 그리고 gpt-oss 120B(8,192개 토큰 프롬프트)를 사용하여 llama-server를 실행하고, 가중치 계산 후 GPU 메모리에 맞는 슬롯을 최대한 많이 할당한 다음, 동시 요청 수를 1개부터 해당 슬롯 한도까지 점진적으로 증가시킵니다. 총 처리량(프롬프트 및 출력 토큰 포함), 출력 처리량, 첫 번째 토큰 처리 시간, 그리고 출력 토큰당 처리 시간을 중앙값으로 보고합니다. 96GB GPU 카드에서 gpt-oss 120B는 22.5GiB의 KV 캐시를 사용하여 64개의 슬롯에 적합하고, Qwen3.8 27B는 8개, 그리고 두 Ministral 모델은 각각 4개의 슬롯에 적합합니다.

| llama-server, gpt-oss 120B, 8,192개 토큰 프롬프트, 1,024개 토큰 출력 | 프로 프리시전 9 T2, 맥스큐 300W | 프로 프리시전 9 T2, 600W | 프로 맥스 타워 T2, 맥스-Q 300W | 프로 맥스 타워 T2, 600W |
|---|---|---|---|---|
| 동시 접속자 1명: 출력 처리량(tok/s) | 160.6 | 182.7 | 158.4 | 179.0 |
| 동시 접속자 1명: 첫 번째 토큰이 생성될 때까지의 시간(중앙값, 밀리초, 낮을수록 좋음) | 1,241 | 918 | 1,238 | 923 |
| 동시 접속자 1명: 출력 토큰당 소요 시간(중앙값, 밀리초, 낮을수록 좋음) | 5.03 | 4.58 | 5.11 | 4.70 |
| 동시 접속자 8명: 총 처리량(tok/s) | 2,088 | 2,460 | 2,154 | 2,534 |
| 동시 접속 사용자 8명: 사용자당 출력량(tok/s) | 29.0 | 34.2 | 29.9 | 35.2 |
| 동시 접속자 8명: 첫 번째 토큰이 생성될 때까지의 시간(중앙값, 밀리초, 낮을수록 좋음) | 2,847 | 2,152 | 2,856 | 2,121 |
| 동시 접속자 64명: 총 처리량(tok/s) | 3,296 | 3,805 | 3,531 | 4,220 |
| 동시 접속 사용자 64명: 사용자당 출력량(tok/s) | 5.7 | 6.6 | 6.1 | 7.3 |
| 동시 접속자 64명: 첫 번째 토큰이 생성될 때까지의 시간(중앙값, 밀리초, 낮을수록 좋음) | 4,315 | 3,491 | 4,607 | 3,622 |
| 동시 접속자 64명: 출력 토큰당 소요 시간(중앙값, 밀리초, 낮을수록 좋음) | 163.0 | 141.3 | 152.7 | 126.3 |
단일 사용자가 Max-Q 카드에서 초당 160.6 토큰, 600W 카드에서 초당 182.7 토큰의 속도로 gpt-oss 120B를 처리하며, 첫 번째 토큰은 8,192개의 토큰 프롬프트 후 각각 1,241ms와 918ms 만에 도착합니다. 64개의 동시 요청으로 카드를 로드하면 총 처리량은 Max-Q 카드에서 초당 3,296 토큰, 600W 카드에서 초당 3,805 토큰으로 증가하지만, 사용자당 처리량은 각각 초당 5.7개와 6.6개로 감소하고 첫 번째 토큰 수신 시간은 각각 4.3초와 3.5초로 늘어납니다. 동시 요청 수가 4개에서 32개 사이일 때는 처리량 곡선이 완만해지다가 64개에서 다시 급증하는데, 이때 배치 처리 과정에서 긴 프롬프트 시간이 상쇄됩니다.

| llama-server, 최대 동시 접속 환경에서의 출력 처리량(tok/s) | 프로 프리시전 9 T2, 맥스큐 300W | 프로 프리시전 9 T2, 600W | 프로 맥스 타워 T2, 맥스-Q 300W | 프로 맥스 타워 T2, 600W |
|---|---|---|---|---|
| Ministral 3 3B 추론, 4 동시 | 562.5 | 600.4 | 576.8 | 625.3 |
| Ministral 3 8B 추론, 4 동시 | 375.8 | 445.1 | 377.9 | 446.3 |
| Qwen3.8 27B, 8 동시 | 153.1 | 189.6 | 152.2 | 187.3 |
| gpt-oss 120B, 동시 접속 64개 | 366.3 | 422.8 | 392.3 | 468.9 |
| 단일 요청 출력 처리량(tok/s) | ||||
| 미니스트랄 3 3B 추론 | 232.1 | 241.8 | 232.1 | 246.0 |
| 미니스트랄 3 8B 추론 | 165.0 | 183.3 | 164.1 | 180.4 |
| 퀀3.8 27B | 54.0 | 63.7 | 54.1 | 63.0 |
| gpt-oss 120B | 160.6 | 182.7 | 158.4 | 179.0 |
Qwen3.8 27B는 Max-Q에서 단일 사용자 기준으로 초당 54.0 토큰으로 가장 느린 모델입니다. 이는 모든 토큰이 270억 개의 모든 매개변수에 접근하기 때문입니다. 반면, GPT-OSS 120B는 디스크 용량이 4배 더 크지만 3.0배 더 빠른 속도를 보입니다. 600W 카드의 성능 우위는 고밀도 모델에서 가장 두드러지며, 동시 요청 8개에서 24%의 차이를 보이고, Ministral 3B에서는 약 7%로 가장 좁습니다. 두 시스템은 64개 요청의 GPT-OSS 경우를 제외하고는 모든 경우에서 약 3% 이내의 차이를 보입니다. 64개 요청의 GPT-OSS의 경우 Core T2가 두 카드 모두에서 7~11%의 우위를 보였으므로, 해당 배치 크기에서는 서버의 CPU 작업 처리 속도가 더 빠른 코어가 유리합니다.
이미지 생성
이미지 생성 테스트는 세 가지 확산 모델과 세 가지 가중치 정밀도를 사용하여 1024×1024 크기의 이미지를 렌더링하고, 이미지당 소요 시간, 노이즈 제거율, 가중치에 사용되는 GPU 메모리 사용량을 보고합니다. 또한 동일한 시드를 BF16 해상도로 렌더링하고 Q4_0 및 Q8_0 출력 결과를 PSNR 및 SSIM으로 평가하여 양자화로 인한 이미지 품질 저하를 수치화합니다.

| 이미지 생성, 1024×1024 | 프로 프리시전 9 T2, 맥스큐 300W | 프로 프리시전 9 T2, 600W | 프로 맥스 타워 T2, 맥스-Q 300W | 프로 맥스 타워 T2, 600W |
|---|---|---|---|---|
| FLUX.2 클라인 4B, 4단계 | ||||
| Q8_0: 이미지당 소요 시간(초가 낮을수록 좋음) | 1.66 | 1.37 | 1.59 | 1.30 |
| Q8_0: 분당 이미지 수 | 36.2 | 43.7 | 37.6 | 46.0 |
| BF16: 이미지당 소요 시간(초가 낮을수록 좋음) | 1.60 | 1.34 | 1.55 | 1.27 |
| Z-Image Turbo 6B, 8단계 | ||||
| Q8_0: 이미지당 소요 시간(초가 낮을수록 좋음) | 3.82 | 2.89 | 3.78 | 2.82 |
| Q8_0: 분당 이미지 수 | 15.7 | 20.7 | 15.9 | 21.3 |
| BF16: 이미지당 소요 시간(초가 낮을수록 좋음) | 3.61 | 2.76 | 3.56 | 2.68 |
| Qwen-Image 20B, 20단계 | ||||
| Q4_0: 이미지당 소요 시간(초가 낮을수록 좋음) | 25.60 | 19.11 | 25.57 | 18.97 |
| Q8_0: 이미지당 소요 시간(초가 낮을수록 좋음) | 26.08 | 19.66 | 26.02 | 19.42 |
| BF16: 이미지당 소요 시간(초가 낮을수록 좋음) | 26.17 | 20.45 | 26.05 | 20.28 |
| Q8_0: 분당 이미지 수 | 2.30 | 3.05 | 2.31 | 3.09 |
| BF16: 가중치 계산용 GPU 메모리(GiB) | 45.3 | 45.3 | 45.3 | 45.3 |
확산(Diffusion)은 연산 능력에 따라 성능이 좌우되며, 600W 그래픽 카드에서 그 성능이 확연히 드러납니다. Qwen-Image 20B(Q8_0) 테스트에서 Max-Q는 이미지당 26.1초, Xeon 타워의 600W 카드는 19.7초가 소요되어 분당 이미지 처리량이 33% 향상되었습니다. Z-Image Turbo 테스트에서는 32%, FLUX.2 klein 테스트에서는 21% 향상되었습니다. CPU 플랫폼은 서버 시작을 제외한 모든 항목에서 두 타워의 성능 차이가 1% 이내로 나타나므로 성능 차이는 여기서는 중요하지 않습니다. 서버 시작 시에는 Xeon T2의 RAID 볼륨이 가중치를 로드하는 데 몇 초 더 걸립니다.
| BF16(동일 시드)에 대한 양자화 충실도 | 프로 프리시전 9 T2, 맥스큐 300W | 프로 프리시전 9 T2, 600W | 프로 맥스 타워 T2, 맥스-Q 300W | 프로 맥스 타워 T2, 600W |
|---|---|---|---|---|
| PSNR(dB, 높을수록 좋음) / SSIM(높을수록 좋음) | ||||
| 플럭스.2 클라인 4B, Q4_0 | 17.5 / 0.788 | 17.5 / 0.788 | 17.5 / 0.788 | 17.5 / 0.788 |
| 플럭스.2 클라인 4B, Q8_0 | 32.9 / 0.987 | 32.9 / 0.987 | 32.9 / 0.987 | 32.9 / 0.987 |
| Z-Image Turbo 6B, Q4_0 | 19.6 / 0.752 | 19.6 / 0.752 | 19.6 / 0.752 | 19.6 / 0.752 |
| Z-Image Turbo 6B, Q8_0 | 28.5 / 0.938 | 28.5 / 0.938 | 28.5 / 0.938 | 28.5 / 0.938 |
| Qwen-Image 20B, Q4_0 | 22.3 / 0.792 | 22.3 / 0.792 | 22.3 / 0.792 | 22.3 / 0.792 |
| Qwen-Image 20B, Q8_0 | 35.8 / 0.985 | 35.8 / 0.985 | 35.8 / 0.985 | 35.8 / 0.985 |
출력은 하드웨어가 아닌 가중치에 따라 달라지므로 네 가지 구성 모두에서 충실도 행이 동일합니다. Q8_0은 0.938~0.987의 SSIM과 28~36dB의 PSNR로 BF16 이미지를 재현하는 반면, Q4_0은 0.75~0.79의 SSIM과 18~22dB로 떨어져 완전히 다른 결과를 보여줍니다. 96GB 메모리 카드에서는 Q8_0보다 낮은 사양의 모델을 사용할 이유가 없습니다. Qwen-Image의 BF16 가중치는 45.3GiB에 적합하며, Q8_0 경로가 양자화 해제에 시간을 소비하기 때문에 세 가지 모델 모두에서 BF16 렌더링 속도가 Q8_0과 비슷하거나 약간 더 빠릅니다.
CPU 성능
두 프로세서는 CPU 성능 테스트에서 명확한 우위를 보였습니다. 모든 코어를 사용하는 테스트에서는 Xeon 658X가 대부분의 테스트에서 27%에서 150%까지 우위를 점했으며, 벡터 폭이 넓고 메모리 트래픽이 많을수록 그 격차는 더욱 커졌습니다. 반면, 단일 스레드 또는 몇 개의 스레드만 사용하는 테스트에서는 Core Ultra 9 285K가 5.7GHz P-코어의 강력한 성능으로 4.9GHz Xeon 코어(캐시 및 메모리 지연 시간 증가) 대비 13%에서 31%까지 우위를 차지했습니다. 600W GPU가 Xeon의 모든 코어 성능에 미치는 영향은 각 표에 자세히 설명되어 있으며 클럭 속도 섹션에서 요약되어 있습니다.
Cinebench 2026 및 지속 부하
Cinebench 2026은 Maxon의 Redshift 엔진을 사용하여 CPU에서 장면을 렌더링하고 싱글 코어, SMT 싱글 코어(하나의 물리적 코어에서 두 개의 스레드 실행), 멀티 코어 처리량을 측정합니다. 그런 다음 약 30분 동안 멀티 코어 실행을 반복하는 지속적인 루프를 수행하고 안정 상태를 첫 번째 실행 결과와 비교합니다.

| 시네벤치 2026 (점수, 높을수록 좋음) | 프로 프리시전 9 T2, 맥스큐 300W | 프로 프리시전 9 T2, 600W | 프로 맥스 타워 T2, 맥스-Q 300W | 프로 맥스 타워 T2, 600W |
|---|---|---|---|---|
| 단일 코어 | 454.1 | 455.6 | 564.4 | 564.5 |
| SMT 싱글 코어 | 599.1 | 601.0 | 해당 없음 (SMT 없음) | 해당 없음 (SMT 없음) |
| 멀티 코어 | 12,322 | 11,705 | 8,856 | 8,838 |
| 지속 루프, 첫 번째 패스 | 12,201 | 11,731 | 8,717 | 8,788 |
| 지속 루프, 정상 상태 | 12,328 | 11,764 | 8,825 | 8,844 |
| 정상 상태 / 첫 번째 통과 | 1.010 | 1.003 | 1.012 | 1.006 |
| 지속 루프, 정상 상태 CPU 클럭(MHz) | 4,274 | 4,178 | 4,669 | 4,690 |
658X는 Max-Q 카드를 장착한 상태에서 멀티코어 점수 12,322점을 기록하며 285K의 8,856점보다 39% 높은 점수를 얻었고, 30분 동안의 테스트에서도 12,328점을 유지하며 첫 번째 테스트보다 1% 높은 안정적인 점수를 보였습니다. 하지만 단일 코어 테스트에서는 순위가 역전되어 285K가 564.4점을 기록한 반면 Xeon은 454.1점을 기록했습니다. Xeon은 단일 코어에서 두 개의 스레드를 사용하여 599.1점을 기록해야 285K의 단일 스레드 점수를 넘어섰습니다.
600W 그래픽 카드를 장착하자 제온 프로세서의 멀티코어 점수는 11,705점, 정상 작동 점수는 11,764점으로 5% 하락했으며, 정상 작동 클럭은 4,274MHz에서 4,178MHz로 떨어졌습니다. 코어 T2는 8,856점과 8,838점으로 변화가 없었습니다. 테스트 스위트에서 두 케이스 모두 CPU와 GPU 온도를 측정하지 않았기 때문에 250W 프로세서가 600W 카드의 발열 때문인지 아니면 전력 공유 때문인지는 알 수 없지만, 더 큰 카드를 장착했을 때 모든 코어 테스트에서 4~5% 정도 성능이 저하되는 것은 분명합니다.
7 - 우편 번호
7-Zip에 내장된 벤치마크는 LZMA 압축 및 압축 해제 처리량을 초당 기가 명령어(Gbps) 단위로 보고합니다. 이 측정은 모든 스레드에서 한 번, 그리고 단일 코어에 고정하여 한 번 수행됩니다. LZMA는 정수 처리량, 분기 예측, 캐시 및 메모리 지연 시간에 의존하므로 벡터 폭보다는 코어 수와 빠른 메모리 경로에 더 유리합니다.

| 7-Zip (GIPS, 높을수록 좋음) | 프로 프리시전 9 T2, 맥스큐 300W | 프로 프리시전 9 T2, 600W | 프로 맥스 타워 T2, 맥스-Q 300W | 프로 맥스 타워 T2, 600W |
|---|---|---|---|---|
| 모든 스레드 | ||||
| 금액 | 289.6 | 288.9 | 174.8 | 175.7 |
| 압축하다 | 276.4 | 273.5 | 151.5 | 151.9 |
| 압축 해제 | 303.0 | 304.4 | 198.1 | 199.4 |
| 하나의 스레드 | ||||
| 금액 | 8.74 | 8.05 | 10.82 | 10.83 |
| 압축하다 | 8.66 | 7.80 | 9.31 | 9.31 |
| 압축 해제 | 8.83 | 8.30 | 12.33 | 12.34 |
48개 스레드에서 Xeon은 24개 스레드 기준 285K의 174.8 GIPS보다 66% 높은 289.6 GIPS를 기록했습니다. 압축에서는 82%, 압축 해제에서는 53% 앞섰습니다. 단일 스레드에서는 285K가 8.74 GIPS보다 높은 10.82 GIPS를 기록했으며, 600W 카드를 Xeon 타워에 장착했을 때는 클럭 속도가 낮아져 격차가 8.05 GIPS까지 벌어졌습니다.
블렌더, 핸드브레이크, LLVM
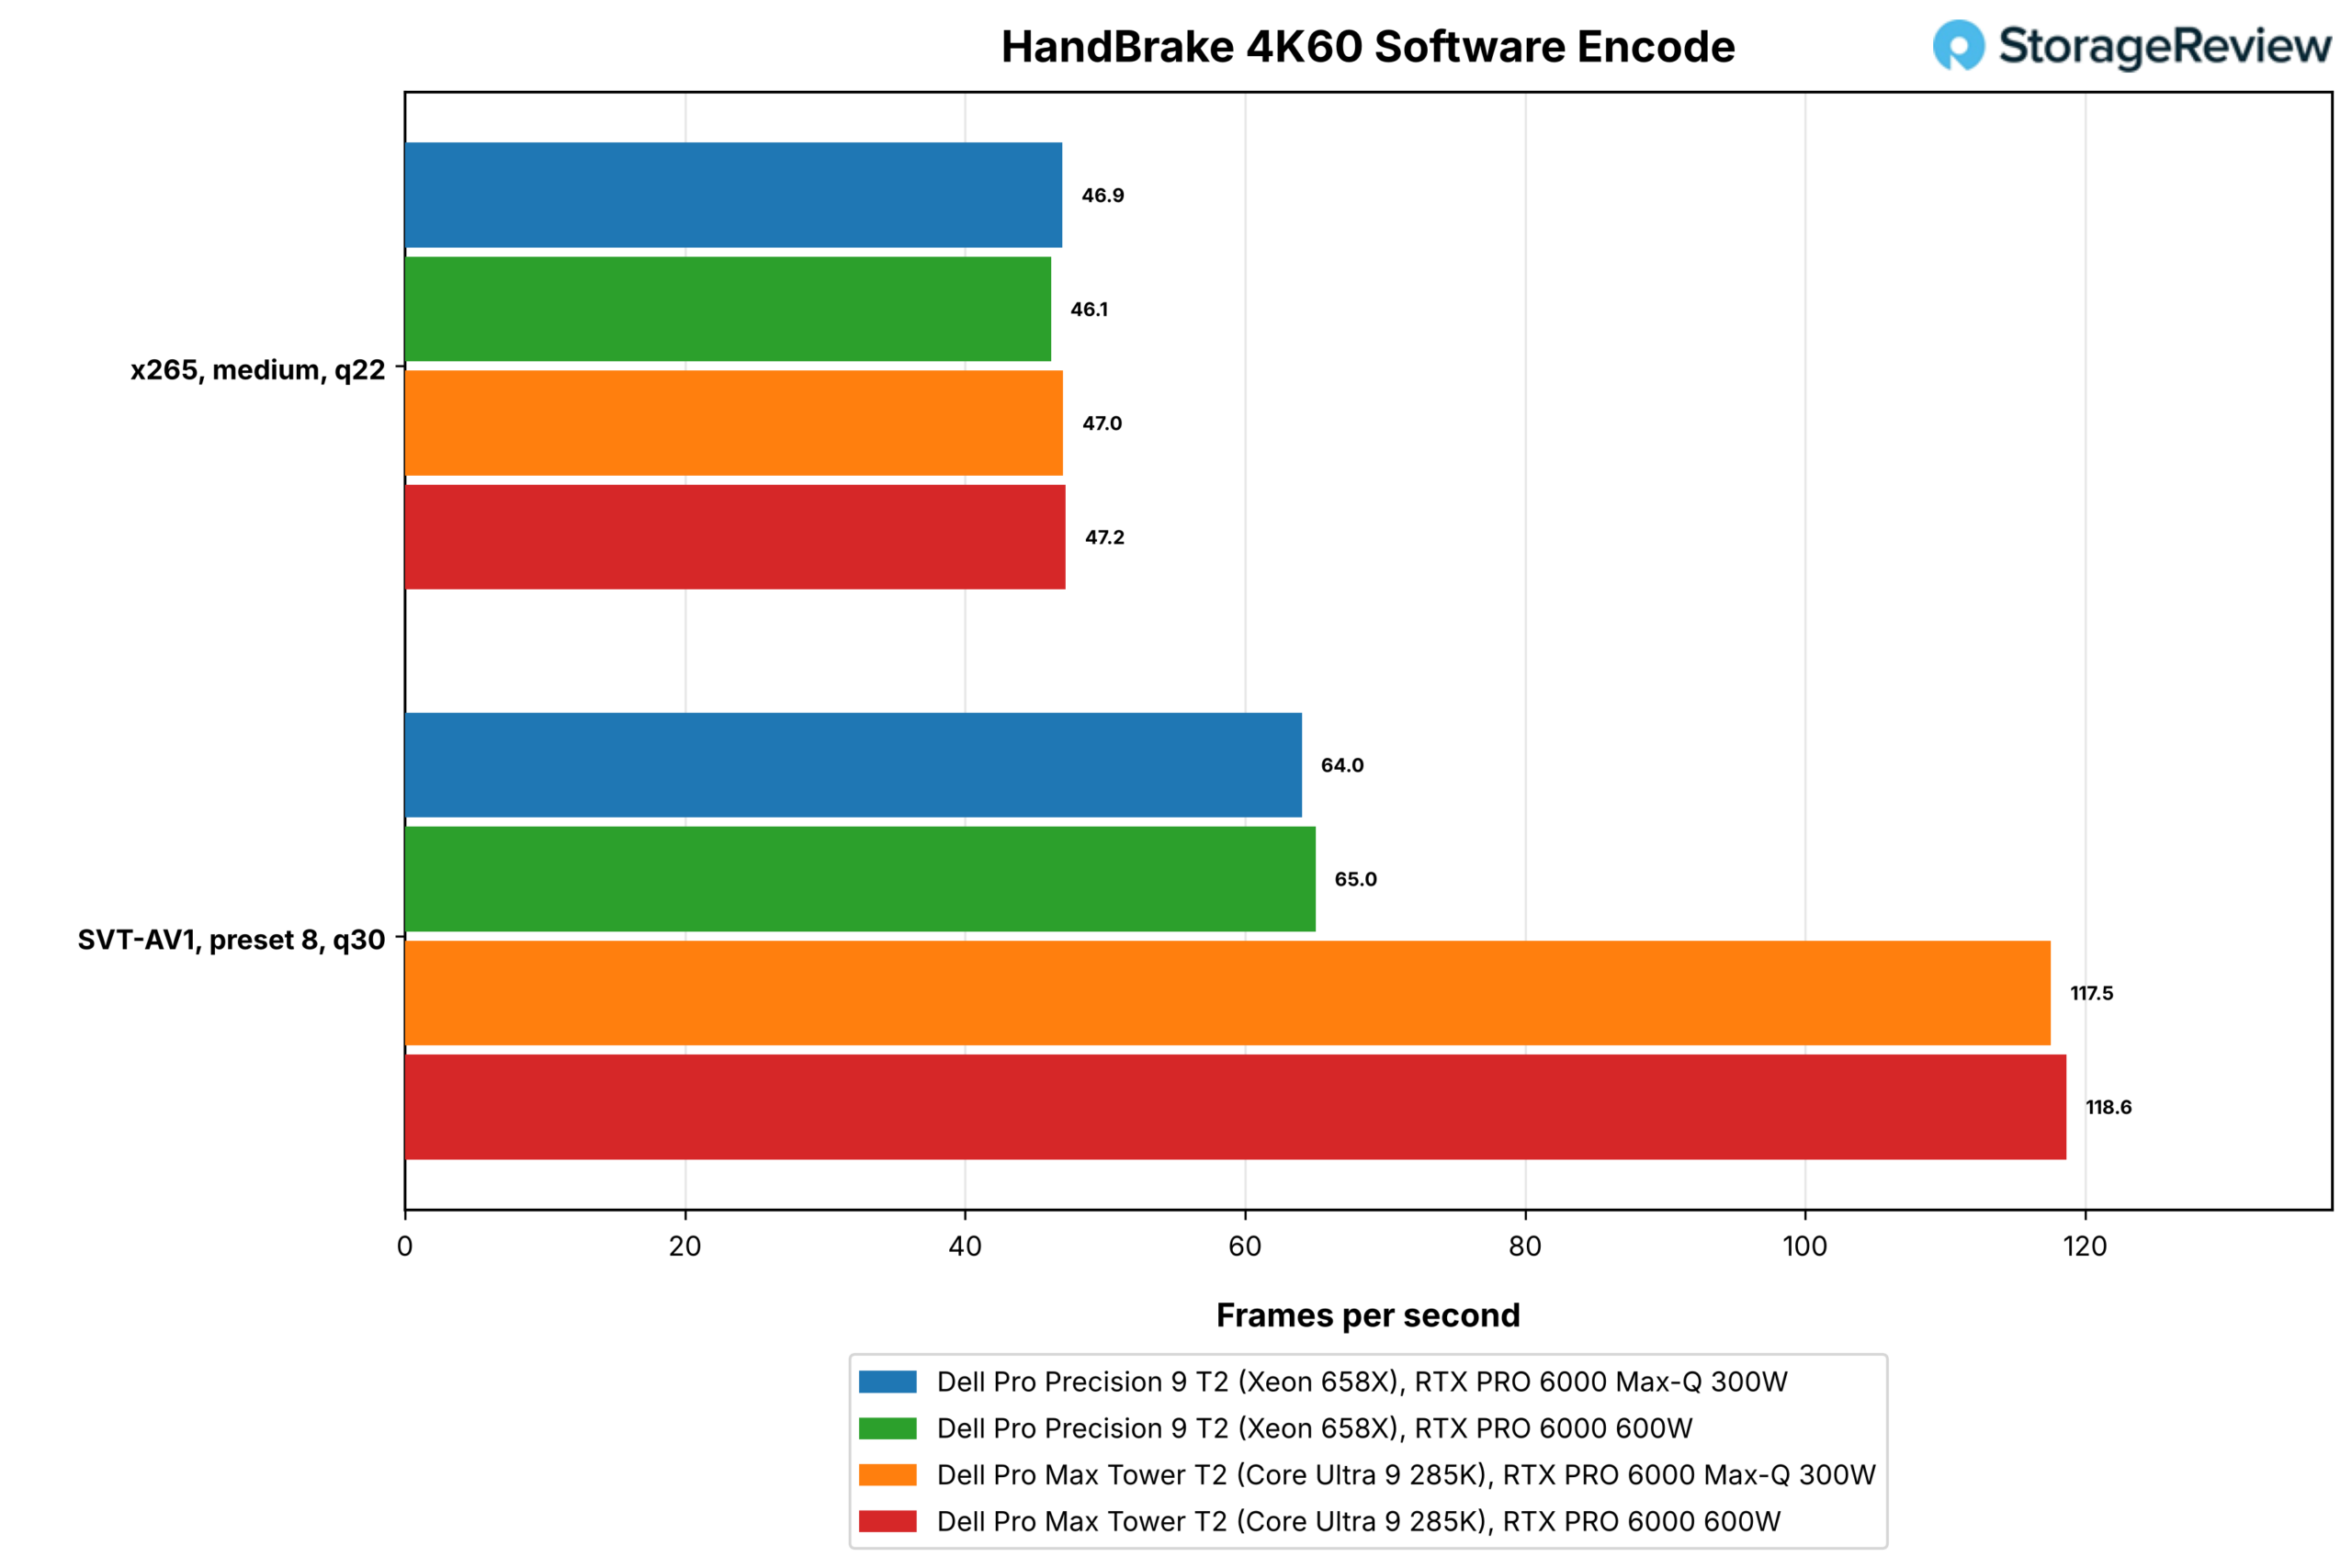
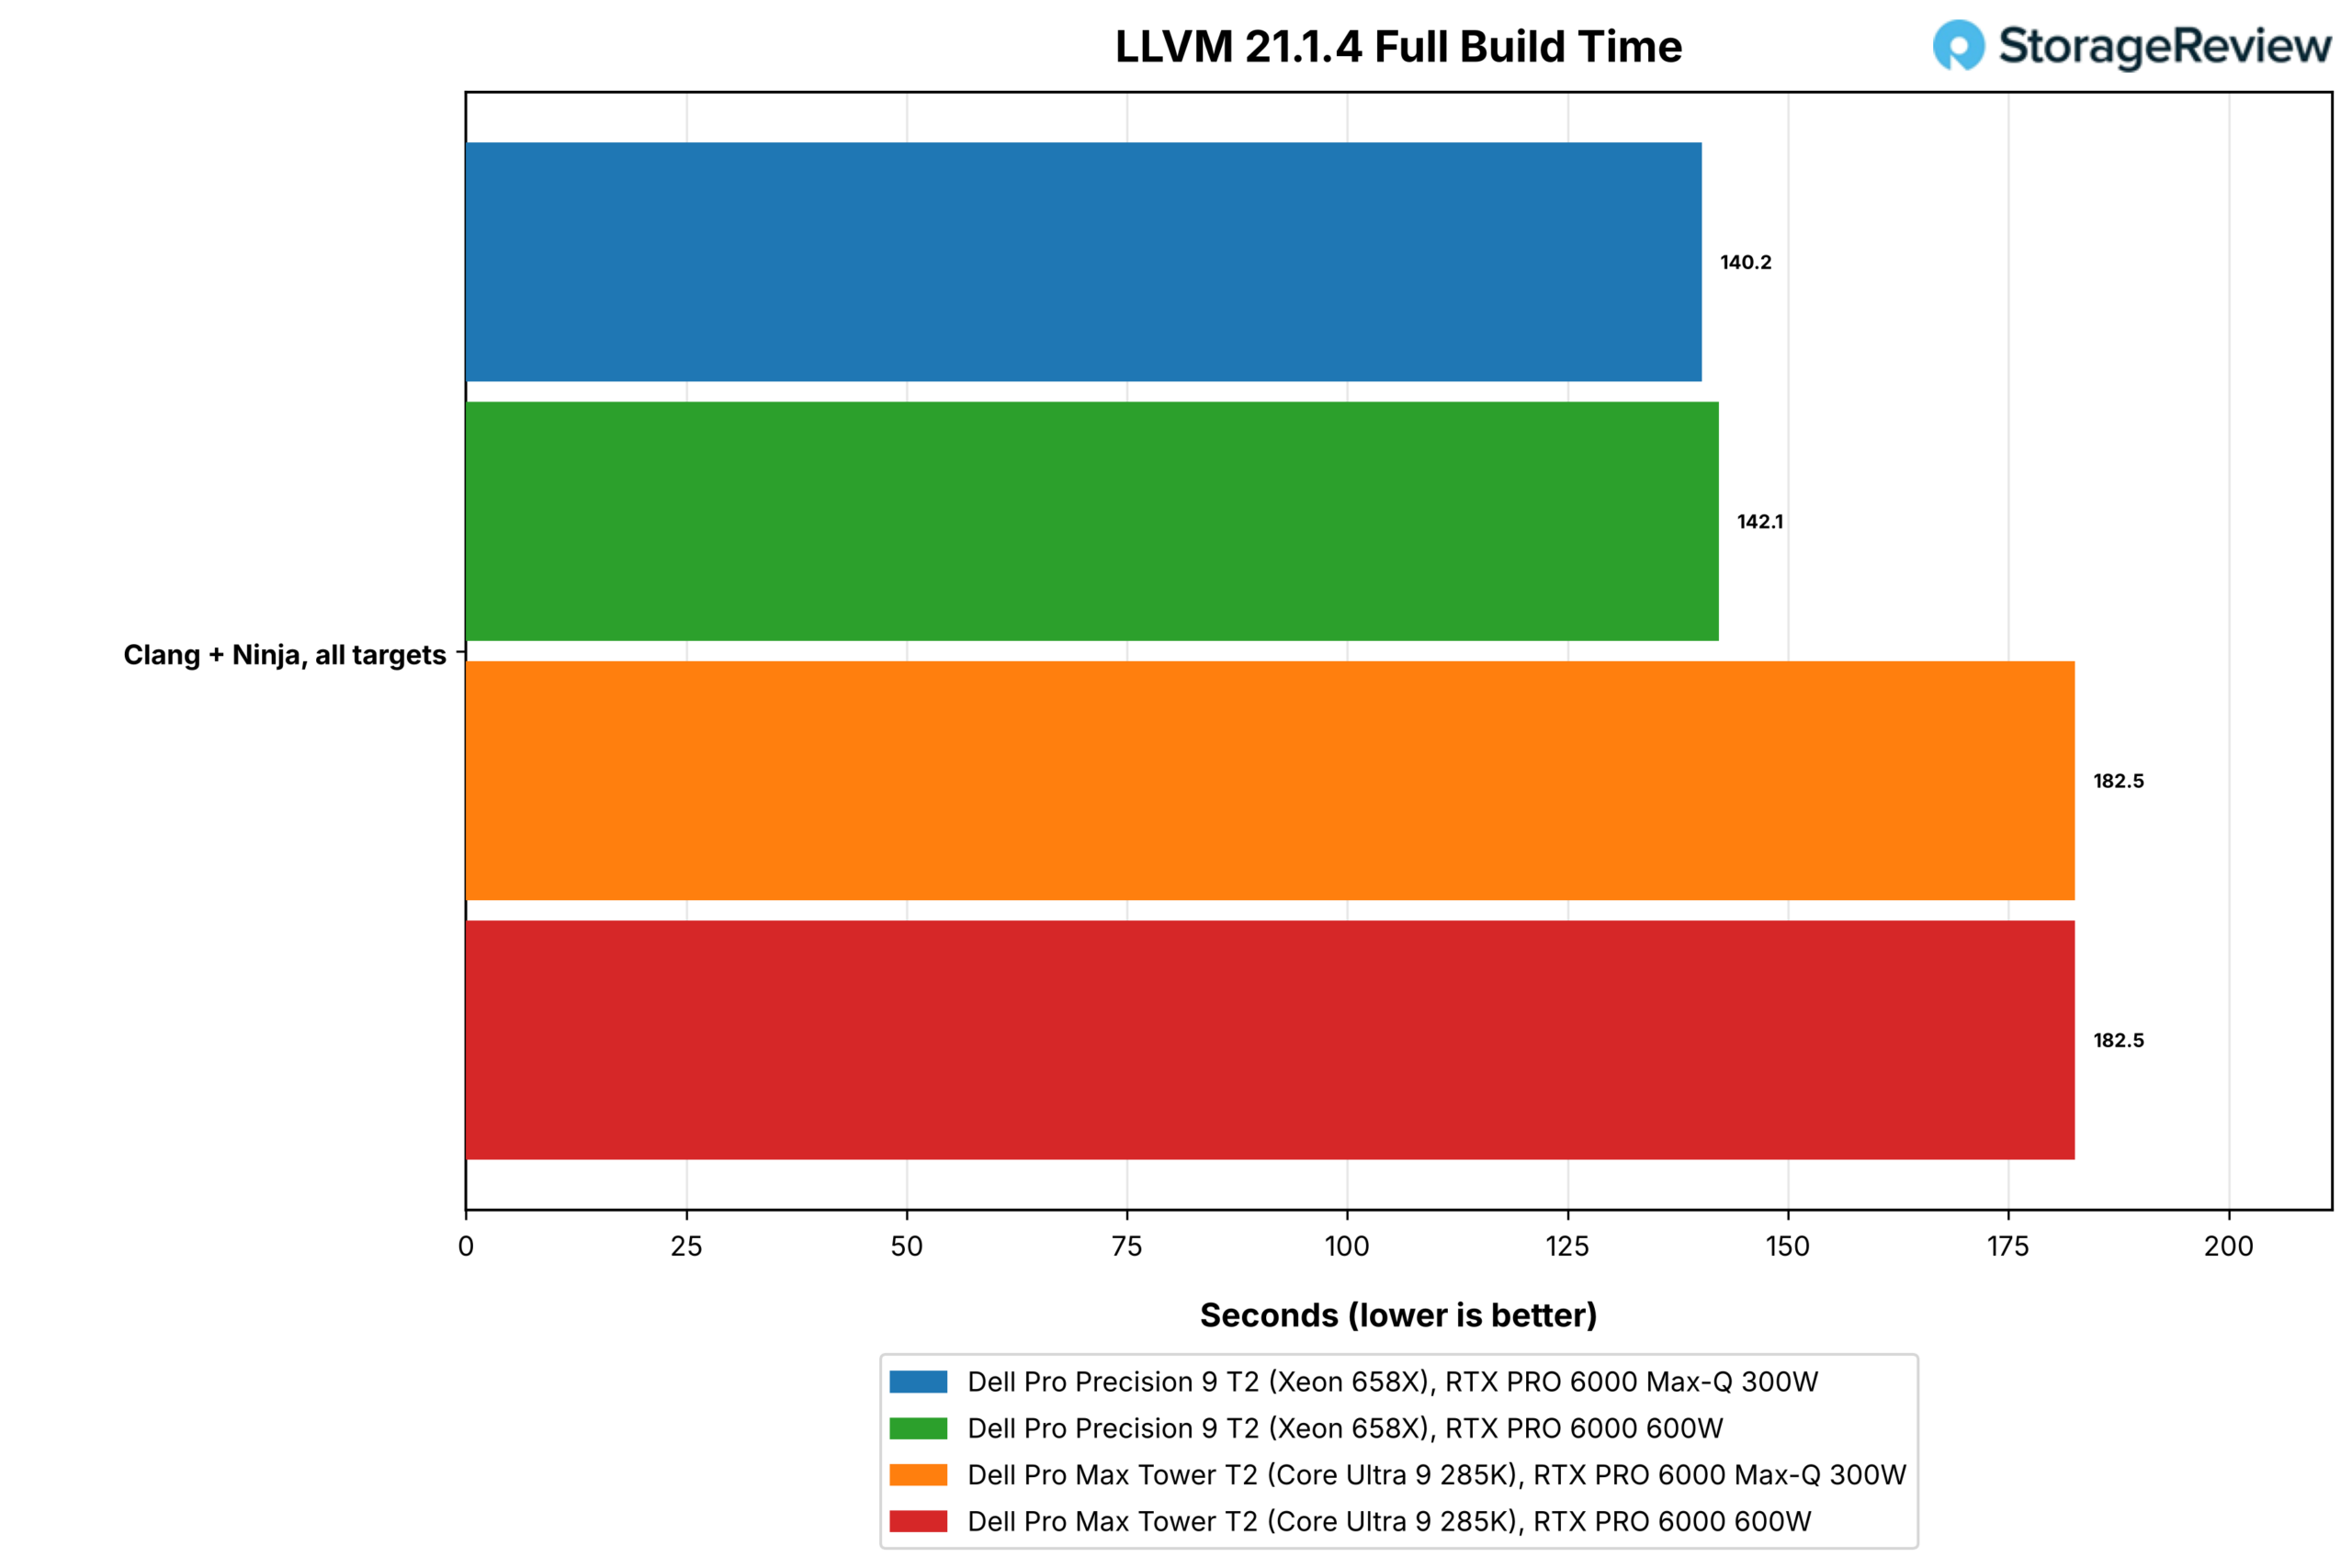
Blender 4.5는 CPU의 Cycles 렌더링 엔진을 사용하여 Monster, Junkshop, Classroom 장면을 렌더링합니다. HandBrake는 4K60 클립 60초 분량을 x265(HEVC, 중간 프리셋, 품질 22) 및 SVT-AV1(프리셋 8, 품질 30) 코덱으로 소프트웨어 인코딩합니다. LLVM 테스트는 Clang과 Ninja를 사용하여 LLVM 21.1.4 전체 트리를 컴파일하는 것으로, 테스트 스위트에서 가장 긴 모든 코어 부하를 수행합니다.

| Test | 프로 프리시전 9 T2, 맥스큐 300W | 프로 프리시전 9 T2, 600W | 프로 맥스 타워 T2, 맥스-Q 300W | 프로 맥스 타워 T2, 600W |
|---|---|---|---|---|
| Blender 4.5 Monster (샘플/분, 높을수록 좋음) | 366.2 | 339.0 | 259.6 | 257.7 |
| Blender 4.5 정크샵(샘플/분) | 238.1 | 228.0 | 166.2 | 166.8 |
| Blender 4.5 강의실용 (샘플/분) | 187.2 | 169.2 | 132.5 | 132.3 |
| HandBrake x265, 중간 설정, q22 (fps, 높을수록 좋음) | 46.9 | 46.1 | 47.0 | 47.2 |
| HandBrake SVT-AV1, 프리셋 8, q30(fps) | 64.0 | 65.0 | 117.5 | 118.6 |
| LLVM 21.1.4 빌드 (s, 숫자가 낮을수록 좋음) | 140.2 | 142.1 | 182.5 | 182.5 |
Xeon은 Monster 렌더링에서 분당 366.2개의 샘플을 기록하며 285K의 259.6개 샘플보다 41% 높은 성능을 보였고, 세 가지 장면 모두에서 2포인트 이내의 차이를 유지했습니다. 또한 LLVM 빌드 시간은 140.2초로 182.5초였던 285K보다 23% 단축되었습니다. 600W 카드를 장착했을 때 Xeon의 Blender 점수는 7~10% 하락했는데, 이는 CPU 제품군 전체에서 Xeon의 성능 저하 중 가장 큰 폭의 하락이었습니다.
HandBrake 테스트 결과는 인코더 종류에 따라 나뉘었습니다. x265 코덱을 중간 설정으로 테스트했을 때 Xeon 프로세서에서는 46.9fps, 285K 프로세서에서는 47.0fps로 동일한 결과를 보였고, SVT-AV1 코덱을 8번 설정으로 테스트했을 때는 Xeon 프로세서에서 64.0fps, 285K 프로세서에서 117.5fps를 기록했습니다.
우리는 그 차이를 파악하기 위해 오후 시간을 투자했고, 이는 스레드별 결과입니다. 이 사전 설정에서 인코더는 병렬 처리 수준 6까지 도달하며 Xeon에서 약 9개의 논리 프로세서에 해당하는 작업을 처리합니다. AVX-512 대신 AVX2 커널을 강제로 사용해도 결과는 동일했고(63.9fps에서 63.8fps로), 물리적 코어당 하나의 스레드로 고정했을 때도 2% 정도 느려졌습니다(62.6fps). 따라서 벡터 경로나 SMT 스케줄링은 원인이 아닙니다. 남은 것은 Xeon 코어 자체와 코어 간의 메시 네트워크인데, 파이프라인 방식의 인코더는 각 단계 간의 핸드오프를 기다릴 때 매 프레임마다 이러한 네트워크의 영향을 받습니다.
Stockfish, primesieve, Python 및 브라우저
Stockfish의 내장 벤치마크는 체스 검색 속도를 초당 수백만 개의 노드 단위로 보고합니다. primesieve는 모든 스레드에서 10^12 미만의 소수를, 하나의 스레드에서는 10^11 미만의 소수를 계산합니다. PyPerformance는 하나의 빠른 코어에 고정하여 세 가지 CPython 벤치마크(go, nbody, regex_compile)를 실행하고, Speedometer 3.1은 Microsoft Edge에서 웹 애플리케이션의 응답성을 측정합니다.
| Test | 프로 프리시전 9 T2, 맥스큐 300W | 프로 프리시전 9 T2, 600W | 프로 맥스 타워 T2, 맥스-Q 300W | 프로 맥스 타워 T2, 600W |
|---|---|---|---|---|
| 스톡피쉬 벤치, 모든 스레드(Mnps, 높을수록 좋음) | 40.87 | 39.17 | 30.10 | 30.63 |
| 스톡피쉬 벤치, 스레드 1개 (Mnps, 높을수록 좋음) | 1.65 | 1.60 | 1.99 | 1.99 |
| 소수체 1e12, 모든 스레드 (s, 값이 낮을수록 좋음) | 7.69 | 7.51 | 6.77 | 6.84 |
| 소수체 1e11, 스레드 1개 (s 값이 낮을수록 좋음) | 10.09 | 10.76 | 8.72 | 8.72 |
| PyPerformance go (ms, 낮을수록 좋음) | 91.4 | 91.0 | 64.8 | 64.9 |
| PyPerformance nbody (ms, 낮을수록 좋음) | 68.3 | 68.8 | 54.3 | 53.8 |
| PyPerformance regex_compile (ms, 낮을수록 좋음) | 88.6 | 90.5 | 61.1 | 61.2 |
| Speedometer 3.1, Edge (점수, 높을수록 좋음) | 36.8 | 37.3 | 46.3 | 46.5 |
Stockfish는 48개 스레드에서 Xeon이 40.87 Mnps, 285K가 30.10 Mnps를 기록했고, 단일 스레드에서는 285K가 1.99로 1.65를 기록했습니다. Primesieve는 모든 스레드를 사용하는 유일한 테스트로, 285K가 6.77초로 7.69초를 기록했는데, 이는 Primesieve의 시프트가 캐시에 적합하고 클럭 속도와 코어 수 모두에 비례하여 확장되기 때문입니다. 단일 스레드 테스트에서는 285K가 13~31% 더 빠른 성능을 보였습니다. PyPerformance는 64.8ms 대 91.4ms, regex_compile은 61.1ms 대 88.6ms, Speedometer는 46.3ms 대 36.8ms를 기록했습니다.
브라우저 응답 속도는 구매자가 책상에서 체감하는 속도입니다. Speedometer 점수 36.8은 절대적인 속도 면에서는 여전히 빠르지만, 동일한 섀시의 Core 타워보다 1/5 정도 느립니다. 따라서 처리량을 중시하여 Xeon을 선택하는 사용자라면 해당 시스템의 대화형 작업 속도가 Core Ultra 데스크톱보다 한 단계 느릴 것이라는 점을 예상해야 합니다.
GROMACS, OpenBLAS 및 메모리
GROMACS는 benchMEM 분자 동역학 사례를 16개 코어에서 4가지 랭크-스레드 레이아웃으로 실행하고 최적의 레이아웃에 대한 하루 시뮬레이션 시간을 나노초 단위로 보고합니다. OpenBLAS 테스트는 모든 코어에서 3가지 문제 크기에 대한 HPL 스타일의 배정밀도 LU 해석과 DGEMM 행렬 곱셈을 실행하고, 285K 프로세서에서는 8개의 P-코어만을 사용하여 다시 실행합니다. Xeon의 24개 코어는 하나의 클래스로 간주되므로 해당 행은 적용되지 않습니다. STREAM은 지속적인 메모리 대역폭을 측정하고, 지연 시간 행은 단일 메모리 접근 및 코어 간 접근을 측정합니다.

| 테스트 결과 (높을수록 좋음) | 프로 프리시전 9 T2, 맥스큐 300W | 프로 프리시전 9 T2, 600W | 프로 맥스 타워 T2, 맥스-Q 300W | 프로 맥스 타워 T2, 600W |
|---|---|---|---|---|
| GROMACS benchMEM, 최적 레이아웃(ns/day) | 47.39 | 47.91 | 37.30 | 37.07 |
| OpenBLAS LU N=10000, 모든 코어(GFLOPS) | 570.3 | 517.3 | 519.7 | 523.1 |
| OpenBLAS LU N=20000, 모든 코어(GFLOPS) | 1,208.6 | 1,100.6 | 633.2 | 631.8 |
| OpenBLAS LU N=40000, 모든 코어(GFLOPS) | 1,659.2 | 1,613.7 | 667.9 | 669.5 |
| OpenBLAS LU N=20000, P-코어만 사용 (GFLOPS) | 해당 사항 없음 (필수 과목 1개) | 해당 사항 없음 (필수 과목 1개) | 515.2 | 517.7 |
| OpenBLAS DGEMM M=8000, 모든 코어(GFLOPS) | 1,637.8 | 1,750.9 | 768.2 | 767.6 |
| OpenBLAS DGEMM M=8000, P-코어 전용 (GFLOPS) | 해당 사항 없음 (필수 과목 1개) | 해당 사항 없음 (필수 과목 1개) | 565.3 | 566.5 |
AVX-512, 144MB의 L3 메모리, 그리고 4채널의 DDR5-6400 메모리가 결합된 결과입니다. DGEMM 테스트에서 Xeon은 1,638 GFLOPS를 기록한 반면, 285K는 768 GFLOPS에 그쳤습니다. 11.9GB의 데이터를 메모리를 통해 스트리밍하는 N=40000 LU 솔브 테스트에서는 Xeon이 1,659 GFLOPS, 285K가 668 GFLOPS를 기록하며 Core Tower의 2.5배 성능을 보였습니다. 285K는 N=20000에서 N=40000으로 넘어갈 때 대역폭 한계에 도달하여 성능 변화가 미미한 반면, Xeon은 지속적으로 확장되는 성능을 보여주었습니다. 16코어에서 수행된 GROMACS 테스트에서는 Xeon이 47.39 ns/day로 27% 더 우수한 성능을 나타냈습니다.

| Test | 프로 프리시전 9 T2, 맥스큐 300W | 프로 프리시전 9 T2, 600W | 프로 맥스 타워 T2, 맥스-Q 300W | 프로 맥스 타워 T2, 600W |
|---|---|---|---|---|
| 스트림 복사 속도(MB/s, 높을수록 좋음) | 106,698 | 106,512 | 39,477 | 39,426 |
| 스트림 규모(MB/s) | 105,368 | 105,180 | 39,788 | 39,801 |
| 스트림 추가(MB/s) | 119,520 | 119,332 | 36,324 | 36,306 |
| 스트림 트라이어드(MB/s) | 122,233 | 122,135 | 33,003 | 33,014 |
| 메모리 지연 시간, 1GiB 버퍼, 4KiB 페이지 (ns, 낮을수록 좋음) | 148.3 | 147.8 | 135.2 | 135.4 |
| 코어 간 지연 시간, 모든 쌍의 평균값(ns, 낮을수록 좋음) | 56.2 | 56.0 | 38.1 | 38.2 |
| 코어 간 지연 시간, 최소 쌍(ns) | 4.6 | 4.6 | 18.6 | 18.6 |
| 코어 간 지연 시간, 최대 쌍(ns) | 65.7 | 66.8 | 44.7 | 44.5 |
STREAM Triad 테스트 결과, Xeon T2에서는 122,233MB/s, Core T2에서는 33,003MB/s의 대역폭을 기록했는데, 이는 DDR5-6400 RDIMM 4채널 사용 시 3.7배 높은 수치입니다. Core T2는 DIMM 메모리 용량이 부족하여 성능 향상이 더딘 플랫폼입니다. 하지만 메모리 도달 시간은 Xeon이 148.3ns, Core T2가 135.2ns로 더 길고, 코어 간 평균 도달 시간은 Xeon이 56.2ns, Core T2가 38.1ns입니다. Xeon의 최소 4.6ns는 한 코어에 있는 두 개의 SMT 메모리 간의 도달 시간이고, 최대 65.7ns는 메시 네트워크를 가로지르는 도달 시간입니다.
노름
SuperTuxKart 1.5는 내장 벤치마크를 1080p 전체 화면 해상도, 최고 설정(수동 동기화 해제)에서 실행하며, 평균 프레임률과 안정적인 프레임률을 보고합니다. 이 해상도에서는 GPU에 여유 공간이 충분하므로 결과는 CPU 성능을 따르며, 이 테스트는 동일한 방식으로 제한되는 많은 전문 뷰포트를 대표합니다. NVENC 인코딩 테스트는 이 시스템에서 완료되지 않아 결과에서 제외되었습니다.

| SuperTuxKart 1.5, 1080p 울트라 설정, Vsync 끔 (fps, 높을수록 좋음) | 프로 프리시전 9 T2, 맥스큐 300W | 프로 프리시전 9 T2, 600W | 프로 맥스 타워 T2, 맥스-Q 300W | 프로 맥스 타워 T2, 600W |
|---|---|---|---|---|
| 평균 | 304.6 | 323.2 | 359.1 | 383.5 |
| 일반적인 | 304 | 322 | 354 | 376 |
| 견실 한 | 161 | 174 | 122 | 135 |
Core T2 Max-Q 카드는 평균 359.1fps를 기록했고, Xeon T2는 304.6fps를 기록하며 단일 스레드 성능에서 다시 한번 격차를 보였습니다. 반면 Xeon 타워는 안정적인 프레임률 면에서 161fps를 기록하며 122fps를 기록한 Core T2 타워보다 우위를 점했고, 프레임 드롭 현상도 더 적었습니다. 600W 카드는 두 타워 모두에서 평균 프레임률을 약 6% 향상시켰습니다.
부하 상태의 시계
두 타워 모두 테스트 장비의 센서 경로를 통해 CPU 또는 GPU 온도를 보고하지 않았기 때문에, 일반적으로 공개하는 열 표 대신 각 테스트 동안의 평균 CPU 클럭을 제시합니다. 이 수치가 600W 그래픽 카드가 Xeon에 미치는 영향을 설명하는 지표입니다. Max-Q를 장착한 상태에서 658X는 30분간의 연속 테스트에서 4,269MHz를 유지했고, 짧은 시간 동안 모든 코어를 사용하는 테스트에서는 4,040~4,480MHz를 기록했습니다. 600W 카드를 장착한 경우에는 대부분의 테스트에서 클럭이 최대 300MHz까지 낮아졌고, 모든 테스트에서 점수도 더 낮았습니다.
| 테스트 중 평균 CPU 클럭 속도(MHz) | 프로 프리시전 9 T2, 맥스큐 300W | 프로 프리시전 9 T2, 600W | 프로 맥스 타워 T2, 맥스-Q 300W | 프로 맥스 타워 T2, 600W |
|---|---|---|---|---|
| Cinebench 2026 | 4,477 | 4,470 | 4,789 | 4,786 |
| 지속 루프 | 4,269 | 4,182 | 4,663 | 4,682 |
| 7 - 우편 번호 | 4,414 | 4,307 | 4,854 | 4,837 |
| 건어 | 4,291 | 3,995 | 4,749 | 4,741 |
| 믹서기 | 4,258 | 4,253 | 4,582 | 4,552 |
| 수동 브레이크 | 4,188 | 4,180 | 4,601 | 4,622 |
| LLVM 빌드 | 4,202 | 4,258 | 4,582 | 4,585 |
| GROMACS | 4,288 | 4,290 | 4,664 | 4,694 |
| 오픈블라스 | 4,039 | 3,979 | 4,766 | 4,761 |
| STREAM | 4,321 | 4,326 | 4,687 | 4,676 |
| 프라임시브 | 4,441 | 4,268 | 4,814 | 4,810 |
| MLPerf 클라이언트 | 4,191 | 4,138 | 3,814 | 3,686 |
| 코딩 에이전트 | 4,134 | 4,100 | 4,239 | 4,213 |
| LLM 과정 제공 | 4,261 | 4,169 | 4,229 | 4,209 |
| 이미지 생성 | 4,044 | 4,008 | 3,702 | 3,837 |
| RAG | 4,178 | 4,197 | 4,172 | 4,108 |
| 슈퍼턱스카트 | 4,239 | 4,211 | 4,637 | 4,649 |
Stockfish는 4,291MHz에서 3,995MHz로, Primesieve는 4,441MHz에서 4,268MHz로, 7-Zip은 4,414MHz에서 4,307MHz로, 그리고 지속 루프는 4,269MHz에서 4,182MHz로 클럭 속도가 떨어졌습니다. 반면 285K는 모든 코어 테스트에서 카드 종류와 관계없이 자체 클럭 속도에서 20MHz 이내의 차이를 보였습니다.
평균 클럭 속도만으로는 모든 것을 설명할 수 없습니다. Cinebench와 Blender는 Max-Q 버전과 평균 10MHz 이내의 차이를 보였음에도 불구하고 5~10%의 성능 저하를 나타냈는데, 이는 테스트별 평균값이 단기적인 변동을 상쇄한다는 것을 시사합니다. 658X는 최대 250W, 600W 버전은 600W의 전력을 소모하며, 두 카드 모두 전면 흡기구 하나 뒤에 있는 32리터 용량의 공간으로 배기됩니다. 성능 제한 요인이 프로세서의 열 관리 여유 공간인지 아니면 플랫폼의 전력 제한인지는 외부 전원 및 온도 로깅을 사용한 추가 테스트를 통해 확인할 수 있을 것입니다. 현재로서는 모든 코어를 사용하는 CPU 작업을 하는 사용자는 Max-Q 구성이 CPU 성능 면에서 더 빠르다는 점을 알아두어야 합니다.
스토리지 성능
저희 스토리지 테스트는 fio의 네 가지 핵심 기능을 부팅 드라이브에 대해 5GB 및 25GB 용량으로 실행하고, 파일 시스템 상태와 원시 장치 상태 모두에서 다시 한번 테스트하며, 여기서는 25GB 테스트 결과를 보고합니다. Core T2의 부팅 드라이브는 Gen5 x4 구성의 2TB SK hynix PCB01 단일 드라이브이고, Pro Precision 9 T2는 FlexBay에 장착된 두 개의 E3.S Gen5 드라이브가 Graid Technology의 VROC 기술로 4,097GB RAID0 볼륨으로 구성되어 있습니다. 네 가지 구성 모두에서 BitLocker는 비활성화되어 있으므로 파일 시스템 행은 암호화가 아닌 NTFS 및 RAID 계층을 측정합니다.


| fio, 25GB 용량, QD32 | 프로 프리시전 9 T2, 맥스큐 300W | 프로 프리시전 9 T2, 600W | 프로 맥스 타워 T2, 맥스-Q 300W | 프로 맥스 타워 T2, 600W |
|---|---|---|---|---|
| 순차 읽기 128K, 파일 시스템(MB/s) | 9,332 | 9,255 | 11,377 | 11,406 |
| 순차 읽기 128K, 원시 장치(MB/s) | 10,782 | 10,675 | 11,186 | 11,444 |
| 순차 쓰기 속도 128K(MB/s) | 6,507 | 6,496 | 7,401 | 7,371 |
| 1MB 사전 채우기 읽기, QD32(MB/s) | 4,617 | 4,679 | 6,440 | 6,346 |
| 4K 랜덤 읽기, 파일 시스템, 최대 IOPS(초당 입출력 횟수) | 840,075 | 853,615 | 1,778,576 | 1,756,968 |
| 랜덤 읽기 4K, 원시 장치, 최대(IOPS) | 1,107,862 | 1,120,737 | 2,297,681 | 2,294,800 |
| 랜덤 쓰기 4K, 최대 (IOPS) | 557,512 | 550,505 | 957,461 | 921,774 |
| 원시/파일 시스템 임의 읽기 | SR 1.32x | SR 1.31x | SR 1.29x | SR 1.31x |
| 랜덤 읽기 4K, 4개 작업, p99 지연 시간(미국 기준, 낮을수록 좋음) | 506 | 485 | 183 | 185 |
| 랜덤 읽기 4K, 16개 작업, p99.99 지연 시간(미국 기준, 낮을수록 좋음) | 15,270 | 23,462 | 676 | 676 |
| 랜덤 쓰기 4K, 4개 작업, p99 지연 시간(미국 기준, 낮을수록 좋음) | 610 | 594 | 228 | 228 |
| 구동 온도, 최대 (섭씨) | 해당 없음 (RAID 구성 뒤) | 해당 없음 (RAID 구성 뒤) | 50 | 57 |
스트라이프 구성은 단일 드라이브보다 빠르지 않으며, 작은 블록 처리에서는 훨씬 뒤쳐집니다. 두 개의 E3.S 드라이브는 NTFS를 통해 순차적으로 9,332MB/s, 원시 볼륨에서는 10,782MB/s를 읽었는데, PCB01의 경우 각각 11,377MB/s와 11,186MB/s였습니다. 쓰기 속도는 6,507MB/s로, PCB01의 7,401MB/s와 비교됩니다. 4K 랜덤 읽기에서 이 볼륨은 파일 시스템을 통해 최대 840.1K IOPS, 원시 볼륨에서는 1.11M IOPS를 기록했는데, 단일 드라이브의 경우 각각 1.78M과 2.30M이었습니다. 랜덤 쓰기 속도는 557.5K IOPS로, 단일 드라이브의 957.5K IOPS와 비교됩니다. 원시 볼륨과 파일 시스템의 비율은 두 경우 모두 약 1.3배이므로 NTFS 처리 비용은 동일합니다. 차이점은 두 경로 아래에 있는 VROC 레이어에 있습니다.
테일 레이턴시는 다음과 같습니다. 16개 작업에서 가장 느린 0.01%의 임의 읽기 시간은 볼륨에서 15.3ms, 단일 드라이브에서 0.68ms였습니다. 또한 4개 작업의 p99 읽기 레이턴시는 506us, 단일 드라이브에서는 183us였습니다. 두 개의 NVMe 장치에 걸친 소프트웨어 RAID는 모든 I/O에 CPU 홉을 추가하며, fio CPU 측정값에서 이를 확인할 수 있습니다. 순차 패스에서 CPU 사용률은 80%로 Core T2의 40%보다 높았습니다. 또한 볼륨은 드라이브의 SMART 데이터를 숨기므로 테스트 도구에서 드라이브 온도를 기록할 수 없었습니다.
그렇다고 FlexBay가 잘못된 선택이라는 뜻은 아닙니다. FlexBay는 T2에 전면에서 정비가 가능하고 핫플러그 방식의 드라이브를 제공하며, M.2로는 구현할 수 없는 용량까지 확장 가능한 폼팩터를 갖추고 있습니다. 또한 두 개의 드라이브로 4TB 부팅 볼륨을 구성하는 것도 편리합니다. 다만, 워크로드가 소량의 임의 I/O 작업, 로컬 데이터베이스 또는 캐시가 많이 사용되는 모델 디렉터리인 경우 스트라이프가 없는 단일 E3.S 드라이브나 내부 M.2 슬롯을 고려해야 합니다. Core T2의 내부 M.2 슬롯 성능은 이 섀시에서 Gen5 드라이브 하나의 성능과 유사합니다.
맺음말
델 프로 프리시전 9 T2는 워크스테이션 프로세서가 탑재된 프로 맥스 타워 T2 모델이며, 리뷰 데이터에 따르면 구매자들이 기대하는 바로 그 성능을 제공합니다. 동일한 32리터 섀시에 탑재된 제온 658X는 시네벤치 멀티코어 처리량을 39% 향상시키고, 메모리 대역폭은 3.7배, DGEMM 속도는 두 배로 높였습니다. 또한 24코어 48스레드 프로세서로 AVX-512, AMX, 레지스터드 ECC 메모리, 그리고 최대 1TB까지 확장 가능한 메모리 경로를 제공합니다. 프라임시브부터 파이썬까지 다양한 단일 스레드 작업에서 13~31%의 성능 향상을 보여주며, 뷰포트나 터미널에서 많은 시간을 보내는 사용자라면 이러한 성능 차이를 확실히 체감할 수 있을 것입니다.
이 리뷰는 구매자들이 GPU 선택에 대한 이해를 돕기 위해 작성되었습니다. Max-Q와 600W RTX PRO 6000 카드는 96GB의 메모리를 공유하며 디코딩 성능은 7~20% 정도 차이가 나지만, 600W 카드는 빠른 처리 속도에서 그 성능을 입증합니다. 첫 번째 토큰 표시 시간이 3분의 1 이상 단축되고, 이미지 로딩 속도가 20~34% 빨라집니다.
Xeon 타워에서 600W 그래픽 카드는 모든 코어를 사용하는 작업 시 프로세서 성능을 4~5% 정도 저하시키며, 바로 옆 슬롯을 차지하기 때문에 저희 테스트 환경에서는 25GbE 어댑터를 제거해야 했습니다. CPU 렌더링 및 시뮬레이션, 로컬 모델링 작업을 주로 하는 사용자라면 Dell에서 기본으로 제공하는 Max-Q 그래픽 카드가 적절한 선택입니다. 하지만 팀에 모델을 제공하거나 하루 종일 이미지 렌더링 작업을 하는 사용자라면 600W 그래픽 카드를 위해 슬롯을 확보하고 1500W 파워 서플라이를 사용하는 것이 더 효율적일 수 있습니다.
FlexBay에 탑재된 E3.S는 우리가 오랫동안 타워형 PC에서 원해왔던 폼팩터이며, Graid Technology의 VROC는 RAID 스택에 적합한 신뢰할 수 있는 조합입니다. 다만, Core T2에 탑재된 단일 M.2 드라이브보다 작은 크기의 임의 I/O 작업 속도는 약 절반 정도 느리며, 4K 읽기/쓰기 속도도 절반 수준입니다. RAID 부팅 볼륨이 필요하지 않은 사용자라면 E3.S 드라이브 하나만 사용하거나 내장 M.2 슬롯을 활용하는 방안을 고려해 볼 수 있습니다.
반면, E3.S SSD가 이제 60TB를 넘어서면서, 극단적인 데이터 사용량을 가진 사용자들은 이전에는 외장 케이스를 사용하거나 공유 스토리지 볼륨을 마운트해야만 가능했던, 플래시 메모리 가격이 실질적인 한계였던 상황에서 완전히 새로운 세계를 접하게 되었습니다.
델 공식 웹사이트(Dell.com)에서 구성 기준으로 약 28,300달러에 판매되는 Pro Precision 9 T2는 대부분의 기업 구매자가 적용받는 대량 구매 할인 전 가격으로, 현재 동일한 사양으로 구성된 Pro Max Tower T2보다 약 4,500달러 더 비쌉니다. 동일한 사양으로 구성된 Pro Max Tower T2는 285K CPU, 128GB DDR5-4400 ECC 메모리, RTX PRO 6000 그래픽 카드, 2TB Gen5 하드 드라이브, 그리고 1500W 파워 서플라이를 포함하여 약 23,800달러이며, 두 제품의 GPU 및 메모리 옵션 가격 차이는 900달러 이내입니다. 두 번째 FlexBay 드라이브는 1,700달러이며, 나머지는 Xeon 플랫폼의 가격 차이입니다.
이 제품은 데스크톱과 동일한 크기를 유지하면서 모든 코어에 부하가 걸리면 소형 서버처럼 작동하는 단일 소켓 타워형 PC이며, 바로 이러한 이유로 Precision이라는 이름이 다시 등장하게 된 것입니다.
순위표: 델 프로 프리시전 9 T2는 최고의 데스크톱 워크스테이션 순위표에서 종합 1위를 차지했으며, RTX PRO 6000 성능은 최고의 엔터프라이즈 GPU 순위표에도 이름을 올렸습니다.



 아마존