

8월에 NVIDIA는 최고 사양의 Blackwell 데스크톱 제품군을 전문가용 워크스테이션과 서버 두 가지 트랙으로 나눴습니다. RTX PRO 6000 워크스테이션 카드는 타워 또는 데스크톱 섀시 내에서 최대의 컴퓨팅 성능과 VRAM을 필요로 하는 크리에이터, 엔지니어, AI 개발자를 위해 설계되었습니다. RTX PRO 6000 Blackwell Server Edition은 데이터 센터의 랙 서버와 헤드리스 추론 또는 렌더링 노드에 적합하도록 설계되었습니다. 이제 워크스테이션 카드를 벤치에 올렸으니, 이 리뷰에서는 워크스테이션 카드에 집중해 보겠습니다.
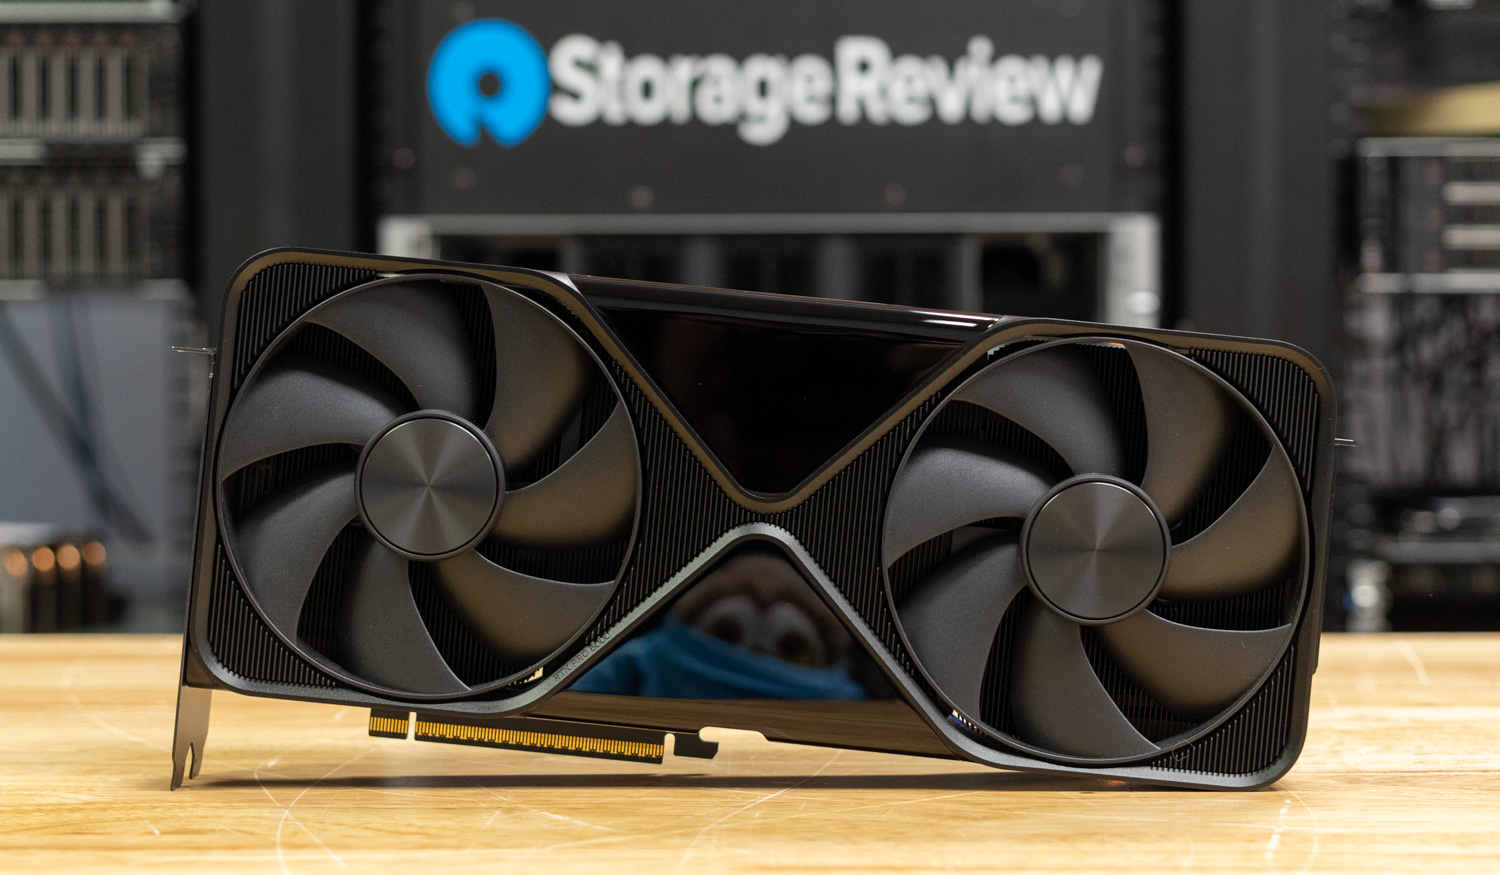
8,500달러의 RTX PRO 6000은 24,064개의 CUDA 코어, 752개의 5세대 텐서 코어, 188개의 4세대 RT 코어, 그리고 96GB GDDR7 ECC를 탑재한 풀사이즈 GB202 그래픽 카드를 선보입니다. 그 매력은 바로 드러납니다. 일반 소비자용 그래픽 카드가 따라올 수 없는 메모리 용량, 프로 드라이버, 그리고 특별한 전력이나 공기 흐름 요구 사항 없이도 실제 워크스테이션에 적합한 듀얼 슬롯 폼팩터를 제공합니다.
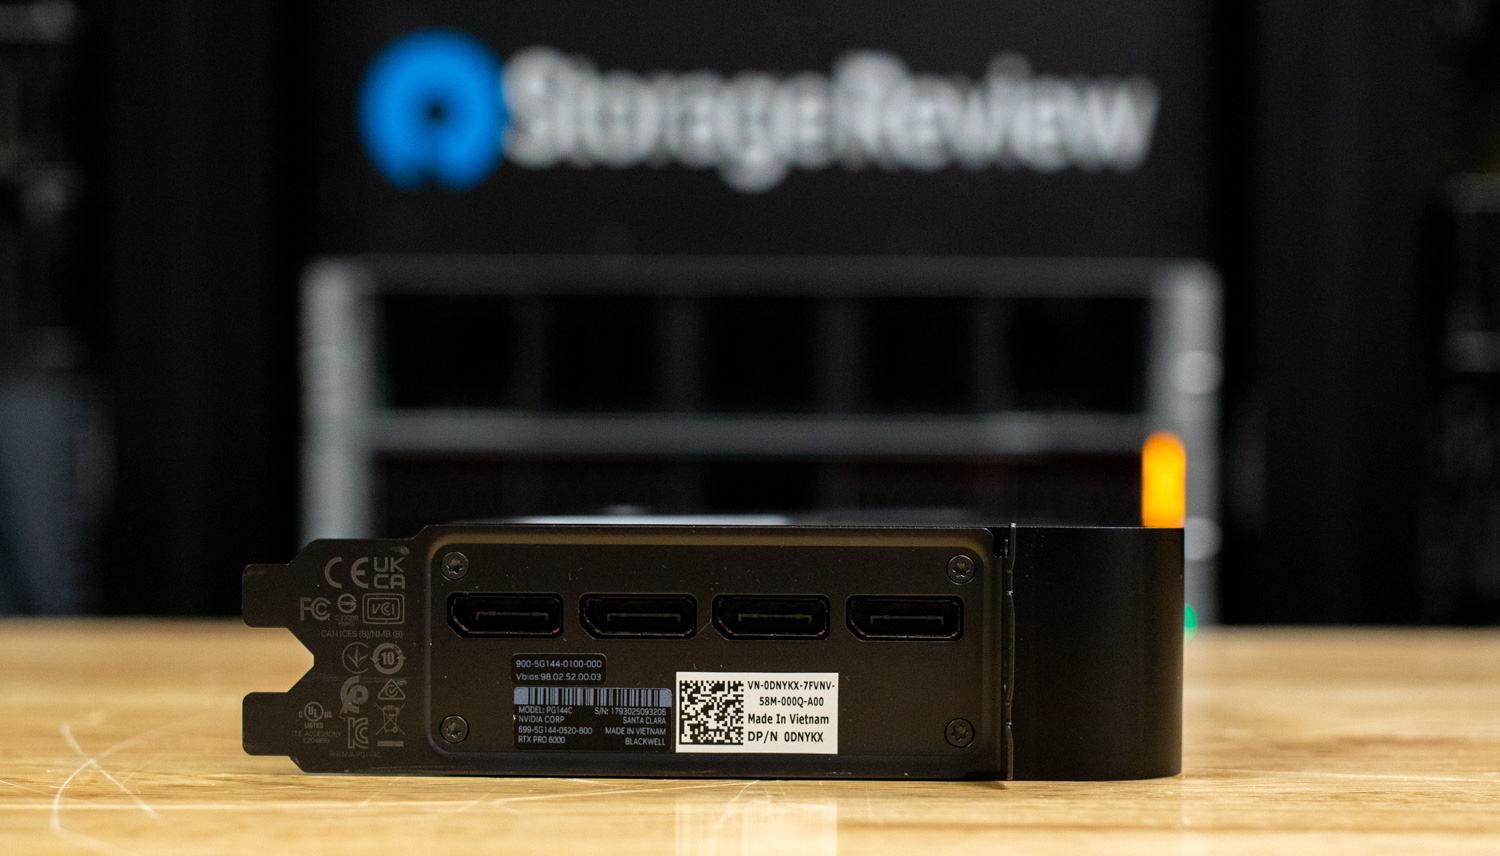
NVIDIA는 이 GPU를 혼합된 워크플로우에 적합하도록 설계했습니다. 여기에는 긴 컨텍스트를 사용한 로컬 LLM 추론, 대규모 장면 렌더링, 복잡한 시뮬레이션, 그리고 다중 GPU 연구 장비가 포함됩니다. 실용적인 측면이 중요합니다. 이 카드는 표준 PCIe 5.0 x16 인터페이스를 사용하고, 고해상도 및 고주사율 시각화를 위한 4개의 DisplayPort 2.1b 출력을 제공하며, 600W의 구성 가능한 TDP를 제공하여 개발자가 최적의 열, 음향 또는 밀도를 조정할 수 있도록 합니다.
우리의 목표는 이 워크스테이션 버전이 AI, 렌더링, 일반 컴퓨팅 전반에 걸쳐 실험실에서 어떤 성능을 보이는지 평가하고, 96GB 풀이 단일 데스크톱 노드의 성능에 미치는 영향을 정량화하는 것입니다.
NVIDIA RTX PRO 6000 워크스테이션 vs. 서버 에디션
RTX PRO 6000 모델은 동일한 Blackwell GB202 기반에서 시작하므로, 기본적인 연산 기능은 사양상으로는 비슷해 보입니다. 하지만 차이점은 두 모델의 사용 방식과 위치에 있습니다. 테스트 중인 워크스테이션 카드는 4개의 DisplayPort 2.1b 출력과 스튜디오급 드라이버를 갖춘 독립형 액티브 냉각 듀얼 슬롯 보드입니다. 타워형 또는 데스크사이드 워크스테이션에 장착하여 로컬 패널을 구동하고, CUDA, TensorRT, cuDNN과 함께 ISV 인증 DCC 및 CAD 앱을 실행합니다. 워크플로우에 대화형 뷰포트 작업, 로컬 시각화, 그리고 온박스 AI가 혼합되어 있다면, 이 방법을 사용하면 모든 것을 하나의 섀시에 통합하여 예측 가능한 소음 및 발열을 구현할 수 있습니다.
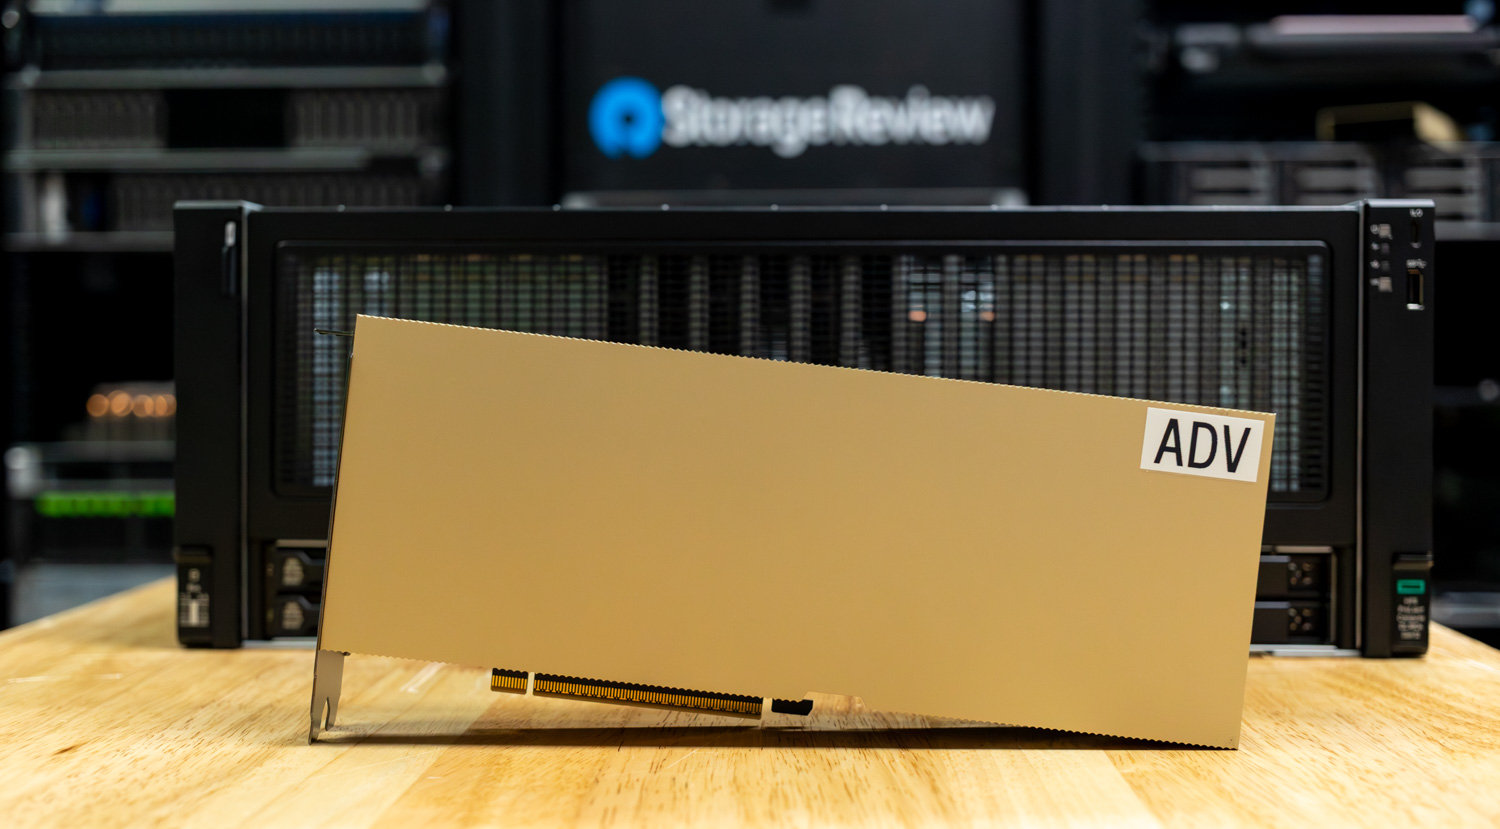
RTX PRO 6000 Blackwell 서버 에디션은 완전히 다른 용도로 설계되었습니다. 헤드리스 방식의 랙 우선 구성으로 서버 환경에 최적화되어 있으며, 전면에서 후면으로 공기가 흐르고 원격 관리 기능을 제공합니다. 작업은 네트워크를 통해 예약되고 결과는 원격으로 처리되므로 활성 디스플레이 출력은 없습니다. 펌웨어, 전력 및 열 프로파일은 스케줄러를 통해 24시간 7일 가동되도록 최적화되어 있으며, 일반적으로 NVIDIA AI Enterprise, 컨테이너 오케스트레이션 및 하이퍼바이저 패스스루와 함께 사용됩니다. 간단히 말해, 크리에이터와 엔지니어가 대규모 추론 또는 시뮬레이션 배치 작업을 실행하면서 동시에 로컬에서 작업을 확인하고 수정해야 할 때 워크스테이션 모델이 적합합니다. 서버 에디션은 데이터 센터에서 동일한 노드를 여러 대 설치하여 확장해야 하는 경우, 모든 전력 소비, 케이블 및 공기 흐름 경로가 OEM 서비스 계획에 맞춰야 할 때 더 적합합니다.
NVIDIA RTX PRO 6000 사양
아래 표는 NVIDIA RTX PRO 6000의 사양을 RTX 5090 및 이전 세대인 Ada Lovelace RTX 4090과 비교한 것입니다.
| GPU 비교 | 엔비디아 RTX 프로 6000 | 엔비디아 RTX 5090 | 엔비디아 RTX 4090 |
| GPU 이름 | GB202 | GB202 | AD102 |
| 아키텍처 | 블랙웰 2.0 | 블랙웰 2.0 | 에이다 러브 레이스 |
| 프로세스 크기 | 5 nm의 | 5 nm의 | 5 nm의 |
| 트랜지스터 | 92,200 만 | 92,200 만 | 76,300 만 |
| 밀도 | 122.9M / mm² | 122.9M / mm² | 125.3M / mm² |
| 다이 크기 | 750 mm² | 750 mm² | 609 mm² |
| 슬롯 너비 | 듀얼 슬롯 | 듀얼 슬롯 | 트리플 슬롯 |
| 크기 | 304 mm X 137 mm X 40 mm | 304 mm X 137 mm X 48 mm | 304 mm X 137 mm X 61 mm |
| TDP | 600W | 575W | 450W |
| 출력 | 4x 디스플레이포트 2.1b | 1x HDMI 2.1b, 3x 디스플레이포트 2.1b | 1x HDMI 2.1, 3x 디스플레이포트 1.4a |
| 전원 커넥터 | 1x 16- 핀 | 1x 16- 핀 | 1x 16- 핀 |
| 버스 인터페이스 | PCIe 5.0 x16 | PCIe 5.0 x16 | PCIe 4.0 x16 |
| 기본 시계 | 1590 MHz | 2017 MHz | 2235 MHz |
| 부스트 클럭 | 2617 MHz | 2407 MHz | 2520 MHz |
| 메모리 클럭 | 1750MHz (28Gbps 유효) | 2209MHz (28Gbps 유효) | 1313MHz (21Gbps 유효) |
| 메모리 크기 | 96 GB | 32 GB | 24 GB |
| 메모리 유형 | GDDR7 ECC | GDDR7 | GDDR6X |
| 메모리 버스 | 512 비트 | 512 비트 | 384 비트 |
| 메모리 대역폭 | 1.79 TB / 초 | 1.79 TB / 초 | 1.01 TB / 초 |
| 쿠다 코어 | 24,064 | 21,760 | 16,384 |
| 텐서 코어 | 752 | 680 | 512 |
| ROPs | 192 | 192 | 176 |
| SM 카운트 | 188 | 170 | 128 |
| RT 코어 | 188 | 170 | 128 |
| L1 캐시 | 128KB(SM당) | 128KB(SM당) | 128KB(SM당) |
| L2 캐시 | 128 MB | 88 MB | 72 MB |
| 픽셀 비율 | 502.5G픽셀/초 | 462.1G픽셀/초 | 443.5G픽셀/초 |
| 질감 비율 | 1,968.0 GTexel/초 | 1,637 GTexel/초 | 1,290 GTexel/초 |
| FP16(하프) | 126.0 TFLOPS(1:1) | 104.8 TFLOPS(1:1) | 82.58 TFLOPS(1:1) |
| FP32(플로트) | 126.0 TFLOPS | 104.8 TFLOPS | 82.58 TFLOPS |
| FP64(더블) | 1.968 TFLOPS(1:64) | 1.637 TFLOPS(1:64) | 1,290GFLOPS(1:64) |
| 출시 가격 (USD) | $8,500 | $1,999 | $1,599 |
빌드 및 디자인
RTX PRO 6000 워크스테이션 GPU는 RTX 5090 FE에서 볼 수 있었던 NVIDIA의 깔끔하고 기능적인 디자인을 계승하여 산업용 무광 블랙 마감과 워크스테이션 환경에 최적화된 이중 축 팬 레이아웃을 적용했습니다. 각 팬은 전체 길이의 3D 증기 챔버를 통해 공기 흐름을 원활하게 하여 지속적인 작업 부하에서도 열 평형을 유지하도록 설계되었습니다. 304mm x 137mm x 40mm 크기의 이 제품은 듀얼 슬롯 구성에 적합하며, 600W TDP 정격을 고려했을 때 탁월한 성능 밀도를 제공합니다.
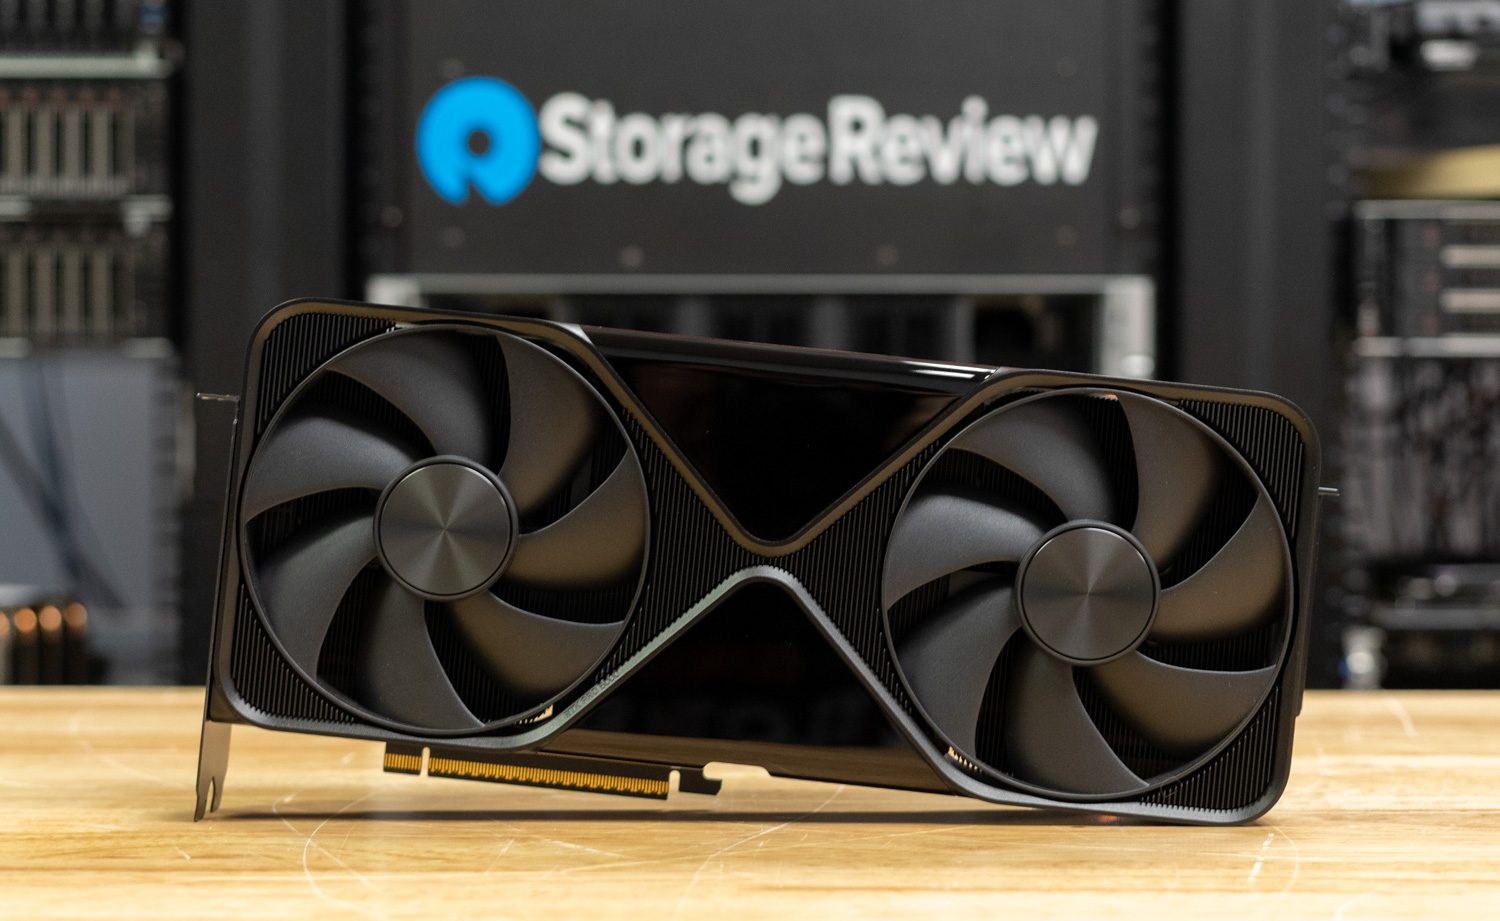
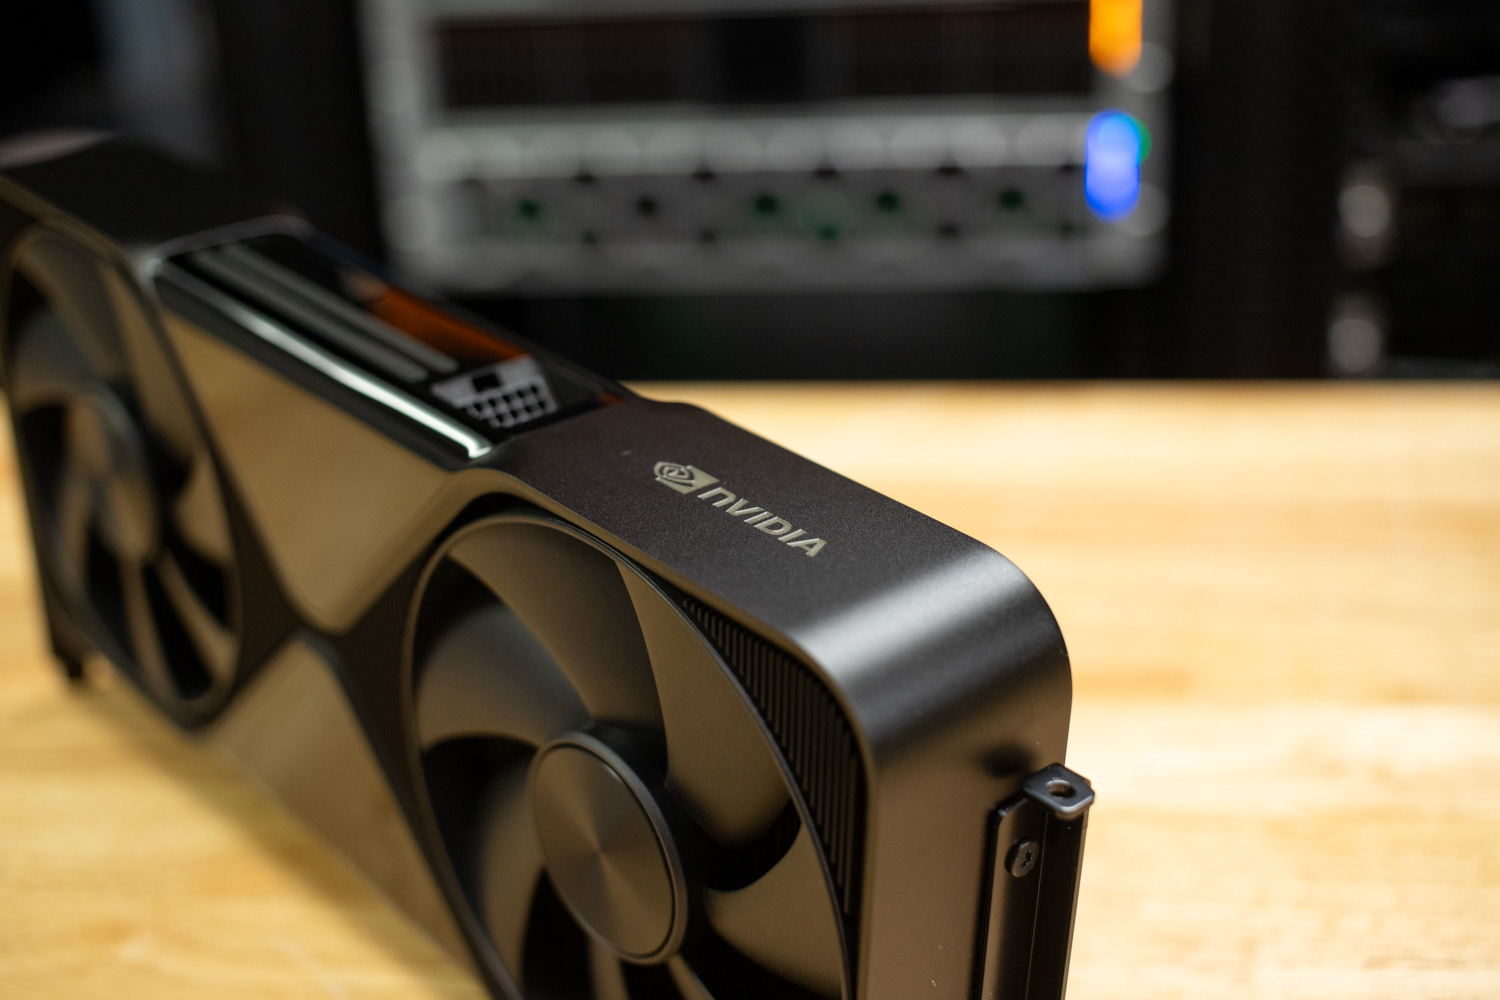
PRO 6000은 상단 가장자리에 16핀 전원 커넥터 하나를 갖추고 있어 96GB GDDR7 메모리와 완전한 Blackwell 2.0 아키텍처를 지원하는 데 필요한 전류를 공급합니다. 알루미늄 덮개는 핀 스택을 따라 공기를 효율적으로 흐르게 하여 고급스럽고 견고한 느낌을 줍니다. NVIDIA의 은은한 브랜딩은 RGB나 게이밍 장식 없이 전문적인 미학을 완성하며, 열 관리가 까다로운 워크스테이션 섀시에서도 뛰어난 안정성과 성능을 강조합니다.
I/O 측면에서 NVIDIA는 4개의 DisplayPort 2.1b 출력을 제공하여 멀티 모니터 8K 설정, 정확한 색상 HDR 워크플로우 및 고급 렌더링 환경과의 호환성을 보장합니다. HDMI를 통한 DisplayPort 2.1b 사용은 고해상도 및 고주사율 디스플레이를 위한 향상된 대역폭을 제공하는 NVIDIA의 전문적인 지향성을 반영합니다.
성능 시험
NVIDIA RTX PRO 6000 샘플의 성능을 평가하기 위해 NVIDIA의 주력 소비자용 제품인 RTX 5090 Founders Edition 및 RTX 4090 Founders Edition과 직접 비교했습니다. 테스트는 전문가용 워크로드와 AI 기반 워크로드를 혼합하여 진행하여 원시 컴퓨팅 성능과 실제 애플리케이션 성능을 모두 강조했습니다. 벤치마크에는 UL Procyon AI 텍스트 생성, UL Procyon AI 이미지 생성, LuxMark, Geekbench 6, V-Ray가 포함되어 렌더링, 추론 및 생산성 성능에 대한 균형 잡힌 개요를 제공합니다.
이러한 표준 워크로드 외에도 RTX PRO 6000의 96GB GDDR7 메모리를 보여주기 위해 설계된 타겟 테스트도 실행하여 용량과 지속적인 처리량이 중요한 대규모 모델, 고해상도 데이터 세트 및 전문적인 시각화 워크로드를 처리하는 데 있어 이 메모리의 장점을 보여주었습니다.
- RTX 프로 6000
- 지포스 RTX 5090 FE
- 지포스 RTX 4090 FE
- RTX 6000 ADA
새로운 NVIDIA RTX PRO 6000의 이점을 최대한 활용하기 위해 AMD ThreadRipper 플랫폼을 활용했습니다. 이 시스템은 64코어 CPU와 수냉 루프를 제공합니다. GPU가 방해받지 않고 작업을 수행할 수 있도록 충분한 CPU 성능을 제공합니다. 전체 시스템 구성은 아래와 같습니다.
StorageReview AMD ThreadRipper 테스트 플랫폼
- 마더 보드 : ASUS 프로 WS TRX50-SAGE WIFI
- CPU : AMD Ryzen Threadripper 7980X 64코어
- 램: 32GB DDR5 4800MT/초
- 스토리지 : 2TB 삼성 980 프로
- OS : 워크스테이션용 Windows 11 Pro
UL Procyon: AI 텍스트 생성
Procyon AI 텍스트 생성 벤치마크는 간결하고 일관된 평가 방법을 제공하여 AI LLM 성능 테스트를 간소화합니다. 이 벤치마크를 통해 여러 LLM 모델에 대한 반복 테스트가 가능하며, 대규모 모델과 다양한 변수로 인한 복잡성을 최소화할 수 있습니다. AI 하드웨어 분야의 선두 기업들과 협력하여 개발된 이 벤치마크는 로컬 AI 가속기 활용을 최적화하여 더욱 안정적이고 효율적인 성능 평가를 제공합니다. 아래 측정 결과는 TensorRT를 사용하여 테스트되었습니다.
네 가지 모델 테스트 모두에서 NVIDIA RTX PRO 6000은 꾸준히 선두를 달렸습니다. Phi부터 PRO 6000은 전체 점수 6,775점을 기록하며 RTX 5090(5,749점), RTX 4090(4,958점), RTX 6000 Ada(4,508점)를 앞지르며 압도적인 우위를 보였습니다. 빠른 토큰 생성 속도(초당 325.9토큰)와 낮은 지연 시간(첫 토큰 생성까지 0.182초)은 실시간 텍스트 생성 및 채팅 기반 AI 워크로드에서의 뛰어난 응답성을 보여줍니다.
이러한 추세는 Mistral에서도 이어졌습니다. PRO 6000은 7,346 Ada를 기록하며 5090(6,267), 4090(5,094), 6000 Ada(4,255)보다 상당한 우위를 유지했습니다. 271.8 토큰/초의 처리량은 96GB의 대용량 메모리 풀과 고맥락 추론을 위한 최적화된 워크스테이션 튜닝의 이점을 보여줍니다.
Llama3에서 PRO 6000은 6,501점을 기록하며 RTX 5090(6,104점), 4090(4,849점), 6000 Ada(4,026점)보다 앞서 나갔습니다. 이는 NVIDIA Blackwell 아키텍처의 일관성을 보여주는 것으로, PRO 6000은 트랜스포머 워크로드의 복잡성과 컨텍스트 길이가 확장됨에도 불구하고 성능 우위를 유지합니다.
마지막으로, 장기 맥락 추론과 지속적인 성능을 강조하는 Llama2에서 PRO 6000은 8,008 Ada를 달성한 반면, 5090, 4090, 6000 Ada는 각각 6,591, 5,013, 3,957 Ada로 뒤처졌습니다. 시퀀스 길이와 추론 시간이 증가했음에도 불구하고, PRO 6000은 속도와 안정성 모두에서 확연한 우위를 유지하며 테스트된 다른 모든 GPU보다 더 빠르고 원활한 처리량으로 실행을 완료했습니다.
| UL Procyon: AI 텍스트 생성 | 엔비디아 RTX 프로 6000 | 엔비디아 RTX 5090 | 엔비디아 RTX 4090 | 엔비디아 RTX 6000 에이다 |
| 파이 전체 점수 | 6,775 | 5,749 | 4,958 | 4,508 |
| 첫 번째 토큰까지의 Phi 출력 시간 | 0.182들 | 0.244들 | 0.255들 | 0.288들 |
| 초당 Phi 출력 토큰 | 325.855 토크/초 | 314.435 토크/초 | 244.343 토크/초 | 228.359 토크/초 |
| 파이 전체 기간 | 9.498들 | 10.280들 | 12.872들 | 13.869들 |
| 미스트랄 종합 점수 | 7,346 | 6,267 | 5,094 | 4,255 |
| 미스트랄 출력 시간 첫 번째 토큰까지 | 0.229들 | 0.297들 | 0.322들 | 0.419들 |
| 초당 미스트랄 출력 토큰 | 271.779 토크/초 | 255.945 토크/초 | 183.266 토크/초 | 166.633 토크/초 |
| 미스트랄 전체 기간 | 11.493들 | 12.593들 | 17.010들 | 19.092들 |
| Llama3 전체 점수 | 6,501 | 6,104 | 4,849 | 4,026 |
| Llama3 첫 번째 토큰까지의 출력 시간 | 0.218들 | 0.234들 | 0.259들 | 0.348들 |
| Llama3 초당 출력 토큰 | 226.407 토크/초 | 214.285 토크/초 | 150.039 토크/초 | 138.620 토크/초 |
| 라마3 전체 지속 시간 | 13.554들 | 14.304들 | 19.991들 | 22.062들 |
| Llama2 전체 점수 | 8,008 | 6,591 | 5,013 | 3,957 |
| Llama2 첫 번째 토큰까지의 출력 시간 | 0.307들 | 0.419들 | 0.500들 | 0.679들 |
| Llama2 초당 출력 토큰 | 145.595 토크/초 | 134.502 토크/초 | 92.853 토크/초 | 78.532 토크/초 |
| 라마2 전체 지속 시간 | 20.712들 | 23.018들 | 32.448들 | 38.923들 |
UL 프로키온: AI 이미지 생성
Procyon AI 이미지 생성 벤치마크는 저전력 NPU부터 고성능 GPU에 이르기까지 다양한 하드웨어에서 AI 추론 성능을 일관되고 정확하게 측정하는 방법을 제공합니다. 이 벤치마크는 고성능 GPU용 Stable Diffusion XL(FP16), 중성능 GPU용 Stable Diffusion 1.5(FP16), 저전력 장치용 Stable Diffusion 1.5(INT8)의 세 가지 테스트로 구성됩니다. 각 시스템에 최적화된 추론 엔진을 사용하여 공정하고 비교 가능한 결과를 보장합니다.
Stable Diffusion 1.5(FP16)부터 NVIDIA RTX PRO 6000은 총 8,869점이라는 압도적인 점수를 기록하며 RTX 5090(8,193점), RTX 4090(5,260점), RTX 6000 Ada(4,230점)를 앞지르는 성능을 보였습니다. PRO 6000은 이미지 생성에 11.27초, 이미지당 평균 0.705초를 기록하며 이 테스트에서 가장 빠른 속도를 기록했습니다. 이는 워크스테이션에 최적화된 튜닝과 96GB GDDR7 메모리가 효율성 저하 없이 지속적인 고정밀 출력을 가능하게 한다는 것을 보여줍니다.
경량 양자화 추론 성능을 측정하는 Stable Diffusion 1.5(INT8) 테스트에서 모든 GPU가 유사한 성능을 보였습니다. PRO 6000은 79,064점을 기록하여 RTX 5090의 79,272점과 거의 동일했지만, RTX 4090(62,160점)과 RTX 6000 Ada(55,901점)보다 앞섰습니다. INT8 워크로드는 메모리 대역폭과 용량에 대한 의존도가 낮기 때문에 차이는 미미했지만, PRO 6000은 이미지당 평균 생성 시간 0.395초로 일관된 결과를 유지했습니다.
Stable Diffusion XL(FP16) 테스트는 메모리와 지속적인 컴퓨팅 처리량 모두에 부담을 주는 더 길고 까다로운 추론 실행을 요구하는 GPU에 부하를 가합니다. 이 테스트에서 PRO 6000은 전체 점수 6,991점을 기록하여 RTX 5090의 7,179점에 약간 못 미치는 점수를 기록했지만, RTX 4090의 5,025점과 RTX 6000 Ada의 3,043점보다는 훨씬 앞섰습니다. 총 렌더링 시간은 85.8초(이미지당 5.36초)로, PRO 6000이 장시간 세대 워크로드를 속도 저하 없이 효율적으로 처리함을 보여줍니다.
| UL Procyon: AI 이미지 생성 | 엔비디아 RTX 프로 6000 | 엔비디아 RTX 5090 | 엔비디아 RTX 4090 | 엔비디아 RTX 6000 에이다 |
| 안정적 확산 1.5(FP16) – 전체 점수 | 8,869 | 8,193 | 5,260 | 4,230 |
| 안정적 확산 1.5(FP16) – 전체 시간 | 11.274들 | 12.204들 | 19.011들 | 23.639들 |
| 안정적 확산 1.5(FP16) – 이미지 생성 속도 | 0.705초/이미지 | 0.763초/이미지 | 1.188초/이미지 | 1.477초/이미지 |
| 안정적 확산 1.5(INT8) – 전체 점수 | 79,064 | 79,272 | 62,160 | 55,901 |
| 안정적 확산 1.5(INT8) – 전체 시간 | 3.162들 | 3.154들 | 4.022들 | 4.472들 |
| 안정적 확산 1.5(INT8) – 이미지 생성 속도 | 0.395초/이미지 | 0.394초/이미지 | 0.503초/이미지 | 0.559초/이미지 |
| Stable Diffusion XL(FP16) – 전체 점수 | 6,991 | 7,179 | 5,025 | 3,043 |
| 안정적 확산 XL(FP16) – 전체 시간 | 85.819들 | 83.573들 | 119.379들 | 197.172들 |
| 안정된 확산 XL(FP16) – 이미지 생성 속도 | 5.364초/이미지 | 5.223초/이미지 | 7.461초/이미지 | 12.323초/이미지 |
블렌더 4.4
블렌더는 오픈소스 3D 모델링 애플리케이션입니다. 이 벤치마크는 블렌더 벤치마크 유틸리티를 사용하여 실행되었습니다. 점수는 분당 샘플 수로 측정되며, 값이 높을수록 성능이 우수함을 나타냅니다.
세 장면 모두에서 NVIDIA RTX PRO 6000이 1위를 차지하며 블랙웰 아키텍처와 확장된 메모리 용량의 이점을 보여주었습니다. 몬스터 장면에서 PRO 6000은 분당 7,870.17개의 샘플을 기록하여 RTX 5090(7,421.50)을 앞섰고, RTX 4090과 RTX 6000 Ada는 각각 5,733.97과 5,632.60으로 그 뒤를 이었습니다.
정크샵(Junkshop) 환경에서 PRO 6000은 분당 4,158.91개의 샘플을 기록하며 선두를 유지했고, RTX 5090은 3,980.15개, RTX 4090은 2,827.83개, RTX 6000 Ada는 2,663.77개를 기록했습니다. 마지막으로, 셰이딩과 메모리 효율성을 모두 강조하는 Classroom 환경에서 PRO 6000은 분당 4,041.11개의 샘플을 기록하며 RTX 5090의 3,732.63개를 다시 앞지르고, RTX 4090과 RTX 6000 Ada의 각각 2,909.35와 2,818.83보다 훨씬 높은 성능을 보였습니다.
| Blender 4.4 (높을수록 좋습니다) | 엔비디아 RTX 프로 6000 | 엔비디아 RTX 5090 | 엔비디아 RTX 4090 | 엔비디아 RTX 6000 에이다 |
| 몬스터 | 7,870.17 | 7,421.50 | 5,733.97 | 5,632.60 |
| 정크샵 | 4,158.91 | 3,980.15 | 2,827.83 | 2,663.77 |
| 교실 | 4,041.11 | 3,732.63 | 2,909.35 | 2,818.83 |
럭스마크
Luxmark는 오픈소스 레이 트레이싱 렌더러인 LuxRender를 활용하여 고도로 세부적인 3D 장면 처리 시 시스템 성능을 평가하는 GPU 벤치마크입니다. 이 벤치마크는 특히 서버 및 워크스테이션의 그래픽 렌더링 성능 평가에 적합하며, 정확한 조명 시뮬레이션이 필수적인 시각 효과 및 건축 시각화 애플리케이션에서 특히 유용합니다.
음식 장면 테스트에서 NVIDIA RTX PRO 6000은 24,287점으로 RTX 5090(23,141점)을 제치고 선두를 차지했으며, RTX 4090과 RTX 6000 Ada는 각각 17,171점과 14,873점으로 그 뒤를 이었습니다. 이는 PRO 6000이 안정성 저하나 열 조절 없이 매우 세부적인 지오메트리 및 조명 워크로드에서도 매끄러운 레이 트레이싱 성능을 유지함을 보여줍니다.
대규모 기하학과 복잡한 글로벌 일루미네이션을 강조하는 더욱 까다로운 Hall 장면에서 PRO 6000은 다시 52,588점으로 최고 결과를 확보했으며, RTX 5090의 51,725점보다 약간 앞섰고, RTX 4090(38,887)과 RTX 6000 Ada(32,132)보다 훨씬 높았습니다.
| Luxmark (높을수록 좋음) | 엔비디아 RTX 프로 6000 | 엔비디아 RTX 5090 | 엔비디아 RTX 4090 | 엔비디아 RTX 6000 에이다 |
| 음식 점수 | 24,287 | 23,141 | 17,171 | 14,873 |
| 홀 스코어 | 52,588 | 51,725 | 38,887 | 32,132 |
Geekbench 6
Geekbench 6 는 시스템의 전반적인 성능을 측정하는 크로스 플랫폼 벤치마크 프로그램입니다. Geekbench 브라우저를 사용하면 어떤 시스템이든 Geekbench 6와 비교할 수 있습니다.
이 테스트에서 NVIDIA RTX PRO 6000은 GPU OpenCL 점수 384,158점을 기록하여 RTX 5090(374,807점), RTX 4090(333,384점), 그리고 RTX 6000 Ada(336,882점)를 능가했습니다. PRO 6000의 높은 점수는 최적화된 워크스테이션 설계, 향상된 메모리 대역폭, 그리고 전문적인 드라이버 스택을 반영하며, 이 모든 요소가 광범위한 컴퓨팅 집약적 워크로드에서 일관된 성능을 보장합니다.
| Geekbench (높을수록 좋음) | 엔비디아 RTX 프로 6000 | 엔비디아 RTX 5090 | 엔비디아 RTX 4090 | 엔비디아 RTX 6000 에이다 |
| GPU OpenCL 점수 | 384,158 | 374,807 | 333,384 | 336,882 |
V- 레이
V -Ray 벤치마크는 고급 V-Ray 6 엔진을 사용하여 CPU, NVIDIA GPU 또는 둘 다의 렌더링 성능을 측정합니다. 빠른 테스트와 간단한 점수 시스템을 통해 사용자는 시스템의 렌더링 기능을 평가하고 비교할 수 있습니다. 효율적인 성능 분석을 원하는 전문가에게 필수적인 도구입니다.
테스트 결과, NVIDIA RTX PRO 6000은 12,128개의 vpath를 기록하여 14,764개로 선두를 차지한 RTX 5090과 10,847개로 선두를 차지한 RTX 4090 사이에 위치했습니다. RTX 6000 Ada는 10,766개로 약간 뒤처졌습니다. RTX 5090이 이 GPU 집약적 렌더링 테스트에서 근소한 우위를 유지했지만, PRO 6000은 강력하고 일관된 성능을 보여주며 워크스테이션 중심의 튜닝과 최대 렌더링 부하에서도 지속적인 효율성을 입증했습니다.
| V-Ray (높을수록 좋음) | 엔비디아 RTX 프로 6000 | 엔비디아 RTX 5090 | 엔비디아 RTX 4090 | 엔비디아 RTX 6000 에이다 |
| vpaths | 12,128 | 14,764 | 10,847 | 10,766 |
LM Studio 다중 모델 추론 테스트
이번 테스트에서는 LM Studio를 사용하여 GPT-OSS 120B, Gemma 3(4B, 12B, 27B), Llama 3.1(8B, 70B), Llama 3.3 70B를 포함한 다양한 인기 있는 대규모 언어 모델에서 NVIDIA RTX PRO 6000의 성능을 평가했습니다. 각 모델에는 동일한 명령어가 사용되었습니다.
"나무늘보의 역사에 관한 500단어 분량의 학술 논문을 쓰세요."
이 테스트의 주요 초점은 초당 토큰(처리량)과 총 시간(완료 기간)입니다. 이는 RTX PRO 6000이 동일한 생성 조건에서 다양한 모델 크기와 복잡성을 얼마나 효율적으로 처리하는지 보여줍니다.
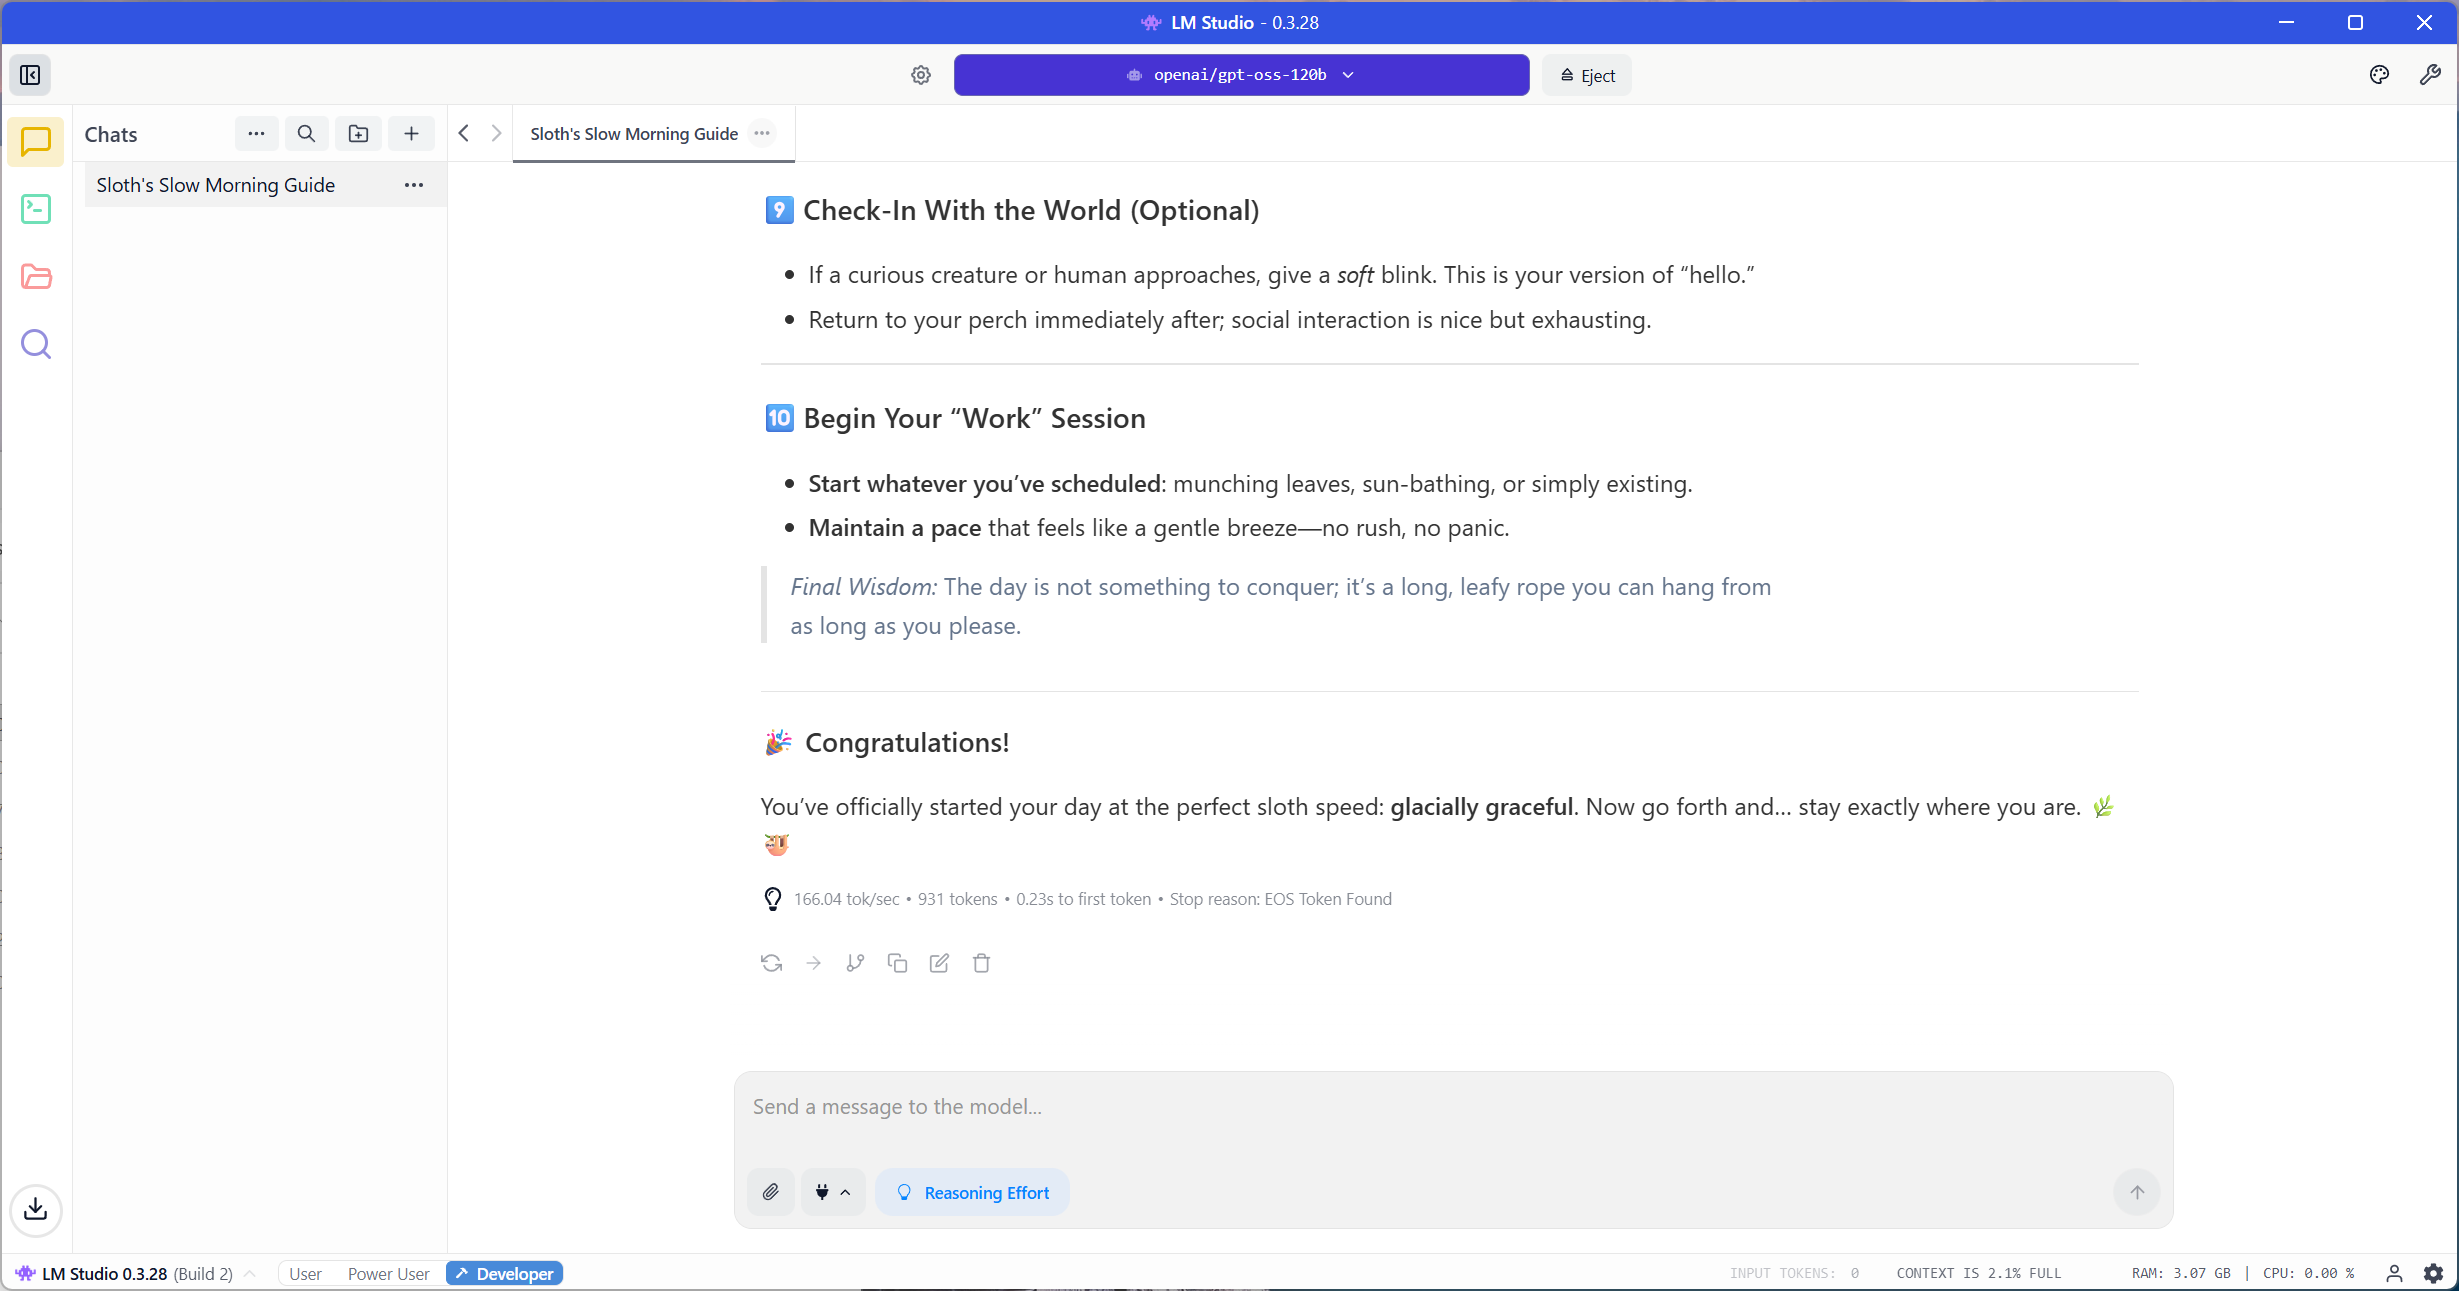
LM Studio 추론 테스트에서 NVIDIA RTX PRO 6000은 작은 4B 매개변수 모델부터 대규모 120B 클래스 구성까지 다양한 모델 크기에 걸쳐 뛰어난 성능과 확장성을 보여주었습니다.
이 테스트의 하이라이트는 OpenAI GPT-OSS 120B였습니다. RTX PRO 6000은 초당 163.1개의 토큰을 생성하고 500개의 단어 생성을 9.54초 만에 완료했습니다. 이 결과는 RTX 5090과 같은 그래픽 카드가 120B 모델을 로드하거나 실행할 수 없고, 제한된 VRAM으로 인해 70B 모델조차 처리하지 못하는 경우가 많다는 점을 고려하면 주목할 만합니다. PRO 6000은 96GB GDDR7 메모리를 통해 이러한 대용량 모델을 로컬에서 처리할 수 있어 워크스테이션 GPU 중에서도 독보적인 성능을 자랑합니다.
소형 모델의 경우, Gemma 3.4 B가 가장 높은 처리량을 달성하여 3.51초 만에 초당 226.7개의 토큰을 처리하며 작업을 완료했습니다. Llama 3.1 8B Instruct는 초당 197.1개의 토큰을 처리하며 총 4.17초를 기록하며 그 뒤를 바짝 쫓았습니다. 이러한 결과는 PRO 6000이 중간 수준의 추론 워크로드에서 뛰어난 효율성과 빠른 응답 속도를 보여준다는 것을 보여줍니다.
상위 모델인 Llama 3.1 70B Instruct와 Llama 3.3 70B 모델은 초당 평균 31.8개의 토큰을 생성했으며 총 생성 시간은 각각 27.2초와 25.3초로, 크기가 큰 것에도 불구하고 일관된 출력을 보였습니다.
전반적으로 RTX PRO 6000은 대규모 모델 실행 시 탁월한 안정성, 처리량 및 성능을 제공합니다. 96GB 메모리 용량은 일반 소비자용 GPU의 한계를 뛰어넘는 워크로드를 처리할 수 있도록 하여, 고급 AI 및 생성 모델 개발을 위해 안정적인 로컬 성능이 필요한 개발자, 연구원 및 전문가에게 탁월한 선택입니다.
| LM Studio(모델 추론 결과) | |||||||||
|---|---|---|---|---|---|---|---|---|---|
| 모델 이름 | 토큰 / 초 | 첫 번째 토큰까지의 시간(초) | 총 시간(초) | 프롬프트 토큰 | 예측 토큰 | 총 토큰 | |||
| 오픈AI GPT-OSS 120B | 163.15 | 0.193 | 9.543 | 81 | 1,557 | 1,638 | |||
| 젬마 3 4B | 226.73 | 0.113 | 3.51 | 25 | 796 | 821 | |||
| 젬마 3 12B | 117.15 | 0.068 | 8.06 | 25 | 944 | 969 | |||
| 젬마 3 27B | 68.06 | 0.221 | 12.048 | 25 | 820 | 845 | |||
| 메타 라마 3.1 8B 지시 | 197.07 | 0.062 | 4.171 | 49 | 822 | 871 | |||
| 메타 라마 3.1 70B 지시 | 31.84 | 0.159 | 27.227 | 49 | 867 | 916 | |||
| 메타라마 3.3 70B | 31.74 | 0.323 | 25.329 | 49 | 804 | 853 | |||
NVIDIA RTX PRO 6000 전력 소비
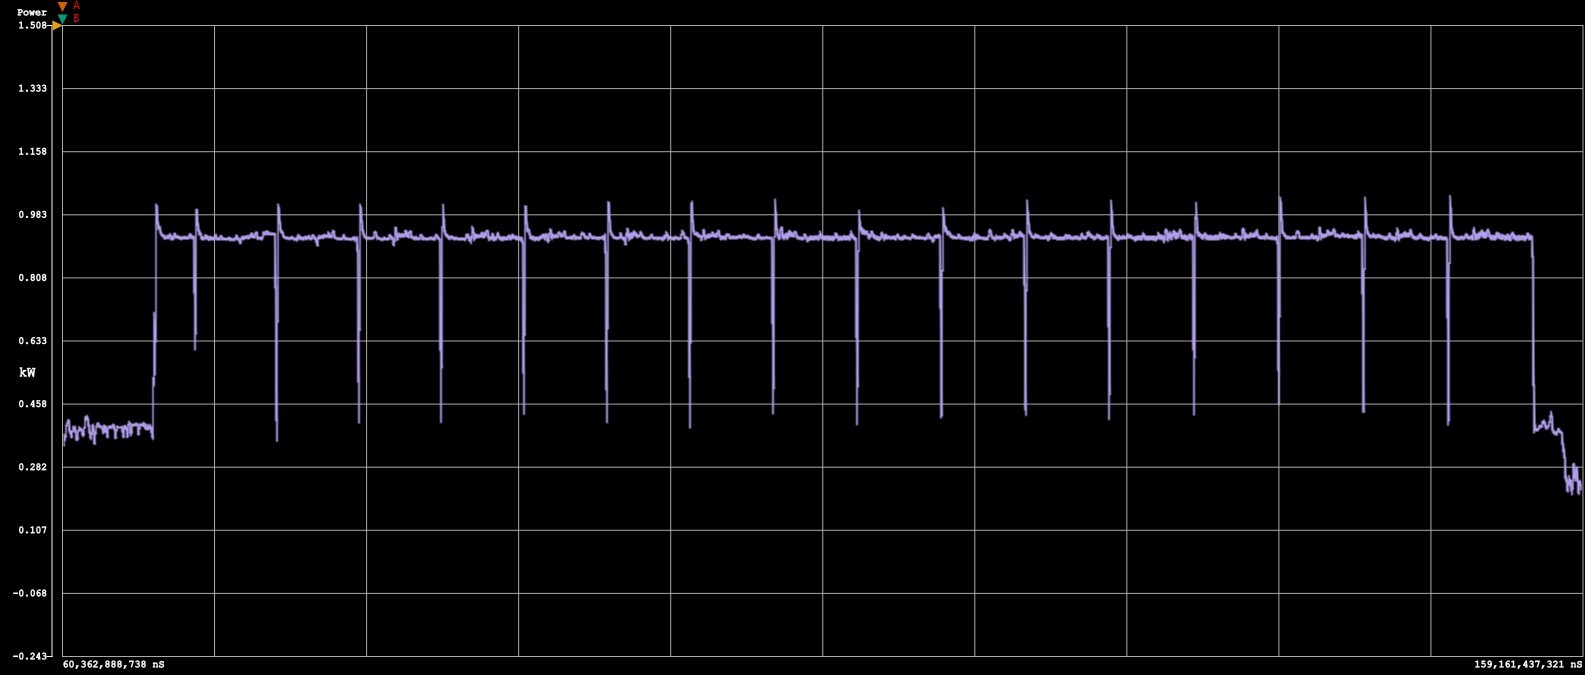
AI 워크로드의 실제 효율성을 평가하기 위해 UL Procyon AI 이미지 생성 벤치마크, 특히 Stable Diffusion XL FP16 테스트를 활용했습니다. 이 테스트는 두 번째 이미지와 마지막 이미지 사이의 간격에 초점을 맞추고, 해당 간격을 완료하는 데 걸리는 시간, 최대 및 지속 전력 소비량, 그리고 완료 후 시스템 유휴 전력을 측정합니다.
테스트 중 RTX PRO 6000은 지속 부하 시 평균 918.5W의 시스템 전력 소모량을 유지했으며, 최대 1,036.3W까지 소모했습니다. 워크로드 완료 후 유휴 전력은 152.3W로 안정화되었습니다. 전체 테스트 간격은 5.3초 동안 진행되었으며, 총 1.35Wh의 에너지를 소비했습니다. 이러한 결과는 워크스테이션급 GPU로서 뛰어난 전력 대비 성능 효율을 보여주며, 장시간 추론 워크로드에서도 높은 출력을 유지하면서 전력 소모량을 효과적으로 제어합니다.
다른 GPU와 비교했을 때, RTX PRO 6000은 더 빠른 완료 시간을 유지하면서도 총 에너지 소비량 면에서 RTX 4090과 거의 동일하며, 전력 효율과 속도 면에서 RTX 6000 Ada보다 훨씬 뛰어납니다. 흥미롭게도, GB202 칩을 공유하는 새로운 Blackwell 카드는 이 워크로드에서 매우 유사한 효율 특성을 보이며, 총 에너지 사용량에는 PRO 6000의 높은 TDP 덕분에 미미한 차이만 있을 것으로 예상됩니다. 이는 NVIDIA의 최신 세대 제품이 와트당 성능을 크게 개선하기보다는 지속적으로 개선하고 있음을 시사합니다.
| Stable Diffusion XL FP16 이미지 전력 사용(낮을수록 좋음) | 엔비디아 RTX 프로 6000 | 엔비디아 RTX 5090 | 엔비디아 RTX 4090 | 엔비디아 RTX 6000 에이다 |
| 소비 전력 | 1.35Wh | 1.16Wh | 1.35Wh | 1.76Wh |
| 시험 기간 | 5.3s | 5.1s | 7.3s | 12.6s |
맺음말
NVIDIA RTX PRO 6000은 전문가용 워크플로우에 사용 가능한 가장 강력한 워크스테이션 GPU로, 데스크톱 폼팩터에서 데이터센터급 성능을 제공합니다. 테스트 당시 소매 가격은 약 8,500달러로, 프로덕션 작업에 필요한 안정성, 높은 컴퓨팅 밀도, 그리고 대용량 ECC 메모리 풀을 필요로 하는 팀을 대상으로 합니다. 24,064개의 CUDA 코어, 752개의 텐서 코어, 96GB의 GDDR7 ECC, 그리고 블랙웰 아키텍처를 탑재한 RTX PRO 6000은 GeForce RTX 5090이나 4090과 같은 일반 소비자용 카드의 실질적인 한계를 뛰어넘는 워크로드를 처리합니다. 개별 벤치마크에서는 일반 소비자용 카드가 기본 속도 면에서 우위를 보일 수 있지만, 용량, 안정성, 드라이버, ISV 지원 등을 종합적으로 고려했을 때 RTX PRO 6000은 전문가용 그래픽 카드에 더 적합합니다.
AI와 ML의 경우, 96GB 풀이 핵심입니다. 이 풀은 로컬에서 긴 컨텍스트 추론과 매우 큰 규모의 체크포인트를 가능하게 하며, 초당 강력한 토큰 처리량을 유지하면서 70억에서 120억 개의 클래스 모델을 실행하여 이를 입증했습니다. 렌더링 및 시뮬레이션 또한 더 큰 L2 캐시 및 메모리 대역폭의 이점을 활용하여 Blender, V-Ray, LuxMark에서 장시간 부하에서도 예측 가능하고 지속적인 성능을 제공합니다.
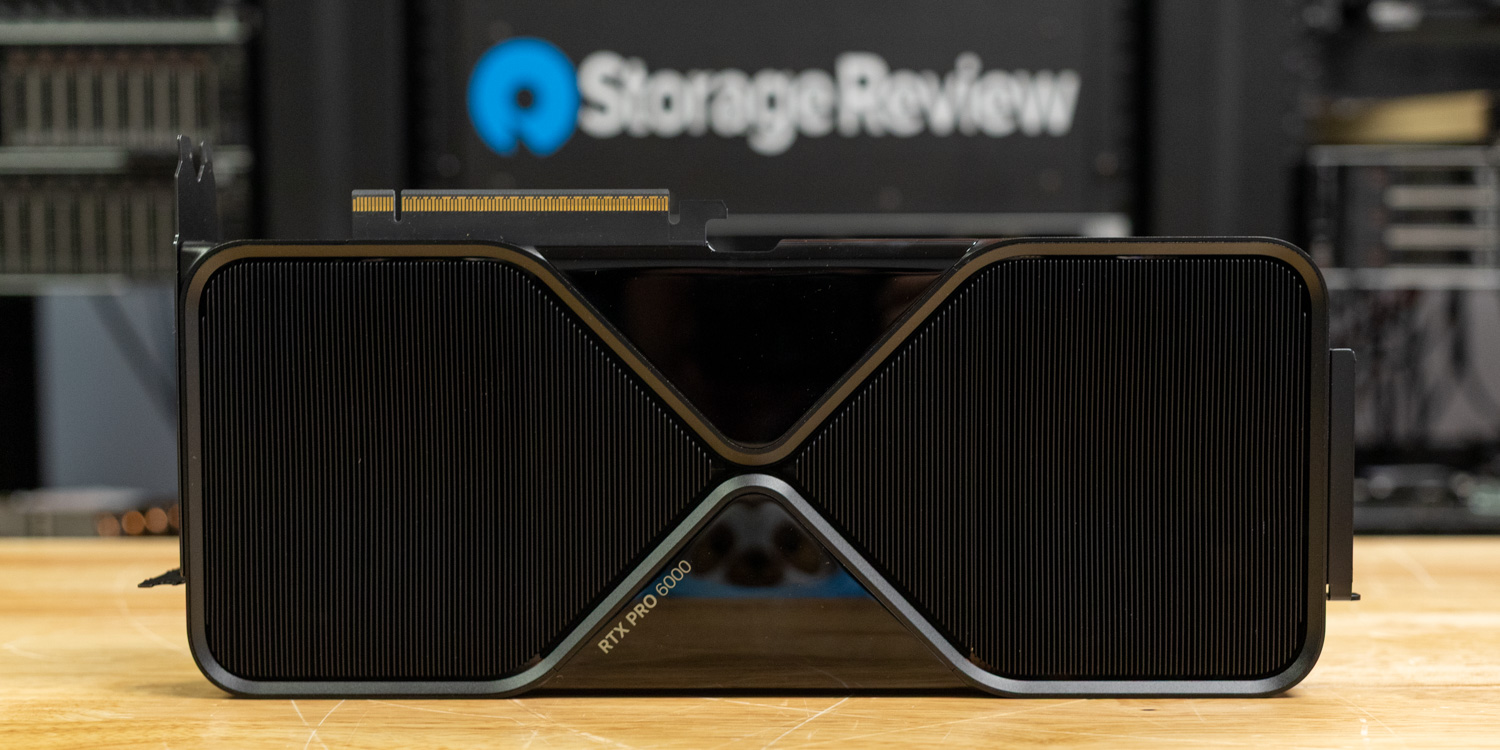
이 카드는 실제 워크스테이션에 적합합니다. PCIe 5.0 x16 인터페이스, DisplayPort 2.1b 출력 4개, 그리고 16핀 전원 입력 1개를 갖춘 진정한 듀얼 슬롯 디자인을 자랑합니다. 600W 보드 전력을 지원하기 위해 고품질 PSU와 섀시 공기 흐름을 고려하세요. OEM 및 ISV가 AI, 렌더링 및 컴퓨팅 스택 전반에 걸쳐 2~8개의 GPU를 지원하므로 멀티 GPU 구성도 간편합니다.
작업에 긴 컨텍스트 LLM, 매우 큰 장면 또는 단일 노드에서의 고정밀 시뮬레이션이 포함된 경우 RTX PRO 6000은 다른 카드가 따라올 수 없는 용량과 일관성으로 프리미엄급 성능을 정당화합니다.
순위표: RTX PRO 6000 Blackwell 서버 에디션은 당사의 최고 엔터프라이즈 GPU 순위표에서 최고의 엔터프라이즈 추론 GPU로 선정되었으며, 이 카드의 워크스테이션 에디션 데이터가 서버 부문을 나타냅니다.


 아마존