

삼성의 새로운 990 SSD는 효율성과 가성비를 최우선으로 고려한 메인스트림 PCIe Gen4 드라이브로, 소비자 라인업에 새롭게 합류했습니다. 삼성은 이 제품을 자사에서 출시한 SSD 중 가장 전력 효율이 뛰어난 제품으로 소개하며, 기존 제품 대비 최대 38% 향상된 전력 효율을 제공한다고 주장합니다. 990 PRO2TB 모델은 순차 읽기 속도 7,250MB/s, 쓰기 속도 6,450MB/s이며, 랜덤 I/O는 읽기 최대 850K IOPS, 쓰기 최대 1,200K IOPS입니다. 1TB 모델은 순차 읽기 속도 7,150MB/s, 랜덤 읽기 700K IOPS, 랜덤 쓰기 1,100K IOPS로 성능이 약간 낮아집니다. 이 드라이브는 1TB와 2TB 용량으로 출시되며, 권장 소비자 가격은 각각 269.99달러와 529.99달러입니다.
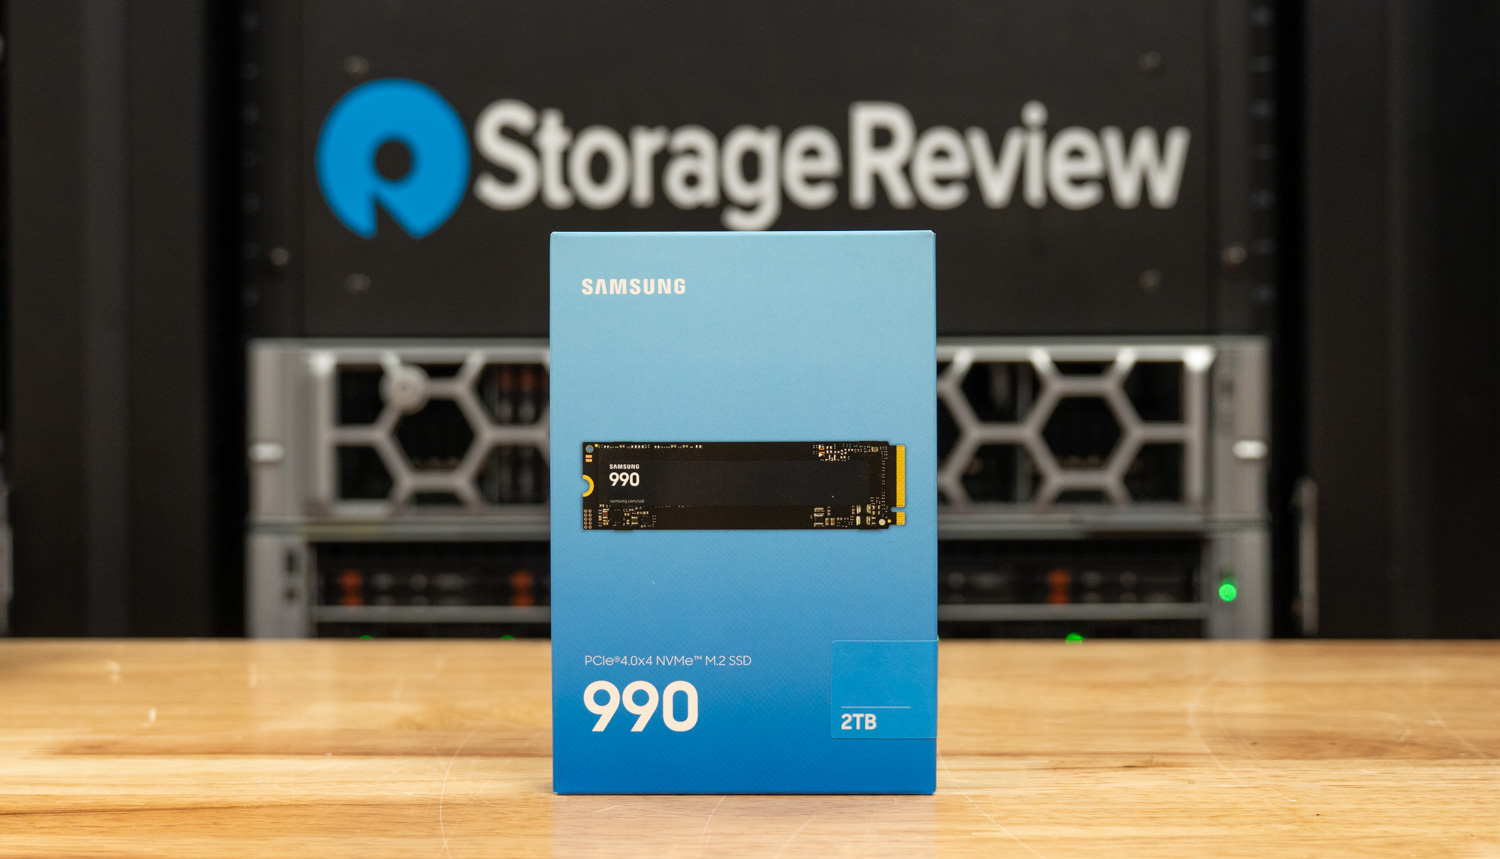
이 제품 이름에 대해서는 간단한 설명이 필요합니다. 삼성의 990 제품군은 이미 990 PRO, 990 EVO , 990 EVO Plus를 포함하고 있습니다. 이제 "990"이라는 이름의 이 제품은 새로운 세대를 시작하는 것이 아니라 기존 제품들과 함께 엔트리급 SSD로 자리매김합니다. 삼성 자체 개발 컨트롤러와 V-NAND(자세한 내용은 후술)를 탑재했으며, DRAM이 없는 설계에 호스트 메모리 버퍼(HMB)를 사용합니다. 보증 기간은 3년으로, PRO 모델의 5년 보증 기간보다 짧습니다. 1TB 및 2TB 용량 모델은 각각 400TB 및 800TB의 쓰기 용량을 제공합니다. 순차 읽기 속도는 7,250MB/s로 990 EVO Plus와 동일하지만 7,450MB/s의 990 PRO에는 미치지 못합니다. 랜덤 읽기 IOPS는 850K로 PRO 모델의 1,400K에 비해 훨씬 낮습니다. 삼성의 핵심 홍보 문구는 두 가지 수치입니다. 순차 쓰기 속도가 990 EVO보다 50% 이상 빠르고, 효율성이 38% 향상되었다는 점입니다. 삼성 자체 테스트 결과, 2TB 읽기 속도는 와트당 1,686MB/s로 990 PRO의 와트당 1,221MB/s보다 높습니다. 하지만 최고 속도를 중시하는 구매자들은 이미 삼성의 5세대 9100 PRO 제품군을 사용하고 있으며, 저희는 출시 당시와 8TB 용량 모델을 다시 한번 리뷰했습니다 . 따라서 990은 이 제품들과 직접적인 경쟁을 목표로 하는 것은 아닙니다.
삼성은 이미 비슷한 경험을 했습니다. 2021년 저희 연구소에 입고된 첫 번째 DRAM이 없는 소비자용 NVMe 드라이브인 980은 좋지 않은 평가를 받았습니다. 특히 용량이 작은 모델들은 성능 평가에서 최하위를 기록했고, 연구소 내에서 혹평을 받았습니다. 하지만 그 이후 시장 상황은 극적으로 변했습니다. AI 시장 확대로 NAND와 DRAM 공급이 급증하고, 부품 가격이 상승하면서 소비자들은 전반적으로 경제적 부담을 느끼고 있습니다. 이러한 상황에서, 탄탄한 순차 속도, 낮은 전력 소모, 그리고 적당한 용량을 제공하는 4세대 드라이브는 가격만 적절하다면 합리적인 선택으로 여겨질 수 있습니다.
삼성 측에서 공개를 거부한 사양 중 하나는 NAND 플래시 메모리 자체에 관한 것입니다. 리뷰어 가이드에는 "삼성 V-NAND"라고만 표기되어 있습니다. 직접 문의했을 때, 삼성은 공식 사양 외에는 부품 세부 정보를 공개할 수 없다며, 정격 성능과 "최신 삼성 V-NAND 기술"을 언급했습니다. 따라서 우리는 행간의 의미를 추측할 수밖에 없는데, 이는 QLC가 아닌 TLC를 사용했을 가능성을 시사합니다. 내구성 사양이 결정적인 단서입니다. 3년 보증 기간 동안 400TB와 800TB는 연간 쓰기 용량으로 환산하면 각각 약 133TB와 267TB에 해당하며, 이는 990 PRO의 5년 보증 기간 동안의 연간 쓰기 용량 600TB와 1,200TB와 거의 동일합니다. 가장 유력한 설명은 이 드라이브에 품질이 낮은 삼성 TLC V-NAND를 사용했거나, 가격을 낮추기 위해 보증 기간이 짧은 저가형 옵션을 제공했을 가능성입니다. 일반적으로 핵심 사양인 쓰기 용량에 대해 의도적으로 정보를 숨기는 것은 의아한 부분입니다.
본 리뷰에 사용된 제품은 2TB 모델(MZ-V9V2T0)로, 펌웨어 0B2QLXL7이 설치된 사전 생산 샘플입니다. 해당 제품을 대상으로 fio, GDS 및 AI 모델 부하 테스트를 진행했으며, 자세한 내용은 아래에 설명되어 있습니다.
삼성 990 SSD 사양
| 스펙 | 삼성 990 1TB | 삼성 990 2TB |
|---|---|---|
| 플랫폼 개요 | ||
| 인터페이스 | PCIe 4.0 x4, NVMe 2.0 (PCIe 3.0과 하위 호환) | |
| 폼 팩터 | M.2 2280 최대 80.15 x 22.15 x 2.38 (mm) |
|
| 제어 장치 | 삼성 사내 컨트롤러 | |
| 낸드 | 삼성 V- 낸드 | |
| 캐시 메모리 | HMB(호스트 메모리 버퍼), DRAM 없음 | |
| 모델 코드 | MZ-V9V1T0 | MZ-V9V2T0 |
| 성능 | ||
| 순차적 읽기 | 최대 7,150MB / s | 최대 7,250MB / s |
| 순차적 쓰기 | 최대 6,450MB / s | 최대 6,450MB / s |
| 무작위 읽기 | 최대 700K IOPS | 최대 850K IOPS |
| 임의 쓰기 | 최대 1,100K IOPS | 최대 1,200K IOPS |
| 힘과 지구력 | ||
| 유효 전력(평균 읽기) | 4.0W | 4.3W |
| 유효 전력(평균 쓰기) | 3.7W | 3.8W |
| 공회전 시 전력 소모량(일반적인 값) | 55mW PS3 (APST 켜짐) 3mW PS4 (L1.2) |
|
| 지구력 (TBW) | 400TB | 800TB |
| MTBF | 1.5 백만 시간 | |
| 품질 보증 | 3 년 제한 | |
| 기능 | ||
| 지원 기능 | TRIM (운영체제 지원 필요) 쓰레기 수거 SMART |
|
| 데이터 보안 | AES 256비트 전체 디스크 암호화 TCG/오팔 V2.0 암호화된 드라이브(IEEE1667) |
|
| 소프트웨어 | 삼성 마술사 9.0 | |
| MSRP | $269.99 | $529.99 |
삼성 990 SSD 디자인 및 제작
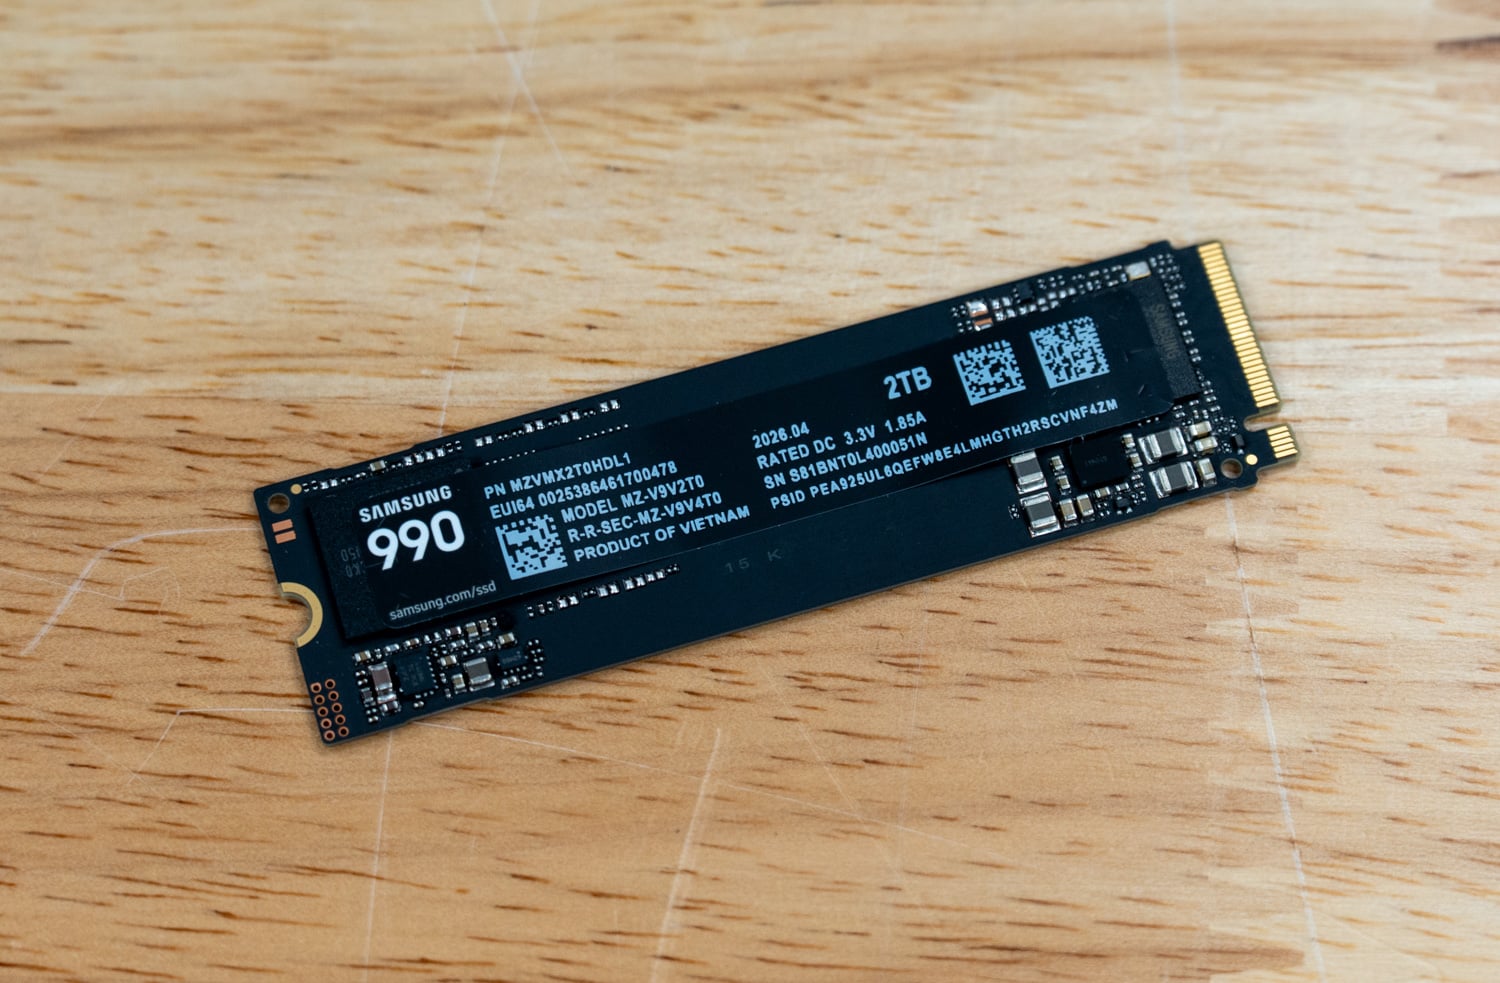
삼성 990은 익숙한 M.2 2280 폼팩터를 채택했으며, 크기는 최대 80.15 x 22.15 x 2.38mm입니다. 단면 설계로 출시되었으며, 별도의 방열판 옵션은 제공되지 않습니다. 따라서 노트북, 소형 PC, 그리고 자체 M.2 쿨링 시스템을 갖춘 데스크톱 마더보드에 장착하기에 적합합니다. 전체적인 구조는 간단하며, 삼성은 컨트롤러, NAND 플래시 메모리, 그리고 관련 회로를 PCB 한쪽 면에 모두 배치했습니다.
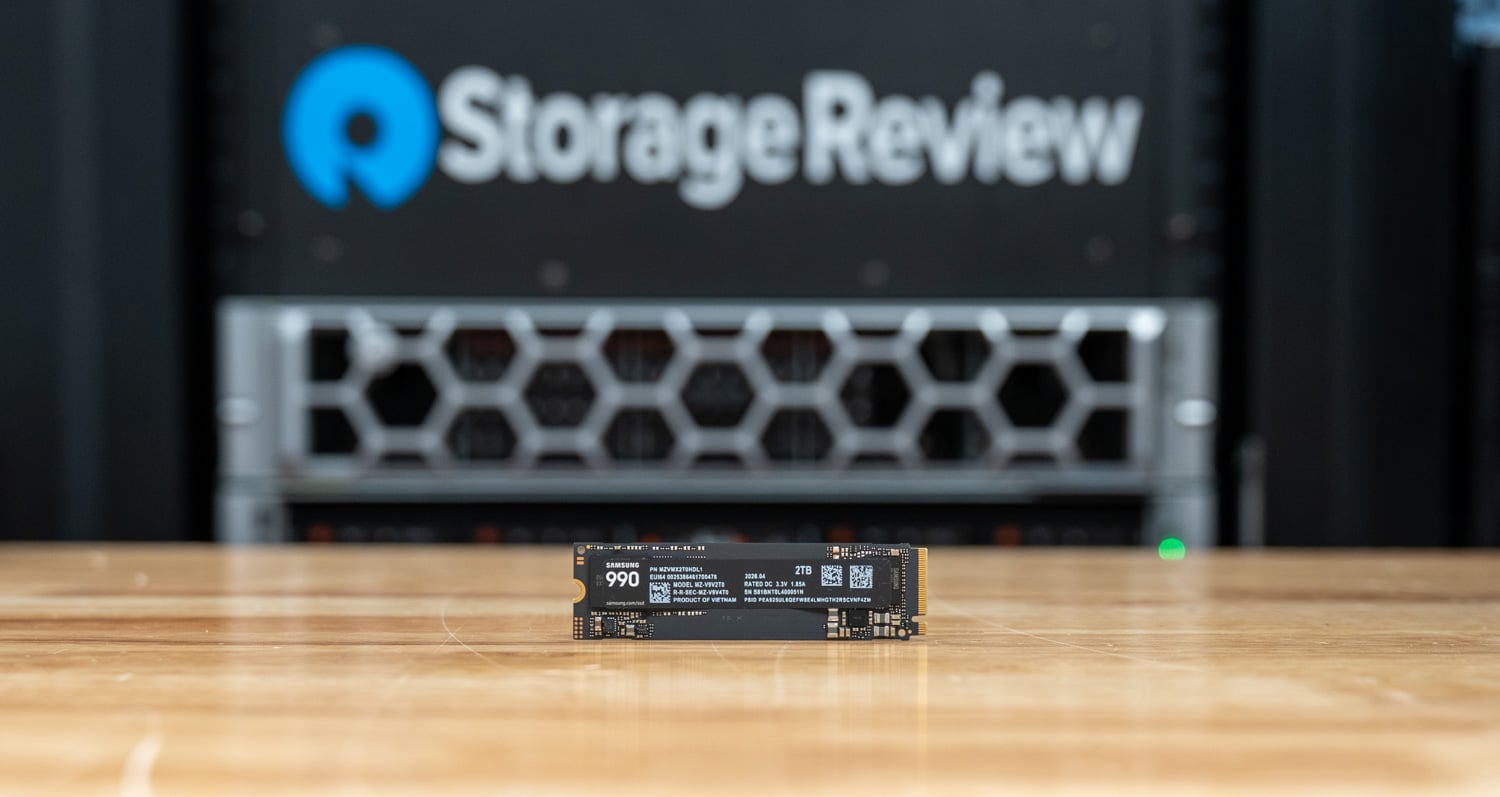
전면 라벨에는 삼성 990 브랜드, 2TB 용량, 모델 번호, 펌웨어 및 전기 사양이 표시됩니다. 내장형 방열판이 없으므로 냉각은 시스템 공기 흐름과 사용자가 제공하는 M.2 방열판에 의존합니다.
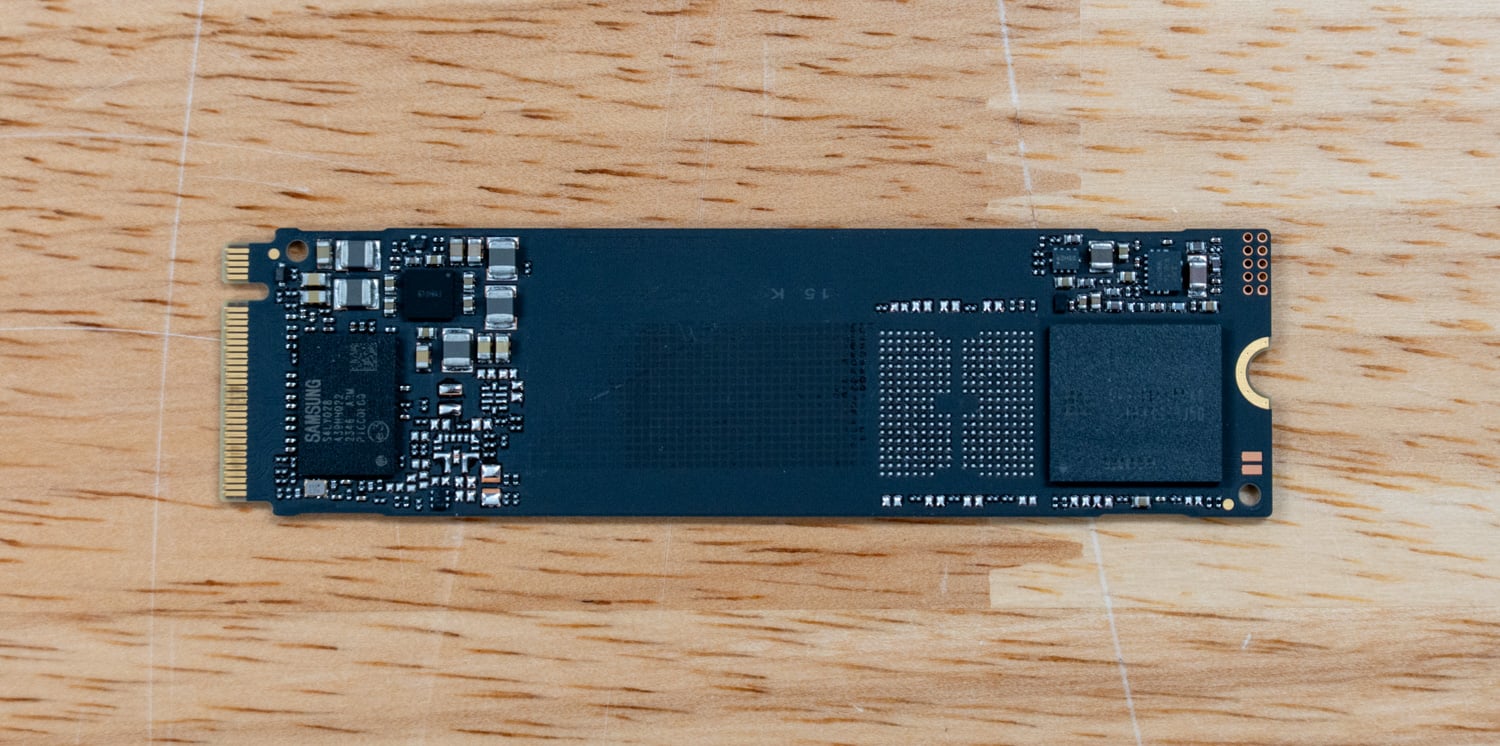
라벨을 제거하면 M.2 커넥터 근처에 삼성 자체 제작 컨트롤러가 있고 그 주변에 전원 부품들이 밀집되어 있는 것을 볼 수 있습니다. NAND 플래시 메모리는 보드의 반대쪽 끝에 위치해 있어 가운데에 상당한 여유 공간이 있습니다. 이 드라이브는 DRAM이 없기 때문에 PCB에 별도의 DRAM 칩이 없습니다.
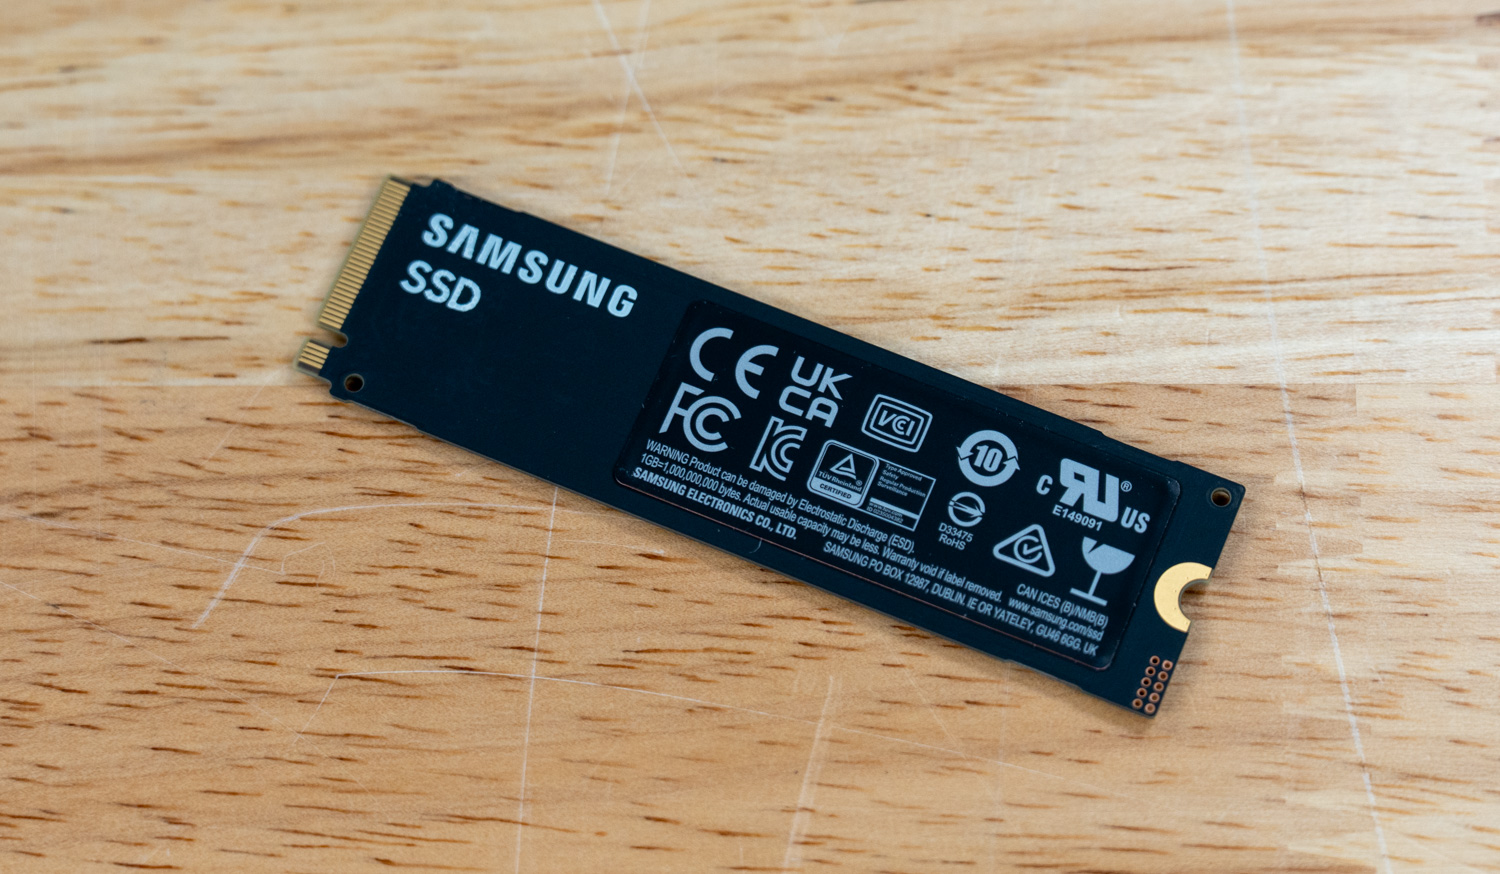
드라이브 뒷면은 대부분 규제 라벨로 덮여 있으며, 그 아래에는 활성 부품이 없습니다. 990은 단면 레이아웃을 사용하기 때문에 M.2 슬롯 주변 공간이 협소한 얇은 노트북이나 소형 시스템에 장착하기가 더 쉽습니다.
소프트웨어 측면에서 990은 삼성 매지션 9.0을 통해 관리되며, 펌웨어 업데이트, 드라이브 상태 및 SMART 모니터링, 진단 스캔, 벤치마킹, 보안 삭제, 그리고 드라이브의 AES 256비트 암호화 기능 설정 등 필수적인 기능을 모두 제공합니다. HMB 구성은 사용자 설정이 필요 없으므로 990에 특화된 설정은 없습니다. 펌웨어를 최신 상태로 유지하려면 처음 부팅할 때 매지션을 설치하는 것이 좋으며, 전반적으로 매우 유용한 도구입니다.
삼성 990 퍼포먼스
최고의 합성 성능
FIO 테스트는 SSD 및 HDD를 포함한 스토리지 장치의 성능을 측정하는 유연하고 강력한 벤치마킹 도구입니다. 이 테스트는 순차 및 임의 읽기/쓰기 작업과 같은 다양한 워크로드에서 대역폭, IOPS, 지연 시간과 같은 지표를 평가합니다. 스토리지 시스템의 최대 성능을 평가하는 데 유용하며, 여러 장치 또는 구성을 비교하는 데 적합합니다. 본 테스트에서는 두 SSD 모두에 10GB의 워크로드를 적용하여 최대 버스트 성능을 측정했습니다.
최대 합성 성능: 삼성 990은 순차 읽기 7,177MB/s, 순차 쓰기 6,070MB/s, 랜덤 읽기 IOPS 872K, 랜덤 쓰기 IOPS 1.08M을 기록하며 PCIe Gen4/Gen5 비교 그룹에서 하위권에 머물렀습니다. 삼성 990 Pro와 비교했을 때, 990은 순차 읽기에서 약 4% 뒤처졌고, 순차 쓰기에서는 15.7%, 랜덤 읽기 IOPS에서는 37.7%, 랜덤 쓰기 IOPS에서는 23.0% 뒤처졌습니다. 가장 빠른 Gen5 드라이브인 SanDisk SN8100과 비교하면 격차는 훨씬 벌어져, 990은 순차 읽기 처리량에서 약 52%, 순차 쓰기 처리량에서 57%, 랜덤 읽기 성능에서 62%, 랜덤 쓰기 성능에서 50% 낮은 성능을 보였습니다.
| FIO 테스트(MB/s/IOPS가 높을수록 좋습니다) | 순차 128K 읽기(1T/64Q) | 순차 128K 쓰기(1T/64Q) | 무작위 4K 읽기(16T/32Q) | 무작위 4K 쓰기(16T/32Q) |
|---|---|---|---|---|
| 샌디스크 SN8100 | 15,000MB/s(평균 지연 시간 0.56ms) | 14,100MB/s(평균 지연 시간 0.59ms) | 2.312M IOPS(0.22ms 평균 지연) | 2.144M IOPS(0.24ms 평균 지연) |
| 킹스턴 퓨리 레니게이드 G5 | 14,600MB/s(평균 지연 시간 0.57ms) | 14,100MB/s(평균 지연 시간 0.59ms) | 2.028M IOPS(0.25ms 평균 지연) | 2.028M IOPS(0.25ms 평균 지연) |
| Samsung 9100 Pro | 14,600MB/s(평균 지연 시간 0.57ms) | 13,300MB/s(평균 지연 시간 0.63ms) | 2.734M IOPS(0.18ms 평균 지연) | 2.734M IOPS(0.19ms 평균 지연) |
| SK 하이닉스 플래티넘 P51 | 14,500MB/s(평균 지연 시간 0.58ms) | 13,500MB/s(평균 지연 시간 0.62ms) | 2.369M IOPS(0.22ms 평균 지연) | 2.669M IOPS(0.19ms 평균 지연) |
| 결정적인 T705 | 14,400MB/s(평균 지연 시간 0.58ms) | 12,300MB/s(평균 지연 시간 0.68ms) | 1.585M IOPS(0.32ms 평균 지연) | 2.703M IOPS(0.19ms 평균 지연) |
| 팀그룹 GE 프로 2TB | 13,900MB/s(평균 지연 시간 0.60ms) | 12,800MB/s(평균 지연 시간 0.65ms) | 2.585M IOPS(0.23ms 평균 지연) | 1.818M IOPS(0.28ms 평균 지연) |
| 렉사 프로페셔널 NM1090 PRO | 13,800MB/s(평균 지연 시간 0.61ms) | 13,600MB/s(평균 지연 시간 0.62ms) | 2.251M IOPS(0.23ms 평균 지연) | 1.818M IOPS(0.28ms 평균 지연) |
| 팀그룹 GC 프로 2TB | 13,600MB/s(평균 지연 시간 0.62ms) | 12,700MB/s(평균 지연 시간 0.66ms) | 2.110M IOPS(0.24ms 평균 지연) | 1.686M IOPS(0.28ms 평균 지연) |
| PNY CS2150 | 10,400MB/s(평균 지연 시간 0.80ms) | 8,801MB/s(평균 지연 시간 0.95ms) | 1.379M IOPS(평균 지연 시간 0.371ms) | 1.623M IOPS(0.32ms 평균 지연) |
| Corsair MP700 MICRO 4TB | 9,169MB/s(평균 지연 시간 0.91ms) | 7,948MB/s(평균 지연 시간 1.06ms) | 1.277M IOPS(0.40ms 평균 지연) | 1.540M IOPS(0.33ms 평균 지연) |
| 크루셜 P510 | 8,835MB/s(평균 지연 시간 0.90ms) | 9,961MB/s(평균 지연 시간 0.80ms) | 1.163M IOPS(0.44ms 평균 지연) | 1.196M IOPS(0.51ms 평균 지연) |
| 마이크론 3610 2TB | 6,839MB/s(평균 지연 시간 1.23ms) | 9,673MB/s(평균 지연 시간 0.87ms) | 1.523M IOPS(0.34ms 평균 지연) | 1.871M IOPS(0.27ms 평균 지연) |
| Samsung 990 Pro | 7,483MB/s(평균 지연 시간 1.12ms) | 7,197MB/s(평균 지연 시간 1.16ms) | 1.400M IOPS(0.36ms 평균 지연) | 1.403M IOPS(0.36ms 평균 지연) |
| 크루셜 P310 2TB | 7,197MB/s(평균 지연 시간 1.16ms) | 6,376MB/s(평균 지연 시간 1.31ms) | 1.163M IOPS(0.44ms 평균 지연) | 1.196M IOPS(0.43ms 평균 지연) |
| 삼성 990 2TB | 7,177MB/s(평균 지연 시간 1.17ms) | 6,070MB/s(평균 지연 시간 1.38ms) | 872K IOPS(평균 지연 시간 0.59ms) | 1.08M IOPS(0.47ms 평균 지연) |
| WD SN850X 2TB | 6,632MB/s(평균 지연 시간 0.76ms) | 7,235MB/s(평균 지연 시간 0.92ms) | 1.2M IOPS(0.43ms 평균 지연) | 825K IOPS(평균 지연 시간 0.62ms) |
| 마이크론 2600 2TB | 5,702MB/s(평균 지연 시간 1.47ms) | 6,612MB/s(평균 지연 시간 1.27ms) | 1.11M IOPS(0.46ms 평균 지연) | 1.36M IOPS(0.38ms 평균 지연) |
평균 LLM 로드 시간
평균 LLM 로드 시간 테스트는 DeepSeek R1 7B, Meta Llama 3.2 11B, DeepSeek R1 32B 등 세 가지 LLM의 로드 시간을 평가했습니다. 각 모델은 10회씩 테스트되었으며, 평균 로드 시간이 계산되었습니다. 이 테스트는 드라이브가 대규모 언어 모델(LLM)을 메모리에 빠르게 로드하는 능력을 측정합니다. LLM 로드 시간은 AI 관련 작업, 특히 실시간 추론 및 대규모 데이터 세트 처리에서 매우 중요합니다. 로드 속도가 빠를수록 모델이 데이터를 더 빠르게 처리할 수 있으므로 AI 응답성이 향상되고 대기 시간이 줄어듭니다.
평균 LLM 로드 시간: AI 모델 로딩은 삼성 990의 가장 약한 테스트였으며, 세 가지 워크로드 모두에서 최하위권에 머물렀습니다. DeepSeek R1 7B에서 5.06초, Meta Llama 3.2 11B Vision에서 7.61초, DeepSeek R1 32B에서 7.86초를 기록했습니다. 가장 빠른 드라이브인 SK 하이닉스 플래티넘 P51과 비교했을 때, 삼성 990은 7B 모델 로딩에 약 99%, 11B Vision 모델 로딩에 약 112%, 32B 모델 로딩에 약 88% 더 오래 걸렸습니다. 더 흥미로운 결과는 삼성 990 Pro의 결과입니다. 이 제품은 보급형 모델과 마찬가지로 최하위권에 머물렀습니다. 990은 7B 로드에서 Pro보다 약 1% 앞섰지만, 11B Vision 모델에서는 15%, 32B 모델에서는 8% 뒤처졌습니다. 삼성의 4세대 드라이브가 이러한 작업 부하에서 어떤 성능을 발휘하든, 그 성능 저하는 공통적으로 나타나므로 Pro 버전으로 업그레이드해도 AI 모델 로딩 성능 향상은 미미합니다.
| 평균 LLM 로드 시간(낮을수록 좋음) | 딥시크 R1 7B | 메타 라마 3.2 11B 비전 | 딥시크 R1 32B |
|---|---|---|---|
| SK 하이닉스 플래티넘 P51 | 2.5481s | 3.5809s | 4.1790s |
| 샌디스크 SN8100 | 2.5702s | 3.5856s | 4.2870s |
| 삼성 9100 프로 4TB | 2.6173s | 3.6017s | 4.3735s |
| PNY CS2150 | 2.8107s | 3.6820s | 4.8962s |
| 크루셜 T705 2TB | 2.8758s | 3.6312s | 5.1080s |
| 크루셜 P510 1TB | 2.8817s | 3.6631s | 5.0594s |
| 팀그룹 GE 프로 2TB | 2.9092s | 3.9136s | 4.8974s |
| 팀그룹 GC 프로 2TB | 2.9379s | 3.9267s | 4.8188s |
| WD SN850X 2TB | 3.0082s | 3.6543s | 5.4844s |
| 킹스턴 퓨리 레니게이드 G5 | 3.1843s | 4.8009s | 4.6523s |
| 크루셜 P310 2TB | 3.1889s | 3.7083s | 5.4844s |
| 렉사 프로페셔널 NM1090 PRO | 3.2135s | 4.9504s | 7.2108s |
| 마이크론 2600 2TB | 3.3178s | 3.9174s | 5.9060s |
| Corsair MP700 MICRO 4TB | 3.4694s | 5.2106s | 5.3990s |
| 마이크론 3610 2TB | 3.5348s | 5.3853s | 5.5731s |
| 삼성 990 2TB | 5.0645s | 7.6087s | 7.8619s |
| 삼성 990 프로 2TB | 5.1255s | 6.6051s | 7.3021s |
이 테스트벤치에서 수행된 테스트 중 하나는 Magnum IO GPU Direct Storage(GDS) 테스트였습니다. GDS는 NVIDIA에서 개발한 기능으로, GPU가 NVMe 드라이브 또는 기타 고속 저장 장치에 저장된 데이터에 액세스할 때 CPU를 거치지 않고 직접 액세스할 수 있도록 합니다. GDS는 데이터를 CPU와 시스템 메모리를 거치는 대신 GPU와 저장 장치 간의 직접 통신을 가능하게 하여 지연 시간을 크게 줄이고 데이터 처리량을 향상시킵니다.
GPU 직접 스토리지 작동 방식
기존 방식에서는 GPU가 NVMe 드라이브에 저장된 데이터를 처리할 때, 데이터가 GPU에 도달하기 전에 먼저 CPU와 시스템 메모리를 거쳐야 했습니다. 이 과정에서 CPU가 중간 역할을 하여 지연 시간을 발생시키고 시스템 리소스를 소모하기 때문에 병목 현상이 발생했습니다. GPU Direct Storage는 GPU가 PCIe 버스를 통해 스토리지 장치에서 직접 데이터에 접근할 수 있도록 함으로써 이러한 비효율성을 해결합니다. 이러한 직접 경로는 데이터 이동 오버헤드를 줄여 더 빠르고 효율적인 데이터 전송을 가능하게 합니다.
AI 워크로드, 특히 딥 러닝과 관련된 워크로드는 매우 데이터 집약적입니다. 대규모 신경망을 훈련하려면 테라바이트 규모의 데이터를 처리해야 하며, 데이터 전송이 지연되면 GPU 활용도가 낮아지고 훈련 시간이 길어질 수 있습니다. GPU Direct Storage는 데이터가 가능한 한 빨리 GPU에 전달되도록 하여 유휴 시간을 최소화하고 계산 효율성을 극대화함으로써 이러한 과제를 해결합니다.
또한 GDS는 비디오 처리, 자연어 처리 또는 실시간 추론과 같이 대용량 데이터 세트를 스트리밍하는 작업 부하에 특히 유용합니다. GDS는 CPU에 대한 의존도를 줄임으로써 데이터 이동을 가속화하고 다른 작업을 위한 CPU 리소스를 확보하여 전반적인 시스템 성능을 더욱 향상시킵니다.
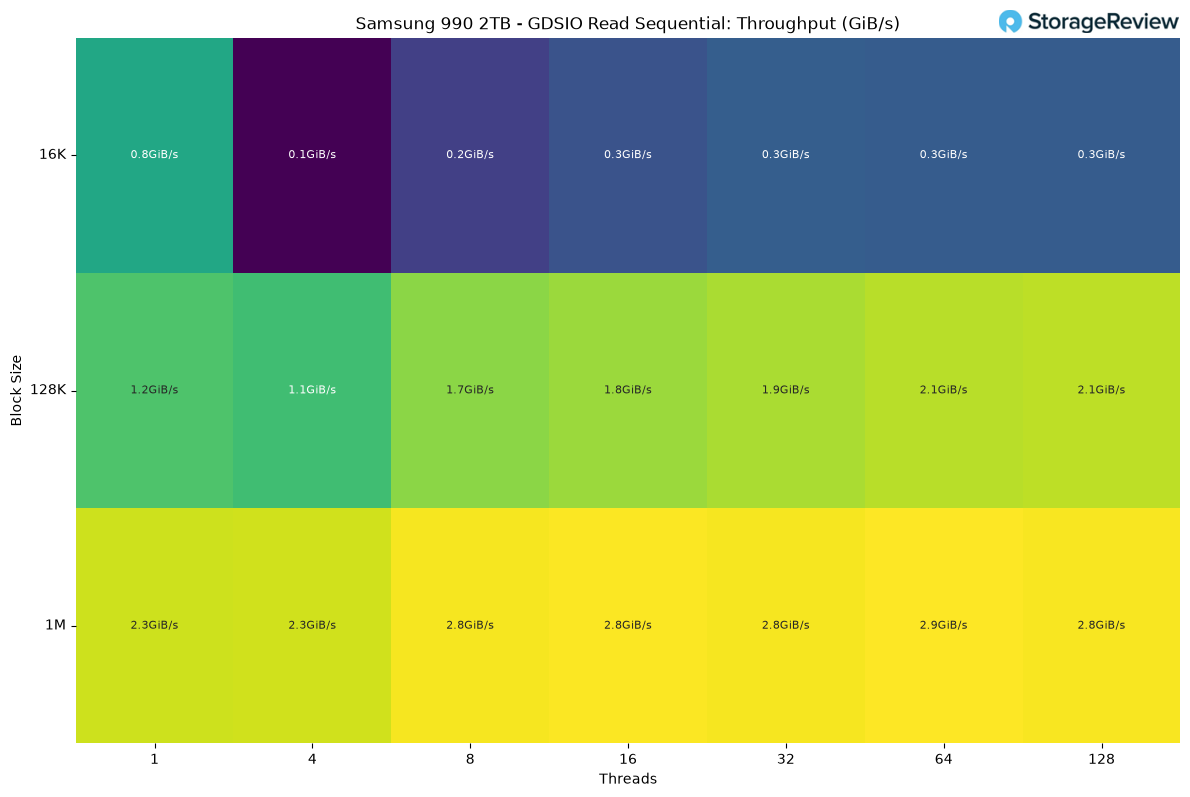
읽기 처리량은 스레드 수가 증가함에 따라 꾸준히 상승했습니다. 1M 블록 크기에서 삼성 990은 단일 스레드에서 2.27GiB/s로 시작하여 64개 스레드에서 2.89GiB/s로 최고치를 기록한 후 128개 스레드에서 2.79GiB/s로 안정화되었습니다. 128K 블록 크기도 비슷한 양상을 보였는데, 단일 스레드에서 1.21GiB/s에서 128개 스레드에서 2.12GiB/s로 증가하여 약 75%의 성능 향상을 보였습니다. 16K 블록 크기는 다른 양상을 보였습니다. 단일 스레드에서 0.82GiB/s로 최고치를 기록한 후 동시성이 도입되면 급격히 감소했고, 8개 스레드 이상에서는 약 0.3GiB/s 수준에서 안정화되었습니다. 이러한 패턴은 작은 블록 I/O가 대역폭 자체보다는 연산당 오버헤드에 의해 포화되는 현상과 일치합니다.
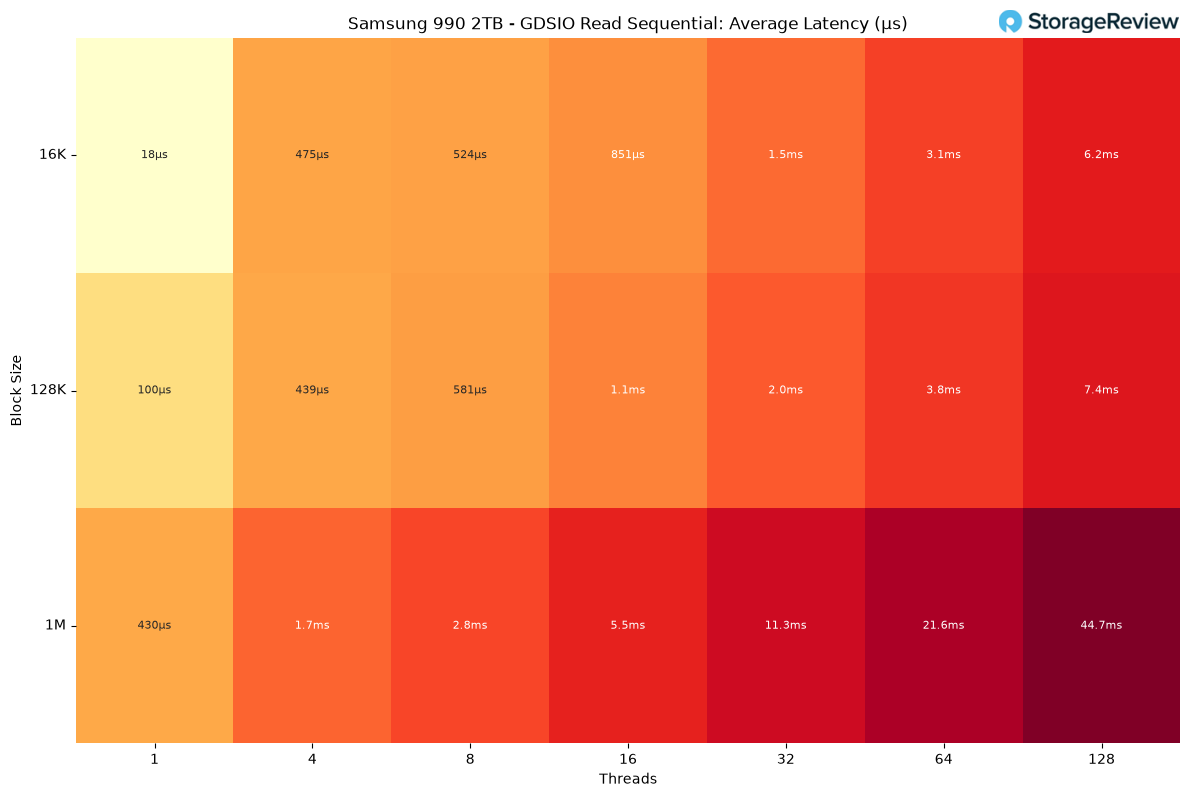
지연 시간은 예상대로 스레드 수에 따라 증가했습니다. 1M 블록 크기에서 평균 지연 시간은 단일 스레드에서 430마이크로초에서 128개 스레드에서 44.7밀리초로 약 100배 증가했는데, 이는 더 많은 GPUDirect Storage 스레드가 동시에 실행됨에 따라 큐 깊이가 증가했음을 반영합니다. 128K 및 16K 블록 크기에서도 동일한 상승 추세를 보였으며, 128개 스레드에서 각각 7.4밀리초와 6.2밀리초에 도달했습니다. 특히 16K 블록 크기는 세 가지 크기 중 단일 스레드 지연 시간이 가장 낮았는데(18마이크로초), 이는 전체 처리량 상한선이 가장 낮았음에도 불구하고 작업당 처리량이 더 적었음을 보여줍니다.
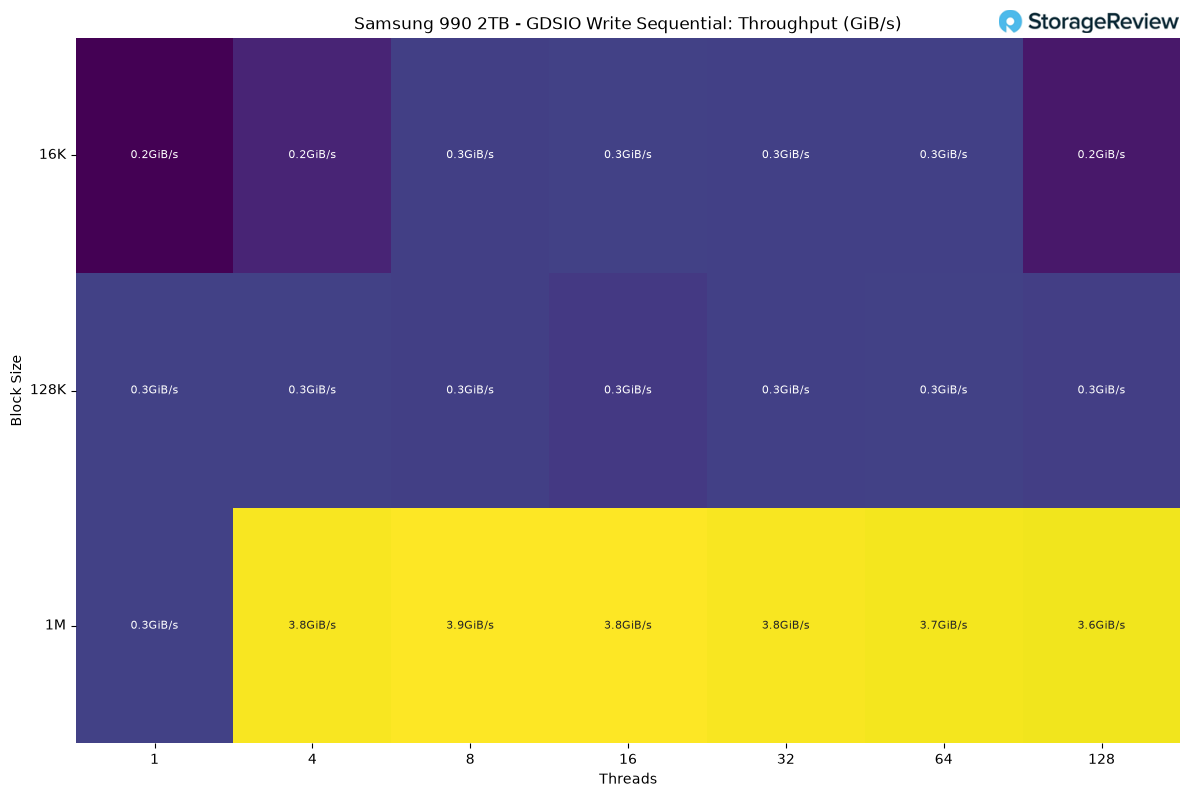
쓰기 처리량은 블록 크기에 따라 차이가 있었습니다. 특히 1M 블록 크기는 단일 스레드에서 0.32GiB/s에서 시작하여 8개 스레드에서 3.89GiB/s로 급증한 후, 큐잉 오버헤드가 증가함에 따라 128개 스레드에서는 3.63GiB/s로 약간 감소하는 등 두드러진 결과를 보였습니다. 128K 및 16K 블록 크기는 스레드 수에 관계없이 0.3GiB/s 부근에서 안정적인 처리량을 유지했습니다. 이는 해당 블록 크기에서는 쓰기 경로가 대역폭보다는 I/O별 오버헤드 또는 컨트롤러 큐잉에 의해 제한됨을 시사합니다.
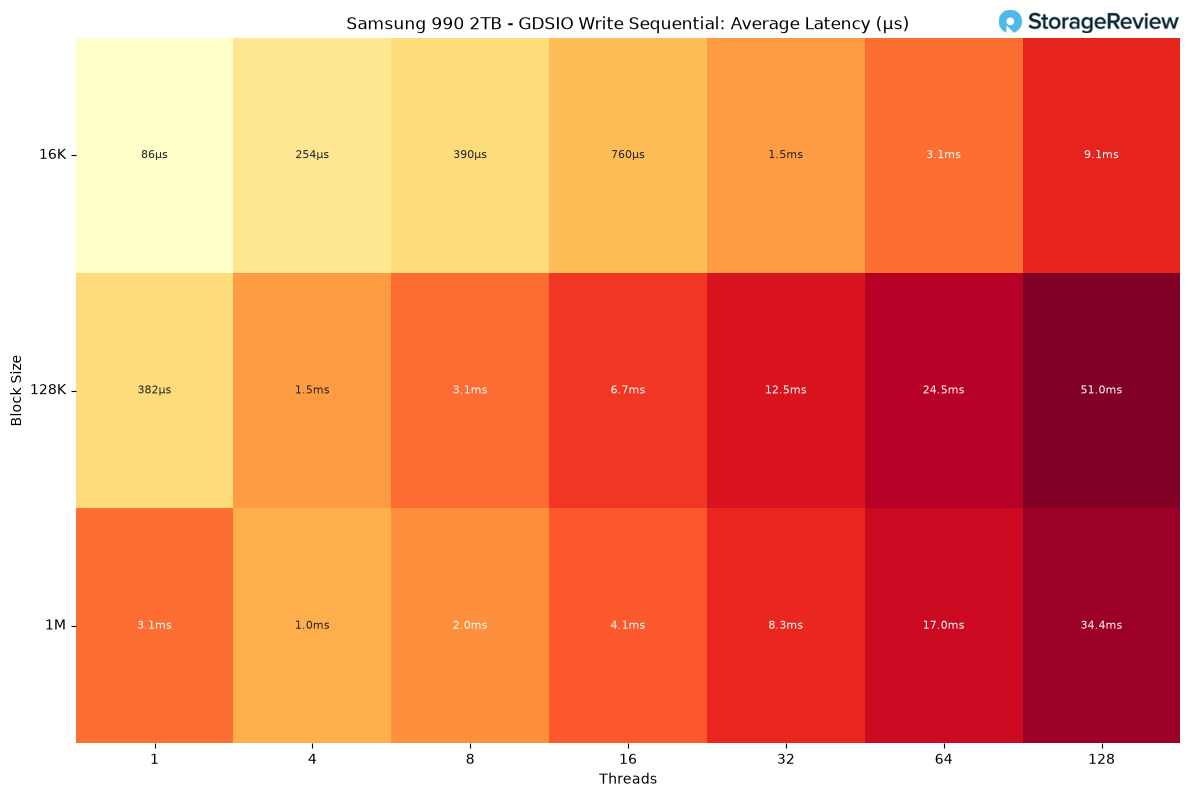
쓰기 지연 시간은 읽기 지연 시간보다 훨씬 가파르게 증가했는데, 특히 128K 블록 크기에서 이러한 경향이 두드러졌습니다. 128K 블록 크기는 단일 스레드에서 382마이크로초였던 지연 시간이 128개 스레드에서는 51.0밀리초까지 치솟아 쓰기 및 읽기 테스트를 통틀어 가장 높은 수치를 기록했습니다. 1M 블록 크기에서는 이례적으로 지연 시간이 감소하는 현상이 나타났는데, 단일 스레드 실행 시 쓰기 경로가 아직 포화 상태에 이르지 않았기 때문에 3.06밀리초에서 4개 스레드 실행 시 1.03밀리초로 떨어졌습니다. 이후 지연 시간은 꾸준히 증가하여 128개 스레드에서는 34.4밀리초까지 상승했습니다. 16K 블록 크기는 가장 안정적인 지연 시간을 보였으며, 세 가지 블록 크기 중 가장 낮은 9.1밀리초로 테스트를 마무리했습니다.
맺음말
삼성 990은 최고 수준의 성능을 추구하지 않으며, 그 결과는 분명합니다. 모든 FIO 테스트에서 990 Pro에 뒤처졌는데, 순차 읽기에서는 4%, 랜덤 읽기 IOPS에서는 38%나 차이가 났으며, 비교 대상 그룹에서 가장 빠른 4세대 및 5세대 드라이브보다도 성능이 떨어졌습니다. AI 모델 로딩 테스트에서도 비슷한 결과가 나왔는데, 990과 990 Pro 모두 최하위권을 기록했습니다. DeepSeek R1 7B 로드 테스트에서는 990이 990 Pro를 약간 앞섰지만, 더 큰 모델들에서는 8~15% 정도 뒤처졌습니다. 고성능 워크로드에 필요한 최고 처리량을 요구하는 사용자라면 삼성의 다른 제품, 특히 5세대 9100 Pro를 고려해 보는 것이 좋습니다.
하지만 990을 시중에서 가장 빠른 드라이브와 비교하는 것은 이 드라이브의 본질을 놓치는 것입니다. 이 제품은 벤치마크 성능 최고치가 아닌 효율성과 가성비를 중심으로 설계된 주류 4세대 SSD이며, 실제 전작인 990 EVO와 비교하면 확실한 업그레이드입니다. 순차 쓰기 속도는 50% 이상 빨라졌고, 전력 효율은 삼성 자체 측정치에 따르면 38% 향상되었으며, 순차 읽기 속도는 990 EVO Plus와 비슷한 수준입니다. 삼성은 NAND 플래시 메모리에 대해서는 언급하지 않았지만, 내구성 등급을 보면 QLC 방식이 아닌 우수한 TLC 방식이 사용되었음을 알 수 있습니다.
Gen5 속도나 전문가급 랜덤 I/O 성능이 필요하지 않고, 합리적인 가격에 안정적이고 전력 효율이 뛰어난 Gen4 드라이브를 원하는 구매자에게 990은 EVO 라인에서 업그레이드하기에 좋은 선택입니다. 특히 990 Pro로 업그레이드해도 AI 모델 로딩 기능은 향상되지 않으므로, 두 제품 중 어떤 것을 선택할지는 AI 관련 기능보다는 랜덤 I/O와 지속 쓰기 속도에 따라 결정됩니다. 1TB 모델은 269.99달러, 2TB 모델은 529.99달러로 책정된 권장 소비자 가격은 드라이브의 보급형 포지셔닝보다는 현재 메모리 시장 상황을 반영한 것이므로, 990의 가성비는 실제 판매 가격에 따라 결정될 것입니다. 순수 성능이 최우선이라면 990은 적합한 드라이브가 아니지만, 본래의 용도에는 충실합니다.


 아마존