

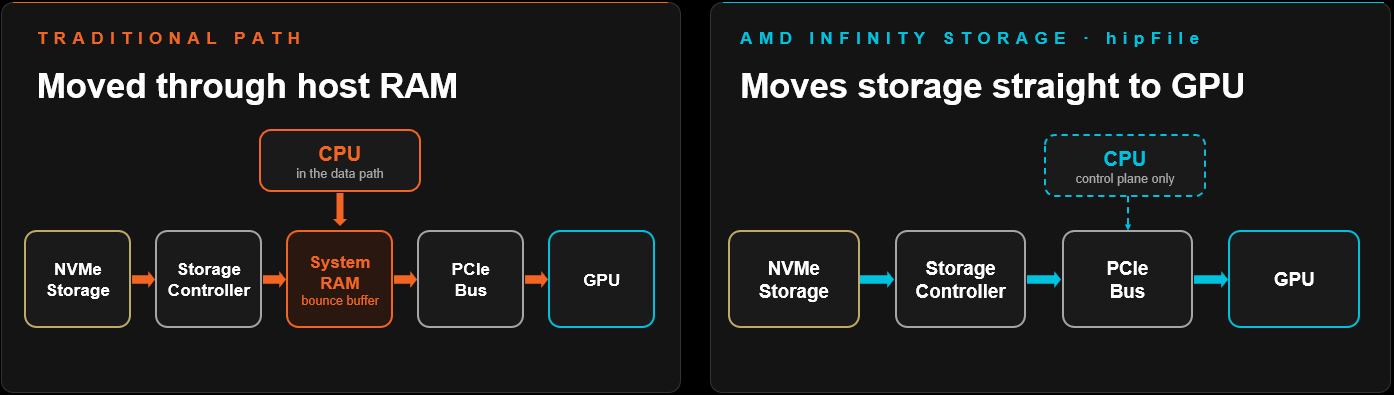
AMD ROCm 10.1, uitgebracht op 5 oktober, legt de nadruk op het pad tussen opslag en de GPU. Checkpointbestanden, key-value caches en modelgewichten overtreffen nu routinematig het geheugen van de accelerator, en wanneer dat gebeurt, begint de tijd die nodig is om gegevens te verplaatsen de iteratietijd meer te bepalen dan de berekeningen zelf. Deze release bouwt voort op AMD Infinity Storage, de directe opslagstack die in ROCm 7.14 werd geïntroduceerd, door opslagtoegang te integreren in de HIP-runtime en NUMA-compatibel hostgeheugen toe te voegen, zodat gegevens de GPU bereiken zonder omweg via het CPU-geheugen.
Directe GPU-opslagpipelines en NUMA-compatibel geheugen
De hipFILE-bibliotheek in AMD Infinity Storage krijgt een asynchrone fast-path-backend. Lees- en schrijfverzoeken worden direct uitgevoerd op een HIP-stream, waardoor de stap van het voorbereiden in het hostgeheugen die het traditionele pad vereist, wordt overgeslagen. Volgens AMD resulteert dit in een lagere latentie voor checkpoint-engines en KV-cache-offload, terwijl de bandbreedte behouden blijft. In de release-opmerkingen worden de aanroepen genoemd: hipFileReadAsync() en hipFileWriteAsync() ondersteunen nu het fast-path-pad.
Een batch-I/O-API dient meerdere bestandsverzoeken tegelijk in en verdeelt deze over een interne pool van workerthreads. Hierdoor blijven de opslagwachtrijen vol wanneer een trainingstaak een grote dataset verwerkt. De telemetrie groeit mee: hipFileGetStatsL1, L2 en L3 leveren steeds gedetailleerdere I/O-statistieken op. Deze tellers voeden de ROCm-profilers, zodat een operator kan vaststellen of een pipeline wordt beperkt door rekenkracht, geheugen of datalevering.
Op hosts met twee sockets betaalt een buffer die op de verkeerde socket is toegewezen een inter-socket-penalty bij elke overdracht. ROCm 10.1 breidt de HIP virtuele geheugenbeheer-API's uit met hipMemLocationTypeHostNuma en hipMemLocationTypeHostNumaCurrent, zodat hostgeheugen op een specifiek NUMA-knooppunt kan worden geplaatst gedurende de volledige levenscyclus van aanmaken, reserveren, toewijzen en verwijderen. Bibliotheken zoals RCCL kunnen daar bovenop NUMA-lokale, zero-copy communicatiebuffers bouwen en het verkeer tussen host en apparaat buiten de socket-interconnect houden.
ROCm CLI v1.0.0 en AI Agent-workflows
ROCm CLI is nu beschikbaar als versie 1.0.0, een enkel binair bestand voor Linux, Windows en WSL2 waarmee lokale AI-workloads op AMD GPU's kunnen worden geïnstalleerd, geconfigureerd en uitgevoerd. Het detecteert de flash-attn- en amd-aiter-wheels die vLLM nodig heeft, ondersteunt de bijgewerkte pakketstructuur van ROCm 10 en voegt een optie toe voor volledig niet-interactieve installaties in gescripte of CI-omgevingen. Een TUI-dashboard op volledig scherm toont live GPU-telemetrie naast de modelserver en een lokaal chatvenster om te controleren of een endpoint reageert.
AMD Skills, de pakketintegraties voor codeeragents zoals Claude Code en Codex, voegt er nog twee toe. quark-install installeert AMD Quark met een bijbehorende PyTorch-build, en quark-torch-llm-ptq voert post-trainingskwantisatie uit op PyTorch- en Hugging Face LLM's met schema's zoals FP8 en INT4.
Modernisering van profilering en telemetrie
De ROCprofiler-SDK voegt kernel-replay toe (in bèta). GPU-hardware biedt een beperkt aantal prestatiemeters per dispatch, waardoor het verzamelen van een volledige set tellers voorheen betekende dat de hele applicatie één keer per tellergroep opnieuw moest worden uitgevoerd. Kernel-replay voert elke dispatch ter plaatse opnieuw uit, reset het GPU-geheugen tussen de passes en verzamelt de volledige set in één keer. De SDK maakt het ook mogelijk om profiling op elk punt in een run te starten en te stoppen voor PyTorch Kineto en Triton Proton, en bevat een PC-sampling agent skill die een codeerassistent door rocprofv3 PC-sampling leidt om rekenvertragingen te vinden.
Het roofline-rapport van ROCm Compute Profiler is nu een interactieve HTML-pagina, waardoor een engineer een enkele kernel kan isoleren en de as voor de rekenintensiteit tussen cacheniveaus kan schakelen. PC-samplingrapporten per kernel, tot op het niveau van het aantal samples en stalls per instructie, en een nieuwe handleiding behandelt het profileren van vLLM. ROCm Systems Profiler voegt Linux-tracing toe voor Gorgon Point 1, 2 en 3 APU's (gfx1150, gfx1152 en gfx1153), en ROCm Optiq visualiseert nu rocprofv3-profielen naast Systems Profiler-traces en Compute Profiler-analyses.
AMD SMI (amd-smi) vervangt ROCm SMI, dat in deze release uit de standaard build is verwijderd. Het ondersteunt AMD GPU's, CPU's en APU's op Linux en Windows, zowel op bare metal als gevirtualiseerd, met een CLI, een C-bibliotheek (amd_smi_lib) en bindings voor Python, Go en Rust. De ondersteuning voor containers strekt zich uit tot containerd, CRI-O, Podman, LXC en LXD, inclusief Kubernetes-pods, zodat een clusterbeheerder GPU-processen en -gebruik kan afstemmen op de container waarop ze draaien.
Kernupdates voor de compiler, bibliotheken en runtime-ondersteuning
De toolchain is geüpgraded van LLVM 23 naar LLVM 24, en de clang_major macro rapporteert nu versie 24. Iedereen die compilerversies vastzet of linkt met libLLVM doet er goed aan dit te controleren voordat ze upgraden. Incrementele builds worden sneller door het cachen van de partities die tijdens de linktijdoptimalisatie van de apparaatcode worden gecreëerd, waardoor ongewijzigde partities bij de volgende build opnieuw worden gebruikt.
Composable Kernel versnelt de aandacht op Radeon GPU's en voegt meer gekwantiseerde matrixvermenigvuldigingstypen toe aan de dispatcher. MIGraphX wisselt zijn backend-compiler van rocMLIR naar rocMLIRTriton, wat volgens AMD de inferentieprestaties verbetert en de compilatietijd van modellen vaak verkort, terwijl de compiler gelijke tred houdt met de upstream Triton. rocSPARSE voert driehoekige oplossingen rechtstreeks uit op matrices die zijn opgeslagen in het ELLPACK (ELL)-formaat, zonder voorafgaande conversiestap.
hipThreads, een nieuwe toevoeging aan de threading-bibliotheken van de ROCm Core SDK, brengt standaard C++-threadingconcepten naar AMD GPU's op Linux en Windows. Het doel is om bestaande CPU-threaded code te versnellen op de GPU zonder deze volledig te hoeven herschrijven naar HIP-kernels en synchronisatieprimitieven.
Windows Subsystem for Linux 2 (WSL2) is nu beschikbaar als technische preview. Standaard Linux-pakketten worden geïnstalleerd in het gastbesturingssysteem, terwijl GPU-paravirtualisatie de taken overdraagt aan het Windows-hoststuurprogramma. De preview omvat .deb-pakketten en Python wheels, maar geen RPM's. Profiling, debugging en KFD-afhankelijke tools werken nog niet binnen WSL2. Wat virtualisatie betreft, wordt KVM SR-IOV nu ondersteund met Ubuntu 26.04 LTS, zowel als host als gast, in combinatie met versie 9.3.0.K van AMD's GIM-virtualisatiestuurprogramma.
De lijst met ondersteunde hardware omvat nu ook de Radeon AI PRO R9600, samen met de Instinct MI355X, MI350X en MI350P, de MI300- en MI200-serie, de rest van de Radeon AI PRO R9700-familie en Ryzen AI-processors.


 Amazon