

CoreWeave heeft een multi-rack NVIDIA Vera Rubin NVL72 -cluster geïmplementeerd op CoreWeave Cloud, waarmee honderden Rubin GPU's worden verbonden tot één schaalbare omgeving die is gericht op agentische AI-workloads. Elk door Dell gebouwd rack bevat 72 Rubin GPU's, 36 Vera CPU's, NVLink 6 als schaalbare fabric, BlueField-4 DPU's en twee ConnectX-9 SuperNIC's per GPU. De racks zijn met elkaar verbonden via NVIDIA Spectrum-X Ethernet in een tweelaags, niet-blokkerend fabric dat volgens CoreWeave schaalbaar is tot ongeveer 128,000 GPU's. CoreWeave is de eerste cloudprovider die een enkele Vera Rubin NVL72 heeft gevalideerd en in gebruik genomen, en de eerste die de gemeten prestaties ervan publiceert. De eerste peer-reviewed cijfers van het platform verschenen vorige week in MLPerf Inference v6.1 , waar CoreWeave's eigen inzending draaide op een GB300 NVL72. Naast de rekenkracht biedt CoreWeave AI Object Storage ook schrijfversnelling tussen regio's en een nieuwe archiveringslaag.
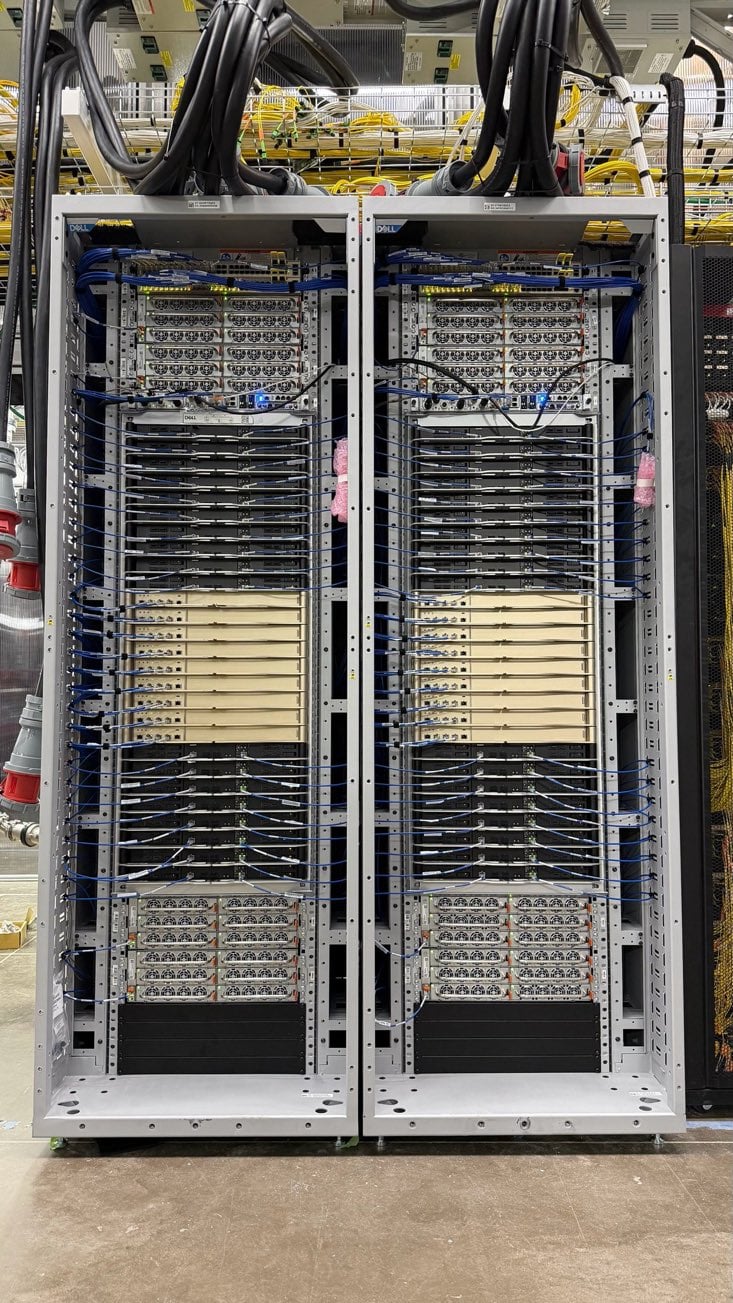
Multi-Rack NVIDIA Vera Rubin NVL72-architectuur
De multi-rack-configuratie is gericht op agentische uitvoeringspaden, waarbij seriële redeneerlussen en aanroepen van externe tools de latentie bij gegevenstoegang over gedistribueerde infrastructuur verhogen. De twee ConnectX-9 SuperNIC's op elke Rubin GPU bieden tot 1.6 Tb/s aan backend-netwerkconnectiviteit per GPU via multi-rail, multi-plane paden. CoreWeave beschrijft de fabric als modulair, waardoor extra NVL72-racks aan dezelfde niet-blokkerende topologie kunnen worden toegevoegd naarmate de capaciteit groeit. De racks worden gekoeld met vloeistofkoeling op 45 °C.
CoreWeave verbindt de racks met elkaar via de Mission Control-software. Een Rack LifeCycle Controller beheert de provisioning en de levenscyclus van elk rack, inclusief hardwaredetectie via firmware-flashing, validatie, stroomvoorziening en thermische circuits. Een rackmanagementlaag genaamd Racky regelt de stroomvoorziening en de infrastructuur, en een programmeerbare koelcontroller genaamd Valvey biedt softwarematige zichtbaarheid en controle over de vloeistofkoelingscircuits en omgevingssensoren.
Racks worden pas in productie genomen na een gefaseerde validatieprocedure. Op node-niveau betekent dit urenlange, herhaalde GPU-diagnostiek, controle van de gegevensoverdracht tussen CPU en GPU, validatie van de interconnectie en de temperatuur onder belasting, en realistische trainingsruns. Op rack-niveau verifiëren gesynchroniseerde taken over alle 72 GPU's de NVLink GPU-naar-GPU-prestaties, en elk systeem dat onder het verwachte bereik presteert, wordt verder onderzocht. CoreWeave voert over de racks heen gedistribueerde workloads uit, schakelt de NVLink-paden bewust uit om het verkeer via het backend-netwerk te leiden, en bewaakt de fysieke infrastructuur op instabiele verbindingen, stijgende foutpercentages, oververhitte hardware en onregelmatig verkeer, met belastingpatronen die agentapplicaties nabootsen: plotselinge pieken in de vraag, wisselende gelijktijdigheid en communicatiepieken. De beschrijving van CoreWeave over het opstarten van meerdere racks beschrijft elke fase en is zeer interessant om te lezen.
Updates voor AI-objectopslag: Schrijven tussen regio's en archiveringslaag
De opslagfunctionaliteit is gebaseerd op CoreWeave AI Object Storage en de Local Object Transport Accelerator (LOTA), een cachingproxy die draait op elke GPU- en CPU-node in CoreWeave Kubernetes Service en objecten opslaat op NVMe-geheugen dat lokaal op de node is opgeslagen. CoreWeave meldt leessnelheden tot 7 GB/s per GPU met een p99-leeslatentie die meer dan 8 keer lager is dan bij lezen rechtstreeks vanuit de bucket. Een voorbeeld hiervan is een aanbieder van een grensverleggend model die LOTA gebruikt op meer dan 15,000 GPU's en 20 PB cache met een hitrate van 99.7 procent. LOTA is gratis.
Cross-region write acceleration stelt een applicatie in staat om met lokale latentie naar een bucket in een externe regio te schrijven zonder dat er wijzigingen in de API of SDK nodig zijn. De applicatie voert een standaard S3-schrijfopdracht uit naar het LOTA-eindpunt; de objectgegevens worden permanent in de lokale regio opgeslagen, terwijl de metadata naar de externe regio worden gecommit; het object is direct leesbaar, ook door de taak die het heeft geschreven; en de gegevens worden op de achtergrond naar de externe regio gemigreerd. Applicaties zien één bucket-namespace in alle regio's met uniforme IAM-beleidsregels, levenscyclusregels en toegangsrechten, waardoor de per-regio forks en replicatiepipelines die normaal gesproken nodig zijn voor checkpointdistributie over verschillende locaties, overbodig worden.
"Onze datasets beslaan meerdere regio's en we kunnen het ons niet veroorloven dat ons trainingsschema afhankelijk is van vertragingen bij het ophalen van gegevens uit verschillende regio's", aldus Cécile Robert-Michon, directeur interne infrastructuur bij Cohere. "CoreWeave AI Object Storage biedt ons een uniforme datasetstructuur voor alle regio's, waarbij leesbewerkingen lokaal in de cache worden opgeslagen, zodat er geen wachttijden op het netwerk zijn."
De Archive-laag is een vierde opslagklasse naast Hot, Warm en Cold, bedoeld voor data die eenmalig wordt geschreven en zelden wordt gelezen, zoals oudere trainingscheckpoints en ruwe datasets. Deze laag heeft een lagere basiscapaciteit en er worden geen kosten in rekening gebracht voor ophalen, cachen, kosten per aanvraag, vroegtijdige verwijdering, tiering en uitgaand dataverkeer. CoreWeave stelt voor om recente checkpoints in de snellere lagen te bewaren voor onmiddellijke herstarts en ze na 60 dagen zonder leesbewerking automatisch naar Archive te verplaatsen. Zowel cross-region writes als de Archive-laag zijn nu beschikbaar; de configuratiegegevens zijn te vinden in het bericht van CoreWeave over opslag .


 Amazon