

MLCommons heeft MLPerf Inference v6.1 gepubliceerd. Deze ronde heeft een recordaantal deelnemers: 30 organisaties hebben resultaten ingediend en er zijn 486 datacenter- en edge-resultaten gegenereerd. Twee nieuwe tests zijn aan de suite toegevoegd: een end-to-end RAG-pipeline voor datacenters en een Edge Agentic Inference-benchmark voor apparaten met één gebruiker. De resultaten bevatten de eerste peer-reviewed cijfers voor NVIDIA's Vera Rubin NVL72, AMD's Instinct MI350P, Intel's Arc Pro B70 en AMD's Ryzen AI Max+ 395. Wat betreft de verbetering meldt MLCommons dat het beste DeepSeek-R1-resultaat per accelerator in het serverscenario 5.7 keer beter is dan in v5.1 een jaar geleden, en dat het beste VLM-resultaat in de zes maanden sinds v6.0 met een factor 2.99 is verbeterd.
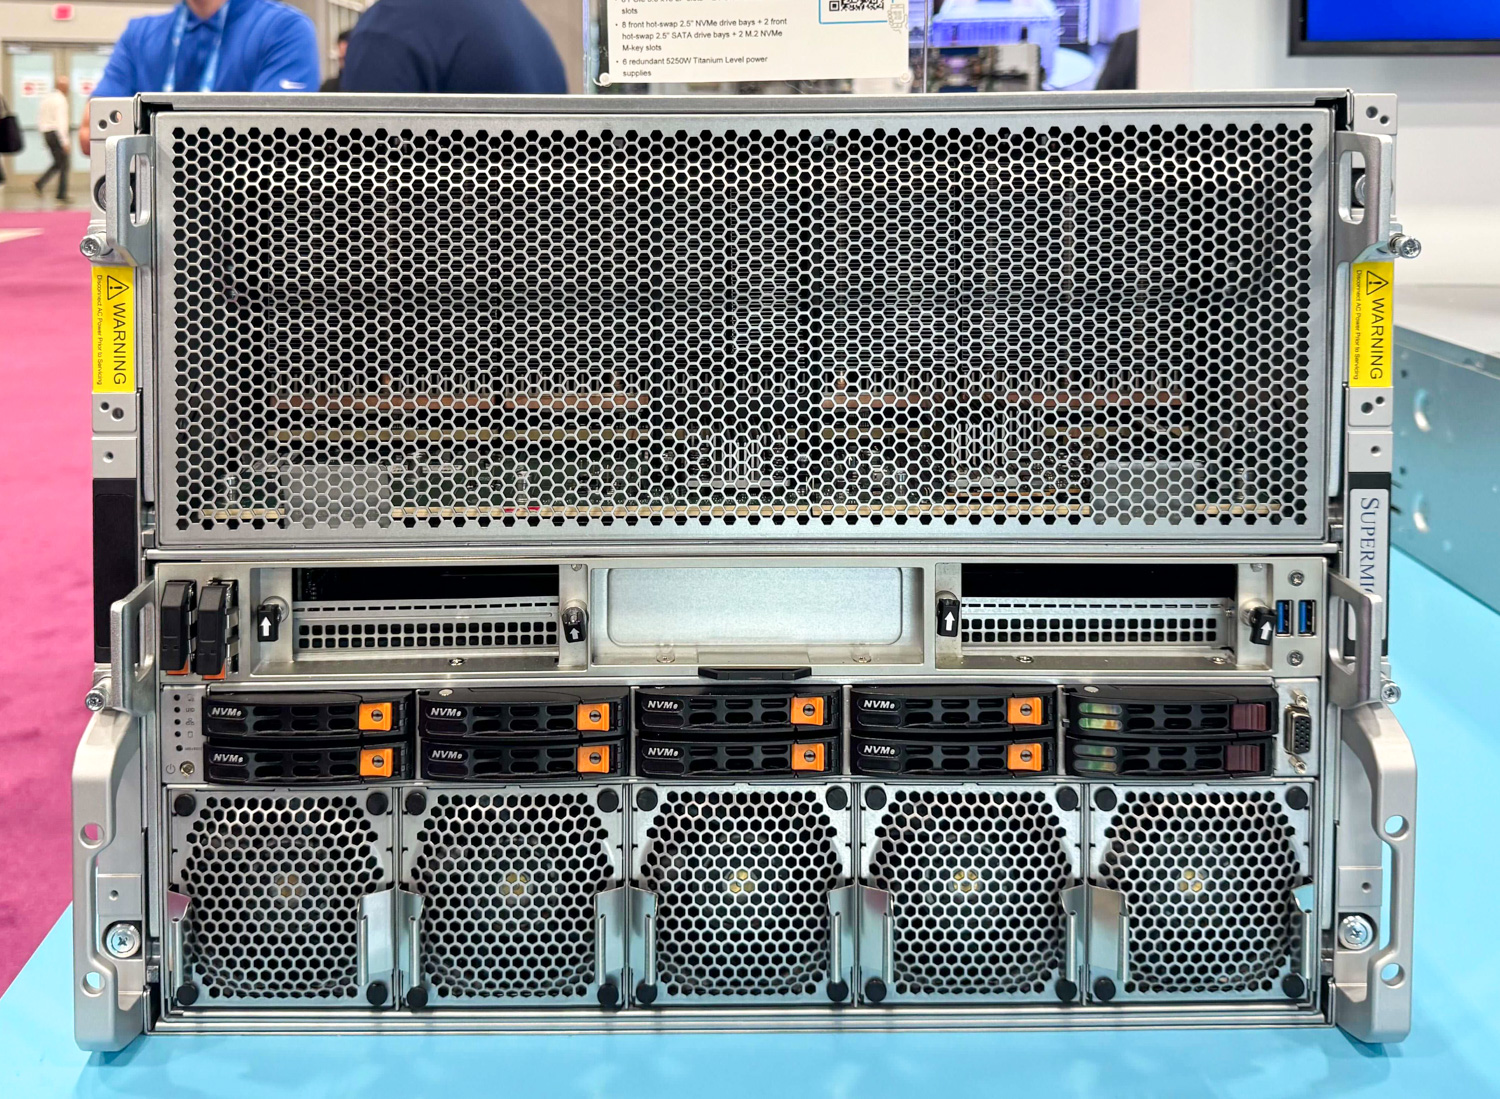
Twee nieuwe tests: End-to-End RAG en Edge Agentic Inference
De End-to-End RAG-benchmark meet een complete vraag-antwoordpipeline, bestaande uit meerdere modellen en een vectordatabase die samenwerken. De referentie-implementatie gebruikt vier modellen tegelijk: gpt-oss-120B behandelt de decompositie van de query, de controle op voldoende informatie en het genereren van antwoorden; gpt-oss-20B beoordeelt de opgehaalde documenten; e5-base-v2 produceert embeddings; en ColBERTv2 herrangschikt passages. Het corpus bestaat uit 107,484 passages, afkomstig uit 2,515 HTML-bestanden; de vragen zijn 824 multi-hop taken uit de FRAMES-dataset van Google; en elke taak kan tot 5 retrievalrondes doorlopen voordat de pipeline besluit dat er voldoende bewijs is. Er worden twee meetwaarden gebruikt: documenten per seconde voor het opbouwen van de FAISS HNSW-vectordatabase en taken per seconde voor het beantwoorden van vragen op basis daarvan. Een Llama 3.1-8B-jury beoordeelt de eindantwoorden aan de hand van een streefwaarde van 97% nauwkeurigheid, en er is geen tijdslimiet voor de beoordeling.
De Edge Agentic Inference-benchmark richt zich op het codeerassistent-patroon dat is doorgedrongen tot werkstations en desktop AI-systemen. Het model is Qwen3.6-27B met de denkfunctie uitgeschakeld, uitgevoerd als een Q4_K_M GGUF onder llama.cpp in de referentie, met een contextvenster van 32 per beurt. De prestatiebelasting is een opgenomen herhaling van 20 agentische codeertrajecten uit SWE-bench Verified, in totaal 1,007 beurten, uitgevoerd in één stream met één verzoek tegelijk, zoals een ontwikkelaar op een laptop een agent uitvoert. De gerapporteerde metriek is de gemiddelde latentie per beurt, met daarnaast de verdeling van de tijd tot het eerste token en de tijd per uitvoertoken. De nauwkeurigheid wordt afzonderlijk gemeten door BFCL v4 op 97% van de referentiescore. MLCommons heeft het framework aangepast van zijn aankomende MLPerf Agentic datacenterbenchmark.
"We hebben de End-to-end RAG-test toegevoegd omdat het duidelijk is dat query-answering verder is geëvolueerd dan alleen een LLM getraind op een corpus; belanghebbenden moeten inzicht hebben in de prestaties in de praktijk van de soorten meerstaps, meercomponenten pipelines die tegenwoordig worden gebouwd", aldus Miro Hodak, co-voorzitter van de MLPerf Inference-werkgroep. "Evenzo hebben we de Edge Agentic Inference-test toegevoegd omdat complexe inferentiesystemen met agentische eigenschappen steeds vaker worden gehost op edge computing-apparaten, wat een nieuwe reeks prestatie-uitdagingen met zich meebrengt voor onze klanten."
Deze ronde breidt ook de ondersteuning voor speculatieve decodering, die voorheen beperkt was tot DeepSeek-R1, uit naar de GPT-OSS-benchmark in het interactieve scenario, en definieert een nieuw interactief scenario voor de VLM-test met responstijden van ongeveer 1.5 seconde.
Nieuwe siliciumtechnologie: van desktop tot rack.
De Vera Rubin NVL72 van NVIDIA maakt zijn debuut op MLPerf in de preview-categorie, ingediend door NVIDIA en Nebius met hun VR200 NVL72. NVIDIA meldt een tot 2.5 keer hogere token-doorvoer dan de GB300 NVL72 op DeepSeek-R1 in offline, server- en interactieve scenario's met TensorRT-LLM, en tot 3.7 keer hoger op het Qwen3-visie-taalmodel met vLLM en NVIDIA Dynamo. Dit zijn NVIDIA's vergelijkingen met hun eigen vorige generatie, en de preview-aanduiding betekent dat het platform naar verwachting commercieel beschikbaar zal zijn in de volgende ronde.
AMD heeft zijn inzending voor MLPerf Inference 6.1 uitgebreid naar zes modelfamilies voor taken op het gebied van taalverwerking, redeneren, tekst-naar-video en aanbevelingen, waarbij gebruik wordt gemaakt van de Instinct MI355X, MI350X en de nieuwe MI350P PCIe-kaart. Het Crusoe-cluster met 512 GPU's, gebouwd op de MI355X, wordt hieronder beschreven, samen met AMD's eigen analyse van de ronde.
De Intel Arc Pro B70 verschijnt in een node met vier GPU's en 128 GB gecombineerd VRAM, die Intel gebruikte voor Llama 3.1-8B, Llama 2-70B, gpt-oss-120B, Whisper en de nieuwe E2E-RAG-test. Intel meldt dat gpt-oss-120B een verbetering van 36% liet zien in serverconfiguraties en 27% in offlineconfiguraties ten opzichte van versie 6.0 op dezelfde hardware. Wat de CPU betreft, zegt Intel dat de serverdoorvoer van de Xeon 6980P Llama 3.1-8B met een factor 2.4 is gestegen ten opzichte van versie 6.0 op identieke siliciumchips, een winst die uitsluitend door softwareverbeteringen is behaald.
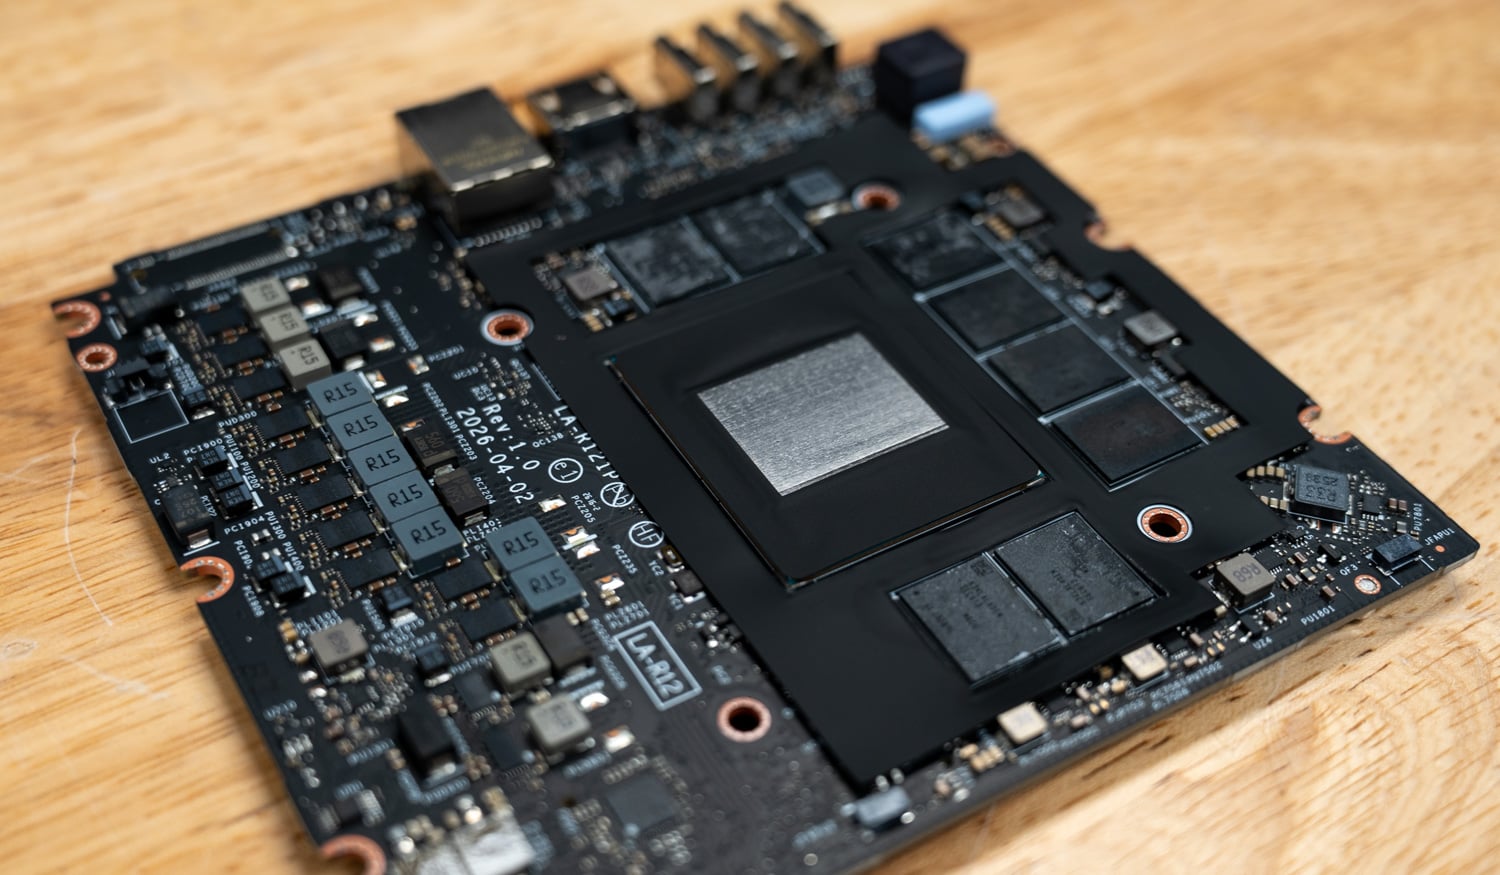
De Ryzen AI Max+ 395 is verschenen in de resultaten van Atlas Inference, een nieuwe inzender die de nieuwe Edge Agentic-workload heeft uitgevoerd op zowel een NVIDIA DGX Spark als een AMD Strix Halo desktop met dezelfde engine en kwantiseringsmethode. Atlas rapporteert 20.1 tokens per seconde op de DGX Spark, waarbij alle 1,007 beurten in minder dan 64 minuten werden voltooid, en 19.63 tokens per seconde op de Strix Halo. Dat is een kleiner verschil dan we tussen de twee platforms hebben gemeten met standaard runtimes in onze reviews van de Ryzen AI Halo en DGX Spark , en het is precies het soort resultaat dat de nieuwe benchmark beoogt te laten zien.
Groter, diverser en meer verspreid.
Het aantal inzendingen met meerdere nodes bereikte dit keer een record, tegenover nul in versie 4.0, en drie springen eruit. Crusoe, eveneens een debutant, draaide het grootste systeem in de geschiedenis van MLPerf Inference met AMD: 512 Instinct MI355X GPU's verdeeld over 64 nodes op een standaard RoCE Ethernet-netwerk, ingediend voor gpt-oss-120b en DeepSeek-R1. AMD rapporteert 5.75 miljoen tokens per seconde in het offline scenario en 5.39 miljoen in de servermodus voor gpt-oss-120b vanuit dat cluster, en 2.90 miljoen offline en 2.41 miljoen in de servermodus voor DeepSeek-R1, wat AMD de hoogste totale tokendoorvoer in de geschiedenis van MLPerf noemt, waarbij de doorvoer vrijwel lineair schaalt van 1 tot 64 nodes. De gpt-oss-120b-run diende het model als 512 onafhankelijke replica's met één GPU in native MXFP4; DeepSeek-R1 gebruikte SGLang met één replica van acht GPU's per node. AMD noemt afzonderlijk een GPT-OSS-120B-inzending met 72 GPU's, een schaalbaarheidsefficiëntie van 95% en 1 miljoen tokens per seconde, dezelfde prestatie die het behaalde met MI355X in versie 6.0.
Cisco diende het eerste heterogene systeem met meerdere leveranciers in voor de benchmark, waarbij acht NVIDIA H200 en acht AMD Instinct MI350X GPU's werden samengevoegd tot één inferentiepool via een Cisco Silicon One G200-netwerk. Dit is dezelfde gemengde acceleratoraanpak die Cisco ook aanbiedt via zijn Secure AI Factory . De geografisch verspreide inzending kwam van MangoBoost in samenwerking met Dell: vier locaties op twee continenten, gehost door MangoBoost, Dell, TensorWave en Microsoft Azure, verspreid over de Stille Oceaan en draaiend als één eindpunt met een schaalbaarheidsefficiëntie van 97%, aldus MangoBoost. MangoBoost claimt tevens de eerste resultaten met gedisaggregeerde prefill/decode-gegevens voor AMD Instinct GPU's.
In andere resultaten meldt CoreWeave een totaal van 1.16 miljoen tokens per seconde op GB300 NVL72, met een offline doorvoer per GPU die sinds versie 6.0 met 17% is gestegen. HPE noemt 8,500 tokens per seconde per GPU op DeepSeek-R1, verdeeld over twee Compute XD690-servers met Blackwell Ultra. Google concentreerde zich in zijn inzending op DeepSeek-R1, verwijzend naar de verschuiving in de industrie naar grote modellen met een mix van experts. gpt-oss-120b ontving 112 inzendingen, het hoogste aantal van alle MLPerf-workloads.
AMD's twee CDNA 4-vormfactoren: OAM en dual-slot PCIe
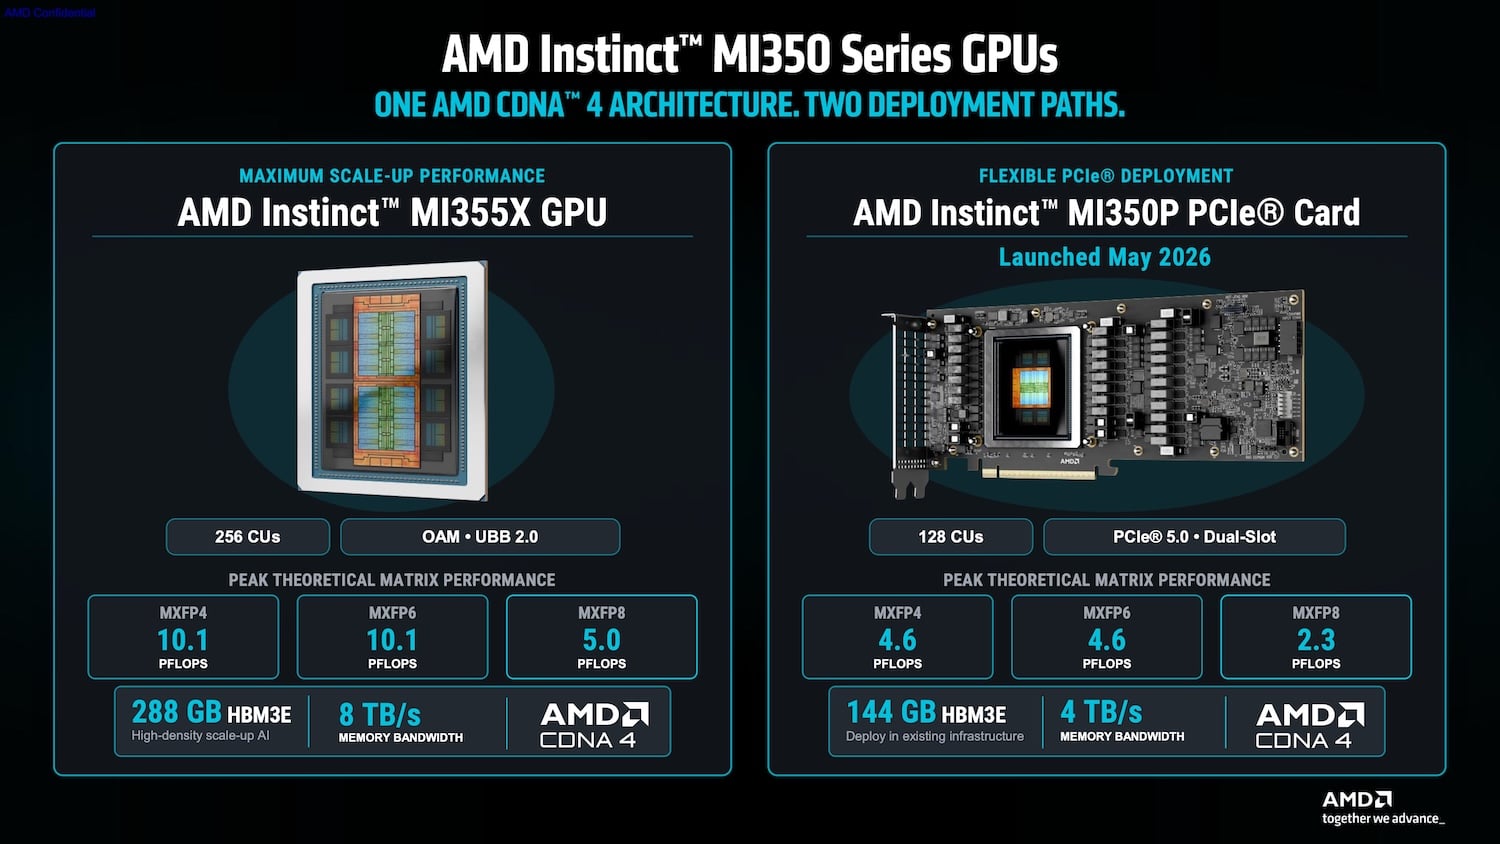
De CDNA 4-architectuur van AMD is beschikbaar in twee fysieke vormfactoren om te voldoen aan specifieke eisen op het gebied van stroomvoorziening en koeling in datacenters. Het vlaggenschip, de Instinct MI355X, is gericht op rekenknooppunten met een hoge dichtheid en maakt gebruik van een OAM-vormfactor op een OCP Universal Baseboard (UBB 2.0)-platform. Deze kaart biedt 256 rekeneenheden, 288 GB HBM3E-geheugen en een totale geheugenbandbreedte van 8 TB/s. De kaart levert tot 10.1 PFLOPS aan theoretische MXFP4- en MXFP6-matrixberekeningen. De recent geïntroduceerde Instinct MI350P past dezelfde CDNA 4-chip aan in een dual-slot PCIe 5.0-uitbreidingskaart voor standaard enterprise-chassis. Deze kaart biedt plaats aan 128 rekeneenheden, 144 GB HBM3E-geheugen, een bandbreedte van 4 TB/s en levert tot 4.6 PFLOPS aan theoretische MXFP4- en MXFP6-matrixberekeningen.
Softwaregestuurde generatieverbetering op identieke siliciumchips
Softwareoptimalisaties in AMD ROCm v7 leverden meetbare doorvoerwinsten op identieke MI355X-hardware op tijdens één MLPerf-cyclus. Tests op een MI355X-node met acht GPU's toonden aan dat de GPT-OSS-120B-doorvoer met 28% steeg in het offline-scenario en met 38% in het server-scenario, terwijl de Wan-2.2 SingleStream-prestaties met 70% verbeterden. Op clusterschaal behaalden 72 MI355X-acceleratoren in MLPerf 6.1 een hogere gecombineerde GPT-OSS-120B-doorvoer dan een configuratie met 94 GPU's die in ronde 6.0 werd gerapporteerd. In door AMD gepubliceerde vergelijkingen behaalde de MI355X met acht GPU's de beste resultaten ten opzichte van de NVIDIA B200 en B300 op GPT-OSS-120B, terwijl het cluster met 72 GPU's de GB200-inzending van NVIDIA overtrof.
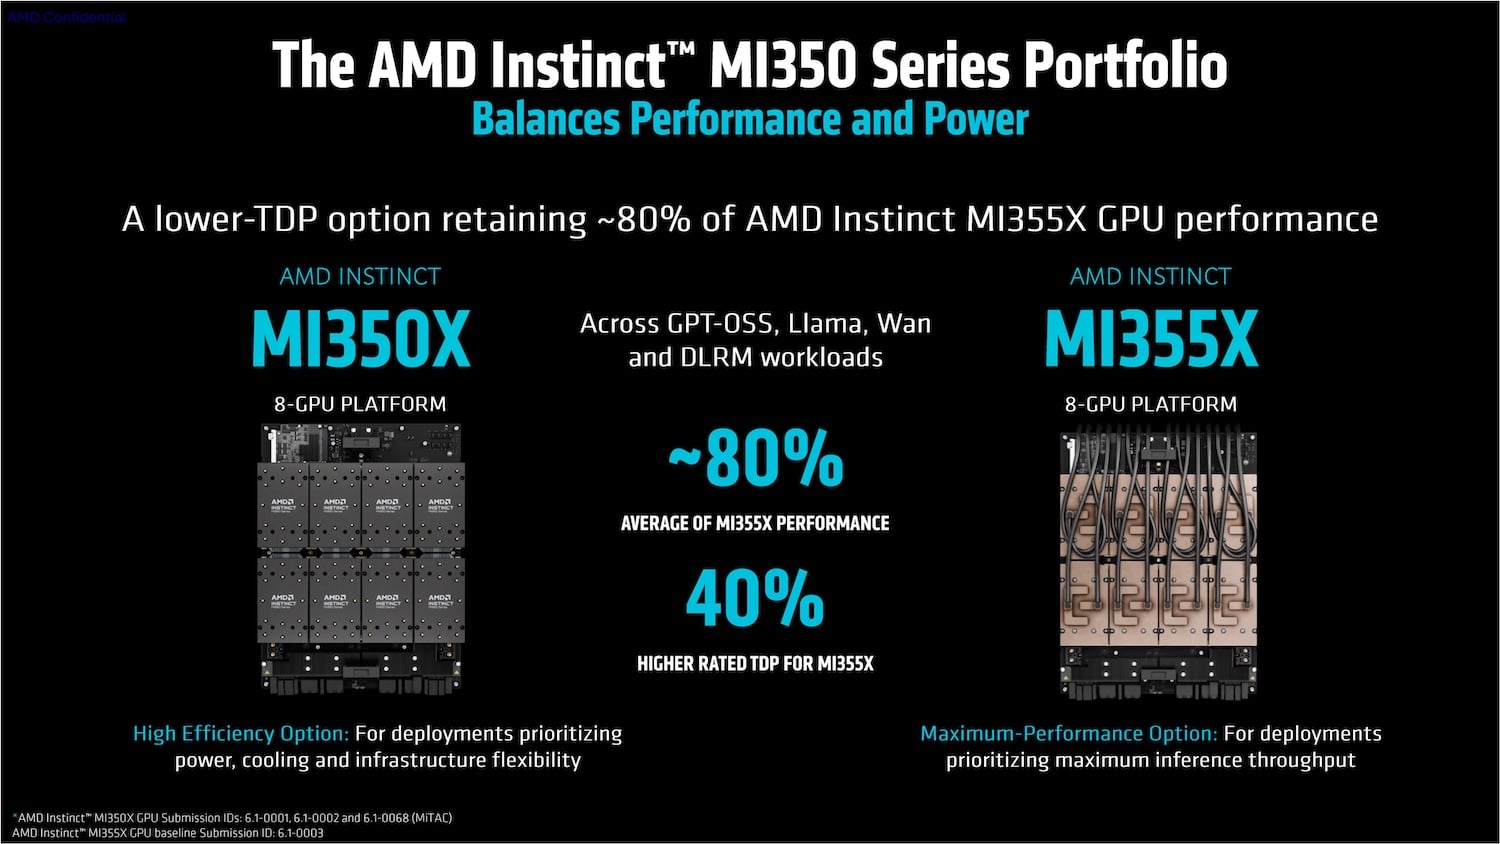
In de eerste MLPerf-ronde presteerde de dual-slot MI350P uitstekend in vijf gesloten workloads en behaalde toonaangevende resultaten ten opzichte van geselecteerde inzendingen van de NVIDIA RTX PRO 6000 Server Edition en de H200 NVL. Voor implementaties waar energie- en koelingsbudgetten een belangrijke rol spelen, behield een MI350X-systeem met acht GPU's ongeveer 80% van de benchmarkprestaties van het MI355X-platform in GPT-OSS-, Llama-, Wan- en DLRM-workloads, terwijl de MI355X een 40% hoger nominaal TDP heeft. Een onderzoek in opdracht van Signal65 toonde aan dat deze doorvoercijfers zich vertaalden in lagere operationele kosten per document en een hogere tokenoutput per dollar binnen vaste latentielimieten.
Resultaten van AMD-partners en de Korea-VS-cluster
AMD meldt dat vergelijkbare MI355X-tests van zeven partners – Dell Technologies, Oracle, Hewlett Packard Enterprise, Supermicro, MangoBoost, Crusoe en MiTAC – gemiddeld binnen 4% van de resultaten van het referentiesysteem lagen, waarbij sommige tests deze resultaten evenaarden of zelfs iets overtroffen.
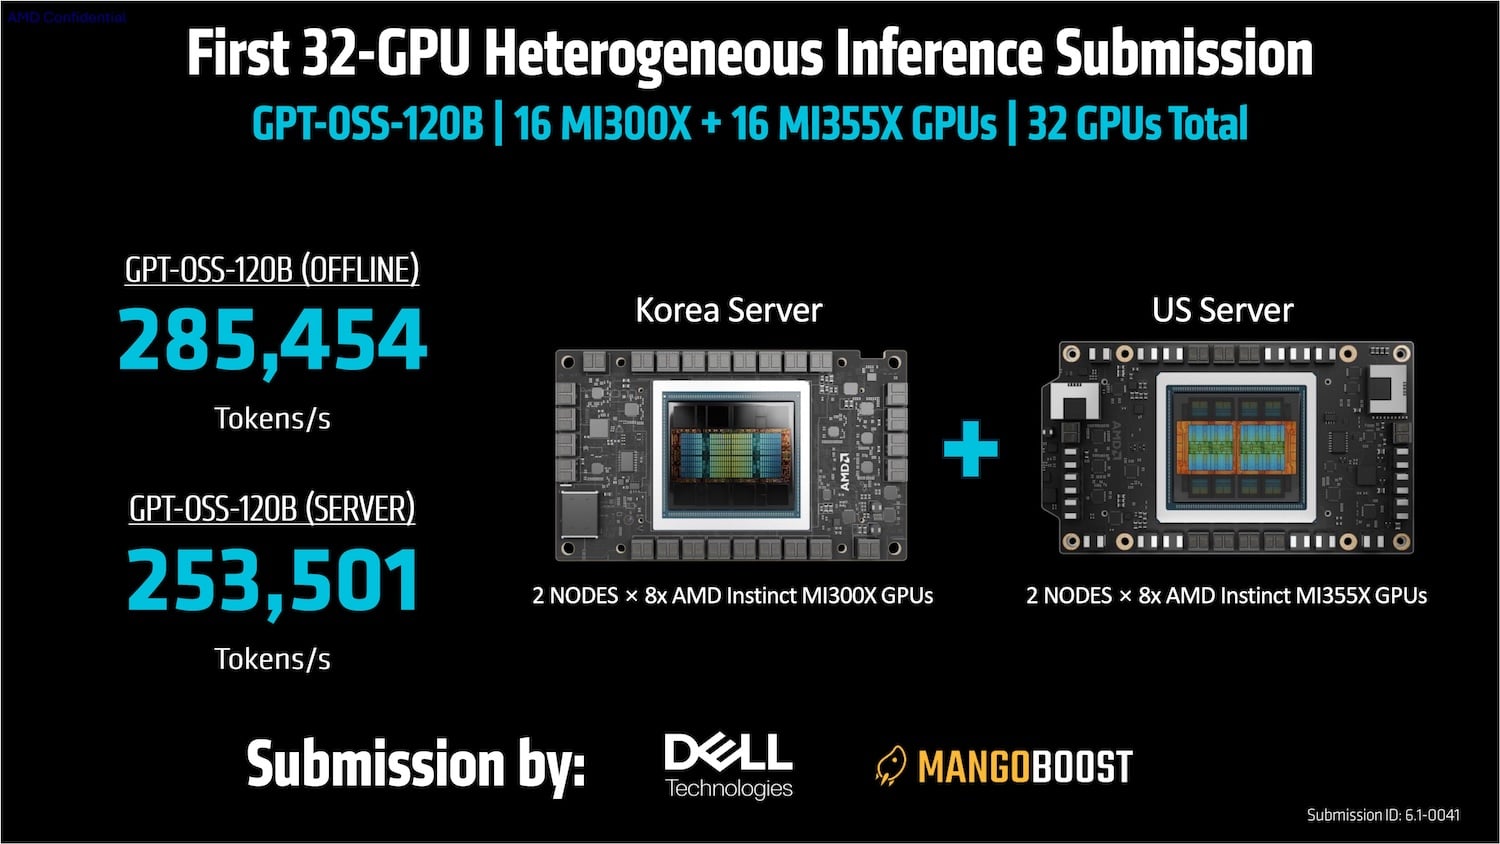
De hierboven genoemde inzending van MangoBoost en Dell is de eerste heterogene configuratie met 32 GPU's die in de benchmark is gebruikt. Deze configuratie combineert 16 Instinct MI300X GPU's van de vorige generatie in Korea met 16 Instinct MI355X GPU's in de Verenigde Staten tot één GPT-OSS-120B-eindpunt. De gesplitste clusterconfiguratie leverde 285,454 offline tokens per seconde en 253,501 servertokens per seconde. De inzendingen werden uitgevoerd op ROCm 7; AMD wijst naar de release van ROCm 10 , met de profilingtools vLLM, SGLang en ROCm.AI, als de volgende stap voor de op HBM4 gebaseerde MI400-serie en de daaropvolgende MI500-generatie.
Het instrumentarium dat MLPerf-inferentie in het datacenter vervangt.
Zestien van de 30 inzenders gebruikten deze ronde de API-georiënteerde testomgeving van MLPerf, tegenover slechts één inzender in versie 6.0 die een open testomgeving gebruikte. De testomgeving draait een echte client/server-configuratie via standaard API's tegen een gehost eindpunt, zoals ook gebruikt wordt bij datacenter-inferentie. De testomgeving ondersteunt al de nieuwe Edge Agentic-test, VLM-Interactive, gpt-oss, DeepSeek-R1, Llama 3.1-8B en tekst-naar-video. Het vormt de basis van MLPerf Endpoints, dat vanaf oktober 2026 on-demand inzendingen mogelijk maakt en MLPerf Inference in 2027 vervangt als de benchmark voor datacenters. Voor Endpoints v1.0 zijn genormaliseerde resultaten en uitgebreidere agentische workloads gepland.
"In de toekomst zal MLPerf Endpoints Inference vervangen in onze reeks benchmarks voor datacenters, en de snelle acceptatie van ons API-georiënteerde framework zal bijdragen aan een naadloze overgang", aldus David Kanter, hoofd van MLPerf. De zes nieuwe deelnemers in deze ronde zijn Atlas Inference, Crusoe, Orrick Industries, ScitiX, VibeHPC en individuele deelnemer Naeem Khoshnevis van het Kempner Institute van Harvard, die een resultaat voor de single-H200 Llama 3.1-8B heeft ingediend.
De inferentieronde volgt op de MLPerf Storage v3.0-resultaten die twee weken geleden zijn gepubliceerd, en volledige datacenter- en edge-tabellen, samen met aanvullende gegevens van de inzenders, zijn beschikbaar op de MLCommons-resultatenpagina's.


 Amazon