

HPE heeft een uitgebreide generatie HPE Cray supercomputingoplossingen geïntroduceerd, ontworpen om te voldoen aan de prestatiedichtheid, efficiëntie en operationele behoeften van AI op schaal. Het portfolio is gebaseerd op een blade-architectuur met meerdere leveranciers en meerdere workloads, uniforme systeembeheersoftware en een krachtige interconnect-infrastructuur. Dit vormt een samenhangend platform gericht op onderzoeksinstellingen, overheidsinstellingen en grote ondernemingen dat de ontdekking, simulatie en productie van AI versnelt.
Het combineren van AI- en HPC-architecturen
Het nieuwste Cray-platform van HPE combineert HPC en AI in een uniforme architectuur die deterministische prestaties op schaal levert, met de operationele controle die de IT-afdeling van bedrijven verwacht. Bij de aankondiging van het platform benadrukte Trish Damkroger, Senior Vice President en General Manager HPC en AI Infrastructure Solutions bij HPE, dat het combineren van AI- en HPC-architecturen essentieel is om de prestatiedichtheid te verhogen en nieuwe niveaus van wetenschappelijke en technologische vooruitgang te ontsluiten. Kortom, het standpunt van HPE is duidelijk: AI en supercomputing convergeren en HPE wil vooroplopen met geïntegreerde systemen die zowel onderzoek als praktijkresultaten bevorderen.
Deze uitbreiding bouwt voort op de introductie van de HPE Cray Supercomputing GX5000 vorige maand, speciaal ontwikkeld voor het geïntegreerde AI+HPC-tijdperk en nu aangevuld met de HPE Cray Supercomputing Storage Systems K3000. De K3000 is het eerste in de fabriek gebouwde opslagsysteem met ingebouwde DAOS (Distributed Asynchronous Object Storage) open-sourcesoftware, ontworpen om de prestaties te ondersteunen bij I/O-intensieve AI- en simulatieworkloads.
Snelle adoptie in toonaangevende onderzoekscentra
Het platform is al vroeg in gebruik genomen dankzij de selecties van het High-Performance Computing Center van de Universiteit Stuttgart (HLRS) en het Leibniz Supercomputing Center (LRZ) van de Beierse Academie van Wetenschappen. Hun volgende-generatiesystemen, Herder van HLRS en Blue Lion van LRZ, zullen gebruikmaken van de HPE Cray Supercomputing GX5000. Deze implementaties samen onderstrepen het momentum onder toonaangevende Europese HPC-locaties die AI-gedreven ontdekkingen willen uitbreiden met HPC-rigoureusheid op productieniveau.
Nieuwe vloeistofgekoelde, multi-vendor computerblades
HPE introduceert drie nieuwe compute blades die gecombineerd kunnen worden in een HPE Cray GX5000 rack, afgestemd op workloadprofielen, budgetten en faciliteitsbeperkingen. Alle blades maken gebruik van directe vloeistofkoeling, bieden twee on-board NVMe SSD's voor node-lokale acceleratie en integreren vier of acht HPE Slingshot 400 Gbps endpoints voor high-throughput, low-latency fabric-connectiviteit. De ondersteunde processors omvatten toonaangevende GPU's - NVIDIA Rubin en AMD Instinct MI430X - en AMD EPYC "Venice" CPU's, waardoor rekenkracht en workloadkarakteristieken nauwkeurig kunnen worden afgestemd.
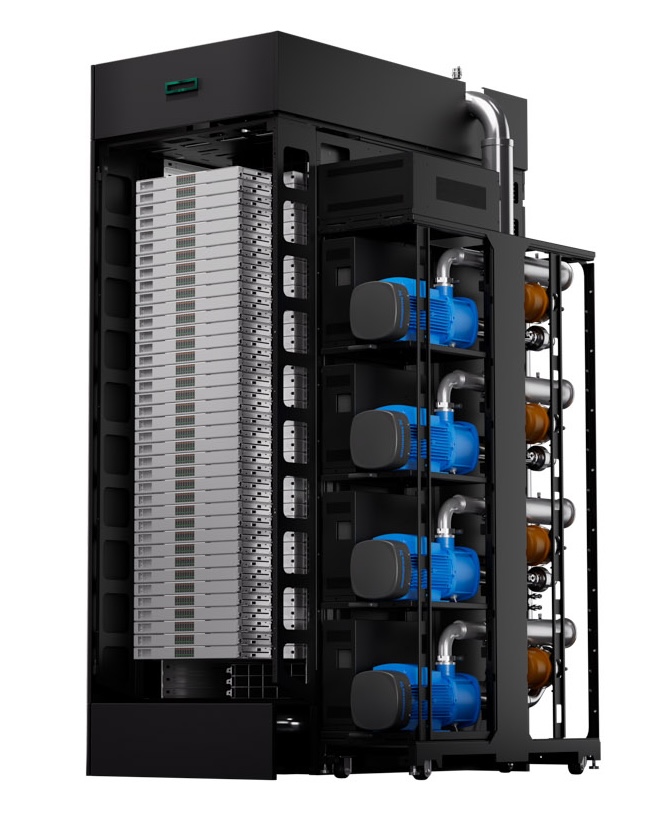
- HPE Cray Supercomputing GX440n Versnelde Blade: Deze blade is ontworpen als een universele AI-HPC-engine en combineert vier NVIDIA Vera CPU's met acht NVIDIA Rubin GPU's. Met maximaal 24 blades per rack kunnen configuraties worden geschaald tot 192 GPU's per rack, gericht op grootschalige AI-training, multi-node inferentie en versnelde simulatieworkflows.
- HPE Cray Supercomputing GX350a Versnelde Blade: De GX350a is geoptimaliseerd voor mixed-precision computing en combineert een enkele AMD EPYC SP7 600W "Venice" CPU (tot 256 cores) met vier AMD Instinct MI430X GPU's uit de MI400-serie. Deze combinatie is gericht op AI-training en HPC-acceleratie, met sterke FP16/BF16-prestaties, terwijl de dubbele precisiecapaciteit voor simulatiefasen behouden blijft: tot 28 blades per rack leveren 112 AMD MI430X GPU's.
- HPE Cray Supercomputing GX250 Compute Blade: De GX250 is gebouwd voor zware CPU-workloads met dubbele precisie (bijv. CFD, weer en traditionele simulatie) en integreert acht AMD EPYC "Venice" CPU's per blade, elk met maximaal 256 cores. Met maximaal 40 blades per rack is hij aantrekkelijk voor faciliteiten die grote MPI-taken consolideren met voorspelbaar schaalgedrag.
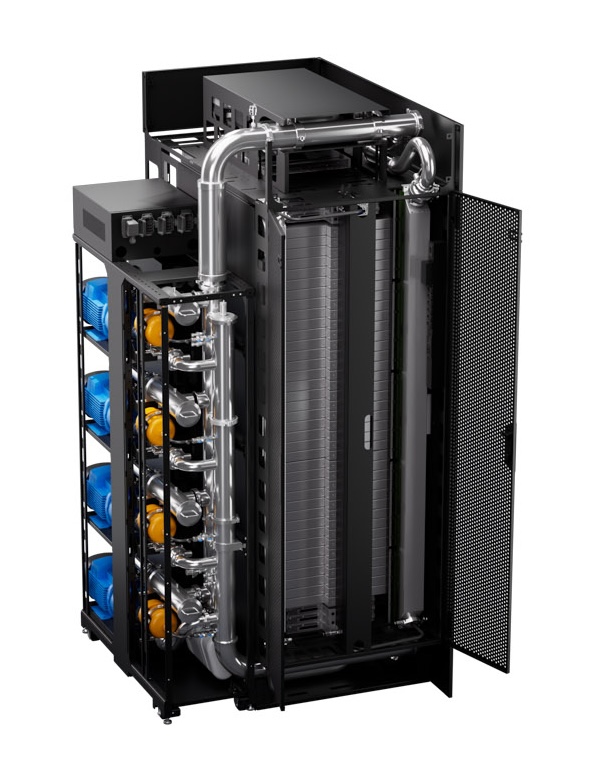
Flexibele mix van deze blades op rackniveau maakt een op maat gemaakt systeemontwerp mogelijk, variërend van GPU-intensieve AI-trainingseilanden tot CPU-gestuurde simulatiepools, zonder dat dit ten koste gaat van de stroomvoorziening, koeling of verbindingsbronnen.
Geünificeerd beheer van systemen voor meerdere tenants
De HPE Supercomputing Management Software biedt multi-tenancy en beveiliging op enterpriseniveau in bare-metal, gevirtualiseerde en gecontaineriseerde omgevingen. Het doel is om de benutting te maximaliseren en tegelijkertijd operators sterke isolatiecontrole te bieden voor gebruikers, projecten en workloads. Energiebeheer en stroomvoorziening zijn eersteklas functies. De software biedt realtime en historische telemetrie, kostenramingen en hooks voor energiebewuste planning, waardoor organisaties de energie-efficiëntie kunnen optimaliseren en kosten kunnen voorspellen.
De operationele scope bestrijkt de volledige levenscyclus van het systeem, inclusief provisioning, monitoring, toezicht op stroom/koeling en elastische schaalbaarheid, met verbeterde beveiligingscontroles en rapportage. Voor technische operationele teams is het netto-effect één controlepaneel, ontworpen voor gemengde AI- en HPC-omgevingen met een hoge bezettingsgraad.
HPE Slingshot 400 voor GX5000-gebaseerde systemen
Nu beschikbaar voor HPE Cray Supercomputing GX5000-clusters, verbetert de HPE Slingshot 400 de interconnect-infrastructuur met een direct vloeistofgekoelde switchblade-architectuur, ontworpen voor implementaties met hoge dichtheid en een constante doorvoer onder samengestelde AI+HPC-belastingen. Elke switchblade biedt 64 poorten met 400 Gbps en configuraties op chassisniveau ondersteunen:
- 8 switches met 512 poorten
- 16 switches met 1,024 poorten
- 32 switches met 2,048 poorten
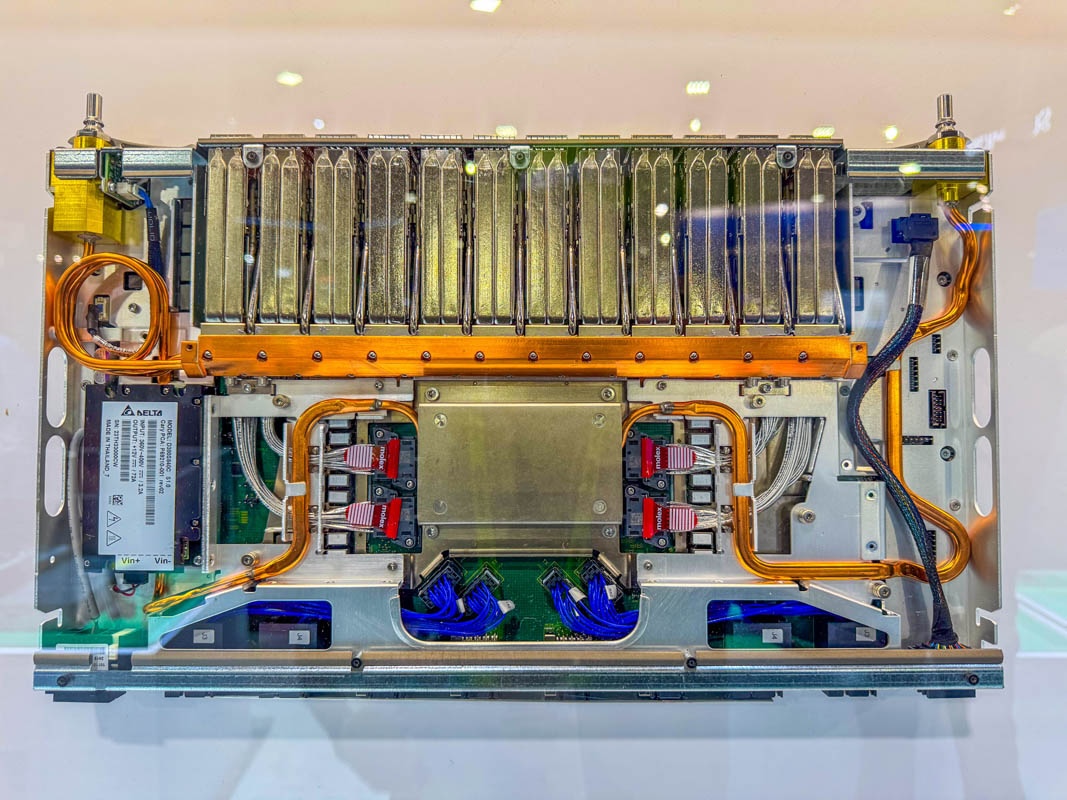
Slingshot 400, dat vorig jaar voor het eerst werd aangekondigd, is ontworpen om de krachtigere topologie van de GX5000 te benutten, latentie te verminderen, de bandbreedte te vergroten en de betrouwbaarheid te verbeteren, met behoud van kostenbeheersing. Voor multi-tenantomgevingen en gemengde workflows streeft de combinatie naar voorspelbare prestaties op schaal.
DAOS-ondersteunde opslag om I/O-gebonden AI te versnellen
De HPE Cray Supercomputing Storage Systems K3000 maakt gebruik van HPE ProLiant Compute DL360 Gen12-servers met ingebouwde DAOS om objecttoegang met lage latentie, hoge parallelliteit en lineaire schaalbaarheid te prioriteren – cruciale kenmerken voor I/O-gebonden AI-pipelines en simulatiecheckpoints. Het platform balanceert de rekenkracht per storagenode met geheugen en NVMe-dichtheid om GPU's en CPU's gelijktijdig te laten werken.
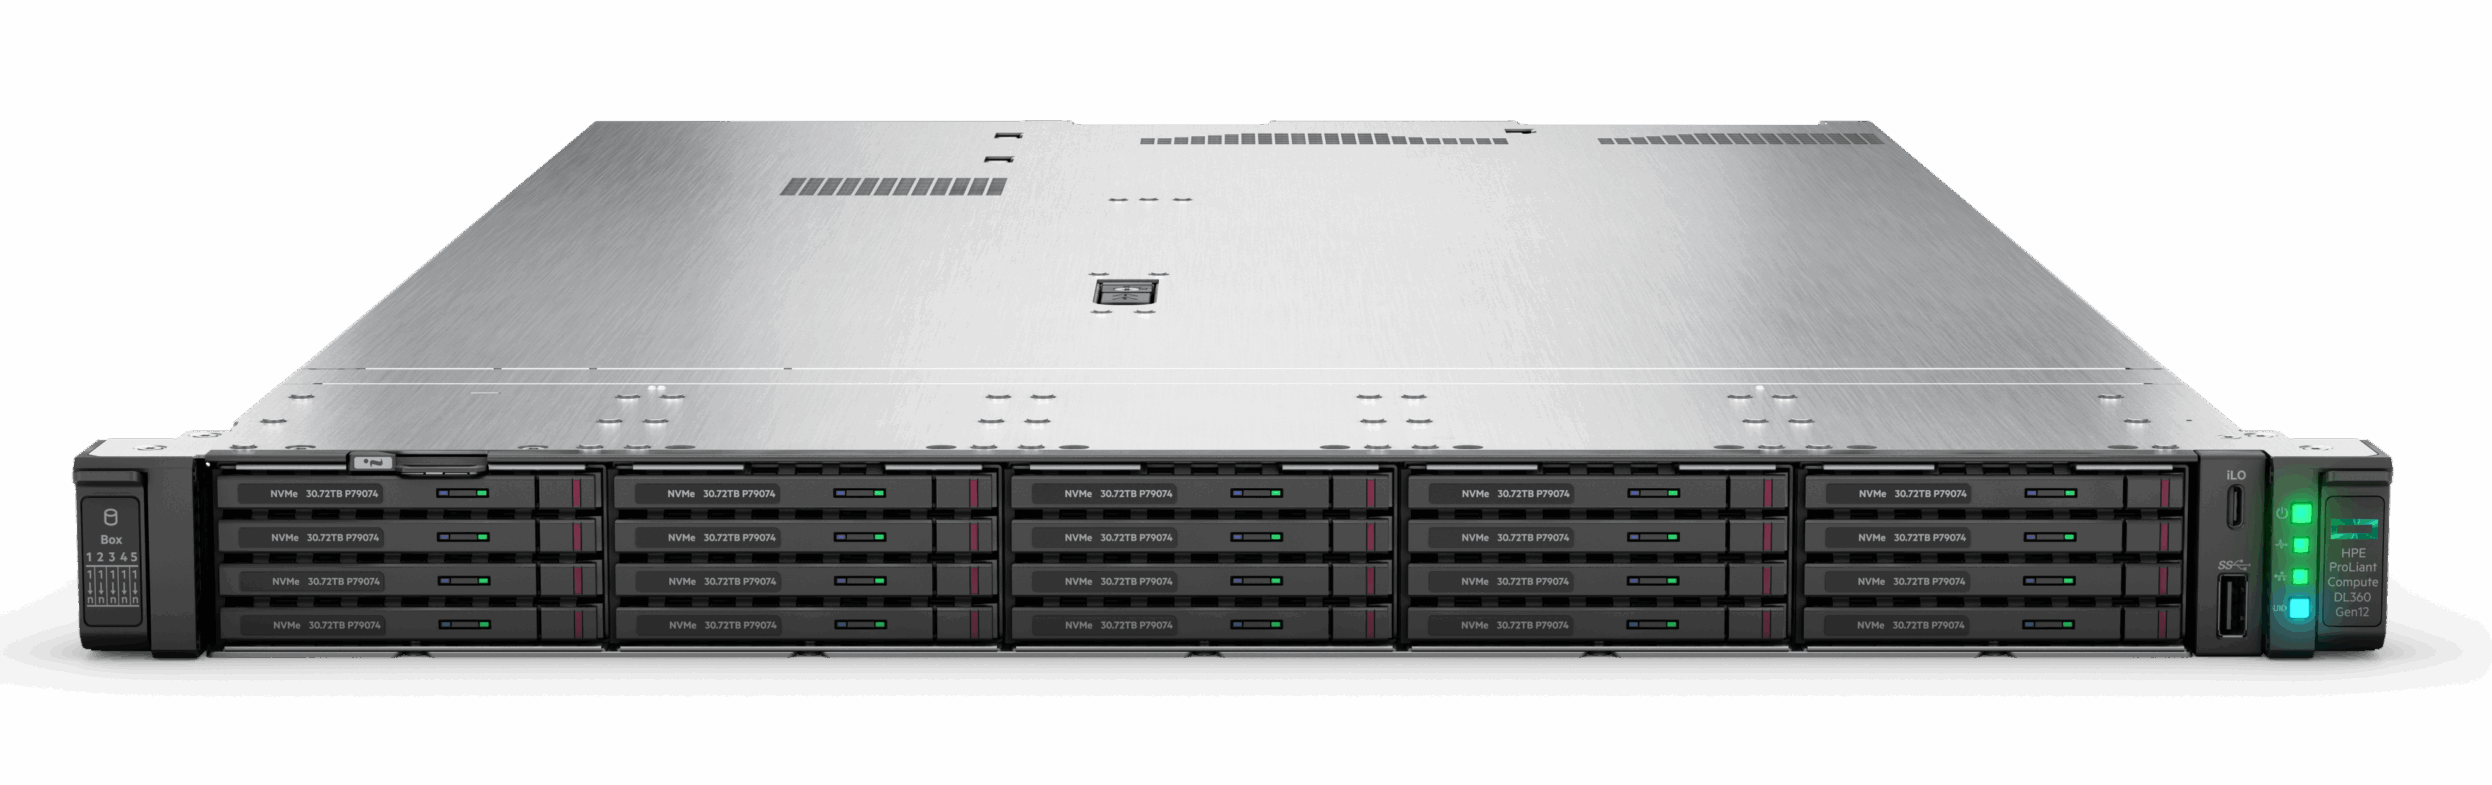
Met configureerbare opties kunt u de prestaties en capaciteit aanpassen:
- Prestatiegeoptimaliseerde DAOS-opslagservers met 8, 12 of 16 NVMe-schijven
- Capaciteitsgeoptimaliseerde DAOS-opslagservers met 20 NVMe-schijven
- NVMe-schijfgroottes: 3.84 TB, 7.68 TB of 15.36 TB
- DRAM-opties: 512 GB, 1,024 GB of 2,048 GB, afgestemd op het aantal schijven en werklastprofielen
De keuze van interconnecties weerspiegelt heterogene datacenternetwerken en workflowbehoeften:
- HPE Slingshot 200
- HPE Slingshot 400
- InfiniBand-NDR
- 400 Gigabit Ethernet
Door DAOS te integreren in een fabrieksgeïntegreerd, door leveranciers ondersteund systeem, streeft HPE ernaar de implementatietijdlijnen te verkorten, de integratiecomplexiteit te verminderen en de duurzame prestaties voor data-intensieve AI en HPC te verbeteren.
Beschikbaarheid
- HPE Cray Supercomputing Storage Systems K3000 met HPE ProLiant Compute-servers: begin 2026
- HPE Cray Supercomputing GX440n Accelerated Blade, GX250 Compute Blade en GX350a Accelerated Blade: begin 2027
- HPE Supercomputing Management Software: begin 2027
- HPE Slingshot 400 voor GX5000-gebaseerde systemen: begin 2027
Het next-gen Cray-portfolio van HPE is gepositioneerd om traditionele AI/HPC-silo's te doorbreken, een hogere prestatiedichtheid per rack te leveren en de processen voor instellingen te stroomlijnen die zowel simulatie als AI-training/-inferentie opschalen op een gemeenschappelijk, uiterst efficiënt platform.


 Amazon