

NVIDIA heeft Minerva aangekondigd op GTC Berlijn, een AIOps-platform dat telemetriegegevens verzamelt van GPU's, netwerken, opslag, schedulers en de AI-workloads die erop draaien. Vervolgens past het machine learning toe om een component te vinden dat in slechte staat verkeert voordat het een trainingstaak vertraagt. Dell Technologies, Lenovo en Supermicro zullen het aanbieden in hun portfolio's voor AI-fabrieksoperaties, IREN gebruikt het al en IBM, Jio, Lambda, Quake AI, Tesla, Aolani en Bitdeer AI zijn van plan het te implementeren. NVIDIA heeft nog geen prijs of releasedatum bekendgemaakt.
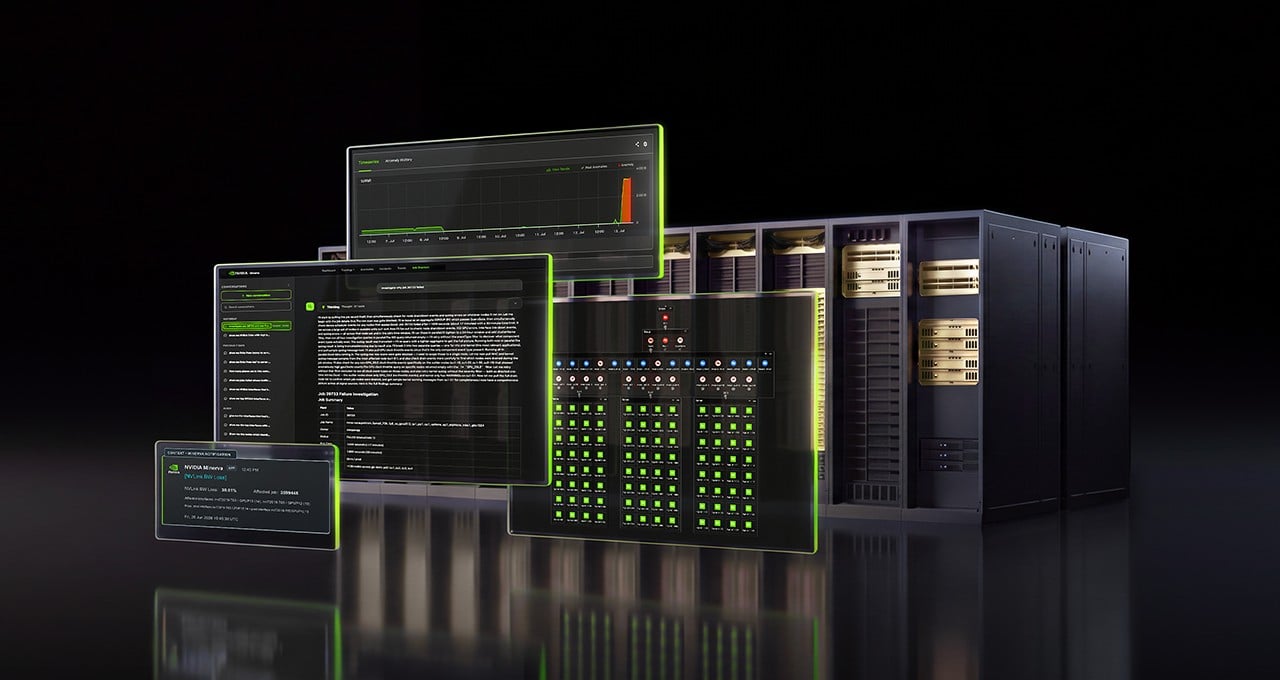
Het probleem waar Minerva zich op richt, is er een dat elke grote clusterbeheerder kent: duizenden GPU's op een snelle fabric gedragen zich als één machine, waardoor één onderdeel dat niet aan de specificaties voldoet, de hele taak vertraagt. NVIDIA geeft als voorbeelden een GPU die warmer wordt dan zijn buren en een NVMe-schijf die onder belasting prestatieverlies lijdt. Dit soort gegevenssignalen is tegenwoordig te vinden in een netwerktool, een rekentool en het dashboard van een ML-team, elk met een aparte weergave van hetzelfde cluster.
Wat Minerva horloges
Minerva bouwt een dynamische kennisgrafiek die GPU's, SuperNIC's, switches, kabels en de daaraan toegewezen taken in kaart brengt. Vervolgens analyseert het systeem, volgens NVIDIA, miljarden datapunten per uur met behulp van supervised en unsupervised machine learning. De modellen leren het normale gedrag van de fabriek, signaleren afwijkingen die ze nog niet eerder hebben gezien, voorspellen opkomende storingen en correleren gerelateerde gebeurtenissen met behulp van de topologie. Zo kan een trage trainingstaak worden herleid tot het verantwoordelijke onderdeel in de fabrieken van NVIDIA, die honderdduizenden GPU's tellen.
De output is georganiseerd als incidenten, waarbij gerelateerde gebeurtenissen worden gegroepeerd in één item en een waarschijnlijke oorzaak eraan wordt gekoppeld. Volgens NVIDIA vervangt dit een stortvloed aan waarschuwingen door één actiegericht item. Een ingebouwde assistent beantwoordt vragen in natuurlijke taal op basis van de live telemetrie en adviseert een oplossing. Het platform maakt verbinding met externe agenttools. Operators kiezen of een persoon de herstelactie uitvoert of dat Minerva dit overdraagt aan automatisering via infrastructuur-API's en externe systemen.
NVIDIA omschrijft de voordelen als de opbrengst van een AI-fabriek, die het meet in GPU-uren, goodput, cluster-uptime en tokenproductie. De geclaimde resultaten zijn langere intervallen tussen onderbrekingen, snellere reparaties en minder meldingen die moeten worden afgehandeld, waarbij het operationele team overstapt van reactief naar proactief onderhoud. Dit zijn beweringen van de leverancier zonder concrete cijfers; NVIDIA heeft geen gemiddelde reparatietijd of uptime-cijfers voor Minerva gepubliceerd.
Waar het zich in de stapel bevindt
NVIDIA verkoopt al operationele software voor zijn referentieontwerpen. Mission Control , geïntroduceerd in maart 2025, beheert clusterprovisioning via Base Command Manager, workloadbeheer via Run:ai, telemetrie en autonoom herstel van taken voor DGX SuperPOD-systemen. In dezelfde week als Minerva bracht NVIDIA drie open-source DSX OS-componenten uit in een ontwikkelaarspreview voor het beheer van de levenscyclus van AI-fabrieken: Config Manager voor netwerkconfiguratie, Rack Management Service voor stroomvoorziening, inventaris, firmware en switchbeheer op rackniveau, en Cluster Readiness Engine voor het valideren van GPU-clusters met gedistribueerde workloads.
De omvang van het probleem dat Minerva wil aanpakken, werd duidelijk in het Prometheus-artikel van Meta van vorige week. Meta beheert elk NVL72-domein als een slice met 64 GPU's, waarbij de overige acht GPU's als reserve in het rack worden gehouden. Ongeveer 2 procent van de racks is in reserve en elk gerepareerd systeem wordt in quarantaine geplaatst totdat de validatie is geslaagd. Een jaar lang onderzoek naar de oorzaak van de problemen, in samenwerking met NVIDIA-technici ter plaatse, heeft het aantal onderbrekingen met 99 procent teruggebracht en de gemiddelde tijd tussen onderbrekingen verhoogd tot meer dan 54,000 GPU-uren, met een streefwaarde van 100,000.
Dat is een hyperscaler die een speciaal daarvoor ontwikkelde telemetrie-pipeline gebruikt en een gezamenlijk triage-team met NVIDIA. Minerva lijkt een kant-en-klare versie van die discipline, iets dat dichter bij de standaardoplossing ligt voor een onderneming of neocloud die inzicht wil op hyperscaler-niveau in de gezondheid van GPU's, fabric en opslag, en de bijbehorende workflow voor reserveonderdelen en herstarts, geleverd via dezelfde OEM's die de racks verkopen.
NVIDIA heeft niet bekendgemaakt hoe Minerva zich verhoudt tot Mission Control of DSX OS, of het als software, appliance of als gehoste service wordt geleverd, of hoe de OEM-verpakking van Dell, Lenovo en Supermicro eruit zal zien. De documentatiepagina van het product verwijst klanten naar hun NVIDIA-accountteam voor de gebruikershandleiding. De klantreferentie is IREN, dat volgens NVIDIA Minerva momenteel gebruikt om zijn AI-fabrieken te optimaliseren.
"NVIDIA Minerva biedt ons operationele team een overzicht van het hele netwerk, de GPU's en de taken die erop draaien", aldus Denis Skrinnikoff, Chief Technology Officer van IREN. Hij gaf aan dat het systeem ervoor heeft gezorgd dat het team nu meer tijd kan besteden aan proactief onderhoud.
Wat de opslag betreft, is de interessante bewering dat het schijfgedrag onder belasting, naast GPU- en fabric-telemetrie, als input wordt gebruikt. Een NVMe-schijf die trager wordt, is immers zelden zichtbaar in het GPU-gebruik, tenzij een checkpoint of data-laadfase vastloopt. Hoe gedetailleerd die opslagtelemetrie precies is en welke OEM's en arrayplatformen deze gegevens aanleveren, is een detail dat interessant zal zijn om te onderzoeken wanneer deze oplossing op de markt komt.



 Amazon