

In een verbazingwekkende weergave van computervaardigheid heeft het StorageReview Lab Team een opeenvolgende wereldrecord gevestigd door pi te berekenen tot maar liefst 202,112,290,000,000 cijfers. Deze opmerkelijke prestatie overschaduwt het vorige record van 105 biljoen cijfers, dat ook in handen was van het team. Het toont de ongeëvenaarde mogelijkheden van moderne high-performance computing en goed ontworpen standaardhardwareplatforms.
Ongekende rekenprestatie
Het StorageReview Lab Team gebruikte een zeer geavanceerde opstelling om deze prestatie te leveren. Met behulp van Intel Xeon 8592+ CPU's en Solidigm P5336 61.44 TB NVMe SSD's voerde het team gedurende 85 dagen vrijwel continu een berekening uit, waarbij bijna 1.5 petabyte aan ruimte werd verbruikt, verdeeld over 28 Solidigm SSD's. Dit baanbrekende project toont aanzienlijke vooruitgang in zowel rekenkracht als efficiëntie.
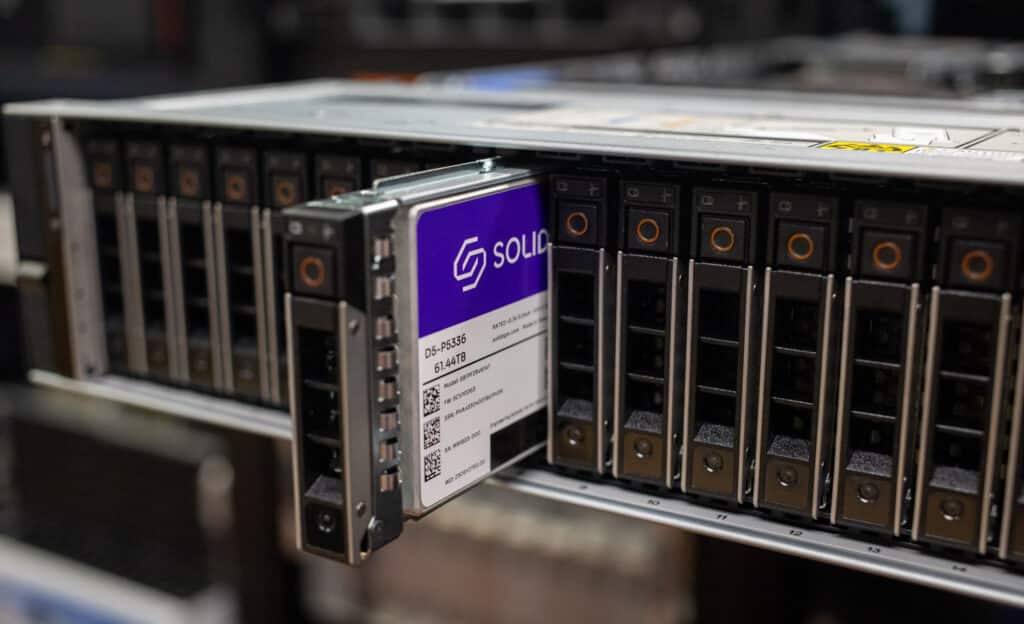
"Dit nieuwe record benadrukt het buitengewone potentieel van de hedendaagse high-performance computerinfrastructuur", zegt Jordan Ranous, de systeemarchitect van het StorageReview Lab Team. “Door deze mijlpaal te bereiken stellen we niet alleen nieuwe maatstaven in de computationele wiskunde, maar maken we ook de weg vrij voor toekomstige innovaties in verschillende wetenschappelijke en technische disciplines.”
In maart 2024 behaalde het StorageReview Lab Team een wereldrecord door pi te berekenen tot 105 biljoen cijfers . Met behulp van een dual-processor AMD EPYC-systeem met 256 cores en bijna een petabyte aan Solidigm QLC SSD's overwon het team aanzienlijke technische uitdagingen, waaronder beperkingen op het gebied van geheugen en opslag. Deze mijlpaal toonde de mogelijkheden van moderne hardware aan en leverde waardevolle inzichten op voor het optimaliseren van krachtige computersystemen.
"Niet alleen werkten de Solidigm-schijven en de Dell PowerEdge R760 feilloos samen, het feit dat dit nieuwe record vrijwel volledig geautomatiseerd was, was een welkome verandering na de problemen bij onze vorige recordpoging", aldus Kevin O'Brien, directeur van het StorageReview Lab. "Na wat we hebben meegemaakt tijdens de vorige testrun naar 105 biljoen cijfers, ben ik blij dat we voor dit platform hebben gekozen voor de grote recordpoging", vervolgde hij. Voor meer details over de vorige poging om 105 biljoen cijfers te halen en de bijbehorende uitdagingen, kunt u het volledige artikel hier lezen.
CompSci en wiskundeles
Toen we voor het eerst begonnen te kijken naar leuke manieren om SSD's met grote capaciteit te testen, stond het voor de hand liggende antwoord in onze CPU- en systeemrecensies: y-cruncher. Bij het gebruik van swapspace voor uitgebreide berekeningen is de benodigde ruimte ongeveer 4.7:1 voor de cijfers, dus 100 biljoen cijfers hebben ongeveer 470 TiB aan ruimte nodig. Zonder al te diep in de wiskunde en informatica te duiken, is y-cruncher, het Chudnovsky-algoritme, gebaseerd op een snel convergerende reeks die is afgeleid van de theorie van modulaire functies en elliptische curven. De kern van het algoritme is gebaseerd op de volgende oneindige reeksen:

De belangrijkste vraag die we kregen met betrekking tot onze 100T- en 105T-berekeningen was: “Oké, geen probleem. Waarom duurt dit zo lang en heeft het zoveel geheugen nodig?” Deze vraag was een van de vervelende zorgen over open source en de programmeermogelijkheden van Alex Yee. Laten we een stapje terug doen en dit vanuit het systeemniveau bekijken.
Voor het berekenen van een groot aantal cijfers van Pi, zoals 100 biljoen, is aanzienlijke ruimte nodig vanwege de grote rekenkundige bewerkingen die ermee gepaard gaan. De uitdaging ligt vooral in het vermenigvuldigen van grote getallen, waarvoor inherent veel geheugen nodig is. De beste algoritmen voor het vermenigvuldigen van N-cijferige getallen hebben bijvoorbeeld ongeveer 4N bytes geheugen nodig, waarvan de meeste als kladruimte dienen. Dit geheugen moet tijdens de berekening meerdere keren worden benaderd, waardoor het proces verandert in een schijf-I/O-intensieve taak in plaats van een CPU-gebonden taak.
De Chudnovsky-formule, die veel wordt gebruikt voor het berekenen van vele cijfers van Pi, vereist uitgebreide rekenkundige bewerkingen. Deze vermenigvuldigings-, delings- en kwadratuurbewerkingen worden vaak teruggebracht tot grote vermenigvuldigingen. Historisch gezien gebruikten supercomputers AGM-algoritmen, die, ondanks dat ze langzamer waren, gemakkelijker te implementeren waren en profiteerden van de brute kracht van talloze machines. Door moderne ontwikkelingen is het knelpunt echter verschoven van rekenkracht naar geheugentoegangssnelheden.
Processor Arithmetic Logic Units (ALU's) en Floating Point Units (FPU's) verwerken deze grote vermenigvuldigingsgetallen op dezelfde manier als handmatige vermenigvuldiging op papier, en splitsen ze op in kleinere, beheersbare bewerkingen. Voorheen waren Pi-berekeningen computergebonden, maar de huidige rekenkracht overtreft de geheugentoegangssnelheden, waardoor opslag en betrouwbaarheid de kritische factoren zijn bij het instellen van Pi-records. Er werd bijvoorbeeld weinig prestatieverschil waargenomen tussen onze 128-core Intel-machine en een 256-core AMD Bergamo; de focus lag op schijf-I/O-efficiëntie.
Solidigm SSD's spelen een cruciale rol in deze berekeningen, niet vanwege hun inherente snelheid, maar vanwege hun uitzonderlijke opslagdichtheid. NVMe-schijven van consumentenkwaliteit kunnen tot 4 TB opslaan in een klein volume, terwijl SSD's van bedrijven deze chips stapelen voor een nog grotere capaciteit. Hoewel QLC NAND langzamer kan zijn dan andere typen flashgeheugen, levert het parallellisme in deze dichte SSD's een hogere totale bandbreedte op, waardoor ze ideaal zijn voor grootschalige Pi-berekeningen.
Solidigm QLC NVMe SSD's, die de waanzin mogelijk maken
Oké, als je nog wakker bent en me volgt, hoef je alleen maar te weten dat computers, wanneer getallen te groot zijn om in het geheugen te passen, software-algoritmes voor multiprecisie-rekenkunde moeten gebruiken. Deze algoritmes splitsen de grote getallen op in behapbare delen en voeren de deling uit met behulp van speciale technieken. Dit is waar de Solidigm P5336 61.44 TB NVMe SSD's in beeld komen. y-cruncher neemt deze behapbare delen, verzamelt ze eerst in het systeemgeheugen en zet ze vervolgens om naar een tijdelijke opslaglocatie.
Bedenk dat we ongeveer 4.7:1 nodig hebben voor de uitwisseling, omdat elk onderdeel van die enge formule daarboven door heel veel bits moet worden weergegeven.
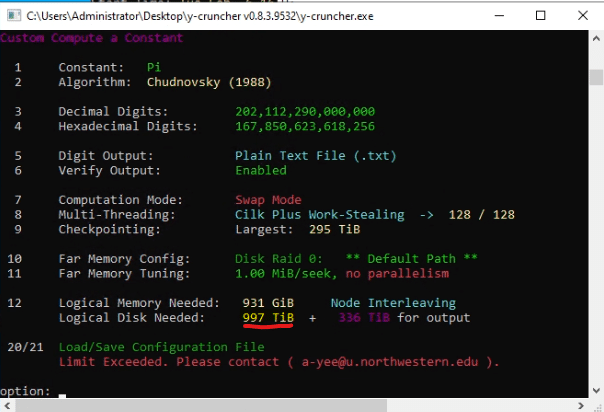
y-cruncher heeft een ingebouwde schatter voor de hoeveelheid benodigde schijfruimte (nog steeds genaamd disk*cough*) die volgens ons perfect accuraat is in deze en eerdere runs.
Hoewel je er wel wat harde schijven of objectopslag aan zou kunnen toevoegen, is de pure grootte slechts één onderdeel van een zeer complexe vergelijking, zoals we in onze eerste ronde hebben aangetoond. De mogelijkheid om voldoende grote en snelle opslag dicht bij het rekenapparaat te krijgen, is een terugkerend thema bij StorageReview, zeker met de opkomst van AI. De prestaties van de swapruimte vormen de grootste bottleneck in deze berekening. Direct aangesloten NVMe biedt de hoogste prestaties, en hoewel sommige opties de snelste doorvoer per apparaat kunnen hebben, was onze grote, zeer compacte array van QLC-schijven in totaal meer dan voldoende.
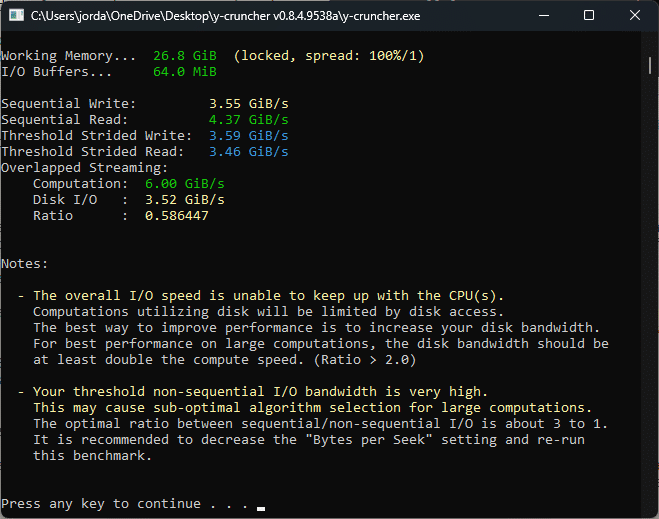
Consumentendrive en CPU-prestaties. NIET het opnamesysteem
Y-Cruncher heeft een ingebouwde benchmark waarmee je alle instellingen kunt aanpassen om de beste prestaties voor je schijfarray te vinden. Dit is uiterst belangrijk. De bovenstaande schermafbeelding laat zien dat de benchmark feedback geeft voor dit consumentensysteem, met gegevens over hoe snel de CPU de berekeningen kan uitvoeren en de prestaties van de SSD.
Alex heeft uitgebreide documentatie beschikbaar , maar om het kort samen te vatten: na wekenlang testen hebben we ontdekt dat het het beste is om y-cruncher rechtstreeks met de schijven te laten communiceren. We hebben netwerkdoelen, schijven achter een SAS RAID-kaart, NVMe RAID-kaarten en iSCSI-doelen getest. Wanneer we de controle over de hardware aan y-cruncher overlaten, is het prestatieverschil enorm. iSCSI lijkt ook acceptabel, maar we hebben dat alleen getest voor het uitvoerbestand, dat gebruik kan maken van "Direct IO" voor die interactie. De RAID-code in swapmodus moet relatief goed doordacht zijn, en uit onze tests en gesprekken met de ontwikkelaar kunnen we afleiden dat deze op een laag niveau met de schijven werkt.
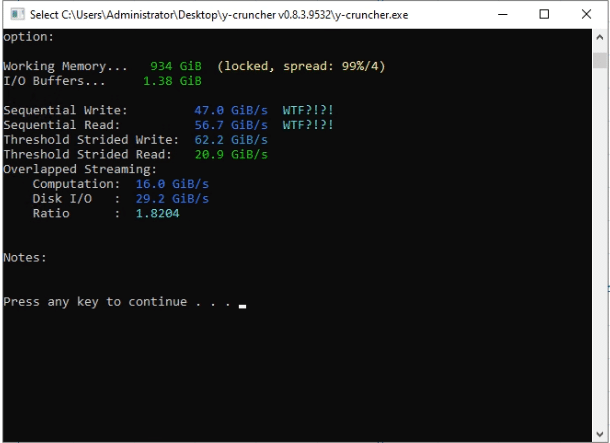
De Solidigm-schijven van 61.44 TB beginnen naar voren te komen als het beste antwoord op veel problemen op dat gebied. Als we de benchmark op ons systeem uitvoeren, zien we dat de schijven op de specificaties presteren voor zowel lezen als schrijven. We hebben specifiek de Intel CPU's geselecteerd om zo dicht mogelijk bij de optimale 2:1 Drive to Computation-verhouding te komen. Dit is de optimale verhouding, zodat u geen tijd verspilt aan het wachten op de CPU tot de schijven presteren. Naarmate de aandrijftechnologie sneller wordt, kunnen we uitgebreidere, snellere runs uitvoeren door CPU's met een hoger core-aantal te selecteren.
“Aangepaste” Dell PowerEdge R760-server
Zoals het gezegde luidt: de derde keer is scheepsrecht. Dit is niet onze eerste rodeo met het breken van records met Pi; we hebben lessen getrokken uit onze eerste twee iteraties om het beste Pi-platform te bouwen. Onze eerste build maakte gebruik van een 2U-server met 16 NVMe-bays en drie interne SSD-sleeën. Met Solidigm P30.72 SSD's van 5316 TB hadden we de swap-opslag voor y-cruncher, maar moesten we een HDD-gebaseerde opslagserver gebruiken voor het uitvoerbestand. Vooral aan het einde van de uitschrijffase was het niet optimaal. Ons tweede platform gebruikte dezelfde server, met een externe NVMe JBOF eraan, wat ons een extra NVMe-bay gaf, maar ten koste van gevoelige bekabeling en onevenwichtige prestaties. Het nadeel van beide platforms was dat ze gedurende de hele y-cruncher-run afhankelijk moesten zijn van externe hardware, ten koste van extra kracht en extra storingspunten.
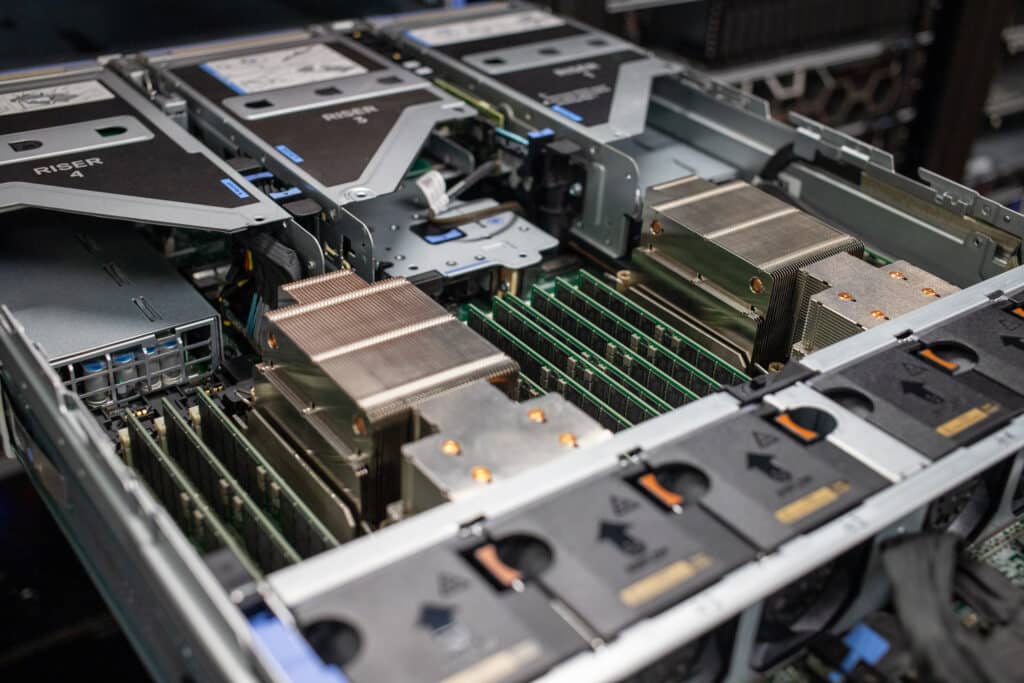
Voor deze run wilden we gebruik maken van één volledig directe NVMe-server en voldoende ruimte hebben voor onze y-cruncher swap-opslag en uitvoeropslag onder één metalen dak. Maak kennis met de Dell PowerEdge R760 met de 24-bay NVMe Direct Drives-backplane. Dit platform maakt gebruik van een interne PCIe-switch om alle NVMe-schijven tegelijkertijd met de server te laten praten, waardoor de noodzaak voor extra hardware of RAID-apparaten wordt omzeild. Vervolgens hebben we een PCIe-riserconfiguratie samengesteld uit meerdere R760's in onze laboratoriumomgeving, waardoor we vier PCIe-slots aan de achterkant kregen voor extra op U.2 gemonteerde NVMe SSD's. Een bonus was het verwijderen van grotere koellichamen van een andere R760, waardoor we zoveel mogelijk turbo-boost-ruimte kregen. Directe vloeistofkoeling kwam een maand te laat in ons laboratorium om in deze run te worden geïmplementeerd.
“De berekening van pi tot meer dan 202 biljoen cijfers door het StorageReview Lab-team, uitgevoerd met een 5e generatie Intel Xeon-processor, onderstreept de kracht en efficiëntie van deze CPU's. Dankzij het grotere aantal cores en de geavanceerde prestatiekenmerken van de 5e generatie Xeon-processor zet deze mijlpaal een nieuwe standaard in de computationele wiskunde en effent het de weg voor innovaties in diverse wetenschappelijke en technische toepassingen”, aldus Suzi Jewett, algemeen directeur van Intel voor 5e generatie Intel Xeon-processorproducten.
Hoewel je technisch gezien een Dell-configuratie kon bestellen die precies zo was als degene die in deze run werd gebruikt, was het niet iets dat ze hadden liggen en in elkaar moesten worden gezet. (Misschien zal Michael een limited edition “Pi” batch R760’s uitvoeren met exact deze configuratie, aangepaste verf en het SR-logo.)
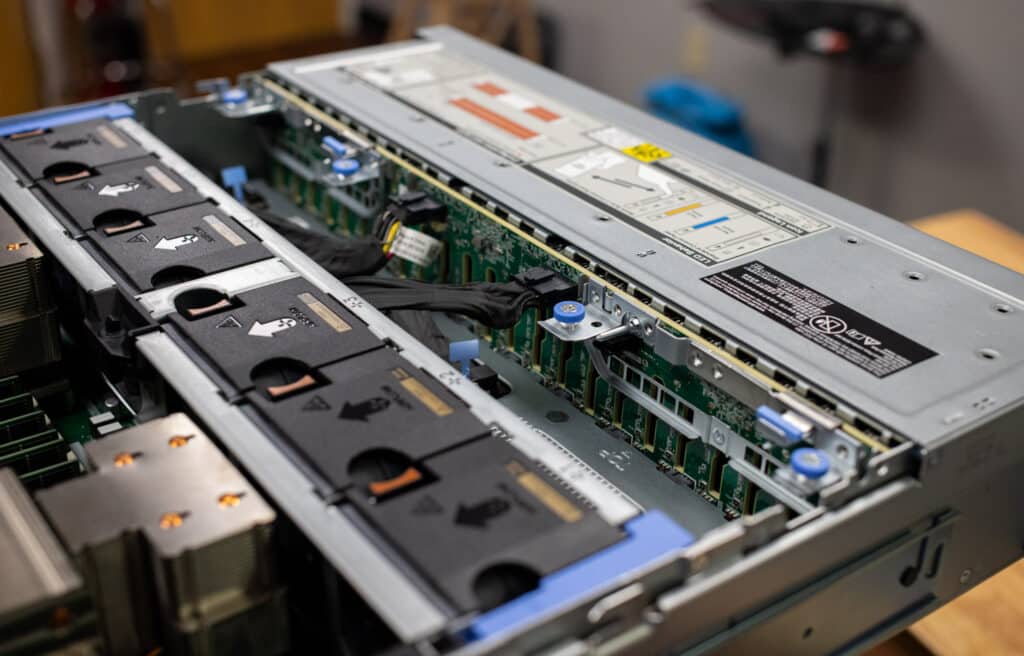
De grootte van de voeding was ook van cruciaal belang voor deze run. Hoewel de meesten meteen zouden denken dat de CPU's het grootste deel van de stroom verbruiken, is het hebben van 28 NVMe SSD's onder één dak een aanzienlijke impact op de energievoorziening. Onze build maakte gebruik van de 2400W PSU's, die, zo bleek, nauwelijks werkten. We hadden een paar bijna kritieke stroomverbruikmomenten waarbij we te weinig stroom zouden hebben gehad als het systeem één voedingsaansluiting had verbroken. Dit raakte al vroeg; Het stroomverbruik schoot omhoog terwijl de CPU-belasting een piek bereikte en het systeem de I/O-activiteit naar alle SSD's verhoogde. Als we dit nog een keer zouden moeten doen, hadden de 2800W-modellen de voorkeur gehad.
Prestatiespecificaties
Technische hoogtepunten
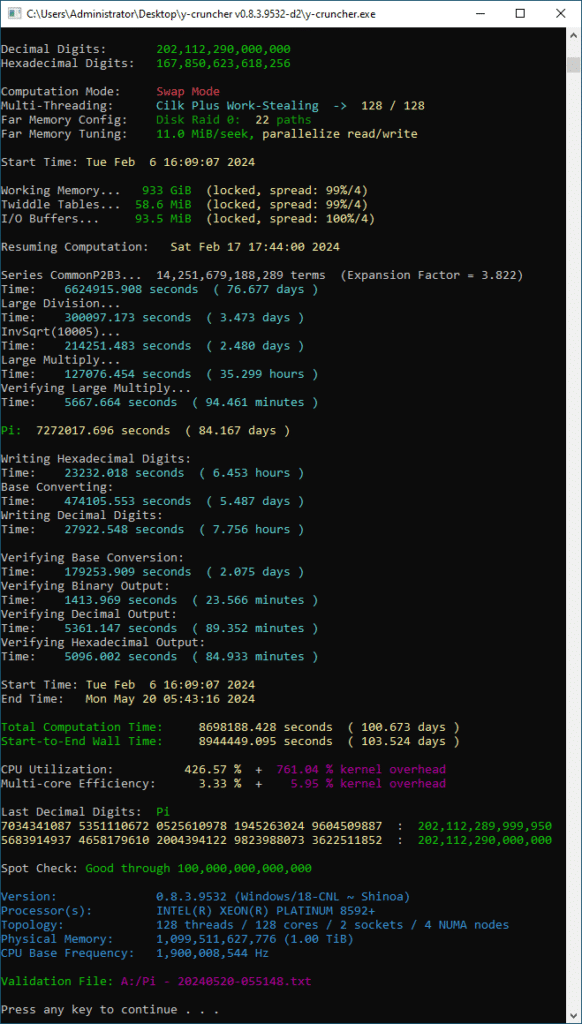
- Totaal aantal cijfers berekend: 202,112,290,000,000
- Gebruikte hardware: Dell PowerEdge R760 met 2x Intel Xeon 8592+ CPU's, 1TB DDR5 DRAM, 28x Solidigm 61.44TB P5336
- Software en algoritmen: y-cruncher v0.8.3.9532-d2, Chudnovsky
- Data opslag: 3.76 PB geschreven per schijf, 82.7 PB over de 22 schijven voor swap-array
- Berekeningsduur: 100.673 dagen
y-cruncher-telemetrie
- Logisch grootste ijkpunt: 305,175,690,291,376 (278 TiB)
- Logisch piekschijfgebruik: 1,053,227,481,637,440 (958 TiB)
- Logische schijfbytes gelezen: 102,614,191,450,271,272 (91.1 PiB)
- Logische schijfbytes geschreven: 88,784,496,475,376,328 (78.9 PiB)
- Startdatum: di 6 februari 16:09:07 2024
- Einddatum: ma 20 mei 05:43:16 2024
- Pi: 7,272,017.696 seconden, 84.167 dagen
- Totale rekentijd: 8,698,188.428 seconden, 100.673 dagen
- Begin-tot-eind wandtijd: 8,944,449.095 seconden, 103.524 dagen
Het grootste bekende cijfer van Pi is 2, op positie 202,112,290,000,000 (tweehonderdtwee biljoen, honderdtwaalf miljard, tweehonderdnegentig miljoen).
Bredere implicaties
Hoewel het berekenen van pi tot zo'n groot aantal cijfers een abstracte uitdaging lijkt, hebben de praktische toepassingen en technieken die tijdens dit project zijn ontwikkeld verreikende implicaties. Deze verbeteringen kunnen verschillende computertaken verbeteren, van cryptografie tot complexe simulaties in de natuurkunde en techniek.
De recente 202 biljoen cijfers pi-berekening benadrukt aanzienlijke verbeteringen in de opslagdichtheid en de totale eigendomskosten (TCO). Onze opstelling leverde een verbazingwekkende 1.720 petabyte aan NVMe SSD-opslag op binnen één 2U-chassis. Deze dichtheid vertegenwoordigt een sprong voorwaarts in de mogelijkheden voor gegevensopslag, vooral gezien het totale energieverbruik dat piekte op slechts 2.4 kW bij volledige CPU- en schijfbelasting.
Deze energie-efficiëntie staat in contrast met traditionele HPC-recordruns die aanzienlijk meer stroom verbruiken en overmatige hitte genereren. Het stroomverbruik neemt exponentieel toe als u rekening houdt met extra knooppunten voor uitbreidbare opslagsystemen als u gedeelde opslag met lage capaciteit moet uitbreiden in vergelijking met lokale opslag met hoge dichtheid. Warmtebeheer is van cruciaal belang, vooral voor kleinere datacenters en serverkasten. Het koelen van traditionele HPC-recordsystemen is geen sinecure, omdat er datacenterkoelers nodig zijn die meer stroom kunnen verbruiken dan de apparatuur die alleen draait. Door het energieverbruik en de warmteafgifte te minimaliseren, biedt onze opstelling een duurzamere en beheersbare oplossing voor kleine bedrijven. Als bonus werd het grootste deel van onze run uitgevoerd met koeling met frisse lucht.
Om dit in perspectief te plaatsen, stel je eens voor met welke uitdagingen degenen die werken met gedeelde netwerkopslag en niet-geoptimaliseerde platforms worden geconfronteerd. Voor deze opstellingen zijn een of meer datacenter-koelers nodig om de temperatuur onder controle te houden. In deze omgevingen vertaalt elke bespaarde watt zich in minder benodigde koeling en lagere operationele kosten, waardoor onze benadering met hoge dichtheid en laag vermogen een ideale keuze is. Een ander cruciaal voordeel van het runnen van een slank en efficiënt platform voor recordruns is het beschermen van de hele installatie met batterijback-uphardware. Zoals eerder vermeld, heb je batterijback-ups nodig voor computerservers, switches, opslagservers, koelmachines en waterpompen om de computer een groot deel van het jaar in leven te houden.
Over het geheel genomen toont deze recordbrekende prestatie het potentieel van de huidige HPC-technologieën aan en onderstreept het het belang van energie-efficiëntie en thermisch beheer in moderne computeromgevingen.
Zorgen voor nauwkeurigheid: de Bailey-Borwein-Plouffe-formule
Het berekenen van pi tot 202 biljoen cijfers is een gigantische taak, maar het garanderen van de nauwkeurigheid van die cijfers is net zo cruciaal. Dit is waar de formule Bailey-Borwein-Plouffe (BBP) in het spel komt.
Met de BBP-formule kunnen we de binaire cijfers van pi in hexadecimaal formaat (basis 16) verifiëren zonder dat we alle voorgaande cijfers hoeven te berekenen. Dit is vooral handig voor het vergelijken van delen van onze enorme berekening.
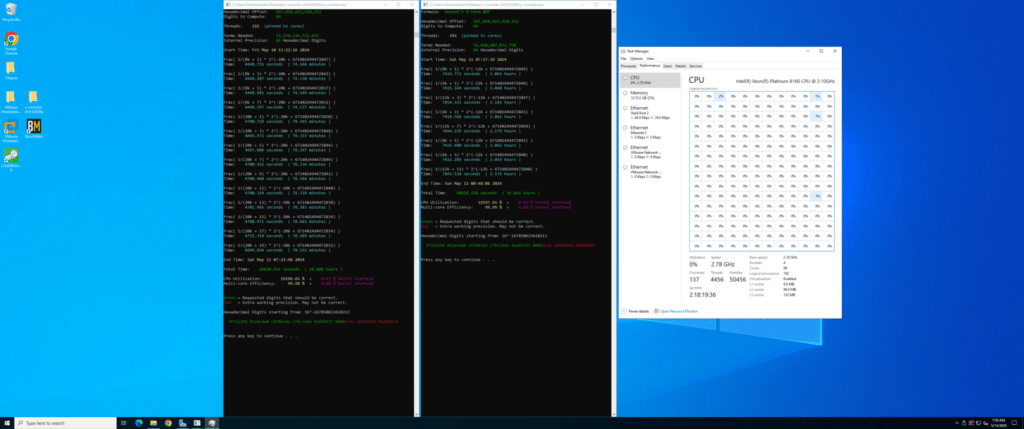
Twee van de verificatieberekeningen.
Hier is een vereenvoudigde uitleg:
- Hexadecimale uitvoer: We genereren eerst de cijfers van pi in hexadecimaal tijdens de hoofdberekening. De BBP-formule kan elk willekeurig individueel cijfer van pi in grondtal 16 rechtstreeks berekenen. Je kunt dit doen met andere programma's zoals GPUPI, maar y-cruncher heeft ook een ingebouwde functie. Als u de voorkeur geeft aan een open source-aanpak, de formules zijn bekend.
- Kruisverificatie: We kunnen deze resultaten vergelijken met onze hoofdberekening door specifieke posities van de hexadecimale cijfers van pi onafhankelijk te berekenen met de BBP-formule. Als ze overeenkomen, geeft dit sterk aan dat onze hele reeks correct is. We hebben deze kruiscontrole zes keer uitgevoerd; hier zijn er twee.
Als onze primaire berekening bijvoorbeeld op verschillende punten dezelfde hexadecimale cijfers oplevert als die verkregen uit de BBP-formule, kunnen we met vertrouwen de nauwkeurigheid van onze cijfers beweren. Deze methode is niet alleen theoretisch; het is praktisch toegepast in alle belangrijke pi-berekeningen, waardoor robuustheid en betrouwbaarheid van de resultaten wordt gegarandeerd.
R= Officieel runresultaat, V= Verificatieresultaat
- R: f3f7e2296 822ac6a8c9 7843dacfbc 1eeb4a5893 37088*
- V: *3f7e2296 822ac6a8c9 7843dacfbc 1eeb4a5893 370888
Oplettende lezers zullen opmerken dat de verificaties van de screenshots en de bovenstaande vergelijking enigszins verschoven zijn (*). Hoewel dit niet noodzakelijk was, aangezien de hexadecimale waarde aan het einde toch beïnvloed zou worden, hebben we ook een paar andere locaties (zoals 100 biljoen en 105 biljoen cijfers) steekproefsgewijs gecontroleerd om er zeker van te zijn dat de resultaten overeenkwamen. Hoewel het theoretisch mogelijk is om elk decimaal cijfer van pi te berekenen met een vergelijkbare methode, is het onduidelijk of dat een nauwkeurigheid zou opleveren voorbij slechts 100 miljoen cijfers, of dat het computationeel efficiënt genoeg zou zijn om dit te doen, in plaats van de Chudnovsky-methode te gebruiken om ze allemaal te berekenen. (Mocht Eric Weisstein dit lezen, neem dan contact met me op; ik wil het graag eens proberen.)
Door dit wiskundige kruiscontroleproces te integreren, kunnen we de integriteit van onze recordbrekende pi-berekening van 202 biljoen cijfers garanderen, wat onze rekenprecisie en toewijding aan wetenschappelijke nauwkeurigheid aantoont.
De weg voor ons
De prestatie van het StorageReview Lab-team om pi tot meer dan 202 biljoen cijfers te berekenen, is een bewijs van de opmerkelijke vooruitgang op het gebied van krachtige computer- en opslagtechnologie. Deze recordbrekende prestatie, waarbij gebruik wordt gemaakt van Intel Xeon 8592+ CPU's in onze Dell PowerEdge R760 en Solidigm 61.44TB QLC NVMe SSD's, benadrukt de mogelijkheden van moderne hardware om complexe en resource-intensieve taken met ongekende efficiëntie uit te voeren. Het succes van het project toont niet alleen de bekwaamheid van het StorageReview-team aan, maar onderstreept ook het potentieel van de hedendaagse HPC-infrastructuur om de grenzen van computationele wiskunde en andere wetenschappelijke disciplines te verleggen.
“Dit nieuwe wereldrecord voor Pi is een fantastische prestatie, omdat de rekenkracht die hiervoor nodig is net zo intensief is als veel van de AI-workloads die we tegenwoordig zien. De Solidigm D5-P5336 61.44TB SSD's hebben wederom bewezen dat de krachtige combinatie van ultrahoge capaciteit, PCIe 4-leesprestaties die de maximale capaciteit benutten en hoge petabytes aan schrijfsnelheid, bestand is tegen en de kracht kan ontketenen van enkele van de meest veeleisende applicaties van vandaag”, aldus Greg Matson, VP van Solidigm's Data Center Storage Group. “We zijn verheugd dat we samen met onze partners bij Dell Technologies en de experts van StorageReview de kans hebben gekregen om opnieuw een recordpoging te wagen om Pi te berekenen.”
Dit streven biedt ook waardevolle inzichten in het optimaliseren van de opslagdichtheid en energie-efficiëntie, waardoor de weg wordt vrijgemaakt voor duurzamere en beheersbare computeroplossingen. Terwijl we de mogelijkheden van HPC blijven verkennen, zullen de lessen die uit dit project worden geleerd ongetwijfeld toekomstige innovaties aandrijven, waarvan verschillende gebieden zullen profiteren, van cryptografie tot engineering. De prestatie van het StorageReview Lab-team geldt als een mijlpaal in de computergeschiedenis en laat zien dat we nieuwe hoogten van wetenschappelijke ontdekkingen en technologische vooruitgang kunnen bereiken met de juiste combinatie van hardware en expertise.
Dankwoord
Het StorageReview Lab-team bedankt Solidigm, Dell Technologies, Intel en y-cruncher Alex Yee voor hun niet aflatende steun en bijdragen aan dit project.


 Amazon